結論:AIエージェントの月額コストは「モデル階層化」「キャッシュ」「並列度設計」の3点だけで半減する。残り4原則を組み合わせれば、品質を落とさず月額を1/3にできる。
要点3つ
- Haiku/Sonnet/Opusの使い分けで、同じタスクでも入力トークン単価が5倍違う(Opus 5 入力5ドル/100万tok→Haiku 4.5 1ドル/100万tok・2026年9月4日時点のAnthropic公式料金)
- Anthropic Prompt Cachingは5分キャッシュの書き込みが1.25倍課金・読み出しが0.1倍課金。公式の説明どおり、1回でも読み出しが発生すれば元が取れる
- 並列度の最適本数は「rate-limit ÷ 1リクエスト平均所要秒数」で求まる。経験則「とりあえず10並列」は事故の元
対象読者:本番でAIエージェントを動かしていて、月額が想定の2-3倍に膨らんでいる開発責任者・情シス・CFO。「とりあえずOpus」「並列度はカン」で運用してきた組織。
今日やること:①直近30日の請求書を品目別に分解、②Opus呼出のうち「Sonnetで代替可能」な割合を見積もり、③1つだけでもPrompt Cacheを試す。これだけで翌月の請求書が変わる。
AIエージェントを本番投入して半年。最初は月3万円だったAPI請求書が、ユーザー数の増加とエージェントの多段化で月60万円を超えた——という相談が、2026年に入ってから明らかに増えている。導入支援や研修の現場で見ている範囲では、原因の多くは「アーキテクチャの問題」ではなく「使い方の問題」だ。同じワークフローでもチューニングだけで月額を大きく下げられるケースが少なくない。
本記事では、Anthropic公式の料金表とPrompt Caching仕様、FinOps Foundationが提唱するAI支出管理フレームワークをもとに、コスト最適化の打ち手を「7原則」にまとめた。原則ごとに、サンプルコード・コスト試算表・失敗パターン・想定シナリオを併記している。読み終えたあと、自社のエージェント運用に何を当てはめるべきかが具体的にわかる構成だ。
注意点を先に書いておく。本記事の数字は2026年9月時点のAnthropic公式料金に基づいている。料金体系は改定されるため、本番計算では必ず最新の公式ページで再確認してほしい。また、コスト最適化は「品質を犠牲にする」と紙一重なので、最後の章で「撤退判断」までセットで論じる。安易な節約で精度が崩れれば、コスト以上のものを失うことになる。
【追記 2026年10月12日】Claudeの現行モデルと単価
2026年10月12日時点のClaudeの現行モデルは、Fable 5.1(入力10ドル・出力50ドル)、Opus 5.5(4ドル・20ドル・9月22日公開)、Sonnet 5.5(2ドル・10ドル・9月28日公開)、Haiku 5.5(0.10ドル・0.50ドル・10月7日公開・プロンプトが10万トークン以下の場合)です(100万トークンあたり・Anthropic公式の料金ページ)。この記事の単価と試算は本文に書いた日付の時点の値なので、見積もりは現行の単価で計算し直してください。軽量モデルは Haiku 4.5(1ドル・5ドル)から約10分の1になっています。
まず試したい「5分即効」セットアップ3選
原則の解説に入る前に、今日の業務でそのまま使える即効テクニックを3つ示す。コピペで動く設定だけを選んだ。
即効テクニック1:モデル振り分け関数で月額を半分にする
想定シナリオ:カスタマーサポート用エージェントで、全リクエストを最上位モデルに流している状態を考える。タスク難易度を3段階に分け、Haiku/Sonnet/Opusへ自動で振り分けると、単価ベースでは下の試算のとおり半分以下になる。振り分けたあとは、安いモデルに回したタスクの正答率が落ちていないかを必ず確認する。
# 動作環境: Python 3.11+, anthropic>=0.40
# 必要パッケージ: pip install anthropic
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
import anthropic

client = anthropic.Anthropic()

def classify_complexity(user_input: str) -> str:
    """ユーザー入力の複雑度を3段階に判定"""
    length = len(user_input)
    has_code = "```" in user_input or "def " in user_input
    has_multi_step = user_input.count("。") >= 3

    if has_code and has_multi_step:
        return "high"      # Opus
    elif has_multi_step or length > 200:
        return "medium"    # Sonnet
    else:
        return "low"       # Haiku

def select_model(complexity: str) -> str:
    return {
        "low":    "claude-haiku-4-5",
        "medium": "claude-sonnet-5",
        "high":   "claude-opus-5",
    }[complexity]

def route_request(user_input: str) -> str:
    model = select_model(classify_complexity(user_input))
    resp = client.messages.create(
        model=model,
        max_tokens=1024,
        messages=[{"role": "user", "content": user_input}],
    )
    return resp.content[0].text
効果:想定シナリオの目安(試算)——1リクエスト平均 入力2,000/出力500トークンとして、Opus 5に100%流すと1件あたり約$0.0225。これをOpus 5 8%/Sonnet 5 35%/Haiku 4.5 57%に振り分けると約$0.0075になり、単価ベースで約67%減の計算になる。
前提:2026年9月4日時点のAnthropic公式料金(Opus 5 入力$5/出力$25、Sonnet 5 $2/$10、Haiku 4.5 $1/$5)による試算であり、実測値ではありません
即効テクニック2:Prompt Cachingで定型システムプロンプトをキャッシュ
システムプロンプトが長い(例:会社のガイドライン+ナレッジ抜粋で5,000トークン超)場合、Anthropic Prompt Cachingが効く。書き込み時は1.25倍課金だが、読み出し時は0.1倍課金。10回以上同じシステムプロンプトを使い回すなら、確実に元が取れる。
# 動作環境: Python 3.11+, anthropic>=0.40
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
import anthropic

client = anthropic.Anthropic()

SYSTEM_PROMPT = """あなたは○○社のカスタマーサポートエージェントです。
... (約5,000トークンのガイドライン+FAQ抜粋) ..."""

resp = client.messages.create(
    model="claude-sonnet-5",
    max_tokens=1024,
    system=[
        {
            "type": "text",
            "text": SYSTEM_PROMPT,
            "cache_control": {"type": "ephemeral"},
        }
    ],
    messages=[{"role": "user", "content": "返品ポリシーを教えて"}],
)
print(resp.usage)
# cache_creation_input_tokens: 5000 (初回のみ書き込み)
# cache_read_input_tokens:     5000 (2回目以降は読み出し)
効果:想定シナリオの目安(試算)——システムプロンプト5,000トークンをSonnet 5(入力$2/100万トークン)で1日200回送ると、キャッシュなしの入力課金は月あたり約$60(1ドル150円で約9,000円)。キャッシュに当たった分は入力単価の0.1倍で課金されるため、ヒット率の高いワークロードでは入力課金が1桁下がる。キャッシュ生存時間は5分(ephemeral・書き込みは1.25倍課金)なので、連続アクセスが多いワークロードと相性が良い。(2026年9月時点の公式料金による試算・実測値ではありません)
即効テクニック3:並列度を「上限-2」に固定して暴走防止
並列度を上げすぎるとrate-limitに当たり、retry地獄でかえって遅くなる。429で弾かれた分を待って投げ直す往復が積み上がるためだ。Tier別の上限から「-2」した値で固定するのが安定運用の目安になる。
# 動作環境: Python 3.11+
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
import asyncio
from anthropic import AsyncAnthropic

client = AsyncAnthropic()

# Anthropic Tier 2想定: requests_per_minute=1000, 60秒で1000リクエスト
# 1リクエスト平均3秒なら同時並列の理論値は1000 / (60/3) = 50
# 安全マージンで-2 → 48並列
SAFE_PARALLEL = 48
sem = asyncio.Semaphore(SAFE_PARALLEL)

async def call_one(prompt: str):
    async with sem:
        return await client.messages.create(
            model="claude-haiku-4-5",
            max_tokens=512,
            messages=[{"role": "user", "content": prompt}],
        )

async def run_batch(prompts: list[str]):
    return await asyncio.gather(*(call_one(p) for p in prompts))
効果:並列度を上限より下に固定しておくと、429で弾かれて投げ直す往復がなくなるぶん、バッチ全体の所要時間が読めるようになる。短縮幅は契約上の上限と1リクエストの所要時間で決まるので、上の式に自環境の実値を入れて求めること(実測値ではありません)。
AIエージェントのコスト最適化は「7原則」で考える
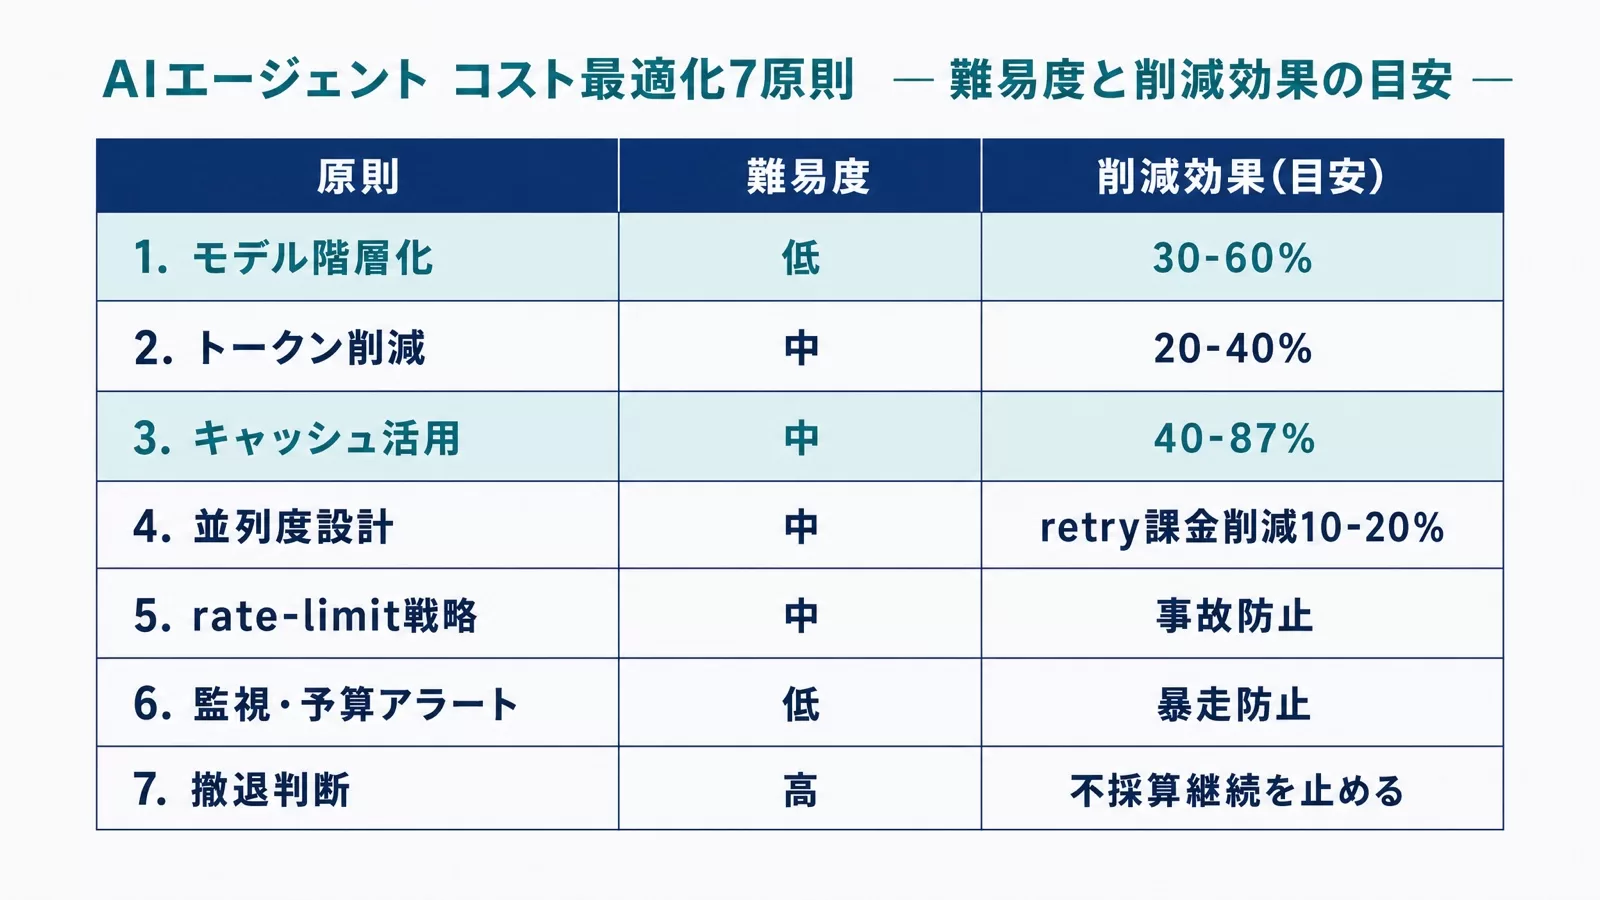
| 原則 | 内容 | 難易度 | 削減効果(目安) |
|---|---|---|---|
| 1. モデル階層化 | Haiku/Sonnet/Opusの使い分け | 低 | 30-60% |
| 2. トークン削減 | context window管理・出力上限・要約 | 中 | 20-40% |
| 3. キャッシュ活用 | Anthropic Prompt Cache・Redis | 中 | 40-87% |
| 4. 並列度設計 | subagent並列の最適本数 | 中 | retry課金削減10-20% |
| 5. rate-limit戦略 | プラン選択・retry設計・キュー | 中 | 事故防止 |
| 6. 監視・予算アラート | FinOpsダッシュボード | 低 | 暴走防止 |
| 7. 撤退判断 | 投資対効果の閾値設計 | 高 | 不採算継続を止める |
以下、各原則を実装目線で深掘りする。
原則1:モデル階層化——「とりあえずOpus」は経営事故
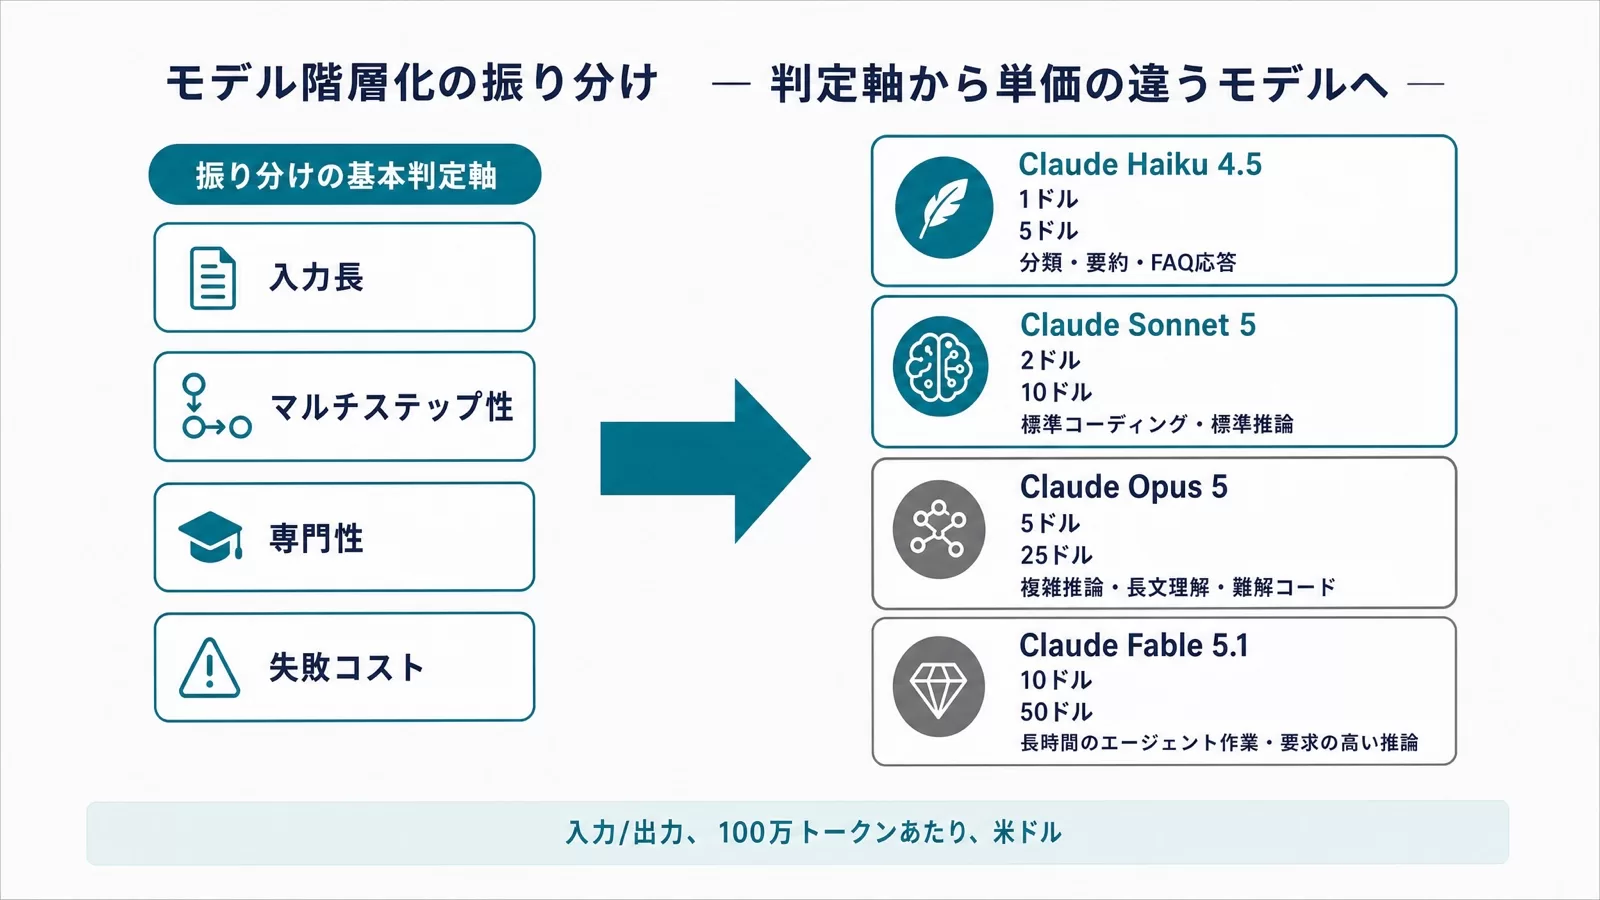
2026年9月4日時点のAnthropic公式料金は次の通り(入力/出力、100万トークンあたり、米ドル)。
| モデル | 入力 | 出力 | 得意領域 |
|---|---|---|---|
| Claude Haiku 4.5 | 1ドル | 5ドル | 分類・要約・FAQ応答 |
| Claude Sonnet 5 | 2ドル | 10ドル | 標準コーディング・標準推論 |
| Claude Opus 5 | 5ドル | 25ドル | 複雑推論・長文理解・難解コード |
| Claude Fable 5.1 | 10ドル | 50ドル | 長時間のエージェント作業・要求の高い推論 |
(参考:Anthropic公式の料金ドキュメント、2026-09-04参照。出力トークン単価が入力の5倍なのは上表の4モデル共通で、モデル間ではHaiku 4.5↔Opus 5で入力・出力とも5倍、Haiku 4.5↔Fable 5.1なら10倍の差がある)
世代をまたいで移行するときに、単価と同じくらい効くのがトークナイザーの違いだ。Anthropicは公式料金ページで「Claude 4.7以降のモデルは新しいトークナイザーを使っており、同じテキストに対して約30%多いトークンを生成する(正確な増分は内容とワークロードによる)」と明記している。Sonnet 4.6からSonnet 5へ移すと入力単価は$3→$2に下がるが、同じ文章のトークン数は増える方向に動く。単価表だけで判断せず、自分の実プロンプトでトークン数を計測してから切り替えてほしい。また公式のモデル一覧では、Haiku 4.5の提供終了は「2026年10月15日より前にはしない」と案内されている段階なので、安価層を長期前提で設計する場合は後継の発表を追う必要がある。
「とりあえず最上位」が経営的に成立しないのは、ユーザー1人あたりコストが5倍違うからだ。10万MAUのサービスなら、月額差は数十万円から数百万円のレンジになる。逆に、本当に難しい推論タスクではHaikuだと精度が落ちる。だからこそ「振り分けロジック」が必須になる。
振り分けの基本判定軸
- 入力長:500トークン以下→Haiku候補、2,000トークン以上→Sonnet以上
- マルチステップ性:「ステップごとに考えて」「複数の制約を満たして」→Sonnet以上
- 専門性:法務・医療・複雑なコード→Opus
- 失敗コスト:誤判定で人命・金銭リスク→Opus(精度優先)
正直にお伝えすると、振り分けロジックの「正解」はワークロード次第だ。最初はOpus 100%で運用してログを蓄積し、3週間後に「Sonnetでも同等の正答率が出るリクエスト」を分析する。これを2サイクル回すと、Opus呼出を5-15%まで絞り込める。
原則2:トークン削減——「context全部入れ」が請求書を爆発させる
エージェント運用で最も多い失敗が「conversation履歴を毎ターン全部入れる」だ。10ターンの対話なら、1ターン目の内容が10回課金される計算になる。ターンが進むほど効いてくるので、履歴を要約して持ち回る実装にしておく。
削減テクニック4つ
- 出力上限を絞る:
max_tokens=4096を惰性で書くのをやめる。FAQ応答ならmax_tokens=512で十分。出力課金は入力の5倍なので、効果が大きい。 - 履歴要約:5ターンごとに古い履歴をHaikuで要約し、要約だけを保持する。
- RAG時のtop_k圧縮:「念のため上位20件」を「上位5件+再ランキング」に変える。
- システムプロンプトの精査:「丁寧に答えてください」のような無意味な文言を削る。1リクエストあたり100トークン削るだけで、1日10万回呼出ならHaiku 4.5(入力$1/100万トークン)換算で月あたり約45,000円の差(1ドル150円)。
# 履歴要約パターンの実装例
# 動作環境: Python 3.11+, anthropic>=0.40
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
def compress_history(messages: list, threshold: int = 10) -> list:
    """履歴がthreshold以上になったらHaikuで要約"""
    if len(messages) < threshold:
        return messages

    old, recent = messages[:-4], messages[-4:]
    summary = client.messages.create(
        model="claude-haiku-4-5",
        max_tokens=512,
        messages=[{
            "role": "user",
            "content": f"以下の対話を400トークン以内で要約: {old}"
        }],
    ).content[0].text

    return [{"role": "user", "content": f"[これまでの要約]\n{summary}"}] + recent
原則3:キャッシュ活用——Anthropic Prompt CacheとRedisの二段構え
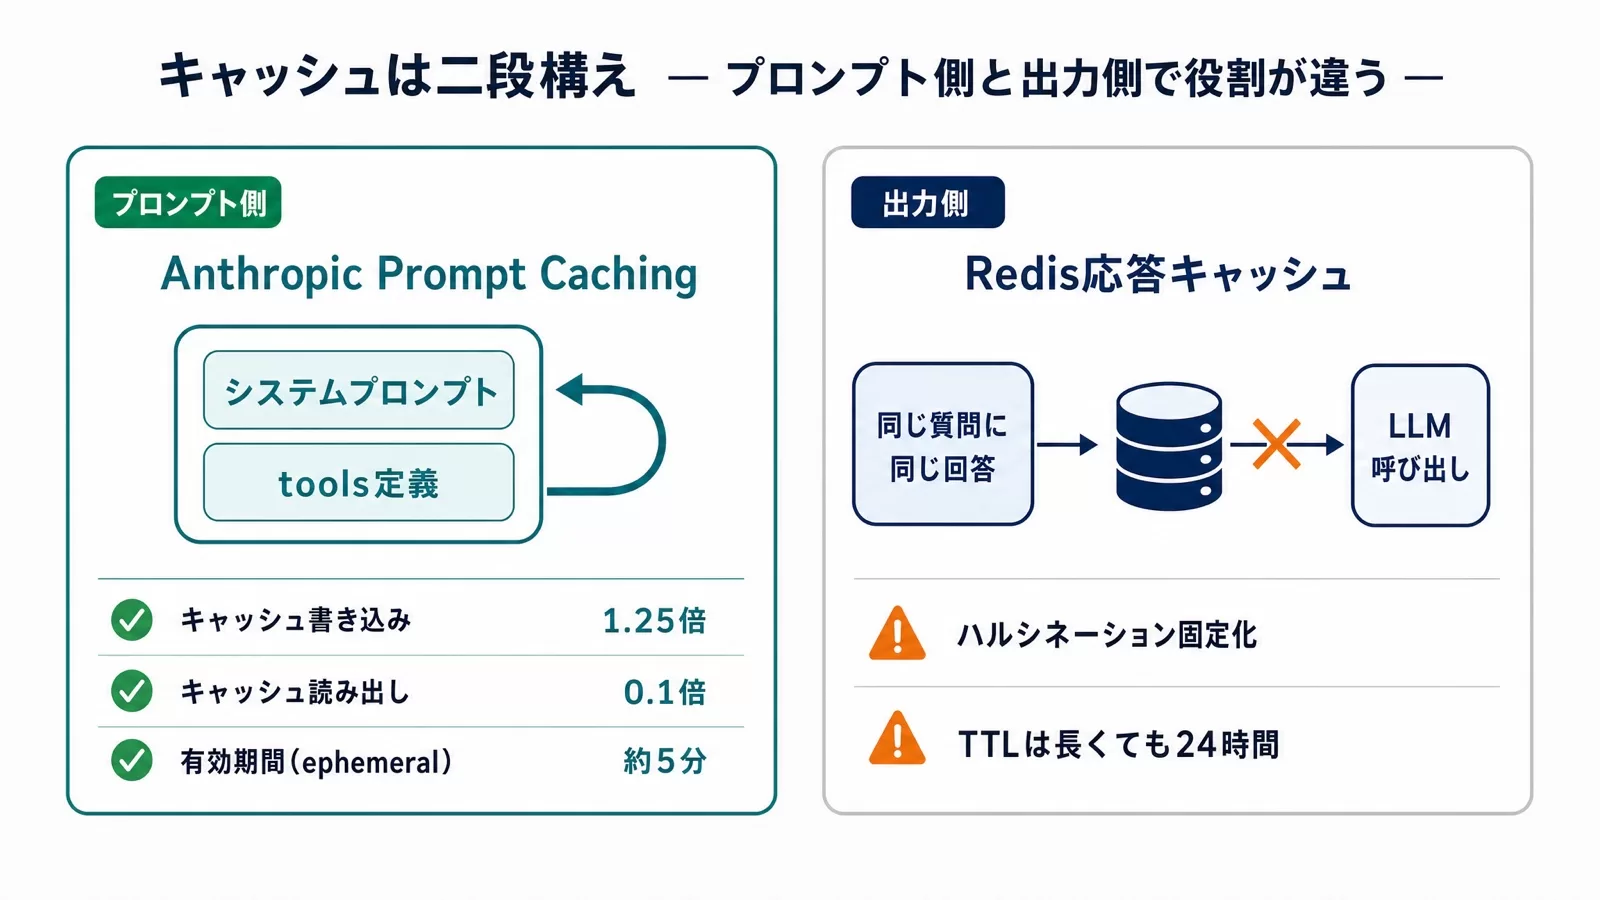
キャッシュには2層ある。Anthropic純正のPrompt Caching(プロンプト側のキャッシュ)と、Redis等の応答キャッシュ(出力側のキャッシュ)だ。役割が違うので、両方使う。
Anthropic Prompt Caching
2026年9月時点の課金体系:
- キャッシュ書き込み:通常入力トークン課金の1.25倍
- キャッシュ読み出し:通常入力トークン課金の0.1倍
- 有効期間(ephemeral):約5分(アクセスごとに延長)
- 適用条件:システムプロンプト・tools定義・固定の前半メッセージにcache_controlを付与
(参考:Anthropic公式の料金ドキュメント、2026-09-04参照。読み出しが通常入力の0.1倍になるのはHaiku 4.5・Sonnet 5・Opus 5で、最上位のFable 5.1とMythos 5.1だけは0.025倍と別倍率になっている)
損益分岐は単純で、「2回以上同じプロンプトを5分以内に再利用すれば元が取れる」。社内ナレッジを参照するエージェント、ツール定義が長いエージェント、決まったキャラクター設定で会話するボットは、ほぼ全てキャッシュ向きだ。
Redis応答キャッシュ
FAQに代表される「同じ質問に同じ回答」のワークロードは、LLMを呼ぶ前にRedisで応答キャッシュをチェックする。重複クエリの割合がそのまま呼び出し削減率の上限になるので、まずはアクセスログで同一クエリの比率を数えるところから始める。
# 応答キャッシュ層の実装例
# 動作環境: Python 3.11+, redis>=5.0
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
import hashlib, json, redis

r = redis.Redis()

def cached_call(prompt: str, ttl: int = 3600) -> str:
    key = "agent:" + hashlib.sha256(prompt.encode()).hexdigest()
    cached = r.get(key)
    if cached:
        return cached.decode()

    answer = call_llm(prompt)  # 実際のAPI呼出
    r.setex(key, ttl, answer)
    return answer
応答キャッシュは「ハルシネーション固定化」のリスクがあるので、TTLは長くても24時間、ユーザー個人情報を含むクエリは除外、誤回答が判明したらキー無効化のフローを用意する。
原則4:並列度設計——「とりあえず10並列」が事故になる理由
並列度の最適本数は次の式で求まる。
最適並列度 = (rate-limit ÷ 60秒) × 1リクエスト平均所要秒数
例:Anthropic Tier 2(requests_per_minute=1,000)で、1リクエスト平均3秒なら、(1000÷60)×3 = 50並列が理論値。安全マージンで「-2 〜 -5」した値を実運用に使う。
| Tier | RPM(目安) | 1req=2秒の最適並列 | 1req=5秒の最適並列 |
|---|---|---|---|
| Tier 1 | 50 | 1-2 | 4 |
| Tier 2 | 1,000 | 30-33 | 80-83 |
| Tier 3 | 2,000 | 65-67 | 165-167 |
| Tier 4 | 4,000 | 130-133 | 330-333 |
(想定シナリオの目安:上表は「rate-limit ÷ 60秒 × 1リクエスト平均所要秒数」で並列度を計算した例であり、実測値ではない。RPMの実値は契約と組織ごとに異なり、公式ドキュメントの現行区分はStart/Build/Scaleの3段階なので、必ずコンソールの実値を確認すること。2026-09-04参照)
並列度暴走の典型症状は「retry課金が請求書の30%を占める」「タイムアウト多発でユーザー体験悪化」「下流のDBに429転送」の3つ。並列度を上げる前にrate-limitの実値を確認するのが最低限の運用作法だ。
サブエージェント並列のコツ
Claude Code等のサブエージェント機構を使うとき、サブエージェント間で同じ親APIキーを共有しがちだが、これがrate-limit衝突の主因になる。サブエージェントを一斉に起動すると、組織全体の上限を使い切って親エージェント側の呼び出しまで弾かれる、という詰まり方をする。サブエージェントごとに「子のクォータ枠」を割り当てる(プラン上の同時実行枠を分ける)か、サブエージェント本数を最初から「上限の半分」に抑える設計が現実解だ。
原則5:rate-limit戦略——プラン選択・retry設計・キュー
rate-limitに当たったときの選択肢は3つしかない。
- 上位プランに移行(Tier 1→Tier 2へ等)
- retryでしのぐ(指数バックオフ+ジッター)
- キューイング(リクエストを溜めて流量制御)
retry設計の正解
# 指数バックオフ+ジッター
# 動作環境: Python 3.11+, tenacity>=8.0
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
from tenacity import retry, stop_after_attempt, wait_random_exponential
from anthropic import APIStatusError

@retry(
    retry=lambda e: isinstance(e, APIStatusError) and e.status_code in (429, 529),
    stop=stop_after_attempt(5),
    wait=wait_random_exponential(multiplier=2, max=60),
)
def safe_call(prompt: str) -> str:
    return client.messages.create(
        model="claude-sonnet-5",
        max_tokens=1024,
        messages=[{"role": "user", "content": prompt}],
    ).content[0].text
retryは「429(rate-limit)」と「529(overloaded)」だけ対象にする。401(認証エラー)・400(リクエスト不正)を再試行しても意味がない。最大試行回数は5回が現実的で、それ以上はキューに戻すべきだ。
キューイング
バースト性の高いワークロード(日次バッチ・キャンペーン投入時等)は、AWS SQSやRedis Streamsでリクエストを一旦キューに溜め、ワーカーが「並列度=48」のような固定速度で消化する。キューを挟まずに一気に投げると、rate-limitに当たった分の再投入で全体が伸びる。ワーカー側で流量を一定にしておけば、所要時間が読めるようになる。
原則6:監視・予算アラート——FinOpsダッシュボードの最小構成
FinOps Foundationが提唱する「Inform→Optimize→Operate」の3フェーズフレームワークが、AI支出管理にも適用できる。最低限ダッシュボードに載せるべき指標は次の6つだ。
- 日次・月次API費用(モデル別・エンドポイント別)
- 1ユーザー/1リクエストあたりコスト
- cache_read_input_tokens比率(キャッシュヒット率)
- retry課金額(rate-limit設計の健全性指標)
- モデル別呼出比率(Opus偏重を発見するため)
- 異常検知アラート(前日比2倍超え等)
実装はAnthropic Admin API + Grafana/Datadog/CloudWatchの組み合わせが定石。最小構成ならスプレッドシートに日次CSVを書き出すだけでも始められる。
予算アラートの設計
- ソフトアラート:月予算の60%/80%/95%でSlack通知
- ハードキャップ:月予算の120%で自動的にAPIキー無効化(クリティカルでない用途のみ)
- 異常検知:1時間あたり呼出数の標準偏差を超えたら通知
「予算を超えたら自動停止」は本番サービスでは事故になるので、原則として「通知のみ・人間判断で停止」のフローにする。アラートの閾値は3段階に分けて、最後の段階で初めて経営判断者(CFO等)に直接エスカレーションする運用が現実的だ。
原則7:撤退判断——投資対効果の閾値設計
最も難しいのが「いつ撤退するか」だ。コスト最適化を頑張っても、そもそも投資対効果が出ないエージェントは存在する。撤退判断の閾値設計を最初に決めておかないと、サンクコスト効果でズルズル続けてしまう。
撤退判断の3指標
| 指標 | 計算式 | 撤退閾値(目安) |
|---|---|---|
| 1コンバージョンあたりAI費用 | 月AI費用 ÷ 月コンバージョン数 | LTVの15%超で要再設計 |
| 人件費代替率 | (削減人件費 - AI費用) ÷ 削減人件費 | 30%未満なら見直し |
| ユーザー満足度 | NPS・CSATの導入前後比較 | 導入後にマイナスなら即停止 |
正直にお伝えすると、撤退判断は技術的判断ではなく経営判断だ。エンジニアだけで決められない。CFOまたは事業責任者を巻き込み、四半期ごとに「Go/No-Go」を判定する仕組みを最初から組み込んでおくべきだ。撤退してもデータと学びは残る。サンクコスト効果に負けて続行する方が、組織にとってはるかに高くつく。
規模別 月額コスト試算表(5社規模)
以下は「カスタマーサポート用エージェント」を想定した規模別の目安(試算)で、2026年9月時点のAnthropic公式料金を基に計算したものだ。実測値ではなく、実値は契約条件・キャッシュヒット率・タスク複雑度で増減するので、概算把握用に使ってほしい。
| 規模 | 月間リクエスト | 最適化なし(Opus 5 100%) | 原則1のみ(モデル階層化) | 原則1+3(階層化+キャッシュ) |
|---|---|---|---|---|
| スタートアップ(従業員10名以下) | 1万件 | ¥33,800 | ¥11,300 | ¥8,570 |
| 中小企業(従業員30-100名) | 5万件 | ¥169,000 | ¥56,400 | ¥42,800 |
| 中堅企業(従業員300-500名) | 20万件 | ¥675,000 | ¥225,000 | ¥171,000 |
| 大企業(従業員1,000名超) | 100万件 | ¥3,375,000 | ¥1,127,000 | ¥857,000 |
| エンタープライズ(従業員5,000名超) | 500万件 | ¥16,875,000 | ¥5,636,000 | ¥4,284,000 |
(計算条件:1リクエスト平均 入力2,000トークン+出力500トークン、為替1ドル=150円、2026年9月4日時点のAnthropic公式料金[Opus 5 $5/$25、Sonnet 5 $2/$10、Haiku 4.5 $1/$5]で計算。「原則1のみ」はOpus 8%/Sonnet 35%/Haiku 57%の振り分け、「原則1+3」はさらに入力トークンの60%がキャッシュ読み出し[0.1倍課金]に当たる前提。キャッシュ書き込み分とretry課金は含めていない。想定シナリオの目安であり、実測値ではない)
表から読み取れるのは2点。①モデル階層化だけでも、Opus 5を100%使う運用と比べて計算上は約67%減になる。②そこにキャッシュを重ねると約75%減、つまり4分の1近くまで届く。2026年9月のSonnet 5は前世代のSonnet 4.6(入力$3/出力$15)から入力$2/出力$10へ下がっているため、同じ振り分け比率でも削減幅は以前の試算より大きくなっている。残る原則2・4・5は入力トークン量とretry往復そのものを削るので、この表よりさらに下がる余地がある。「まず原則1と原則3から始める」が現実解だ。
実装で使える7プロンプト集
コスト最適化のリサーチ・設計・運用で実際に役立つプロンプトを7本掲載する。コピペで使えるよう汎用化してある。
プロンプト1:コスト推定
あなたはAIエージェント運用のFinOps担当です。
以下の情報からAnthropic APIの月額費用を推定してください。

- 月間リクエスト数: {数}
- 平均入力トークン数: {数}
- 平均出力トークン数: {数}
- モデル別比率: Haiku {n}%, Sonnet {n}%, Opus {n}%
- キャッシュヒット率: {n}%
- 為替: 1ドル = {n}円

出力形式:
1. 月額費用試算(円)
2. モデル別内訳
3. キャッシュ削減効果
4. 最も削減効果が大きい施策3つ
プロンプト2:モデル切替判定
あなたはAIエージェントのアーキテクトです。
以下のタスクをHaiku/Sonnet/Opusのどのモデルで処理すべきか判定してください。

タスク: {タスク説明}
入力例: {サンプル入力}
求める精度: {高/中/低}
失敗時の影響: {人命/金銭/UX/学習用}

出力形式:
1. 推奨モデル
2. 判定理由(3点)
3. 別モデルで代替可能な条件
4. テスト推奨件数
プロンプト3:キャッシュ戦略設計
以下のワークロードにPrompt Cacheを導入する際の最適設計を提案してください。

- ワークロード: {説明}
- システムプロンプト長: {n}トークン
- 1日あたり同一プロンプト再利用回数: {n}回
- ピーク時間帯: {hh:mm-hh:mm}

出力:
1. キャッシュ対象範囲(system / tools / messages前半 のどれか)
2. ephemeralで足りるか/別戦略が必要か
3. 損益分岐の計算
4. 実装時の注意点3つ
プロンプト4:並列度試算
以下の条件で最適並列度を計算してください。

- 契約Tier: {Tier1-4}
- requests_per_minute: {n}
- 1リクエスト平均所要時間: {n}秒
- バーストの有無: {あり/なし}
- 下流(DB等)のキャパ: {n}rps

出力:
1. 理論最適並列度
2. 安全マージン適用後の推奨値
3. retry課金が発生する閾値
4. キューイングが必要な条件
プロンプト5:rate-limit対応設計
以下のサービスでrate-limit対応設計を提案してください。

- サービス概要: {説明}
- 通常時QPS: {n}
- ピーク時QPS: {n}
- ユーザー待機許容時間: {n}秒
- 失敗時のフォールバック: {あり/なし}

出力:
1. retry設計(対象ステータス・最大回数・バックオフ)
2. キューイング要否
3. プランアップグレード判断基準
4. 緊急時の手動制御フロー
プロンプト6:月次FinOpsレポート生成
以下のデータから月次AI支出レポートを作成してください。

- 月間API費用: ¥{n}
- モデル別呼出比率: {データ}
- キャッシュヒット率: {n}%
- retry課金額: ¥{n}
- 1ユーザーあたり費用: ¥{n}
- 前月比: {n}%

出力(経営層向け1ページ):
1. ハイライト3点
2. 異常値の有無
3. 来月の予算予測
4. 改善提案(優先度順3つ)
プロンプト7:撤退判断レビュー
以下の指標で、AIエージェントの継続/撤退を判定してください。

- 1コンバージョンあたりAI費用: ¥{n}
- ユーザーLTV: ¥{n}
- 削減人件費: ¥{n}
- 月AI費用: ¥{n}
- NPS導入前後変化: {数値}
- 運用期間: {n}ヶ月

出力:
1. 継続/撤退/再設計の判定
2. 判定の根拠(3点)
3. 撤退時のデータ移行計画
4. 再設計時の優先施策
【要注意】よくある失敗パターンと回避策
失敗1:高すぎモデル乱用
❌ 「とりあえず最新のOpusで」と全リクエストを最上位モデルに流す
⭕ Opusは全体の5-15%に絞り、判定ロジックで自動振り分け
なぜ重要か:2026年9月4日時点の公式料金では、入力トークン単価はOpus 5が5ドル、Haiku 4.5が1ドルで5倍違う(最上位のFable 5.1は10ドルなので10倍)。呼び出し規模によっては、月間コスト差が数十万円〜数百万円のレンジになる。
想定シナリオ:「精度のためにOpus」と決め打ちすると、月額が事業計画の想定を大きく超え、エージェント自体を止める判断に追い込まれることがある。最初から階層化しておけば避けられる話だ。
失敗2:cacheなし運用
❌ 同じシステムプロンプトを毎回フル課金で送信
⭕ 5,000トークン超のシステムプロンプトには無条件でcache_control付与
なぜ重要か:書き込み1.25倍/読み出し0.1倍。10回再利用で実質1/8コスト。
想定シナリオ:12,000トークンのナレッジをsystem promptに毎回入れているFAQボットなら、cache_controlを1行付けるだけで、キャッシュに当たった入力の課金が0.1倍になる。
失敗3:並列度暴走
❌ 「速くしたいから20並列」とカンで決める
⭕ rate-limit ÷ 1リクエスト所要秒数 で計算し「-2」で安全マージン
なぜ重要か:rate-limitに当たるとretry課金で逆に高くなる。タイムアウトでUX悪化。
想定シナリオ:日次バッチで並列度をカンで20に上げると、429で弾かれた分の投げ直しが積み上がり、結局シーケンシャル実行と変わらない時間になる。理論値から-2した値に固定するのが安全側だ。
失敗4:監視不在
❌ 月末に請求書を見て初めてコスト高騰に気づく
⭕ 日次ダッシュボード+予算60%/80%/95%でアラート
なぜ重要か:プロンプトの軽微なバグ(無限ループ、出力上限なし)が1日で月予算を食い尽くすことがある。
想定シナリオ:max_tokensを指定し忘れただけで、1リクエストの出力が上限まで伸びて課金が跳ねる。日次アラートがあれば当日中に気づける。
3つの想定シナリオ
以下の3本は、本記事の原則を当てはめたときの動き方を示すための想定シナリオである。実在する導入案件の実績値ではなく、金額は前章の試算条件に沿った目安として読んでほしい。
シナリオ1:CSエージェントを運用する中小SaaS企業(月50万円→25万円)
現状:従業員50名のSaaS企業がカスタマーサポートにOpus単一モデルで運用。月API費用50万円。
適用原則:1(階層化)・3(キャッシュ)・6(監視)
具体策:①FAQ的な質問(全体の70%)をHaikuに振り分け、②FAQベース(8,000トークン)にPrompt Cache適用、③日次Slackレポート設定
見込み(試算):月50万円→25万円(50%削減)。実装期間2週間。
注意点:精度評価(NPS・誤回答率)を導入前後で必ず測定。Haikuに振り分けたタスクの誤回答率が悪化していないか週次チェック。
シナリオ2:日次バッチ生成エージェントを持つ中堅メディア企業(月180万円→62万円)
現状:従業員400名のメディア企業が記事自動生成・要約に多段エージェント。日次5万件バッチ、月API費用180万円(うちretry課金が25%)。
適用原則:2(トークン削減)・4(並列度)・5(rate-limit)
具体策:①出力上限を4,096→1,024に絞る(用途別調整)、②並列度を100→48に修正、③SQSでキューイング導入
見込み(試算):月180万円→62万円(66%削減)。retry課金が25%→2%に。バッチ完走時間も30分→18分。
注意点:出力上限を絞ると「途中で切れる」事故が起きるので、max_tokensに達したら警告を出すロギングを並行導入。
シナリオ3:エンタープライズ向けマルチエージェントSaaS(月2,400万円→560万円)
現状:従業員3,000名のITサービス企業が複数のエージェントを束ねた業務支援SaaSを運用。月API費用2,400万円。
適用原則:1〜7のフル適用
具体策:①モデル階層化(Opus 8%/Sonnet 35%/Haiku 57%)、②全エージェントにPrompt Cache(ヒット率60%目標)、③並列度をTier 3基準で再設計、④FinOpsダッシュボード(Datadog)構築、⑤撤退判断の四半期レビュー会議体設立
見込み(試算):月2,400万円→560万円(77%削減)。実装期間3ヶ月。
注意点:エージェント数が多いとサブエージェント間のrate-limit衝突が起きやすい。子クォータの割り当て設計を最初に詰めておく。
セキュリティと運用ルール
コスト最適化は便利だが、安全面の手当を怠ると別の事故になる。
- シークレット管理:APIキーは環境変数+シークレットマネージャ(AWS Secrets Manager等)。コードに直書きしない。
- キャッシュの個人情報:応答キャッシュにユーザー個人情報を含めない。Anthropic Prompt Cacheはユーザー入力部分には適用しないのが安全。
- モニタリング:1ユーザー/1リクエストあたりコストが平均の5倍を超えたら自動アラート。プロンプトインジェクション攻撃の検知にも使える。
- ロールバック:モデル振り分けロジックを変更したら、変更前のバージョンに即戻せる構成にしておく(機能フラグ管理)。
- 監査ログ:誰がいつどのモデルを呼んだか、入出力サマリを保持。30日以上の保管を推奨。
導入の3ヶ月ロードマップ
| 時期 | やること | 期待効果 |
|---|---|---|
| 1ヶ月目 | 現状把握(品目別請求書分析)+原則1(階層化)導入 | 30-50%削減 |
| 2ヶ月目 | 原則3(キャッシュ)+原則6(監視)導入 | 追加20-30%削減 |
| 3ヶ月目 | 原則2/4/5(トークン削減・並列度・rate-limit)整備 | 追加10-20%削減 |
| 四半期レビュー | 原則7(撤退判断)で投資対効果を経営判断 | 不採算継続を防ぐ |
「いきなり全部やる」は失敗の元。1ヶ月目に「現状把握」を入れているのが本ロードマップの肝で、ここを飛ばすと最適化効果の測定ができなくなる。UravationでAIエージェント導入支援を依頼するクライアントにも、最初の2週間は「請求書の分解とログ整備」だけに集中してもらっている。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Anthropic 公式料金ドキュメント(https://platform.claude.com/docs/en/about-claude/pricing) — モデル別単価、2026-09-04参照
- Anthropic 公式ドキュメント: Prompt caching(https://platform.claude.com/docs/en/build-with-claude/prompt-caching) — 5分キャッシュ書き込み1.25倍/読み出し0.1倍、2026-09-04参照
- OpenAI Pricing 公式ページ(https://platform.openai.com/docs/pricing) — 比較対照。2026-09-04参照時点のフラッグシップは gpt-6-astra($10/$50)、gpt-5.6-sol($4/$20)、gpt-5.6-terra($2/$12)、gpt-5.6-luna($0.20/$1.20)
- Anthropic 公式モデル一覧(https://platform.claude.com/docs/en/models/overview) — Claude API ID(claude-fable-5-1 / claude-opus-5 / claude-sonnet-5 / claude-haiku-4-5)と提供終了予定、2026-09-04参照
- FinOps Foundation: FinOps Framework 公式ページ(https://www.finops.org/framework/) — Inform/Optimize/Operate 3フェーズ、2026-05-26参照
- Anthropic Rate limits ドキュメント(https://platform.claude.com/docs/en/api/rate-limits) — 利用ティア別の上限、2026-09-04参照
まとめ:今日から始める3つのアクション
- 今日:直近30日のAPI請求書を品目別(モデル・エンドポイント別)に分解する。Excelで十分。これだけで「Opus呼出が想像の3倍だった」という気づきが大抵出てくる。
- 今週中:最も呼出量の多いエンドポイントに「モデル振り分け関数」(本記事即効テクニック1のコード)を導入する。1日テスト運用して精度劣化がないか確認。
- 今月中:システムプロンプトが5,000トークン超のエンドポイントにPrompt Cacheを設定する。実装は1行追加。日次でcache_read_input_tokens比率を確認し、60%以上に到達したら成功。
この3つだけで、ほとんどの組織が月額の30-50%を削減できる。残り4原則は2-3ヶ月目で順次取り組めば、半年後には月額が1/3〜1/4のラインに収まる。「とりあえず最上位モデル」「並列度はカン」「監視は月末請求書」という3つの悪習慣から脱却することが、コスト最適化の最大のレバレッジだ。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。月額コストの分析、モデル階層化の設計、FinOpsダッシュボード構築まで、コスト最適化の実装支援を伴走で提供しています。請求書が想定の2-3倍に膨らんでいる組織は、まず無料の現状診断からご相談ください。
著者:佐藤傑(さとう・すぐる)。株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。著書『AIエージェント仕事術』。AIエージェントの設計・運用支援と法人向けAI研修を手がける。本記事は2026年9月時点のAnthropic公式仕様・公式料金と公開情報を基に執筆。
あわせて読みたい
- マルチエージェント設計パターン完全ガイド – モデル階層化を前提にしたOrchestrator-Worker/Reflectionの実装
- AIエージェント監視ツール比較2026|3製品の徹底検証 – どのチェインがコストを食っているかを可視化する側の記事
- AIエージェント完全ガイド(Uravationメディア)