結論:2026年9月4日時点のLangGraph最新安定版はPython 1.2.11(2026年8月11日 PyPI公開)、TypeScript版は@langchain/langgraph 1.4.13(2026年8月26日公開)。v1.0で確定したStateGraphのコアAPIは今も無変更のまま、v1.1で型付きストリーミング、v1.2でノード単位のタイムアウト・エラーハンドラ・DeltaChannel・イベントストリーミングv3が積み増されました。
対象読者:LangGraphでエージェントを組む、または既存グラフを1.2系へ上げる開発者・アーキテクト。
この記事の要点:
- StateGraphの基本(State・ノード・エッジ・条件分岐・Command・Send)を、そのまま動くコードで押さえる
- checkpointer(スレッド内の短期記憶)とstore(スレッド横断の長期記憶)を混同しない
- human-in-the-loopは
interrupt()+Command(resume=...)。ノード引数のinterrupt_beforeではない - v1.2で入った
TimeoutPolicy・error_handler・graceful shutdownが、長時間エージェントの落ち方を変えた - 「LangGraph Platform」「LangGraph Studio」という名前はもう公式ドキュメントに無い(LangSmith Deployment / LangSmith Studio)
今日やること:pip install -U langgraph で1.2系に上げ、graph.invoke() の戻り値を result["key"] で読んでいる箇所を洗い出す(1.1以降で非推奨、3.0で削除予定)。
日本語の解説記事は「v1.0が出ました」で止まっているものが大半ですが、v1.0(2025年10月17日)から10か月以上が経ち、マイナーリリース2回とパッチ20回以上が重なっています。その間に公式ドキュメント側で製品名そのものが変わりました。この記事は2026年9月3日時点の公式ドキュメント・GitHub Releases・PyPI/npmレジストリを1件ずつ突き合わせ、「今のLangGraphはこう書く」だけを残したものです。バージョンと日付はすべて一次情報から取っています。
LangGraphの現在地|1.0から1.2.11までを整理する
前提の共有から。LangGraphは公式ドキュメントの言葉で「低レベルのオーケストレーションフレームワークかつランタイム」、つまりエージェントの並べ方だけを担当するライブラリです。モデルやツールの抽象化はLangChain側の仕事で、LangGraph単体でも動きます。
リリース年表(一次情報ベース)
| バージョン | 公開日(PyPI) | 中身 |
|---|---|---|
| 1.0.0 | 2025-10-17 | 安定化リリース。グラフのプリミティブと実行モデルは据え置き、型安全性とドキュメントの整備が主眼。create_react_agentを非推奨化 |
| 1.1.0 | 2026-03-10 | version="v2"の型安全なstream()/invoke()。GraphOutput導入、辞書アクセスを非推奨化 |
| 1.2.0 | 2026-05-12 | DeltaChannel(beta)、ノード単位タイムアウト、ノードレベルのエラーハンドラ、graceful shutdown、イベントストリーミングv3、set_node_defaults() |
| 1.2.11 | 2026-08-11 | 2026年9月3日時点の最新安定版 |
押さえておきたいのはv1.0が「機能追加リリース」ではなかったことです。公式のv1リリースノートは「グラフのプリミティブ(state・ノード・エッジ)と実行/ランタイムモデルは変更されていない」と明言しています。よくある「v1.0で永続化がビルトインになった」という説明は不正確で、永続化はv1以前からfirst-classでした。実際に機能が増えたのはv1.1とv1.2、特にv1.2は「長時間走るエージェントをどう安全に止めて再開するか」に集中しています。
パッケージ構成と依存関係(1.2.11時点)
LangGraphは責務ごとに分割された複数パッケージの集合です。pip install langgraph で入るのはコア部分だけで、PostgreSQLやSQLiteのcheckpointerは別途入れます。
| パッケージ | 最新版(2026-09-03) | 役割 |
|---|---|---|
langgraph |
1.2.11 | 本体。Python 3.10以上 |
langgraph-checkpoint |
4.2.0 | checkpointerの基底インターフェースとInMemorySaver。本体に同梱 |
langgraph-checkpoint-postgres |
3.1.2 | 本番用。PostgresSaver / AsyncPostgresSaver。別途インストール |
langgraph-checkpoint-sqlite |
3.1.1 | ローカル検証用。SqliteSaver / AsyncSqliteSaver |
langgraph-prebuilt |
1.1.0 | ToolNodeなどの高水準API。廃止されていない |
langgraph-cli |
0.4.31 | langgraph dev 等のローカル開発サーバー。Python 3.11以上 |
langgraph-sdk |
0.4.4 | デプロイ済みグラフを叩くクライアント |
@langchain/langgraph |
1.4.13 | TypeScript版。バージョン体系はPython版と独立 |
依存の向きも確認しておくと事故が減ります。langgraph 1.2.11 は langchain-core の1.4.7以上2.0未満を、逆に langchain 1.3.18(2026年8月27日公開)は langgraph の1.2.11以上1.3未満を要求します。つまりLangChainを最新にするとLangGraphも1.2.11以上へ引き上げられる関係で、「LangChainだけ上げたつもりが挙動が変わった」はこれが原因です。
# インストール(Python)
pip install -U langgraph

# 本番でPostgresをcheckpointerに使うなら
pip install -U langgraph-checkpoint-postgres

# ローカル開発サーバー(Python 3.11以上が必要)
pip install --upgrade "langgraph-cli[inmem]"

# TypeScript
npm install @langchain/langgraph @langchain/core
本番採用企業は公式のケーススタディで確認する
採用事例は日本語記事で用途の記述が不正確なことがあります。2026年9月時点の公式ケーススタディ一覧ではUber=開発者生産性とコード生成、LinkedIn=コード生成と検索・ディスカバリ(Text-to-SQL)、Klarna/J.P. Morgan=業務特化のコパイロットと整理されています(ほかにReplit、Vodafone、Rakuten、Cisco、Elastic、AppFolioなど)。公式トップの表記も「Klarna、Uber、J.P. Morgan をはじめとする企業に信頼されている」へ変わり、v1.0のGA告知にあった3社から並びが動いています。
StateGraphの基本|5分で動く最小構成から
構成要素は4つだけです。State(共有する状態)、ノード(状態を受け取り更新を返す関数)、エッジ(次にどこへ行くかの配線)、compile(配線チェックとランタイム化)。残りは全部オプションです。
最小構成:LangChainなしで動くグラフ
公式のhello worldはLLMを一切呼ばずにグラフの挙動だけを確認できます。エージェントを組む前に、まずこれが動く状態を作ってください。
from langgraph.graph import StateGraph, MessagesState, START, END

def mock_llm(state: MessagesState):
    return {"messages": [{"role": "ai", "content": "hello world"}]}

graph = StateGraph(MessagesState)
graph.add_node(mock_llm)
graph.add_edge(START, "mock_llm")
graph.add_edge("mock_llm", END)
graph = graph.compile()

graph.invoke({"messages": [{"role": "user", "content": "hi!"}]})
ポイントは3つです。
add_node(mock_llm)のように関数だけを渡すと、関数名がノード名になります。だから次の行で"mock_llm"という文字列で参照できますSTARTとENDは仮想ノードです。langgraph.graphからインポートしますcompile()を呼ばないとグラフは使えません。公式ドキュメントも「MUST compile」と強調しています
実際のモデルをつなぐ最小差分(2026年9月4日時点の現行ID)
上のhello worldはmock_llmのままなので、次は関数の中身だけを本物のモデル呼び出しに差し替えます。LangGraph自体はモデルを抽象化しないので、モデルの初期化はLangChain側のinit_chat_modelを使うのが公式ドキュメントの標準ルートです。
# pip install -U "langchain[openai]"
import os
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START, END

os.environ["OPENAI_API_KEY"] = "sk-..."

# プロバイダ接頭辞つきのIDで初期化する
model = init_chat_model("openai:gpt-5.6-luna")

def call_model(state: MessagesState):
    return {"messages": [model.invoke(state["messages"])]}

graph = StateGraph(MessagesState)
graph.add_node(call_model)
graph.add_edge(START, "call_model")
graph.add_edge("call_model", END)
graph = graph.compile()
モデルIDは各社の世代交代が速いので、記事や書籍の値をそのまま貼らず、必ず公式ページで現行IDを確認してください。2026年9月4日時点で各社の公式ページに載っている現行の代表IDは次のとおりです。
- OpenAI:
openai:gpt-5.6-luna(最安クラス。標準料金は1Mトークンあたり入力$0.20 / 出力$1.20)、openai:gpt-5.6-terra(汎用の中位。入力$2.00 / 出力$12.00)、openai:gpt-6-astra(フラッグシップ)。旧世代のgpt-4o-2024-05-13は公式Deprecationsで2026年10月23日停止と告知済みです - Anthropic:
anthropic:claude-sonnet-5(コンテキスト100万トークン)。claude-3-5-sonnet-20241022など3系はすでにRetired扱いで、リクエストは失敗します - Google:
google_genai:gemini-3.8-flash(テキスト・画像・動画・音声・PDF入力、入力上限1,048,576トークン)
ノードの中でモデルを呼ぶだけなら、この差分だけでhello worldが実際のエージェントになります。リトライやタイムアウトは後段の「障害対策」で足せるので、まずはこの形で1往復させてから設計を足していくのが手戻りが少ないです。
Stateとリデューサ:更新をどう合成するか
StateのスキーマはTypedDict、Pydanticモデル、dataclassのいずれかで書けます。ノードが返した辞書はキーごとにリデューサで既存の値と合成され、既定は「上書き」です。よく詰まるのは並列ノードが同じキーに書き込むケースで、既定のままだと同一スーパーステップ内の並行更新としてエラーになります。累積したいキーには明示的にリデューサを付けます。
from typing import Annotated, NotRequired
from typing_extensions import TypedDict
import operator

class State(TypedDict):
    # 上書き(既定)
    current_step: str
    # 追記(並列ノードから安全に書ける)
    logs: Annotated[list[str], operator.add]
    # 後から足したキーはNotRequiredにする(後述の互換性のため)
    summary: NotRequired[str]
NotRequired を付けるのは保存済みチェックポイントが新しいスキーマを満たさなくなるのを防ぐためです(詳細は後述の互換性の節)。運用中にStateへキーを足すときは原則 NotRequired か Optional[...] = None にします。
MessagesState:会話履歴の定番
会話メッセージのリストは頻出なので、langgraph.graph に MessagesState というprebuiltのStateが用意されています。messages という単一キーを持ち、add_messages リデューサが設定済みです。実務ではこれを継承して自分のフィールドを足す形が一般的です。
from langgraph.graph import MessagesState

class State(MessagesState):
    documents: list[str]
    retry_count: int
なお、クラス名は MessagesState(複数形のs付き)です。MessageState という単数形のクラスは存在しません。日本語記事で単数形の表記を見かけますが、そのままコピーするとImportErrorになります。
TypeScriptで書く場合
TypeScript版はStateの定義方法がPython版と大きく違います。1.4系では StateSchema クラスにZodスキーマと特殊な値型を渡す形です。旧来のAnnotation.Rootベースの記事とは書き方が変わっているので注意してください。
import {
  StateSchema,
  ReducedValue,
  MessagesValue,
  UntrackedValue,
  StateGraph,
  START,
  END,
} from "@langchain/langgraph";
import { z } from "zod/v4";

const AgentState = new StateSchema({
  messages: MessagesValue,
  currentStep: z.string(),
  retryCount: z.number().default(0),
  allSteps: new ReducedValue(
    z.array(z.string()).default(() => []),
    {
      inputSchema: z.string(),
      reducer: (current, newStep) => [...current, newStep],
    }
  ),
  // チェックポイントに保存しない一時領域
  tempCache: new UntrackedValue(z.record(z.string(), z.unknown())),
});

const graph = new StateGraph(AgentState)
  .addNode("myNode", async (state) => ({ currentStep: "done" }))
  .addEdge(START, "myNode")
  .addEdge("myNode", END)
  .compile();
UntrackedValue は「Stateには置きたいがチェックポイントには残したくない」一時データ用です(DBコネクションなどシリアライズすべきでない値)。Python側にも同等の「Untracked values」がGraph APIドキュメントに記載されています。
制御フロー|条件分岐・ループ・Command・Send
LangGraphを選ぶ理由の大半はここです。直線的なパイプラインで足りるならLangChainで十分で、ループ・条件分岐・再試行・動的ルーティングが要る瞬間にLangGraphの出番になります。
条件付きエッジ
ルーティング関数はStateを受け取って「次のノード名」を返します。戻り値をそのままノード名として使うか、辞書でマッピングするかを選べます。
from langgraph.graph import END

def route_after_write(state: State) -> str:
    if state["retry_count"] >= 3:
        return "give_up"
    if state["current_step"] == "needs_review":
        return "review"
    return "finish"

graph.add_conditional_edges(
    "write",
    route_after_write,
    {"review": "review_node", "give_up": "fallback_node", "finish": END},
)公式ドキュメントには明確な警告があります。1つのノードから「通常エッジ」と「条件付きエッジ/Commandによる動的ルーティング」を混ぜてはいけません。両方の経路が実行されうるため、挙動の追跡が一気に難しくなります。ノード単位でどちらか一方に統一してください。
Command:状態更新とルーティングを1関数にまとめる
Command は「Stateを更新しつつ次のノードも指定する」プリミティブです。ルーティング関数を別に用意せずに済むので、ノード数が増えたグラフでは可読性が上がります。
from typing import Literal
from langgraph.types import Command

def triage(state: State) -> Command[Literal["urgent", "normal"]]:
    if state["priority"] > 8:
        return Command(
            update={"current_step": "escalated"},
            goto="urgent",
        )
    return Command(update={"current_step": "queued"}, goto="normal")

# CommandでルーティングするノードはaddしただけでOK(エッジを引かない)
builder.add_node("triage", triage)
builder.add_node("urgent", handle_urgent)
builder.add_node("normal", handle_normal)パラメータは4つ(update / goto / graph / resume)。graph はサブグラフから親のノードへ飛ぶとき、resume はinterrupt再開専用です。ここに罠が1つあり、公式はCommand(resume=...) だけが invoke() / stream() への入力として想定されたパターンだと明記しています。マルチターン会話の継続に Command(update=...) を入力として渡すのは誤用で、素の辞書を渡すのが正解です。
Send:件数が実行時まで分からないmap-reduce
「LLMが返したリストの各要素に同じノードを走らせたい」ときは Send です。エッジの本数が実行時まで決まらず、かつ下流に渡すStateを要素ごとに変えたいケース向けのAPIです。
from langgraph.types import Send

def fan_out_sections(state: OverallState):
    # sectionsの件数はLLMの出力次第で毎回変わる
    return [Send("write_section", {"section": s}) for s in state["sections"]]

graph.add_conditional_edges("plan", fan_out_sections)
受け側の write_section は親のStateではなく Send の第2引数の辞書を受け取ります。結果の集約には、親State側の集約先キーに operator.add のようなリデューサを付けます。オーケストレータ・ワーカー型はこの組み合わせで組むのが定石です。
ノードキャッシュ:同じ入力なら計算しない
高コストなノードは、入力ハッシュでキャッシュできます。compile(cache=...) でキャッシュ実体を、add_node(..., cache_policy=...) でTTLを指定します。
import time
from langgraph.cache.memory import InMemoryCache
from langgraph.types import CachePolicy

def expensive_node(state: State) -> dict:
    time.sleep(2)
    return {"result": state["x"] * 2}

builder.add_node("expensive_node", expensive_node, cache_policy=CachePolicy(ttl=3))
graph = builder.compile(cache=InMemoryCache())

print(graph.invoke({"x": 5}, stream_mode="updates"))
# 1回目: [{'expensive_node': {'result': 10}}]
print(graph.invoke({"x": 5}, stream_mode="updates"))
# 2回目: [{'expensive_node': {'result': 10}, '__metadata__': {'cached': True}}]
key_func 未指定時のキャッシュキーは入力のpickleハッシュです。Stateに毎回変わる値(タイムスタンプなど)が混ざっているとキャッシュが一切効かないので、その場合は key_func で対象フィールドを絞ります。
永続化|checkpointerとstoreを混同しない
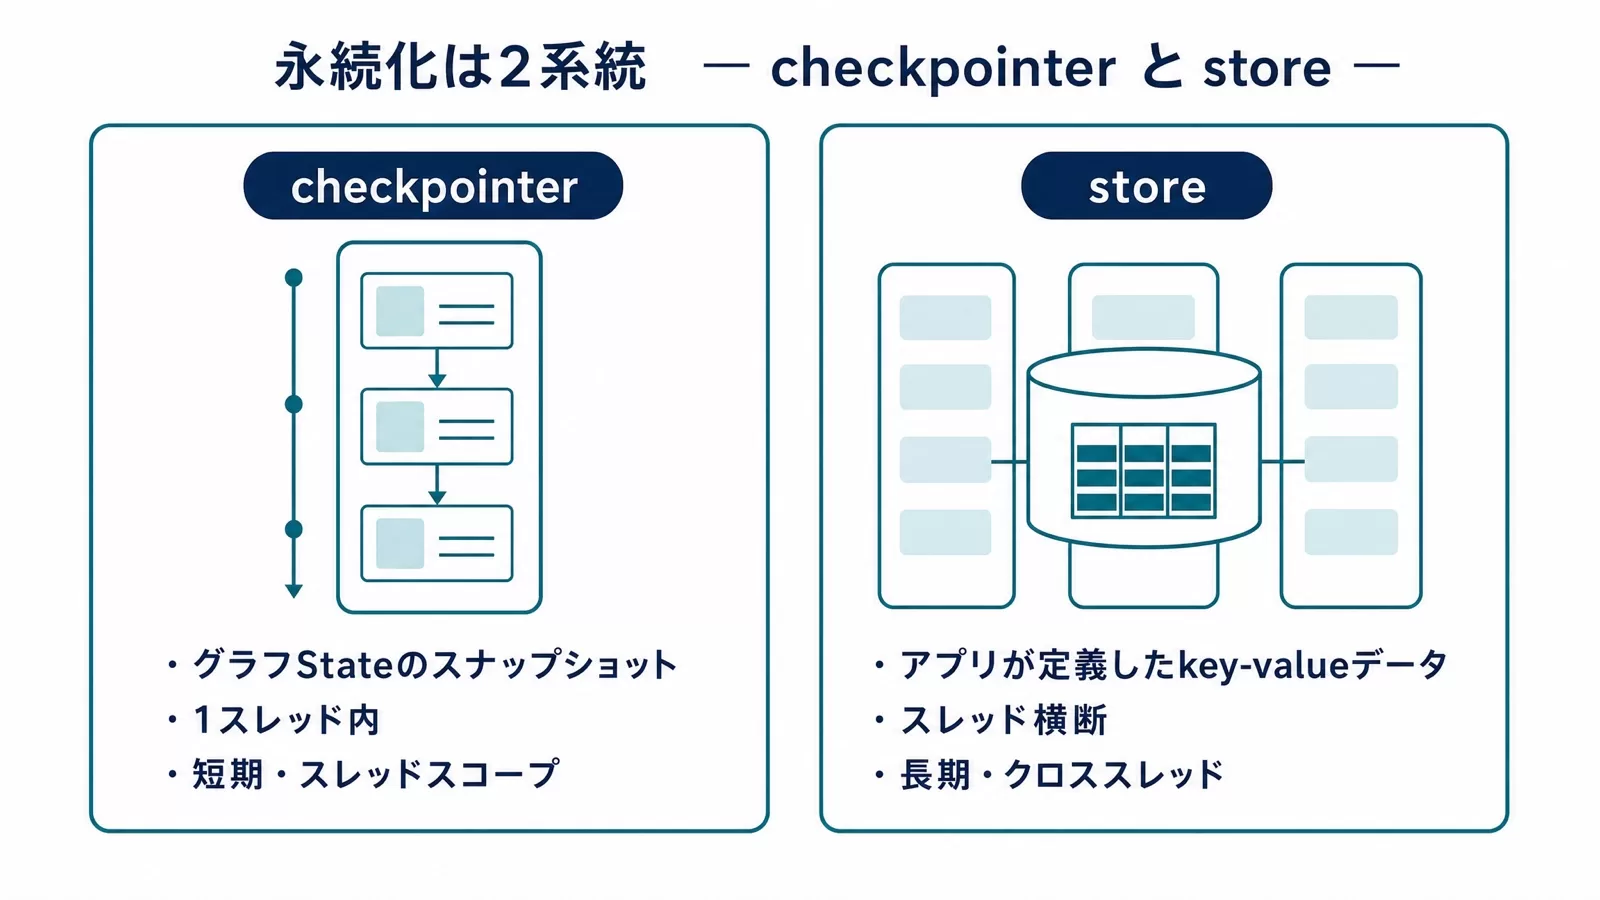
永続化は2系統あるという理解が出発点です。1つだと思っていると「会話は覚えているのにユーザーの好みを覚えていない」設計になります。
| 観点 | checkpointer | store |
|---|---|---|
| 保存するもの | グラフStateのスナップショット | アプリが定義したkey-valueデータ |
| スコープ | 1スレッド内 | スレッド横断 |
| 記憶の種類 | 短期・スレッドスコープ | 長期・クロススレッド |
| 主な用途 | 会話の継続、human-in-the-loop、タイムトラベル、耐障害性 | ユーザーの好み、事実、共有ナレッジ |
| アクセス方法 | configにthread_idを渡す |
ノードやアプリコードからput/search |
checkpointer:スレッドとthread_id
checkpointerはスーパーステップの境界ごとにStateのスナップショットを保存します。thread_id は永続的なカーソルで、同じ値なら同じ会話の続きから、新しい値なら空のStateから始まります。
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.store.memory import InMemoryStore

checkpointer = InMemorySaver()
store = InMemoryStore()

graph = builder.compile(checkpointer=checkpointer, store=store)

result = graph.invoke(
    {"messages": [{"role": "user", "content": "はじめまして、田中です。"}]},
    {"configurable": {"thread_id": "thread-1"}},
)本番でのcheckpointer選定は次のとおりです。ここは公式ドキュメントのトラブルシューティング節にも明記されている内容で、InMemorySaver はプロセス再起動で全部消えます。
# 開発・単体テスト
from langgraph.checkpoint.memory import InMemorySaver
checkpointer = InMemorySaver()

# ローカル検証(要 pip install langgraph-checkpoint-sqlite)
import sqlite3
from langgraph.checkpoint.sqlite import SqliteSaver
checkpointer = SqliteSaver(sqlite3.connect("checkpoint.db"))

# 本番(要 pip install langgraph-checkpoint-postgres)
from langgraph.checkpoint.postgres import PostgresSaver
checkpointer = PostgresSaver.from_conn_string("postgresql://...")
checkpointer.setup() # 初回のみ。テーブルとインデックスを作るPostgresSaverの実務的な落とし穴として、thread_id のカラム長には上限がある点も押さえてください。公式は255文字未満を推奨しています。ユーザーIDとセッションIDとタイムスタンプを連結したような長いIDはUUIDかハッシュに置き換えます。
store:スレッドをまたぐ長期記憶
storeは名前空間(タプル)とキーで値を出し入れします。「このユーザーはピザが好き」のような、会話スレッドが変わっても引き継ぎたい情報を置く場所です。
import uuid
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()

user_id = "1"
namespace = (user_id, "memories")

store.put(namespace, str(uuid.uuid4()), {"food_preference": "I like pizza"})

memories = store.search(namespace)   # 既定でlimit=10
print(memories[-1].dict())
# {'value': {'food_preference': 'I like pizza'}, 'key': '07e0caf4-...', 'namespace': ['1', 'memories'], ...}名前空間はユーザー単位である必要はなく、テナント単位・プロジェクト単位で切るのも一般的です。長期記憶の設計パターンはAIエージェントメモリ実装入門とAIエージェントの状態・会話履歴・セッション管理ガイドで整理しています。
durabilityモード3種:どこまで書き込みを待つか
LangGraphは実行メソッドに durability= を渡すことで、チェックポイント書き込みのタイミングを3段階で選べます。性能と一貫性のトレードオフを明示的に握るためのスイッチです。
| モード | 書き込みタイミング | 向いている状況 |
|---|---|---|
"exit" |
実行終了時のみ(成功・エラー・interrupt) | 性能最優先。プロセスクラッシュからの中間復帰は諦める |
"async" |
次のステップと並行して非同期に書く | 性能と耐久性のバランス。クラッシュ時に書き漏れる可能性が僅かに残る |
"sync" |
次のステップ開始前に同期的に書く | 耐久性最優先。書き込み分のオーバーヘッドを許容する |
graph.stream({"input": "test"}, durability="sync")DeltaChannel(v1.2・beta):チェックポイントの肥大を抑える
既定ではLangGraphはスーパーステップごとに全チャネルの値をまるごと書き込みます。会話が100ターン続くスレッドでは100回目のチェックポイントに1回目からのメッセージが全部入り、これがストレージ費用とレイテンシの主因になります。v1.2の DeltaChannel は差分だけを保存し、Kステップごとにフルスナップショットを取る方式へ切り替えるチャネル型です。
from typing import Annotated, Sequence
from typing_extensions import TypedDict
from langgraph.channels import DeltaChannel

# バッチリデューサ: 現在値とスーパーステップ内の全書き込みを一度に受け取る
def list_reducer(messages: list[str], writes: Sequence[list[str]]) -> list[str]:
    return [*messages, *(item for write in writes for item in write)]

class State(TypedDict):
    messages: Annotated[list[str], DeltaChannel(list_reducer, snapshot_frequency=5)]
snapshot_frequency=5 は「5ステップごとにフルスナップショット」で、読み出しレイテンシの上限を決める値です(小さくするほどストレージが増えて読み出しが速い)。注意点としてDeltaChannel は langgraph>=1.2 が必須で、2026年9月時点でbeta扱いです。公式にも「将来のリリースでAPIが変わる可能性がある」と明記されているため、本番の中核パスに入れるかはその前提で判断してください。
human-in-the-loop|interrupt()とCommand(resume=...)
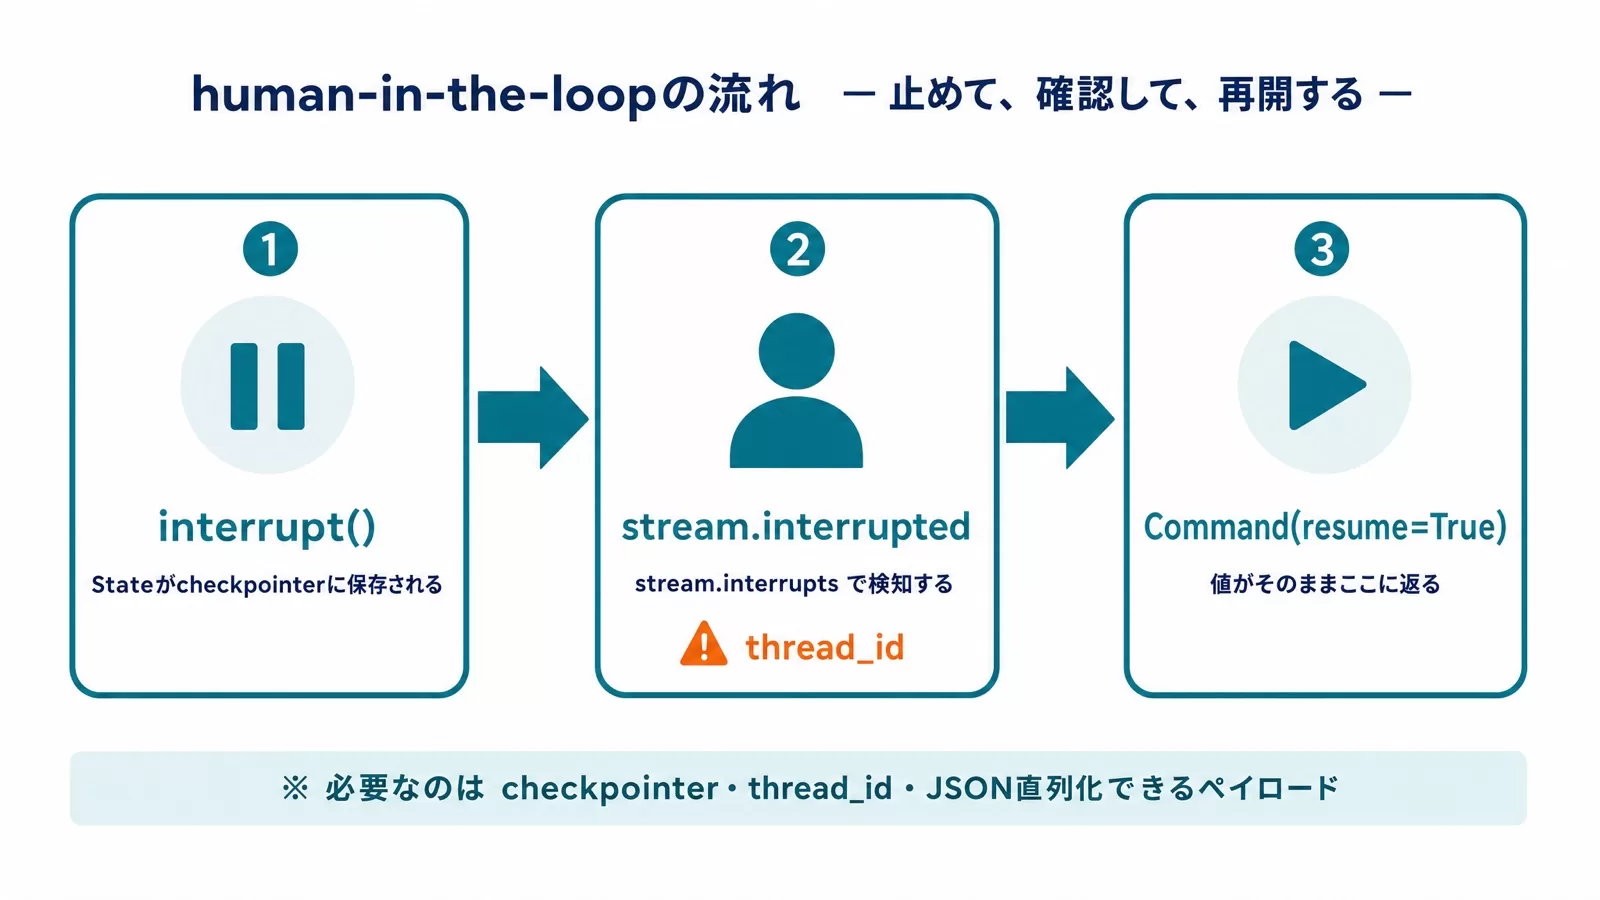
ここは古い日本語記事が最も危険な領域です。ノード引数に interrupt_before=True を渡す書き方は現行APIではありません。正解はノード関数の中で interrupt() を呼ぶ動的interruptで、必要なのはcheckpointer(本番では永続的なもの)、thread_id、JSON直列化できるペイロードの3点です。
from langgraph.types import interrupt

def approval_node(state: State):
    # ここで実行が止まり、Stateがcheckpointerに保存される
    approved = interrupt({
        "question": "この送金を承認しますか?",
        "amount": state["amount"],
        "to": state["recipient"],
    })
    # 再開時、Command(resume=...) の値がそのままここに返る
    return {"approved": approved}
再開のしかた
公式推奨は graph.stream_events(..., version="v3") でストリームを回し、stream.interrupted / stream.interrupts で検知する形です。
from langgraph.types import Command

config = {"configurable": {"thread_id": "thread-1"}}

stream = graph.stream_events({"amount": 50000, "recipient": "取引先A"},
                             config=config, version="v3")
final = stream.output   # ストリームを完走させて最終Stateを得る

if stream.interrupted:
    print(stream.interrupts)
    # (Interrupt(value={'question': 'この送金を承認しますか?', ...}),)

    resumed = graph.stream_events(Command(resume=True), config=config, version="v3")
    final = resumed.output
従来の graph.invoke() も動き、interruptは result["__interrupt__"] に出ます。ただし辞書アクセスは非推奨経路なので、新規実装は stream_events 系に寄せるのが無難です。
再開時の3つの落とし穴
- ノードは先頭から再実行される:
interrupt()より前のコードはもう一度走ります。副作用はinterrupt()の後ろに置くか冪等に作ります - 同じ
thread_idを使う:別IDを渡すと新しい空スレッドが始まるだけで再開になりません - 並列interruptはIDで対応付ける:ファンアウトした複数ノードが同時に
interrupt()を呼んだ場合、各IDと再開値をマッピングして渡します。順番に頼ると取り違えます
トークンを流しながら承認待ちする
実運用のチャットUIでは「LLMの出力を流しつつ、承認が必要になったら止める」ループを組みます。v3のプロジェクションなら素直に書けます。
from langgraph.types import Command

stream_input: dict | Command = initial_input

while True:
    stream = graph.stream_events(stream_input, config=config, version="v3")

    # サブグラフ内も含めてLLMのトークンをそのまま流す
    for message in stream.messages:
        for token in message.text:
            display_streaming_content(token)

    if not stream.interrupted:
        final_state = stream.output
        break

    interrupt_info = stream.interrupts[0].value
    user_response = get_user_input(interrupt_info)
    stream_input = Command(resume=user_response)
ストリーミング|stream v2とstream_events v3の使い分け
ストリーミングは1.1と1.2でそれぞれ別の新方式が入り、現時点で3つの世代が同時に生きています。どれを使うか決めてからコードを書いてください。
| 世代 | API | 必要バージョン | 状態 |
|---|---|---|---|
| v1 | stream() 既定。モード数やサブグラフ設定で戻り値の形が変わる |
全バージョン | 既定のまま維持 |
| v2 | stream(..., version="v2")。常にStreamPart形式で型が絞れる |
1.1以上 | 安定 |
| v3 | stream_events(..., version="v3")。型付きプロジェクションを返す |
1.2以上 | beta(仕様変更の可能性あり) |
v2:戻り値の形が固定される
v1の使いにくさはオプションで戻り値の形が変わることでした(単一モードは生データ、複数モードは (mode, data) タプル、サブグラフありは (namespace, data) タプル)。v2では常に {"type", "ns", "data"} の形です。
for part in graph.stream(
    {"topic": "ice cream"},
    stream_mode=["values", "updates", "messages", "custom"],
    version="v2",
):
    if part["type"] == "values":
        print(f"State: topic={part['data']['topic']}")
    elif part["type"] == "updates":
        for node_name, state in part["data"].items():
            print(f"Node `{node_name}` updated: {state}")
    elif part["type"] == "messages":
        msg, metadata = part["data"]
        print(msg.content, end="", flush=True)
    elif part["type"] == "custom":
print(f"Progress: {part['data']['progress']}%")各モードに対応するTypedDict(ValuesStreamPart、UpdatesStreamPart、MessagesStreamPart など7種)が langgraph.types から使え、part["type"] による型ナローイングがエディタと型チェッカーで効きます。
v3:辞書のフィルタリングをやめる
v3の発想は「イベント辞書を呼び出し側でフィルタする」のをやめ、チャネルごとの型付きプロジェクションを直接回すことです。UIへのトークンレベルストリーミングは1.2ではこちらが推奨経路です。
run = graph.stream_events(input, version="v3")

for state in run.values:      # スーパーステップごとのStateスナップショット
    print(state)

print(run.output)             # 最終State
print(run.interrupted, run.interrupts)
組み込みのプロジェクションは4つです。
| プロジェクション | 流れてくるもの |
|---|---|
run.values |
スーパーステップごとのStateスナップショット(run.outputの元になる) |
run.messages |
LLM呼び出しごとに1つのChatModelStream |
run.lifecycle |
サブグラフのstarted / completed / failed |
run.subgraphs |
直下のサブグラフへのナビゲーションハンドル |
それ以外(updates、custom、checkpoints、tasks、debug)はオプトインで、compile(transformers=[...]) か呼び出し時の transformers= で登録します。誰も購読していないモードにはオーバーヘッドがかからないのが、v2までとの実装上の大きな違いです。
from langgraph.stream import UpdatesTransformer, CustomTransformer

graph = builder.compile(transformers=[UpdatesTransformer, CustomTransformer])

run = graph.stream_events(input, version="v3")
for update in run.updates:
    print(update)
もう1つ実務で効くのが、LLM呼び出し単位のサブプロジェクションです。テキストトークン・推論・ツール呼び出し・使用量を別々に取り出せるので、チャンクを自前で仕分ける処理が消えます。
async for chat in graph.astream_events(input, version="v3").messages:
    async for token in chat.text:
        print(token, end="", flush=True)
    tool_calls = await chat.tool_calls.collect()
final = await chat.output # 確定したAIMessage制約としてプロジェクションは既定で単一コンシューマで、run.values を2回イテレートすると例外になります。ファンアウトは projection.tee(n)(非同期はatee(n))、到着順にまとめて消費するなら run.interleave("messages", "values")。またコンテンツブロックストリーミングは内側のグラフも含めv3で統一が必要で、親だけv3にしてもサブグラフがv2なら期待どおり流れません。
障害対策|v1.2で入った4つの制御
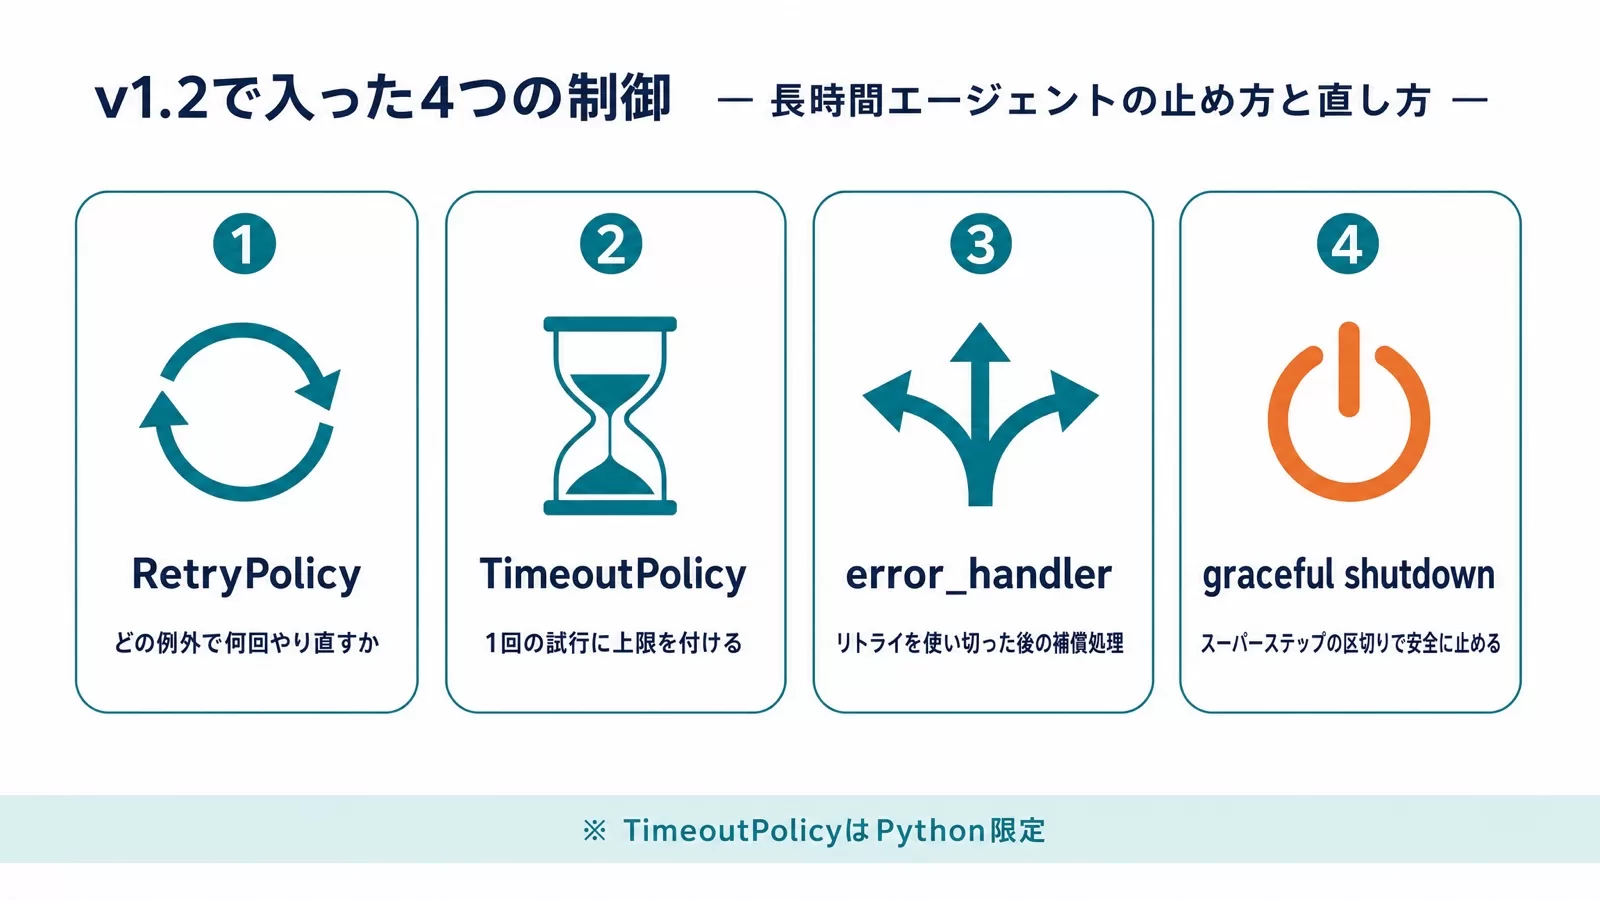
v1.2の主題は「長時間走るエージェントの止め方と直し方」です。ここが揃ったことで、LangGraphは実運用のワークフローエンジンとして普通に使えるようになりました。
1. RetryPolicy:どの例外で何回やり直すか
from langgraph.types import RetryPolicy

builder.add_node("call_api", call_api, retry_policy=RetryPolicy(max_attempts=3))| パラメータ | 既定値 | 意味 |
|---|---|---|
max_attempts |
3 | 初回を含む最大試行回数 |
initial_interval |
0.5秒 | 最初の再試行までの待ち時間 |
backoff_factor |
2.0 | 再試行ごとの間隔倍率 |
max_interval |
128.0秒 | 再試行間隔の上限 |
jitter |
True | 間隔にランダムなゆらぎを足す |
retry_on |
default_retry_on |
再試行対象の例外、または判定関数 |
既定の default_retry_on は「ほぼ全ての例外を再試行するが、コードのバグ由来の例外は再試行しない」設計です。除外は ValueError、TypeError、ArithmeticError、ImportError、LookupError、NameError、SyntaxError、RuntimeError、ReferenceError、StopIteration、StopAsyncIteration、OSError とそのサブクラス。requests や httpx の例外は5xxのときだけ再試行します。自前クライアントではここまで賢く判定されない点に注意してください。
2. TimeoutPolicy:1回の試行に上限を付ける(v1.2・Python限定)
from langgraph.types import RetryPolicy, TimeoutPolicy

# 進捗に関係なく2分で打ち切る
builder.add_node(
    "call_model",
    call_model,
    timeout=TimeoutPolicy(run_timeout=120),
    retry_policy=RetryPolicy(max_attempts=3),
)

# 30秒間まったく出力が無ければ打ち切る(出力があればタイマーがリセットされる)
builder.add_node("stream_response", stream_response,
                 timeout=TimeoutPolicy(idle_timeout=30))
上限に達すると NodeTimeoutError が送出され、その試行の書き込みは破棄されてリトライポリシーに引き継がれます(既定で再試行対象)。タイムアウトは非同期ノードにのみ適用され、同期ノードに timeout= を付けるとcompile時に拒否されます。知らずに書くと書き直しになります。
3. error_handler:リトライを使い切った後の補償処理
再試行を使い切った後に呼ばれる回復関数を登録できます。ハンドラは失敗ノード名と例外を持つ NodeError を受け取り、Command でStateを更新しつつ別ノードへ飛ばせます。Sagaの補償トランザクションを素直に書ける形です。
from langgraph.errors import NodeError
from langgraph.types import Command, RetryPolicy

def payment_error_handler(state: State, error: NodeError) -> Command:
    return Command(
        update={"status": f"compensated: {error.error}"},
        goto="finalize",
    )

builder.add_node(
    "charge_payment",
    charge_payment,
    retry_policy=RetryPolicy(max_attempts=3, retry_on=ConnectionError),
    error_handler=payment_error_handler,
)
ハンドラ自身が失敗すれば例外は通常どおり伝播し、ノード内の interrupt() はハンドラをバイパスします(承認待ちは「エラー」ではないため)。
4. graceful shutdown:スーパーステップの区切りで安全に止める
タイムアウトがノードの途中で発火するのに対し、graceful shutdownは実行中の処理の完了を待ってから止め、再開可能なチェックポイントを保存します。ローリングデプロイでpodがterminateされるとき、走っているエージェントを壊さず畳むための機能です。
import signal
from langgraph.runtime import RunControl
from langgraph.errors import GraphDrained

control = RunControl()
signal.signal(signal.SIGTERM, lambda *_: control.request_drain("sigterm"))

try:
    result = graph.invoke(inputs, config, control=control)
except GraphDrained as e:
    # 現在のスーパーステップ完了後にクリーンに停止した
    log.info("graph drained: %s", e.reason)

# 次回起動時、同じconfigで続きから
result = graph.invoke(None, config)
set_node_defaults:全ノードに一括適用
ノードが20個あるグラフで retry_policy= を20回書くのは現実的ではありません。v1.2の set_node_defaults() でまとめて指定できます。
from langgraph.types import RetryPolicy, TimeoutPolicy

graph = (
    StateGraph(State)
    .set_node_defaults(
        retry_policy=RetryPolicy(max_attempts=3),
        timeout=TimeoutPolicy(run_timeout=30),
        error_handler=fallback_handler,
    )
    .add_node("a", node_a)
    .add_node("b", node_b, retry_policy=RetryPolicy(max_attempts=5))  # 個別指定が勝つ
    .add_edge(START, "a")
    .compile()
)適用範囲には例外があります。retry_policy と timeout はエラーハンドラノードを含む全ノードに効きますが、cache_policy と error_handler は通常ノードにのみ適用されます(ハンドラは自分自身を捕まえず、ハンドラ結果のキャッシュは安全でないため)。またデフォルトはサブグラフに継承されません。
サブグラフとマルチエージェント|2026年の設計パターン
サブグラフをノードとして追加する
親とサブグラフが同じStateキーを共有しているなら、compile済みサブグラフをそのまま add_node に渡せます。ラッパー関数は不要で、サブグラフが親のチャネルを直接読み書きします。
from typing_extensions import TypedDict
from langgraph.graph.state import StateGraph, START

class State(TypedDict):
    foo: str

def subgraph_node_1(state: State):
    return {"foo": "hi! " + state["foo"]}

subgraph_builder = StateGraph(State)
subgraph_builder.add_node(subgraph_node_1)
subgraph_builder.add_edge(START, "subgraph_node_1")
subgraph = subgraph_builder.compile()

builder = StateGraph(State)
builder.add_node("node_1", subgraph)   # compile済みグラフをそのまま渡す
builder.add_edge(START, "node_1")
graph = builder.compile()
Stateキーが共有されていない場合は、ノード関数の中でサブグラフを呼び、入出力を明示的に変換します。この2通りの使い分けがサブグラフ設計の最初の分岐点です。
サブグラフの永続化は .compile() の checkpointer 引数で制御します。未指定なら親のcheckpointerを継承し、checkpointer=True なら独自のスレッドスコープを持ちます。「請求担当のサブエージェントは前回の質問を覚えているべきか」を決める場所がここです。なお親からサブグラフのStateがすぐ見えないのは、サブグラフが独自のチェックポイント名前空間を持つための正常な挙動で、境界をまたぐデータは store 経由で共有するのが公式の推奨です。
マルチエージェントは「supervisorパターン」から離れつつある
日本語記事で定番だった langgraph-supervisor は、2026年9月時点で最終リリースが2025年11月19日(0.0.31)のまま止まっています。langgraph-swarm も2025年12月4日の0.1.0が最後です。新規プロジェクトでこれらを起点にするのは推奨できません。現在の公式ドキュメントはマルチエージェントを5パターンで整理しており、実装レイヤーはLangChain側、LangGraphは「カスタムワークフロー」の受け皿という位置づけです。
| パターン | 仕組み | 向いている場面 |
|---|---|---|
| Subagents | メインエージェントがサブエージェントをツールとして呼ぶ。ルーティングは全部メインを経由 | チーム別の分散開発、並列実行、大きなコンテキストの分割 |
| Handoffs | ツール呼び出しがStateを更新し、それがルーティングや設定変更を引き起こす | マルチホップ、ユーザーとの直接対話 |
| Skills | 単一エージェントが必要に応じて専門プロンプト・知識をロード | シンプルで焦点の絞れたタスク |
| Router | 分類ステップが入力を専門エージェントへ振り分け、結果を統合 | 並列実行、大きなコンテキストの分割 |
| Custom workflow | LangGraphで独自の実行フローを組む。他のパターンをノードとして埋め込める | 決定的ロジックとエージェント的挙動を混ぜたいとき |
公式ドキュメントには、同じタスクを各パターンで解いたときのモデル呼び出し回数の比較も載っています。「コーヒーを買って」のような単発リクエストでは Handoffs・Skills・Router が3回、Subagents が4回。Subagents が1回多いのは結果がメインエージェントを経由して戻るためで、そのオーバーヘッドが中央集権的な制御と引き換えになっています。パターン選定はマルチエージェントの設計パターン3選|失敗例と実装ガイドとAIエージェントのワークフロー設計パターン5選|LangGraph実装でコード付きで比較しています。
LangSmith StudioとAgent Server|旧「LangGraph Platform」はどこへ行ったか
ここが2026年に最も情報が古びやすい領域です。「LangGraph Platform」は LangSmith Deployment に、「LangGraph Studio」は LangSmith Studio に名前が変わりました(改称は2025年10月)。2026年9月時点の公式ドキュメントに、旧名のページはもうありません。「LangGraph Platform 使い方」で見つかる日本語記事の画面キャプチャは、現行UIと一致しない可能性が高いです。
ローカルで動かす:langgraph dev
Studioはローカルで動いているエージェントに接続して、プロンプト・ツール呼び出し・中間状態を可視化する無料のビジュアルインターフェースです。手順は次の4つです。
# 1. CLIを入れる(Python 3.11以上)
pip install --upgrade "langgraph-cli[inmem]"
# 2. .env にLangSmithのAPIキーを置く(.envはgit管理から除外する)
LANGSMITH_API_KEY=lsv2...
# LangSmithへトレースを送りたくない場合は、あわせてこれを書く
# LANGSMITH_TRACING=false3つ目に、langgraph.json でグラフの場所を宣言します。
{
  "dependencies": ["."],
  "graphs": {
    "agent": "./src/agent.py:agent"
  },
  "env": ".env"
}
# 4. 開発サーバーを起動
langgraph dev起動するとAPIが http://127.0.0.1:2024、Studio UIが https://smith.langchain.com/studio/?baseUrl=http://127.0.0.1:2024 で使えます。ホットリロード対応で、プロンプトやツールのシグネチャの変更が即反映されます。注意点が1つ、SafariはlocalhostへのStudio接続をブロックします。その場合は langgraph dev --tunnel で起動し、Studio UIの「Connect to a local server」からトンネルURLを許可オリジンに追加します。なお LANGSMITH_TRACING=false を設定すればトレースは送られず、データはローカルサーバーから出ません。
本番へ出す:Agent Server
デプロイ先の中核が Agent Server です。アシスタント(特定タスク向けに設定されたエージェント)の概念の上に構築され、永続化とタスクキューを内蔵します。Agent Serverを使う場合、checkpointerもstoreも自分で設定する必要はありません。
デプロイ形態は LangSmith Cloud(フルマネージド)のほか、ハイブリッド、スタンドアロンサーバー、コントロールプレーン付きセルフホストが用意されています。GitHub連携でのデプロイは、公式手順で完了まで15分程度とされています。
from langgraph_sdk import get_sync_client   # 非同期は get_client

client = get_sync_client(url="your-deployment-url", api_key="your-langsmith-api-key")

for chunk in client.runs.stream(
    None,      # スレッドなしの実行
    "agent",   # langgraph.json で定義したグラフ名
    input={"messages": [{"role": "human", "content": "What is LangGraph?"}]},
):
print(chunk)興味深いのはAgent Serverに載せるグラフはLangGraphで書かれている必要がない点です。公式は、Strands・Claude Agent SDK・Google ADK などで作ったエージェントも Functional API や deployments-wrap-sdk 経由でデプロイできると明記しています。フレームワーク比較はAIエージェントFW5強徹底比較とAgents SDKか、LangGraphか|2026年のフレームワーク選定指針で整理しています。
非推奨・変更されたAPI一覧(移行チェックリスト)
「v1.0で何が廃止されたか」は誤情報の多い領域です。2026年9月時点で公式に確認できる内容だけを表にします。
| 対象 | 状態 | 対応 |
|---|---|---|
create_react_agent |
非推奨(v1.0) | LangChainの create_agent へ移行。ミドルウェアによるカスタマイズ余地が広い |
GraphOutputの辞書アクセス(result["key"]、result["__interrupt__"]、"key" in result) |
非推奨(v1.1、LangGraphDeprecatedSinceV11警告) |
result.value / result.interrupts へ。v3.0で削除予定 |
set_entry_point() / set_finish_point() |
非推奨ではない(現行ドキュメントに現役で記載) | 対応は不要。ただしドキュメントは add_edge(START, ...) / add_edge(..., END) を「推奨されるモダンな構文」と表記 |
langgraph.prebuilt(ToolNode等) |
現役。langgraph-prebuilt 1.1.0(2026-05-12) |
対応は不要。「モジュールごと廃止」は誤り |
MessageState(単数形) |
そもそも存在しない | 正しくは MessagesState |
add_node(..., interrupt_before=True) |
現行APIに存在しない | ノード内で interrupt() を呼び、Command(resume=...) で再開する |
| 「LangGraph Platform」「LangGraph Studio」 | 改称(2025年10月) | LangSmith Deployment / Agent Server、LangSmith Studio |
グラフの構造変更と後方互換性
LangGraphは実行中のスレッドにも常に最新のグラフコードを適用します。「開始時のバージョンで固定する」ワークフローエンジンとは設計が違うので、デプロイのたびに「保存済みチェックポイントに対する破壊的変更になっていないか」を意識する必要があります。壊れやすいのは次の3つです。
- ノードのリネーム・削除:interruptで止まっているスレッドが、保存された名前のノードを見つけられず実行に失敗します。再開はノードの先頭からなので、そのノードが無いと再開先がありません
- Stateキーのリネーム・削除:古いチェックポイントが持つキーを下流ノードが読んでいると落ちます
- Stateフィールドの厳格化:
Optionalを必須にする、型を狭める、デフォルト無しの必須キーを足す、はいずれも既存チェックポイントがスキーマを満たさなくなります
逆にエッジのトポロジはチェックポイントに保存されません。存在するノード同士のエッジを足す・消す・張り替えるのは実行中スレッドに対して安全です。壊れるトポロジ変更はノードのリネームと削除だけ、と覚えておくと判断が速くなります。
推奨される進め方は「追加してから消す」です。新しいフィールド/ノードを旧いものと並べて置き、移行期間は両方に書く。実行中スレッドが無くなってから旧いほうを消します。存在確認は、LangSmithにデプロイ済みならAgent Serverのスレッド検索(status に idle / busy / interrupted / error を指定)、それ以外なら graph.get_state(config) と graph.get_state_history(config) で個別に見ます。
MCPツールの接続先が変わった(2026年9月1日・LangChain v1.4.0)
LangGraph本体ではなくLangChain側の変更ですが、LangGraphでツールを持つエージェントを組んでいるなら影響します。公式Changelogによると、2026年9月1日のlangchain v1.4.0でMCPサポートがlangchain.mcp名前空間としてLangChain本体に取り込まれ、独立パッケージだったlangchain-mcp-adaptersを置き換えました。中身はFastMCPベースです。
# pip install "langchain[mcp]"
from langchain.mcp import MCPAdapter   # beta。importするとLangChainBetaWarningが出る

# URL・stdioで動くローカルスクリプト・インプロセスサーバー・
# 複数サーバー用のMCPConfig辞書・作成済みのfastmcp.Client を渡すと、
# アダプタ側がトランスポートを判別する
adapter = MCPAdapter("https://example.com/mcp")

tools = await adapter.list_tools() # LangChainツールとして返る移行の要点は3つです。第一に、MultiServerMCPClientはMCPAdapterに置き換わりました(機能が変更・削除されたものもあるため、公式の移行ガイドを先に読んでください)。第二に、サーバー側が処理の途中で入力を求めてくるelicitationが、LangGraphのinterrupt()としてそのまま浮上します。つまりこの記事のhuman-in-the-loopの節で書いたCommand(resume=...)の作法が、MCPサーバーからの問い合わせにもそのまま使えます。第三に、各ツールのメタデータにmcp名前空間で出自が入り、destructive_hintのようなアノテーションを見て「破壊的操作は承認を挟む」という制御が書けるようになりました。
langchain.mcpはbeta表記なので、本番投入前に自分のユースケースで挙動を確かめてください。
PythonとTypeScriptの差分(2026年9月時点)
「TypeScriptでも同じことができますか」は最頻出の質問です。バージョン体系が独立しているので数字の対応から整理します。
| 項目 | Python | TypeScript |
|---|---|---|
| パッケージ | langgraph |
@langchain/langgraph |
| 最新版(2026-09-03) | 1.2.11(2026-08-11) | 1.4.13(2026-08-26) |
| State定義 | TypedDict / Pydantic / dataclass |
StateSchema + Zod(standard schemas) |
| リトライポリシー | 対応 | 対応 |
| ノードタイムアウト(v1.2) | 対応 | 非対応(Python限定) |
| error_handler(v1.2) | 対応 | 非対応(Python限定) |
公式のv1.2リリースノートは「タイムアウトとエラーハンドラはPython限定で、リトライポリシーは引き続きPythonとTypeScriptの両方で動作する」と明記しています。ノードの実行時間制御と補償処理をフレームワークに任せたいなら、2026年9月時点ではPythonが確実です。TypeScript側の追随予定は、2026年9月時点で公式のロードマップとして確認できていません。
TypeScriptでの選択肢そのものを比較したい場合はMastra完全ガイドも参考になります。TypeScriptネイティブに設計されたフレームワークとLangGraph JSでは、State定義の書き味がかなり違います。
本番投入で踏みやすい失敗パターン7選
ここまでの内容を、やりがちな間違いの形でまとめます。
- ❌ 直線的なパイプラインにLangGraphを持ち込む
⭕ ループ・条件分岐・再試行・動的ルーティングが要るときだけLangGraphにする。一本道ならLangChainのcreate_agentで十分で、必要になった時点でStateGraphへ切り出す - ❌
InMemorySaverのまま本番へ出す
⭕ 再起動で全チェックポイントが消える。本番はPostgresSaver、ローカル検証はSqliteSaver。Agent Serverに載せるなら設定自体が不要 - ❌ 副作用を
interrupt()より前に書く
⭕ 再開時、ノードは先頭から再実行される。メール送信・決済・DB書き込みはinterrupt()の後ろへ置くか、冪等キーで二重実行に耐えるように作る - ❌ Stateにメッセージを全部貯めたまま長時間スレッドを回す
⭕ 毎ステップで全チャネルの値が書かれるためストレージが線形に膨らむ。v1.2以上ならDeltaChannel(beta)、それ以外は要約・トリムでStateを畳む - ❌ 同じノードから通常エッジと
Commandの動的ルーティングを両方出す
⭕ 両方の経路が実行されうる。ノード単位でどちらか一方に統一する - ❌ 運用中にStateキーやノード名をリネームする
⭕ interruptで止まっているスレッドが再開不能になる。新旧を並べ、実行中スレッドがゼロになってから旧いほうを消す。新規キーはNotRequiredで足す - ❌ 親グラフだけv3ストリーミングにしてサブグラフをv2のままにする
⭕ コンテンツブロックストリーミングは内側のグラフも含めv3で統一する必要がある。トークンが流れないときはまずここを疑う
よくある質問
LangGraphとLangChainの違いは何ですか?
LangChainはエージェントフレームワーク(モデル・ツール・エージェントループの抽象化とプロバイダ統合)、LangGraphはオーケストレーションランタイム(耐久実行・ストリーミング・human-in-the-loop・永続化)です。どちらかを選ぶ関係ではなく、LangChainの create_agent は内部でLangGraphの上に構築されています。実務では「LangChainで速く始め、明示的な状態管理が要る特定のワークフローだけStateGraphへ落とす」進め方が現実的です。LangChainでAIエージェントを構築する完全ガイドも合わせてどうぞ。
LangGraphは無料で使えますか?
LangGraph本体はオープンソースで pip install langgraph だけで完結します。LangSmith Studioは公式に「無料のビジュアルインターフェース」と記載されていますが、接続にはLangSmithアカウントとAPIキーが必要です。本番デプロイ(LangSmith Cloud等)の料金は別体系なので、最新の価格は公式ページで確認してください。
LangGraphの開発元はどこですか?
LangChainを開発しているLangChain Inc.です。設計思想はGoogleのPregelとApache Beam、公開インターフェースはNetworkXに影響を受けていると公式ドキュメントに明記されています。ただしLangChainを使わずLangGraph単体で使うこともできます。
v1.0からv1.2へ上げるときに壊れる箇所はありますか?
コアAPI(State・ノード・エッジ・実行モデル)は変わっていないので、通常は pip install -U langgraph だけで通ります。確認すべきは graph.invoke() の戻り値の読み方で、version="v2" かつ result["key"] のような辞書アクセスをしている箇所は v1.1以降 LangGraphDeprecatedSinceV11 警告が出てv3.0で削除予定です。result.value / result.interrupts へ書き換えてください。
マルチエージェントを組むならsupervisorパターンですか?
langgraph-supervisor は2025年11月19日の0.0.31が最終リリースで更新が止まっています。2026年9月時点の公式ドキュメントは Subagents / Handoffs / Skills / Router / Custom workflow の5パターンで整理しており、実装レイヤーはLangChain側、LangGraphは「Custom workflow」の実装基盤という位置づけです。
まとめ:今日から始める3つのアクション
- 今日:
pip install -U langgraphで1.2.11に上げ、result["key"]形式の辞書アクセスをgrepで洗い出してresult.valueへ置換する(v3.0で消える経路) - 今週中:本番グラフのcheckpointerを確認する。
InMemorySaverのままならPostgresSaverへ差し替え、thread_idが255文字未満か確認。あわせてset_node_defaults()でRetryPolicyとTimeoutPolicyを全ノードへ一括適用する - 今月中:長時間スレッドのチェックポイントサイズを実測し、線形に膨らんでいるなら
DeltaChannel(beta)か要約・トリムを入れる。同時にSIGTERMハンドラを書き、デプロイ時にエージェントが壊れず畳めるようにする
LangGraph導入を本格化したい方へ
UravationではAIエージェント設計・本番運用のコンサル・研修を実施。LangGraph実装支援もご相談ください。
参考・出典
いずれも参照日は2026年9月4日です。
- Changelog(LangChain / LangGraph / Deep Agents)(v1.2.0の内容とlangchain v1.4.0のMCP統合)
- Models(init_chat_modelとプロバイダ接頭辞)
- OpenAI API Pricing(gpt-5.6-luna / terra の料金)
- Claude Models overview(claude-sonnet-5のモデルID)
- Gemini API Models(gemini-3.8-flashのモデルID)
- LangGraph overview
- Graph API overview
- Checkpointers
- Interrupts
- Event streaming
- Fault tolerance
- Backward compatibility
- LangSmith Studio
- Agent Server
- Multi-agent
- What’s new in LangGraph v1
- Release langgraph==1.2.0a6(v1.2の機能解説)- GitHub
- LangGraph Releases – GitHub
- LangGraph JS Releases – GitHub
- langgraph – PyPI(バージョンと公開日)
- Delta Channels: How We’re Evolving our Runtime for Long-Running Agents – LangChain Blog
- LangChain and LangGraph Agent Frameworks Reach v1.0 Milestones – LangChain Blog
- Case studies(本番採用企業の一覧)
関連記事:
- AIエージェントFW5強徹底比較 — 他フレームワークと横並びで見る
- LangChainでAIエージェントを構築する完全ガイド — 上位レイヤー側の話
- AIエージェントのワークフロー設計パターン5選|LangGraph実装 — グラフの形の作り方
- マルチエージェントの設計パターン3選|失敗例と実装ガイド — 複数エージェントの束ね方
- AIエージェントメモリ実装入門 — storeの上に何を置くか
- Mastra完全ガイド — TypeScriptでの対抗馬
- Google ADK v1.0完全解説 — Agent Serverにも載る別系統のSDK
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- 公式Deprecations(platform.openai.com)
- FastMCP(gofastmcp.com)
- Uravation(uravation.com)
- Changelog(LangChain / LangGraph / Deep Agents)(docs.langchain.com)
- Models(init_chat_modelとプロバイダ接頭辞)(docs.langchain.com)
- OpenAI API Pricing(platform.openai.com)
- Claude Models overview(platform.claude.com)
- Gemini API Models(ai.google.dev)
- LangGraph overview(docs.langchain.com)
- Graph API overview(docs.langchain.com)