LiteLLMは、100以上のLLMプロバイダーをOpenAI互換の1本のAPIに束ねるOSSのAIゲートウェイで、ゲートウェイ本体の利用料は0円(自ホスト・Enterpriseのみ問い合わせ制)、2026年9月27日時点の最新安定版はv1.102.1(2026年9月23日公開)です。
GSCで本記事に集まる上位クエリ(litellm jev/litellm cost/litellm routing_strategy)に先に答えると、JevはAuto Routerの振り分け判定をLLMの代わりに行うTypeSafe AIの判定モデル(2026年9月20日にv1.103.0-rcで提供開始・100万入力トークンあたり0.042ドル=1ドル150円換算で約6.3円)、costはレスポンスヘッダーx-litellm-response-costとDBテーブルLiteLLM_SpendLogsで1リクエスト単位に記録される仕組み、routing_strategyは5種類あるうち公式が本番で推奨しているのは既定のsimple-shuffleのみ(usage-based系は本番非推奨)です。
この記事は2026年9月27日に公式ドキュメント・GitHub・公式ブログを取得し直して書いています。以下は同日時点のスナップショットです。
- 最新安定版:v1.102.1(2026年9月23日公開)。プレリリースはv1.104.0-dev.2(9月25日)、サポート中の安定系列としてv1.100.3/v1.99.4/v1.98.1も同日に出ている
- 規模:GitHubスター59,690(GitHub APIで9月27日取得)、公式サイト表記では対応プロバイダー140以上・モデル1,892種類・Dockerプル2億4,000万回以上・コントリビューター1,005人以上
- 料金:OSS版は0円(公式プラン表記は「$0 Free forever」)。Enterpriseは2026年9月27日時点で公式サイトに金額の記載がなく、問い合わせ(Request pricing)と30日間のトライアルキー発行のみ
- 実装の変化:ホットパスをRustへ移す作業が進行中で、v1.102.1では「OCRがRust既定」、次のv1.104.0-rc.1で「Anthropic Messagesがオプトイン」「OCRはRustのみ」に変わる
- 必要なデータストア:仮想キー・コスト追跡・Admin UIからのモデル管理を使うならPostgreSQLが必須(SQLiteは非対応)、インスタンスを2台以上にするならRedisも必須
- セキュリティ:2026年3月にPyPIのv1.82.7/v1.82.8へ資格情報を盗むコードが混入した事案が公式に公開されている。公開済みのGitHubセキュリティアドバイザリは14件(critical 3/high 5/medium 4/low 2・最新は2026年8月26日)
「モデルを切り替えるたびに、APIクライアントのコードを書き直している」——OpenAIで動いていたコードをAnthropicに向けようとしたらメソッド名もレスポンス構造も違う、Bedrockはまた別のSDK、Azure OpenAIはAPIバージョン指定が必要。LiteLLMが解こうとしているのはこの一点です。以下、主要クエリごとに公式の当日値で整理します。
LiteLLMとは|2026年9月時点の全体像と料金
LiteLLMはBerriAI(Berrie AI Incorporated)が開発するOSSのLLMゲートウェイです。公式ドキュメントのQuickstart(2026年9月27日取得)は「100以上のLLMをOpenAI形式で呼べる統一インターフェース」と定義し、使い方は2通りに分かれます。
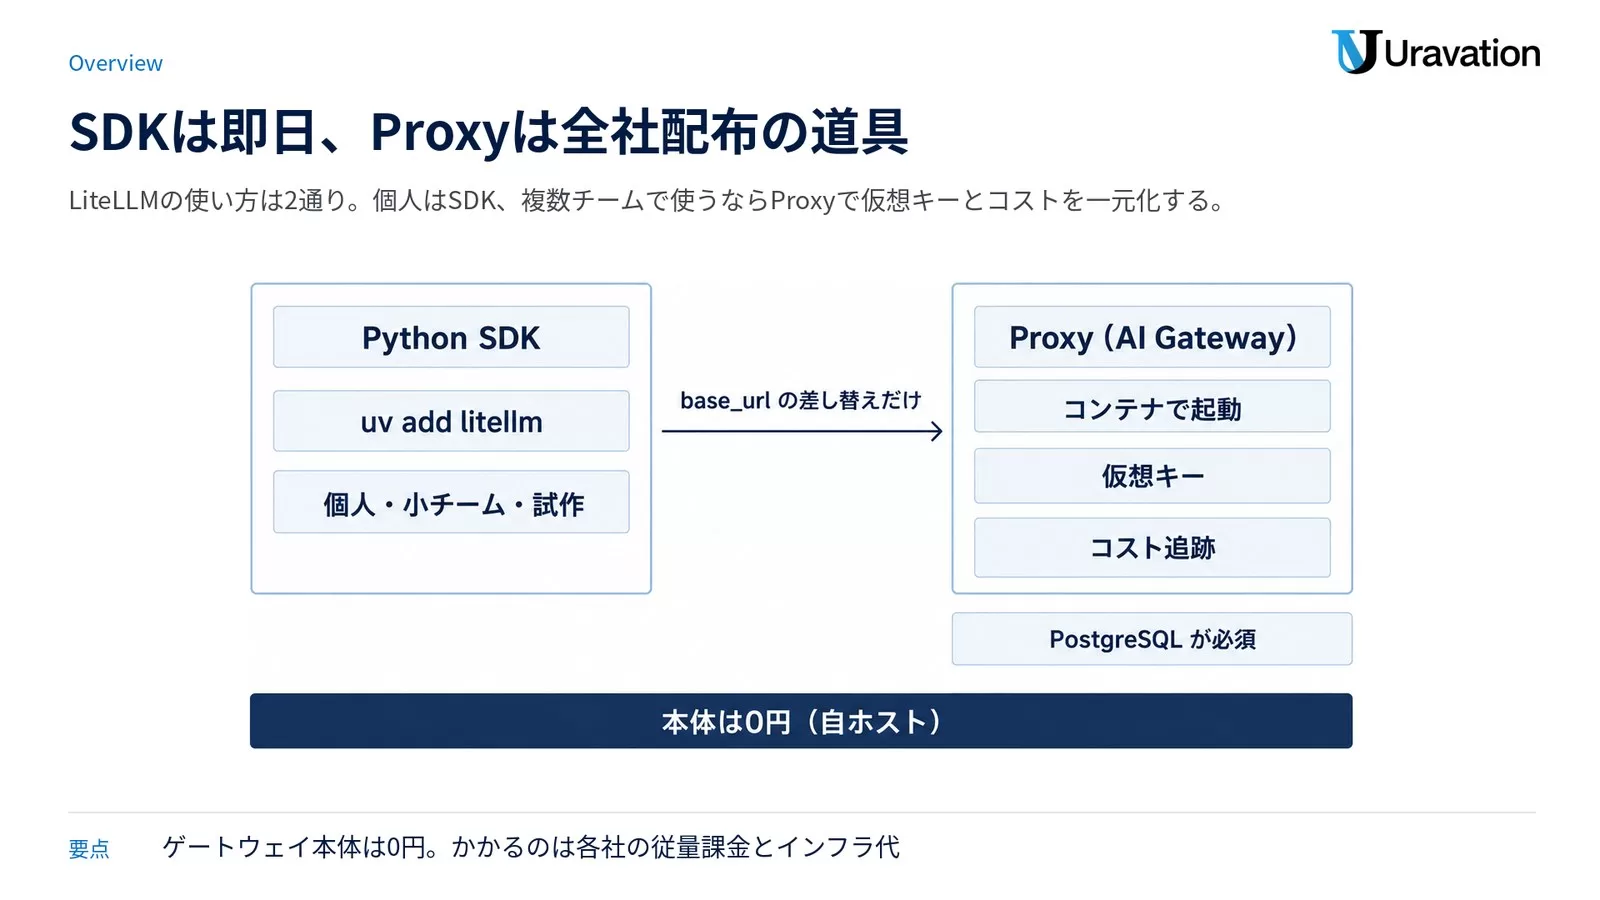
| 観点 | Python SDK | Proxy(AI Gateway) |
|---|---|---|
| 導入 | uv add litellm のみ(公式の推奨表記) |
コンテナで起動。Python環境の用意は不要 |
| 向く相手 | 個人・小チーム・試作 | 複数チーム・本番・全社配布 |
| APIキー管理 | アプリ側で各自が持つ | ゲートウェイ側で一元化(仮想キー) |
| コスト追跡 | completion_cost/cost_per_token を自分で呼ぶ |
DBへ自動記録+Admin UIとAPIで集計 |
| ルーティング | Router クラスで組む |
config.yaml の router_settings で宣言 |
| 既存コードの移行 | 呼び出しの書き換えが必要 | base_url の差し替えだけ(OpenAI互換) |
| PostgreSQL | 不要 | 仮想キー・コスト追跡を使うなら必須 |
料金は「本体0円、Enterpriseは非公開」
公式サイトのプラン表(2026年9月27日取得)は、OSS版を「$0 Free forever/No credit card. Self-host in minutes.」とし、含まれる機能として140以上のプロバイダー連携・Langfuse/Arize Phoenix/LangSmith/OTELへのロギング・仮想キーと予算とチーム・ロードバランシングとRPM/TPM制限・ガードレールを挙げています。Enterpriseは「Enterprise support and custom SLAs/JWT auth, SSO, and audit logs」などが加わりますが、金額は2026年9月27日時点で公式に記載がなく、「Request pricing」と30日間のトライアルキー申込だけが公開されています。つまりlitellm 料金で調べている人への答えは「ゲートウェイ自体に費用はかからない。かかるのは各LLMプロバイダーの従量課金と、自ホストするインフラ代」です。
対応プロバイダー(公式docsの当日表記から抜粋)
| プロバイダー | 公式docsに載っているモデル例(2026年9月27日) | prefix |
|---|---|---|
| OpenAI | gpt-5.6-terra/gpt-5.6-luna | openai/ |
| Anthropic | claude-sonnet-5/claude-haiku-4-5 | anthropic/ |
| Google Vertex AI | gemini-3.1-pro-preview | vertex_ai/ |
| Google AI Studio | Gemini系 | gemini/ |
| AWS Bedrock | us.anthropic.claude-sonnet-5 | bedrock/ |
| Azure OpenAI | デプロイ名を指定 | azure/ |
| Groq | llama3-8b-8192 | groq/ |
| Ollama(ローカル) | llama3(api_base でポート指定) |
ollama/ |
| Deepseek/xAI | プロンプトキャッシュ対応プロバイダーとして記載 | deepseek//xai/ |
レスポンスはどのプロバイダーでもOpenAI Chat Completions形式(ModelResponse)で返るため、呼び出し側は分岐を書かずに済みます。
litellm jevとは|Auto Routerの判定をTypeSafeのJevに置き換える
litellm jevは誤入力ではなく、2026年9月20日に公開された新機能です。公式ブログ「TypeSafe Jev on LiteLLM」(2026年9月20日・Kerry Lu)によれば、JevはTypeSafe AIの判定モデルで、テキストではなく「選択・スコア・はい/いいえの確率」を返すため/chat/completionsではなく専用のevaluateエンドポイントを持ちます。LiteLLMはこのエンドポイントをロギングとコスト追跡付きで中継し、さらにAuto Routerの分類器としてclassifier_type: jevで選べるようにしました。
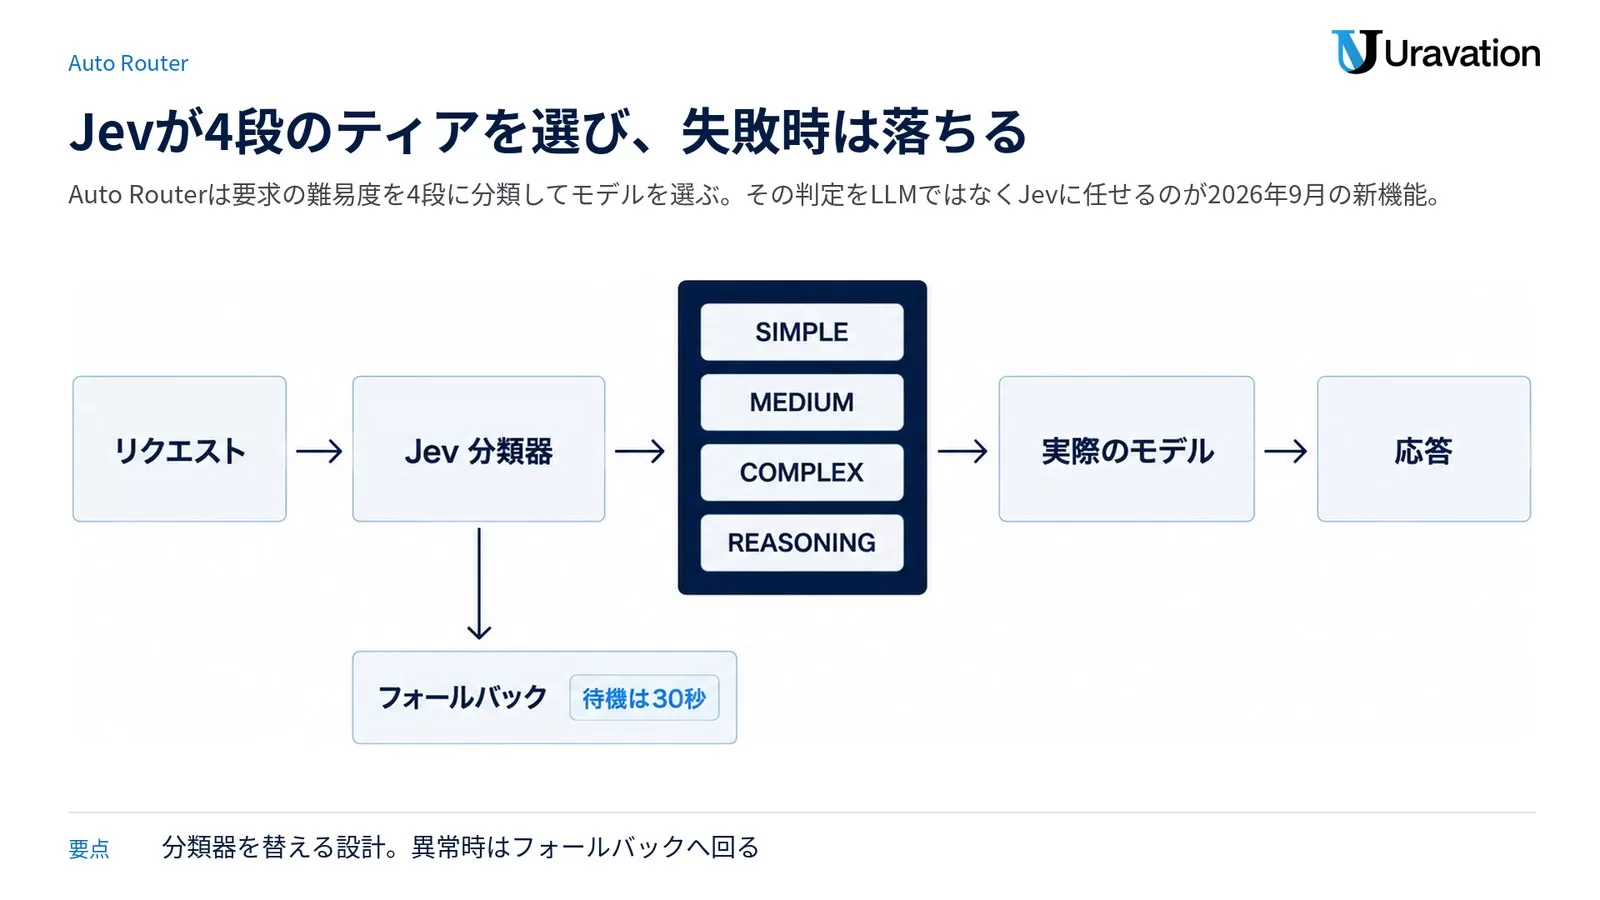
Auto Routerは「1つのモデル名をクライアントに渡し、ゲートウェイ側が要求の難易度をSIMPLE/MEDIUM/COMPLEX/REASONINGの4段に分類して実際のモデルを選ぶ」仕組み(公式docsでは[Add-on]表記)。その分類自体にコストとレイテンシがかかるのが弱点で、そこをLLMではなくJevに任せるのが今回の変更点です。
公式ベンチマークの数値(2026年9月18日実施)
| 指標 | Jev(jev-1.13.0) | 比較対象(claude-haiku-4-5-20251001) |
|---|---|---|
| 想定ティアとの一致 | 228/240(95.00%) | 177/240(73.75%) |
| 分類レイテンシ p50 | 126.81ミリ秒 | 688.40ミリ秒(比5.43倍) |
| 分類レイテンシ p95 | 231.16ミリ秒 | 896.94ミリ秒(比3.88倍) |
| 240回分の分類コスト | 0.007706664ドル(約1.2円) | 0.198534ドル(約29.8円) |
| 入力単価 | 100万トークンあたり0.042ドル(約6.3円)・出力課金なし | 入力1ドル/出力5ドル(100万トークンあたり) |
円換算はいずれも1ドル150円で計算しています。公式ブログ自身が「80件の合成ケースを著者が自ら採点した前提であり、一般的な分類精度を示すものではない」「削減効果は分類器の境界で止まる(完了モデルのコストは含まない)」と明記しているので、そのまま自社の削減率として持ち出すのは避けるべき数字です。ブートストラップ区間はp50比が5.20〜5.71倍、コスト削減率が95.973〜96.266%と公開されています。
設定の書き方(公式blogのconfig.yamlから)
# Auto Router の分類器を Jev にする(公式ドキュメント記載のキーのみ)
- model_name: jev-router
  litellm_params:
    model: auto_router/complexity_router
    complexity_router_default_model: openai-large
    complexity_router_config:
      tiers:
        SIMPLE: openai-small
        MEDIUM: openai-large
        COMPLEX: anthropic
        REASONING: anthropic-large
      classifier_type: jev
      jev_classifier_config:
        model: jev-latest
        timeout_ms: 3000
        circuit_breaker_enabled: true
        circuit_breaker_cooldown_seconds: 30
        classifier_fallback: default_model
        classifier_context_window_size: 3
        classifier_context_budget_chars: 8000
        classifier_context_include_assistant_turns: false
サーバー側の環境変数はTYPESAFE_API_KEY(TYPESAFE_API_BASEは省略時https://api.typesafe.ai)。タイムアウト・HTTPエラー・不正な応答・未知のティア・サーキットブレーカー開放時は既存のフォールバックに落ち、既定の待機は30秒です。会話履歴は既定で直前3ターン・8,000文字までがTypeSafe側へ送られるため、送りたくない場合はclassifier_context_window_size: 0を明示します。Auto RouterのダッシュボードのTest Routingは完了モデルを呼ばない一方、分類だけで課金が発生する点も公式が注意書きしています。
Jevを分類器ではなく単体で使う場合は、パススルーでPOST /typesafe/v1/systemoneを叩きます。クライアントはLiteLLMの仮想キーだけ持てばよく、支出はTypeSafeが返すバージョン付きモデル名(現在はtypesafe/jev-1.13.0)で記録されます。
注意点として、公式ブログはJevの提供開始を「v1.103.0-rc」と書いています。2026年9月27日時点の最新安定版はv1.102.1なので、安定版だけを追っている環境ではclassifier_type: jevがまだ使えない可能性があります(v1.102.1への搭載有無は2026年9月27日時点で公式に記載なし)。
litellm costの答え|コストの計算・追跡・最適化の3層
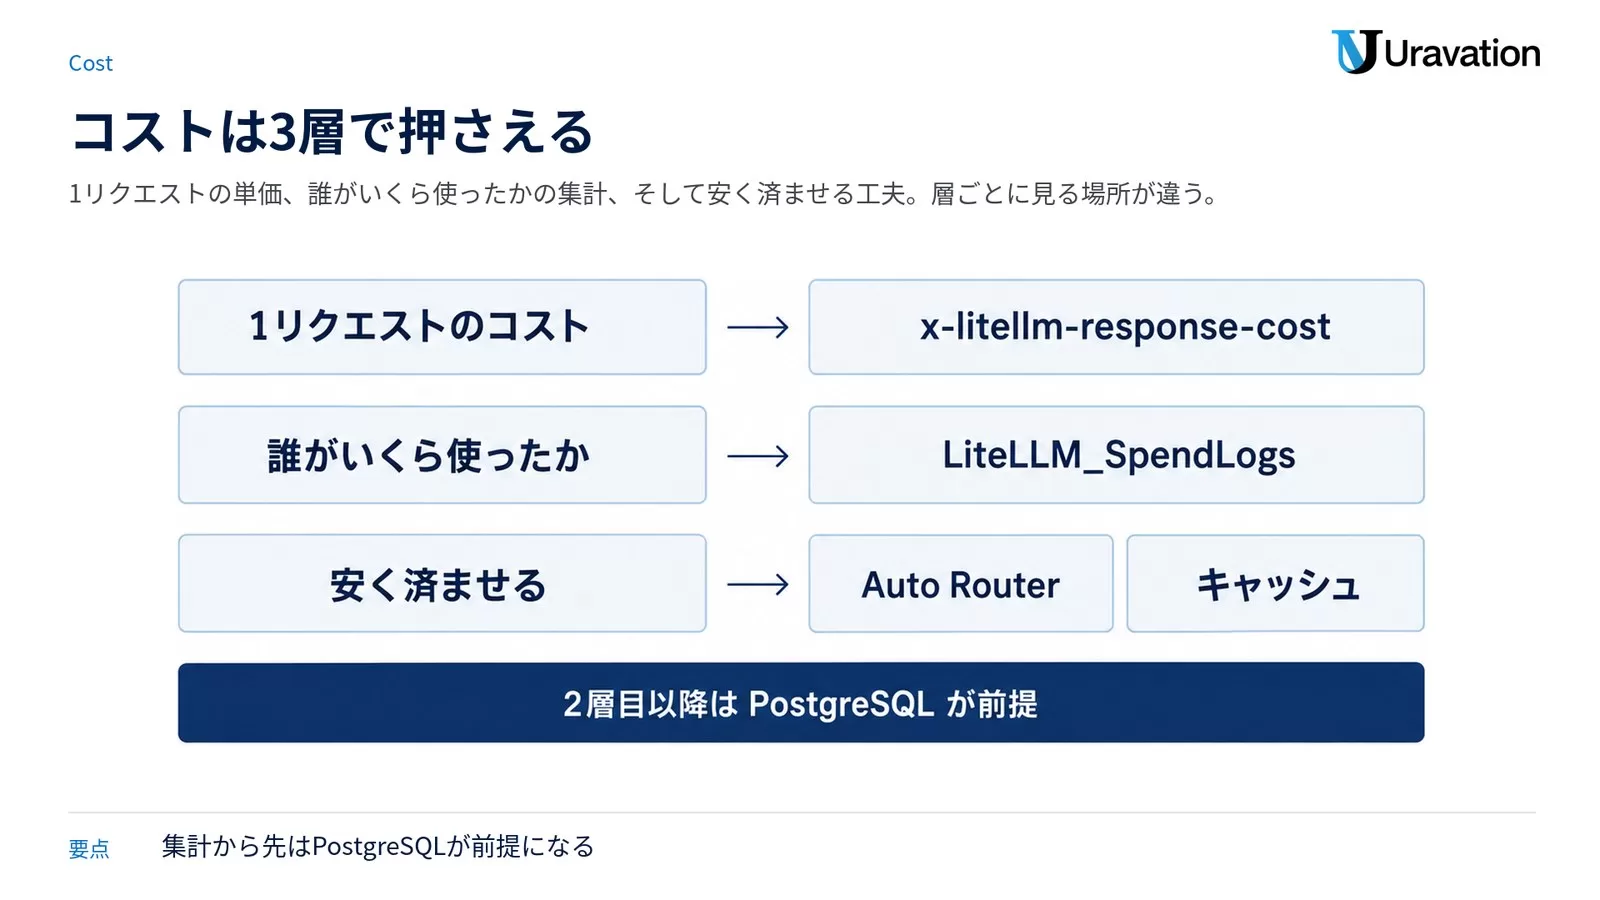
litellm costで探している内容は、実際には「1回いくらだったかを知る」「誰がいくら使ったかを集計する」「そもそも安く済ませる」の3層に分かれます。LiteLLMは3層すべてに機能を持っていますが、2層目以降はPostgreSQLが前提です。
1. 1リクエストのコストを知る
# SDK: 呼び出し結果からコストを計算する(公式 docs/completion/token_usage)
from litellm import completion, completion_cost

response = completion(
    model="openai/gpt-5.6-terra",
    messages=[{"role": "user", "content": "コスト計算のテスト"}],
)
cost = completion_cost(completion_response=response)
print(f"このリクエストのコスト(ドル): {cost:.6f}")
Proxy経由なら計算済みの値がレスポンスヘッダーx-litellm-response-costに入って返ります。入出力を別々に見たいときはcost_per_token、モデル一覧の単価と最大トークン数を一括で見たいときはmodel_costを使います。
2. 誰がいくら使ったかを集計する
Proxyは各リクエストをLiteLLM_SpendLogsテーブルへ書き込みます。記録されるのはAPIキーのハッシュ・内部ユーザー・チームID・リクエストタグ・エンドユーザー・model_group・api_base・spend・トークン数、そしてフォールバックが何回走ったかまでです。集計の入口は次の3つです。
| 用途 | エンドポイント | 備考 |
|---|---|---|
| チーム別・顧客別のレポート | GET /global/spend/report |
group_by=team/group_by=customerを指定。Enterprise機能として記載 |
| ユーザーの日次内訳 | GET /user/daily/activity |
件数は支出ログ由来で、上流への再試行も1件ずつ数える |
| 明細を機械的に取る | GET /spend/logs/v2 |
ページング対応(1ページ最大1,000件)。旧/spend/logsは直近10,000件で打ち切られる |
単価が登録されていないモデルはspend = 0で記録されますが、黙って0円になるのではなく、プロキシログにWARNINGが出て、Prometheusカウンターlitellm_zero_cost_requests_totalがmissing_pricing_keyなどの理由ラベル付きで増えます。ここを監視対象に入れておけば、請求と集計のズレに気付けます。モデル別の可視化やアラート設計はAIエージェントのコスト監視|トークン可視化と暴走対策とLLM可観測性の実装ガイドも合わせて読んでください。
3. 単価表そのものの挙動(litellm_model_cost_map_url)
LiteLLMの単価表は起動時にGitHubのmainからmodel_prices_and_context_window.jsonを取得し、失敗するとパッケージ同梱のバックアップに黙って落ちる設計でした。公式のインシデントレポート「Invalid model cost map on main」(2026年2月10日公開・発生は1月27日・約20分・Severity Low)では、不正なJSONがmainに入った結果、古いパッケージの利用者が新しいモデルのコスト追跡を失っています。LLM呼び出しとルーティングには影響しません(単価表はリクエスト経路の外で、レスポンス後のtry/catchの中にあるため)。
| 環境変数 | 既定値と効果 |
|---|---|
LITELLM_MODEL_COST_MAP_URL |
単価表の取得先。既定はGitHub mainのmodel_prices_and_context_window.json |
LITELLM_LOCAL_MODEL_COST_MAP |
既定False。Trueにすると同梱ファイルのみを使い、起動時と/reload/model_cost_mapでのリモート取得を止める |
閉域運用や再現性を重視する環境ではLITELLM_LOCAL_MODEL_COST_MAP=Trueで固定し、新モデルを足すときだけ明示的に更新するのが安全側です。
4. 安く済ませる(cost optimization)
公式サイトがコスト最適化として挙げているのは、プロバイダー・リージョン・キーをまたぐロードバランシング、要求を満たせる最安デプロイへのルーティング、Auto Routerによる難易度別の振り分け、Redis/S3/GCSを使う応答キャッシュとセマンティックキャッシュ、プロンプト圧縮です。キャッシュ側の設計はプロンプトキャッシュ比較2026|3大LLMのコスト最適化戦略とセマンティックキャッシュ実践ガイド、モデル振り分けの判断軸はモデルルーティング設計ガイドが対応します。
プロンプトキャッシュを使うときの注意は、入力が各プロバイダーの最小トークン数に届かないと黙ってスキップされることです。公式docsの当日表記では、OpenAIは1,024トークン、Anthropicはモデルによって512/1,024/4,096トークン、Google Geminiは1,024トークンで、エラーは返りません。効いたかどうかは応答のcache_creation_input_tokensで確認します。モデルが対応しているかの判定はlitellm.utils.supports_prompt_caching()です(litellm直下ではなくlitellm.utils)。
# Anthropic / Gemini 系は cache_control でキャッシュ対象を明示する
from litellm import completion
from litellm.utils import supports_prompt_caching

print(supports_prompt_caching(model="anthropic/claude-sonnet-5"))

response = completion(
    model="anthropic/claude-sonnet-5",
    messages=[
        {
            "role": "system",
            "content": [
                {
                    "type": "text",
                    "text": "長い共通プロンプト(ここをキャッシュする)",
                    "cache_control": {"type": "ephemeral"},
                }
            ],
        },
        {"role": "user", "content": "この関数をレビューしてください"},
    ],
)
print(response.usage)
Bedrockでは同じcache_control表記をLiteLLMがBedrock固有のcachePoint形式へ自動変換するため、コード側の書き換えは不要です。
routing_strategyの選び方|5つの戦略と公式推奨
litellm routing_strategyで最初に知るべきは、選択肢の一覧ではなく公式が本番で推奨しているのは既定のsimple-shuffleだけという点です。公式docsのRouterページ(2026年9月27日取得)は「We recommend using simple-shuffle (default) for best performance in production」と書き、usage-based系については「Redis操作で大きなレイテンシが乗るため本番には推奨しない」と警告を出しています。
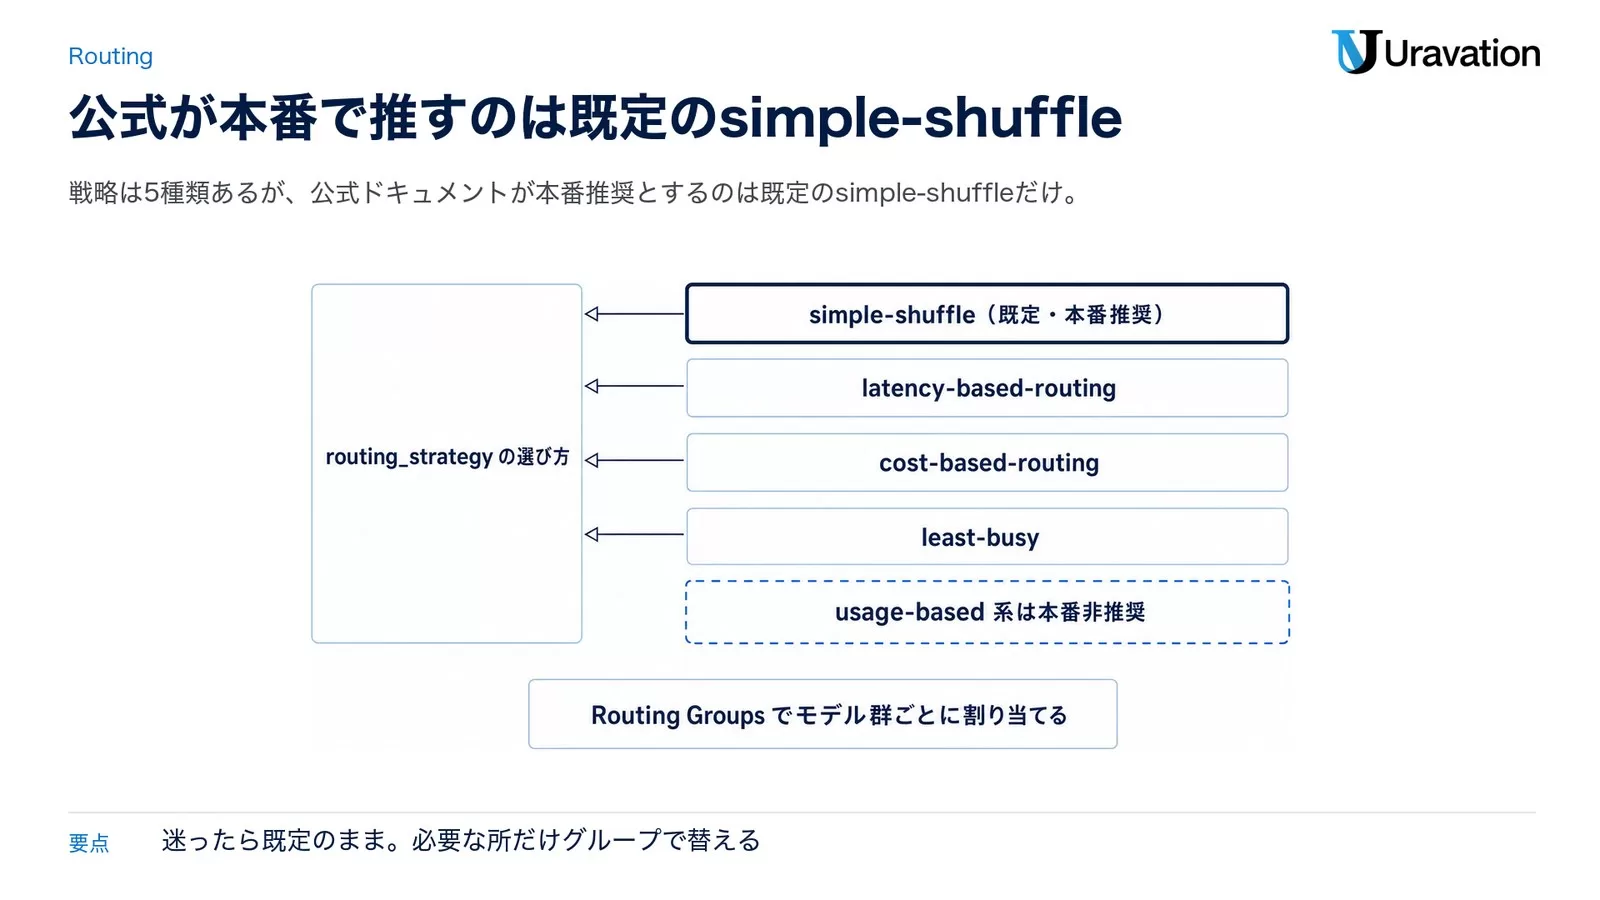
routing_strategy |
挙動 | 公式の位置づけ |
|---|---|---|
simple-shuffle |
各デプロイのrpm/tpm/weightに応じた重み付き抽選(指定がなければランダム) |
既定・本番推奨。オーバーヘッド最小 |
latency-based-routing |
直近の応答時間が短いデプロイへ。ttlとlowest_latency_bufferで調整 |
レイテンシ重視の用途向け |
usage-based-routing-v2 |
TPM/RPM上限を超えたデプロイを除外し、その分のTPM使用量が最小のデプロイへ(Redis前提) | 非同期実装。ただし本番非推奨の注意書きあり |
usage-based-routing |
v2の旧実装 | 同上 |
least-busy |
同時処理中のリクエストが最も少ないデプロイへ | バースト平準化向け |
cost-based-routing |
単価表またはinput_cost_per_token/output_cost_per_tokenで最安デプロイを選ぶ(単価不明は1ドル扱い) |
非同期。バッチ的な処理向け |
| カスタム | set_custom_routing_strategy()で自作クラスを差す |
公式に手順あり |
モデルごとに戦略を変える(Routing Groups)
「レイテンシ重視のモデルと、安さ重視のモデルを1つのルーターに同居させたい」ときは、ルーターを2つ立てるのではなくRouting Groupsを使います。グループはそれ自体がモデル名として呼べて、/v1/modelsにも出るため、ゲートウェイからモデルを発見するクライアント(公式docsはClaude CodeのCLAUDE_CODE_ENABLE_GATEWAY_MODEL_DISCOVERY=1やCodexを例示)のピッカーにも現れます。
# config.yaml:モデル群ごとに戦略を割り当てる
router_settings:
  routing_strategy: simple-shuffle   # グループに属さないモデルの既定
  routing_groups:
    - group_name: anthropic-latency
      models: ["claude-sonnet-5"]
      routing_strategy: latency-based-routing
      routing_strategy_args:
        ttl: 3600
    - group_name: cheap-batch
      models: ["cheap-model"]
      routing_strategy: cost-based-routing
ルールは公式docsに明記されています。1つのmodel_nameが属せるグループは1つだけ(重複は初期化時にValueError)、グループ名を既存のmodel_nameやmodel_group_aliasと衝突させると設定読み込みが失敗する、アクセス権はグループ名を独立したモデル名として扱う(メンバーへの権限はグループの権限を含まない)、defaultという名前は予約済み。支出ログにはグループ名がmodel_groupとして残り、実際に応答したメンバーのデプロイも行ごとに記録されます。
リトライとフォールバック
# config.yaml:公式docsに実在するキーだけで組んだ冗長化設定
router_settings:
  num_retries: 3
  allowed_fails: 3        # 1分あたりの許容失敗数。超えるとクールダウン
  cooldown_time: 30       # クールダウン秒数
  fallbacks:
    - {"claude-sonnet-5": ["gpt-5.6-terra"]}
  context_window_fallbacks:
    - {"claude-sonnet-5": ["gpt-5.6-terra"]}
  content_policy_fallbacks:
    - {"claude-sonnet-5": ["my-fallback-model"]}
  default_fallbacks: ["gpt-5.6-terra"]
  retry_policy:
    AuthenticationErrorRetries: 0
    NotFoundErrorRetries: 0
    TimeoutErrorRetries: 2
    RateLimitErrorRetries: 3
    ContentPolicyViolationErrorRetries: 3
    BadRequestErrorRetries: 1
    ServiceUnavailableErrorRetries: 2
    DefaultRetries: 1
num_retriesは4か所(リクエストボディ、model_listのlitellm_params、litellm_settingsなど)に書けて優先順位が決まっており、公式docsは「num_retriesはLiteLLM自身のリトライループで、プロバイダーSDKのmax_retriesとは別の設定」「二重適用でリトライが掛け算になり、1リクエストが想定外の回数で上流を叩くのを防ぐため」と説明しています。ここを混同したまま両方に3を入れると、障害時に上流へ想定外の負荷をかけます。
litellm sqliteの答え|必要なのはPostgreSQLで、SQLiteは非対応
litellm sqliteへの答えははっきりしています。2026年9月27日時点のリポジトリschema.prismaはprovider = "postgresql"のみを指定しており、SQLiteをデータストアとして使う記述は公式ドキュメントにもありません。本番デプロイガイドも「PostgreSQL:キー・チーム・ユーザー・支出ログ・設定を保持/プロキシの認証と追跡機能に必須」「Redis:レート制限・ルーター状態・インスタンス横断のキャッシュ/インスタンスを2台以上にしたら必須」と書いています。
# 公式デプロイガイドが挙げるコア設定(抜粋)
DATABASE_URL="postgresql://user:password@host:5432/litellm"
LITELLM_MASTER_KEY="sk-..."      # ゲートウェイの管理キー
LITELLM_SALT_KEY="sk-..."        # DB内の資格情報を暗号化する。一度決めたら変更しない
DISABLE_SCHEMA_UPDATE="true"     # マイグレーションは専用ジョブに任せる
STORE_MODEL_IN_DB="True"         # モデル管理をAdmin UI側で行う
LITELLM_SALT_KEYはモデルを登録した後にローテーションできません(DBに保存したプロバイダー資格情報を復号できなくなる)。最初に強いランダム値を生成し、クラウドのシークレットマネージャーへ入れておきます。
では「DBなしで動かせないのか」というと、OpenAI互換APIだけなら動きます。ただし公式docsが明示している制約があり、Admin UIからのモデル管理・仮想キー・支出追跡は使えず、litellm_settings.max_budgetは上限として機能しません(全体支出の読み出しにDBクライアントが必要で、合計が不明なままグローバル予算チェックが発火しないため)。「予算上限を入れたつもりで入っていない」という事故はここから起きます。
Rust版ゲートウェイと本番構成|2026年に変わった点
2026年のLiteLLMで最大の構造変化は、ゲートウェイのホットパスをPythonからRustへ移していることです。GitHubリポジトリの説明文も2026年9月27日時点で「The fastest, litest AI Gateway. Rust core with Python SDK」に変わっています。
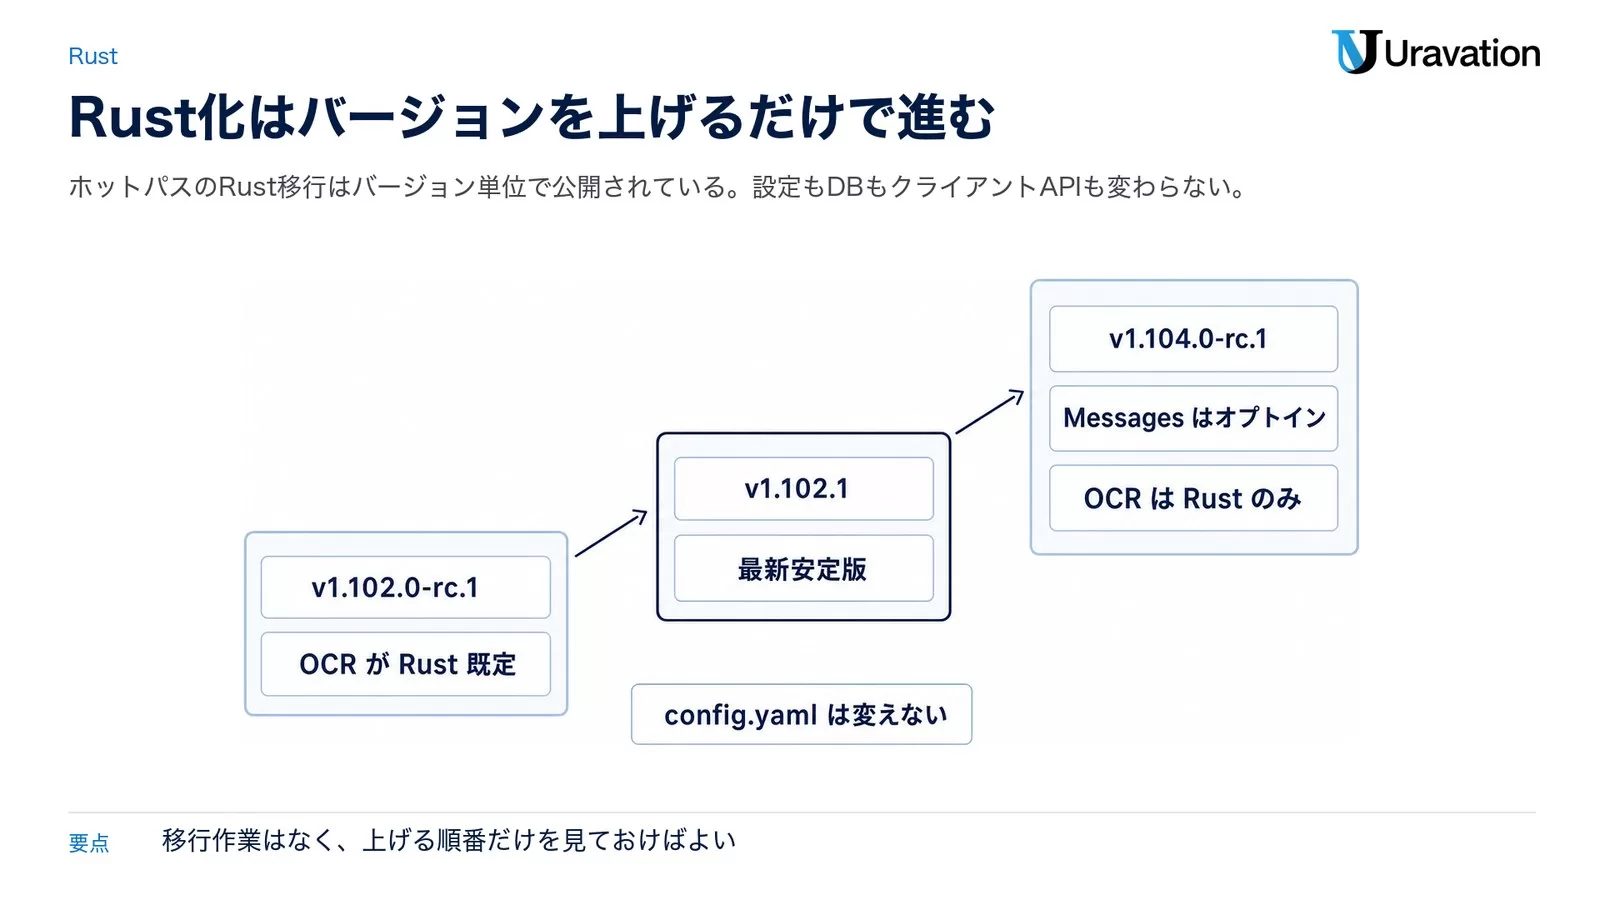
移行の進み方はバージョン単位で公開されています。v1.102.1の時点では「OCRがRust既定(全プロバイダー・v1.102.0-rc.1/2026年9月13日から)」まで完了し、次のv1.104.0-rc.1で「Anthropic Messagesがオプトイン」「OCRはRustのみ」に進みます。公式は「v2ではない・書き換えではない・config.yamlもDBもクライアントAPIも変えない」と繰り返しており、移行はバージョンを上げるだけです。
| ゲートウェイ | p99の追加レイテンシ | アイドル時メモリ |
|---|---|---|
| LiteLLM(Rust・ベータ) | 約0.7ミリ秒 | 21.8MB |
| Portkey | 約2.3ミリ秒 | 90.4MB |
| Bifrost v1.6.4 | 約4.5ミリ秒 | 199.1MB |
| LiteLLM(Python v1) | 約257.7ミリ秒 | 329.5MB |
出典は公式ブログ「Benchmarking the LiteLLM Rust AI Gateway」(2026年7月22日)で、計測はAIGatewayBench、上流は各ゲートウェイ共通のローカルモックです。公式サイトのトップは同じ枠組みでp99 0.66ミリ秒・アイドル時約22MB・毎秒2,800リクエスト以上(CPU使用率約21%)という数値を掲げています。ここは読み方に注意が必要で、公式自身が「ベンダー自身が回したベンチマークである」「ローカルモック相手なので絶対値は現実の応答時間ではない」「ロギング・支出追跡・永続化を無効にした転送経路だけの比較」「1ホスト・試行の誤差幅なし」と断っています。1回のチャット応答ではモデルのレイテンシに埋もれる差で、効くのは埋め込み・分類・ガードレールのような高頻度呼び出しと、1タスクで何十ターンも回すエージェントループです。またRustゲートウェイは2026年9月27日時点でベータ(docsのナビゲーションも「[Beta] Rust AI Gateway」表記)です。
本番構成そのものは2通りが公式に定義されています。1つのイメージがLLMトラフィックと管理APIとUIを兼ねるモノリシック(Helmチャートの既定)と、ゲートウェイ(4000番)・バックエンド(4001番)・UI(3000番)を別々にスケールさせるマイクロサービス構成です。公式イメージはghcr.io/berriaiに公開されdocker.litellm.ai/berriaiにミラーされており、PostgreSQLを伴うモノリシック構成ではPrismaツールチェーンを同梱するghcr.io/berriai/litellmを使い、latestではなくバージョンタグで固定するよう明記されています。全イメージはcosignで署名されています。
セキュリティ|2026年3月のPyPI混入と、公開済み脆弱性の扱い方
LiteLLMは全社のLLMキーが集まる場所なので、脆弱性の扱いは機能選定と同じ重さで見る必要があります。2026年3月24日、公式ブログ「Security Update: Suspected Supply Chain Incident」が公開され、PyPI上のlitellm 1.82.7と1.82.8に資格情報を盗むコードが混入していたことが報告されました。公式の記載は次のとおりです。
- 該当パッケージは2026年3月24日10:39 UTCから約40分間PyPIで公開され、PyPIによって隔離された
- v1.82.7は
proxy_server.pyに悪性ペイロード、v1.82.8はさらにlitellm_init.pthを含んでいた - 混入の起点はCI/CDのセキュリティスキャンで使っていたTrivy依存だと考えられている
- 公式のProxy Dockerイメージを使っていた利用者は影響を受けていない(
requirements.txtで依存を固定しており、該当PyPIパッケージを使わない経路のため) - 3月30日にCI/CD v2パイプラインで再構築したクリーンなv1.83.0が公開された
この事案はGitHubのアドバイザリデータベースにもGHSA-5mg7-485q-xm76(critical・2026年3月25日公開・影響範囲1.82.7以上1.82.8以下)として登録されています。確認と復旧の手順も公式に載っているものだけを引用します。
# 1) 入っているバージョンを確認する(SDK。Proxyはベース URL でバージョン表示を見る)
pip show litellm

# 2) 混入ファイルの有無を調べる(パスは自分の Python に合わせる)
find /usr/lib/python3.13/site-packages/ -name "litellm_init.pth"
該当版を動かした環境では、公式は「LiteLLMの環境から見えていた資格情報はすべて漏れたものとして扱い、APIキー・クラウドのアクセスキー・DBパスワード・SSH鍵・Kubernetesトークン・環境変数や設定ファイルの秘密をローテーションする」よう求めています。litellm_init.pthが見つかった場合は削除し、ホストの追加侵害を調査します。CI/CDのジョブ履歴やDockerビルドまで遡って確認することも明記されています。
単発の事案だけでなく、恒常的なパッチ追従も必要です。リポジトリのセキュリティアドバイザリは2026年9月27日時点で14件公開されており、内訳はcritical 3件・high 5件・medium 4件・low 2件、最新は2026年8月26日公開の2件(user_configパラメーター経由のSSRFと、リクエストボディのルーティングパラメーターを検証していなかったことによるSSRF/プロバイダー資格情報の流出)です。過去にはプロキシのAPIキー検証におけるSQLインジェクション(critical・2026年4月)、Hostヘッダーインジェクションによる認証バイパス(critical・2026年5月)も公開されています。いずれも修正版が出ているため、運用上の結論は「最新の安定版に追従し、バージョンタグで固定して計画的に上げる」に尽きます。自ホスト型を選ぶということは、この更新責任を自分が引き受けるという意味でもあります。
既存の手段との位置関係
「LiteLLMを入れるべきか」は、比較対象を並べると判断しやすくなります。2026年9月27日時点の各公式情報にもとづく整理です。
| 手段 | 置き場所 | 得意 | 弱い・注意 |
|---|---|---|---|
| LiteLLM Proxy(自ホスト) | 自社インフラ | キーの一元管理・チーム別予算・支出ログ・監査・閉域運用 | PostgreSQLとRedisの運用、脆弱性追従を自分が負う |
| LiteLLM Python SDK | アプリのプロセス内 | すぐ入る。プロバイダー差の吸収だけが目的なら十分 | 組織横断のキー管理・予算統制はできない |
| OpenRouter | 他社SaaS | サーバー運用が不要。すぐ多モデルに届く | 推論トラフィックが外部を通る。自社の監査ログ要件と相談 |
| 自前ラッパー | 自社コード | 要件に完全一致させられる | 新モデル追随・フォールバック・支出集計を全部自作することになる |
| LangChainなど | アプリのフレームワーク層 | チェーン・エージェントの組み立て | 役割が違う。LiteLLMは下のモデル接続層で、ChatLiteLLMで併用できる |
# LangChain から LiteLLM を使う(公式 docs/langchain の当日表記)
from langchain_community.chat_models import ChatLiteLLM
from langchain_core.messages import HumanMessage

chat = ChatLiteLLM(model="claude-sonnet-5", temperature=0.3)
print(chat.invoke([HumanMessage(content="AIエージェントの設計パターンを教えてください")]).content)
エージェント層の設計まで踏み込む場合はLetta完全ガイド2026|記憶を持つAIエージェントをPythonで実装、ログ基盤側はLangfuse実装ガイドが対応します。
触ってみる最短手順(公式ドキュメント記載のコマンドのみ)
2026年9月27日時点の公式Docker Quick Startは、設定ファイルを書かずにゲートウェイとPostgreSQLを立ち上げる形になっています。以下は公式記載のコマンドそのままです。
# 1) compose ファイルを取得し、必須の2キーを生成する
curl -sSLO https://github.com/BerriAI/litellm/raw/main/docker/docker-compose.quickstart.yml
printf 'LITELLM_MASTER_KEY=sk-%snLITELLM_SALT_KEY=sk-%sn' "$(openssl rand -hex 32)" "$(openssl rand -hex 32)" > .env

# 2) 起動(ゲートウェイは 4000 番、Postgres が同時に立つ)
docker compose -f docker-compose.quickstart.yml up -d
http://localhost:4000/uiを開く。ユーザー名はadmin、パスワードは.envのLITELLM_MASTER_KEY- Models + Endpoints の Add Model タブでプロバイダーとモデルを選び、プロバイダーのAPIキーを入れる。Test Connect で疎通を確認してから Add Model(キーを環境変数で持ちたい場合は
os.environ/OPENAI_API_KEYと入力する) - Playground でテスト送信。Get Code ボタンで同じ呼び出しのコードが出る
- Virtual Keys で配布用のキーを作る(表示は1回だけ)
- アプリからはOpenAI互換として叩く
# 3) 仮想キーでゲートウェイを呼ぶ
curl http://localhost:4000/v1/chat/completions \
  -H 'Authorization: Bearer sk-<your-virtual-key>' \
  -H 'Content-Type: application/json' \
  -d '{"model": "gpt-5.6-terra", "messages": [{"role": "user", "content": "Hello from LiteLLM"}]}'
DBを立てずに「OpenAI互換APIだけ」欲しい場合は、設定ファイルを渡して単体イメージを動かす経路も公式に載っています。
# DB なし運用(Admin UI のモデル管理・仮想キー・支出追跡は使えない)
docker run \
  -v $(pwd)/litellm_config.yaml:/app/config.yaml \
  -e OPENAI_API_KEY=<your-openai-key> \
  -e LITELLM_MASTER_KEY=sk-<paste-a-long-random-key> \
  -p 4000:4000 \
  docker.litellm.ai/berriai/litellm:latest \
  --config /app/config.yaml
コーディングエージェント側から使う手順も公式にあります。CLIを入れてlite configureを実行し、Claude CodeまたはCodex(公式はCodexはstable 0.129.0以降と記載)にゲートウェイURLと仮想キーとモデル名を登録する形です。設定ファイルの細部やその他のインストール方法は公式ドキュメントを参照してください。
# LiteLLM CLI を入れてエージェントを接続する
curl -fsSL https://raw.githubusercontent.com/BerriAI/litellm/main/scripts/install-cli.sh | sh

export LITELLM_PROXY_API_KEY="sk-your-virtual-key"
lite configure
  --gateway-url https://your-proxy.example.com
  claude
  --api-key "$LITELLM_PROXY_API_KEY"
  --model smart-router
よくある失敗パターン5選
失敗1:モデル名のprefixを省略する
# ❌ NG:プロバイダーが特定できない書き方
completion(model="claude-sonnet-5", messages=[...])

# ⭕ 正解:公式docsどおり prefix を付ける
completion(model="anthropic/claude-sonnet-5", messages=[...])
失敗2:SQLiteで済ませようとする/DBなしで予算上限を入れたつもりになる
# ❌ NG:DB を用意せず max_budget だけ書く(上限として機能しない)
litellm_settings:
  max_budget: 100.0

# ⭕ 正解:PostgreSQL を接続する(SQLite は非対応)
# 環境変数側
# DATABASE_URL="postgresql://user:password@host:5432/litellm"
# LITELLM_MASTER_KEY="sk-..."
# LITELLM_SALT_KEY="sk-..."   # 後から変更できない
失敗3:レイテンシ要件のある本番でusage-based系を選ぶ
公式docsはusage-based-routing系について「Redis操作で大きなレイテンシが乗るため本番には推奨しない。高トラフィックでは既定のsimple-shuffleを使うこと」と警告しています。TPM/RPMの分散が本当に必要なら、enable_pre_call_checks: trueとrpm/tpm指定を併用したsimple-shuffleから検討します。
# ⭕ 公式推奨の出発点
router_settings:
  routing_strategy: simple-shuffle
  enable_pre_call_checks: true
  redis_host: <your-redis-host>
  redis_port: <your-redis-port>
  redis_password: <your-redis-password>
失敗4:フォールバック先をmodel_listに登録し忘れる
# ❌ NG:fallbacks の行き先が model_list に存在しない
router_settings:
  fallbacks:
    - {"claude-sonnet-5": ["gpt-5.6-terra"]}

# ⭕ 正解:行き先も model_list に登録する
model_list:
  - model_name: claude-sonnet-5
    litellm_params:
      model: anthropic/claude-sonnet-5
      api_key: os.environ/ANTHROPIC_API_KEY
  - model_name: gpt-5.6-terra        # 行き先
    litellm_params:
      model: openai/gpt-5.6-terra
      api_key: os.environ/OPENAI_API_KEY
失敗5:バージョンをlatestで運用する
公式デプロイガイドは「latestや動くタグではなくバージョンタグで固定し、ロールバックを決定論的にする」と明記しています。2026年3月のPyPI混入事案や継続的に公開されるアドバイザリを踏まえると、固定したうえで計画的に上げるのが唯一の運用です。イメージはcosignで署名されているので、検証手順も公式のDocker Image Security Guideに従えます。
よくある質問
LiteLLMとは何ですか?
100以上のLLMプロバイダーをOpenAI形式の統一インターフェースで呼べるOSSのAIゲートウェイです。Pythonライブラリ(SDK)としても、OpenAI互換のHTTPエンドポイントを自ホストするProxy(AI Gateway)としても使えます。開発元はBerriAIで、GitHubスターは59,690(2026年9月27日時点)です。
LiteLLMの料金はいくらですか?
OSS版は0円です(公式プラン表記は「$0 Free forever」)。費用として実際に発生するのは各LLMプロバイダーの従量課金と、自ホストするインフラ(PostgreSQL・Redis・コンテナ)の運用費です。Enterpriseプランの金額は2026年9月27日時点で公式に記載がなく、問い合わせと30日間のトライアルキー申込のみが公開されています。
LiteLLMが対応しているサービスは?
公式サイトの表記では140以上のプロバイダー・1,892種類のモデルです。OpenAI・Anthropic・Google Vertex AI/AI Studio・AWS Bedrock・Azure OpenAI・Groq・Ollama・Deepseek・xAIなどがopenai/のようなprefixで指定できます。Chat Completions以外にEmbeddings・画像生成・音声・OCRなどの経路も公式ドキュメントに用意されています。
LiteLLM ProxyとPython SDKはどちらを使うべきですか?
プロバイダー差の吸収だけが目的で利用者が自分だけならSDKで十分です。複数チームが使う、キーを配りたくない、チーム別に予算を切りたい、支出を監査したい——このどれかが要件に入った時点でProxyです。Proxyへ移す際、アプリ側の変更はbase_urlと仮想キーの差し替えだけで済みます。
routing_strategyは何を設定すればいいですか?
まず既定のsimple-shuffleのままにしてください。公式docsが本番で推奨しているのはこれだけです。レイテンシ最重視の機能だけlatency-based-routing、バッチ処理だけcost-based-routingにしたい場合は、ルーターを増やすのではなくRouting Groupsでモデル群ごとに戦略を割り当てます。
LiteLLMはSQLiteで動きますか?
いいえ。2026年9月27日時点のschema.prismaはprovider = "postgresql"のみで、SQLiteは非対応です。DBを用意しないままでもOpenAI互換APIとしては動きますが、Admin UIからのモデル管理・仮想キー・支出追跡は使えず、litellm_settings.max_budgetも上限として機能しません。
LiteLLMのJevは何に使えて、いくらかかりますか?
JevはTypeSafe AIの判定モデルで、LiteLLMではAuto Routerの分類器(classifier_type: jev)として、またパススルー(/typesafe/v1/systemone)として使えます。料金は100万入力トークンあたり0.042ドル(1ドル150円換算で約6.3円)で出力課金はありません。提供開始はv1.103.0-rcで、ダッシュボードのTest Routingでも分類分の課金が発生する点に注意してください。
LiteLLMとLangChainの違いは何ですか?
層が違います。LangChainはチェーンやエージェントを組み立てるアプリ側のフレームワーク、LiteLLMはその下でモデル接続・ルーティング・キー管理・コスト記録を担うゲートウェイです。langchain_community.chat_modelsのChatLiteLLMを使えば併用でき、LangChain側のコードを変えずにモデルだけ入れ替えられます。
脆弱性が心配です。どのバージョンを使えばいいですか?
2026年9月27日時点の最新安定版はv1.102.1です。PyPIのv1.82.7/v1.82.8は資格情報を盗むコードが混入した版として公式に公表されており、使ってはいけません(公式Docker Proxyイメージ経由の利用者は影響なしと公表されています)。公開済みのアドバイザリは14件あり、いずれも修正版が出ているため、バージョンタグで固定しつつ最新の安定版へ計画的に追従してください。
まとめ:今日やる3つ
- いま入っているバージョンを確認する:
pip show litellmとProxyのバージョン表示を見て、v1.82.7/v1.82.8を踏んでいないか、v1.102.1からどれだけ離れているかを把握する - routing_strategyを見直す:
cost-basedやusage-basedを本番の全トラフィックに当てているなら、既定のsimple-shuffleへ戻し、必要な機能だけRouting Groupsで切り出す - コストの数字が取れているか確かめる:
x-litellm-response-costが返っているか、litellm_zero_cost_requests_totalが増えていないか、単価表の取得がLITELLM_LOCAL_MODEL_COST_MAPで固定されているかを点検する
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Getting Started|LiteLLM公式ドキュメント(参照日: 2026-09-27)
- Router – Load Balancing(routing_strategy・Routing Groups・retry_policy)(参照日: 2026-09-27)
- Spend Tracking|LiteLLM公式ドキュメント(参照日: 2026-09-27)
- Production Deployment(PostgreSQL・Redis・イメージのタグ固定)(参照日: 2026-09-27)
- Docker Quick Start|LiteLLM公式ドキュメント(参照日: 2026-09-27)
- Auto Router [Add-on]|LiteLLM公式ドキュメント(参照日: 2026-09-27)
- TypeSafe Jev on LiteLLM(2026年9月20日・料金と使い方)(参照日: 2026-09-27)
- JEV Classifier: 5.43x as Fast as Haiku, 96% Lower Cost(2026年9月20日)(参照日: 2026-09-27)
- Benchmarking the LiteLLM Rust AI Gateway(2026年7月22日)(参照日: 2026-09-27)
- Rust Migration Impact by Version(v1.102.1時点の対応範囲)(参照日: 2026-09-27)
- Security Update: Suspected Supply Chain Incident(2026年3月)(参照日: 2026-09-27)
- Incident Report: Invalid model cost map on main(2026年2月10日)(参照日: 2026-09-27)
- Prompt Caching(対応プロバイダーと最小トークン数)(参照日: 2026-09-27)
- BerriAI/litellm|GitHub(スター数・schema.prisma・リリース)(参照日: 2026-09-27)
- GHSA-5mg7-485q-xm76|Two LiteLLM versions published containing credential harvesting malware(参照日: 2026-09-27)
- LiteLLM Enterprise(プラン内容・価格は問い合わせ制)(参照日: 2026-09-27)
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。LiteLLMを含むLLMゲートウェイの設計から本番運用まで、実務ベースでサポートします。
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー10万人超。100社以上の企業向けAI研修・導入支援。著書累計3万部突破。SoftBank IT連載7回執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談は お問い合わせフォーム からお気軽にどうぞ。