2026年11月5日時点で、Moonshot AI は Kimi K3.1 Pro の重みを Hugging Face の moonshotai/Kimi-K3.1-Pro に公開しています(リポジトリの作成は 2026年11月2日 04:13 UTC。Hugging Face の API で確認)。ライセンスは「Kimi K3.1-Pro License」で、利用・複製・改変・第三者への提供・販売・ファインチューニングを無償で認める一方、Model as a Service(モデルを API などで第三者に提供する事業)を営む事業者への売上の条件と、大規模な商用製品での「Kimi K3.1-Pro」の表示義務が付きます。社内だけで使う場合はこの 2 つの条件の対象外です。自社で動かすには、96 個の safetensors で合計約 1.56 TB の重みを置けるストレージと、モデルカードが推奨する vLLM・SGLang・TokenSpeed のいずれかの推論エンジン、そして各エンジンのレシピが示す構成(vLLM の基準は B300 の 1 ノード=GPU 8 枚か、GB300 のトレイ 2 台)が要ります。
この記事は、Hugging Face のモデルカード・LICENSE・ファイルの一覧・config.json、Moonshot AI の公式ブログと API の文書、推奨エンジンのレシピを 2026年11月5日時点で確認し、公式の文書で確かめた範囲だけを書いています。私たちは重みをダウンロードしておらず、動かしてもいません。API で十分な人と、自社で動かす人の分かれ目は次の 3 行です。
- API で十分: 従量で小さく始めたい。データは学習に使われないと公式ヘルプにあり、Zero Data Retention(入出力を保持しない扱い)も API の顧客向けに用意されている。
- 自社で動かす: データを社外のサーバーに出せない、モデルの版を自分で固定したい、独自にファインチューニングしたい。1.56 TB の重みと GPU 8 枚級以上の機材を持てる。
- その中間: Moonshot が検証結果を公開している第三者のホスト事業者を使う。機材を持たずに重み版を使える。
この記事の要点(2026年11月5日時点)
- 重みは 2026年11月5日時点で Hugging Face の moonshotai/Kimi-K3.1-Pro に公開済み(リポジトリの作成は 2026年11月2日 UTC)。同意のクリック(gated)は設定されておらず、ModelScope にも同名のリポジトリがある。
- ライセンスは Kimi K3.1-Pro License。無償で使え、条件は「表示の保持」「MaaS 事業者の売上 2,000 万ドル超で別契約」「月間 1 億ユーザー超か月売上 2,000 万ドル超の製品で『Kimi K3.1-Pro』の表示」の 3 つ。社内利用と、Moonshot の公式製品・認定パートナー経由の利用は売上と表示の条件の対象外。
- 重みは 96 ファイル・約 1.56 TB。MXFP4 の重みと MXFP8 の活性化で学習時から量子化済み(モデルカード)。
- 推奨の推論エンジンは vLLM・SGLang・TokenSpeed。vLLM のレシピの基準は B300 の 1 ノード(GPU 8 枚)か GB300 のトレイ 2 台、AMD は MI355X の 1 ノード。
- API は 100 万トークンあたり入力 2.00 ドル・出力 10.00 ドル(kimi-k3.1-pro・税抜き)。Highspeed 版は Kimi.ai・Kimi Work・Kimi Code・Kimi API で提供され、その重みは Hugging Face の moonshotai の一覧(11月5日時点・20 件)に無い。
対象読者:オープンウェイトのモデルを自社の環境で動かすかを検討している開発者・情報システム担当者。
読み終えたらできること:ライセンスの 3 つの条件と対象外の定めに自社が当たるかを判定し、API・ホスト事業者・自社で動かすの 3 択を、費用の考え方・データの置き場・更新・運用の手間で比べられます。
そもそも重みの公開とは|公開された物の一覧
重みとは、学習で決まったモデルのパラメータ(数値)のファイルです。重みが公開されると、誰でもダウンロードして自分の機材で推論を動かし、ファインチューニング(追加の学習)もできます。API は、同じモデルを Moonshot AI のサーバーで動かし、呼び出した分だけ払う形です。なお「オープンウェイト」は「オープンソース」と同じではありません。今回のリポジトリにあるのは重み・設定・推論用の Python コード・トークナイザで、学習データや学習の手順は含まれていません(ファイルの一覧で確認)。公開された物は次の 5 つに分けられます。
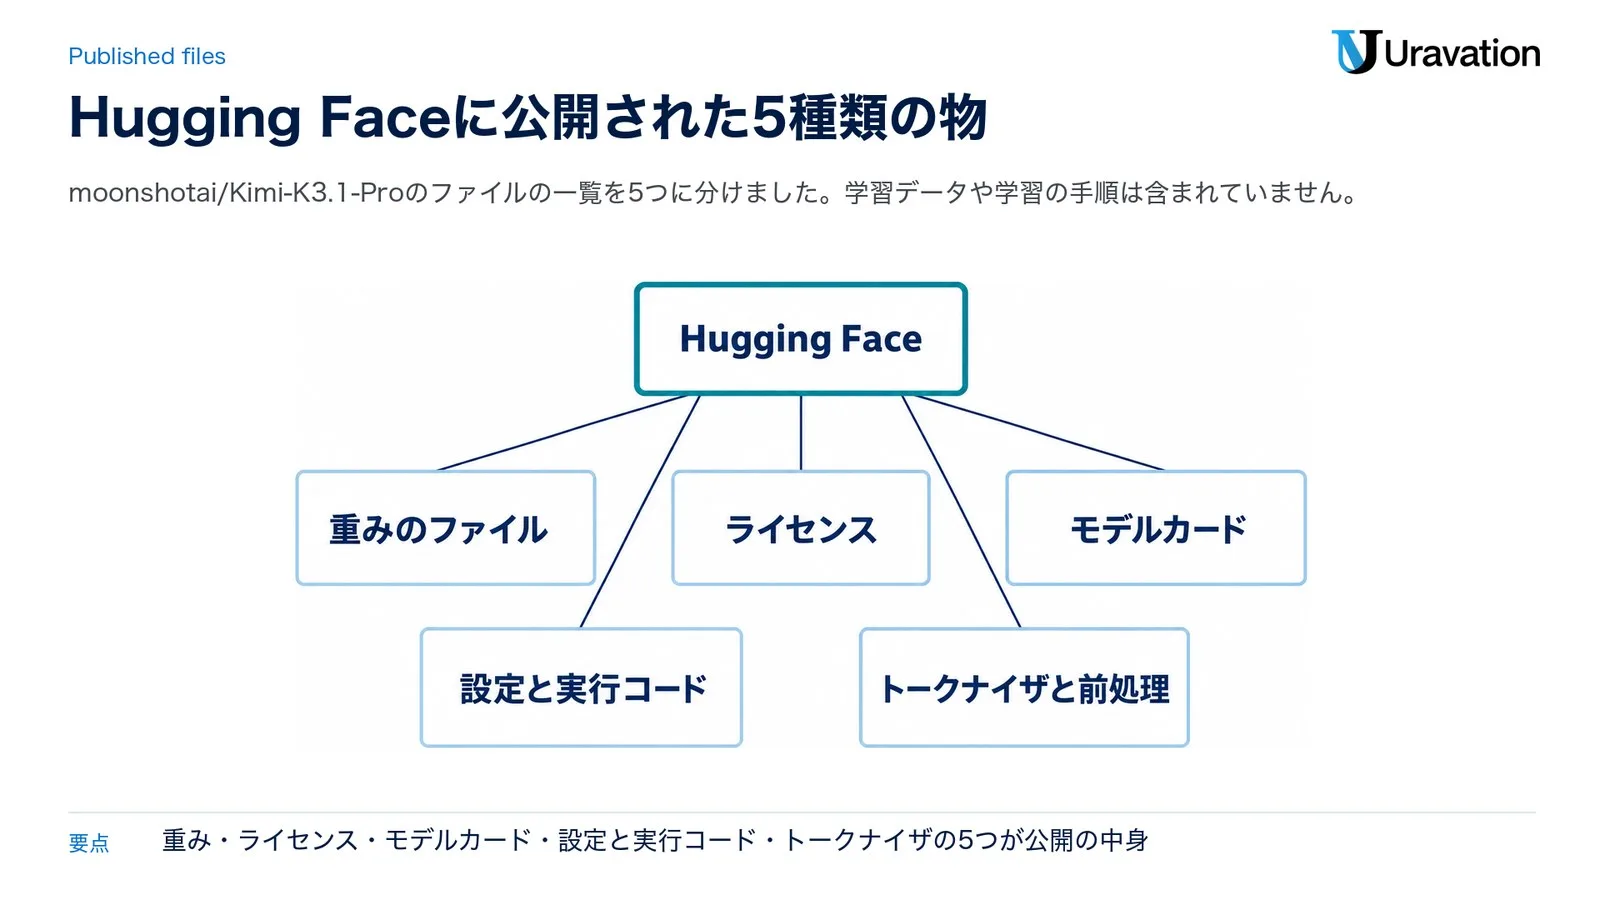
| 項目 | 内容(2026年11月5日時点) | 出典 |
|---|---|---|
| 重みのファイル | model-00001〜00096-of-000096.safetensors の 96 個。合計 1,561,293,160,568 バイト(約 1.56 TB。2 進の表示では約 1.42 TiB)。リポジトリ全体では約 1.56 TB・113 項目 | Hugging Face のファイルの一覧(API) |
| ライセンス | LICENSE(Kimi K3.1-Pro License・3,077 バイト)。メタデータは license: other・license_name: kimi-k3.1-pro | LICENSE・モデルカードの冒頭 |
| モデルカード | README.md。モデルの概要、構成の表、ベンチマーク、推奨エンジン、使い方の例、ライセンスへのリンク | README.md |
| 設定と実行コード | config.json(architectures: KimiK31ForConditionalGeneration・model_type: kimi_k31・max_position_embeddings: 1048576・量子化は compressed-tensors の mxfp4-pack-quantized)と、configuration_kimi_k3.py・kimi_k3_processor.py などリポジトリ同梱の Python コード(タグ custom_code) | config.json・ファイルの一覧・Hugging Face の API のタグ |
| トークナイザと前処理 | tiktoken.model(約 2.8 MB)・tokenization_kimi.py・tokenizer_config.json・preprocessor_config.json・画像処理の Python コード | ファイルの一覧 |
Hugging Face の API では、pipeline_tag が image-text-to-text(画像とテキストの入力)、library_name が transformers、gated(同意のクリック)が false、private が false です。公式ブログ(Kimi K3.1 Pro Tech Blog)は「Full model weights will be released by Nov 4, 2026.(重みは 2026年11月4日までに公開する)」と書いており、11月2日の作成はその予告の範囲内です。ブログの本文は 11月5日時点でもこの予告の文のままで、重みを公開したことを知らせる別の公式の文は、私たちが確かめた範囲では見つけられませんでした。モデルカードの同じ README は ModelScope の moonshotai にもリンクしており、ModelScope の API でも同名のリポジトリを確認できました。一方、kimi-k3.1-pro-highspeed(公式ブログで「K3.1 Pro の 2〜3 倍の速さ」。Kimi.ai・Kimi Work・Kimi Code・Kimi API で提供)の重みは、Hugging Face の moonshotai の一覧(11月5日時点・20 件)にはありません。
Kimi K3.1 Pro License の読み方|商用・表示・MaaS の条件
ライセンスは英文で 52 行の短い文書です。冒頭で「use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software; to run, deploy, fine-tune, or otherwise modify the Software and create derivative works」を無償で許諾し、そのうえで次の条件を置いています(LICENSE 原文・2026年11月5日取得)。「Software」には重み・パラメータ・設定ファイル・推論と学習のコード・付属文書が含まれると定義されています。
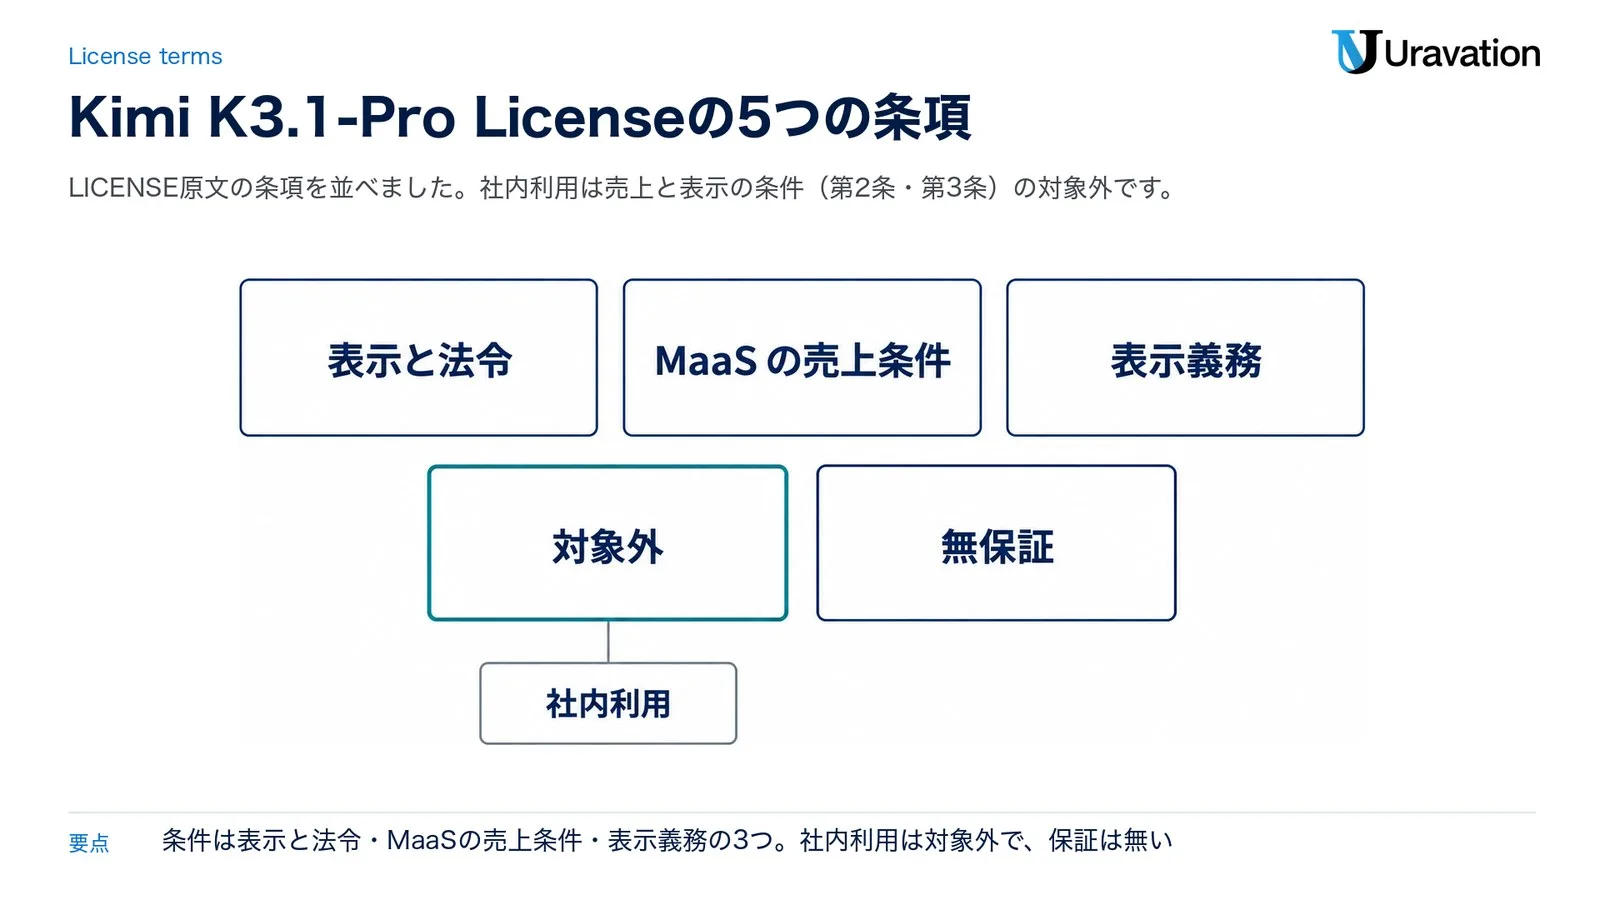
| 条項 | 原文の要旨(訳) | 誰に関係するか |
|---|---|---|
| 第 1 条 表示と法令 | 著作権表示とこの許諾文を、複製と実質的な部分のすべてに含める。利用は適用される法令に従う | 全員。改変版や派生モデルを他者に渡す時も表示を残す |
| 第 2 条 MaaS の売上条件 | 「Model as a Service」=第三者に推論やファインチューニングへのアクセス(例: API)を与え、その第三者が入力・パラメータ・学習データを実質的に制御できる形。(a) 特定の機能やハーネスに能力を組み込んだだけのエンドユーザー製品、(b) 他者がホストするモデルへの単なる中継は含まない。本人か関連会社のいずれかが MaaS 事業を営み、本人と関連会社の売上の合計が連続する 12 か月で 2,000 万米ドル(相当額)を超える場合は、商用目的で使う前に Moonshot AI と別の契約を結ぶ | 推論の API を売る事業者。製品に組み込むだけの会社は定義上 MaaS に当たらない |
| 第 3 条 表示義務 | Software や派生物を使った商用の製品・サービスが、月間アクティブユーザー 1 億人超か、月売上 2,000 万米ドル(相当額)超なら、「Kimi K3.1-Pro」をそのユーザーインターフェースに目立つ形で表示する | 大規模な製品を持つ会社。しきい値未満なら表示義務は無い |
| 第 4 条 対象外 | 第 2 条と第 3 条は、(a) 社内利用(Software・その出力・その能力を第三者に提供しない利用)と、(b) Moonshot AI の公式製品か認定された推論パートナー経由の利用には適用しない | 社内の業務だけで使う会社。API の利用者 |
| 第 5 条 無保証 | Software とその出力は「AS IS」(現状のまま)で提供され、商品性や特定目的への適合性を含むいかなる保証も無い。Moonshot AI と関連会社は損害の責任を負わない | 全員。品質の担保は使う側の責任 |
読み方のポイントは 3 つです。第一に、第 2 条の売上のしきい値は「本人と関連会社の売上の合計」で数え、MaaS 事業を営むのが本人でなく関連会社でも対象になります。第 3 条のユーザー数と月売上のしきい値は、Software を使った個々の商用の製品・サービスごとに見ます。MaaS の条件は製品への組み込みを除く定義になっています。第二に、第 4 条の「社内利用」は「出力や能力を第三者に提供しない」ことが条件なので、社内で作った出力を顧客向けサービスとして出す時は社内利用に当たらない可能性があります。第三に、出力を他のモデルの学習に使うことや、用途を制限する条項(いわゆる Acceptable Use Policy)は本文にありません。制限は「法令に従う」の一文だけです。問い合わせ先として license@moonshot.ai が示されています。
Kimi K3 の LICENSE と行ごとに比べたところ、違いは文書名の「Kimi K3 License」→「Kimi K3.1-Pro License」と、第 3 条で表示する名前の「Kimi K3」→「Kimi K3.1-Pro」の 2 か所だけで、条件そのものは同じでした。他社のオープンウェイトモデルのライセンスとの比べ方は、オープンウェイトモデル導入の落とし穴、ライセンス・蒸留・更新運用で表にしています。
自社で動かすのに要る物|容量・推論エンジン・GPU の構成
必要な物は、モデルカードの記載と、モデルカードがリンクする各推論エンジンの公式レシピに書かれた範囲で 4 つに整理できます。メモリの量や GPU の枚数は、公式の文に無い数字を推測で書きません。
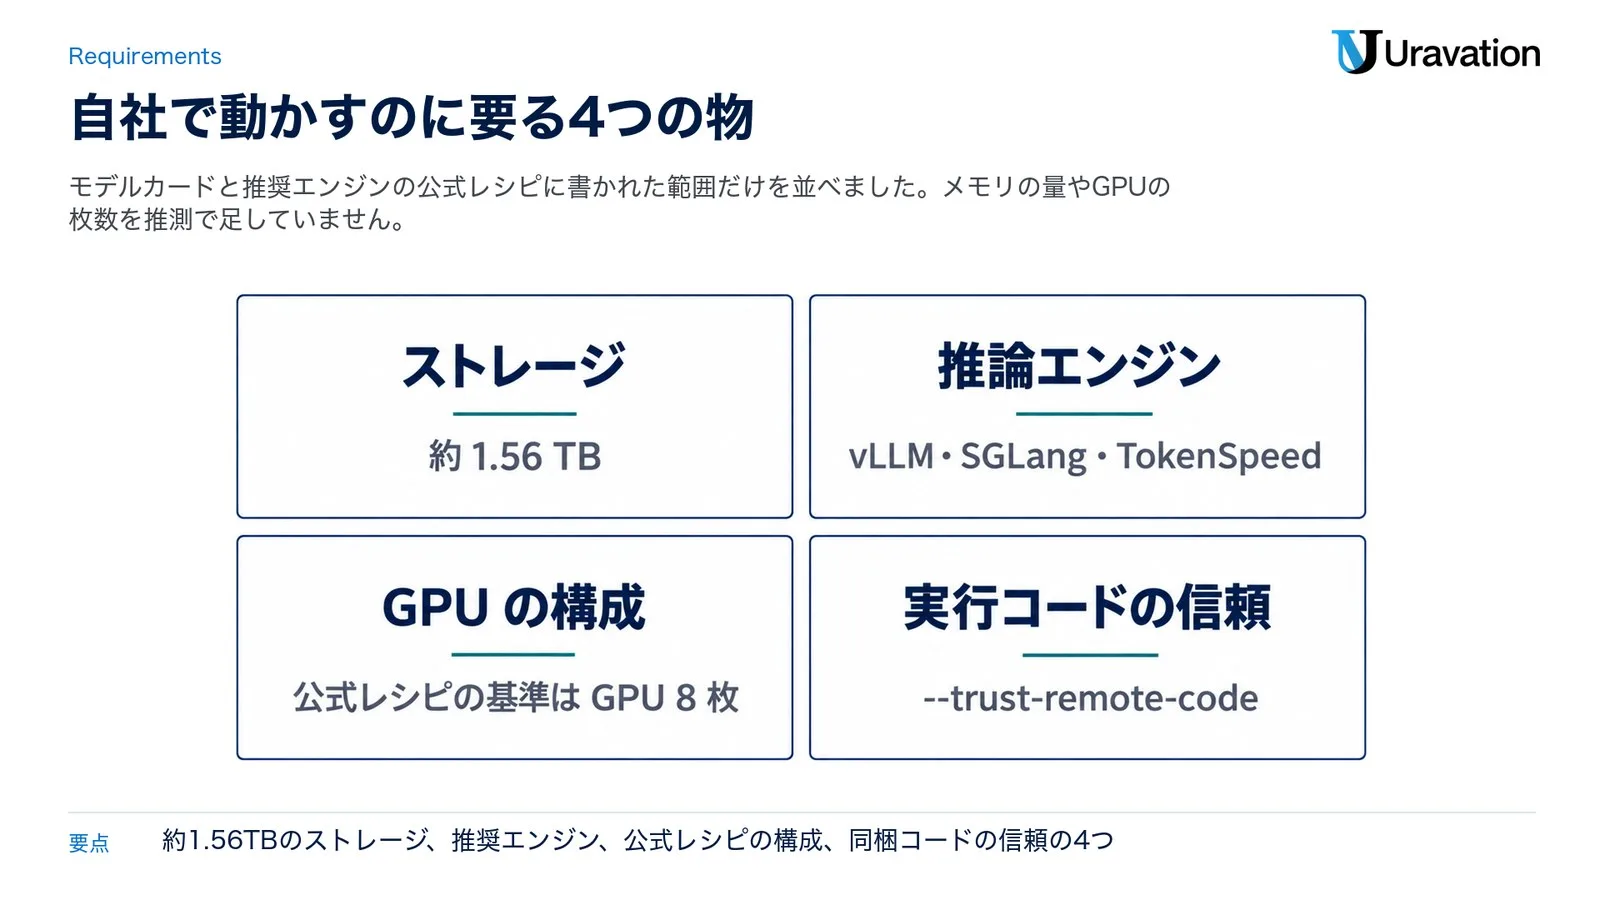
| 要る物 | 公式の文にある内容 | 出典 |
|---|---|---|
| ストレージ | 重みの 96 ファイルだけで約 1.56 TB。少なくともこの容量を置けるディスクが要る。モデルカードは「MXFP4 weights / MXFP8 activations(quantization-aware training)」と記載。vLLM のレシピは「ルーティングされるエキスパートの重みが MXFP4、それ以外は BF16」と説明 | ファイルの一覧・モデルカード 2. Model Summary・vLLM のレシピ |
| 推論エンジン | モデルカードの 4. Deployment and Availability が推奨するのは vLLM(レシピあり)・SGLang(クックブックあり)・TokenSpeed の 3 つ(TokenSpeed はモデルカードがレシピのページの K3.1 Pro の節にリンクしているが、11月5日に取得したそのページの Kimi の節は K2.5/K2.6 と K3 の 2 つだけで、K3.1 Pro の節は確かめられなかった)。SGLang は「kimi-k3.1-day-0 ブランチ」から提供し、専用の Docker イメージを案内。vLLM のレシピは vLLM 0.34.0 以降と表示 | モデルカード・SGLang のクックブック・vLLM のレシピ |
| GPU の構成(公式レシピ) | vLLM: 「MXFP4 のチェックポイントを TP8(テンソル並列=1 つのモデルを 8 枚の GPU に分けて動かす配置・--tensor-parallel-size 8)で、GB300 のトレイ 2 台か B300 の 1 ノード、または MI355X の 1 ノード」が基準構成(既定の表示は 4× GB300 NVL4 のマルチノード)。SGLang: GB300 はトレイ 2 台(2×4 GPU)、MI350X/MI355X は 8 GPU の 1 ノード。他の環境の配置は B200/GB200 が TP16・DCP16、H200 が TP16・EP16、H100 が TP32・EP32、TPU7x が TP32・EP8(クックブックはこれらを「placeholder」の形と呼び、検証中と注記)。vLLM は PPU(810E の 16 PPU ノード 2 台、M890 の 8 PPU ノード 4 台)も記載 | vLLM のレシピ・SGLang のクックブック「Recipe shapes」 |
| 実行コードの信頼 | リポジトリは独自の Python コード(custom_code)を同梱し、vLLM のレシピのコマンドは --trust-remote-code を付ける。会社で使うなら、どのコミット(11月5日時点の sha は 6d0a0202…)のコードを信頼するかを決めておく | Hugging Face の API・vLLM のレシピ |
公式レシピの流れは次のとおりです(手順は vLLM のレシピとモデルカードの記載の範囲。私たちは実行していません)。
- モデルカードの推奨エンジン(vLLM・SGLang・TokenSpeed)から 1 つ選び、そのレシピのページで自社の機材に合う構成(ハードウェア・配置)を確かめる(11月5日時点で K3.1 Pro の構成を確かめられたのは vLLM のレシピと SGLang のクックブック)。
- レシピが指定する版のエンジンかイメージを用意する(vLLM は 0.34.0 以降、SGLang は kimi-k3.1-day-0 ブランチか専用イメージ)。
- レシピのコマンドで vllm serve(または sglang serve)を起動する。vLLM の例は --trust-remote-code、--enable-auto-tool-choice、--tool-call-parser kimi_k3、--reasoning-parser kimi_k3 を付ける。
- 起動後は OpenAI 互換の /v1/chat/completions にリクエストを送る(レシピの Client usage の例)。
vLLM のレシピに載っている既定の起動コマンド(公式レシピの例・2 ノードの TP8)は次のとおりです。
export GLOO_SOCKET_IFNAME=$IFACE_NAME
export NCCL_SOCKET_IFNAME=$IFACE_NAME
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve moonshotai/Kimi-K3.1-Pro \
  --trust-remote-code \
  --tensor-parallel-size 8 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr $HEAD_IP \
  --load-format fastsafetensors \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
Ollama や LM Studio は、モデルカードの推奨エンジンには挙げられていません(11月5日時点・確かめた範囲)。1.56 TB という重みの容量からも、手元の PC で動かす対象ではなく、データセンター級の機材を前提にした公開です。
API・ホストされた版との比較|費用の考え方・データ・更新・運用
同じモデルを使う入口は、Moonshot の Kimi API、第三者のホスト事業者、自社で動かす重み版の 3 つです。ライセンスの第 4 条 (b) が「Moonshot AI の公式製品か認定された推論パートナー経由の利用」を第 2 条・第 3 条の対象外にしているので、入口の選び方はライセンスの読み方にも関わります。4 つの観点で並べます。
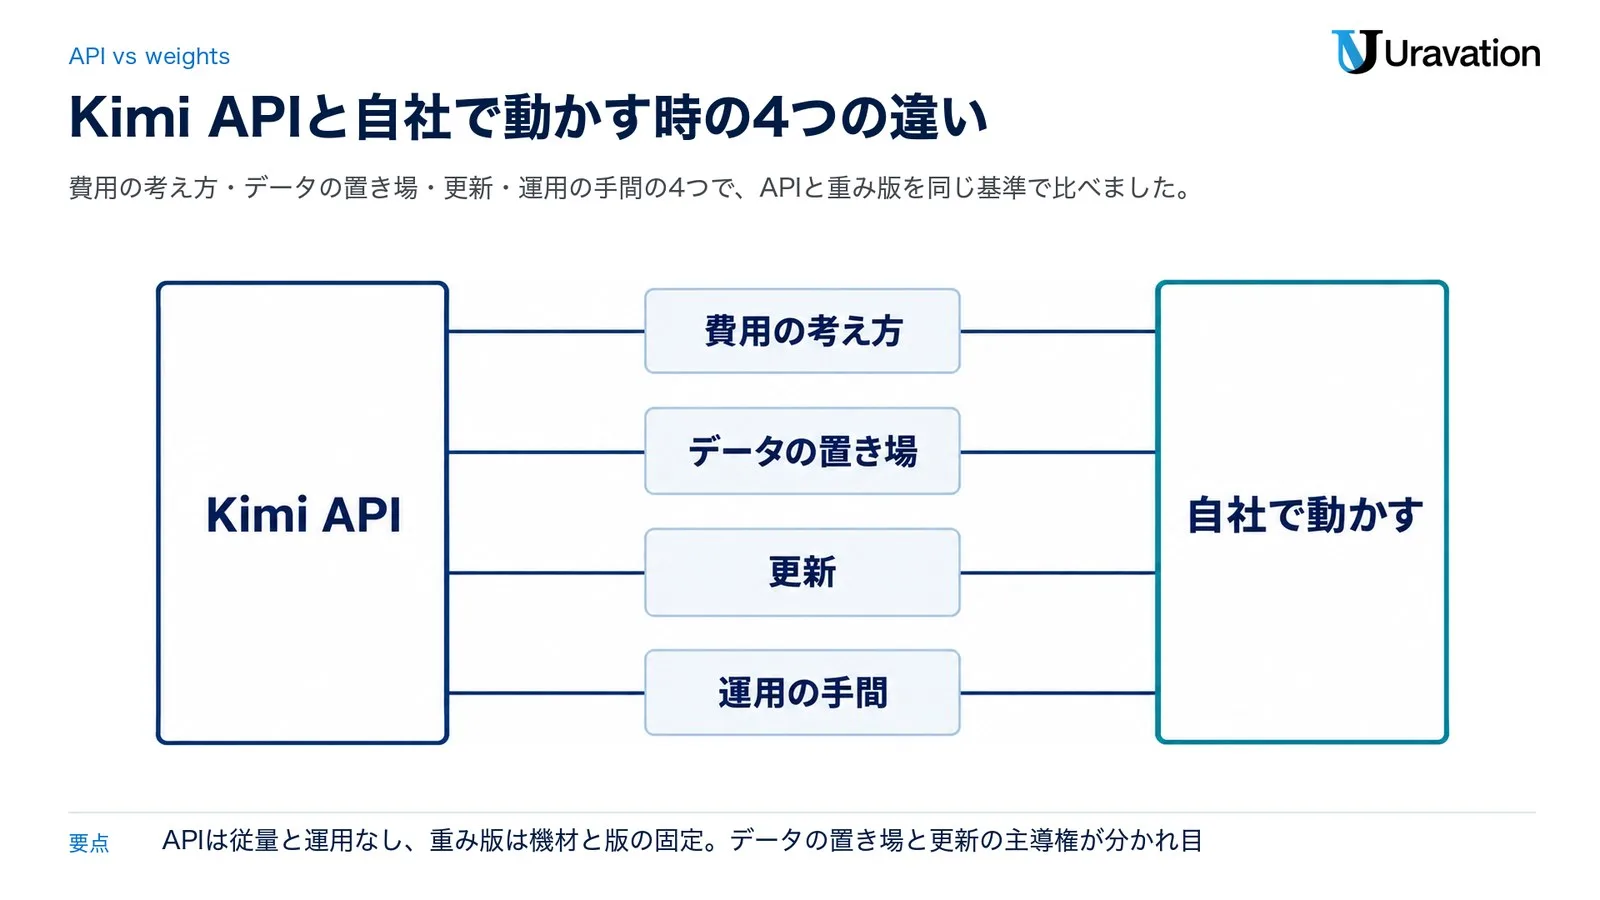
| 観点 | Kimi API | 自社で動かす(重み版) | 第三者のホスト事業者 |
|---|---|---|---|
| 費用の考え方 | 従量課金で定額プランは無い。100 万トークンあたり入力 2.00 ドル・出力 10.00 ドル(下の表)。K3.1 Pro は最低 1 ドルの入金で使える(公式クイックスタート「Access requirements」)。入金の累計でレート制限の段階が決まる | トークン課金は無く、機材・電力・人の費用に置き換わる。金額は構成次第で公式の数字は無い | 事業者ごとの料金。Moonshot の Kimi Vendor Verifier の K3.1 Pro の表には 11月5日時点で Baseten・DigitalOcean・Fireworks・Inferact・Modal・Nebius・Together・Verda の 8 社の検証結果が載る |
| データの置き場 | Moonshot のサーバーで処理。公式ヘルプは「API で送った入力と出力はモデルの学習や改善に使わない」「通信は HTTPS/TLS」「利用者ごとにデータを分離」と記載。公式ブログは API の顧客向けに Zero Data Retention を用意と記載 | 自社の機材から出ない。ログや入出力の保存は自社の設計次第 | 事業者の規約次第。ライセンス第 4 条 (b) の「認定された推論パートナー」に当たるかは事業者ごとに確かめる |
| 更新 | 提供側がモデルを入れ替える。例: K2 系は 2026年10月31日から新規登録者に提供されず、2026年12月末までに退役の予定(公式の料金ページ・モデル一覧) | 版を自分で固定できる。新しい重みへの切り替えは自社の判断と評価が要る | 事業者の提供状況次第 |
| 運用の手間 | サーバーの運用は不要。Highspeed 版、バッチ推論(標準価格の 60%)、自動のコンテキストキャッシュ、公式ツールなど、重み版には無い機能がある | エンジンの版・ブランチの追従、GPU の構成の調整、監視を自社で持つ。Highspeed 版の重みは Hugging Face の一覧に無い(11月5日時点) | サーバーの運用は不要。機能の対応は事業者ごと(Vendor Verifier が API の機能の適合も検証) |
API の単価は次のとおりです(公式の料金ページ・2026年11月5日取得・100 万トークンあたり・税抜き)。K3 系はいずれも 1,048,576 トークンのコンテキストで、コンテキストキャッシュは繰り返しのプレフィックスに自動で適用され、TTL(保持時間)の既定は 5 分です。
| モデル | 入力 | 出力 | キャッシュ済み入力 | キャッシュ書き込み 5 分 | キャッシュ書き込み 1 時間 |
|---|---|---|---|---|---|
| kimi-k3.1-pro | 2.00 ドル | 10.00 ドル | 0.20 ドル | 2.00 ドル | 4.00 ドル |
| kimi-k3.1-pro-highspeed | 4.00 ドル | 20.00 ドル | 0.20 ドル | 4.00 ドル | 8.00 ドル |
| kimi-k3 | 3.00 ドル | 15.00 ドル | 0.30 ドル | 3.00 ドル | 6.00 ドル |
K3 の API をエージェントから呼ぶ時の組み方は Kimi K3 APIエージェント開発ガイド に書いています。K3.1 Pro でも OpenAI 互換と Anthropic 互換の API(モデルカード 4. Deployment and Availability)を同じ形で呼べます。思考が常にオンで、reasoning_effort(low・high・max・既定 max)で深さを決める点も K3 と同じです(K3 の公式クイックスタートにも「K3 always has thinking mode enabled」とあり、K3 のモデルカード 6. Model Usage にも同じ記載があります)。
エージェントで使う時に確かめること|ツール呼び出し・コンテキスト・出力の形式
エージェントに組み込む前に確かめる点を、公式の文で確かめた範囲で 6 つ挙げます。重み版でこれらがそのまま使えるかは、推論エンジンの対応に依存します。
- ツール呼び出しの往復: マルチターンとツール呼び出しでは、API が返した assistant メッセージを reasoning_content と tool_calls を含めてそのまま messages に戻す(content だけを残すのは不可)。モデルカード 5. Model Usage と公式クイックスタートの両方に明記。vLLM のレシピは --tool-call-parser kimi_k3 と --reasoning-parser kimi_k3 を付けて起動する。
- tool_choice と動的なツールの読み込み: 最初のターンで tool_choice=”required” を指定すると、必ず 1 つ以上のツールを呼ぶ。ツール定義を content の無い system メッセージに置くと、その位置以降で使える(サーバーは保持しないので、後続のリクエストにも含める)。
- コンテキストと出力の長さ: コンテキストは 1,048,576 トークン(config.json の max_position_embeddings も同じ値)。API の max_completion_tokens は既定 131,072、最大 1,048,576。SGLang のクックブックは、1M の窓を出すのは High-Throughput(PP4 × PCP2)のプレフィルの構成だと記載。
- 固定のパラメータ: API では temperature=1.0、top_p=0.95、n=1、presence_penalty=0、frequency_penalty=0 が固定で、リクエストに書かない。SGLang のクックブックも「モデルが固定する値・サンプルコードに書かない」と注記。思考はオフにできず、長い時は reasoning_effort を low にする。
- 出力の形式: API は response_format に json_schema と strict: true を指定して message.content を制約できる。解析するのは content だけで reasoning_content は読まない。重み版で同じ制約を使えるかは推論エンジンの機能次第で、私たちは確かめられませんでした。
- 画像の入力: モデルカードの Modality は Text と Image。API では画像を公開 URL で渡せず、base64 か ms://<file-id> で渡し、content を配列にする。API の文書には動画ファイルの入力例もあるが、重み版で同じことができるかは確かめられませんでした。
モデルカードに載っている Python の例(公式の例。思考の内容を次のターンに保持する形)は次のとおりです。
import openai

def chat_with_preserved_thinking(client: openai.OpenAI, model_name: str):
    messages = [
        {"role": "user", "content": "Tell me three random numbers."},
        {
            "role": "assistant",
            "reasoning_content": "I'll start by listing five numbers: 473, 921, 235, 215, 222, and I'll tell you the first three.",
            "content": "473, 921, 235"
        },
        {"role": "user", "content": "What are the other two numbers you have in mind?"}
    ]
    response = client.chat.completions.create(
        model=model_name,
        messages=messages,
        stream=False,
        max_tokens=4096,
        reasoning_effort="max",
    )
    # the assistant should mention 215 and 222 that appear in the prior reasoning content
    print(f"response: {response.choices[0].message.reasoning}")
    return response.choices[0].message.content
公式クイックスタートは、Web 検索の公式ツールについて「更新中で、当面は本番の処理に使うことを勧めない」と書いています。検索を組み込む設計なら、この注記が外れるまで自前の検索ツールを使う前提で組みます。
会社で使う前に決めること|6 項目のチェック表
重み版を会社で使うかを決める時に、担当者が先に答えておく項目です。根拠はすべてこの記事の上の節に書いた公式の文です。
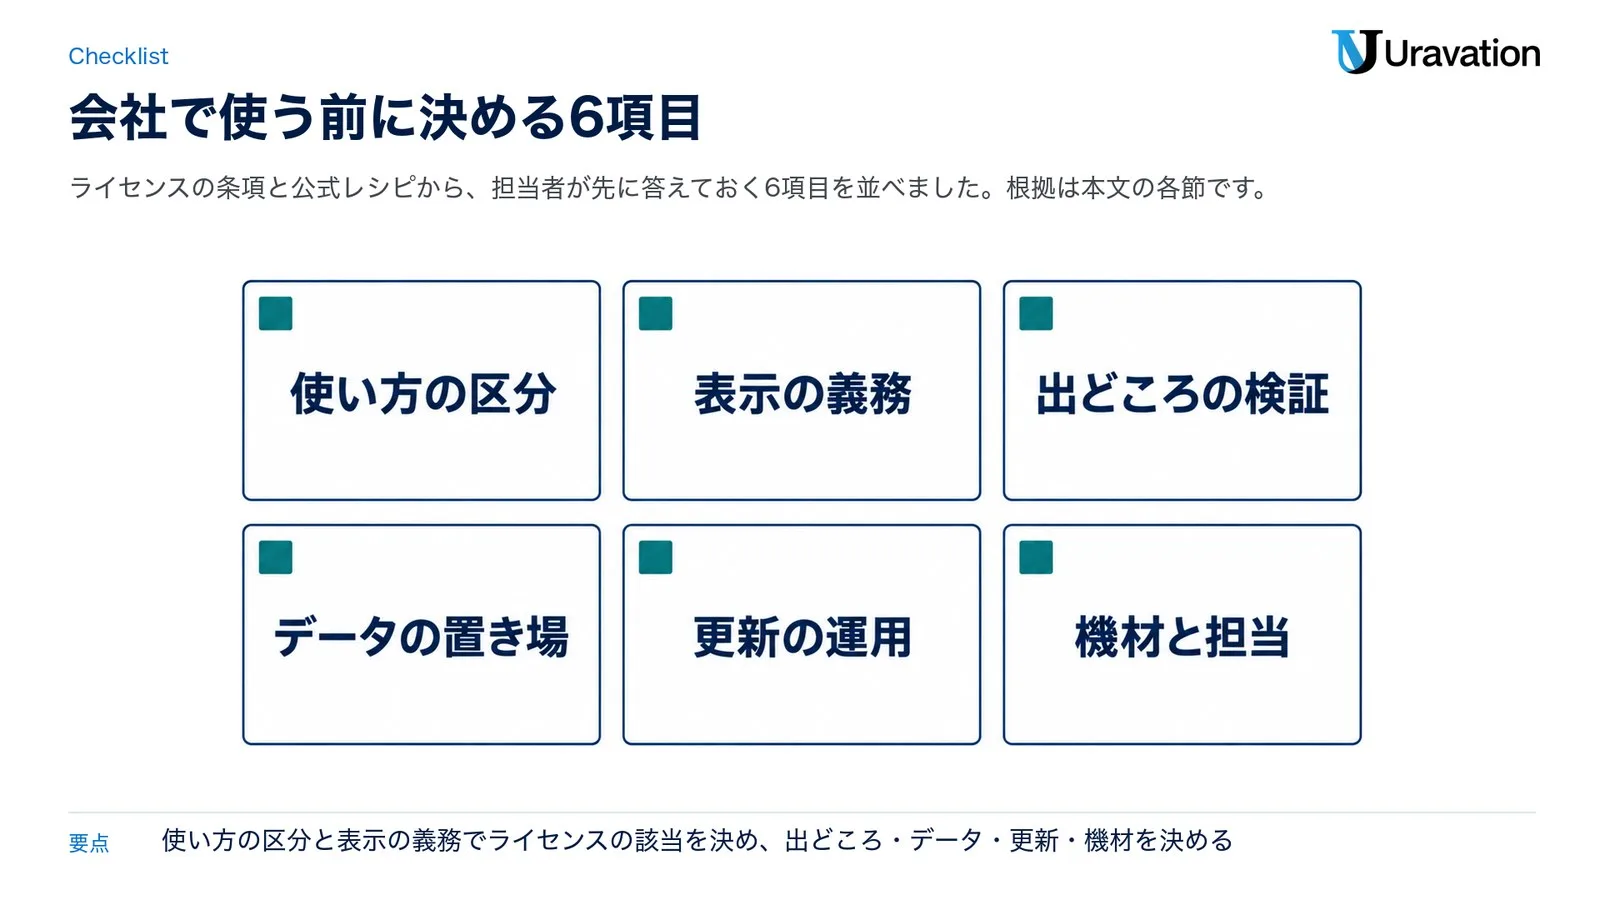
| 項目 | 決めること | 根拠 |
|---|---|---|
| 1. 使い方の区分 | 社内だけか、製品に組み込むか、推論を API として売るか。区分で第 2 条・第 3 条の該当が変わる | LICENSE 第 2 条・第 4 条 (a) |
| 2. 表示の義務 | Software や派生物を使った自社の商用の製品・サービスが、月間 1 億ユーザー超、または月売上 2,000 万米ドル超のしきい値に当たるか。当たるならその製品・サービスの UI に「Kimi K3.1-Pro」を表示する | LICENSE 第 3 条 |
| 3. 出どころの検証 | moonshotai/Kimi-K3.1-Pro のどのコミット(sha)を使うか決め、同梱の Python コードを読んでから --trust-remote-code を付ける。第三者が再公開した量子化版や変換版は別物として扱う | Hugging Face の API・vLLM のレシピ |
| 4. データの置き場 | API なら公式ヘルプの「学習に使わない」と Zero Data Retention の条件を契約で確かめる。重み版ならログと入出力の保存先を自社で設計する | 公式ヘルプ・公式ブログ |
| 5. 更新の運用 | 版を固定した上で、新しい重みが出た時に誰がどの評価セットで回帰を見るかを決める。API 側はモデルの退役がある(K2 系は 2026年12月末までに退役の予定) | 公式の料金ページ・モデル一覧 |
| 6. 機材と担当 | 公式レシピの構成(vLLM は B300 の 1 ノードか GB300 のトレイ 2 台か MI355X の 1 ノードが基準)を用意できるか。エンジンの day-0 ブランチや専用イメージを追える担当がいるか | vLLM のレシピ・SGLang のクックブック |
【要注意】読み違いやすい 4 点
重みの公開は「無料で何でもできる」と読まれがちです。公式の文に当たると、次の 4 点は読み違いです。
❌ 重みが公開された=誰でも何にでも無料で使える
⭕ 利用そのものは無償ですが、MaaS 事業者の売上の条件(連続する 12 か月で 2,000 万ドル超なら別契約)と、大規模な商用製品での「Kimi K3.1-Pro」の表示義務があります。社内利用と、Moonshot の公式製品・認定パートナー経由の利用はこの 2 つの対象外です。著作権表示と許諾文の保持は全員の義務です。
❌ 手元の PC や Mac で動かせる
⭕ 重みだけで約 1.56 TB あり、モデルカードの推奨エンジンのレシピは B300 の 1 ノード(GPU 8 枚)や GB300 のトレイ 2 台、MI355X の 1 ノード、H100 なら TP32・EP32(SGLang のクックブックが placeholder の形として示す値)といった構成です。手元の機材で動かすモデルを探すなら、ローカルLLMおすすめモデル10選と ローカルLLMをMac miniで動かす5手順で扱っている規模のモデルが対象です。
❌ 重み版を自分で動かせば API と同じ性能が必ず出る
⭕ Moonshot は、事業者ごとの提供がモデルの精度と API の機能の要件を満たすかを検証する Kimi Vendor Verifier を公開しています。K3.1 Pro の表では同じモデルでも事業者ごとに数値が異なり(例: BEAM(1M)は 0.3842〜0.3976)、推論エンジン・設定・ハードウェアで結果が変わる前提です。自社で動かす時も同じ検証を自分で持つ必要があります。
❌ Hugging Face の作成日 11月2日=公開日
⭕ Hugging Face のリポジトリの作成(最初のコミット)は 2026年11月2日 04:13(UTC)ですが、作成日時は public になった日時とは限らず、公開された日時は API では確かめられませんでした。公式ブログの予告は「11月4日までに」で、ブログの本文は 11月5日時点でも予告の文のままです。日付を社内の資料に書くなら「2026年11月5日時点で公開済み(リポジトリの作成は 11月2日 UTC)」のように、確かめた時点と作成日を分けて書きます。
私たちならこう判断する
日本の開発チームが K3.1 Pro を検討するなら、私たちは次の順で判断します。
第一に、まず Kimi API で試します(Vendor Verifier に載るホスト事業者を使うなら、その事業者が第 4 条 (b) の「認定された推論パートナー」に当たるかを先に確かめます)。ライセンス第 4 条 (b) により、Moonshot AI の公式製品経由の利用は MaaS の売上条件と表示義務の対象外なので判定を後回しにでき、公式ヘルプの「API のデータは学習に使わない」と Zero Data Retention の条件を契約で確かめれば、データの扱いの説明も社内でしやすいからです。
第二に、重み版に進むのは「データを社外のサーバーに出せない」「モデルの版を数年単位で固定したい」「独自にファインチューニングしたい」のどれかが明確な時だけにします。1.56 TB の重みと GPU 8 枚級以上の構成は、使う量が読めない段階で持つ機材ではありません。持つと決めたら、第 3 項の出どころの検証(コミットの固定と同梱コードの確認)と第 5 項の更新の運用を、機材の調達と同じ重さで決めます。
第三に、社内の資料には「ライセンスの条件は K3 と同じ(名前だけ違う)」「kimi-k3.1-pro の API の単価はどの項目も K3 の 3 分の 2」「Highspeed 版の重みは Hugging Face の moonshotai の一覧に無い」の 3 点を、取得日付きで書いておきます。どれも 2026年11月5日時点の公式の文で確かめられる事実で、更新があった時に差分を追いやすいからです。
よくある質問
Kimi K3.1 Pro の重みは商用利用できますか?
できます。Kimi K3.1-Pro License は利用・複製・改変・販売・ファインチューニングを無償で許諾しています。条件は、著作権表示と許諾文の保持、MaaS 事業者で連続する 12 か月の売上が 2,000 万米ドル超なら Moonshot AI との別契約、月間 1 億ユーザー超か月売上 2,000 万米ドル超の商用製品での「Kimi K3.1-Pro」の表示の 3 つで、社内利用と Moonshot の公式製品・認定パートナー経由の利用は売上と表示の条件の対象外です(2026年11月5日取得の LICENSE 原文)。
Hugging Face から誰でもダウンロードできますか?
2026年11月5日時点で、リポジトリは public で、同意のクリックを求める gated の設定は false です(Hugging Face の API)。ダウンロードの可否の条件が今後変わる可能性はあるので、取得の前にリポジトリのページで状態を確かめてください。96 個の safetensors で約 1.56 TB あります。
Ollama や LM Studio で動きますか?
モデルカードが推奨する推論エンジンは vLLM・SGLang・TokenSpeed の 3 つで、Ollama や LM Studio は挙げられていません(11月5日時点・確かめた範囲)。重みの容量が約 1.56 TB あり、公式レシピの構成はデータセンター級の GPU ノードなので、手元の PC で動かす前提のモデルではありません。
API の料金はいくらですか?
kimi-k3.1-pro は 100 万トークンあたり入力 2.00 ドル・出力 10.00 ドル・キャッシュ済み入力 0.20 ドル、kimi-k3.1-pro-highspeed は入力 4.00 ドル・出力 20.00 ドル、kimi-k3 は入力 3.00 ドル・出力 15.00 ドルです(公式の料金ページ・2026年11月5日取得・税抜き)。キャッシュ書き込みの単価は上の表のとおりで、バッチ推論は標準価格の 60%、K3.1 Pro は最低 1 ドルの入金で使えます。
Kimi K3 の重みと何が違いますか?
モデルカードの構成の表で違うのは注意層の構成で、K3 の「KDA 69 層と Gated MLA 24 層」が K3.1 Pro では「KDA 69 層と Gated DSA 24 層」になっています(長いコンテキストを効率よく扱うために、全注意(full-attention)の Gated MLA 層を Gated DeepSeek Sparse Attention 層に置き換えたとモデルカードが説明)。総パラメータ 2.8T、活性 104B、93 層、896 エキスパート中 16 を選択、コンテキスト 1,048,576、MXFP4 の量子化、MoonViT-V2 の視覚エンコーダは同じです。ファイルの合計容量もほぼ同じ(K3 は重みの 96 ファイルで 1,560,936,091,448 バイト・リポジトリ全体で 1,560,998,988,078 バイト)で、ライセンスは名前以外同じ文面です。K3.1 Pro は K3 を元に大規模な強化学習で事後学習した版です。
Highspeed 版の重みはありますか?
2026年11月5日時点で確かめられた範囲ではありません。kimi-k3.1-pro-highspeed は API のモデル一覧にある「同じ知能で約 2〜3 倍の速さ」の版で、Hugging Face の moonshotai の一覧(2026年11月5日時点・20 件)にその重みはありません。速さが要る場合は、Kimi API など Moonshot のサービスで Highspeed 版を使うことになります。
まとめ
Kimi K3.1 Pro の重みは 2026年11月5日時点で Hugging Face に公開されており(リポジトリの作成は 2026年11月2日 UTC)、ライセンスの条件は K3 と同じです。社内利用なら売上と表示の条件は掛からず、製品に組み込む会社は MAU 1 億・月売上 2,000 万ドルのしきい値を、推論を売る会社は 12 か月 2,000 万ドルの売上条件を見ます。自社で動かすには 1.56 TB のストレージと、公式レシピが示す GPU 8 枚級以上のノード、推奨エンジンの day-0 の版を追う体制が要ります。まずは API かホスト事業者で試し、データの置き場と版の固定が理由になった時だけ重み版へ進む。この順番が、2026年11月5日時点の公式の文から読める判断です。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- moonshotai/Kimi-K3.1-Pro(モデルカード README.md) — Moonshot AI・Hugging Face(参照日: 2026-11-05)
- Kimi K3.1-Pro License(LICENSE) — Moonshot AI・Hugging Face(参照日: 2026-11-05)
- config.json — Moonshot AI・Hugging Face(参照日: 2026-11-05)
- Hugging Face Hub API: moonshotai/Kimi-K3.1-Pro(作成日時・タグ・gated の状態)と ファイルの一覧(tree API) — Hugging Face(参照日: 2026-11-05)
- moonshotai/Kimi-K3(モデルカード)と Kimi K3 License — Moonshot AI・Hugging Face(参照日: 2026-11-05)
- Kimi K3.1 Pro Tech Blog: Advancing Open Intelligence — Moonshot AI(参照日: 2026-11-05)
- Kimi K3.1 Pro(API Quickstart) — Kimi API Platform(参照日: 2026-11-05)
- Model Inference Pricing — Kimi API Platform(参照日: 2026-11-05)
- Model List — Kimi API Platform(参照日: 2026-11-05)
- Reasoning Effort — Kimi API Platform(参照日: 2026-11-05)
- Best Practices for context caching — Kimi API Platform(参照日: 2026-11-05)
- Data processing & security(Kimi API) — Kimi Help Center(参照日: 2026-11-05)
- moonshotai/Kimi-K3.1-Pro | vLLM Recipes — vLLM Project(参照日: 2026-11-05)
- Kimi-K3.1-Pro – SGLang Documentation(Cookbook) — SGLang(参照日: 2026-11-05)
- Model recipes | TokenSpeed — LightSeek(参照日: 2026-11-05)
- Kimi Vendor Verifier(README) — Moonshot AI・GitHub(参照日: 2026-11-05)
- ModelScope: moonshotai — ModelScope(参照日: 2026-11-05)