朝会で「この問い合わせはどのサブエージェントに渡ったのか」を追い、同じ情報を何度も受け渡しているなら、そのルーターや領域別サブエージェントは減らす候補です。
残すかどうかは、①文脈の膨張で性能が測定可能に低下する、②独立した新しい文脈で並列に進め、終了後はその文脈を捨てられる、③単一エージェントではツールを正しく選べない、または指示が衝突する、という3条件で判断します。
2026年10月24日時点の結論は、サブエージェントを一括廃止せず、役割を1体ずつスキルとツールへ移して共通評価で比較し、品質が落ちるものだけを残すことです。
こうした症状は、モデルの能力不足ではなく、ルーターや受け渡しを増やした構成そのものから生じている場合があります。
AnthropicのDiane Sarkis氏が2026年10月22日に公開した「Building agents: When to fold subagents into your main agent loop」は、この問題を「サブエージェントを使うか、使わないか」の二択ではなく、測定しながら単一ループへ寄せる設計判断として整理しています。これは製品の公開案内ではなく、Claude Platformで企業向けエージェントを構築してきた経験に基づく設計指針です。
ここでは、Claude Platform、Claude Agent SDK、Claude Codeを使う日本の開発チーム向けに、残す3条件、戻す候補の見分け方、移行キットの使い方、単一ループに置く上限と書き込み関門までを整理します。数字や事例はAnthropicの一次情報で確認できた範囲に限定しています。
Anthropicの指針を表で読む
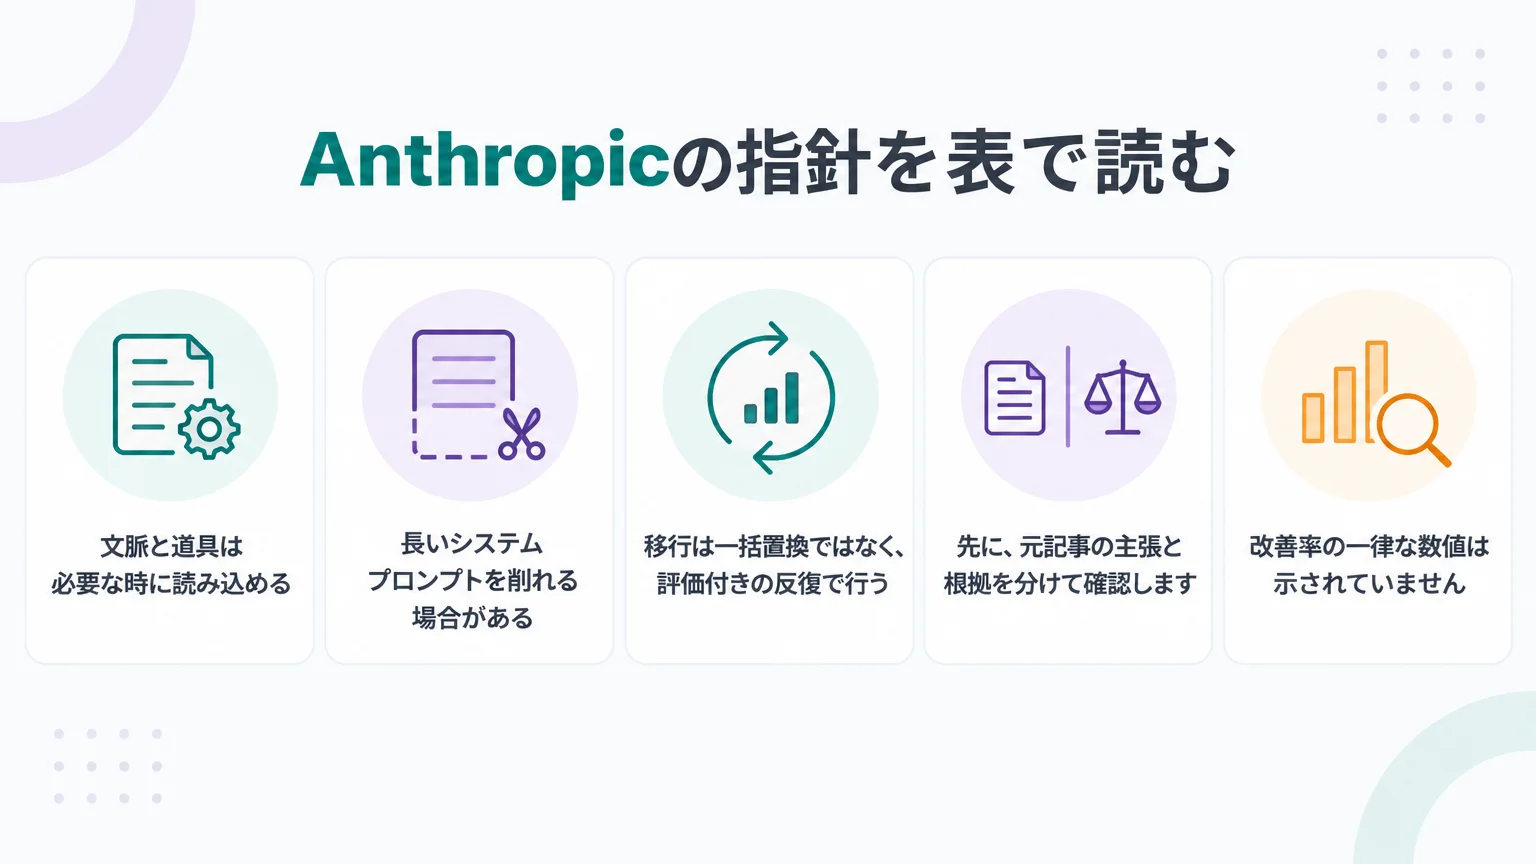
先に、元記事の主張と根拠を分けて確認します。重要なのは、Anthropicが「単一ループは常に優れている」とは書いていない点です。比較対象と条件をそろえ、サブエージェントを残す結果も認めるのが出発点です。
| 主張 | 根拠と条件 | 出典の節 |
|---|---|---|
| スキル付きの単一エージェントが有力な場合がある | Anthropicによると、複数の企業導入を比較した際、スキル付きの単一エージェントは、1つの長いプロンプトへ詰め込む構成とサブエージェント構成の双方を品質面で上回ることが多く、タスク当たりの費用と待ち時間も低い場合が多かったとされています。改善率の一律な数値は示されていません。 | 記事冒頭 |
| 複雑なマルチエージェント構成は待ち時間を増やし得る | ある顧客が自社のマルチエージェント基盤と単一ループを比較し、後者が前者より約2倍速く完了した事例です。1社の比較であり、一般的な速度差ではありません。 | Agent building failure modes for large organizations |
| 文脈と道具は必要な時に読み込める | スキルは起動時に名前と短い説明だけを読み、必要になった時に本文と参考資料を読み込みます。tool searchは遅延対象のツール定義を初期文脈へ載せず、必要時に検索して展開します。 | Using an agent loop with progressive disclosure |
| 長いシステムプロンプトを削れる場合がある | Anthropicによると、Claude Opus 5やClaude Fable 5のような高度なモデル向けClaude Codeで、システムプロンプトを80%以上削減しても、同社のコーディング評価では測定可能な性能低下がありませんでした。すべてのモデルや用途に当てはまる値ではありません。 | Using an agent loop with progressive disclosure/The new rules of context engineering for Claude 5 generation models |
| 移行は一括置換ではなく、評価付きの反復で行う | 小さなエンドツーエンド評価を用意し、1体ずつスキルとツールへ移し、同じ評価で比較します。移行後の得点が悪化するなら、そのサブエージェントを残します。 | How to fold subagents into the main agent loop |
したがって、「サブエージェントを減らす」は目標ではありません。目標は、品質、待ち時間、モデル呼び出し、トークン、費用、書き込みの安全性を同じ評価軸で見て、構成に根拠を持たせることです。
サブエージェントを残す3条件
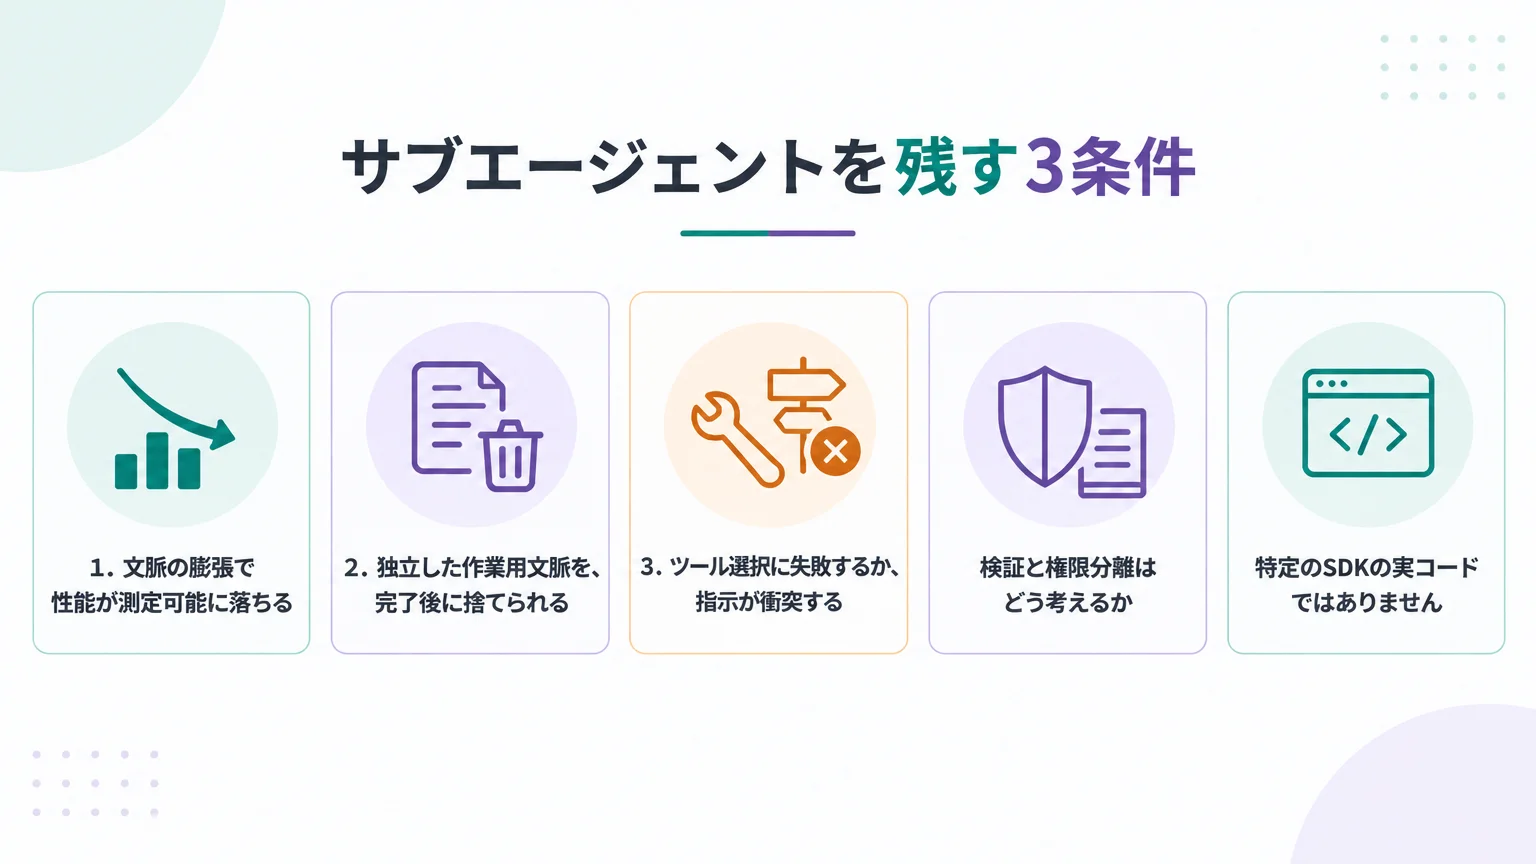
元記事は、サブエージェントを残す場面を3つに絞っています。次のどれかに該当するかを、印象ではなくトレースと評価結果で確認してください。
1.文脈の膨張で性能が測定可能に落ちる
長い調査、巨大なコードベース、複数の資料をまたぐ監査では、メインの文脈にすべてを残すことで選択や要約の質が落ちる場合があります。この低下が共通の評価で確認できるなら、独立した文脈を持つサブエージェントには意味があります。「文脈が長そう」という推測だけでは残す理由になりません。
2.独立した作業用文脈を、完了後に捨てられる
互いに依存しない調査経路、別々のコンポーネントの調査、候補の独立探索は、サブエージェントに向いています。各担当を新しい文脈で動かし、完了後は必要な結果だけをメインへ返して、作業用文脈を破棄できるためです。逆に、前の担当の細かな判断を次の担当が必要とする連鎖では、受け渡しのたびに情報が落ちやすくなります。
3.ツール選択に失敗するか、指示が衝突する
1つのエージェントが適切なツールを選べない、または領域ごとの指示が同じシステムプロンプト内でぶつかる場合も、分離を検討できます。ただし、先にツールの説明、スキルの発火条件、重複した指示を整えてください。設計の乱れをサブエージェント数で覆い隠すと、所有者と評価まで分散します。
判定を実装へ落とす時は、次のような概念的な分岐にできます。特定のSDKの実コードではありません。
# 概念例:特定SDKには依存しません
if context_bloat_causes_measurable_degradation:
    keep_subagent()
elif task_is_parallel_and_context_can_be_discarded:
    keep_subagent()
elif tool_selection_fails_or_instructions_conflict:
    repair_design_then_compare()
else:
    test_fold_into_main_loop()

# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
検証と権限分離はどう考えるか
Anthropicは、検証、並列作業、権限のモジュール化をサブエージェントの有効な用途として挙げています。たとえば、生成担当と検証担当を分け、検証担当には生成過程を見せず、成果物だけを独立して判定させる設計には合理性があります。
一方で、権限が違うからといって、利用者ごとに別のエージェントが必須になるわけではありません。元記事は、各ツールが、そのツールを呼び出した利用者の閲覧・実行権限を確認し、許可できない時はメインのモデルが読める拒否結果を返す方法も示しています。必要なのが権限チェックだけならツール側へ置き、文脈、ツール、所有範囲まで分離したい時にサブエージェントを残す、と切り分けると判断しやすくなります。
単一ループへ戻す候補はどこか
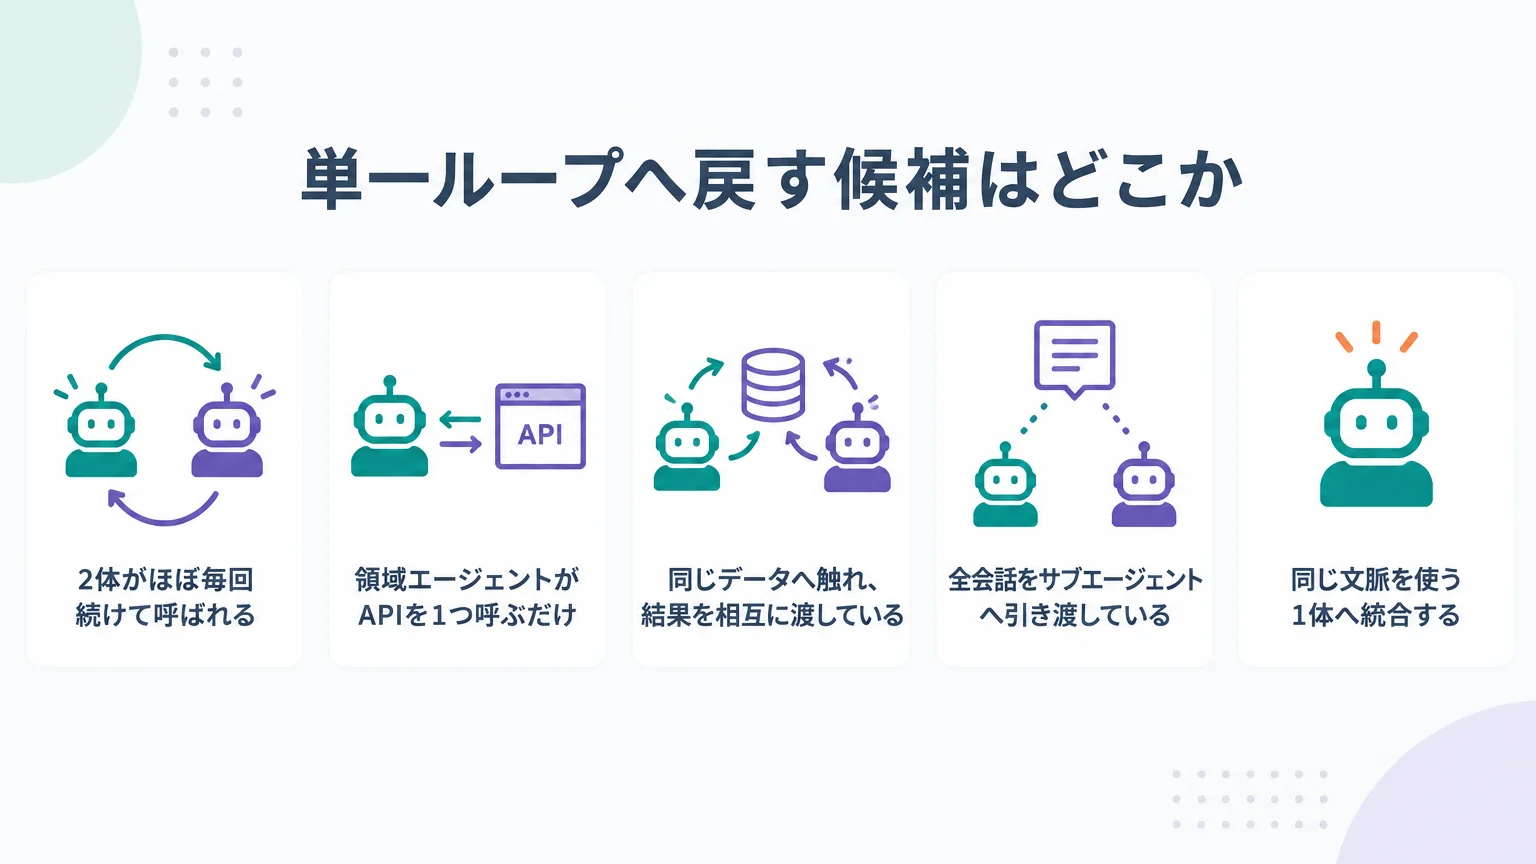
減らしやすいのは、組織図をそのまま写したサブエージェントです。営業、請求、配送、返品という部門名だけで分けた結果、同じ顧客情報を順に読み、同じ会話へ要約を返しているなら、境界は技術的な独立性より組織の都合で決まっています。
| 観察できる状態 | 最初に検討する変更 | 残す可能性 |
|---|---|---|
| 2体がほぼ毎回続けて呼ばれる | 同じ文脈を使う1体へ統合する | 片方だけ独立して使う経路が多いなら残す |
| ルーターが分類するだけで、後段が同じ情報を読み直す | 分類をメインの判断へ戻し、領域手順をスキル化する | 誤分類が重大で、独立した検証が必要なら残す |
| 領域エージェントがAPIを1つ呼ぶだけ | API呼び出しをMCPツールへ移す | 独自の長い推論と隔離された権限が必要なら残す |
| 同じデータへ触れ、結果を相互に渡している | 共有文脈を持つ単一ループで比較する | 文脈の膨張で評価が下がるなら再分離する |
| 全会話をサブエージェントへ引き渡している | メインからツールとして呼び、結果だけ受け取る | サブエージェントが利用者と直接対話する必要がある時だけ完全な引き渡しを検討する |
候補選びでは、呼び出し回数だけでなく「一緒に動く組み合わせ」を見ます。Anthropicは、互いの出力を連鎖的に使う、同じデータへ触れる、同時に呼ばれることが多い専門エージェントを、統合候補として挙げています。
# 移行候補の記録例:実測値を入れて使います
candidate: shipping_specialist
current_path: main -> orders -> shipping
shared_context: order_record
eval_cases: every_production_chain
decision: fold_or_keep_after_comparison

# 注意: 件数や基準は自社のトレースと評価方針で定めてください。
大きな組織で起きやすい5つの失敗
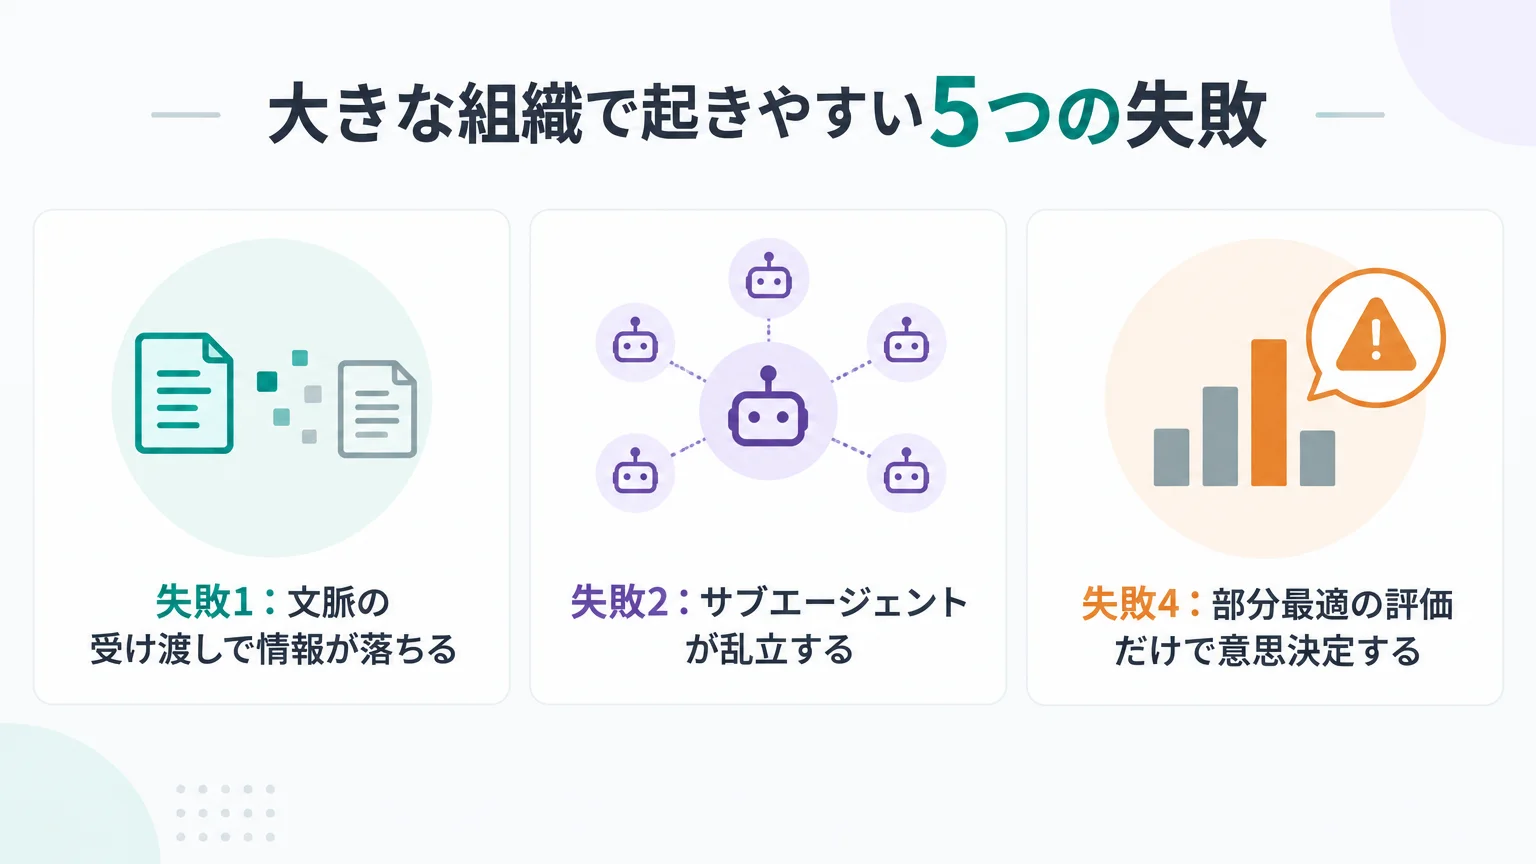
元記事が挙げる失敗は、モデルより所有構造に原因があります。中央チームがオーケストレーターを作り、各部門が自分のエージェントだけを最適化すると、全体の品質を持つ人がいなくなります。
失敗1:文脈の受け渡しで情報が落ちる
❌ 各サブエージェントが長い作業結果を短い要約へ変え、次の担当がその要約だけで判断する。
⭕ 前工程の結果を次工程が細部まで必要とするなら、同じ文脈に置くか、固定形式の生データを返します。
失敗2:サブエージェントが乱立する
❌ 各チームが似た役割のエージェントを追加し、数百の重複した担当に所有者も共通基準もない。
⭕ 新しいエージェントを増やす前に、既存のスキル、ツール、評価と重複しないかを中央で確認します。
失敗3:各チームが1文ずつ足したプロンプトになる
❌ 例外が出るたびにシステムプロンプトへルールを追記し、口調、優先順位、禁止事項が衝突する。
⭕ 共通のシステムプロンプトは短く保ち、領域固有の手順は必要時に読むスキルへ移します。
失敗4:部分最適の評価だけで意思決定する
❌ 各チームが自分の処理だけを高得点にする評価を持ち、最終回答や一連のタスク完了を測らない。
⭕ 中央チームが共通のエンドツーエンド評価を持ち、各スキルの小さな評価をその下に置きます。
失敗5:待ち時間を構造上のコストとして扱わない
❌ ネストしたモデル呼び出しを増やしながら、最終回答までの時間を測らない。
⭕ 品質だけでなく、待ち時間、モデル呼び出し、トークン、費用、経路の変化を同じ比較へ含めます。
約2倍という数字は、この5つ目を考える材料になります。ただし、元記事にあるのは1社の比較です。自社の構成が同じだけ速くなるとは限らないため、移行前のベースラインが欠かせません。
スキルとtool searchで段階的に読み込む
単一ループに戻すと、すべての手順とツール定義が1つの巨大なプロンプトへ集まりそうに見えます。そこで使うのが段階的な読み込みです。スキルとtool searchは役割が異なるため、分けて設計します。
スキルは「仕事の進め方」を持つ
AnthropicのAgent Skills解説では、起動時にスキルの名前と説明だけを見せ、必要と判断した時にSKILL.mdを読み、さらに詳しい参考資料は必要時だけ読む構造が説明されています。領域エージェントのプロンプトに入っていた手順、判断基準、例外処理は、ここへ移す候補です。
ただし、スキルを増やせば自動的に整うわけではありません。各領域の担当者がスキルの責任者になり、似たスキルを統合し、発火条件と評価を保守する必要があります。
tool searchは「使える道具」を必要時に見つける
Claude Platformのtool search公式ドキュメントでは、遅延読み込みを指定したツール定義を初期文脈へ載せず、必要時に検索し、見つかった定義を展開して呼び出す流れが示されています。これは、全スキルの短い説明を先に見せる仕組みとは同一ではありません。
Anthropicは元記事で、システムプロンプト内のツール定義の数が30〜50個を超えると、ツール選択の精度が落ちやすいという経験則も示しています。これは製品上の上限ではなく、説明の重複や曖昧さを点検する目安です。よく使う少数のツールは常時見せ、それ以外を遅延読み込みにする方法が考えられます。
知識ベースは「必要な時だけ参照する事実」を持つ
社内規程、指標の定義、製品仕様などは、検索・参照ツールから取得できる場所か、スキルの参考ファイルに置きます。コードが先回りして大量の資料をプロンプトへ貼り付ける構成は避け、モデルが必要性を判断して取りに行けるようにします。
単一ループは何を残し、何を外すのか
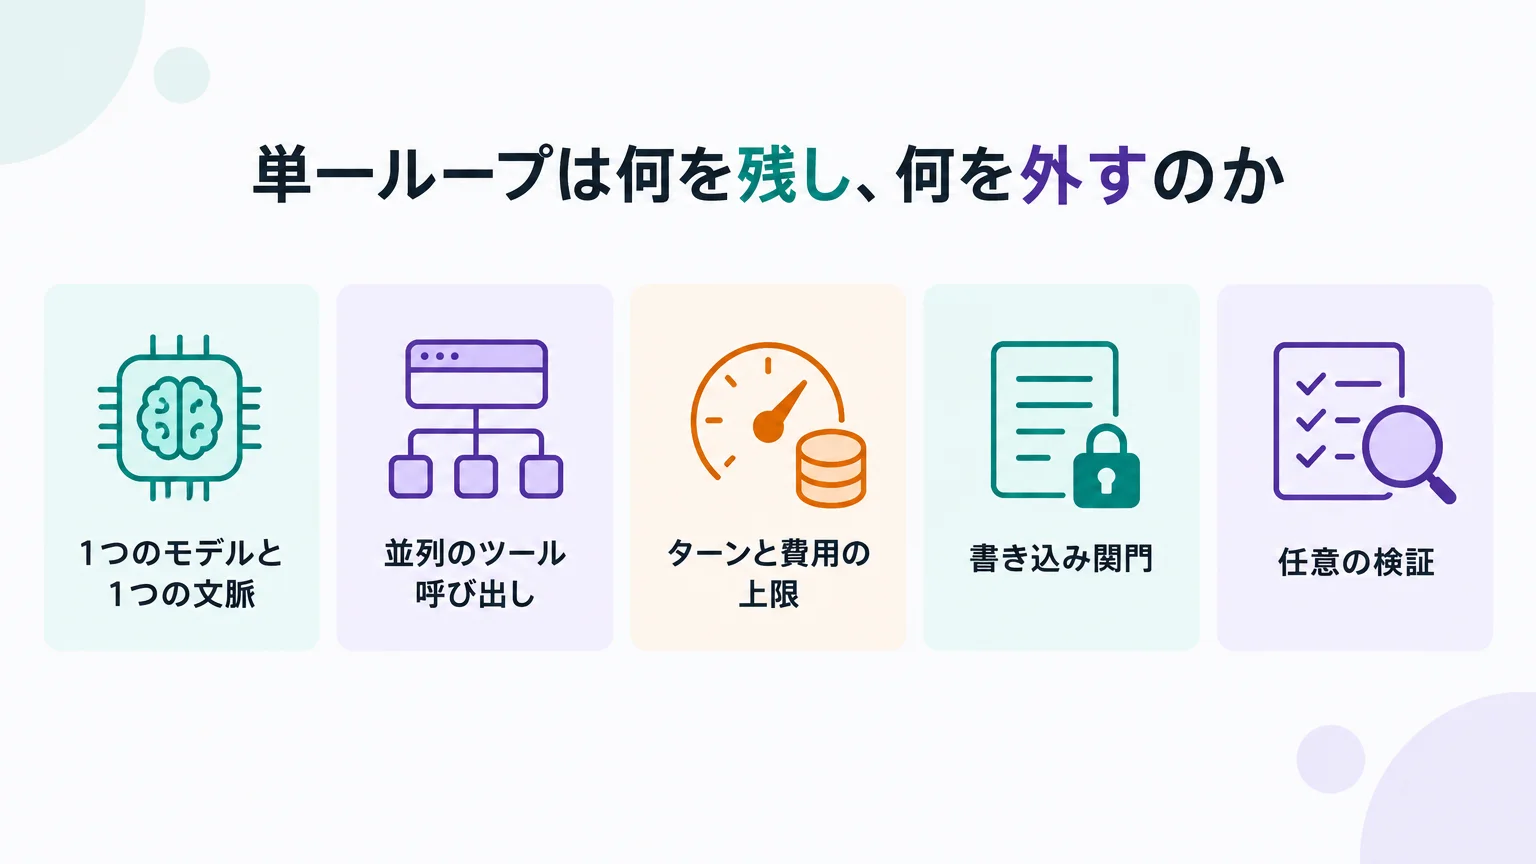
元記事が示す単一ループは、モデルに無制限の自律性を渡す構成ではありません。計画と判断はモデルに担わせつつ、ターン数・費用の上限や不可逆な操作の関門は、モデルを制御する実行基盤(ハーネス)に残します。
- 1つのモデルと1つの文脈:同じモデルが計画し、道具を使い、結果を受け、計画を直します。
- 並列のツール呼び出し:各ターンで必要なツールをまとめて出し、ハーネスが並列に実行して生の結果を同じモデルへ返します。
- ターンと費用の上限:回答するか上限に達した時点で止めます。上限の値は自社タスクの分布から決めます。
- 書き込み関門:外部送信、更新、削除などの操作は、モデルの判断だけで通さず、明示的な承認や検証をハーネス側に置きます。
- 任意の検証:最終回答後に目標達成や検証担当を走らせることはできます。独立性が必要なら検証サブエージェントを残せます。
単一ループの骨格は、次の疑似コードで表せます。実際のAPI名や例外処理は利用環境に合わせてください。
# 概念例:1つのモデルが計画と実行を担当します
plan = model.write_plan(user_request)

while within_turn_and_cost_budget():
    calls = model.choose_tool_batch(plan)
    approved_calls = require_write_gate(calls)
    raw_results = run_in_parallel(approved_calls)
    plan = model.revise_plan(raw_results)
    if model.is_ready_to_answer():
        break

answer = model.answer()
optional_verify(answer)

# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
Claude APIのTask budgetsは、思考、ツール呼び出し、ツール結果、出力を含む作業量をトークンで伝える補助機能です。ただし公式ドキュメントでは、作業量の目安を伝える機能であり、超過を強制的に止める上限ではないと説明されています。2026年10月24日時点ではベータ版で、Claude CodeやCoworkの画面からは利用できず、Messages APIの対応モデルで使用します。ターン数、円換算の費用、書き込み承認までこの機能だけで制御できるとは考えず、ハーネス側の停止条件と組み合わせてください。
移行キットを使う6段階
元記事からリンクされたSingle agent loop kitは、マルチエージェント構成を調べ、変更を一度に1か所ずつ加えて前後を比較するための参照実装です。中心にあるのは、Measure、Combine、Foldという流れです。実務では次の6段階として扱えます。
段階1:全サブエージェントを棚卸しする(Audit)
ルーター、プランナー、専門担当について、プロンプト、ツール、所有者、呼び出し経路、書き込み権限を一覧にします。ルーターやプランナーなどメインの役割には「main」、サブエージェントには「スキルとツールへ移す」「別の担当と統合する」「ツールとして呼ぶ」「そのまま残す」を付けます。全体では5種類の判定です。ここではまだ削除しません。
段階2:現在値を固定する(Baseline)
中央チームが共通のエンドツーエンド評価を持ち、各領域チームが小さな評価を添えます。Anthropicは、最初の評価セットは10件の正解例からでも作り始められるとしていますが、十分性を保証する件数ではありません。現在のルーティング精度、最終回答、待ち時間、呼び出し数、トークン、費用を記録します。
段階3:密結合の担当を統合する(Merge)
毎回同じ順で動く、同じデータへ触れる、片方の結果をもう片方が必ず使う組み合わせから着手します。変更前に、その連鎖を通る本番タスクが評価に含まれているかを確認します。
段階4:1体ずつスキルとツールへ移す(Fold)
サブエージェントの指示はスキルへ、API呼び出しはMCPツールへ移します。一度に複数を変えず、前後で同じ評価を実行してください。最終得点だけでなく、どのタスクが合格から不合格へ変わったかも読みます。
元記事のサポート例では、統合によって待ち時間が下がった一方、メインエージェントが注文検索ツールだけで回答し、配送担当へ配達日を確認しない失敗が起きました。しかも2回のうち1回だけ現れたため、重要なルールは複数回実行しないと見落とします。
段階5:ツールとして残す(Keep as a tool)
3条件に該当して残す場合は、メインエージェントからツールとして呼び出す方法があります。メインが利用者との会話を保持し、サブエージェントは共通の応答形式で結果を返します。応答形式をそろえることで、メインエージェント側で返却内容を比較・検証しやすくなります。ただし、別プロンプト、別文脈、別評価、ネストしたモデル呼び出しは残るため、最終形とは限りません。
段階6:プロンプトと所有者を整理する(Upkeep)
移行後は、古いモデル向けの指示、使われないスキル、重複したツール説明を減らします。小さな中央チームがシステムプロンプトと共通評価を持ち、各領域チームは自分たちのスキルとツールを保守します。
移行キットの限界:READMEは、このキットを「保守されず、コントリビューションも受け付けない参照実装」と位置づけています。記録された実モデルの例は、1人が1モデルで実施したサポートデスク例の2回です。統合、継続整備、完成版の単一ループ、他システムへの適用などには実モデルで未検証の範囲があります。企業システムで効果が保証された移行製品ではありません。
中央の小さなチームが全体品質を持つ
単一ループへの移行は、エージェント数を減らすだけのリファクタリングではなく、責任分担の見直しでもあります。中央の小さなチームはシステムプロンプト、共通評価、ツールとスキルの審査を担い、各領域チームは領域手順を表すスキルと、実データにつながるツールを保守します。
この分担なら、返品チームが返品手順を更新しても、顧客との会話全体を別エージェントへ引き渡す必要はありません。中央チームは口調と最終品質を一貫させ、領域チームは自分たちの知識とAPIの正しさに責任を持てます。
新しいスキルやツールを追加する時は、少なくとも次を確認してください。
- 既存のスキルやツールと役割が重複していないか
- 短い説明だけで適切に選ばれるか
- 固定形式の入力と結果が必要な処理はツールになっているか
- 領域の手順や判断基準はスキルになっているか
- 全体評価と領域評価の両方に検査項目があるか
- 書き込みと権限の確認がモデルの指示文だけに依存していないか
日本の開発チームが今週やること
大規模な置き換え計画を作る前に、今週は1体だけを対象にしてください。進め方は次の通りです。
- 呼び出し経路を出す:本番トレースから、どのサブエージェントがどの順で動いたかを一覧にします。
- 共通の正解例を作る:利用頻度が高い依頼、絶対に破ってはいけない規則、書き込みを伴う依頼を含めます。正解の判定者も決めます。
- 候補を1体選ぶ:他の担当と常に連鎖する、APIを1つ呼ぶだけ、手順がスキルへ移しやすい担当を優先します。
- 1変更だけ行う:指示をスキルへ、APIをツールへ移し、他のプロンプト改善は同時に行いません。
- 同じ評価で比較する:品質、待ち時間、モデル呼び出し、トークン、費用、経路、書き込みの有無を比較します。
- 結果で決める:品質が落ちたら修正か復帰、同等以上なら移行を維持します。最初から「必ず減らす」と決めません。
Claude Platformで可観測性を整える場合は、AnthropicのAgent observability解説も参考になります。同記事は2026年10月14日に公開され、2026年10月24日時点ではAgent Observabilityを公開ベータとして案内しています。エージェントのターン、モデル呼び出し、ツール利用、待ち時間、トークンなどを追う考え方が示されています。
既刊ガイドで実装を補う
今回の判断は「作るべきか、減らすべきか」を評価で決める話です。残すと決めた担当の実装は、Claude Agent SDKのサブエージェント実装ガイドで、定義、ツール、権限、呼び出し方を確認できます。
領域プロンプトを段階的に読む仕組みへ移す場合は、Agent Skills完全ガイドが対応します。スキルの構造、発火条件、本番運用の考え方を補えます。
単一ループ内で複数の道具を同時に動かす設計は、Parallel Tool Useとtool_choiceの設計パターンもあわせて確認してください。サブエージェントを増やさなくても並列化できる範囲を見分けやすくなります。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Building agents: When to fold subagents into your main agent loop — Anthropic / Claude、Diane Sarkis、2026年10月22日公開(参照日:2026年10月24日)
- Single agent loop kit — Anthropic公式GitHub、移行手順と参照実装(参照日:2026年10月24日)
- Building agents with Skills: Equipping agents for specialized work — Anthropic / Claude、2026年1月22日公開(参照日:2026年10月24日)
- Tool search tool — Claude Platform公式ドキュメント(参照日:2026年10月24日)
- The new rules of context engineering for Claude 5 generation models — Anthropic / Claude、Thariq Shihipar、2026年7月24日公開(参照日:2026年10月24日)
- Multi-agent coordination patterns: Five approaches and when to use them — Anthropic / Claude、2026年4月10日公開(参照日:2026年10月24日)
よくある質問
サブエージェントはすべて減らすべきですか?
いいえ。文脈の膨張で単一ループの性能が測定可能に落ちる、新しい文脈で独立作業を並列化できる、単一エージェントがツールを選べないか指示が衝突する、のいずれかに当てはまり、評価でも有利なら残します。目的はサブエージェントの体数を最小にすることではなく、根拠のある構成にすることです。
最初に減らす候補はどれですか?
毎回ほかの担当と連続して呼ばれる、同じデータを読む、APIを呼ぶだけ、利用者との対話を必要としないサブエージェントから確認してください。まずツールとして呼ぶ形へ変えると、全面的な書き換えをせず比較しやすくなります。
評価は何件あれば始められますか?
Anthropicは、小さな出発点として10件の正解例でも始められるとしています。ただし、10件で十分と保証するものではありません。本番で頻出する一連の処理、破ってはいけない規則、書き込みを伴う経路を含め、重要なタスクは複数回実行してください。
権限分離には別のサブエージェントが必要ですか?
必ずしも必要ではありません。各ツールが、そのツールを呼び出した利用者の権限を確認し、許可できない操作を拒否する設計なら、1つのループで異なる権限を扱えます。独立した文脈、専用の道具、別の所有境界まで隔離する必要がある場合は、サブエージェントを残す選択肢があります。
移行キットを実行すれば自動で安全に移行できますか?
いいえ。キットは監査と比較を案内する参照実装で、評価結果と停止点ごとに人が判断する設計です。READMEには保守されないこと、実モデルで未検証の範囲があることも明記されています。まずテスト環境と正解を判定できる担当者を用意してください。
最後に確認すべきこと
サブエージェントを減らすべきか迷ったら、「この担当は独立した文脈を得ることで、共通評価の得点を上げているか」と問い直してください。効果を測れないまま残すと、プロンプト、所有者、評価、待ち時間だけが増えていきます。
一方で、独立した検証、依存の少ない並列調査、隔離すべき権限と道具には、サブエージェントを残す価値があります。共通評価を置き、1体ずつ変更し、悪化したら戻す。この順番なら、単一ループを流行として採用するのではなく、自社の仕事に合う構成を選べます。
エージェント構成の棚卸しや、移行前後を比べる評価設計まで整理したい方へ。
Uravationへのお問い合わせでは、既存のサブエージェント構成を前提に、残す部分と単一ループへ戻す部分を切り分けるところから相談できます。