「Open LLM Leaderboardの上位モデルを選べば、ローカルLLM選びは終わる」という理解は誤りです。Hugging FaceのOpen LLM Leaderboardは2025年3月13日に公式終了しており、2026年の新モデルを横並びで判定する現役ランキングではありません。
2026年10月3日時点のローカル LLM おすすめは、高性能なコーディングならQwen3.8 27B、日本語と軽さの両立ならQwen3.5 9B、画像も扱う軽量PCならGemma 4 E4B、16GB級メモリで推論を重視するならgpt-oss-20bです。Llama 4 Scoutは最新Llama世代ですが、一般的なノートPCではなくH100級の大型環境向けです。
- 8GB RAM級:Llama 3.2 3BまたはPhi-4-miniから試す
- 16GB RAM・統合メモリ級:Qwen3.5 9B、Gemma 4 E4B、Ministral 3 8Bを比較する
- 32GB級:Qwen3.8 27B、Devstral Small 2、gpt-oss-20bを用途で選ぶ
- 大容量GPUサーバー:超長文処理が必要な場合に限りLlama 4 Scoutを検討する
スナップショット:2026年10月3日。モデル容量とコンテキスト長はOllama Libraryの当日表示、用途・言語・ライセンスは各社の公式モデルカードを照合しています。
ローカルLLMでは、モデル名より先に「手元のメモリ」「日本語・コード・画像のどれを優先するか」「Ollamaで試すのか、vLLMで配信するのか」を決める必要があります。モデルの重みがメモリに収まっても、長いコンテキストのKVキャッシュや画像入力、同時実行の余裕がなければ、期待した条件では動きません。
そこで、当日確認できた公式モデルとOllamaタグだけに絞り、用途別の10候補を比較します。速度や日本語性能の架空実測は置かず、公式仕様と、そこから算出した余裕込みのメモリ目安を明確に分けました。ローカルLLMの基本から確認したい方は、先にローカルLLMの仕組み・クラウドとの違いを読むと判断しやすくなります。
用途別10モデルを先に比較
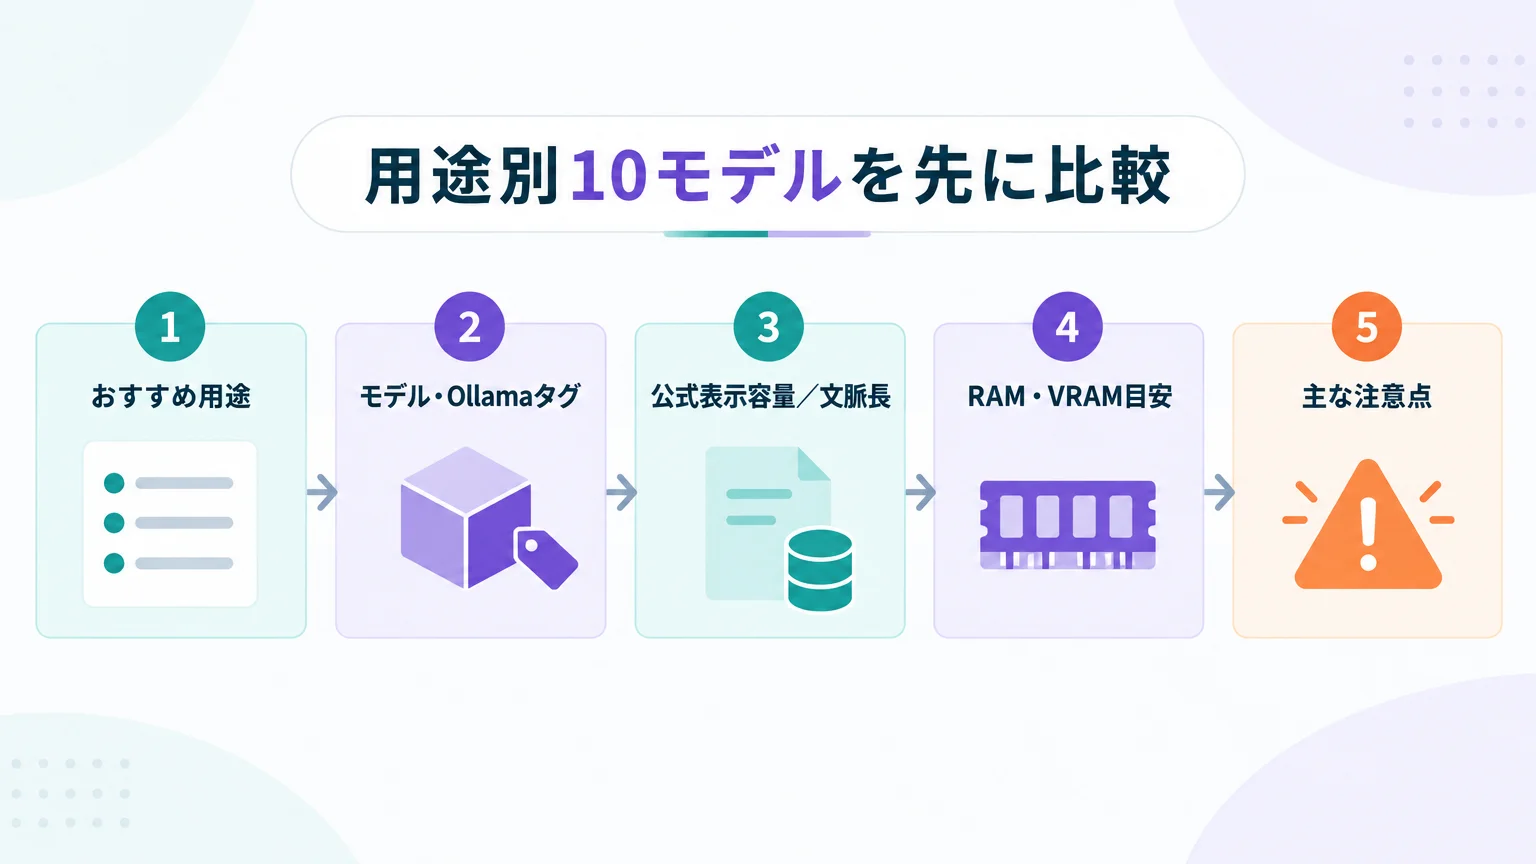
下表の「Ollama容量」は公式ライブラリに表示された量子化済みモデルの容量です。「RAM・VRAM目安」は最低保証ではなく、短めの入力で単体実行するために重み容量へランタイムとKVキャッシュの余裕を加え、一般的なメモリ構成へ切り上げた編集部目安です。最大コンテキストを使う場合は、さらに大きな余裕が必要です。
| おすすめ用途 | モデル・Ollamaタグ | 公式表示容量/文脈長 | RAM・VRAM目安 | 主な注意点 |
|---|---|---|---|---|
| 総合・コーディング | qwen3.8:27b |
18GB/256K | RAM 32GB、VRAM 24GB級 | 日本語首位を示す公式比較ではない |
| 日本語と軽さの両立 | qwen3.5:9b |
6.6GB/256K | RAM 16GB、VRAM 8〜12GB級 | 最大文脈ではメモリ増加に注意 |
| 軽量マルチモーダル | gemma4:e4b |
6.6〜9.5GB/128K | RAM 16GB、VRAM 8〜12GB級 | E4Bはファイル容量4GBの意味ではない |
| PC向け画像理解 | gemma4:12b |
7.7〜8.0GB/256K | RAM 16〜24GB、VRAM 12〜16GB級 | OllamaタグはText・Image。音声は対応ランナーを確認 |
| 超長文・大型サーバー | llama4:scout |
67GB/10M | RAM 96GB以上、VRAM 80GB級 | Llama 4 Community Licenseを確認 |
| 最小クラスのテキスト処理 | llama3.2:3b |
2.0GB/128K | RAM 8GB、VRAM 4GB級 | 公式対応言語に日本語は含まれない |
| 12GB VRAM級の日本語・画像 | ministral-3:8b |
6.0GB/256K | RAM 16GB、VRAM 12GB級 | 最大文脈時の12GB動作保証ではない |
| コードベース編集 | devstral-small-2:24b |
15GB/384K | RAM 32GB、VRAM 24GB級 | 一般会話より開発エージェント向け |
| 軽量な日本語テキスト | phi4-mini:3.8b |
2.5GB/128K | RAM 8GB、VRAM 4〜6GB級 | 非英語では性能低下の可能性を公式が明記 |
| 推論・ツール利用 | gpt-oss:20b |
14GB/128K | 公式最小16GB、余裕込みRAM 24GB級 | テキスト専用で学習データは英語中心 |

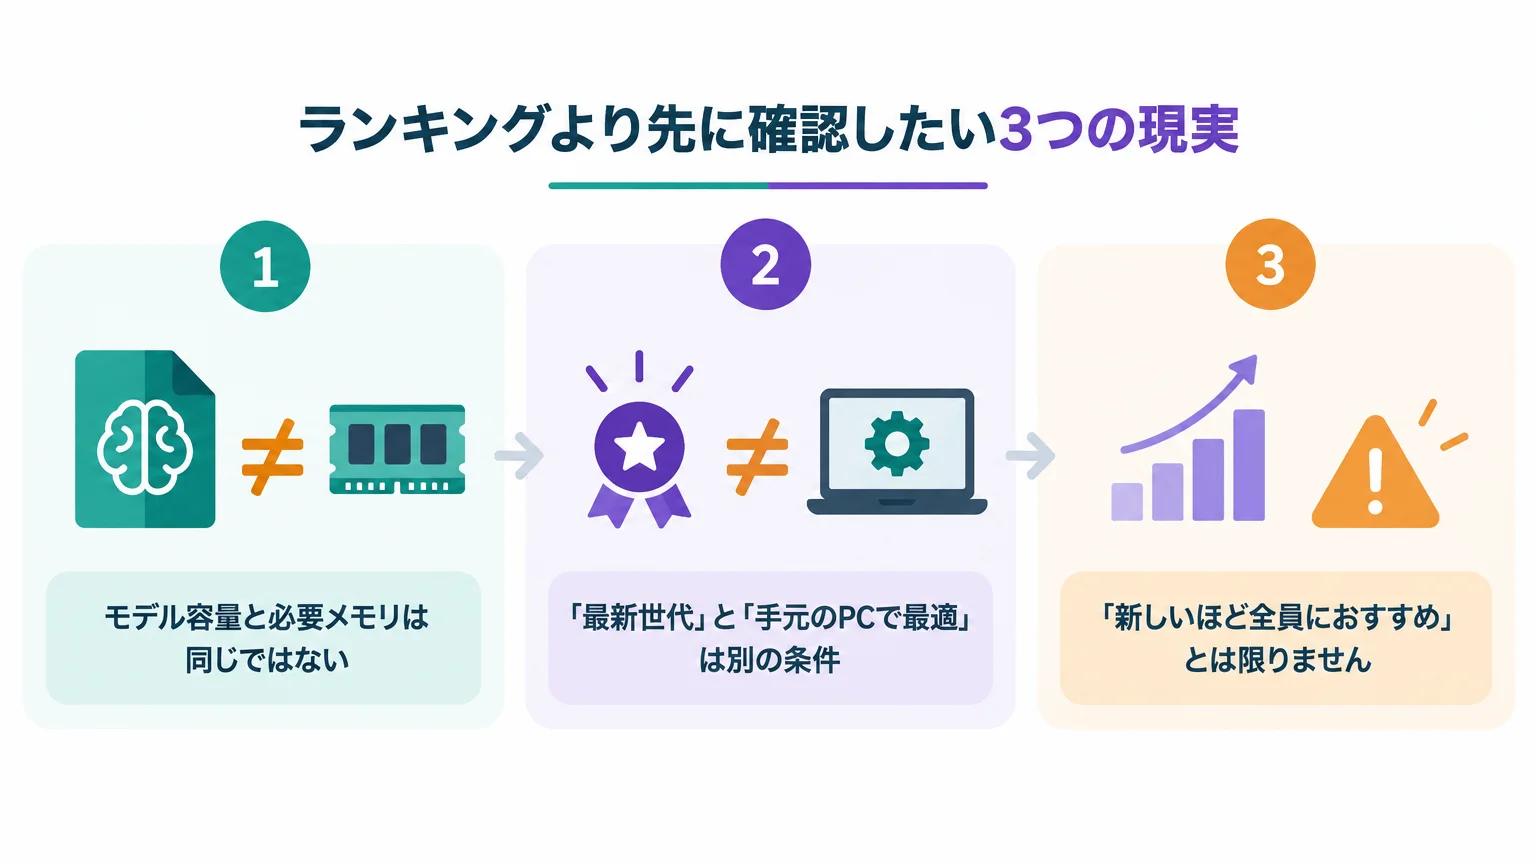
ランキングより先に確認したい3つの現実
Open LLM Leaderboardは2026年モデルの現役順位表ではない
Hugging Faceの公式ディスカッションによると、Open LLM Leaderboardは2025年3月13日に終了しました。IFEval、MATH、GPQA、MMLU-Proなど複数の評価軸をそろえた功績は大きい一方、Qwen3.8やGemma 4を当日順位で比較する根拠にはできません。2026年10月3日現在は、評価項目の設計を学ぶ資料として使い、最終判断は最新の公式モデルカードと自分の代表タスクで行うのが妥当です。
モデル容量と必要メモリは同じではない
Ollama Libraryの「6.0GB」「18GB」は、主に提供されるモデルファイルの容量を示します。実行時にはランタイム、KVキャッシュ、入力トークン、画像エンコーダーなどが追加されます。Ollamaは2025年9月23日のメモリ管理更新で、起動前に必要メモリを測定する方式を導入しました。判断時は容量表だけでなく、起動後にollama psやOSのメモリ表示を確認してください。
「最新世代」と「手元のPCで最適」は別の条件
Llamaの最新公開世代はLlama 4ですが、ScoutのOllama容量は67GBです。一方、Llama 3.2 3Bは旧世代でも2.0GBで、軽い要約や書き換えの検証を始めやすい選択肢です。同様にQwen3.8 27Bは高性能候補ですが、日本語と軽さを両立したい16GB級PCではQwen3.5 9Bの方が現実的です。「新しいほど全員におすすめ」とは限りません。

用途ごとに選ぶローカルLLMおすすめ10選
1. Qwen3.8 27B:コーディングと長時間エージェントの本命
Qwen3.8 27Bは、Qwen公式がコーディング、専門業務、調査、長時間のエージェント作業の改善を掲げる27Bモデルです。モデル本体は画像・動画入力に対応し、ネイティブのコンテキスト長は262,144トークンです。一方、2026年10月3日時点のOllamaタグqwen3.8:27bは18GBで、入力表示はText・Imageです。Ollamaで動画を直接渡せるという意味ではないため、動画入力は対応ランナーを別途確認してください。
一方、公式モデルカードには民生GPUの最低VRAMや「日本語で最上位」という比較はありません。24GB VRAM級を選定目安としつつ、実際のリポジトリと日本語指示で確認してください。Qwen 3.5とのハイブリッド構成はClaude Code × Qwen 3.5のローカル開発ガイドも参考になります。
2. Qwen3.5 9B:日本語と16GB級PCのバランス
Qwen3.5の公式発表は201言語・方言を列挙し、日本語も明記しています。9B版はOllamaで6.6GB、256Kコンテキストです。日本語の文書要約、社内FAQ、軽めのコーディングを1台で試したい場合の出発点にしやすいモデルです。
ただし、対応言語であることと、個別業務で最も正確であることは別です。敬語、固有名詞、社内略語、長文の指示追従を代表入力で採点し、Phi-4-miniやMinistral 3 8Bと比較してください。
3. Gemma 4 E4B:小型PCで画像も扱いたい
GoogleはGemma 4 E4BをノートPCやモバイルを意識したエッジモデルとして公開しています。モデル本体は128Kコンテキストで、テキストだけでなく画像・音声入力、推論、コード、関数呼び出しに対応します。一方、2026年10月3日時点のOllamaタグgemma4:e4bは6.6〜9.5GBで、入力表示はText・Imageです。音声を扱う場合は、Gemma 4の音声入力に対応するランナーを確認してください。
名称のE4Bは「有効パラメータ」を示し、ファイルが必ず4GBに収まる意味ではありません。軽量さだけならPhi-4-miniが有利ですが、小型モデルで画像入力も必要ならGemma 4 E4Bが勝つ観点があります。
4. Gemma 4 12B:PC向けマルチモーダルの中間点
Gemma 4 12Bは2026年6月3日にGoogleが発表した中型モデルで、モデル本体は画像・音声入力と256Kコンテキストに対応します。Ollama容量は7.7〜8.0GBですが、当日のOllamaタグが表示する入力はText・Imageです。Ollamaでは文書と画像を扱う候補とし、音声入力は対応ランナーを確認してください。
画像を入力するとテキストだけの場合よりメモリを使います。16GB RAMでモデルが起動しても、長い文書と画像を同時に処理する用途では24GB以上を選ぶ方が安全です。これは公式最低要件ではなく、重み容量へ実行余裕を足した選定目安です。
5. Llama 4 Scout:10M文脈を持つ大型サーバー向け
Metaが2025年4月5日に発表したLlama 4 Scoutは、17Bアクティブ・109B総パラメータのMoEモデルです。公式は10Mコンテキストと、Int4量子化で単一NVIDIA H100に収まることを案内しています。Ollamaの量子化タグも67GBなので、一般的なノートPC向けのおすすめではありません。
大量文書や巨大コードベースを扱う専用サーバーでは候補になりますが、日本語は公式対応12言語に含まれません。またApache 2.0ではなくLlama 4 Community Licenseです。長文性能だけで決めず、言語と利用条件を先に確認してください。
6. Llama 3.2 3B:軽いテキスト処理を8GB級で試す
Llama 3.2 3BはMetaがエッジ・モバイル向けに公開した小型テキストモデルです。Ollama容量は2.0GBで、要約、指示追従、書き換えなどの軽い処理を試しやすい点が強みです。新しいPCを用意する前に、ローカル推論の流れを確認したい場合にも向きます。
ただし、公式対応言語に日本語は含まれていません。日本語を主目的にするならPhi-4-miniやQwen3.5 9Bを先に比較し、Llama 3.2 3Bは軽さを優先する枠として扱うのが公平です。
7. Ministral 3 8B:12GB VRAM級で日本語と画像に対応
Mistral AIのMinistral 3 8Bは、日本語を公式対応言語に含み、画像理解、関数呼び出し、JSON出力を扱えます。公式モデルカードはFP8で12GB VRAMに収まると案内し、Ollamaのministral-3:8bは6.0GBです。日本語と画像の両方を必要とし、Qwen以外も比較したい場合に有力です。
12GBという値はFP8重みについての公式説明であり、256Kコンテキストを最大まで使う際の総メモリ保証ではありません。長い入力ではコンテキストを抑えてから段階的に増やしてください。
8. Devstral Small 2 24B:複数ファイルを触るコード作業
Devstral Small 2は、コードベース探索、複数ファイル編集、ツール利用を行うソフトウェアエージェント向けの24Bモデルです。OllamaのQ4_K_Mタグは15GBです。Mistral公式は単一RTX 4090または32GB RAMのMacで実行できると案内しています。
一般会話の万能モデルとしてではなく、開発リポジトリを扱う専用候補として比較してください。Qwen3.8 27Bが総合・調査にも広げやすいのに対し、Devstral Small 2はコード作業へ明確に寄せられる点が選ぶ理由です。
9. Phi-4-mini:小型の日本語テキストと関数呼び出し
MicrosoftのPhi-4-mini-instructは3.8Bの小型モデルで、128Kコンテキスト、関数呼び出し、日本語を含む多言語対応を公式に掲げています。Ollama容量は2.5GBです。8GB RAM級で、短い日本語の分類、抽出、要約を試す候補になります。
公式モデルカードは、学習データが主に英語であり、非英語では性能が下がる可能性も明記しています。日本語対応というラベルだけで決めず、Qwen3.5 9Bと同じ入力で比べる必要があります。
10. gpt-oss-20b:16GB級の推論とツール利用
OpenAIのgpt-oss-20bは、総21B・1トークンあたり3.6BアクティブのMoEモデルです。OpenAIは16GBメモリでのローカル実行を案内しており、Ollama容量は14GBです。推論強度の調整、関数呼び出し、構造化出力、ツール利用を重視する場合に適しています。
テキスト専用で、公式モデルカードは学習データを英語中心と説明しています。日本語中心ならQwen3.5やMinistral 3が勝つ観点があり、推論・エージェント機能ならgpt-ossが候補になります。すべてを1モデルで済ませる発想は避けましょう。
Qwen・Gemma・Llamaは何が違うか
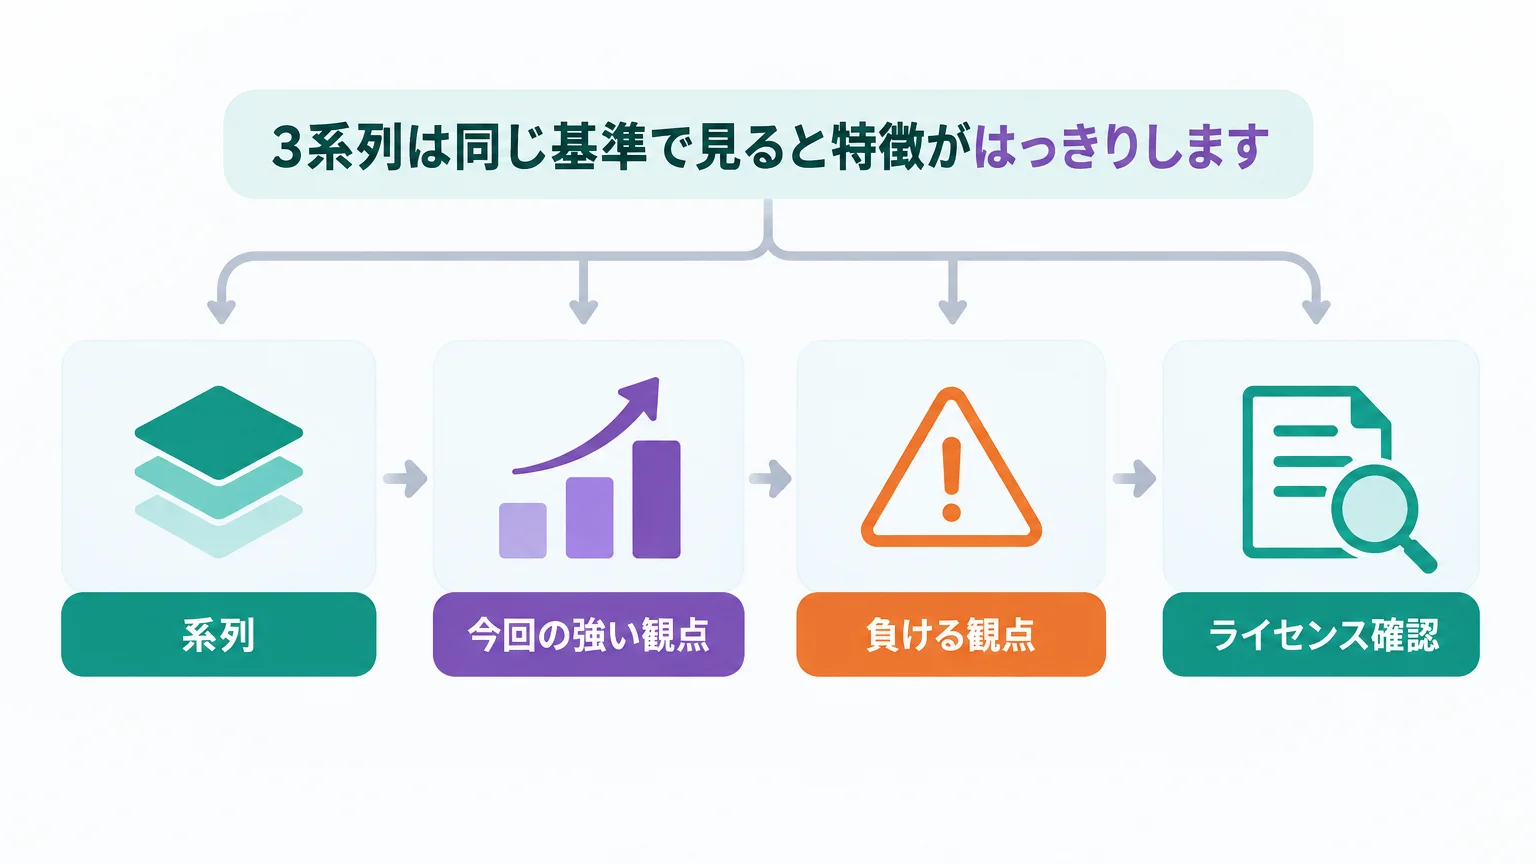
3系列は同じ基準で見ると特徴がはっきりします。Qwenは当日世代のコーディングとエージェント機能、Gemmaは小型から中型までのマルチモーダル構成、Llamaは広いエコシステムとScoutの超長文が比較軸です。ただし、Llamaは独自ライセンスで、日本語対応にも注意が必要です。
| 系列 | 今回の強い観点 | 負ける観点 | ライセンス確認 |
|---|---|---|---|
| Qwen | Qwen3.8のコード・エージェント、Qwen3.5の201言語 | 27B版は軽量PCには重い | Apache 2.0 |
| Gemma | モデル本体はE4Bから12Bまで画像・音声対応 | Ollamaタグの入力方式は別途確認が必要 | Apache 2.0 |
| Llama | Scoutの10M文脈、幅広い実行基盤 | Scoutは大容量、日本語は公式対応外 | Community License |

PCメモリから逆引きする選び方
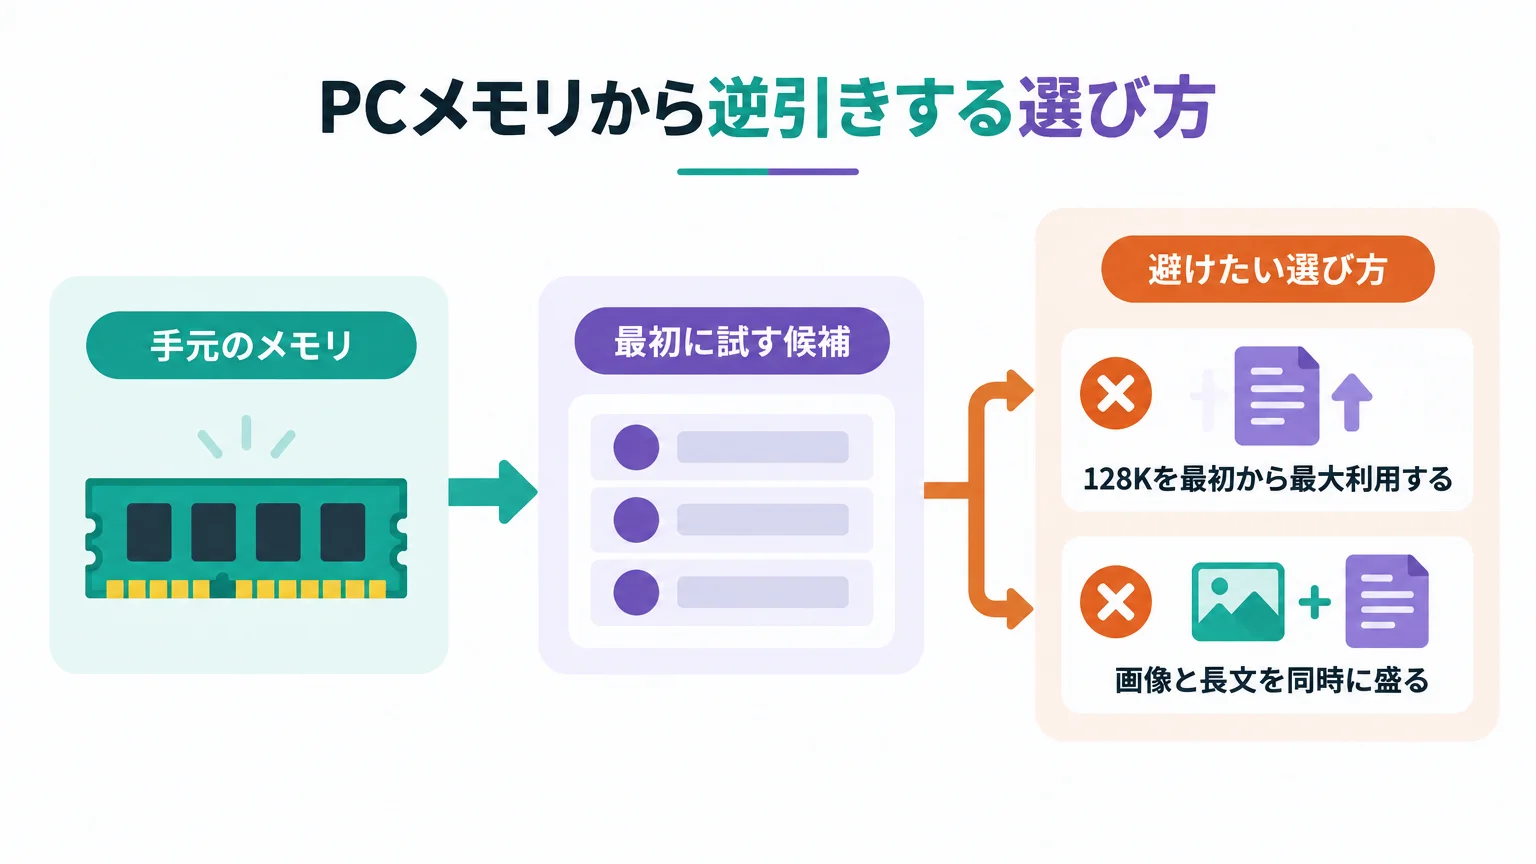
必要メモリは量子化方式とコンテキスト長で変わります。ここではOllamaの当日表示容量を起点にし、短い入力で単体実行する前提で選定します。Apple SiliconではRAMとVRAMが統合メモリを共有するため、モデルだけで全容量を使わず、OSや他アプリの余裕を残してください。
| 手元のメモリ | 最初に試す候補 | 避けたい選び方 |
|---|---|---|
| 8GB | Llama 3.2 3B、Phi-4-mini | 128Kを最初から最大利用する |
| 16GB | Qwen3.5 9B、Gemma 4 E4B、Ministral 3 8B | 画像と長文を同時に盛る |
| 24〜32GB | Gemma 4 12B、gpt-oss-20b、Qwen3.8 27B | モデル容量だけで同時実行を判断する |
| 80GB級GPU | Llama 4 Scout、複数ユーザー向け配信 | 10M文脈を常に必要と決めつける |
Macでの選び方と確認手順はローカルLLMをMac miniで動かす5手順にまとめています。購入前は、いまのPCで小型モデルを動かし、必要な入力長と応答品質を先に確認するのが安全です。
Ollama・LM Studio・vLLMの相性
同じモデルでも、実行ツールは目的で変わります。Ollamaは公式タグから素早く試す用途、LM StudioはGUIでGGUFを比較する用途、vLLMはAPIとして複数ユーザーへ配信する用途に向きます。2026年9月22日にはHugging Face TransformersがGGUF・llama.cpp量子化の直接実行を発表しましたが、対応カーネルがない場合はデ量子化され、メモリ使用量が増える注意もあります。
| 実行ツール | 向く場面 | 今回のモデル例 | 確認点 |
|---|---|---|---|
| Ollama | 個人PC、CLI、ローカルAPI | 10モデルすべて公式タグあり | タグ容量、コンテキスト、GPU搭載率 |
| LM Studio | GUIでGGUFを比較 | Qwen、Gemma、Llama、Mistral系 | 提供元と量子化方式 |
| vLLM | GPUサーバー、OpenAI互換API | Qwen3.8、gpt-oss、Mistral系 | 対応バージョン、量子化、同時実行 |
Ollamaで日本語候補を試す
動作環境:2026年10月3日時点の現行Ollama。まずQwen3.5 9Bを取得し、そのまま対話を開始します。
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
ollama run qwen3.5:9b
コーディング向けモデルを比較する
動作環境:Devstral Small 2に対応する現行Ollama。コードを置いたディレクトリや権限範囲は、接続するエージェント側で制限してください。
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
ollama run devstral-small-2:24b
GPUサーバーでQwen3.8を配信する
動作環境:Qwen公式モデルカードが案内するvLLM。インストール済み環境でモデルをOpenAI互換APIとして起動します。
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
vllm serve "Qwen/Qwen3.8-27B"本番配信では認証、レート制限、ログ、モデル固定、ロールバックを別途設計してください。詳しい構成はvLLMでオープンLLMをセルフホストする本番運用ガイド、Ollamaの導入はOllamaでローカルLLMを動かすガイドで確認できます。

日本語・コード・RAGを同じ手順で評価する
公開ベンチマークは候補を絞る道具であり、自社タスクの合格証ではありません。ローカルLLMは、モデル・量子化・プロンプト・コンテキスト長・実行ツールを固定し、同じ入力で比較してください。日本語なら敬語と固有名詞、コードなら既存テストへの適合、RAGなら根拠外の回答をしないかを見ると差が出ます。
- 代表入力を固定:実際の文書やコードを匿名化し、全モデルへ同じ順番で渡す
- 合格条件を固定:正確性、指示追従、引用、JSON形式、拒否条件を先に決める
- 環境を記録:モデルタグ、量子化、コンテキスト長、実行ツール、メモリを残す
- 失敗を分類:知識不足、入力長、言語、ツール呼び出し、速度を分ける
- ライセンスを確認:商用利用、第三者への提供、表示義務、利用規約を公開前に読む
回答の良し悪しだけでなく、メモリ不足、初回ロード時間、長文時の劣化、ツール呼び出しの再現性も記録しましょう。Qwen3.8がコードで勝っても、日本語の短文分類ではPhi-4-miniの軽さが勝つことがあります。用途別に勝者を分ける方が、運用コストを抑えられます。

選定で起きやすい4つのズレ
失敗1:Ollamaの容量を必要VRAMと断定する
❌ 18GBのモデルだから18GB VRAMで最大文脈まで動くと考える
⭕ 重み容量にKVキャッシュ、ランタイム、画像入力の余裕を加え、短い文脈から確認する
なぜ重要か:モデルが読み込めることと、希望する入力長で安定して動くことは別だからです。
失敗2:最新の大型モデルをノートPCへ入れる
❌ 最新Llamaだからという理由だけでLlama 4 Scoutを選ぶ
⭕ 8GB級ならLlama 3.2 3BやPhi-4-mini、16GB級ならQwen3.5 9Bから始める
なぜ重要か:用途に対して過大なモデルは、速度・発熱・メモリの負担を増やします。
失敗3:「多言語対応」を日本語品質の保証と読む
❌ 対応言語に日本語があるだけで業務採用する
⭕ 敬語、固有名詞、長文指示、根拠付き回答を実データに近い入力で比べる
なぜ重要か:公式の対応範囲は、各社固有の語彙や出力形式まで保証するものではありません。
失敗4:Ollamaで動けばvLLMでも同じと考える
❌ モデル名が同じなら実行基盤を問わず同条件だとみなす
⭕ vLLMの対応版、量子化、テンプレート、GPU要件を公式ドキュメントで再確認する
なぜ重要か:2026年9月22日公開のvLLM v0.30.0にも新モデル対応と破壊的変更が含まれ、ランナーごとの確認が必要だからです。
よくある質問
ローカルLLMのおすすめモデルは結局どれですか?
2026年10月3日時点では、コーディングと総合力ならQwen3.8 27B、日本語と16GB級PCのバランスならQwen3.5 9B、軽量な画像入力ならGemma 4 E4Bが出発点です。1台ですべてを賄わず、用途別に選んでください。
ローカルLLMは無料で使えますか?
多くのモデルは重みを無償で取得できますが、電力、PC・GPU、保守の費用は発生します。また「無料」と「無条件で商用利用できる」は同じではありません。Apache 2.0、MIT、Llama Community Licenseなど、モデルごとの条件を確認してください。
日本語対応でおすすめなのはどれですか?
公式に日本語対応を明記する候補として、Qwen3.5 9B、Ministral 3 8B、Phi-4-miniがあります。モデルサイズと学習言語の違いがあるため、社内文書の要約、敬語、固有名詞を同じ入力で比較して決めるのが安全です。
コーディング向けのローカルLLMはどれですか?
総合的な開発支援はQwen3.8 27B、コードベース探索と複数ファイル編集はDevstral Small 2が候補です。16GB級で始めるならgpt-oss-20bも比較できます。実行前にリポジトリ権限とコマンド実行範囲を制限してください。
GPUなしのノートPCでも動きますか?
CPUやApple統合メモリでも小型・量子化モデルは実行できます。ただし速度はハードウェア、入力長、量子化方式で変わります。8GB級ではLlama 3.2 3BやPhi-4-miniから始め、長いコンテキストを避けて確認してください。
MacではOllamaとMLXのどちらがおすすめですか?
導入の簡単さとローカルAPIを優先するならOllama、Apple Silicon向けの提供形式や細かな実行調整を重視するならMLX系が候補です。まずOllamaの公式タグで品質を確かめ、必要が出た段階でMLX版を比較すると迷いにくくなります。
OllamaとLM Studioの違いは何ですか?
OllamaはCLIとローカルAPIを中心に自動化しやすく、LM StudioはGUIでモデルを探し、量子化版を比較しやすい点が違います。チームのAPI連携ならOllama、非エンジニアを含む手元比較ならLM Studioが始めやすい選択です。
必要なVRAMはどう見積もればよいですか?
量子化済み重みの容量を起点に、KVキャッシュ、ランタイム、画像入力、同時実行の余裕を加えます。本表の値は短い入力での選定目安であり、最大コンテキストの保証ではありません。Ollama起動後の実使用量を確認して調整してください。
Open LLM Leaderboardの順位は参考になりますか?
評価軸の理解には役立ちますが、同Leaderboardは2025年3月に公式終了しました。2026年モデルの当日順位としては扱わず、公式モデルカードと代表業務の再現テストを優先してください。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Qwen3.8-27B公式モデルカード — Qwen Team(モデル仕様・対応ランナー、参照日:2026年10月3日)
- Qwen3.8|Ollama Library — Ollama(タグ容量・コンテキスト長、参照日:2026年10月3日)
- Qwen3.5公式発表 — Qwen Team(対応言語、2026年2月15日発表、参照日:2026年10月3日)
- Gemma 4: Byte for byte, the most capable open models — Google DeepMind(2026年4月2日発表、参照日:2026年10月3日)
- Introducing Gemma 4 12B — Google DeepMind(2026年6月3日発表、参照日:2026年10月3日)
- Gemma 4|Ollama Library — Ollama(モデル容量・コンテキスト長、参照日:2026年10月3日)
- The Llama 4 herd — Meta(2025年4月5日発表、参照日:2026年10月3日)
- Llama 3.2: Revolutionizing edge AI and vision — Meta(2024年9月25日発表、参照日:2026年10月3日)
- Ministral 3 8B公式モデルカード — Mistral AI(仕様・言語・FP8メモリ、参照日:2026年10月3日)
- Devstral Small 2公式モデルカード — Mistral AI(用途・実行環境、参照日:2026年10月3日)
- Phi-4-mini-instruct公式モデルカード — Microsoft(対応言語・制約、参照日:2026年10月3日)
- Introducing gpt-oss — OpenAI(2025年8月5日発表・16GBメモリ、参照日:2026年10月3日)
- End of the Open LLM Leaderboard — Hugging Face Open LLM Leaderboard Team(2025年3月13日、参照日:2026年10月3日)
- New model scheduling — Ollama(2025年9月23日、参照日:2026年10月3日)
- Running GGUF and llama.cpp quants in Transformers — Hugging Face(2026年9月22日、参照日:2026年10月3日)
- vLLM v0.30.0 release — vLLM Project(2026年9月22日、参照日:2026年10月3日)
最後に確認すべきこと
モデル名だけで迷ったら、手元のメモリで動く最小候補を1つ、日本語・コード・画像の中心用途に強い候補を1つ選び、同じ入力で比べてください。Qwen3.8 27Bは高性能なコード・エージェント候補ですが、軽量PCではQwen3.5 9B、Gemma 4 E4B、Ministral 3 8Bの方が運用しやすい場合があります。Llama 4 Scoutは最新世代でも、一般PC向けではありません。
- Ollamaタグとモデル容量を当日に再確認する
- 短いコンテキストから始め、実使用メモリを測る
- 日本語・コード・RAGを代表入力で採点する
- 本番配信前にライセンス、認証、ログ、ロールバックを確認する
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
この記事はAIgent Lab編集部がお届けしました。