2026年9月24日時点でも、Qwen 3.7 はダウンロードできる重みが1本も公式公開されていない世代です。Hugging Face の Qwen 公式アカウントをモデル検索API(author=Qwen+search=3.7)で引くと該当0件、Ollama 公式ライブラリの ollama.com/library/qwen3.7 は HTTP 404(いずれも同日確認)。「qwen 3.7 27b」「qwen 3.7 35b a3b」「qwen 3.7 huggingface」で見つからないのは、探し方が悪いからではなく存在しないからです。
では 27B や 35B-A3B は何なのか。Qwen3.6 世代(2026年4月)と Qwen3.8 世代(2026年8月)のオープンウェイトで、どちらも Apache-2.0 で Hugging Face にあります。Qwen 3.7 は Max・Plus・Flash の3本が、Alibaba Cloud Model Studio と OpenRouter 経由の有償APIとしてのみ動いています。
この記事は2026年6月公開の「Qwen 3.7 Max 徹底解説」をファミリー全体の地図として書き直したものです。API 側(Max・Plus・Flash)とオープンウェイト側(27B・35B-A3B の入手先とローカル実行の目安)を、Hugging Face のモデルカード、Model Studio の料金ページ、QwenLM の GitHub だけで裏を取り、参照日を添えて並べ直します。
Qwen 3.7の全体像|2026年9月5日時点のスナップショット
Qwen は「有償APIの最前線」と「1世代前後のオープンウェイト」の二本立てで動いており、3.7 は前者だけに存在する世代です。2026年9月24日現在、Alibaba Cloudの公式モデル一覧はコーディング用途に qwen3.7-plus(1Mコンテキスト)を推奨し、最上位の推論用途には qwen3.8-max を案内しています。
| モデル | パラメータ | 構成 | コンテキスト | 提供形態 | ライセンス |
|---|---|---|---|---|---|
Qwen 3.7 Max(qwen3.7-max) |
2026年9月5日時点で公式に確認できていない | 同左 | 100万トークン(OpenRouter掲載値) | 有償APIのみ | 重み非公開 |
Qwen 3.7 Plus(qwen3.7-plus) |
同上 | 同上 | 100万トークン(同) | 有償APIのみ | 重み非公開 |
Qwen 3.7 Flash(qwen3.7-flash) |
同上 | 同上 | 100万トークン(同) | 有償APIのみ | 重み非公開 |
| Qwen3.6-27B | 27,781,427,952 | 密(Gated DeltaNet+Gated Attention)+ビジョンエンコーダ | 262,144(最大1,010,000) | オープンウェイト | Apache-2.0 |
| Qwen3.6-35B-A3B | 35,951,822,704(活性化3B) | MoE・エキスパート256のうちルーテッド8と共有1を活性化 | 262,144(最大1,010,000) | オープンウェイト | Apache-2.0 |
| Qwen-AgentWorld-35B-A3B | 34,660,610,688(活性化3B) | MoE・言語ワールドモデル | 262,144 | オープンウェイト | Apache-2.0 |
| Qwen3.8-27B | 27,781,427,952 | 密+ビジョンエンコーダ | 262,144(最大1,000,000) | オープンウェイト | Apache-2.0 |
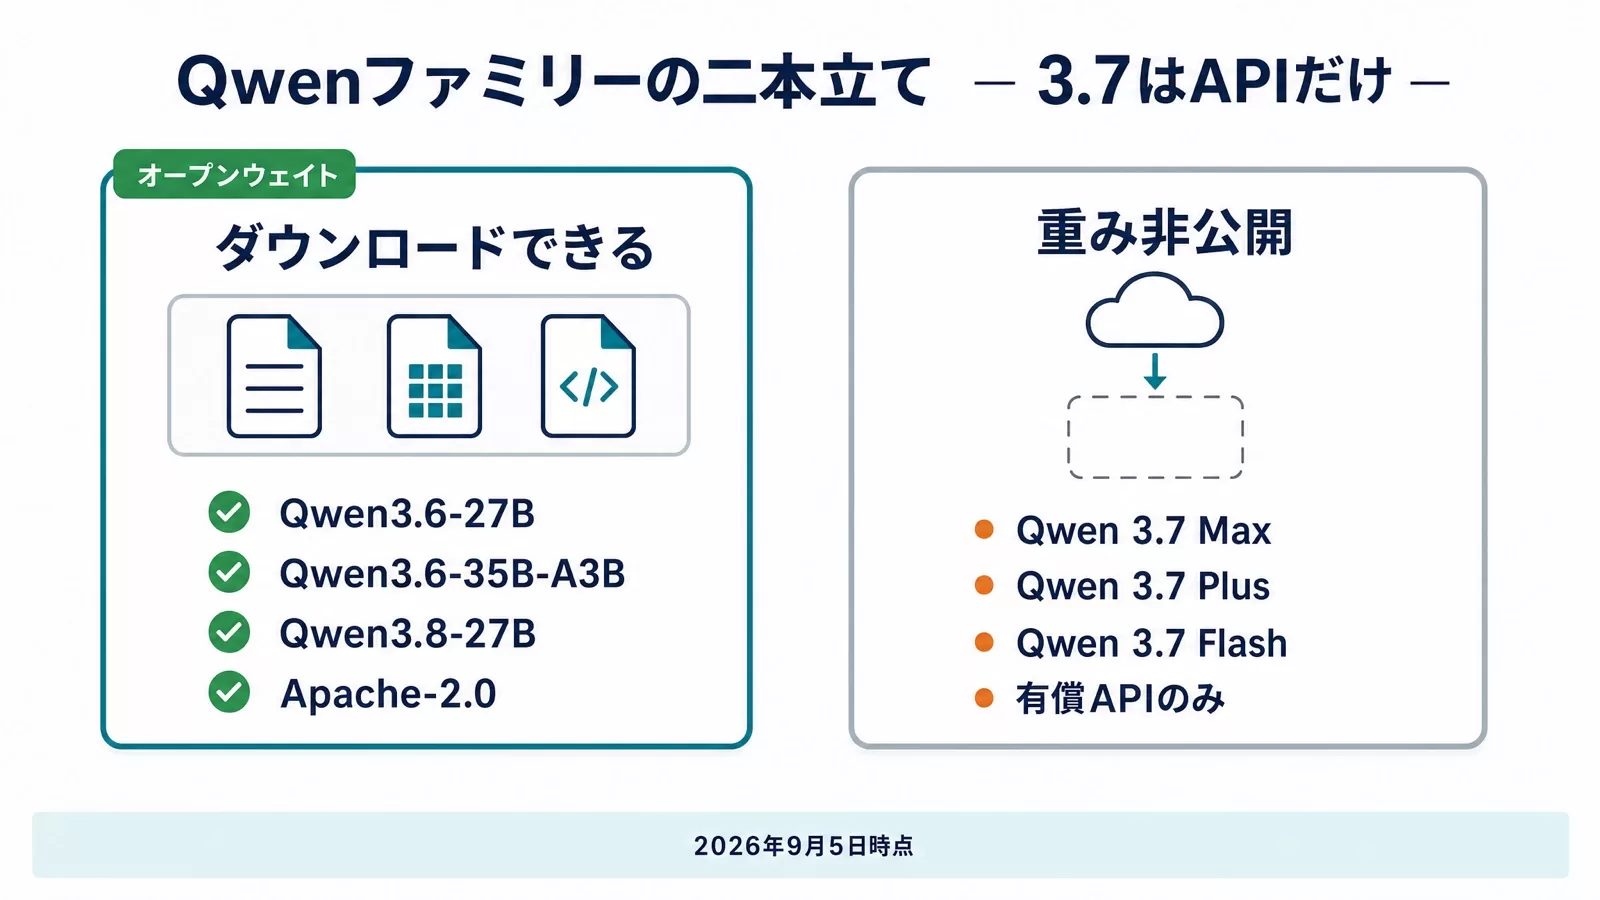
パラメータ数は Hugging Face の safetensors メタデータから取った実数です(参照日: 2026-09-05)。Qwen 3.7 の3本は総パラメータ数もアクティブパラメータ数も公表がないため、推定値を書かずに「公式に確認できていない」としています。よく見る「397B-A17B」は Qwen3.5-397B-A17B の構成で、Max の仕様として公式に示されたものではありません。コンテキスト長も、料金ページの課金区分 0<Token≤1M と OpenRouter の掲載値から「100万トークン級」と読めるだけです。
Qwen 3.7シリーズのAPIモデル|Max・Plus・Flashの違い
3.7 世代のAPIは3階層で、Model Studio のドキュメントと OpenRouter の掲載仕様を突き合わせると扱えるモダリティに差があります。
| モデルID | 既定の実体 | 入出力 | コンテキスト/最大出力 | 位置づけ |
|---|---|---|---|---|
qwen3.7-max |
qwen3.7-max-2026-05-20 |
テキストのみ | 1,000,000/131,072 | 3.7世代の最上位。思考モードと非思考モードの両対応 |
qwen3.7-max-2026-06-08 |
— | テキスト+画像・動画 | 1,000,000/131,072 | マルチモーダルAPIを使えるのはこのスナップショットのみ |
qwen3.7-plus |
qwen3.7-plus-2026-05-26 |
テキスト+画像 | 1,000,000/131,072 | Model Studio の推奨モデル一覧に現役で載っている実務層 |
qwen3.7-flash |
qwen3.7-flash-2026-07-15 |
テキスト+画像・動画 | 1,000,000/65,536 | 大量処理・低コスト層 |
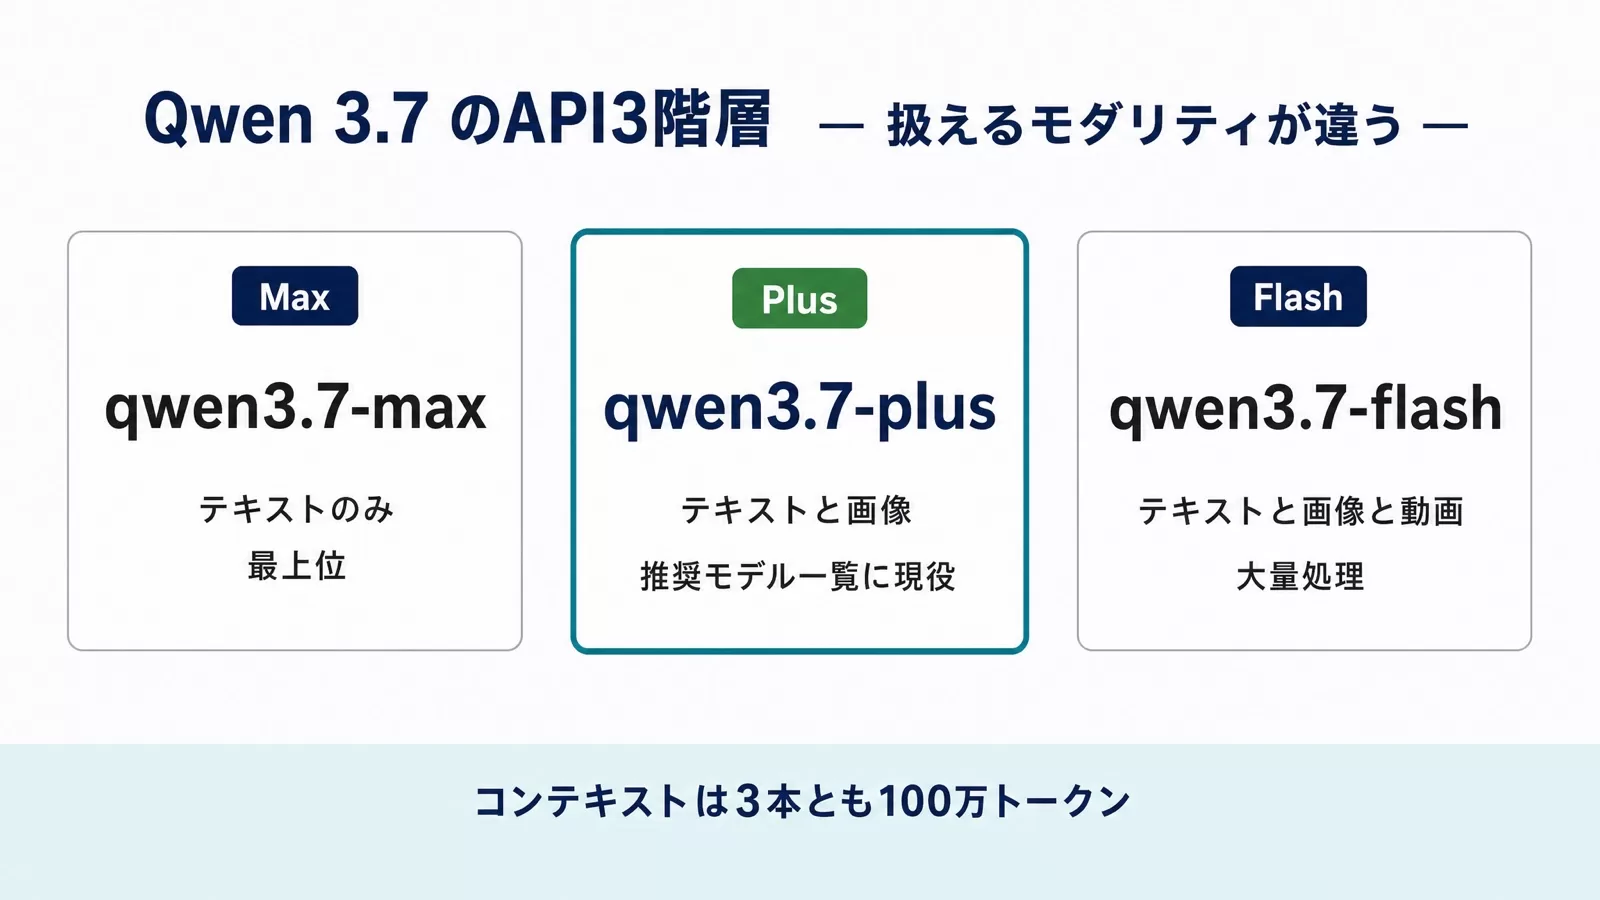
見落とされがちなのが、既定エイリアスの qwen3.7-max はテキスト専用という点です。Model Studio のテキスト生成ドキュメント(最終更新: 2026年9月4日)に「qwen3.7-max、qwen3.7-max-2026-05-20、qwen3.6-max-preview はテキストAPIのみをサポートする」と明記されており、画像を投げる前提で指定すると URL エラーになります。マルチモーダルが要るなら qwen3.7-max-2026-06-08 か Qwen3.8-Max です。
もうひとつ、同じ日付の推奨モデル一覧でテキスト生成の筆頭に並ぶのは qwen3.8-max・qwen3.7-plus・qwen3.8-flash です。3.7 世代で推奨枠に残っているのは Plusで、Max は一覧から外れています。
「Qwen 3.7 27B」「35B-A3B」で探して来た人への答え
この記事に届く検索語のうち実需要が大きいのは「qwen 3.7 27b」「qwen 3.7 35b a3b」「qwen 3.7 moe」「qwen 3.7 huggingface」「qwen 3.7 ローカル」といったオープンウェイト系です。答えを先に置きます。
- 27B が欲しい →
Qwen/Qwen3.6-27B(2026年4月)またはQwen/Qwen3.8-27B(2026年8月)。どちらも密モデル+ビジョンエンコーダで Apache-2.0。 - 35B-A3B(MoE)が欲しい →
Qwen/Qwen3.6-35B-A3B。総35B・活性化3B。エキスパート256のうちルーテッド8と共有1を使う構成。 - エージェント寄りの 35B-A3B →
Qwen/Qwen-AgentWorld-35B-A3B(2026年6月24日公開)。ただし後述のとおり用途が特殊です。 - Qwen 3.7 そのものの重み → 2026年9月5日時点で公開されていません。
MoE(Mixture of Experts)は「総パラメータは大きいが、1トークンの推論で使うのは一部だけ」という構成です。Qwen3.6-35B-A3B のモデルカードには「エキスパート256、活性化はルーテッド8と共有1」と書かれており、総35B のうち推論時に動くのは約3B。ディスクとメモリには35B分を載せるのに、1トークンあたりの計算量は3Bクラス=置き場所は食うが速い、という挙動です。27B の密モデルとは得意不得意が逆になります。
Ollama で「qwen3.7」を名乗るモデルには手を出さない
Ollama で qwen3.7 を検索すると aratan/qwen3.7-35b-q4 や aratan/qwen3.7-abliterated-35b-q4(約22,600プル)が並びます。これらは公式ライブラリではなくユーザー投稿枠で、説明文には投稿者自身が「No Oficial(非公式)」と書いています。ollama.com/library/qwen3.7 は404で、公式ライブラリに qwen3.7 は存在しません。名前が似ているだけの派生モデルを Qwen 3.7 の重みだと思って本番に載せないでください。ライセンスと素性の確認はオープンウェイトモデル導入の落とし穴で整理しています。
Hugging Faceでの配布状況と入手手順
Qwen 公式アカウント huggingface.co/Qwen にあるオープンウェイトのうち、この記事で扱う4本はすべて Apache-2.0 です(参照日: 2026-09-05)。
| リポジトリ | 公開時期 | 重みの形式 | safetensors 実サイズ |
|---|---|---|---|
Qwen/Qwen3.6-27B |
2026年4月 | BF16 | 約55.6GB |
Qwen/Qwen3.6-35B-A3B |
2026年4月 | BF16 | 約71.9GB |
Qwen/Qwen-AgentWorld-35B-A3B |
2026年6月 | BF16 | 約69.3GB |
Qwen/Qwen3.8-27B |
2026年8月 | BF16 | 約55.6GB |
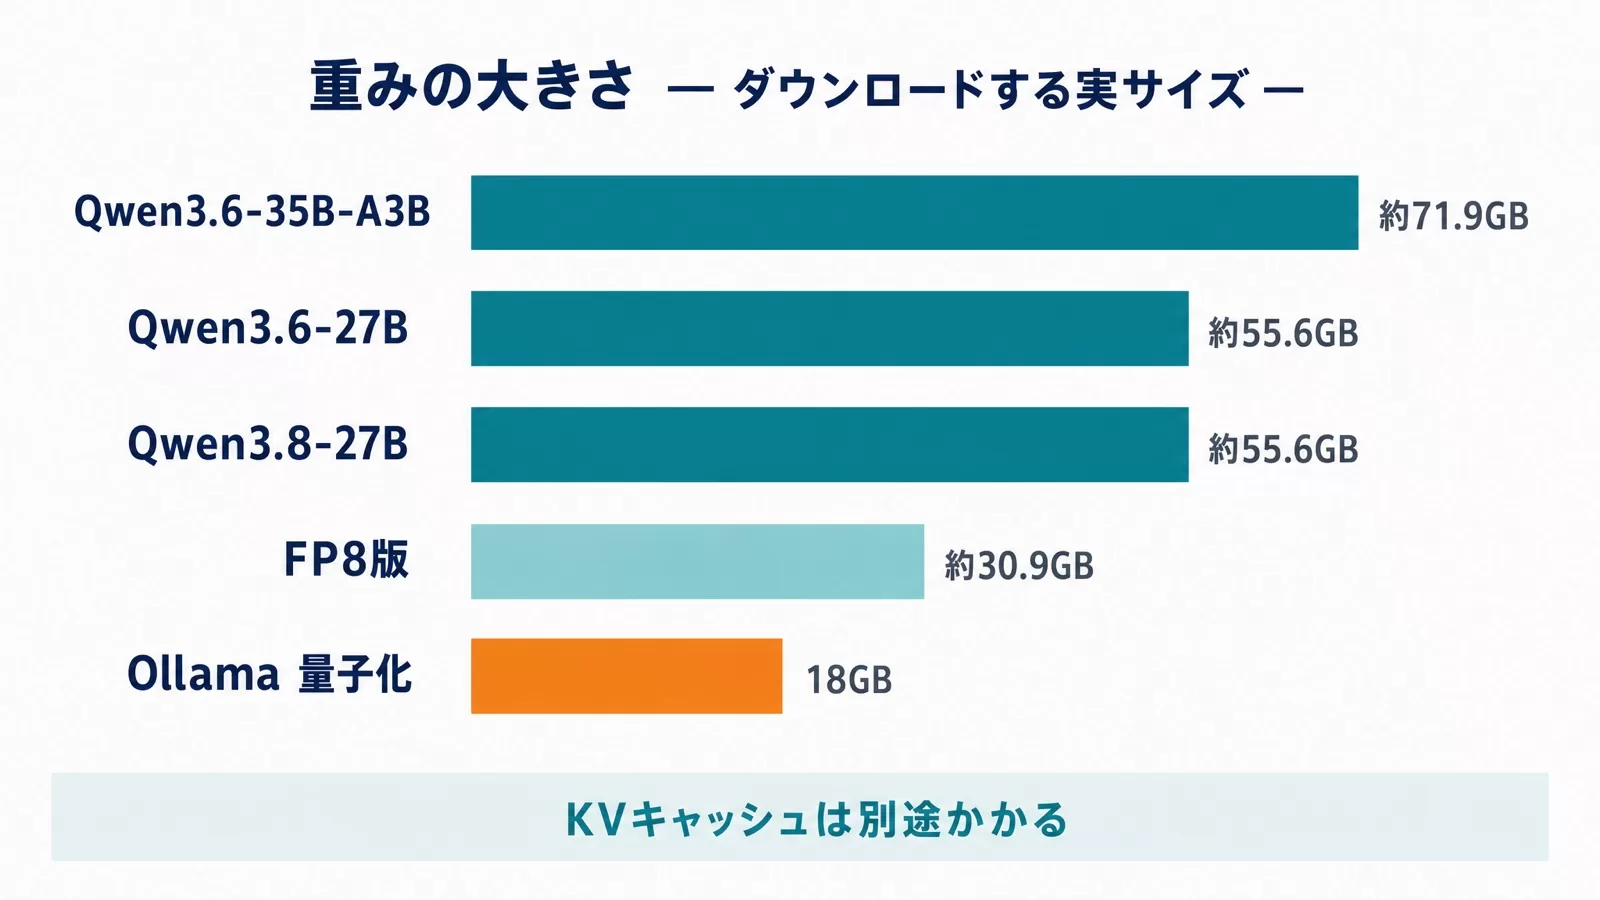
サイズは safetensors ファイルの合計です。BF16 は1パラメータあたり2バイトなので、27B で約55GB、35B で約72GB という計算どおり。同じ内容の FP8 版(Qwen3.6-27B-FP8・Qwen3.8-27B-FP8)は約30.9GB まで落ちます。入手はコマンド1本です(動作環境: Python 3.10 以上、huggingface_hub 最新版)。
# Hugging Face CLI で重みを取得(例: Qwen3.6-27B)
pip install -U huggingface_hub
hf download Qwen/Qwen3.6-27B --local-dir ./Qwen3.6-27B

# MoE 版 / 最新世代の密モデル
hf download Qwen/Qwen3.6-35B-A3B --local-dir ./Qwen3.6-35B-A3B
hf download Qwen/Qwen3.8-27B --local-dir ./Qwen3.8-27B
Hugging Face Hub に届かない環境には ModelScope にも同じ重みがあり、SGLang は SGLANG_USE_MODELSCOPE=true、vLLM は VLLM_USE_MODELSCOPE=true で取得元が切り替わります。
ローカル実行の目安|重みサイズ・vLLM・SGLang・Ollama
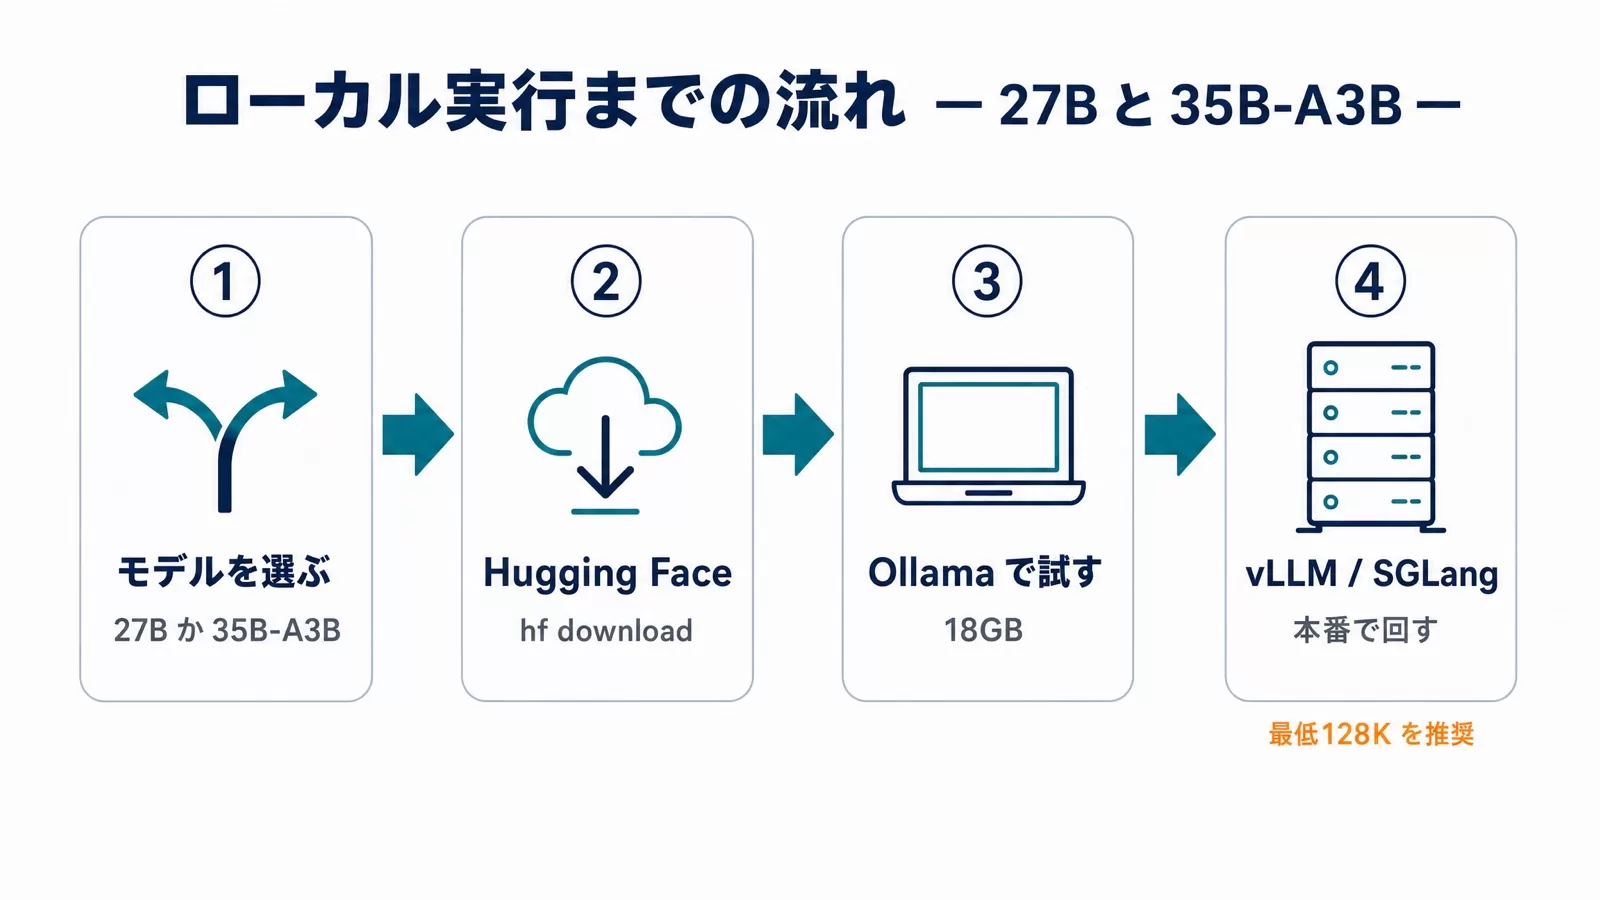
「27B なら手元のGPUで動くのか」を判断するとき押さえるのは 重みのサイズと、別に積み上がるKVキャッシュです。上の表は重みだけの大きさで、実際に必要なメモリにはコンテキスト長ぶんのKVキャッシュと実行時のワークスペースが乗ります。同じ 27B でも 256K で開くのと 32K に絞るのとでは必要量が違います。
Qwen3.6 のモデルカードには但し書きがあります。「既定コンテキスト長は262,144トークン。メモリ不足(OOM)が出る場合はコンテキストウィンドウを縮めることを検討してほしい。ただし思考能力を保つには最低128Kの維持を推奨する」。削ればメモリは減るが、削りすぎると持ち味が落ちるというトレードオフです。
サーバ用途:vLLM と SGLang
本番のスループットを取るなら vLLM か SGLang。モデルカードの起動コマンドがそのまま使えます(テンソル並列8枚・コンテキスト262,144の例)。本番に入れる前に必ずテスト環境で動作確認してください。
# vLLM(vllm>=0.19.0 推奨)
vllm serve Qwen/Qwen3.6-27B \
    --port 8000 \
    --tensor-parallel-size 8 \
    --max-model-len 262144 \
    --reasoning-parser qwen3

# SGLang(sglang>=0.5.10 推奨)
python -m sglang.launch_server \
    --model-path Qwen/Qwen3.6-35B-A3B \
    --port 8000 \
    --tp-size 8 \
    --mem-fraction-static 0.8 \
    --context-length 262144 \
    --reasoning-parser qwen3
ツール呼び出しを使うなら --tool-call-parser qwen3_coder を足します。Qwen-AgentWorld-35B-A3B は vLLM 起動時に --language-model-only が必須で、「アーキテクチャにビジョンコンポーネントの定義が含まれるがチェックポイントには言語モデルの重みしか入っていないため、このフラグがないと初期化に失敗する」とモデルカードにあります。vLLM 本番運用の設計はvLLMでオープンLLMをセルフホストする本番運用ガイドにまとめています。
手元の1台で試す:Ollama
まず動かして感触を掴むなら Ollama 公式ライブラリが最短です。量子化済みタグのサイズは次のとおり(参照日: 2026-09-05)。
| タグ | ダウンロードサイズ | コンテキスト | 入力 |
|---|---|---|---|
qwen3.6:27b |
18GB | 256K | テキスト・画像 |
qwen3.6:35b(qwen3.6:latest) |
23GB | 256K | テキスト・画像 |
qwen3.8:27b(qwen3.8:latest) |
18GB | 256K | テキスト・画像 |
qwen3.8:27b-mlx-bf16 |
56GB | 256K | テキスト・画像 |
# Ollama 公式ライブラリから取得して対話(MoE 版は qwen3.6:35b)
ollama run qwen3.8

# OpenAI 互換の呼び出し(ローカル)
curl http://localhost:11434/api/chat -d '{
  "model": "qwen3.8",
  "messages": [{"role": "user", "content": "Hello!"}]
}'
18GB は BF16 の 55.6GB を約3分の1に圧縮した配布物です。ダウンロードサイズと実行時メモリは別物ですが、この関係を掴むと見積もりがぶれません。Ollama 側の運用手順はOllamaの使い方 2026、ローカルLLMをエージェントに組み込む設計はローカルAIエージェント入門で扱っています。
Qwen-AgentWorld-35B-A3Bという「35B-A3B」の正体
「qwen 3.7 35b a3b」で探している人の一部が向かう先が、2026年6月24日に公開された Qwen-AgentWorld-35B-A3B です。これは Qwen 3.7 の小型版ではありません。ベースは Qwen3.5-35B-A3B-Baseで、MCP(ツール呼び出し)・検索・ターミナル・SWE・Android・Web・OS の7ドメインを1本でカバーする「言語ワールドモデル」として学習されています。
役割が独特です。ワールドモデルはエージェントの行動と履歴を受け取って「次に環境がどんな状態になるか」を予測する側=本体ではなく訓練・評価用のシミュレータです。GitHub の README には、実世界の対話軌跡1,000万件超で CPT→SFT→RL の3段階学習を行ったと書かれています。
AgentWorldBenchのスコアは「エージェント性能ランキング」ではない
同時公開された AgentWorldBench の結果はモデルカードに載っています(各ドメインの5次元ルーブリック平均を0〜100に正規化)。
| モデル | MCP | Search | Terminal | SWE | OS | 総合 |
|---|---|---|---|---|---|---|
| Qwen-AgentWorld-397B-A17B | 68.24 | 37.82 | 57.73 | 68.49 | 67.89 | 58.71 |
| GPT-5.4 | 70.10 | 37.26 | 53.69 | 66.29 | 68.58 | 58.25 |
| Claude Opus 4.6 | 69.90 | 29.30 | 57.51 | 64.55 | 70.20 | 57.80 |
| Claude Opus 4.8 | 54.93 | 35.14 | 59.18 | 64.10 | 66.62 | 56.59 |
| Qwen-AgentWorld-35B-A3B | 64.79 | 36.69 | 53.96 | 65.63 | 65.92 | 56.39 |
| Claude Sonnet 4.6 | 70.00 | 28.79 | 56.98 | 64.52 | 63.17 | 56.04 |
| Gemini 3.1 Pro | 59.07 | 30.21 | 52.47 | 59.07 | 66.92 | 54.57 |
この表を「Qwen がエージェント性能で GPT-5.4 を抜いた」と読むのは誤りです。採点しているのは Format・Factuality・Consistency・Realism・Quality の5次元で、予測した環境の観測がどれだけもっともらしいかであって、エージェントがタスクを完遂できたかどうかではありません。しかも Qwen-AgentWorld は次状態予測に特化学習した専用モデルで、汎用モデル側は特化学習なしで採点されています。土俵が違う比較だという前提を外すと数字だけが独り歩きします。
使いどころは限定的です。「エージェントの検証環境を安全に大量生成したい」「実機を叩かずに回帰テストを回したい」チームには効きますが、日常の推論モデルとして 35B-A3B が欲しいだけなら Qwen3.6-35B-A3B のほうが素直です。
API料金|Model Studioの公式単価(2026年9月5日時点)
ここがいちばん誤情報の多い領域です。公式の qwen3.7-plusモデル情報 と テキスト生成モデル一覧 を2026年9月24日に再確認し、料金表はモデルページに掲載された原価表から抜き出します。単価は100万トークンあたりで、入力と出力は別単価です。
| モデル | リージョン/デプロイ範囲 | 入力トークン区分 | 入力 | 出力 |
|---|---|---|---|---|
qwen3.7-max |
シンガポール(International) | 100万トークンまで | $2.5 | $7.5 |
qwen3.7-max |
日本(東京)/Global 範囲 | 100万トークンまで | $1.65 | $4.951 |
qwen3.8-max |
シンガポール(International) | 100万トークンまで | $2 | $6 |
qwen3.8-max |
日本(東京)/Global 範囲 | 100万トークンまで | $1.65 | $4.951 |
qwen3.7-plus |
日本(東京)/Japan 範囲 | 256Kまで | $0.4 | $1.6 |
qwen3.7-plus |
日本(東京)/Japan 範囲 | 256K超〜100万 | $1.2 | $4.8 |
qwen3.7-plus |
Global 範囲(定価) | 256Kまで | $0.276 | $1.101 |
qwen3.7-flash |
シンガポール(International) | 32Kまで | $0.030 | $0.130 |
qwen3.7-flash |
シンガポール(International) | 256K超〜100万 | $0.200 | $0.800 |
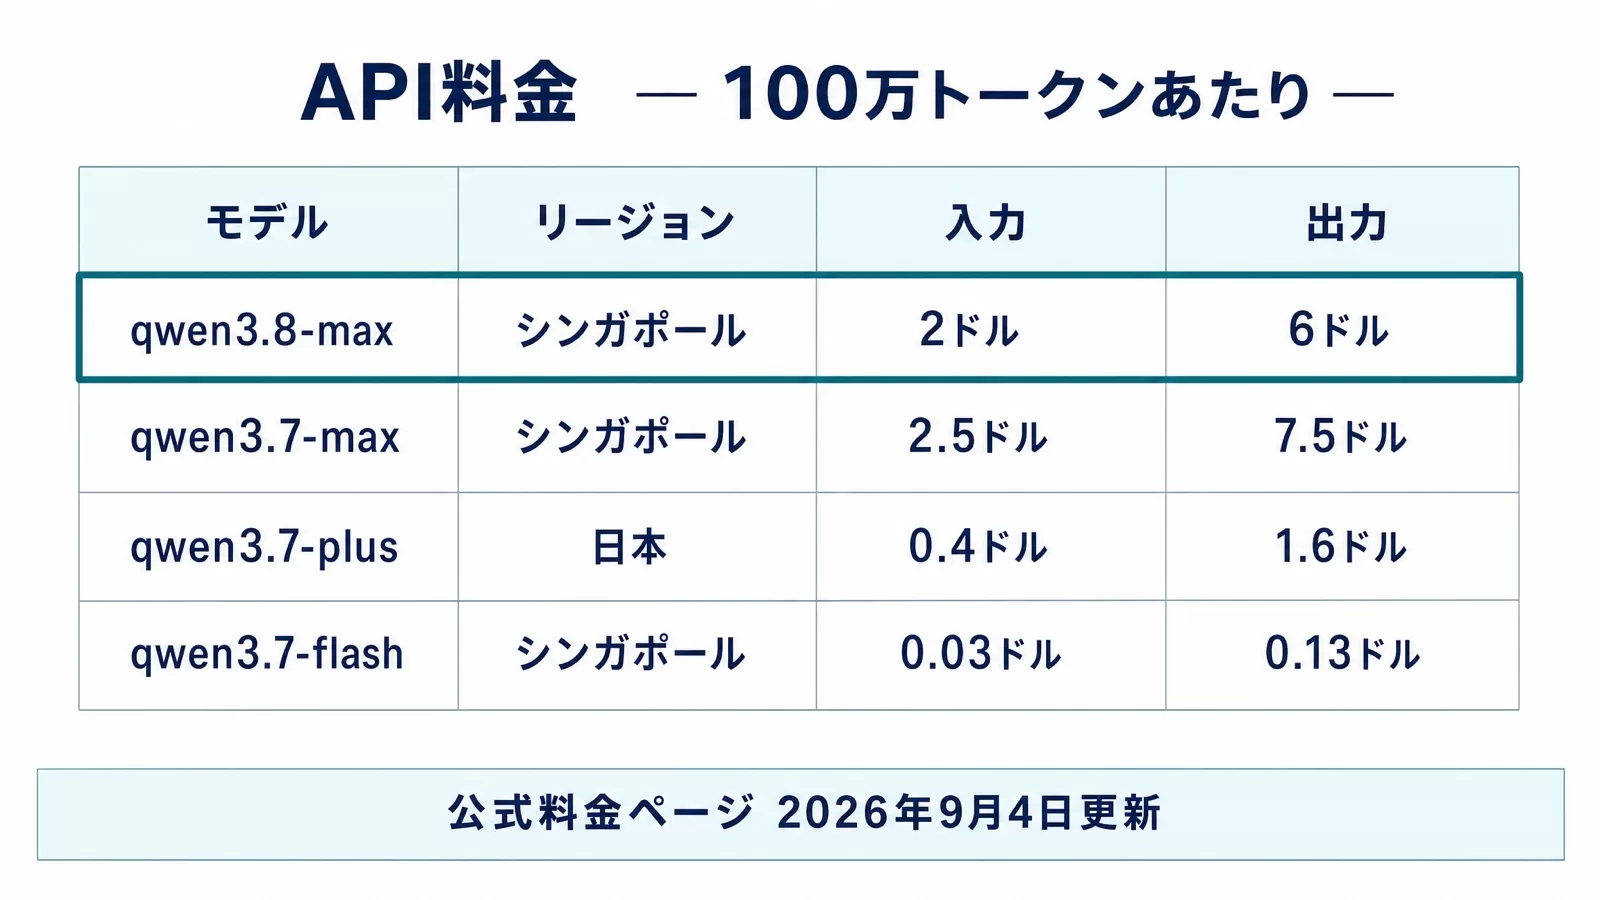
読み取れるのは3点。シンガポールでは 3.8-Max($2/$6)が 3.7-Max($2.5/$7.5)より安いので 3.7-Max を新規に選ぶ理由は薄い。日本(東京)リージョンが使え、Max 系は Global 範囲の $1.65/$4.951 とシンガポール定価より安く出る。Plus と Max は単価が1桁近く違うので、タスクを振り分ける価値が大きい。
夜間割引・無料枠・バッチ・キャッシュ
よく見る「Max がオフピークで80%オフ」という説明は、確認範囲では公式料金ページに根拠が見当たりませんでした。割引ラベルが付いているのは Plus のほうです。
- 夜間割引:
qwen3.7-plusの Global 範囲に「期間限定の夜間60%オフ、日中20%オフ」。夜間は課金時刻ベースで22:00〜08:00(UTC+8)=日本時間23:00〜翌朝09:00。 - 無料枠: 各モデル100万トークン。有効期限は Model Studio の有効化日・モデルのリリース日・申請承認日のいずれか遅いほうから90日。付くのはシンガポールリージョンのみです。
- バッチ推論: 対応モデルは入力・出力ともリアルタイム推論の50%。
- コンテキストキャッシュ: 明示キャッシュの作成は通常入力単価の125%、ヒットは10%。バッチ割引との同時適用はできません。
キャッシュ設計の考え方そのものはプロンプトキャッシュ比較2026で3大LLM横断に整理しています。
Qwen 3.7 MaxとQwen3.8-Maxの関係|いま新規で選ぶなら
推奨モデル一覧では qwen3.8-max がテキスト生成の筆頭に置かれ、オープンウェイト側も Qwen3.8-27B と Qwen3.8-2.4T-A95B が2026年8月に Hugging Face へ出ました。3.7 世代は「Plus と Flash は現役、Max は後継に置き換わりつつある」状態です。
判断の目安はこうです。すでに qwen3.7-max で本番が回っているなら急いで剥がす理由はない(料金ページに提供終了の告知はありません)。ただし新規に組むなら、同一リージョンで安く新しい 3.8-Max を選ばない理由が見つかりません。マルチモーダル入力が要るならなおさらです。自前運用まで含めた 3.8 世代の判断材料はQwen3.8-Max登場|自前運用の判断はまだ早い理由で詳しく書きました。中国発モデル同士の比較ならGLM-5.2徹底比較、欧州発の対抗馬はSoofi S 30Bが参考になります。
実装コード|OpenAI互換APIでQwen 3.7を呼ぶ
Model Studio は OpenAI 互換エンドポイントなので、既存の OpenAI SDK からモデル名とベースURLを差し替えるだけで動きます。以下はシンガポールリージョンの例で、{WorkspaceId} は自分のワークスペースIDに置き換えます。本番投入の前に必ずテスト環境で動作確認してください。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3.7-max",          # テキスト専用。画像を送るなら qwen3.7-max-2026-06-08
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "社内ドキュメントの要約方針を3案出してください。"},
    ],
)
print(completion.choices[0].message.content)
コストを効かせるならタスクの重さでモデルを分けます。分類・要約・抽出のような定型は Flash、実務の生成は Plus、長い推論やエージェントループだけ Max、という3段構えが料金表の形とかみ合います。
ROUTES = {
    "classify": "qwen3.7-flash",   # 32Kまで $0.030 / $0.130
    "draft":    "qwen3.7-plus",    # 256Kまで $0.4 / $1.6(日本)
    "reason":   "qwen3.8-max",     # 100万まで $2 / $6(シンガポール)
}

def ask(kind: str, prompt: str) -> str:
    res = client.chat.completions.create(
        model=ROUTES[kind],
        messages=[{"role": "user", "content": prompt}],
    )
    return res.choices[0].message.content
ローカルの Qwen3.6/3.8 を混ぜる構成も同じ書き方で、vLLM か Ollama を OpenAI 互換サーバとして立てて base_url を差し替えれば機密データの経路をローカルへ逃がせます。設計の全体像はClaude Code × Qwen ローカルLLMハイブリッド開発を参照してください。
# ローカル(vLLM / Ollama)と Model Studio を同じコードで切り替える
LOCAL = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

def pick(sensitive: bool):
    return LOCAL if sensitive else client   # 社外に出せないデータはローカルへ
つまずきやすい5つのポイント
既存の解説や検索結果を公式情報と突き合わせて、食い違った点を挙げます。
- ❌ 「Qwen 3.7 の 27B をダウンロードして動かす」→ ⭕ 3.7 に公開された重みはありません。27B は Qwen3.6-27B か Qwen3.8-27B です。
- ❌ 「
qwen3.7-maxに画像を投げる」→ ⭕ 既定エイリアスはテキスト専用でURLエラーになります。マルチモーダルはqwen3.7-max-2026-06-08か 3.8 系です。 - ❌ 「AgentWorldBench 総合1位=エージェント性能1位」→ ⭕ 環境シミュレーションの品質を測る指標で、タスク完遂率ではありません。専用学習モデルと汎用モデルを並べた表でもあります。
- ❌ 「オフピークで Max が80%オフ」→ ⭕ 公式料金ページで夜間割引の表示があるのは Plus の Global 範囲です。Max には割引ラベルが付いていません。
- ❌ 「Ollama で
qwen3.7を pull する」→ ⭕ 公式ライブラリに qwen3.7 はなく404です。検索に出るのはユーザー投稿の非公式モデルです。
よくある質問
Qwen 3.7 のオープンウェイトはいつ公開されますか?
2026年9月5日時点で、公開予定の公式アナウンスは確認できていません。Qwen 公式アカウントには 3.6 世代(2026年4月)と 3.8 世代(2026年8月)の重みがあり、3.7 だけが飛んでいる状態です。
Qwen 3.7 Max のパラメータ数は何Bですか?
総パラメータ数もアクティブパラメータ数も公表されておらず、2026年9月5日時点で公式に確認できていません。「397B-A17B」は Qwen3.5-397B-A17B の構成であり、Max の仕様ではありません。
Qwen 3.7 Plus と Flash はまだ使えますか?
使えます。推奨モデル一覧(2026年9月4日更新)に qwen3.7-plus が載り、Flash も料金ページに現役の単価表があります。
日本リージョンから使えますか?
使えます。料金ページの日本(東京)の表では、Max 系が Global 範囲の $1.65/$4.951、qwen3.7-plus が Japan 範囲の $0.4/$1.6(256Kまで)です。ただし無料枠が付くのはシンガポールリージョンだけです。
27B と 35B-A3B はどちらを選べばいいですか?
載せやすさと安定を取るなら密モデルの 27B、メモリに余裕があって1トークンあたりの計算量を下げたいなら MoE の 35B-A3B です。35B-A3B は総35Bぶんのメモリが要る一方、推論時に動くのは約3Bぶんです。
まとめ:今日から始める3つのアクション
- 今日: 手元で試すなら
ollama run qwen3.8(18GB)。API なら Model Studio のシンガポールリージョンで無料枠100万トークンを使いqwen3.7-plusから触る。 - 今週中: 自社のタスクを「分類・抽出」「生成」「長い推論」に仕分けし、Flash/Plus/Max の3段ルーティングで、日本リージョンの単価を使って見積もりを作り直す。
- 今月中: 機密データの経路だけ Qwen3.6-27B か Qwen3.8-27B のローカル実行へ切り出し、同じコードから切り替えられる形にする。
更新履歴
- 2026年9月5日: Max 単体の解説から、ファミリー全体(API3階層と 3.6/3.8 のオープンウェイト、Qwen-AgentWorld)を扱う構成へ全面改稿。料金を Model Studio 公式ページ(2026年9月4日更新)の値へ更新し、日本リージョンの単価・オープンウェイトの入手手順・ローカル実行の目安を追加。公式に確認できない割引率・パラメータ数・事例の記述を削除。
- 2026年7月21日: 旧版の最終更新。2026年6月30日: 初版公開。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Qwen 公式アカウント — Hugging Face(参照日: 2026-09-05)
- Qwen3.6-27B/Qwen3.6-35B-A3B/Qwen3.8-27B/Qwen-AgentWorld-35B-A3B の各モデルカード — Hugging Face(参照日: 2026-09-05)
- QwenLM/Qwen-AgentWorld — GitHub(参照日: 2026-09-05)
- Model inference pricing — Alibaba Cloud Model Studio(最終更新 2026-09-04・参照日: 2026-09-05)
- Text generation/Recommended models — Alibaba Cloud Model Studio(最終更新 2026-09-04・参照日: 2026-09-05)
- qwen3.8/qwen3.6 — Ollama 公式ライブラリ(参照日: 2026-09-05)
- Qwen3.7 Max — OpenRouter(参照日: 2026-09-05)
関連記事
- Qwen3.8-Max登場|自前運用の判断はまだ早い理由 — 後継世代を自前で持つかの判断
- vLLMでオープンLLMをセルフホスト — 27B/35B-A3B を本番で回す設計
- Qwen3.5-Omni APIガイド — 音声・映像を扱う Qwen 系の別ライン
この記事を読んで、社内のどのタスクをローカルLLMに寄せるか整理したくなった方へ
UravationではAIエージェント導入の研修・コンサルを行っています。モデル選定、コスト設計、機密データを扱う経路の切り分けまで伴走します。お気軽にご相談ください。