2026年9月20日時点の結論:Open Code Review(CLI名 ocr)は、Alibaba が社内の公式 AI コードレビュー補助ツールを Apache-2.0 で公開したものです。GitHub API で当日取得した star 数は 38,001、最新リリースは v1.12.7(2026年9月19日)。「AI レビューは当たり外れが大きい」に対する答えが設計そのものに書かれていて、間違えてはいけない工程(どのファイルを見るか・どのルールを当てるか・どの行に貼るか)を LLM ではなくプログラムが担当し、判断だけをエージェントに任せるハイブリッド構成になっています。
先に持ち帰るべき点は3つ。①公式が掲げる優位は precision(誤検知の少なさ)であって recall ではありません——README が「汎用エージェントより recall は低い。ノイズより精度を優先した意図的なトレードオフ」と明記しています。②レビューコメントの既定言語は英語で、日本語で出すには ocr config set language が要ります。③LLM の API キーは自分で用意するのが既定ですが、Claude Code などのサブスク枠を使う委任モードならキー無しで動きます。
対象読者はコーディングエージェントの出力をレビューしてマージする立場の開発者・テックリード・PM。この記事は公式リポジトリの README・ドキュメント原文・CI サンプル・リリースノートだけを根拠に書いています(筆者は本番リポジトリでの実行はしていないため、コマンドはすべて公式の例として示します)。
エージェントに書かせる量が増えると、最初に詰まるのはレビューです。1つの PR が数十ファイル・1,000行を超えてくると、人が読み切れないぶんを AI に読ませたくなる。ところが Claude Code のような汎用エージェントに「この差分をレビューして」と投げると、手応えが毎回違う。全部見たと言いながら数ファイルしか触れていなかったり、指摘の行番号が実際のコードとずれていたり、同じ差分を2回投げると違う結論が返ってきたりします。
この記事では、公式ドキュメントに書かれている範囲だけで、何がプログラムで固定され、何が LLM に委ねられているのかを分解します。そのうえで導入手順、GitHub Actions への組み込み、自分のエージェント開発で使える部分、そして触る前に知っておくべき注意点を並べます。
Open Code Reviewとは|Alibaba発のハイブリッドAIレビュー
Open Code Review は、Git の diff を読み、変更ファイルをツール利用機能つきのエージェント経由で LLM に送り、行レベルの精度で構造化されたレビューコメントを生成する CLI ツールです。GitHub リポジトリの README は「もともと Alibaba Group 社内の公式 AI コードレビューアシスタントとして誕生し、過去2年間で数万人の開発者に提供され、数百万件のコード欠陥を発見してきた」と説明しています。diff がない場面でも ocr scan でファイル全体をレビューでき、馴染みのないコードベースの監査に使えます。
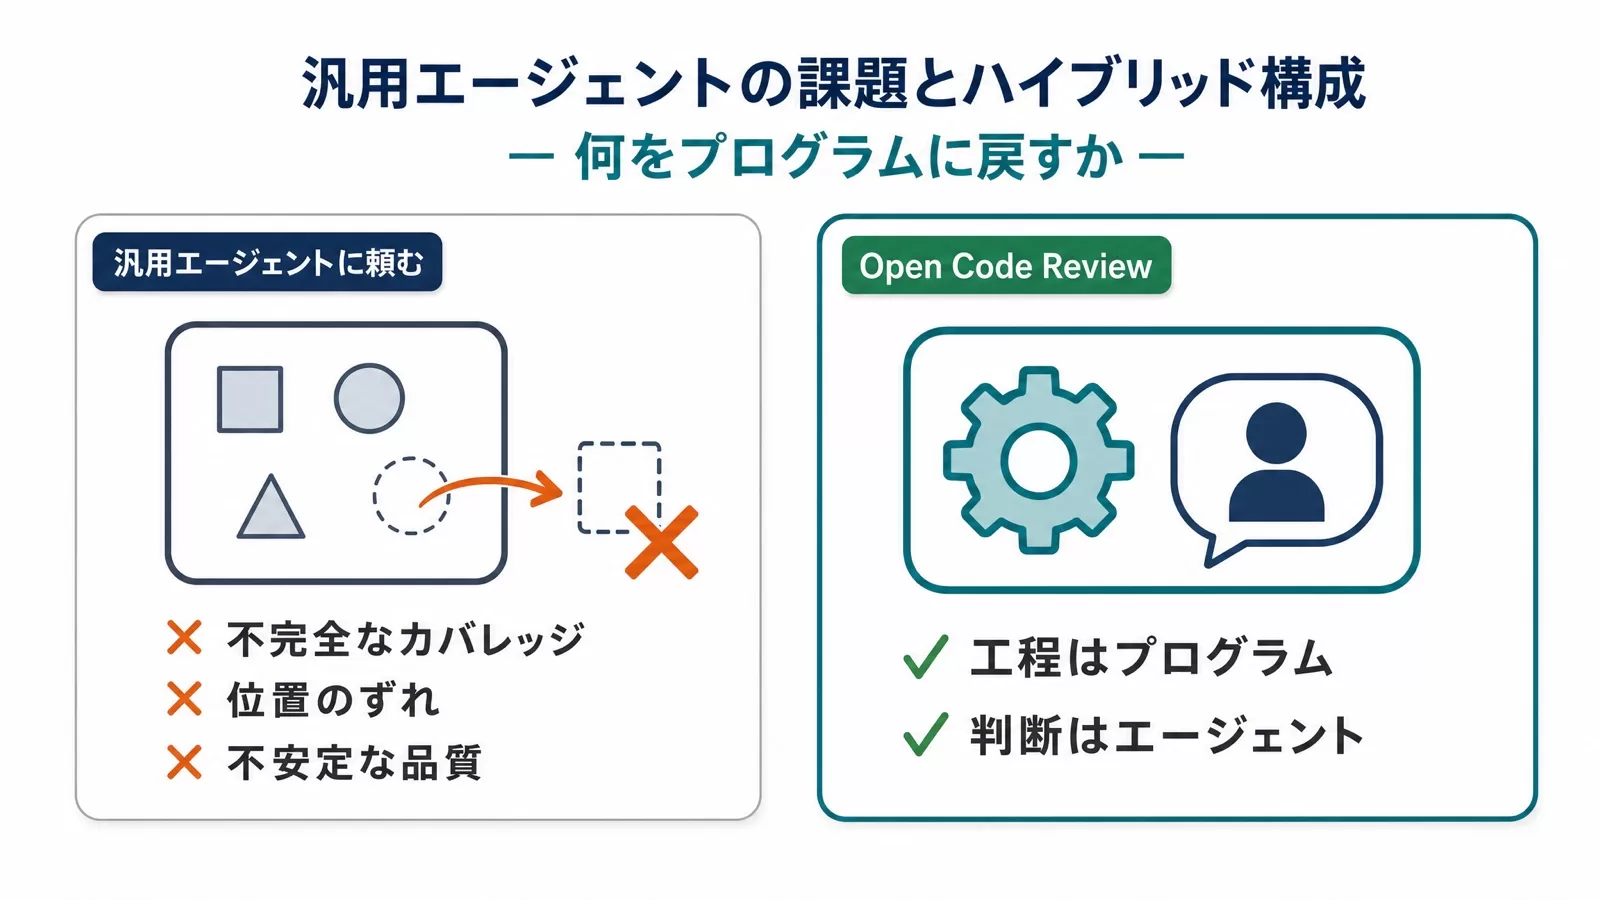
README は、汎用エージェントにレビューを頼んだときの課題を3つ名指ししています。不完全なカバレッジ(大きな変更セットで一部ファイルを飛ばす)、位置のずれ(行番号・ファイル参照がターゲットから外れる)、不安定な品質(自然言語駆動のスキルはデバッグしづらく、わずかなプロンプト差で結果が変わる)。根本原因は「純粋に言語駆動のアーキテクチャには、レビュープロセスに対するハードな制約が欠けている」ことだ、という診断です。
その答えとして置かれているのが、工程はプログラム・判断はエージェントという分担です。間違えてはいけない工程(どのファイルを見るか、どのルールを当てるか、どの行に貼るか)はエンジニアリングロジックが保証し、エージェントには動的な意思決定と動的なコンテキスト取得だけを任せます。README はこれを「決定論的エンジニアリング × エージェントのハイブリッド」と呼んでいます。
2026年9月20日時点で GitHub API から取得した公開情報と、公式ドキュメントの記載を整理します。
| 項目 | 公式に記載されている内容 |
|---|---|
| 提供元 | Alibaba(リポジトリは alibaba/open-code-review) |
| 公開時期 | リポジトリ作成 2026年5月18日 |
| ライセンス | Apache License 2.0(Copyright 2026 Alibaba) |
| 実装言語 | Go |
| star / fork | 38,001 / 2,703(2026年9月20日に GitHub API で取得) |
| 最新リリース | v1.12.7(2026年9月19日公開) |
| CLI 名 | ocr(バイナリ名は opencodereview) |
| 配布 | npm @alibaba-group/open-code-review、Homebrew、インストールスクリプト、GitHub Release バイナリ、ソースビルド |
| 前提 | Git 2.41 以上、Node.js 18 以上 |
| 対応 OS | Windows・macOS・Linux |
| LLM | OpenAI 互換・Anthropic・Gemini・Bedrock ほか組み込み provider 23種+カスタム |
| 出力形式 | text / json / SARIF 2.1.0(GitHub Code Scanning 向け) |
ベンチマークについても README に記載があります。AACR-Bench は、人気オープンソースリポジトリ50件から実際の Pull Request 200件を選び、10のプログラミング言語をカバーし、80人以上のシニアエンジニアのクロスバリデーションで1,505件の欠陥を注釈したデータセットで、Hugging Face で公開されています。README の主張は「同じ基盤モデルを使った汎用エージェントと比べ precision と F1 が有意に高く、トークン消費はおよそ9分の1」というものです。
ただしこの数値そのものはリポジトリ内の画像に描かれており、テキストとして検証できる形では公開されていません。同じ段落で「recall は汎用エージェントより低い」とも自認しています。ベンダー自身が自社ツールを有利に見せる条件で測った結果である点は差し引いて読む必要があるため、この記事では数値を引用せず、「精度優先・見逃しは増える設計」という方向性だけを事実として扱います。
仕組み|決定論的な工程とエージェントの分担
ハイブリッドという言葉だけでは中身が分かりません。公式のアーキテクチャ解説は、ocr review を実行してから JSON が出るまでを6段階のパイプラインとして書いています。
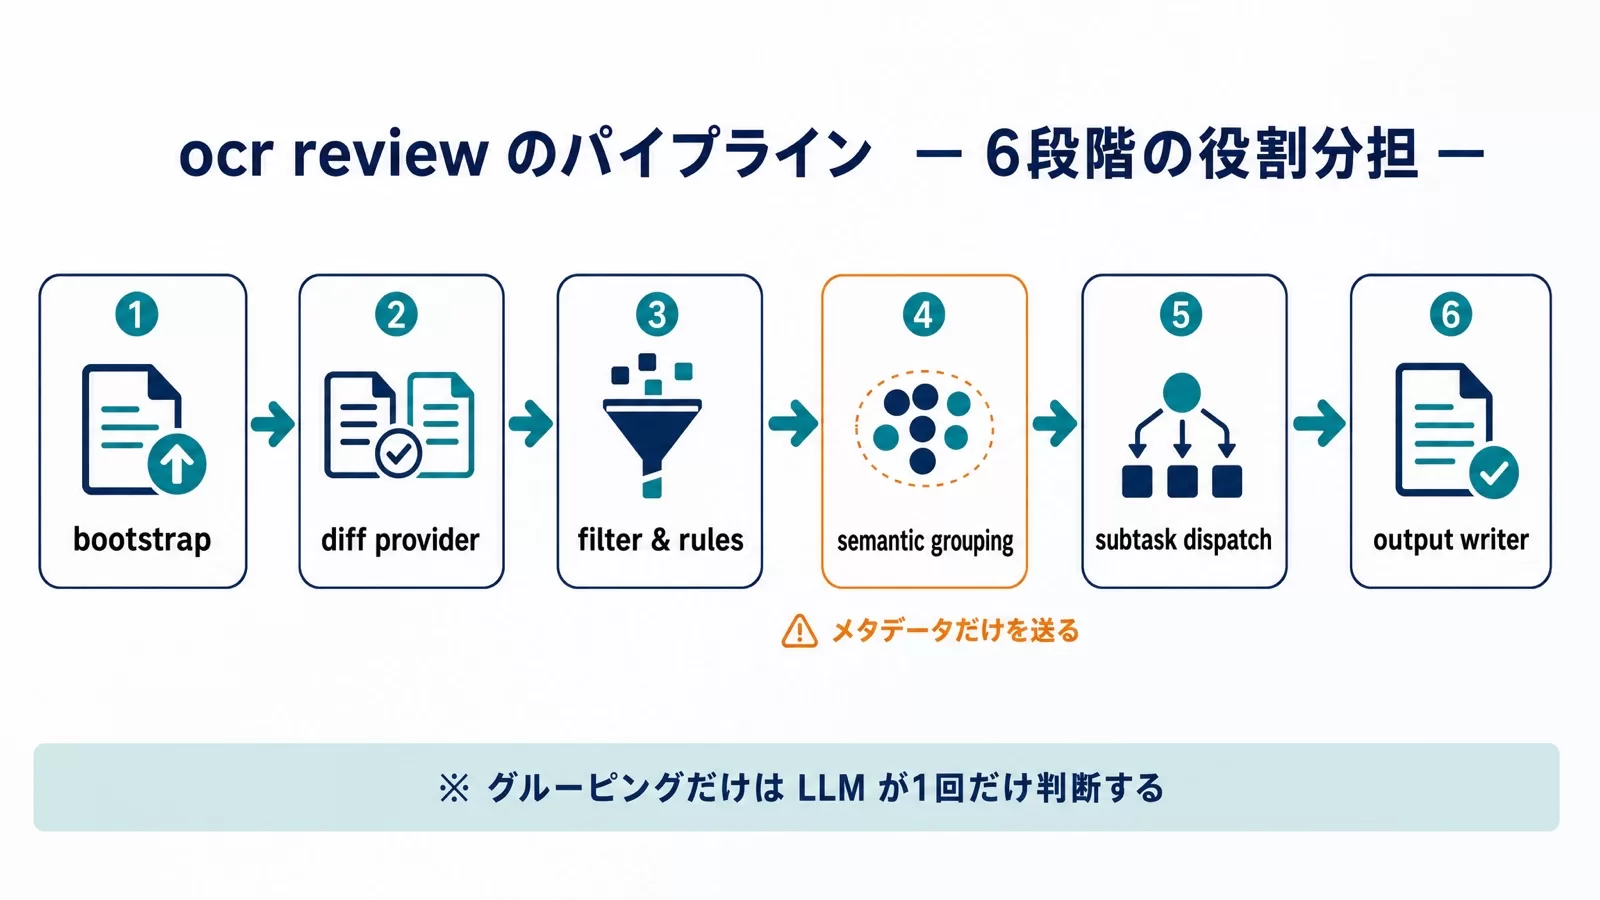
| 段階 | 担当 | 内容 |
|---|---|---|
| bootstrap | プログラム | LLM エンドポイントを config → 環境変数 → rc ファイルの順で解決し、テンプレート・ツールレジストリ・システムルールを読む |
| diff provider | プログラム | Workspace / Commit / Range の3モードで diff を生成 |
| filter & rules | プログラム | 6段階のゲートでファイルを取捨選択し、ファイルごとにルールを確定 |
| semantic grouping | LLM(1回) | ファイルのメタデータだけを見て、関連するファイルを同じグループにまとめる |
| subtask dispatch | エージェント | グループごとにサブエージェントを起動し、plan 段階と main ループを回す |
| output writer | プログラム | 行解決とレビューフィルタを通して text / JSON / SARIF に整形 |
ファイル選択はプログラムが決めるのが最初の分岐点です。公式ドキュメントは6段階のゲートを順に適用すると書いています。binary(バイナリを落とす)→ secret_exclude(組み込みの秘密情報パス保護。ユーザーの include でも上書きできない)→ user_exclude → user_include(一致したら以降のゲートを飛ばして即保持)→ unsupported_ext(拡張子ホワイトリスト)→ default_path(組み込みのテストファイル除外)。さらにゲートの後で、diff 単独で max_tokens の80%を超えるファイルが too_large として外れます。
ここで効いてくるのが --preview です。LLM を1回も呼ばずに、どのファイルが残ってどれが落ちたか、落ちた理由つきで一覧できます。「レビューされなかった」という苦情のほとんどはこの出力で自己解決できる、というのが公式 FAQ の立て付けです。
グルーピングだけは LLM が1回だけ判断します。このとき送るのはパス・状態・追加削除行数といったメタデータだけで、diff の中身は送りません。同じモジュールに属するファイル、インターフェースと実装、同じリソースの i18n / 設定バリアントなどが1グループにまとまります。1グループは最大10ファイルで、トークン上限を超えるとファイル単位に分割され、グルーピング呼び出しが失敗した場合はファイルごと1グループへフォールバックします。
グループごとに走るサブエージェントには、2つの段階があります。
- plan 段階(条件つき):グループ内のどれか1ファイルの変更行数が50以上、またはファイルが2つ以上かつ合計変更行数が100以上のときだけ実行されます。小さい diff では静かに飛ばされます。plan 中はツールを呼べず、読み取り専用ツールの定義がテキストとして渡されるだけで、モデルはチェックリストを返します。
- main ループ:
code_search/file_read_diff/file_find/file_read/code_comment/task_doneの6ツールを使ってレビューします。ラウンド数は--effortで決まり、low が1ラウンド、medium が2ラウンド(既定)、high が3ラウンド。2ラウンド目以降は plan 結果を外し、前ラウンドで確定した指摘を「すでに見つかったもの」として渡し、新しい問題を探させます。
メモリ管理も決め打ちです。プロンプト上限 MAX_TOKENS は ocr review で200,000、ocr scan で58,888。60%で非同期の圧縮が走り、80%で同期圧縮に切り替わります。なお --max-tokens を上げてもモデルの出力上限は広がりません。出力は別定数 MAX_COMPLETION_TOKENS(16,384)が握っています。
そして「何行目か」を決めるのもプログラム側です。モデルが返した existing_code をスライディングウィンドウで diff と照合して行番号を算出し、失敗した場合だけ再配置用のプロンプトで再アンカーを依頼します。main ループ終了後には REVIEW_FILTER_TASK が走り、明らかに誤りと証明できるコメントを落とします。照合に失敗したコメントは行番号が 0 になりますが、指摘自体は破棄されません。
意図的に自動化していない部分も明記されています。エンドポイント発見にフォールバックはなく、サブエージェントの失敗は隔離されてリトライされず(リトライは CI 側の責務)、クロスファイルの推論はグループの範囲に限られます。この割り切りで「グループごとに決定的」な実行とコストの予測可能性を得ている、というのが公式の説明です。
既存の手段との位置関係|lint・汎用エージェント・形式検証
AI レビューを検討するとき、比較対象は他社の AI レビューだけではありません。すでに CI に入っている静的解析、エージェントに直接頼むレビュー、そしてもっと強い保証を狙う形式検証まで含めて、どこが空いているのかを見たほうが判断が速くなります。
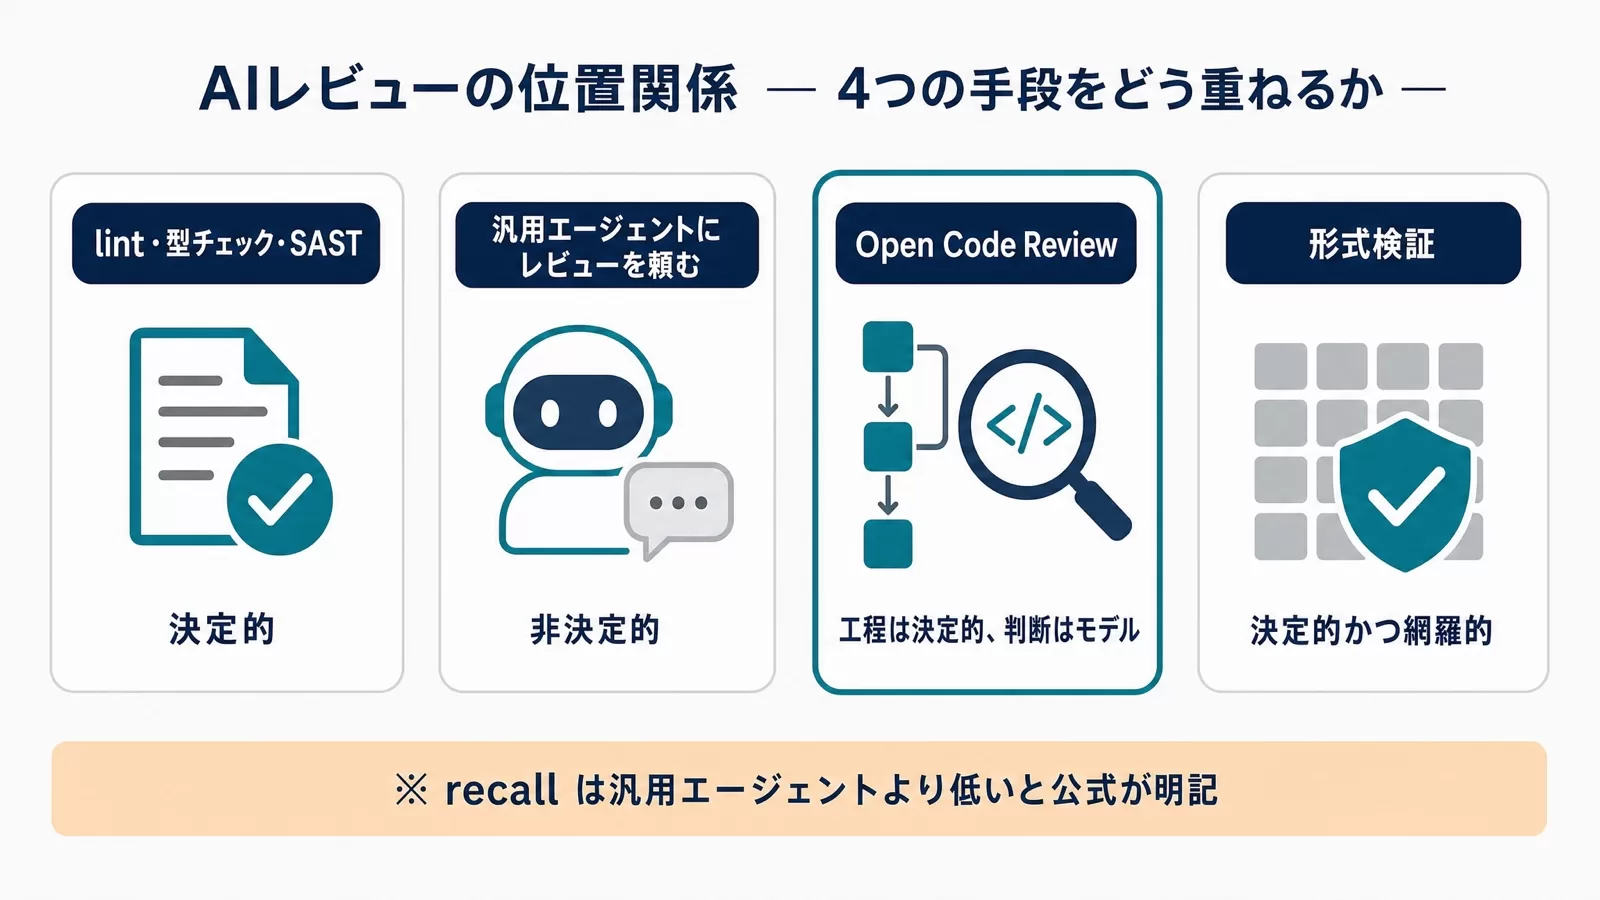
| 手段 | 判定の性質 | 主に見つかるもの | 弱いところ |
|---|---|---|---|
| lint・型チェック・SAST | 決定的(同じ入力なら同じ結果) | 規約違反、既知パターンの脆弱性、型の不整合 | ルールに書かれていない設計の誤りは素通りする |
| 汎用エージェントにレビューを頼む | 非決定的 | 意図と実装のずれ、読みにくさ、広めの指摘 | カバレッジ・位置精度・再現性が安定しない |
| Open Code Review | 工程は決定的、判断はモデル | 言語別ルールに沿った欠陥、行アンカーつきの指摘 | recall は汎用エージェントより低いと公式が明記 |
| 形式検証(証明で止める系) | 決定的かつ網羅的 | 書いた命題が成り立たない実装 | 書いていない命題は守られない。導入コストが高い |
Open Code Review が埋めようとしているのは、lint では届かないが、汎用エージェントに任せると毎回ぶれる帯域です。言い換えると、AI の判断力は使いたいが、AI に任せる範囲は最小にしたい、という位置取りになります。
もう一段強い保証が必要な領域には、証明でコンパイルを止める言語という選択肢もあります。今朝公開したBend 2の解説記事で扱ったように、そちらは「人が書いた law を AI が proof で埋める」設計で、守られるのは書いた命題だけという制約があります。実務では①型・テストなどの決定的な検査 ②Open Code Review のようなルール駆動の AI レビュー ③人のレビューという多層の関門を積む形になり、どの層も単独では完結しません。エージェント自体の品質をどう測るかはpytest・Deepeval を使ったテスト自動化の記事で整理しています。
触ってみる最短手順|公式ドキュメントにあるコマンドだけ
ここから先のコマンドは、すべて公式ドキュメントと README に載っている例です。筆者の環境で実行した結果ではないため、動作確認はご自身のリポジトリでお願いします。
1. インストール。npm が推奨経路で、インストール後は ocr がグローバルに使えます。
npm install -g @alibaba-group/open-code-review
ocr version
2. LLM を設定。対話 UI で provider・API キー・モデルを選ぶと、接続テストまで自動で走ります。CI や TUI が無い環境では ocr config set で直接書けます。
# 対話式
ocr config provider
ocr config model

# 非対話式(公式ドキュメントの例)
ocr config set provider                    anthropic
ocr config set model                       claude-opus-4-6
ocr config set providers.anthropic.api_key sk-ant-xxxxxxxxxx

# 接続確認
ocr llm test
組み込み provider は23種あり、anthropic / openai / gemini / bedrock / deepseek / kimi / xai などが Base URL とプロトコルをプリセットした状態で入っています。providers.<name>.api_key を設定しなければ対応する環境変数にフォールバックするため、Claude Code 向けに ANTHROPIC_* をすでに設定している環境なら、設定ファイルを書かずに認識されます。
3. 日本語で出す設定。ここは日本のチームで最初に踏む段差です。公式ドキュメントは「language はレビューコメントをどの言語で出力するかを決める。未設定の場合はデフォルトで英語になる」と明記しています。
ocr config set language 日本語4. レビューを実行。モードは3つで、引数なしがワークスペース(staged・unstaged・untracked すべて)、--commit が単一コミット、--from/--to がブランチ区間(merge-base(from, to)..to)です。3つは排他で、混ぜるとエラーになります。
# まず何がレビューされるか確認(LLM を呼ばない)
ocr review --preview

# ワークスペースの変更をレビュー
ocr review

# ブランチ区間
ocr review --from main --to feature-branch

# 単一コミット
ocr review --commit abc123

# ラウンドを1回に減らす(low = 1 / medium = 2 / high = 3)
ocr review --effort low

# 機械可読な出力(上流のエージェントや CI 向け)
ocr review --format json --audience agent > review.json

# diff がないディレクトリをファイル全体でレビュー
ocr scan --path internal/agent
覚えておくと効く引数は --background です。公式 CI ガイドが「最も効果の大きい単一の引数」と書いており、PR タイトルや要件の一文を渡すだけでモデルが往復せずに判断できる場面が増えます。ほかに --concurrency(既定8)、--timeout(サブタスクごと既定15分・effort に比例)、--max-tokens-budget(実行全体の入出力トークン上限)、--rule(ルールファイルの上書き)があります。
5. 結果を見返す。各レビューは ~/.opencodereview/sessions/ 配下に JSONL の追記ログとして残り、データベースは使いません。ocr viewer がそのファイルを直接読んでブラウザで再生し、v1.12.7 ではセッションを自己完結の HTML に書き出す機能が入りました。
終了コードは 0(完了)と 1(引数誤り、エンドポイント未解決、全サブエージェント失敗などの致命的エラー)の2種類だけです。指摘が出たかどうかで終了コードは変わりません——CI で「指摘があれば落とす」を実装するなら、JSON の comments を自分で数える必要があります。
CIに組み込む|GitHub Actionsの公式ワークフロー
上流リポジトリには、そのままコピーして使えるワークフローが examples/github_actions/ocr-review.yml として置かれています。GitLab CI、GitFlic CI、Gerrit、Bitbucket Pipelines、Codeup の例も examples/ 配下にあります。
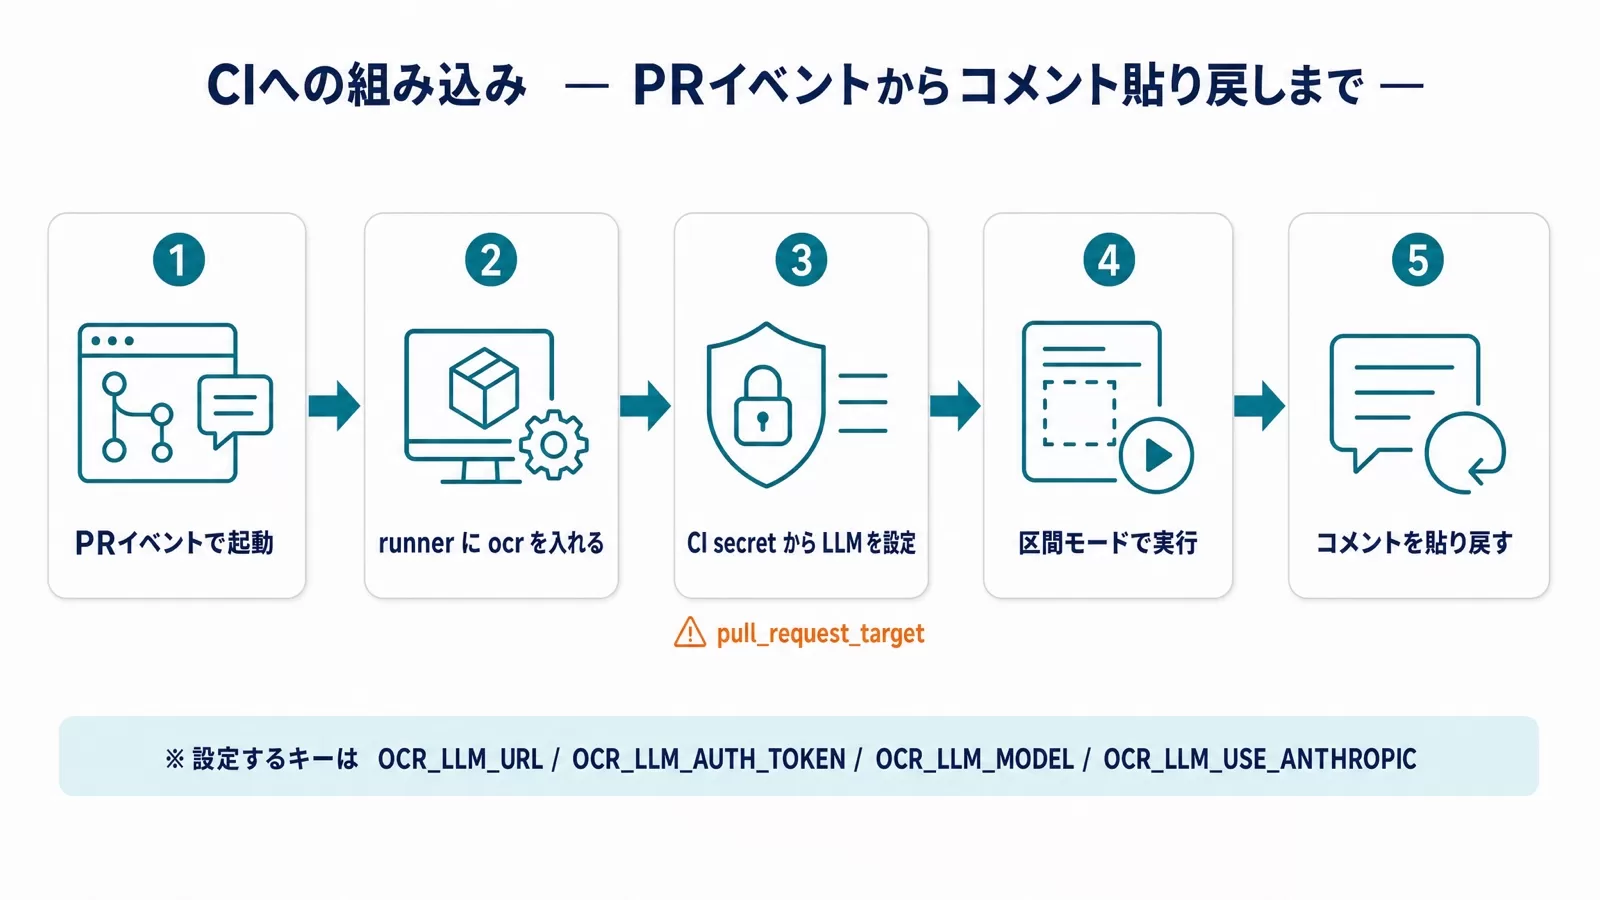
mkdir -p .github/workflows
curl -o .github/workflows/ocr-review.yml \
  https://raw.githubusercontent.com/alibaba/open-code-review/main/examples/github_actions/ocr-review.yml
設定するのは Settings → Secrets and variables → Actions の4つです。
| キー | 種別 | 必須 | 内容 |
|---|---|---|---|
OCR_LLM_URL |
secret | はい | LLM API エンドポイント |
OCR_LLM_AUTH_TOKEN |
secret | はい | LLM の認証トークン(OCR 側の環境変数名は OCR_LLM_TOKEN で別名) |
OCR_LLM_MODEL |
variable | いいえ | モデル名。既定値は無いので実質必須 |
OCR_LLM_USE_ANTHROPIC |
variable | いいえ | Anthropic のモデルを使うなら true |
ワークフローは再利用可能なコンポジットアクションに委譲する形で、レビューの強さなどは with: で渡します。公式ドキュメントに載っている例がこちらです。
- uses: alibaba/open-code-review@main
  with:
    llm_url: ${{ secrets.OCR_LLM_URL }}
    llm_auth_token: ${{ secrets.OCR_LLM_AUTH_TOKEN }}
    llm_model: ${{ vars.OCR_LLM_MODEL }}
    llm_use_anthropic: ${{ vars.OCR_LLM_USE_ANTHROPIC }}
    effort: high
    max_tokens_budget: '10000000'
    llm_reasoning_effort: low
    stream_progress: 'true'
トリガーは2系統です。PR イベント(opened / synchronize / reopened)に加えて、PR コメントの本文が /open-code-review または @open-code-review で始まったときにも走ります。後者はレビュアーが任意のタイミングで再レビューを回すための口で、コメント側のトリガーは author_association が MEMBER / OWNER / COLLABORATOR の人間だけに絞られています。誰でもコメント1つで LLM のクォータを消費できてしまう事態を避けるためです。
セキュリティまわりで読み飛ばさないほうがいい点が2つ、ワークフローのコメントに書かれています。
pull_requestではなくpull_request_targetを使う理由:fork からの PR でも secret を使えるようにするため。安全と言える根拠は「このアクションは diff を読むだけで、PR に含まれるコードを実行しない」からだと明記されています。裏を返すと、ここに任意のコードを実行するステップを足した瞬間に前提が崩れます。- PR タイトルやブランチ名を
run:に直接展開しない:GitHub は${{ }}をシェルが行を解析する前にテキスト置換するため、シェルのメタ文字を含む PR タイトルが runner 上で実行されてしまいます。公式の作例はenv:経由で渡しています。
コメントの貼り戻しは GitHub Pull Request Review API 経由で、行情報を持たない指摘はインラインではなくサマリー本文にまとめられます。一括送信が失敗したときは1件ずつの投稿へフォールバックします。GitLab では GITLAB_API_TOKEN を明示的に設定するのが推奨で、fork MR に対しては組み込みの CI_JOB_TOKEN にフォールバックします。GitHub Actions で PR レビューを自動化する全体像はCodex GitHub Action の解説記事も参考になります。
コストを気にするなら max_tokens_budget の挙動を先に押さえてください。LLM の各ラウンド前に確認され、超えたサブタスクには指摘を提出する最終ラウンドが1回だけ与えられ、以降のサブタスクはディスパッチされません。超過分は failed(budget) として報告され、部分的な結果は公開されたうえでレビューは終了コード0で終わります。予算切れを失敗として検知したいなら、この報告を自分で拾う必要があります。
エージェント開発での使いどころ|委任モードとルール
ここが、自分でエージェントを作っている人にとっていちばん転用が効く部分です。Open Code Review は「レビューを代行するサービス」としてだけでなく、レビューの足場(どのファイルを・どのルールで見るか)を作る部品としても使えるように分解されています。
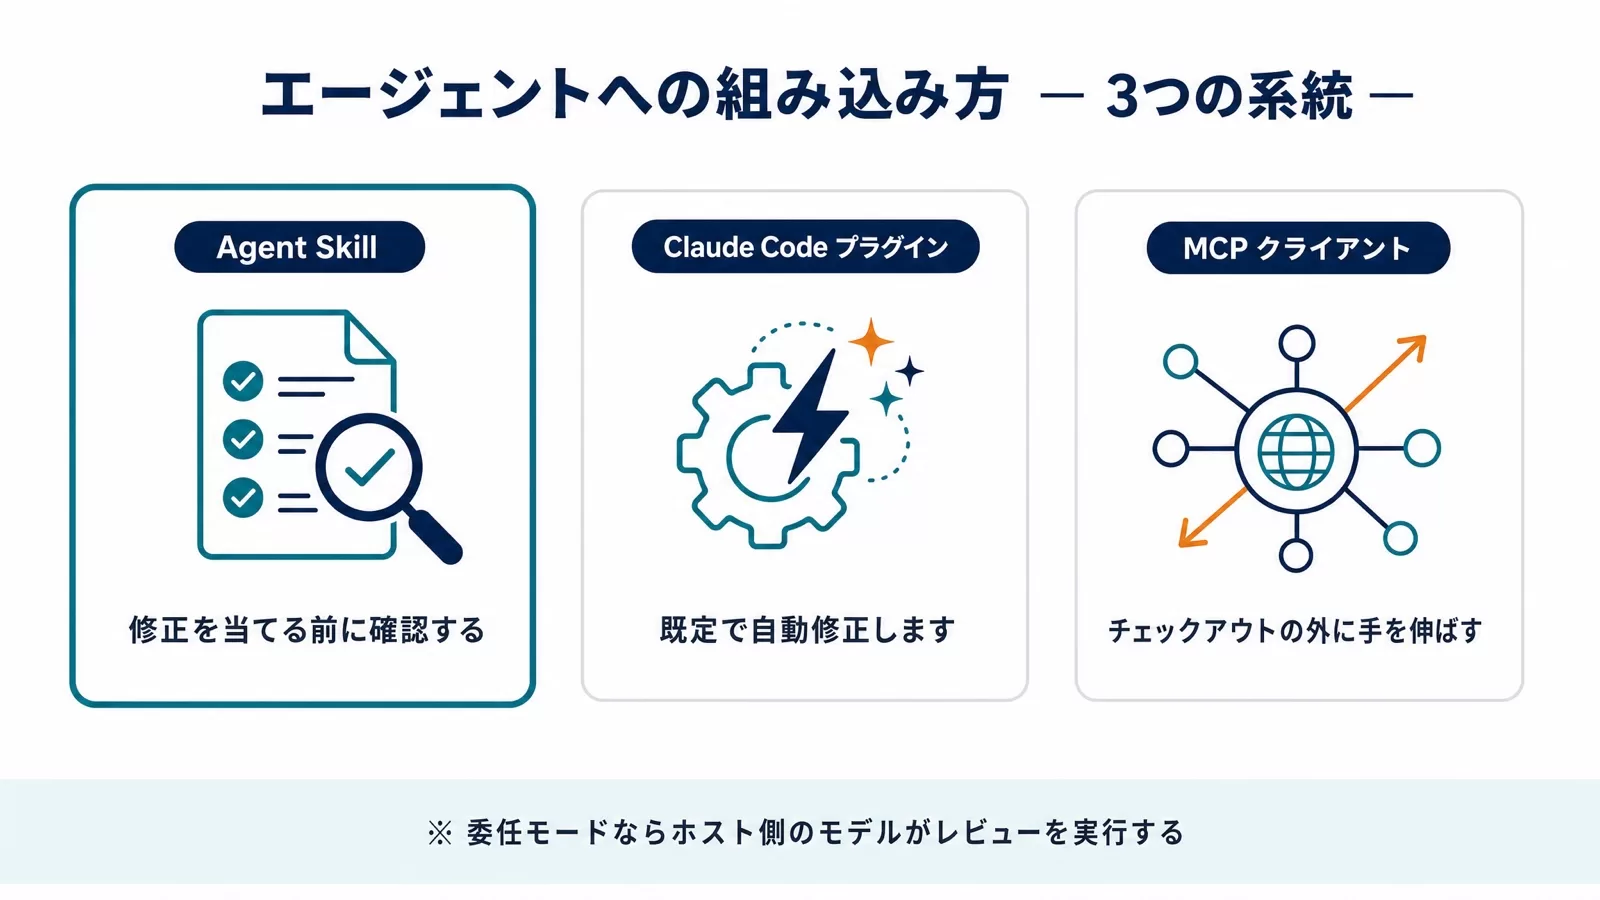
委任モード(Delegation Mode)は、OCR が決定論的な工程だけを担当し、実際のレビューはホストのエージェントが自分の LLM で行う構成です。OCR 側に API キーは要りません。サブスク契約のあるコーディングエージェント——Claude Code、Codex、Cursor、Open Code、Qoder など——の枠をそのままレビューに使える、というのが公式が挙げる第一の動機です。
# レビュー対象と除外理由を機械可読に出す
ocr delegate preview
ocr delegate preview --from main --to feature

# 対象ファイルに当たるルールを解決して取得(同じルールのファイルはまとまる)
ocr delegate rule src/main.go src/handler.go
自作のパイプラインを持っているなら、この2コマンドの出力(モード・ref メタデータ・レビュー可能ファイル一覧・除外理由つきの除外一覧・ルールのグループ)をそのまま入力として使えます。ファイル選択と除外ロジックを自前で書き直さずに済むのが実利です。
ルールエンジンは4層の優先順位チェーンで解決されます。上から --rule 引数、リポジトリの .opencodereview/rule.json、ユーザーの ~/.opencodereview/rule.json、バイナリ同梱のシステムデフォルト。ファイルごとに、最初に一致したパターンのルール本文がプロンプトに入ります。
{
  "include": ["src/**/*.{ts,tsx}", "src/**/*.go"],
  "exclude": ["**/*.test.ts", "**/generated/**"],
  "rules": [
    {
      "path": "src/api/**/*.go",
      "rule": "All exported handlers must validate request bodies before use."
    },
    {
      "path": "**/*mapper*.xml",
      "rule": "Check SQL for injection risks, parameter errors, and missing closing tags."
    }
  ]
}
注意したいのは include の意味です。ホワイトリストではなく「組み込みのデフォルト除外を迂回するための指定」で、どの include にも一致しないファイルも通常のチェックを通ってレビュー対象になり得ます。どの層のどのパターンが効いたかは ocr rules check <path> で確認できます。
システムデフォルトのルールは言語・ファイル種別ごとに用意されていて、Java・Go・Python・TypeScript/JavaScript・Rust・C/C++・PHP のようなソースだけでなく、pom.xml・package.json・Cargo.toml などの依存定義、.github/workflows/ の YAML、Terraform、Protocol Buffers・GraphQL・Prisma、Solidity、Verilog・VHDL まで含まれます。
エージェントへの組み込み方は3系統あります。
- Agent Skill:
npx skills add alibaba/open-code-review --skill open-code-reviewで SKILL.md を導入します。事前チェック(which ocrとocr llm test)、--backgroundの生成、High / Medium / Low の分類基準までプロンプトに書かれていて、修正を当てる前に確認するのが既定です。Skill の書き方そのものはClaude Code Skills の解説記事で扱っています。 - Claude Code プラグイン:
/plugin marketplace add alibaba/open-code-review→/plugin install open-code-review@open-code-reviewで/open-code-review:reviewが登録されます。こちらは既定で自動修正します。「レビューして片付ける」には向き、「diff を見せてほしい」には向かない、と公式が明言しています。挙動を変えたいならローカルのコマンドファイルを編集します(呼び出しのたびに読み直されるので再起動は不要)。 - MCP クライアントとして外部ツールを足す:
ocr config set mcp_servers.<name>.commandなどで MCP サーバーを登録すると、そのツールが組み込みツールと並んでレビューエージェントから使えます。Jira / GitHub issue の取得、社内 API ドキュメントの参照、独自の依存関係チェッカーの呼び出しなど、チェックアウトの外に手を伸ばすのが用途だと整理されています。公開するツールはtoolsで許可リスト化できます。
可観測性まわりも用意されています。telemetry.enabled を有効にすると OpenTelemetry の span と metric(ocr.llm.tokens_used、ocr.llm.requests_total、ocr.llm.request_duration_seconds)が出て、どのモデルにどれだけトークンを使ったかを追えます。console exporter ならその場で集計が出ますし、OTLP に切り替えれば既存の基盤へ流せます。エージェント全般の監視設計はOpenTelemetry・LangSmith を比較した記事にまとめてあります。
注意点|ライセンス・データの扱い・確認できていない範囲
導入判断の前に、公式が書いていることと書いていないことを分けておきます。
ライセンスは Apache License 2.0 で、商用利用・改変・再配布が可能です。リポジトリには CODE_OF_CONDUCT・CONTRIBUTING・GOVERNANCE・ROADMAP が揃い、README には OpenSSF Best Practices の Gold バッジが掲げられています。ツール本体が無料であることと、レビューにかかる LLM の API 費用が無料であることは別です。後者は自分の契約から出ていきます。
コードがどこへ行くかについて、公式 FAQ は「OCR はあなたの diff(および読み取りツールが取得したスニペット)を、設定した LLM エンドポイントに送る。それ以外のものは一切マシンから出ない。セッション JSONL とルールファイルはローカルにのみ存在する」と書いています。テレメトリを有効にしてもプロンプトと応答の内容がエクスポートされることはない、とも明記されています。
秘密情報のマスクは組み込みではありません。ファイル選択の secret_exclude ゲートが既定の秘密情報パス(.env.* など。ただし .env.example / .env.sample / .env.template は通常のレビュー対象)を無条件で外しますが、ソースコードの中に直接書かれた値は diff に乗れば送信されます。公式が推奨している回避策は「秘密情報をコミットしない」「機密ファイルを exclude に入れる」「pre-commit でマスクする」の3点で、マスクルール機能はロードマップ段階です。
ロードマップには JetBrains プラグイン、委任モードの拡充、recall を上げる代わりにトークンと時間を使う Ultra モードが2026年下期、ドメイン特化の長期記憶が2027年上期として挙がっています。逆に「やらない」と明記されているのが3つ——人のレビューを挟まない自動修正、汎用 AI コーディングアシスタント化、自前モデルのバンドルです。レビュー専用ツールに留まる宣言は、導入設計をするうえで読んでおく価値があります。
この記事で確認できていない範囲も書いておきます。筆者は本番リポジトリで ocr review を実行しておらず、日本語コードベースでの指摘品質、日本語コメント設定時の出力の自然さ、大規模 PR での所要時間、実際の課金額はいずれも未確認です。README のベンチマークはベンダー自身の測定で、数値は画像でのみ提供されています。導入判断は、自社の小さなリポジトリで --preview と --effort low から始めて、自分の目で確かめてください。
【要注意】Open Code Reviewで踏みやすい失敗パターン4つ
公式 FAQ で「よくある」とされている詰まり方を、実務で踏みそうな順に4つ挙げます。
❌ 失敗1:いきなり ocr review を回して「うちのファイルがレビューされない」と判断する
テストファイル(*_test.go、*.test.ts、test_*.py など)は既定で除外され、vendor/ や node_modules/ は diff の段階で落ちます。後者は include を書いても戻りません。
⭕ 正解:先に ocr review --preview を回す
LLM コストをかけずに、残ったファイルと落ちたファイルが除外理由つきで出ます。binary / user_exclude / unsupported_ext / default_path / provider_directory / too_large / deleted のどれかが表示されるので、対処方法もそこで決まります。テストファイルをレビューしたいなら include に足します。
❌ 失敗2:レビューが高いのでプランの閾値を下げてみる
plan 段階は「グループ内の最大変更行数が50以上」または「2ファイル以上かつ合計100行以上」で起動します。閾値を下げると、より多くのグループが plan を通るのでむしろ高くなります。
⭕ 正解:--effort low と --background から試す
main ループを1ラウンドに減らすのがいちばん素直な削減手段で、公式 FAQ も「レビューコストはおよそ半分になる」と書いています。--background で事前コンテキストを渡すと、モデルが file_read / code_search の往復をせずに終えられる場面が増えます。レート制限に当たるなら --concurrency を既定の8から下げます。
❌ 失敗3:--max-tokens を上げれば大きな差分も通ると考える
max_tokens が制限しているのはプロンプト側だけです。モデルの出力上限は別定数(16,384)が握っているため、上げても長い指摘が返るようにはなりません。diff 単独で上限の80%を超えるファイルは too_large として外れます。
⭕ 正解:変更を小さなコミットに割り、--commit モードで回す
自動生成ファイルなら exclude に入れるのが先です。一括のワークスペースモードではなく、コミット単位のレビューに切り替えるのが公式の推奨です。実行全体の上限を決めたいなら --max-tokens-budget を使います。
❌ 失敗4:行番号が 0 のコメントをバグとして無視する
start_line: 0 / end_line: 0 は、モデルが返した existing_code を diff に照合できなかったサインです。モデルがスニペットを書き換えてしまった場合や、CRLF・タブと空白の混在で照合が壊れた場合に起きます。
⭕ 正解:アンカーされていないだけで、指摘自体は読む
公式 FAQ は「コメント自体は本物で、自動的に配置されなかっただけ」と書いています。Agent Skill や Claude Code プラグインなどの統合は existing_code フィールドを読んで自力で位置を特定します。CI の貼り戻しでも、行情報を持たない指摘はサマリー本文にまとめられる設計です。
よくある質問
Open Code Reviewは無料で使えますか?
ツール本体は Apache License 2.0 のオープンソースで、npm・Homebrew・GitHub Release から無料で入手できます。ただしレビューを実行するには LLM が必要で、その API 費用は利用者の負担です。すでに Claude Code などサブスク型のコーディングエージェントを使っているなら、委任モード(ocr delegate)でホスト側のモデルにレビューを実行させられるため、OCR 用の API キーを別に用意せずに済みます。
AIコードレビューとは何ですか?Open Code Reviewは何が違いますか?
AI コードレビューは、変更差分を大規模言語モデルに読ませてバグ・脆弱性・設計上の問題を指摘させる仕組み全般を指します。Open Code Review が他と違うのは、LLM に任せる範囲を意図的に絞っている点です。どのファイルを見るか、どのルールを当てるか、どの行に貼るかはプログラムが決め、モデルは「このコードのどこが問題か」の判断と動的なコンテキスト取得に集中します。README はこの構成を、汎用エージェントのカバレッジ・位置精度・再現性の問題に対する答えとして説明しています。
レビューコメントを日本語で出せますか?
出せます。ただし既定は英語で、ocr config set language に言語名を渡して初めて切り替わります。公式ドキュメントには ocr config set language 中文 / ocr config set language English の例が載っています。ドキュメント自体は英語・中国語・日本語・韓国語・ロシア語の5言語で提供されています。
GitHub以外のCIでも使えますか?
使えます。リポジトリの examples/ には GitHub Actions のほかに GitLab CI、GitFlic CI、Gerrit(Jenkinsfile)、Bitbucket Pipelines、Codeup の作例が入っています。どれも「PR / MR イベントで起動 → runner に ocr を入れる → CI secret から LLM を設定 → 区間モードで --format json --audience agent を実行 → JSON を解析してコメントを貼り戻す」という同じ型です。貼り戻しには LLM の認証情報とは別に、PR / MR への書き込みトークンが要ります。
社内のコードが外部に送られませんか?
公式 FAQ は「diff と読み取りツールが取得したスニペットを、あなたが設定した LLM エンドポイントに送る。それ以外はマシンから出ない」と説明しています。送り先はあくまで自分で設定したエンドポイントなので、Bedrock や社内でホストしている OpenAI 互換エンドポイントを指定する運用も取れます。一方で秘密情報のマスク機能は組み込まれていません。既定の秘密情報パスはファイル選択の段階で除外されますが、コード中に直接書かれた値は diff に乗れば送信されるため、exclude の設計と pre-commit でのマスクを先に決めてください。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
まとめ:今日から始める3つのアクション
Open Code Review の価値は、AI レビューの精度が上がったことよりも、AI に任せてはいけない工程を明示的に切り出したことにあります。ファイル選択・ルール適用・行アンカーをプログラムに戻し、判断だけをモデルに残す。この分け方は、自分でレビュー用のエージェントを組む場合にもそのまま設計指針になります。
今日できることを3つに絞ります。
- 小さなリポジトリで
ocr review --previewだけ回す。LLM を呼ばないので費用ゼロで、自分のリポジトリのどのファイルがレビュー対象から落ちるかが分かります。ここで納得できなければ導入も進みません。 - いま CI に何段の関門があるかを数える。型・lint・テスト・AI レビュー・人のレビュー。抜けている段があるなら、埋めるのは必ずしも AI レビューとは限りません。
- 入れると決めたら
languageと--effortと--max-tokens-budgetを先に決める。既定のまま回すと英語コメントが2ラウンド・トークン上限なしで返ってきます。運用の3点を決めてから本番の PR に当てるほうが、初日の納得感が違います。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- alibaba/open-code-review リポジトリ(README・ROADMAP・LICENSE) — GitHub(参照日: 2026-09-20)
- README 日本語版 — GitHub(参照日: 2026-09-20)
- リリース一覧(v1.12.7・2026-09-19 ほか) — GitHub(参照日: 2026-09-20)
- クイックスタート — open-codereview.ai 公式ドキュメント(参照日: 2026-09-20)
- アーキテクチャ(パイプライン・フィルタリング・メモリ圧縮) — open-codereview.ai 公式ドキュメント(参照日: 2026-09-20)
- レビュールール(4層の優先順位チェーン) — open-codereview.ai 公式ドキュメント(参照日: 2026-09-20)
- 設定(組み込み provider・effort・language) — open-codereview.ai 公式ドキュメント(参照日: 2026-09-20)
- CLI リファレンス(引数・終了コード) — open-codereview.ai 公式ドキュメント(参照日: 2026-09-20)
- FAQ(コスト・プライバシー・トラブルシューティング) — open-codereview.ai 公式ドキュメント(参照日: 2026-09-20)
- デリゲーションモード — open-codereview.ai 公式ドキュメント(参照日: 2026-09-20)
- GitHub Actions サンプルワークフロー — GitHub(参照日: 2026-09-20)
- AACR-Bench データセット — Hugging Face(参照日: 2026-09-20)
- @alibaba-group/open-code-review — npm(参照日: 2026-09-20)
著者:佐藤傑(さとう・すぐる)。株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。著書『AIエージェント仕事術』。100社以上の企業向けAI研修・導入支援を手がけています。ご質問・ご相談はお問い合わせフォームからどうぞ。