TypeSafe AI の判定モデル Jev を既存のパイプラインに組み込むとき、公式ドキュメントに出てくる設計は7つの型に収まります。2026年9月21日時点で、叩き先は POST https://api.typesafe.ai/v1/systemone の1本だけ、モデル名は jev-latest(実体は jev-1.13.0)、課金は入力トークンだけで100万トークンあたり0.042ドル・出力トークンは無料、1リクエストの上限は64,000トークン(うち state と最長の質問で32,000トークン)。ここまでは全パターンで共通で、違うのは「返ってきた型をコードのどこで受けるか」だけです。
この記事は、Jev が何であるかの説明ではなく、すでに動いているエージェントやバッチ処理のどこに Jev を差し込むかを、公式ドキュメントに載っているコードだけで7つに整理したものです。用語・料金表・型の意味から知りたい場合はJev API入門の記事を、料金と仕様の総論はJevの仕様と料金をまとめた解説を先にご覧ください。以下に載せたコードはすべて公式ドキュメントの例で、筆者が実行して結果を確かめたものではありません。数値は公式の現在値を2026年9月21日に引き直しています。
Jev APIの実装は7つの型に収まる
公式の Patterns セクションには4つの型(Speculative fan-out/Confidence-gated routing/Composite scoring/Intent routing)が並び、Cookbooks 側に LLM のガードレールや抽出結果の検証が置かれています。これらをエージェント側から見た「置き場所」で並べ直すと、次の7つになります。
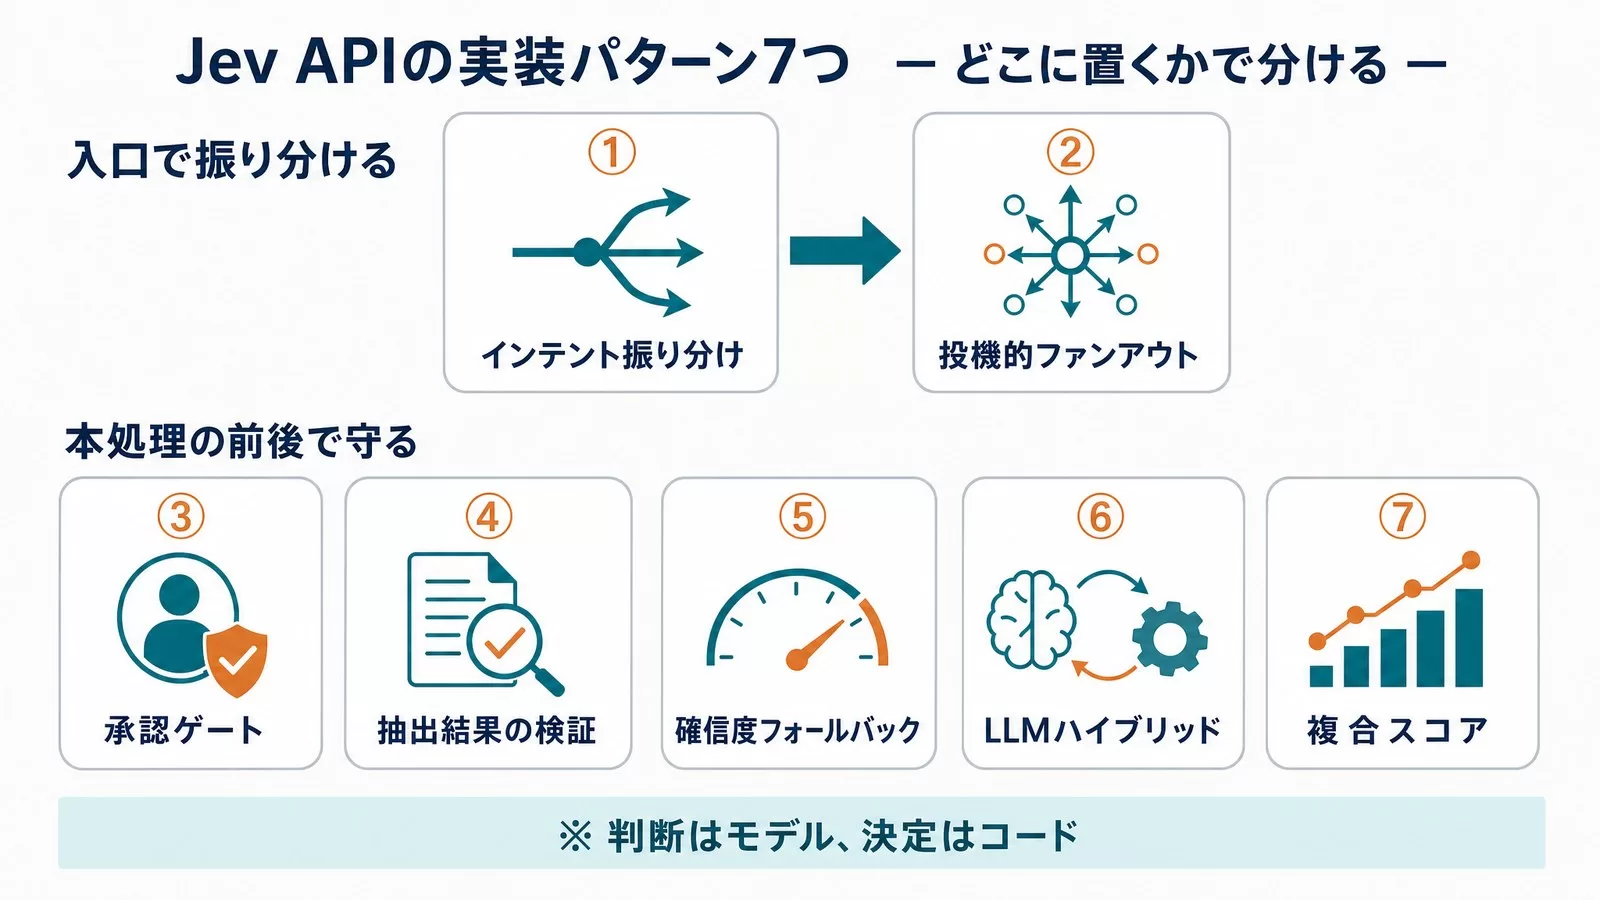
| # | 型 | パイプライン上の位置 | 返り値のどこを見るか |
|---|---|---|---|
| 1 | インテント振り分け | 入口。処理系を選ぶ手前 | choice と confidence |
| 2 | 投機的ファンアウト | 入口。1往復で全部聞く | 使う答えだけコードで拾う |
| 3 | 承認ゲート | LLM 呼び出しの前後 | noul の配列と score |
| 4 | 抽出結果の検証 | パース処理の直後 | choice(候補から選ばせる) |
| 5 | 確信度フォールバック | 自動実行の直前 | confidence のしきい値 |
| 6 | LLMハイブリッド | 生成モデルの手前 | choice で行き先を決める |
| 7 | 複合スコア | 並び替え・優先度づけ | 複数の score を重み付け |
7つに共通する考え方は、公式の「How to build with TypeSafe」が1行でまとめています。制御フロー・決定的なルール・副作用はコードが持ち、モデルには狭く型のついた判断だけを渡す。同ページは System One を「エージェントを作るためのものではない」と明記していて、モデルが次の行動を自分で選ぶ設計は想定に入っていません。既存のエージェントに入れるときも、Jev が置き換えるのは while ループではなく、その中にある脆い if と正規表現です。
組み込む前に決める4点と、既存の手段との置き場所
パターンを選ぶ前に、コードの都合として先に固まる値が4つあります。公式の Models ページと API リファレンスの現在値です。
| 決めること | 2026年9月21日時点の公式値 | 実装上の注意 |
|---|---|---|
| エンドポイント | POST https://api.typesafe.ai/v1/systemone(Authorization: Bearer)。モデル一覧は GET /v1/models |
質問の種類が増えても叩き先は同じ。型ごとにルートは分かれない |
| モデル名 | jev-latest と jev-preview はどちらも jev-1.13.0 を指す。応答の model には版番号が返る |
エイリアスは新版が出ると移動する。しきい値を調整した後は版番号で固定する |
| SDK と言語 | Python(pip install typesafe-sdk・Python 3.10 以上)と JavaScript/TypeScript(npm install @typesafe-ai/sdk・Node.js 20 以上)。他言語は HTTP API を直接呼ぶ |
公式 SDK は既定の再試行ポリシーを持つ。直叩きすると再試行は自前になる |
| 上限と課金 | 1リクエスト64,000トークン、state と最長の質問で32,000トークン。毎秒250,000トークン/毎分1,200リクエスト。入力100万トークンあたり0.042ドル(10億トークンあたり42ドル)、出力は無料 | レート上限は「予告なく変わる場合がある」と公式が明記。上限に当たると 429 |
入力はテキストだけです。文字列・JSON オブジェクト・テキスト値の配列を受け取り、画像・音声・動画は受け付けません。画面や PDF を扱うなら、OCR や構造化を済ませたうえで state に入れる必要があります。
既存の手段のどれと入れ替わるのか
公式ブログ(2026年9月15日)は、既存の LLM との違いを自社の比較表として次のように説明しています。以下はいずれも TypeSafe 側の説明であって、第三者の測定ではありません。
| 観点 | 既存のLLM(公式ブログの記載) | System One / Jev(公式ブログの記載) |
|---|---|---|
| 出力 | 文字列。使う側でパースと検証が要る | 型のついた構造化された値。型エラーを起こさない |
| サンプリング | 逐次。1トークンずつ生成する | 並列。1クエリで全出力を生成する |
| 入力単価 | 100万トークンあたり0.20ドルから10ドル。出力は入力の約5倍 | 100万トークンあたり0.042ドル。出力は無料 |
| 応答時間 | エンドツーエンドで3秒から329秒 | エンドツーエンドで70ミリ秒から500ミリ秒 |
| 確信度 | 聞いても自信過剰・不安定になりがち | すべての出力に較正された確率と確信度が付く |
実装の判断としては、文字列を生成させる必要がある処理は置き換えられないという一点に尽きます。公式の失敗モード一覧も「生成には別のモデルを使え」と書いています。置き換え先になるのは、すでに LLM に投げている分類・スコアリング・可否判定、あるいは正規表現とルールで書いた脆い判定です。モデルを用途で振り分ける設計そのものについてはモデルルーティング設計ガイドで扱っています。
パターン1・2|インテント振り分けと投機的ファンアウト
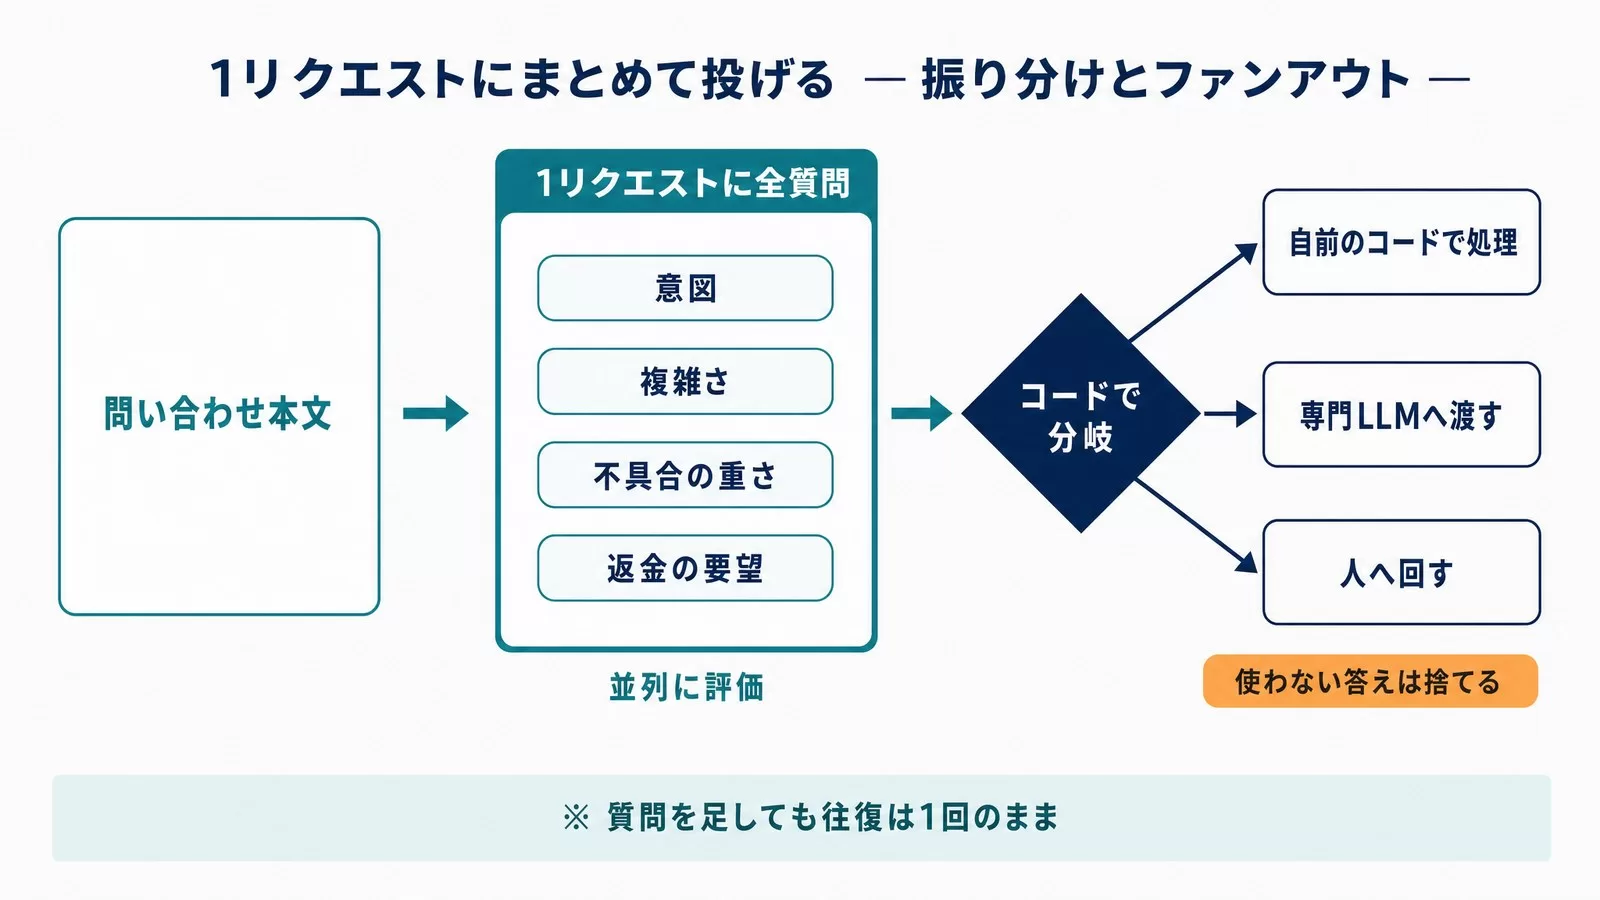
入口に置く2つは、組み合わせて1リクエストにまとめるのが公式の書き方です。まず最小の1発。公式クイックスタートの cURL をそのまま引用します(実行はしていません)。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
  {
    "state": "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.",
    "model": "jev-latest",
    "questions": {
      "urgency": {
        "type": "noul",
        "instructions": "Does this message express urgency?"
      }
    }
  }
EOF
Python SDK なら、同じ state に3種類の質問を同時に載せられます。こちらも公式クイックスタートの例です。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

ticket = "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP."

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=[
                "Calm, just stating facts",
                "Frustrated but civil",
                "Very angry, strong language",
            ],
        ),
        "is_urgent": Noul(
            instructions="The message conveys urgency or time-sensitivity",
        ),
    },
)

print(response.answers["department"].choice)  # "technical"
print(response.answers["frustration"].score)  # 1.0
print(response.answers["is_urgent"].noul)     # 1.0
クライアントは環境変数 TYPESAFE_API_KEY を読み、既定で jev-latest を呼びます。JavaScript/TypeScript でも形は同じで、回答の型は質問から推論されます。
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient();
const response = await client.systemOne({
  state: { document: "I was charged twice. Please fix this ASAP." },
  questions: {
    category: choice("What is this ticket about?", {
      billing: null,
      technical: null,
      other: null,
    }),
  },
});

console.log(response.answers.category.choice);
振り分けは confidence を先に見る
公式の Intent routing パターンは、意図(Choice)と複雑さ(Score)を1リクエストで聞き、分岐の先頭に確信度の下限を置く書き方を示しています。
def route_ticket(ticket_id, response):
    intent = response.answers["intent"]
    complexity = response.answers["complexity"]

    if intent.confidence < 0.5:
        # If we don't have enough confidence to classify, route to a human agent
        return route_to_human_agent(ticket_id)

    if intent.choice == "order_status":
        handle_order_status(ticket_id)

    elif intent.choice == "product_question":
        handle_with_llm(ticket_id, PRODUCT_SPECIALIST)

    elif intent.choice == "return_exchange":
        handle_with_llm(ticket_id, RETURNS_SPECIALIST)

    elif intent.choice == "complaint":
        low_confidence = complexity.confidence < 0.5
        # A higher complexity.score leans toward the "escalation needed" end of the scale.
        if complexity.score > 1 or low_confidence:
            # Too complex for safe automation, or we're not sure about the complexity; route to a human.
            route_to_human_agent(ticket_id)
        else:
            handle_with_llm(ticket_id, COMPLAINT_RESOLUTION)
4つの行き先のうち、1つは LLM を呼ばない自前のコード、2つは文脈の違う専門 LLM、1つは Score を見て人へ回すかどうかを決めます。高い資源を使うのは「本当に必要だった要求」だけになります。
使うか分からない質問も最初の1回に入れる
公式の Speculative fan-out は、後で使うかもしれない質問を最初のリクエストに全部載せる設計です。質問は state に対して並列に評価されるため、数を増やしても応答時間はほとんど変わらず、増える費用は追加の質問トークンぶんだけ、と公式は説明しています。サポートの例では、区分(Choice)と一緒に不具合の重さ・再現手順の有無・返金の要望・苛立ちの度合いまで最初の1回で聞いておき、区分が確定してから使わない答えは捨てるという流れになります。
category = response.answers["category"]
bug_severity = response.answers["bug_severity"]
bug_repro = response.answers["has_reproducible_steps"]
refund = response.answers["refund_requested"]
frustration = response.answers["frustration"]

if category.choice == "bug_report":
    if bug_severity.score > 1.5 and bug_repro.noul > 0.6:
        escalate_to_engineering(ticket_id, severity="high")
    else:
        add_to_bug_backlog(ticket_id)

elif category.choice == "billing":
    if refund.noul > 0.7:
        route_to_billing_with_flag(ticket_id, refund_likely=True)
    else:
        route_to_billing(ticket_id)

elif category.choice == "feature_request":
    log_feature_request(ticket_id)
効果の目安として、公式の Parallel questions クックブックは GDPR の記事に13問を投げる例で、13回に分けた場合と比べて1回にまとめると12.2倍安く10.0倍速く、答えは変わらなかったと掲載しています(同じ比較は Primitives の概要ページでは別の数字が書かれており、ここではクックブック本体の実行結果を採りました)。この差が出るのは、state を1回だけ読ませるからです。
パターン3・4|承認ゲートと抽出結果の検証
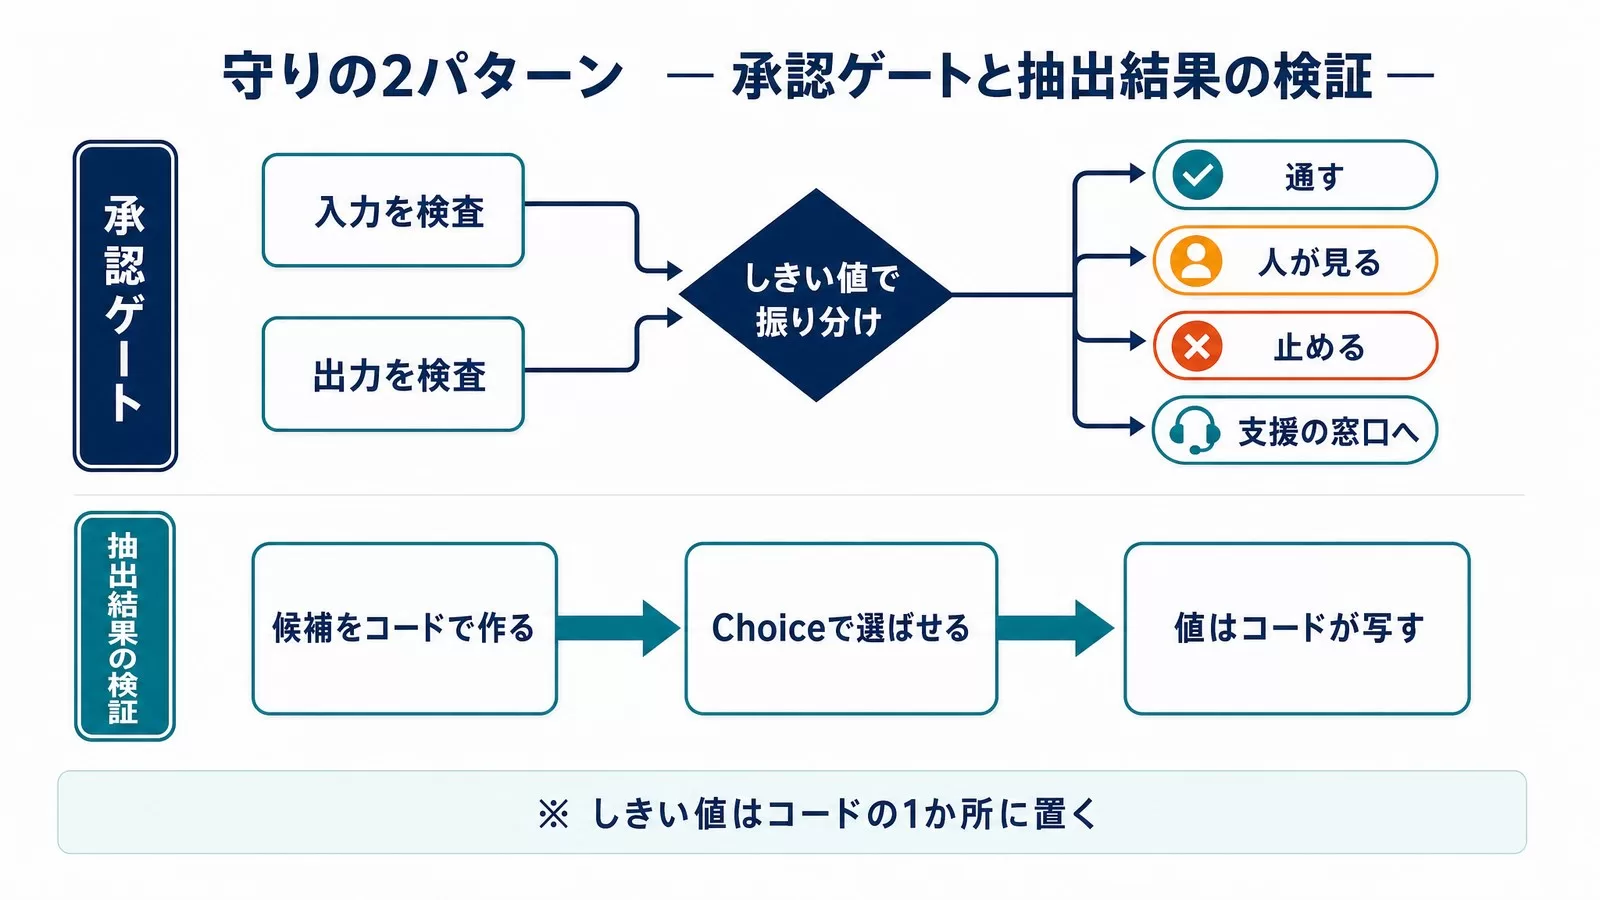
次の2つは、すでに動いている処理の前後に「関所」として足す型です。エージェントの本体に手を入れずに済むので、最初に入れる場所としても現実的です。
承認ゲートはしきい値をコードの1か所に集める
公式の LLM ガードレール向けクックブックは、危険性ごとの Noul と重さの Score を1リクエストで聞き、返ってきた確率をアプリ側のポリシーに当てて行き先を決める形を示しています。掲載されている数値は jev-1.12 で2026年8月15日に取得したものだと明記されています。
# A high-probability hazard triggers the product action below.
HAZARD_ACTION = {
    "jailbreak": "block",
    "broke_policy": "block",
    "harmful_request": "block",
    "medical_advice": "review",  # Routes to a human review path instead of blocking it
    "self_harm": "support",      # Routes to a support path instead of blocking it
}
PRECEDENCE = ["support", "block", "review", "pass"]  # Highest precedence wins

POLICIES = {
    "strict": {"review_threshold": 0.35, "action_threshold": 0.70, "severity_block": 2.0},
    "permissive": {"review_threshold": 0.35, "action_threshold": 0.85, "severity_block": 2.0},
}
DEFAULT_POLICY = "strict"


def route(nouls: dict[str, float], severity: float, policy: dict) -> str:
    """Turn one message's TypeSafe assessment into one policy-specific action."""
    triggered = []
    for hazard, probability in nouls.items():
        if probability >= policy["action_threshold"]:
            triggered.append(HAZARD_ACTION[hazard])
        elif probability >= policy["review_threshold"]:
            triggered.append("review")
    if severity >= policy["severity_block"]:
        triggered = ["block" if action == "review" else action for action in triggered]
    return next((action for action in PRECEDENCE if action in triggered), "pass")
実装として効くのは POLICIES の形です。しきい値に名前を付けて1つの辞書に集めておくと、ポリシーの変更が「質問文の書き直し」ではなく「定数の差分」になり、レビューできる変更になります。公式の Agent skill ページも「質問としきい値の定数は1か所にまとめる」ことを、コーディングエージェントと一緒に書くときの注意点として挙げています。
このクックブックは、入力側と出力側の両方で同じ検査を回すよう勧めています。ふつうに見える入力から有害な応答が出ることがあるためです。関所の設計思想そのものはLLMガードレール実装ガイドで扱った内容と重なりますが、Jev に載せ替えると検査が1往復ぶんの LLM 呼び出しではなくなります。
抽出は「生成させない」で通す
抽出結果の検証は、実装の順番が独特です。公式の失敗モード一覧が「文章の生成には使うな」と書いている一方で、候補をコードで作る→Choiceで選ばせる→値はコードが写す、という3段が推奨の形だと書かれています。候補づくりは正規表現でも生成モデルでもかまいません。最後に値そのものはコードが元データから写すので、モデルが値を作り直す余地がありません。
日付はその代表例です。公式は、日付をテキストとして読むため前後関係や期間の判定が当てにならないとしたうえで、月・日・年のような「閉じた集合」を Choice の選択肢にして取り出し、組み立てと比較はコードでやる、と指示しています。選択肢に「記載なし」を1つ足しておけば、欠けている部分が推測されずに報告されます。Choice の選択肢は1問あたり最大255個、Score のレベルは2つ以上10個までです。
パターン5・6・7|確信度フォールバック、LLMハイブリッド、複合スコア
残る3つは、答えを受け取ったあとのコード側の設計です。
しきい値は「取り返しのつかなさ」で変える
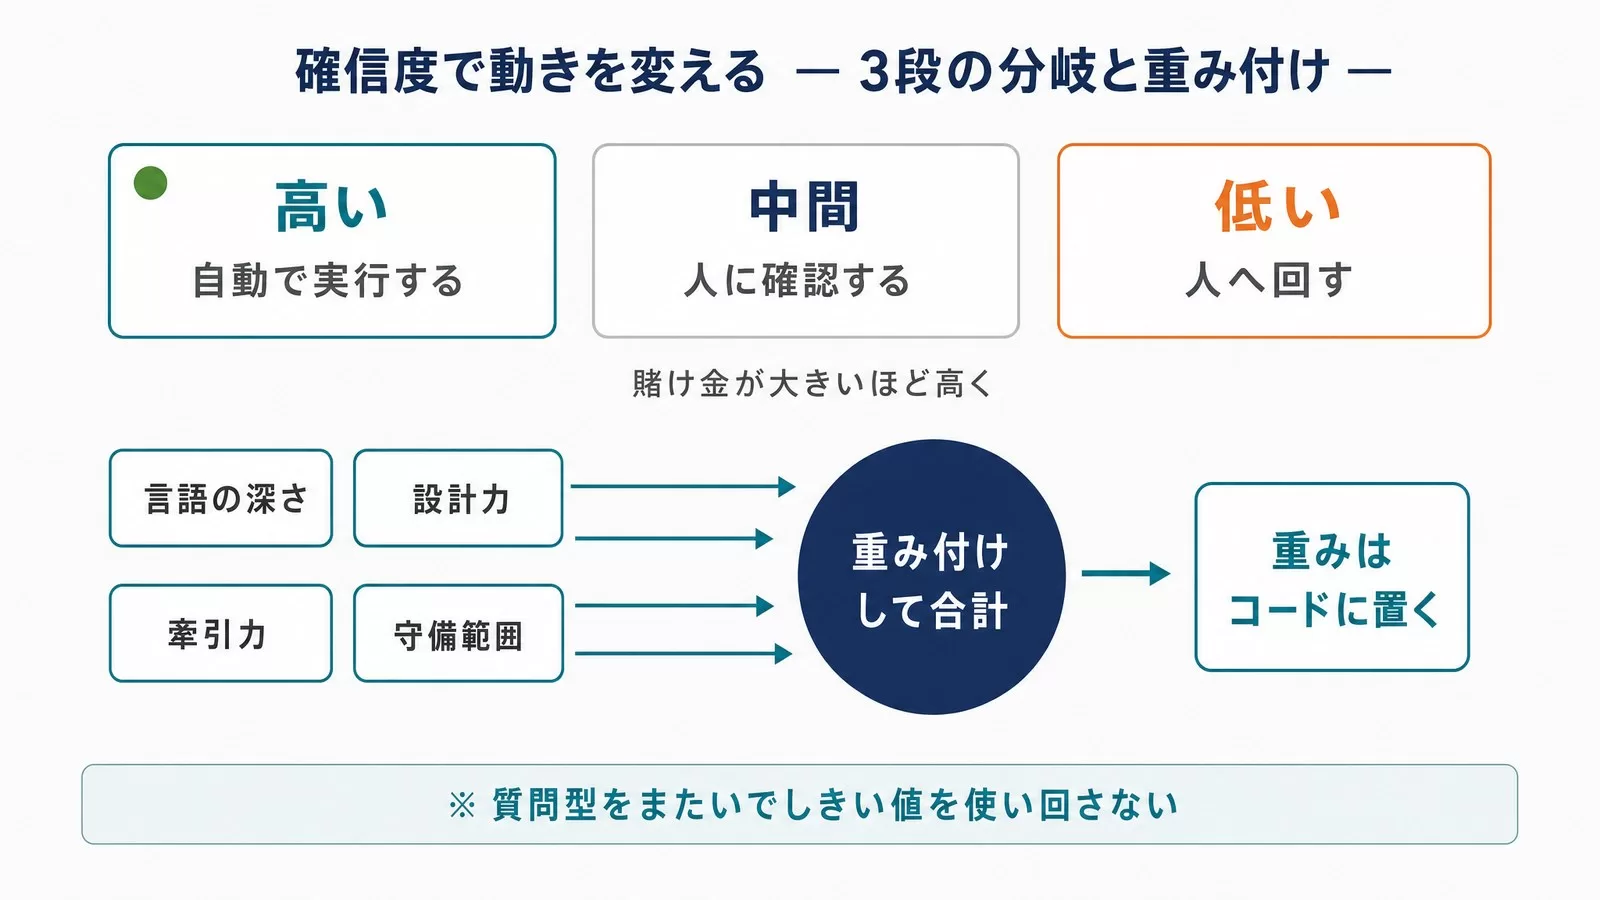
公式の Confidence ページは、確信度を高・中・低の3段に割り、同じシステムの中でも操作ごとに違うしきい値を置くと説明しています。高いなら自動で実行する、中間なら人に確認する、低いなら人へ回す。分かれ目の数字はひとつに決められるものではなく、賭け金が大きいほど高くします。Confidence-gated routing パターンの例は、音声バンキングで残高照会と送金承認に別のラインを引いています。
action = response.answers["intent"]

# Below 0.6 confidence on any action, route to a human
if action.confidence < 0.6:
    route_to_support_agent(account_id)

elif action.choice == "check_balance":
    # Low stakes. 0.6 confidence is sufficient.
    show_balance(account_id)

elif action.choice == "approve_transfer":
    if action.confidence > 0.85:
        # High stakes, but high confidence. Safe to act automatically.
        approve_transfer(account_id)
    else:
        # High stakes, moderate confidence. Verify intent first.
        ask_user_to_confirm("Just to confirm: you would like to approve this transfer, is that correct?")

else:
    route_to_support_agent(account_id)
公式は「正しいしきい値は領域とモデルの成績で決まる。保守的な値から始めて自分のデータで検証し、結果を見て調整する」と注記しています。数字をそのまま持ってくる前提のコードではありません。なお Noul には confidence が付きません。0.5 は「はいといいえが同じ確率」という意味であって、「中くらい」ではない点に注意が要ります。
フォールバック先は2系統を用意するのが実装としては安全です。ひとつは人への引き継ぎ、もうひとつは判断が重すぎる場合に回す推論モデル。公式の How to build ページも、確信度が低いケースは「人か、より高価な推論モデルへ上げる」と書いています。
Jevで振り分け、LLMで書かせる
ハイブリッドは、上の Intent routing がすでにその形をしています。handle_with_llm(ticket_id, PRODUCT_SPECIALIST) のように、Jev は行き先を決めるだけで、文面を作るのは従来どおり生成モデルです。ここで効くのは、専門ごとに違う文脈を積んだ LLM を用意しておき、全部に同じ巨大なシステムプロンプトを持たせるのをやめられる点です。
公式の失敗モード一覧は、Jev に文章を生成させようとすると「うまくいかないうえに非常に遅くなる」と明記しています。生成が要る場所を残す設計は妥協ではなく、公式の想定どおりの使い方です。
重み付けをコードに残す
複合スコアは、ひとつの大きな判断を独立した軸に割り、重みはコードに置く型です。公式の Composite scoring は履歴書の評価を例に、言語の深さ(Python の熟達度)・牽引力(チームを率いた経験)・設計力(システム設計)・守備範囲(ジェネラリスト度合い)の4つを別々の Score で聞き、0 から 1 に正規化してから役割ごとに違う重みで足す書き方を示しています。
py      = response.answers["python_depth"].score / 4
lead    = response.answers["team_leadership"].score / 4
arch    = response.answers["system_design"].score / 4
general = response.answers["generalist"].score / 4
同じ考え方を「危険信号の合成」に使った例が How to build ページにあります。重みを定数として書いておけば、方針が変わったときに直すのは数字だけで、質問文には触らずに済みます。
answers = response.answers

# Combine independent signals into one application-specific score.
quality = (
    0.4 * answers["answers_request"].noul
    + 0.4 * answers["citations_are_supported"].noul
    + 0.2 * (1 - answers["contradicts_context"].noul)
)
動かす前に読む2つの数字|公式evalsとjaggedness
設計を決める前に、公式が自分で出している2つの資料を読んでおくと、期待値の置き方がぶれません。
evals.typesafe.ai の見方
TypeSafe は evals.typesafe.ai で、セキュリティ警報・エージェントの実行ログ点検・請求書処理・カスタマーサービスの4つの業務を題材に、各モデルを「ワークフロー(判断を細かい質問に割ってコードで合成する)」と「プロンプト(1発で解かせる)」の2条件で比べた結果を公開しています。ページの読み方として押さえるべきは次の3点です。
- 正解ラベルはモデルが作っている。基準は GPT-6 Astra と Claude Fable 5.1 を高い思考設定で走らせた回答の平均で、他のモデルは各社の既定設定。人手の正解集合ではありません
- Jev はワークフロー条件だけに載っている。4業務平均で正答率67.8パーセント、1件あたり0.0004ドル、0.4秒。同じ平均で opus 5 のワークフローが73.1パーセント・0.1761ドル・37.8秒です
- 業務によって順位が入れ替わる。カスタマーサービスでは Jev が76.0パーセントで上位に並ぶ一方、請求書処理では61.8パーセントで他の多くを下回ります。自分の業務がどちらに近いかで読む数字が変わります
この比較の主張は「構造化したほうが良い」であって「Jev が一番賢い」ではありません。同じページは、どのモデルも同じ方針をプロンプト1発で解かせるより、ワークフローに分解したほうが正答率・費用・時間のすべてで良くなったと書いています。評価そのものの設計の考え方はAIエージェントのテスト自動化の記事で扱っています。
jaggedness ページは仕様書として読む
公式には jev-1.13 向けの「ジャギーな縁」を集めたページがあり、2026年9月17日に最終確認と記載されています。ここが実質的な制約仕様で、9項目それぞれに「代わりにこうしろ」が書かれています。次章で表にします。
公式が挙げる失敗モード9つと、コード側の受け方
以下は公式の失敗モード一覧の9項目を、実装側の受け方として並べ直したものです。左は公式の見出し、右は同ページの「Do this instead」を要約したものです。
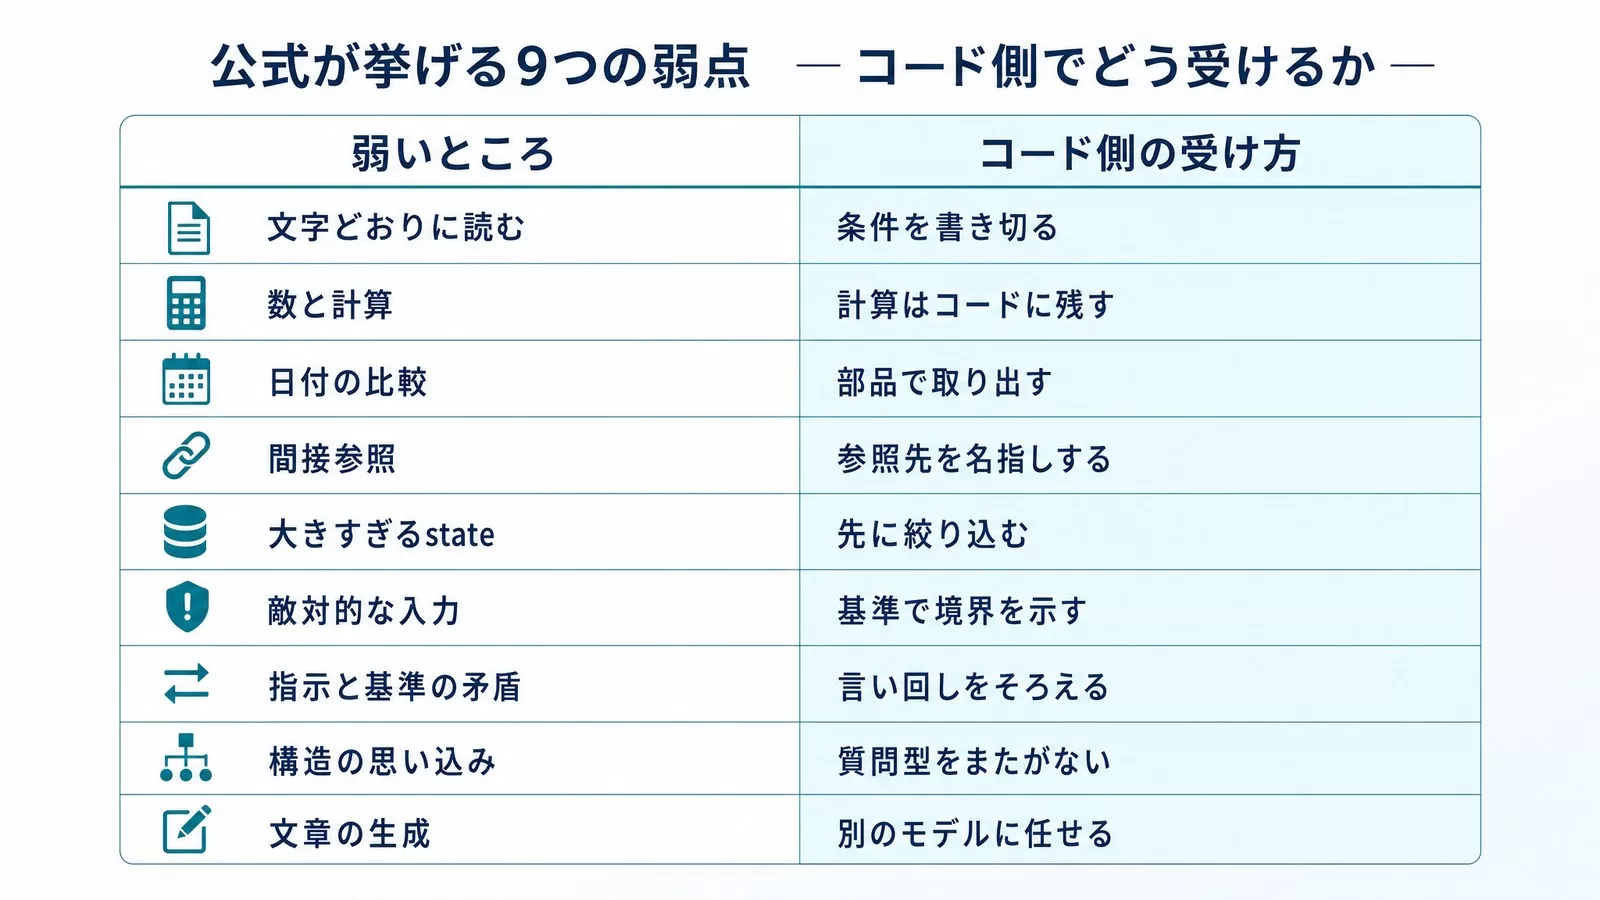
| # | 弱いところ | コード側の受け方 |
|---|---|---|
| 1 | 文字どおりに読む | 条件を書き切る。境界の例は criteria に入れる。解釈が要るなら2つの質問に割る |
| 2 | 数と計算 | 計算はコードに残す。数えるなら候補ごとに1問ずつ聞いて、合計はコードで取る |
| 3 | 日付の比較 | 部品で取り出す。組み立て・前後関係・期間はコードが持つ |
| 4 | 間接参照 | 参照先を名指しする。二重否定や多段の参照を避けて直接書く |
| 5 | 大きすぎるstate | 先に絞り込む。関係ない情報は精度を落とす。絞れないときは Noul で関連度を取る |
| 6 | 敵対的な入力 | 基準で境界を示す。state は既定では敵対的として扱われない。配布前に境界事例で試す |
| 7 | 指示と基準の矛盾 | 言い回しをそろえる。criteria は instructions の続きとして書く |
| 8 | 構造の思い込み | 質問型をまたがない。Noul で決めたしきい値を Choice に持ち込まない |
| 9 | 文章の生成 | 別のモデルに任せる。答えの範囲が有限なら Choice で選ばせる |
8番目は見落としやすいところです。公式は同じ問い「返金を求めているか」を Noul と二択の Choice で聞いた例を載せていて、Noul が 0.22、Choice の yes が 0.01 と、比べられる数字にならない様子を示しています。さらに、ある問いとその否定形を2つの Noul で聞くと合計が 1.19 になった例も挙げています。Choice は相対的にどれかを選ぶ問い、Noul は絶対的な可否の問いで、算術的な同一性は成り立ちません。
2番目の「数える」については、公式が回避のコードまで書いています。
from typesafe_sdk import Noul, TypeSafeClient

client = TypeSafeClient(model="jev-1.13")
YES = 0.5  # up to you on what you want the threshold to be, depends on your usecase.

items = ["typesafe", "apple", "california", "banana", "likes", "calibration", "orange", "vertex"]

result = client.system_one(
    {"items": items},
    {
        f"item_{i}": Noul(instructions=f"Is `items[{i}]` the name of a fruit?")
        for i in range(len(items))
    },
)

count = sum(result.nouls[f"item_{i}"].noul > YES for i in range(len(items)))
エラーと再試行は SDK の既定をまず読む
HTTP 側で返るのは 401(鍵の不備)、422(リクエストの検証失敗)、429(レート上限)、529(過負荷)です。公式は 429 と 529 を即時再試行せず指数バックオフで戻すよう指示していて、SDK を使っていれば既定のポリシーで処理されます。直叩きにするなら自前で実装が要ります。
Python SDK の RetryPolicy は、再試行回数・初回バックオフ・上限・ジッター・対象ステータス・Retry-After ヘッダを尊重するかどうか・総再試行予算などを持ちます。
from typesafe_sdk import RetryPolicy, TypeSafeClient

client = TypeSafeClient(
    retry=RetryPolicy(
        max_retries=3, timeout=10.0, http_statuses={429, 500, 502, 503, 504}
    )
)例外はステータスごとに型が分かれています。TypeSafeRateLimitError はサーバが要求した待ち時間を retry_after_ms で持ち、TypeSafeAPIError は x-typesafe-request-id ヘッダを request_id として公開します。ログにこの request_id を残しておくと、後から問い合わせるときの材料になります。応答の形が壊れていた場合は TypeSafeAPIResponseValidationError が field_path(たとえば answers.tone.confidence)を持って上がります。
早期提供・データ・第三者実装をどう扱うか
本番に入れる判断をする前に、公式に書いてあることと書いていないことを分けておきます。
- 提供形態:2026年9月15日の公式ブログに「Jev は本日から早期提供(early access)で利用できる」「待機リストから開発者を順次受け入れている」と書かれています。待ち時間の目安・無料枠の有無は、2026年9月21日時点で公式に確認できていません
- 基盤の選択肢:Amazon Bedrock などのマネージド基盤経由での提供、オープンウェイトの公開、自社環境での実行について、公式ドキュメントとブログに記載はありません。現時点で確認できる経路は TypeSafe のクラウド API のみです
- チューニング:Jev は顧客データでのファインチューニングや LoRA 適用を行わず、全アカウントで同じ重みが使われると明記されています。ドメインに寄せる手段は state・instructions・criteria、および判断を分解してコードで合成することです
- 言語:英語が主たる学習言語で精度も最も良く、CJK を含む他言語は「扱えるが同等ではない」と書かれています。日本語で使うなら、自分のデータで試し、振り分けでは確信度をよく見るよう公式が注意しています
- データの扱い:顧客のリクエストとレスポンスはモデルの学習に使わないと明記されています。データ処理契約・プライバシーポリシー・基本契約が Legal ページに置かれ、エンタープライズ向けにはデータ無保持(ZDR)の提供があります
第三者の実装例は「公式ではない」と分けて読む
GitHub の awlevin/typesafe-computer-use は、画面を OCR して次の操作を Jev の Choice で選ばせる macOS 向けのコンピュータ操作ループです。2026年9月16日作成・MIT ライセンス・Python 3.12 以上で、2026年9月21日時点のスター数は646。README には「1手あたり0.0002ドル、Claude Opus 5 に素のスクリーンショットを渡した場合の0.032ドルと比べて155倍安い」といった比較表が載っています。
これはTypeSafe 公式の成果物ではなく個人開発のプロジェクトで、掲載の数字も作者の測定です。設計の参考として読む価値はありますが、公式仕様として扱わないでください。同じ理由で、この記事でも数字は引用元を分けて書いています。
コーディングエージェントに書かせるなら公式スキルを入れる
公式は Claude Code や Codex 向けのエージェントスキルを配布しています。Claude Code の場合は次の2コマンドです(公式の記載どおりで、筆者の実行結果ではありません)。
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
他のエージェントは npx skills add typesafe-ai/skills --skill typesafe-ai を使います。公式が挙げている注意点のうち実装に効くのは2つ。コーディングエージェントは「1呼び出しに1質問」の癖に人より強く陥るので、スキル側から多問化を促していること。そして、スキルが古いとリクエストやレスポンスの項目をエージェントが創作する場合があるので、更新してから使うことです。
つまずきやすい設計ミス4つ
公式ドキュメントの記述と突き合わせると、避けられる失敗がはっきりします。
❌ 広い問いを1問投げて、返り値を後から解釈する
⭕ 判断を分解して、同じ state に対する独立した問いとして並べます。公式は「これがこのガイドでいちばん重要な考え方」とまで書いています。広い問いは複数の判断を1つの答えの裏に隠してしまい、外れたときにどこが外れたのか分かりません。分解しても質問は並列に評価されるので往復は増えません。
❌ 念のため全部 state に入れる
⭕ 質問が必要とする項目だけを入れます。公式は、判断に関係のない内容が増えるほど精度が落ちる(文脈の劣化)と明記し、先にコードで検索・絞り込みをしてから送るよう指示しています。上限の64,000トークンに収まることと、精度が保たれることは別の話です。
❌ Noul で調整したしきい値を Choice にも使う
⭕ 質問型ごとに別の数字として持ちます。公式の例では同じ問いが Noul で 0.22、Choice の yes で 0.01 になっています。しきい値の定数には、どの質問 ID に対するものかを名前で残しておくと取り違えを防げます。
❌ エイリアスのまま、しきい値を固定して本番に置く
⭕ 調整が終わった時点で版番号(jev-1.13.0)に固定します。公式は、エイリアスは新版が出ると移動し、そのぶん答えが変わりうると書いています。応答の model フィールドに実際に答えた版番号が入るので、ログに残しておけば入れ替わりに気づけます。
よくある質問
Jev API はどの言語から呼べますか?
公式 SDK は Python(3.10 以上)と JavaScript/TypeScript(Node.js 20 以上)の2つです。ほかの言語からは HTTP API を直接呼びます。その場合、SDK が既定で持っている再試行とバックオフは自前で実装することになります。
1リクエストに質問をいくつまで入れられますか?
質問数そのものの上限は公式に記載がありません。制約はトークン側で、1リクエストで64,000トークン、うち state と最長の質問1つで32,000トークンまでです。Choice の選択肢は1問あたり最大255個、Score のレベルは2つ以上10個までと明記されています。
レート制限はどのくらいですか?
2026年9月21日時点の公式値は毎秒250,000トークン、毎分1,200リクエストです。どちらかを超えると 429 が返ります。公式は「需要が非常に大きく、上限は予告なく変わることがある」と注記していて、上位プランでの引き上げは営業窓口の案内になっています。
Playground やコンソールはどこから使いますか?
公式クイックスタートは Playground(console.typesafe.ai/playground)にログインして state を貼り、質問を足していく手順を案内しています。API キーは同じコンソールの鍵ページで発行します。早期提供の段階なので、利用可否はアカウントの状態によります。
既存のエージェントのどこから置き換えるのが現実的ですか?
公式の考え方に沿うなら、最初に触るのは生成ではなく判定です。正規表現とルールで書いた分類、LLM に投げている可否判定、ログの仕分けといった「答えの範囲が最初から決まっている処理」が候補になります。文章を書かせている部分は残したまま、その前後に関所として足す入れ方から始めるのが、変更量の点でも安全です。
要点の整理
- 叩き先は
POST /v1/systemoneの1本、モデル名はjev-latest(実体jev-1.13.0)。課金は入力だけで、出力は無料 - 公式ドキュメントに出てくる設計は7つ。入口に置く2つ、前後に足す2つ、受け取った後の3つに分かれる
- しきい値と質問の定数は1か所に集め、名前を付けて扱う。レビューできる変更になる
- 計算・日付・数え上げはコードに残す。公式が弱点として明記している領域
- 調整を終えたら版番号に固定する。エイリアスは新版が出ると移動する
- 評価は公式の eval を鵜呑みにせず、自分の業務に近い題材の行を読む
この記事のコードは公式ドキュメントに掲載されている例で、筆者が実行して結果を確認したものではありません。導入にあたっては、自社のデータで確信度としきい値を必ず検証してください。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- TypeSafe AI「Introducing System One Models & Jev」(2026年9月15日・参照2026年9月21日)
- TypeSafe AI 公式ドキュメント「API reference」(参照2026年9月21日)
- TypeSafe AI 公式ドキュメント「Models」(参照2026年9月21日)
- TypeSafe AI 公式ドキュメント「How to build with TypeSafe」(参照2026年9月21日)
- TypeSafe AI 公式ドキュメント「Intent routing」・「Speculative fan-out」・「Confidence-gated routing」・「Composite scoring」(参照2026年9月21日)
- TypeSafe AI 公式ドキュメント「Confidence」・「Primitives (Questions)」(参照2026年9月21日)
- TypeSafe AI 公式ドキュメント「Jev 1.13 jaggedness」(2026年9月17日最終確認・参照2026年9月21日)
- TypeSafe AI 公式クックブック「Guardrails for LLMs」・「Parallel questions」(参照2026年9月21日)
- TypeSafe AI 公式ドキュメント「Retries」・「Exceptions」・「Agent skill」・「Legal」(参照2026年9月21日)
- TypeSafe AI「Workflow evals」(参照2026年9月21日)
- awlevin/typesafe-computer-use(第三者プロジェクト・MIT ライセンス・参照2026年9月21日)