2026年9月20日時点でどう扱うか:Bend 2 は「AI が書いたコードを人がレビューしきれない」問題に、人が書く lawとAI が書く proofで答える言語で、公式リポジトリの Limitations に「コンパイラの99%はAIが書いており、まだ完全な監査を受けていない」と書かれている段階です。本番の検証基盤として今すぐ採用する材料はありません。持ち帰る価値があるのは言語そのものではなく、エージェントの出力に機械が判定できる関門を置くという設計です。
要点は3つ。①保証されるのは LAWS.bend に書いた条件だけで、条件の書き漏れは保証されません。②速さの主張は比較条件に注意が必要で、Bend は型推論・型クラス・タクティクを持たないぶん検査が軽いという指摘があります。③既存の形式検証には自動証明の系統があるため、「証明は人(AI)が全部書く」以外の選択肢が現実にあります。
対象読者はコーディングエージェントの出力をマージする立場の開発者・PM。今日やることは Bend の導入ではなく、自分の CI にある関門を数えてみることです。
コーディングエージェントに任せる量が増えるほど、レビューの体力が先に尽きます。差分が1,000行を超えたあたりから、読んでいるつもりで読めていない箇所が出てくる。テストは通る。型も通る。それでも「この変更で、前から守られていたはずの性質が壊れていないか」は、テストが書かれた範囲しか答えてくれません。
2026年9月17日に公開された Bend 2 は、その隙間を「数学的証明」で埋めようとする言語です。人間が LAWS.bend にアプリが破ってはいけない条件を書き、AI が実装と、その条件が成り立つことの証明を書く。証明が通らなければコンパイルが失敗する——という設計です。公開直後に Hacker News で603ポイントを集め、翌日には「Bend 2 and the Vibe-Coding Trap」という批判記事が323ポイントで並ぶという、賛否が同時に立ち上がる形になりました。
この記事では、公式サイト・GitHub の README と CHANGELOG・言語ガイド、および批判側の記事と Hacker News の議論を突き合わせて、Bend 2 が何を証明で止められ、何は止められないのかを整理します。そのうえで、Bend を使うかどうかとは別に、エージェント時代の CI へ持ち帰れる考え方を残します。
【関連 2026年9月】証明の手前の層:決定的な検査とLLMを重ねる Open Code Review
証明で止める Bend 2 に対し、既存のコードベースにそのまま入れられる層として、どのファイルを見るか・どのルールを当てるかをプログラムが決め、判断だけを LLM に任せる Alibaba の Open Code Review(Apache-2.0)があります。導入手順と CI への組み込みは次の記事にまとめました。 Open Code Reviewとは|AIコードレビュー導入法
Bend 2とは|lawをPROOFで埋めさせる言語
Bend 2 は Victor Taelin 氏が2026年9月17日に公開した言語です。公式サイトは自らを「a fast language that blocks AI mistakes via proof(証明によってAIのミスを止める高速な言語)」と説明し、「C speed · CUDA parallelism · Lean proofs · Python syntax」という4点を掲げています。gihyo.jp も2026年9月18日の記事で、開発者が条件を定めて AI が実装と証明を書く言語として紹介しました。
公開時点の基本情報を、GitHub リポジトリと公式サイトの記載から整理します。
| 項目 | 公式に記載されている内容 |
|---|---|
| 公開日 | 2.0.0 が 2026年9月17日(CHANGELOG「2.0.0 (2026-09-17)」) |
| 作者 | Victor Taelin 氏(X で公開を告知) |
| ライセンス | Apache License 2.0 |
| 構文 | Python 風。意味論は Haskell / Lean に近く、リソースの扱いは Rust 的と公式ガイドが説明 |
| 型システム | アフィン依存型理論(BendTT)。既定で変数は最大1回しか使えない |
| コンパイル先 | C / Metal / CUDA / JavaScript |
| 対応環境 | Linux・macOS。Windows は非対応(WSL は可) |
| 証明の仕組み | タクティクなし。命題は型、証明はその型を持つ def |
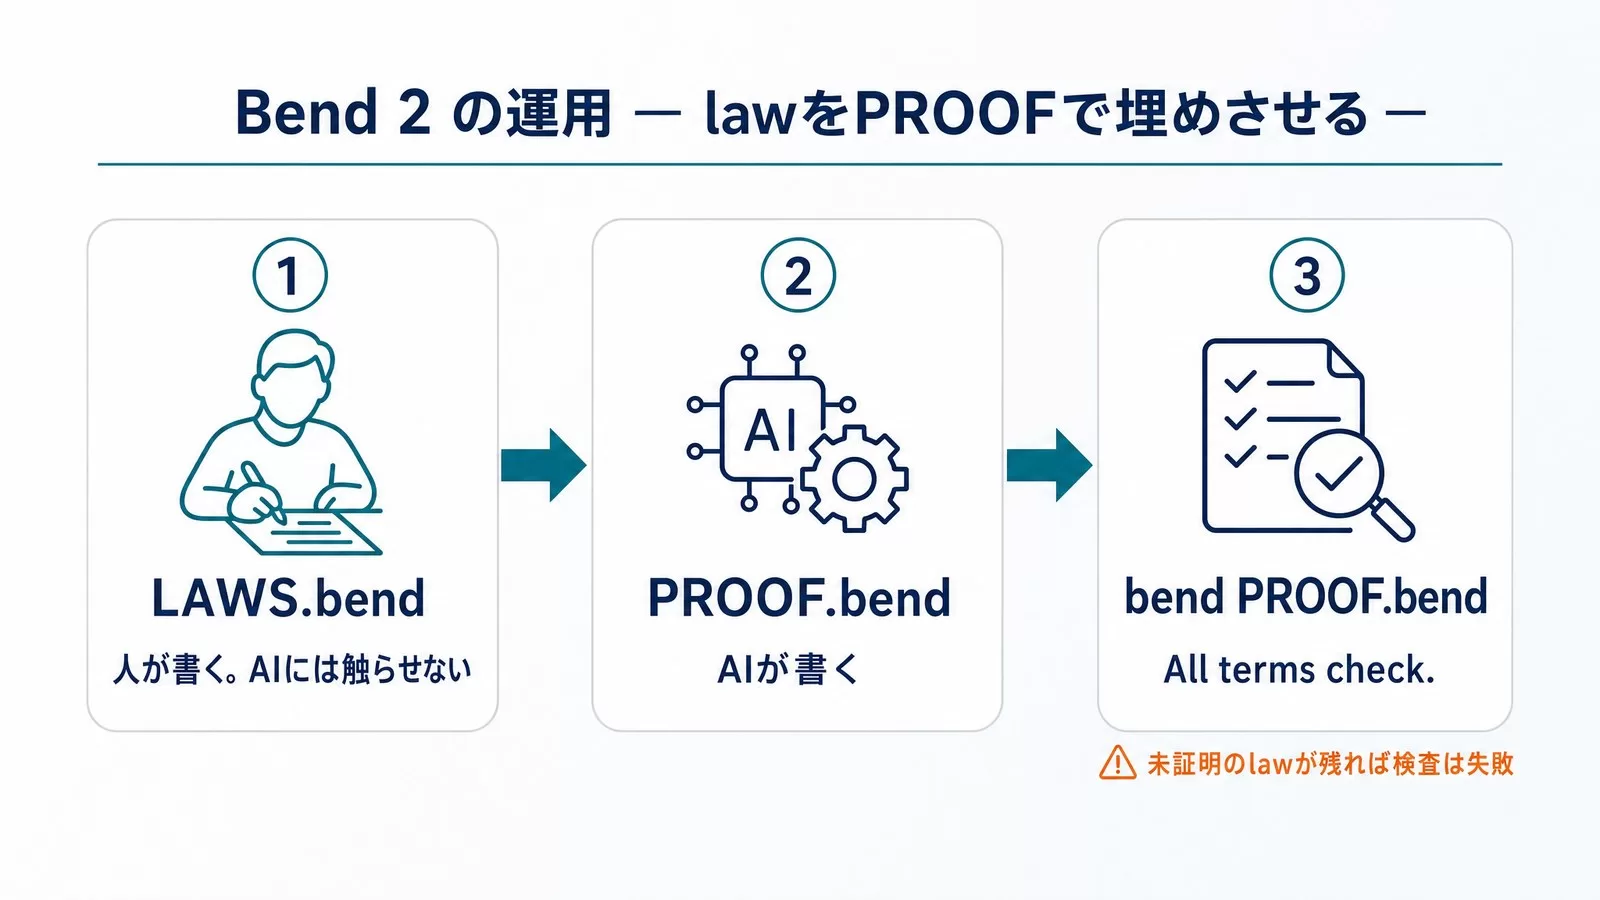
運用の形は公式ガイドがはっきり決めています。プロジェクトのルートに2つのファイルを置く。LAWS.bend には人間が守らせたい条件を書き、AI には触らせない。PROOF.bend には AI が実装コードと、その条件が成り立つことの証明を書く。bend PROOF.bend を実行すると、未証明の law が1つでも残っていれば検査が失敗し、全部埋まったときだけ「All terms check.」と表示される、という流れです。
公式ガイドに載っている最小の law と proof は次のものです(公式の例・筆者は実行していません)。「どんな自然数 x でも、x に 0 を足すと x になる」という主張を、0 の場合と「1つ小さい数に1を足した場合」に分けて帰納法で示しています。
import Base

# LAW: "for every x, x plus 0 equals x"
law add_zero:
  for x: Nat
  {Nat.add(x, 0n) == x : Nat}

# PROOF: case analysis:
# - base case: reflexivity
# - step case: induction, rewrite, reflexivity
def add_zero(x):
  match x:
    case 0n:
      {==}
    case 1n+p:
      %add_zero(p) : {1n+Nat.add(p, 0n) == 1n+_ : Nat}
      {==}

def main() -> {Nat.add(2n, 0n) == 2n : Nat}:
  add_zero(2n)
公式サイトのデモは、これをアプリに適用した例です。「どう操作しても勝てない」という law を1つだけ置いたゲームに、AI へ「盤面が端でつながるようにして」と指示する。law を要求しない場合は、端を回り込んで旗に到達できてしまう変更がそのままマージされました。law を要求した場合、AI は壁を追加し、新機能を入れたうえで「勝てない」を保ち続けた——というのが公式の説明です。README はこれを「LAWS.bend は証明に裏打ちされた AGENTS.md だ」とまとめています。
エージェント運用の観点で効くのは、公式が AGENTS.md に書けと案内している4行です。「bend guide を実行して言語を学べ」「重要なルールは LAWS.bend に置け」「コミット前に bend PROOF.bend を実行しろ」「可能な限り並列化しろ」。エージェントの手元に、自分では書き換えられない合否判定を置くという構図になっています。判定を型やスキーマに寄せる発想そのものは Bend に限りません。本日公開したJev API の入門記事も、曖昧な if 判定を型付きの API に閉じ込めるという同じ方向の話です。
何を証明で止められ、何は止められないのか
ここが賛否の分かれ目です。公式の主張と、公式自身が書いている制約を並べます。
止められる範囲
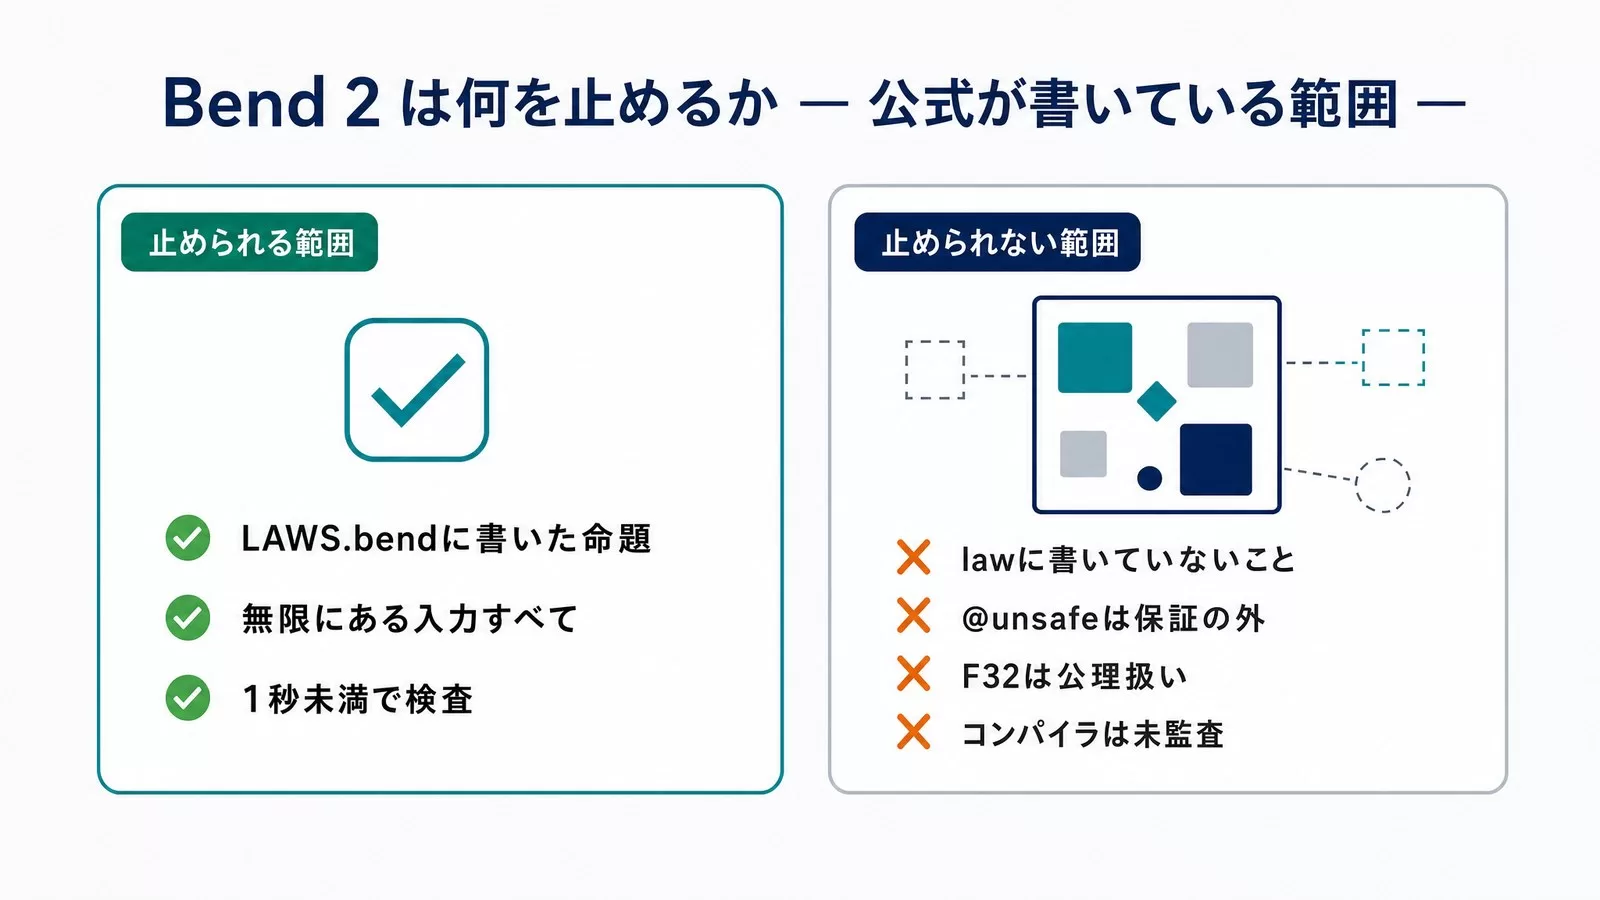
止められるのは「LAWS.bend に書いた命題が、実装に対して成り立つこと」です。テストとの違いは検査の網羅性にあります。Hacker News の議論でも指摘されていましたが、通常のテストは「選んだ入力に対して期待した出力が出たか」を見るのに対し、law は帰納法によって無限にある入力すべてについて成り立つことを示します。ゲームのデモで言えば、「初期状態が条件を満たす」ことと「条件を満たす状態にどの操作を加えても条件を満たしたままである」ことを証明すれば、どれだけ長い操作列でも勝てないことが従う、という構造です。
もう1つの主張が検査の速さです。README は「あらゆる証明支援系を数桁上回ることを目標にする」と書き、公式サイトは「他のプロジェクトなら数分かかるファイルを1秒未満で検査する」と説明しています。狙いは明確で、AI がコードを変えるたびに証明を検査できる速度にすることです。検査に数分かかるなら、エージェントのループには入りません。
止められない範囲
公式自身が挙げている限界のうち、判断に効くものを抜き出します。いずれも README の Limitations 節と言語ガイドの記載です。
- law に書いていないことは保証されない:gihyo.jp も「検証の対象は記述したルールに限られ、アプリに必要な条件が漏れなく記述されていることまで保証するものではない」と明記しています。
- @unsafe は保証の外:Bend は再帰が必ず終わることを検査しますが、
@unsafeを付けた関数はこの検査を無効化します。README は検査結果の表示が「All terms check, with N unsafe annotations.」になると書いています。 - F32 は公理扱い:README は「F32 is axiomatic: nothing about floating point can be proven(浮動小数点について何も証明できない)」と書いています。数値計算の正しさを law にすることはできません。
- コンパイラは未監査:README は「The compiler (not kernel) is 99% AI-written and has not been fully audited yet」と書いています。証明を検査する中核(カーネル)は人手で監査されたと作者が説明していますが、実行コードを吐く部分は別です。
- 形式化と実装に食い違いがある:README は「The Lean formalization and bend.ts mismatch. Early consistency bugs may occur」とし、誤った証明を受け入れてしまう不具合があり得ると述べています。
さらに実務的な制約として、数値型は Nat・U32・F32 のみで64ビット整数も倍精度もない、文字列は文字の連結リストなのでテキスト処理が遅い、TLS・HTTP ライブラリ・JSON・正規表現が現時点でない、テストフレームワークがない、デバッガ・プロファイラ・REPL がない、といった項目が README に並んでいます。Bend 1 のプログラムは Bend 2 へそのまま持ち越せないことも明記されています。
まとめると、「証明が通った」が意味するのは「書いた law については破れない」であって、「アプリが正しい」ではありません。この距離が、次の批判につながります。
批判側の論点|「SPARKで足りる」「ベンチが不公平」
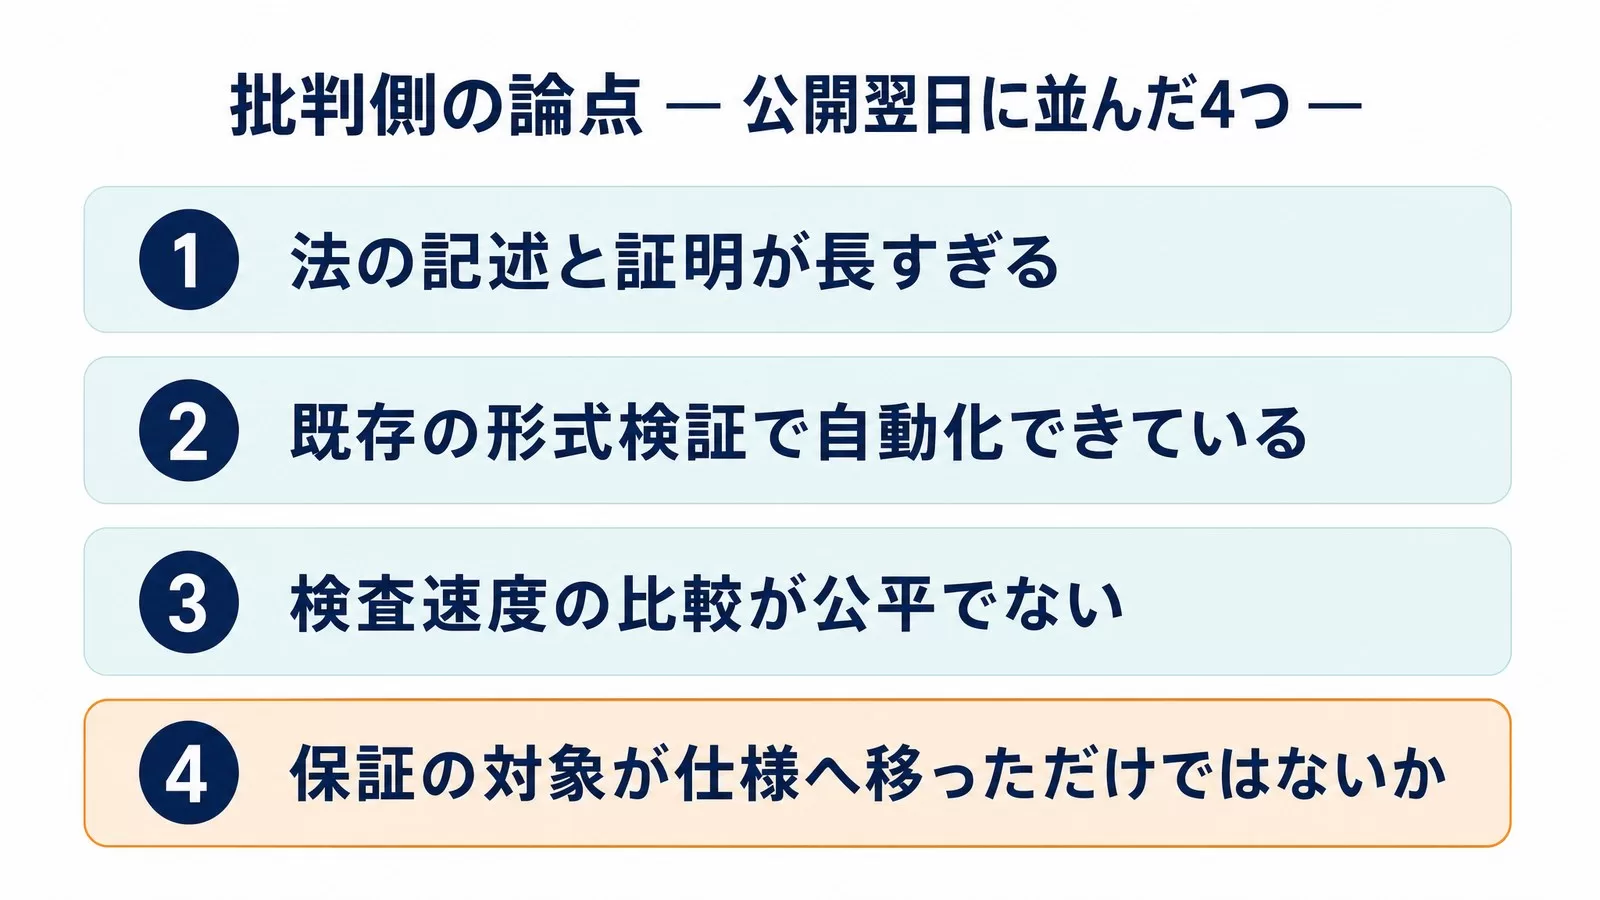
公開翌日の2026年9月18日、Liam Powell 氏が「Bend 2 and the Vibe-Coding Trap」を公開しました。Hacker News で323ポイントを集め、235件のコメントが付いています。主張は3点に整理できます。
論点1:法の記述と証明が長すぎる
同記事は、公式デモの LAWS.bend が58行、それを証明する PROOF.bend が442行であることを指摘しています。「プレイヤーは旗に触れられない・勝てない」というだけの性質に、この分量が必要だという指摘です。
論点2:同じことが既存の形式検証で自動化できている
同記事は同じゲームを SPARK(Ada 系の形式検証向け言語)で書き直し、事前条件・事後条件とループ不変条件を添えただけのコードに対して GNATprove を実行し、「Success: all checks proved (12 checks).」という結果を得たと報告しています。証明そのものは道具が自動で組み立てた、というのが要点です。筆者はこの再現を行っていないため、以上は同記事の報告としてお読みください。
その上で同氏は「Bend の Web サイトにもコードベースにも formal verification という語が1度も出てこない」と述べ、分野の存在ごと見落としたまま言語とコンパイラを作り上げてしまった例だ、と批判しました。記事の主眼は Bend 個別の優劣ではなく、バイブコーディングは「もっと良い解が既にある」と気づく前に、substantial な実装を完成させてしまうという一般論に置かれています。
論点3:検査速度の比較が公平でない
Hacker News のコメントと、同日に公開された検証ノートが、ベンチマークの読み方に注文を付けています。Lean・Agda・Rocq などが検査に時間を使っているのは、省略された暗黙の引数を埋めるエラボレーションや単一化、型クラスの解決、タクティクの実行であり、Bend にはそれらがそもそも無い。README 自身「everything is annotated and nothing is inferred」と書いているとおりです。つまり比較しているのは「Bend の検査器」対「他系のエラボレータ+カーネル」であり、カーネル同士で比べれば他系も十分速い、という指摘です。
論点4:保証の対象が仕様へ移っただけではないか
もっとも運用に効くのがこの指摘です。型検査が保証するのは「コードが LAWS.bend を満たすこと」であって「LAWS.bend が意図を表していること」ではない。LLM が law を空疎に、あるいは意図より狭く満たすことを妨げるものは何もない——信頼の問題がコードから仕様へ移動しただけだ、という論です。
これを裏付ける実験報告も投稿されています。公式デモの壁を外させてみたところ、AI は「移動を斜めだけにする」という解に到達し、「勝てない」という law は保ったまま、ゲームとしては別物になった、というものです。law が1つしかなければ仕様は当然に不足し、不足した仕様と厳格な検査の組み合わせは、AI を文言は満たすが趣旨は外す解へ押しやる、という見立てです。
作者側の反論
賛否を片側だけ載せるのは公平ではないので、作者の応答も要約します。Taelin 氏は批判記事のスレッドで、形式検証を知らないという前提が事実と違うと反論しました。7年前に形式検証の講演をしていること、Aaron Stump 氏の self types を実装した Cedille Core、5年前に作った Kind-Lang といった過去の実装を挙げ、10年ほどこの分野を独学で研究してきたと述べています。証明が冗長なのは推論や単一化を知らないからではなく、設計上の選択だという立場です。
また別のコメントで、コンパイラ・ランタイム・カーネルといった中核は自分の設計であり、カーネルは人手で広範に監査済みで、AI が書いた雑な部分は時間をかけて刈り取っていくと説明しています。第三者からも「Bend 2 は依存型の系統で、自動証明を押し進める Ada/SPARK とは別のトレードオフを取っているだけで、両者を対立させるのは藁人形だ」という擁護が付いています。
整理すると、批判側と作者側は「証明を誰が書くか」で割れています。SPARK は道具に自動で解かせる系統、Bend は LLM に書かせる前提で検査器を軽く速くした系統です。どちらが正しいかは、トークン単価と自動証明の到達範囲が今後どう動くかに依存します。
Lean・Dafny・SPARK・Rustとの位置関係
「うちで何を使うべきか」を判断するには、各公式が自分をどう説明しているかを並べるのが早いです。以下はすべて各公式サイト・公式ドキュメントの記載範囲に限っています。
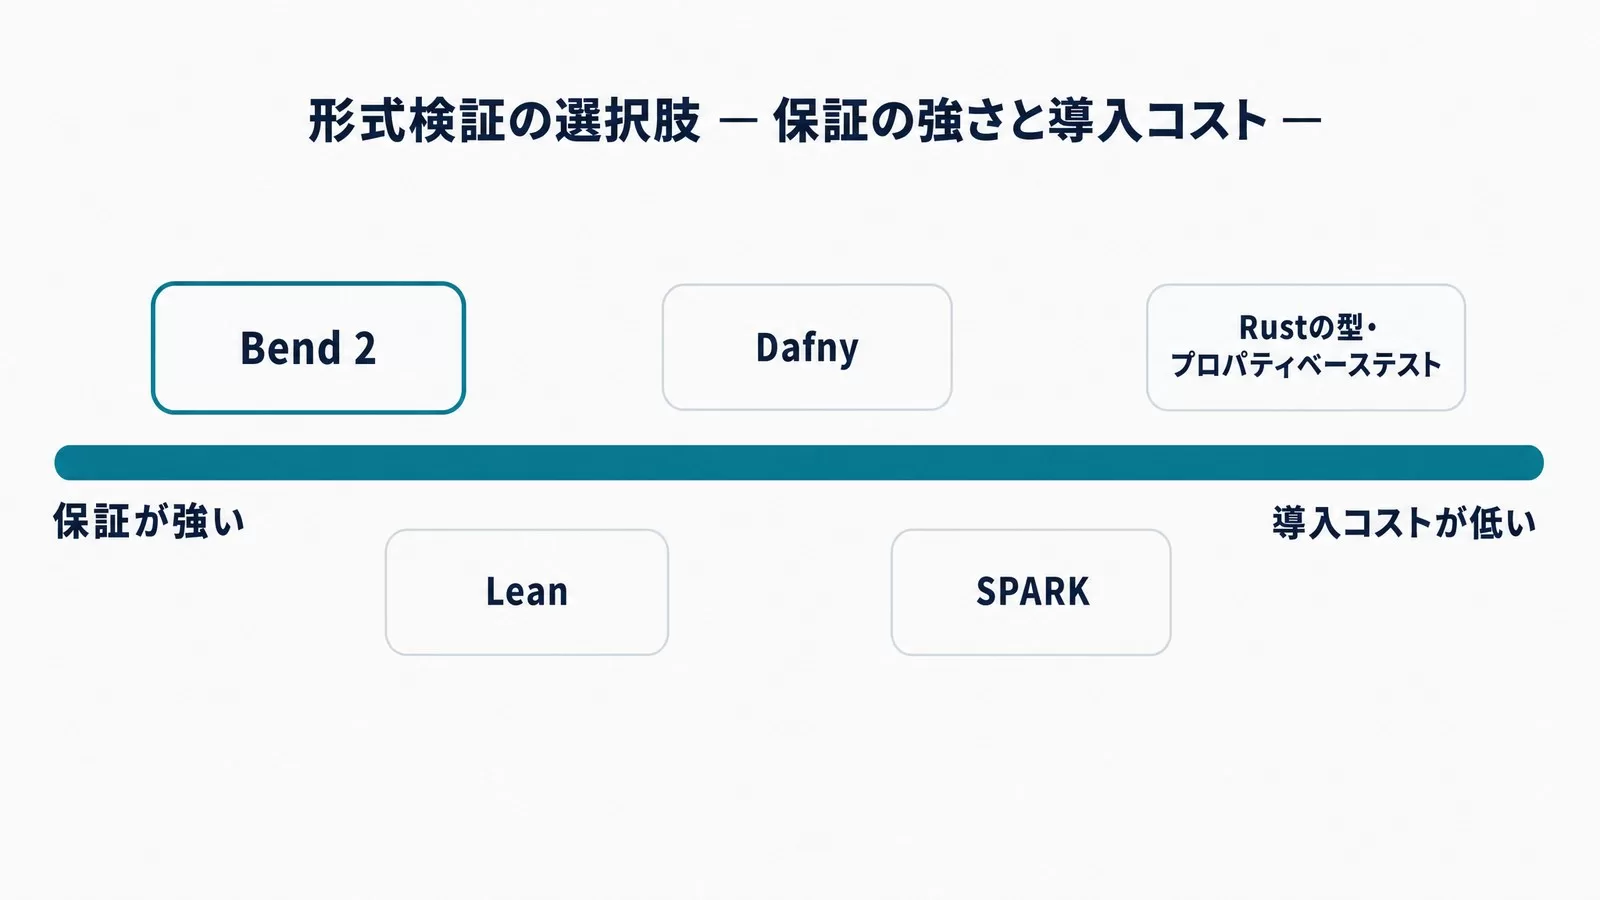
| 名前 | 公式の説明 | 証明を誰が書くか | 今日の使いどころ |
|---|---|---|---|
| Bend 2 | 証明によってAIのミスを止める高速な言語。C並みの速度、CUDA並みの並列性、Python風の構文 | AI(タクティクなし・帰納法を手で書く) | 検証の実験。公式が未監査部分ありと明記 |
| Lean | 正しく保守可能で形式検証されたコードを書けるオープンソースの言語かつ証明支援系 | 人(grind などの自動化タクティクあり) | 数学の形式化、仕様の厳密な検証 |
| Dafny | 仕様の記述を言語機能として持ち、静的プログラム検証器を備えた検証指向言語。C#・Java・JavaScript・Go・Python へコンパイル | 道具(自動推論)+人の補助 | 既存の開発環境に検証を混ぜる |
| SPARK | AdaCore が Formal Proof のカテゴリで提供。GNATprove で形式検証を行う | 道具(GNATprove が自動で解く) | 高信頼領域の実績ある選択肢 |
| Rust の型・プロパティベーステスト | 言語の型検査と、入力を生成して性質を確かめるテスト手法 | 書かない(反例を探す) | 今日の現場で最も導入コストが低い |
読み方は単純です。右へ行くほど導入コストが低く、左へ行くほど保証が強い。そして保証が強い側ほど、仕様を書く人間の負担が増えます。Bend 2 が独自なのは「保証は強い側、仕様と証明の記述量も多い側、ただし記述量の負担は AI が持つ」という置き方をした点です。この賭けが成立するかどうかが、まさに論争の中身です。
なお、プロパティベーステストと law の関係はよく混同されます。どちらも「どんな入力でも成り立つ性質」を書きますが、プロパティベーステストは反例を探すので見つからなければ「見つからなかった」までしか言えません。law は成り立つことを示すので、通れば反例は存在しません。エージェントのテスト設計をどう組むかは、AIエージェント品質評価ガイドで pytest を軸に整理しています。
触ってみる最短手順|公式ガイドに載っているコマンドだけ
以下はすべて公式サイト・README・公式ガイドに記載されたコマンドです。筆者の環境では実行していないため、実測値や体感は書きません。本番環境で使う前に、必ず検証用の環境で動作を確認してください。
手順1:インストールとエージェントへの申し送り
# 公式サイトが案内するインストール
curl -fsSL https://bend-lang.com/install.sh | sh

# バージョンの確認(2.0.17 で bend --version から bend version に変更)
bend version
インストーラは GitHub リリースからプラットフォームごとの実行ファイルを1つ取得し、スクリプト内の sha256 と照合してインストールする、と CHANGELOG 2.0.8 に書かれています。Bend は自分自身を更新せず、bend update はインストーラを再実行する仕組みです。1日1回、バージョン・OS・CPU 種別を公式サイトへ送る動作があり、BEND_NO_TELEMETRY=1 で無効化できると明記されています。社内に入れる場合は、この telemetry の扱いを先に決めてください。
エージェントに使わせる場合、公式が案内している AGENTS.md の追記は次の4行です。
When using Bend:
- run `bend guide` to learn it
- use `LAWS.bend` to keep important rules
- run `bend PROOF.bend` before committing
- parallelize the code whenever possible
手順2:最小のプログラムを動かす
公式ガイドの hello world は、IO を返す型付きの def です。
import Base

def main() -> IO(Unit):
  do IO<Unit>:
    IO.print("Hello, world!")
実行と出力の切り替えは1つのコマンドに集約されています。
bend hello.bend            # 検査して main を実行する
bend hello.bend -o hello   # ネイティブの実行ファイルを作る(clang 14以上)
bend hello.bend -o hello.js # JavaScript として出力する
bend hello.bend --check-only # 検査だけ行い、何も実行しない
./hello --threads 8        # 8スレッドで実行する
./hello --gpu off          # GPU 呼び出しを CPU で実行する
--check-only は2026年9月19日の 2.0.17 で追加されたフラグで、ファイルとその import を検査して実行はしません。CI の関門に置くならこちらです。ネイティブへのコンパイルは時間がかかるため、開発を素早く回すには JavaScript 実行を使うよう公式が案内しています。ただし JavaScript 実行は単一コア動作で、CPU・GPU への並列化は行われません。
手順3:law を1つ置いて、検査を失敗させてみる
実際に効果を確かめるいちばん短い道は、証明を書かずに law だけ置くことです。公式ガイドは「law に対応する def がない場合、それは open claim(未証明の主張)として扱われ、bend PROOF.bend は失敗する」と説明しています。また ?TODO を置けば証明を意図的に開いたままにでき、?name はその時点のゴールを表示します。
# LAWS.bend — 人が書く。AI には触らせない
import Base

law add_zero:
  for x: Nat
  {Nat.add(x, 0n) == x : Nat}
# PROOF.bend — AI が書く。law と同じ名前の def で埋める
import LAWS
def Laws.add_zero(x):
?TODOこの状態で bend PROOF.bend を実行すると、law が未証明のままなので検査は通りません。全部埋まったときにだけ「All terms check.」が出る、というのが公式ガイドの説明です。なお公式ガイドは、LAWS.bend の隣に置かれた PROOF.bend がそれを import していない場合、bend 自体がその PROOF.bend を拒否する、とも書いています。law を迂回して「通った」ことにはできないという作りです。
手順4:並列実行の書き方を見る
Bend の並列化はスレッドやカーネルを書かず、再帰呼び出しを分割する形で表現されます。以下は README の例です。
import Base

# 2^d を並列で計算する。d 段の木で、葉が1つずつユニットに載る
def pow2(+d: Nat) -> U32:
  match d:
    case 0n:
      1
    case 1n+p:
      a b = pow2(p) pow2(p)
      (a + b : U32)

# `!` を付けて GPU で実行する
def main() -> IO(Unit):
  result = pow2!(20n)
  IO.print(U32.show(result))
公式ガイドは、分割した処理の所要時間が偏ると効率が落ちるため、各処理の時間をおおむねそろえる必要があると注記しています。README も「Parallelism requires balanced calls」と同じことを書いています。
エージェントの出力に関門を重ねる設計
ここからは Bend を入れる前提を外して、今日の CI に持ち帰れる考え方の話です。Bend の思想を一般化すると「エージェントが自分では書き換えられない合否判定を、出力の手前に置く」に尽きます。判定には強さの階層があり、1つで足りることはありません。
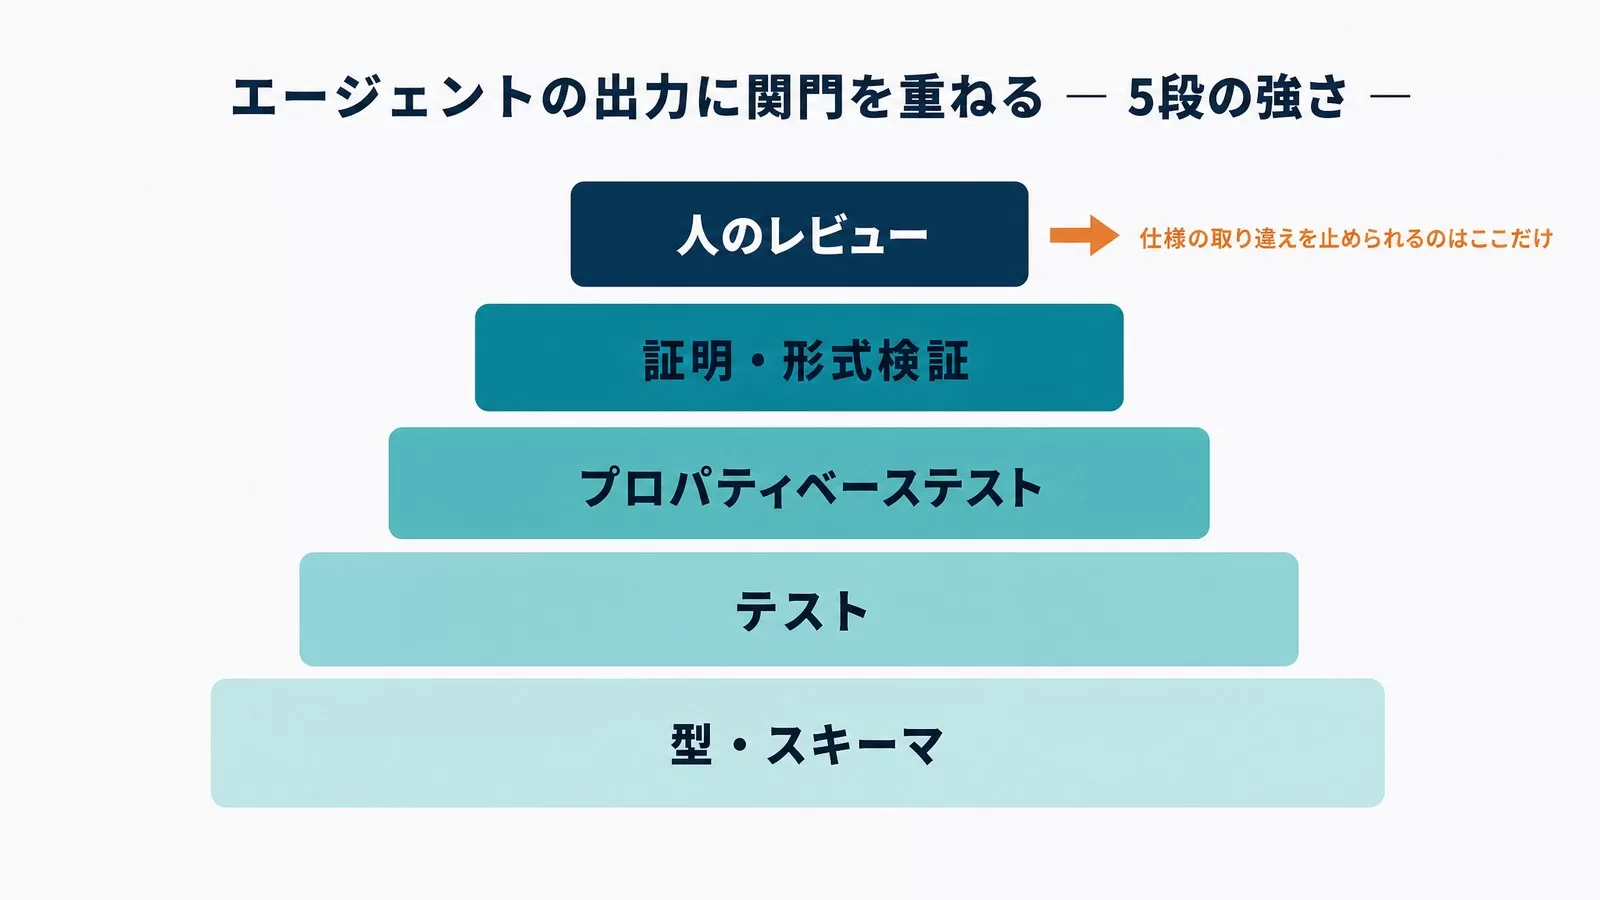
| 関門 | 何を止めるか | 止められないもの |
|---|---|---|
| 型・スキーマ | 形の食い違い、null の混入、引数の取り違え | 形は合っているが意味が違う実装 |
| テスト | 選んだ入力に対する挙動の退行 | テストを書いていない入力での破綻 |
| プロパティベーステスト | 探索範囲で見つかる反例 | 見つからなかったことの証明 |
| 証明・形式検証 | 書いた命題に対する反例の存在そのもの | 書かなかった命題、仕様の取り違え |
| 人のレビュー | 仕様の取り違え、設計の筋の悪さ | 分量。差分が増えると先に尽きる |
この表の要点は、いちばん上の段(人のレビュー)だけが仕様の取り違えを止められるのに、いちばん先に容量が尽きるという非対称です。だから下の4段でできるだけ絞り、人の注意を「仕様が意図どおりか」に集中させる、という配分になります。Bend が狙っているのも正確にここで、批判側が「信頼の問題が仕様へ移っただけ」と言うのも、裏返せば人が見るべき場所が仕様に絞られたということです。
実務に落とすと、明日からでもできる形は3つあります。
- エージェントが触れないファイルを決める:仕様・不変条件・禁止事項を1ファイルに集め、エージェントの書き込み対象から外す。Bend の
LAWS.bendとPROOF.bendの分離がそのまま参考になります。 - コミット前に走る機械判定を1本足す:型検査でもリンタでも構いません。重要なのはエージェント自身が結果を書き換えられないことと、失敗理由がエージェントに読める形で返ることです。Bend が「検査は1秒未満」にこだわるのも、エージェントのループに入る速度でなければ関門として機能しないからです。
- 守りたい性質を自然言語ではなく実行可能な形で書く:いきなり証明に行かなくても、プロパティベーステストなら今日の言語で書けます。「この関数の出力は常に昇順」「残高の合計は常にゼロ」といった性質は、書いた時点で価値が出ます。
コードレビューをエージェントに任せる場合も同じで、AI レビューは「人の目の代わり」ではなく関門の1段として数えるのが実態に近い扱いです。エージェントのテストと評価の設計は pytest と Deepeval の比較記事にまとめています。AI が数学の証明を扱う話題としては、OpenAI Astra の経緯も参考になります。
【要注意】Bend 2で踏みやすい失敗パターン4つ
公式の記載と公開後の議論から、判断を誤りやすい点を4つ挙げます。
失敗1:law が1つで足りると思う
❌ 「勝てない」だけを law に書き、AI に自由に改修させる。
⭕ 守りたい性質を列挙してから law にする。公式デモの壁を外させた報告では、AI が移動を斜めだけにするという解に到達し、law は保ったままゲームの性質が変わりました。law が少ないほど、AI は文言を満たして趣旨を外す解に流れます。
失敗2:「All terms check.」を「バグがない」と読む
❌ 検査が通ったので安全だと判断する。
⭕ 通ったのは「書いた law については破れない」まで。gihyo.jp も「アプリに必要な条件が漏れなく記述されていることまで保証するものではない」と書いています。さらに表示が「All terms check, with N unsafe annotations.」になっている場合、@unsafe を経由する def は停止性の検査から外れています。N がゼロかどうかを見てください。
失敗3:Bend 1 の資産が引き継げると思う
❌ 以前の Bend や HVM のコードをそのまま移す。
⭕ README は「Bend 1 programs and HVM do not carry over」と明記しています。Bend 2 は実行方式を変えており、gihyo.jp によれば HVM2 の基礎だった相互作用ネットを実行時に使いません。移行ではなく新規に書き直す前提で見積もってください。
失敗4:標準ライブラリが揃っている前提で見積もる
❌ ソートや順序の性質は最初から証明済みだろうと仮定する。
⭕ README は「Base is small: expect to write helpers other languages ship built in」と書いています。Hacker News には、実際に小さなジョブを移植した報告として、証明163行のうち約60行が「あると思っていた基本的な補題」で埋まった、標準の List.sort には整列済みであることの law が付いてこないため「出力の区間が重ならない」という law を書くにはマージソートの正しさから証明する必要があった、という投稿がありました。「原理的に証明できる」と「今日の午後に証明できる」の距離がここに出ます。
よくある質問
Bend 2 は今すぐ業務に使えますか
2026年9月20日時点では実験段階として扱うのが妥当です。README が「BEND IS YOUNG. EXPECT BUGS」と書き、コンパイラの99%が AI 製で完全な監査を受けていないこと、Lean による形式化と実装に食い違いがあり誤った証明を受け入れる不具合があり得ることを、公式自身が明記しています。デバッガ・プロファイラ・REPL・テストフレームワークも現時点ではありません。
バイブコーディングの品質問題は Bend で解決しますか
解決するのは「書いた条件が破られていないか」の部分だけです。条件を書き漏らせばそこは守られません。批判側が繰り返し指摘しているのは、信頼の問題がコードから仕様へ移るだけで消えはしない、という点です。むしろ何を守りたいのかを人間が言語化する作業が主戦場になります。
Lean や Dafny ではなく Bend を選ぶ理由はありますか
公式が挙げている差別化は、検査の速さと、GPU を含む実行性能、そして Python 風の構文です。一方で Hacker News では、Bend が推論も型クラスもタクティクも持たないため検査が軽いのであって、速度比較は同じ土俵ではないという指摘が出ています。既に Lean や Dafny の運用がある組織が乗り換える材料は、現時点では見当たりません。
SPARK で十分という批判は妥当ですか
用途によります。批判記事は同じデモを SPARK で書き、GNATprove が自動で12件の検査を証明したと報告しています。証明を道具に解かせる系統が既に実用段階にあるのは事実です。一方で、Bend は依存型の系統で、数学の形式化に耐える表現力を志向しており、両者は前提の違うトレードオフだという反論も出ています。自動で解ける範囲の性質なら SPARK 系、表現力が要るなら依存型系、という切り分けが現実的です。
Windows で使えますか
公式は Linux と macOS を対応環境としており、Windows には直接対応していません。WSL 経由で利用できると gihyo.jp が説明しています。GPU 実行には Linux で CUDA 12、macOS で Metal が必要です。ネイティブのバイナリには clang 14以上、! を使う場合は clang 19以上が要るとも README に書かれています。
まとめ:今日から始める3つのアクション
- 今日やること:自分のリポジトリで、エージェントが書き換えられない合否判定がいくつあるか数える。ゼロなら、型検査かリンタを1本、コミット前に固定するところから始める。
- 今週中:守りたい性質を3つだけ自然言語で書き出し、そのうち実行可能な形(プロパティベーステスト・スキーマ・アサーション)にできるものを1つ選んで書く。Bend の law がやっていることの、いちばん安い入口です。
- 今月中:形式検証の系統を1つ調べる。自動証明が効く範囲の性質が多いなら SPARK や Dafny、表現力が要るなら Lean。Bend 2 はCHANGELOGを見るかぎり公開から数日で20回近くリリースが出ており、動きが速い段階です。判断はもう少し落ち着いてからで構いません。
Bend 2 をめぐる論争でいちばん有益なのは、実は言語の優劣ではありません。「AI が書いたコードを、人が読まずに受け入れてよい条件は何か」という問いが、初めて具体的な形で議論の俎上に載ったことです。その答えが証明であれ、自動検証であれ、丁寧なテストであれ、問いを持って CI を見直すこと自体が今日から効きます。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Bend 公式サイト — bend-lang.com(参照日: 2026-09-20)
- bendlang/bend リポジトリ(README・Limitations) — GitHub(参照日: 2026-09-20)
- Bend CHANGELOG(2.0.0〜2.0.20) — GitHub(参照日: 2026-09-20)
- Bend 言語ガイド(GUIDE.md) — GitHub(参照日: 2026-09-20)
- GPU上で動く高級言語「Bend 2」公開 ——AIが書くコードを数学的な証明で検証 — gihyo.jp(2026-09-18・参照日: 2026-09-20)
- Bend 2 and the Vibe-Coding Trap — Liam Powell’s Blog(2026-09-18・参照日: 2026-09-20)
- Bend – a language that blocks AI mistakes via proof and runs on GPUs — Hacker News(参照日: 2026-09-20)
- Why the benchmarks of Bend’s 2 typechecker are misleading — GitHub Gist(参照日: 2026-09-20)
- The Dafny Programming and Verification Language — dafny.org(参照日: 2026-09-20)
- Lean 公式サイト — lean-lang.org(参照日: 2026-09-20)
- SPARK User’s Guide — Getting Started with SPARK — AdaCore(参照日: 2026-09-20)
著者:佐藤傑(さとう・すぐる)。株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。著書『AIエージェント仕事術』。100社以上の企業向けAI研修・導入支援を手がけています。ご質問・ご相談はお問い合わせフォームからどうぞ。