Alibaba の Qwen チームが2026年9月18日に公開した Qwen3.8-Omni-Flash は、100万トークンの文脈を持つオムニモーダルモデルで、公式料金表の単価はシンガポール拠点で入力 $0.15/出力 $0.47(100万トークンあたり・USD)。音声もテキストも動画も同じ入力単価という料金設計になったため、公式の換算式(音声は秒数×7トークン)で計算すると1時間の音声を丸ごと入れても約 $0.0038です。前世代 qwen3.5-omni-plus の音声入力 $11 で同じ1時間を計算すると $0.2772 なので、Qwen が言う「音声入力の1時間あたり98%以上の値下げ」は公式レートカード上でも98.6%減として再現できます。
この記事は、Qwen 公式ブログ、Alibaba Cloud Model Studio の Qwen-Omni ドキュメントと料金表、Qwen-MM-Plugins のリポジトリ、Gemini API の料金表とトークン換算ドキュメントを2026年9月19日に直接読み、公式に書かれている範囲だけで整理したものです。筆者は API を叩いていないので、出力例や体感の速さは書きません。公式に記載が見つからなかった項目は「未確認」と明記します。
2026年9月19日時点の結論|どこが動いたのか
開発者として押さえるべき変化は3つです。
- モダリティ別の単価が消えた。3.5世代までは「テキスト/画像/動画」と「音声」で入力単価が分かれ、音声が約7.9倍高い設計でした。qwen3.8-omni-flash の料金表にはその区分がなく、入力は一本の単価です。
- 文脈が100万トークンになった。音声は秒数×7トークンなので、API 上限の3時間(75,600トークン)を入れても文脈の約7.6%しか使いません。長さより先に API 側の時間上限に当たります。
- 出力はテキストだけ。喋らせる用途は別モデル(Qwen3.5-Omni 系)か、同時発表の Qwen3.8-Omni-Flash-Realtime の担当です。ただし後者は2026年9月19日時点で公式料金表にもリアルタイム API ドキュメントにも載っていません。
つまり「安くなった音声理解のエンジン」であって、「安くなった音声対話アシスタント」ではありません。ここを取り違えると設計を丸ごと間違えます。
何が出たか|3つの発表と確認できた事実
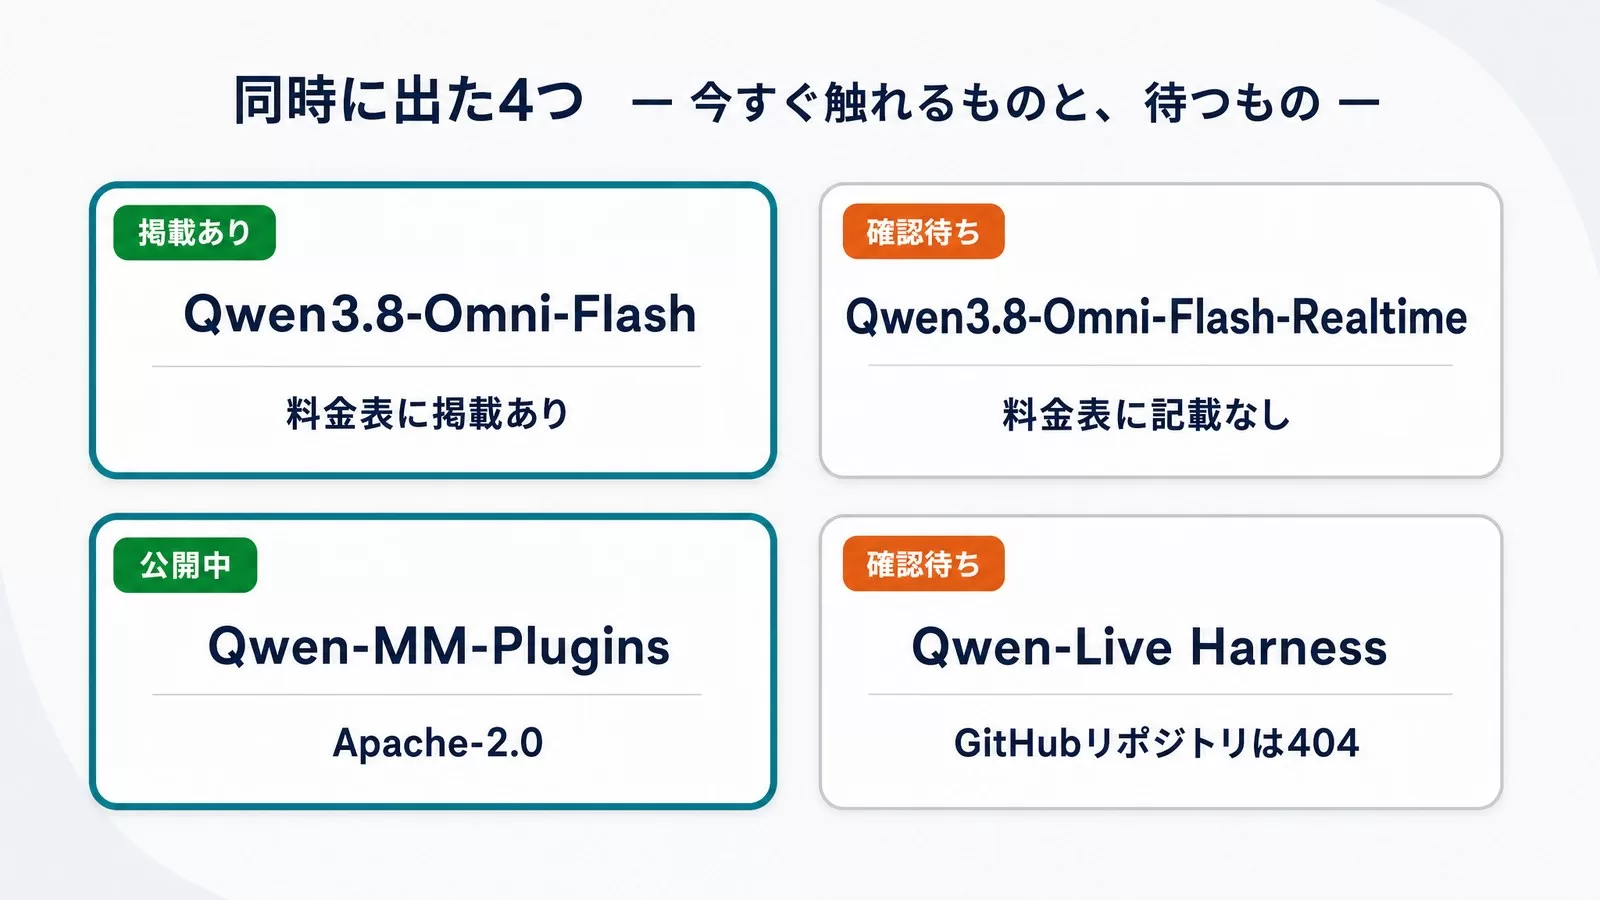
公式ブログが同時に告知したのは、モデル本体・プラグイン群・リアルタイム用のハーネスです。それぞれ「今この瞬間に触れるか」を実際に確かめた結果が次の表です。
| 名前 | 正体 | 2026年9月19日時点の状態 |
|---|---|---|
| Qwen3.8-Omni-Flash | モデル本体(モデルID qwen3.8-omni-flash) |
Model Studio のドキュメント・料金表に掲載あり。6リージョンで提供 |
| Qwen3.8-Omni-Flash-Realtime | WebSocket/WebRTC のリアルタイム版 | 公式ブログにサンプルコードあり。リアルタイム API ドキュメント(最終更新 2026年9月16日)と料金表には記載なし=単価が確認できない |
| Qwen-MM-Plugins | エージェントハーネスを多モーダル対応にする Skill/MCP 群 | GitHub で公開中・Apache-2.0。筆者確認時点のスターは2,908 |
| Qwen-Live Harness | リアルタイム版向けのランタイム | npm パッケージ qwen-live-harness は 0.4.2 が公開済み。ただし公式ブログがリンクする GitHub リポジトリは 404 を返す |
モデル本体のスペックは Model Studio のドキュメントに明記されています。入力はテキスト・画像・音声・動画、出力はテキスト、対応 API は Chat Completions と Responses。文脈長は100万トークン。音声入力は113言語・方言に対応(Qwen3.5-Omni と同じ)。Function Calling と web search に対応し、Responses の組み込みツールは現時点で web_search のみです。
入力の上限も具体的に書かれています。音声は最長3時間、動画は最長2時間、公開 URL 経由ならファイルサイズは2GB まで、Base64 なら10MB 未満。音声形式は AMR・WAV・3GP・3GPP・AAC・MP3、動画形式は MP4・AVI・MKV・MOV・FLV・WMV。そして動画に含まれる映像と音声は別々に課金されると明記されています。この一文が後のコスト計算で効いてきます。
単価と文脈長の意味|1時間の音声はいくらになるか
Model Studio の料金表(2026年9月19日参照)に載っている qwen3.8-omni-flash の単価は次のとおりです。100万トークンあたり、通貨は USD。
| リージョン | 入力 | キャッシュヒット入力 | 出力 |
|---|---|---|---|
| シンガポール(International) | $0.15 | $0.016 | $0.47 |
| 中国(北京)/香港/日本(東京)/フランクフルト/バージニア | $0.113 | $0.014 | $0.382 |
前世代と並べると、料金表の構造そのものが変わったことが分かります。以下は同じ料金表のシンガポール欄からの引用です。
| モデル | テキスト/画像/動画の入力 | 音声の入力 | テキスト出力 |
|---|---|---|---|
| qwen3.8-omni-flash | $0.15(モダリティ別の区分なし) | $0.47 | |
| qwen3.5-omni-plus | $1.4 | $11 | $8.3 |
| qwen3.5-omni-flash | $0.4 | $3 | $2.2 |
ここに公式のトークン換算式を掛けます。Model Studio のドキュメントは、Qwen3.8-Omni-Flash と Qwen3.5-Omni 系の入力音声をどちらも「合計トークン=音声の秒数×7」と定義しています。同じ式なので、世代間の比較が成立します。
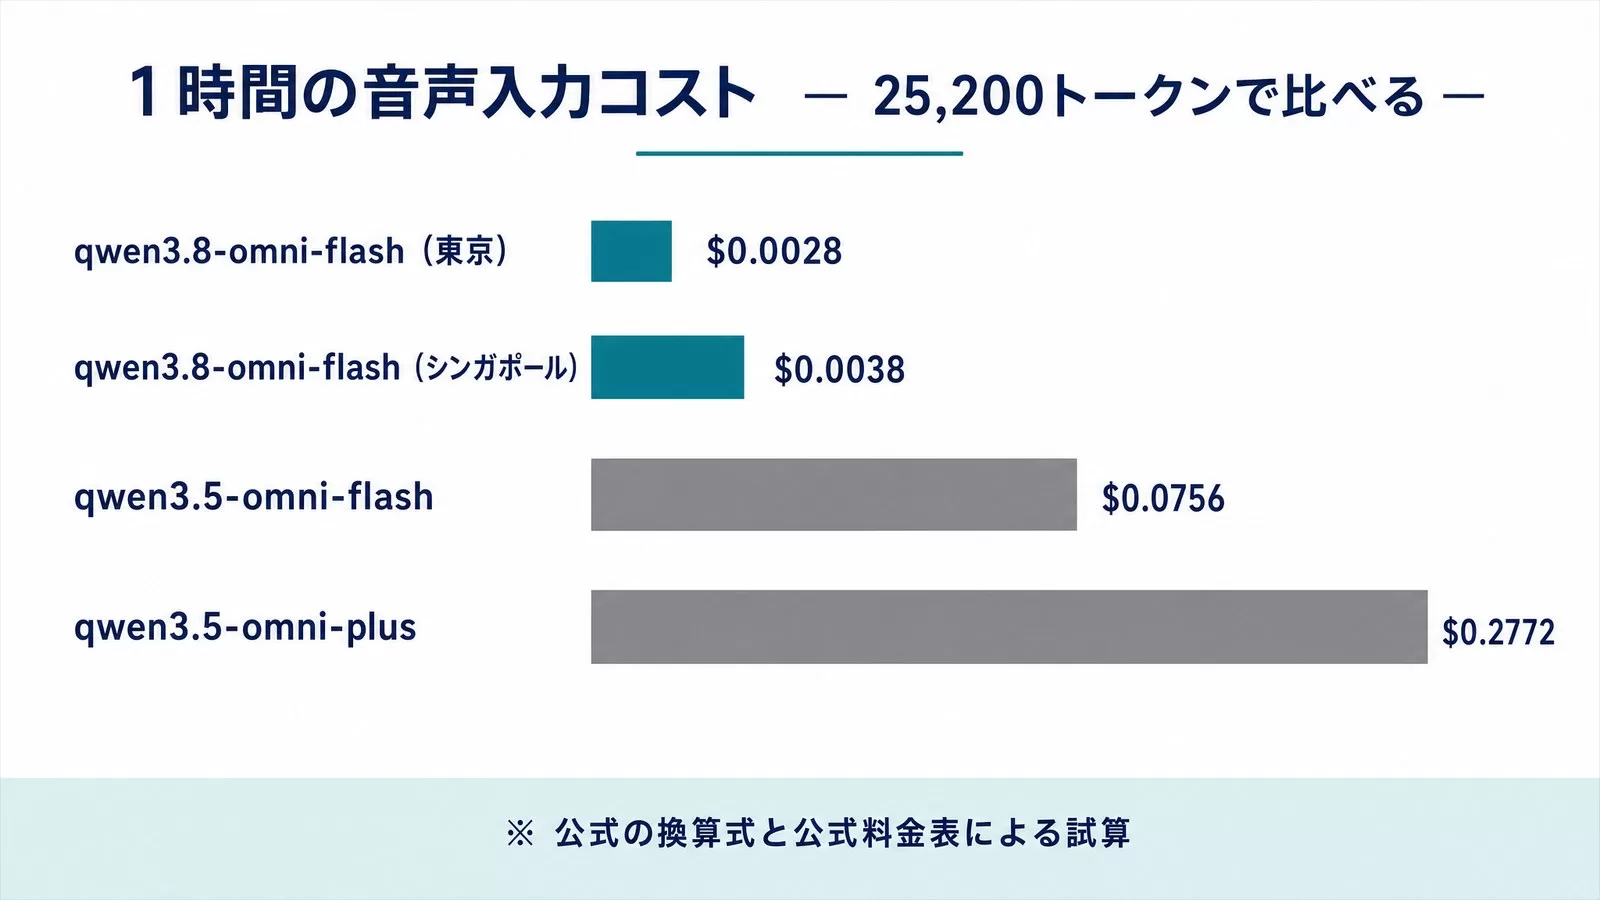
1時間の音声=3,600秒×7=25,200トークン。これに各単価を掛けた試算(公式の換算式と公式料金表を掛けただけの計算で、実測値ではありません)が次の表です。
| モデル・リージョン | 1時間の音声入力トークン | 入力コスト(試算) |
|---|---|---|
| qwen3.8-omni-flash(シンガポール) | 25,200 | $0.0038 |
| qwen3.8-omni-flash(東京) | 25,200 | $0.0028 |
| qwen3.5-omni-flash(シンガポール) | 25,200 | $0.0756 |
| qwen3.5-omni-plus(シンガポール) | 25,200 | $0.2772 |
qwen3.5-omni-plus 比で98.6%減、qwen3.5-omni-flash 比で95%減。公式ブログの「1時間あたりの音声入力価格が98%以上下がった」という表現は、レートカードから素直に再現できます。なお公式ブログは価格比較の方法を脚注で明示しており、「2分の素材の入力コストを30倍して1時間として推定、映像は720p・1fps、為替は1USD=6.7191CNY」と書いています。筆者の試算とは前提が違うので、数字が完全に一致しない点は理解しておいてください。
映像を入れると支配項が変わる
動画は映像と音声が別課金です。Model Studio のドキュメントは映像トークンの見積もりコードを公開していて、既定値は「サンプリング2fps・1フレームあたり最大640トークン・抽出フレーム数は最大2,048枚・映像全体のピクセル上限あり」となっています。この公式コードに1280×720/30fps の動画を入れて計算すると次のようになります(試算・パラメータを変えれば結果も変わります)。
| 動画の長さ | 抽出フレーム | 映像トークン | 音声トークン | 合計の入力コスト(シンガポール・試算) |
|---|---|---|---|---|
| 10分 | 1,200(2.0fps 相当) | 約165,600 | 4,200 | 約 $0.026 |
| 60分 | 2,048(0.57fps 相当) | 約156,700 | 25,200 | 約 $0.027 |
| 120分 | 2,048(0.28fps 相当) | 約156,700 | 50,400 | 約 $0.031 |
読み取るべき点は2つあります。第一に、映像トークンが音声トークンの6倍前後を占めること。安くなったのは音声の話で、映像を足した瞬間にコストの重心は映像へ移ります。第二に、抽出フレームが2,048枚で頭打ちになること。60分でも120分でも映像トークンはほぼ同じで、代わりにサンプリング間隔が粗くなります。長尺動画で一瞬の出来事を捉えたいなら、丸ごと投げるのではなく先に区間を絞る設計が要ります。
100万トークンの文脈をどう使うか
音声が秒数×7で済むことは、文脈設計にも効きます。API 上限いっぱいの3時間の音声は75,600トークンで、100万トークンの約7.6%。1時間の会議なら25,200トークンで約2.5%です。「会議1本を丸ごと入れて、そのうえで過去の議事録や仕様書も一緒に渡す」という使い方が、文脈の枯渇を気にせず成立します。
公式ブログは、この長尺理解をさらに効率化する方向も示しています。OmniVideoBench での比較では、モデルに全部を読ませる Static Understanding が正解率63.4・クエリあたり145,736トークンだったのに対し、質問から出発して見る箇所を自分で決める Agentic Understanding は正解率67.8・79,117トークンで、トークン消費が約45.7%減りながら精度が上がったと報告されています。長尺を全部読ませるのが常に最適ではない、というのは実装方針に直結する話です。
なお、暗黙キャッシュ(implicit caching)に対応しており、Responses ではセッションキャッシュも使えます。キャッシュヒット時の入力単価はシンガポールで $0.016=通常入力の約9分の1です。同じ音声に対して何度も質問を投げる設計なら、ここが効きます。
Qwen-MM-PluginsとQwen-Live Harnessの現在地
モデルと同時に出たツール2つは、性格がはっきり違います。
Qwen-MM-Plugins は「任意のエージェントハーネスをマルチモーダルネイティブにする」という位置づけのリポジトリで、Apache-2.0 で公開されています。各機能は Skill と任意の MCP サーバの組み合わせとして個別にインストールする方式。ガイド付きインストーラが対応するハーネスとして、公式 README は Claude Code・CodeBuddy・Codex・Qoder・OpenClaw・Qwen Code・Gemini CLI を挙げています。Omni 系モデル向けに用意されているのは次の4つです。
omni-memory:長尺動画の音声つき視聴覚メモリを作る(誰がいて、誰が何を、どう言ったか)omni-video2note:ローカルのチュートリアル動画を図入り PDF ノートへ変換するomni-skill-creator:デモンストレーション動画を再利用可能な Agent Skill に変えるomni-chatcut:Music-to-MV、映画解説、話者の声を保ったまま翻訳する動画制作の Skill 集
いずれも DashScope の API キーと ffmpeg が前提です。そして README には見逃せない注記があります。「ほとんどのハーネスは、まだメインモデルへ音声をネイティブに渡せない。当面、音声は API 経由で扱う」。つまりコーディングエージェントの中で音声を直接扱えるようになったわけではなく、プラグインが API を呼ぶ構成です。ハーネス側の対応を待つ部分が残っています。
Qwen-Live Harness のほうは、公式ブログが「Qwen3.8-Omni-Flash-Realtime API を中心に設計した包括的なオープンソースのハーネス」と説明し、タスク委譲・能動的な発話・長期記憶・文脈管理に対応すると書いています。インストールはブログ記載のとおり3行です。
npm install -g qwen-live-harness
qwen-live-harness init
qwen-live-harness
ただし現状には注意が要ります。npm レジストリ上のパッケージ qwen-live-harness は最新版 0.4.2(2026年9月15日更新)として実在しますが、公式ブログがリンクしている GitHub リポジトリ QwenLM/Qwen-Live-Harness は2026年9月19日時点で 404 を返します。国内報道でも公開当日に 404 だったことが指摘されています。ソースを読んでから採用を判断したいチームは、リポジトリが公開されるまで待つのが無難です。
Gemini 3.8 Flash・3.8 Liveとの使い分け
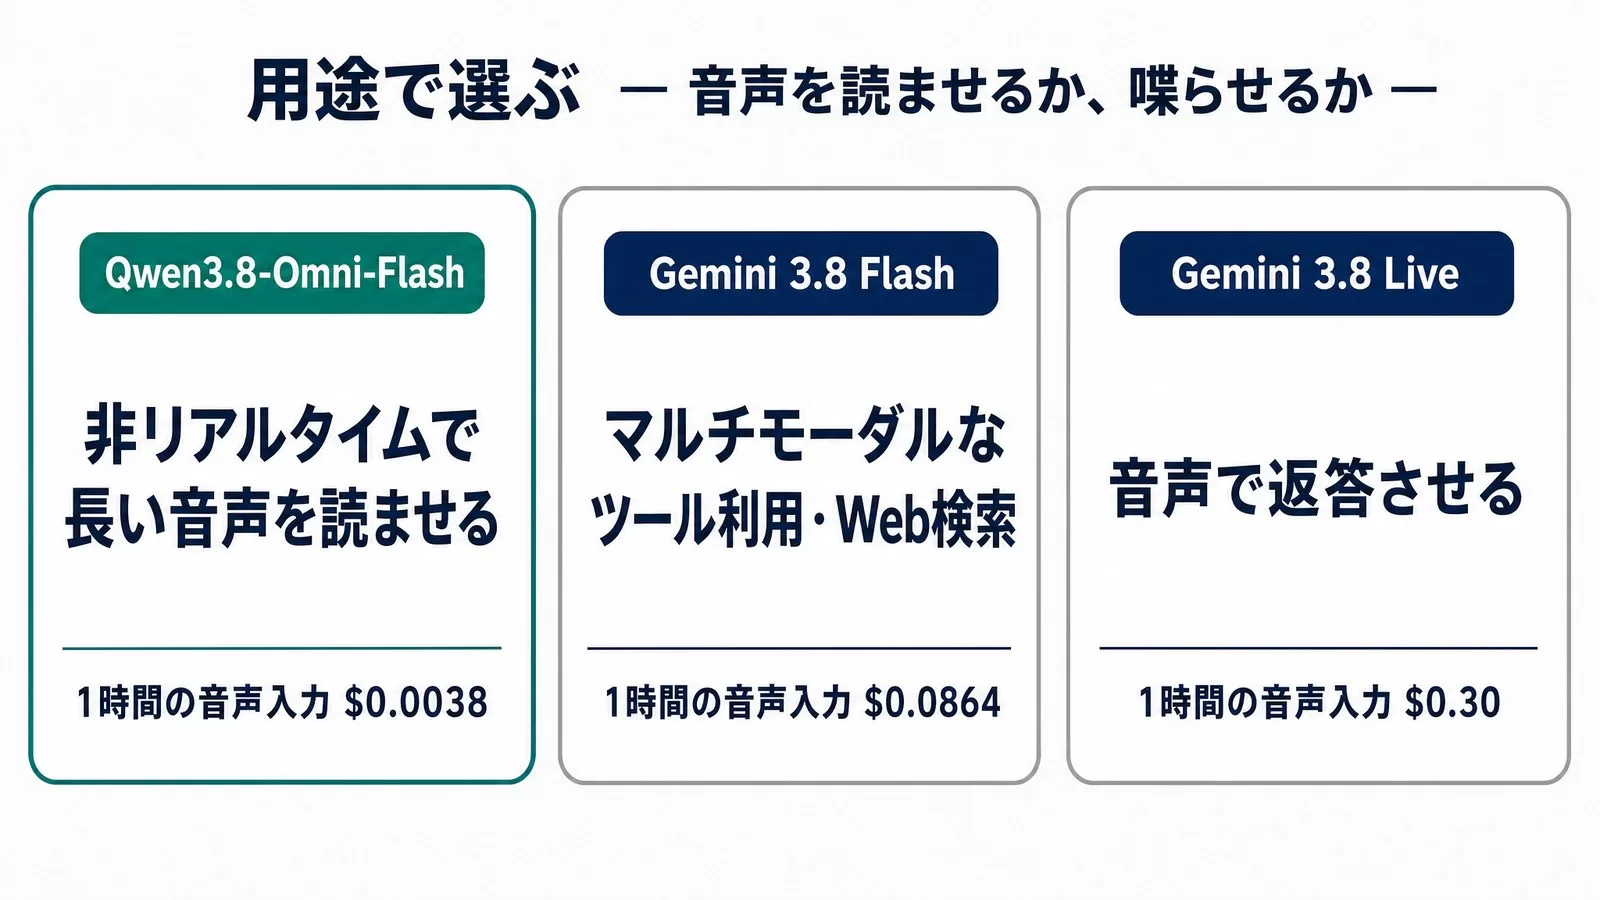
比較対象として公式ブログが名指ししているのは Gemini 3.8 Flash です。ここでは料金と性能を、両社の公式資料に書いてある値だけで並べます。Gemini 側の音声トークン換算は公式ドキュメントに「音声は1秒あたり32トークン」と明記されているので、同じ1時間の音声で比較できます。
| 項目 | Qwen3.8-Omni-Flash | Gemini 3.8 Flash | Gemini 3.8 Live |
|---|---|---|---|
| 入力 | テキスト・画像・音声・動画 | テキスト・画像・音声・動画 | テキスト・画像・音声・動画 |
| 出力 | テキストのみ | テキスト | テキストと音声 |
| 入力単価(100万トークン) | $0.15(シンガポール)/$0.113(東京ほか) | $0.75(2026年12月31日まで。2027年1月1日から $1.50) | テキスト $0.75/音声 $3.00/画像・動画 $1.00 |
| 出力単価(100万トークン) | $0.47(シンガポール) | $3.75(2026年12月31日まで) | テキスト $4.50/音声 $12.00 |
| 音声1秒あたりのトークン | 7 | 32 | 公式料金表は分単位を併記(音声入力 $0.005/分) |
| 1時間の音声入力コスト(試算) | $0.0038 | $0.0864 | $0.30 |
| リアルタイム対話 | 別モデル(Realtime 版・料金未掲載) | 非対応 | 対応(WebSocket ベースの Live API) |
非リアルタイムの「音声を読ませる」用途に限れば、1時間あたりの入力コストは Qwen が Gemini 3.8 Flash の約23分の1です。差の内訳は単価だけではありません。1秒あたりのトークンが7対32なので、同じ100万トークンの文脈に入る音声の量も約4.6倍違います。
Gemini が勝っている観点を先に書く
ただし、全部の観点で Qwen が勝っているわけではありません。公式ブログのベンチマーク表から、Gemini 3.8 Flash が上回っている項目を先に挙げます。
- AgenticVBench(マルチモーダルなツール利用):Gemini 45.0 に対し Qwen 36.8
- OmniGAIA(Web 検索):Gemini 78.6 に対し Qwen 74.0
- OmniVideoBench(Static):Gemini 65.2 に対し Qwen 63.4
- Video-MME-v2:Gemini 71.0 に対し Qwen 65.0
- LongAudioSpan の Chain 指標:Gemini 64.6 に対し Qwen 48.2
- VoiceBench:Gemini 92.3 に対し Qwen 91.6(前世代 Qwen3.5-Omni-Plus の92.9も上回れていない)
逆に Qwen が明確に上回っているのは、エージェント的なツール利用の一部(WildClawBench-MM 71.0 対 58.9、UniClawBench 69.6 対 69.0)、ストリーミング理解(StreamingBench 80.8 対 79.9)、そして複数話者の会議です。AliMeeting の話者分離誤り率/話者つき単語誤り率は Gemini 3.8 Flash の72.6/53.1に対し Qwen は3.4/17.2。前世代 Qwen3.5-Omni-Plus の88.1/89.6からの改善幅も含めて、ここが今回いちばん変わった部分です。
もう1つ正直に書いておくべき点があります。多言語の素の音声認識は前世代より悪化しています。FLEURS の ASR 単語誤り率は Qwen3.5-Omni-Plus の7.2に対し Qwen3.8-Omni-Flash は9.3、音声翻訳の BLEU も32.2に対し31.8です。「会議の議事録と話者特定」が主目的なら大幅に改善、「多言語の文字起こし精度」が主目的なら乗り換え前に比較が必要、という読み方になります。エージェント全体の設計思想はマルチモーダルAIエージェント実装ガイド、Gemini 側の料金と非同期 function calling の詳細はGemini 3.8 Live の記事で個別に扱っています。
実装の勘所|公式docsに書かれた設定だけ
ここから先は、Qwen 公式ブログと Model Studio ドキュメントに載っている呼び出し方だけを引きます。筆者が API を叩いて確認したわけではないので、実行結果は各自の環境で確かめてください。
1. OpenAI 互換の Chat Completions で音声を渡す
DashScope は OpenAI 互換モードを提供しており、公式ドキュメントのクイックスタートは音声 URL をそのまま input_audio で渡す形です。API キーはリージョンごとに別物で、ベース URL も分かれます。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url=os.environ["DASHSCOPE_BASE_URL"],
)
completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "Summarize the main points of this recording."},
            {"type": "input_audio", "input_audio": {
                "data": os.environ["AUDIO_URL"],
                "format": "wav",
            }},
        ],
    }],
    stream=True,
    stream_options={"include_usage": True},
)
ベース URL は北京が https://dashscope.aliyuncs.com/compatible-mode/v1、シンガポールが https://dashscope-intl.aliyuncs.com/compatible-mode/v1 と公式ブログに明記されています。
2. 推論の深さでコストを調整する
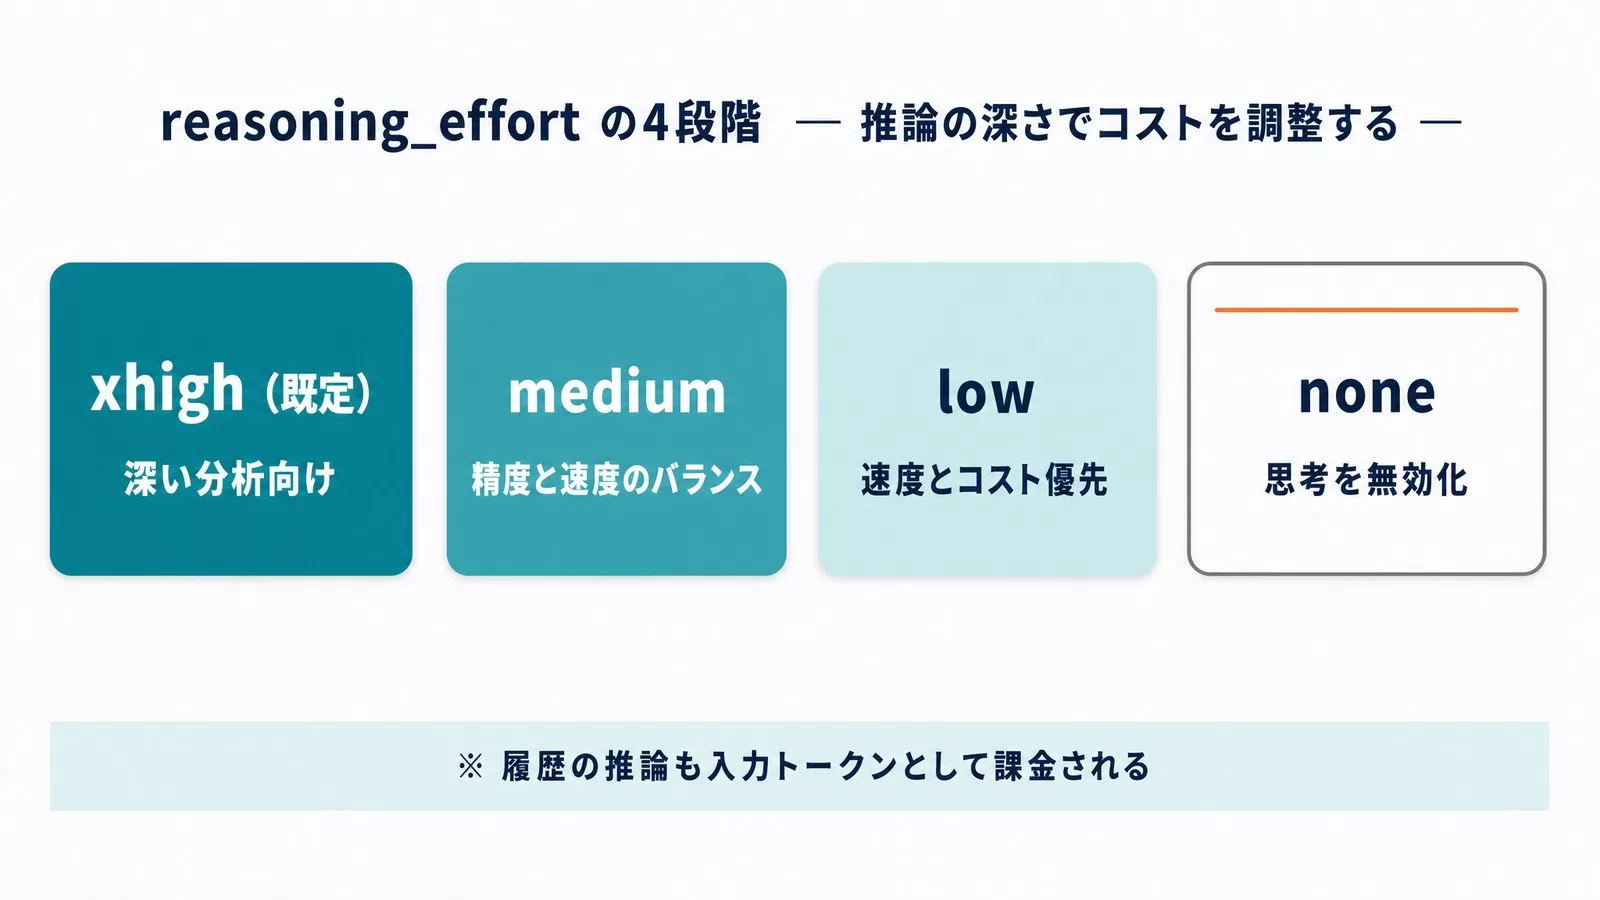
公式ブログは reasoning_effort の対応を明記しています。xhigh が既定で深い分析向け、medium が精度と速度のバランス、low が速度とコスト優先。さらに Model Studio の web 検索サンプルでは reasoning_effort="none" を渡して思考そのものを無効化しています。公式資料に出てくる値を合わせると xhigh・medium・low・none の4つです。
completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=messages,
    extra_body={"enable_thinking": True},
    reasoning_effort="xhigh",   # xhigh / medium / low
    stream=True,
)
マルチターンでは preserve_thinking が既定で有効です。公式ドキュメントは「直前の回答と推論を、履歴の assistant メッセージの content と reasoning_content にそれぞれ入れて次のリクエストに含める」と指示しており、渡した履歴の推論は入力トークンとして課金対象になるとも書いています。長い会話ほどここが効きます。
3. 空間音声とWeb検索を有効化する
qwen3.8-omni-flash は2チャンネルのステレオと4チャンネルの FOA 空間音声(WYZX のチャンネル順)に対応します。既定は false=すべてモノラル扱いなので、空間情報を使いたい場合は明示します。Web 検索は Chat Completions 側では enable_search と search_options の組み合わせです。
# 空間音声(ステレオ / 4ch FOA)を解釈させる
extra_body={"use_multichannel": True}

# Web 検索を有効化し、思考を切ってテキストだけ受け取る
completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=messages,
    extra_body={
        "enable_search": True,
        "search_options": {"search_strategy": "agent"},
    },
    reasoning_effort="none",
    stream=True,
)画像を扱う場合は、32×32ピクセルで1トークン、1枚あたり最低24トークン、既定の上限は1,280トークンで、vl_high_resolution_images を立てると上限が16,384トークンまで上がります。細かい文字を読ませたいときだけ立てる類のスイッチです。
注意点|規約・リージョン・未検証の範囲
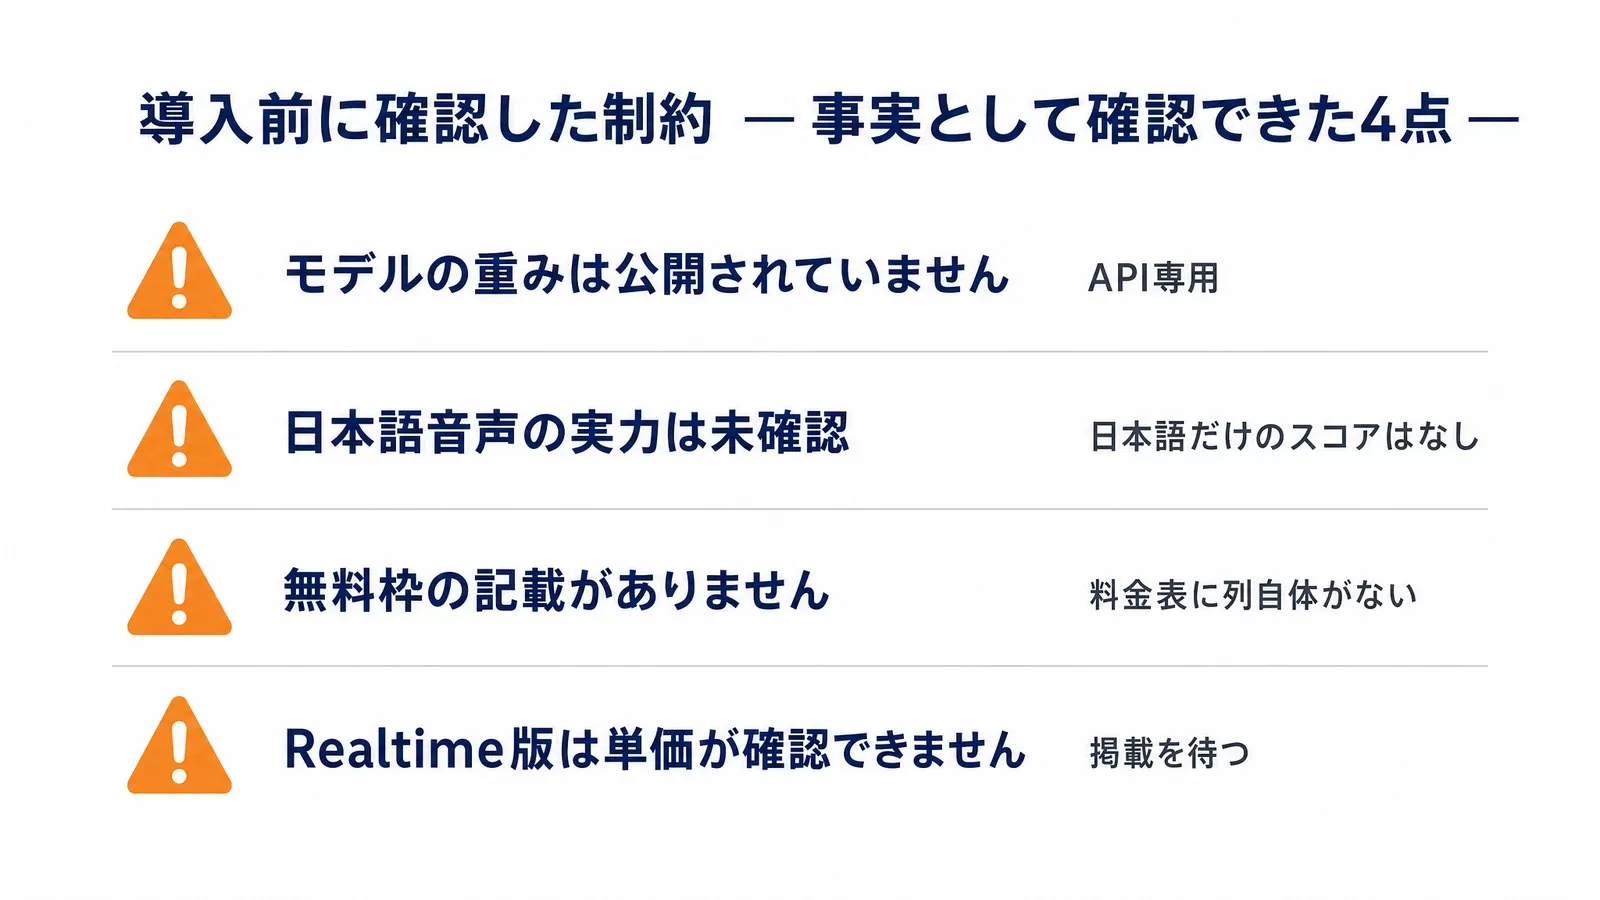
導入判断の前に、事実として確認できた制約を並べます。
- 提供リージョンは6つ。公式ドキュメントはシンガポール・中国(北京)・中国(香港)・日本(東京)・ドイツ(フランクフルト)・米国(バージニア)を挙げ、「選んだリージョンの API キーを使うこと」と明記しています。東京リージョンが選べる点と、単価が $0.113 とシンガポールより安い点は、国内案件では効きます。データの取り扱い条件そのものは Model Studio の規約側の話なので、この記事では踏み込みません(未確認)。
- モデルの重みは公開されていません。2026年9月19日時点で Hugging Face の Qwen 公式アカウントに Qwen3.8-Omni-Flash の重みはなく、Omni 系で公式公開されているのは Qwen3-Omni-30B-A3B 系と Qwen2.5-Omni 系までです。ローカル実行や自前ホストを前提にした計画は立てられません。同じ 3.8 世代でも自前運用の可否はモデルごとに違うので、Qwen3.8-Max の自前運用に関する記事の判断軸も合わせて確認してください。
- 日本語音声の実力は単独では公表されていません。音声入力が113言語・方言に対応していること、評価に使われた FLEURS の60言語に日本語が含まれることは公式に書かれていますが、日本語だけのスコアはありません。日本語の会議音声で使うなら、自前の評価セットで測るところからです。
- 無料枠の記載がありません。料金表で無料枠が併記されているのは Qwen3.5-Omni 系などで、しかもシンガポール限定という注記付きです。qwen3.8-omni-flash の行には無料枠の列自体がありません。
- Realtime 版は単価が確認できません。前述のとおり、リアルタイム API のドキュメントにも料金表にも qwen3.8-omni-flash-realtime の記載がありません。リアルタイム音声エージェントのコスト試算は、掲載を待つ必要があります。
つまずきやすい4パターン
ここまでの事実から、設計段階で踏みやすい落とし穴を整理します。
❌ 音声で返答させる前提で qwen3.8-omni-flash を選ぶ
⭕ 出力はテキストのみと公式に明記されています。音声出力が要るなら Qwen3.5-Omni 系(音声出力と音声クローンに対応)か Realtime 版。ただし Realtime 版は単価未掲載なので、費用を確定させたい案件では Qwen3.5-Omni 系か 他社の音声エージェントと並べて検討することになります。
❌ 「音声が98%安い」を動画パイプライン全体に当てはめる
⭕ 動画は映像と音声が別課金で、試算では60分の720p 動画の映像トークンが約156,700に対し音声は25,200。安くなったのは音声側で、映像を入れた瞬間に重心が移ります。まず音声だけで要件を満たせるか試すのが順番として正しいです。
❌ シンガポールで取った API キーを東京エンドポイントで使う
⭕ 公式ドキュメントは「リージョンごとに API キーが異なる」と繰り返し書いています。単価も $0.15 と $0.113 で違い、ベース URL も別。コスト試算とキー管理をリージョン単位で揃えてください。
❌ 既定の reasoning_effort のまま長尺を流し続ける
⭕ 既定は最も深い xhigh です。加えてマルチターンでは履歴の推論トークンも入力に乗ります。バッチ的な要約用途なら low、検索を挟む定型処理なら公式サンプルのように none という選択肢もあります。キャッシュヒット単価が通常入力の約9分の1である点も合わせて設計してください。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
よくある質問
Qwen3.8-Omni-Flash の API は無料で使えますか?
公式料金表の qwen3.8-omni-flash の行には、無料枠の列そのものがありません。無料枠が併記されているのは Qwen3.5-Omni 系や Qwen3-Omni 系などで、注記には「シンガポールのみ・Model Studio の有効化またはモデル公開から90日間有効」とあります。新規ユーザー向けの無料枠の扱いは Model Studio のドキュメント側で確認してください。
コンテキスト長はどれくらいですか?
100万トークンです。音声の換算式が「秒数×7」なので、API の音声入力上限である3時間を丸ごと入れても75,600トークン、文脈の約7.6%にとどまります。実務では文脈長より、音声3時間・動画2時間という API 側の時間上限に先に当たります。
日本語に対応していますか?
音声入力は113言語・方言に対応していると公式ドキュメントに明記されています。ベンチマークに使われた FLEURS の60言語にも日本語が含まれます。ただし日本語だけの精度を示すスコアは公開されていないため、日本語音声での実力は未確認です。多言語の素の音声認識は FLEURS の単語誤り率が前世代の7.2から9.3へ悪化している点も、評価の前提として押さえておいてください。
モデルの重みは公開されていますか。ローカルで動かせますか?
2026年9月19日時点で、Hugging Face の Qwen 公式アカウントに Qwen3.8-Omni-Flash の重みはありません。Omni 系で公式に公開されているのは Qwen3-Omni-30B-A3B 系や Qwen2.5-Omni 系までです。現状は API 専用と考えてください。前世代のローカル運用込みの設計はQwen3.5-Omni の実装ガイドで扱っています。
Gemini 3.8 Flash とどちらを選ぶべきですか?
非リアルタイムで長い音声を読ませる用途なら、1時間あたりの入力コスト試算が $0.0038 対 $0.0864 で Qwen が約23分の1、複数話者の会議(AliMeeting)でも Qwen が上回ります。一方で Gemini はマルチモーダルなツール利用(AgenticVBench)、Web 検索(OmniGAIA)、Video-MME-v2 などで上回り、音声で返答させるなら Gemini 3.8 Live のほうが素直です。用途を1つに絞ってから比べるのが早道です。
まとめ
Qwen3.8-Omni-Flash でいちばん重要なのは、ベンチマークの順位ではなく料金表からモダリティ別の区分が消えたことです。音声が特別料金だった前提で「音声はサンプリングして要約だけ渡す」「議事録は事前に文字起こししてテキストで入れる」といった回避策を組んでいたなら、その回避策自体が要らなくなる可能性があります。1時間の会議音声が約 $0.0038、文脈の2.5%という数字は、設計の前提を書き換える種類の変化です。
一方で、出力はテキストのみ、重みは非公開、Realtime 版は単価未掲載、Qwen-Live Harness の GitHub は404、多言語 ASR は前世代より後退――と、確認できていない部分や制約も同じだけあります。判断は「音声理解のバッチ処理」と「リアルタイム音声対話」を分けて、前者から試すのが安全です。
出典(いずれも2026年9月19日参照)
- Qwen 公式ブログ「Qwen3.8-Omni-Flash: Omni Senses. Agentic Delivery.」(ベンチマーク表・値下げ率・reasoning_effort・Qwen-Live Harness の導入手順)
- Alibaba Cloud Model Studio「Qwen-Omni」ドキュメント(モデルID・文脈長・対応リージョン・入力上限・トークン換算式・マルチチャンネル・キャッシュ)
- Alibaba Cloud Model Studio「Model pricing」(各リージョンの入力・キャッシュヒット・出力単価、前世代のモダリティ別単価)
- GitHub: QwenLM/Qwen-MM-Plugins(Apache-2.0・対応ハーネス・Omni 系プラグインの一覧と前提条件)
- npm レジストリ: qwen-live-harness(公開済みバージョンの確認)
- Gemini API 公式料金表(Gemini 3.8 Flash・3.8 Live の単価)
- Gemini API「Token counting」(音声1秒=32トークン)
- GIGAZINE「Alibabaがオムニモーダルモデル Qwen3.8-Omni-Flash を公開」(国内報道・公開当日の GitHub 404 の指摘)
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。