Gemini 3.8 Live は2026年9月15日に Gemini API で GA(一般提供)になった音声対話モデルで、Live API の従量課金は音声入力 $0.005/分・音声出力 $0.018/分、100万トークン換算ではテキスト入力 $0.75・音声入力 $3.00・テキスト出力 $4.50・音声出力 $12.00です(2026年9月18日時点、Gemini API 公式料金表で確認)。同時に GA になった gemini-3.8-live-extended-thinking も同一の単価ブロックに入っており、推論の深い Extended Thinking を選んでも1分あたりの単価は変わりません。
旧モデルの gemini-3.1-flash-live-preview から移る開発者にとって、実装上いちばん大きい差分は料金ではなく非同期 function calling が既定になったことです。公式 changelog は 3.8 Live の特徴を「interleaved reasoning、default asynchronous function calling、full session client content updates」と明記しており、モデルカードの移行ガイドも「Async execution(behavior: NON_BLOCKING)が既定の function calling モードになった」と書いています。3.1 Flash Live では非同期実行そのものが未対応で、ツール応答を返すまでモデルが喋り出しませんでした。
この記事は、公式ブログ・changelog・料金表・Live API ドキュメント・2つのモデルカードを2026年9月18日に読み直し、2モデルの違い/料金/非同期 function calling の書き方/3.1 Flash Live からの移行手順/統合パートナーとの組み合わせ/使い分けの判断を、公式に書かれている範囲だけでまとめたものです。ドキュメントに記載が見つからない項目は「未確認」と明記しています。
Gemini 3.8 Liveと3.8 Live Extended Thinkingの違い
Google は2026年9月15日の発表(Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking・9月17日更新)で、2モデルの役割を次のように分けています。3.8 Live は「スケールとコスト効率のために作られ、流れるような対話と視覚グラウンディングを組み合わせたもの」、Extended Thinking は「高難度タスク向けで、知能と多段推論を強化したもの」です。
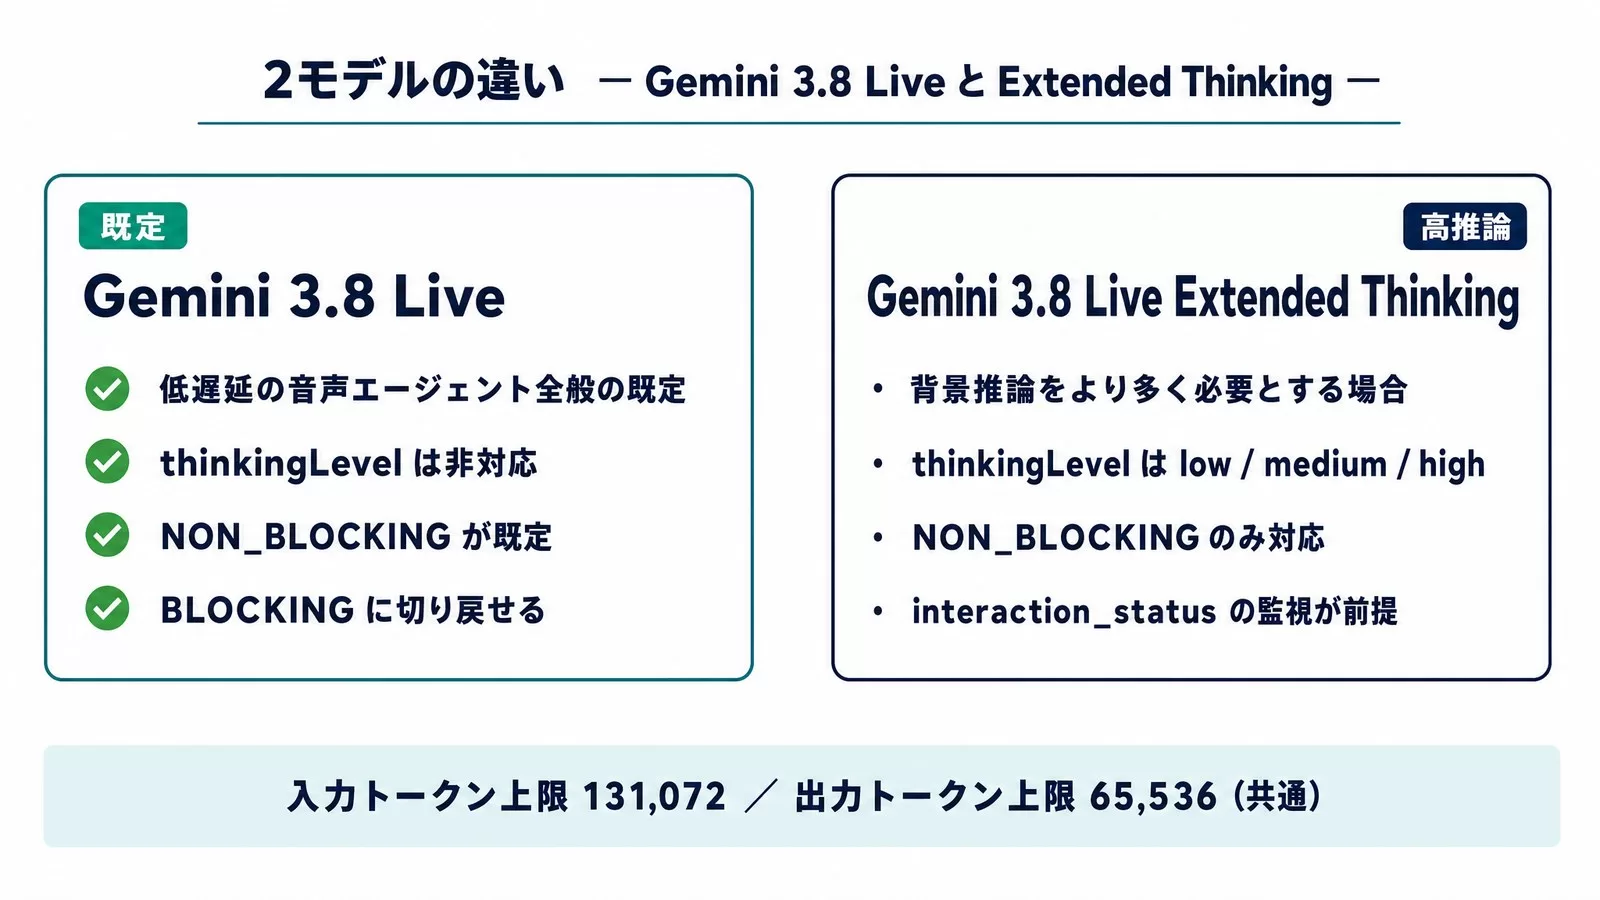
実装者が最初に見るべき差は、思考レベルの設定可否と function calling のモードです。Live API ガイドのモデル比較表とモデルカードから、公式に書かれている項目だけを抜き出すと次のようになります。
| 項目 | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| モデル文字列 | gemini-3.8-live | gemini-3.8-live-extended-thinking |
| 推奨用途(公式表現) | 低遅延の音声エージェント全般の既定 | 背景推論をより多く必要とする場合 |
| 思考 | 対応(interleaved reasoning)。thinkingLevel は非対応でセットアップから外す | 対応。thinkingLevel を low / medium / high で設定(minimal は非対応) |
| 非同期 function calling | 対応・既定。BLOCKING への切り戻し可。scheduling(SILENT / WHEN_IDLE / INTERRUPTED)に対応 | NON_BLOCKING のみ対応。ブロッキングと scheduling は非対応 |
| 応答の受け取り | 1つのサーバーイベントに複数のパートが同時に入る | 同左。非同期推論が動いている間は turnComplete: true が待機状態を意味しない |
| 入力トークン上限 | 131,072 | 131,072 |
| 出力トークン上限 | 65,536 | 65,536 |
| 入出力 | 入力: テキスト・画像・音声・動画/出力: テキストと音声 | 入力: テキスト・画像・音声・動画/出力: テキストと音声 |
| キャッシュ/Batch API | 非対応 | 非対応 |
| 検索グラウンディング | 対応 | 対応 |
| 構造化出力/コード実行/URL context/Maps | 非対応 | 非対応 |
ベンチマークは公式ブログに掲載された値がすべてです。Extended Thinking は Artificial Analysis の Speech to Speech Quality Index で82.6を記録して総合1位、τ-Voice で68.6%、Sierra の τ-Voice-banking で35.1%、Big Bench Audio で97.7%と示されています。3.8 Live は Speech Agent Arena で2位です。ServiceNow の EVA-Bench についてはスコアの数値が示されておらず、「Gemini Enterprise Agent Platform 上の Live API で実行した」という注記だけが付いています。
共通機能として、会話の途中で自動検出して切り替わる97言語以上の対応、リアルタイムに近い視覚入力の処理、そして生成音声すべてへの SynthID 透かしが挙げられています。SynthID は音声出力に直接織り込まれる非可聴の透かしで、AI 生成であることを検出可能にする目的だと説明されています。
Live APIの料金|Gemini 3.8 Liveの単価を一次情報で確認する
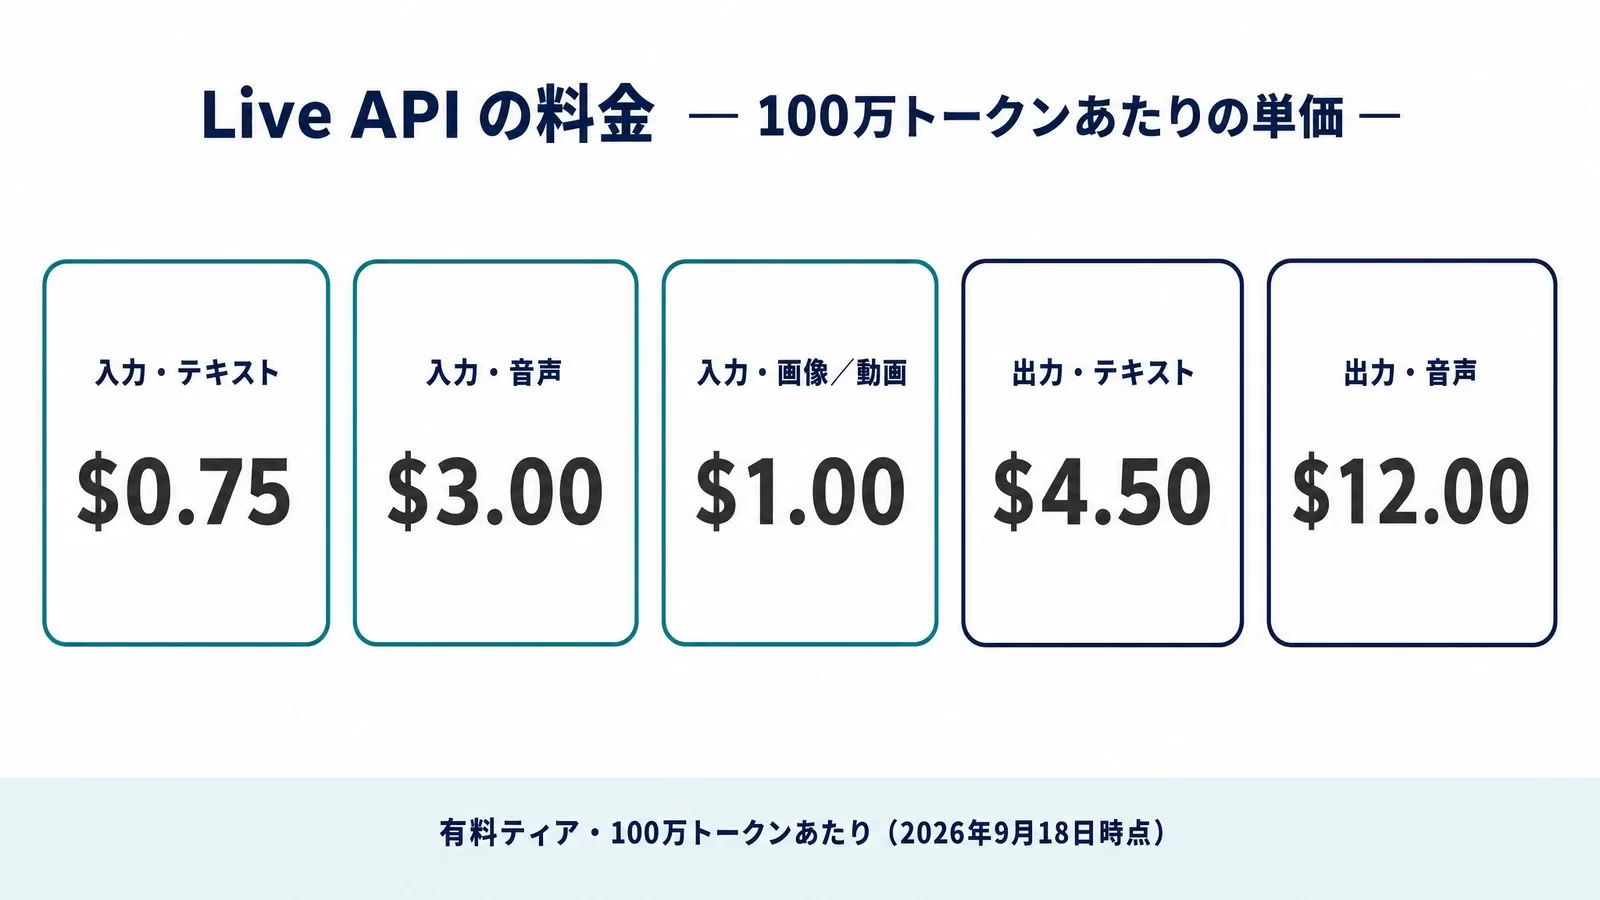
料金表では gemini-3.8-live、gemini-3.8-live-extended-thinking、gemini-3.1-flash-live-preview の3つが同じブロックにまとめられています。つまり2026年9月18日時点では、旧 preview モデルを使い続けても単価は下がりません。以下は公式料金表の有料ティア(Standard)の記載をそのまま整理したものです。
| 区分 | 単価(有料ティア・100万トークンあたり USD) | 分あたりの目安 |
|---|---|---|
| 入力・テキスト | $0.75 | 記載なし |
| 入力・音声 | $3.00 | $0.005/分 |
| 入力・画像/動画 | $1.00 | $0.002/分 |
| 出力・テキスト(思考トークンを含む) | $4.50 | 記載なし |
| 出力・音声(思考トークンを含む) | $12.00 | $0.018/分 |
| 無料ティア | Free of charge | — |
| Google 検索グラウンディング | 月5,000リクエストまで無料(Gemini 3.x 全モデルで共有)、超過分は1,000リクエストあたり$14 | — |
Google の開発者向け記事(Build real-time voice applications with Gemini 3.8 Live and 3.5 Transcribe)も「音声入力 $0.005/分、音声出力 $0.018/分」という同じ数字を挙げています。料金表と開発者ブログの2か所で一致していることは確認できました。
比較対象として、同じ Gemini 3.8 系のテキストモデルである gemini-3.8-flash は「2026年12月31日まで入力 $0.75・出力 $3.75、2027年1月1日から入力 $1.50・出力 $7.50」と期限付きの価格改定が明記されています。一方で Live 系のブロックには、2026年9月18日時点でこうした期限や改定予告の注記がありません。値上げがないと断言はできませんが、少なくとも公式料金表に予告は載っていない、というのが現時点で言えることです。
音声に特化した近縁モデルの単価も同じ料金表にあり、用途によってはこちらが安くなります。gemini-3.5-live-translate-preview は音声入力 $3.50・音声出力 $21.00、gemini-3.5-transcribe-live は音声入力 $3.50・テキスト出力 $21.00(実効で約$0.009/分と注記)です。文字起こしだけなら対話モデルを使わない選択肢があります。
試算例(実測値ではありません・前提と計算式を明示)
前提を「1セッション10分、そのうちユーザー発話が4分、モデル発話が6分、検索グラウンディングなし」と置いた場合の計算です。音声入力は $0.005×4=$0.02、音声出力は $0.018×6=$0.108、合計 $0.128。同じ前提で1日100セッションなら $12.8、30日で $384 になります。実際にはシステム指示・関数宣言・動画フレームの入力トークンが加算されるため、この数字は下限側の目安として扱ってください。公式のベストプラクティスには「ネイティブ音声トークンは1秒あたり約25トークンで急速に積み上がる」と書かれています。
非同期function callingの実装|NON_BLOCKINGとschedulingの書き方
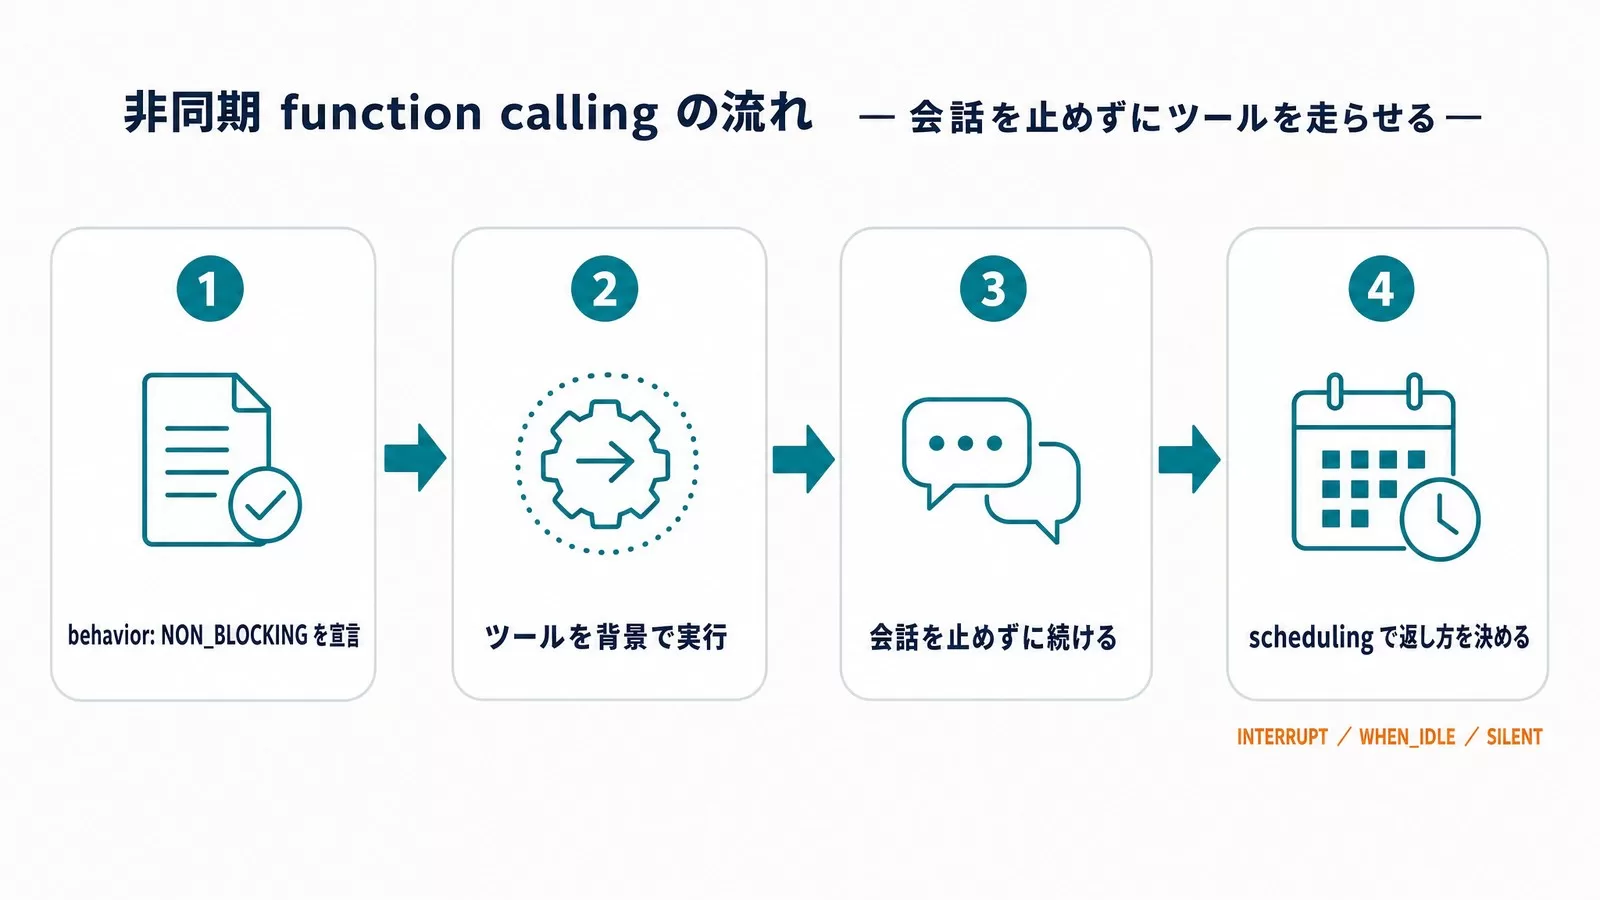
Live API のツール利用ドキュメントによれば、function calling は既定で逐次実行され、各呼び出しの結果が返るまで処理が止まります。会話をブロックしたくない場合は、関数宣言に behavior を付けて非同期実行を指示します。3.8 Live では NON_BLOCKING が既定ですが、宣言単位で明示することもできます。
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live"

# 非同期で走らせる関数宣言
turn_on_the_lights = {"name": "turn_on_the_lights", "behavior": "NON_BLOCKING"}
# 何も付けない関数は従来どおりモデルとのやり取りを止める
turn_off_the_lights = {"name": "turn_off_the_lights"}

tools = [{"function_declarations": [turn_on_the_lights, turn_off_the_lights]}]
config = {"response_modalities": ["AUDIO"], "tools": tools}
JavaScript(@google/genai)では Behavior を import して同じことを書きます。
import { GoogleGenAI, Modality, Behavior } from '@google/genai';

const turn_on_the_lights = { name: "turn_on_the_lights", behavior: Behavior.NON_BLOCKING };
const turn_off_the_lights = { name: "turn_off_the_lights" };

const tools = [{ functionDeclarations: [turn_on_the_lights, turn_off_the_lights] }];
非同期にしたら、結果が返ってきたときにモデルがどう振る舞うかを FunctionResponse の scheduling で決めます。公式ドキュメントが挙げている値は3つだけです。
| scheduling | 公式の説明 | 向く場面 |
|---|---|---|
| INTERRUPT | 今やっていることを中断して、受け取った結果をすぐ伝える | 結果が会話の前提を変える(在庫なし・認証失敗など) |
| WHEN_IDLE | いま話している内容が終わるまで待つ | 補足情報の提示。発話を切りたくない |
| SILENT | 何もせず、その知識を会話の後半で使う | 背景で取得したメタデータ、ログ書き込みの完了通知 |
# 非同期の関数宣言に対しては、応答側で scheduling を指定する
function_response = types.FunctionResponse(
    id=fc.id,
    name=fc.name,
    response={
        "result": "ok",
        "scheduling": "INTERRUPT"  # WHEN_IDLE / SILENT も指定できる
    }
)
注意したいのは、3.8 Live と Extended Thinking で使えるモードが違うことです。モデルカードによれば、3.8 Live は NON_BLOCKING が既定で、後方互換のために behavior: BLOCKING を指定して同期実行に戻すことができ、scheduling も使えます。対して Extended Thinking はNON_BLOCKING のみで、同期のブロッキングモードを指定すると「hard error(明確なエラー)」が返り、scheduling の設定自体が非対応です。共通のツール定義を両モデルで使い回す設計にしていると、ここで落ちます。
もうひとつ、Extended Thinking には受信側の作法があります。モデルカードの記述では、非同期推論が動いている間は turnComplete: true が「モデルが待機状態になった」ことを意味しません。サーバーは背景推論やツール呼び出しを続けている可能性があるため、クライアントは turnComplete: true の後もメッセージを受け続ける必要があります。状態の判定にはサーバーメッセージの interaction_status フィールドを使い、IN_PROGRESS(処理中)と IDLE(完了・入力待ち)で分岐させます。
Live API は generateContent と違い、ツール応答の自動処理に対応していません。クライアント側で session.send_tool_response を呼んで自分で返す必要があります。Gemini API の同期側 function calling の基本はGemini API完全ガイド|PythonとFunction Callingで整理しているので、初めて触る場合はそちらから読むと差分が掴みやすくなります。
Gemini 3.1 Flash Liveからの移行チェックリスト
モデルカードには「Migrating from Gemini 3.1 Flash Live」という節があり、変更点が箇条書きで並んでいます。公式に書かれている項目をそのままチェックリストにしました。
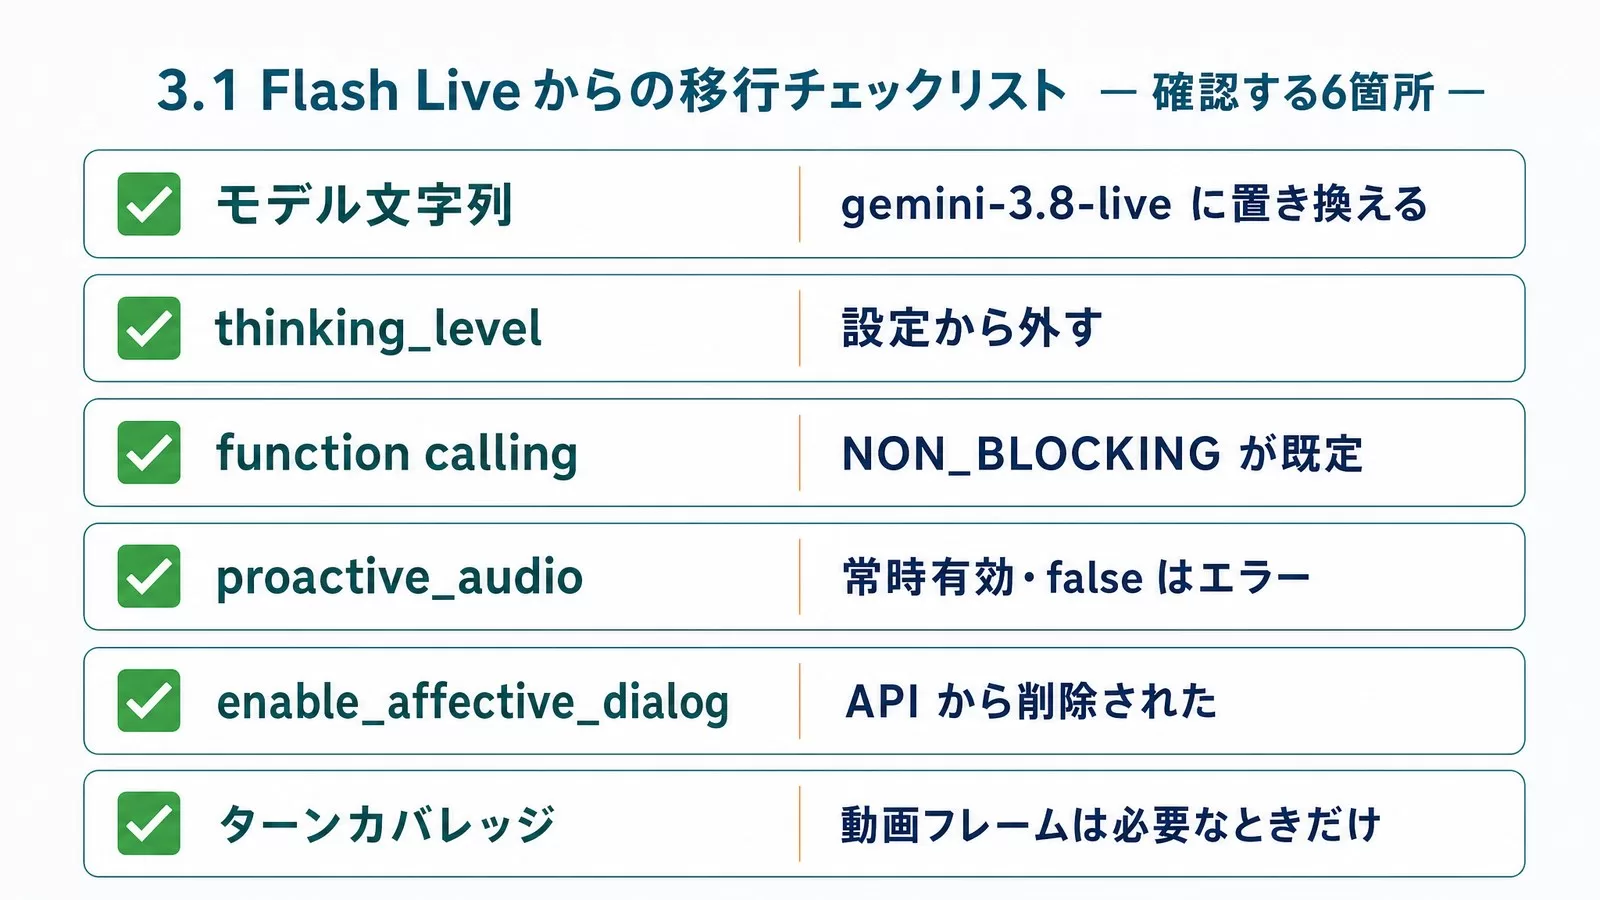
| # | 確認する箇所 | 公式の指示 |
|---|---|---|
| 1 | モデル文字列 | gemini-3.1-flash-live-preview を gemini-3.8-live に置き換える |
| 2 | thinking_level | gemini-3.8-live では非対応。thinking_level(および thinking_config)をセッション設定から外す |
| 3 | function calling | NON_BLOCKING が既定。同期に戻したい宣言には behavior: BLOCKING を明示する |
| 4 | send_client_content | セッションの全期間で使え、role(user / model)を明示する。turn_complete=true は生成中の応答を無条件に中断する |
| 5 | proactive_audio | 常時有効になった。proactive_audio: false を送るとエラーが返る |
| 6 | enable_affective_dialog | API から削除された。設定が残っていれば消す |
| 7 | ターンカバレッジ | 既定が TURN_INCLUDES_AUDIO_ACTIVITY_AND_ALL_VIDEO。動画フレームは既定で送られるため、必要なときだけ送ってコンテキストとコストを抑える |
| 8 | 応答モダリティ | 対応するのは音声。テキストの書き起こしが要るなら出力音声の文字起こしを有効にする |
Extended Thinking へ上げる場合は、上記に加えて interaction_status の監視、NON_BLOCKING 限定、thinking_config の thinking_level(low / medium / high。minimal は非対応)の3点が追加されます。
model = "gemini-3.8-live-extended-thinking"

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
        include_thoughts=True,  # 思考サマリーを受け取る
    ),
)
移行作業で見落としやすいのが、ドキュメント側の記述のばらつきです。Live API のツール利用ページにある「Overview of supported tools」の表は、2026年9月18日時点で Gemini 3.1 Flash Live Preview と Gemini 2.5 Flash Live Preview の2列しかなく、3.8 Live の列がありません。同ページの非同期 function calling の節にも「Gemini 3.1 Flash Live ではまだ非対応」という注記が残っています。3.8 Live の対応状況は、Live API ガイドのモデル比較表と各モデルカードを正として確認してください。
LiveKit・Pipecat・Vercelとの組み合わせ
Google は Live API の統合パートナーとして Agora・Fishjam・LangChain・LiveKit・Pipecat・Vercel・Vision Agents を挙げています。これらのプラットフォームがリアルタイムのメディアストリーミング基盤を裏側で引き受けるので、開発者は体験づくりに集中できる、という位置づけです。Live API のドキュメント側のパートナー一覧には、これに加えて Voximplant(着信・発信の電話接続)と Firebase AI SDK も載っています。
WebRTC 側のフレームワークを使うか、自前で WebSocket を張るかは、運用要件で決まります。Live API の技術仕様はステートフルな WebSocket 接続(WSS)で、入力音声は 16bit PCM・16kHz・リトルエンディアン、画像は毎秒1フレーム以下の JPEG、出力音声は 16bit PCM・24kHz・リトルエンディアンと定められています。ブラウザやモバイルから直接つなぐクライアント対サーバー構成では、API キーの代わりに短命なエフェメラルトークンを使うことが公式に推奨されています(エフェメラルトークンは2026年9月18日時点で Preview 扱い、対応は Live API のみ)。
LiveKit と Pipecat については、それぞれの実装手順を別記事で扱っています。フレームワーク側の構成から入りたい場合はLiveKit Agents完全ガイド|WebRTC音声AI、Python でパイプラインを組む場合はPipecat完全ガイド|音声AIエージェント実装を参照してください。OpenAI 側の同種の構成(VoicePipeline・SIP)と比べたい場合はVoicePipelineで作る音声AIエージェント完全ガイドが参考になります。
音声の指定は speechConfig で行います。ネイティブ音声出力のモデルはテキスト読み上げ用の音声をそのまま使えますが、言語コードの明示指定には対応しておらず、モデルが自動で適切な言語を選びます。応答言語を固定したいときは、公式ベストプラクティスに載っているとおりシステム指示で指定する形になります。
config = {
    "response_modalities": ["AUDIO"],
    "speech_config": {
        "voice_config": {"prebuilt_voice_config": {"voice_name": "Kore"}}
    },
}
2モデルの使い分け|どちらを選ぶかの判断軸
ここからは公式仕様を踏まえた当社の見立てです。判断材料は単価ではなく、「会話を止めずに済ませたい処理の重さ」と「クライアント実装をどこまで作り込めるか」の2つだと考えています。単価が同一である以上、コストで選ぶ理由がないからです。
| 状況 | 選ぶモデル | 理由 |
|---|---|---|
| 受付・一次対応・FAQ応答など、ツール呼び出しが1〜2回で完結する | Gemini 3.8 Live | 公式が「低遅延の音声エージェント体験の既定」と位置づけている。scheduling を使って結果の返し方も選べる |
| 既存の同期前提のツール実装をそのまま持ち込みたい | Gemini 3.8 Live | behavior: BLOCKING で同期に戻せる。Extended Thinking では同期指定がエラーになる |
| 予約変更・見積り・複数システムを跨ぐ照会など、多段の処理が入る | Extended Thinking | 背景推論と非同期ツール呼び出しを、音声を流しながら並行処理すると説明されている |
| 処理の進み具合を会話で伝えたい | Extended Thinking | 公式ブログが「Let me check that…」のような早い段階の合図と、多段タスクの進捗ナレーションに言及している |
| クライアント側の状態管理に手を入れられない | Gemini 3.8 Live | Extended Thinking は interaction_status の監視が前提になり、受信ループの作り替えが必要 |
企業内の利用面から入る場合は、提供チャネルが分かれている点にも注意が必要です。公式ブログによれば、3.8 Live は開発者向けに Gemini API と Google AI Studio、企業向けには Gemini Enterprise でプライベートプレビュー、一般には Search Live で提供されます。Extended Thinking は開発者向けの提供に加えて、Gemini Live、および Google Workspace の Docs(Google AI Pro・Ultra 加入者)、Gmail と Keep(Google AI 加入者)で使えるとされています。「Gemini アプリで試せた体験がそのまま API で再現できる」とは限らないので、検証はモデル文字列を指定した API 側で行ってください。
なお Live API そのものは、2026年9月18日時点でドキュメント上「Preview」と表示されています。モデル2つは GA ですが、API 全体の位置づけは別だという点は、社内の稟議資料に書くときに誤解を招きやすいところです。
【要注意】Live API実装でつまずく4つの失敗パターン
公式ドキュメントに明記されている制約のうち、設計段階で見落とすと後から作り直しになるものを4つ挙げます。いずれも想定シナリオとして書いており、当社が運用実績を測定した結果ではありません。
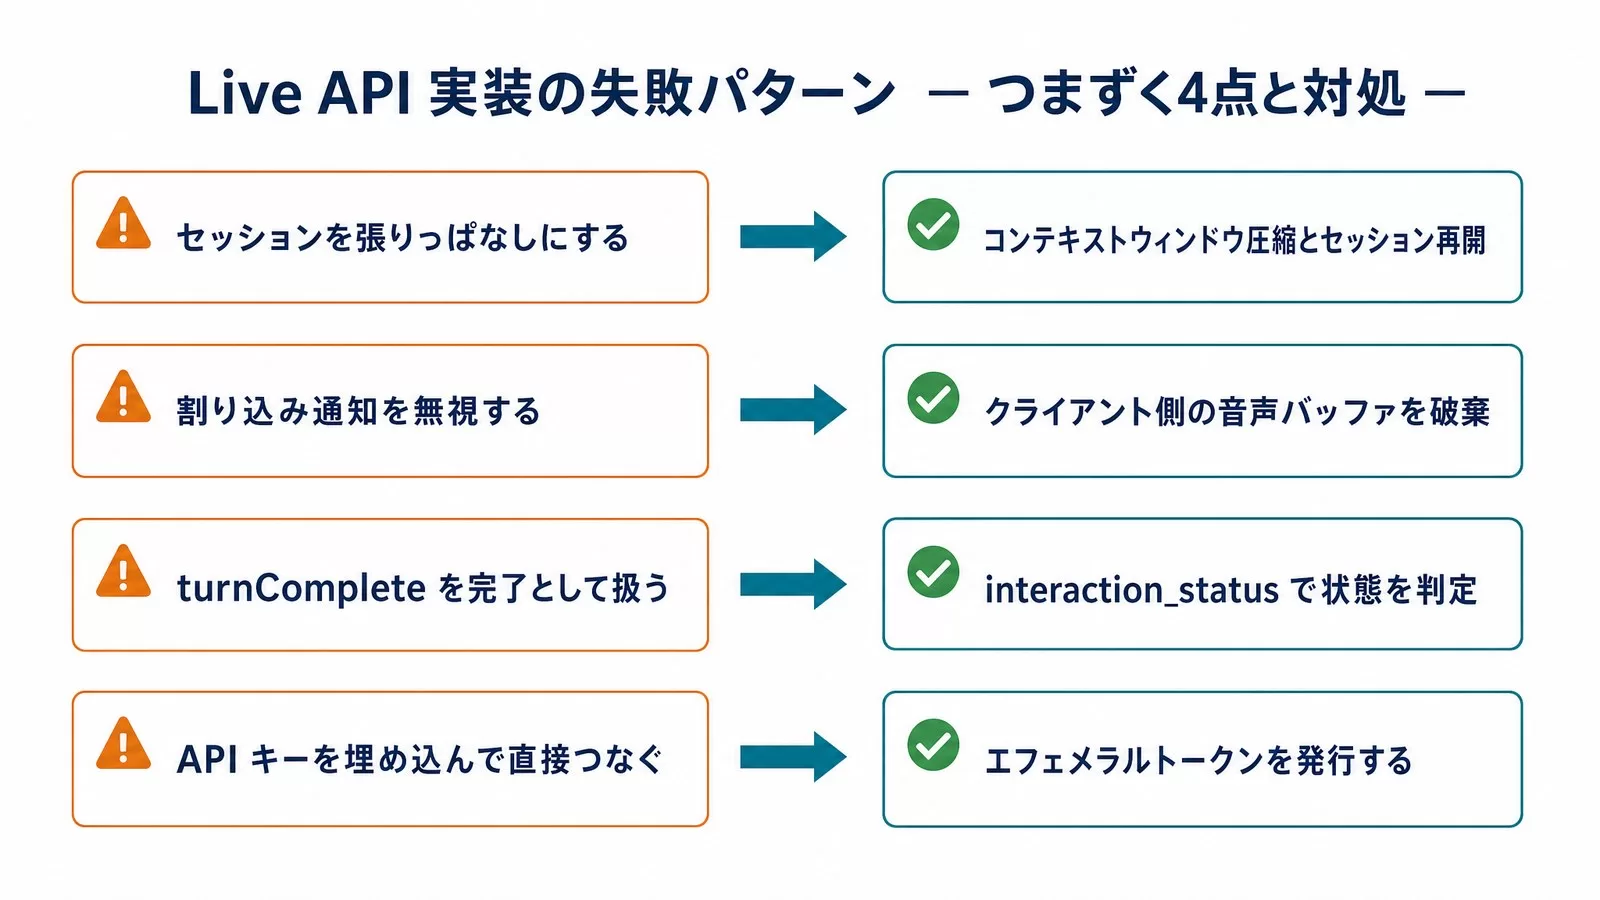
❌ セッションを張りっぱなしにして長時間の通話を設計する
公式のセッション管理ドキュメントによれば、圧縮なしの音声のみのセッションは15分、音声と動画のセッションは2分で上限に達し、超えるとセッション(と接続)が終了します。接続自体の寿命も約10分です。
⭕ コンテキストウィンドウ圧縮とセッション再開を最初から入れる
contextWindowCompression にスライディングウィンドウを設定すればセッションを無制限に延ばせる、と明記されています。接続のリセットに備えるなら sessionResumption を設定して再開トークンを受け取り、接続が切れる前に届く GoAway メッセージで後処理を走らせます。
❌ ユーザーが割り込んだのにクライアントの音声バッファを流し続ける
モデルの応答中にユーザーが話すと、サーバーは server_content に "interrupted": true を付けて送ってきます。これを無視すると、ユーザーの発話に被せてエージェントが喋り続けます。
⭕ 割り込み通知を受けたら即座にクライアント側バッファを捨てる
公式ベストプラクティスは「直ちにクライアント側の音声バッファを破棄すること」と書いています。あわせて、送信する音声チャンクは20ミリ秒〜40ミリ秒が推奨で、1秒分といった大きな単位で溜めてから送らないことも明記されています。
❌ Extended Thinking で turnComplete を「処理完了」として扱う
非同期推論が動いている間、turnComplete: true はセッションが待機状態になったことを意味しません。ここで受信ループを閉じると、後続のツール呼び出しや音声フレームを取りこぼします。
⭕ interaction_status で状態を判定する
IN_PROGRESS なら処理継続中、IDLE なら全処理が終わってユーザー入力待ち、と公式に定義されています。UI の「考え中」表示もこのフィールドに連動させるのが素直です。
❌ ブラウザやモバイルアプリに API キーを埋め込んで直接つなぐ
クライアント対サーバー構成は遅延の面で有利ですが、API キーはクライアントから抽出され得ます。
⭕ エフェメラルトークンを発行する経路を先に作る
バックエンドで短命トークンを発行し、クライアントはそれを API キーの代わりに使う流れが公式に案内されています。トークンは既定で発行から1分以内に新しい Live API セッションを開始する必要がある、と書かれています。
加えて、動画フレームの扱いもコストに直結します。3.8 Live のターンカバレッジは既定で全動画フレームを含むため、画面共有やカメラ入力を常時流す設計にすると入力トークンが積み上がります。公式の移行ガイドも「必要なときだけフレームを送ってコンテキストとコストを管理する」と明記しています。音声AIの選定を横断的に比べたい場合は音声AIエージェント徹底比較2026、Gemini のテキスト系モデルの単価を確認したい場合はGemini 3.7 Flash登場|料金半額とベンチマークを検証もあわせてご覧ください。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
よくある質問
Gemini Live APIとは何ですか?
Gemini との低遅延・リアルタイムな音声・映像のやり取りを実現する API です。音声・画像・テキストの連続ストリームを処理して即座に音声で応答します。接続方式はステートフルな WebSocket(WSS)で、サーバー対サーバーとクライアント対サーバーの2通りの実装方針が公式に示されています。2026年9月18日時点、ドキュメント上は Preview と表示されています。
Gemini Live APIの料金はいくらですか?
Gemini 3.8 Live・3.8 Live Extended Thinking・3.1 Flash Live Preview は同一の単価ブロックで、有料ティアの100万トークンあたり入力テキスト $0.75、入力音声 $3.00($0.005/分)、入力画像・動画 $1.00($0.002/分)、出力テキスト $4.50、出力音声 $12.00($0.018/分)です。無料ティアも用意されています(2026年9月18日時点の公式料金表)。日本円換算で検討する場合は、為替の影響を受けるため概算として扱ってください。
gemini-3.8-liveとgemini-3.8-live-extended-thinkingはどちらを使うべきですか?
公式は 3.8 Live を「ほとんどの低遅延な音声エージェント体験の既定」、Extended Thinking を「より多くの背景推論が必要な場合の推奨」としています。単価は同じなので、多段のツール呼び出しや複雑な照会が入るかどうかで決めるのが実務的です。ただし Extended Thinking は同期のブロッキング実行に非対応で、interaction_status の監視が前提になります。
3.1 Flash Live Previewから移行する必要はありますか?
公式の Live API モデル比較表は 3.1 Flash Live Preview を「レガシーのプレビューモデル。Gemini 3.8 Live への更新を推奨」としています。3.1 Flash Live は非同期 function calling に対応しておらず、ツール応答を返すまでモデルが喋り出しません。会話を止めずにツールを走らせたい要件があるなら、移行の理由があります。終了日については2026年9月18日時点で公式の記載を確認できていません。
Live APIでは何言語に対応していますか?
Gemini 3.8 Live については、公式ブログが「97言語以上を自動検出し、会話の途中で切り替える」と説明しています。Live API のドキュメント側の「Key features」には多言語対応として70言語という記述もあり、モデルごとに数字が異なります。導入検討時は、対象言語を実際のモデル文字列で確認してください。なお音声モデルは言語コードの明示指定に非対応で、応答言語を固定したい場合はシステム指示で指示します。
まとめと出典
2026年9月18日時点の要点は次の3つです。第一に、Gemini 3.8 Live と 3.8 Live Extended Thinking は2026年9月15日に GA になり、料金は3.1 Flash Live Preview と同一ブロック(音声入力 $0.005/分・音声出力 $0.018/分)。第二に、実装上の最大の差分は非同期 function calling が既定になったことで、3.8 Live は BLOCKING への切り戻しと scheduling が使えるのに対し、Extended Thinking は NON_BLOCKING 専用です。第三に、Extended Thinking を使うなら turnComplete ではなく interaction_status で状態を判定するようクライアントを書き換える必要があります。
移行作業は「モデル文字列の置換」だけでは終わりません。thinking_level の削除、proactive_audio: false と enable_affective_dialog の撤去、動画フレーム送信の制御、セッション上限への対策までを一度に洗い出したうえで着手するのが安全です。
参照した一次情報(参照日: 2026年9月18日)
- Google「Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking」(2026年9月15日公開・9月17日更新) — ベンチマーク値、97言語以上の自動検出、SynthID、提供チャネル
- Google「Build real-time voice applications with Gemini 3.8 Live and 3.5 Transcribe」(2026年9月15日) — 統合パートナー、分あたり単価
- Gemini API changelog(2026年9月15日の項) — 2モデルの GA、既定の非同期 function calling
- Gemini API Pricing — 料金表の各数値
- Live API 概要 — 技術仕様、実装方針、パートナー一覧
- Live API Tool use — 非同期 function calling、scheduling
- モデルカード gemini-3.8-live / モデルカード gemini-3.8-live-extended-thinking — 仕様値と移行ガイド
- Live API セッション管理 / Live API ベストプラクティス — セッション上限、割り込み処理、チャンクサイズ
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。音声エージェントの要件定義から実装体制づくりまで、現場に合わせてご相談いただけます。