2026年11月3日時点で、Claude APIのmessage threadsは、長い会話やエージェントのループで、毎回会話の全部を送り直さず、2回目以降は新しいメッセージと前の応答のidだけを送れるようにするMessages APIのベータ機能です。Anthropicが2026年11月2日に発表し、使うにはベータのヘッダーmessage-threads-2026-08-12を付け、リクエストにthreadパラメーターを足します。
2026年11月3日時点で公式docsを確認して書いています(docsはAnthropicの開発者向けのドキュメント)。筆者は実機で試しておらず、書き方とエラーの扱いはdocsの記載の範囲です。ベータの機能のため、仕様は今後変わる可能性があります。
この記事の要点(2026年11月3日時点)
- 何が変わるか:最初の1回(create)で会話の全部とsystem・toolsを送り、2回目以降は新しい分と前の応答のidだけを送ります。サーバーが会話を持つのは短い間で、最後のリクエストから5分で続けられなくなり、使われなくなってから1時間以内に消えます。
- 速くなる条件:会話が長いほど効きます。Anthropicの発表では、Claude Codeの50万〜100万トークンのリクエストで、TTFT(応答の最初のトークンが届くまでの時間)の中央値が約35%下がりました。短い会話の数字は出ていません。
- 費用:料金とレート制限は変わりません。Claudeは毎ターン会話の全部を読むので、トークンの使用量も同じです。
- 先に確かめること:ZDR(応答の後にデータを保存しない取り決め)とHIPAA readiness(米国の医療情報を扱う組織向けの取り決め)の対象外です(ZDRの組織でもAPIは止めないので、使えばそのデータはZDRの外に出ます。HIPAA readinessを有効にした組織ではAPIが断ります)。Message Batches(リクエストをまとめて非同期で処理するAPI)、トークン数え(送る前にトークン数を数えるAPI)、CompactionやContext editing(APIの側で会話を短くする機能)とは組み合わせられず、Amazon BedrockとClaude Models on Google Cloud(Google managed)は対応表に入っていません。切れた時に送り直せるよう、会話の写しはアプリ側に持ちます。
message threadsとは|会話を毎回送り直さない仕組み
message threadsは、会話を短い間だけサーバーに置いておく仕組みです。docsの説明では、system(システムプロンプト)とtools(ツールの定義)を含む会話の全部を最初に1回送り、その後のターンでは新しいメッセージと前の応答のidだけを送ります。APIはモデルを呼ぶ前に会話を組み立て直し、返ってくるのはいつもどおりのメッセージです。足すパラメーターはthreadの1つで、付けなければ今までどおりの動きです。
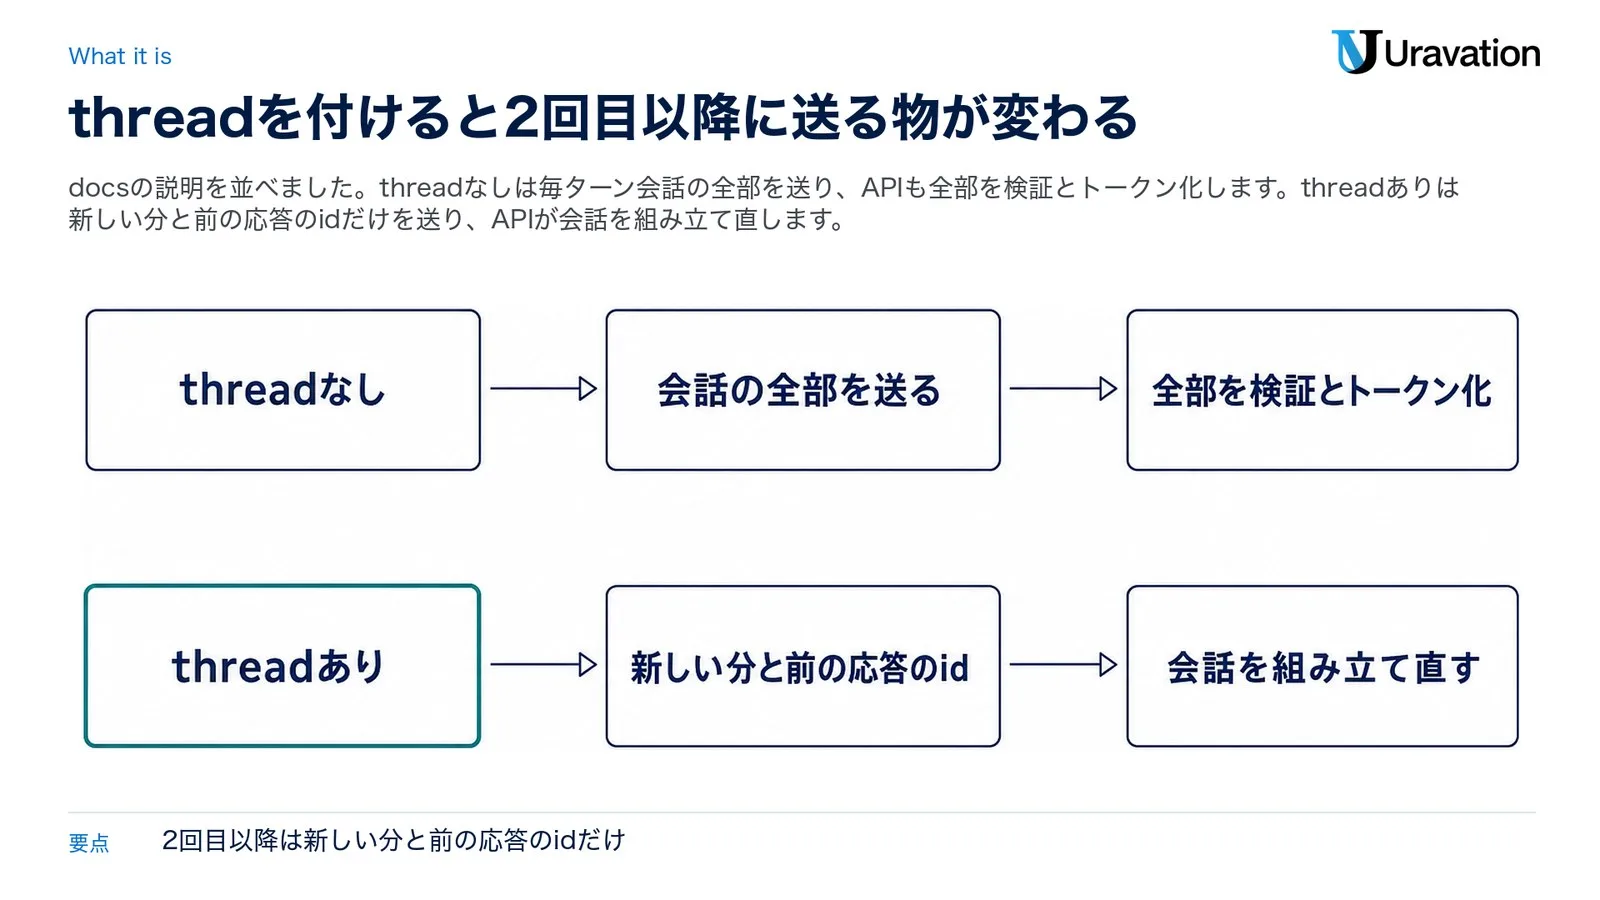
threadを付けない今までの使い方では、毎ターン会話の全部をアップロードし直し、APIもその全部を検証してトークンに分け直します(トークン化)。threadを付けると、その手間の大半が新しいターンの分だけになり、docsは「リクエストが小さくなり、会話が伸びてもTTFTが低く、安定したままになる」と説明しています。
| 比べる所 | threadなし | threadあり |
|---|---|---|
| 2回目以降に送る物 | 会話の全部を送る | 新しい分と前の応答のid |
| APIの手間 | 全部を検証とトークン化 | 会話を組み立て直す(検証とトークン化の大半は新しいターンの分だけ) |
| systemとtools | 毎回送る | createのリクエストだけで送る |
名前の似たClaude Managed Agents(エージェントとセッションをAPIで扱う別の仕組み)のsession threadsはマルチエージェントのセッションでエージェントごとの作業の流れを扱う機能で、docsは「message threadsとは別物」と明記しています。
2026年11月2日の発表の要点
| 項目 | 内容(2026年11月3日時点) |
|---|---|
| 発表日 | 2026年11月2日(発表記事とリリースノート) |
| 状態 | ベータ。docsは「全モデルでベータ」、発表は「公開ベータ」と表記 |
| ベータのヘッダー | message-threads-2026-08-12 |
| 使える場所 | Claude API、Claude Platform on AWS、Claude Models on Google Cloud(Anthropic managed)、Microsoft Foundry |
| 料金とレート制限 | 変わらない |
| データの扱い | ZDRとHIPAA readinessの対象外。サーバー管理の鍵で暗号化してメモリに置き、永続的な保存先には書かず、最後に使ってから1時間以内に消す |
Amazon Bedrockと、Google Cloudの「Google managed」(GoogleがAgent Platformの一部として動かす側)は、2026年11月3日時点の対応表に入っていません。どちらのGoogle Cloudを使っているかは、SDK(各言語向けの公式のライブラリ)のクライアントがAnthropicGoogleCloudならAnthropic managed、AnthropicVertexならGoogle managedだと、Google Cloudの比較のページが見分け方を載せています。AWSでは、SDKのクライアントがAnthropicAWS(ベータ)ならClaude Platform on AWS、AnthropicBedrockMantleかAnthropicBedrockならAmazon Bedrockだと、Claude Platform on AWSのページの比べる表にあります。
仕組み|create・continue・replayと期限
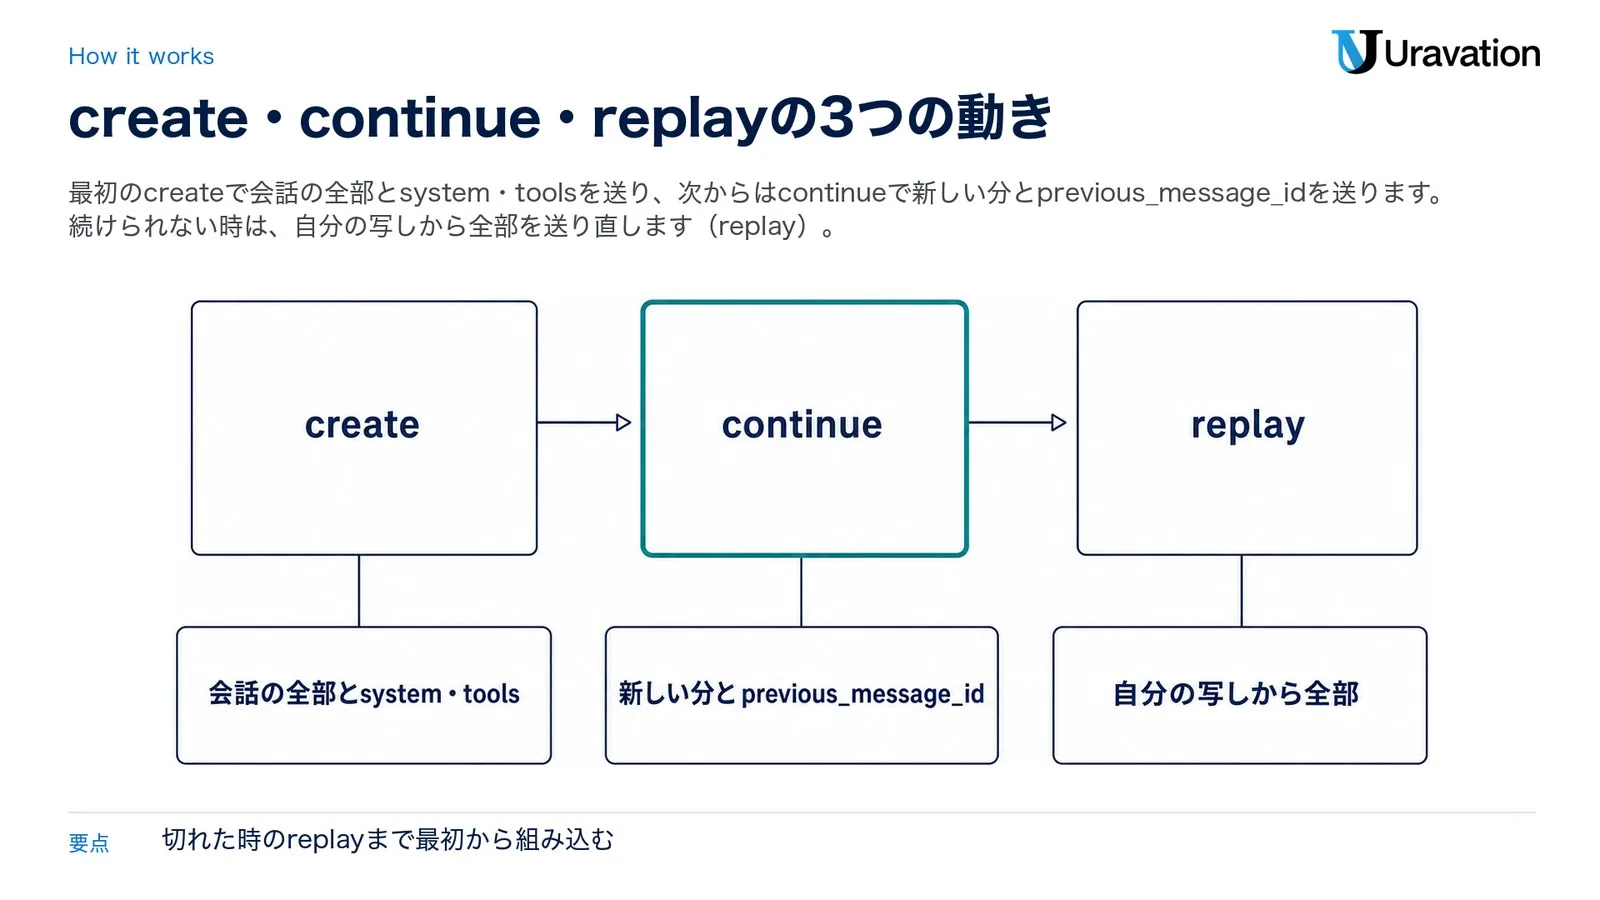
動きはcreate(作る)・continue(続ける)・replay(送り直す)の3つです。docsはスレッドを「best-effort(できる限り保つが、保証はしない)」と書いており、切れた時の送り直しまでを最初から組み込む前提です。
| 動き | 送る物 | 使う時 |
|---|---|---|
| create | 会話の全部とsystem・toolsに、"thread": {"type": "create"}を足す |
最初の1回。APIはClaudeの返事を含む会話を、応答のidの下に保存する |
| continue | 新しい分とprevious_message_id。"thread": {"type": "continue", "previous_message_id": "<前のid>"}を足し、systemとtoolsは入れない |
2回目以降。次のターンには新しい応答のidを使う |
| replay | 自分の写しから全部(system・toolsも)を、新しいcreateとして送る | continueが404を返した時など、続けられない時 |
正しい記録はアプリ側の写し
docsは「会話のsource of truth(正しい元の記録)はアプリ側に残る」と書き、すべてのメッセージの写しを自分で持ち、replayの道を最初から作るよう求めています。createにもcontinueにも、そのターンをAPIが保存したかを示す応答は無く、分かるのは次のcontinueを送った時だからです。SDKのthreadヘルパーも写しをメモリにしか持たないので、プロセスが終わった後も続けるなら写しは自分で保存します。履歴と状態の持ち方は、AIエージェントの状態・会話履歴・セッション管理の記事で整理しています。
期限は「最後のリクエストから5分」
- 最後のリクエストから5分で切れる
- 使われなくなってから1時間以内に、APIがスレッドを消す
- APIが応答を保存するたびに、5分が数え直しになる
この3つはdocsの記載で(前の2つはリリースノートにもあります)、スレッドを一覧・読み出し・削除するAPIはありません。ユーザーの返事や人の承認を5分以上待つエージェントでは、待つたびにreplayになると考えておきます。長く止まるエージェントの設計は、長時間実行の中断再開の記事が参考になります。
速くなる条件と費用|発表の数字の読み方
発表によると、コーディングのエージェントは1つのセッションで数百回のリクエストを送ることがあり、どのリクエストもそれまでのメッセージとツールの結果を全部送り直します。会話が数十万トークンに達すると、その送り直しだけでClaudeが答え始めるまでの時間が延びます。message threadsは、この送り直しを減らしてTTFTを下げる機能です。
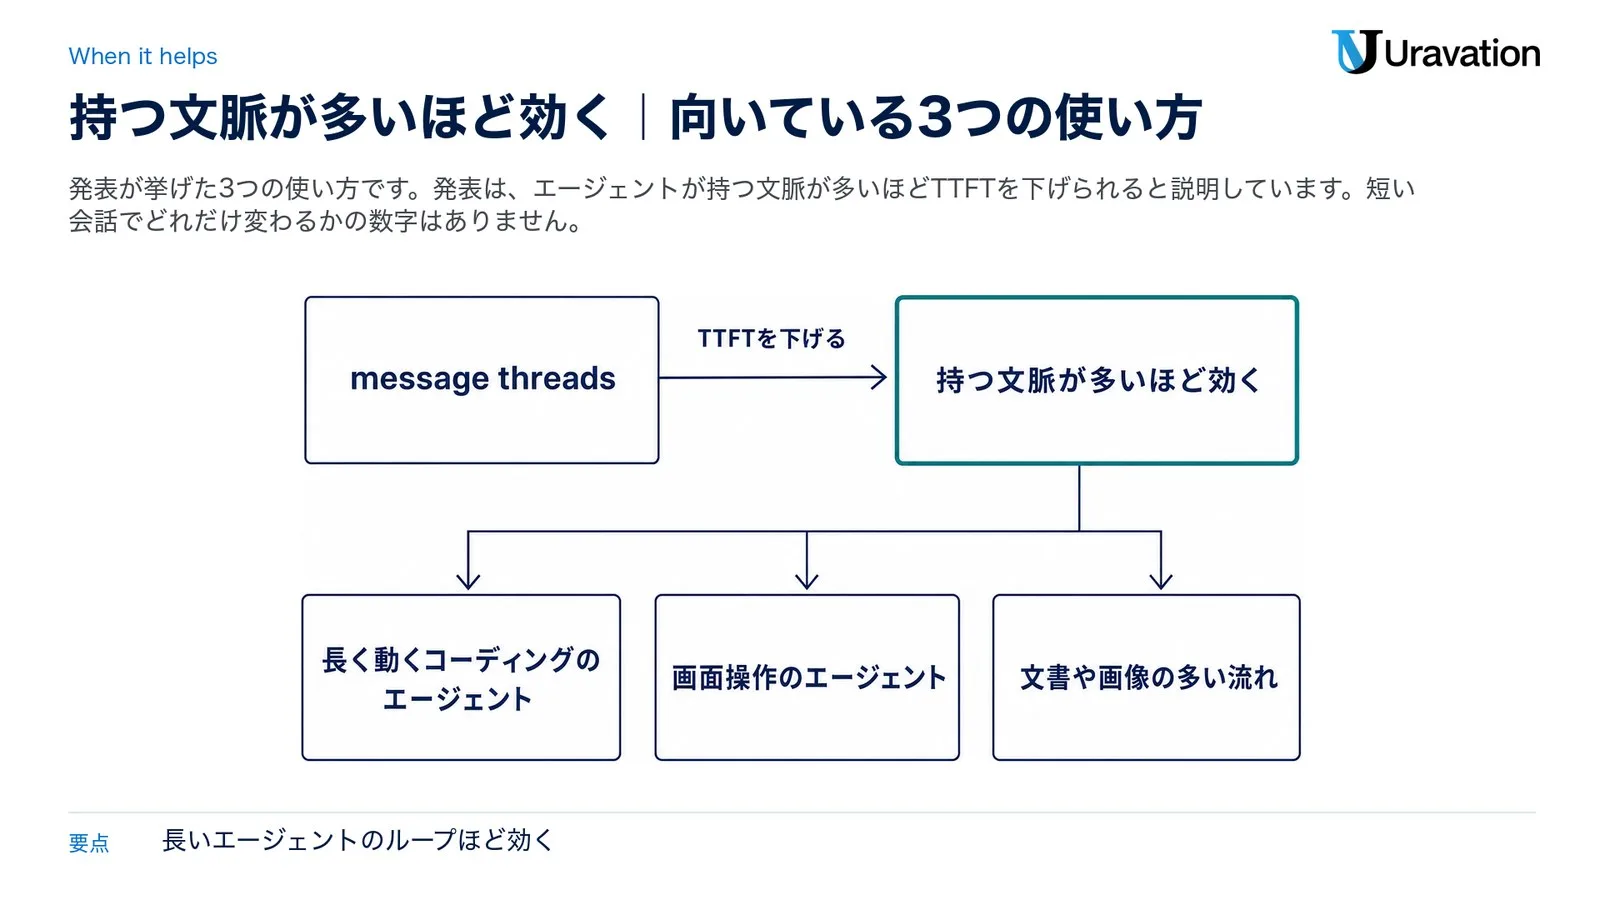
速さの数字は1つだけです。Anthropicの発表では、Claude Codeの大半の利用者でmessage threadsが既定で有効になっており、50万〜100万トークン(発表の表記は500k to 1M tokens)のリクエストで、TTFTの中央値が約35%下がりました。これはAnthropicが発表したClaude Codeでの数字で、筆者が測った値ではありません。比べた条件と期間は発表に書かれていません。
発表は、待ち時間が問題になる、動いている最中のセッション(active sessions)に最も向くとして、次の3つを例に挙げています。
- 長く動くコーディングのエージェント:ツールの結果やファイルの編集のたびに会話が伸びる
- 画面操作のエージェント(computer use):スクリーンショットを毎ターンアップロードし直さず、スレッドに残せる
- 文書や画像の多い流れ:リクエストが小さくなる
発表は「エージェントが持つ文脈が多いほど、TTFTを下げられる」、docsは「最も効くのは長いエージェントのループ」と書いており、持つ文脈が多いほど効くというのが公式の説明です。数往復で終わる短い会話でどれだけ変わるかは、発表にもdocsにも数字がありません。
料金とトークンの使用量は変わらない
docsは「threadは料金とレート制限を変えない」、発表は「通常のClaudeのトークン料金と今のレート制限が適用される」と書いています。さらに発表は「リクエストは小さくなるが、Claudeは毎ターン会話の全部を読むので、トークンの使用量は同じ」と説明しています。message threadsは待ち時間を減らす機能で、トークン代を下げる機能ではありません。費用にかかわるのはプロンプトキャッシュ(toolsやsystem、それまでの会話など毎回同じ前の部分をAPI側に一時的に保存し、次のリクエストではその分を基本の入力単価より安く読み込む仕組み)で、threadを付けても自動ではかかりません。
書き方|SDKのthreadヘルパーとthreadフィールド
書き方は、SDKのthreadヘルパーに任せる方法と、threadフィールドを自分で付ける方法の2つです。docsにはPython・TypeScript・C#・Go・Java・PHP・Rubyの例があり、ここではPythonの公式の例を載せます(筆者は動かしていません)。Claude APIのキーと料金の基本は、Claude APIとは(料金・使い方・始め方)にまとめています。threadフィールドを自分で付ける時の流れは、docsの説明をつなぐと次のとおりです。
- スレッドのすべてのリクエストに、ベータのヘッダー
message-threads-2026-08-12を付ける(SDKのヘルパーなら自動で付く)。 - 最初のリクエストで会話の全部とsystem・toolsを送り、
"thread": {"type": "create"}を足す。 - 返ってきた応答の
idを、アプリ側の会話の写しと一緒に残す。 - 次のターンでは、新しいメッセージ(次のユーザーの発言か、前の応答の
tool_useに答えるtool_result)だけを送り、"thread": {"type": "continue", "previous_message_id": "<前のid>"}を足す。systemとtoolsは入れない。 modelやthinkingなど「毎回同じ値」の項目は、createと同じ値で毎回送る。- continueが404(
thread_not_found)を返したら、写しから会話の全部をsystem・toolsと一緒に新しいcreateで送り直し、新しい応答のidから続ける。
SDKのthreadヘルパーを使う例(公式の例)
ヘルパーはMessagesのリクエストと同じ項目で作り、1ターンずつ送ります。1ターン目でスレッドを作り、2ターン目から続け、ベータのヘッダーも代わりに付けます。docsの例はanthropicパッケージをimportした後の部分だけで、コメントも原文のままです。Python SDKのリリースノートでは、v2.2.0(2026年10月23日)に「add support for message threads」とあります。
client = anthropic.Anthropic()

# Create the helper. This call sends no request.
thread = client.beta.messages.thread(
    model="claude-opus-5-5",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="You are a support agent for Acme. Keep replies short.",
)

# Turn 1: the helper creates a thread and sends the full conversation
thread.send({"role": "user", "content": "Hi! I have a question about an order."})

# Turn 2: the helper continues the thread and sends only the new message
second = thread.send(
    {"role": "user", "content": "How long does standard shipping usually take?"}
)

for block in second.content:
    if block.type == "text":
print(block.text)トップレベルのcache_controlは任意です。付けると毎ターンでプロンプトキャッシュを求める指定になり、付けなければ、自分でキャッシュの印を付けない限り何もキャッシュされません(docs)。
threadフィールドを自分で付ける例(公式の例)
cURLやSDKのいつものcreateで書く時は、各リクエストに次のthreadを足します(docsに載っている形)。docsのPythonの例では、client.beta.messages.create(...)にthread={"type": "create"}とbetas=["message-threads-2026-08-12"]を付けて1ターン目を送り、2ターン目はsystemを外してthread={"type": "continue", "previous_message_id": first.id}を付けています。modelとcache_controlは1ターン目と同じ値です。
"thread": {"type": "create"}

"thread": {"type": "continue", "previous_message_id": "<previous id>"}
注意:本番環境で使用する前に、必ずテスト環境で動作確認してください。
ヘルパーには会話の全部を返すthread.messagesや、スレッドを写すthread.fork()などもあります(docsの表)。SDKのベータのtool runner(ツールの呼び出しのループをSDKが回す仕組み)も既定でスレッドを使い、tool_runner(..., thread=False)で使わない形にできます。
毎回送る物の決まりとキャッシュの印
threadを付けたリクエストの項目は、docsで3つの組に分かれています。ざっくり言うと、systemとtoolsはcreateだけ(replayの新しいcreateでも送る)、modelやthinkingは毎回同じ値、max_tokensやstreamは毎回変えてよい、の3つです。
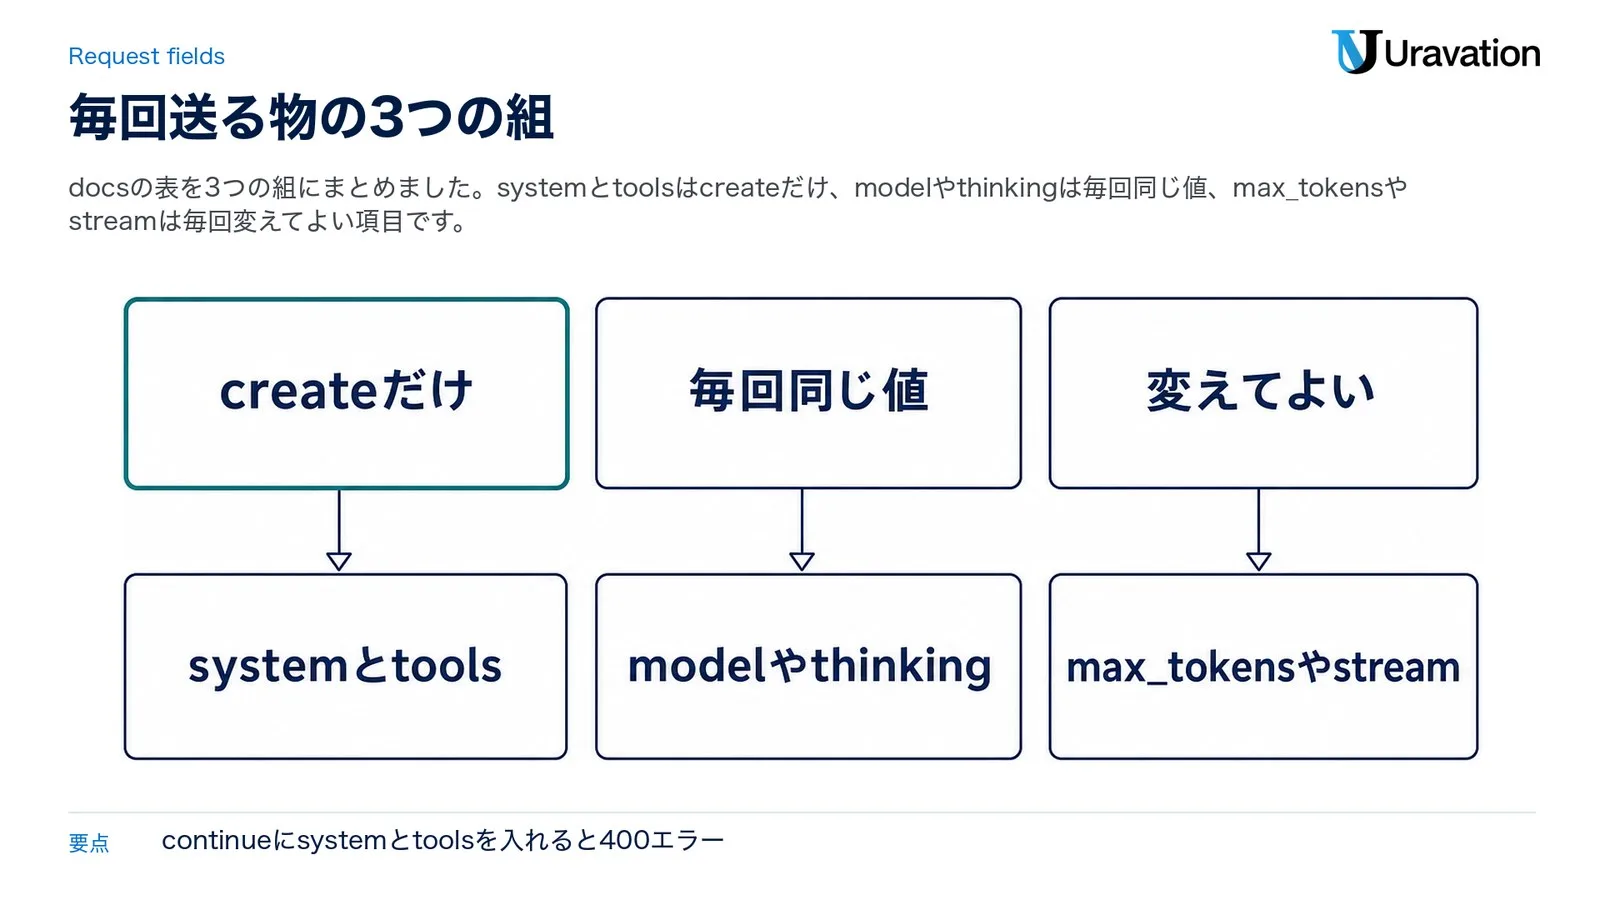
| 組 | 項目 | 決まり |
|---|---|---|
| createだけ | system、tools |
createのリクエストだけで送る(キャッシュの印を付けるならここで)。continueに入れると、nullでも400エラー |
| 毎回同じ値 | model、tool_choice、thinking、mcp_servers(各サーバーの認可トークンは除く)、context_management、output_config、containerの中のskills、トップレベルのcache_control、anthropic-betaの値の組み合わせ |
すべてのリクエストでcreateと同じ値を送る。違う値は400エラー(thread_fingerprint_mismatch)で、違う項目の名前がエラーのメッセージに出る |
| 変えてよい | max_tokens、stop_sequences、stream、metadata、service_tier、docsのこのページに名前の無いほかの項目 |
ターンごとに変えてよい |
- APIはMCPサーバー(Claudeから外部のツールを呼ぶための接続先)のURL、MCPの認可トークン、
containerのidを保存しないので、使うリクエストでは毎回mcp_serversとcontainerを送ります。 - createだけの項目や毎回同じ値の項目を変える時は、新しい値で会話の全部をcreateとして送り、新しいスレッドを始めます。
- サーバー側のfallback(分類器が断った時に別のモデルで答え直す機能・後の節で説明)を使うなら、
fallbacksをスレッドのすべてのリクエストに付けるか、どれにも付けないかをcreateの時に決めます。値は変えてよいですが、continueで足したり外したりすると400エラー(thread_fingerprint_mismatch)です。組織がthreadとfallbacksを併用できない時は、thread_unsupported_requestが返ります。 - Claude Fable 5.1・Mythos 5.1・Opus 5.5・Sonnet 5.5・Haiku 5.5では、systemかtoolsを変えると会話の中の
thinkingとredacted_thinkingのブロックが無効になり、createが400エラーを返すことがあります。避けるには、送る会話からこの2種類のブロックを外します(モデルはそれまでの推論なしで答えます)。Opus 5.5とSonnet 5.5のAPIの変更点は、Opus 5.5 APIの記事とSonnet 5.5 APIの記事にまとめています。
応答がstop_reason: "pause_turn"(Stop reasonsのdocsによると、ウェブ検索などサーバー側のツールを回すループが回数の上限に達して止まった状態)で終わった時は、その応答のidから空のmessages("messages": [])でcontinueします。404なら止まった応答も含めて全部をcreateで送ります。止まっている間に新しいuserのメッセージを送ると、APIが断ります。
キャッシュは自分で付ける
docsは「スレッドが代わりにプロンプトをキャッシュすることはない」と書いています。キャッシュの印(ブレークポイント)をどこに置くかは、スレッドが無い時と同じで自分で決めます。各ターンをキャッシュするなら、トップレベルのcache_controlをすべてのリクエストに同じ値で送ります。APIは各リクエストのmessagesのうちキャッシュできる最後のブロックにこれを当て、各ターンは前の会話をキャッシュから読み、新しいターンを書き込みます。prompt cachingのdocsは、この書き方を「automatic caching」と呼んでいます(自動なのは印を当てる場所で、トップレベルのcache_controlは自分で送ります)。
- 効くのは、会話がキャッシュできる最小の長さを超えてから。prompt cachingのdocsの表では、Opus 5.5・Sonnet 5.5・Haiku 5.5などが512トークンです。
- threadを付けたリクエストのcache_controlの印は4つまで。トップレベルの分も1つに数え、createで送ったsystemとtoolsの印はcontinueのたびに数えます。保存済みの前のメッセージの印は数えません。超えると400エラー(
thread_unsupported_request)です。 - 一度送った印は動かせず、外せません。replayの時は、自分で付けた前のメッセージの印を外し、最後のブロックに1つ残します。
prompt cachingのdocsでは、キャッシュの読み込みは基本の入力単価の一部の値段(倍率はモデルごとの表)で、5分のキャッシュの書き込みは基本の入力単価より25%高くなります。費用を左右するのはこちらで、message threadsではありません。また、スレッドの5分はAPIが応答を保存するたびに数え直しになるのに対し、キャッシュの既定の5分はキャッシュを書くか読むリクエストの開始から数え、応答の生成にかかった時間も含みます。prompt cachingのdocsの例では、応答に4分かかると、同じキャッシュを使う次のリクエストは、応答が終わってからおよそ1分以内に始める必要があります。同じ5分でも数え方が違います。
使えない機能と、続けてはいけない場面
threadには、組み合わせられない機能と、続けずに新しいcreateへ移る場面があります。使えない機能はdocsに一覧があり、新しいcreateへ移る場面はdocsの拒否・fallback・ストリーミングなどの節に書かれています。知らずに作ると400エラーや、続けられないターンが出ます。
threadで使えない機能(docsの一覧)
- Message Batches(リクエストをまとめて非同期で処理するAPI):threadを含む項目は、バッチの結果で
invalid_request_errorになる - トークン数え(送る前にトークン数を数えるAPI):threadを含めると400エラー。systemとtoolsを含む会話の全部を数える
- Compaction(会話を要約のブロックに置き換えて短くする機能):threadと使えず、
compactionパラメーターなどを付けると400エラー - Context editing(ツールの結果やthinkingを会話から消す機能):使えない。例外は
clear_thinking_20251015をkeep: "all"で使う場合だけ - HIPAA readinessを有効にした組織
- Inference hooksを有効にした組織:Inference hooksは、Claude Enterpriseの組織が推論の前に会話を自社のAIセキュリティのサーバーに送り、許可か拒否を受ける仕組み
対応しない機能を使うと、APIはたいてい400エラーのthread_unsupported_requestを返します。error.details.unsupportedがある時は、context_management・cache_control・fallbacks・hipaa・inference_hooksのどれかが入ります。知らない値なら、threadなしで会話の全部を送ります(docs)。
ZDRとHIPAAの対象外
message threadsは、ZDR(Zero Data Retention=APIが応答を返した後、プロンプトと応答を保存しない取り決め)とHIPAA readinessの対象外です。データ保持のdocsによると、ZDRの組織でも対象外の機能をAPIは止めず、使えばそのデータはZDRの外に出ることを選んだ扱いになります。ほかのZDRの対象の機能の扱いは変わりません。HIPAA readinessを有効にした組織では、APIがthreadのリクエストを断ります。なお、スレッドはファイルを参照で持つので、使う間は会話が使うファイルを消さずに残しておきます(docs)。
続けずに新しいcreateへ移る場面
- 拒否(refusal)の後:Refusals and fallbackのdocsによると、Fable 5.1・Opus 5.5・Sonnet 5.5・Haiku 5.5などには、リクエストを断ることがある安全の分類器があり、断る時はエラーではなく
stop_reason: "refusal"の普通の応答が返ります。APIが断られたターンを持っている可能性があり、continueでは消せないので、きっかけのターンを外すか言い換えて新しいcreateで始めます。 - fallbackのモデルが答えた回:サーバー側のfallback(分類器が断った時に、APIが同じリクエストを別のモデルで答え直すベータの機能・Claude APIではthreadと併用可)で別のモデルが答えた回は、スレッドが1つのモデルを保つため保存されず、そのidからは続けられません。
usage.iterationsにfallback_messageがあれば、その応答と次のメッセージを含めて全部を新しいcreateで送ります。同じリクエストをもう一度送るか、modelをfallbackのモデルにしてfallbacksを外した新しいスレッドにするかを選べます。同じリクエストを送る道では、sticky routing(fallbackの後の約1時間、同じ会話のcreateをfallbackのモデルへ直接回すことがある仕組み)で、毎ターン会話の全部を送ることになる場合があります(docs)。 - ストリーミングの途中:応答のidは
message_startのイベントで届きますが、続けるのはmessage_stopを受け取ってからです。continueのストリームがmessage_stopの前に切れたら同じcontinueをもう一度送り、thread_already_continuedかthread_continue_in_flightが返ったら全部をcreateで送ります。docsは「replayはいつでも安全」と書いています。 - 途中の書き換えと枝分かれ:スレッドは後ろに足していくだけ(append-only)で、1つの応答のidから続けられるのは1回だけです。前のメッセージを直したい時、枝分かれさせたい時、要約で置き換えたい時は、新しいcreateで始めます。
切れた時の戻し方|5つのエラーとSDKの役割
docsのエラーの表には5つのerror_codeがあり、どれもモデルが動く前にAPIが返します。トークンは使われず、スレッドとその期限も変わりません。error.typeは、400がinvalid_request_error、404がnot_found_errorです。
| 状態 | error_code | 意味 | すること |
|---|---|---|---|
| 404 | thread_not_found |
APIがスレッドを続けられない | 会話の全部を新しいcreateで送る |
| 400 | thread_fingerprint_mismatch |
毎回同じ値の項目が、スレッドに保存された値と違う | 同じ値で送る。変えるなら新しいスレッド |
| 400 | thread_already_continued |
1つの応答のidから続けられるのは1回だけ | 最新のidから続ける。その応答を受け取れていなければreplay |
| 400 | thread_continue_in_flight |
同じidからの別のcontinueがまだ動いている(多くは自分の前の試み) | 終わるのを待ってその応答のidから続けるか、replay |
| 400 | thread_unsupported_request |
threadが対応しない機能か組織の設定を使っている | その機能を外すか、threadなしで会話の全部を送る |
continueにprevious_message_idが無い時や、systemかtoolsを入れた時など、error_codeの付かない400エラーもあります。存在しないモデルを指定しても404が返るので、replayの前にerror.details.error_codeを確かめます。docsに載っているエラーの本文の例(cache_controlの印が5つあった時)は次の形です。
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "message": "thread: a maximum of 4 blocks with cache_control may be provided when `thread` is set. Found 5.",
    "details": {
      "error_code": "thread_unsupported_request",
      "unsupported": ["cache_control"]
    }
  },
  "request_id": "req_011CSHoEeqs5C35K2UUqR7Fy"
}
thread_not_foundになる主な原因
404の応答は理由を示しません。docsが挙げる原因は次のとおりです。
- スレッドの期限が切れた
- APIが前のターンに答えたが、保存しなかった(例:
max_tokensで途中で切れたツールの呼び出しで終わった応答) - 前の応答をfallbackのモデルが書いた
- 前の応答がまだ生成中
- 別の組織かワークスペース(同じ組織の中を分ける単位)、またはスレッドを作った主体と別のユーザーやサービスアカウントからのリクエスト
- 保存された会話が受け付けられない物を新しいメッセージが足した(例:画像の無かった会話に最初の画像を足す)
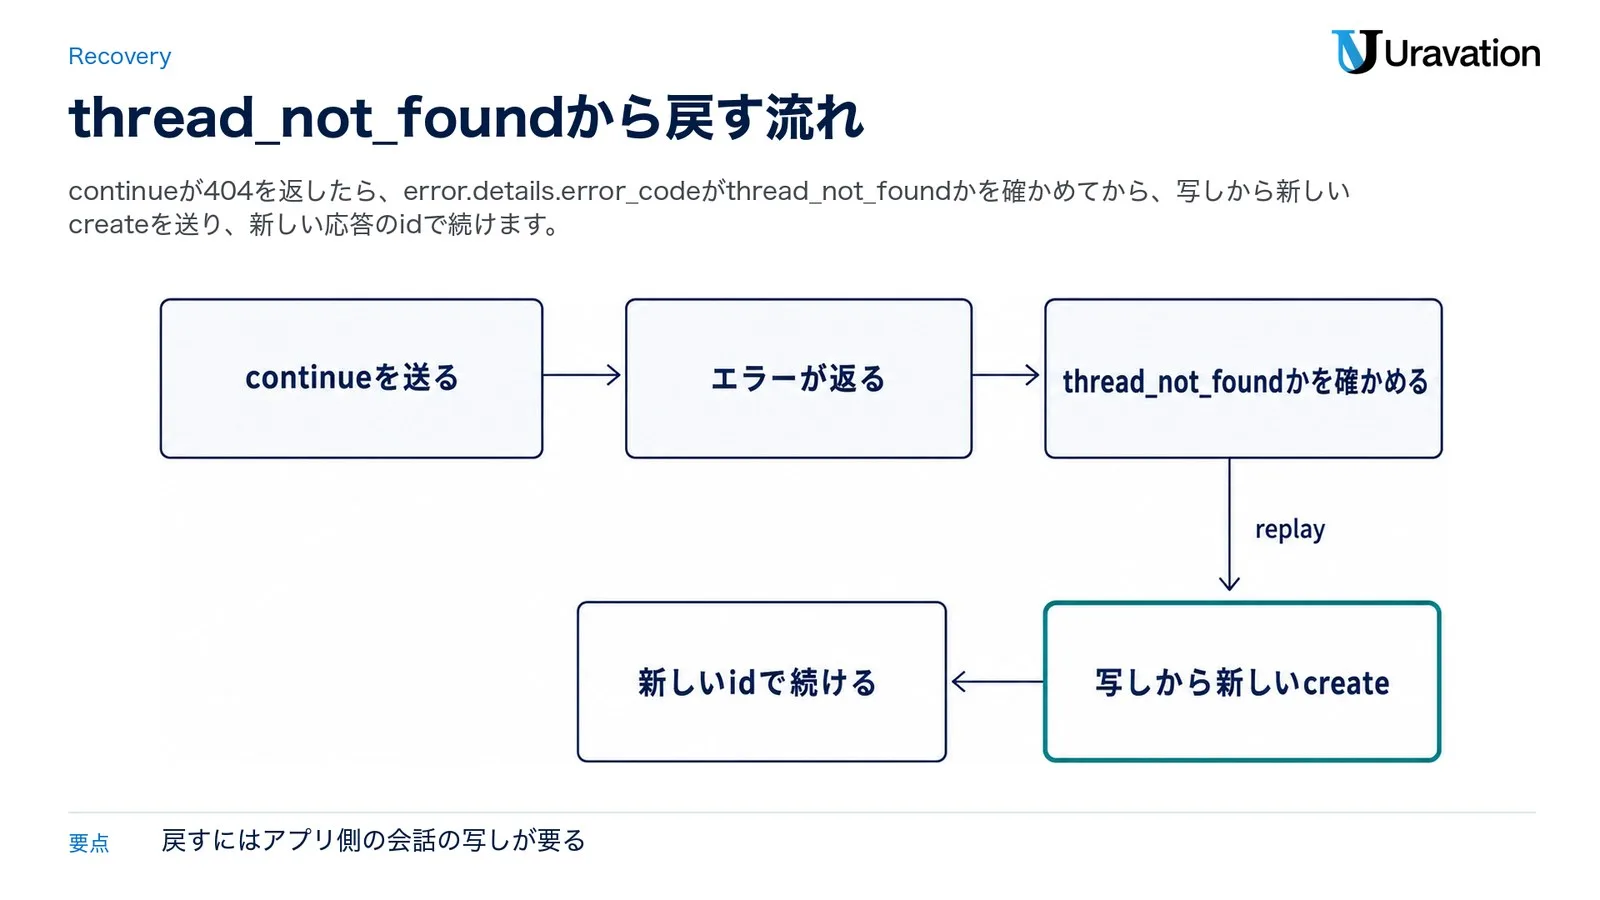
戻す流れ
戻す流れは、continueを送る、404エラーが返る、error.details.error_codeがthread_not_foundかを確かめる、写しから新しいcreate(systemとtoolsも付け、前のメッセージのcache_controlの印は外す)、新しいidで続ける、の順です。持ち主の違いで切れないよう、1つのスレッドのリクエストは同じAPIキーとワークスペースで送ります。Claude Platform on AWSでは、スレッドを作ったIAMロールかIAMユーザー(AWSの権限の単位)の認証情報で署名します。replayの直後のcontinueがまた404なら、とても大きな会話などをAPIが保存できない可能性があるので、threadなしで送ります。
SDKのヘルパーがやること・自分でやること
| 場面 | ヘルパーの動き | 自分ですること |
|---|---|---|
| thread_not_found・thread_already_continued・thread_continue_in_flight | 会話の全部を新しいcreateで1回送り直す(前のターンのcache_controlの印は外す) | replayの直後のcontinueもthread_not_foundの時にthreadなしへ切り替えるなら、unsupported_request_behaviorをcontinue_unthreadedにしてヘルパーを作る(付けないと毎ターンreplayする) |
| 拒否の後 | 断られたターンを残さず、次のターンで新しいスレッドを始める | 言い換えたメッセージを送る。ヘルパーを作る時に渡したメッセージやthread.append(...)で足したメッセージは残り、次のターンで一緒に送られるので、それが拒否のきっかけなら、そのメッセージを除いたthread.paramsから新しいスレッドを始める |
| fallbackのモデルが答えた後 | 404を待たずに、次のターンで新しいcreateを送る | fallbackのモデルへ移すなら、thread.params(ヘルパーの項目と会話の全部)から、modelをfallbackのモデルにし、fallbacksを外して新しいスレッドを始める |
| ストリームが途中で切れた | 届いた分を持ち、次のターンで全部をcreateで送る。自動では送り直さない | 中断したターンを送り直すなら、メッセージ無しでsend() |
| thread_fingerprint_mismatch・thread_unsupported_request | 処理せず、エラーのまま自分のコードに返す | 自分で処理する。thread_unsupported_requestの後にthreadなしで続けるなら、unsupported_request_behaviorをcontinue_unthreadedにしてヘルパーを作る。thread_fingerprint_mismatchなら、毎回同じ値の項目をcreateと同じ値にそろえるか、新しいスレッドを始める |
| プロセスが終わる時 | 写しはメモリにしか無い | 写しを自分で保存する |
入れる前の判断表
入れるかどうかは、会話の長さだけでなく、データの取り決め、使っている機能、アプリ側の作りで決まります。docsと発表の条件を、確かめる順に並べました。
| 確かめること | 入れてよい | 待つ・threadなしのまま |
|---|---|---|
| 会話の長さ | ツールの結果や画像が毎ターン増え、数十万トークンまで伸びるループ | 数往復で終わる短い会話(docsに使えない条件は無いが、効果の数字が出ていないので、threadあり・なしのTTFTを比べてから決める) |
| データの取り決め | ZDRの範囲で扱う必要が無いデータ | ZDRで扱う必要があるデータ、HIPAA readinessを有効にした組織 |
| 使っている機能・組織の設定 | Messages APIに1回ずつ送って答えを受け取る使い方(トークン数えは、threadを付けずにsystemとtoolsを含む会話の全部を数えれば使える) | Message Batches、Compaction、Context editingに頼る作り、Inference hooksを有効にした組織 |
| 会話の写し | アプリ側に全部のメッセージの写しを持てる | 会話がAPI側に残る前提の作り |
| fallback | 使わないか、fallbackの後に新しいcreateへ戻る作りにできる | fallbackの後も同じidで続ける前提の作り |
| 会話の編集 | 後ろに足していくだけ | 途中のメッセージを書き換える、枝分かれさせる作り |
| 使っている場所 | Claude API、Claude Platform on AWS、Claude Models on Google Cloud(Anthropic managed)、Microsoft Foundry | Amazon Bedrock、Claude Models on Google Cloud(Google managed)(対応表に無い) |
Claude Codeを使っているだけなら、発表のとおり大半の利用者で既定で有効になっています。どの利用者で有効にならないか(ZDRの取り決めがある組織での扱いを含む)は、発表にもmessage threadsのdocsにも書かれていません。この表が要るのは、Claude APIで自分のエージェントを作っている場合です。
よくある失敗パターンと対策
失敗1:continueで会話の全部を送ってしまう
❌ いつもの組み立てのまま、continueにも前の応答を含めた会話の全部を入れる。
⭕ continueは新しいメッセージだけにします。前の応答から始まるcontinueはエラーになり、送り直したメッセージは二重に入るか、エラーになります。
失敗2:continueにsystemやtoolsを入れる
❌ 毎回同じ関数でリクエストを作り、continueにもsystemとtoolsを入れる(nullでも同じ)。
⭕ systemとtoolsはcreateだけで送ります。入れると400エラーです。変えたい時は、新しい値で会話の全部をcreateとして送ります。
失敗3:会話の写しを持たずにAPI側に頼る
❌ スレッドが会話を持っているからと、アプリ側の履歴を捨てる。
⭕ 全部のメッセージの写しを持ち、replayの道を最初から作ります。スレッドは最後のリクエストから5分で切れ、保存されたかどうかは次のcontinueを送るまで分かりません。
失敗4:message_startで届いたidですぐに続ける
❌ ストリーミングで、message_startのイベントでidが届いた時点で次のcontinueを送る。
⭕ message_stopを受け取ってから続けます。早いcontinueは404になることがあります。SDKのヘルパーで読むのを途中でやめる時は、Pythonならwithのブロックを抜けて、スレッドを次のターンに使える状態にします。
よくある質問
message threadsを使うと料金は安くなりますか?
安くはなりません。docsは「threadは料金とレート制限を変えない」と書き、発表も「Claudeは毎ターン会話の全部を読むので、トークンの使用量は同じ」と説明しています。費用を抑えたい時は、プロンプトキャッシュを別に設定します。
message threadsはどうやって使い始めますか?
ベータのヘッダーmessage-threads-2026-08-12を付け、最初のリクエストに"thread": {"type": "create"}を、次からは"thread": {"type": "continue", "previous_message_id": "<前のid>"}を足します。continueでは前の応答より後の新しいメッセージだけを送り、systemとtoolsは入れません(nullでも400エラー)。SDKのthreadヘルパー(Pythonならclient.beta.messages.thread(...))を使うと、ヘッダーとcreate・continueの切り替えをヘルパーが行います。使えるのはClaude API、Claude Platform on AWS、Claude Models on Google Cloud(Anthropic managed)、Microsoft Foundryで、HIPAA readinessかInference hooksを有効にした組織ではAPIがthreadのリクエストを断ります。
Amazon BedrockやGoogle Cloudでも使えますか?
2026年11月3日時点のdocsの対応表に入っているのは、Claude API、Claude Platform on AWS、Claude Models on Google Cloud(Anthropic managed)、Microsoft Foundryの4つです。Amazon Bedrockと、Google Cloudの「Google managed」は入っていません。Google Cloudでは、SDKのクライアントがAnthropicGoogleCloudならAnthropic managed、AnthropicVertexならGoogle managedです。AWSでは、AnthropicAWS(ベータ)ならClaude Platform on AWS、AnthropicBedrockMantleかAnthropicBedrockならAmazon Bedrockです。
ZDRの取り決めがある組織でも使えますか?
message threadsはZDRの対象外です。データ保持のdocsによると、ZDRの組織でもAPIは止めず、使えばそのデータはZDRの外に出ることを選んだ扱いになります。SDKのベータのtool runner(ツールの呼び出しのループをSDKが回す仕組み)は既定でスレッドを使い、tool_runner(..., thread=False)で使わない形にできます(docs)。HIPAA readinessを有効にした組織では、APIがthreadのリクエストを断ります。
ユーザーが5分以上返事をしないとどうなりますか?
スレッドは最後のリクエストから5分で切れ(APIが応答を保存するたびに数え直し)、5分以上空くと次のcontinueは404(thread_not_found)になります。アプリ側の写しから会話の全部を新しいcreateで送り直せば続けられ、SDKのthreadヘルパーはこの送り直しを1回、代わりに行います。ただしヘルパーの写しはメモリにしか無いので、返事を待つ間にプロセスが終わる作りなら、写しを自分で保存しておきます。
まとめ
message threadsは、長い会話で毎回の送り直しを減らし、TTFTを下げるMessages APIのベータ機能です。料金とトークンの使用量は変わりません。ZDRとHIPAA readinessの対象外で(ZDRの組織でもAPIは止めず、使えばそのデータはZDRの外に出る扱いになり、HIPAA readinessを有効にした組織ではAPIが断ります)、Message Batches・トークン数え・Compaction・Context editing(一部の設定を除く)とは組み合わせられません。速くなった数字はAnthropicが発表したClaude Codeの例だけなので、自分のエージェントでの効き方は、threadあり・なしのTTFTを比べて確かめます。
- 今日:自分のエージェントの1回のリクエストが何トークンあるか、ZDRやHIPAA readinessの取り決めがあるか、使っている場所が対応表に入っているかを確かめる
- 今週:会話の写しを持ったまま、create・continue・replayの3つの動きを試験の環境で組む
- 今月:長い会話のTTFTをthreadあり・なしで比べ、5つのエラーの扱いをログで確かめてから本番に広げる
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Make long-running agents faster with message threads — Anthropic(2026年11月2日・参照日 2026-11-03)
- Message threads — Claude Platform Docs(参照日 2026-11-03)
- Claude Platform release notes(November 2, 2026 の項) — Claude Platform Docs(参照日 2026-11-03)
- Prompt caching — Claude Platform Docs(参照日 2026-11-03)
- API and data retention — Claude Platform Docs(参照日 2026-11-03)
- Refusals and fallback — Claude Platform Docs(参照日 2026-11-03)
- Stop reasons and fallback — Claude Platform Docs(参照日 2026-11-03)
- Session threads — Claude Platform Docs(参照日 2026-11-03)
- Claude Models on Google Cloud — Claude Platform Docs(参照日 2026-11-03)
- Claude Platform on AWS — Claude Platform Docs(参照日 2026-11-03)
- Inference hooks — Claude Platform Docs(参照日 2026-11-03)
- anthropic-sdk-python v2.2.0 — GitHub Releases(2026年10月23日・参照日 2026-11-03)