2026年9月20日時点の結論:Cactus Needle 3 は、スマートフォン・ウェアラブル・ロボット・スマートホーム・車載・マイコンで動かすことを前提にした8〜29MBの1ファイルのモデルです。汎用の会話能力を捨てて、ツール呼び出し・構造化抽出・テキスト埋め込みの3つだけに絞っています。ライセンスはApache-2.0、重みと各プラットフォーム向けエンジンは Hugging Face で公開されています。
クラウドに出せない業務データを端末内で構造化する用途では、今日から評価を始められる段階にあります。ただし「小さいのに賢い」という期待で入ると外します。公式が示しているのは「モバイルのツール呼び出しで10倍規模のモデルを上回り、抽出で2〜3倍規模のモデルに並ぶ」という狭いタスク上の主張であり、推論・含意・日本語での信頼度スコアは公式自身が弱点として明記しています。
対象読者は、エージェントの入力前処理をどこで行うか決めようとしている開発者・PM。今日やることは全面採用の判断ではなく、自分のプロダクトのツール定義を3つ書いて、手元で通るかを見ることです。
エージェントを業務に載せるとき、最初に詰まるのはモデルの賢さではなく、たいてい「このテキストをクラウドに出していいのか」でした。請求書、社内通知、問診票、設備のアラート。中身は定型に近いのに、外部APIに投げる稟議が通らないという理由だけで、前処理の自動化が止まる。
2026年9月18日、Cactus Compute が公開した Needle 3 は、その前処理だけを端末の中で完結させることを狙ったモデルです。同日の Show HN は229ポイントを集めましたが、コメント欄はデモが期待どおり動かないという報告で埋まりました。賛否が同時に立ち上がったという意味で、Bend 2 の公開と似た週になっています。
この記事では、公式サイト・GitHub の README・Hugging Face のモデルカード・公式ガイド6本を突き合わせて、Needle 3 が公式に何を主張しているのか、そのうち何がまだ検証されていないのかを線引きします。筆者はこの記事のために本番環境へ組み込んでおらず、数値はすべて公式が公開している値です。
Needle 3とは|3つの仕事と公式スペック
Needle 3 は、Cactus Compute が「Simple Attention Network」と呼ぶ独自構成の上に作られた、小型デバイス向けの基盤モデルです。公式サイトの説明によれば、モデル全体が単一のバイナリとして配布され、そのサイズは構成によって8〜29MBに収まります。
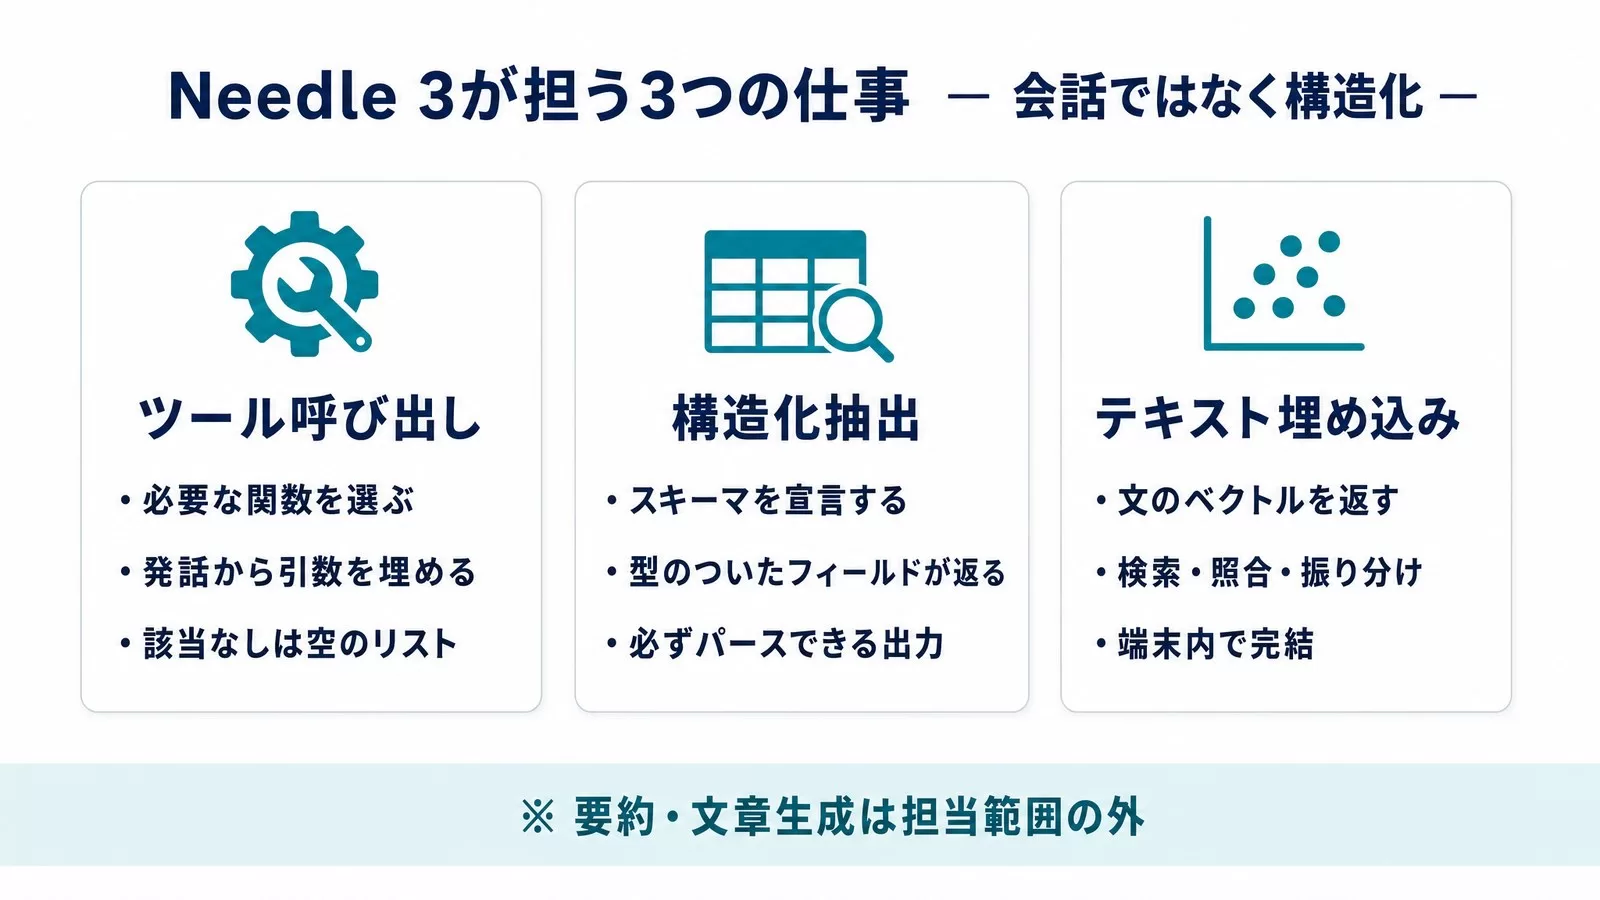
公式が挙げている仕事は3つだけです。
- ツール呼び出し:アプリが公開している関数群を渡すと、必要なものを選び、ユーザーの発話から引数を埋める。2つ頼めば順序どおり2つの呼び出しが返り、どのツールでも対応できない依頼には推測ではなく空のリストが返る
- 構造化抽出:欲しい形(スキーマ)を宣言して雑多なテキストを渡すと、型のついたフィールドが返る。請求書、予約、通知、フォームなど。デコード側の文法が「必ずパースできる出力」を保証する
- テキスト埋め込み:同じモデルが文のベクトルを返すので、検索・照合・振り分けを端末内で完結できる
公式サイトのモデル欄に記載されている主要なスペックは次のとおりです。
| 項目 | 公式記載の値 |
|---|---|
| 入力 | テキストのプロンプト+ツール定義または抽出スキーマ |
| 出力 | ツール呼び出しまたは抽出結果の構造化JSON |
| パラメータ数 | 29M〜121M(うち70.8Mはエングラムテーブル) |
| 量子化 | CQ2(Cactus Quants・1重みあたり2.125ビット) |
| 学習データ | 独自の構造化データセット3,600億トークン |
| 速度(Raspberry Pi 5) | デコード400〜4,000トークン/秒、プリフィル1,000〜10,000トークン/秒 |
| ライセンス | Apache-2.0(GitHub・Hugging Face とも) |
| 語彙 | SentencePiece BPE・8,192ピース |
速度に幅があるのは、後述する「ラダー」のどの深さで動かすかで変わるためです。公開状況は2026年9月20日時点で、GitHub リポジトリ cactus-compute/needle が約11,700スター、Hugging Face の Cactus-Compute/needle3 が累計36,096ダウンロード。モデルカードのリポジトリ作成日は2026年9月16日です。
仕組み|ラダー構造と文法でJSONを強制する
Needle 3 の設計で押さえるべき点は2つあります。ひとつは1セットの重みが複数のモデルを兼ねること、もうひとつは出力形式をモデルに守らせるのではなく強制することです。
深さを選べる「知能のはしご」
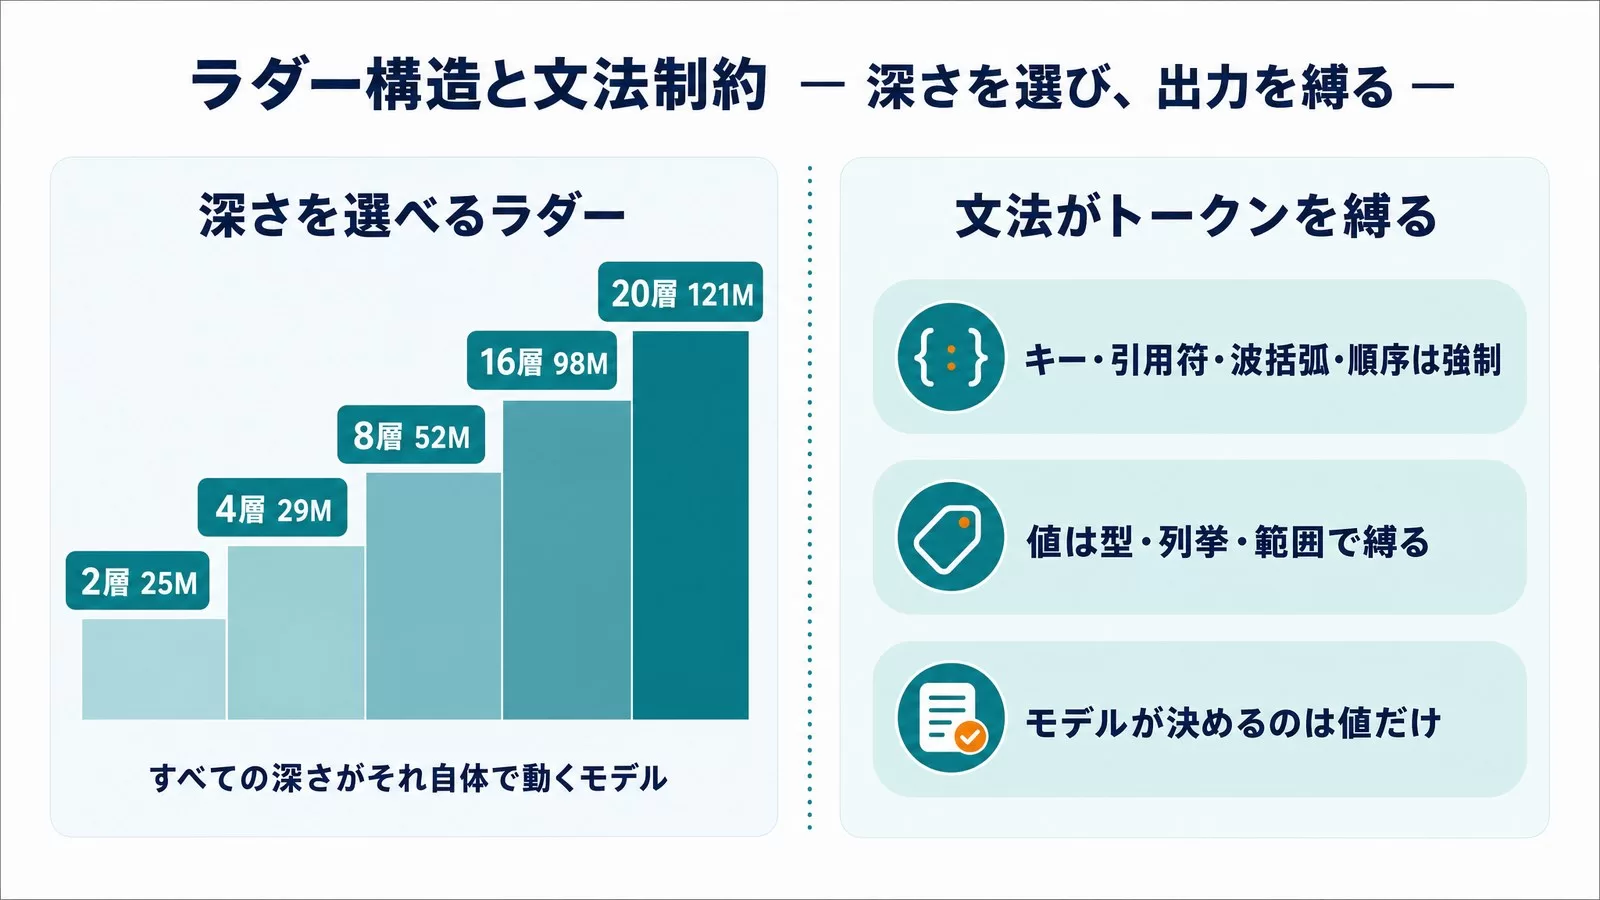
公式は Needle 3 を「Laddered Simple Attention Network」と呼んでいます。2層から20層まで、すべての深さがそれ自体で動くモデルとして学習されているため、開発者は端末の余力に合わせて深さを切り出せます。公式ガイドが示す対応は次のとおりです。
| 深さ | パラメータ数 | 想定される置き場所 |
|---|---|---|
| 2層 | 25M | マイコン級・安価なIPカメラ・ルーター |
| 4層 | 29M | ウェアラブル(この深さで約8MB) |
| 8層 | 52M | Raspberry Pi・小型ボード |
| 16層 | 98M | スマートフォン |
| 20層 | 121M | 出荷される標準構成(29MB) |
パラメータの大半がエングラム(ハッシュ化したn-gramメモリ)のテーブルに置かれているため、深さを削っても記憶量はあまり減らず、1トークンあたりの計算量だけが減る、というのが公式の説明です。アーキテクチャ図の注記では、同じ構成のTransformerと比べて1トークンあたりのMFLOPsが2分の1以下とされています。
この構造の狙いは、汎用性能ではなくファインチューニング前提の運用にあります。公式は「DroidCall でのファインチューニングにより、すべてのサブネットワークが18〜36ポイント向上し、4層以上では DeepSeek V4 Flash を上回る」と書いています。逆にいえば、素のまま使う想定のモデルではありません。
スキーマから作った文法がトークンを縛る
もうひとつの核が、デコード時の文法制約です。公式ガイドの説明では、渡したスキーマから最初のトークンを出す前にバイトレベルの文法がコンパイルされ、キー・引用符・波括弧・順序は予測されるのではなく強制される。値も型・列挙・範囲・パターン・長さで縛られます。モデルが決めるのは値だけで、その値も制約からは出られません。
加えて公式は「すべての引数はリクエストのスパン(文字列の一部)である」という契約を掲げています。ユーザーが言っていない値は呼び出しに入らず、必須項目に対応する根拠がなくデフォルトもない場合、呼び出しは suppressed_calls に退避され function_calls は空で返ります。数値はとくに厳格で、公式ガイドは「整数か数詞だけが根拠として数えられるので、”a bit warmer”(もう少し暖かく)はどんな数値の根拠にもならない」と明記しています。
スキーマで出力を縛るという発想そのものは、ドキュメント抽出・パースの設計で扱ったRAGの取り込み層と同じです。Needle 3 が変えているのは、その層をクラウドAPIではなく端末に置けるという一点に絞られます。
クラウドAPI・ローカルLLM・正規表現との位置関係
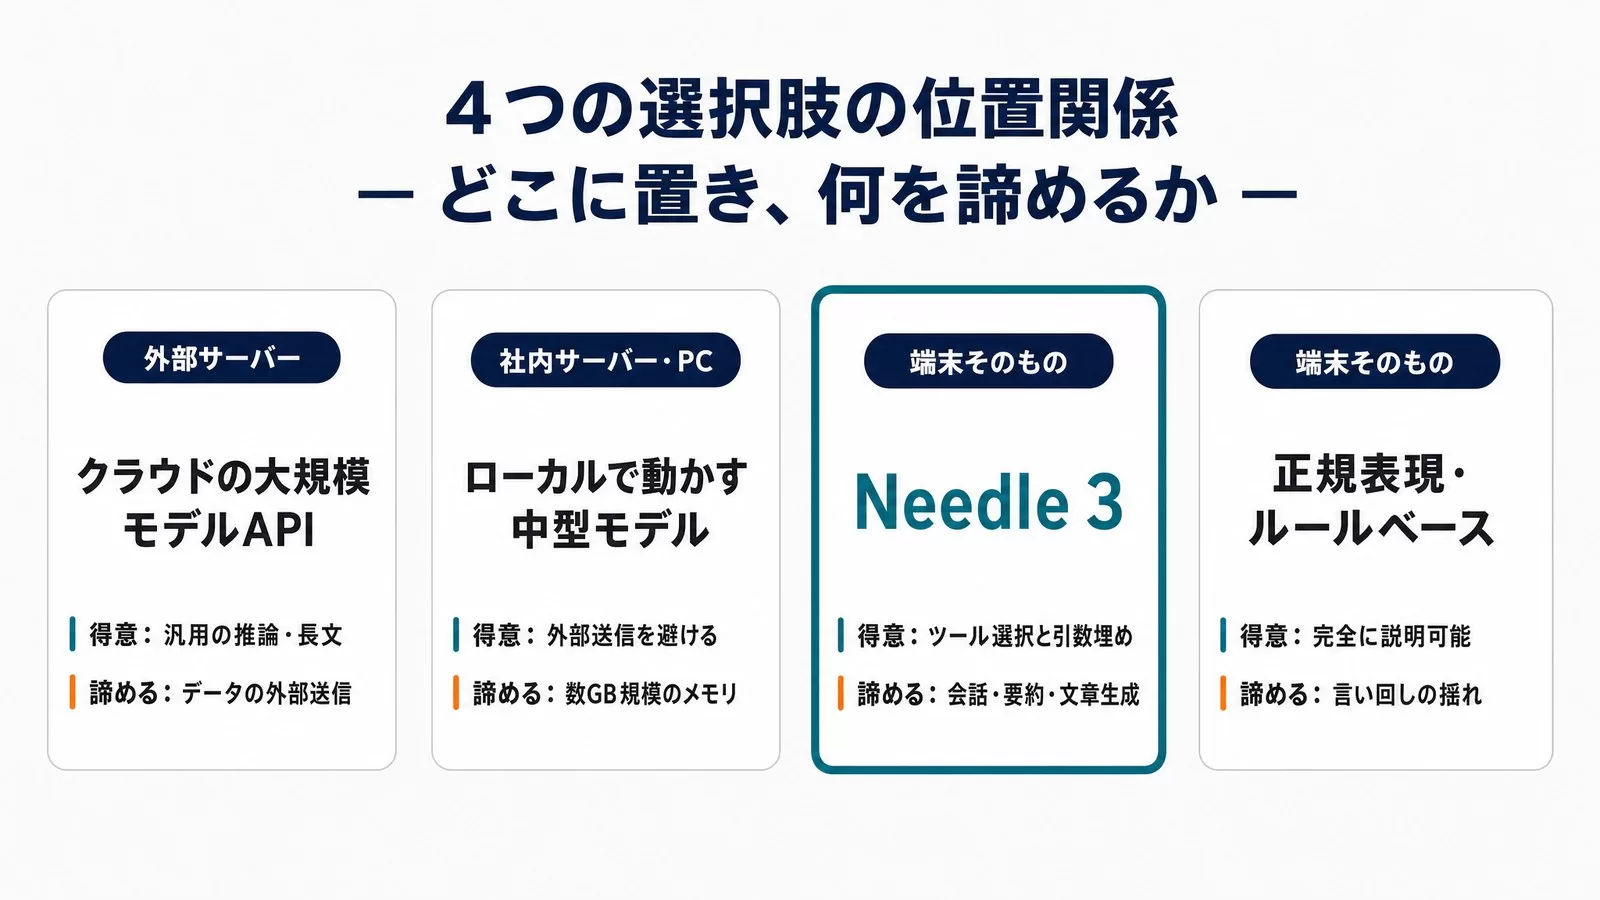
「小さいモデルが大きいモデルに勝つ」という見出しは毎月流れてくるので、まず何と比べて何を諦めているのかを整理します。公式サイト自身が「汎用の会話能力をトレードしている」と書いており、Show HN でも創業者が「Needle はタスク特化のモデルで、狭いタスク集合でのみ良い性能を出すよう学習している」と応答しています。
| 選択肢 | 置き場所 | 得意 | 諦めること |
|---|---|---|---|
| クラウドの大規模モデルAPI | 外部サーバー | 汎用の推論・長文・含意の理解 | データの外部送信・通信の遅延と可用性・従量課金 |
| ローカルで動かす中型モデル | 社内サーバー・PC | 汎用性を保ったまま外部送信を避ける | 数GB規模のメモリとGPU。載らない端末には置けない |
| Needle 3 | 端末そのもの | ツール選択と引数埋め・スキーマどおりの抽出 | 会話・要約・文章生成・込み入った含意の解釈 |
| 正規表現・ルールベース | 端末そのもの | 決め打ちの書式なら最速・完全に説明可能 | 言い回しの揺れ。表現ごとにルールが増え続ける |
創業者は Show HN で、「LAN上の8B〜27Bモデルは、それが載るハードウェアなら汎用タスクで勝つ。Needle はそれが載らないハードウェア、たとえば素のARMv7、安価なIPカメラのMIPS32チップ、RISC-V、腕時計のためのもの」と述べ、さらに「端末内モデルではコストよりも可用性と遅延がレバーになると分かった」と書いています。PCやサーバーの余力がある環境なら、Ollamaでローカルモデルを動かす構成のほうが素直です。
端末側で完結させる流れ自体は、エッジで動くマルチモーダルLLMから続くものですが、Needle 3 はサイズの桁がひとつ違い、担当する仕事も会話ではなく構造化に限定されています。「小型の汎用モデル」ではなく「構造化専用の部品」として見るほうが実態に合います。
公式が示しているベンチマークの中身
公式サイトは6つの評価セットを挙げています。数値そのものは対話的なグラフで提示されているため、ここではどの課題で測っているかを示します。
| 評価セット | 課題 | 規模と判定 |
|---|---|---|
| Mobile Actions | スマートフォンへの指示をAndroidのインテントに変換 | 961件・呼び出しの完全一致 |
| DroidCall | 2つの呼び出しが必要な依頼を含むスマートフォン操作 | 200件・順序どおりの完全一致 |
| BFCL v4 | Berkeley function calling(シングルターン) | 3,641件・AST一致。無関係な依頼では呼び出さない |
| DSTC8 | 対話のスロットをスキーマへ流し込む | 1,813ターン・フィールドF1 |
| SNIPS | スキーマを与えた上での正解スロット埋め | 700件・フィールドF1 |
| SNIPS 7-way | 7つの中からスキーマを選んでから埋める | 700件・フィールドF1 |
比較条件も公式に書かれています。Needle 3 のサブネットワークは出荷されるCQ2ビットのバイナリ、比較対象のモデルはvLLM上のf16、DeepSeek V4 Flash はクラウドAPI経由です。量子化したモデルと非量子化のモデルを同じ図に並べている点は、読むときに意識しておく必要があります。
触ってみる最短手順(公式の例)
以下はすべて公式サイトと公式Pythonドキュメントに掲載されているコードです。筆者が実行して得た出力ではなく、公式が示している例であることを明記します。
導入はPythonパッケージ1つで、エンジンと重みは初回に Hugging Face から取得されてキャッシュされます。
pip install cactus-needle              # ランタイム
pip install "cactus-needle[train]" # ファインチューニング用(JAXを含む)例1:関数をデコレートしてループまで回す。シグネチャが引数の型を、docstringがツールの説明を与えます。run() はモデルに呼び出しを選ばせ、関数を実行し、結果を戻して最終応答を返します。
import needle

@needle.tool
def get_weather(city: str):
    "Get the current weather for a city."
    return {"city": city, "temp_c": 27, "sky": "clear"}

agent = needle.Needle(tools=[get_weather])
print(agent.run("what's it like in Lagos right now?")["results"])
# [{'city': 'Lagos', 'temp_c': 27, 'sky': 'clear'}]例2:必ず届かせたい意図に正規表現のトリガーを付ける。説明文だけでは言い回しを列挙しきれない場合、triggers に正規表現を渡すと、一致したリクエストはそのツールに絞られ、呼び出しが必須になります。
from typing import Literal

@needle.tool(triggers=[r"\b(turn|switch|power|flip)\b.*\b(on|off)\b", r"\btoggle\b"])
def control_device(device: str, action: Literal["on", "off", "toggle"]):
    "Switch or toggle any named smart-home device."
    return {"device": device, "action": action}

agent = needle.Needle(tools=[control_device, get_weather])
agent.complete("toggle the garage door")
# function_calls [{"name": "control_device",
# "arguments": {"device": "garage door", "action": "toggle"}}]例3:抽出は「ツールが1つだけのツール呼び出し」。Pydanticのモデルを渡すと型のついたオブジェクトが返ります。公式ガイドによれば、宣言したツールが1つだけのとき文法はその名前の呼び出しだけを許すため、スキーマ適合が要求ではなく保証になります。
from pydantic import BaseModel

class Invoice(BaseModel):
    vendor: str
    total: float
    due_date: str
    po_number: str | None = None

invoice = needle.extract("Invoice from Acme Corp, $1,200.00, due 2026-09-01", Invoice)
print(invoice.vendor, invoice.total) # -> Acme Corp 1200.0例4:信頼度で「実行・確認・拒否」を振り分ける。応答には校正済みのヘッドが出す confidence が必ず載ります。エンジンは0.1を下限として自動で足切りし、それより下の呼び出しは suppressed_calls へ退避されます。上の帯をどう切るかは開発者側の設計です。
r = agent.complete(user_text)
calls = r["function_calls"]
held  = r["suppressed_calls"]

if calls and r["confidence"] >= 0.7:
    execute(calls)                        # 確信あり: そのまま実行
elif calls or held:
    confirm(calls or held, r["reasoning"])  # 迷い: 呼び出しを見せて確認
else:
say("I can't do that here") # 該当なし: 断る1ターンの応答は次の形のJSONで返ります。peak_ram_mb や decode_tps が毎回入っているため、実機での挙動を推測ではなく計測で確かめられます。
{
  "type": "call",
  "success": true,
  "function_calls": [ { "name": "set_lights",
      "arguments": { "room": "living room", "on": true, "brightness": 30 } } ],
  "reasoning": "'living room' -> room; 'dim' -> on true, brightness 30",
  "confidence": 0.94,
  "prefill_tps": 4300.0,
  "decode_tps": 850.0,
  "peak_ram_mb": 28.5
}
実機へ出すときは、プラットフォームのフォルダを取得して重みを横に置きます。公式が挙げる配布先は13のフォルダで、それぞれに1MB未満のエンジンが入っています。
needle build --platform macos-arm64
needle build --platform linux-arm64 --layers 8 --out ./pi
needle build --platform linux-mipsel --layers 2 --out ./camera
needle build --lora adapter.safetensors --out tuned.cact対応はmacOS、Linux(x86-64・ARM64・ARMv7・RISC-V・MIPS32el)、Windows(x64・ARM)、Android(arm64・armv7・riscv64)、iOS、watchOS、tvOS、ブラウザとNode向けのwasm、WASIコンポーネントです。ネイティブ向けはCLIランナーと静的ライブラリ、ヘッダが同梱され、needle.h は needle_init・needle_complete・needle_embed を公開しています。
エージェント開発での使いどころ|入力の前処理に置く
ここまでの仕様を踏まえると、Needle 3 の置き場所はかなりはっきりします。エージェントの頭脳としてではなく、入口のパーサーとして置くのが公式の設計に沿った使い方です。
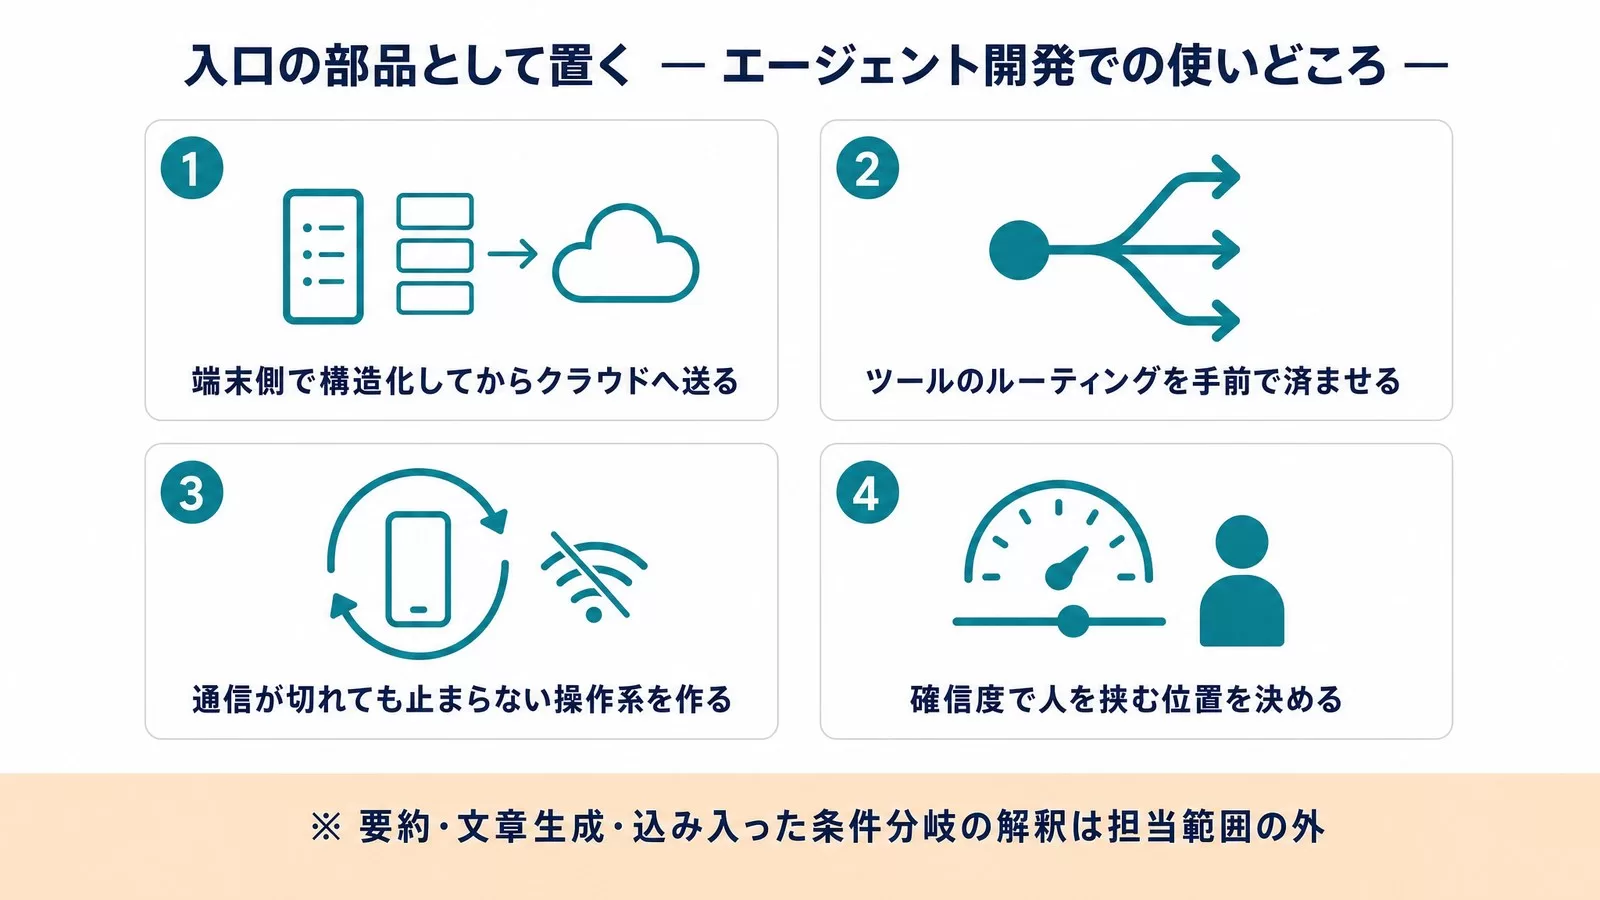
具体的には、次のような形が候補になります。
- 端末側で構造化してからクラウドへ送る:自由文を先にスキーマへ落としてしまえば、クラウドへ渡すのは型のついたフィールドだけになる。原文そのものを外に出さずに済む経路を作れる
- ツールのルーティングを手前で済ませる:
agent.embed()が返すベクトルでツールを照合し、候補を絞ってから大きなモデルに渡す。公式APIには大規模なツールカタログ向けに埋め込みを永続化するtool_index_pathがある - 通信が切れても止まらない操作系を作る:照明・空調・録画の開始停止のような、遅延とオフライン耐性が価値になる操作を端末内で閉じる
- 確信度で人を挟む位置を決める:ロック解除や送金のように取り返しのつかない操作は、スコアが高くても確認を挟む設計にする
逆に、要約・文章生成・込み入った条件分岐の解釈は担当範囲の外です。エージェントの判断そのものを小さなモデルへ移す話ではなく、判断の手前に検証可能な層を置くという設計に近い。機械が判定できる関門を重ねるという考え方は、証明でAIのコードを止める言語の議論とも地続きです。
ツール設計の指針も公式ガイドに具体的に書かれており、そのまま実装の基準として使えます。1つのアクションにつき1つのツールを作り、カテゴリ名ではなくカバーする動作で説明する。列挙値はユーザーが実際に使う語で命名する(["increase", "decrease"] は「turn up」「louder」に一致するが ["inc", "dec"] は一致しない)。値の書式は説明文に例示する。そして、公式が挙げている落とし穴として、「office」という名前の部屋は「off」を含むすべてのリクエストを汚染するため、公式のスマートホーム環境では「study」を使っている、という記述があります。
注意点|ライセンス・データ・公式主張と未検証の線
導入判断の前に確認しておくべき点を、公式に書かれている範囲で整理します。
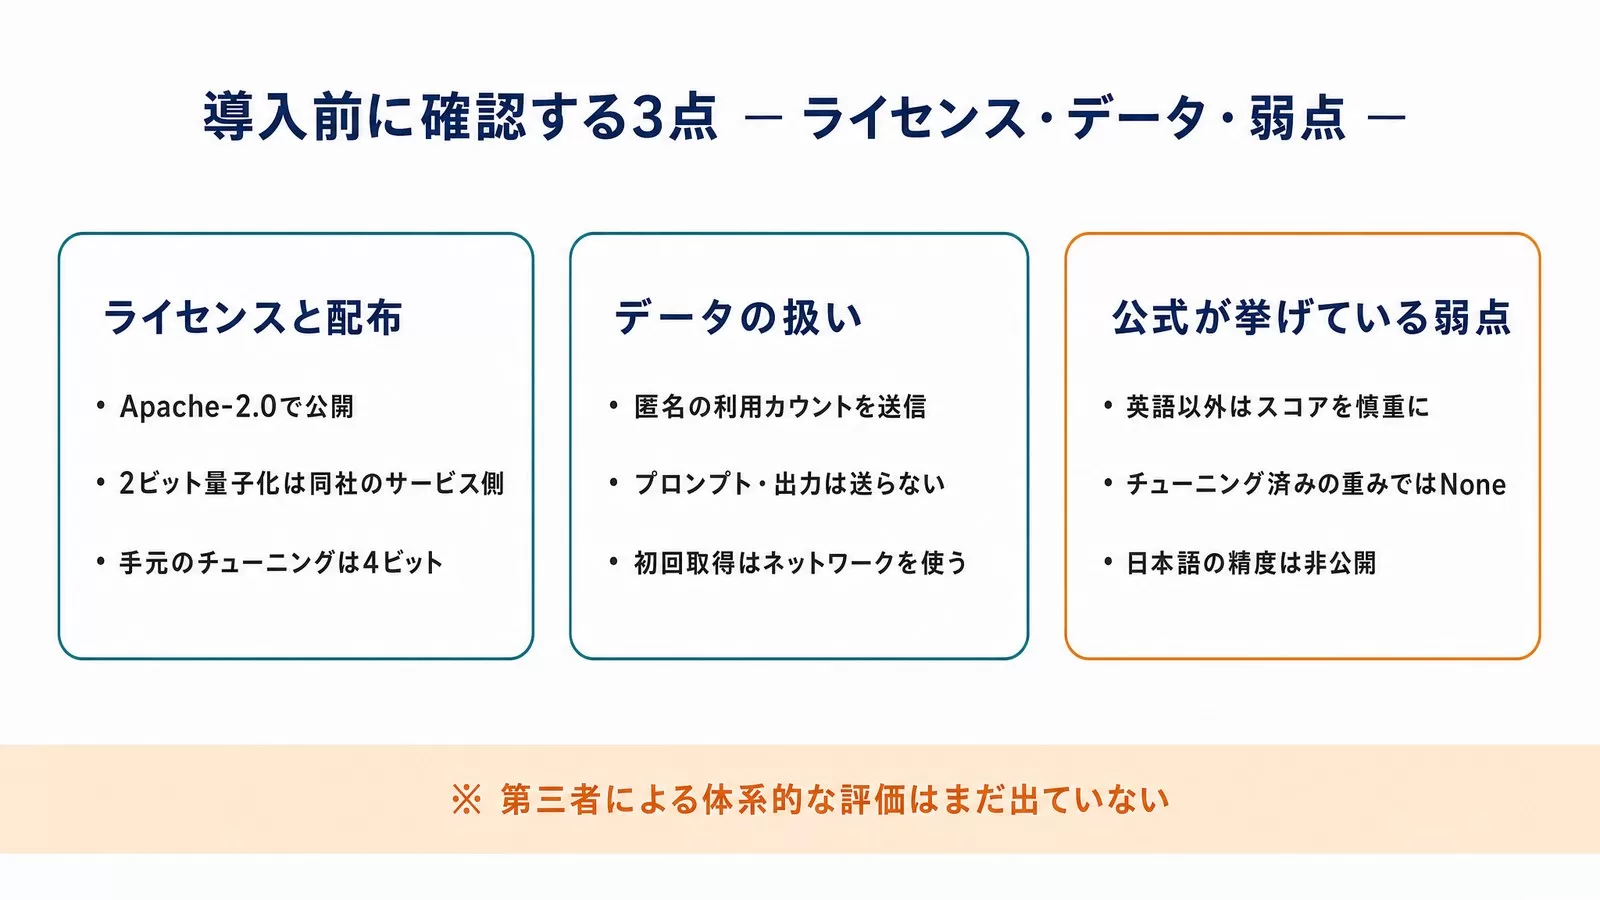
ライセンスと配布
GitHub の cactus-compute/needle と Hugging Face の Cactus-Compute/needle3 はいずれも Apache-2.0 です。リポジトリには20層の needle3.cact、ファインチューニング用の needle3.safetensors チェックポイント、プラットフォームごとのエンジンが含まれます。一方で、出荷モデルの背後にある2ビットの事後学習・量子化と、Cactus独自のデータセットは「Cactus Platform」という同社のサービス側にあると明記されています。手元でのファインチューニングは4ビットで学習・書き出しを行う、というのが公式の説明です。無償のモデルと有償の基盤が分かれている構造は、評価の段階で把握しておく必要があります。
データの扱い
Pythonパッケージは匿名の利用カウント(関数名・パッケージバージョン・OS・ランダムなインストールID)を送信します。公式ドキュメントには「プロンプト・出力・データは決して送らない」と書かれており、NEEDLE_TELEMETRY=0 または DO_NOT_TRACK=1 で無効化でき、CI環境は自動的に除外されるとされています。オフライン要件のある案件では、この送信を止めた状態で検証するのが前提になります。エンジンと重みの初回取得もネットワークを使うため、閉域で使うなら事前にフォルダを取得しておく運用が必要です。
公式自身が挙げている弱点
ここが最も重要です。日本語や英語以外での利用を考えているなら、公式の注記を先に読むべきです。信頼度スコアのガイドには、次の2点が明記されています。
- 校正済みヘッドはベース模型に対して校正されているため、
weights=でチューニング済みの重みを読み込むと更新されない。パッケージはconfidenceをNoneとして報告し、構築時に一度警告を出す - 英語以外での運用ではスコアを慎重に扱うべきで、正しいスペイン語の呼び出しが0.0と計測されたことがある
つまり、日本語の業務テキストに対して信頼度スコアで自動実行・確認・拒否を振り分ける設計は、そのまま持ち込めるとは限りません。日本語での精度について、公式は数値を公開していません。2026年9月20日時点で、日本語データでの第三者による評価結果は確認できていません。
公開直後の議論で指摘されていること
Show HN のコメント欄では、サイト上のデモで意図どおりの呼び出しが返らなかったという報告が複数寄せられました。「もっと明るく」「両方のドアを施錠して」が通らなかったという報告や、トイレの照明を点けさせようとして掃除機やコーヒーメーカーが呼ばれたという報告が並んでいます。これらは第三者が公開の場で行った試行の報告であり、体系的な評価ではありません。
創業者はこれに対し、デモがあくまで初期設定のプリセットであること、ツールとその説明は編集できることを説明したうえで、「含意や関係の理解はモデルにとって難しい」「reasoning は汎用LLMのような真の推論ではなく、モデルが自分で生成する接地(grounding)に近い」と応答しています。別のコメントでは「これはスイスアーミーナイフではなく、コルク抜きだ」という整理も出ており、公式の位置づけとおおむね一致します。
一方で、実務での採用検討も報告されています。あるコメントでは、Webアプリに小型モデルを埋め込んで自然言語インターフェースを提供する評価を進めており、Needle はアーキテクチャの独自性から有力候補だが、評価用データセットを作り終えるまで結論は出さない、と書かれています。評価データを自分で用意してから判断するという姿勢が、現時点では最も妥当です。
失敗パターン4つ
公式ドキュメントに書かれている設計ルールと、公開直後の議論で表面化した論点から、避けたい形を4つ挙げます。
❌ 何でもできる汎用ツールを1つ用意する
control_home(device, action, value) のような包括的なツールは、判断を3つの自由記述の引数へ押し込みます。公式ガイドは「モデルは名前を選ぶのが最も得意で、決定の代わりになる自由記述の値を作るのが最も苦手」と明言しています。
⭕ 1アクション1ツールに割る:set_thermostat(temperature)、set_lights(room, on, brightness)、lock_door(door) のように分けると、判断が「名前を選ぶこと」に変わり、残る引数はすべて発話のスパンになります。
❌ 発話に出てこない値を必須引数にする
必須でデフォルトのない引数に根拠がないと、呼び出し自体が退避されて空の結果が返ります。「たまに動かない」の多くはこれです。
⭕ スキーマにデフォルトを置く:リクエストが何も指定しないときはエンジンがデフォルトを埋めます。発話に現れない値は、そもそも必須にしない設計にします。
❌ 信頼度スコアをそのまま日本語の自動実行に使う
公式自身が、英語以外ではスコアを慎重に扱うべきだと注記しています。校正が効いていない言語で0.7を閾値にすると、正しい呼び出しが落ちるか、逆に落ちるべきものが通ります。
⭕ 自前の評価データで閾値を決める:自社の実データから数十件の正解セットを作り、スコアの分布を見てから帯を切ります。チューニング済みの重みではスコアが None になる点も、分岐の前に確認しておきます。
❌ 素のモデルの性能で採否を決める
Needle 3 はファインチューニング前提の設計です。公式が示す「4層以上で DeepSeek V4 Flash を上回る」という主張は、DroidCall でチューニングした後の話です。
⭕ フルモデルで開発してから深さを決める:公式が推奨する手順は、Pythonでフルモデルに対して開発し、一度ファインチューニングし、そのうえで端末クラスごとに許容できる深さをビルドする、という順序です。
よくある質問
Needle 3は日本語で使えますか?
入力としての日本語について、公式は対応言語の一覧も日本語での精度も公開していません。公式が明示しているのは、信頼度スコアが英語以外で信頼しにくいという点だけです(正しいスペイン語の呼び出しが0.0と計測された例が挙げられています)。日本語の業務データで使うなら、自社データでの評価セットを作って確かめる工程が必須になります。
クラウドのAPIと比べて何が節約できますか?
創業者はShow HNで「端末内モデルではコストよりも可用性と遅延がレバーになる」と述べています。通信が切れても止まらないこと、往復の待ち時間がなくなること、原文を外部へ送らずに済むことが主な利点です。金額の比較について公式は数値を示していません。
オフラインの端末でも動きますか?
動きます。ただしエンジンと重みは初回にHugging Faceから取得してキャッシュされる仕組みなので、閉域で使うには事前に needle build --platform または needle download でフォルダを取得しておく必要があります。公式ガイドにはネットワークのない環境向けの手順が別項目として用意されています。
商用プロダクトに組み込めますか?
GitHubリポジトリとHugging Faceのモデルカードはいずれも Apache-2.0 です。ただし出荷モデルの背後にある2ビット量子化と独自データセットは同社のCactus Platform側にあると公式に記載されているため、フルの学習パイプラインまで自前で再現する前提であれば、その範囲を事前に確認しておくのが安全です。
今すぐ本番に入れるべきですか?
2026年9月20日時点では、評価を始める段階です。公開から数日しか経っておらず、第三者による体系的な評価はまだ出ていません。公開直後のデモに対する指摘も複数あります。自社のツール定義を3つほど書いて、自社の実データで通るかを見る——そこまでを今週の作業に置くのが現実的な進め方です。
まとめ
Cactus Needle 3 は、2026年9月18日に公開された8〜29MBの端末内モデルで、ツール呼び出し・構造化抽出・テキスト埋め込みの3つに用途を絞っています。Apache-2.0で公開され、13のプラットフォーム向けにエンジンが用意され、2層から20層まで深さを選べる構造を持ちます。
押さえるべきは3点です。①公式の性能主張は「モバイルのツール呼び出しと抽出」という狭い範囲のもので、会話や要約は担当範囲の外にあります。②数値の多くはファインチューニング後の話であり、素のまま評価すると設計意図から外れます。③信頼度スコアは英語以外で慎重に扱うべきだと公式自身が明記しているため、日本語での運用は自社データの評価セットなしに設計できません。
クラウドに出せないテキストを端末内で型のついたデータへ落とす、という一点に用途を限れば、今日から評価を始める価値はあります。判断を任せる相手としてではなく、入口の部品として見る——それが公式の設計にも、公開直後の議論にも、いちばん素直に沿う読み方です。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。端末内処理とクラウドの切り分けを含め、自社データでどこまで自動化できるかの設計からご相談いただけます。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Needle 3 — Automation Foundation Model For Tiny Devices — Cactus Compute 公式リリースページ(2026-09-18・参照日: 2026-09-20)
- cactus-compute/needle(README・Apache-2.0) — GitHub(参照日: 2026-09-20)
- Cactus-Compute/needle3 モデルカード — Hugging Face(参照日: 2026-09-20)
- What Devices Are Supported on Needle — Cactus Compute 公式ガイド(2026-09-18・参照日: 2026-09-20)
- Leveraging Needle’s Confidence — Cactus Compute 公式ガイド(2026-09-18・参照日: 2026-09-20)
- Structured JSON Extraction with Needle — Cactus Compute 公式ガイド(2026-09-18・参照日: 2026-09-20)
- How to Design Tools for Needle 3 — Cactus Compute 公式ガイド(参照日: 2026-09-20)
- Needle Python Docs — Cactus Compute 公式ドキュメント(参照日: 2026-09-20)
- The .cact Format — Cactus Compute 公式ガイド(2026-09-18・参照日: 2026-09-20)
- Show HN: Cactus Needle 3: 8-29MB automation models can match DeepSeek V4 Flash — Hacker News(2026-09-18・参照日: 2026-09-20)
著者:佐藤傑(さとう・すぐる)。株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。著書『AIエージェント仕事術』。100社以上の企業向けAI研修・導入支援を手がけています。ご質問・ご相談はお問い合わせフォームからどうぞ。