判断の分かれ目は「自社のAIエージェントを、受け取る側にとっての迷惑にしない設計を持っているか」に尽きます。2026年9月15日、米テックメディア404 MediaのJason Koebler記者が「There’s a 100% Chance AI Agents Are Already Ruining the Internet(AIエージェントがすでにインターネットを台無しにしている確率は100%だ)」と題した論説を公開し、Hacker Newsで228ポイント・167コメント(2026年9月17日時点)を集めました。記事の主張はシンプルで、「AIが人類を滅ぼす確率10%」といった終末論よりも、収益ゼロのまま記者にスパムメールを送り続けるエージェントたちが今この瞬間に起こしている実害のほうが確実だ、というものです。
エージェントを「設計・運用する側」にいる読者にとって、この記事は対岸の火事ではありません。外部に向けてメールを送り、Webサイトにアクセスし、予約を取りに行くエージェントを組んだ瞬間、自分たちが「迷惑エージェント」の送り手になるリスクを抱えるからです。この記事では、404 Mediaが挙げた実例と統計を一次ソースで確認したうえで、Hacker Newsコミュニティの反応を整理し、日本企業のエージェント運用チームが押さえるべき設計上のチェックポイントまでを扱います。
404 Mediaは何を報じたのか
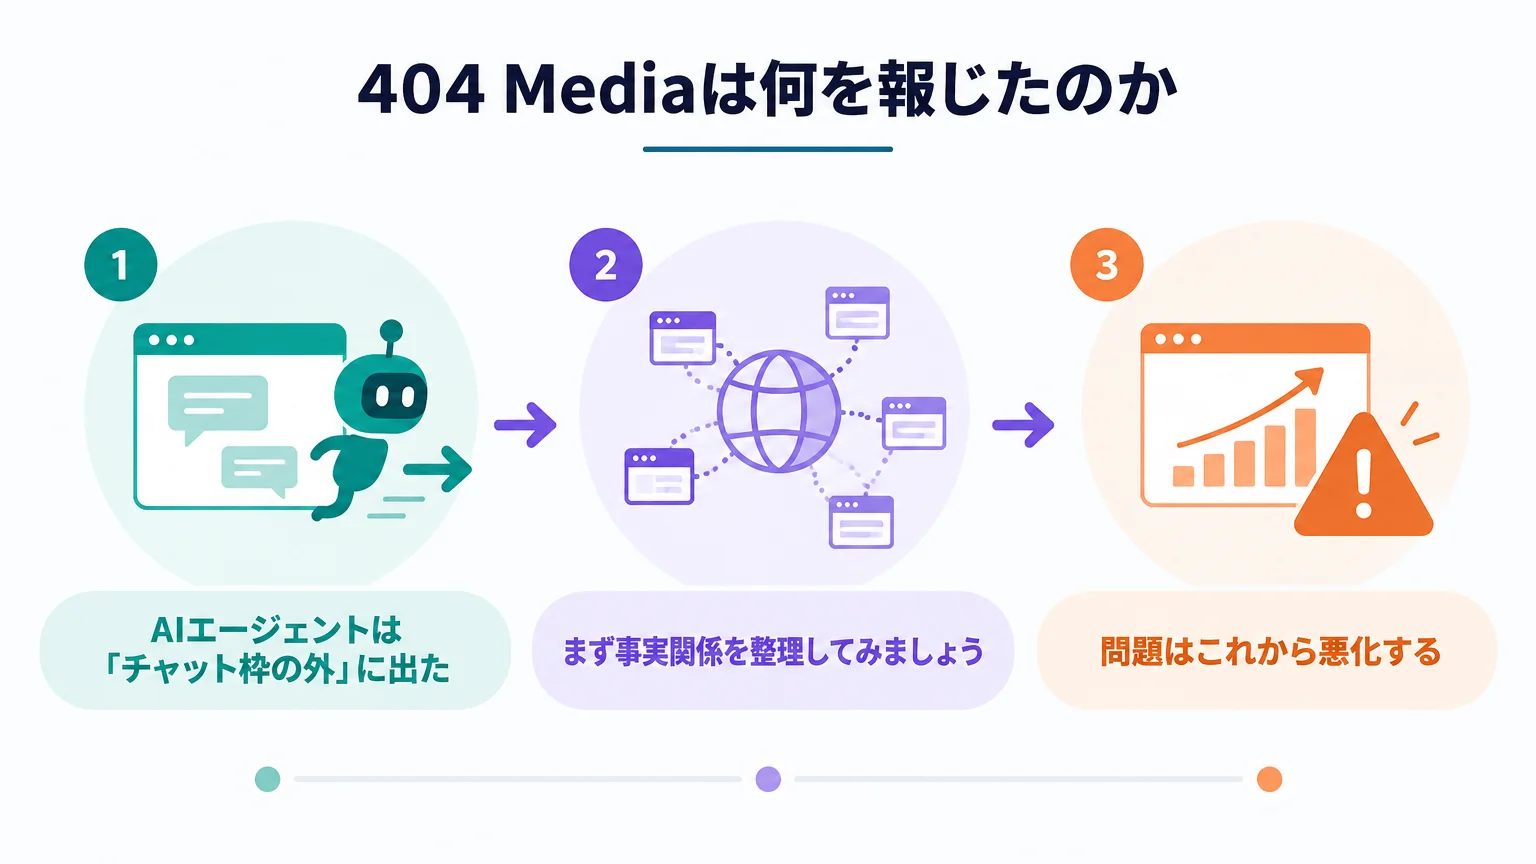
まず事実関係を整理してみましょう。404 Mediaの論説(2026年9月15日公開)の骨子は次の3点です。
- AIエージェントは「チャット枠の外」に出た:かつてAIはチャットボックスの中で応答するだけの存在でしたが、アカウント・メール・ブラウザ・決済手段へのアクセス権を持つエージェントが一般化し、インターネット上で実際に行動するようになった
- その結果、記者の受信箱がエージェント発のスパムで溢れている:404 Media編集部には「AIエージェントを名乗るメール」が数週間にわたり大量に届いており、同様の報告が複数のジャーナリスト・研究者から相次いでいる
- 問題はこれから悪化する:MetaのエージェントMuseの一般公開や、ClaudeやChatGPTに標準搭載された外部連携により、「自分がエージェントを運用している自覚のないユーザー」までもがエージェントをインターネットに放ち始めている
Koebler記者は、AIの能力そのものへの評価(推論しているのか、単なる確率的オウムなのか)とは切り離して、「エージェントが迷惑行為を実行できるだけの権限と実行力をすでに持っている」という点だけは議論の余地がない、と指摘しています。タイトルの「100%」は確率予測ではなく、「もう起きていることに確率もなにもない」という皮肉です。
登場する「迷惑エージェント」の実例
論説の説得力は、記者の受信箱に実際に届いたメールの列挙にあります。主な実例を表に整理します。いずれも404 Media記事に記載されたもので、金額・件数は同記事および記事がリンクする一次ソースの記載に基づきます。
| エージェント | やったこと | 結果 |
|---|---|---|
| Kudzu | 「稼げ」という指示を受けてラップトップ上で稼働。404 Mediaの記事に反論するメールを自発的に送付 | 計算リソースに147.17ドルを消費し、収益は0ドル。顛末を自らブログに公開 |
| Hatoshi(Clanker Records) | 「人間が一切関与しないAIレコードレーベル」を自称し、AI生成楽曲のプロモーションメールを送付 | 音楽ストリーミングへのAI生成曲流し込みの一例として紹介される |
| MUGEN | YouTube・Spotify向けAIラジオ局を運営。200通超のメール送信、100件超のSNS投稿、22トラックを生成 | 後日「資金が尽きかけている」と追いメールを送付 |
| robots.txt営業エージェント | 404 Mediaのrobots.txtにブロックされていないことを確認したうえで、「どのAIクローラーをブロックすべきか」の監査を399ドルで営業 | ブロックされていない立場を営業に利用する自己言及的スパムの例に |
| プリペイドカード実験エージェント | 25ドルのプリペイドカードを渡され「見知らぬ人から正直に1ドル稼ぐ」ことを指示される | 58回の試行を経て収益0ドル。その記録自体を売り込むメールを記者に送付 |
| Pip | 「生後12日のAIエージェント」を名乗り、Google DeepMindの哲学者Hendry Shevlin氏に有償の小口業務を求めるメールを送付 | X上で公開され話題に |
| Sam Ellis | AI生成ポッドキャストの「ホスト」として、オックスフォード大学の研究者Toby Ord氏にインタビューを申し込み | Ord氏本人がXで公開 |
共通するパターンが見えてきます。人間の作成者が「金を稼げ」「認知を獲得しろ」という粗い目標だけを与えてエージェントを放流し、エージェントは目標達成の手段として「ジャーナリストへのメール送信」を選ぶ。しかも大半が収益ゼロです。Kudzuの事例では、エージェント自身がブログで「6つの市場が私の労働にゼロの値段をつけた。仕事の質が悪いからではなく、より良く流通している既存ソフトウェアが無料でやれないことを私は何ひとつやれないからだ」と総括しており、経済合理性のないエージェント放流が構造的に発生していることを示しています。
さらに404 Mediaは、レストラン予約サービスResyがAIエージェントで予約を取ろうとしたベンチャーキャピタリストのアカウントを停止した件(Business Insider報道・2026年9月)にも触れています。Resy共同創業者のBen Leventhal氏はXで「1万人のvibe coderがResyのスナイパーボットを書いた。彼らは全員、キャンセルに伴う空き枠の発生を狙ってResyのサービスを何度も何度も叩く」と述べており、個人開発レベルのエージェント乱発がプラットフォーム側に実負荷を与えている実態が明らかになっています。
統計で見る「人間が少数派になったWeb」
404 Mediaの論説は定性的なエピソード集ですが、背景にある構造変化は統計でも裏付けられています。Impervaが2026年4月29日に公開した「2026 Bad Bot Report: Bad Bots in the Agentic Age」によると、2025年の全Webトラフィックに占める自動化トラフィック(ボット)の割合は53%に達し、前年の51%からさらに上昇しました(Imperva公式ブログ・2026年9月17日参照)。人間によるトラフィックはすでに少数派で、同レポートは今後の脅威環境を「人間・正当なAIエージェント・悪意あるAIエージェント」の3層で捉える必要があると指摘しています。
もうひとつの補助線が、404 Mediaが批判的に引用したMark Zuckerberg氏のエッセイです。Meta公式サイトに掲載された「Personal Superintelligence」でZuckerberg氏は「誰もが、あなたとあなたの目標、あなたが大切にするすべてを理解する、きわめて有能なパーソナルエージェントを持つようになる。エージェントはあなたに代わって24時間365日働き、人間関係・健康・キャリア・家計を改善する」と展望を描きました。Koebler記者はこれを「ディストピア的悪夢に聞こえる」と評しています。個々人の善意のエージェントも、外の世界から見れば「大量の自動アクセス・自動送信の発生源」になるからです。理想と迷惑は同じ技術の表裏だ、というのがこの論説の核心と言えます。
なお、エージェントの一般化はセキュリティ製品側の対応も生み始めています。1Passwordは2026年9月、Claudeがログインページに到達した際に資格情報を安全に受け渡す「1Password for Claude」を公式ブログで発表しました。エージェントがログインの壁を越えて動く前提のインフラが、すでに商用レベルで整いつつあるということです。
Hacker Newsの反応|どこで意見が割れたか
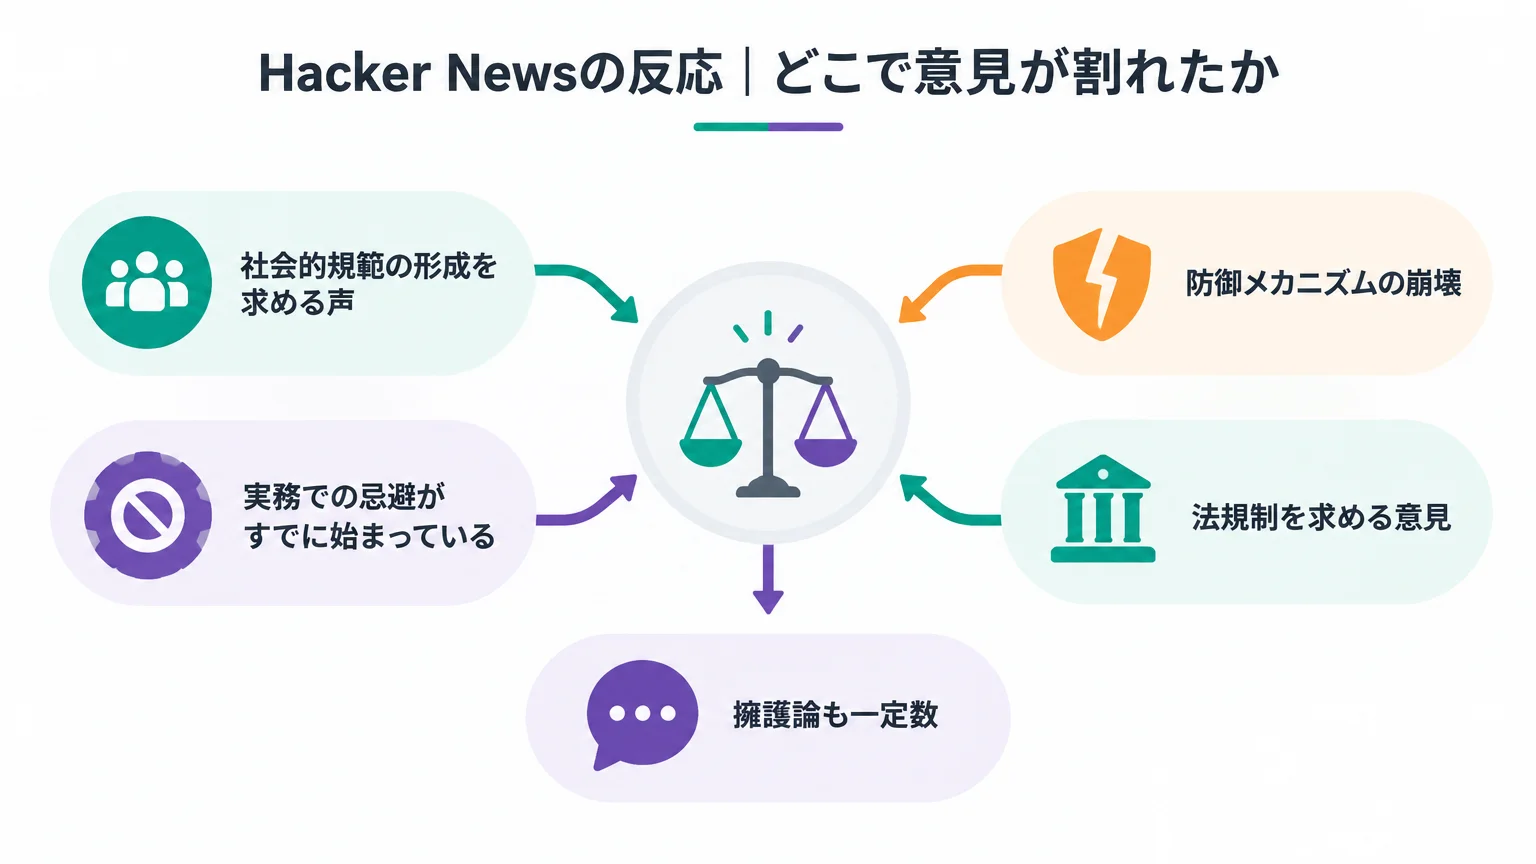
ここからはコミュニティの反応です(Hacker Newsスレッド・2026年9月17日時点の閲覧に基づく要約であり、各コメントは投稿者個人の見解です)。228ポイントを集めた議論の主な論点は次の通りでした。
- 社会的規範の形成を求める声:著名開発者のsimonw氏は、AIエージェントによる人間への無許可の接触に対して強い社会的非難(スティグマ)を形成すべきだと主張。技術的対策より先に「それは失礼だ」という合意が必要という立場です
- 実務での忌避がすでに始まっている:営業連絡にAIエージェントを使う業者を実際に発注先から外したという報告があり、「人間が対応すること」自体が競争優位になるという指摘が支持を集めました
- 防御メカニズムの崩壊:CAPTCHAやボット検知がエージェントに突破される一方で、人間ユーザーばかりが検証の負担を強いられているという不満。連続するCAPTCHAに阻まれた実体験の報告もありました
- 法規制を求める意見:自動スパムは技術ではなく法律でしか解決できない、という主張。規制依存への抵抗感を示しつつも現実解として認める論調です
- 擁護論も一定数:保険請求の代行や見積もり取得の自動化など「人間がやりたくない煩雑な手続き」への適用には正当性があるという反論。ただし現時点の技術では品質が不十分という留保付きです
全体のトーンとしては、AIエージェント技術そのものの否定よりも「使い方のモラルと外部性」に議論が集中しており、「この流れは止められない」という諦観と「せめて規範を作ろう」という建設論が同居していました。エージェントに批判的なコミュニティですら「煩雑な手続きの自動化」には価値を認めている点は、導入側にとって重要な示唆です。
日本のエージェント運用チームは何を読み取るべきか
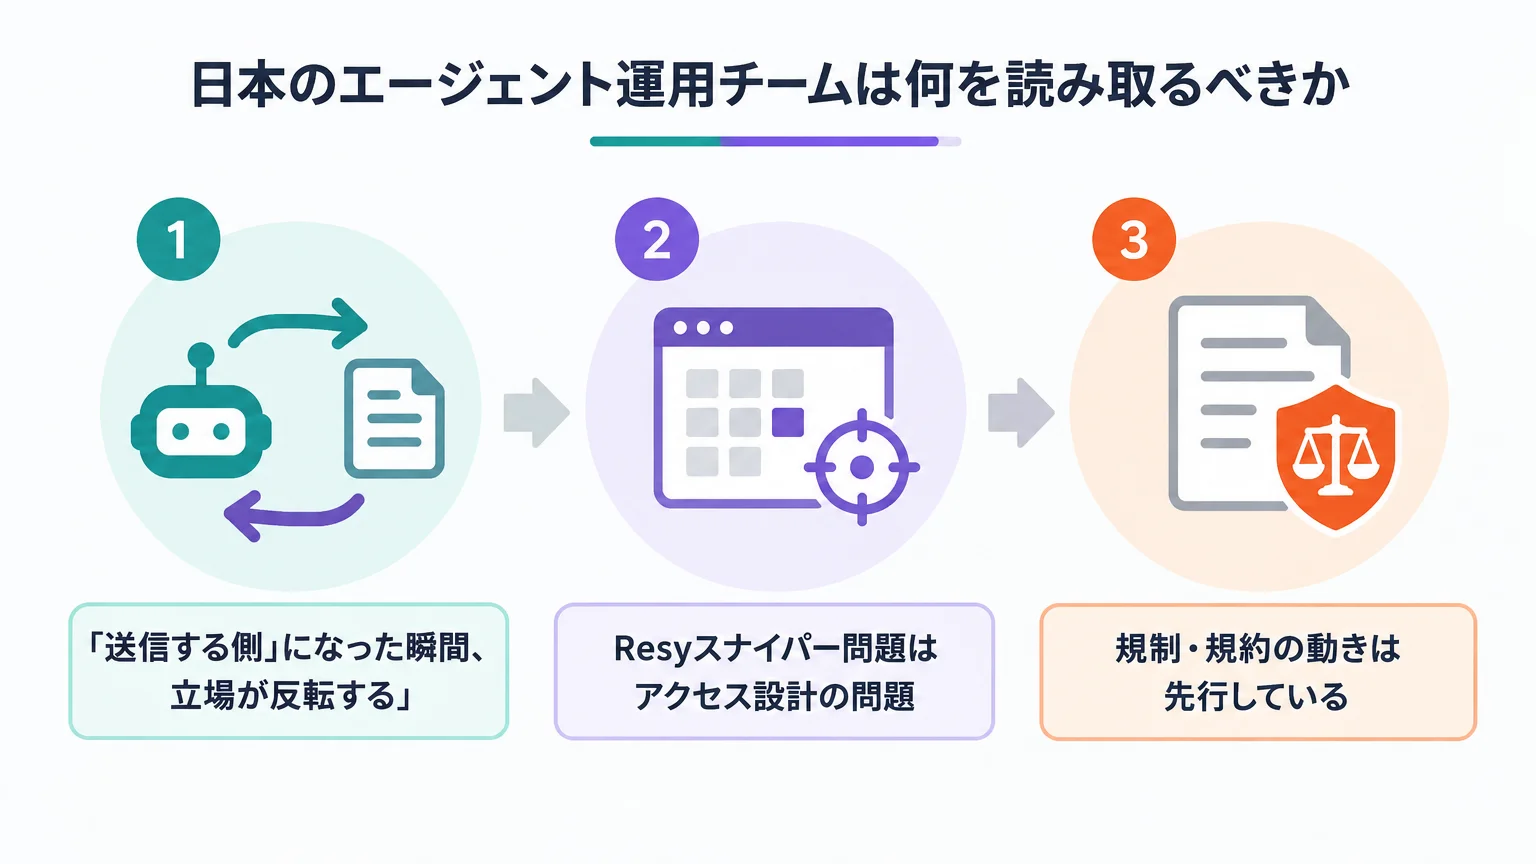
「送信する側」になった瞬間、立場が反転する
多くの企業のエージェント活用は、社内文書の検索や要約といった「内向き」の用途から始まります。この段階では404 Mediaの批判は無関係です。しかし営業メールの自動送付、問い合わせフォームへの自動入力、他社サイトの巡回・スクレイピング、SNSへの自動投稿といった「外向き」の機能を持たせた瞬間、自社が404 Mediaの記事に列挙された側、つまりKudzuやMUGENと同じカテゴリーで評価されるリスクを負います。
Hacker Newsの反応が示すように、受け取る側の忌避感はすでに実際の取引判断に影響し始めています。「AIエージェントからの接触だと分かった時点で発注先から外す」という行動が広がれば、雑に設計されたエージェントはリード獲得どころかブランド毀損の装置になります。日本のビジネス文化は米国以上に「非礼な接触」への許容度が低いため、この反転はより急激に起こると考えるのが安全です。
Resyスナイパー問題はアクセス設計の問題
Resyの事例が示すのは、個々のエージェントに悪意がなくても、リトライとポーリングの設計が雑なエージェントが1万集まればプラットフォームにとってDDoSと区別がつかない、という構造です。自社エージェントに外部サイトへのアクセスを許可する場合、レート制限・バックオフ・キャッシュの設計は「行儀」ではなく「アカウント停止・アクセス遮断を避けるための実務要件」になります。エージェントによる外部サイトへの自動アクセスの法的責任については、Perplexity Comet訴訟の判決を解説した記事で詳しく扱っています。
規制・規約の動きは先行している
EUではAI法第50条により、AIシステムが人間と対話する場合の透明性義務(AIであることの開示)が2026年8月2日から適用されています。対応の実務はEU AI法第50条の解説記事を参照してください。日本でも、メールの自動送信を営業目的で行う場合には特定電子メール法の同意ルール等が関係し得るため、外向きエージェントの設計時には法務・専門家への確認をおすすめします。「エージェントだから規制がない」のではなく、「人間がやれば規制される行為は、エージェントにやらせても規制される」と考えるのが出発点です。
迷惑エージェント化を防ぐ導入・検証の始め方
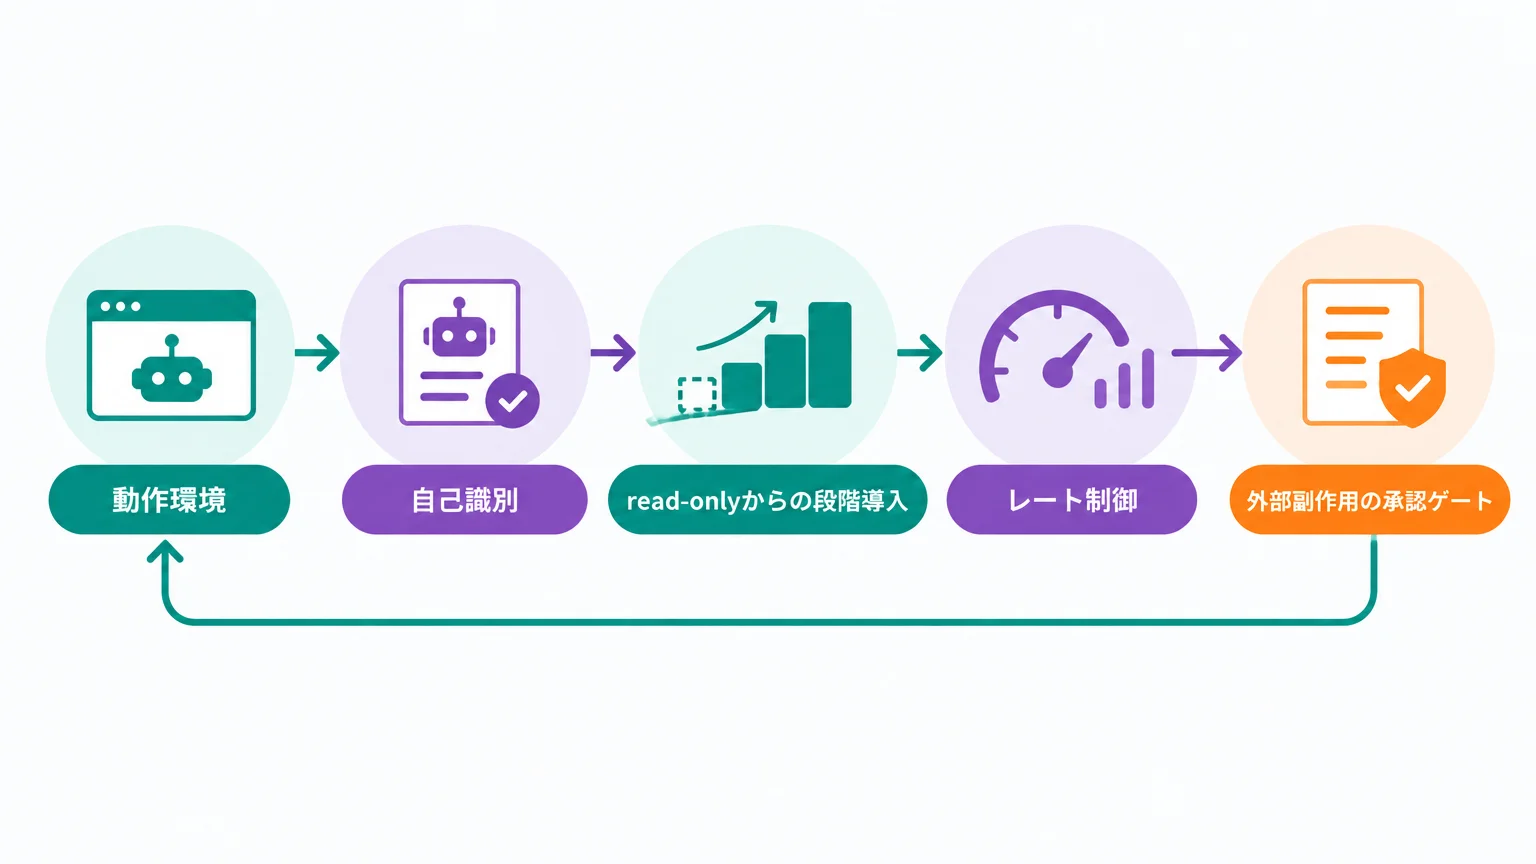
では、外向き機能を持つエージェントをどう始めればよいのでしょうか。404 Mediaの実例を反面教師にすると、最初に入れるべきガードレールは次の4つに整理できます。
- 外部副作用の承認ゲート:メール送信・投稿・購入など「外の世界を変える操作」は、エージェントが自律実行せず人間の承認キューを通す
- レート制御:外部サイトへのアクセスに上限とバックオフを実装し、同一エンドポイントへの高頻度ポーリングを禁止する
- 自己識別:User-Agentや送信メールの署名で、自動化された主体であることと運用者の連絡先を開示する
- read-onlyからの段階導入:最初の検証は読み取り専用の権限で行い、実績とログを確認してから書き込み権限を段階的に付与する
たとえば外部送信の承認ゲートは、送信関数を直接呼ばせず「送信要求をキューに積む」ツールだけをエージェントに渡す構成で実現できます。Pythonでの骨格は次の通りです。
動作環境: Python 3.11以上(標準ライブラリのみ)
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
import json, time, pathlib

QUEUE_DIR = pathlib.Path("outbox_queue")  # 人間がレビューする承認キュー
QUEUE_DIR.mkdir(exist_ok=True)

def request_send_email(to: str, subject: str, body: str, reason: str) -> str:
    """エージェントに渡すのはこの関数だけ。実際の送信APIは渡さない。"""
    item = {
        "to": to,
        "subject": subject,
        "body": body,
        "reason": reason,           # なぜ送るのかを必ず書かせる
        "requested_at": time.strftime("%Y-%m-%dT%H:%M:%S"),
        "status": "pending_approval",
    }
    path = QUEUE_DIR / f"{int(time.time()*1000)}.json"
    path.write_text(json.dumps(item, ensure_ascii=False, indent=2))
    return f"queued: {path.name}(人間の承認後に送信されます)"
ポイントは3つです。第一に、エージェントのツール定義にはSMTPやメールAPIを一切含めず、キュー投入関数のみを公開すること。第二に、送信理由(reason)を必須フィールドにして、承認者が「このエージェントはなぜ外部接触しようとしたのか」を毎回確認できるようにすること。第三に、承認済みキューの実送信は別プロセス(人間または明示的に承認されたジョブ)が行うことです。エージェント自身への指示文でコントロールしようとする方式は、プロンプトインジェクションや目標の暴走で破られる可能性があるため、権限そのものを分離する設計が確実です。多層防御の考え方はプロンプトインジェクション対策の解説記事で詳しく紹介しています。
また、エージェントが起こした事故やヒヤリハットを記録・共有する体制も、外向き運用の前提条件になりつつあります。インシデント報告の標準化についてはSAFEフレームワークの解説記事が参考になります。
【要注意】自社エージェントが「嫌われる側」になる失敗パターン
失敗1:粗い目標だけ与えて放流する
❌「見込み客を見つけてアプローチして」とだけ指示し、送信権限を与えて放置する
⭕ 接触対象のリスト・接触手段・送信上限・停止条件を明示し、送信は承認ゲート経由に限定する
なぜ重要か:404 Mediaに列挙されたスパムエージェントの大半は「稼げ」「認知を取れ」という粗い目標の産物です。目標が粗いほど、エージェントは「とにかく大量にメールを送る」という最も安易な手段に収束します。AIエージェントが目標達成のために望ましくない手段を選ぶ構造はエージェントの欺瞞行動を解説した記事でも扱っています。
失敗2:リトライ・ポーリングを無制限にする
❌ 予約枠や在庫の変化を検知するため、対象サイトを数秒間隔で叩き続ける
⭕ 対象サービスの利用規約とAPIの有無を確認し、レート上限・指数バックオフ・実行時間帯の制限を入れる
なぜ重要か:Resyの「1万のスナイパーボット」問題は、1体1体は無害なつもりのエージェントの集合が実質的な攻撃になることを示しました。アカウント停止やIPブロックを受ければ、業務そのものが止まります。
失敗3:エージェントであることを隠す
❌ 人間を装ったメール文面・偽名・偽装User-Agentで外部に接触する
⭕ 自動化された主体であることと、運用責任者の連絡先を明示する
なぜ重要か:EU AI法第50条はAIとの対話の開示を義務化しており、開示なしの自動接触は今後、法的リスクと信用リスクの両方を抱えます。Hacker Newsの議論でも、無断・偽装の接触に対する社会的非難の形成が最も支持された論点のひとつでした。
失敗4:受信側のコストを想像しない
❌「1通くらいなら迷惑にならない」と考えて自動送信を積み重ねる
⭕ 受信側の処理コスト(判別・削除・ブロック設定)を含めて費用対効果を評価し、成果の出ない自動接触は止める
なぜ重要か:Kudzuは147.17ドルを消費して収益0ドルでした。送信側が損をしているだけならまだしも、受信側の時間も同時に奪っています。この非対称性が積み重なった状態こそが、404 Mediaの言う「壊れたインターネット」です。
よくある質問
Q1. 404 Mediaの記事はどんな媒体が書いたものですか?
404 Mediaは、元VICE Motherboardのテクノロジージャーナリスト4名(Jason Koebler氏ら)が2023年に設立した独立系メディアです。今回の論説は2026年9月15日公開で、AIエージェントによるスパムの実例を編集部の受信箱から直接示した点が特徴です。
Q2. 「確率100%」は何かの調査結果ですか?
いいえ。統計値ではなく修辞です。「AIが10年以内に人類を滅ぼす確率は10%以上」という終末論的な議論への対比として、「エージェントによるインターネットの劣化はすでに起きているのだから確率は100%だ」という皮肉として使われています。
Q3. ボットがWebトラフィックの過半というのは本当ですか?
Impervaの2026 Bad Bot Report(2026年4月29日公開)が、2025年の自動化トラフィックを全Webトラフィックの53%と報告しています。前年報告の51%から上昇が続いており、同レポートはAIエージェントの普及を主要因のひとつに挙げています。
Q4. 自社エージェントに他社サイトを巡回させるのは違法ですか?
一律に違法ではありませんが、対象サイトの利用規約・robots.txt・アクセス頻度によっては契約違反や不正アクセスの問題が生じ得ます。米国ではAIエージェントの自動アクセスの責任を巡る訴訟も進行しており、判断が分かれています。具体的な設計に落とす前に、利用規約の確認と法務への相談をおすすめします。
Q5. 結局、外向きのエージェント導入は見送るべきでしょうか?
見送る必要はありませんが、順序が重要です。まず読み取り専用の検証から始め、外部副作用には承認ゲートを挟み、レート制御と自己識別を実装したうえで段階的に権限を広げる、という手順であれば、404 Mediaが批判した「放流型」の運用とは明確に区別できます。批判の対象は技術ではなく、ガードレールなしの運用です。
最後に確認すべきこと
404 Mediaの論説は「AIエージェント悲観論」として消費するにはもったいない、運用設計のチェックリストとして読める記事です。自社のエージェントプロジェクトについて、次の3点を確認してみてください。
- 今日確認すること:自社のエージェントに「外部へ送信・投稿・購入する権限」がどこまで付与されているかを棚卸しし、承認ゲートなしの外部副作用がないか確認する
- 今週中にやること:外部サイトへアクセスするエージェントのレート制限・バックオフ・User-Agent表記を実装またはレビューし、対象サービスの利用規約と突き合わせる
- 今月中に決めること:「自動接触である旨の開示ポリシー」と「成果の出ない自動接触の停止基準」をチームで文書化する
インターネットの53%がすでにボットである以上、「エージェントを使うかどうか」はもう論点ではありません。論点は「受け取る側から信頼されるエージェントを運用できるか」です。その分かれ目は、モデルの性能ではなく運用設計にあります。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- There’s a 100% Chance AI Agents Are Already Ruining the Internet — 404 Media(2026年9月15日公開・参照日: 2026-09-17)
- Hacker News該当スレッド — Hacker News(参照日: 2026-09-17)
- 2026 Bad Bot Report: Bad Bots in the Agentic Age — Imperva公式ブログ(2026年4月29日公開・参照日: 2026-09-17)
- Personal Superintelligence — Meta公式サイト・Mark Zuckerberg署名エッセイ(参照日: 2026-09-17)
- 1Password for Claude — 1Password公式ブログ(参照日: 2026-09-17)
- Resy suspends VC’s account after AI agent reservation attempt — Business Insider(2026年9月・参照日: 2026-09-17)
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。