顧客会議の直前、社外秘の議事録を要約したいのに、クラウドサービスへ貼り付けてよいか判断できず、手が止まることがあります。
別の日には、API利用料やネットワーク待ちが気になり、「手元のPCだけで動かせないか」と考えるかもしれません。
ローカルLLMとは、モデルの重みを自分のPCや自社サーバーへ置き、その機器上で推論を実行する構成です。
2026年10月2日時点では、Ollama、LM Studio、llama.cppなどを使って始められます。ただし、アプリ名だけで「完全ローカル」と判断してはいけません。ローカルモデルを選び、推論先がlocalhostになっていることまで確認して、初めて入力を外部LLM APIへ送らない構成になります。
- 向いている場面:機密情報を外部APIへ送らずに処理したい、オフラインで使いたい、同じ処理を繰り返してAPI従量課金を抑えたい場面
- 向いていない場面:大型モデルの品質をすぐ使いたい、GPU運用や更新を自社で抱えたくない、利用量が少なくクラウドAPIの方が管理しやすい場面
- 最初の判断:用途を1つに絞り、16GB前後のメモリを出発点に、小型の量子化モデルで品質と速度を確認する
ここから、モデル・ランタイム・操作画面の違い、クラウドLLMとの比較、必要スペック、3つの代表ツールの役割、試し方の順に整理します。
ローカルLLMとは、どこで何が動く仕組みなのか
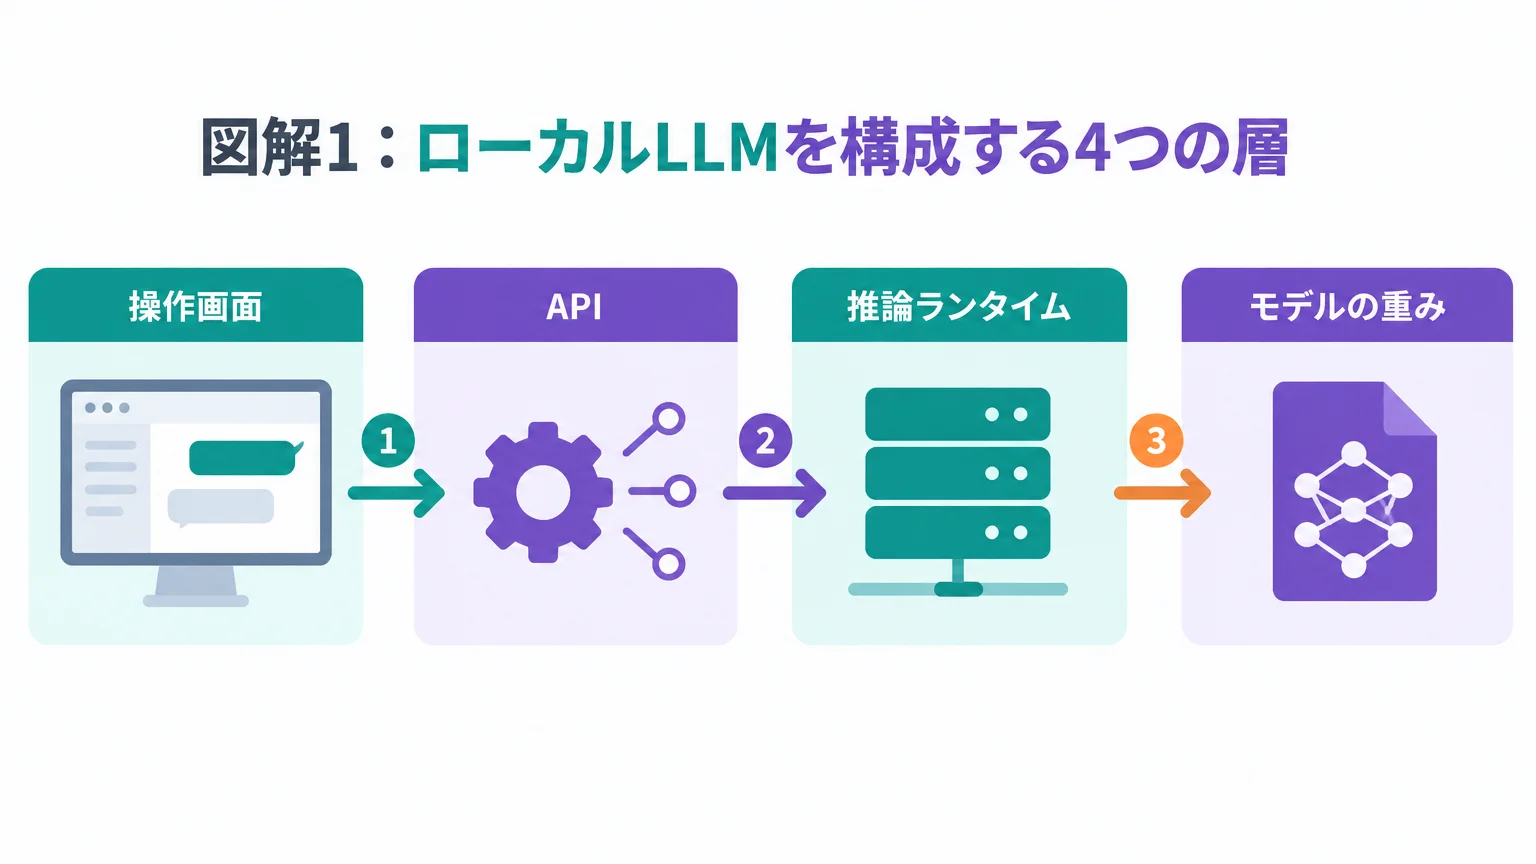
LLMは、大量のテキストなどから学習した規則を使って、入力に続くトークンを生成するモデルです。ローカルLLMという別種類のAIがあるわけではありません。違いは、モデルの重みをどこに置き、どの計算機で推論するかにあります。
クラウドLLMでは、アプリからインターネット経由で事業者のAPIへ入力を送り、事業者側の計算基盤で推論します。ローカルLLMでは、ダウンロードしたモデルファイルをPC、ワークステーション、オンプレミスサーバーなどのRAMやVRAMへ読み込み、その機器で推論します。「ローカル」はノートPC1台だけを意味せず、自社ネットワーク内のサーバーで動かす構成も含みます。
ここで混同しやすいのが、モデルと実行ツールです。Hugging Faceなどで配布されるモデルの重みだけでは会話できません。重みを読み込んで計算する推論ランタイム、会話や設定を扱う操作画面、アプリから呼び出すAPIが必要です。LM Studio公式も、ローカル実行には取得可能な重みが必要で、モデルのロードとは重みなどを収めるためRAMを割り当てることだと説明しています。
- モデルの重み:GGUFやSafetensorsなどのファイル
- 推論ランタイム:重みをRAMやVRAMへ読み込み計算する
- 操作画面・API:チャット画面やlocalhostのHTTP経由で入力する
- PC・自社サーバー:推論を実行し、応答を返す
なお、ローカルLLMとローカルAIエージェントも同義ではありません。LLMは文章を理解・生成する中核モデルです。エージェントは、そのモデルにツール、記憶、権限、処理のループを組み合わせた仕組みです。違いはローカルAIエージェントの仕組みとプライバシーで詳しく整理しています。
2026年10月2日時点で、ローカル実行はどこまで進んでいるのか
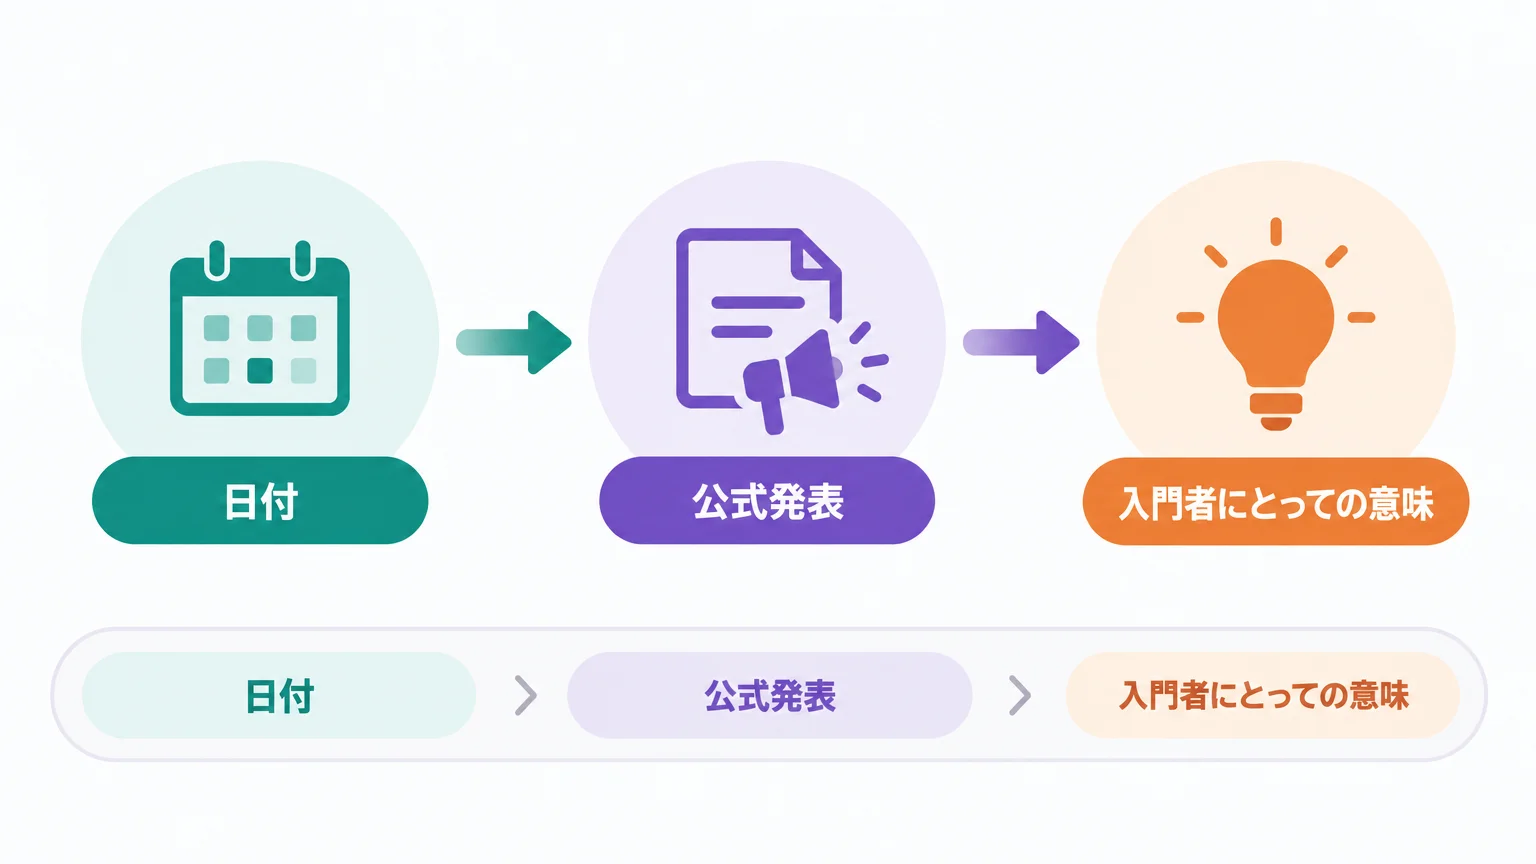
ローカルLLMの基本定義は変わりませんが、周辺ツールは現在も速いペースで更新されています。直近2週間の公式発表だけでも、実行エンジン、量子化モデルの扱い、用途別APIに動きがありました。
| 日付 | 公式発表 | 入門者にとっての意味 |
|---|---|---|
| 2026年9月29日 | Ollama 0.35でdecision model向けAPIを追加 | 一般的なチャット以外にも、分類や振り分けをローカルAPIで扱う選択肢が広がっている |
| 2026年9月22日 | Hugging Face Transformersがllama.cpp系のGGUF量子化モデル実行に対応 | 同じGGUFを扱う経路が増え、Pythonの標準的な開発環境からも試しやすくなっている |
| 2026年9月19日 | LM Studio 0.4.25を公開 | 特定のApple Silicon環境向けに新しい実行エンジン対応が追加され、ランタイムの選択肢が更新され続けている |
この更新状況から分かるのは、「おすすめモデル名を1つ覚えれば終わり」ではないことです。アプリ、ランタイム、モデル形式は別々に更新されます。導入時には、モデルカードと利用ツールの公式ドキュメントを同じ日に確認してください。
また、llama.cppは高頻度でリリースされます。この記事では一時的なビルド番号を推奨条件にはせず、2026年10月2日に公式READMEとリリース一覧を確認したうえで、変わりにくい役割と判断基準に絞っています。
クラウドLLMと何が違うのか
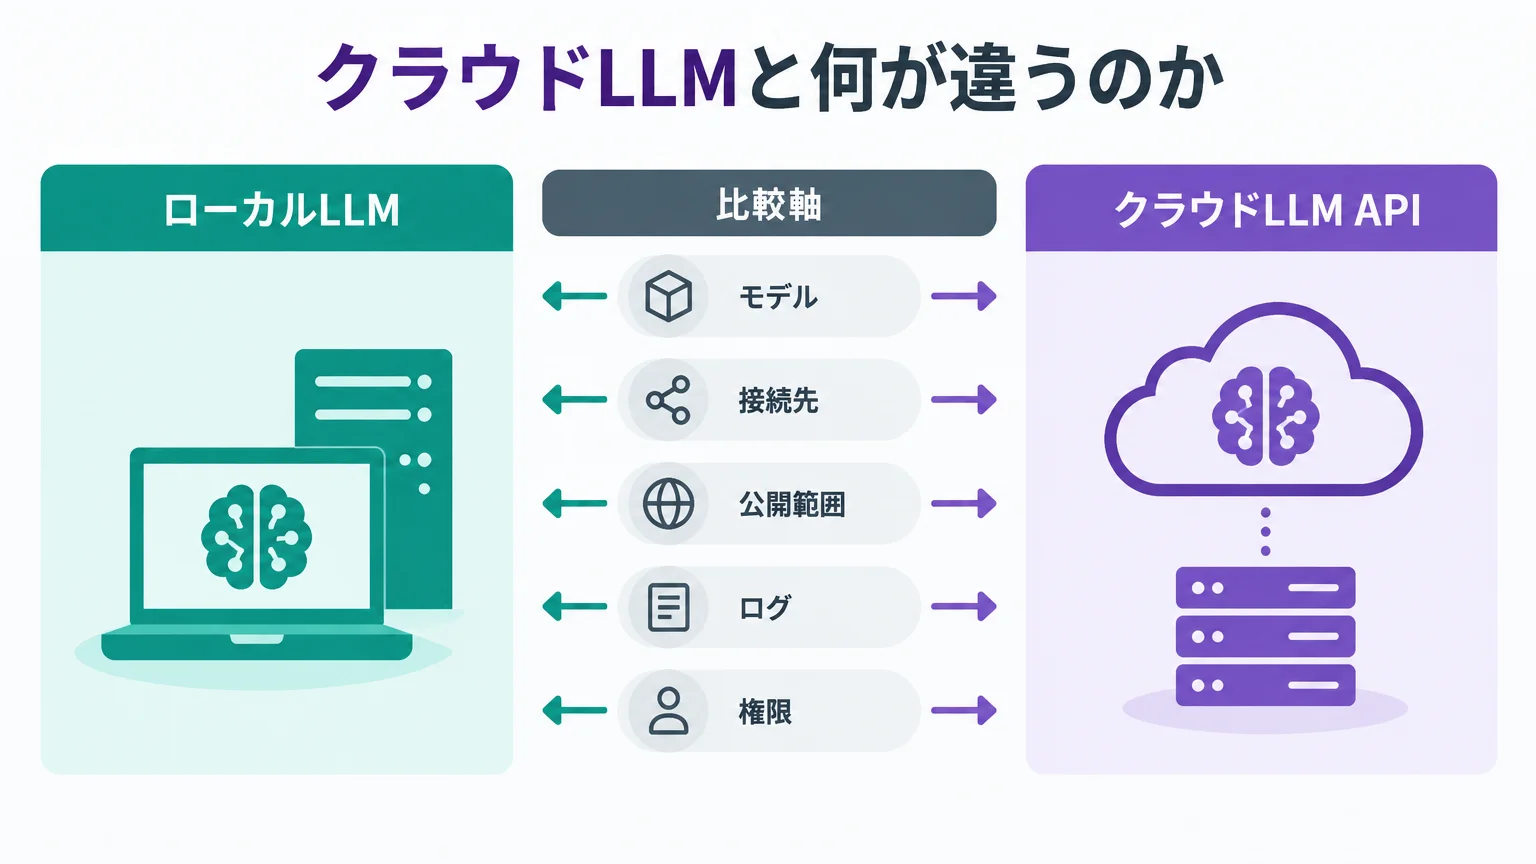
比較対象になるのは、OpenAIのGPT APIやAnthropicのClaude APIなど、事業者の計算基盤を呼び出すクラウドLLMです。ローカルとクラウドは優劣ではなく、データ経路、費用の持ち方、品質、運用責任が違います。
| 比較軸 | ローカルLLM | クラウドLLM API |
|---|---|---|
| 推論場所 | 自分のPCや自社サーバー | サービス事業者の計算基盤 |
| 入力の経路 | 完全ローカル構成なら端末・社内ネットワーク内 | インターネット経由でAPIへ送信 |
| 費用 | 端末、電力、保守、担当者の工数 | 主に利用量に応じたAPI料金と接続運用 |
| レイテンシ | ネットワーク往復を避けられるが、端末性能に左右される | ネットワーク往復があるが、大規模な計算基盤を利用できる |
| モデル品質 | 端末に収まるモデルから選び、自分で評価する | 大型の提供モデルをすぐ利用しやすい |
| 保守責任 | モデル更新、脆弱性、容量、監視を利用者側で管理 | 基盤運用は事業者側、契約・API変更への対応は利用者側 |
| オフライン | モデルとランタイム取得後は可能な構成がある | 原則としてネットワーク接続が必要 |
「クラウドへ送ると必ず学習に使われる」という説明も正確ではありません。OpenAIのAPIデータ制御はAPI入力・出力を明示的なオプトインなしに学習へ使わないと説明し、Anthropicの商用データ学習ポリシーも商用製品とAPIの入力・出力を既定で学習に使わないと説明しています。一方で、保持期間、エンドポイント、契約上のデータ制御には条件と例外があります。クラウドを選ぶ場合は、現在の契約と利用する機能を公式文書で確認する必要があります。
逆に、「ローカルなら自動的に安全」でもありません。ローカルAPIを外部へ公開したり、Web検索、クラウドモデル、外部ツールを有効にしたりすれば通信経路は増えます。安全性は製品名ではなく、モデル、接続先、公開範囲、ログ、権限の組み合わせで決まります。
プライバシー・コスト・レイテンシはどう判断すればよいか
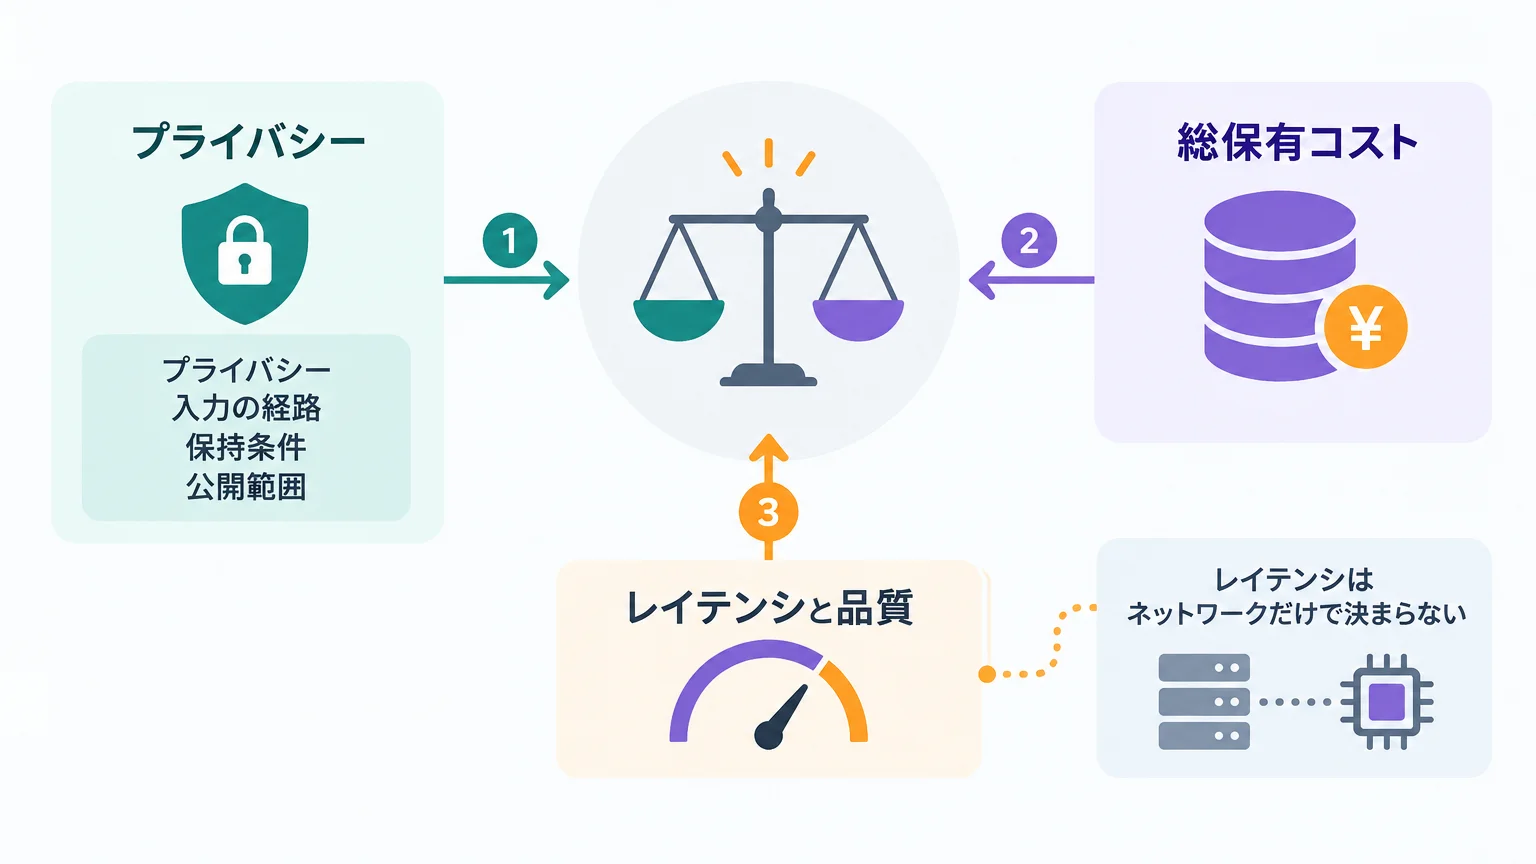
プライバシーは「外へ送らない構成を作れる」ことが利点
ローカルLLMの強みは、入力を外部LLM APIへ送らずに推論できる選択肢です。LM Studioは、取得済みモデルとのチャット、文書を使うRAG、ローカルサーバーをオフラインで動かせると案内しています。ただし、モデル検索、ダウンロード、ランタイム取得、更新確認には通信が必要です。Ollamaにもローカルモデルとクラウドモデルがあるため、実行先を分けて確認してください。
コストは「API料金ゼロ」ではなく総保有コストで比べる
ローカルモデルだけを使えば、外部LLM APIのトークン従量課金を避けられる場合があります。しかし、GPUや大容量メモリを備えた端末、電力、モデルの更新、障害対応、評価の工数は残ります。小規模な試用や利用量が変動する業務では、クラウドAPIの方が安く簡単な場合もあります。毎日繰り返す定型処理や、既存端末に収まるモデルで要件を満たす処理では、ローカルの費用構造が合いやすくなります。
レイテンシはネットワークだけで決まらない
ローカル推論は、APIサーバーまでのネットワーク往復を避けられます。一方、重いモデルをCPU中心で動かせば、生成開始も生成中も遅くなり得ます。クラウドは通信時間が加わるものの、利用者のPCより強い計算資源を使えます。比較するときは「1回の応答時間」だけでなく、モデルのロード時間、入力の長さ、同時利用者数、必要な回答品質も同じ条件にそろえましょう。
入力の経路
保持条件
公開範囲
端末・電力
API料金
保守工数
ネットワーク
端末性能
モデル評価
機密文書の前処理はローカル、難しい推論だけクラウドへ送るハイブリッド構成もあります。その場合も、クラウドへ渡す情報を匿名化・最小化し、どの条件で経路を切り替えるかをコードと運用ルールで固定することが重要です。
どのスペックなら始められるのか
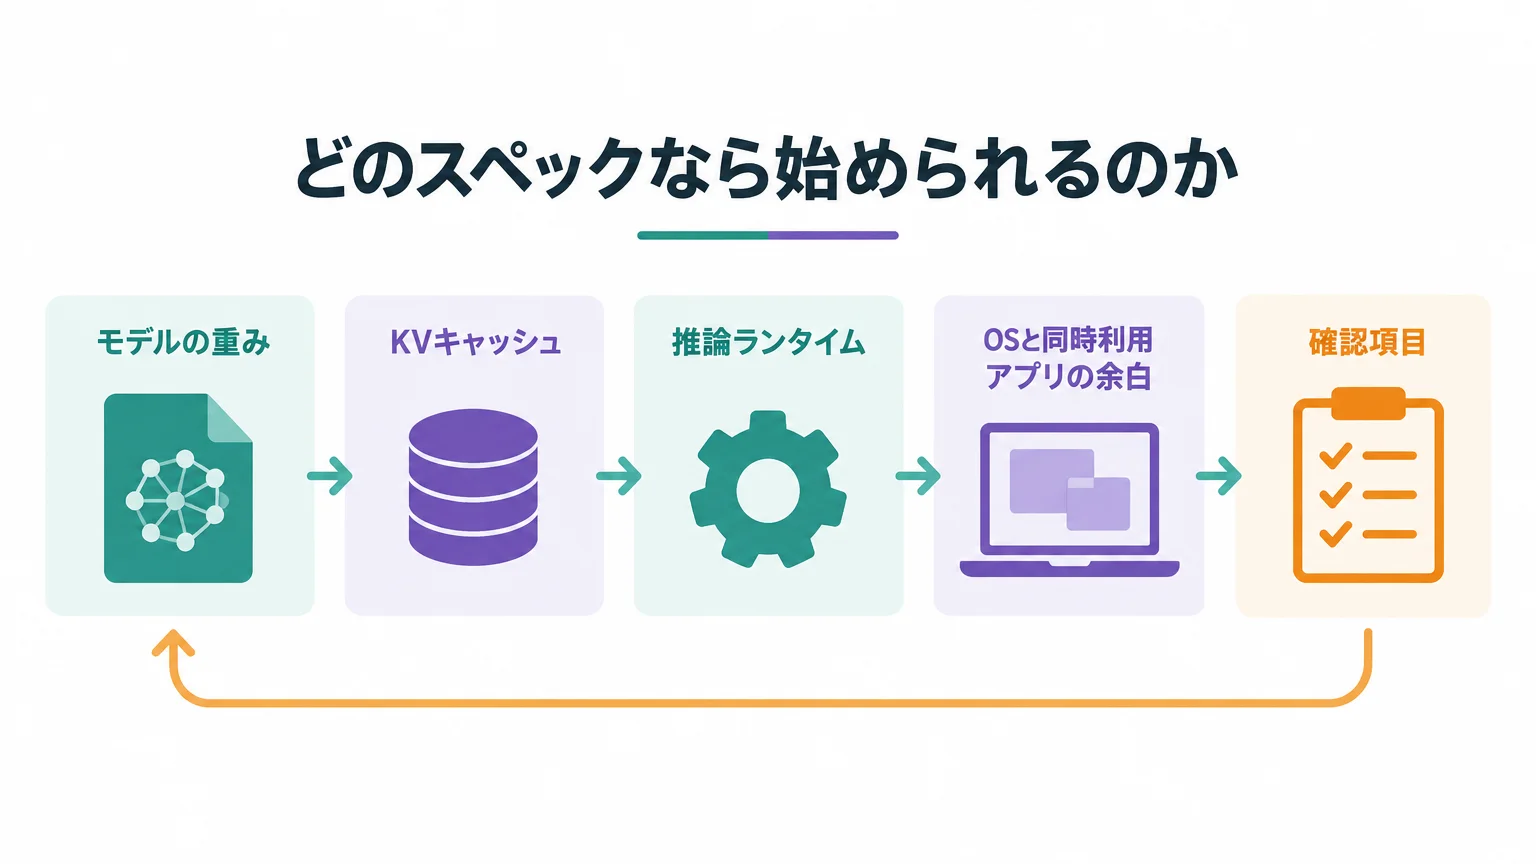
必要スペックを「7Bなら何GB」のようにパラメータ数だけで決めるのは危険です。同じモデルでも、数値表現の精度を下げる量子化、入力を保持するコンテキスト長、画像入力、同時リクエスト数によって必要なRAMやVRAMが変わります。
2026年10月2日時点のLM Studio公式要件は、macOSとWindowsで16GB以上のRAMを推奨しています。8GBのMacでも小型モデルと控えめなコンテキストなら使える場合がある一方、Windowsでは専用VRAM 4GB以上を推奨しています。これはLM Studioというアプリの推奨値であり、すべてのモデルが快適に動く保証ではありません。
| 確認項目 | 公式情報から読める目安 | 判断時の注意 |
|---|---|---|
| 8GB RAMのMac | 小型モデルと控えめなコンテキストなら動く場合がある | OSとGPUがメモリを共有するため余裕を残す |
| 16GB RAM | LM StudioがmacOS・Windowsで推奨する出発点 | 大型モデル、長い入力、並列処理には不足し得る |
| Windowsの専用GPU | LM Studioは4GB以上の専用VRAMを推奨 | モデルの重みが収まるとは限らず、RAMへの退避で遅くなる場合がある |
| Ollamaの現行例 | gemma4:e2bは約7.2GBの取得量で、利用可能なVRAMまたはMacのユニファイドメモリ8GBを推奨 |
特定モデルの値であり、全ローカルLLMへ一般化しない |
選定は、モデルファイルがストレージに収まるか、実行時の重みとキャッシュがメモリに収まるか、必要な速度が出るか、という3段階で行います。目安は次の関係です。
必要な空きメモリ = モデルの重み + KVキャッシュ + 推論ランタイム + OSと同時利用アプリの余白
- モデルの重み:量子化方式で大きさが変わる
- KVキャッシュ:コンテキスト長と並列数で増える
- 推論ランタイム:Ollama、LM Studio、llama.cppなどが使用する
- OSと同時利用アプリの余白:共有メモリを使い切らない
Ollamaではollama psで、実行中モデルのCPU・GPU配置や割り当てコンテキストを確認できます。公式文書内でもコンテキストの既定値に条件差があるため、一律の数字を信じるより、実行環境で表示を確認する方が確実です。
Ollama・LM Studio・llama.cppは何を選ぶ道具なのか
3つは完全な競合ではありません。モデルを扱う層と、利用者が触る範囲が異なります。特にllama.cppは低層の推論エンジンで、OllamaやLM Studioがllama.cpp系ランタイムを利用する場合もあります。
| ツール | 位置づけ | 向いている人 | 強み | 注意点 |
|---|---|---|---|---|
| Ollama | CLI、モデル管理、ローカルAPIをまとめた実行環境 | 開発者、スクリプトやアプリから呼びたい人 | 短いコマンドとlocalhost APIで始めやすい | クラウドモデルもあるため、モデルと接続先を確認する |
| LM Studio | モデル検索、ダウンロード、ロード、チャット、APIをGUIで扱うデスクトップアプリ | 画面でモデルを比べながら試したい人 | 設定とメモリ使用を視覚的に確認しやすい | 検索、取得、更新には通信が必要で、ローカルネットワーク公開は別途保護する |
| llama.cpp | C/C++の推論エンジン、CLI、ライブラリ、HTTPサーバー | 量子化やバックエンドを細かく制御したい人 | 幅広いCPU・GPU、複数の量子化、CPUとGPUの併用に対応 | 導入とチューニングの選択肢が多く、運用知識が必要 |
- GUI中心:LM Studioで検索・ロード・チャット
- CLIとローカルAPI中心:Ollamaでモデル管理・アプリ連携
- 推論エンジン中心:llama.cppで量子化・バックエンド・サーバーを制御
- モデルの重み:用途とライセンスに合うファイルを選ぶ
最初の1台なら、画面で試したい人はLM Studio、API連携まで見たい人はOllama、実行方式を細かく理解したい人はllama.cppが分かりやすい入口です。Ollamaのモデル選択、API、クラウド機能との分け方は、既刊のOllamaでローカルLLMを動かす実践ガイドへ分けています。
最小構成でローカル推論を試すには
入門では、機密情報を使わず、短い質問を1件だけ投げて、モデル取得・起動・応答の経路を確認します。いきなりRAG、社内文書、エージェント、外部公開を追加しないでください。
Ollamaでモデルを取得する
Ollama公式クイックスタートの現行例を使います。約7.2GBを取得するため、ストレージと利用可能なメモリを先に確認してください。
動作環境:Ollamaをインストール済みのmacOS、Windows、Linux。Linuxでは必要に応じてollama serveを先に起動します。
注意:本番環境で使用する前に、必ずテスト環境で動作確認してください。
ollama pull gemma4:e2b取得後、ローカルAPIへ1回だけ質問します。送信先がlocalhost:11434であることを確認してください。
動作環境:Ollamaのローカルサーバー、curl。
注意:本番環境で使用する前に、必ずテスト環境で動作確認してください。
curl PH_4_ \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemma4:e2b",
    "messages": [
      {"role": "user", "content": "ローカル推論を一文で説明してください。"}
    ],
    "stream": false
}'ローカルAPIはAPIキー不要です。そのため、0.0.0.0へ変更して社内LANやインターネットに公開する操作は、入門確認とは分けてください。公開する場合は認証、ファイアウォール、接続元制限、ログ方針が必要です。
LM Studioなら画面で確認する
LM Studioでは、Discoverからモデルを取得し、Chatでモデルをロードして質問します。メモリへ収まらない場合は、より小さなモデルか強い量子化を選び、コンテキストを短くします。モデルを取得した後は、オフラインにして同じ質問を送り、通信が不要な処理だけで応答できるか確認できます。
llama.cppならCLIとサーバーを分けて理解する
llama.cpp公式READMEは、Hugging Faceのモデルを指定してCLIで実行する方法と、OpenAI互換サーバーとして起動する方法を案内しています。
動作環境:現行のllama.cppをインストール済みで、Hugging Faceからモデルを取得できる環境。
注意:本番環境で使用する前に、必ずテスト環境で動作確認してください。
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
1行目はターミナルで直接試す入口、2行目はローカルHTTPサーバーとして使う入口です。最初はCLIだけを動かし、モデルの品質とメモリ使用を確認してからサーバー化すると、問題の切り分けが容易です。
Hugging Faceのモデルカードで何を確認すべきか
モデル名に「4B」「8B」と書かれていても、それだけでは選べません。配布者、用途、ライセンス、ファイル形式、量子化、入力形式、言語、コンテキスト、既知の限界をモデルカードで確認します。第三者が変換したGGUFを使う場合は、元モデルと変換元のリビジョンも追えるか確認してください。
当日版の具体例として、Hugging Face上のQwen3.5-4Bモデルカードは、言語モデル部分を4Bパラメータ、ライセンスをApache 2.0として掲載しています。一方、同じモデル名でも配布形式や量子化は複数あります。モデルカードの数字と、実際にダウンロードするファイルを分けて見なければなりません。
2026年9月22日にHugging Faceが公開したGGUF解説では、Qwen3.5-4BのBF16が8.42GB、Q4_K_Mが2.74GBと示されています。Q4_K_Mは、主に4bitの重みを使いつつ一部の重要なテンソルを高い精度に保つ量子化です。Hugging FaceはQ4_K_Mから始め、メモリに余裕があればQ5_K_MやQ6_Kも試す方法を案内しています。ただし、品質への影響はモデルと業務で異なるため、自分の入力で評価する必要があります。
| モデルカードの確認欄 | 確認する理由 | 見落とした場合の問題 |
|---|---|---|
| 配布者・元モデル | 公式配布か、第三者変換かを区別する | 出所や更新履歴を追えない |
| ライセンス | 商用利用、再配布、表示義務を確認する | 「公開されているから自由」と誤解する |
| Base・Instruct | 会話用に調整されたモデルかを確認する | チャット用途で期待した応答にならない |
| ファイル形式・量子化 | ランタイム対応と必要メモリを確認する | ロードできない、またはメモリ不足になる |
| 言語・モダリティ | 日本語、画像、音声などの対応範囲を確認する | 名前だけで用途に合うと判断してしまう |
| 既知の限界 | 誤情報、安全性、高リスク用途の注意を読む | クラウドLLMと同じ品質・保護を想定してしまう |
「オープンウェイト」と「オープンソース」も同じではありません。重みを取得できても、ライセンスや学習データ、ソースコードの公開範囲はモデルごとに違います。業務利用では、モデルカードのライセンス欄だけでなく、リンク先の利用条件まで保存して確認してください。
ローカルLLMについてよくある質問
ローカルLLMとは何ですか?
モデルの重みを自分のPCや自社サーバーへ置き、その機器で推論する構成です。モデル名ではなく、重みと計算処理をどこに置くかを表す言葉です。
ローカルLLMサーバーとは何ですか?
ローカルに読み込んだモデルを、HTTPなどのAPI経由で利用できるようにしたサーバーです。localhostだけで使う場合と、社内LANの別端末へ提供する場合では、認証やファイアウォールの要件が異なります。
GPT APIやClaude APIと何が違いますか?
GPT APIやClaude APIは、入力を各事業者の計算基盤へ送り、提供モデルの推論結果を受け取ります。ローカルLLMは、取得可能な重みを自分の計算機で動かします。クラウドAPIのモデルをそのままPCへコピーする仕組みではありません。
インターネットなしでも使えますか?
モデルと必要なランタイムを取得済みなら、オフラインで使える構成があります。LM Studio公式は、取得済みモデルとのチャット、文書処理、ローカルサーバーをオフラインで実行できると案内しています。モデル検索、ダウンロード、更新、Web検索などには通信が必要です。
GPUは必須ですか?
必須ではありません。llama.cppはCPU実行とCPU・GPUの併用に対応しています。ただし、対話に必要な速度、モデルサイズ、入力長によってはGPUや高速なユニファイドメモリが有利です。まず小型モデルで実測してください。
16GBのメモリで足りますか?
LM Studioは16GB以上を推奨していますが、モデル、量子化、コンテキスト、同時利用数で必要量は変わります。16GBは始めるための目安であり、任意のモデルが動く保証ではありません。
量子化とは何ですか?
モデルの数値表現の精度を下げ、ファイルと推論時のメモリを小さくする方法です。小さくできる代わりに品質へ影響する可能性があるため、同じ業務データで比較します。
ローカルなら情報漏えいを防げますか?
外部LLM APIへ入力を送らない構成は作れますが、漏えいを自動的に防ぐわけではありません。LAN公開、ログ、外部ツール、クラウドモデル、マルウェア、端末の持ち出しなど別の経路が残ります。
ローカルLLMは無料ですか?
外部APIの従量料金が発生しない構成はありますが、端末、電力、保守、担当者の工数は必要です。モデルごとのライセンス条件も確認してください。
初心者はどのツールから始めるべきですか?
画面操作を重視するならLM Studio、ローカルAPI連携まで試すならOllama、推論エンジンを細かく扱うならllama.cppが入口になります。1つのモデルと1つの質問で比較してから用途を広げてください。
業務利用へ進む前に決めておくこと
個人の検証から業務利用へ進むと、モデルの品質より先に運用境界が問題になります。少なくとも、入力してよいデータ、推論サーバーの公開範囲、モデルの取得元とライセンス、ログの保存場所、更新担当者、失敗時の人間確認を決めてください。
- データ区分:公開情報、社内限定、個人情報、秘密情報のどこまで入力できるか
- 接続先:localhost、社内LAN、クラウドのどこで推論するか
- モデル管理:配布元、リビジョン、ハッシュ、ライセンスを記録する
- アクセス制御:APIを誰が呼べるか、ネットワークと認証で制限する
- 評価:正答率だけでなく、拒否、誤情報、機密情報の再現、速度を業務入力で確認する
- 人間確認:顧客送信、契約、採用、医療、金融など影響の大きい判断を自動確定しない
- データ区分を決める
- 接続先を固定する
- モデル管理とアクセス制御を整える
- 業務入力で評価する
- 人間確認を残して利用する
複数利用者、GPUサーバー、監視、負荷分散まで必要になったら、PC向けツールの延長だけで考えない方が安全です。サーバー運用の選択肢はvLLMでオープンLLMをセルフホストする本番運用ガイドへ分けています。
選び方でつまずきやすい5つのパターン
失敗1:アプリを入れただけで完全ローカルだと思う
❌ OllamaやLM Studioを使っているので、すべての入力が端末内にあると判断する。
⭕ モデル名、APIのベースURL、Web検索、外部ツール、クラウド機能を個別に確認する。
なぜ重要か:同じアプリからローカルモデルとクラウドモデルを選べるためです。製品名ではデータ経路を証明できません。
失敗2:最初から最大のモデルを選ぶ
❌ 公開されている中で最も大きなモデルをダウンロードする。
⭕ 1つの業務、10件程度の評価入力、小型の量子化モデルから始める。
なぜ重要か:大きなモデルはストレージ、メモリ、ロード時間、電力を増やします。必要な品質を満たす最小構成の方が運用しやすくなります。
失敗3:パラメータ数だけで必要スペックを決める
❌ 「8Bだからこのメモリで必ず動く」と決める。
⭕ 実際の重みファイル、量子化、コンテキスト、画像入力、並列数を確認する。
なぜ重要か:同じモデルでもBF16と4bit量子化ではファイルサイズが大きく違い、KVキャッシュも入力長で増えるためです。
失敗4:ローカルAPIを認証なしで共有する
❌ localhostで動いたサーバーを、そのまま全ネットワークインターフェースへ公開する。
⭕ まずlocalhostに限定し、共有が必要なら認証、ファイアウォール、接続元制限、TLS、監査ログを設計する。
なぜ重要か:「自社内だから安全」ではありません。推論APIへの不正利用、入力の盗み見、意図しないモデル操作を防ぐ境界が必要です。
失敗5:クラウドと同じ回答品質を前提にする
❌ 代表的な質問に1回答できたため、業務全体を置き換えられると判断する。
⭕ 実際の業務入力を使い、正解、誤情報、拒否、出力形式、速度をモデルごとに比較する。
なぜ重要か:量子化の影響や日本語能力、長文処理、ツール呼び出しはモデルごとに異なります。ローカル・クラウド・ハイブリッドを同じ評価票で比べてください。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Ollama Quickstart — ローカル・クラウドの分岐、現行モデル例、ローカルAPI(参照日: 2026年10月2日)
- Ollama API Introduction — localhost APIと認証条件(参照日: 2026年10月2日)
- Ollama Context length — コンテキストと必要メモリ(参照日: 2026年10月2日)
- Ollama now supports Jev-style decision models — Ollama、2026年9月29日公開(参照日: 2026年10月2日)
- Get started with LM Studio — モデルの重み、ロード、基本操作(参照日: 2026年10月2日)
- LM Studio System Requirements — OS、RAM、VRAMの推奨条件(参照日: 2026年10月2日)
- LM Studio Offline Operation — オフラインで動く処理と通信が必要な処理(参照日: 2026年10月2日)
- LM Studio Changelog — LM Studio 0.4.25、2026年9月19日公開(参照日: 2026年10月2日)
- ggml-org/llama.cpp — 対応バックエンド、量子化、CLI、サーバー(参照日: 2026年10月2日)
- Qwen3.5-4B Model Card — Qwen、パラメータ、ライセンス、用途(参照日: 2026年10月2日)
- Transformers now runs llama.cpp quants — Hugging Face、2026年9月22日公開(参照日: 2026年10月2日)
- Data controls in the OpenAI platform — OpenAI APIの学習利用、保持、データ制御(参照日: 2026年10月2日)
- Is my data used for model training? — Anthropic商用製品・APIの学習利用条件(参照日: 2026年10月2日)
- How long do you store my organization’s data? — Anthropic商用製品・APIの保持条件(参照日: 2026年10月2日)
最後に確認すべきこと
ローカルLLMとは、単にOllamaやLM Studioを入れることではありません。モデルの重みと推論を自分の管理する計算機へ置き、データ経路と運用責任を引き受ける構成です。
- 用途を1つに絞る:要約、分類、コード補助など、合否を判断できる仕事から始める
- モデルカードと実ファイルを見る:配布者、ライセンス、量子化、サイズ、限界を同じ日に確認する
- 経路を確認する:ローカルモデル、localhost API、外部ツールの有無を確認する
- 同じ入力で比較する:ローカル、クラウド、ハイブリッドを品質・速度・総保有コストで比べる
- 共有は後から設計する:個人PCでの検証と、社内サーバーの公開・認証・監視を分ける
迷う場合は、16GB前後のメモリを出発点に、小型の量子化モデルへ機密情報を含まない質問を送り、速度・品質・メモリ使用を記録してください。その結果が要件を満たさなければ、モデルを大きくする前にクラウドAPIやハイブリッド構成も同じ条件で比較するのが現実的です。
あわせて読みたい:
- Ollamaの使い方 2026|ローカルLLMでAIエージェント — Ollamaのモデル選択とAPI連携を進めたい方向け
- vLLMでオープンLLMをセルフホスト|本番運用ガイド【2026】 — 複数利用者向けの本番サービングを検討する方向け
- ローカルAIエージェントとは|プライバシーと自律性【2026】 — LLMにツールと記憶を加える構成を知りたい方向け
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。