2026年9月27日時点で、RAG(Retrieval-Augmented Generation・検索拡張生成)は「質問が来たら先に自社の文書を検索し、見つかった本文をそのままモデルへ渡して、その本文を根拠に答えさせる」作り方です。モデルを学習し直さないので、元の文書を差し替えればその日から答えが変わり、どの文書を使ったかを出典として返せます。最短の作り方は公式ドキュメントに載っている3通り(OpenAI の Retrieval API・LangChain・LlamaIndex)で、いずれも20行ほどのコードで動きます。費用は埋め込みが100万トークンあたり0.02ドル(1ドル150円換算で3円)から、1問あたりの生成が数円という水準です。
この記事は、RAG の元論文(2020年5月22日投稿・NeurIPS 2020採択)と、OpenAI・Anthropic・Google・LangChain・LlamaIndex・Microsoft GraphRAG・RAGAS の公式ドキュメントを2026年9月27日に取得し、その記載だけで組み立てています。日本語の解説では「ベクトル検索で似た文書を探して渡す」で説明が止まりがちですが、実装で効くのは分割の既定値・検索の並べ替え設定・出典の返し方・単価の3層です。数字はすべて当日の公式値で、当社が測った値は含みません。
RAGとは|社外に置いた文書を検索して、その本文ごと答えさせる仕組み
この記事の要点
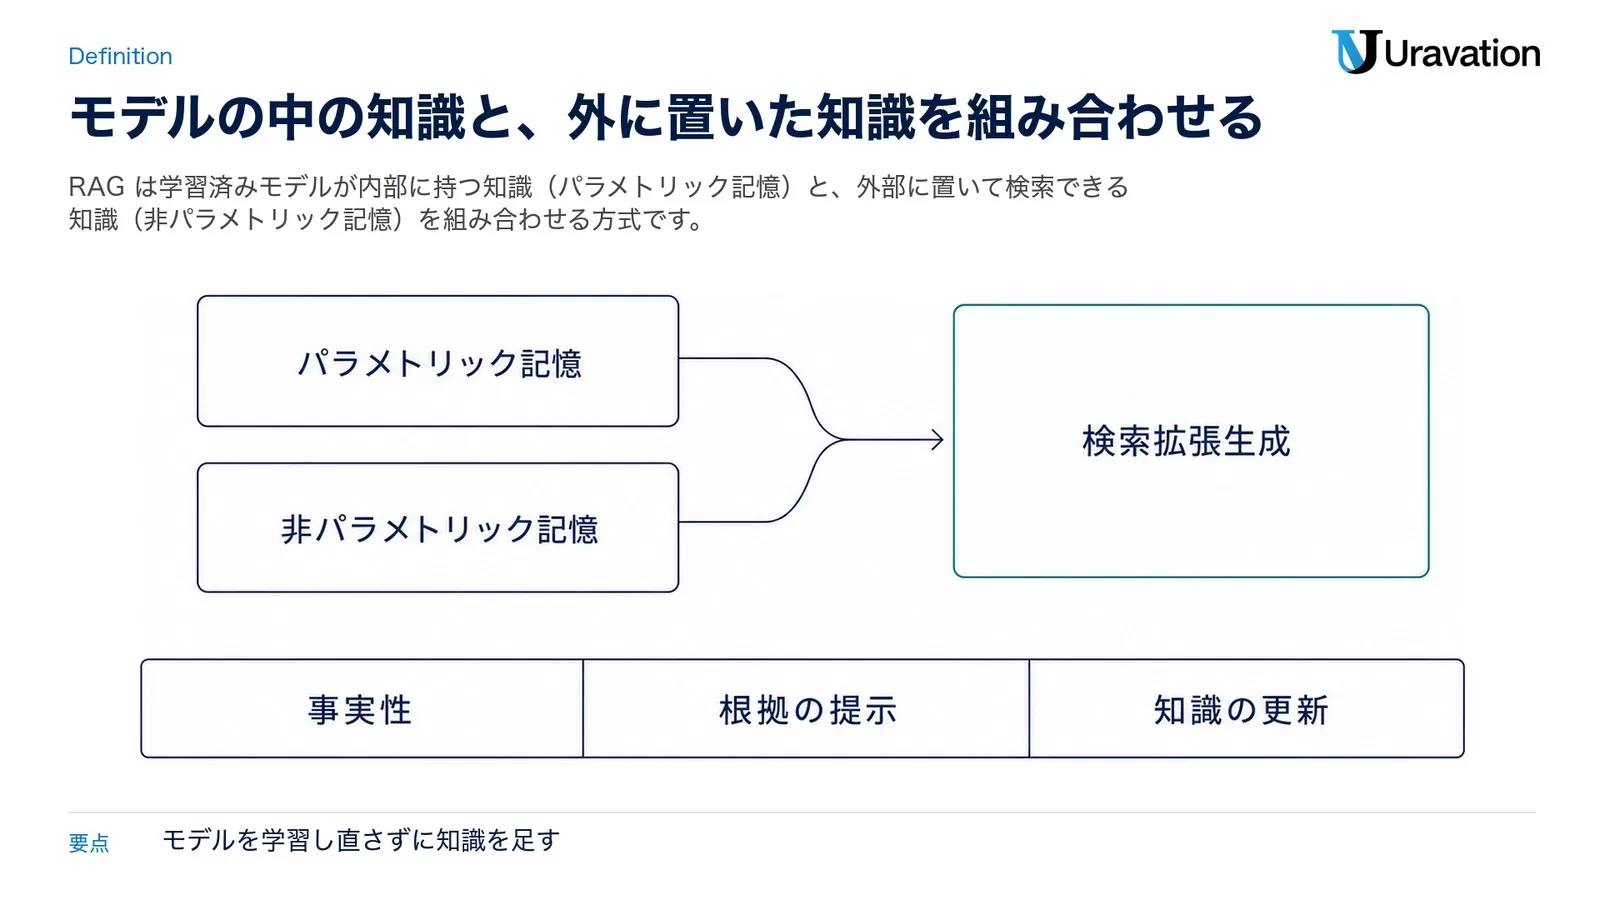
- 要点1:RAG は Retrieval-Augmented Generation の略で、日本語では「検索拡張生成」と訳されます。元論文は、学習済みモデルの中に固定されている知識(パラメトリック記憶)と、外部に置いた検索できる知識(非パラメトリック記憶)を組み合わせる方式として RAG を定義しています。
- 要点2:処理は取り込み・分割・埋め込み・検索・生成の5段です。OpenAI のベクトルストアは1チャンク800トークン・重なり400トークンが既定値で、検索結果は既定10件・最大50件。ここを知らずに「精度が出ない」と言っている状態が一番多い入口です。
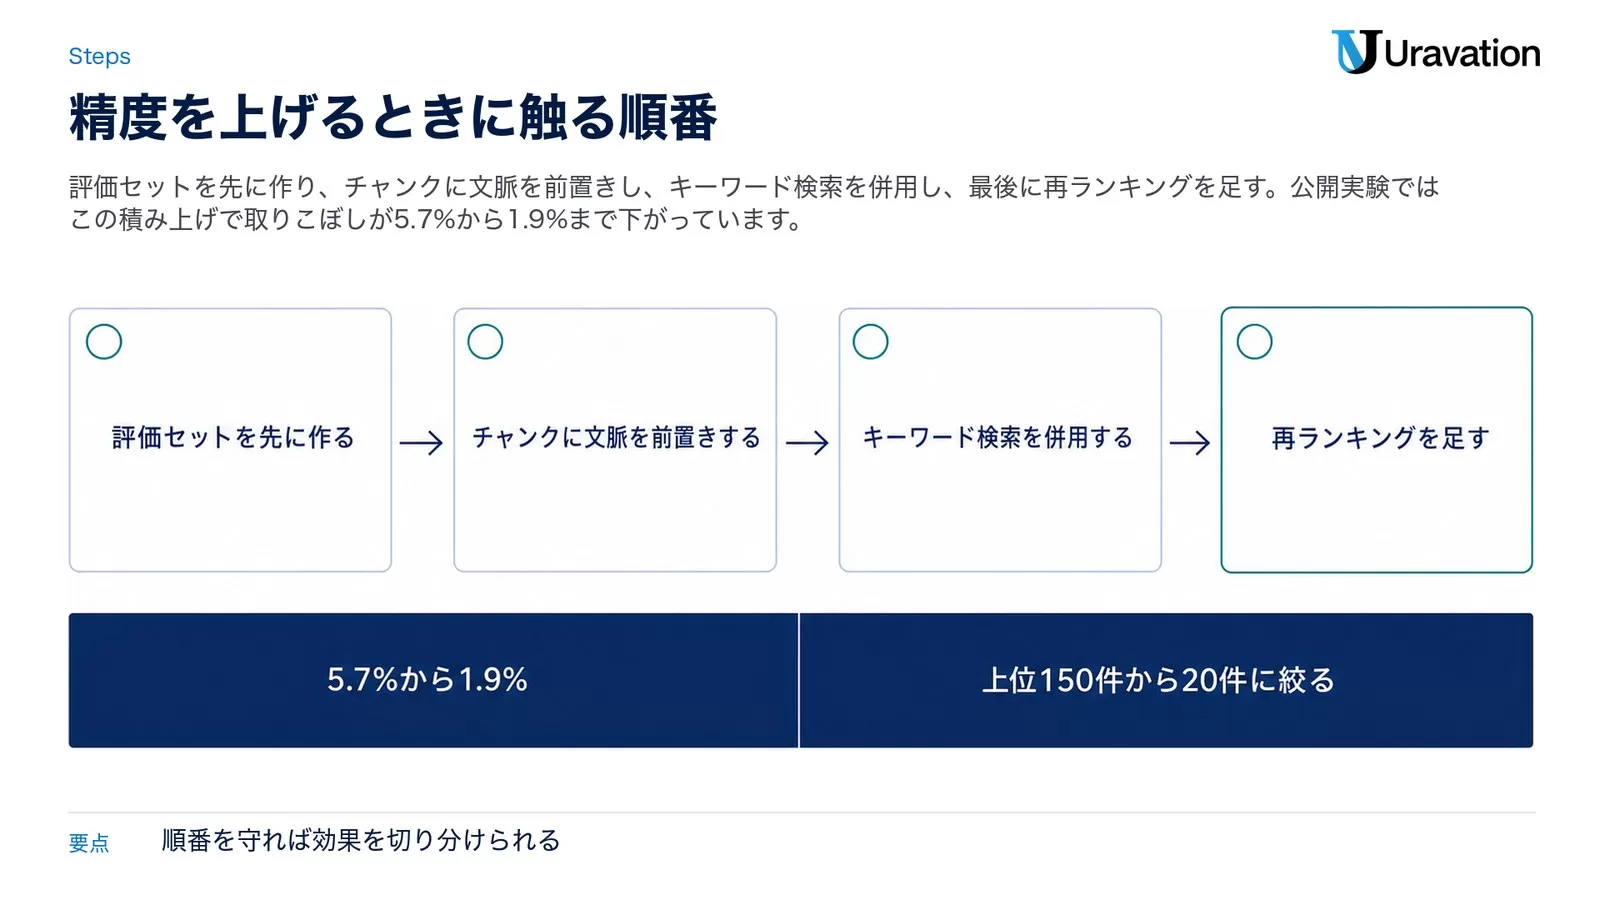
- 要点3:精度を上げる順番は決まっています。評価セットを作る→分割に文脈を足す→ハイブリッド検索にする→再ランキングを足す。Anthropic の公開実験では、上位20件に正解が入らなかった割合が5.7%から、文脈付けで3.7%、ハイブリッド検索の併用で2.9%、再ランキングの追加で1.9%まで下がっています。
対象読者:社内文書を使った質問応答やAIエージェントの知識源をこれから実装する開発者・PM。
今日やること:公式のクイックスタートを1つだけ動かして、上位何件が返るかと、出典に文書名が付くかを確認する。並行して、質問20問と「その答えが載っている文書」の対を書き出す。
言葉の分解から始めます。Retrieval は「検索・取り出し」、Augmented は「補強された」、Generation は「生成」。つまり「検索で補強した生成」です。日本語では検索拡張生成と訳され、読み方は「ラグ」が一般的で「アールエージー」と読む人もいます。ただし日本語の読み方を定めた公式の記載は2026年9月27日時点で確認できません。元論文の表記は一貫して大文字の「RAG」で、本文では「RAG models」と数えられる名詞として扱われています。
出発点は2020年5月22日に arXiv へ投稿され、NeurIPS 2020 に採択された論文「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」(Patrick Lewis ほか12名・最終改訂2021年4月12日)です。論文は前提をこう書いています。大規模な事前学習モデルは事実知識をパラメータの中に持っているが、その知識に正確にアクセスしたり書き換えたりする能力は限られており、判断の根拠を示すことと世界知識を更新することは未解決の課題である。そこで、学習済みの seq2seq モデルをパラメトリック記憶、Wikipedia の密ベクトル索引を非パラメトリック記憶として組み合わせ、検索器を通して読ませる。これが RAG の原型です。
論文は、生成する文全体で同じ検索結果を条件にする形と、トークンごとに別の検索結果を使える形の2つを比べ、3つのオープンドメイン質問応答タスクで当時の最高精度を出し、文章生成では「より具体的で、多様で、事実に即した言葉を生成した」と報告しています。つまり RAG は最初から事実性・根拠の提示・知識の更新の3点を同時に解くための設計でした。2026年の実装で「出典を返す」「文書を差し替えれば答えが変わる」が当たり前なのは、この出発点の延長線です。
実務での線引きも単純です。社内規程・製品マニュアル・問い合わせ履歴のようにモデルが学習していない・学習させたくない・頻繁に変わる文書を扱うなら RAG が第一候補、口調や出力形式を固定したいだけなら的を外します。
RAGの5段の流れ|取り込み・分割・埋め込み・検索・生成
RAG は5つの段に分かれます。どの段でつまずいているかが分かれば直す場所は決まります。各段の「公式に書かれている既定値」を並べます。
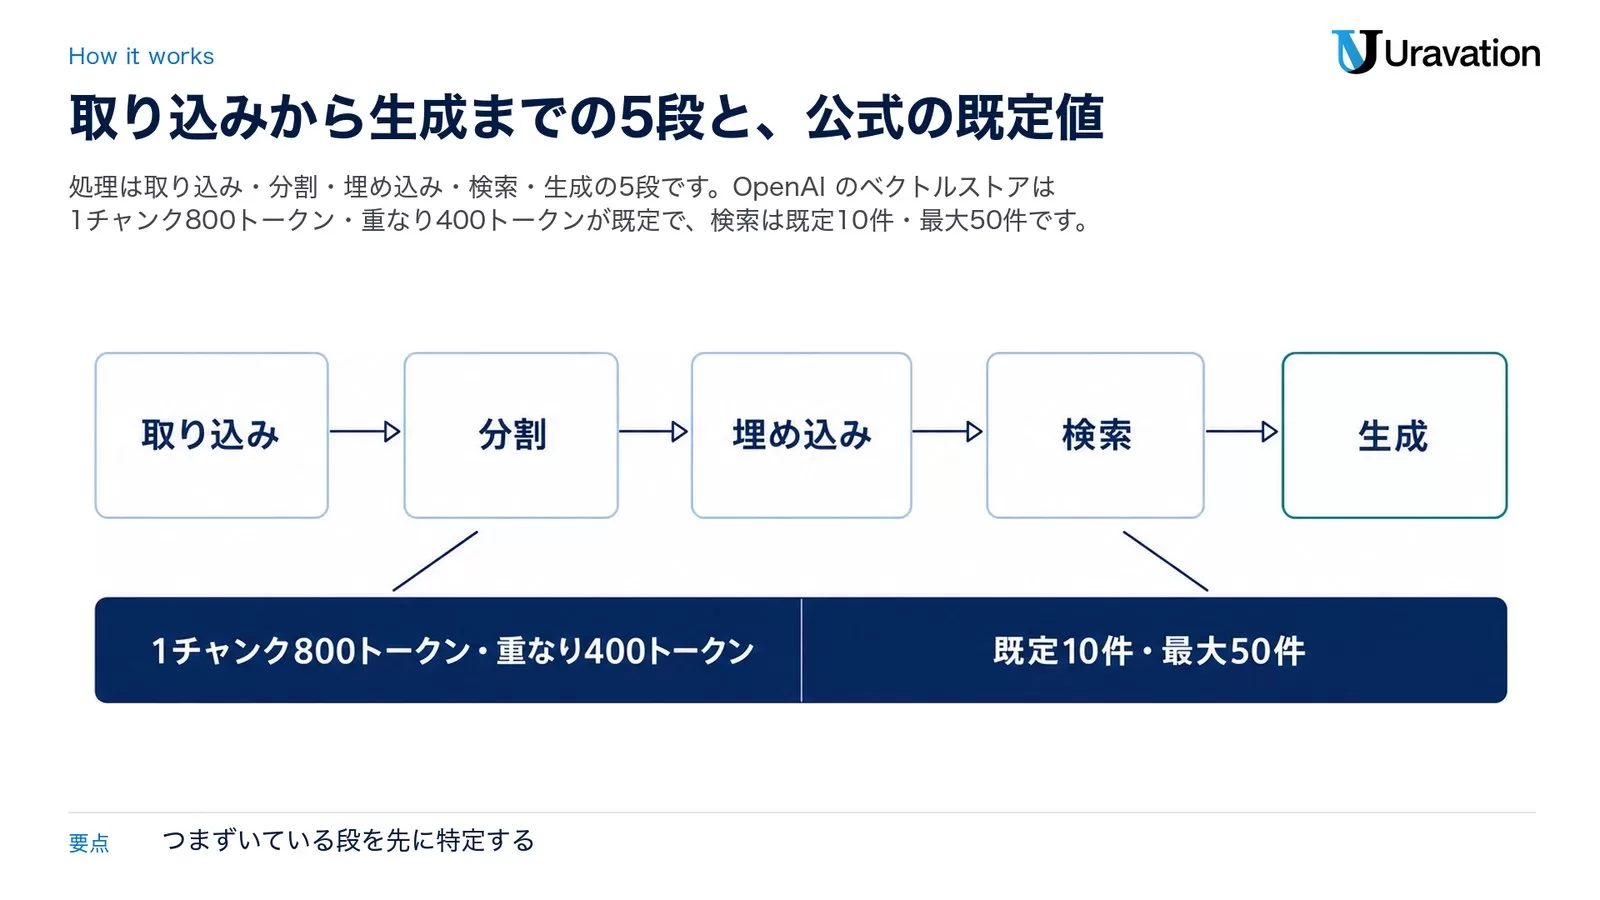
| 段 | やること | 公式に書かれている既定値・制限(2026年9月27日時点) |
|---|---|---|
| 1 取り込み | PDF・Word・Markdown などを読み込む | OpenAI のベクトルストアは1ファイル512 MB以下・1ファイル500万トークン以下。対応形式は .pdf/.docx/.doc/.md/.txt/.html/.json/.pptx と .py・.js・.java などのコードで、text 系の文字コードは utf-8/utf-16/ascii のいずれか |
| 2 分割 | 数百トークン単位のチャンクに切る | OpenAI の既定は1チャンク800トークン・重なり400トークン。指定できる範囲は100〜4,096トークンで、重なりはチャンクサイズの半分以下。LangChain は RecursiveCharacterTextSplitter(chunk_size=1000・chunk_overlap=200)を「一般的な文章に推奨する分割器」と説明 |
| 3 埋め込み | チャンクをベクトルに変える | text-embedding-3-small は既定1,536次元・最大入力8,192トークン、text-embedding-3-large は既定3,072次元。gemini-embedding-2 は128〜3,072次元の可変(推奨は768・1,536・3,072)で最大入力8,192トークン |
| 4 検索 | 質問に近いチャンクを取り出す | OpenAI の search は既定10件・最大50件(max_num_results で指定)。rewrite_query=true で質問を検索向けに書き換え、attribute_filter で対象ファイルを絞り、ranking_options で並べ替え(score_threshold は0.0〜1.0、hybrid_search は embedding_weight と text_weight で重み付け) |
| 5 生成 | 取り出した本文を渡して答えさせる | Claude は search_result ブロック(type・source・title・content が必須)で渡すと、回答に search_result_location 形式の引用が自動で付く。引用は既定で無効なので citations.enabled を true にする |
3段目の埋め込みは「意味の近さを座標で表す」段です。OpenAI の公式ガイドには分かりやすい例が載っています。「moon cake(月餅)」を含む検索語に対して、キーワードの重なりで測ると40%の一致に見える文と、意味の近さ(コサイン類似度)で測ると28%と出る文があり、いちばん関係のある結果は検索語の単語を1つも含んでいないことがある。これが意味検索の強みで、同時に「型番やエラーコードを外す」弱みの説明にもなっています。埋め込みモデルの選び方はEmbeddingモデル選定ガイドに、保管先の選び方はAIエージェント用ベクトルDBの比較にまとめています。
2段目の分割は結果がいちばん大きく動く場所です。Anthropic は「チャンクは通常でも数百トークンを超えないように」と書き、「チャンクサイズ・切れ目・重なりの選び方が検索性能に影響する」と注意しています。決め方はRAGチャンキング戦略、PDFや表を崩さずに取り込む方法はドキュメント抽出・パースで扱っています。
5段目で見落とされがちなのが出典です。Anthropic の検索結果ブロックは、source に「URL でも kb://article-1234 のような内部識別子でも、安定した文字列なら何でもよい」と書かれています。引用には cited_text(引用された本文そのもの)が付き、この cited_text は出力トークンとして課金されないと明記されています。引用の最小単位は content 配列の1ブロックなので、細かく引用させたいならチャンクを複数のテキストブロックに分けて渡します。
{
  "type": "search_result",
  "source": "https://example.com/article",
  "title": "Article Title",
  "content": [
    { "type": "text", "text": "The actual content of the search result..." }
  ],
  "citations": { "enabled": true }
}
上は Anthropic 公式ドキュメントに載っている検索結果ブロックの形です(公式の例・当社で実行した結果ではありません)。search_result は Messages API の標準機能で、ベータヘッダーは不要、Claude Haiku 3 を除く現行モデルすべてで使えると書かれています。渡し方は2通りで、ツールの戻り値として返す形(実行時に取りに行く動的なRAG)と、ユーザーメッセージに直接置く形(取得済み・キャッシュ済みの本文を渡す)です。
ファインチューニング・長文コンテキストとの使い分け
「RAGとファインチューニングはどちらがよいか」は問いの立て方が違います。変えられる対象が別なので「何を変えたいのか」から入ります。2026年9月27日時点の公式の状況も併記します。
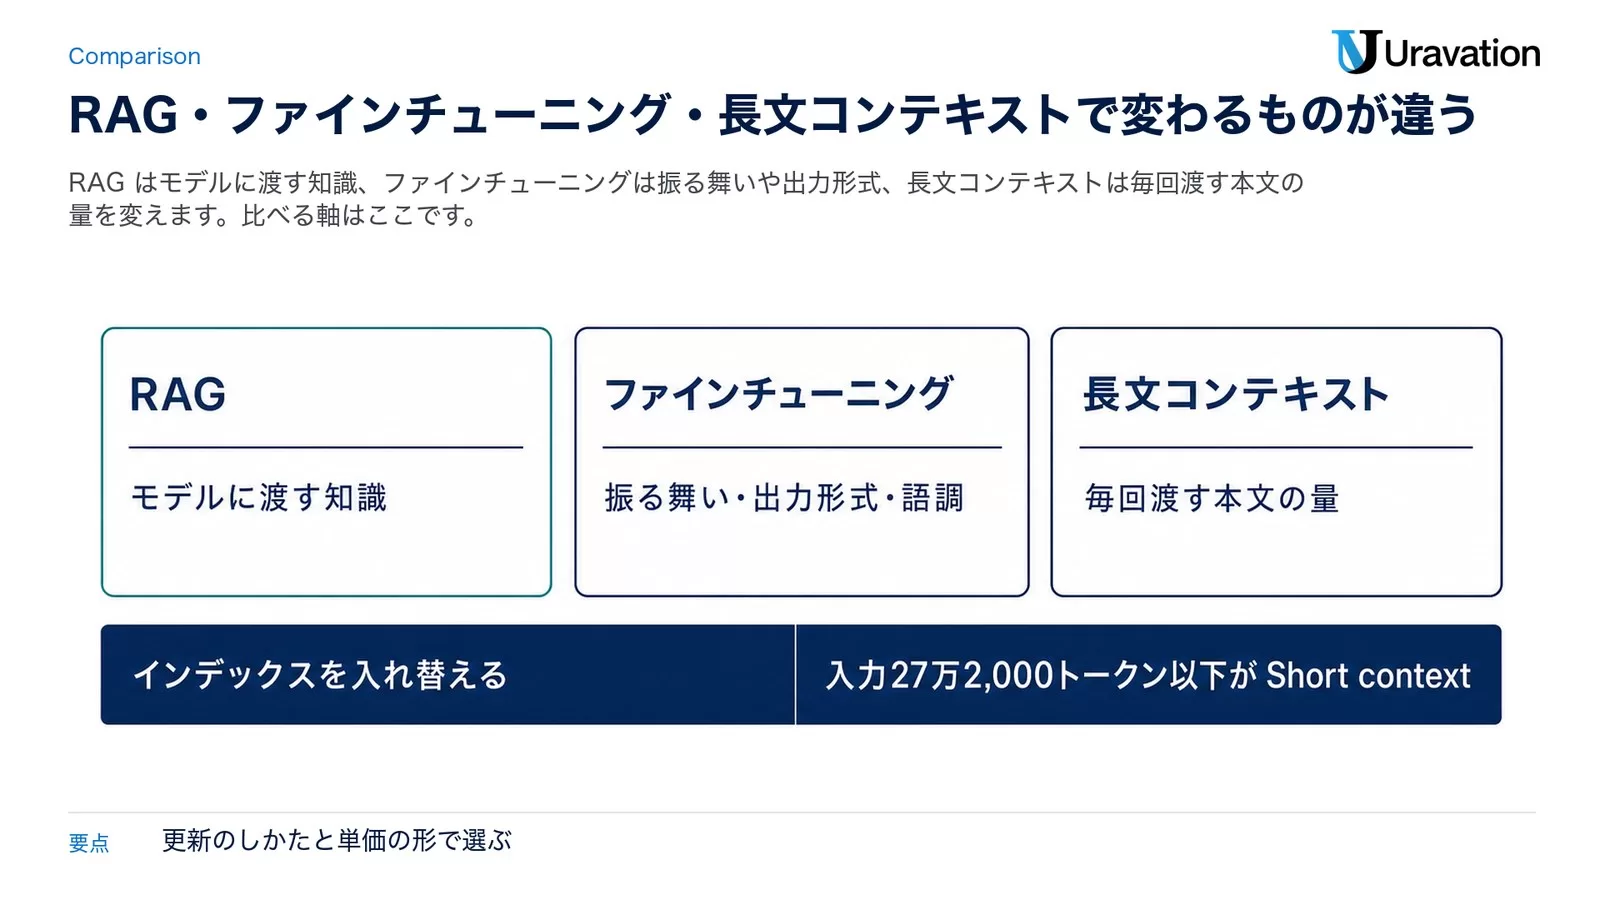
| 手段 | 何が変わるか | 更新のしかた | 出典を返せるか | 公式の状況(2026年9月27日時点) |
|---|---|---|---|---|
| RAG | モデルに渡す知識 | インデックスを入れ替える(学習し直さない) | 返せる | 各社が標準機能として提供。OpenAI は Retrieval API とベクトルストア、Anthropic は search_result ブロックで自動引用 |
| ファインチューニング | 振る舞い・出力形式・語調 | 学習ジョブを回す(データ整備が前提) | 返せない | OpenAI は料金ページに「ファインチューニングのプラットフォームを段階的に終了する。新規ユーザーは利用できず、既存利用者は今後数か月は学習ジョブを作成できる」と明記。学習済みモデルはベースモデルの廃止まで推論に使える |
| 長文コンテキスト | 毎回渡す本文の量 | 渡す文書を差し替える | プロンプト内の位置で示す | Claude 4.6 以降は100万トークンの文脈まで標準単価(90万トークンの依頼も9,000トークンの依頼と同じ単価)。OpenAI は入力27万2,000トークン以下が Short context、超えると Long context で単価が上がる(gpt-6-sol は入力100万トークンあたり2.00ドル→4.00ドル) |
| プロンプトだけ | 指示の書き方 | 文章を直す | 返せない | 費用も実装も最小。まずここで足りるかを確かめる |
注目したいのは、OpenAI がファインチューニングのプラットフォームを閉じる方向に動いている点です。2026年9月27日の料金ページには、新規ユーザーが使えないことと、既存利用者の学習ジョブ作成が「今後数か月」に限られることが書かれています。ファインチューニング前提で組んでいた社内ナレッジの計画は、この記載に当たっていないか確認したい局面です。判断基準はRAG・ファインチューニング・プロンプトの使い分けに整理しています。
「文脈窓が広がったからRAGは不要」という話は、単価の形を見ると結論が変わります。Claude 4.6 以降は100万トークンまで標準単価で長文を入れやすい一方、入力トークンは毎回課金される点は変わりません。同じ文書を毎回まるごと渡せば1問ごとにその分の入力料金が乗ります。RAG は「毎回渡す量を上位20件ほどに絞る」ことでこの費用を削っている、と見るのが実務に近いです。固定の前置き(指示文・用語集)はプロンプトキャッシュに寄せるとさらに下がり、Claude Opus 5.5 ではキャッシュ読み出しが入力単価の5%(100万トークンあたり0.20ドル)です。
最短の作り方|公式ドキュメントの最小構成3通り
以下は各社の公式ドキュメントに載っている最小構成です。当社で実行して測った結果ではなく、公式の例をそのまま並べています。どれで始めても5段の流れは同じです。
1. OpenAI の Retrieval API(ベクトルストアを作ってファイルを入れ、自然文で検索する)
from openai import OpenAI
client = OpenAI()

vector_store = client.vector_stores.create(name="Support FAQ")
client.vector_stores.files.upload_and_poll(
    vector_store_id=vector_store.id,
    file=open("customer_policies.txt", "rb"),
)

results = client.vector_stores.search(
    vector_store_id=vector_store.id,
    query="How many woodchucks are allowed per passenger?",
)公式ガイドでは、ファイルをベクトルストアに入れた時点で分割・埋め込み・索引付けが自動で行われます。戻り値には該当チャンク・類似度スコア・元のファイルが含まれます。並べ替えは ranking_options に ranker(auto または default-2024-08-21)と score_threshold を渡し、キーワード一致も効かせたいときは hybrid_search の embedding_weight と text_weight を指定します。公式は後者を「逆順位融合が意味の近さと文字の重なりをどう釣り合わせるかを決める重み」と説明しています。
2. LangChain(分割器と埋め込みとベクトルストアを自分で組む)
from langchain_openai import OpenAIEmbeddings
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_text_splitters import RecursiveCharacterTextSplitter

embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
vector_store = InMemoryVectorStore(embeddings)

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000, chunk_overlap=200, add_start_index=True
)
all_splits = text_splitter.split_documents(docs)
ids = vector_store.add_documents(documents=all_splits)

results = vector_store.similarity_search(
    "How many distribution centers does Nike have in the US?"
)
公式ページは add_start_index=True を付けて「各チャンクが元文書のどの文字位置から始まるか」をメタデータに残すことを勧めています。検索は文字列でもベクトルでも、スコア付きでも、最大限界関連度(多様性も取る並べ方)でも呼べます。差し替えられるベクトルストアとして Chroma・Milvus・MongoDB・PGVector・Pinecone・Qdrant・Astra DB が並んでいます。エージェントまで組む場合はLangChainでAIエージェントを構築する完全ガイドを併せて読んでください。
3. LlamaIndex(フォルダを読ませて検索できる道具にする)
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
query_engine = index.as_query_engine()

response = await query_engine.aquery("What did the author do in college?")
LlamaIndex の公式スタート例には注意書きがあります。Settings.embed_model を設定しない場合、VectorStoreIndex は OpenAIEmbedding に落ち、既定で text-embedding-ada-002 が使われます。新規のプロジェクトでは OpenAIEmbedding(model=”text-embedding-3-small”) を明示するよう公式が勧めています。APIキーなしで手元だけで動かしたい場合は、HuggingFaceEmbedding(model_name=”BAAI/bge-small-en-v1.5″) に差し替える2行の例も載っています。この検索エンジンをそのままエージェントの道具にすると、いわゆる Agentic RAG になります。詳しい型はAgentic RAG実践ガイドとLlamaIndex完全ガイドで整理しています。
Google のモデルで埋め込みを作る場合は、公式ドキュメントの例が最短です。gemini-embedding-2 は task_type を受け付けないので、用途の指示はプロンプト側に書くと明記されています(gemini-embedding-001 は RETRIEVAL_DOCUMENT・RETRIEVAL_QUERY・QUESTION_ANSWERING など8種類の task_type を取ります)。
from google import genai

client = genai.Client()

result = client.models.embed_content(
    model="gemini-embedding-2",
    contents="What is the meaning of life?"
)

print(result.embeddings)
精度を上げる順番|評価を先に作り、分割・ハイブリッド・再ランキングの順で直す
RAG の改善はつまみが多く、順番を決めずに触ると「前より良くなったのか分からない」状態に入ります。順番の根拠として公開されている一次データでいちばん具体的なのが Anthropic の Contextual Retrieval の実験です。指標は「1 − recall@20」、つまり上位20件のチャンクに正解の文書が入らなかった割合で、低いほど良い数字です。
| 打ち手 | 上位20件で取りこぼした割合 | 元の5.7%からの改善 |
|---|---|---|
| 何もしない(埋め込みだけ) | 5.7% | — |
| チャンクに文脈を前置きする(Contextual Embeddings) | 3.7% | 35%減 |
| さらにキーワード検索を併用する(Contextual BM25) | 2.9% | 49%減 |
| さらに再ランキングを足す | 1.9% | 67%減 |
積み上げると、上位20件での取りこぼしは5.7%から1.9%まで下がります。1段ごとに何ポイント動いたかを自分の評価セットで確かめてから次へ進むのが、この順番の使い方です。
手順0:評価セットを先に作る。数字が動いたかどうかを見る土台がないと、以降の改善はすべて感想になります。RAGAS の公式ドキュメントは RAG 向けの指標として Context Precision・Context Recall・Context Entities Recall・Noise Sensitivity・Response Relevancy・Faithfulness を挙げています。最初に見るべきは Context Recall(正解の文書が取り出せたか)と Faithfulness(渡した本文に忠実に答えたか)の2つです。検索が取れていないのか、取れているのに答えが本文から外れているのか、この2つで切り分けられます。測り方はRAGの精度を測る|RAGASと評価指標にまとめています。
手順1:チャンクに文脈を前置きする。Anthropic が挙げている例が分かりやすいです。「当社の売上は前四半期比で3%伸びた」というチャンクは、それ単体ではどの会社のいつの話か分からないため、正しく取り出せず、取り出せても使えません。そこで各チャンクの前に、文書全体のなかでの位置づけを説明する50〜100トークンの文を付けてから埋め込みとキーワード索引を作ります。公式は付ける文を Claude 3 Haiku に生成させるプロンプトを公開しており、プロンプトキャッシュを使えば文書100万トークンあたり1.02ドル(1ドル150円換算で153円)の一度きりの費用で済むと書いています(前提は800トークンのチャンク・8,000トークンの文書・50トークンの指示・チャンクごとに100トークンの文脈)。
手順2:キーワード検索を併用する(ハイブリッド検索)。BM25 は文字の一致で順位を付ける手法で、TF-IDF を土台に文書の長さと語の出現回数の飽和を考慮したものだと公式記事は説明しています。効き方の例も具体的です。技術サポートのデータベースで「Error code TS-999」と検索したとき、埋め込みモデルは「エラーコード全般」の文書を見つけても TS-999 そのものを外すことがある。BM25 はこの文字列を探しに行く。だから両方を組み合わせて上位を取り、重複を除いてから渡す、という順番になります。OpenAI 側でも ranking_options.hybrid_search の重みで同じ考え方が設定できます。具体的な組み方はRAG精度を上げるリランク・ハイブリッド検索にあります。
手順3:再ランキングを足す。実験の手順は、最初の検索で上位150件を取り、質問と一緒に再ランキングモデルへ渡して関連度で点を付け、上位20件だけをモデルに渡す形です(上位150件から20件に絞る)。公式は「実行時に1段増えるので少しだけ遅くなる」「多く並べ替えれば精度は上がるが費用と待ち時間は増える」というトレードオフを明言し、渡す件数は5件・10件・20件を比べて20件がいちばん良かったとしています。同時に「情報が多すぎるとモデルの気が散るので限度がある」とも注意しています。
手順4:質問側を直す。OpenAI の検索には rewrite_query があり、有効にすると質問を検索向きに書き換えます。公式の例では「本社ビルの高さを知りたいのですが」が「primary office building height」、「サービスの不具合について苦情を申し立てるにはどうすればよいですか」が「service complaint filing process」に変わり、書き換え後の文字列は search_query フィールドで確認できます。さらに踏み込む場合はRAGの検索精度をクエリ側で上げるを参照してください。
手順5:GraphRAG(グラフRAG)を検討する
ここまでの4手順は「似ている文を上手に取り出す」路線です。それでも答えられない質問が残ります。Microsoft の GraphRAG は素のベクトル検索をBaseline RAGと呼び、苦手な場面を2つに絞っています。1つは「点と点をつなげる質問」=共通する属性をたどって別々の情報を渡り歩かないと答えが作れない質問。もう1つは「大量の文書、あるいは1本の長い文書の全体像を要約して理解する質問」で、「この資料群の主要なテーマは何か」がこれに当たります。
GraphRAG の処理は、文書を TextUnits に切る→実体・関係・主要な主張を抽出する→Leiden 法でグラフを階層的にクラスタリングする→コミュニティ単位の要約を下から積み上げる、という流れです。検索は4種類に分かれ、全体像を問う質問は Global Search(コミュニティ要約を使う)、特定の実体を問う質問は Local Search(隣接ノードへ広げる)、その両方を組み合わせるのが DRIFT Search、素のベクトル検索で足りる質問は Basic Search です。公式の導入手順は Python 3.10〜3.12 で次の4行です。
python -m pip install graphrag
graphrag init
graphrag index
graphrag query "What are the top themes in this story?"
公式ドキュメントの冒頭には警告が置かれています。「GraphRAG は LLM のリソースを大量に消費する可能性がある。仕組みを理解するまではチュートリアルのデータセットで始め、大きな索引付けに踏み込む前に速くて安いモデルで試すことを強く勧める」。加えて「そのまま使うと最良の結果にならない場合がある」ためプロンプトの調整を勧めており、マイナーバージョンが上がったときは graphrag init --root [path] --force を実行して設定の形式を合わせるよう書かれています。実装の手触りはGraphRAG実践ガイドにまとめました。
費用の見方|埋め込み・検索・生成の単価(2026年9月27日時点)
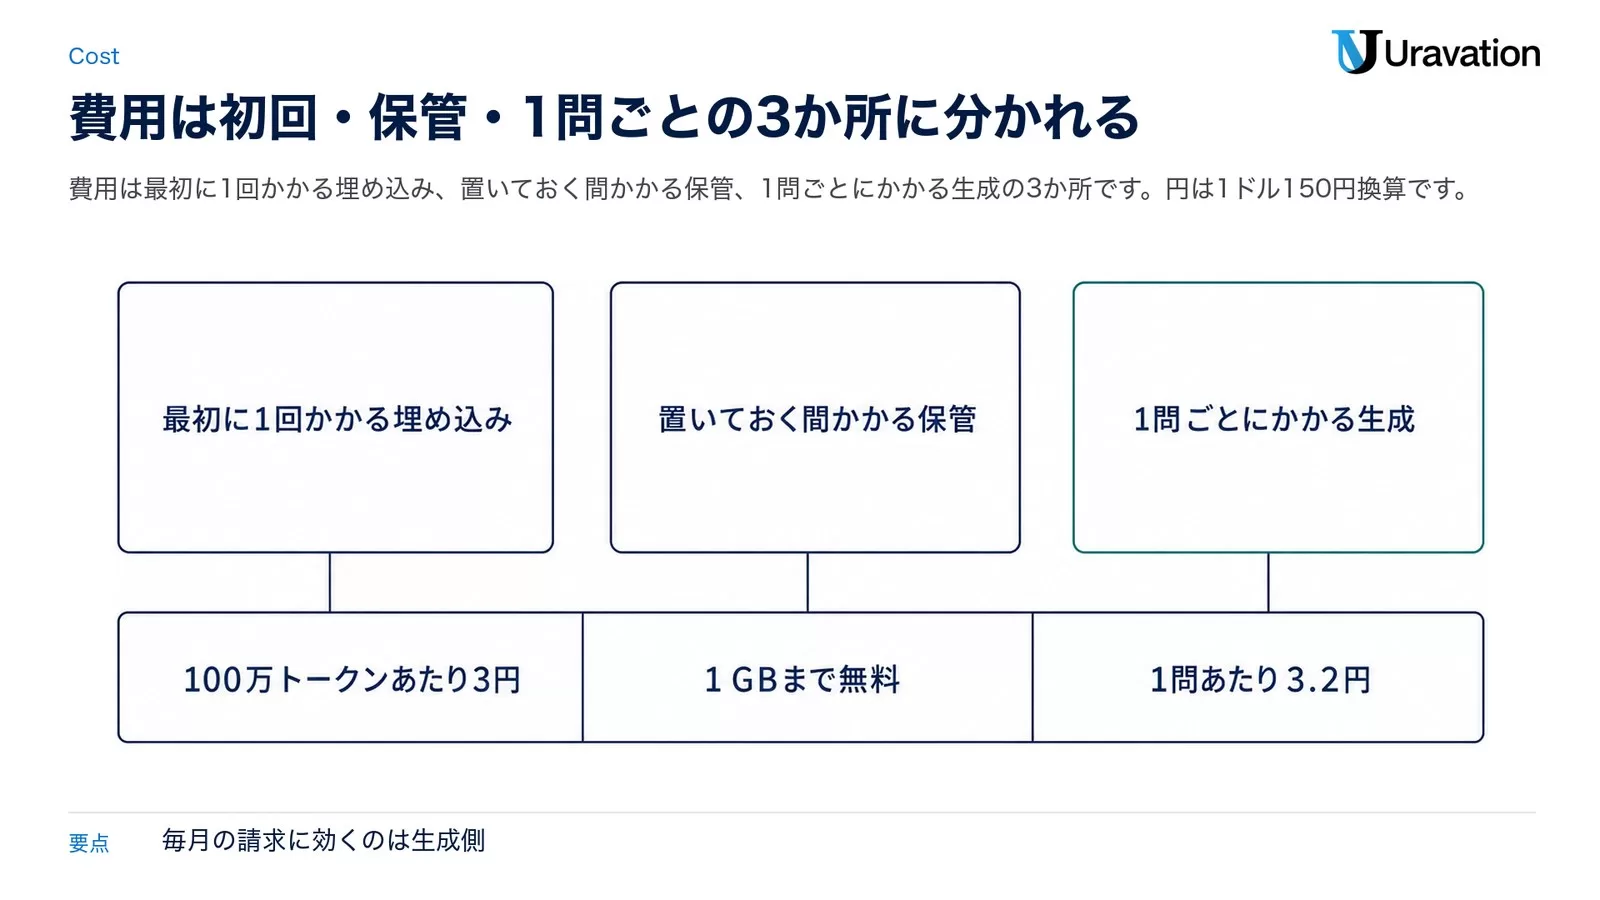
RAG の費用は3か所に分かれます。最初に1回かかる埋め込み、置いておく間かかる保管、1問ごとにかかる生成です。金額はすべて2026年9月27日の公式料金ページの値で、円は1ドル150円換算です。
| 埋め込みモデル | 100万トークンあたり | 円換算 | 既定の次元数 | 最大入力 | 1ドルで処理できるページ数(1ページ約800トークン換算) |
|---|---|---|---|---|---|
| text-embedding-3-small | 0.02ドル | 3円 | 1,536 | 8,192トークン | 62,500ページ |
| text-embedding-3-large | 0.13ドル | 19.5円 | 3,072 | 8,192トークン | 9,615ページ |
| text-embedding-ada-002 | 0.10ドル | 15円 | 公式ガイドに記載なし | 8,192トークン | 12,500ページ |
| gemini-embedding-2(テキスト入力) | 0.20ドル | 30円 | 128〜3,072の可変(推奨768・1,536・3,072) | 8,192トークン | 公式に記載なし |
OpenAI の公式ガイドには MTEB という多言語ベンチマークの値も併記されており、text-embedding-3-small が62.3%、text-embedding-3-large が64.6%、text-embedding-ada-002 が61.0%です。3-large は3-small の6.5倍の単価で、ベンチマークの差は2.3ポイント。この差に見合うかどうかは、自前の評価セットで確かめる以外に決め方がありません。なお gemini-embedding-2 は画像・音声・動画も同じモデルで扱え、画像入力が100万トークンあたり0.45ドル、音声が6.50ドル、動画が12.00ドルです。gemini-embedding-001 の単価は2026年9月27日時点の公式料金ページで確認できていません。
保管側は次のとおりです。OpenAI のベクトルストアは、すべてのストアを合わせて1 GBまで無料、それを超えた分が1 GBあたり1日0.10ドル(15円)。課金の対象は「分割後のチャンクとその埋め込みの合計サイズ」と明記されています。file search ツールの呼び出しは1,000回あたり2.50ドル(375円)、web search は1,000回あたり10.00ドル(1,500円)です。
| 生成モデル | 入力100万トークン | 出力100万トークン | キャッシュ読み出し(入力100万トークン) |
|---|---|---|---|
| gpt-6-luna | 0.10ドル(15円) | 0.50ドル(75円) | 0.01ドル |
| gpt-6-sol | 2.00ドル(300円) | 10.00ドル(1,500円) | 0.20ドル |
| gpt-6-astra | 10.00ドル(1,500円) | 50.00ドル(7,500円) | 1.00ドル |
| Claude Haiku 5.5(2026年10月7日公開・プロンプト10万トークン以下) | 0.10ドル(15円) | 0.50ドル(75円) | 0.01ドル |
| Claude Sonnet 5.5(2026年9月28日公開) | 2ドル(300円) | 10ドル(1,500円) | 0.10ドル(2026年10月7日から) |
| Claude Haiku 4.5(前世代) | 1ドル(150円) | 5ドル(750円) | 0.10ドル |
| Claude Sonnet 5(前世代) | 2ドル(300円) | 10ドル(1,500円) | 0.20ドル |
| Claude Opus 5.5 | 4ドル(600円) | 20ドル(3,000円) | 0.20ドル |
| Gemini 3.8 Flash | 0.75ドル(約113円) | 3.75ドル(約563円) | 公式料金ページの当該欄では確認できず |
| Gemini 3.5 Flash-Lite | 0.30ドル(45円) | 2.50ドル(375円) | 公式料金ページの当該欄では確認できず |
OpenAI の数値は入力27万2,000トークン以下の Short context の列です。超えると Long context の単価に切り替わり、gpt-6-sol なら入力が2.00ドルから4.00ドルへ上がります。Gemini 3.8 Flash の価格には「2026年12月31日まで」という期限が付いています。
試算例(実測値ではありません・前提と計算式を明示します)。前提は、社内文書1,000万トークン、1問あたり入力8,000トークン(上位20件のチャンク+質問+指示)・出力500トークン、月1万問です。
- 初回の埋め込み:10 × 0.02ドル = 0.20ドル(30円)。text-embedding-3-large なら10 × 0.13ドル = 1.30ドル(195円)。
- 文脈の前置き(Contextual Retrieval):公式の見積り1.02ドル/文書100万トークンで、10 × 1.02ドル = 10.20ドル(1,530円)の一度きり。
- 保管:1 GBを超えた分だけ1 GBあたり1日0.10ドル(15円)。
- 生成(gpt-6-sol):(8,000 × 2.00 + 500 × 10.00) ÷ 1,000,000 = 0.021ドル ≒ 3.2円/問。月1万問で210ドル(31,500円)。
- 生成(gpt-6-luna):(8,000 × 0.10 + 500 × 0.50) ÷ 1,000,000 = 0.00105ドル ≒ 0.16円/問。月1万問で10.5ドル(1,575円)。
まとめると、埋め込みは100万トークンあたり3円から、保管は1 GBまで無料、生成は1問あたり3.2円(gpt-6-sol の試算)です。固定の前置きが長い構成では、キャッシュ読み出しが入力の5%になります。
この形にすると、費用を下げる順番も見えます。まず生成モデルの選び直し(1問あたりが20倍違う)、次に渡す件数と指示文の圧縮、最後に埋め込みモデルです。埋め込みは初回の一括処理が支配的で、毎月の請求に効くのは生成側です。固定の前置きが長い構成なら、プロンプトキャッシュの読み出し単価(Claude Opus 5.5 で入力の5%、gpt-6-sol で0.20ドル)が効きます。索引の作り直しをどの頻度で回すかはRAGインデックス運用ガイドで扱っています。
RAG導入でつまずく失敗パターン4つ
順番の話と裏表ですが、実装が止まる場所には型があります。
失敗1:評価セットを作らずにチャンクサイズをいじる
- ❌ 800トークンを400にし、次は1,200にし、体感で「今のほうが良い気がする」と決める。次の週に別の人が同じ作業を繰り返す。
- ⭕ 質問20〜50問と「その答えが載っている文書」の対を先に固定し、Context Recall(正解の文書が上位に入った割合)を毎回同じ手順で出す。数字が動かない変更は採用しない。公式が挙げている評価指標名をそのまま使えば、後から人が増えても指標の意味がぶれません。
失敗2:意味検索だけで型番・エラーコード・社内略語を探させる
- ❌ 埋め込み検索だけで「TS-999」「発注No.」「部門コード」を引かせ、「エラーコード全般の説明」が返ってきて外す。
- ⭕ BM25 などのキーワード検索を併用し、両方の上位を統合してから渡す。OpenAI のベクトルストアなら ranking_options.hybrid_search の embedding_weight と text_weight を設定する(どちらかは0より大きくする必要があると公式に明記されています)。
失敗3:チャンクを短くしすぎて「どの会社のいつの話か」が消える
- ❌ 200トークンまで細かく切って「売上は前四半期比で3%伸びた」だけのチャンクを大量に作る。検索では当たらず、当たっても答えの根拠にならない。
- ⭕ チャンクの前に、文書全体のなかでの位置づけを説明する50〜100トークンの文を付けてから埋め込みと索引を作る。付ける文は安いモデルに生成させ、元文書はプロンプトキャッシュに載せて使い回す。
失敗4:権限と出典を後回しにする
- ❌ 全部署の文書を1つのインデックスに入れて動かし、後から「この部署には見せられない文書が混ざっている」と分かる。回答に出典が付いていないので、どの文書が漏れたかも追えない。
- ⭕ 絞り込みの設計を先に決める。OpenAI なら attribute_filter でファイルの属性(部署・日付・言語など)で範囲を限定し、Anthropic なら search_result の source と title を必ず埋めて引用を有効にする。source は内部識別子でもよいので、社内文書管理の ID をそのまま入れられます。権限とマスキングの設計はRAGのデータセキュリティ実装にまとめています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
よくある質問
RAGとは何の略ですか?
Retrieval-Augmented Generation の略です。日本語では検索拡張生成と訳されます。2020年5月22日に arXiv へ投稿され NeurIPS 2020 に採択された論文「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」で提案された用語で、論文は学習済みモデル内部の知識(パラメトリック記憶)と外部の検索できる知識(非パラメトリック記憶)を組み合わせる方式として定義しています。
RAGはどう読みますか?
日本語では「ラグ」と読まれることが多く、「アールエージー」と読む例もあります。ただし2026年9月27日時点で、読み方を定めた公式の記載は確認できません。元論文は大文字の「RAG」と表記し、本文では「RAG models」のように数えられる名詞として扱っています。
RAGを簡単に言うと何をしているのですか?
「答えの前に社内の文書を検索して、見つかった本文をそのまま質問文に添えて渡し、その本文だけを根拠に答えさせる」ことです。モデルの中身は変えません。だから文書を差し替えればその日から答えが変わり、どの文書を使ったかを出典として返せます。
RAGとファインチューニングの違いは何ですか?
変えられる対象が違います。RAG は渡す知識を変え、ファインチューニングは振る舞いや出力形式を変えます。出典を返せるのは RAG だけです。なお OpenAI は2026年9月27日時点の料金ページで、ファインチューニングのプラットフォームを段階的に終了し新規ユーザーは利用できないと明記しています(学習済みモデルはベースモデルの廃止まで推論に使えます)。
RAGの具体例を挙げてください。
公式ドキュメントに出てくる例で言えば、OpenAI のクイックスタートは「Support FAQ」という名前のベクトルストアに社内規程のテキストを入れ、「乗客1人あたり何匹まで持ち込めるか」という自然文で検索する形です。Anthropic の例は社内ナレッジベースで、source に kb://article-1234 のような内部識別子を入れて引用させる形です。いずれも「モデルが学習していない社内文書に答えさせる」用途です。
ローカルRAGとは何ですか?
埋め込みと検索を外部APIに出さず、手元の環境で動かす構成の呼び方です。公式の最小例としては、LlamaIndex が HuggingFaceEmbedding(model_name=”BAAI/bge-small-en-v1.5″) に差し替える2行の手順を載せており、APIキーなしで完結する構成の案内もあります。生成モデルまで手元で動かす場合は、埋め込み・ベクトルストア・生成の3つをそれぞれ手元の実装に置き換えることになります。
ChatGPTのRAGとは何を指しますか?
「ChatGPT の RAG」という製品名は公式にはありません。開発者が API で同じことをする場合は、OpenAI の Retrieval API とベクトルストア、あるいは file search ツールを使います。file search のツール呼び出しは1,000回あたり2.50ドル(1ドル150円換算で375円)、ベクトルストアの保管は全体で1 GBまで無料で超過分が1 GBあたり1日0.10ドル(15円)です。
GraphRAG(グラフRAG)は通常のRAGと何が違いますか?
Microsoft の GraphRAG は、文書から実体と関係を抽出して知識グラフを作り、Leiden 法で階層的にまとめた要約を検索時に使います。公式は素のベクトル検索を Baseline RAG と呼び、それが苦手な2種類(別々の情報をたどらないと答えられない質問、大量の文書の全体像を要約する質問)に効くと位置づけています。ただし公式ドキュメントは「LLM のリソースを大量に消費する可能性がある」と警告しており、まず小さなデータセットと安いモデルで試すよう勧めています。
まとめ|今日やる3つと参考・出典
RAG は「検索してから答えさせる」の一文に尽きますが、動かしてから効くのは既定値の把握と順番の管理です。押さえる数字は3つ。分割の既定は800トークン・重なり400トークン、渡す件数は上位20件が公開実験で最良、取りこぼした割合は文脈付けとハイブリッド検索と再ランキングの積み上げで5.7%から1.9%まで下がる。
今日やることは次の3つです。
- 公式のクイックスタートを1つだけ動かす。OpenAI・LangChain・LlamaIndex のどれでもよいので、ファイルを1本入れて検索し、返ってきた件数と類似度スコアを目で見る。
- 質問20問と正解文書の対を書き出す。コードより先にこれを作ると、以降の変更が「良くなった気がする」で終わらなくなる。
- 単価を3か所に分けて紙に書く。初回の埋め込み・保管・1問あたりの生成。月の問い合わせ件数を掛けて、どこを削ると効くかを先に把握する。
エージェントに検索を持たせる段まで進むなら、次は検索を「道具」として呼ばせる設計に移ります。Agentic RAG実践ガイドと、社内文書を丸ごと扱う基盤の実例としてWeKnora導入手順が近い内容です。
参考・出典(すべて2026年9月27日取得)
- Patrick Lewis ほか「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」arXiv:2005.11401(2020年5月22日投稿・2021年4月12日改訂・NeurIPS 2020採択)
- OpenAI「Vector embeddings」(埋め込みモデルの次元数・最大入力・MTEB値)
- OpenAI「Retrieval」(ベクトルストア・既定の分割値・検索設定・保管料金)
- OpenAI「Pricing」(モデル単価・埋め込み単価・ツール料金・ファインチューニングの終了告知)
- Anthropic「Search results」(search_result ブロックと自動引用)
- Anthropic「Pricing」(モデル単価・キャッシュ単価・長文コンテキストの扱い)
- Anthropic「Contextual Retrieval in AI Systems」(文脈付け・BM25併用・再ランキングの改善率と費用)
- Google「Embeddings」(gemini-embedding-2/001 の次元数・task_type)
- Google「Gemini API pricing」(埋め込みとテキストモデルの単価)
- LangChain「Knowledge base」(RecursiveCharacterTextSplitter の推奨値・ベクトルストア連携)
- LlamaIndex「Starter Tutorial」(VectorStoreIndex の最小例・既定の埋め込みモデル)
- Microsoft「Welcome to GraphRAG」(Baseline RAG との違い・処理と検索の種類)
- Microsoft「GraphRAG Getting Started」(対応Pythonと導入コマンド・資源消費の警告)
- Ragas「List of available metrics」(RAG向け評価指標の一覧)
設計の順番と費用の見積りを社内で共有する段まで進んだ方へ
Uravationの無料資料では、AIエージェント導入の進め方と社内展開の手順をまとめています。個別の設計相談はお問い合わせから受け付けています。