判断の分かれ目は、Claude Codeの提案メッセージを「入力を少し楽にするUI」と見るか、「次に進む方向をモデル側から示す意思決定支援」と見るかに尽きます。
2026年10月7日時点で確認できる事実は、Claude Codeが会話履歴をもとに次のプロンプトを灰色の候補として生成し、利用者が採用・編集・破棄できることです。一方、「候補の採否や編集差分をモデル訓練の選好シグナルとして集めている」という見方は、元記事の仮説であって公式発表ではありません。元記事にはその後、Hacker News上でClaude Code担当を名乗る人物が、選好シグナル収集への利用を否定した旨が追記されています。
- 公開事実:候補文は同じセッションのモデルへの短いバックグラウンドリクエストで生成され、プランの利用枠またはAPIコストの対象になります。
- 未確認の仮説:無編集採用、編集、破棄を将来のモデル訓練に使っているという公式説明は確認できません。
- 日本企業の実務:採用率だけで便利さを判断せず、その後のタスク完了、手戻り、権限逸脱、レビュー負荷まで一続きで測るべきです。
きっかけは、2026年10月6日に公開されたZohaib Ansari氏の記事「The smartest Claude code feature is not for its users」です。Hacker Newsでは「Claude Code’s suggested message feature: I think the real customer is the model」という題で共有されました。記事が面白いのは、数秒の入力短縮ではなく、「次のユーザー発話を予測する仕組みは、モデル自身の改善や自律化に価値があるのではないか」と問題を置き換えた点にあります。
ただし、刺激的な仮説ほど事実との境界が重要です。ここでは、Anthropicの公式ドキュメント、元記事の追記、Hacker Newsの反応を分けたうえで、日本のAIエージェント運用に何を持ち帰るべきかを整理します。
ニュースの核心は「便利な予測」より「誰のための予測か」
最初に確認しておきたいのは、2026年10月6日にAnthropicがこの機能を新発表したわけではないことです。今回新しく公開されたのは、既存機能の意味を読み解く外部の考察記事です。Anthropic公式GitHubの変更履歴では、少なくともClaude Code 2.0.70で候補の採用操作、2.0.71でオン・オフの設定が記録されています。したがって、「新機能の発表」ではなく、「既存機能をめぐる新しい仮説と、それに対する反論」がニュースの実像です。
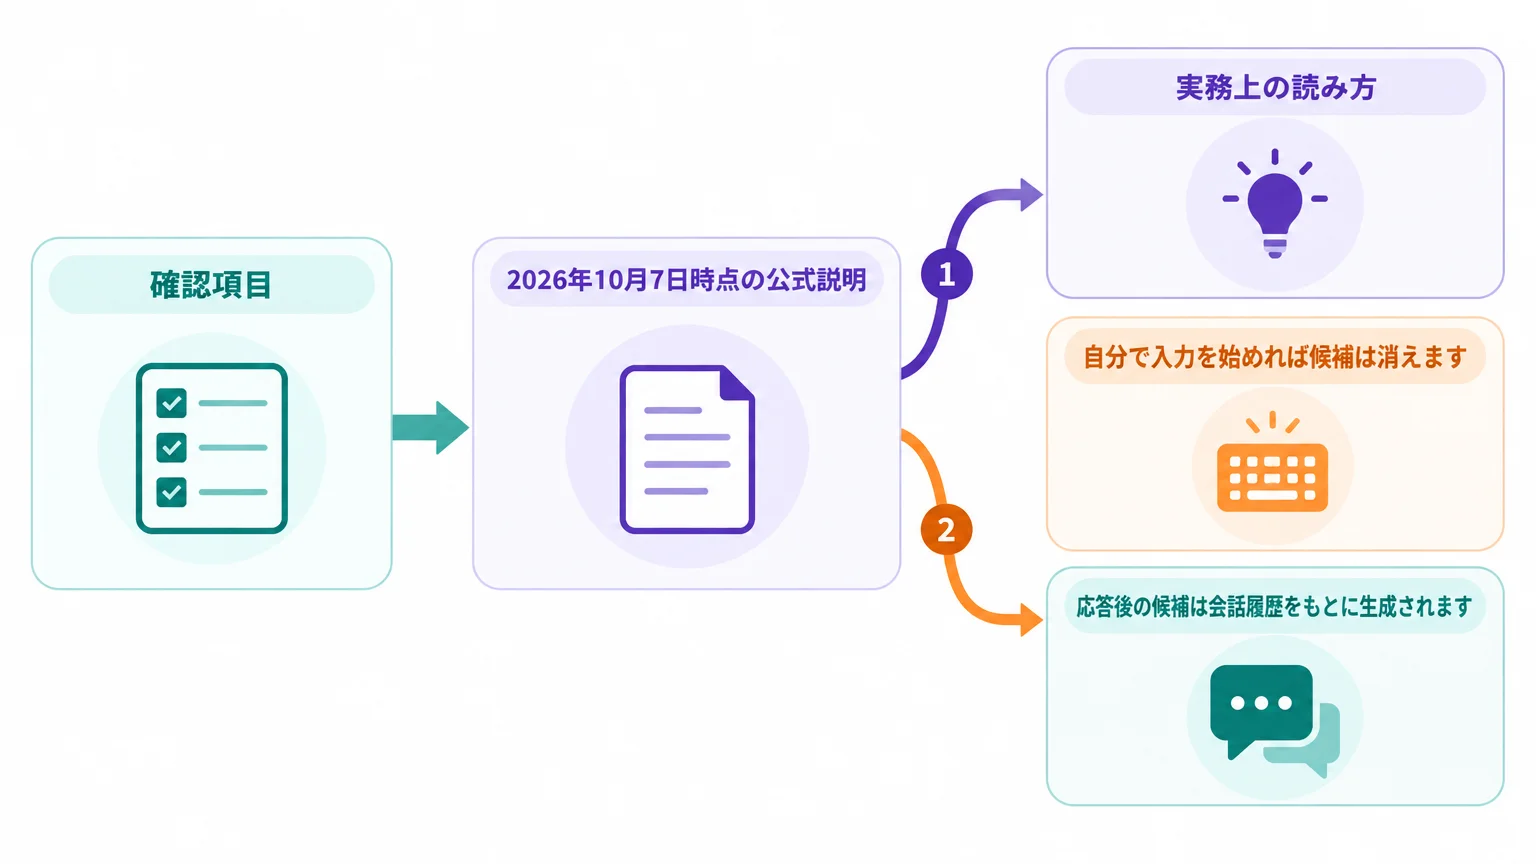
Claude Codeの提案メッセージは、応答終了後の入力欄に次のプロンプト候補を表示する機能です。Claude Code公式のInteractive modeドキュメントによれば、会話履歴から複数工程の続きや自然な次の作業を推定します。利用者はTabまたは右矢印で候補を入力欄へ移し、必要なら編集してから送信できます。自分で入力を始めれば候補は消えます。
セッションを最初に開いたときの例示と、応答後の次プロンプト候補は区別が必要です。公式説明では、開始時の例示はプロジェクトのGit履歴を参照し、最近扱ったファイルを反映します。応答後の候補は会話履歴をもとに生成されます。見た目はいずれも「薄い文字」でも、入力に使う文脈は同じではありません。
| 確認項目 | 2026年10月7日時点の公式説明 | 実務上の読み方 |
|---|---|---|
| 候補の生成 | セッションで使っているものと同じモデルへの短いバックグラウンドリクエスト | 固定ルールによる補完ではなく、現在の会話文脈に依存する |
| 利用者の操作 | Tabまたは右矢印で取り込み、Enterで送信。入力開始で候補を破棄 | 表示された時点では命令でも承認でもない |
| 利用量 | プランの利用枠またはAPIコストの対象。主にプロンプトキャッシュの読み取りと少量の出力 | 大量利用では、便益と追加利用量を同じ台帳で見る |
| 停止方法 | /config、設定ファイル、環境変数、組織の管理設定で無効化可能 |
個人の好みだけでなく、組織ポリシーとして制御できる |
| 表示されない場面 | キャッシュが冷えているとき、直前の応答がエラーのとき、plan modeなど複数条件 | 非表示を障害や設定漏れと即断しない |
つまり、公式に確認できるのは「次のメッセージを予測する製品機能」です。ここから先の「その反応を何に使うか」は、別の問いとして扱わなければなりません。
事実、仮説、否定コメントを同じ箱に入れない
元記事は、提案をそのまま送れば肯定的なラベルになり、編集すれば元の候補と修正文の組が選好データになり得る、と論じました。また、次のユーザー発話を当てる能力そのものが、作業順序を学ぶ訓練目標になり得ると考察しています。これはAIエージェント研究の観点では筋の通った仮説です。しかし、著者自身が「推測であり、Anthropic内部の知識はない」と明記しています。
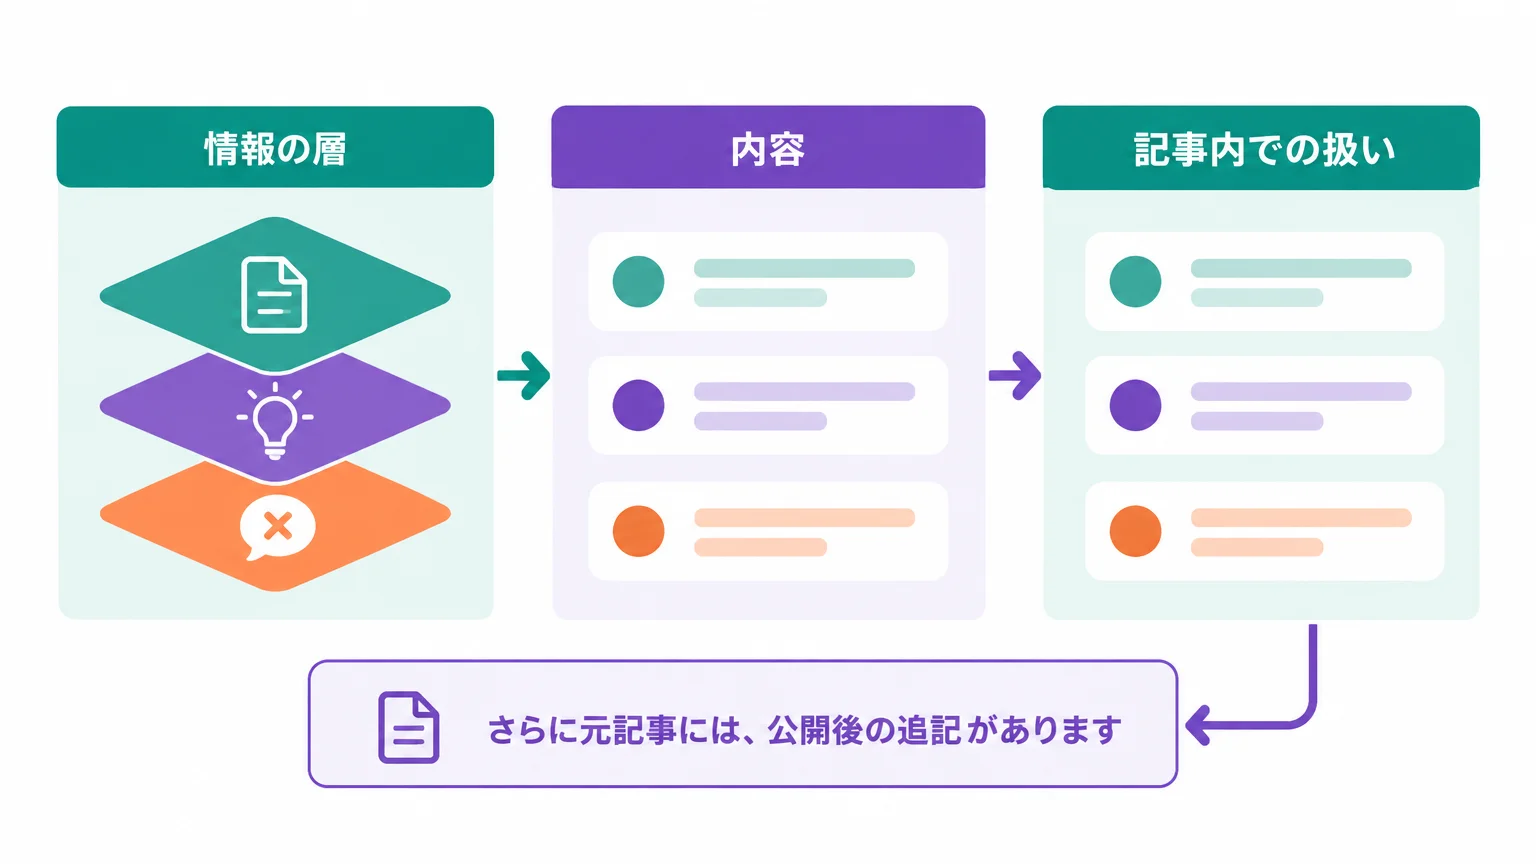
さらに元記事には、公開後の追記があります。Hacker News上でClaude Code担当を名乗るedwinarbus氏のコメントは、提案メッセージを選好シグナル収集には使っておらず、セッションの流れを保つことや、時間を空けて戻った利用者へ次の一手を思い出してもらうことが目的だと説明しました。採用数は機能全体の有用性を知るために見ているとも述べています。
このコメントは重要ですが、Hacker News上の発言です。企業の正式なプレスリリースや契約条項と同じ重みで扱うべきではありません。現時点で安全に言える範囲を整理すると、次のようになります。
| 情報の層 | 内容 | 記事内での扱い |
|---|---|---|
| 公式仕様 | 会話履歴を使い、同じモデルが候補を生成する。利用量に算入され、無効化できる | 確認済みの製品事実 |
| 元記事の仮説 | 採用や編集の反応は、選好データや次ターン予測の学習材料になり得る | 著者の分析として紹介 |
| 担当者を名乗るコメント | 選好シグナル収集には使っていない。目的はフロー維持と復帰支援 | コミュニティ上の反論として紹介 |
| 確認できない点 | 候補ごとの採否ログの保存範囲、保持期間、将来の利用方法 | 推測せず、契約・設定・公式更新を確認 |
ニュースを読む際のポイントは、「仕組み上は価値あるデータになり得る」と「実際に訓練へ使っている」を分けることです。前者から後者を推論してはいけません。
「本当の顧客はモデル」という見方が残す実務上の問い
訓練利用の仮説が否定されたとしても、元記事の視点は無価値になりません。むしろ、AIエージェントを設計する側には三つの問いを残します。
次の発話は、作業状態を圧縮したインターフェースになる
「テストを実行する」「差分を確認する」「認証まわりだけ再テストする」といった次の指示は、直前までの長い会話を次の作業状態へ圧縮します。提案が適切なら、利用者は会話を読み直して作業再開点を組み立てる負担を減らせます。逆に候補がずれていれば、モデルが把握した完了条件や優先順位のずれが短い一文として表面化します。
これは単なるタイプ量の削減ではありません。候補文を「モデルが現在どこまで理解し、次に何をすべきだと見ているか」の可視化として読めます。AIエージェントの状態管理を考えるとき、自然言語の次ターン候補は小さなデバッグ面になります。
編集差分は、製品訓練でなくても運用改善に使える
組織が自社の検証環境で、表示候補と実際に送った文の差を適切な同意・アクセス制御のもとで記録すれば、業務設計の弱点を見つけられます。たとえば候補に対象範囲、完了条件、テスト条件が繰り返し欠けるなら、モデル性能だけでなく、プロジェクト指示や作業チケットの書き方に不足がある可能性があります。
ここで述べているのは自社側の検証設計です。Anthropicが同じ差分を収集・学習しているという意味ではありません。また、プロンプトやコードには機密情報が含まれ得るため、記録を始める前に保存先、閲覧権限、削除手順を定める必要があります。
候補は予測であると同時に、利用者の選択を変える
候補を見せなければ、利用者は自分の次の指示をゼロから書きます。候補を見せれば、採用しない場合でも発想の起点が候補側へ寄る可能性があります。Hacker Newsでも「実装フェーズでは便利」という反応と、「考えている最中に割り込まれて認知負荷になる」という反応が分かれました。
したがって、正解率だけでは評価できません。設計・要件整理のように発散が必要な場面と、テスト・差分確認のように次の手順が比較的明確な場面では、同じ候補でも影響が異なります。
日本企業への影響はUIより責任分界に出る
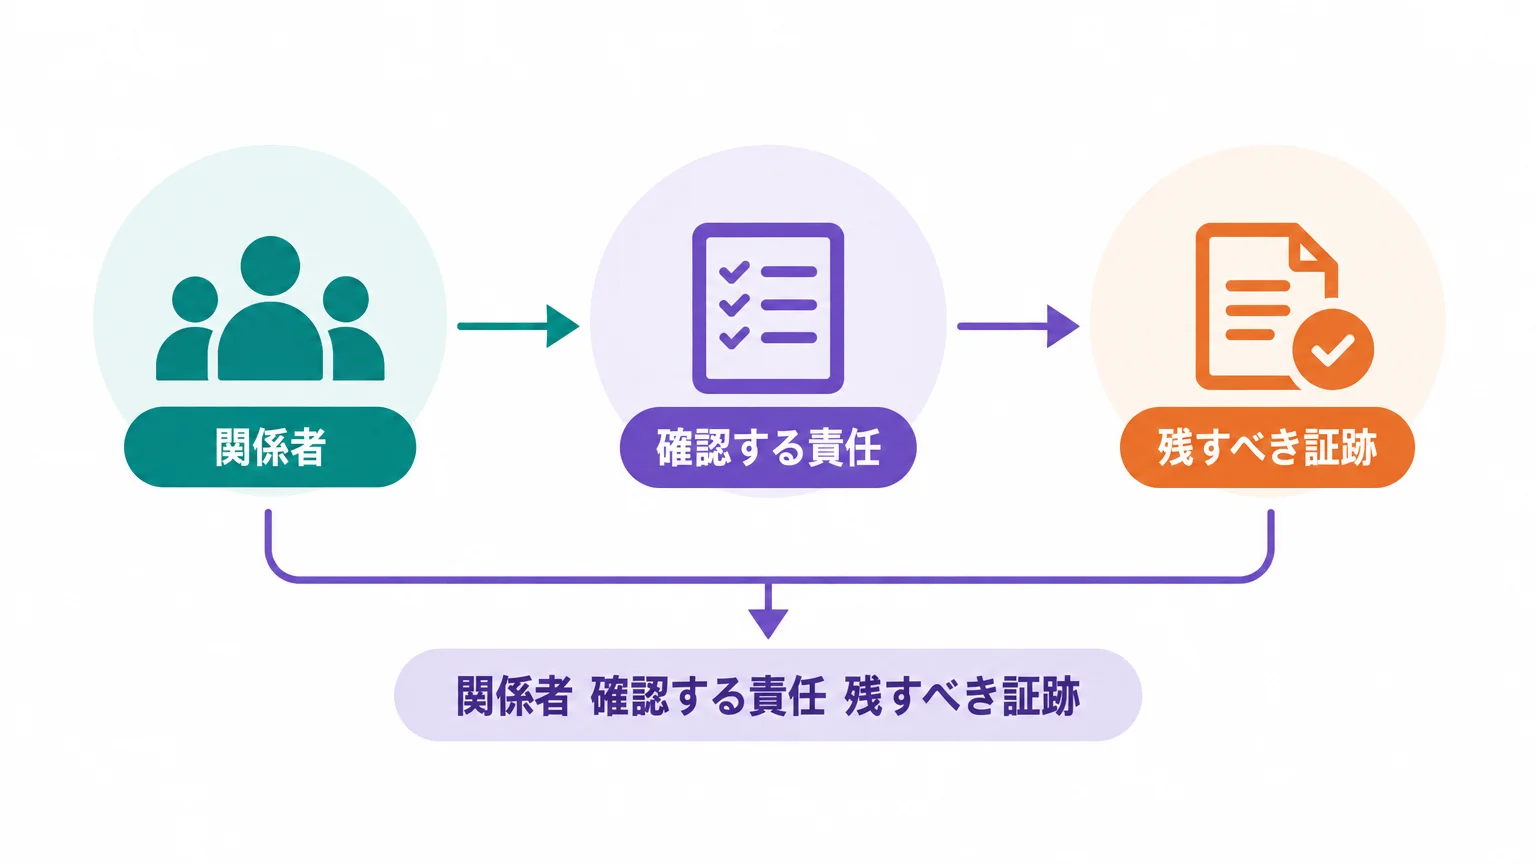
企業利用で見るべきなのは、「候補が当たるか」だけではありません。誰が次の行動を決め、誰がリスクを引き受け、どの地点で人間の承認を必須にするかです。提案メッセージ自体は文字列でも、送信後のエージェントはファイル編集、コマンド実行、外部サービス操作へ進む可能性があります。
| 関係者 | 確認する責任 | 残すべき証跡 |
|---|---|---|
| 利用者 | 候補が依頼範囲、対象ファイル、完了条件と一致するか | 送信した最終文と採用・編集・破棄の別 |
| チーム責任者 | 提案から進めてよい操作と、個別承認が必要な操作の境界 | 権限ルール、例外承認、レビュー結果 |
| セキュリティ・法務 | 契約プラン、データ利用設定、機密情報の入力可否 | 設定確認日、規程、変更履歴 |
| 運用担当 | 便利さと手戻り・事故予兆を同時に測れているか | 評価指標、対象タスク、除外条件 |
重要なのは、候補の表示を承認と解釈しないことです。「commit this」「deploy」などが候補になっても、組織の変更管理や外部公開の承認線は変わりません。人間を単なるEnterキーにしない設計は、AIエージェントのHuman-in-the-loop設計ガイドで整理した承認・修正・停止の考え方と同じです。
採用率だけでは提案メッセージの品質を測れない
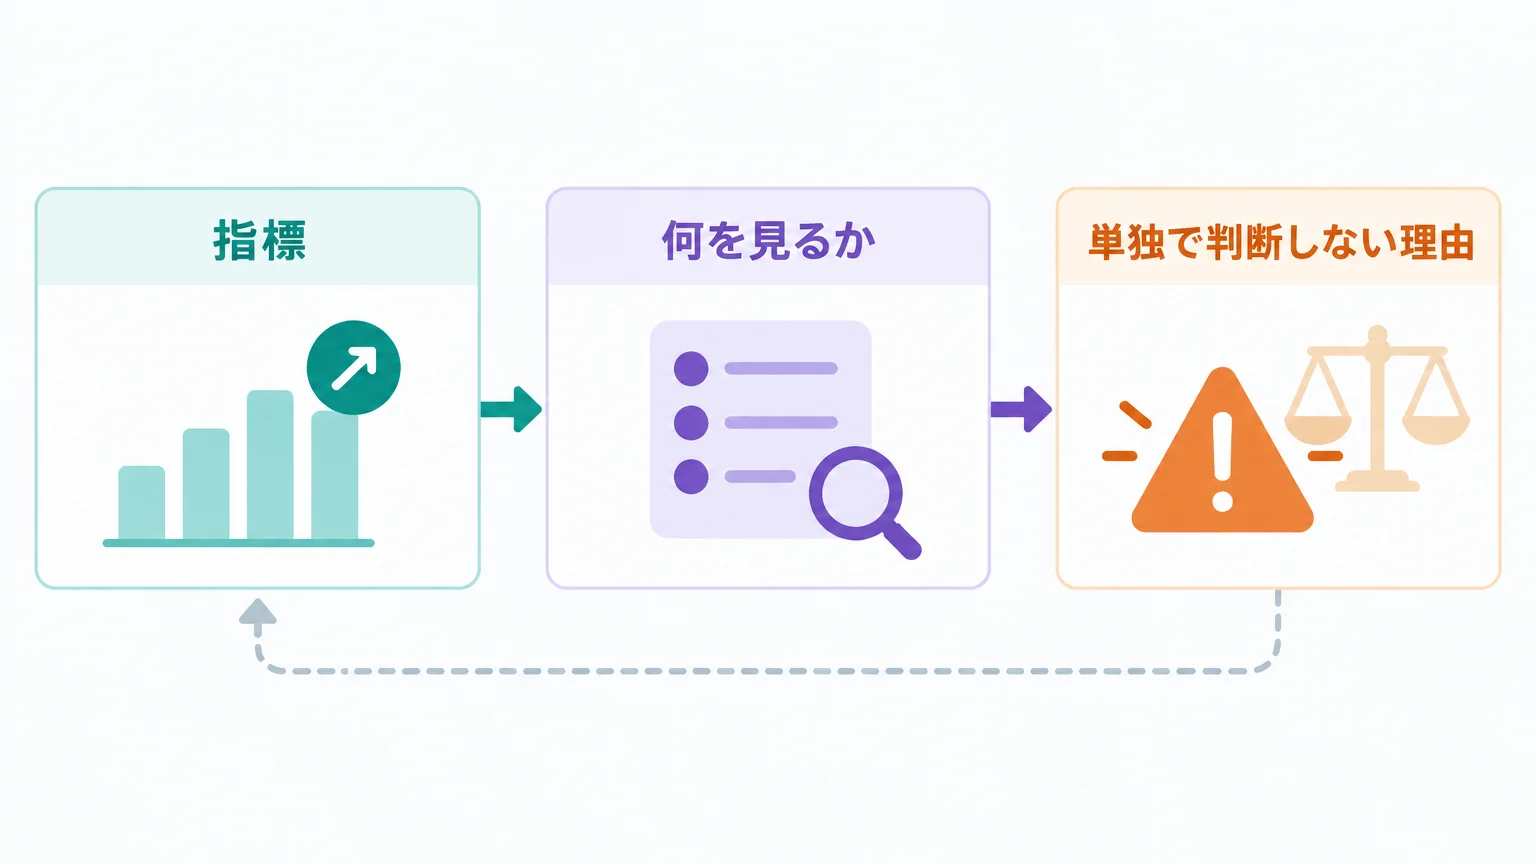
候補の採用数は、機能が使われたかを見るには役立ちます。ただし、採用された候補が正しかったのか、作業を安全に完了させたのかまでは分かりません。短く自然な候補ほど採用されやすくても、必要な制約が抜けていれば後工程で手戻りが増えます。
日本企業が社内検証するなら、次の指標を分けてください。以下は導入検証の設計例であり、Anthropicが公開している計測項目ではありません。
| 指標 | 何を見るか | 単独で判断しない理由 |
|---|---|---|
| 無編集採用率 | 表示候補のうち、そのまま送った割合 | 短く曖昧な候補でも上がり得る |
| 編集率 | 対象、範囲、完了条件などを直して送った割合 | 編集が「改善」か「別指示への変更」かを区別できない |
| 破棄率 | 候補を使わず、自分で書いた割合 | 候補が悪い場合と、創造的な作業で不要な場合が混ざる |
| タスク完了率 | 送信後に定めた完了条件を満たしたか | 完了条件が曖昧なら数字自体が信頼できない |
| 手戻り率 | 修正、再実行、取り消しが必要になったか | 難易度やリポジトリ状態の影響を受ける |
| 承認逸脱 | 外部送信、本番変更、機密操作へ承認なく進もうとしたか | 発生件数が少なくても影響が大きい |
見るべき単位は一つの候補文ではなく、「候補表示→利用者の最終入力→モデルの行動→検証結果」です。品質の回帰を継続して追う方法はAIエージェントの継続的評価とCI/CD回帰検知、入出力と評価をひも付ける考え方はLangfuseによるAIエージェントの可観測性・評価も参考になります。
契約とデータ利用は機能設定とは別に確認する
「提案メッセージをオンにしたら、編集差分が自動的に訓練へ使われる」と短絡するのは正確ではありません。逆に「有料だからすべて訓練対象外」と一括りにするのも危険です。Claude Code公式のData usageとAnthropic Privacy Centerは、コンシューマー利用と商用利用を分けています。
| 利用区分 | 公式に確認できるモデル改善方針 | 導入前の確認 |
|---|---|---|
| Free・Pro・Maxにひも付くClaude Code | 利用者がモデル改善へのデータ利用を許可するか選択できる | 個人のPrivacy設定と社内規程が一致しているか |
| Team・Enterprise・APIなど商用条件 | 既定ではコードやプロンプトを生成モデル訓練に使わない。明示的な提供やフィードバックなどは別扱い | 契約、組織設定、例外プログラムへの参加有無 |
| 提案メッセージ機能 | 背景リクエストの生成方法、利用量、停止方法は公式記載あり。候補の採否を訓練へ使うという記載は確認できない | 機能オン・オフとデータ利用同意を別項目で管理 |
| フィードバック・品質調査 | 通常セッションとは別の送信経路と扱いが定められている | 何を送る操作なのか、会話共有を伴うかを画面ごとに確認 |
商用製品のモデル訓練に関する公式説明は、既定で商用製品の入出力を訓練に使わない一方、明示的なフィードバックや許可は例外になり得ると説明しています。コンシューマー向けのモデル改善設定では、設定をオフにした後の新しいチャットやコーディングセッションを将来のモデル訓練に使わないと案内しています。
この区別は、元記事の仮説を評価するうえでも欠かせません。一般のデータ利用方針と、特定機能の採否シグナル利用は同じ主張ではありません。自社の契約と設定を確認したうえで、それでも不明な点はAnthropicへ書面で確認するのが安全です。
検証は候補文ではなく一連の作業を対象にする
導入判断は、全社で一斉にオン・オフする二択にする必要はありません。候補が役立ちやすく、失敗しても戻せるタスクから、評価可能な形で始めます。
- 対象を限定する:テスト実行、差分確認、ドキュメント更新など、完了条件を観察できる作業を選びます。外部送信、本番反映、権限変更は最初の対象から外します。
- 比較条件をそろえる:提案メッセージあり・なしで、同程度のタスクを扱います。リポジトリ、担当者、難易度が大きく違う結果を単純比較しません。
- 候補と最終入力を分けて記録する:そのまま採用したか、どこを編集したか、破棄したかを残します。機密情報を含むログは、保存前にアクセス権と削除方針を決めます。
- 下流の結果まで追う:テスト結果、レビュー指摘、手戻り、承認要求を候補文にひも付けます。入力時間だけで成功と判定しません。
- 危険な候補を分類する:範囲外編集、検証省略、外部操作、破壊的操作、機密情報の取り込みを別カテゴリで確認します。
- 継続条件を決める:有用なタスクでは維持し、思考への割り込みや手戻りが大きい工程では無効化します。役割別に設定を変える判断も可能です。
評価項目を先に固定する方法は、Claude Codeのbuild-evalとhillclimbで紹介した「評価を作り、変更を一つ加え、再評価する」流れと相性があります。提案文を改善したいからといって、複数の指示ファイル、権限、モデル、作業手順を同時に変えると、何が効いたのか分からなくなります。
提案メッセージ運用で起きやすい三つのズレ
ズレ1:採用率が高ければ成功とみなす
❌ 候補がそのまま送られた回数だけをKPIにし、作業結果を見ない。
⭕ 採用後の完了条件、テスト、レビュー、手戻りまで追います。採用率は利用状況、完了品質は業務成果として別に扱います。
ズレ2:候補文を実行許可とみなす
❌ 「commit」「push」「deploy」と表示されたため、利用者の承認が済んだと解釈する。
⭕ 候補は下書きにすぎないと定義し、外部公開、本番変更、送信、権限変更は既存の承認フローを通します。モデルの提案と人間の権限行使を分離します。
ズレ3:機能設定とモデル訓練設定を混同する
❌ 提案メッセージを無効にすれば、契約上のデータ利用確認も終わったと考える。
⭕ 提案機能、モデル改善へのデータ利用、フィードバック送信、ログ保持を別々の設定項目として確認します。契約形態が違うメンバーを同じ前提で扱いません。
ズレ4:設計工程と実装工程を同じ基準で測る
❌ アイデアを広げる場面でも、次の一手を素早く採用することを良い結果とみなす。
⭕ 設計では候補が思考を狭めないか、実装では検証可能な次工程を示せるかを分けて評価します。タスクの性質に応じて表示を切り替えます。
コミュニティの反応は「便利」と「思考への割り込み」に分かれた
Hacker Newsの議論では、反応が一方向にはまとまっていません。実装中に推奨された次工程へ進む場面では入力を減らせるという声がある一方、自分の指示を考えている途中で候補が視界に入り、無視するだけでも負担になるという声もあります。小文字中心の文体や、意図と違う候補への違和感を挙げる投稿も見られました。
訓練データ仮説にも反論があります。候補を画面に出さなくても、過去の会話を途中で切り、モデルの予測と実際の次発話を比較できるのではないかという指摘です。これに対して、画面に提示した候補なら「別の妥当な次手を利用者が受け入れたか」を観察できる、という議論もありました。
これらは製品利用者の意見であり、公式仕様の証拠ではありません。ただし、検証項目を作る材料にはなります。「正解したか」だけでなく、「思考を妨げたか」「候補に引っ張られたか」「工程によって価値が変わるか」を聞く必要があるからです。
よくある質問
Claude Codeの提案メッセージとは何ですか?
Claudeの応答後、会話履歴をもとに次のプロンプト候補を入力欄へ薄く表示する機能です。Tabまたは右矢印で取り込み、編集してから送信できます。自分で入力を始めると候補は破棄されます。
候補を採用・編集した内容はモデル訓練に使われますか?
候補の採否や編集差分を選好シグナルとして使っているという公式発表は、2026年10月7日時点で確認できません。元記事も仮説だと明記し、追記ではClaude Code担当を名乗る人物が利用を否定しています。ただし、一般の会話データ利用は契約形態とPrivacy設定で異なるため、別途確認してください。
提案メッセージは無効にできますか?
できます。公式ドキュメントでは、/configのPrompt suggestions、設定ファイルのpromptSuggestionEnabled、環境変数、組織の管理設定による無効化が案内されています。組織で統一する場合は、利用者が個別に再有効化できない設定になっているかも確認します。
提案メッセージに追加コストはかかりますか?
公式説明では、候補生成はプランの利用枠またはAPIコストの対象です。同じ会話のプロンプトキャッシュを再利用し、主にキャッシュ読み取りと少量の出力になるため、追加コストは小さいと説明されています。実際の影響は利用形態で変わるため、自社の利用量で確認してください。
企業はすぐに全員へ有効化してよいですか?
まず、戻しやすく完了条件が明確なタスクに限定するのが安全です。契約とデータ利用設定を確認し、採用率だけでなく完了品質、手戻り、承認逸脱、利用者の認知負荷を測ってから対象を広げてください。
結論:本当の顧客を決めるのは運用設計
2026年10月7日時点の答えは明確です。Claude Codeの提案メッセージは、公式には利用者のフロー維持と次の操作支援として説明されており、「モデル訓練のための選好データ収集機能」と断定できる根拠はありません。元記事の「本当の顧客はモデル」という一文は、確認済みの内部事情ではなく、機能の潜在的な価値を読み解く仮説です。
それでも、この仮説はAIエージェント実務に有効な視点を与えます。次のプロンプト候補は、モデルが理解した作業状態を短い文で示し、利用者の採用・修正・破棄は、組織側の評価設計に使えるからです。ただし、候補は承認ではなく、採用は成功でもありません。
導入判断では、機能のオン・オフ、データ利用同意、権限境界、下流の品質評価を分けて管理してください。候補が人間の判断を助ける範囲を明確にできたとき、提案メッセージは単なる入力補完を超えて、エージェント運用の状態を観察する小さな窓になります。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- The smartest Claude code feature is not for its users — Zohaib Ansari、2026年10月6日公開(参照日:2026年10月7日)
- Interactive mode:Prompt suggestions — Claude Code公式ドキュメント(参照日:2026年10月7日)
- Data usage — Claude Code公式ドキュメント(参照日:2026年10月7日)
- Is my data used for model training? — Anthropic Privacy Center、2026年8月18日更新(参照日:2026年10月7日)
- How do I change my model improvement privacy settings? — Anthropic Privacy Center、2026年8月3日更新(参照日:2026年10月7日)
- Updates to Consumer Terms and Privacy Policy — Anthropic、2025年8月28日公開(参照日:2026年10月7日)
- Claude Code CHANGELOG — Anthropic公式GitHubリポジトリ(参照日:2026年10月7日)
- Claude Code’s suggested message feature: I think the real customer is the model — Hacker News、コミュニティ反応(参照日:2026年10月7日)
この記事はAIgent Lab編集部がお届けしました。
提案メッセージを含むAIエージェントの評価・承認設計を、自社業務に合わせて整理したい方へ
UravationではAIエージェント導入の研修・コンサルを行っています。