2026年9月30日時点で、build-eval と hillclimb は、Anthropic が2026年9月28日に紹介した claude-api スキルの2つのコマンドです。Claude Code で /claude-api build-eval を実行すると、Claude が質問をしながら自分のコードベースの中に評価(入力の例・実行の仕組み・採点方法)を作り、/claude-api hillclimb を実行すると、その評価に対してプロンプトやモデルの設定を1回に1つずつ変え、見せていない検証用の例で合わせ込みすぎを確かめながら改善します。Anthropic 自身の例では、問い合わせ対応の評価で、正答率を上げながら1件あたりのコストを約5分の1にしています。
この記事の要点(2026年9月30日時点)
- 紹介は2026年9月28日の開発者ブログ。claude-api スキルは Claude Code に同梱で、追加の導入は要りません。指示文の実物は GitHub の anthropics/skills で読めます
- build-eval は、入力の例を集める順番(本番の記録→不具合の報告→手書き5〜10件→コードから合成)と採点方法を提案し、入力と採点のそれぞれで利用者の確認を待ってから、基準になる初回の実行を行います
- hillclimb は、評価の例を学習用と検証用にランダムに分け、1回に1つの変更を差分として当てます。学習用だけ伸びて検証用が伸びない変更は、合わせ込みすぎとして取り消します
- 終わった時の結論は「検証用での基準との差」です。差が誤差の範囲なら、そう報告して取り込まないよう勧める、と指示文に書かれています
- 公式ドキュメントの claude-api スキルのページには、2026年9月30日時点でこの2つのコマンドの説明は確認できていません。一次情報は開発者ブログと GitHub の指示文です
対象読者:Claude の API やスキルを組み込んだアプリを運用していて、プロンプトやモデルを変える時の判断材料がほしい開発者。読み終えたらできること:2つのコマンドが何を聞き、何を作り、どこで止まるかを説明でき、使う前に用意するものを洗い出せます。
この記事は、Anthropic の開発者ブログ「Automating eval design and hillclimbing with Claude」(2026年9月28日掲載)、公式ドキュメントの claude-api スキルのページ、GitHub の anthropics/skills にある指示文(build-eval.md と eval-hillclimb.md)を2026年9月30日に読み、書かれている範囲で整理したものです。コマンドとファイルの構成は、これらに載っている形のまま引用しています。評価の基礎から押さえたい場合は AI Evals と LLM-as-a-Judge の設計 を先に読むと流れが追いやすくなります。
build-evalとhillclimbとは|9月28日に紹介された2つのコマンド
ブログは冒頭で、評価を設計することと、自分をだまさずに評価の成績を上げることはどちらも難しい、と書いています。2つのコマンドは、そのための手引きを claude-api スキルに入れたものです。
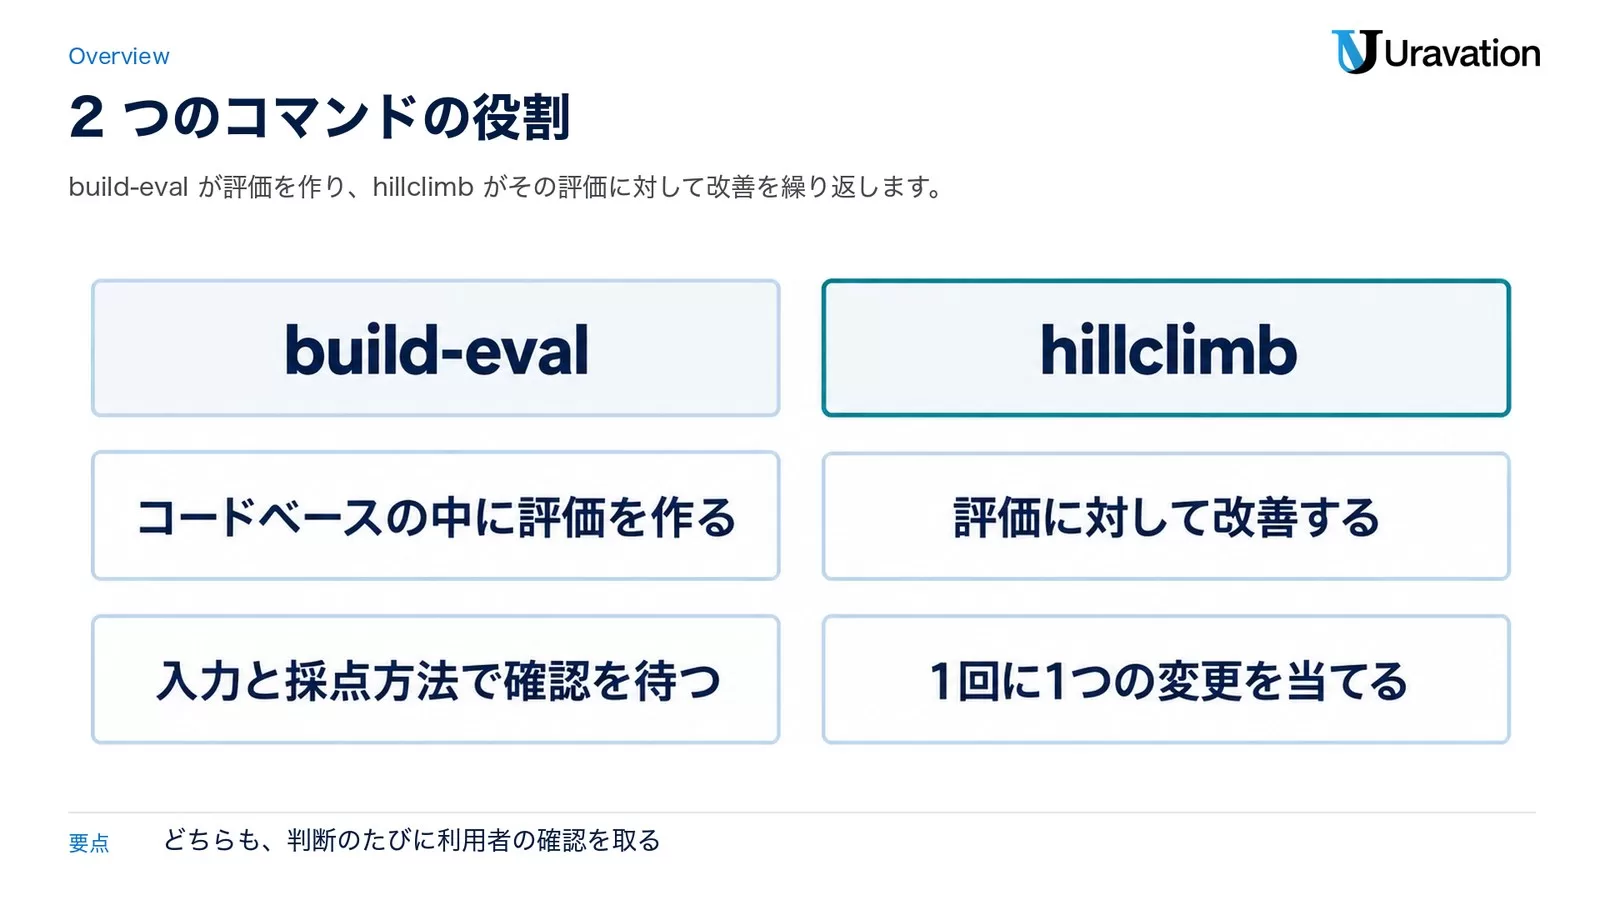
| 項目 | build-eval | hillclimb |
|---|---|---|
| 実行のしかた | /claude-api build-eval |
/claude-api hillclimb |
| 目的 | コードベースの中に評価を作る | 評価に対してアプリを改善する |
| 最初に聞かれること | 何を測りたいか | 実行できる評価があるか、何を最適化するか |
| 利用者の確認で止まる場面 | 入力の例、採点方法、最初の課金の前 | 計画(目標・変える対象・止める条件) |
| 残るもの | 例・採点の仕組み・実行の仕組み・例ごとの記録・結果のページ | 回ごとの変更と差分・成績・最終の報告 |
どちらも、Claude が一方的に作業を進める形ではありません。GitHub の指示文は、判断のたびに推奨の選択肢を先頭に置いて利用者に聞くこと、確認を飛ばさないことを Claude に求めています。
前提|claude-apiスキルとは、どこで使えるか
claude-api スキルは、Claude の API と Claude Managed Agents でアプリを作るための参考資料を Claude に渡す、オープンソースの Agent Skill です。公式ドキュメントによると、Claude Code に同梱されていて、導入の作業は要りません。Python・TypeScript・C#・Go・Java・PHP・Ruby・cURL の8つに対応します。
スキルは2通りで働きます。Anthropic の SDK を読み込んでいるコードを触る時などに自動で働く形と、/claude-api と打って呼び出す形です。build-eval と hillclimb は後者で、サブコマンドとして付けます。
Claude Code 以外の環境には、スキルのリポジトリから入れられます。ドキュメントに載っている方法は次の2つです。
npx skills add https://github.com/anthropics/skills --skill claude-api/plugin marketplace add anthropics/skills
/plugin install claude-api@anthropic-agent-skillsスキルそのものの作り方と仕組みは Claude Code Skills ガイド で解説しています。
よい評価の4つの条件|Anthropicが挙げる設計の原則
ブログは、コマンドの説明の前に、よい評価に共通する要素を4つ挙げています。build-eval はこの4つを手順にしたものです。
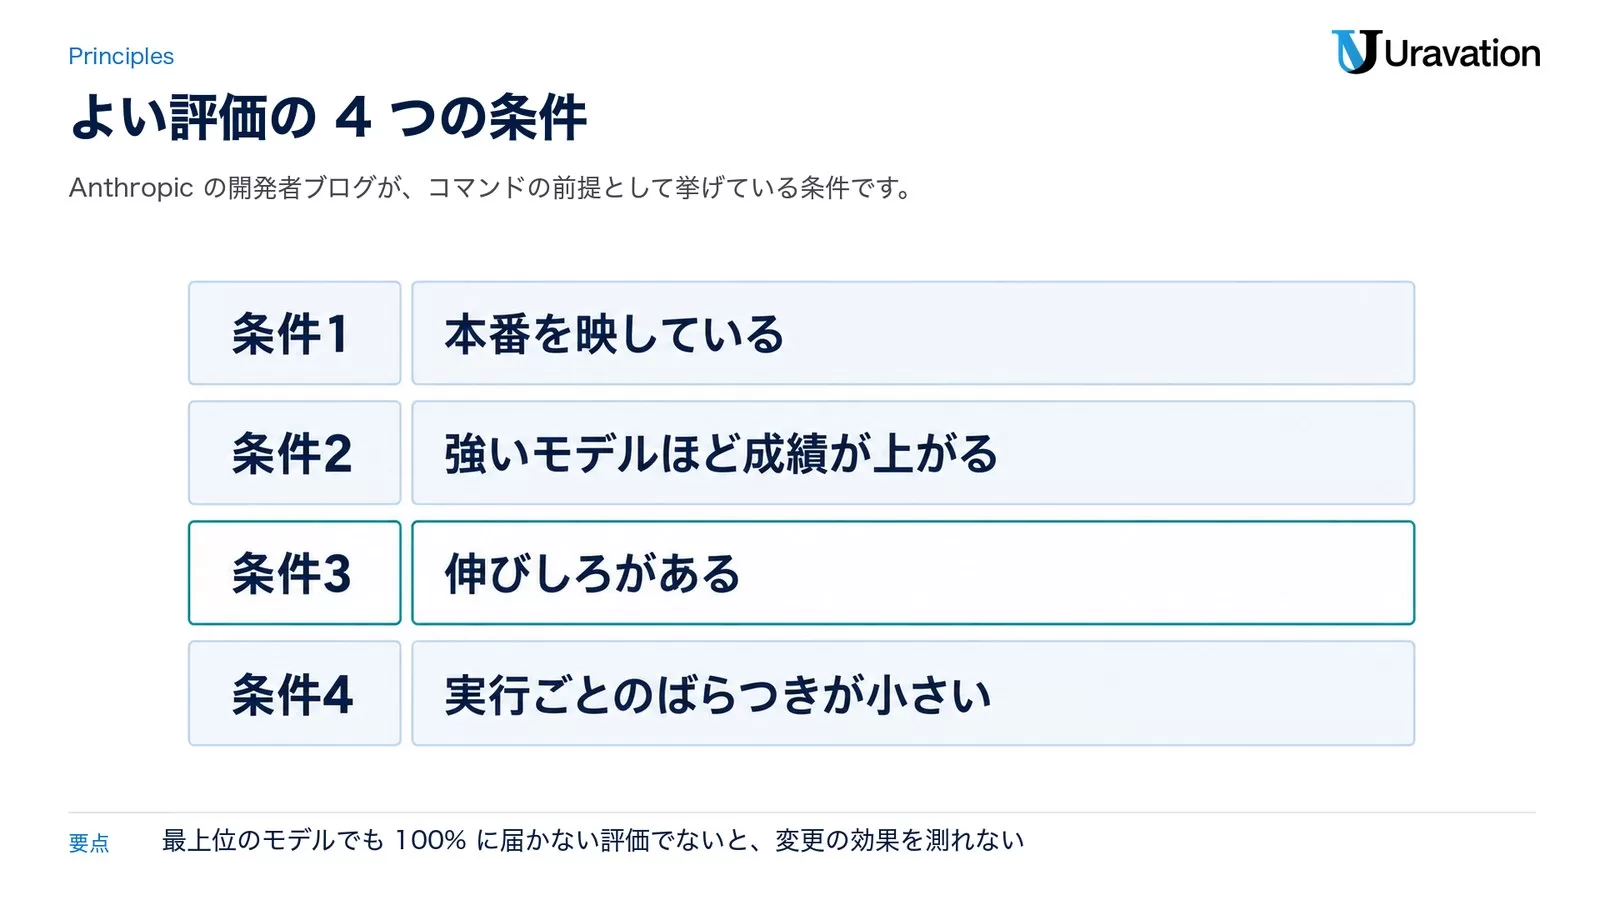
| 条件 | 内容 |
|---|---|
| 本番を映している | 作りやすさや採点のしやすさで例を選ばず、本番で大事にしている作業から例を取る |
| 強いモデルほど成績が上がる | 能力の高いモデルや、思考の量を増やした設定で成績が上がらないなら、例があいまいか採点がずれている |
| 伸びしろがある | 最上位のモデルでも100%を十分に下回る。ただし、解けない例やあいまいな例で下がっているのではないこと |
| 実行ごとのばらつきが小さい | ばらつきの原因は、あいまいな例、同じ出力に違う判定を出す採点、設定の不統一、前の試行の残りもの |
難しい例の選び方にも注意があります。「今のモデルが失敗するから」という理由で例を選ぶと、そのモデルの弱点だけを測る評価になります。ブログは、人が難しいと判断した例を選ぶこと、入れる前に「なぜ難しいか」を言えることを目安に挙げています。本番の利用記録をそのまま信じることにも注意を促しています。利用者は通りそうなことを試す傾向があるので、記録だけから取ると易しい例に偏る、という指摘です。
build-evalの流れ|入力・採点方法・実行・引き渡し
GitHub の指示文は、評価を3つのものと定義しています。入力の例の集まり、各入力に対してアプリを動かす方法、各出力を採点する方法です。実行の仕組みは普通の Python スクリプトでも、コマンドでも、pytest のテストでもよく、枠組みを押しつけずに既存のコードベースの構造に合わせる、と書かれています。
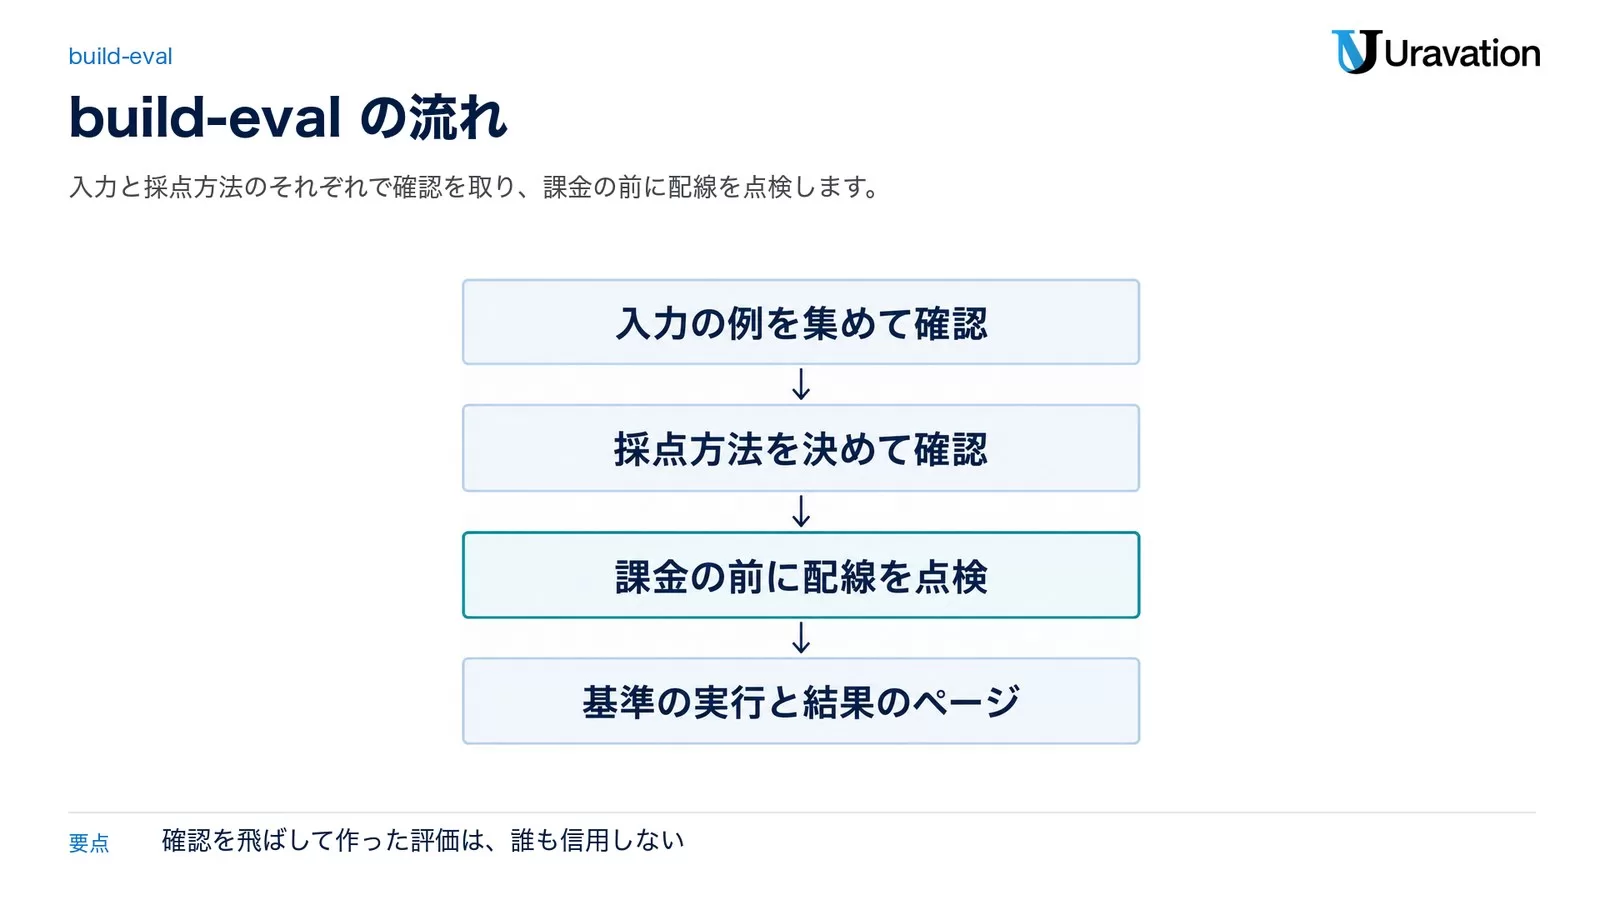
1. 入力の例を集める。Claude は次の順で例を探します。
- 本番の記録(保存期間と機微な情報の扱いを先に聞く)
- 不具合の報告と問い合わせの記録
- 利用者が手で書く5〜10件
- コードベースから合成した例
本番の記録が優先ですが、利用者が渡した少数の実例をもとに合成することもできます。集めた入力はすべて1枚のページに並べられ、利用者が確認するまで先へ進みません。
2. 採点方法を決める。Claude は、出力に合うもっとも安い採点方法を提案します。
| 採点方法 | 使う場面 | 中身 |
|---|---|---|
| コードによる検証 | 出力の形が決まっている | 完全一致、決まった選択肢のラベル、スキーマに合う JSON、テストの合格 |
| モデルによる採点 | 正解が1つに決まらないが、品質の基準ははっきりしている | 別のモデルが、入力・出力・確認できる主張の形で書いた基準を読んで採点する(5段階の点数にはしない) |
比べる基準がある時は、採点するモデルに2つの出力を順番を混ぜて見せ、どちらが基準かを伝えずによいほうを選ばせます。採点に使うモデルは利用者が選び、試験の対象と同じモデルにはしない、とブログは書いています。決めた後、Claude は数件を採点して見せ、「自分なら違う点を付けた例はあるか」を聞きます。
3. 基準の実行。採点方法の確認が済むと、評価の大きさ(例の数 × 繰り返し × モデルと、おおよその時間)を伝えたうえで基準の実行を行い、信頼区間つきで成績を出します。実行中に次の点検も行います。
- 採点:同じ出力を2回採点し、判定が変わらないか
- 配管:時間切れ・API のエラー・途中で切れた回答が、モデルのばらつきに紛れていないか
- 伸びしろ:基準の成績が約95%以上なら警告し、hillclimb では品質でなくコストか応答時間を目標にするよう促す
4. 引き渡し。手元に残るのは、例、採点の仕組み、実行の仕組み、例ごとの JSON の1行と全文の記録、各例の成績と記録へのリンクを並べたページです。グラフなどの追加のページを頼んだ場合、それらは既定では手元で開く静的なファイルで、ネットワークから何も読み込みません。
最初の課金の前に行う点検|基準の答えと空の答えを通す
指示文には、API の料金がかかる実行の前に行う点検が書かれています。評価の配線の間違いを、全件を回す前に見つけるためです。
| 点検 | 期待する結果 |
|---|---|
| 正解そのものを実行と採点に通す | ほぼ100% |
| 空の出力や決まり文句の答えを通す | ほぼ0% |
| 採点するモデルに、空の文字列・「分かりません」・別の質問への自信のある答えを渡す | 3つとも不合格 |
| わざと API のエラーを起こす | 0点ではなく、エラーとして記録される |
そのうえで、Claude は「何件 × 何回を、どのモデルで、約何分」と伝え、利用者が了承してから実行します。費用を聞かれた時は、少数の例での試し実行の実際の使用量だけから見積もる決まりです。指示文は、過去の記録からの見積もりは2〜4倍、勘での見積もりは3〜10倍ずれることがよくある、と理由を書いています。
hillclimbの流れ|目標・分割・1回に1つの変更
hillclimb は、決まった評価に対して「実行→失敗を読む→1つ変える→再実行」を繰り返します。指示文は最初に、実行できる評価があるかを聞くよう求めています。無ければそこで止まり、先に評価を作ります。
変えてよい対象を選ぶ。利用者が選べる対象は次の5つです。
- システムプロンプト
- スキルや指示のファイル
- ツールの説明
- モデルの選択、effort の水準、その他の API の設定
- ハーネスのコード
ブログは、向いている対象の条件を3つ挙げています。変更と取り消しが安いこと、成績の変化がその変更によるものだと言えること、目標の範囲がはっきりしていること、です。プロンプトやスキルの文章は変えやすく戻しやすいので向いていて、ハーネスを自由に直させる指定は行き詰まりやすい、と書いています。
目標と止める条件を決める。Claude は、何を最適化するか(性能か、性能を保ったままのコストか)を聞きます。止める条件は、指示文では3つから選びます。成績が伸びなくなるまで(推奨)、1回ごとに確認、決めた回数、です。
分割と基準。評価の例をランダムに学習用と検証用に分け、基準の成績を取ります。最初の回の前に、評価の誤差(偶然だけで成績が動く幅)が、取り入れたい最小の改善より小さいかを確かめ、足りなければ繰り返しか例を増やすよう提案します。
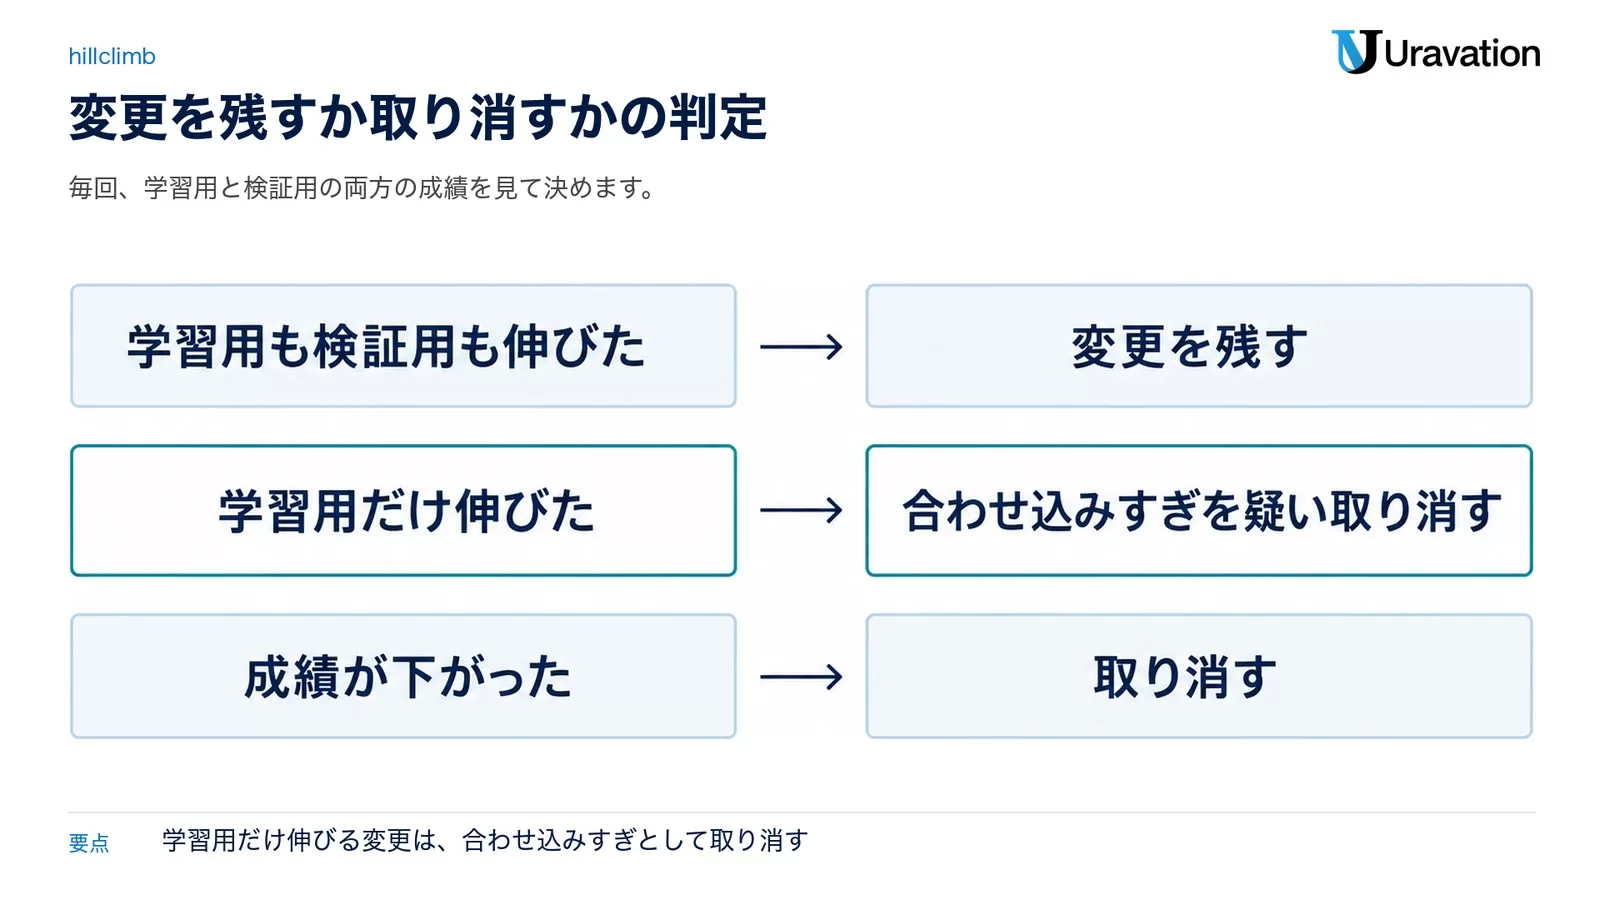
毎回の動き。Claude は前の回の学習用の記録を読み、1つの変更を差分として提案し、当てて評価を回します。判定は次のとおりです。
| 結果 | 扱い |
|---|---|
| 学習用も検証用も伸びた | 変更を残す |
| 学習用は伸びたが、検証用は変わらない | 合わせ込みすぎを疑い、取り消す |
| 成績が下がった | 取り消す |
成績が2〜3回伸びない時は、変更をやめて、残っている失敗を1件ずつ読み、原因で分類します。あいまいな例、ハーネスの不具合、実行ごとのばらつきがここで見つかります。続きの回に回すのは、本当の失敗だけです。
終わり方。コードは、検証用でいちばん成績のよかった版に戻されます。報告は、検証用での基準との差を信頼区間つきで示します。差が誤差の範囲なら、そう書いて取り込まないよう勧めます。
合わせ込みすぎを防ぐ3つの仕組み
評価が本番の作業の分布とぴったり一致することはまずありません。評価に合わせすぎると、評価の成績だけが上がり、本番では変わらないという結果になります。ブログは OCR の例を挙げています。評価の例に OCR が効く課題が混ざっていると、改善の過程で OCR のツールが足され、成績は上がりますが、本番の作業にはほとんど関係がない、という場合です。
対策としてブログが挙げ、スキルが実行するのは次の3つです。
- 例を分ける:改善役が読んでよい学習用と、見せない検証用に分ける
- 失敗をプロンプトに貼らない:改善役が失敗の記録を読んでも、失敗の中身をそのままプロンプトに写さない。直すのは振る舞い
- 答えを届かない場所に置く:試験を受けるモデルが、期待される答えを読めない構造にする。指示で禁じるだけにしない
指示文は3つ目について、公開のベンチマークでは「届く場所」にインターネットも含まれる、と書いています。Web を使えるエージェントは、解答の載ったページを取りに行けるためです。
残るファイル|.claude/hillclimbの構成
繰り返しは複数の回、場合によっては複数のセッションにまたがります。指示文は、状態をディスクに置くよう求めていて、新しく始める時の既定の構成を示しています。利用者が既に結果の置き場を持っている場合は、そちらを使います。
.claude/hillclimb/<flow>/
  _state.json
  metrics.md
  narrative.md
  trajectory/
    scores.tsv
  baseline/
    results.jsonl
    summary.json
    traces/
      <id>_rep<k>.json
  v1/
    change.md
    change.patch
    results.jsonl  summary.json  traces/<id>_rep<k>.json
  v2/
    ...
baseline が基準、v1 以降が各回です。change.md に「何を、なぜ変えたか」、change.patch に実際の差分が残るので、どの変更がどの成績につながったかを後から追えます。報告のページ(report.html)は、この構成を読んで作られます。
Anthropicの実例|コスト削減と性能向上
ブログは、社内で hillclimb を使った例を2つ載せています。
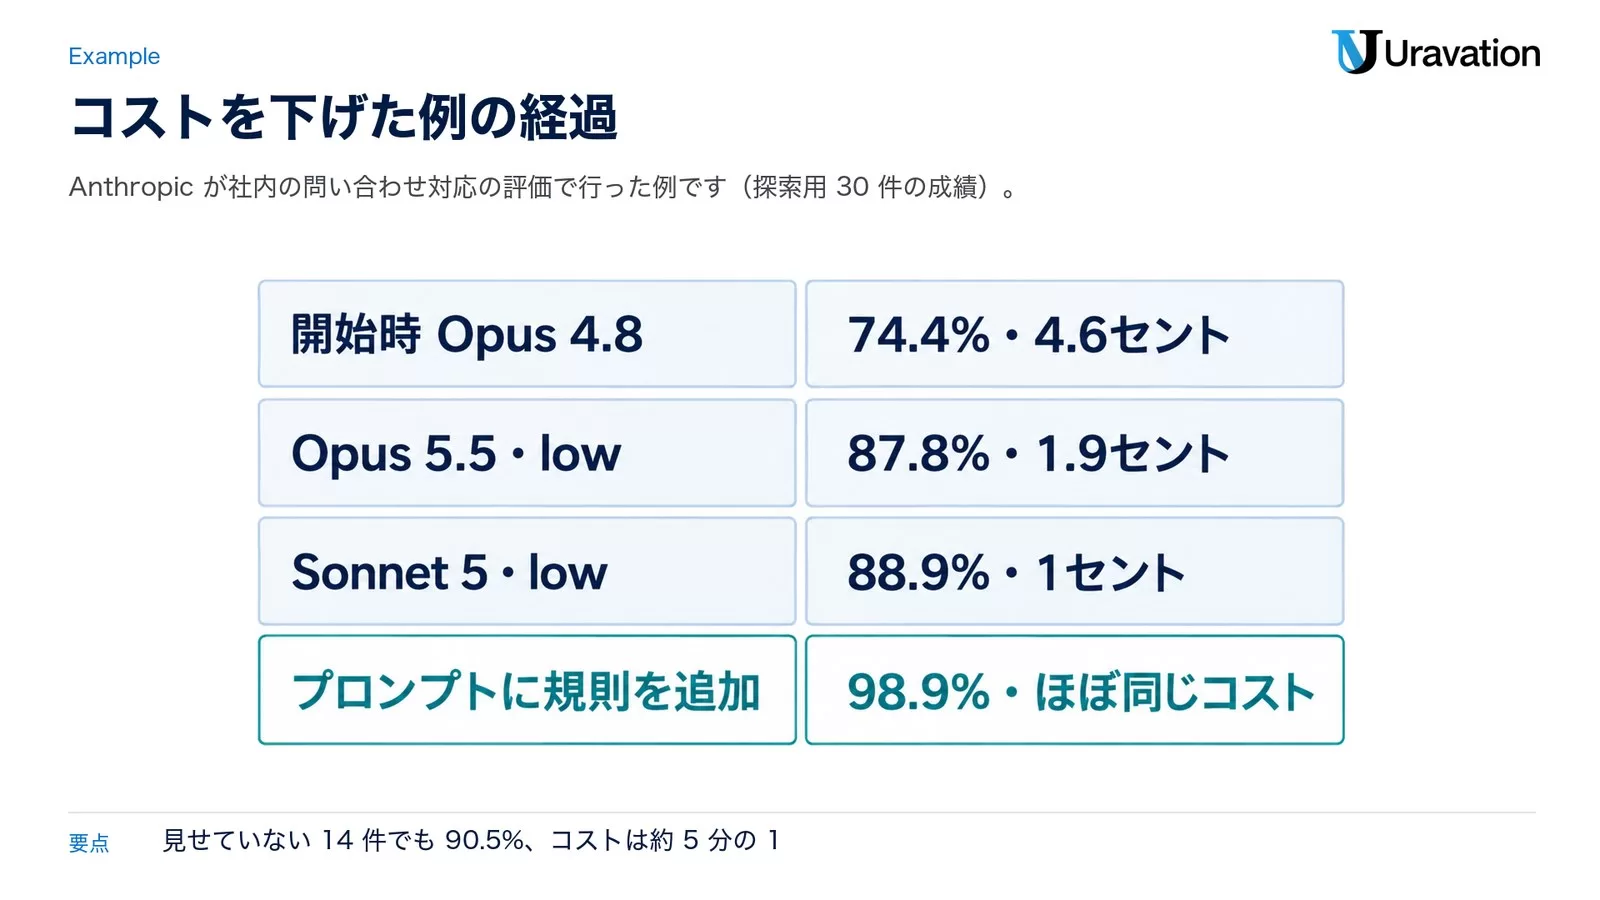
コストを下げた例。問い合わせ対応の社内の評価(44件。30件を探索に使い、14件は見せない)で行ったものです。
| 段階 | 判断の正答率(探索用) | 1件あたりのコスト |
|---|---|---|
| 開始時:Opus 4.8・既定(high)の effort | 74.4% | 4.6セント(約6.9円) |
| プロンプトを整理し、Opus 5.5・low の effort に変更 | 87.8% | 1.9セント(約2.9円) |
| 1段下げて Sonnet 5・low の effort | 88.9% | 1セント(約1.5円) |
| プロンプトに振り分けの規則などを追加(Sonnet 5) | 98.9% | ほぼ同じ |
円は1ドル150円で換算しています。見せていなかった14件では、最終の構成が90.5%、元の構成が78.6%で、コストは約5分の1でした。プロンプトの整理で外したのは、必須にしていたツール呼び出しの手順、下書きの段階、互いに矛盾する規則です。
性能を上げた例。対象は claude-api スキル自身です。ドキュメントから作った評価で、開始時は66%でした。
| 行ったこと | 成績 |
|---|---|
| 開始時 | 66% |
| 抜けていた8つの機能の説明を追加 | 74% |
| C# と Java の型の表の誤りを修正 | 77% |
| 2回伸びなかったので失敗を原因で分類。古い書き方から今の書き方へ導く表を冒頭近くに追加 | 80% |
| 例と採点の側の誤りを修正し、スキルをさらに編集 | 約88% |
4行目が示すのは、内容は書いてあるのに、Claude が学習時に覚えた古い API の形で書いてしまう、という失敗でした。5行目は評価の側の問題です。ある例は、課題文が求める内容と採点が求める内容が食い違っていました。別の採点の指示はドキュメントと矛盾していて、実際の API で試すとドキュメントが正しかった、と書かれています。伸びない例は、評価の側を疑う手がかりになります。
使う前に用意するもの・既存の評価基盤との関係
一次情報から読み取れる、使う前に用意するものは次のとおりです。
- Claude Code(claude-api スキルは同梱)。他の環境ではスキルを導入する
- 評価したいアプリの、実際の入口。指示文は、評価の中でアプリを作り直さず、利用者の実際の入口を呼ぶよう求めています
- 入力の例のもと。本番の記録を使うなら、保存期間と個人情報の扱いを先に決めておく
- API の利用料の上限。全件の実行と、hillclimb の回数分の費用がかかります
- hillclimb を使うなら、コマンドラインから実行でき、例ごとの結果を書き出す評価
ここからは当社の見方です。既に CI で回帰の確認を回しているチームにとって、この2つは置き換えではなく前後の工程です。build-eval が作るのは普通のスクリプトと例のファイルなので、作った評価を CI に載せれば継続的な確認になります。hillclimb は、モデルを切り替える時やプロンプトを直す時の、一時的な探索に向いています。評価を CI に載せる運用は 継続的評価と CI/CD での回帰検知、pytest での自動化は AIエージェント品質評価ガイド で扱っています。
費用の面では、採点にもモデルを使う場合、評価の実行のたびに「アプリの実行」と「採点」の両方の利用料がかかります。回数を決める前に、少数の例で実際の使用量を測るという指示文の手順は、そのまま守るのが安全です。Claude Code のどの版からこの2つのコマンドが入ったかは、2026年9月30日時点で公式に確認できていません。
【要注意】指示文が挙げる失敗パターン
GitHub の指示文は、どちらのコマンドにも「避ける失敗」の一覧を持っています。人が自分で評価を作る時にもそのまま当てはまるものを抜き出します。
失敗1:確認を飛ばす
もっともらしい入力を40件と、それらしい採点の基準を、利用者に見せずに作る。指示文は、誰も信用しない評価ができる、確認こそが成果物だ、と書いています。
失敗2:評価の中でアプリを作り直す
評価のスクリプトの中で Claude の呼び出しを一から書き直すと、本番の動きから静かにずれ、違うものを測ることになります。
失敗3:0を信じる
コストが0、応答時間が0、全件で同じ値、という結果は、ほとんどの場合、測定ではなく項目名の食い違いなどの不具合です。指示文は、0になるはずのない欄の0を、結果ではなく実行の仕組みの不具合として扱うよう求めています。
失敗4:検証用の例を見る
分割は、本当の改善と合わせ込みすぎを分ける唯一の仕切りです。検証用の記録を開いたり、その内容を変更の案に反映したりすると、結果の信用がなくなります。
失敗5:1件の失敗から全体を書き換える
1つの失敗に見えた型をもとにプロンプト全体を書き直すのは、成績を下げるもっともよくある道だ、と指示文は書いています。変更の大きさは、その失敗が何件あるかに合わせます。
よくある質問
build-evalとhillclimbは無料で使えますか?
スキル自体はオープンソースで、Claude Code に同梱されています。評価の実行とモデルによる採点には API の利用料がかかります。指示文は、費用を聞かれた時に、少数の例での試し実行の使用量から見積もるよう求めています。
評価がまだ無くてもhillclimbを使えますか?
使えません。指示文は、実行できる評価が無い場合はそこで止まるよう書いています。先に build-eval で評価を作ります。
Claude以外のモデルのアプリにも使えますか?
公式ドキュメントによると、claude-api スキルは、OpenAI など他の AI の SDK を読み込むコードでは自動では働きません。2つのコマンドの指示文も、Claude を使ったアプリの評価を前提に書かれています。
採点に使うモデルは何を選べばよいですか?
利用者が選びます。ブログは、試験の対象と同じモデルにしないことを条件に挙げています。採点の基準は、5段階の点数ではなく、確認できる主張の形で書きます。
結果が誤差の範囲だった時はどうなりますか?
報告にそう書かれ、取り込まないよう勧められます。指示文は、わずかな伸びを飾って見せるより、「動かなかった、次に試すならこれ」と正直に伝えるほうが利用者の役に立つ、と書いています。
まとめ
build-eval と hillclimb は、評価を作る工程と、評価に対して改善を繰り返す工程を、Claude Code の中の手順にしたものです。build-eval は入力と採点方法のそれぞれで利用者の確認を取り、課金の前に配線を点検してから基準を取ります。hillclimb は例を学習用と検証用に分け、1回に1つの変更を当て、検証用で伸びない変更を取り消します。結論は検証用での基準との差で、誤差の範囲なら取り込まないよう勧められます。
試すなら、1つの処理の流れに絞って build-eval を実行し、入力の例のページと採点の例を自分の目で確かめるところからです。社内で AI を組み込んだ業務の評価の進め方を検討する段階で相談先が必要な場合は、Uravation でも AI エージェントの導入を支援しています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Automating eval design and hillclimbing with Claude — claude.dev Blog(Anthropic・2026年9月28日・参照日: 2026-09-30)
- Claude API skill — Claude Platform Docs(参照日: 2026-09-30)
- skills/claude-api/shared/evals/build-eval.md — GitHub anthropics/skills(参照日: 2026-09-30)
- skills/claude-api/shared/evals/eval-hillclimb.md — GitHub anthropics/skills(参照日: 2026-09-30)
- skills/claude-api/shared/evals(eval-audit.md・cost-hillclimb.md を含む) — GitHub anthropics/skills(参照日: 2026-09-30)