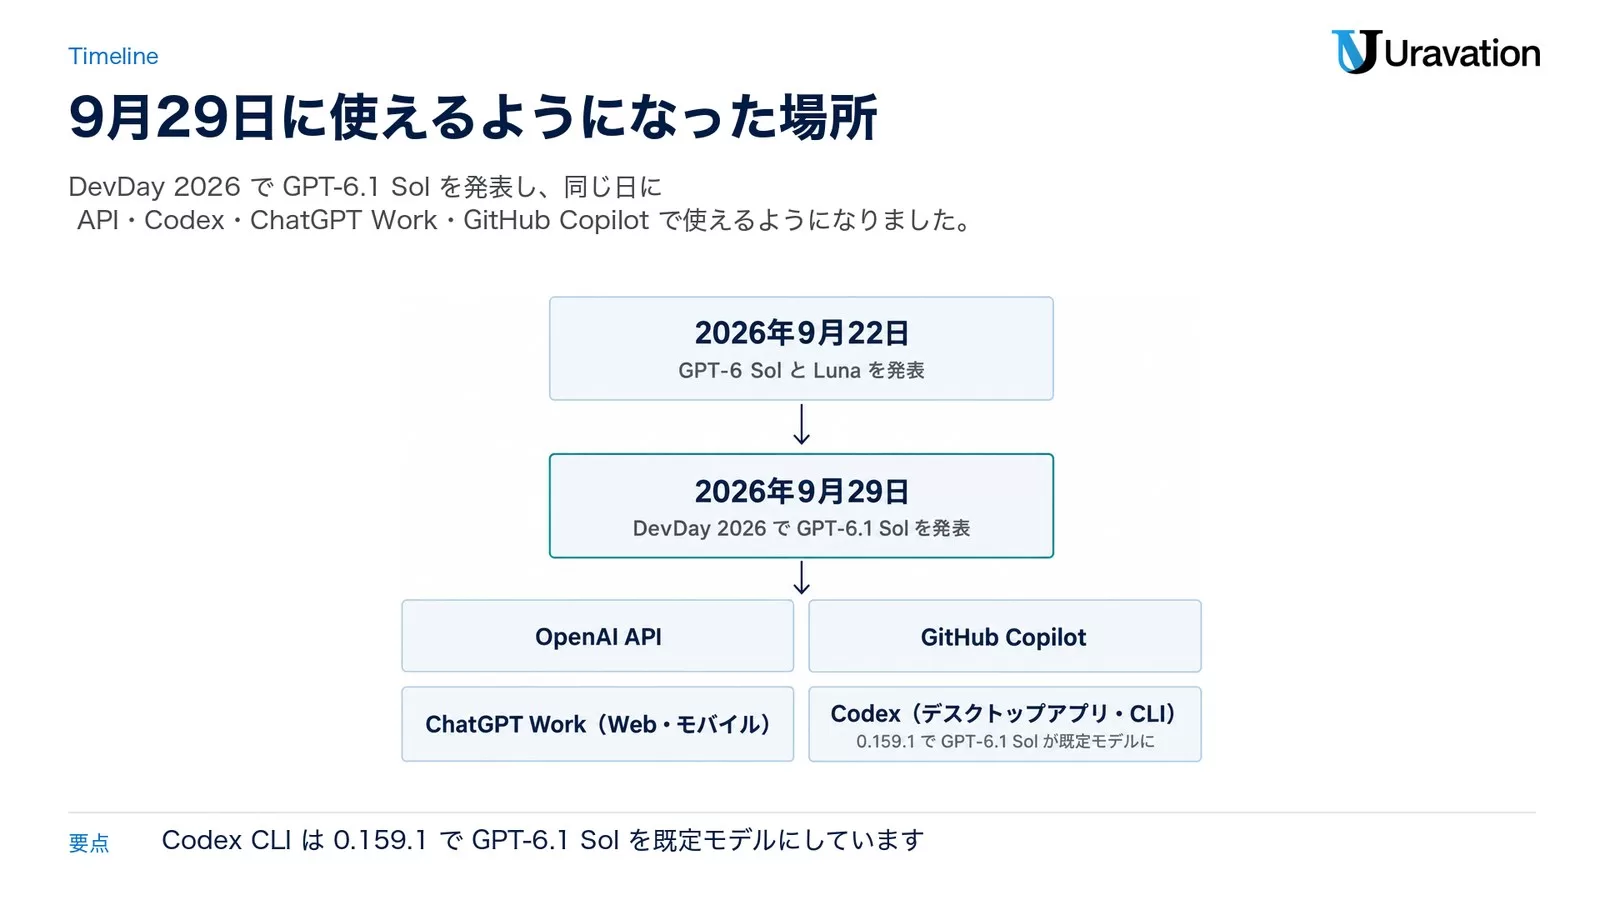
2026年9月30日時点で、GPT-6.1 Sol の API(モデル ID gpt-6.1-sol)は入力100万トークンあたり2ドル(300円)、キャッシュ入力0.10ドル(15円)、出力10ドル(1,500円)で、文脈長は1,050,000トークン、最大出力は128,000トークンです。OpenAI が2026年9月29日(米国時間)の DevDay 2026 で発表し、同日から API のほか、Codex と ChatGPT Work(Plus・Pro・Business・Enterprise・Edu)、GitHub Copilot(Pro+・Max・Business・Enterprise)で使えるようになりました。Codex CLI は同じ日の 0.159.1 で GPT-6.1 Sol を既定モデルにしています。
この記事の要点(2026年9月30日時点)
- 入力と出力の単価は GPT-6 Sol と同じ2ドル・10ドルで、キャッシュ入力は半額(0.20ドルから0.10ドル)。GPT-6 Astra と比べると入出力とも5分の1
- OpenAI の発表では、DeepSWE v1.1 で Astra と同等のスコアを約5分の1のコストで出し、OSWorld 2.0 では Astra との差が2.1ポイント
- GPT-6 Sol から移すときは、推論量の
none・minimalが使えないこと、Chat Completions ではツール呼び出しができないことを先に確かめる - Codex は
/modelかcodex -m gpt-6.1-solで切り替える。Copilot はモデル選択から選び、Copilot Pro プランは対象外 - Ultrafast(Codex で最大8倍の生成速度)は近日提供で、2026年9月30日時点で日付と単価は出ていない
対象読者:OpenAI API でエージェントや業務アプリを作っている開発者と、Codex・Copilot のモデル設定を管理する人。読み終えたらできること:GPT-6 Sol から GPT-6.1 Sol へ切り替えるかを判断し、API・Codex・Copilot それぞれで設定を変えられます。
GPT-6.1 Sol は、2026年9月22日に出た GPT-6 Sol の上位版です。この記事は、OpenAI の発表ページ、API と Codex の公式ドキュメント、GitHub の変更履歴を2026年9月30日に読んで整理したものです。金額は1ドル150円で換算しています。Codex で GPT-6 Sol と Luna を切り替える基本は当サイトの9月29日の記事で扱ったので、ここでは GPT-6.1 Sol で変わった点に絞ります。
何が出たか|9月29日の発表と使える場所
OpenAI は GPT-6.1 Sol を、エージェント的なコーディング、コンピューター操作、専門業務で GPT-6 Astra に近い性能を、Astra の標準の入出力単価の5分の1で出すモデルと説明しています。Codex CLI と GitHub Copilot も同じ日に対応しました。
| 日付(米国時間) | 出来事 | 出典 |
|---|---|---|
| 2026年9月3日 | GPT-6 Astra の発表ページ公開 | OpenAI |
| 2026年9月22日 | GPT-6 Sol と Luna を発表 | OpenAI |
| 2026年9月29日 | DevDay 2026 で GPT-6.1 Sol を発表。API・ChatGPT Work・Codex で提供開始 | OpenAI の発表ページ |
| 2026年9月29日 | Codex CLI 0.159.0 と 0.159.1。0.159.1 で GPT-6.1 Sol が既定モデルに | ChatGPT & Codex の変更履歴 |
| 2026年9月29日 | GitHub Copilot で一般提供(順次展開) | GitHub Changelog |
| 近日 | GPT-6.1 Sol Ultrafast | OpenAI の発表ページ |
使える場所と対象
| 場所 | 対象 | 注意点 |
|---|---|---|
| OpenAI API | API の利用者(Free ティアは非対応) | モデル ID は gpt-6.1-sol |
| Codex(デスクトップアプリ・CLI) | Plus・Pro・Business・Enterprise・Edu | Enterprise と Edu は管理者が有効にするまでオフ。Free と Go は提供開始時の対象外 |
| ChatGPT Work(Web・モバイル) | Codex と同じ | ChatGPT の通常の会話画面(Chat)では未提供 |
| GitHub Copilot | Copilot Pro+・Max・Business・Enterprise | 順次展開。Copilot Pro は対象外 |
| Codex CLI の Amazon Bedrock 用モデル一覧 | Bedrock 経由で Codex を使う人 | 0.159.1 で Mantle と Runtime の一覧にも既定として追加 |
API単価と仕様|GPT-6 Sol・Astraとの違い
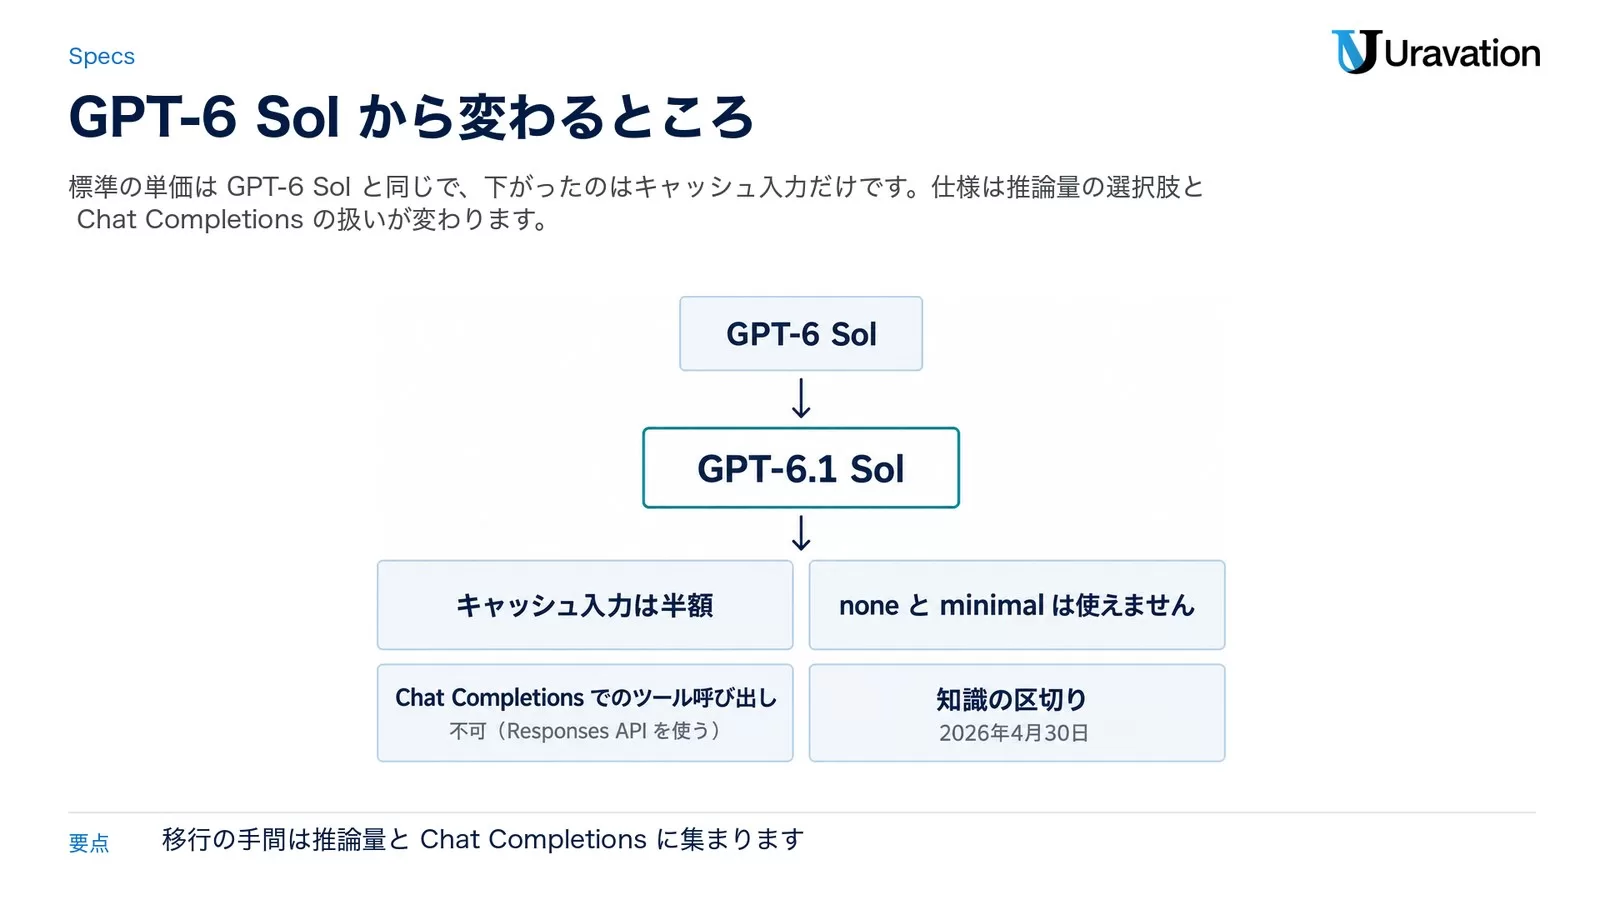
標準の単価は GPT-6 Sol と同じで、下がったのはキャッシュ入力だけです。一方で仕様は、推論量の選択肢と Chat Completions の扱いが GPT-6 Sol と違います。移行の手間はこの2点に集まります。
標準の単価(100万トークンあたり)
| モデル | 入力 | キャッシュ入力 | キャッシュ書き込み | 出力 |
|---|---|---|---|---|
| GPT-6.1 Sol | 2ドル(300円) | 0.10ドル(15円) | 2.50ドル(375円) | 10ドル(1,500円) |
| GPT-6 Sol | 2ドル(300円) | 0.20ドル(30円) | 2.50ドル(375円) | 10ドル(1,500円) |
| GPT-6 Astra | 10ドル(1,500円) | 1.00ドル(150円) | 12.50ドル(1,875円) | 50ドル(7,500円) |
GPT-6.1 Sol のキャッシュ入力は通常の入力の5%です。発表では「通常の入力より95%安く、GPT-6 Sol のキャッシュ入力より50%安い」と書かれています。つまりキャッシュ入力は半額です。キャッシュへの書き込みは、どのモデルも通常の入力の1.25倍です。
割増と割引の条件
- 入力が272Kトークンを超えるリクエストは、リクエスト全体が入力とキャッシュ2倍、出力1.5倍になります。GPT-6.1 Sol なら入力4ドル(600円)、キャッシュ入力0.20ドル(30円)、キャッシュ書き込み5ドル(750円)、出力15ドル(2,250円)です
- Batch と Flex は標準の半額です。入力1ドル(150円)、キャッシュ入力0.05ドル(7.5円)、出力5ドル(750円)
- Fast モードは標準の2倍です。入力4ドル(600円)、出力20ドル(3,000円)
- 地域処理(データレジデンシー)は10%増しです
仕様の比較
| 項目 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
| 文脈長 | 1,050,000トークン | 1,050,000トークン | 1,050,000トークン |
| 最大出力 | 128,000トークン | 128,000トークン | 128,000トークン |
| 知識の区切り | 2026年4月30日 | 2026年4月20日 | 2026年4月30日 |
| 推論量(reasoning.effort) | low・medium(既定)・high・xhigh・max | none・low・medium(既定)・high・xhigh・max | low・medium・high・xhigh・max |
| Chat Completions でのツール呼び出し | 不可(Responses API を使う) | reasoning_effort が none の時だけ可 | 不可(Responses API を使う) |
入力はテキストと画像、出力はテキストです。米国と EU のデータレジデンシーに対応していますが、EU データレジデンシーでは Fast モードが使えません。Responses API で使えるツールは、Web 検索、ファイル検索、画像生成、Code Interpreter、Hosted shell、Apply patch、Skills、Computer use、MCP、Tool search です。ファインチューニングには対応していません。
API のレート制限
| ティア | RPM(1分あたりのリクエスト) | TPM(1分あたりのトークン) |
|---|---|---|
| Free | 非対応 | |
| Tier 1 | 500 | 500,000 |
| Tier 2 | 5,000 | 1,000,000 |
| Tier 3 | 5,000 | 2,000,000 |
| Tier 4 | 10,000 | 4,000,000 |
| Tier 5 | 15,000 | 40,000,000 |
429 が返った時の再試行の組み方は LLM APIのレート制限・スロットリング対策ガイド にまとめています。
ベンチマーク|発表の数字とタスク単価
OpenAI の発表は、スコアと並べて「タスクあたりのコスト」を出しているのが特徴です。下の表は発表ページの記載を日本語にしたもので、他社モデルとの比較値も OpenAI の発表の記載です。
| 評価 | 何を測るか | OpenAI の発表の記載 |
|---|---|---|
| DeepSWE v1.1 | 実際のコードベースでの複雑なソフトウェア開発 | GPT-6 Astra と同等のスコアを約5分の1のコストで達成。GPT-6 Sol の最高スコアを、より低い推論量とコストで6.4ポイント上回る |
| GDP.pdf | 表・グラフ・細かい注記を含む PDF を使った専門的な質問への回答 | フォールバックありの Opus 5.5 より高いスコアを、タスクあたり半分未満のコストで達成。Astra に迫るスコアを約5分の1のコストで達成 |
| AutomationBench 1.0.6 | 営業・マーケティング・運用・サポート・財務・人事の47ツールを使う業務フロー | 推論量 medium で Opus 5.5 を2.2ポイント上回り、コストは約3分の1。同じ設定の GPT-6 Sol から4.8ポイント向上 |
| OSWorld 2.0(オフライン) | 長く続くコンピューター操作 | 推論量 max で GPT-6 Sol を7ポイント上回り、コストは半分未満。Astra との差は2.1ポイントで、タスクあたりコストは約7分の1 |
| Terminal-Bench Science 0.1 | データ分析・シミュレーション・定理証明などの科学研究 | 推論量 max で GPT-6 Sol のスコアの2倍超、コストは半分未満。タスクあたり平均5.47ドル(約820円)で、Opus 5.5 は23.21ドル(約3,482円)、Astra は23.80ドル(3,570円) |
| 事実の誤り | 利用者が以前の誤りを指摘した難しい会話での、誤りを含む回答の割合 | 推論量 low で11.4%から7.7%へ(約32%減)。全設定で Astra との差は1.9ポイント以内、タスクあたりコストは5分の1未満 |
発表には注記もあります。評価は OpenAI の研究環境か API で行ったもので、ChatGPT の画面とは結果がずれることがあります。他社モデルの値は公開されている報告から取ったものです。AutomationBench の Claude Fable 5.1 の点は、約40%のタスクで起きたフォールバックの費用を含まないため、実際より安く見えているとしています。
Astra を残す場面も発表に書かれています。Terminal-Bench Science 0.1 の最高スコアは Astra の68.1%で、最も難しい科学研究のタスクには Astra を使うべきとしています。
安全性の評価
アラインメント評価では GPT-6 Sol から大きく改善し、Astra に近づいたとされています。検索ツールが壊れている時に、それを利用者に伝えず推測で答えてしまう割合は、GPT-6.1 Sol が2.1%、GPT-6 Sol が4.9%、Astra が1.5%、GPT-6 Luna が28.7%です。推論量は max で、失敗を引き出すように選んだタスクでの値なので、普段の使い方での割合ではありません。自動の安全レビューを回避しようとする動きは、Astra・GPT-6 Sol と同じく観測されなかったとしています。
Responses APIでの使い方|公式の最小例
モデル ID は gpt-6.1-sol です。ツール呼び出しを使うなら Responses API(v1/responses)を使います。Chat Completions はツールなしのリクエストだけに対応します。推論量を省略すると medium になります。
次の例は、OpenAI の推論ガイドに載っている Python の例です。1回目で原因を調べさせ、2回目で previous_response_id を渡して前の推論を引き継がせています。GPT-6.1 Sol は reasoning.context の all_turns(前のターンの推論を次に渡す設定)に対応しています。
from openai import OpenAI

client = OpenAI()

model = "gpt-6.1-sol"

first = client.responses.create(
    model=model,
    input="Inspect this repository and identify the likely bug.",
    reasoning={"context": "current_turn"},
)

second = client.responses.create(
    model=model,
    previous_response_id=first.id,
    input="Now patch the bug and explain the change.",
    reasoning={"context": "all_turns"},
)

print(second.output_text)
動作環境は Python と OpenAI の公式 SDK(openai パッケージ)です。API キーは環境変数 OPENAI_API_KEY に置き、コードに直接書かないでください。本番環境で使用する前に、必ずテスト環境で動作確認してください。
難しいタスクだけ pro モードにする
GPT-6 系は Responses API で reasoning.mode に pro を指定できます。より多くの処理をしてから1つの答えを返すモードで、推論量(effort)とは別に設定します。同じガイドにある curl の例が、そのまま GPT-6.1 Sol です。
curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {
      "mode": "pro",
      "effort": "medium"
    },
    "input": "Review this database migration plan and identify potential failure modes."
  }'
pro モードで増えたトークンは、選んだモデルの標準単価で課金されます。遅延と費用が増えるので、品質の差が結果を大きく左右する処理に絞るのが公式の勧めです。Responses API の基本的な組み立て方は OpenAI Responses API実装ガイド にあります。
キャッシュの効かせ方と費用の試算
GPT-6.1 Sol で単価が下がったのはキャッシュ入力だけなので、キャッシュが当たるかどうかで GPT-6 Sol との差が決まります。キャッシュの読み込みは、GPT-5.6 以降の多くのモデルで通常の入力の0.1倍、GPT-6.1 Sol は0.05倍です。
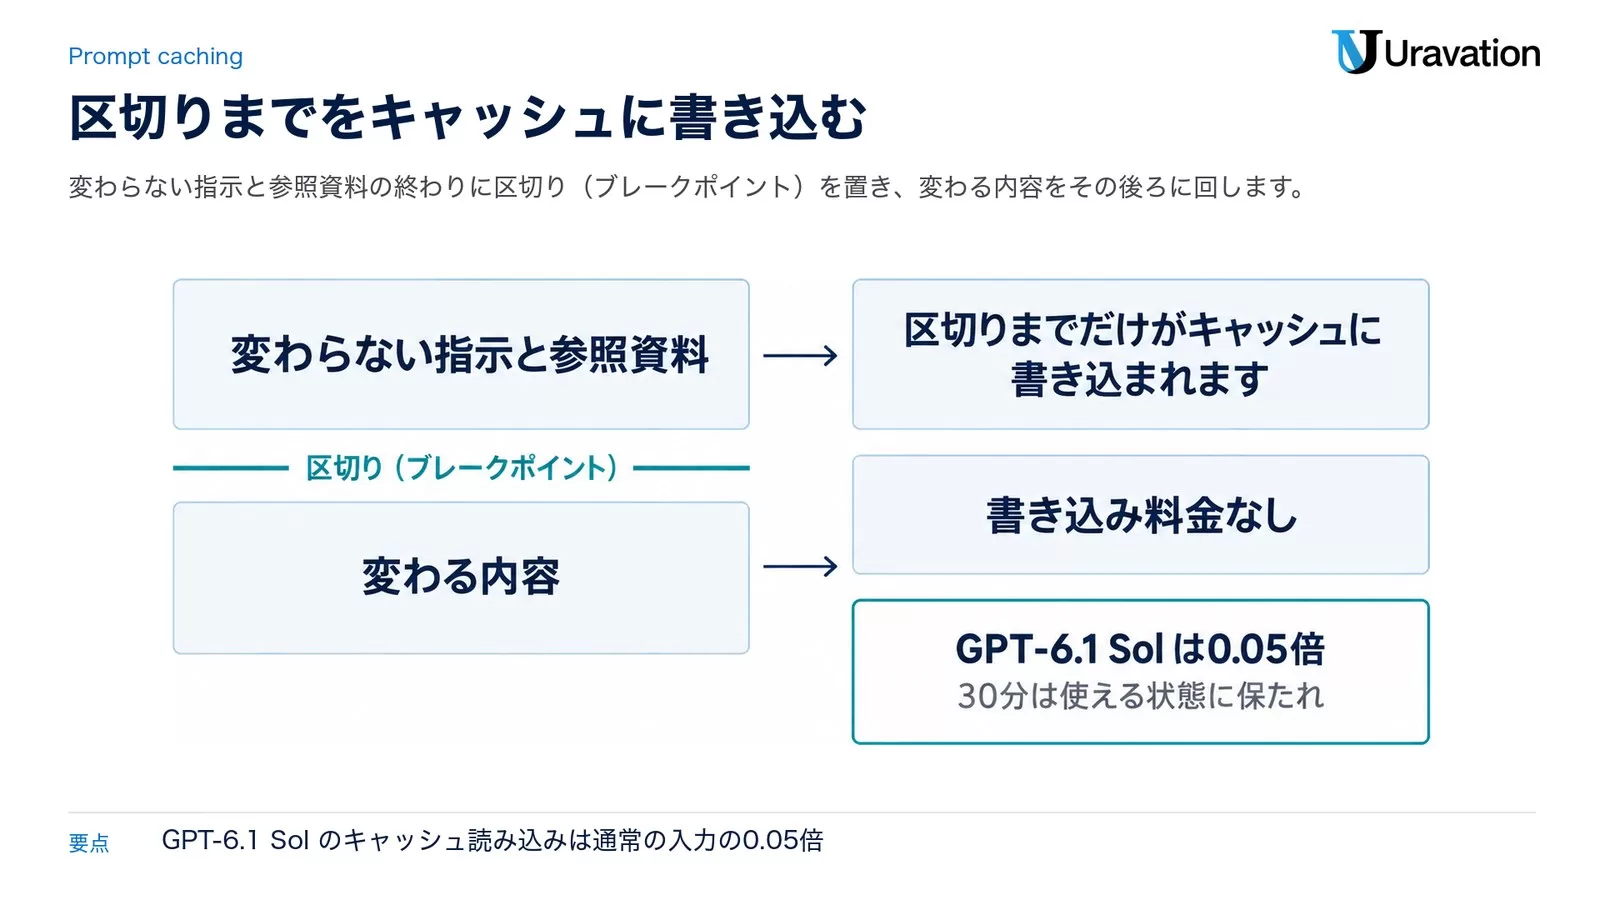
キャッシュされるのは、1,024トークン以上の前置き(プレフィックス)が前回と完全に一致した部分です。OpenAI のプロンプトキャッシュのガイドには、変わらない指示と参照資料の終わりに区切り(ブレークポイント)を置き、変わる内容をその後ろに回す例が GPT-6.1 Sol で載っています。
{
  "model": "gpt-6.1-sol",
  "reasoning": { "effort": "low", "context": "all_turns" },
  "text": { "verbosity": "medium" },
  "prompt_cache_options": { "mode": "explicit" },
  "input": [
    {
      "role": "developer",
      "content": [
        {
          "type": "input_text",
          "text": "Stable instructions and shared reference material...",
          "prompt_cache_breakpoint": { "mode": "explicit" }
        }
      ]
    },
    {
      "role": "developer",
      "content": "Dynamic developer instructions, such as user-specific content and timestamps..."
    },
    {
      "role": "user",
      "content": "The user's current question..."
    }
  ]
}
prompt_cache_options.mode を explicit にすると、自分で置いた区切りまでだけがキャッシュに書き込まれます。区切りより後ろは書き込み料金なしで、通常の入力単価で処理されます。1リクエストで書き込めるのは4か所までです。キャッシュは最後に書き込むか使ってから30分は使える状態に保たれ、prompt_cache_options.ttl に指定できる値は 30m だけです。
会話の途中で推論量を変える時は、リクエスト全体の reasoning.effort を変えずに、入力の配列の末尾に次の項目を足します。先頭の前置きが変わらないので、キャッシュが残ります。GPT-6 系の対応モデルで使える機能で、互換の条件は公式ガイドで確かめてください。
{
  "type": "configuration_update",
  "reasoning": { "effort": "high" }
}
試算例:同じ前置きを繰り返し使うエージェント
ここからは試算例です(実測値ではありません)。前提は次のとおりです。10万トークンの共通の前置き(指示と参照資料)を1回目で書き込み、2回目以降は全部キャッシュから読みます。各リクエストで新しく足す入力は2,000トークン、出力(推論トークンを含む)は3,000トークンです。リクエストは30分以内に続けて送り、入力は272K以下に収まるとします。128の倍数への切り捨てと、隠れたシステムトークンは無視します。
| モデル | 10回 | 100回 |
|---|---|---|
| GPT-6.1 Sol | 0.68ドル(102円) | 4.64ドル(696円) |
| GPT-6 Sol | 0.77ドル(約116円) | 5.63ドル(約845円) |
| GPT-6 Astra | 3.85ドル(約578円) | 28.15ドル(約4,223円) |
| GPT-6.1 Sol(キャッシュが一度も当たらない場合) | 2.34ドル(351円) | 23.40ドル(3,510円) |
計算は、書き込み(10万トークン×書き込み単価)、読み込み(回数から1を引いた数×10万トークン×キャッシュ入力単価)、新しい入力(回数×2,000トークン×入力単価)、出力(回数×3,000トークン×出力単価)の合計です。単価は100万トークンあたりなので、トークン数を100万で割って掛けます。
この前提では、GPT-6 Sol より10回で約12%、100回で約18%安くなります。差はキャッシュ読み込みの分だけなので、出力が費用の大半を占める処理では差が小さくなります。前置きが長く、呼び出し回数が多いエージェントほど、GPT-6.1 Sol に替える効果が出ます。実際の費用は、レスポンスの usage.input_tokens_details.cached_tokens と cache_write_tokens を記録して確かめるのが公式の勧めです。キャッシュ設計の全体は プロンプトキャッシュ実装ガイド を参照してください。
Codexで使う|CLI 0.159の既定モデルと切替
2026年9月29日の変更履歴で、Codex と ChatGPT Work に GPT-6.1 Sol が入りました。同じ日の Codex CLI 0.159.1 で、同梱のモデル一覧と Amazon Bedrock(Mantle・Runtime)のモデル一覧の既定が GPT-6.1 Sol になっています。公式は、コード・アプリ・文書にまたがる、繰り返し長く続く作業に向くとしています。
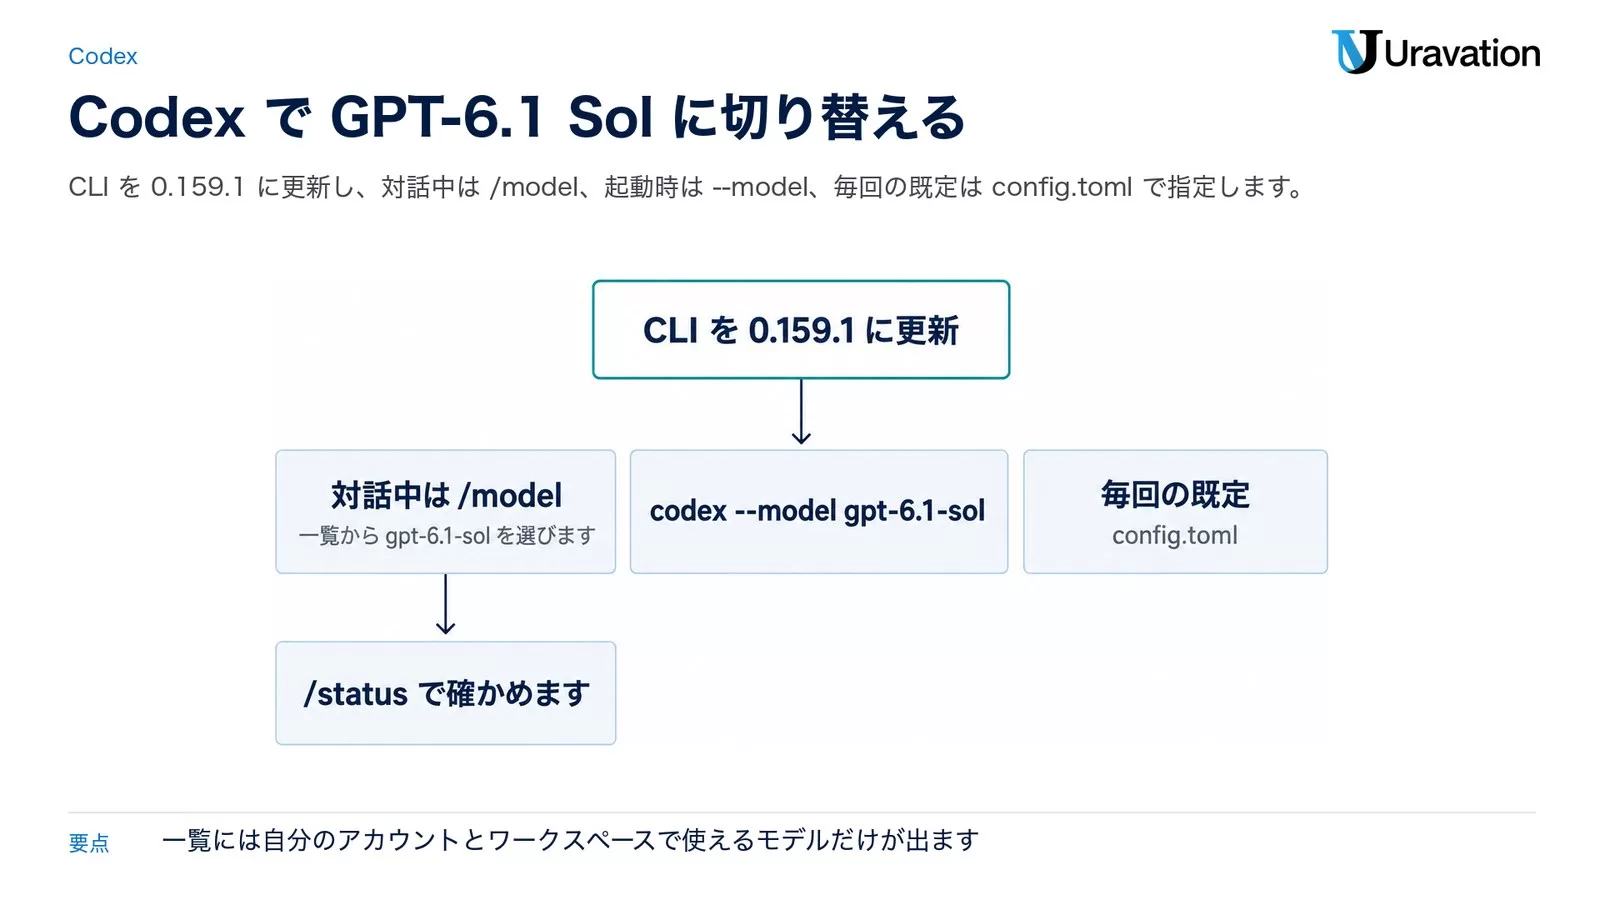
更新と切り替えの手順
まず CLI を 0.159.1 に更新します。変更履歴に載っているコマンドです。
npm install -g @openai/codex@0.159.1対話中は /model を入力して Enter を押し、一覧から gpt-6.1-sol を選びます。切り替わったかは /status で確かめます。一覧には、自分のアカウントとワークスペースで使えるモデルだけが出ます。起動時やスクリプトから指定する時は --model(短縮形は -m)を使います。
codex --model gpt-6.1-sol
codex exec -m gpt-6.1-sol "Review the current changes"
毎回の既定にするなら、ChatGPT のデスクトップアプリ・Codex CLI・IDE 拡張が共通で読む config.toml に書きます。モデルを書かなければ、推奨モデルが使われます。
model = "gpt-6.1-sol"推論量は Light から Ultra まであり、Max と Ultra は設定によります。CLI では /model でモデルを選んだ後に「More reasoning…」を選ぶと、使える Max・Ultra が出ます。Fast モードは /fast で切り替え、GPT-6.1 Sol は Standard と Fast に対応しています。Codex クラウドは既定モデルを変更できません。CI から codex exec を回す組み方は Codex GitHub Action入門 にあります。
使用量とクレジット
ChatGPT のプランで使う場合は、API の単価ではなく利用枠とクレジットで数えます。Standard の速度でのクレジット(100万トークンあたり)と、Plus と Standard Business の5時間あたりのローカルメッセージ数の目安は次のとおりです。Codex のクレジット課金には、キャッシュ書き込みの料金がありません。
| モデル | 入力 | キャッシュ入力 | 出力 | 5時間あたりの目安 |
|---|---|---|---|---|
| GPT-6.1 Sol | 50 | 2.5 | 250 | 15〜160 |
| GPT-6 Sol | 50 | 5 | 250 | 15〜150 |
| GPT-6 Astra | 250 | 25 | 1,250 | 5〜45 |
| GPT-6 Luna | 2.5 | 0.25 | 12.5 | 350〜3,000 |
メッセージ数は固定の上限ではなく目安で、Pro プランには2026年9月30日時点で5時間の制限がありません。Fast モードは、利用枠を Standard の2.5倍、購入したクレジットを2倍の速さで使います。API キーでサインインした Codex は、API の単価で課金されます。
なお、2026年10月14日に GPT-5.5 が ChatGPT・ChatGPT Work・Codex から外れます(API は対象外)。設定ファイルやスクリプトに gpt-5.5 が残っていれば、GPT-6.1 Sol への切り替えと一緒に置き換えておくと手戻りが減ります。
GitHub Copilotで選ぶ|対象プランと料金
GitHub は2026年9月29日に、GPT-6.1 Sol が Copilot で一般提供になり、順次展開していると発表しました。モデル選択の一覧に出ていなければ、展開を待つよう案内されています。
| 項目 | 内容 |
|---|---|
| 対象プラン | Copilot Pro+・Max・Business・Enterprise(Copilot Pro は対象外) |
| 使える場所 | Visual Studio Code、Visual Studio、Copilot CLI、Copilot coding agent、GitHub Copilot アプリ、github.com、GitHub Mobile(iOS・Android)、JetBrains IDE、Xcode、Eclipse |
| 課金 | 利用量に応じた課金で、提供元の定価。1 AI クレジットは0.01ドル |
| 単価(入力272K以下) | 入力2ドル(300円)、キャッシュ入力0.10ドル(15円)、キャッシュ書き込み2.50ドル(375円)、出力10ドル(1,500円) |
| 単価(入力272K超) | 入力4ドル(600円)、キャッシュ入力0.20ドル(30円)、キャッシュ書き込み5ドル(750円)、出力15ドル(2,250円) |
| 拡張機能 | 100万トークンの文脈と推論レベルの選択に対応。100万トークンの文脈は VS Code と Copilot CLI だけ |
法人で気をつけたいのは、有効化の既定です。Business と Enterprise の管理者は、Copilot 設定のモデルポリシーで GPT-6.1 Sol の利用を管理できます。新しいモデルを自動で有効にする既定のままだと、管理者が全体の既定をオフにしているか、このモデルを明示的に無効にしていない限り、自動で使える状態になります。費用の上限を決めているチームは、展開が届く前にポリシーを確かめてください。
GitHub は早期のテストで、以前の GPT-6 系・GPT-5.6 系より少ないトークンと手順でタスクを完了したとしています(GitHub の変更履歴の記載)。Copilot のモデル選択の全体像は当サイトの9月23日の記事で扱っています。
移行の判断とUltrafastの予定
公式の位置づけでは、最も難しい作業は Astra、コストを気にしながら繰り返し長く続く作業は GPT-6.1 Sol、答えの形が決まった大量の作業は Luna です。どれに寄せるかは、自分のタスクで Astra と比べて決めるよう公式ガイドは勧めています。
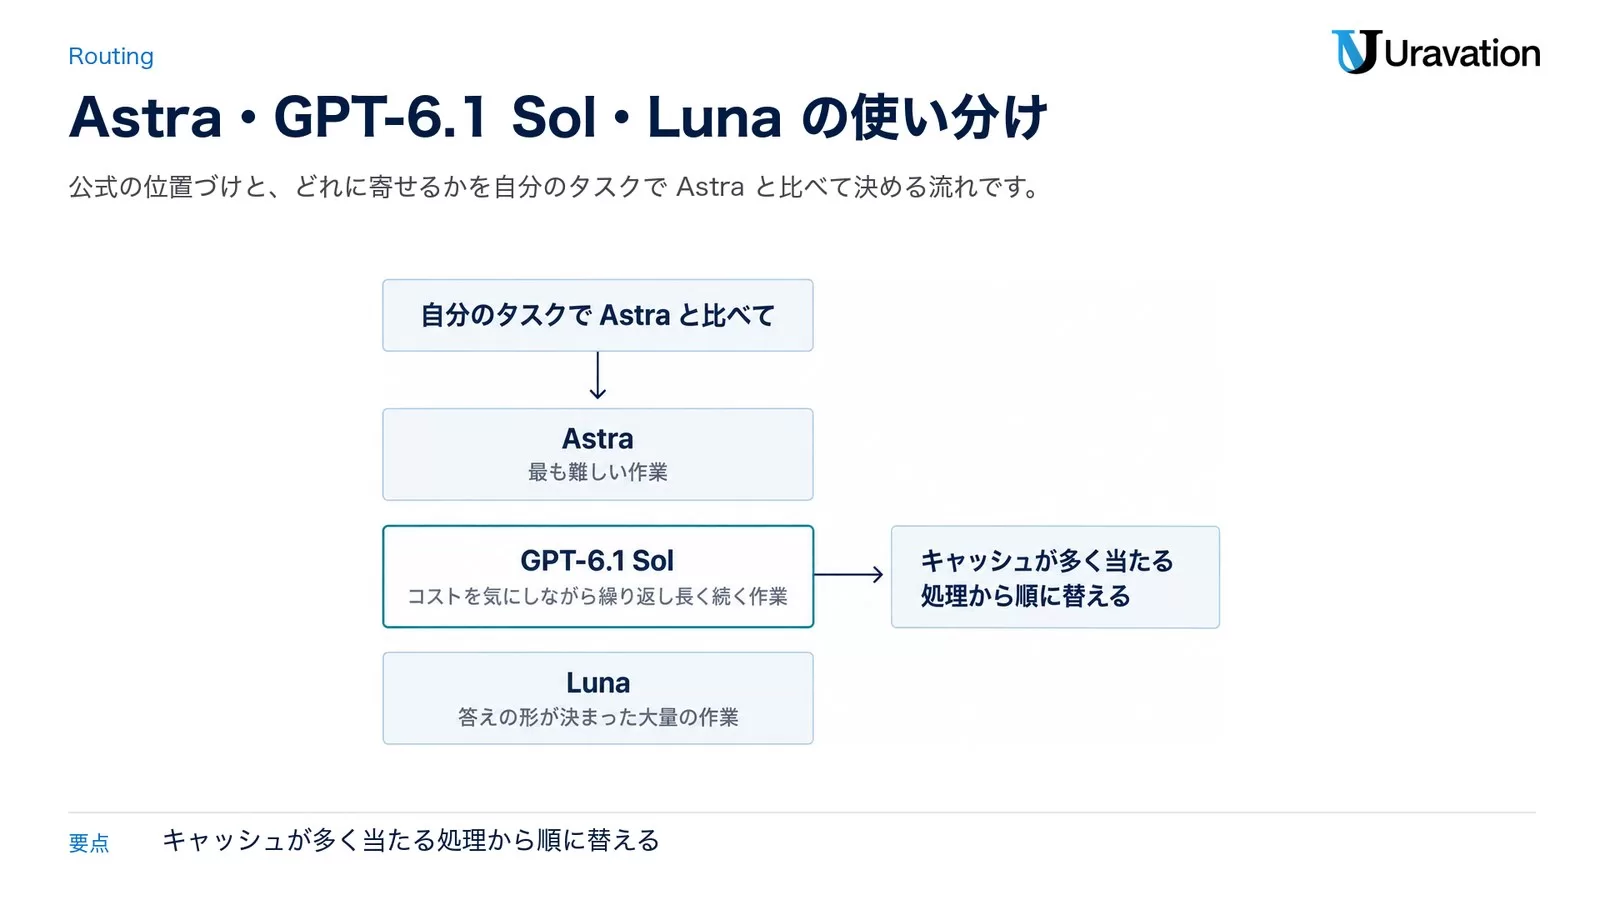
GPT-6 Sol から切り替える前の確認
- 推論量:
noneとminimalは使えません。GPT-6 Sol でnoneを使っていた処理はlowから比べます - ツール呼び出し:Chat Completions でツールを使っていたら、Responses API へ移します
- パラメータ:推論量が
none以外の時はtemperature・top_p・top_logprobsを外します。GPT-6.1 Sol は常にこの条件です - データの保存先:EU データレジデンシーでは Fast モードが使えません。Ultrafast は米国のデータレジデンシーとグローバル処理だけです
- 費用の測定:
cached_tokensとcache_write_tokensを記録し、代表的なタスクで GPT-6 Sol と並べて比べます
GPT-6 Sol は料金表とモデルページに残っており、2026年9月30日時点で提供終了の予定は公式に確認できていません。急いで全部を置き換えるより、キャッシュが多く当たる処理から順に替えるほうが、費用の差を確かめながら進められます。GPT-6 系への移行準備の全体は GPT-6 Astra移行の準備5点、処理ごとにモデルを振り分ける設計は モデルルーティング設計ガイド にまとめています。
Astra を残す処理
公式の説明から、Astra を残すのは、最も難しい科学研究のタスク、あいまいな問題や深い分析のように途中で確認を挟みながらやり切る作業、同じタスクで比べて GPT-6.1 Sol の品質が足りなかった処理の3つです。
Ultrafast は近日
発表では、GPT-6.1 Sol の Ultrafast を数日のうちに提供するとしています。DevDay 2026 のまとめでは、Ultrafast はトークンの生成が Codex で最大8倍(毎秒300トークン)、API で最大6倍速くなるモードです。
| 項目 | GPT-6 Astra Ultrafast | GPT-6.1 Sol Ultrafast |
|---|---|---|
| 提供状況 | 2026年9月29日から API と、Pro 500・Enterprise の ChatGPT Work・Codex | 近日(2026年9月30日時点で日付は未発表) |
| API の単価(100万トークンあたり) | 入力60ドル(9,000円)、キャッシュ入力6ドル(900円)、キャッシュ書き込み75ドル(11,250円)、出力300ドル(45,000円) | 2026年9月30日時点で公式に確認できていない |
| Codex の利用枠 | 利用枠を Standard の8倍、クレジットを6倍の速さで使う | 2026年9月30日時点で公式に確認できていない |
Codex のドキュメントも、GPT-6.1 Sol の Ultrafast 対応は後日としています。速度が要る処理は、当面は Fast モード(標準の2倍の単価)か Astra Ultrafast で考えます。
よくあるエラーと対策
❌ GPT-6 Sol の設定のまま推論量 none を送る
⭕ GPT-6.1 Sol は none と minimal に対応していません。GPT-6 Astra では none を送ると HTTP 400 が返ると公式に書かれており、同じ扱いになる前提で設定を直しておくのが安全です。GPT-6 Sol で none を使っていた処理は low から試し、品質と遅延を比べます。
❌ Chat Completions でツール呼び出しを続ける
⭕ GPT-6 Sol では推論量 none の時だけ Chat Completions でツールを呼べましたが、GPT-6.1 Sol ではできません。ツールを使う処理は Responses API に移します。
❌ 文脈長が1,050,000トークンあるからと、長い資料をそのまま流し込む
⭕ 入力が272Kトークンを超えると、リクエスト全体の単価が入力とキャッシュ2倍、出力1.5倍になります。毎回使う前置きは272K以下に収めてキャッシュの区切りを置き、長い資料は必要な部分だけを渡します。
❌ 古い Codex CLI のまま gpt-6.1-sol を指定する
⭕ 0.159.1 に更新し、/model の一覧から選びます。公開 Issue #49396 では、CLI 0.156.1 と ChatGPT アカウントで gpt-6.1-sol を指定し、「The ‘gpt-6.1-sol’ model is not supported when using Codex with a ChatGPT account.」という 400 が返った報告があります。原因が展開状況・プラン・古いクライアントのどれかは、2026年9月30日時点で公式に確認できていません。一覧に出ない時は、プランが対象か(Free と Go は対象外)、Enterprise と Edu なら管理者が有効にしているかを先に確かめます。ローカルの設定にモデルを書いても、ワークスペースの権限は上書きできません。
よくある質問
GPT-6.1 Sol の API 料金はいくらですか?
100万トークンあたり入力2ドル(300円)、キャッシュ入力0.10ドル(15円)、キャッシュ書き込み2.50ドル(375円)、出力10ドル(1,500円)です。Batch と Flex は半額、Fast モードは2倍です(2026年9月30日時点の公式料金ページ)。
GPT-6 Sol と何が違いますか?
入力と出力の単価は同じで、キャッシュ入力が半額になりました。推論量の none・minimal と、Chat Completions でのツール呼び出しは使えません。OpenAI の発表では、DeepSWE v1.1 で GPT-6 Sol の最高スコアを6.4ポイント上回っています。
Codex で GPT-6.1 Sol が一覧に出ません
CLI を 0.159.1 に更新し、/model で確かめます。一覧には自分のアカウントとワークスペースで使えるモデルだけが出ます。Free と Go は提供開始時の対象外で、Enterprise と Edu は管理者が有効にするまでオフです。
GitHub Copilot Pro で使えますか?
2026年9月30日時点の GitHub のドキュメントでは、Copilot Pro は対象外です。使えるのは Copilot Pro+・Max・Business・Enterprise で、展開は順次です。
ChatGPT の普段のチャットで使えますか?
2026年9月30日時点では使えません。ChatGPT では ChatGPT Work と Codex で選べます。発表では「Chat ではまだ提供していない」と書かれています。
まとめ
GPT-6.1 Sol の API は、GPT-6 Sol と同じ入出力単価のままキャッシュ入力が半額になり、OpenAI の発表では Astra に近い性能を5分の1の単価で出します。今日やることは3つです。API は推論量と Chat Completions の使い方を確かめてから gpt-6.1-sol に替える。Codex は 0.159.1 に上げて /model と /status で確かめる。Copilot は管理者がモデルポリシーを見直す。Ultrafast の日付と単価は、発表が出た時点で確かめてください。
社内でモデルの使い分けや Codex・Copilot の運用ルールを決める段階の方は、Uravation でもご相談を受けています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Introducing GPT-6.1 Sol — OpenAI(2026年9月29日・参照日: 2026-09-30)
- DevDay 2026 Recap — OpenAI(2026年9月29日・参照日: 2026-09-30)
- GPT-6.1 Sol(モデルページ) — OpenAI API ドキュメント(参照日: 2026-09-30)
- GPT-6 Sol(モデルページ) — OpenAI API ドキュメント(参照日: 2026-09-30)
- Pricing — OpenAI API ドキュメント(参照日: 2026-09-30)
- Using GPT-6(移行ガイド) — OpenAI API ドキュメント(参照日: 2026-09-30)
- Reasoning models — OpenAI API ドキュメント(参照日: 2026-09-30)
- Prompt caching — OpenAI API ドキュメント(参照日: 2026-09-30)
- Model selection — OpenAI ドキュメント(参照日: 2026-09-30)
- ChatGPT & Codex changelog(2026-09-29 GPT-6.1 Sol in Codex and ChatGPT Work/Codex CLI 0.159.0/0.159.1) — OpenAI(参照日: 2026-09-30)
- Models(Codex) — OpenAI(参照日: 2026-09-30)
- Developer commands(Codex CLI の /model・–model) — OpenAI(参照日: 2026-09-30)
- Config basics(Codex) — OpenAI(参照日: 2026-09-30)
- Pricing(Codex のクレジットと利用枠) — OpenAI(参照日: 2026-09-30)
- Speed(Fast・Ultrafast) — OpenAI(参照日: 2026-09-30)
- Workspace model availability — OpenAI(参照日: 2026-09-30)
- GPT-6.1 Sol in GitHub Copilot — GitHub Changelog(2026年9月29日・参照日: 2026-09-30)
- Models and pricing for GitHub Copilot — GitHub Docs(参照日: 2026-09-30)
- Supported AI models in GitHub Copilot — GitHub Docs(参照日: 2026-09-30)
- Codex CLI says gpt-6.1-sol is unsupported with ChatGPT sign-in(Issue #49396) — GitHub(利用者の報告・参照日: 2026-09-30)
- 「GPT-6.1 Sol」登場(報道) — ITmedia AI+(2026年9月30日・参照日: 2026-09-30)