OpenAIのGPT-6 Astraは、2026年9月22日現在、APIのモデルID・料金・コンテキスト長・最大出力まで公式ドキュメントで公開されています。OpenAIのモデル一覧では gpt-6-astra が案内され、標準料金は入力$10・出力$50(100万トークンあたり)、コンテキストは1.05M、最大出力は128Kトークンです。提供条件やレート制限などは更新され得るため、契約・実装前には公式のGPT-6 Astraガイドと料金ページを再確認してください。9月1日公開の Path to Astra で示された安全設計も、長時間エージェントの実装に直結します。ひとつは、AstraがPreparedness Frameworkのサイバーセキュリティ分野で「Critical」に該当すると判断された初のモデルであること。もうひとつは、安全策が作業を止めたときChatGPTとCodexでは続行前に確認を求められ、APIではタスクが停止すると明記されたことです。つまり移行で見直すべきなのはプロンプトだけではなく、モデルIDの持ち方と「途中で止まったとき」の分岐です。
この記事は、AIエージェントを実装・運用している開発者向けに、GPT-6 Astraへ移行する前に確認したい準備を5点にまとめたものです。公式ドキュメントで確定したモデルID・料金・コンテキストを反映しつつ、モデル切り替えで残る評価・停止処理・コスト見積もりの論点を実装目線で整理します。
【追記 2026年9月23日】移行の準備に「プロンプトキャッシュの設定」を足してください(9/22 強化)
OpenAI は 2026年9月22日(米国時間)に「Better prompt caching for GPT-6」を公開し、GPT-6 系(Astra・Sol・Luna)のプロンプトキャッシュを強化しました。既定のまま命中率が上がるほか、prompt_cache_diagnostics で命中しなかった理由が返り、prompt_cache_breakpoint でキャッシュする接頭辞の終点を指定でき、reasoning effort やツールの有効・無効を変えてもキャッシュが切れません。単価は据え置き(読み取り 0.1 倍・書き込み 1.25 倍)。Astra へ移した後のコスト最適化として、キャッシュの設定手順と試算例を GPT-6のプロンプトキャッシュ強化|費用の下げ方【2026年9月】 にまとめました。
【追記 2026年9月30日】GPT-6.1 Sol が出て、移行先の候補が 1 つ増えました
OpenAI は 2026 年 9 月 29 日(米国時間)に GPT-6.1 Sol を公開しました。API の単価は GPT-6 Sol と同じ入力 2 ドル・出力 10 ドルで、キャッシュ入力だけ 0.10 ドルに下がっています。Astra との使い分けと Codex での切替は GPT-6.1 Sol API|単価・性能・Codexで使う【2026年9月】 にまとめました。
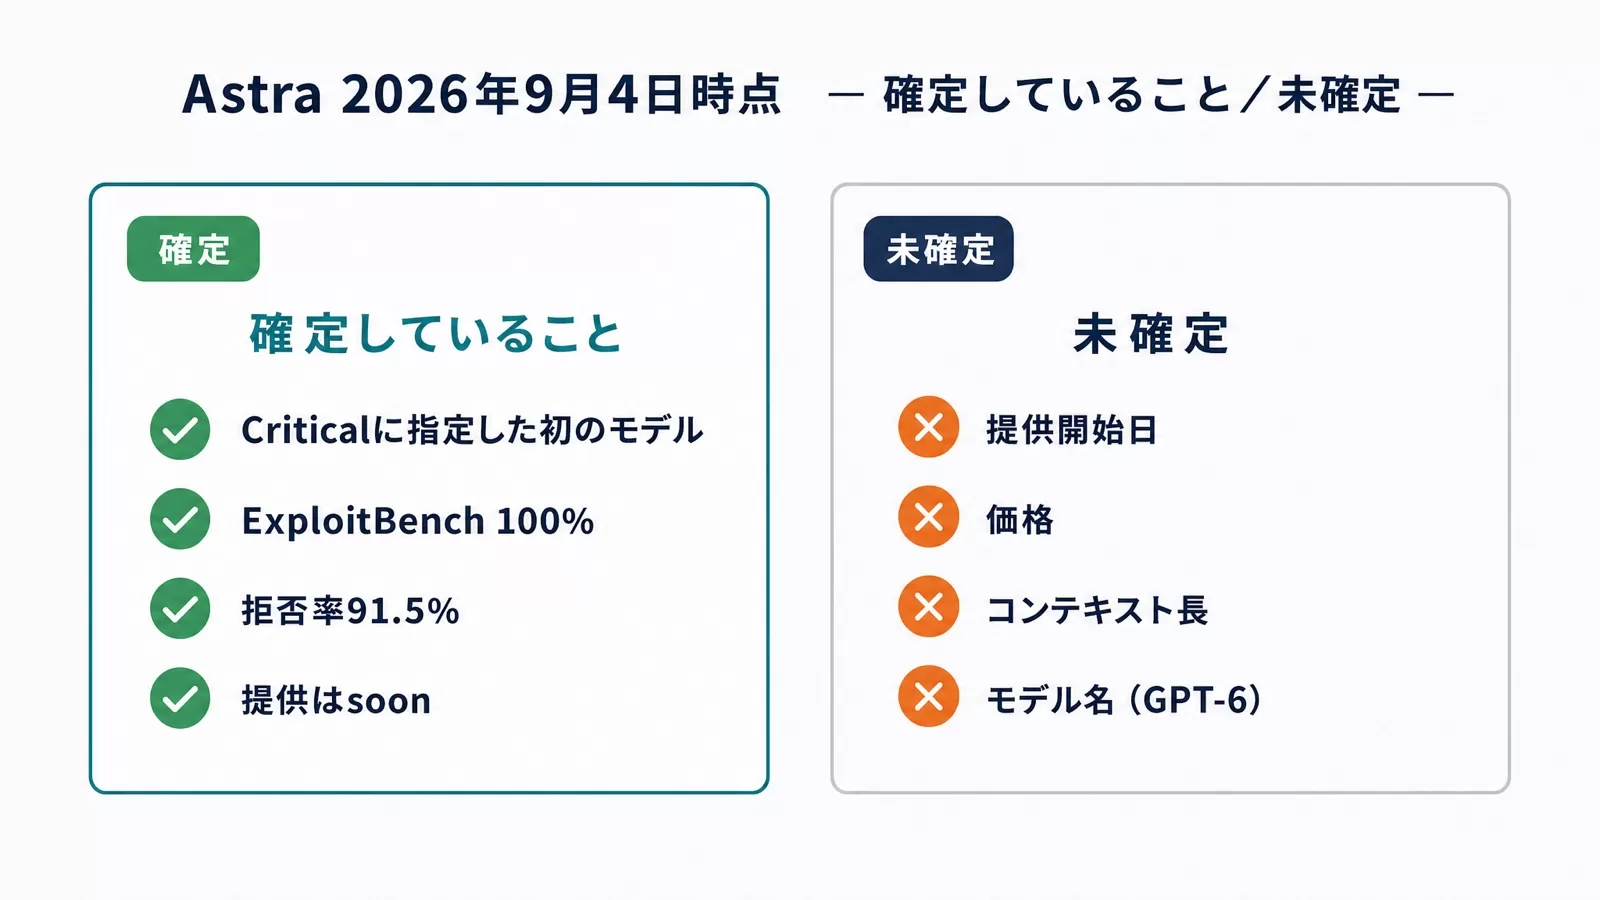
2026年9月22日時点で確定していること
まず情報の切り分けから始めます。Astraについては8月から3本の公式投稿が出ており、内容が少しずつ変わっています。ここを混ぜると設計判断を誤ります。
8月7日の Responding to the next frontier of critical cyber capabilities は「予備的評価の段階で、Criticalの水準を排除できない」という表現でした。同じ日の Pacing model development in an era of cyber-critical capabilities では、監視・アラインメント・セキュリティの3層を固めるため、配備予定モデルの強化学習を二週間止めたことと、最大級のフロンティアRLランを保留していることが説明されました。そして9月1日の Path to Astra で「Criticalの閾値を満たすと考える」と判断が確定し、保留していた大規模RLランを8月28日に再開したことも記載されています。
Path to Astra で公表された数値と方針は次のとおりです。
| 項目 | 公式に記載されている内容(2026年9月1日) |
|---|---|
| Preparedness Framework | サイバーセキュリティ分野で Critical に指定した初のモデル |
| ExploitBench | 既知の脆弱性からエクスプロイトを開発する評価で100% |
| サイバー系ジェイルブレイク拒否率 | Astra 91.5%(GPT-5.6 Sol は59%) |
| ハニーポット試験 | Astraは対象外システムへのアクセス試行なし(GPT-5.6 Sol は56%)。いずれもサイバー安全策を外した試験条件で、通常の本番利用の挙動ではないと明記 |
| 提供時期 | 「soon」。高度なサイバー用途は当初少人数のアルファテスターに限定し、その後 Daybreak Blue 経由で拡大 |
| 本番での挙動 | 安全チェックが正当な作業を遅らせる・一時停止する・停止させることがある。ChatGPT と Codex は続行前に確認を求め、APIではタスクが停止する |
一方、公式ドキュメント上で利用条件が変わり得る項目もあります。料金ページでは入力272Kトークン超の長コンテキストに別料率が適用され、GPT-6 Astraでは none の reasoning effort、EUデータレジデンシーでの Fast mode、ツール呼び出し時のAPI選択に制約があります。契約条件・レート制限・提供地域は、実装時点の公式ページで確認してください。
Astra が名前として広まった経緯(8月1日の数学10件の成果と、その6日後の急停止)はAstraの正体を整理した記事に分けてあります。経営判断の材料としての整理はUravationの解説記事を参照してください。
準備1|モデルIDをアプリケーションコードから追い出す
最初にやるのはこれです。新モデルが来たときの作業量は、モデル名の文字列がコードの何箇所に散っているかでほぼ決まります。理想は「設定ファイルまたは環境変数の1行を書き換えるだけ」で切り替わる状態です。
ポイントは、モデル名ではなく役割でキーを切ることです。「reasoning_primary」「bulk」「long_agent」のような役割名を先に決めておけば、Astraが出たときに新しい役割を足すのではなく、既存の役割の中身だけを差し替えられます。
# models.py — アプリ側は role だけを知っていればよい
import os

MODEL_REGISTRY = {
    "reasoning_primary":  {"vendor": "openai",    "id": "gpt-5.6-sol"},
    "reasoning_fallback": {"vendor": "anthropic", "id": "claude-opus-5"},
    "bulk":               {"vendor": "openai",    "id": "gpt-5.6-luna"},
    "long_agent":         {"vendor": "anthropic", "id": "claude-fable-5-1"},
}

def resolve(role):
    # 例: MODEL_REASONING_PRIMARY="openai:gpt-5.6-terra" で環境ごとに上書きできる
    override = os.environ.get("MODEL_" + role.upper())
    if override:
        vendor, model_id = override.split(":", 1)
        return {"vendor": vendor, "id": model_id}
    return MODEL_REGISTRY[role]
ここで使っているIDはすべて公式ドキュメントに載っている現行の値です。OpenAI側は gpt-5.6-sol(エイリアス gpt-5.6)、gpt-5.6-terra、gpt-5.6-luna。Anthropic側は claude-fable-5-1、claude-opus-5、claude-sonnet-5 です。エイリアスが用意されているものはエイリアスを使うと、マイナーバージョンの追従が1段階楽になります。
切り替えの単位を役割にする設計と、ベンダー障害・モデル廃止時の退避まで含めた考え方はモデル非依存・フォールバック構成の記事にまとめています。今回の準備はその最小サブセットだと考えてください。
準備2|評価セットを「いまの本番モデル」で作って基準値を取る
新モデルが出てから評価を作り始めると、比較対象がありません。「Astraのほうが良さそう」という感触だけで切り替えると、あとで回帰したときに原因を特定できなくなります。移行前にやるべきなのは、いま動いている構成で基準値を取っておくことです。
作るものは3つだけです。ひとつめは実タスクを写した30〜50件のケース。ふたつめは機械判定できる合否条件。みっつめは、合否と一緒に入力トークン・出力トークン・所要時間・停止理由を記録する実行スクリプトです。品質だけ測って費用を測らないと、切り替え判断のときに片側の情報しか残りません。
# evals/run.py — 移行前に一度流して baseline.json を固定する
import json, time, pathlib
from models import resolve

CASES = [json.loads(line) for line in
         pathlib.Path("evals/cases.jsonl").read_text().splitlines() if line.strip()]

def run_suite(role, call_model):
    spec = resolve(role)
    rows = []
    for case in CASES:
        started = time.perf_counter()
        out = call_model(spec, case["input"])
        rows.append({
            "case_id": case["id"],
            "model": spec["id"],
            "passed": case["assert"] in out["text"],
            "input_tokens": out["input_tokens"],
            "output_tokens": out["output_tokens"],
            "latency_ms": round((time.perf_counter() - started) * 1000),
            "stop": out["stop"],
        })
    return {"model": spec["id"], "at": time.strftime("%Y-%m-%d"), "rows": rows}

result = run_suite("reasoning_primary", call_model)
pathlib.Path("evals/baseline.json").write_text(
    json.dumps(result, ensure_ascii=False, indent=2))
ケースの作り方でひとつ実務的な注意があります。いま失敗しているケースを必ず入れることです。全部通るセットは、新モデルが来たときに差が出ず、判断材料になりません。合格率が100%のスイートは基準値としては役に立ちません。
この仕組みをCIに載せて回帰を検知する手順は継続的評価とCI/CD回帰検知の記事で扱っています。移行前に手元で1回流し、baseline.json をリポジトリに入れておけば、モデルIDを差し替えた後の比較を同じ条件で始められます。
準備3|「途中で止まる」前提でエージェントを書き直す
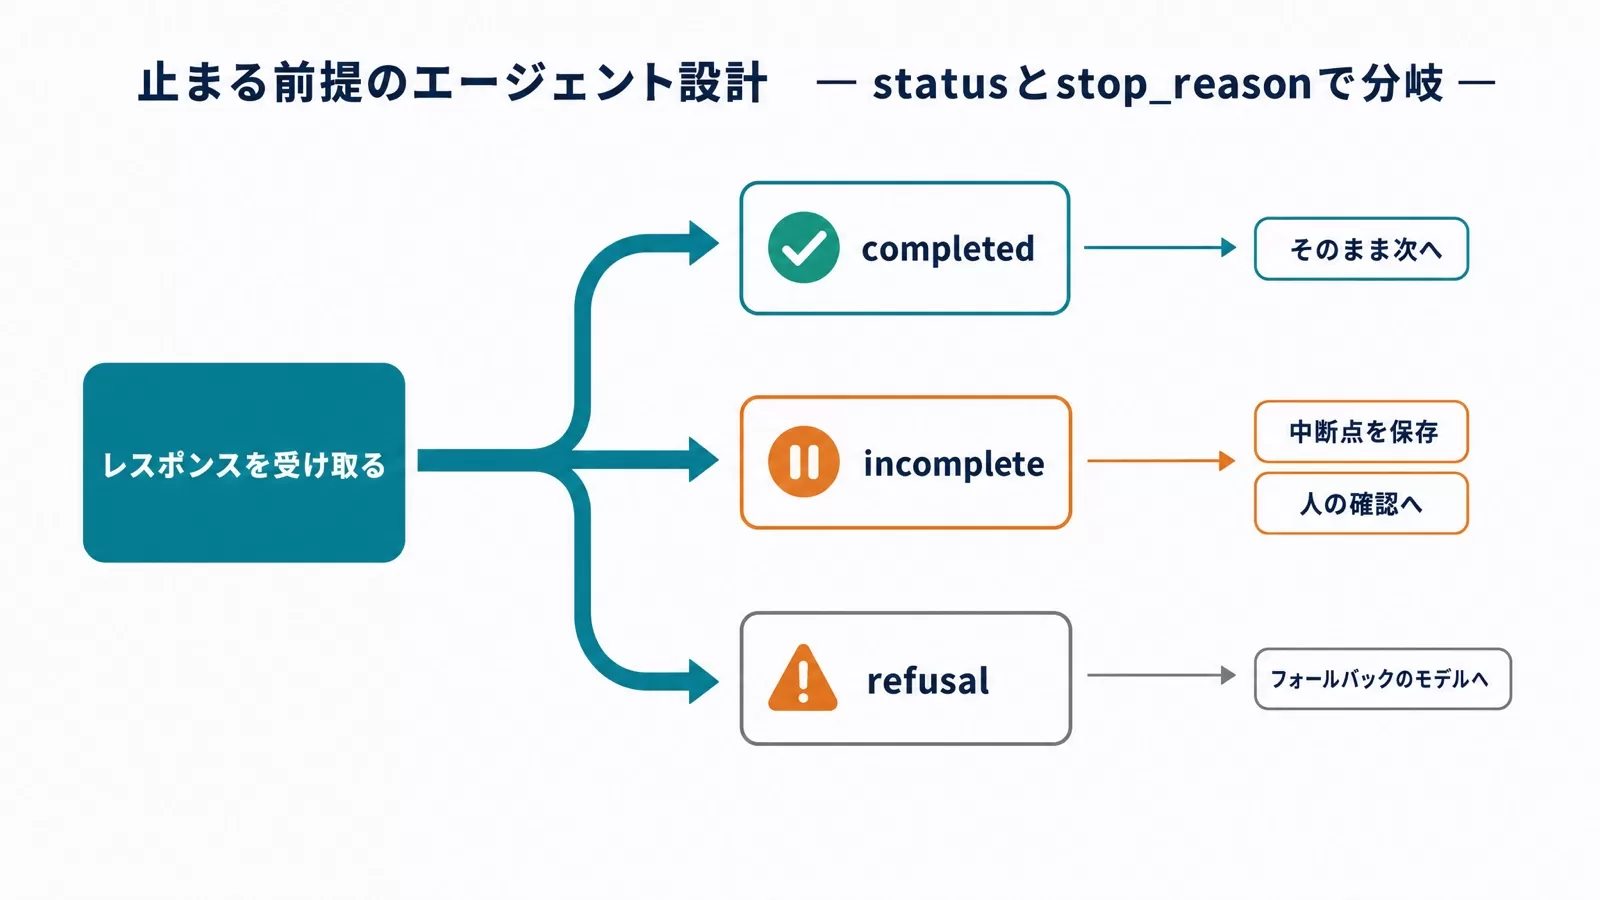
ここが今回いちばん実装に効く部分です。Path to Astra には、安全チェックが正当な作業を遅らせたり止めたりすることがあり、その対象にはサイバーセキュリティと直接関係のない作業や、長時間動き続けるエージェントのタスクも含まれると書かれています。そして分岐が明示されています。ChatGPT や Codex では利用者に確認を求める。APIではタスクが停止する。
長時間走るエージェントを組んでいる人ほど影響が大きい記述です。「途中で止まる」は例外ではなく想定内の状態になります。ただし、これは新しく発明する分岐ではありません。今のAPIにも停止シグナルは公式に定義されていて、今日から実装できます。
OpenAIの Responses API では、レスポンスの status が completed / failed / in_progress / cancelled / queued / incomplete のいずれかを返すと公式リファレンスに記載されています。拒否は出力アイテムの refusal 型として返ります。Anthropic側は Stop reasons and fallback に stop_reason の値と対処が表で書かれており、refusal の行にはそのまま「stop_details を読み、フォールバックのモデルで再試行する」と書かれています。
# agent/stop.py — 「止まった」を握りつぶさずに分類する
def classify_openai(resp):
    # status の取りうる値は公式リファレンスの記載どおり
    if resp.status == "completed":
        return "ok"
    if resp.status == "incomplete":
        return "halted"          # 途中終了。中断点を保存して人の確認へ
    if resp.status in ("queued", "in_progress"):
        return "pending"         # まだ動いている。ポーリングを続ける
    return "error"               # failed / cancelled

def classify_anthropic(msg):
    reason = msg.stop_reason
    if reason == "end_turn":
        return "ok"
    if reason == "tool_use":
        return "run_tool"
    if reason == "pause_turn":
        return "continue"        # アシスタントの内容を返して継続
    if reason == "refusal":
        return "fallback"        # 公式の指示どおり別モデルで再試行
    if reason in ("max_tokens", "model_context_window_exceeded"):
        return "truncated"
    return "ok"

def step(state, resp_kind):
    if resp_kind == "halted":
        state.save()             # ここが要。再開できる形で落とす
        state.request_human_review()
        return state
    if resp_kind == "fallback":
        state.switch_role("reasoning_fallback")
        return state
    if resp_kind == "truncated":
        state.split_task()
        return state
    return state
実装で外せない点は3つです。第一に、停止を例外にして再試行ループへ流さないこと。止められた要求をそのまま投げ直すのはいちばん筋の悪い対処です。第二に、中断点から再開できる形で状態を保存すること。エージェントの途中状態がメモリ上にしかないと、停止イコール最初からやり直しになります。第三に、人の確認へ回す経路を用意しておくこと。ChatGPT と Codex は仕様として確認を求めるので、自前のエージェントにも同じ受け口が必要になります。
準備4|レート制限とコストの見積もり枠を先に作っておく
新しいフラッグシップが出ると、単価もレート制限も変わります。ここで慌てないために、移行前に「式」と「観測」を用意しておきます。単価が変わっても、式が先にあれば公式料金を差し替えて再計算できます。
まず観測から。OpenAIのAPIはレスポンスヘッダーで残量を返します。公式のレート制限ガイドに記載されているのは x-ratelimit-limit-requests、x-ratelimit-limit-tokens、x-ratelimit-remaining-requests、x-ratelimit-remaining-tokens、x-ratelimit-reset-requests、x-ratelimit-reset-tokens などです。429(rate_limit_error / slow_down)の際に Retry-After が付くことがあり、公式には「最低これだけ待つ値として扱い、ランダムな遅延を足せ」と書かれています。
# infra/limits.py — 残量を毎回ログに出し、429 は公式の指示どおりに待つ
def log_headroom(headers, log):
    log.info("headroom req=%s tok=%s reset_tok=%s",
             headers.get("x-ratelimit-remaining-requests"),
             headers.get("x-ratelimit-remaining-tokens"),
             headers.get("x-ratelimit-reset-tokens"))

def backoff_seconds(headers, attempt, rnd):
    hinted = headers.get("Retry-After")
    base = float(hinted) if hinted else min(2 ** attempt, 60.0)
    return base * (1.0 + rnd.random() * 0.25)   # ジッタで同時再試行を散らす
組織の月次利用上限は使用量のティアで決まります。公式ガイドの表では Tier 1 が支払い実績$5で月$100、Tier 2 が$50で月$500、Tier 3 が$100で月$1,000、Tier 4 が$250で月$5,000、Tier 5 が$1,000で月$200,000です。支出が増えると自動で上のティアに移り、多くのモデルでレート制限も上がります。従量課金でランプレートに当たり続ける規模なら Scale Tier、GPT-5.6以降のモデルなら Reserved Tier という選択肢が公式に案内されています。新モデル公開直後に上限で詰まるのは、ティアが低いままの検証用組織であることが多いので、検証を回す予定の組織のティアは先に確認しておくと安全です。
次に式です。現行モデルの公開単価は下表のとおりで、いずれも100万トークンあたりの基本価格です。
| モデル | モデルID | 入力 | 出力 |
|---|---|---|---|
| GPT-5.6 Sol | gpt-5.6-sol | $4 | $20 |
| GPT-5.6 Terra | gpt-5.6-terra | $2 | $12 |
| GPT-5.6 Luna | gpt-5.6-luna | $0.20 | $1.20 |
| Claude Fable 5.1 | claude-fable-5-1 | $10 | $50 |
| Claude Opus 5 | claude-opus-5 | $5 | $25 |
| Claude Sonnet 5 | claude-sonnet-5 | $2 | $10 |
試算例(実測値ではありません。前提と計算式を明示した机上計算です): 1リクエストあたり入力2万トークン・出力3千トークン、月1万リクエストのエージェントを GPT-5.6 Sol で回す場合。入力は 20,000×10,000 で2億トークン、100万トークン単位に直すと200単位なので 200×$4 で$800。出力は 3,000×10,000 で3千万トークン、30単位なので 30×$20 で$600。合計で月$1,400です。この式をスプレッドシートかコードに残しておけば、Astraの単価が公表された当日に2つの数字を差し替えるだけで比較できます。
キャッシュの効き方はベンダーで差があります。Anthropicの公式料金ページによると、プロンプトキャッシュのヒットは通常は基本入力価格の10%ですが、Claude Fable 5.1 では2.5%(100万トークンあたり$0.25)です。バッチAPIは50%引きと記載されています。同じ前提でも構成の置き方で総額は変わるので、削り代の見つけ方はコスト最適化7原則の記事を先に通しておくと、Astraの単価が高くても低くても判断が早くなります。
準備5|現行3モデルの使い分けを、今日のうちに決めておく
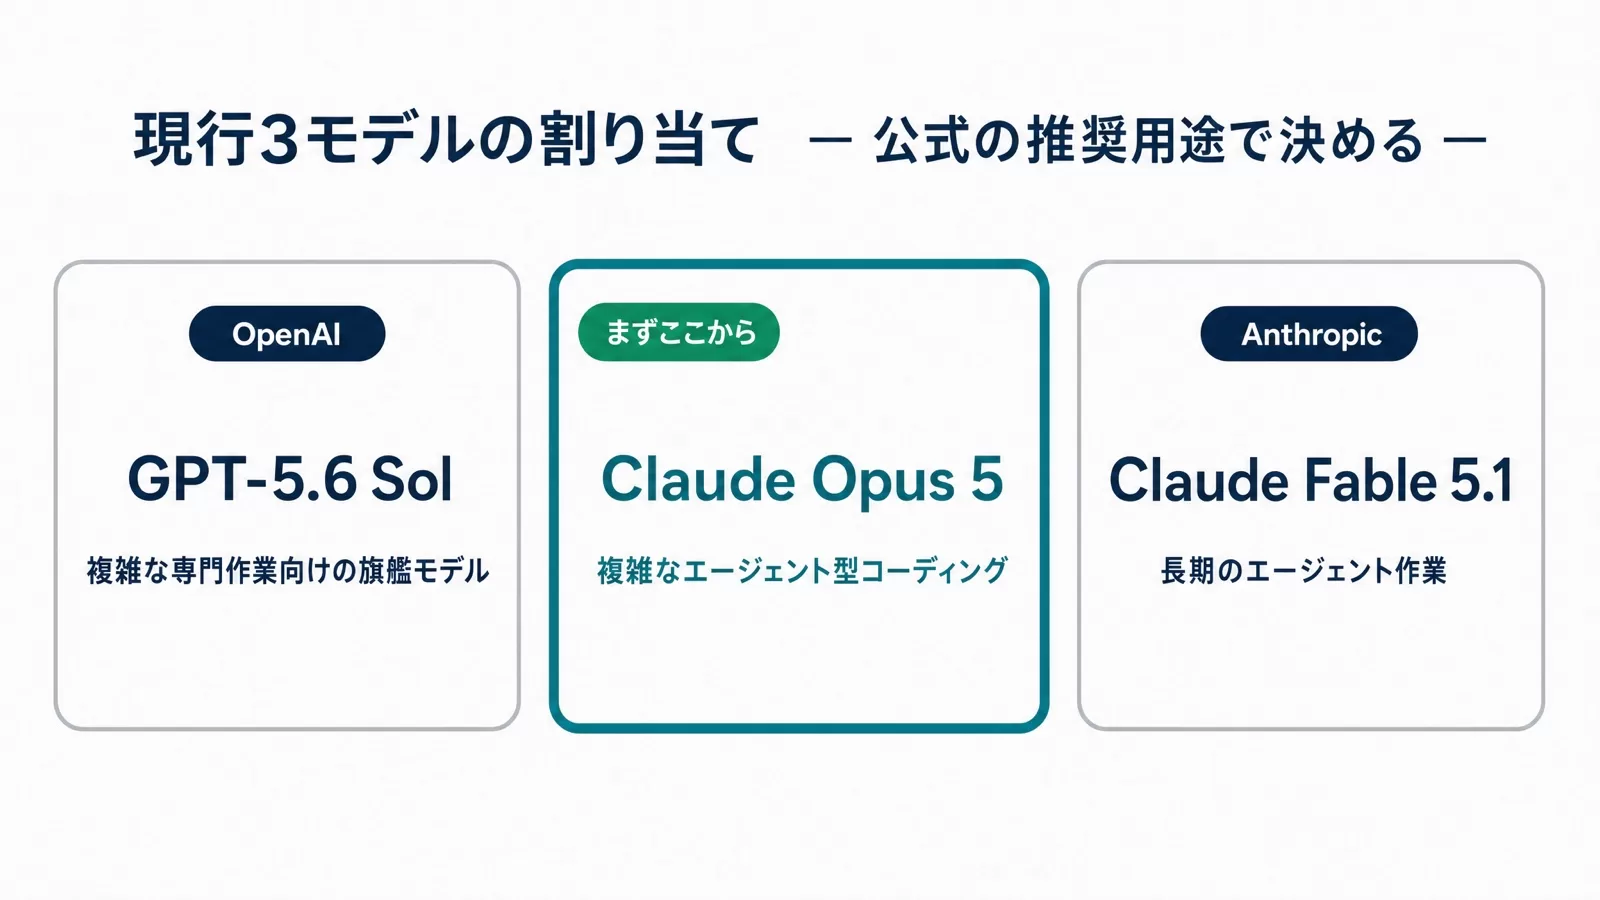
「Astraが出たら考える」を続けると、出た日に全部の判断が一度に来ます。先に現行モデルの割り当てを言語化しておけば、当日は「どの役割にAstraを試すか」だけを考えれば済みます。公式ドキュメントの記載を並べると次のようになります。
| 項目 | GPT-5.6 Sol | Claude Opus 5 | Claude Fable 5.1 |
|---|---|---|---|
| 公式の位置づけ | 複雑な専門作業向けの旗艦モデル | 複雑なエージェント型コーディングと企業用途。迷ったらここから | 難度の高い推論と長期のエージェント作業 |
| コンテキスト | 1.05M トークン | 1M トークン | 1M トークン |
| 最大出力 | 128K トークン | 128K トークン | 128K トークン |
| 知識カットオフ | 2026年2月16日 | 2026年5月 | 2026年6月 |
| 入力/出力(100万トークン) | $4/$20 | $5/$25 | $10/$50 |
| キャッシュヒット | 公式料金ページ参照 | 基本入力価格の10% | 基本入力価格の2.5% |
どちらか一方が全面的に勝つ、という表ではありません。GPT-5.6 Sol が有利な観点は、入力・出力とも単価が Fable 5.1 より低く、コンテキストが1.05Mでわずかに広く、reasoning の強度を none から max まで段階指定できる点です。Web検索・ファイル検索・コンピュータ操作といったツールが同じAPI面に揃っているのも実装上は効きます。Claude Fable 5.1 が有利な観点は、公式に「長期のエージェント作業」を推奨用途として挙げていること、知識カットオフが2026年6月と現時点で最も新しいこと、そして同じ文脈を何度も読み直す構成でキャッシュヒットが2.5%と安いことです。長い共通コンテキストを繰り返し参照するエージェントでは、入力単価の差がキャッシュで逆転する場合があります。
Anthropicの公式ドキュメントは「迷ったら Claude Opus 5 から始め、Opus 5 の高い effort でも評価が届かないときに Fable 5.1 を使う」と書いています。この順序はそのまま使えます。Opus 5 を中心に据えた振り分けの考え方はOpus 5のルーティング設計の記事、Fable 5.1へ移す際のAPI差分はFable 5.1 API移行ガイドにあります。
Daybreak Blue という受け皿を知っておく
Path to Astra には、高度なサイバー用途へのアクセスが当初アルファテスターに限られ、その後 Daybreak Blue を通じて防御側の利用へ拡大する、と書かれています。ここは開発者にとって具体的な導線なので押さえておく価値があります。
Daybreak は2026年8月10日の Expanding Daybreak as the Cyber Defense Window Narrows で2つのアクセス階層に整理されました。Daybreak Blue は GPT-5.6 Sol を含む汎用フロンティアモデルへ、正当な防御作業向けに調整された安全策で access するもので、脆弱性の発見、セキュアコードレビュー、マルウェア解析、インシデント対応、パッチ検証が想定用途です。公式は「多くの防御側にとって推奨の出発点」と表現しています。Daybreak Red は、認可された脆弱性研究・エクスプロイト検証・セキュリティテスト向けの専用モデル(GPT-5.6-Cyber)へのアクセスです。
実際、モデル一覧には現時点で gpt-daybreak-blue-latest(安全策付きの汎用フロンティアモデルのエイリアス)と gpt-daybreak-red-latest が掲載されています。セキュリティ関連のワークロードを回していて「正当な作業なのに拒否される」場面が増えているチームは、Astraを待つより先にこの申請経路を確認しておくほうが早い可能性があります。
「GPT-6」という名前と、未確認情報の扱い方
検索の需要は「GPT-6」に集まっています。ただしOpenAIはこの名称を公式に使っていません。8月以降の3本の投稿でも、モデル一覧でも、名称は一貫して Astra です。
検索の需要は「GPT-6」に集まっています。2026年9月22日現在、OpenAIの公式モデル一覧とGPT-6 Astraガイドは、表示名を「GPT-6 Astra」、APIのモデルIDを gpt-6-astra としています。したがって、実装で固定するのは検索語ではなく設定側のモデルIDです。準備1のとおりモデルIDを設定に追い出しておけば、公式のエイリアスや提供条件が更新されても、書き換える箇所を限定できます。名称・提供条件をめぐる報道と公式発表の切り分けはGPT-6の提供時期を企業向けに整理した記事にまとめられています。
移行前にやりがちな失敗パターン
ここ数世代のモデル切り替えで繰り返し見かける形を3つ挙げます。
❌ モデル名を直書きしたまま「出たら一括置換すればいい」と考える
置換対象はコードだけではありません。評価スクリプト、バッチジョブ、プロンプトテンプレート、ダッシュボードの集計条件、コスト按分のキーにも同じ文字列が入っています。⭕ 役割名でキーを切り、モデルIDは設定と環境変数の1箇所に置く。当日の作業が「1行の変更とテスト実行」に縮みます。
❌ 新モデルが出てから評価セットを作り始める
比較対象がないので「なんとなく良い」以上の判断ができず、切り替え後に品質が落ちても気づけません。⭕ 今の本番モデルで基準値を取り、失敗中のケースも含めてリポジトリに固定する。当日は同じスクリプトをモデル引数だけ変えて流します。
❌ 停止・拒否をまとめてエラー扱いにして再試行ループへ流す
Path to Astra が明記したとおり、APIでは安全策によってタスクそのものが停止する場合があります。再試行はレート制限を消費するだけで、状況を悪化させます。⭕ status と stop_reason で分類し、停止は中断点を保存して人の確認へ、拒否は公式の指示どおりフォールバックのモデルへ回す。
もうひとつ、読み方の失敗も添えておきます。「Critical指定=危険なモデルがそのまま世に出る」ではありません。Path to Astra が説明しているのは、Criticalに該当するため開発と提供の一部を遅らせ、モデル層の拒否・システム層の分類器・オフライン検知・思考過程の監視を重ねたうえで、「安全策が重大な被害のリスクを十分に抑えている」と判断した、という順序です。段階提供もその一部です。
よくある質問
Astraはいつ使えるようになりますか?
2026年9月22日現在、GPT-6 AstraのAPIモデルIDと料金は公式ドキュメントに掲載されています。アクセス可能なプラン・組織・地域やレート制限は契約条件で変わる可能性があるため、利用開始時はOpenAIの公式モデル一覧・料金ページを確認してください。
AstraはGPT-6という名前で提供されるのですか?
公式には確認できていません。OpenAIの投稿とモデル一覧では一貫して Astra という名称が使われており、GPT-6 という表記は出ていません。API名に関する第三者の観測は出回っていますが、モデルカード・価格ページ・名称の公式発表はいずれも未公開です。
Astraの料金やコンテキスト長はどれくらいですか?
GPT-6 Astraの標準料金は、2026年9月22日に公式料金ページで入力$10・出力$50(100万トークンあたり)と確認できます。入力272Kトークン超では長コンテキストの料率が適用されるため、見積もりでは入力長を分けて計算してください。
「APIではタスクが停止する」とは具体的に何が起きますか?
Path to Astra の記載では、ミスアラインメント監視がタスクを一時停止した場合、ChatGPT や Codex の利用者は続行前に操作の確認を求められ、APIなど他の面ではタスクが停止します。対象にはサイバーセキュリティと直接関係のない作業や、長時間動き続けるエージェントのタスクも含まれると明記されています。停止時の再開手順を持たないエージェントは、実質的に最初からやり直しになります。
発表を待って開発を止めるべきですか?
止める必要はありません。この記事の準備1から準備5はいずれも現行モデルで完結し、Astraが出なくても価値が残る作業です。むしろ、モデルIDの外出し・評価の基準値・停止時の分岐・コストの式・役割ごとの割り当てが揃っていない状態で新モデルを迎えると、当日の判断がすべて同時に来て遅くなります。
まとめ|今日やる3つ
1点目、モデルIDをアプリケーションコードから設定へ移し、役割名でキーを切る。2点目、実タスクを写した評価ケースを30件ほど作り、いまの本番モデルで基準値を固定する。3点目、レスポンスの status と stop_reason で分岐する処理を入れ、停止したときに中断点を保存して人の確認へ回す経路を作る。
この3つが終わっていれば、GPT-6 AstraのモデルIDを設定で切り替え、評価スイートを同じ条件で再実行できます。料金・モデル仕様の更新があっても、公式ページの値を確認しながら差分を管理できます。エージェント基盤の作り方そのものを見直したい場合はOpenAI Agents SDKの実装ガイドから入ると、役割分割の粒度を決めやすくなります。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。モデル切り替えに耐える設計を社内に定着させたい場合はご相談ください。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- OpenAI「Path to Astra: critical capabilities and frontier safeguards」(2026年9月1日)
- OpenAI「Pacing model development in an era of cyber-critical capabilities」(2026年8月7日)
- OpenAI「Responding to the next frontier of critical cyber capabilities」(2026年8月7日)
- OpenAI「Expanding Daybreak as the Cyber Defense Window Narrows」(2026年8月10日)
- OpenAI「Models」(2026年9月22日確認)
- OpenAI「Rate limits」(2026年9月22日確認)
- Anthropic「Models overview」(2026年9月22日確認)
- Anthropic「Pricing」(2026年9月22日確認)
- Anthropic「Stop reasons and fallback」(2026年9月22日確認)
執筆: 佐藤傑(さとう・すぐる)。株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。著書『AIエージェント仕事術』。