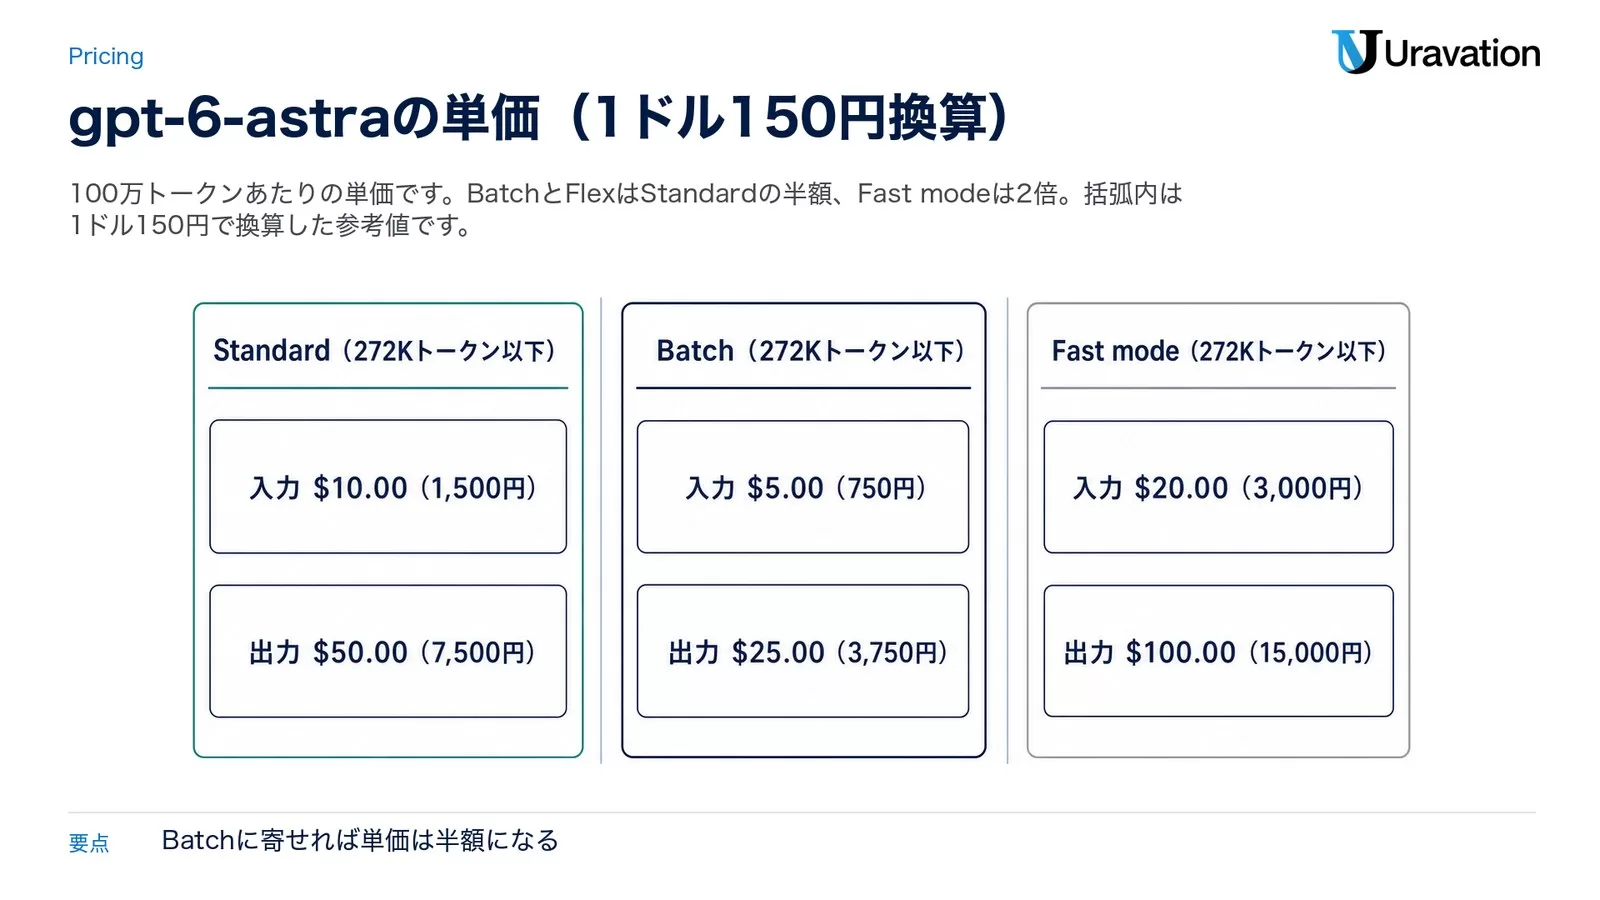
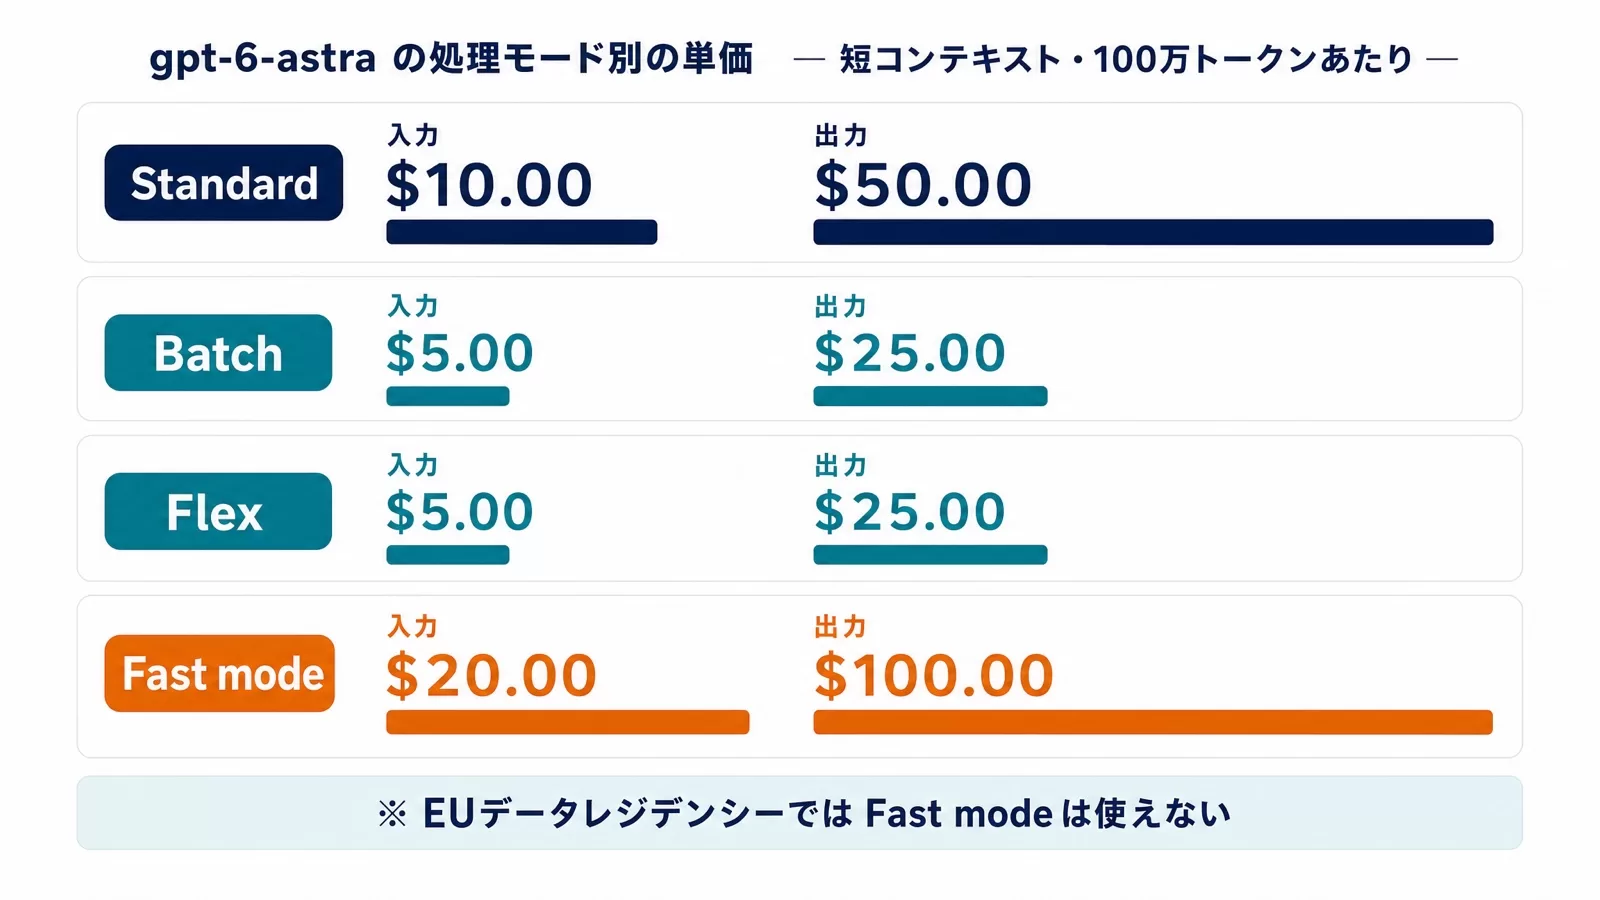
gpt-6-astra の API 料金は、2026年9月24日時点で100万トークンあたり入力$10.00・出力$50.00(1ドル150円換算で1,500円・7,500円)です。キャッシュヒット入力は$1.00(150円)、キャッシュ書き込みは$12.50(1,875円)。入力が272Kトークンを超えたリクエストは、そのリクエスト全体が入力・キャッシュ2倍、出力1.5倍で課金されます。Batch エンドポイントに対応していて単価は半額(入力$5.00・出力$25.00)、Fast mode は2倍です。9月22日には gpt-6-sol(入力$2.00・出力$10.00)と gpt-6-luna(入力$0.10・出力$0.50)が追加され、同じ GPT-6 世代の中に50倍の単価差ができました。この記事は2026年9月24日に取得した OpenAI 公式ドキュメントだけを根拠に、料金・reasoning.effort の制約・移行手順・レート制限を実装目線でまとめたものです。
発表前にやっておく準備の話はAstra(GPT-6)発表前に開発者がやる準備5点に書きました。この記事は「発表されたので、実際にコードをどう直すか」に絞ります。背景(Preparedness FrameworkのCritical指定、安全策の強化)はGPT-6(Astra)発表の速報記事を参照してください。いつから・どのプランで・いくらで使えるかの全体像は、姉妹メディアのGPT-6 Astraとは|いつから使える?提供状況と料金に1ページで整理しています。
【追記 2026年9月23日】GPT-6 のプロンプトキャッシュが強化されました(9/22)
OpenAI は 2026年9月22日(米国時間)に「Better prompt caching for GPT-6」を公開し、GPT-6 系(Astra・Sol・Luna)のプロンプトキャッシュを強化しました。既定のまま命中率が上がるほか、prompt_cache_diagnostics で命中しなかった理由が返り、prompt_cache_breakpoint でキャッシュする接頭辞の終点を指定でき、reasoning effort やツールの有効・無効を変えてもキャッシュが切れません。単価は据え置き(読み取り 0.1 倍・書き込み 1.25 倍)。設定手順・エージェントでの並べ方・費用の試算例は GPT-6のプロンプトキャッシュ強化|費用の下げ方【2026年9月】 へ。
料金早見表:gpt-6-astraの単価と日本円換算(2026年9月24日時点)
まず数字だけ先に置きます。出典はOpenAI公式の料金ページとgpt-6-astraのモデルページ(いずれも2026年9月24日取得)。単価は100万トークンあたりの米ドル建てで、OpenAIは円建ての単価を公表していません。括弧内の円は1ドル150円で換算した参考値です。
| 区分 | 入力 | キャッシュ入力 | キャッシュ書き込み | 出力 |
|---|---|---|---|---|
| Standard(272Kトークン以下) | $10.00 (1,500円) |
$1.00 (150円) |
$12.50 (1,875円) |
$50.00 (7,500円) |
| Standard(272Kトークン超) | $20.00 (3,000円) |
$2.00 (300円) |
$25.00 (3,750円) |
$75.00 (11,250円) |
| Batch(272Kトークン以下) | $5.00 (750円) |
$0.50 (75円) |
$6.25 (約938円) |
$25.00 (3,750円) |
| Flex(272Kトークン以下) | $5.00 (750円) |
$0.50 (75円) |
$6.25 (約938円) |
$25.00 (3,750円) |
| Fast mode(272Kトークン以下) | $20.00 (3,000円) |
$2.00 (300円) |
$25.00 (3,750円) |
$100.00 (15,000円) |
読み方のポイントは4つです。
- 272Kトークンが段差:モデルページの原文は「Prompts with more than 272K input tokens are priced at 2x input and cache rates and 1.5x output for the full request.」です。1トークンでも超えると、そのリクエストは出力分まで割増になります。
- Batch は使える:モデルページの対応エンドポイントは Chat Completions・Responses・Batch の3つです。夜間集計や一括処理を Batch に寄せれば単価は半額になります。
- キャッシュは10分の1:キャッシュヒット入力は通常入力の10分の1($10.00に対して$1.00)。書き込みは1.25倍($12.50)なので、同じ接頭辞を2回以上使い回す設計でないと元が取れません。
- Fast mode に遅延SLAは付かない:Astraの利用ガイドに「Fast mode for GPT-6 Astra does not include a latency SLA.」と明記されています。単価2倍を払っても到達時間の保証はありません。
なお、データレジデンシー対象のリージョナル処理エンドポイントは、2026年3月5日以降にリリースされたモデルについて10%上乗せされます。Astraはこれに該当します。
GPT-6 SolとGPT-6 Luna:9月22日に増えた2モデルの単価
9月4日時点では GPT-6 世代は Astra 1本でしたが、公式のチェンジログによると米国時間2026年9月22日に「Released GPT-6 Sol and GPT-6 Luna.」が入りました。Astra への移行を検討していた処理の一部は、この2つに逃がすほうが安く済みます。
| モデル | 入力 | キャッシュ入力 | 出力 | reasoning effort の none | 対応エンドポイント |
|---|---|---|---|---|---|
| gpt-6-astra | $10.00 (1,500円) |
$1.00 (150円) |
$50.00 (7,500円) |
非対応(HTTP 400) | Chat Completions / Responses / Batch |
| gpt-6-sol | $2.00 (300円) |
$0.20 (30円) |
$10.00 (1,500円) |
対応 | Chat Completions / Responses / Batch |
| gpt-6-luna | $0.10 (15円) |
$0.01 (2円) |
$0.50 (75円) |
対応 | Chat Completions / Responses |
| gpt-5.6-sol(旧世代) | $4.00 (600円) |
$0.40 (60円) |
$20.00 (3,000円) |
対応 | Chat Completions / Responses / Batch |
ここで効いてくるのはgpt-6-sol が gpt-5.6-sol の半額という点です。入力$4.00→$2.00、出力$20.00→$10.00。世代を上げるとむしろ安くなるので、「Astraは高いからSolに据え置く」という判断をしていたなら、据え置き先を旧Solではなく gpt-6-sol にするだけで単価が半分になります。モデルページ記載のナレッジカットオフは gpt-6-sol が2026年4月20日、gpt-6-luna が2026年5月18日、gpt-6-astra が2026年4月30日です。
ただし gpt-6-luna は Batch エンドポイントに対応していません(Chat Completions と Responses のみ)。大量の非同期処理を Luna の単価で回す想定だった場合は、ここで設計が変わります。旧 gpt-5.6-sol に付いていた「プロモーション価格は少なくとも2026年11月21日まで」という注記は9月24日時点も料金ページに残っており、11月以降の値上げ余地は依然あります。
reasoning.effortの値と、料金・遅延への影響
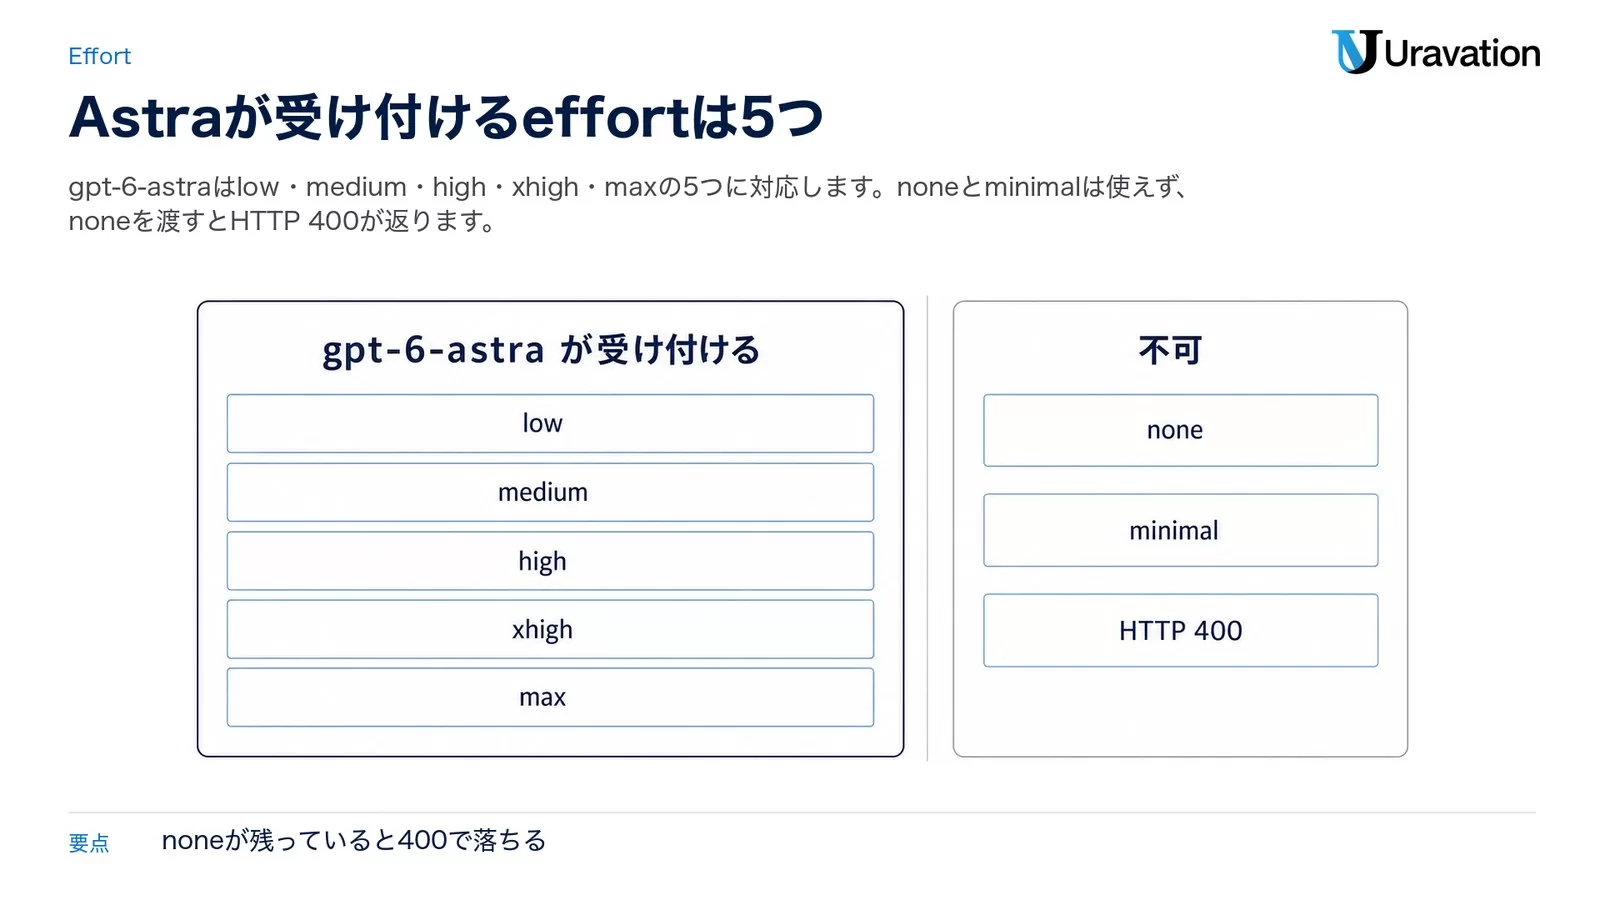
公式のReasoningガイドが定義している reasoning.effort の値は7つです。そのうち gpt-6-astra が受け付けるのは5つで、none と minimal は使えません。
| 値 | gpt-6-astra | gpt-6-sol / gpt-6-luna | 挙動(公式の説明) |
|---|---|---|---|
| none | 不可(HTTP 400) | 対応 | 推論トークンを使わない |
| minimal | 不可 | モデルページの一覧に記載なし | 移行時は low から始めるよう案内 |
| low | 対応 | 対応 | 速度と低トークン消費を優先 |
| medium | 対応 | 対応(既定) | 品質と速度の中間 |
| high | 対応 | 対応 | より完全に考える |
| xhigh | 対応 | 対応 | 同上(さらに上) |
| max | 対応 | 対応 | 最も深く考える |
料金と遅延にどう効くかは、ガイドの1文がすべてです。「Lower effort favors speed and lower token usage, while at higher effort the model thinks more completely to provide higher quality responses.」(努力量が低いほど速度と低トークン消費に有利、高いほどモデルはより完全に考えて品質の高い応答を返す)。
課金上の要点は、推論トークンが出力トークンとして課金されることです。ガイドには推論トークンが「still occupy space in the model’s context window and are billed as output tokens」と書かれています。つまり effort を上げると、見えないトークンが Astra の出力単価$50.00(7,500円)で積み上がります。同じプロンプトでも effort を low から high に変えれば請求額は動きます。倍率がいくつになるかは公式に数値が示されておらず、2026年9月24日時点で公式に記載はありません。自分のワークロードで usage.output_tokens_details.reasoning_tokens を記録して比べてください。
もうひとつ、モデルは「reason adaptively across reasoning efforts, using fewer tokens for simpler tasks and thinking harder for complex tasks」と説明されています。effort は上限の指定に近く、簡単なタスクでは自動的にトークンが減ります。Astra の既定値を名指しした記載は、2026年9月24日時点のモデルページ・Reasoningガイドのいずれにもありません(gpt-5.5・GPT-5.6系・gpt-6-sol・gpt-6-luna は medium 既定と明記されています)。効かせたい値があるなら明示指定してください。
noneを渡したときのHTTP 400を手元で再現する
Reasoningガイドの原文は「Setting reasoning.effort (Responses) or reasoning_effort (Chat Completions) to none returns HTTP 400.」です。移行時にいちばん最初に踏むのがこれなので、切り替え前にステータスコードだけ確認しておくと事故が減ります。
# Astra に none を渡すと HTTP 400 が返る(Responses)
curl -s -o /dev/null -w "%{http_code}\n" https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "none"},
    "input": [{"role": "user", "content": "ping"}]
  }'
# -> 400

# low にすれば通る
curl -s -o /dev/null -w "%{http_code}\n" https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "low"},
    "input": [{"role": "user", "content": "ping"}]
  }'
# -> 200エラーレスポンスの本文(error.message の文字列)は2026年9月24日時点の公式ドキュメントに記載がないため、ここには載せていません。ステータスコードで分岐するリトライ処理を書く場合は、400を「再試行しても直らない設定ミス」として扱い、429(レート制限)と分けてください。
会話の途中でeffortを変えるときはconfiguration_update
リクエストレベルの reasoning.effort を書き換えるとプロンプトの前置きが変わり、プロンプトキャッシュが効かなくなります。GPT-6では configuration_update という入力アイテムで努力量だけ差し替えられます。
{
  "type": "configuration_update",
  "reasoning": {
    "effort": "high"
  }
}制約は4つあります。GPT-6の標準・単一エージェントモードでのみ対応、configuration_update を2つ隣接させると拒否される、自動コンパクションや自動切り詰めとは併用できない、そしてレスポンスの reasoning.effort は更新後の値ではなくリクエストレベルの設定を返し続ける。最後の1点は、ログで実効値を追いたいときに引っかかります。キャッシュ設計そのものの考え方はプロンプトキャッシュ比較2026とプロンプトキャッシュ実装ガイドを参照してください。
確定したスペック:モデルID・コンテキスト・カットオフ
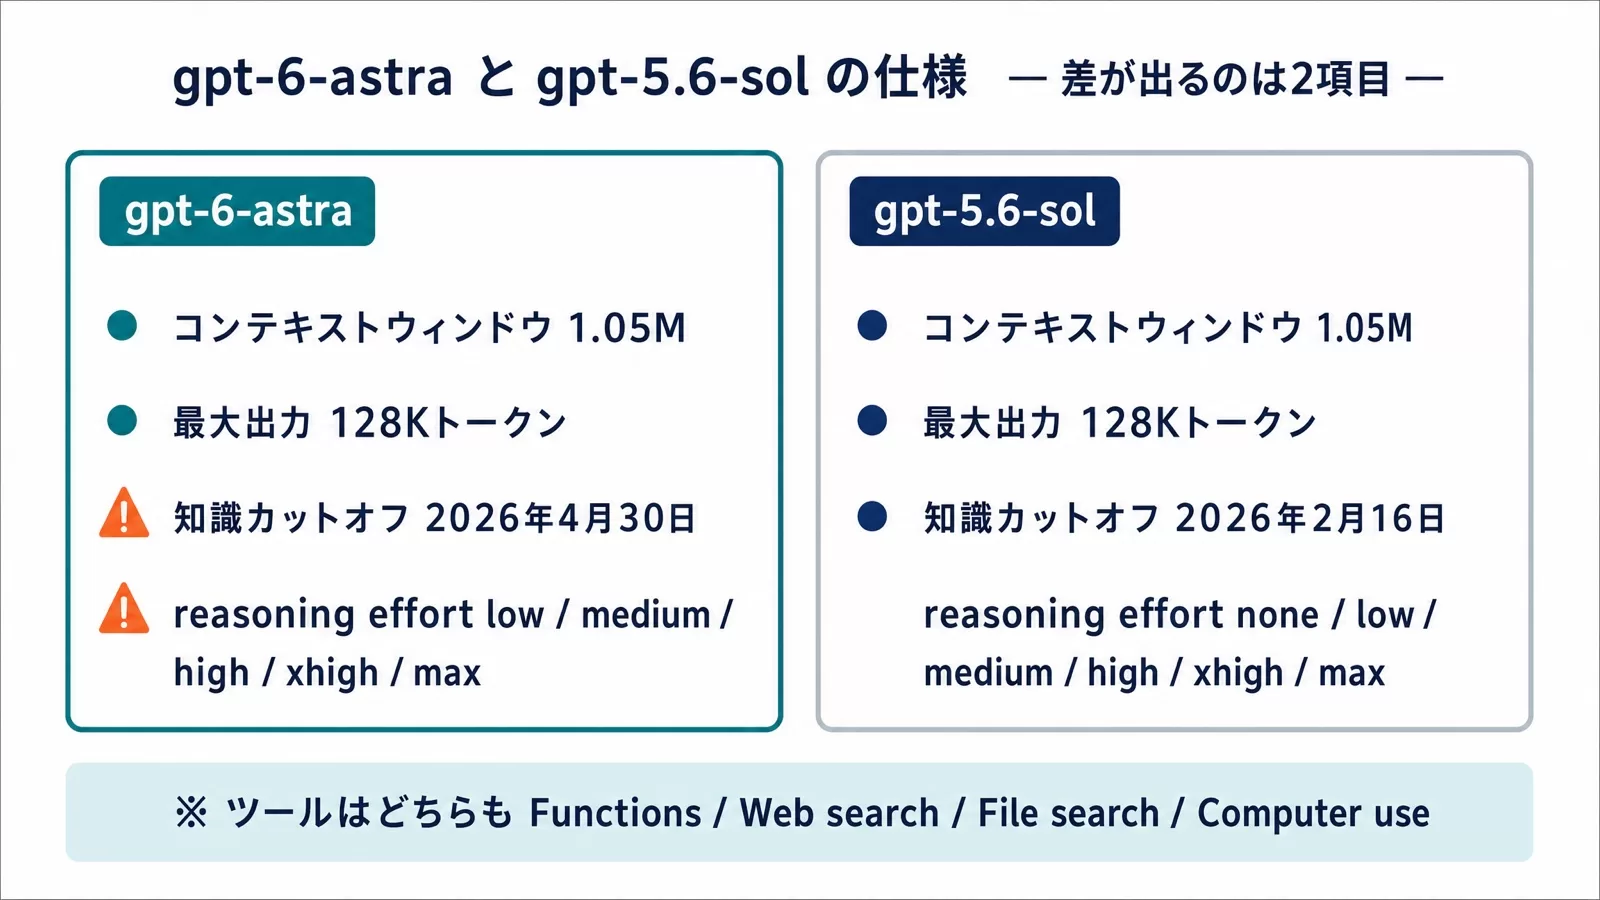
OpenAIのモデル一覧に記載されている gpt-6-astra の仕様は次のとおりです。公式の説明文は「Our most capable model, built for the hardest end-to-end work」で、旗艦モデルの位置づけになっています。
| 項目 | gpt-6-astra | gpt-5.6-sol |
|---|---|---|
| モデルID | gpt-6-astra | gpt-5.6-sol(エイリアス gpt-5.6) |
| コンテキストウィンドウ | 1,050,000トークン | 1,050,000トークン |
| 最大入力 | 922,000トークン | — |
| 最大出力 | 128,000トークン | 128,000トークン |
| 知識カットオフ | 2026年4月30日 | 2026年2月16日 |
| reasoning effort | low / medium / high / xhigh / max | none / low / medium / high / xhigh / max |
| 入出力モダリティ | 入力:テキスト・画像/出力:テキスト | 同左 |
| 対応機能 | streaming、structured_outputs、function_calling、file_search、image_input、web_search、prompt_caching | |
9月24日に取得したモデルページで新しく確認できたのが最大入力922,000トークンです。コンテキストウィンドウ1,050,000トークンとの差は出力と推論トークンの取り分なので、入力側の上限で設計する場合はこちらを見てください。実装で効いてくる差は、知識カットオフが2か月半新しいことと、Astraには none の reasoning effort が存在しないことの2つです。コンテキスト長と最大出力はSolと同じなので、チャンク分割やトークン上限まわりのロジックはそのまま流用できます。
料金:標準は入力$10.00・出力$50.00、長コンテキストは272Kトークン超から
公式の料金ページは、短コンテキストと長コンテキストで別料金の2段構成です。100万トークンあたりの標準(Standard)処理の単価は次のとおりです。
| モデル / 区分 | 入力 | キャッシュ入力 | キャッシュ書き込み | 出力 |
|---|---|---|---|---|
| gpt-6-astra(短コンテキスト) | $10.00 | $1.00 | $12.50 | $50.00 |
| gpt-6-astra(長コンテキスト) | $20.00 | $2.00 | $25.00 | $75.00 |
| gpt-6-sol(短コンテキスト) | $2.00 | $0.20 | $2.50 | $10.00 |
| gpt-6-sol(長コンテキスト) | $4.00 | $0.40 | $5.00 | $15.00 |
| gpt-6-luna(短コンテキスト) | $0.10 | $0.01 | $0.125 | $0.50 |
| gpt-5.6-sol(短コンテキスト) | $4.00 | $0.40 | $5.00 | $20.00 |
| gpt-5.6-terra(短コンテキスト) | $2.00 | $0.20 | $2.50 | $12.00 |
| gpt-5.6-luna(短コンテキスト) | $0.20 | $0.02 | $0.25 | $1.20 |
長コンテキスト料金が適用される条件は、モデルページに明記されています。入力トークンが272Kを超えるプロンプトは、リクエスト全体が入力・キャッシュ料率2倍、出力1.5倍で課金されるという仕様です。つまり272Kを1トークンでも超えた瞬間、そのリクエストの出力分まで割増になります。長い履歴を無圧縮で持ち回す設計では、コンパクションや履歴の切り詰めを入れるかどうかが、そのまま請求額の段差になります。この段差の実額は後述の試算例2で出します。
キャッシュ書き込みは、キャッシュされていない入力単価の1.25倍で課金されます(Astraなら短コンテキストで$12.50)。キャッシュヒットは$1.00なので、同じプレフィクスを何度も使い回す設計ほど効きます。
なお gpt-5.6-sol の料金には「プロモーション価格は少なくとも2026年11月21日まで」という注記が付いています。Sol据え置きで運用する前提のコスト計画は、11月以降の値上げ余地を織り込んでおく必要があります。gpt-6-sol の料金にはこの注記が付いていません(2026年9月24日時点)。
もうひとつの注意点として、2026年3月5日以降にリリースされたモデルのうちデータレジデンシー対象のものは、リージョナル処理エンドポイントで10%上乗せされます。入出力のモダリティはテキストが入力・出力、画像は入力のみで、音声と動画は非対応です。なお gpt-6-astra-pro という名前のモデルは、2026年9月24日時点の料金表・モデル一覧のどちらにも掲載がありません(ChatGPT側の「GPT-6 Astra Pro」とAPIのモデルIDは別物として扱ってください)。
Batch・Flex・Fast modeの実額:半額と2倍
処理モードを変えると単価がそのまま動きます。gpt-6-astra の100万トークンあたりの単価は次のようになります(2026年9月24日時点の料金ページ)。
| 処理モード | 入力(短) | キャッシュ入力(短) | 出力(短) | 入力(長) | 出力(長) |
|---|---|---|---|---|---|
| Standard | $10.00 | $1.00 | $50.00 | $20.00 | $75.00 |
| Batch | $5.00 | $0.50 | $25.00 | $10.00 | $37.50 |
| Flex | $5.00 | $0.50 | $25.00 | $10.00 | $37.50 |
| Fast mode | $20.00 | $2.00 | $100.00 | $40.00 | $150.00 |
BatchとFlexは標準の半額、Fast modeは2倍です。キャッシュ入力も同じ倍率で動くので、Batchでキャッシュを効かせると$0.50(75円)まで下がります。Fast modeは発表記事で「標準処理の最大2倍の速度」と説明されていますが、Astraの利用ガイドにはAstraのfast modeにレイテンシSLAは付かないと書かれています。加えて、利用ガイドの原文は「For GPT-6 Astra, Sol, and Luna, EU data residency is available only with Standard processing.」で、EUデータレジデンシーではAstraだけでなくSol・Lunaも標準処理しか選べません。2026年7月30日にPriority processingがFast modeへ改称され、service_tier は "priority" と "fast" のどちらでも受け付けます。
夜間バッチや非同期の集計処理をAstraへ寄せるなら、まずBatchで組むほうが素直です。Batch APIでのコスト圧縮の考え方はBatch APIでAIコストを半減する方法|主要3社を比較にまとめています。
1リクエストの費用試算3例:前提と計算式を明示
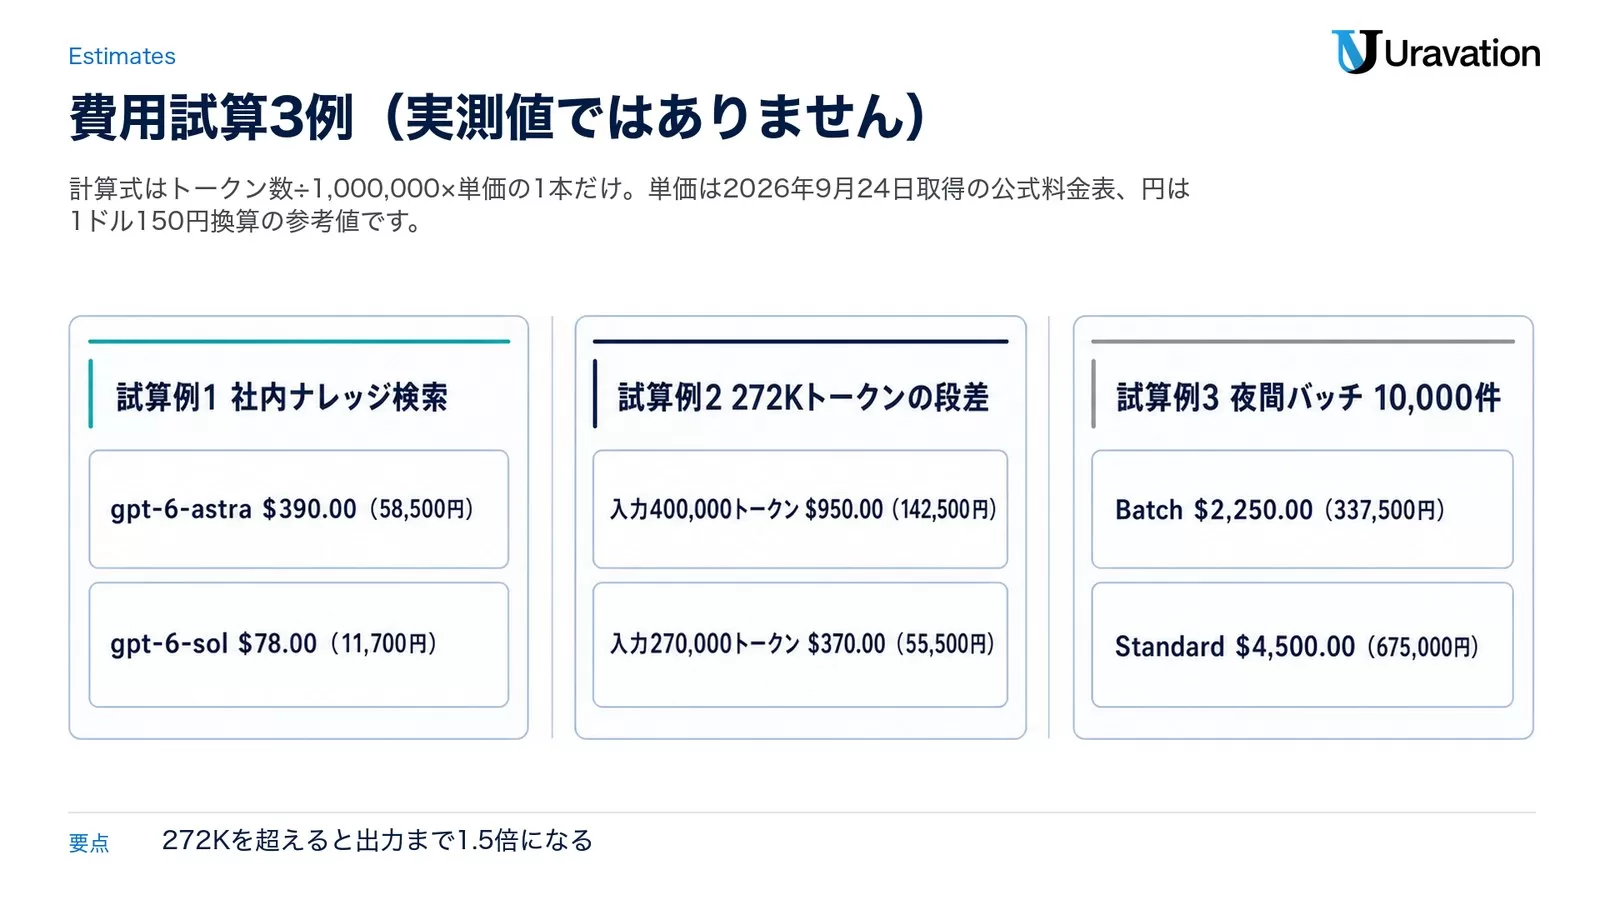
以下はすべて試算例(実測値ではありません)です。計算式は「トークン数 ÷ 1,000,000 × 単価」の1本だけで、単価は前掲の公式料金表(2026年9月24日取得)の値を使っています。円は1ドル150円換算の参考値です。ワークロードによってトークン量は変わるので、そのまま自社の見積もりにしないでください。
試算例1:社内ナレッジ検索(短コンテキスト・キャッシュあり)
前提:1リクエストあたり入力50,000トークン(うち40,000トークンがキャッシュヒット)、出力5,000トークン、Standard処理・272Kトークン以下、1日1,000リクエスト。キャッシュ書き込み分は含めません。
| 内訳 | gpt-6-astra | gpt-6-sol | gpt-5.6-sol | gpt-6-luna |
|---|---|---|---|---|
| 非キャッシュ入力 10,000トークン | $0.100 | $0.020 | $0.040 | $0.001 |
| キャッシュ入力 40,000トークン | $0.040 | $0.008 | $0.016 | $0.0004 |
| 出力 5,000トークン | $0.250 | $0.050 | $0.100 | $0.0025 |
| 1リクエスト合計 | $0.390 | $0.078 | $0.156 | $0.0039 |
| 1日1,000リクエスト | $390.00 (58,500円) |
$78.00 (11,700円) |
$156.00 (23,400円) |
$3.90 (585円) |
同じトークン量ならAstraは旧 gpt-5.6-sol の2.5倍、gpt-6-sol の5倍です。逆に言うと、旧Solから gpt-6-sol に上げるだけで同条件の請求は半額になります。
試算例2:272Kトークンの段差はいくらか(長コンテキスト)
前提:大きなリポジトリやログを丸ごと読ませる想定。入力400,000トークン(キャッシュなし)、出力20,000トークン、Standard処理、1日100リクエスト。入力が272Kトークンを超えるので、入力は2倍、出力は1.5倍の単価が適用されます。
| 内訳 | 入力400,000トークン(272K超) | 入力270,000トークンに削った場合 |
|---|---|---|
| 適用単価 | 入力$20.00 / 出力$75.00 | 入力$10.00 / 出力$50.00 |
| 入力 | $8.000 | $2.700 |
| 出力 20,000トークン | $1.500 | $1.000 |
| 1リクエスト合計 | $9.500 | $3.700 |
| 1日100リクエスト | $950.00(142,500円) | $370.00(55,500円) |
入力を130,000トークン削って272Kトークン以下に収めるだけで、この前提では1日あたり$580.00(87,000円)の差になります。入力の3割強を削ったのに費用は6割減るのは、出力側まで1.5倍が乗っているからです。長い履歴を持ち回すエージェントでは、コンパクションの有無がそのまま請求の段差になります。
試算例3:夜間バッチをBatchに寄せる
前提:1件あたり入力30,000トークン(キャッシュなし)、出力3,000トークン、272Kトークン以下、1晩で10,000件を処理。
| 処理モード | 入力の費用 | 出力の費用 | 1件合計 | 10,000件 |
|---|---|---|---|---|
| Batch | $0.150 | $0.075 | $0.225 | $2,250.00(337,500円) |
| Standard | $0.300 | $0.150 | $0.450 | $4,500.00(675,000円) |
| Fast mode | $0.600 | $0.300 | $0.900 | $9,000.00(135万円) |
期限が翌朝でよい処理をFast modeで流していると、Batchの4倍を払うことになります。ただしOpenAIはAstraの利用ガイドで「Astra achieves stronger results while using substantially fewer output tokens—delivering a lower estimated API cost per task than earlier models despite its higher per-token pricing.」と説明しています。つまり実際の請求額は、出力トークンがどれだけ減るかで変わります。移行判断は単価表ではなく、自分の評価セットを両モデルで流したときの1タスクあたりの総トークン数で行ってください。トークンの可視化と削減の考え方はAIエージェントのコスト最適化7原則が使えます。
gpt-5.6-solからの移行手順:破壊的変更とコード例
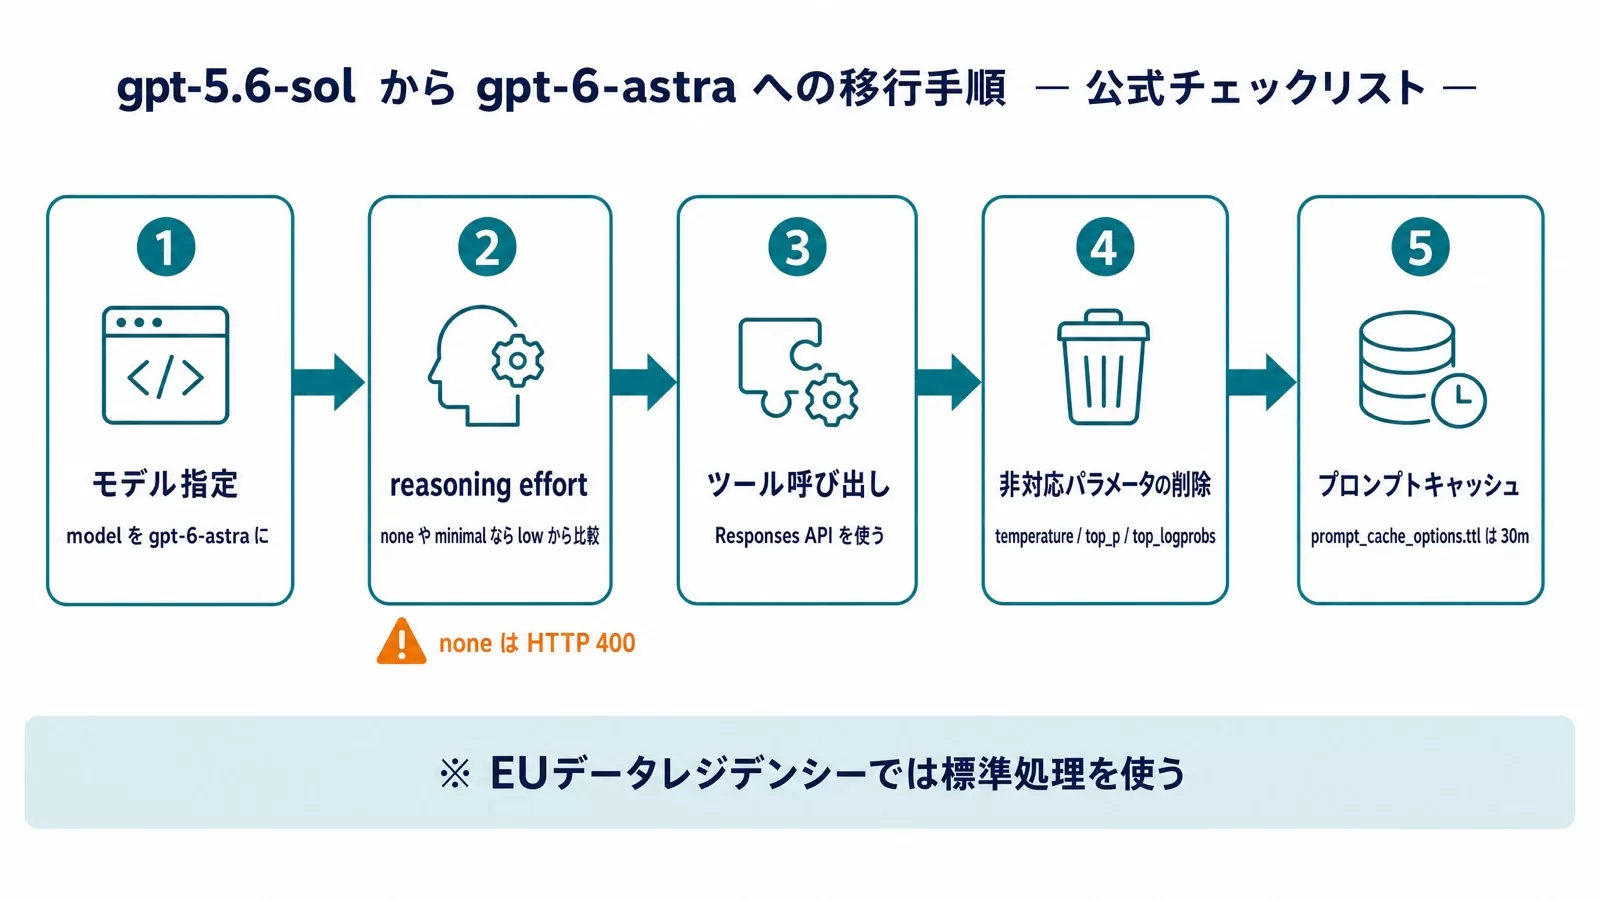
Astraの利用ガイドには「Update API and model parameters」という移行チェックリストがあります。9月24日時点では gpt-6-sol と gpt-6-luna も同じチェックリストの対象になっています。まず、そのまま流用すると落ちる破壊的変更だけを先に並べます。
| 変更点 | 旧(gpt-5.6-sol) | 新(gpt-6-astra) | 放置したときの症状 |
|---|---|---|---|
| reasoning effort の none | 使える | 使えない | HTTP 400 |
| ツール呼び出しのエンドポイント | Chat Completions で可 | Responses が必要 | ツールが呼ばれない |
| temperature / top_p / top_logprobs | 指定できる | 非対応(effortがnone以外のとき) | パラメータエラー |
| Chat Completions の logprobs | 指定できる | 非対応 | パラメータエラー |
| Responses の include | message.output_text.logprobs を指定できる | 外す | パラメータエラー |
| キャッシュ保持の指定 | prompt_cache_retention | prompt_cache_options.ttl(”30m”) | 保持指定が効かない |
| EUデータレジデンシー | — | Standard処理のみ | Fast mode が使えない |
手順としては次の順で潰すのが安全です。
- 非対応パラメータを先に削る:
temperature、top_p、top_logprobs(Chat Completionsはlogprobsも、Responsesはincludeからmessage.output_text.logprobsを)。モデルIDを変える前にやると、切り分けが楽になります。 - ツール経路をResponses APIへ寄せる:公式は「Use the Responses API」「GPT-6 Astra supports Chat Completions, but its tool calling requires Responses」と書いています。テキスト生成だけならChat Completionsのままで動きます。Responses APIの実装そのものはOpenAI Responses API実装ガイドにまとめています。
- reasoning effort を決める:「Preserve your current effective reasoning effort where supported」が原則。
noneかminimalを使っていたならlowから始めて結果を比較します。 - キャッシュ設定を置換する:
prompt_cache_retentionをprompt_cache_options.ttl("30m")へ。 - モデルIDを差し替える:
gpt-6-astra/gpt-6-sol/gpt-6-lunaのどれかに。 - EUデータレジデンシー構成を確認する:
service_tierに"fast"/"priority"を指定していたら標準処理へ戻します。
移行前後のコードを並べると差分はこれだけです。まず旧実装。
# 旧: gpt-5.6-sol / Chat Completions
from openai import OpenAI

client = OpenAI()

response = client.chat.completions.create(
    model="gpt-5.6-sol",
    reasoning_effort="none",   # Astra では 400
    temperature=0.2,            # Astra では非対応
    top_p=0.9,                  # Astra では非対応
    messages=[{"role": "user", "content": prompt}],
    tools=tools,
)

print(response.choices[0].message.content)
移行後はResponses APIに寄せ、非対応パラメータを落とします。
# 新: gpt-6-astra / Responses
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "low"},          # none は不可。low から始める
    prompt_cache_options={"ttl": "30m"},  # 旧 prompt_cache_retention の置き換え
    input=[{"role": "user", "content": prompt}],
    tools=tools,                           # ツール呼び出しは Responses が必要
)

print(response.output_text)
print(response.usage.output_tokens_details.reasoning_tokens)  # 推論トークンを記録する
curlでも同じです。
curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "low"},
    "prompt_cache_options": {"ttl": "30m"},
    "input": [{"role": "user", "content": "..."}]
}'モデルIDをコードに直書きしていると、この差し替えが全ファイル横断の作業になります。設定値として外に出しておく設計はモデル非依存・フォールバック構成で書いたとおりです。破壊的変更の直し方という意味では、Claude Fable 5.1 API移行ガイド|破壊的変更3点の直し方と同じ手順が使えます。
レート制限・ティア・データの扱い
単価より先に詰まるのがレート制限です。gpt-6-astra のモデルページに載っている標準処理のレート制限は次のとおりです(2026年9月24日取得)。
| ティア | RPM(1分あたりリクエスト) | TPM(1分あたりトークン) | Batchキュー上限 |
|---|---|---|---|
| Tier 1 | 500 | 500,000 | 1,500,000 |
| Tier 2 | 5,000 | 1,000,000 | 3,000,000 |
| Tier 3 | 5,000 | 2,000,000 | 100,000,000 |
| Tier 4 | 10,000 | 4,000,000 | 200,000,000 |
| Tier 5 | 15,000 | 40,000,000 | 15,000,000,000 |
注意点が2つあります。Freeティアの行は gpt-6-astra のレート制限表に掲載されていません。そしてTier 4からTier 5でTPMが4,000,000から40,000,000へ10倍、Batchキュー上限が200,000,000から15,000,000,000へ75倍に跳ねます。Tier 5に上がるかどうかで、Batchに流せる量の設計が変わります。
ティアの昇格条件はレート制限ガイドに記載されています。
| ティア | 昇格条件(累計支払額) | 月あたりの利用上限 |
|---|---|---|
| Free | 対象地域であること | $100 / 月 |
| Tier 1 | $5 支払い | $100 / 月 |
| Tier 2 | $50 支払い | $500 / 月 |
| Tier 3 | $100 支払い | $1,000 / 月 |
| Tier 4 | $250 支払い | $5,000 / 月 |
| Tier 5 | $1,000 支払い | $200,000 / 月 |
制限の計測単位はRPM・RPD・TPM・TPD・IPMの5種類で、超えると429が返ります。公式の指示は「Follow Retry-After when it’s present, reduce your request rate, and then increase it gradually.」です。Retry-After があるときはその値に従い、無い場合だけ指数バックオフにしてください。前述のとおり reasoning.effort を上げると推論トークンが出力として積まれるので、effortを上げるとTPMの消費も増えます。単価だけでなくレート制限の側でも効いてきます。
データの扱い:学習利用・保持期間・データレジデンシー
社内で稟議を通すときに必ず聞かれるところを公式のデータ管理ページから整理します。
- 学習利用:「As of March 1, 2023, data sent to the OpenAI API is not used to train or improve OpenAI models (unless you explicitly opt in to share data with us).」APIに送ったデータは、明示的にオプトインしない限り学習に使われません。
- 保持期間:不正利用監視のログは最長30日(法令でより長い保持が必要な場合を除く)。
- Zero Data Retention:対象顧客は監視ログからの除外を申請できます。有効にすると
/v1/responsesと/v1/chat/completionsのstoreパラメータが常にfalseとして扱われます。適用は事前承認制です。 - データレジデンシー:米国・欧州(EEAとスイス)・オーストラリア・カナダ・日本・インド・シンガポール・韓国・英国・UAEに対応。米国以外は監視コントロールの承認とModified Retention amendmentの締結が必要です。前述のとおりリージョナル処理は10%上乗せで、AstraのEUデータレジデンシーは標準処理のみです。
- プロンプトキャッシュ:暗号化されたキー・バリューテンソルはGPUマシン上に置かれ、24時間の期限後は保持されません。
- Batch:バッチ自体は削除するまで保持され、監視ログは既定30日です。
Astraだけの新機能:非同期ツール呼び出しと途中での努力量変更
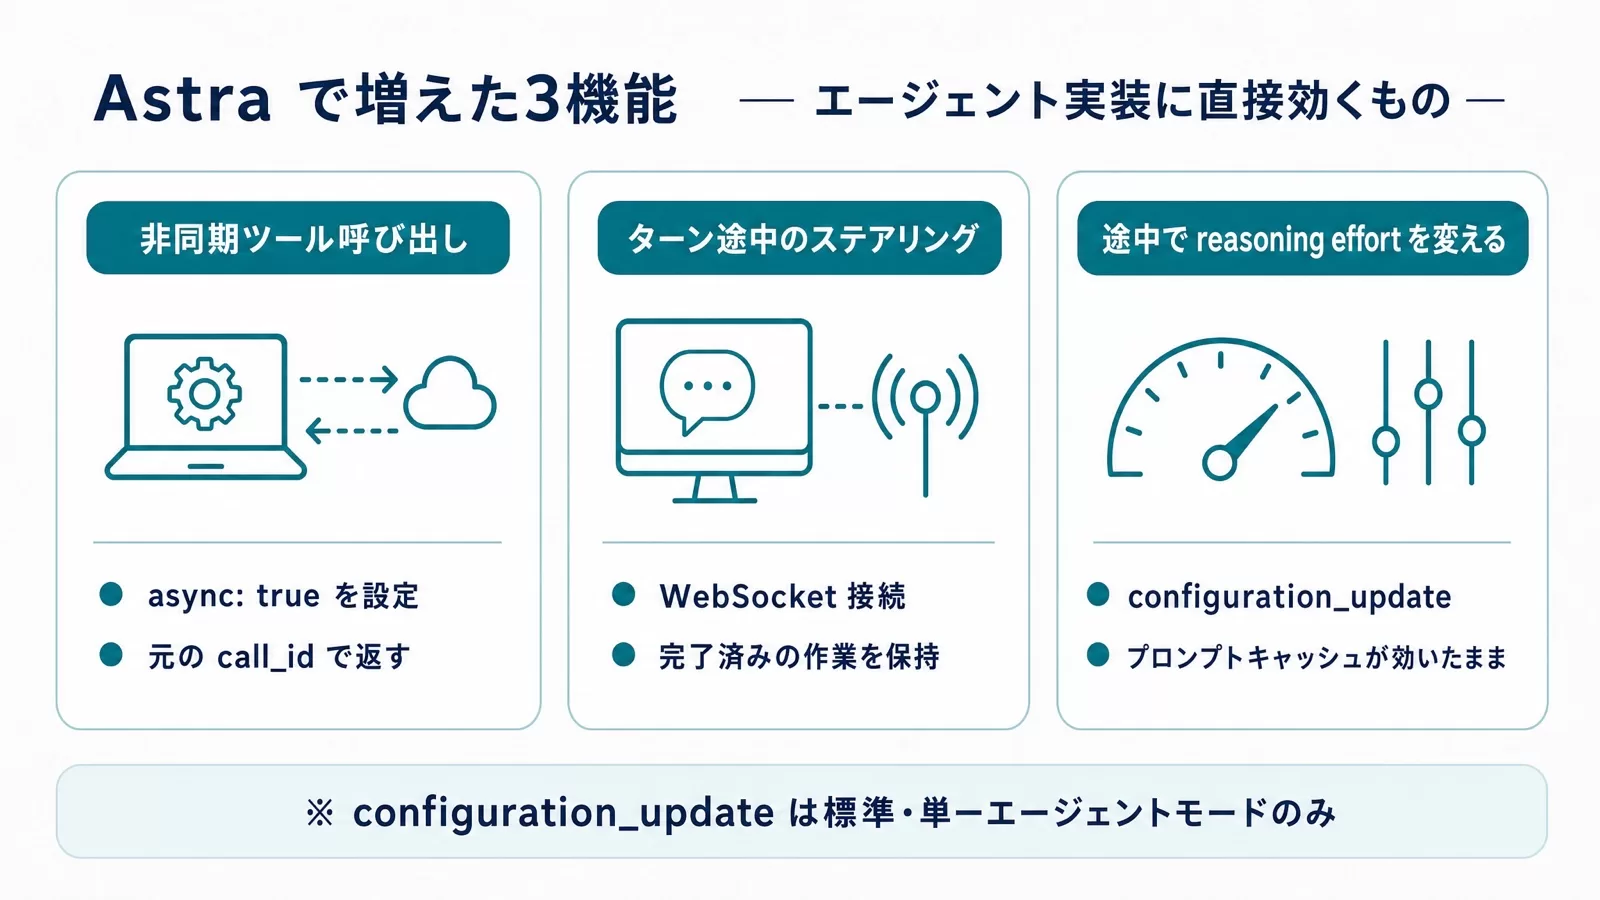
Astraで新しく使えるようになった機能のうち、エージェント実装に直接効くのは3つです。公式チェンジログでは米国時間9月3日に「Async tool calling: Let the model continue working while your application runs function or custom tools.」として追加が記録されています。
非同期ツール呼び出し(Async tool calling)。関数ツールやカスタムツールに async: true を設定すると、アプリケーション側がツールを実行している間もモデルは推論を続けたり、別のツールを呼んだり、リクエストのうち独立した部分に答えたりできます。結果は元の call_id で返します。ツールの実行と待ち状態の管理はアプリケーション側の責任のままです。
ターン途中のステアリング(Mid-turn steering)。WebSocket接続では、Astraが作業している最中に修正や要件変更を送っても、Responses APIが完了済みの作業を保持したまま更新を継続分に含めます。
会話の途中でreasoning effortを変える。configuration_update という入力アイテムを差し込むと、リクエストレベルの reasoning.effort を書き換えずに努力量だけ変更できます。プロンプトの前置きが変わらないので、プロンプトキャッシュが効いたままになるのが利点です。制約は前掲のとおりです。
あわせて、チェンジログには米国時間9月8日に「Prompt Cache Diagnostics」がResponses APIで一般提供になったことも記録されています。キャッシュが効かない理由を返してくれるので、移行直後の費用が想定より高いときはまずここを見ます。
1.05Mコンテキストで何が変わるか
コンテキスト長の数字自体はSolと同じ1,050,000トークンですが、長い文脈での精度は公式ベンチマークで差が付いています。発表記事の表では、OpenAI MRCR v2の8-needle 512K〜1Mでスコア96.3%(Solは73.8%)、256K〜512Kでは100.0%(同91.5%)です。
| 評価 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| OpenAI MRCR v2 8-needle 512K-1M | 96.3% | 73.8% |
| OSWorld 2.0(オフラインセット、部分点) | 72.6% | 65.7% |
| Terminal-Bench 4.0 | 57.9% | 37.3% |
| FrontierMath Tier 4(v2) | 97.6% | 83.0% |
| 社内ハルシネーション評価(低いほど良い) | 4.2% | 12.2% |
スコアはいずれも「任意の努力量での最大値」で、研究環境またはAPI経由の測定値だと注記されています。Codexを使っている場合は、Astraに合わせてハーネス側も更新され、コンテキストウィンドウが埋まったときに要約で潰さず「メモ」として持ち越し、以前のコンテキストを検索できる仕組みが入りました。config.toml で有効にできる実験的機能で、数週間のうちにAstraでの既定になると説明されています。長い履歴を圧縮せずに持ち回す設計、あるいは大きなリポジトリを丸ごと読ませる設計は、Astraのほうが素直に組めます。ただし前掲の試算例2のとおり、272Kトークンを超えた瞬間に課金が段差で上がる点は別で考えてください。レイテンシ面では、OSWorld 2.0のシミュレーションで1タスクあたりの所要時間がSolより約47%短い(約40分に対して約75分)と説明されています。
挙動が変わる4点:プロンプト側の調整が必要
Astraの利用ガイドは、モデルの振る舞いについて4つの注意点を挙げています。単価やパラメータより、こちらのほうが移行時の体感差になります。
- 主体性と完遂:結果が大きく変わりうる場面では、以前のモデルが仮定で進めたところでも質問してくることがある。自律的に進めてほしい場合はプロンプトで明示する。
- 指示追従:長い指示に強くなった一方で、文脈中の情報に敏感になった。スキルファイルや
AGENTS.mdに曖昧な記述や矛盾があると、作業を早めに止めることがある。公式はユーザー指示の優先順位を明示することを勧めている。 - 文体:リスト・表・Markdownを多用する傾向がある。散文で出したいアプリケーションは書式を明示する。
- サブエージェント委譲とテスト:委譲は想定より少なめ、コーディングでは検証が手厚めになる。小さな変更に対しても検証が丁寧なので、期待値を合わせておく。
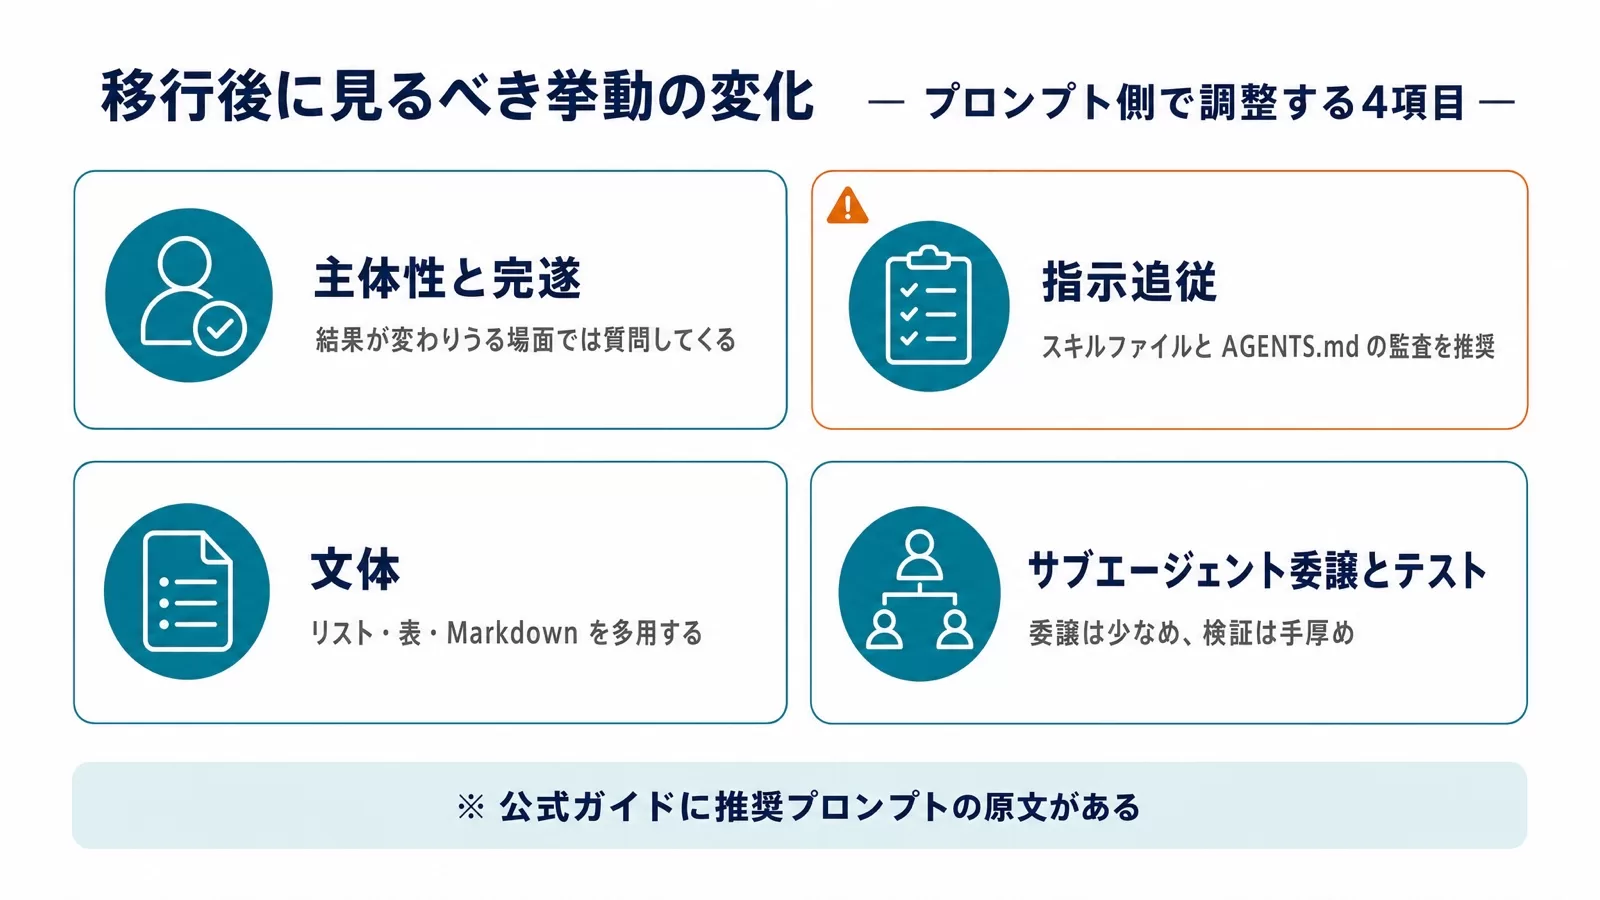
公式ガイドには各項目に対する推奨プロンプトの原文が載っています。移行時はまずそれをそのまま入れて挙動を見るのが早いです。Codexを使っているなら、OpenAI Docsスキルを入れて $openai-docs migrate this project to GPT-6 Astra と指示すると、ガイド記載の変更を適用させることもできます。
安全側の変更:APIではタスクが止まる
安全性概要によると、Astraは「これまでに広く展開した中で最も高性能なモデル」で、Preparedness Frameworkのサイバーセキュリティ能力でCritical水準に達した最初のモデルです。実装側に効くのは、外部提供におけるツール利用推論のすべてにミスアライメント監視が入った点です。
この監視は分類器がモデルの推論と行動を検査し、認可されていない挙動を自動で止めます。発表記事には、ChatGPTやCodexでタスクが一時停止した場合は続行前に確認を求められることがあるが、APIではタスクが停止すると書かれています。長時間動くエージェントを組んでいるなら、停止したレスポンスを受けたときに途中状態を保存して人の確認に回す経路を先に用意しておくべきです。
アライメント評価では、54,000件を超える社内Codexタスクを使ったシミュレーションで、高深刻度のミスアライメント挙動のフラグ数がSolの約半分だったと報告されています。一方で、監視のしやすさ(monitorability)はSolより低下したとも明記されています。Astraの安全性をめぐる経緯はOpenAI Astraの正体|数学10問証明と6日後の急停止にまとめています。
提供状況:2026年9月24日時点でどこまで公式に言えるか
公開直後(9月4日時点)は、Trusted Access Programの企業向けロールアウト中で、APIおよび各プランでの提供は「今後数日のうちに(in the coming days)」という記載でした。2026年9月24日に確認した時点では、その制限表示は残っていません。
- モデル一覧・
gpt-6-astraのモデルページのいずれにも、preview・limited access・trusted access・ロールアウト中といったバナーや注記はありません。 - 料金ページに
gpt-6-astraのStandard・Batch・Flex・Fast modeの単価が掲載されています。 - モデルページにTier 1からTier 5までのレート制限が掲載されています。
- 公式チェンジログの米国時間9月3日の項目は「GPT-6 Astra launched」で、9月22日には
gpt-6-solとgpt-6-lunaのリリースが追記されています。 - APIでは
gpt-6-astraとして提供され、Amazon Bedrock経由でも利用できます。 - ChatGPT側の利用は既存のサブスクリプション枠に含まれ、追加分はクレジット購入。Enterpriseはワークスペース管理者による有効化が必要です。
一方で、「一般提供(GA)を開始した日」を名指しした公式発表は、2026年9月24日時点のチェンジログ・モデルページ・料金ページのいずれにも見当たりません。社内に「何月何日からGA」と案内したい場合は、日付を断定せず「9月24日時点で制限表示なしに提供されている」と書くのが正確です。自分のアカウントで使えるかどうかは、APIキーで GET /v1/models を叩くのが確実です。
curl https://api.openai.com/v1/models/gpt-6-astra \
  -H "Authorization: Bearer $OPENAI_API_KEY"
移行でやりがちな失敗パターン
- ❌ Solで使っていた
reasoning_effort: "none"をそのまま流用する → HTTP 400で落ちる。⭕lowから始めて出力品質とトークン量を比較する。 - ❌ Chat Completionsのままツール呼び出しを続ける → ⭕ ツールを使う経路はResponses APIへ移す。テキスト生成だけならChat Completionsのままでも動く。
- ❌
temperatureやtop_pを残したままモデルIDだけ差し替える → ⭕ 非対応パラメータを先に削除してからモデルを切り替える。 - ❌ EUデータレジデンシー構成で
service_tier: "fast"を指定する → ⭕ 標準処理を使う。Sol・Lunaも同じ制約。 - ❌ 会話の途中でリクエストレベルの
reasoning.effortを書き換える → プロンプトの前置きが変わりキャッシュが効かなくなる。⭕configuration_updateを使う。 - ❌ 「Astraは高いからSolに据え置く」と決めて旧
gpt-5.6-solのまま残す → ⭕ 9月22日に出たgpt-6-solは旧Solの半額。据え置き先を先に見直す。 - ❌ 単価表だけを見て「2.5倍だから見送り」と判断する → ⭕ 自分の評価セットで1タスクあたりの総トークン数を測ってから決める。
- ❌ effortを上げたぶんの費用を入力側だけで見積もる → ⭕ 推論トークンは出力として課金される。TPMの消費も増える。
よくある質問
GPT-6 Astraの料金はいくらですか?
2026年9月24日時点の公式料金ページでは、100万トークンあたり入力$10.00・キャッシュ入力$1.00・キャッシュ書き込み$12.50・出力$50.00です。1ドル150円換算なら入力1,500円・出力7,500円。入力が272Kトークンを超えると入力・キャッシュが2倍、出力が1.5倍になります。Batchは半額(入力$5.00・出力$25.00)、Fast modeは2倍(入力$20.00・出力$100.00)です。
reasoning.effortにはどの値を指定できますか?noneは使えますか?
gpt-6-astra が受け付けるのは low / medium / high / xhigh / max の5つです。none は使えません。Reasoningガイドに「Setting reasoning.effort (Responses) or reasoning_effort (Chat Completions) to none returns HTTP 400.」と明記されています。gpt-6-sol と gpt-6-luna は none に対応しています。
GPT-6 AstraはAPIでいつから使えますか?
米国時間2026年9月3日に公開され、公開当初はTrusted Access Program向けのロールアウトでした。2026年9月24日時点では、モデル一覧・モデルページに制限表示はなく、料金とTier 1からTier 5までのレート制限が掲載されています。ただし「一般提供を開始した日」を名指しした公式発表は9月24日時点で確認できていません。自分のアカウントで使えるかは GET /v1/models/gpt-6-astra で確認してください。
長コンテキストの料金はどこから適用されますか?
入力トークンが272Kを超えるプロンプトが対象です。その場合、リクエスト全体が入力・キャッシュ料率2倍、出力1.5倍で課金されます。272Kトークン以下なら短コンテキストの単価(入力$10.00・出力$50.00)です。段差の実額は本文の試算例2にあります。
gpt-6-solとgpt-5.6-solはどちらが安いですか?
gpt-6-sol です。9月22日に追加された gpt-6-sol は入力$2.00・出力$10.00で、旧 gpt-5.6-sol(入力$4.00・出力$20.00)のちょうど半額です。旧Solには「プロモーション価格は少なくとも2026年11月21日まで」の注記が付いていますが、gpt-6-sol には9月24日時点でこの注記がありません。
Batchは使えますか?どれくらい安くなりますか?
gpt-6-astra と gpt-6-sol はBatchエンドポイントに対応しています(gpt-6-luna はChat CompletionsとResponsesのみ)。Batchの単価はStandardの半額で、Astraなら入力$5.00・出力$25.00です。Batchキューの上限はTier 1で1,500,000トークン、Tier 5で15,000,000,000トークンです。
既存のChat Completions実装はそのまま動きますか?
テキスト生成だけならChat Completionsでも動きますが、ツール呼び出しにはResponses APIが必要です。また temperature、top_p、top_logprobs、Chat Completionsの logprobs は非対応なので削除が要ります。
レート制限はどれくらいですか?ティアはどう上がりますか?
gpt-6-astra の標準処理はTier 1が500 RPM・500,000 TPM、Tier 5が15,000 RPM・40,000,000 TPMです。ティアは累計支払額で上がり、Tier 1は$5、Tier 5は$1,000が条件です。制限を超えると429が返るので、Retry-After があればその値に従ってください。
APIに送ったデータは学習に使われますか?
使われません。公式は「As of March 1, 2023, data sent to the OpenAI API is not used to train or improve OpenAI models (unless you explicitly opt in to share data with us).」としています。不正利用監視のログは最長30日保持され、Zero Data Retentionの承認を受ければ除外できます。日本を含む10地域でデータレジデンシーに対応していますが、リージョナル処理は10%上乗せです。
Astraに切り替えるとエージェントが途中で止まることはありますか?
あります。外部提供のツール利用推論にはミスアライメント監視が入っており、公式は「ChatGPTやCodexでは確認を求められることがあるが、APIではタスクが停止する」と説明しています。停止時に途中状態を保存して人の確認へ回す設計を先に入れておくのが安全です。
GPT-6 Astraとは何ですか?
OpenAIが米国時間2026年9月3日に公開した最新の旗艦モデルです。APIのモデルIDは gpt-6-astra、公式の説明は「Our most capable model, built for the hardest end-to-end work」(最も高性能なモデル、最も難しいエンドツーエンドの作業のために作られた)です。コンテキストウィンドウは1,050,000トークン、最大入力922,000トークン、最大出力128,000トークンです。
まとめ|今日やる3つ
- 非対応パラメータ(
temperature、top_p、top_logprobs)を削り、ツール経路をResponses APIへ寄せる。reasoning_effort: "none"が残っていないかも同時に検索する。 - 評価セットを
gpt-6-astra・gpt-6-sol・旧gpt-5.6-solの3本で流し、スコアと1タスクあたりの総トークン数(推論トークンを含む)を並べて比較する。単価だけで決めない。旧Solに据え置くくらいならgpt-6-solのほうが半額で済む。 - スキルファイルと
AGENTS.mdを読み直し、曖昧な記述や矛盾する指示を消す。Astraはここに敏感で、作業が早めに止まる原因になる。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Pricing – OpenAI API(2026年9月24日取得。Standard・Batch・Flex・Fast modeの単価、gpt-6-sol/gpt-6-lunaの単価、gpt-5.6-solのプロモーション価格の期限、リージョナル処理の10%上乗せ)
- gpt-6-astra モデルページ(2026年9月24日取得。コンテキスト1,050,000・最大入力922,000・最大出力128,000、272Kトークン超の課金ルール、対応エンドポイントとレート制限ティア表)
- Models – OpenAI API(2026年9月24日取得。GPT-6 Astra/Sol/Lunaの説明文、制限表示の有無)
- gpt-6-sol モデルページ(2026年9月24日取得。単価$2.00/$10.00、カットオフ2026年4月20日、noneに対応)
- gpt-6-luna モデルページ(2026年9月24日取得。単価$0.10/$0.50、カットオフ2026年5月18日、Batch非対応)
- Reasoning – OpenAI API(2026年9月24日取得。effortの値、Astraでnoneを渡すとHTTP 400、推論トークンは出力として課金、configuration_updateの制約)
- Using GPT-6 – OpenAI API(2026年9月24日取得。移行チェックリスト、Fast modeにレイテンシSLAなし、EUデータレジデンシーは標準処理のみ、非同期ツール呼び出し、mid-turn steering、挙動の注意点)
- Rate limits – OpenAI API(2026年9月24日取得。ティア昇格条件と月あたり上限、429のリトライ指針)
- Your data – OpenAI API(2026年9月24日取得。学習に使わない方針、監視ログ30日、ZDR、データレジデンシー対応地域)
- Changelog – OpenAI API(2026年9月24日取得。9/3 GPT-6 Astra・非同期ツール呼び出し、9/8 Prompt Cache Diagnostics、9/22 GPT-6 Sol/Luna)
- GPT-6 Astra: A new generation of intelligence(提供範囲、ベンチマーク表、Fast modeの速度、レイテンシ)
- Safety overview: GPT-6 Astra(Critical水準、ミスアライメント監視、54,000件のCodexタスクシミュレーション。OpenAIのニュース一覧で米国時間2026年9月3日付)
- ChatGPT — Release Notes(米国時間2026年9月3日「Introducing GPT-6 Astra」)
- Path to Astra: critical capabilities and frontier safeguards(2026年9月1日・発表前の安全策)