「GPT-5.6はAmazon Bedrockの東京リージョンから本番利用でき、どの推論プロファイルを選べばよいのでしょうか?」
2026年9月27日時点、東京(ap-northeast-1)から呼べるGPT-5.6の経路はglobal.のGlobal推論プロファイルだけで、In-RegionとGeo(us./in.)は東京では非対応です。AWSのモデルカード当日版では3モデルともGlobalが32リージョンで有効、単価はGlobalのTerraが入力100万トークンあたり2.00ドル(1ドル150円換算で300円)・出力12.00ドル(1,800円)です。
- 東京から使う基本形:
bedrock-runtime.ap-northeast-1.amazonaws.comへ接続し、global.openai.gpt-5.6-terraのようなGlobal推論プロファイルIDをモデルとして指定します。変えるのはmodelId(またはmodel)に渡す文字列だけです。 - 2026年9月27日時点の最大の制約:東京からは単一リージョン処理(In-Region)もGeoも選べません。日本国内処理が必須なワークロードは、GPT-5.6では要件を満たせません。
- 料金の分かれ目は272Kトークン:入力が272Kトークン以下か超かで単価が2倍近く変わります。Global CRISはIn-Region・Geoより約9%安い設定です。
対象は、AWS上でOpenAIモデルを本番運用し、データ所在、SCP、IAM、キャッシュ、クォータ、単価を設計する開発者・クラウド基盤担当者です。数値はすべて2026年9月27日に公式ページを取得して確認しています。
この記事は、AWSのWhat’s New(2026年8月17日)、AWS Machine Learning Blog(2026年8月20日)、AWS Japanブログ(2026年8月24日)に加えて、2026年9月27日に取得したSol・Terra・Lunaのモデルカードを突き合わせています。8月の発表記事と9月27日のモデルカードでは、対応リージョン数・単価・キャッシュ仕様・利用できる機能が一致しない箇所があるため、その差分も本文で明示します。
扱う範囲はBedrock上のGPT-5.6配信基盤です。モデル内部のUltra modeやサブエージェント設計はGPT-5.6 Ultra modeとサブエージェント設計、エージェント実行基盤の刷新はBedrock Agents ClassicからAgentCoreへの移行ガイドが対象で、この記事とは論点が異なります。
GPT-5.6 Bedrockは東京リージョンから使えるのか
結論から言うと、「東京から呼べる」は正しく、「東京で処理される」は2026年9月27日時点で不可能です。AWS Japanのブログは「東京・大阪リージョンからGPT-5.6を直接呼び出す方法は提供されていません」と明記しており、モデルカードのRegional availability表も東京はGlobalのみに丸が付いています。
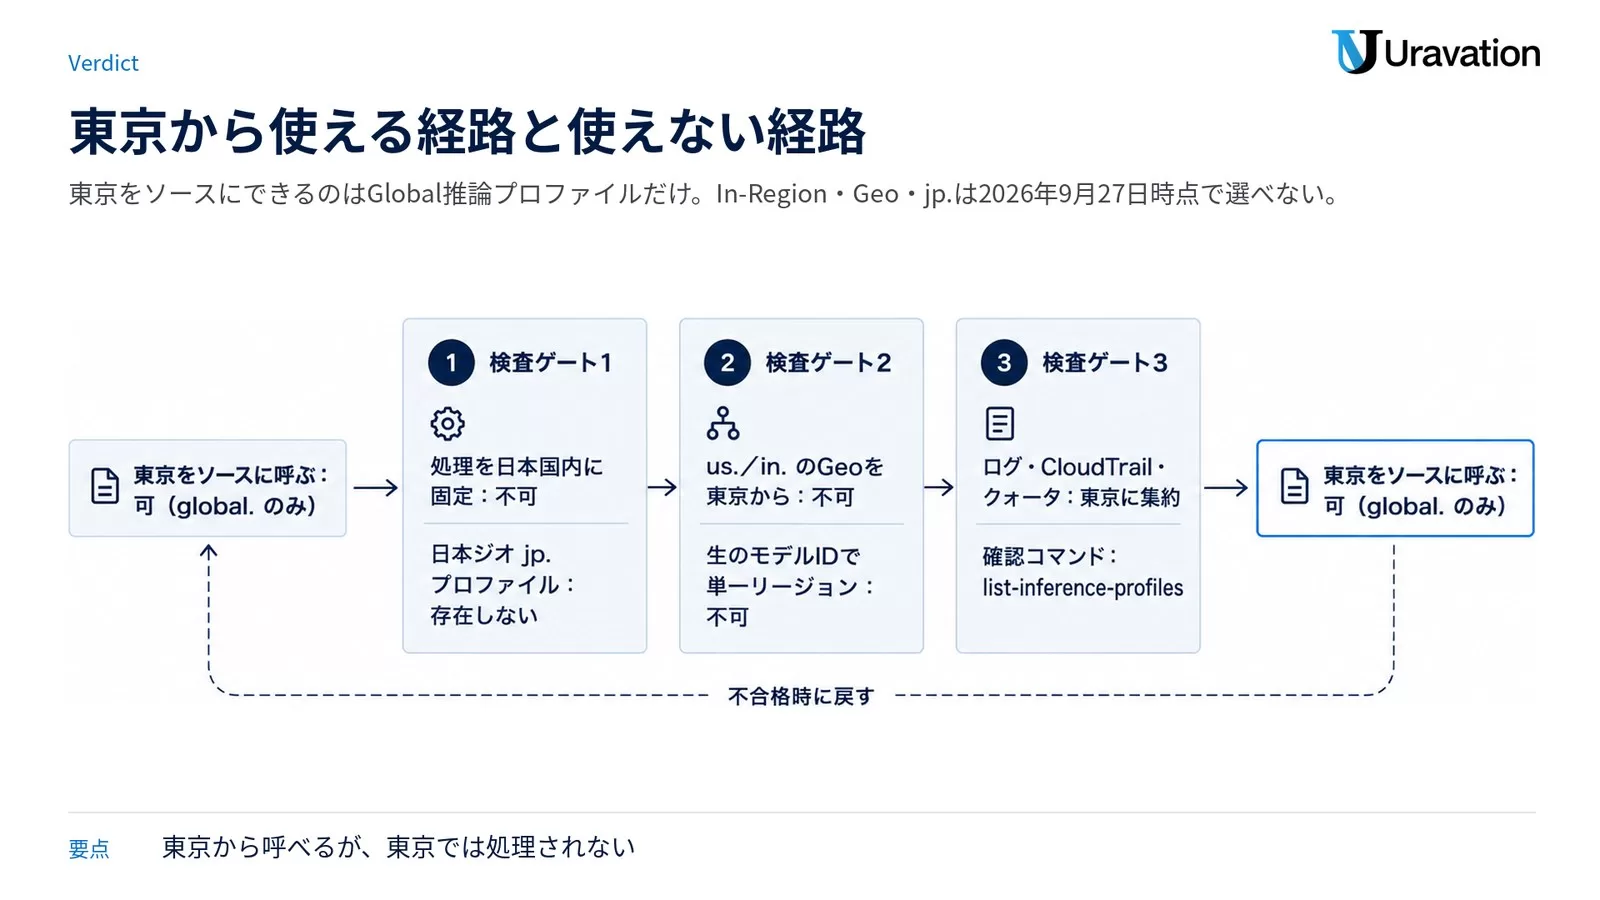
| 要件 | 2026年9月27日時点の可否 | 根拠 |
|---|---|---|
| 東京をソースにGPT-5.6を呼ぶ | 可(global.openai.gpt-5.6-sol / -terra / -lunaのみ) |
モデルカードのap-northeast-1行はGlobalのみ有効 |
| 処理を日本国内に固定する | 不可(日本ジオjp.プロファイルが存在しない) |
AWS Japanブログ「GPT-5.6に日本ジオ(jp.)の推論プロファイルは提供されていません」 |
東京からus./in.のGeoを呼ぶ |
不可(ソースリージョンが米国・カナダ/インドに限定) | モデルカードのGeo列は米国・カナダ・インドのみ |
生のモデルIDopenai.gpt-5.6-terraで単一リージョン処理 |
不可(東京では利用不可。bedrock-mantleの米国リージョン限定) |
モデルカード「This model is not available for in-Region inference on that endpoint」 |
| 呼び出しログ・CloudTrail・CloudWatch・クォータを東京に集約 | 可(すべてソースリージョンに記録) | AWS Machine Learning Blogおよびモデル呼び出しログの仕様 |
自分のアカウントで実際に呼べるプロファイルは、AWS Japanブログが示している次のコマンドで確認できます。記事中のリージョン表を設定ファイルへ転記して固定化するより、デプロイ前にこのコマンドを流す運用のほうが安全です。
aws bedrock list-inference-profiles --region ap-northeast-1 \
  --query "inferenceProfileSummaries[?contains(inferenceProfileId, 'gpt-5.6')].[inferenceProfileId,status]" \
--output tableもう1つ、データレジデンシー要件がある場合の現実的な代替も先に挙げておきます。AWSは日本国内クロスリージョン推論(jp.プロファイル)を2025年10月16日のAWS Japanブログで解説しており、当時の対象はClaude Sonnet 4.5(jp.anthropic.claude-sonnet-4-5-20250929-v1:0)とClaude Haiku 4.5でした。GPT-5.6にこの選択肢はありません。国内処理が契約要件なら、モデル選定そのものを見直す段階から検討してください。Bedrock上のClaude系のデータ境界はClaude Messages API on Bedrockとzero operator accessで別に整理しています。
GPT-5.6 Bedrockで何が変わったのか
GPT-5.6がBedrockへ追加された日、値下げされた日、cross-Region inferenceが追加された日はすべて別です。モデルカードのModel launch dateは2026年7月13日で、その後に料金改定とAPI拡張が段階的に入りました。9月27日時点の到達点を年表で固定します。
| 日付 | 公式の発表内容 | 開発者への意味 |
|---|---|---|
| 2026年7月13日 | GPT-5.6 Sol・Terra・LunaのModel launch date(各モデルカード) | EOLは「2027年7月13日より前にはならない」と明記。レガシー期間は6か月以上 |
| 2026年7月30日 | Lunaのオンデマンド単価を80%、Terraを20%引き下げ(Solは据え置き) | 7月前半の単価で作った試算は作り直しが必要 |
| 2026年8月17日 | Responses・Chat Completions・Converseの3 APIとGlobal・Geo CRISをbedrock-runtimeに追加 |
既存のAWS統制(IAM・ログ・CloudWatch・Cost Explorer)へ載せられるようになった |
| 2026年8月18日 | インドジオin.をTerraとLunaに追加 |
Geoは米国だけではなくなった。ただしSolは対象外 |
| 2026年8月20日 | AWS Machine Learning Blogが「25を超えるリージョン」「IAM・SCP・キャッシュ・クォータ」を具体化 | 本番設計に必要なルーティングと運用条件が揃った |
| 2026年8月24日 | AWS Japanブログが東京・大阪から使う場合の論点(データ所在・レイテンシ)を整理 | 日本拠点向けの判断材料が日本語の一次情報になった |
| 2026年9月27日 | モデルカードでGlobal対応が32リージョン、単価・キャッシュ仕様が公開済み | 「25超」も「単価は料金ページで」も、当日値では更新されている |
3モデルはいずれもテキストと画像を入力し、テキストを出力します。コンテキストウィンドウはモデルカードで3モデルとも1Mトークンです。ストリーミングはResponses・Chat Completionsのstream=TrueとConverseStreamで使えます。
ここで1点、8月の発表と当日モデルカードで食い違う記述があります。8月20日のAWSブログは3モデルとも「server-side tool calling対応」と書いていますが、9月27日時点のモデルカードはbedrock-runtimeのServer-side tool useを「Not Supported」、bedrock-mantleを「Supported」としています。同様に、Intelligent prompt routing・Count tokens・Structured outputsもbedrock-runtimeでは非対応、Guardrailsとアプリケーション推論プロファイルはConverse APIのみです。機能の可否はエンドポイントとAPI単位で読む必要があります。
BedrockのGPT-5.6は3モデル|Sol・Terra・Lunaの違いと選び方
3モデルは同じAPI形状で呼べますが、対応リージョン・単価・想定用途が違います。最初からSolに固定する設計は、クォータと単価の両面で損をしやすいです。
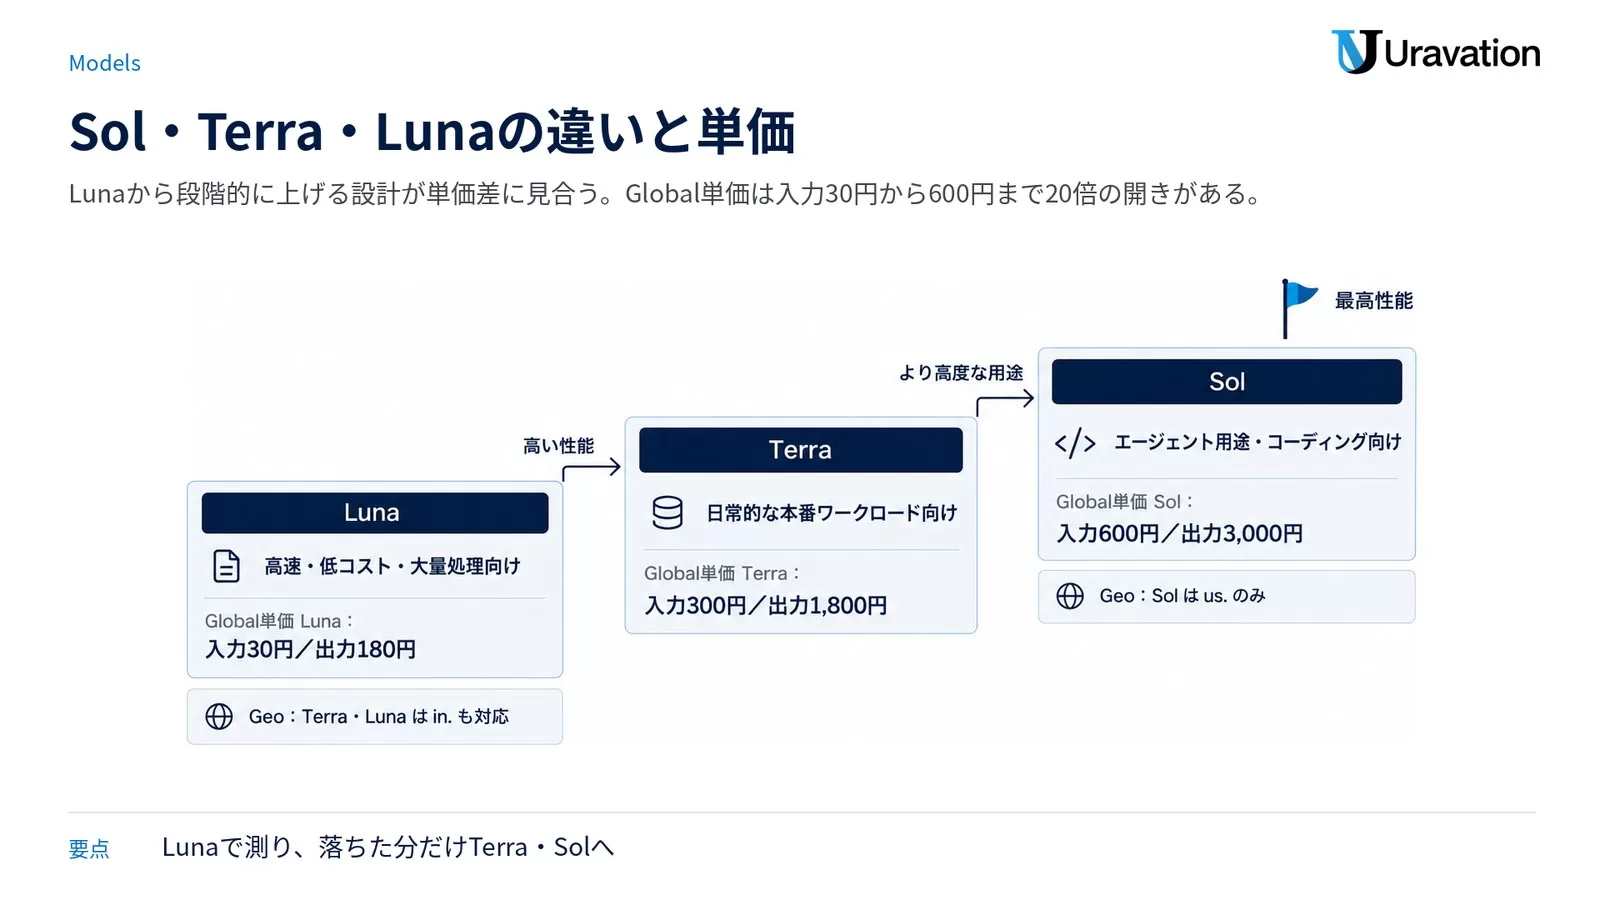
| 項目 | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.6 Luna |
|---|---|---|---|
| 公式の位置づけ | 最も高性能。エージェント用途・コーディング向け | バランス型。日常的な本番ワークロード向け | 高速・低コスト。大量処理向け |
Global CRIS(global.) |
対応(東京から呼べる) | 対応(東京から呼べる) | 対応(東京から呼べる) |
| Geo CRIS | us.のみ |
us.とin. |
us.とin. |
In-Region(bedrock-mantle) |
us-east-1、us-east-2 | us-east-1、us-east-2、us-west-2、GovCloud 2リージョン | us-east-1、us-east-2、us-west-2、GovCloud 2リージョン |
| Global単価(入力/出力・100万トークン・272K以下) | 4.00ドル(600円)/20.00ドル(3,000円) | 2.00ドル(300円)/12.00ドル(1,800円) | 0.20ドル(30円)/1.20ドル(180円) |
| 7月30日の改定 | 据え置き | 20%引き下げ | 80%引き下げ |
| Kiro Coding Agent Index | 80 | 77.4 | 74.6 |
選定の順番は「処理地域の境界 → 必要なリージョン → 単価 → 品質」です。bedrock-runtimeで東京をソースにする限り、3モデルすべてGlobal一択になるため、実質的な選択軸は単価と品質になります。まずLunaで受入率を測り、落ちたケースだけTerraへ、さらに失敗コストが高い処理だけSolへ寄せる段階設計が、単価差(Luna→Solで入力20倍・出力約17倍)に見合います。
モデル・SDK・実行基盤・IDEを同じ評価軸で混ぜないことが選定の出発点です。全体のツール選定から見直す場合はAIエージェントツール比較ガイド、クラウド3社の基盤比較はAIエージェント基盤3強比較が対応します。
32リージョンの対応表|In-Region・Geo・Globalの可否をどう読むか
AWSの8月20日ブログは「more than 25 AWS Regions」と書き、ソースリージョンを28個挙げていました。9月27日時点のモデルカードでは、bedrock-runtimeでGlobalが有効なリージョンが32個に増えています。増えたのはca-west-1(カルガリー)、ap-southeast-6(ニュージーランド)、me-south-1(バーレーン)、af-south-1(ケープタウン)の4つです。
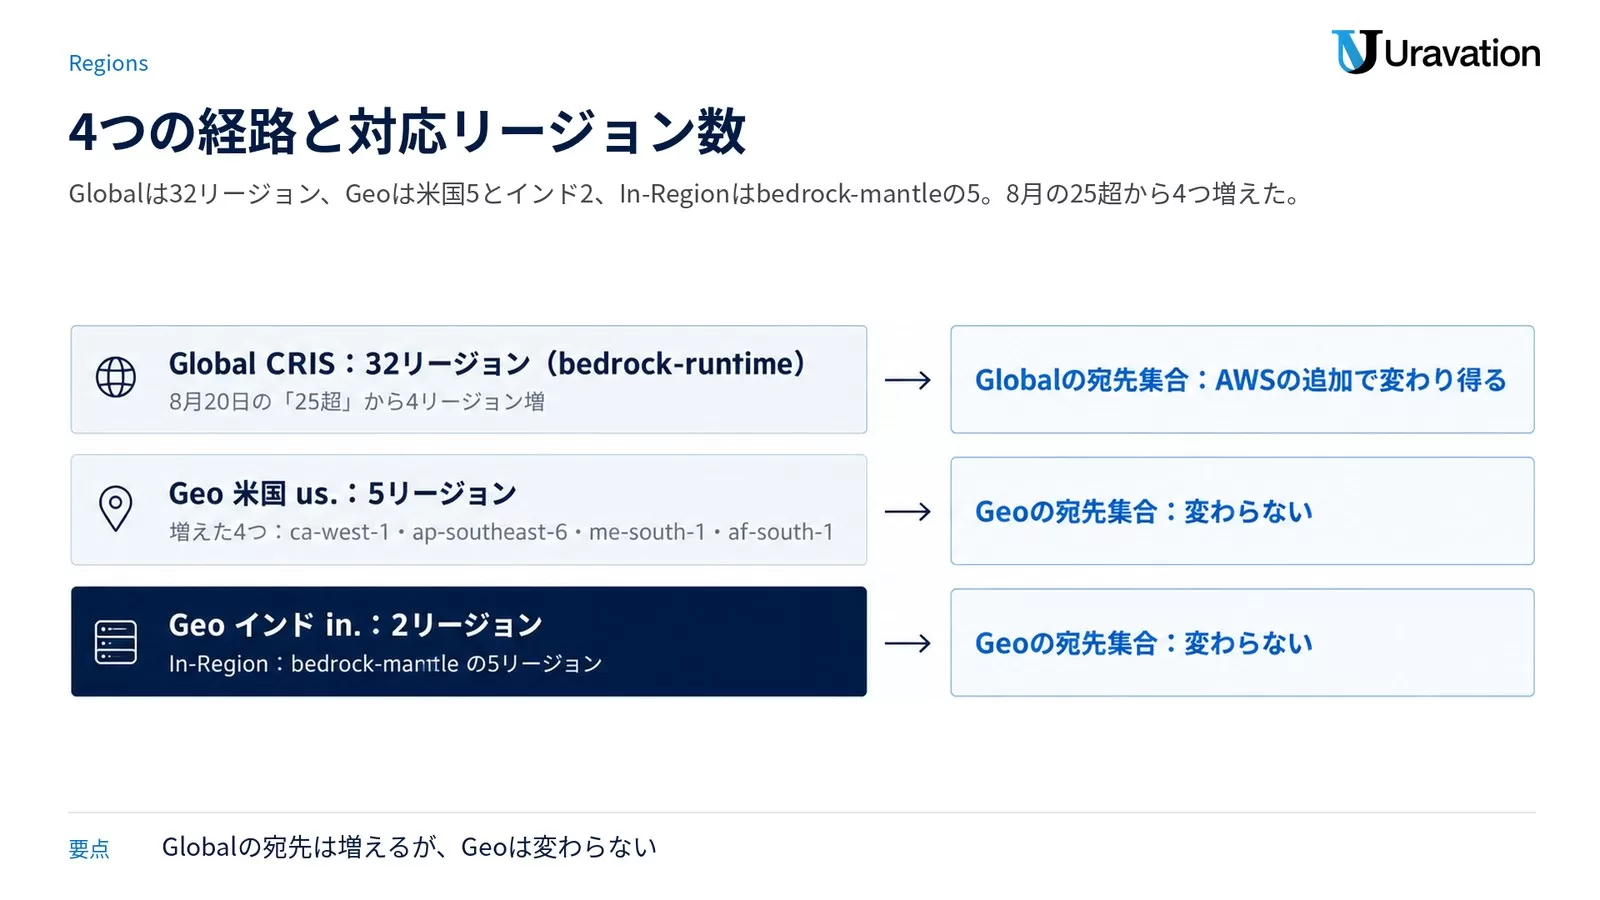
| 経路 | 指定する識別子 | 処理される場所 | 対応リージョン数(2026年9月27日・Terra) | 東京から使えるか |
|---|---|---|---|---|
Global CRIS(bedrock-runtime) |
global.openai.gpt-5.6-terra |
モデルが展開済みの商用AWSリージョン(指定不可) | 32(ソースとして有効なリージョン) | 使える |
Geo CRIS 米国(bedrock-runtime) |
us.openai.gpt-5.6-terra |
us-east-1、us-east-2、us-west-2(ソースによりus-west-1・カナダを含む) | 5(us-east-1/us-east-2/us-west-1/us-west-2/ca-central-1) | 使えない |
Geo CRIS インド(bedrock-runtime) |
in.openai.gpt-5.6-terra |
インドのリージョン内 | 2(ap-south-1/ap-south-2) | 使えない |
In-Region(bedrock-mantle) |
openai.gpt-5.6-terra |
指定した単一リージョン | 5(us-east-1/us-east-2/us-west-2/GovCloud 2) | 使えない |
in.非対応、In-Regionがus-east-1とus-east-2の2リージョンです。ここでいう32は、1つのリクエストが32リージョンへ送信されるという意味ではありません。アプリケーションは1つのソースリージョンから1つの推論プロファイルを呼び、Bedrockがそのプロファイルの対象内から処理先を選びます。Supported Regions and models for inference profilesには、Globalプロファイルの宛先集合はAWSが商用リージョンを追加すると変わり得る一方、地理にひも付くGeoプロファイルの宛先集合は変わらないと書かれています。実際に、ローンチ時の宛先は米国3リージョンのみで、8月18日にTerraとLunaがインドへ広がりました。
同じドキュメントには、見落としやすい記述がもう1つあります。宛先リージョンにはオプトインリージョンが含まれ得るため、自分のアカウントで有効化していないリージョンへもルーティングされる可能性があり、不正利用検知目的の入出力はそのオプトインリージョンに保存され得るという内容です。SCPでリージョンを絞っている組織は、この挙動を前提に設計してください。
GPT-5.6 Bedrockの料金|モデルカード当日値と円換算
8月時点では単価が料金ページのみでしたが、9月27日時点では各モデルカードのPricingセクションに掲載されています。Standardティアのみで、PriorityとFlexは3モデルすべて非対応です。商用リージョンのIn-Region価格にはOpenAIレートに対する10%の上乗せが含まれます(利用者が別途加算する必要はありません)。
| モデル・経路 | 入力(272K以下) | キャッシュ書き込み | キャッシュ読み出し | 出力(272K以下) |
|---|---|---|---|---|
| Sol/In-Region・Geo | 4.40ドル(660円) | 5.50ドル(825円) | 0.44ドル(66円) | 22.00ドル(3,300円) |
| Sol/Global | 4.00ドル(600円) | 5.00ドル(750円) | 0.40ドル(60円) | 20.00ドル(3,000円) |
| Terra/In-Region・Geo | 2.20ドル(330円) | 2.75ドル(413円) | 0.22ドル(33円) | 13.20ドル(1,980円) |
| Terra/Global | 2.00ドル(300円) | 2.50ドル(375円) | 0.20ドル(30円) | 12.00ドル(1,800円) |
| Luna/In-Region・Geo | 0.22ドル(33円) | 0.275ドル(41円) | 0.022ドル(3円) | 1.32ドル(198円) |
| Luna/Global | 0.20ドル(30円) | 0.25ドル(38円) | 0.02ドル(3円) | 1.20ドル(180円) |
設計上の分岐は入力272Kトークンの境界です。入力が272Kを超えるlong contextでは、モデルカードの別表に切り替わり、Terra/Globalは入力4.00ドル(600円)・出力18.00ドル(2,700円)、Sol/Globalは入力8.00ドル(1,200円)・出力30.00ドル(4,500円)、Luna/Globalは入力0.40ドル(60円)・出力1.80ドル(270円)になります。入力はちょうど2倍、出力は1.5倍です。「1Mトークン入るから全部投げる」設計は、この境界を越えた瞬間に単価が跳ねます。
Global CRISを選ぶ金銭的な理由は明確です。同じモデル・同じティアで、GlobalはIn-Region・Geoより入力・出力ともおよそ9%安く設定されています。逆に言えば、データレジデンシー要件のためにGlobalではなくGeoを選ぶと、単価は約10%の上乗せになります。GovCloud(US-EastとUS-West)はさらに高く、TerraのIn-Regionが入力2.64ドル(396円)・出力15.84ドル(2,376円)です。
最新の単価はAmazon Bedrock料金ページと各モデルカードで必ず再確認してください。7月30日に2モデルが一度に改定された実例があるため、見積もりを固定値でドキュメント化すると陳腐化します。サーバーレス構成でのコスト設計はAWS Lambda+Bedrockサーバーレス構築ガイドも合わせて参照してください。
GPT-5.6をBedrockで呼ぶ最短手順|推論プロファイルIDと3つのAPI
ここからは東京リージョンをソースにし、Global CRISのTerraを呼ぶ最小構成を示します。AWSの公式例に沿った構文ですが、認証、モデルアクセス、SCP、クォータはアカウントごとに異なります。
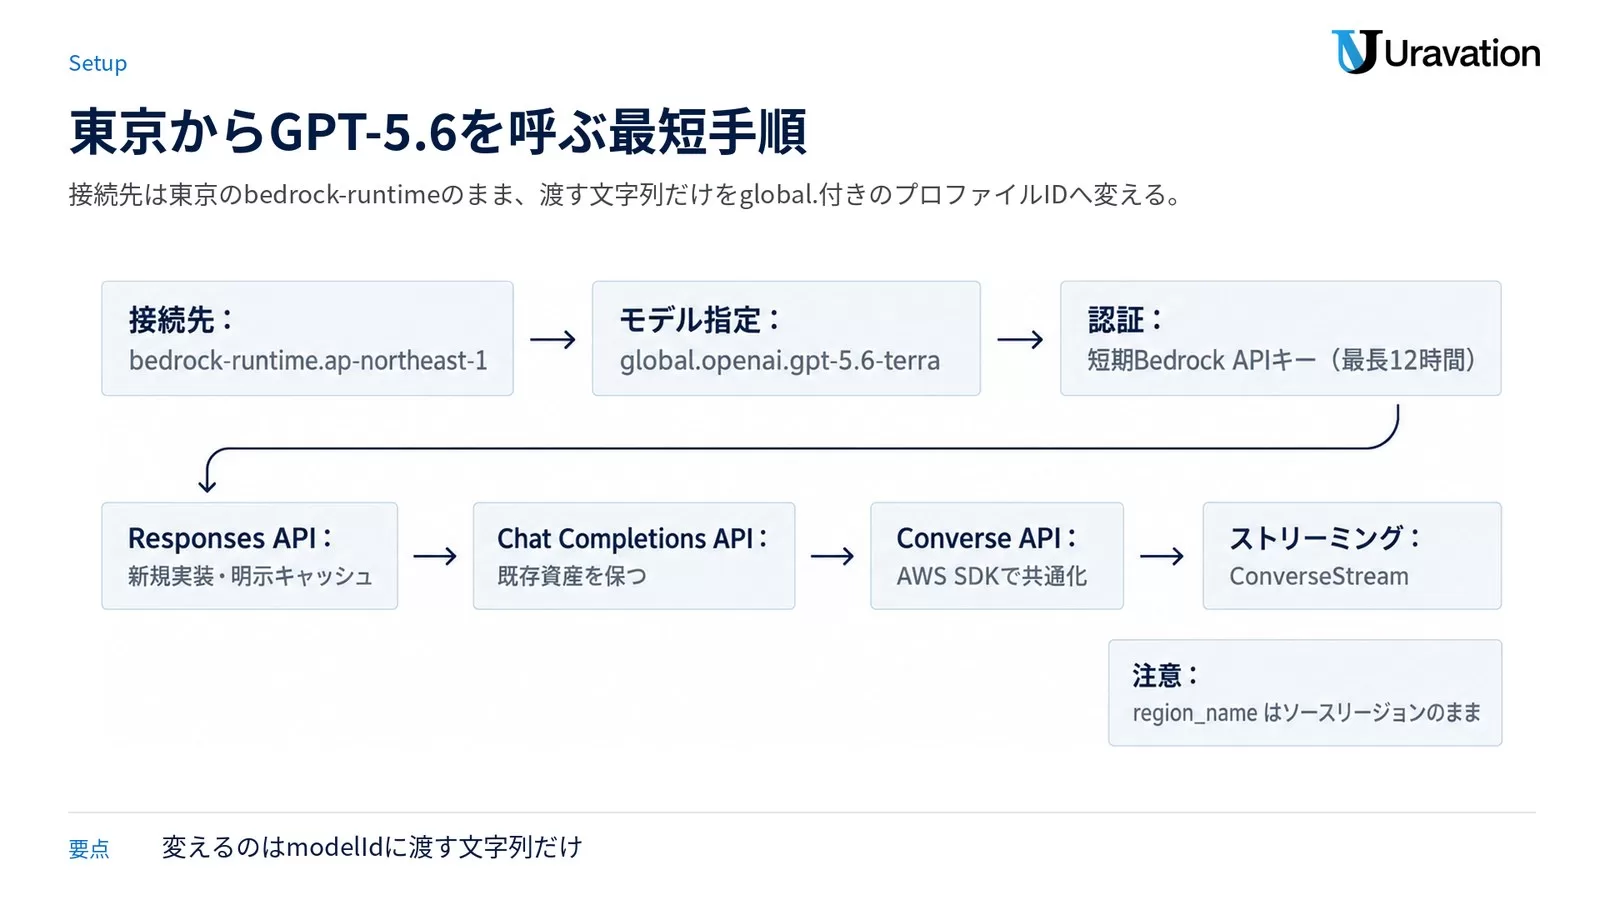
OpenAI SDKを使う → 新規の応答・ツール中心ならResponses/既存資産を保つならChat Completions
AWS SDKでモデル共通化する → Converse/ストリーミングはConverseStream
bedrock-runtimeのみで、bedrock-mantleでは使えません。動作前提:Python 3.11以上、openai、aws-bedrock-token-generator、またはboto3。API仕様の確認日は2026年9月27日です。パッケージは隔離した検証環境へ導入し、採用するバージョンをロックファイルで固定してください。
Responses API:OpenAI SDKからGlobalプロファイルを呼ぶ
既存のOpenAI SDKベースのアプリケーションを移行する場合は、接続先を東京のbedrock-runtimeへ向け、モデル名をGlobal推論プロファイルIDへ置き換えます。短期Bedrock APIキーは既存のAWS認証情報から生成され、公式例では最長12時間有効です。長期キーは探索用途のみが公式の推奨です。
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

region = "ap-northeast-1"
model_id = "global.openai.gpt-5.6-terra"

client = OpenAI(
    base_url=f"https://bedrock-runtime.{region}.amazonaws.com/openai/v1",
    api_key=provide_token(region=region),
)

response = client.responses.create(
    model=model_id,
    input="S3イベント駆動アーキテクチャの要点を3項目で整理してください。",
    max_output_tokens=512,
)

print(response.output_text)

# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。静的な長期キーをソースコードやコンテナイメージへ埋め込まないことがポイントです。実行ロールのAWS認証情報から短期キーを生成し、bedrock:CallWithBearerTokenと推論権限を最小化します。base_urlとregionには必ずソースリージョン(東京)を書きます。宛先リージョンを書くのはAWS Japanが挙げる典型的なつまずきの1つです。
Chat Completions API:reasoningと明示キャッシュを併用する
既存アプリがChat Completions形式を使っている場合は、client.chat.completions.createを維持できます。次の例は、1,024トークン以上の安定した社内ルールを明示キャッシュの対象にし、可変の質問を後ろへ置く形です。
from pathlib import Path

# 1,024トークン以上の安定した接頭辞を用意する
support_policy = Path("support_policy.txt").read_text(encoding="utf-8")

completion = client.chat.completions.create(
    model="global.openai.gpt-5.6-terra",
    messages=[
        {
            "role": "system",
            "content": [
                {
                    "type": "text",
                    "text": support_policy,
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                }
            ],
        },
        {
            "role": "user",
            "content": "破損した端末の返金受付で最初に確認する事項は?",
        },
    ],
    max_completion_tokens=512,
    reasoning_effort="low",
    prompt_cache_key="support-policy-v1",
)

print(completion.choices[0].message.content)

# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。ここは公式同士で記述が分かれている箇所です。上のコードは2026年8月20日のAWS Machine Learning Blogの公式例に沿っていますが、9月27日時点のモデルカードはbedrock-runtimeの暗黙・明示キャッシュを「Responses APIのみ」と記載し、prompt cachingドキュメントもprompt_cache_breakpointを受け付けるフィールドを「Responses APIのinput_text・input_image・input_fileブロック」としています。明示キャッシュを本番で使うなら、Responses APIで実装し、usage.prompt_tokens_detailsのcached_tokensとcache_write_tokensが動いていることを自分のアカウントで確認してから採用してください。
Converse API:AWS SDKの共通インターフェースを使う
複数モデルをAWS SDKの同じ呼び出し形へ寄せたい場合はConverseが便利です。OpenAI固有のreasoning_effortとprompt_cache_keyはadditionalModelRequestFieldsへ渡します。
import boto3

bedrock = boto3.client(
    "bedrock-runtime",
    region_name="ap-northeast-1",
)

response = bedrock.converse(
    modelId="global.openai.gpt-5.6-terra",
    messages=[
        {
            "role": "user",
            "content": [
                {"text": "メッセージキューの代表的な用途を3つ挙げてください。"}
            ],
        }
    ],
    inferenceConfig={"maxTokens": 512},
    additionalModelRequestFields={
        "reasoning_effort": "low",
        "prompt_cache_key": "queue-guide-v1",
    },
)

print(response["output"]["message"]["content"][0]["text"])

# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。Converseの共通パラメータはinferenceConfigへ、モデル固有パラメータはadditionalModelRequestFieldsへ分けます。modelIdにはプロファイルIDの短縮形(global.openai.gpt-5.6-terra)を渡します。ストリーミングへ切り替える場合はconverse_streamを使い、IAMにbedrock:InvokeModelWithResponseStreamがあるか確認してください。対話UIでは、宛先リージョンまでのネットワーク往復が最初の1回に集約されるため、ストリーミングが体感待ち時間の削減に効きます。
東京リージョンでSCPとデータ所在をどう設計するか
Global CRISではaws:RequestedRegionがunspecifiedになる
リージョン制限SCPを使っている組織では、Global CRISが最初の落とし穴です。AWSの8月20日記事によると、Global CRISがリージョン非依存のモデルARNを認可するとき、aws:RequestedRegionは特定のリージョン名ではなくunspecifiedになります。東京だけを許可するSCPでは、IAMが正しくても明示的Denyにより呼び出しが失敗し得ます。
AWSが推奨する考え方は、組織全体のリージョン許可リストを安易に広げるのではなく、bedrock:InferenceProfileArn条件で対象のCRISプロファイルを例外化することです。ソースリージョンである東京は従来どおり許可しつつ、Bedrockの推論プロファイル経由だけを通す設計にします。許可リストへ宛先リージョンとunspecifiedを足す方法もありますが、それはBedrock以外の全サービスに対してもそのリージョンを開けることになります。Geo CRISでは、プロファイルが含む全宛先リージョンがSCP評価対象で、1リージョンでもブロックされるとリクエスト全体が失敗します。
IAMはプロファイルと処理先モデルの両方を許可する
Global CRISのIAMポリシーは4つのステートメントで構成されます。ソースリージョンの推論プロファイルとデフォルトプロジェクト、ソースリージョンの基盤モデル、リージョン非依存のグローバルモデルARN(これがcross-Regionルーティングを有効にします)、そしてBearer認証用のbedrock:CallWithBearerTokenです。Geo CRISは3ステートメントで、2番目が「ソースリージョンとジオ内の全宛先リージョンの基盤モデル」に変わります。
ConverseStreamを使うなら、推論プロファイルと基盤モデルにbedrock:InvokeModelWithResponseStreamも必要です。AWS管理ポリシーAmazonBedrockLimitedAccessで試せても、本番の最小権限ポリシーへ落とす際にグローバルARNのステートメントを抜くと、そこで動かなくなります。どちらのプロファイル種別でも、アカウントとリージョンでモデルアクセスを有効化しておく必要があります。
通常データとabuse detection対象を混同しない
Amazon Bedrockは、チップレベルで実施されるzero operator access(ZOA)と、既定のzero data retention(ZDR)を基本とします。ただしAmazon Bedrock abuse detectionでは、GPT-5.6 Sol・Terra・Lunaについて、自動分類器がフラグしたトラフィックをオフラインのabuse detection目的で最大30日保持すると明記されています。cross-Region inferenceでフラグ対象になった入出力は、処理を担当した宛先リージョンに保存されます。同ドキュメントには条件を満たす顧客はAWSアカウントチーム経由で完全なZDRを要請できるとも書かれています。
| データ | 保存先 |
|---|---|
| モデル呼び出しログ(リクエスト・レスポンス全文) | ソースリージョン(東京)の同一アカウントのS3またはCloudWatch Logs |
| CloudTrailイベント、CloudWatchメトリクス、Service Quotas | ソースリージョン(東京) |
| abuse detectionでフラグされた入出力(最大30日) | 宛先リージョン(推論処理が行われたリージョン。オプトインリージョンを含み得る) |
実際の処理先はCloudTrailのadditionalEventData.inferenceRegionで確認できます。ログの保存場所が東京でも、推論処理が東京とは限りません。モデル提供者と保持条件が異なるため、Claude向けの結論をGPT-5.6へそのまま流用しないでください。Bedrock以外の配信面(Vertex・Foundry)との比較はFable 5.1をBedrock/Vertex/Foundryで使う手順が対応します。
レイテンシは平均だけで判断しない
処理が日本国外で行われるため、東京から呼ぶ場合はリクエストごとにネットワーク往復が上乗せされます。AWS Japanは、宛先が複数候補から都度選ばれ、その候補はモデルの展開に伴って増えるためレイテンシは一定にならないと明記し、平均値だけでなくp90/p99を併せて確認することを推奨しています。Converse APIのレスポンスにはmetrics.latencyMsが含まれるため、まず短いプロンプトで往復を確認し、次に本番相当のプロンプトサイズと出力長で計測する順番が妥当です。バッチ処理や非同期のドキュメント処理では、この往復は問題になりにくい一方、ミリ秒単位の応答性が要件なら先にその要件を確認してください。
キャッシュとクォータをどう設計するか
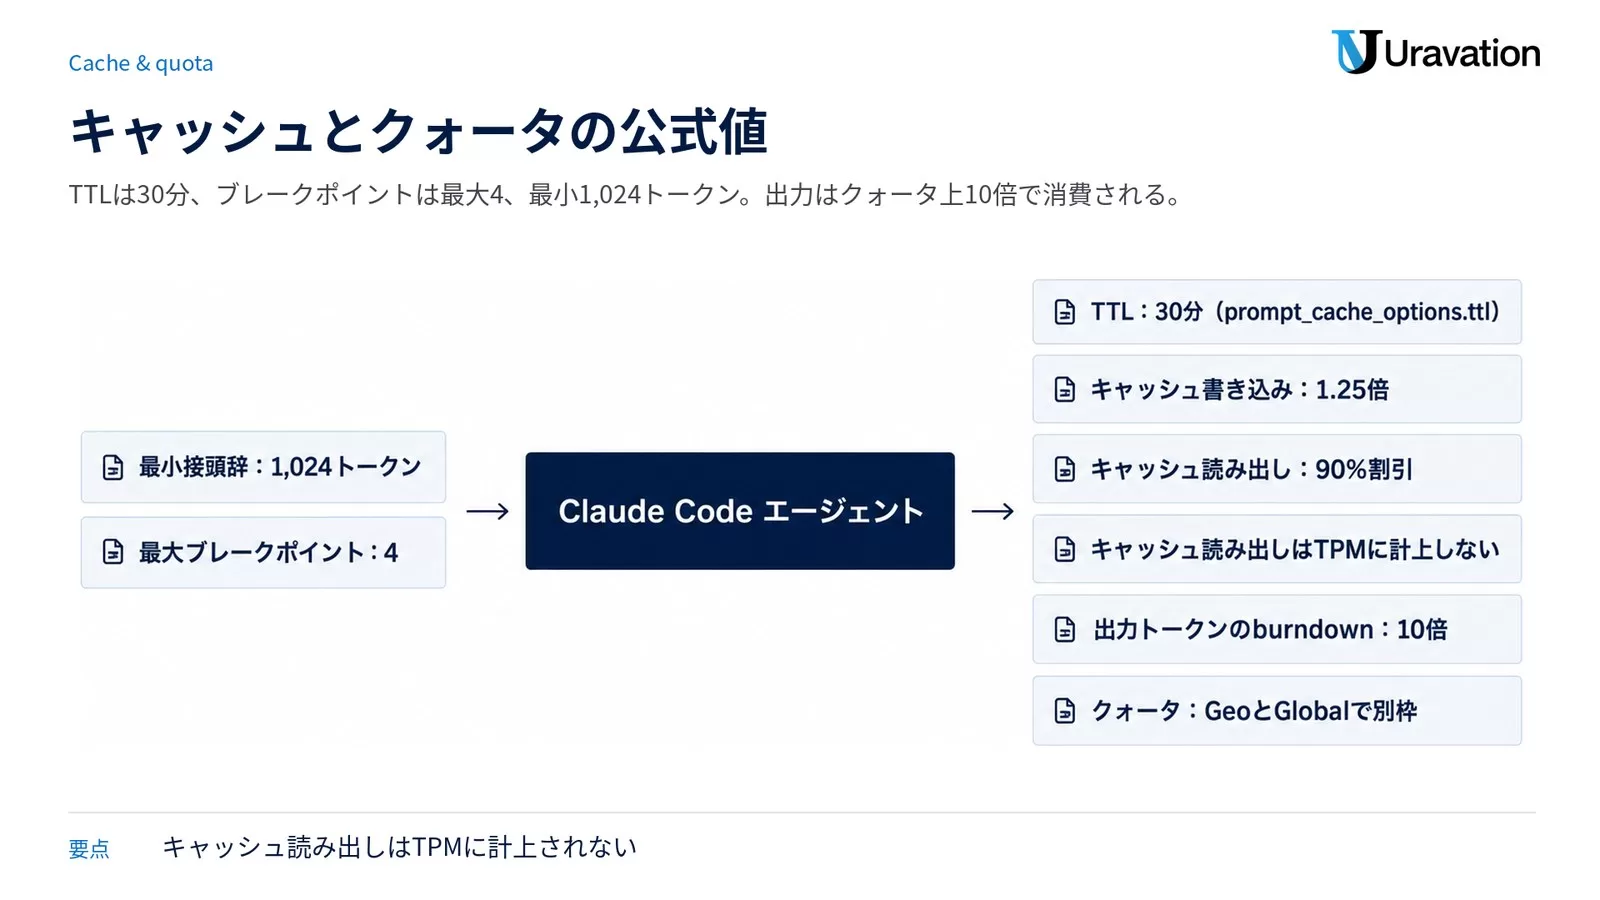
単価を下げる打ち手と、スロットリングを避ける打ち手は、GPT-5.6では同じ場所にあります。キャッシュから読み出した入力トークンは、課金が90%割引になるだけでなく、TPMクォータにも計上されません。
キャッシュは長い安定接頭辞へ置く
3モデルはbedrock-runtimeでprompt cachingに対応します。Implicit cachingは既定で、最新のuserまたはtool message付近へ自動的にブレークポイントを置きます。Explicit cachingは、システム指示、ツール定義、参照文書など、繰り返し使う接頭辞の末尾を開発者が明示します。2026年9月27日時点のドキュメント値は次のとおりです。
| 項目 | 2026年9月27日時点の公式値 |
|---|---|
| 1ブレークポイントの最小接頭辞 | 1,024トークン |
| 1リクエストあたりの最大ブレークポイント数 | 4 |
| TTL | 30分(prompt_cache_options.ttlの既定値が30m) |
| モード指定 | prompt_cache_options.modeにimplicit(既定)またはexplicit |
| キャッシュ書き込みの課金 | キャッシュなし入力単価の1.25倍 |
| キャッシュ読み出しの課金 | キャッシュなし入力単価から90%割引 |
| レート制限への計上 | キャッシュ読み出し分は入力TPMに計上しない |
- 変わらないsystem instruction、ツール定義、参照文書を前へ置く
- ユーザー入力、時刻、リクエスト固有値を後ろへ置く
cached_tokensとcache_write_tokensを計測し、書き込み量に見合う読み出しが発生しているか確認するexplicitモードは自動ブレークポイントが書き込み枠を消費するのを防ぐ用途に使う- GlobalとGeoの両方で、実際に使う推論プロファイルごとに負荷試験する
prompt_cache_keyは、同じ接頭辞を持つリクエストを同じキャッシュへ寄せるための補助キーです。キーを付けるだけでは不十分で、ブレークポイントより前の内容をバイト列として安定させます。時刻、リクエストID、ユーザー固有情報を接頭辞へ混ぜるとキャッシュミスが増えます。モデル横断の設計指針はプロンプトキャッシュ比較2026とプロンプトキャッシュ実装ガイドで整理しています。
出力トークンはクォータ上10倍で消費される
GPT-5.6のon-demandクォータは推論プロファイルごとのTPMで管理され、GeoとGlobalは別の割当です。プロファイルを切り替えると、引き出すプールそのものが変わります。さらに、入力トークンのburndownが1対1である一方、出力トークンのburndownは10倍です。長い回答を返すエージェントは、見かけの総トークン数より早くTPMを使い切ります。
公式の計算式は「入力トークン数 + キャッシュ書き込み入力トークン + (出力トークン数 × burndown rate)」です。AWSの例では、入力2,000・出力1,000のリクエストがクォータを12,000トークン消費します。キャッシュから読み出した入力トークンはこの計算に含まれません。長い固定接頭辞をキャッシュし、max_output_tokensまたはmax_completion_tokensで必要以上の出力を抑えることは、コスト対策とスロットリング対策を同時に満たします。
クォータの確認と増枠申請は、アプリケーションがBedrockを呼ぶリージョン(東京)のService Quotasコンソールから行います。CloudWatchは推論プロファイル単位でクォータ使用率メトリクスをリアルタイムに出すため、閾値アラームと履歴分析はプロファイルIDで組みます。宛先リージョン単位だけでダッシュボードを作ると、アプリケーションが指定したプロファイルとクォータの関係を見失います。負荷試験は本番規模のプロンプトとピークパターンで、実際に使うプロファイル種別に対して行ってください。
Kiroから使うGPT-5.6とBedrockはどう違うのか
同じモデル名でも、KiroとBedrockは提供面と運用条件が別です。Kiroは2026年7月14日の公式ブログでIDE・CLI・Webの3面に3モデルを追加し、Coding Agent Indexとクレジット乗数を公開しました。乗数は2026年7月31日に改定され、Terraは1.2倍から1.0倍、Lunaは0.6倍から0.1倍へ引き下げられました(Solは2.4倍で据え置き。Kiro公式ブログ)。2026年9月27日時点で、この乗数を更新する公式発表は確認できませんでした。
| 観点 | Kiro(IDE・CLI・Web) | Amazon Bedrock(bedrock-runtime) |
|---|---|---|
| コンテキスト | 272Kトークン(公式ブログ) | 1Mトークン(モデルカード)。272K超は単価が別表 |
| 課金単位 | クレジット乗数(Sol 2.4倍/Terra 1.0倍/Luna 0.1倍) | 100万トークンあたりのドル単価 |
| 対象プラン・条件 | Pro、Pro+、Pro Max、Powerで実験的サポート | AWSアカウントでモデルアクセスを有効化 |
| リージョンの扱い | 公式ブログはus-east-1とeu-central-1(フランクフルト)でのロールアウトと記載 | 東京をソースにGlobal CRISで呼べる。処理先は指定不可 |
| 向いている使い方 | 対話的な開発作業をすぐ試す | IAM・SCP・VPC・ログ・コスト配賦を含む基盤を作る |
Kiro側にリージョン選択やデータ所在を制御するリファレンスは、2026年9月27日時点で公式ドキュメントに確認できませんでした。データ所在を自分で管理したいなら、Kiroではなくbedrock-runtime側で推論プロファイルとSCPを設計する側に寄せるのが素直です。AWS上の開発支援ツールを合わせて検討する場合はAgent Toolkit for AWS完全ガイドも参考になります。
AIgent Labの関連記事マップ|Bedrock周辺をどこから読むか
この記事はBedrock上のGPT-5.6という1点に絞っています。サイト内の隣接テーマは次のように分担しているので、目的から逆算して読み進めてください。
| 知りたいこと | 読む記事 |
|---|---|
| GPT-5.6のモデル側の設計(Ultra mode・サブエージェント) | GPT-5.6 Ultra mode解剖 |
| Bedrockでエージェントを動かす実行基盤 | Amazon Bedrock AgentCore完全ガイド/AgentCore移行ガイド |
bedrock-mantle側の企業統合 |
Claude Code×Bedrock Mantle企業統合ガイド |
| サーバーレスでのコスト・構成設計 | AWS Lambda+Bedrock構築ガイド |
| キャッシュでの費用最適化 | プロンプトキャッシュ比較2026 |
| OpenAIモデル同士の使い分け | GPT-5.5 vs 5.4完全解説 |
| クラウド3社の基盤比較から選ぶ | AIエージェント基盤3強比較 |
本番導入で起きやすい失敗をどう避けるか
失敗1:東京から呼べるので日本国内処理だと思う
❌ ap-northeast-1のエンドポイントを使えば、プロンプトも東京だけで処理されると判断する。
⭕ ソースリージョン、推論プロファイル、宛先リージョンを別の設定値として記録し、CloudTrailのinferenceRegionで処理先を監査する。
なぜ重要か:GPT-5.6に日本ジオ(jp.)はなく、処理先を指定する手段もありません。国内処理が必須なら、モデル選定自体をやり直す判断になります。
失敗2:us.のGeoプロファイルを東京から呼ぶ
❌ 「米国で処理したいからus.openai.gpt-5.6-terraを東京から呼ぶ」と設計する。
⭕ aws bedrock list-inference-profiles --region ap-northeast-1で呼べるプロファイルを確認し、東京ではglobal.だけを使う。
なぜ重要か:us.とin.のソースリージョンは米国・カナダとインドに限られ、東京は含まれません。仕組みの制約ではなく提供状況による制約です。
失敗3:region_nameやbase_urlに宛先リージョンを書く
❌ 処理先が米国だからとbase_urlをbedrock-runtime.us-east-1.amazonaws.comに向ける。
⭕ クライアントのリージョン設定はソースリージョン(東京)のまま、渡す文字列だけをglobal.付きのプロファイルIDへ変える。
なぜ重要か:ソースリージョンを書き換えると、ログ・メトリクス・クォータの集約先まで動きます。東京に観測性を残せる利点を自分で捨てることになります。
失敗4:IAMだけ直してSCPの明示的Denyを見落とす
❌ ロールへbedrock:InvokeModelを追加すればGlobal CRISも動くと考える。
⭕ aws:RequestedRegion=unspecifiedとbedrock:InferenceProfileArnを前提に、Organizations側のSCPをセキュリティチームと確認する。
なぜ重要か:IAMのAllowは、上位のSCPにある明示的Denyを上書きできません。Global CRIS用のステートメントは4つで、リージョン非依存のグローバルARNが欠けると失敗します。
失敗5:272Kの境界を無視してコストを見積もる
❌ 1Mコンテキストを前提に、入力サイズと単価を1つの数字で掛け算する。
⭕ 入力272K以下と272K超で単価表が切り替わることを見積もりへ織り込み、超える見込みならRAGで投入量を絞る。
なぜ重要か:272Kを超えると入力単価が2倍になります。上限まで入ることは、そこまで入れるのが最適という意味ではありません。
失敗6:モデル単価だけで必要クォータを見積もる
❌ 入出力トークンを同じ重みで数え、出力の長いエージェントを本番へ入れる。
⭕ 出力トークン10倍のburndownをクォータ計算へ反映し、GlobalとGeoを別々に負荷試験する。
なぜ重要か:コスト見積もりが収まっていても、TPMを先に使い切ればスロットリングが発生します。増枠申請は本番投入前に出します。
失敗7:Bedrock APIキーを固定シークレットとして長期運用する
❌ 検証用に発行したキーをソースコード、CIログ、コンテナイメージへ残す。
⭕ 実行ロールのAWS認証情報から短期キーを生成し、Secrets Manager等の利用方針とローテーションを明文化する。
なぜ重要か:AWS公式例の短期キーは最長12時間で、長期キーは探索用途のみが公式の推奨です。認証更新を前提にしない実装は、期限切れか固定キー依存のどちらかになります。
よくある質問
GPT-5.6 Bedrockは東京リージョンから使えますか?
使えます。2026年9月27日時点のモデルカードで、東京(ap-northeast-1)はGlobal推論プロファイルのソースリージョンとして有効です。bedrock-runtimeの東京エンドポイントに接続し、global.openai.gpt-5.6-sol / -terra / -lunaのいずれかをモデルとして指定します。In-RegionとGeoは東京では使えません。
Amazon Bedrockはどのリージョンに対応していますか?
サービス全体の対応リージョンとモデル別の対応は別に管理されています。GPT-5.6の場合、2026年9月27日時点のモデルカードでGlobal推論プロファイルが有効なのは32リージョン、Geoは米国側5リージョンとインド2リージョン、In-Regionはbedrock-mantleの米国3リージョンとGovCloud 2リージョンです。モデルごとに違うため、必ず対象モデルのモデルカードで確認してください。
東京から呼べば、データは日本国内だけで処理されますか?
いいえ。Global CRISは対応する商用AWSリージョンへ処理を振り分け、処理先を指定する手段はありません。AWS Japanは「グローバルCRISを使うと推論処理は日本国外のリージョンで実行される」と明記しています。abuse detectionでフラグされた入出力は、処理を担当した宛先リージョンに保存されます。
GPT-5.6に日本ジオ(jp.)の推論プロファイルはありますか?
2026年9月27日時点でありません。AWS Japanブログが明示しています。国内処理が必須なら、jp.プロファイルが提供されている他のモデル、または東京でIn-Region呼び出しに対応する他のモデルを検討することになります。
GPT-5.6 Lunaの単価はいくらですか?
2026年9月27日のモデルカードで、Global CRISのStandardティアが入力100万トークンあたり0.20ドル(1ドル150円換算で30円)、出力1.20ドル(180円)です。In-RegionとGeoは入力0.22ドル(33円)・出力1.32ドル(198円)です。入力が272Kトークンを超えるとlong contextの別表に切り替わり、Globalで入力0.40ドル(60円)・出力1.80ドル(270円)になります。2026年7月30日に80%の引き下げが入った後の値です。
GlobalとGeoの推論プロファイルは何が違いますか?
global.openai.gpt-5.6-terraは対応商用リージョンの広い容量プールを使い、単価がGeoより約9%安く、宛先集合はAWSのリージョン追加で変わり得ます。us.openai.gpt-5.6-terraはUS地理内の定義済みリージョンへ処理を限定し、宛先集合は変わりません。クォータもプロファイルごとに別枠です。
Responses、Chat Completions、Converseのどれを選べばよいですか?
OpenAI SDKの新規実装やResponses形式を使うならResponses、既存のChat Completions資産を保つならChat Completions、複数のBedrockモデルをAWS SDKの共通形へ寄せるならConverseです。明示プロンプトキャッシュは、2026年9月27日時点のモデルカードではResponses APIのみの対応と記載されています。Converseはbedrock-runtime専用で、bedrock-mantleでは使えません。
1MトークンのコンテキストならRAGやキャッシュは不要ですか?
不要にはなりません。入力272Kを超えると単価表が切り替わり、出力はクォータ上10倍で消費されます。RAGは投入する証拠と権限境界を絞り、キャッシュは長い固定接頭辞の再計算を減らします。1Mは入力可能な上限であり、関連性、速度、コスト、クォータを保証する数値ではありません。
入出力はどれくらい保持されますか?
既定はゼロデータ保持です。ただしGPT-5.6 Sol・Terra・Lunaでは、自動abuse-detection分類器がフラグしたトラフィックが最大30日保持され、保存先は処理を担当した宛先リージョンになります。条件を満たす顧客はAWSアカウントチーム経由で完全なZDRを要請できると公式ドキュメントに記載されています。通常のモデル呼び出しログの設定とは分けて評価してください。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- GPT-5.6 Terra model card — Amazon Bedrock User Guide(2026年9月27日取得)
- GPT-5.6 Sol model card — Amazon Bedrock User Guide(2026年9月27日取得)
- GPT-5.6 Luna model card — Amazon Bedrock User Guide(2026年9月27日取得)
- Amazon Bedrock expands API support and introduces Cross Region Inferencing for OpenAI models — AWS、2026年8月17日(2026年9月27日取得)
- Introducing cross-Region inference for OpenAI GPT-5.6 models on Amazon Bedrock — AWS Machine Learning Blog、2026年8月20日(2026年9月27日取得)
- 東京・大阪リージョンから Amazon Bedrock の OpenAI GPT-5.6 を使う — AWS Japanブログ、2026年8月24日(2026年9月27日取得)
- Amazon Bedrock announces up to 80% lower prices for OpenAI GPT-5.6 models — AWS、2026年7月30日(2026年9月27日取得)
- Prompt caching for faster model inference — Amazon Bedrock User Guide(2026年9月27日取得)
- Amazon Bedrock abuse detection — Amazon Bedrock User Guide(2026年9月27日取得)
- Supported Regions and models for inference profiles — Amazon Bedrock User Guide(2026年9月27日取得)
- Amazon Bedrock pricing — AWS(2026年9月27日取得)
- Amazon Bedrock で日本国内クロスリージョン推論がサポートされました — AWS Japanブログ、2025年10月16日(2026年9月27日取得)
- 東京リージョンから Amazon Bedrock の OpenAI GPT-5.6 を呼び出す実装ガイド — AWS Japan、2026年8月24日公開・8月26日更新(2026年9月27日取得)
- GPT-5.6 is now available in Kiro — Kiro、2026年7月14日(2026年9月27日取得)
- GPT-5.6 pricing update — Kiro、2026年7月31日(2026年9月27日取得)
ここまでの要点
GPT-5.6 Bedrockを東京から使う最短経路は、東京のbedrock-runtimeエンドポイントへ接続し、global.openai.gpt-5.6-*をモデルとして渡す構成です。2026年9月27日時点では、これが東京から選べる唯一の経路です。
- 東京はGlobal CRISのソースリージョン。In-RegionとGeo(
us./in.)は東京では使えない - 日本ジオ(
jp.)は提供されていないため、国内処理が必須ならモデル選定から見直す - Global対応は32リージョン。8月20日ブログの「25超」より4つ増えている
- 単価はモデルカードに掲載済み。GlobalはIn-Region・Geoより約9%安く、入力272K超で別表に切り替わる
- キャッシュはTTL 30分・最大4ブレークポイント・1,024トークン以上。書き込みは1.25倍、読み出しは90%割引
- 出力トークンのクォータburndownは10倍。GeoとGlobalのクォータは別枠
- abuse detectionでフラグされた入出力は宛先リージョンに最大30日保持され得る
- Kiroは272Kコンテキストとクレジット乗数、Bedrockは1Mコンテキストとトークン単価。提供条件が別
実装前には、対象データを「Globalで処理可」「国内限定が必須」に分類してください。前者ならそのままGlobal CRISで進められます。後者はこの記事の範囲ではなく、モデル選定の問題です。進める場合は、東京ソースで最小コードを動かし、CloudTrailの処理リージョン、CloudWatchのプロファイル別メトリクスとクォータ使用率、キャッシュのヒット率、出力burndownを本番相当の負荷で確認してから移行判断に進んでください。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
関連(2026年9月): Bedrock上のClaude Fable 5.1(リージョナルエンドポイントやIDプレフィックスの違い)は 「Fable 5.1をBedrock/Vertex/Foundryで使う手順」で整理しています。