2026年11月15日時点で、Gemini 4 Hydrogen を Gemini API から呼ぶモデル ID は gemini-4-hydrogen の 1 つで、有料枠の単価は入力 100 万トークンあたり $1.50・出力(思考トークン込み)$7.50、無料枠でも使えます。入力・思考・出力は 1,048,576 トークンの 1 つの窓(コンテキストウィンドウ。入力と出力を合わせた上限)を共有し、思考の段(thinking_level)は low・medium・high(既定)に新しい xhigh が加わった 4 段です(Google の料金ページ・What’s new in Gemini 4 Hydrogen)。Google は 2026年11月12日(米国時間)に一般提供を始め、GitHub Copilot では 11月13日の Changelog で Pro・Pro+・Max・Business・Enterprise の各プランに段階的に展開すると案内しています。
この記事は、Gemini API か GitHub Copilot で Gemini 4 Carbon・Gemini 4 Argon・Gemini 3.8 Flash から Hydrogen に替えるかを決める開発者と開発の責任者に向けて、モデル ID と最小のコード、無料枠と有料枠の単価、Carbon・Argon との使い分け、Copilot での選び方と管理者の設定、移す前に確かめる引数を、2026年11月15日時点で取得して確認した Google と GitHub の公式の文書の範囲だけで整理します。速さや出来の数字は Google の発表に書かれた物をそのまま載せ、当社では測っていません。Google 検索側の Hydrogen の変化は別の記事に任せ、ここでは API と Copilot に絞ります。
この記事の要点(2026年11月15日時点)
- モデル IDは
gemini-4-hydrogen。Gemini API(GenerateContent と、会話の状態をサーバー側で持てる Interactions API の両方)・Google AI Studio・Google Cloud(Gemini Enterprise Agent Platform のモデル一覧・GA)で同じ ID です。GitHub Copilot ではモデルピッカーで Gemini 4 Hydrogen を選びます。 - 単価は有料枠の Standard で入力 $1.50・出力 $7.50(100 万トークンあたり・思考トークン込み)。1M の窓の全域で同じ単価です。Batch と Flex は $0.75・$3.75(待ち時間が延びてよい処理向け)、Priority は $2.70・$13.50(割増しで待ち時間を短く保つ)。無料枠は無料ですが、入力した内容が Google の製品の改善に使われます。
- 窓と出力は 1,048,576 トークンを入力・思考・出力で共有。同期の出力は既定で 65,536 トークンまで、それ以上は long decode(長い出力を何回かに分けて続けて生成する仕組み・background か継続)で、1,048,576 から入力分を引いた長さまで。
- Carbon・Argon との違い(公式の言葉): Carbon は最も強いフロンティアで 1 ターンに使う思考トークンが多く、Argon は高度で長い仕事の大半を Carbon より少ないトークンでこなし、Hydrogen は日常のコーディング・ツールを使うエージェント・並列のサブエージェントの実行に向く。3 つは同じ 1M の窓・long decode・組み込みツールを共有します。
- GitHub Copilotでは Pro・Pro+・Max・Business・Enterprise で選べ(年額の Pro・Pro+ を旧来の課金のまま続けている人を除く)、Business と Enterprise の管理者は model policy で有効・無効を決めます。Copilot の usage-based billing(使ったトークンの量を GitHub AI Credits に換えて払う課金)の単価は Google と同じ $1.50・$7.50。
対象読者:Gemini API か GitHub Copilot で、Carbon・Argon・3.8 Flash から Hydrogen に替えるか、どこで使えるか、単価はいくらかを決めたい開発者・開発の責任者。
読み終えたらできること:モデル ID の差し替えと thinking_level・max_output_tokens・キャッシュ・サンプリング引数の見直し点を公式の移行チェックで確かめ、Copilot の管理者に有効化を頼む時の条件を言えます。
Gemini 4 Hydrogen の位置づけ|Flash の系統で「誰でも使える Gemini 4」
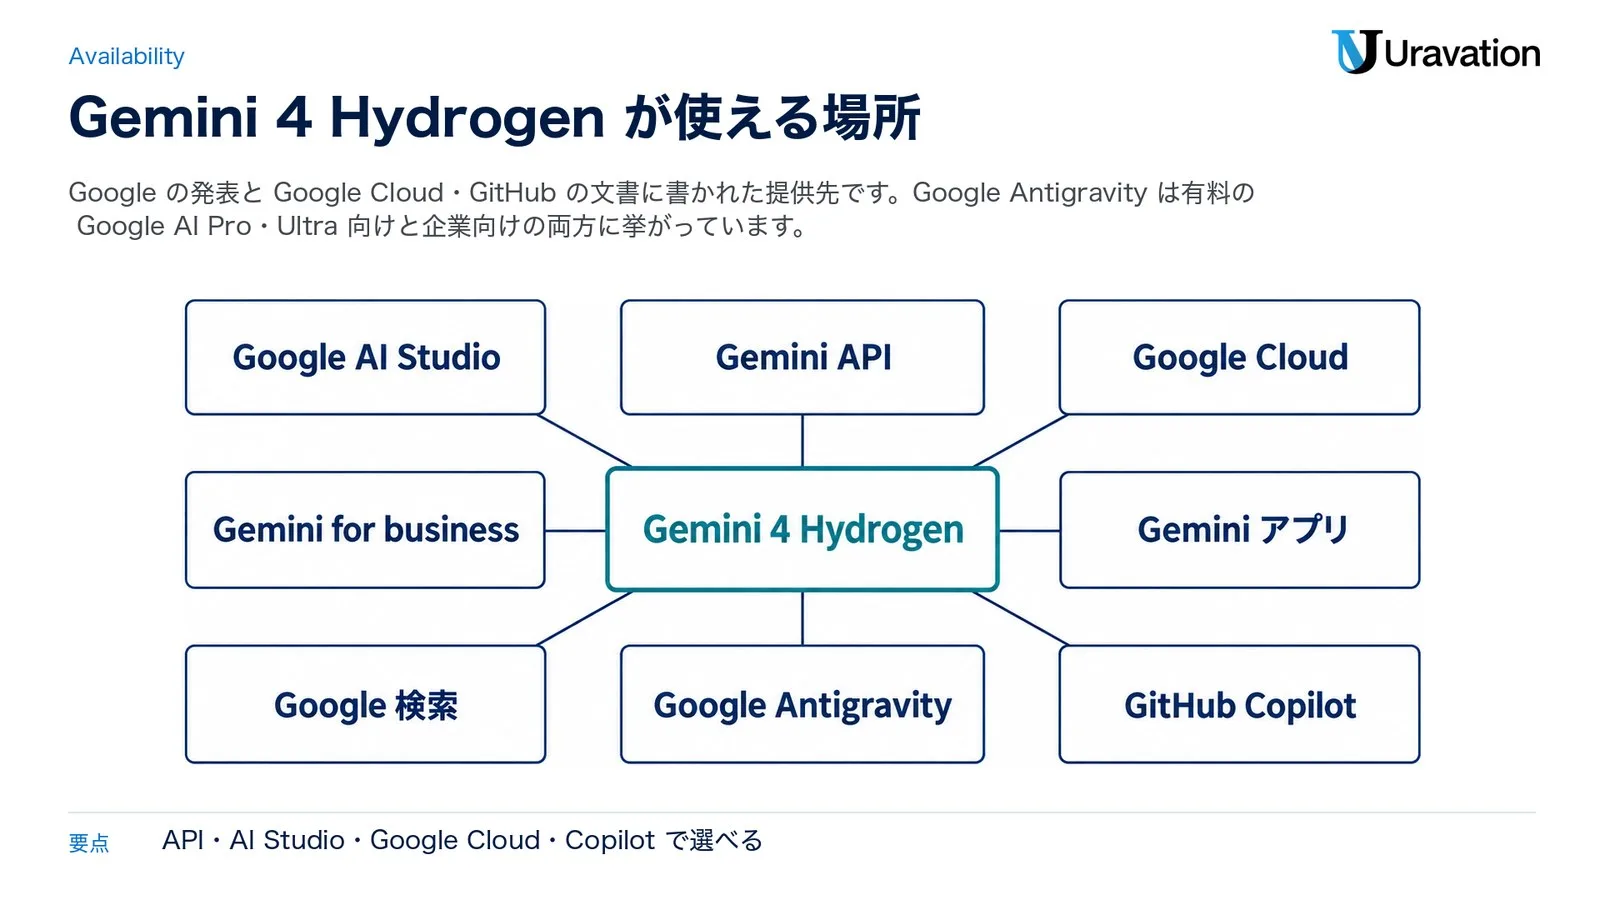
Google はモデル一覧で Gemini 4 Hydrogen を「Brings cutting-edge intelligence to everyone, with speed and efficiency for everyday coding and agentic workflows, featuring a shared 1M context window and long decodes up to 1M tokens.」(最先端の知能を誰にでも。日常のコーディングとエージェントの作業向けの速さと効率、1M の共有の窓と 1M トークンまでの長い出力)と説明しています(Gemini API のモデル一覧)。2026年11月12日の発表では、フロンティアの Gemini 4 Carbon と Gemini 4 Argon が「深い長時間の推論」を受け持ち、Hydrogen は「多様なエージェントの作業での速い実行」のために作ったと書き分け、Hydrogen で Gemini 4 を Google AI Studio の全ての tier・Gemini API・Gemini for business・Gemini アプリ・Google 検索・有料の Google AI Pro と Ultra の Google Antigravity(Google のコーディングエージェント)に広げたとしています(Introducing Gemini 4 Hydrogen)。GitHub の Changelog は Hydrogen を「Google’s latest Flash model」と呼び、Gemini 3.8 Flash より指示に従う力が上がったモデルとして GitHub Copilot で一般提供にしたと書いています。
Gemini 4 の 3 モデルの公式の位置づけを並べると次のとおりです。説明は料金ページと What’s new のページ(モデルの選び方の節)の原文を訳しました。
| モデル | 公式の位置づけ(訳) | 無料枠 | thinking_level の既定 |
|---|---|---|---|
| Gemini 4 Carbon(gemini-4-carbon) | 最も高い能力の推論モデル。仮説の検証とエッジケースの確認に、1 ターンあたり多くの思考トークンを使う | 使えない | medium(上限 high) |
| Gemini 4 Argon(gemini-4-argon) | 効率的なフロンティアの推論モデル。高度で長い仕事の大半を、Carbon より少ないトークンでこなす | 使えない | medium(上限 high) |
| Gemini 4 Hydrogen(gemini-4-hydrogen) | 複雑なエージェントの作業もこなしながら速くて効率的。3.8 Flash と Gemini 3・2.5 からの推奨の移行先(向く仕事は後の「使い分け」の表) | 無料枠でも使える | high(xhigh あり) |
モデルカードによると、Hydrogen は Gemini 4 Carbon から派生(adapted)したモデルです(Gemini 4 Hydrogen model card)。学習データの知識の締め(Knowledge cutoff date)は、Google Cloud のモデルページに 2026年3月と書かれています。入力は文字・画像・動画・音声・PDF、出力は文字だけで、Live API・画像生成・音声生成には対応しません(Gemini 4 Hydrogen のモデルページ)。
速さと出来について Google が発表に書いた主な数字は次のとおりです。Artificial Analysis Intelligence Index(第三者の評価の指標)で、既定の high の思考段で Argon を上回り(51 対 50)、xhigh では 54。Gemini 3.8 Flash と比べて high の既定で 2.5 倍速く仕事を終え、Terminal-Bench 4.1 は 57% 対 18.2%、作り話(fabricated claims)は 5 分の 1 未満。いずれも Google の発表「Introducing Gemini 4 Hydrogen」の数字で、第三者の指標名も Google がその発表で挙げた物です。当社は測っていません。
なおモデル一覧には、2.5 系のモデルは過去に使っていた利用者だけに提供を絞るという注記があり、続けて「新しいプロジェクトには最新のモデル、Gemini 4 Hydrogen か 3.5 Flash-Lite を使う」ように案内しています。
モデル ID と呼び出し方|gemini-4-hydrogen と公式の最小のコード
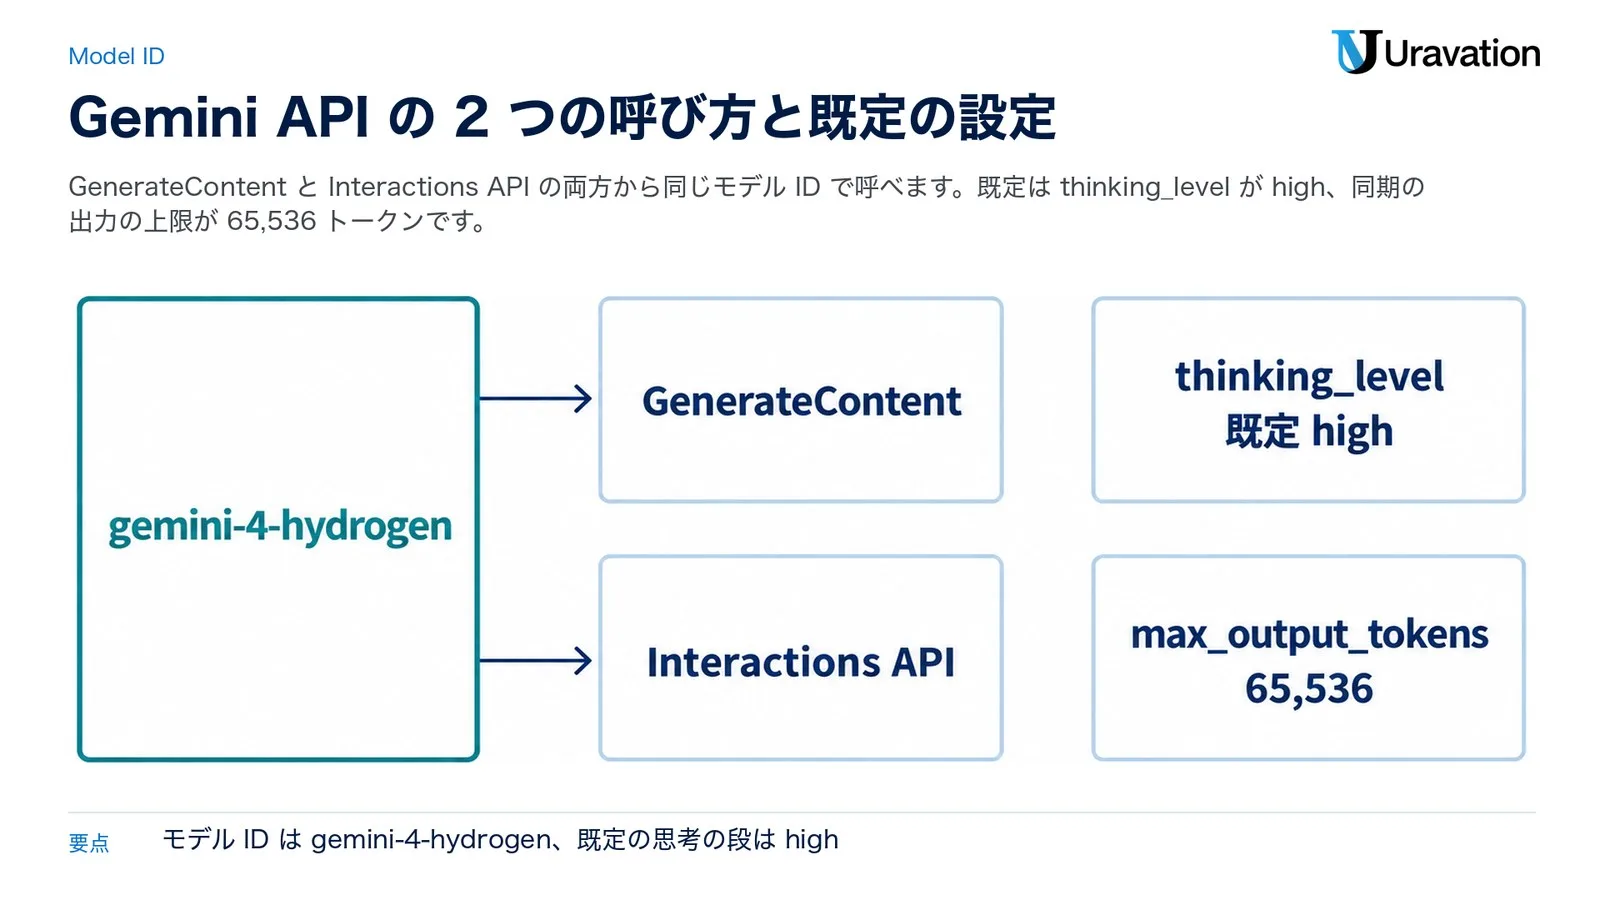
モデル ID は gemini-4-hydrogen で、モデルページの Versions には「Stable: gemini-4-hydrogen」とだけ書かれ、日付つきのプレビュー名はありません(モデルページ)。Gemini API では GenerateContent と Interactions API の両方から呼べ(What’s new)、Google Cloud の文書(Gemini Enterprise Agent Platform のモデルページ。Vertex AI の URL から転送されます)でも同じ ID で、GenerateContent API・Interactions API・Chat Completions API(OpenAI 互換)に対応、Live API には非対応、提供は GA・リリース日 2026年11月12日・リージョンは global・us・eu です(Google Cloud のモデルページ)。既定では thinking_level が high、同期の出力の上限が 65,536 トークンで動きます。
公式の最小のコード(Python・Interactions API)
Google の Quickstart に載っている Python の最小の形です。API キーの用意と SDK の入れ方は Quickstart の手順のとおりです。当社で動かした物ではなく、公式の Quickstart の例をそのまま写しています。本番環境で使用する前に、必ずテスト環境で動作確認してください。
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Explain how AI works in a few words"
)
print(interaction.output_text)
会話を続ける時は、2 回目の呼び出しに previous_interaction_id=interaction.id を渡すと、会話の状態をサーバー側で持てます(Quickstart が「recommended」と書く形)。Python の SDK のセットアップと Function Calling の基本は Gemini API完全ガイド|PythonとFunction Calling にまとめています(2026年3月の記事で、モデル名は当時の物です)。
thinking_level の 4 段|まず high から・minimal は使えない
Google は thinking_level を「Gemini 4 Hydrogen の品質・待ち時間・トークン使用量を決める主な制御」と位置づけ、既定を high にしたうえで xhigh を加えました(Gemini thinking のガイド)。公式の使い分けは次のとおりです。
| thinking_level | 公式の説明(訳) |
|---|---|
| low | 費用や待ち時間を抑えたい時に、medium とともに下げる先として挙げられる段。公式のコード例は low で「有名な物理学者 3 人と業績の一覧」を頼む形 |
| medium | 3.8 Flash から移す時は、medium と high を評価用のテストで比べて速さと費用の釣り合いを決めるよう案内(Carbon と Argon の既定は medium) |
| high(既定) | 「まず high から」。ほとんどの複雑な仕事はここから始める |
| xhigh | high で足りない難しい多段の問題に取っておく。待ち時間とトークンが増えるうえ、文字や JSON の抜き出しのような単純な依頼では考えすぎたり max_output_tokens を使い切ることがある |
- 評価は 4 段すべてで、max_output_tokens を大きくして回し(上限で答えが切れないように)、品質の基準を満たす最も低い段を選ぶ、が公式の手順です。
- minimal は使えない: What’s new は「minimal はエラーで拒否」と書き、Google Cloud の文書は thinking_budget か
thinking_level="MINIMAL"を送ると HTTP 400 の検証エラーになると書いています。古いコードの thinking_budget は外します。
thinking_level を指定する公式の例です(Gemini thinking のガイドの Python をそのまま写した物。"xhigh" の例も同じ形で載っています)。
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Provide a list of 3 famous physicists and their key contributions",
    generation_config={
        "thinking_level": "low"
    }
)
print(interaction.output_text)
max_output_tokens と 1M の窓|上限に当たると “incomplete”
max_output_tokens は思考トークンを含めた応答の上限で、推論の途中で上限に当たると status が “incomplete” になり、切れた出力か空の出力が返ります。その時も生成済みの思考トークンは課金されます。費用や待ち時間を抑えたい時は、小さい max_output_tokens ではなく thinking_level を low か medium に下げるのが公式の案内です。
Gemini 4 の 3 モデル共通で、入力・思考・出力は 1,048,576 トークンの 1 つの窓を共有し、入力と max_output_tokens の合計が窓を超えると API が出力の上限を残りの分に自動で丸めます。同期(background=False)の既定の上限は 65,536 トークンで、Hydrogen はストリーミングでも非ストリーミングでも 1 回(1 hop)で 65,536 トークンまで生成できます(Carbon と Argon の非ストリーミングは 32,768)。65,536 を超える出力が要る時は、max_output_tokens を 65,536 より大きくして background=True にするか、クライアント側の継続(continuation)で 1,048,576 から入力分を引いた長さまで伸ばせます(Long decode のガイド)。background を true にして max_output_tokens を指定しないと、サーバーは 65,536 トークンで止めます。
料金|無料枠と有料の単価・思考トークンも課金
有料枠の Standard の単価は、入力 100 万トークンあたり $1.50、出力(思考トークン込み)$7.50、コンテキストキャッシュ $0.075 で、Google は「1M トークンの窓の全域で同じ単価(flat)」と発表に書いています(料金ページ・Introducing Gemini 4 Hydrogen)。料金ページには Hydrogen の注記として「モデルが処理する全てのトークンを数えて課金する。思考トークンと、グラウンディングを使う時の内部のツールのシステム指示・関数宣言を含む」(グラウンディングは Google 検索やマップの結果を根拠にして答えさせる機能)とあり、出力の単価には思考トークンも入ることを見積もりの前に押さえておきます。請求で見落としやすい 4 つ(思考トークンも課金・無料枠の入力は製品の改善に使われる・キャッシュは暗黙だけ・検索は 1 クエリごと)を、この節で順に確かめます。2026年11月15日時点の料金ページで、Carbon・Argon・3.8 Flash のような期限(〜まで・〜から)が Hydrogen の単価に付いているのは確かめられませんでした。
Hydrogen の単価|消費の方式ごと(100 万トークンあたり・USD)
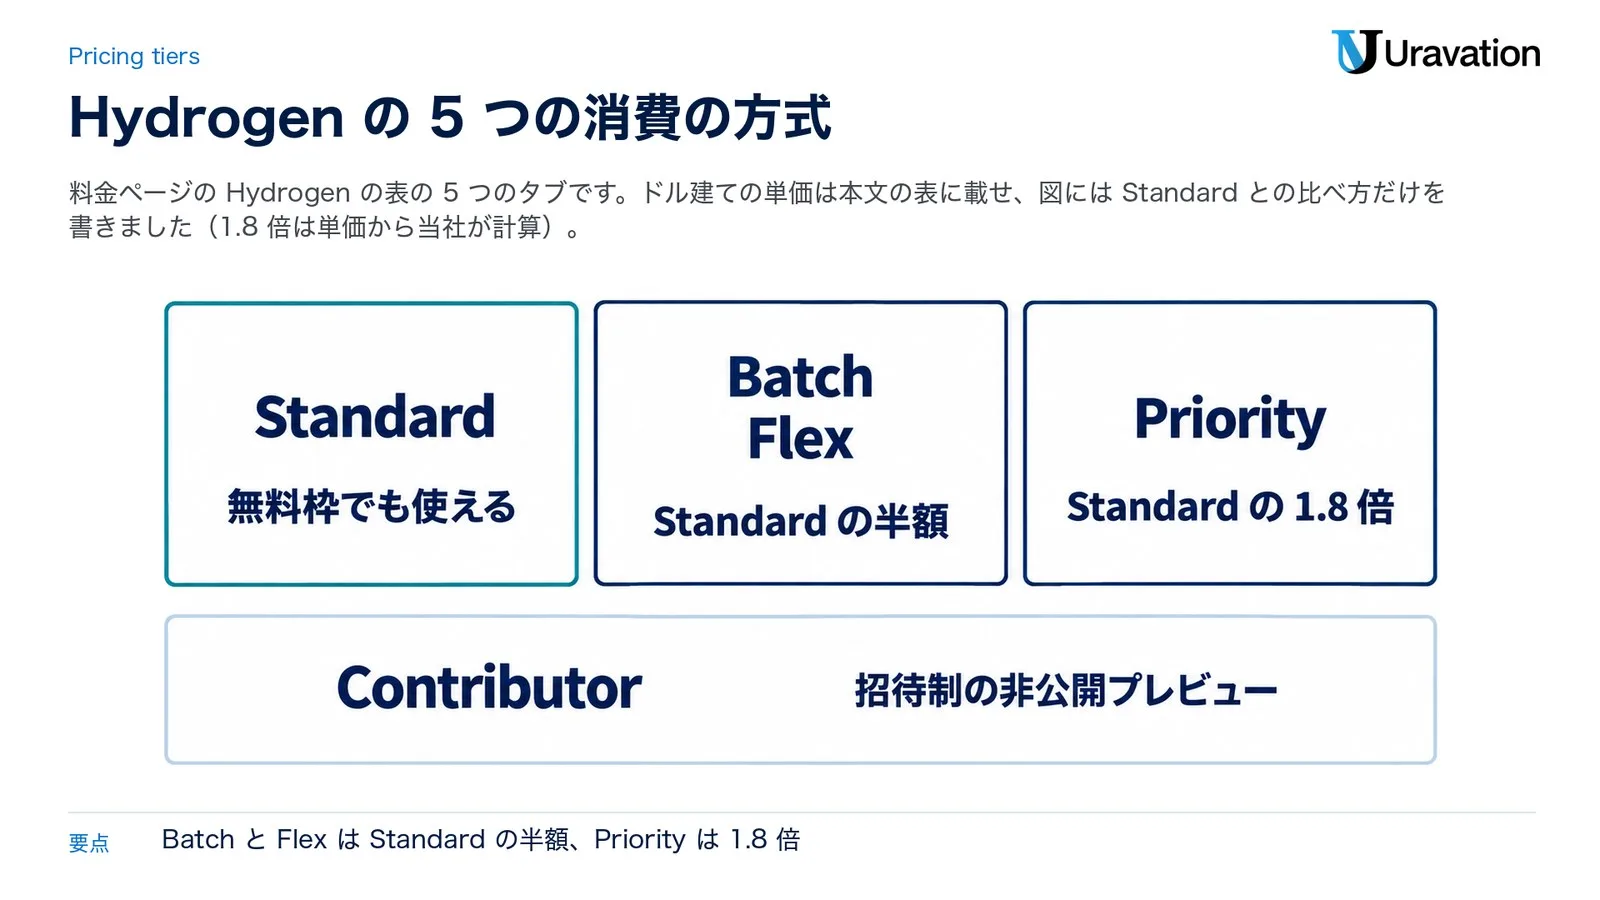
料金ページの Hydrogen の表は Standard・Batch・Flex・Priority・Contributor の 5 つのタブに分かれています。Batch と Flex は速さと引き換えに Standard の半額になる方式で、Batch は急がない大量の依頼をまとめて非同期で処理し(24 時間以内に終えるのが目標・今は generateContent の API だけ)、Flex は待ち時間が数分(1〜15 分が目標)に延び、混んでいる時は 503 で断られても Standard へ自動では切り替わりません。Priority は割増しの代わりに、秒単位の待ち時間と高い信頼性を狙う方式です。Flex と Priority は、各ガイドではプレビューの機能です(Batch API・Flex inference・Priority inference のガイド)。
無料枠(Free Tier)の列は Standard で「Free of charge」、Batch と Flex では「Not available」です。Priority と Contributor の無料枠の列にも「Free of charge」とありますが、無料枠のまま Priority や Contributor を選べるかは確かめられませんでした。
| 方式 | 入力 | 出力(思考込み) | キャッシュ入力 | 無料枠 | 注記(「半額」は Batch・Flex のガイドの記載、「1.8 倍」は単価から当社が計算) |
|---|---|---|---|---|---|
| Standard | $1.50 | $7.50 | $0.075 | 無料(入力は製品の改善に使われる) | 有料枠の入力は製品の改善に使われない |
| Batch | $0.75 | $3.75 | $0.0375 | なし | Standard の半額 |
| Flex | $0.75 | $3.75 | $0.0375 | なし | Standard の半額 |
| Priority | $2.70 | $13.50 | $0.135 | (Free of charge と記載) | Standard の 1.8 倍 |
| Contributor | $0.75 | $3.75 | $0.0375 | (Free of charge と記載) | 招待制の非公開プレビュー。速さと信頼性は Standard と同じ。有料でも入力は製品の改善に使われる |
キャッシュは暗黙だけ(implicit caching)で、明示のキャッシュ(cachedContents・caches.create)は使えません。暗黙のキャッシュは 4,096 トークン以上のプロンプトで既定で働き、キャッシュに当たった入力トークンは 95% 引きの $0.075 になります(What’s new)。Google Cloud の文書には、2027年1月12日から Gemini 4 Hydrogen 以降のモデルで TTL を指定するキャッシュ制御に対応し、キャッシュの書き込みは既定で入力単価の 1.25 倍になるとあります(Google Cloud 側の記載で、Gemini API の料金ページの Hydrogen の節では確かめられませんでした)。
Carbon・Argon・3.8 Flash との単価の比較(Standard・有料枠)
| モデル | 入力 | 出力(思考込み) | キャッシュ入力 | 無料枠 | 期限のある価格 |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.075 | あり | 確かめられず |
| Gemini 4 Carbon | $2.00 → $4.00 | $10.00 → $20.00 | $0.10 → $0.20 | なし | 2026年11月30日まで導入価格、12月1日から右の値 |
| Gemini 4 Argon | $2.00 → $4.00 | $10.00 → $20.00 | $0.10 → $0.20 | なし | 同上 |
| Gemini 3.8 Flash | $0.75 → $1.50 | $3.75 → $7.50 | $0.075 → $0.15 | あり | 2026年12月31日まで現行、2027年1月1日から右の値 |
3.8 Flash の 2027年1月1日からの単価($1.50・$7.50)は Hydrogen の Standard と同じ値です。Carbon と Argon は無料枠がなく、12月1日から単価が 2 倍になります。いずれも料金ページの 2026年11月15日時点の記載で、円の換算は載せません。
グラウンディングと無料枠の条件
- 検索は 1 クエリごと: 料金ページの Hydrogen の表では、Google 検索によるグラウンディングは月 5,000 クエリまで無料(Gemini 3 以降の全モデルで共有)、超えると 1,000 クエリあたり $14、1 日 1,500 クエリの上限があります。1 つのリクエストが複数の検索クエリになることがあり、クエリごとに課金されます。Google マップも月 5,000 リクエストまで無料、超えると $14/1,000。無料枠ではどちらも使えません。
- 無料枠の入力は製品の改善に使われる: 料金ページの「Used to improve our products」は無料枠が Yes、有料枠が No です(招待制の Contributor だけは有料でも Yes)。社内のコードや顧客のデータを流す前に、この列を確かめます。
- レート制限はプロジェクト単位(API キー単位ではない)で、主に 1 分あたりのリクエスト数(RPM)・1 分あたりの入力トークン数(TPM)・1 日のリクエスト数(RPD)で測られ、RPD は太平洋時間の 0 時に戻ります。使った額に応じた上限(spend-based rate limits)もあります。モデルと tier ごとの値は Rate limits のページと AI Studio の画面で確かめます(この記事には値を写しません)。
- GitHub Copilot 経由の usage-based billing でも、Hydrogen の単価は入力 $1.50・キャッシュ入力 $0.075・出力 $7.50 と Google の値と同じです(後述)。
Carbon・Argon との使い分け|公式の説明の範囲で
What’s new のページは、Gemini 4 Hydrogen・Argon・Carbon が「同じ 1M の共有の窓・long decode の仕組み・組み込みツール」を持つとしたうえで、「推論の深さ・待ち時間・費用の目標に合うモデルを選ぶ」ように案内しています。ここでは Google が書いた使い分けだけを並べ、当社の評価は加えません(What’s new in Gemini 4 Hydrogen)。
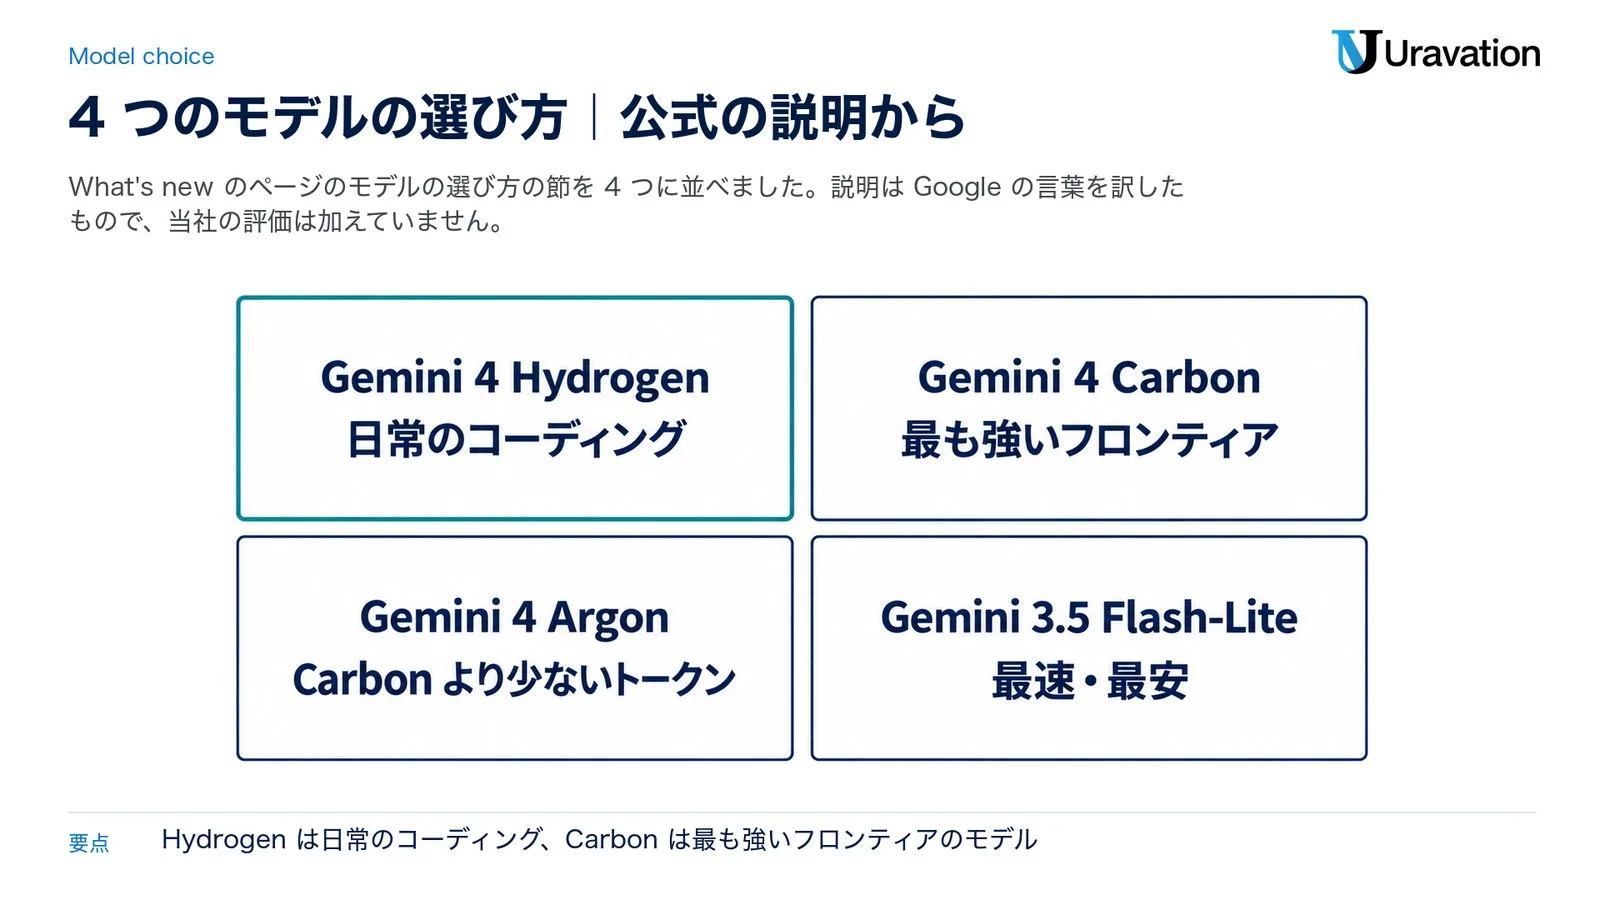
| モデル | Google が挙げる向く仕事 | thinking_level | 非ストリーミング 1 hop の上限 | Standard の単価(入力/出力) |
|---|---|---|---|---|
| Gemini 4 Hydrogen | 日常のコーディング・対話的な Web アプリ・ツールを使うエージェント・マルチモーダルの文書処理・並列のサブエージェントの実行。3.8 Flash と Gemini 3・2.5 からの推奨の移行先 | 既定 high・xhigh まで | 65,536 | $1.50/$7.50 |
| Gemini 4 Carbon | 最も強いフロンティア。難しいアーキテクチャ・デバッグ・科学・セキュリティ監査で、仮説の検証とエッジケースの確認に 1 ターンあたり多くの思考トークンを使う | 既定 medium・high まで | 32,768 | $2.00/$10.00(11月30日まで) |
| Gemini 4 Argon | 高度で長い仕事の大半を、Carbon より少ないトークンでこなしたい時 | 既定 medium・high まで | 32,768 | $2.00/$10.00(11月30日まで) |
| Gemini 3.5 Flash-Lite | 最速・最安。大量の分類・振り分け・1 秒未満の応答が目標の処理はこのまま | — | — | (料金ページ参照) |
Carbon と Hydrogen を 1 つの流れで組む|計画は Carbon・実行は Hydrogen
What’s new は「Carbon と Hydrogen を 1 つのワークフローで組み合わせる」書き方を具体的に示しています。Carbon にシステムのインターフェースの計画と難所の解決を任せ、コードの編集・並列のサブエージェントの仕事・テストの実行を Hydrogen に委ねる形です。実装では、同じ会話の中で計画のターンを gemini-4-carbon、実行のターンを gemini-4-hydrogen に向け、previous_interaction_id でつなぐ(ステートレスなら thought steps を保ったまま)と書かれています。同じ会話の中でモデルを切り替えられる設計で、Carbon・Argon から Hydrogen を足す・替える時にリクエストの形(スキーマ)を変える必要はないとしています。
Google の発表「Introducing Gemini 4 Hydrogen」では、Google Antigravity に入った Orchestrator が同じセッションの中で Carbon と Hydrogen を動的に切り替え、Terminal-Bench 4.0 で Carbon に近い成功率を出しながら、平均で利用枠の消費が 24% 少なく、19% 速く終えたとしています。並列のエージェントでは Carbon が調整役、Hydrogen が作業役と検証役を受け持つ組み方も発表に書かれています。いずれも Google の発表の数字と構成です。発表では、Google Antigravity は、開発者向けには有料の Google AI Pro・Ultra の利用者が試せる場所として、企業向けには Gemini for business(API かモデルの選択欄)・対象の業務用プランの Gemini in Google Sheets と並ぶ提供先として挙げられています。
大量の分類・振り分けや 1 秒未満の応答が目標の処理について、What’s new は Gemini 3.5 Flash-Lite の説明で Flash-Lite のままにするよう案内しています。Flash-Lite 系を使う場面の考え方は Gemini 3.1 Flash-Lite解説|APIコストと他モデルの使い分け に書いています(2026年3月の 3.1 Flash-Lite の記事で、単価は今の料金ページで読み直してください)。
GitHub Copilot で使う|対象プラン・選べる場所・管理者の model policy
GitHub は 2026年11月13日の Changelog「Gemini 4 Hydrogen in GitHub Copilot」で、Hydrogen を Copilot で一般提供(GA)にしたと発表しました。速くて効率的なエージェントのコーディング・ツール使用・多段の作業向けで、Gemini 3.8 Flash より指示に従う力が上がった、という説明です。課金は「usage-based billing の下でプロバイダーの定価(provider list pricing)」で、展開は段階的(「まだ出てこなければ後で確かめて」)と書かれています(GitHub Changelog・2026年11月13日)。
| 項目 | Changelog と GitHub Docs の記載(2026年11月15日時点) |
|---|---|
| 対象プラン | Copilot Pro・Pro+・Max・Business・Enterprise。Copilot Free は Changelog の一覧に入っていません(GitHub Docs の Supported AI models in Copilot では、Copilot Free と Copilot Student は自動のモデル選択だけで使え、2026年11月15日時点の自動のモデル選択の表で Hydrogen は確かめられませんでした)。年額の Copilot Pro・Pro+ を、リクエストの回数をモデルごとの倍率で数える旧来の課金(premium request の request-based billing)のまま続けている人には、GitHub Docs が「新しいモデルと機能は提供されない」と書いています(Model multipliers for annual plans on request-based billing (legacy)) |
| 選べる場所(モデルピッカー) | Visual Studio Code・Visual Studio・Copilot CLI・Copilot coding agent・GitHub Copilot app・github.com・GitHub Mobile(iOS・Android)・JetBrains IDEs・Xcode・Eclipse・Copilot SDK の 11 か所 |
| 最低の IDE の版 | GitHub Docs の対応モデルの表では Gemini 4 Hydrogen は GA、IDE ごとの最低の版は全て TBD(Supported AI models in Copilot) |
| 単価(usage-based billing) | 入力 $1.50・キャッシュ入力 $0.075・出力 $7.50(100 万トークンあたり・Google の値と同じ)。区分は Versatile。どのプランも、含まれる GitHub AI Credits の枠を超えた分が、この単価で GitHub AI Credits(1 credit = $0.01)として課金されます(Models and pricing for GitHub Copilot) |
| 管理者の設定 | Business と Enterprise の管理者は Copilot settings の model policy で Hydrogen の有効・無効を決める。default model enablement の下では、管理者が全体の既定を切っているか、このモデルを明示的に無効にしていなければ、新しいモデルは自動で有効になる |
「自分の IDE に出てこない」時に確かめる順は、下の「よくある質問」にまとめました。モデルの切り替えの手順(VS Code・GitHub.com・CLI・組織のポリシー)と他のモデルの並びは Copilotのモデル選択|Haiku 5.5・GPT-6.1 Sol【2026年10月】、管理者が組織の model policy を API でまとめて管理する手順は CopilotモデルポリシーAPIで一括管理(2026年10月版) に書いています。GitHub Docs は、Enterprise か Organization のオーナーが Business・Enterprise のシートを持つメンバーのモデルを有効・無効にできると説明しています(Configure access to AI models)。
移行の時に確かめること|3.8 Flash から・Carbon と Argon から
What’s new のページには「Migration checklist」として、Gemini 3.8 Flash と Gemini 3 以前から移す時の変更点が 9 項目、Carbon・Argon から替える(または並べて使う)時の変更点が 4 項目書かれています。Hydrogen は Carbon・Argon と同じ Gemini 4 の API 設計なので、3.8 Flash から来る人ほど直す所が多くなります(What’s new in Gemini 4 Hydrogen・Migration checklist)。
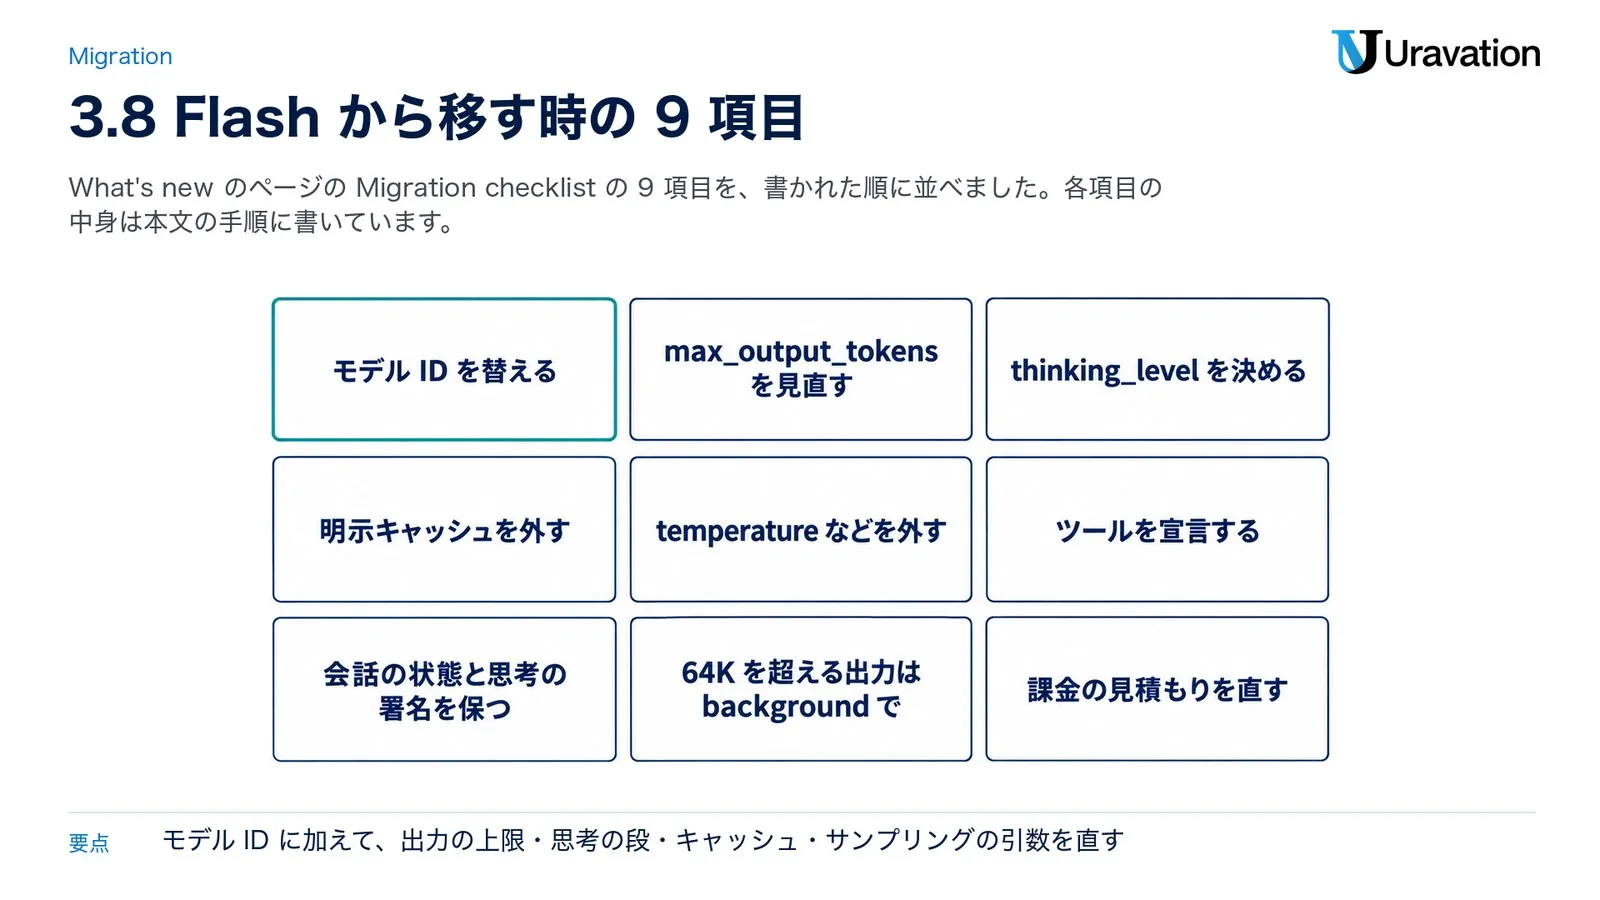
3.8 Flash と Gemini 3 以前から移す手順(公式の 9 項目を順に)
- モデル ID を替える: モデルの文字列を
gemini-3.8-flashからgemini-4-hydrogenに変えます。 - max_output_tokens を見直す: 3.8 Flash は入力 1M と出力 64K の別々の予算でしたが、Hydrogen は入力・思考・出力で 1,048,576 トークンの 1 つの窓を共有します(同期の 1 回の応答の既定と上限は 65,536 のまま)。8,192 のような固定の小さい上限は外すか、65,536 に上げます。長い出力や多段の仕事は background を true にして 131,072 か 262,144(上限は 1,048,576 から入力分を引いた値)が公式の目安です。
- thinking_level を決める: 既定は medium ではなく high になり、xhigh が加わり、minimal はエラーで拒否されます。評価用のテストで medium と high を比べて速さと費用を決めます。
- 明示キャッシュを外す: cachedContents と caches.create は使えません。リクエストから cached_content を消します。暗黙のキャッシュは 4,096 トークン以上のプロンプトで既定で働き、当たった入力は 95% 引きです。
- temperature などを外す: temperature・top_p・top_k をリクエストから消します。範囲内の値は無視され、範囲外の値は 400 の検証エラーになります(Google Cloud の文書では temperature 1.0・topP 0.95・topK 64 に固定)。
- ツールを宣言する: システム指示で「JSON のツール呼び出しを素の文字で返せ」と頼む書き方(ツールの宣言が 0 の状態)は MALFORMED_FUNCTION_CALL を返すことがあります。ツールは関数呼び出しでネイティブに宣言するか、JSON の返答を構造化出力で縛ります。
- 会話の状態と思考の署名を保つ: 思考の署名(thought signatures)は、モデルの内部の推論を暗号化した物で、複数ターンで推論の続きを保つのに要ります(Gemini thinking のガイド)。複数ターンとツール呼び出しは Interactions API の previous_interaction_id を使います。generateContent で履歴を自分で持つ時は、前のモデルのターンと思考の署名を変えずに毎ターン返し、並列の functionCall の間で署名をコピーしません。
- 64K を超える出力は background で: background を true、max_output_tokens を 65,536 より大きくします(最新の SDK ならクライアント側の継続でも可)。ストリームの HTTP の読み取りタイムアウトは 1 ストリームあたり 15〜20 分が Long decode のガイドの目安です。
- 課金の見積もりを直す: 思考トークンと、グラウンディング時の内部のシステム指示・関数宣言を含む全てのトークンが数えられ課金されます。3.8 Flash の見積もりを単価の差し替えだけで流用しません。
Carbon・Argon から替える・並べて使う時の 4 点
- リクエストのスキーマの変更は不要。単体のリクエストかサブエージェントのターンの
modelを gemini-4-hydrogen にします。 - 既定の thinking_level が medium から high に変わり、xhigh が選べます。medium の挙動のままにしたい時は thinking_level を明示します。
- 非ストリーミングの 1 hop が 32,768 から 65,536 に増えます。継続の回数を前提にしたコードがあれば見直します。
- 同じ会話で、計画のターンを gemini-4-carbon、実行のターンを gemini-4-hydrogen に向け、previous_interaction_id でつなぐ組み方が公式に書かれています。
Argon の long decode の実装(Interactions API の background と continuation_token)と、3.1 Pro から移す時に探して直す引数は Gemini 4 Argon API|移行手順と料金の試算【2026年10月】 にまとめています。Argon 向けに直したコードから Hydrogen に替える時に見るのは、上の 4 点です(What’s new はリクエストのスキーマの変更は要らないとしています)。
【要注意】Gemini 4 Hydrogen の API で起きやすい読み違い 4 つ
公式の文書を読み比べて、Carbon・Argon・3.8 Flash の経験をそのまま持ち込むと間違えやすい所を 4 つ挙げます。いずれも料金ページ・What’s new・Gemini thinking のガイドに根拠があり、一部は Google Cloud の文書とモデルカードの記載です。
読み違い 1:無料枠で使えるので、社内のデータもそのまま試してよいと考える
❌ 無料枠で $0 だから検証用に本番のログや顧客の文書を流す。
⭕ 料金ページの「Used to improve our products」は無料枠が Yes、有料枠(Standard・Batch・Flex・Priority)が No です。入力が Google の製品の改善に使われてよいデータだけを無料枠に入れ、それ以外は有料枠(招待制の Contributor を除く)のプロジェクトで試します。無料枠では Google 検索・マップのグラウンディングも使えません。
読み違い 2:max_output_tokens を小さくすれば費用が抑えられると考える
❌ 3.8 Flash の時の 8,192 の上限を残して Hydrogen に替える。
⭕ max_output_tokens は思考トークンを含めた上限で、推論の途中で上限に当たると status “incomplete” で切れた出力か空の出力が返り、生成済みの思考トークンは課金されます。費用と待ち時間を抑える手段は thinking_level を low か medium に下げることで、上限は 65,536 の既定に戻すか外すのが公式の案内です。
読み違い 3:3.8 Flash のリクエストの引数がそのまま動くと考える
❌ temperature・top_p・top_k・cached_content・thinking_budget を残したまま model だけ替える。
⭕ temperature などの範囲内の値は無視され、範囲外の値は 400 の検証エラーになります。cached_content(明示キャッシュ)は非対応で、thinking_level=”minimal” はエラーです(Google Cloud の文書は、thinking_budget を送った時も HTTP 400 になると書いています)。移す前に、リクエストを組む関数からこれらの引数を外し、暗黙のキャッシュ(4,096 トークン以上で既定)に任せます。
読み違い 4:xhigh にすれば常に良い答えになると考える
❌ 品質を上げたいので全てのリクエストを xhigh にする。
⭕ Google は「まず high から始め、high で足りない難しい多段の問題に xhigh を取っておく」と書き、xhigh は待ち時間とトークンが増え、文字や JSON の抜き出しのような単純な依頼では考えすぎたり max_output_tokens を使い切ることがあるとしています。評価は 4 段すべてで回し、基準を満たす最も低い段を選びます。モデルカードも、高い思考段では性能を最大にするためにトークンを多く使うことがあると注記しています。
よくある質問
Gemini 4 Hydrogen の API は無料で使えますか?
使えます。What’s new のページに「Google AI Studio と Gemini API の無料枠と有料枠の両方で使える(GenerateContent と Interactions API)」とあり、料金ページの Standard の無料枠の列は入力・出力・キャッシュとも「Free of charge」です。条件は 3 つで、レート制限がかかること、無料枠に入力した内容は Google の製品の改善に使われること(有料枠は使われない。招待制の Contributor を除く)、Google 検索・マップのグラウンディングと Batch・Flex は無料枠で使えないことです。Carbon と Argon は無料枠では使えません。
モデル ID は何ですか?プレビュー版の名前はありますか?
モデル ID は gemini-4-hydrogen です。モデルページの Versions は「Stable: gemini-4-hydrogen」だけで、日付つきのプレビュー名はありません。Google Cloud(Gemini Enterprise Agent Platform のモデル一覧)でも同じ ID で、提供段階は GA、リリース日は 2026年11月12日です。GitHub Copilot のモデルピッカーの表示名は「Gemini 4 Hydrogen」です。
3.8 Flash から替えると料金は上がりますか?
2026年12月31日までの 3.8 Flash の単価(入力 $0.75・出力 $3.75)と比べると、Hydrogen の Standard($1.50・$7.50)は 2 倍の単価です。ただし 3.8 Flash は 2027年1月1日から $1.50・$7.50 になり、Hydrogen と同じ値です。請求は単価だけでなく、思考トークンを含む処理した全トークンで決まります。What’s new は 3.8 Flash から移す時の注意として、Hydrogen の既定の thinking_level が medium ではなく high になると書き、medium と high を評価用のテストで比べて速さと費用を決めるよう案内しています。同じ評価用の入力で両方のモデルを回し、合計トークンを比べてから判断します。Google は 3.8 Flash と比べた速さと出来の数字を発表に書いていますが、料金の比較は料金ページの単価だけを根拠にしてください。
Carbon・Argon から替える時にコードを直す所はありますか?
What’s new は「リクエストのスキーマの変更は不要」とし、必ず替えるのは model の文字列です。What’s new が挙げる違いは、既定の thinking_level が medium から high になること(xhigh も選べる)と、非ストリーミングの 1 hop が 32,768 から 65,536 トークンに増えることで、このほか Hydrogen には無料枠があります。medium の挙動を保ちたい時は thinking_level を明示します。
GitHub Copilot で Hydrogen が出てこないのはなぜですか?
確かめる順は 4 つです。プランが Pro・Pro+・Max・Business・Enterprise のどれかか(Copilot Free は Changelog の対象に入っていません。年額の Copilot Pro・Pro+ を旧来の premium request の課金のまま続けている人には「新しいモデルと機能は提供されない」と GitHub Docs にあります)、Business・Enterprise なら管理者が model policy で無効にしていないか、展開が自分のアカウントに届いているか(GitHub は「段階的な展開」と書いています)、IDE と Copilot の拡張が最新か(GitHub Docs の最低の版は TBD=未定)。管理者は Copilot settings の model policy で有効にできます。
Vertex AI(Google Cloud)でも使えますか?
使えます。Google Cloud の文書では Gemini Enterprise Agent Platform のモデルページに Gemini 4 Hydrogen が載り(Vertex AI のモデル一覧の URL から転送されます)、Model ID は gemini-4-hydrogen、Launch stage は GA、Release date は November 12, 2026、リージョンは global・us・eu、Provisioned Throughput と Batch inference に対応、Live API と Fixed quota には非対応です。thinking_level は LOW・MEDIUM・HIGH(既定)・XHIGH で、thinking_budget か MINIMAL を送ると HTTP 400 になります。
まとめ
Gemini 4 Hydrogen は、モデル ID gemini-4-hydrogen、有料枠の Standard で入力 $1.50・出力 $7.50(思考トークン込み・1M の窓の全域で同じ単価)、無料枠あり、入力・思考・出力で 1,048,576 トークンを共有し、thinking_level は low・medium・high(既定)・xhigh の 4 段です。Google は Carbon・Argon を「深い長時間の推論」、Hydrogen を「速い実行」と書き分け、計画を Carbon・実行を Hydrogen に分けて同じ会話でつなぐ組み方を公式に示しています。
- Carbon・Argon から替えるなら、リクエストの形は変えずに model の文字列を替えます。既定の thinking_level が medium から high に変わるので、medium のままにしたい時は明示します。非ストリーミングの 1 hop が 32,768 から 65,536 に増える点も押さえます。
- 3.8 Flash から移すなら、公式の 9 項目の順に。小さい max_output_tokens・temperature・cached_content・thinking_budget を外し、ツールはネイティブに宣言するか、構造化出力で JSON の返答を縛ります。
- GitHub Copilot では Pro・Pro+・Max・Business・Enterprise で段階的に展開(旧来の課金のままの年額の Pro・Pro+ には新しいモデルが提供されないと GitHub Docs に記載)。管理者は model policy、単価は Google と同じ $1.50・$7.50。
- 無料枠の入力は製品の改善に使われます。社内のデータを流す検証は有料枠(招待制の Contributor を除く)のプロジェクトで行います。
Carbon と Argon の導入価格は 2026年11月30日まで、3.8 Flash の現行の単価は 12月31日までです。この 2 つの期限の前後で、どの仕事をどのモデルに向けるかを評価用のテストで決めておくと、12月と 1月の請求の読み違いを避けられます。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Gemini 4 Hydrogen(モデルページ) — Google AI for Developers・Gemini API docs、Latest update November 2026(参照日: 2026-11-15)
- What’s new in Gemini 4 Hydrogen — Gemini API docs(参照日: 2026-11-15)
- Gemini Developer API pricing(Gemini 4 Hydrogen の節) — Gemini API docs(参照日: 2026-11-15)
- Gemini models(モデル一覧) — Gemini API docs(参照日: 2026-11-15)
- Gemini thinking — Gemini API docs(参照日: 2026-11-15)
- Long decode — Gemini API docs(参照日: 2026-11-15)
- Release notes(November 12, 2026 の項) — Gemini API docs(参照日: 2026-11-15)
- Gemini API quickstart — Gemini API docs(参照日: 2026-11-15)
- Rate limits — Gemini API docs(参照日: 2026-11-15)
- Batch API — Gemini API docs(参照日: 2026-11-15)
- Flex inference — Gemini API docs(参照日: 2026-11-15)
- Priority inference — Gemini API docs(参照日: 2026-11-15)
- Introducing Gemini 4 Hydrogen — Google The Keyword、Koray Kavukcuoglu、2026年11月12日(11月13日更新)(参照日: 2026-11-15)
- Gemini 4 Hydrogen: everyday coding and agentic workflows for developers — Google The Keyword、2026年11月12日(参照日: 2026-11-15)
- Gemini 4 Hydrogen model card — Google DeepMind(参照日: 2026-11-15)
- Gemini 4 Hydrogen(Gemini Enterprise Agent Platform のモデルページ) — Google Cloud、Release date November 12, 2026(参照日: 2026-11-15)
- Gemini 4 Hydrogen in GitHub Copilot — GitHub Changelog、2026年11月13日(参照日: 2026-11-15)
- Supported AI models in Copilot — GitHub Docs(参照日: 2026-11-15)
- Models and pricing for GitHub Copilot — GitHub Docs(参照日: 2026-11-15)
- Model multipliers for annual plans on request-based billing (legacy) — GitHub Docs(参照日: 2026-11-15)
- Configure access to AI models — GitHub Docs(参照日: 2026-11-15)