2026年9月24日時点で、Gemini 3.8 Flash TTS(gemini-3.8-flash-tts)と Gemini 3.8 Flash-Lite TTS(gemini-3.8-flash-lite-tts)は Gemini API と Google AI Studio で正式提供(GA)されていて、音声出力の単価は 100万トークンあたり $9.00 と $6.00(いずれも 2026年12月31日まで。2027年1月1日から $18.00 と $12.00)です。公式の注記にある「音声は 1 秒あたり 25 トークン」で割り戻すと、1 時間の音声はそれぞれ $0.81 と $0.54 になります。対応言語は 130 と 101 で、どちらも日本語を含みます。
開発者にとっての本題は値段よりも API の書き方が変わったことです。旧 gemini-3.1-flash-tts-preview では台本の中に「明るく:こんにちは」のような演出を混ぜて書いていましたが、Gemini 3.8 TTS は text を逐語の台本として扱います。演出はターン単位の speech_metadata.style と、台本内に置く山かっこタグに分けて渡します。さらに非ストリーミング時の既定出力が raw PCM から WAV に変わったため、旧コードをそのまま向けると音声ファイルが壊れます。この記事は、公式ドキュメントに書かれている範囲だけで、料金・仕様・移行のつまずきどころを整理します。
結論|2 モデルとも正式提供、音声出力は 100万トークンあたり $9.00 と $6.00
Google は 2026年9月23日に公式ブログ「Gemini 3.8 text-to-speech says hello」で 2 つの TTS モデルを発表しました。Gemini API のリリースノート(release notes)側の日付は 2026年9月22日で、「次世代の text-to-speech 音声モデルと Gemini API Voices エンドポイント(/v1beta/voices)を GA として提供」と書かれています。preview ではなく GA という点が、旧 gemini-3.1-flash-tts-preview との大きな違いです。
公式ブログが挙げている変更点は 3 つに整理できます。
- プリセットから「作る」へ:自然言語の説明文から声そのものを作れるようになりました(Voice design)。既存の声を再現する機能(Voice replication)も同時に提供されています。
- 行ごとの演出:間・感情・方言の切り替え・相づちを、台本の行単位で指定できます。
- 安全機能が内蔵:生成された音声にはすべて SynthID の透かしが入り、声の再現には所有者本人の同意音声が必要です。公式ブログは C2PA のクレデンシャルにも触れています。
Google は Gemini Audio 系列として Live API 向けの 3.8 Live、文字起こしの 3.5 Transcribe、翻訳の 3.5 Live Translate を先に出しており、今回の 2 つはその「読み上げ」側にあたります。Live API 側の使い分けはGemini 3.8 Live の解説記事で扱っているので、対話型の音声エージェントを作るつもりの人はそちらも合わせて読んでください。
Gemini 3.8 TTS とは|Flash と Flash-Lite の違いを表で
2 つのモデルは API のスキーマとプロンプトの書き方が完全に同じで、公式ドキュメントも「パラメータを 1 つ変えるだけで切り替えられる」と明記しています。違うのは音質の上限・対応言語数・単価です。
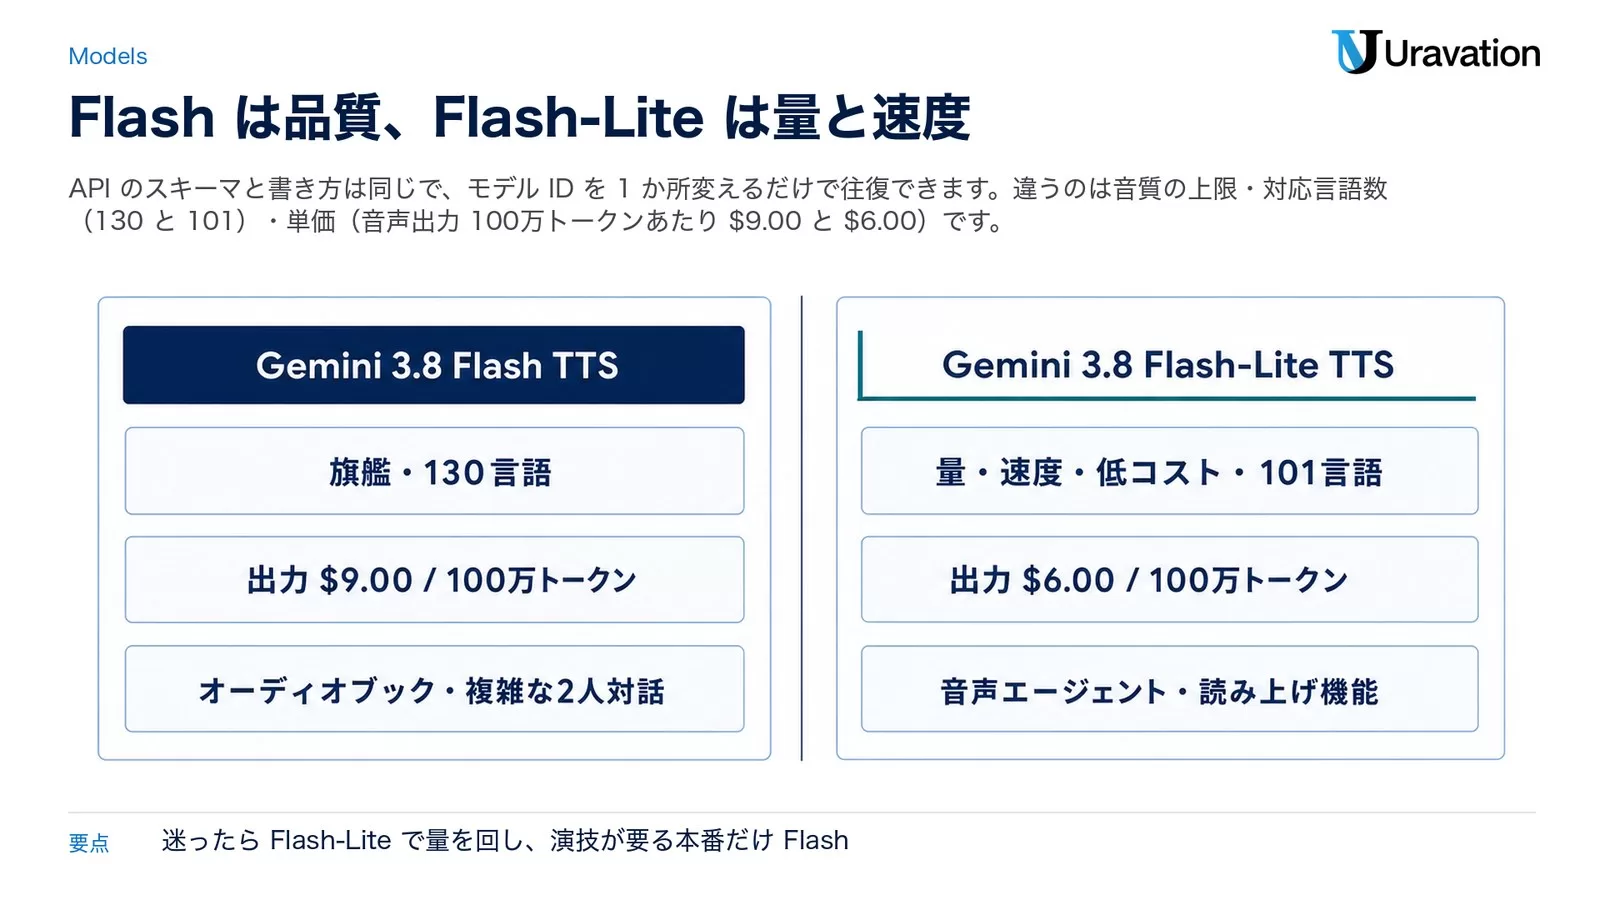
| 項目 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| モデル ID | gemini-3.8-flash-tts |
gemini-3.8-flash-lite-tts |
| 位置づけ | 旗艦のクリエイティブ向け | 高スループット・低遅延・低コスト |
| 得意な仕事 | オーディオブック、スタジオ品質のナレーション、複雑な 2 人対話、方言・難読の発音 | 大量生産、リアルタイム音声エージェント、読み上げ機能、日常的な 1 人音声 |
| 対応言語 | 130 言語 | 101 言語 |
| 置き換え対象 | 新設の旗艦(該当なし) | gemini-3.1-flash-tts-preview |
| 入力トークン上限 | 8,192 | 8,192 |
| 出力トークン上限 | 16,384 | 16,384 |
| 音声出力(100万トークン・2026年内) | $9.00 | $6.00 |
機能面は 1 人音声・2 人音声・Voice design・Voice replication のすべてに両方が対応しています。一方で、関数呼び出し・構造化出力・thinking・コード実行・検索グラウンディングはどちらも非対応です(コンテキストキャッシュは対応)。TTS モデルは「テキストを入れて音声を出す」専用で、エージェントの頭脳として使うものではない、という線引きがモデルページのスペック表にはっきり出ています。
公式ブログは第三者ベンチマークの順位にも触れていて、Hume AI の Voice Design Benchmark で総合 1 位(71.4)、アクセント再現でも首位(60.8)、Overall Quality Index で Flash TTS が 1 位・Flash-Lite TTS が 2 位と書かれています。Voice Arena の人手による比較では日本語を含む主要言語で上位、とも記載されています。いずれも Google の発表ページに載っている数字であり、当社で測定したものではありません。
どこで使えるか|開発者は Gemini API と Google AI Studio から
公式ブログの「Start using our latest Gemini Audio models」節に、提供面が対象者別で書かれています。同じ日に全部が開くわけではない点に注意してください。
| 提供面 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| Gemini API(開発者) | 提供中 | 提供中 |
| Google AI Studio(開発者) | 提供中 | 提供中 |
| Gemini Enterprise(法人) | API 経由で近日 | API 経由で近日 |
| Gemini Notebook(一般利用者) | 提供中 | 記載なし |
| Google Vids(一般利用者) | 記載なし | 提供中 |
一般向けの 2 面が Flash と Flash-Lite で分かれているのが読みどころです。Gemini Notebook には表現力の高い Flash TTS、Google Vids には量をさばく Flash-Lite TTS が入る、という割り当てになっています。法人向けの Gemini Enterprise はどちらも「Coming soon via API」で、2026年9月24日時点では提供開始日は公表されていません。
開発プラットフォーム側では、公式ブログが Agora・LiveKit・Pipecat・Vercel を「Gemini API 経由で音声生成を組み込める開発者プラットフォーム」として挙げています。既に LiveKit や Pipecat で音声パイプラインを組んでいるなら、読み上げ部分のモデル指定を差し替えるところから試すのが近道です。なお日本は Gemini API の提供地域一覧(available regions)に載っています。
料金|音声は 1 秒 25 トークン、1 時間の音声がいくらになるか
Gemini Developer API の料金ページ(参照日 2026年9月24日)から、2 モデルの有料ティアの単価を並べます。すべて 100万トークンあたりの米ドルです。
| 項目 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| 入力(テキスト) | $0.50(2027年1月1日から $1.00) | $0.50(2027年1月1日から $1.00) |
| 出力(音声) | $9.00(2027年1月1日から $18.00) | $6.00(2027年1月1日から $12.00) |
| コンテキストキャッシュ(入力分) | $0.125(同 $0.25) | $0.125(同 $0.25) |
| キャッシュ保存(100万トークン・1 時間) | $0.50(同 $1.00) | $0.50(同 $1.00) |
| 無料ティア | Free of charge | Free of charge |
見落としやすいのは 2026年12月31日までの期間限定価格という但し書きです。2027年1月1日に入力・出力・キャッシュのすべてが倍になります。年をまたぐ予算を組むときは、年明けの単価で見積もってください。
料金ページには両モデルとも「音声トークンは音声 1 秒あたり 25 トークンに相当する」という注記が付いています。ここから尺あたりの費用を逆算できます。以下は試算例で、実測値ではありません。計算式は「秒数 × 25 ÷ 1,000,000 × 単価」、入力テキスト分と税・為替は含みません。
| 音声の長さ | 出力トークン | 3.8 Flash TTS(2026年内) | 3.8 Flash-Lite TTS(2026年内) |
|---|---|---|---|
| 1 分 | 1,500 | $0.0135 | $0.0090 |
| 1 時間 | 90,000 | $0.81 | $0.54 |
| 10 時間(長編 1 冊相当) | 900,000 | $8.10 | $5.40 |
2027年1月1日以降は単価が倍になるので、同じ試算式で 1 時間あたり $1.62 と $1.08 になります。Flash と Flash-Lite の差は 1 時間で $0.27(2026年内)です。1 本のナレーションなら誤差ですが、1 万本の読み上げを回すバッチなら効いてきます。逆に言えば、少量・高品質が欲しい用途で Flash-Lite を選ぶ理由は価格面ではほとんどないという判断になります。
なお料金ページの各モデルには Standard・Batch・Flex・Priority のタブがあり、ここで読んだのは Standard の値です。Batch API については料金ページのプラン説明に「有料ティアの機能として 50% の費用削減」と書かれていますが、TTS モデル個別の Batch 単価は今回確認していません。実際に大量処理を組む前に、料金ページで該当タブを開いて確認してください。旧世代の単価と比べたい場合は、gemini-3.1-flash-tts-preview が入力 $1.00/出力 $20.00 なので、Flash-Lite TTS への移行は出力単価で 70% 減にあたります。世代ごとの単価の動きはGemini 2.5 系の利用制限と移行先の記事でも触れています。
仕組み|本文は逐語の台本、演出は speech_metadata と山かっこタグへ
Gemini 3.8 TTS のいちばん重要な仕様は、text フィールドを厳密に逐語の台本として扱うことです。旧モデルの感覚で「ささやくように:誰かいる?」と書くと、「ささやくように」まで読み上げられます。演出は次の 4 か所に分けて置きます。
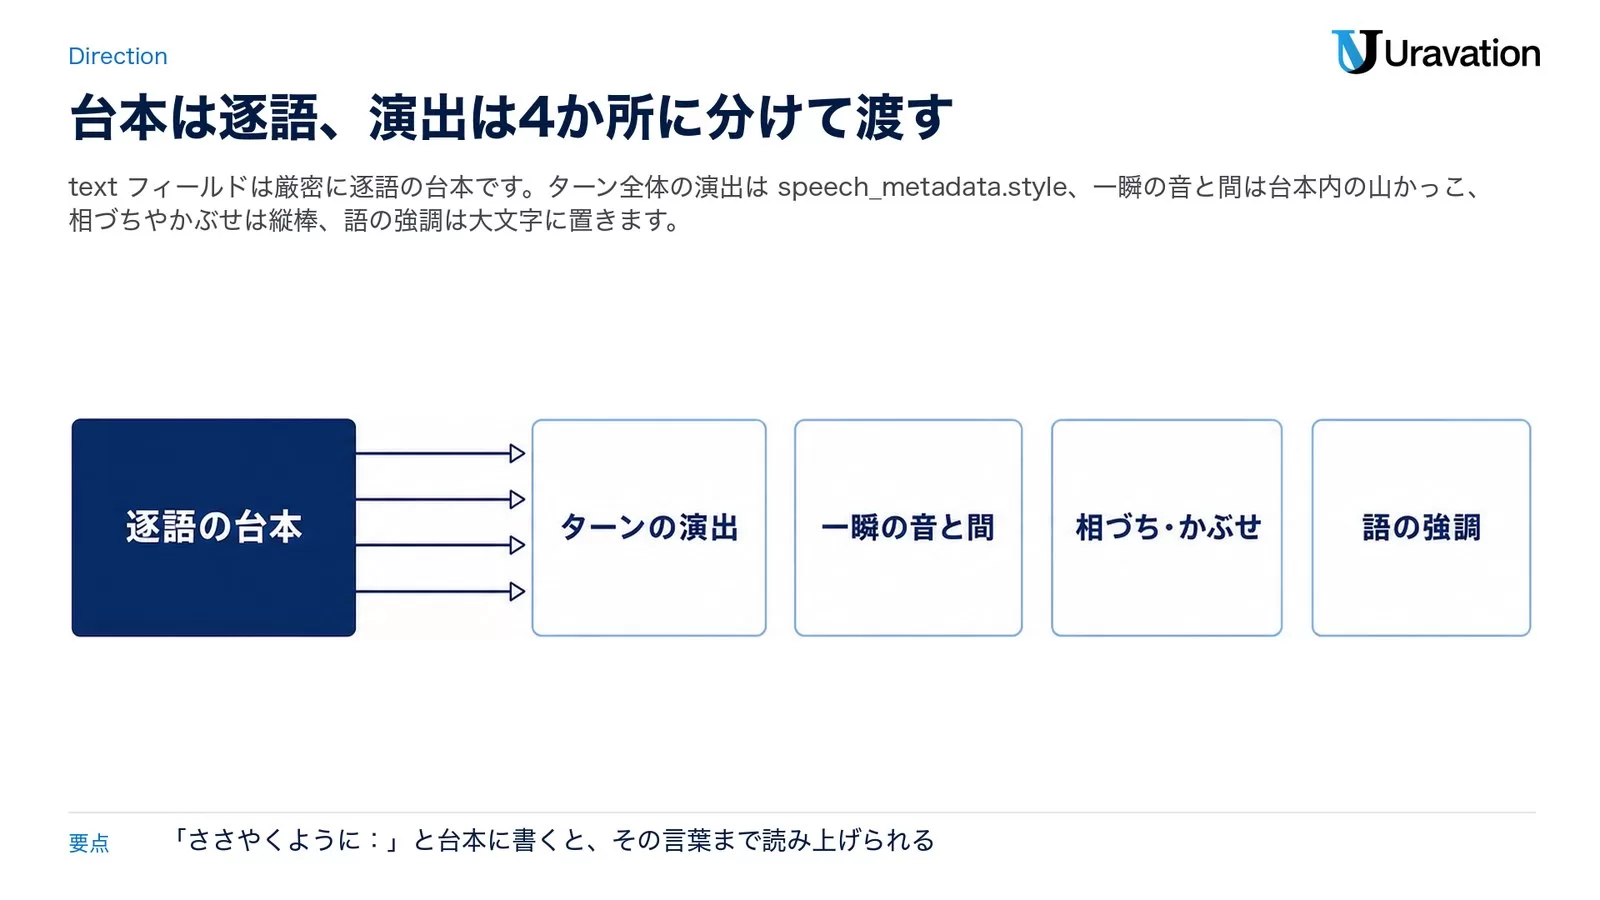
| 演出の種類 | 置き場所 | 公式ドキュメントの例 |
|---|---|---|
| ターン全体に続く演出(感情・速度・声量) | speech_metadata.style |
"whispered urgently"、"out of breath"、"warm and enthusiastic" |
| 一瞬の非言語音・間 | 台本内の山かっこ | <cough>、<sigh>、<short pause>、<long pause> |
| 相づち・かぶせ(2 人対話) | 台本内を縦棒で囲む | |oh hmm|、|oh really?|、|absolutely| |
| 語単位の強調 | 台本内を大文字にする | This is a VERY important point! |
山かっこタグは公式ドキュメントに一覧があり、<laugh> <chuckle> <gasp> <groan> <yawn> <throat-clearing> <breath> など 30 種類以上が推奨として挙がっています。ここで 拍手やドアの音のような「人の声でない効果音」は推奨されていません。あくまで人の発声に限る、という設計です。
日本語で使うときの実務的な注意が 1 つあります。公式ドキュメントは「台本が英語以外の言語であっても、インラインタグは英語のまま使うのが最良の結果になる」と明記しています。日本語の台本に <笑い> と書くのではなく、<laugh> と書きます。
間の作り方は 3 段階で指定できます。句読点・ダッシュ・三点リーダーで自然なためらいを作る、<short pause> と <long pause> を正確な位置に置く、ターン全体の速度は "style": "speaking rapidly" のように指定する、という使い分けです。感情がターンの途中で変わるなら、1 つのターンを分割して別々の style を付けるのが公式の推奨です。
声の選び方・作り方 4 つ|プリセット 30・拡張ライブラリ・Voice design・Voice replication
公式ドキュメントは声の指定方法を 4 つ挙げています。
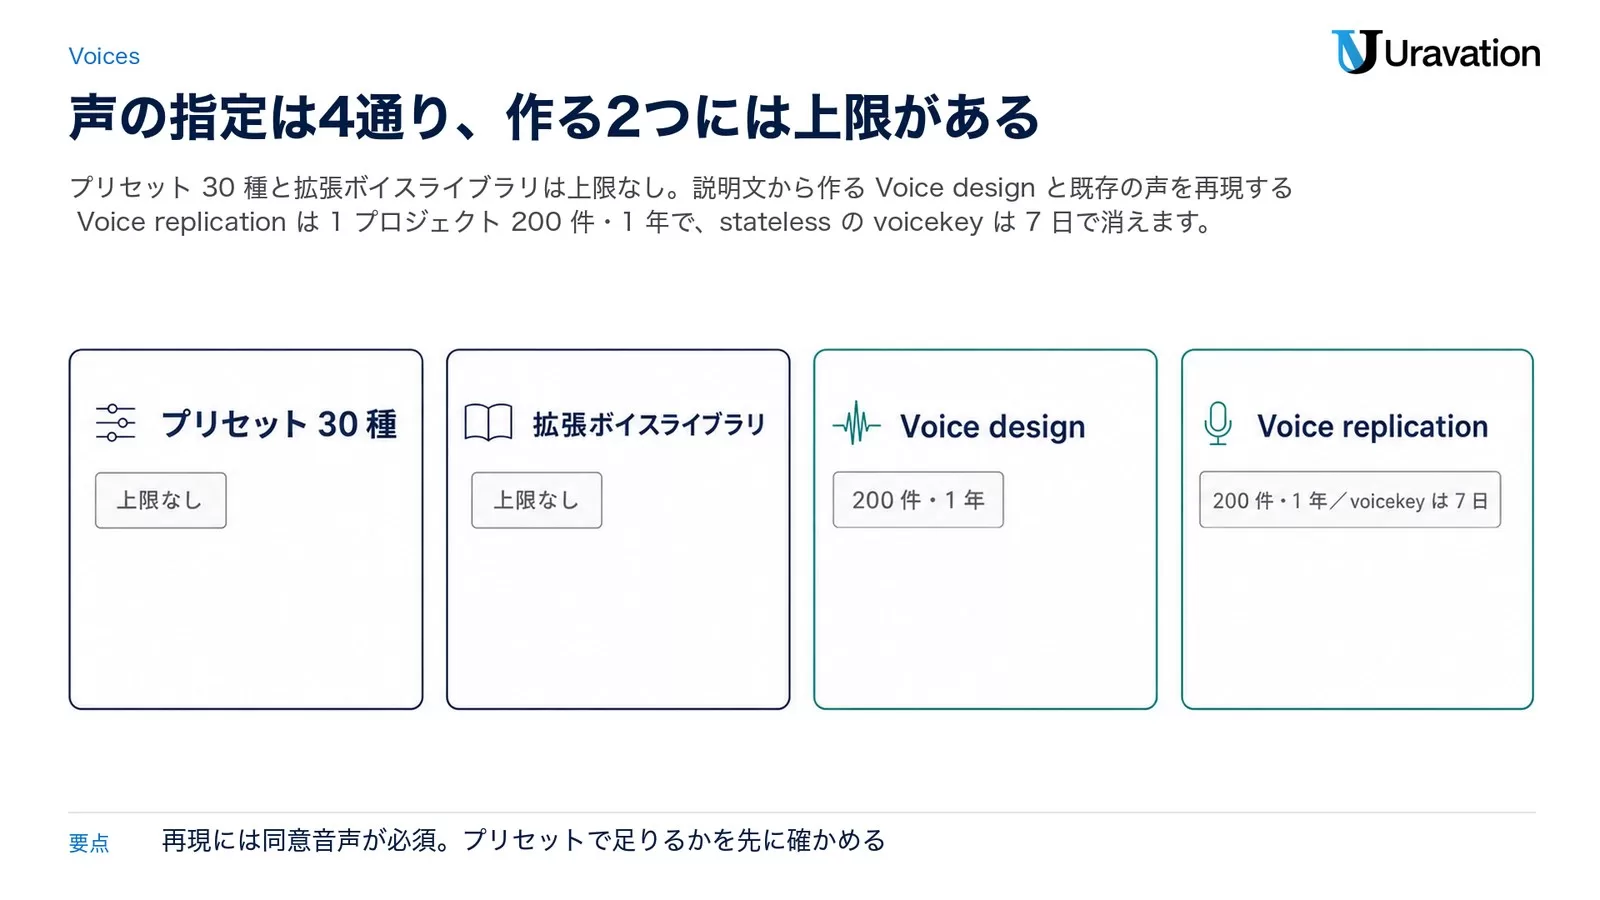
| 方法 | 指定するもの | 上限・保存期間 |
|---|---|---|
| プリセットのスタジオ音声 30 種類 | 名前(Kore、Puck、Charon など) |
なし |
| 拡張ボイスライブラリ | client.voices.list() で取得した ID |
なし |
| Voice design(説明文から作る) | voice_… |
1 プロジェクト 200 件・1 年 |
| Voice replication(既存の声を再現) | voice_… または voicekey_… |
保存型は 200 件・1 年/stateless の voicekey_ は 7 日 |
プリセットの 30 種類には Zephyr(Bright)、Kore(Firm)、Puck(Upbeat)、Sulafat(Warm)のように性格ラベルが付いています。拡張ボイスライブラリは GET /v1beta/voices で引けて、language_code・region_code・accent・gender・pitch・persona・contexts・type・search で絞り込めます。同じパラメータに複数値を渡すと OR、違うパラメータ同士は AND で結合されます。
ここで公式の表記が揃っていない点を 1 つ挙げておきます。収録声数について、公式ブログは「2,000 以上」、リリースノートは「150 以上」、ドキュメント本文は「数百」と書いており、3 か所で数え方が違います。カスタム音声を含むかどうか、プリセットだけを数えるかで変わるのだと思われますが、2026年9月24日時点でどの定義かは公表されていません。自分のプロジェクトから実際に引ける数を知りたい場合は、client.voices.list(page_size=1000) を叩いて数えるのが確実です。
Voice design は自然言語の説明文から声を作る機能です。公式ドキュメントは「1〜2 文の明確な説明のほうが、矛盾した長文より良い結果になる」と書いており、例として「30 代の、ややミッドウェスト訛りのある、切れのいい快活なスポーツアナウンサー」のような粒度を挙げています。年齢・性別・声質・地域訛りといった変えられない特徴は Voice design 側に、その場の感情は style 側に置く、という分担です。
最短手順|公式の Python 例で 1 ファイル出すまで
以下は Gemini API の公式ドキュメントに掲載されている Python の例です。筆者は実行していません。実際に動かすときは公式ページで最新のコードを確認してください。まずは 1 人音声です。
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Have a wonderful day!",
            "annotations": [{
                "type": "speech_metadata",
                "style": "cheerful and friendly",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": "Kore"},
        ]
    },
)

with open("out.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
ポイントは 3 つです。interactions.create() を使うこと(Interactions API が推奨経路)、response_format={"type": "audio"} で音声を要求すること、interaction.output_audio が最後に生成された音声ブロックを返すことです。非ストリーミングの戻り値は RIFF ヘッダー付きの WAV なので、デコードしたバイト列をそのまま .wav に書けば再生できます。
次は 2 人対話です。話者ごとに speech_metadata.speaker を付け、speech_config.speakers に声を割り当てます。自然なターンの受け渡しが欲しい場合は "mode": "conversational" を指定します。
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [
            {
                "type": "text",
                "text": "How's it going today Jane?",
                "annotations": [{
                    "type": "speech_metadata",
                    "speaker": "Joe",
                    "style": "cheerful and friendly",
                }],
            },
            {
                "type": "text",
                "text": "Not too bad, how about you? Ready to test these new voices?",
                "annotations": [{
                    "type": "speech_metadata",
                    "speaker": "Jane",
                    "style": "calm and relaxed",
                }],
            },
        ],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": {
            "mode": "conversational",
            "speakers": [
                {"speaker": "Joe", "voice": "Puck"},
                {"speaker": "Jane", "voice": "Kore"},
            ],
        }
    },
)
3 つめは Voice design で独自の声を作る例です。store=True で作ると恒久的な voice_… ID が返り、同時に試聴用の sample_audio(WAV・base64)も返ります。
created_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "prompted",
        "display_name": "Warm British Astronomer",
        "gender": "male",
        "language_code": "en-GB",
        "prompted": {
            "input": (
                "A warm, thoughtful astronomer in his late 60s with a gentle"
                " British accent, speaking with quiet wonder."
            )
        },
    },
)

print(f"Created voice ID: {created_voice.id}")
返ってきた created_voice.id は、合成リクエストの speech_config で {"voice": created_voice.id} のように、声の名前が入る場所ならどこでも使えます。作った声は voices.list() / voices.get() / voices.delete() で管理します。なお Voices エンドポイントを使うには google-genai 2.25.0 以降(JavaScript は @google/genai 2.24.0 以降)が必要です。
ストリーミングで逐次再生したい場合は stream=True を渡します。このとき戻り値はヘッダーなしの生 PCM(audio/l16・24 kHz・モノラル・16 bit リトルエンディアン)のチャンクになり、そのまま連結・再生できます。出力形式は response_format の mime_type で audio/wav・audio/l16・audio/mulaw・audio/alaw から選べ、sample_rate で 24000/16000/8000 などを指定できます。mu-law と A-law が用意されているのは電話系の用途(IVR)を想定したもので、公式ドキュメントも北米・日本の電話網と欧州系の標準として説明しています。
TTS と Live API の違い|音声エージェントはどちらで作るか
公式ドキュメントは冒頭で、TTS と Live API の音声生成は別物だと明言しています。要点を表にします。
| 観点 | TTS(3.8 Flash TTS / Flash-Lite TTS) | Live API(3.8 Live など) |
|---|---|---|
| 入力 | テキストのみ | 音声・テキストなどのマルチモーダル |
| 出力 | 音声のみ | 音声(双方向のやり取り) |
| 設計思想 | 台本の正確な読み上げと、細かい演出の制御 | 対話的・非構造な音声のやり取り |
| 向く用途 | ポッドキャスト、オーディオブック、読み上げ機能 | 割り込みのある会話、リアルタイム通話 |
| 関数呼び出し | 非対応 | 対応 |
では音声エージェントはどちらで作るのか。公式ドキュメントは両方の道を示しています。Live API は音声から音声へ直接つなぐ一体型、TTS は「大規模言語モデルが文章を作り、それを TTS が読む」カスケード型です。TTS 側のドキュチメントには、カスケード型を作るときの具体的な指針が書かれています。
- 言語モデルのテキストが届くたびに、ターンごとに 1 回 TTS を呼ぶ。
- 話者の同一性は設定した声(プリセット・
voice_…・voicekey_…)に持たせ、毎ターン長いキャラクター設定を送り直さない。 - ターンごとの
styleは空にするか、会話全体で同じ短い文字列を 1 つ使う。 - エージェントの返答が長いときは、強い
styleを足すのではなくターンを短く割る。
カスケード型の音声エージェントは、遅延とコストの設計が肝です。Flash-Lite TTS が「リアルタイム音声エージェントのカスケード」を名指しで得意用途に挙げているのは、この文脈です。構成の作り方そのものは 音声 AI エージェントの比較記事や、Qwen3.8-Omni-Flash を使った音声エージェントの記事で扱っている考え方がそのまま使えます。
3.1 Flash TTS preview からの移行|既定の出力が WAV に変わった
公式ドキュメントの移行ガイドは 5 項目です。順に潰していけば移行できます。
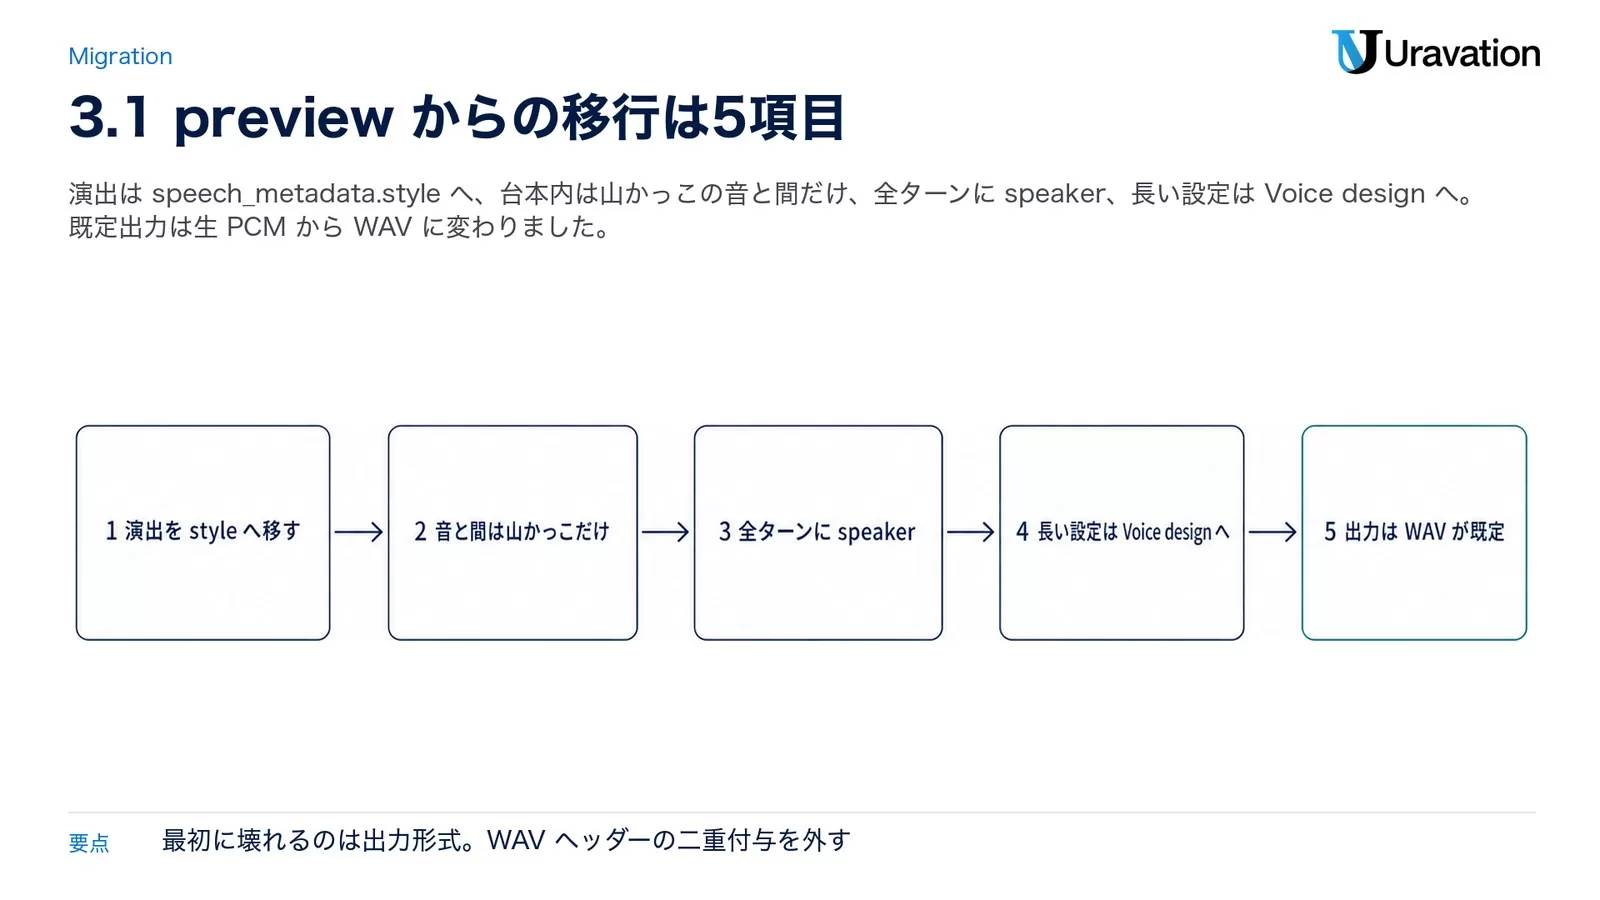
| やること | 旧(3.1 preview 以前) | 新(3.8 TTS) |
|---|---|---|
| 演出の置き場所 | 台本の中に「Say cheerfully:」などを書く | speech_metadata.style へ移す |
| 一瞬の音・間 | 混在 | 山かっこタグだけを台本内に残す |
| 話者の指定 | 台本に「Speaker 1:」と書く | 全ターンに speech_metadata.speaker を必ず付ける |
| キャラクター設定 | 長い Audio Profile / Director’s Notes | Voice design で voice_… を作り、style は短く |
| 出力形式 | ヘッダーなしの生 PCM(audio/l16)が既定 |
非ストリーミングは WAV(audio/wav)が既定 |
実害が出やすいのは最後の 1 行です。旧モデルは生 PCM を返していたため、Python の wave モジュールや ffmpeg で WAV ヘッダーを付ける処理を自前で書いていたはずです。その処理を残したまま 3.8 TTS に向けると、WAV ヘッダーの付いた音声にもう一度ヘッダーを被せることになり、ファイルが壊れます。公式ドキュメントも「手動のヘッダー付与を外して、返ってきたバイト列をそのまま .wav に書け」と明記しています。生 PCM のまま扱いたいパイプラインは、response_format で audio/l16 を明示してください。
もう 1 つ、静かに効いてくるのが声のぶれ(drift)の原因です。公式ドキュメントは「旧モデルから持ち越した長文の Audio Profile や箇条書きの Director’s Notes が、声がぶれる最大の原因」と書いています。さらに「声を保て」「音色を変えるな」といったメタ指示を入れること自体が drift を増やす、とも明記しています。3.8 TTS は音声リファレンスを最優先で参照するよう学習されているため、余計なプロンプトを消すほど安定するという設計です。旧プロンプトを機械的に移植するのではなく、まず style を空にして素の音声を出し、必要なターンだけ短い文字列を足す、という順番が公式の推奨ワークフローです。
注意点|同意音声・SynthID・保存上限・入力 8,192 トークン
本番に載せる前に確認しておきたい制約を整理します。
- 声の再現には同意音声が必須:Voice replication のリクエストには、同一の成人話者による 2 本の実録音が要ります。参照音声(
source_audio)は 10〜30 秒のきれいな自然発話、同意音声(consent_audio)は所定の同意文を本人が読み上げたものです。日本語(ja-JP)の同意文は「私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。」と一言一句が指定されています。対応するのは 30 のロケールです。 - 録音条件をそろえる:公式ドキュメントは、参照音声と同意音声を同じマイク・同じ音響環境で録るよう求めています。話者照合のチェックが確実に通るようにするためです。推奨は 24 kHz モノラル 16 bit の WAV です。
- AI Studio 経由の声の再現は一部地域で使えない:公式ブログの脚注に、Illinois・Texas・EEA・英国・スイス・インドでは AI Studio からの Voice replication は提供されないと書かれています。日本はこの一覧に含まれていません。
- 透かしは常に入る:公式ブログは「Gemini Audio モデルが生成したすべての音声クリップに SynthID の透かしが入る」と明記しています。人の耳では気づかないが検出可能、という位置づけです。オフにする方法は 2026年9月24日時点で公表されていません。
- 保存上限と期限:保存型の音声(
store=True)は 1 プロジェクト 200 件まで、保持期間は 1 年です。この 200 件は Voice design と Voice replication の合算です。サーバー側に声のプロファイルを残したくない場合はstore=Falseでvoicekey_…を受け取り、自前で保管しますが、こちらの有効期間は 7 日です。 - 入力は 8,192 トークンまで:1 リクエストに丸ごと 1 章を投げることはできません。長編は章や段落で分割して合成し、後でつなぐ設計が必要です。出力は 16,384 トークン(=音声およそ 10 分相当)です。
- 1 リクエストの複数話者は 2 人まで:しかも公式ドキュメントによれば、1 リクエスト内の複数話者指定で使えるのはプリセット音声です。作った声や再現した声を複数キャラで混ぜたい場合は、話者ごとに個別に合成して 24 kHz の PCM フレームを連結するのが公式の案内です。
商用利用については、今回確認した 4 ページ(text-to-speech ガイド・Voice design・Voice replication・料金)に TTS 固有の可否条項は書かれていませんでした。ドキュメントのフッターにある CC BY 4.0 / Apache 2.0 の表記は、ページの文章とコードサンプルのライセンスであって生成された音声の話ではありません。案件で使う前に Gemini API の利用規約と使用ポリシーを確認してください。特に既存の声を再現する場合は、Google への同意(consent_audio)とは別に、声の持ち主との契約・出演範囲・二次利用の取り決めが必要になります。
失敗パターン 4 つ(❌→⭕)
公式ドキュメントが「やりがち」として挙げている挙動と、その直し方です。
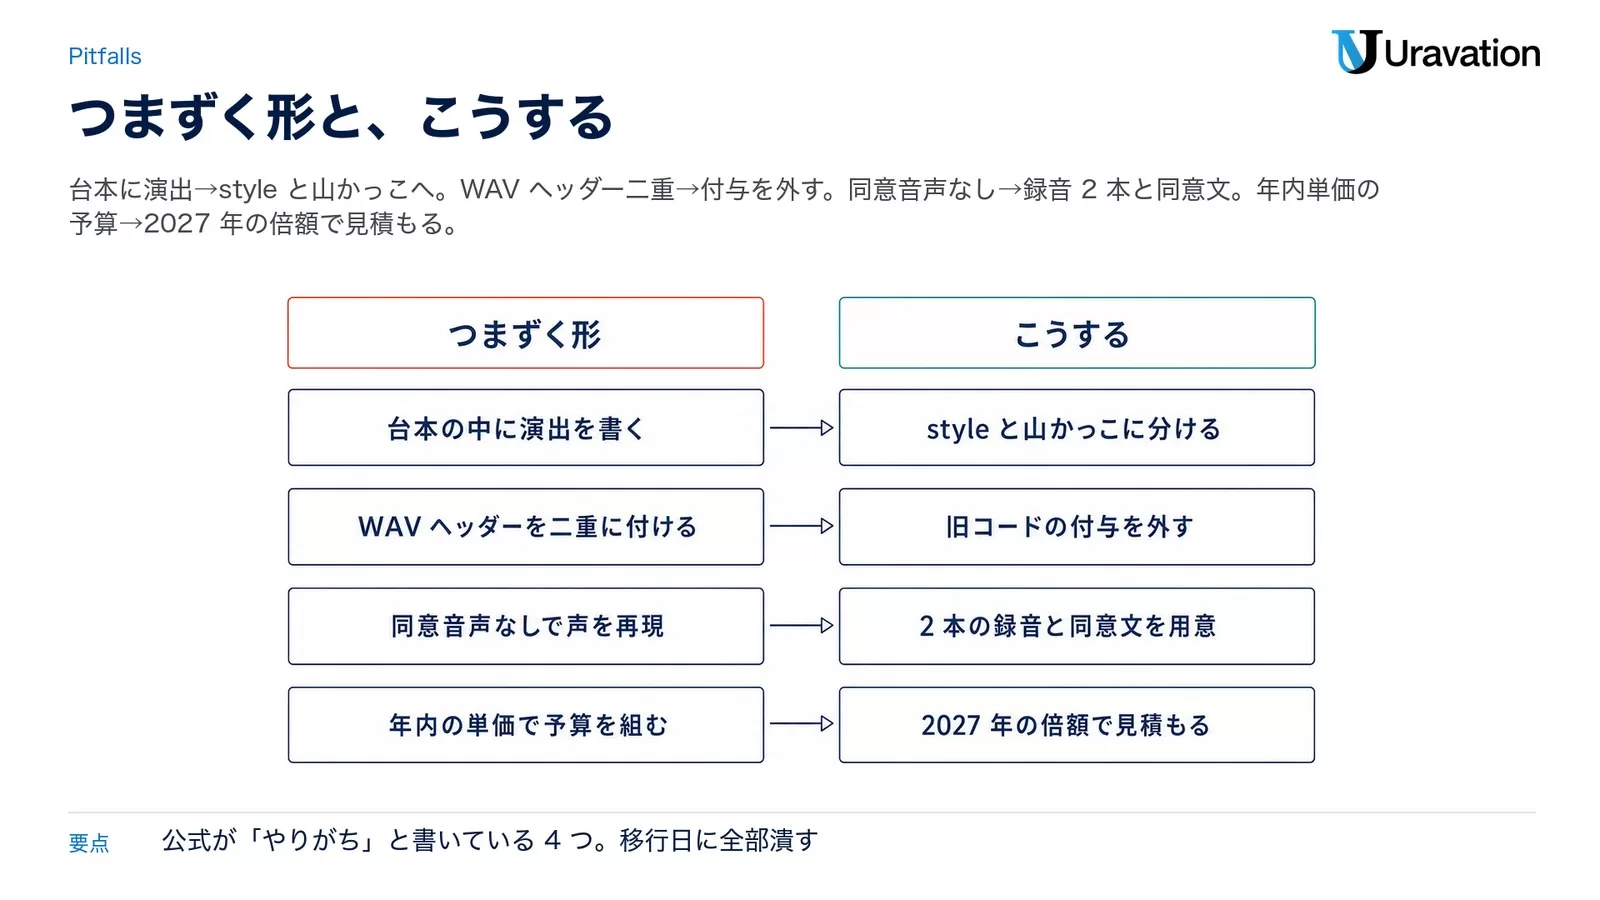
❌ 台本の中に演出を書く
"text": "明るく元気に:こんにちは!" と書くと、「明るく元気に」まで読み上げられます。3.8 TTS は text を逐語の台本として扱うためです。
⭕ 演出は speech_metadata.style へ移す
"text": "こんにちは!"、"style": "cheerful and friendly" のように分けます。一瞬の息づかいや間だけを台本内の山かっこに残します。
❌ 旧コードの WAV ヘッダー付与を残したまま移行する
3.1 preview 以前は生 PCM が返っていたので、wave モジュールでヘッダーを付ける処理が入っているはずです。3.8 TTS の非ストリーミング応答は既に WAV なので、二重にヘッダーが付いて再生できないファイルになります。
⭕ ヘッダー付与を外して、デコードしたバイト列をそのまま .wav に書く
生 PCM が必要なパイプラインは response_format に "mime_type": "audio/l16" を明示します。
❌ 毎ターン長いキャラクター設定を送り続ける
旧モデル時代の「Audio Profile」「Director’s Notes」をそのまま毎回付けると、公式ドキュメントが「声がぶれる最大の原因」と名指ししている状態になります。「音色を維持せよ」といったメタ指示を足すと、さらに悪化します。
⭕ Voice design で voice_… を 1 回作り、それを使い回す
style は空にするか、会話を通して同じ短い文字列を 1 つだけ使います。
❌ 作った声 2 人分を 1 リクエストの複数話者で混ぜる
1 リクエストでの複数話者は 2 人まで、かつプリセット音声が対象です。カスタム音声や再現音声を複数キャラで同時に指定する設計は通りません。
⭕ 話者ごとに合成して、24 kHz の PCM フレームを連結する
公式ドキュメントが案内している回避手順です。台本の分割とつなぎ合わせを自分のコード側で持つ前提で設計します。
よくある質問
Gemini TTS は無料で使えますか?
料金ページの無料ティア(Free Tier)は、2 モデルとも入力・出力・キャッシュのすべてが「Free of charge」と表記されています。ただし無料ティアはレート上限が低く、料金ページに「コンテンツがプロダクト改善に利用される」と明記されています(有料ティアは利用されない)。業務で使うなら有料ティアを前提にしてください。まず触ってみるだけなら Google AI Studio の音声プレイグラウンドが手早いです。
Gemini 3.8 Flash TTS と Flash-Lite TTS はどちらを選べばいいですか?
公式ドキュメントの基準はシンプルです。音質・演技の機微・方言の再現が最優先なら Flash TTS、量と速度とコストが優先なら Flash-Lite TTS です。API のスキーマは同一なので、モデル ID を 1 か所変えるだけで往復できます。迷ったら Flash-Lite で試し、品質が足りない箇所だけ Flash に上げる進め方が無駄が少ないはずです。単価差は 1 時間の音声で $0.27(2026年内の試算)です。
日本語は使えますか?
対応言語表に Japanese が入っており、Flash TTS の 130 言語・Flash-Lite TTS の 101 言語の両方に含まれます。入力言語はモデルが自動で判定するため、言語の指定は不要です。1 点だけ注意があり、公式ドキュメントは「台本が英語以外でも、インラインタグは英語のまま使うのが最良」としています。日本語の台本でも <laugh> <sigh> と英語で書いてください。公式ブログは、Voice Arena の人手比較で日本語を含む主要言語で上位を取ったとも記載しています。
自分の声を再現できますか?
Voice replication で可能です。必要なのは 10〜30 秒の参照音声と、同じ人が所定の同意文を読み上げた同意音声の 2 本です。日本語の同意文は文言が固定されています。保存する場合は 1 プロジェクト 200 件・1 年、サーバーに残したくない場合は store=False で 7 日有効の voicekey_… を受け取ります。なお Google AI Studio 経由の Voice replication は Illinois・Texas・EEA・英国・スイス・インドでは提供されません(日本は対象外=利用可)。
商用利用や権利関係はどうなりますか?
2026年9月24日時点で、text-to-speech ガイド・Voice design・Voice replication・料金の 4 ページに TTS 固有の商用利用条項は書かれていません。Gemini API 全体の利用規約と使用ポリシーで判断してください。確実なのは、生成音声には必ず SynthID の透かしが入ること、声の再現には所有者本人の同意録音が要ることの 2 点です。他人の声を使う案件では、Google への同意とは別に、声の持ち主との契約(用途・期間・二次利用)を先に整えるのが安全です。
まとめ|今日やる 3 つ
Gemini 3.8 TTS は「声を選ぶ」道具から「声を作って演出する」道具に変わりました。開発者側でやることは 3 つに絞れます。
- 旧コードの WAV ヘッダー付与を外す。
gemini-3.1-flash-tts-previewから移すなら、既定出力が生 PCM から WAV に変わった点が最初に壊れる場所です。 - 台本と演出を分ける。
textは逐語、ターン単位の演出はspeech_metadata.style、一瞬の音と間は山かっこタグ、相づちは縦棒。この 4 分割を先に決めます。 - 年明けの単価で見積もる。音声出力の $9.00/$6.00 は 2026年12月31日までの価格で、2027年1月1日に倍になります。1 秒 25 トークンで尺から逆算して、年度をまたぐ予算を作り直してください。
Gemini Enterprise 向けの提供時期、Voice remixing(ライブラリの声を選んで音色・音程・速度・訛りを微調整する機能)の開始時期は、2026年9月24日時点で公式発表がありません。判明し次第この記事に追記します。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Google「Gemini 3.8 text-to-speech says hello」(2026年9月23日・参照日 2026年9月24日)
- Gemini API docs「Text-to-speech generation (TTS)」(最終更新 2026年9月23日・参照日 2026年9月24日)
- Gemini API docs「Voice design」(最終更新 2026年9月23日・参照日 2026年9月24日)
- Gemini API docs「Voice replication」(最終更新 2026年9月23日・参照日 2026年9月24日)
- Gemini Developer API pricing(参照日 2026年9月24日)
- Gemini API docs「Gemini models」(参照日 2026年9月24日)
- Gemini API「Release notes」2026年9月22日の項(参照日 2026年9月24日)
- Gemini API docs「Gemini 3.8 Flash TTS」モデルページ(参照日 2026年9月24日)
- Gemini API docs「Gemini 3.8 Flash-Lite TTS」モデルページ(参照日 2026年9月24日)
- Gemini API docs「Available regions」(参照日 2026年9月24日)
- Google AI Studio
記事中の料金・仕様は 2026年9月24日時点で上記の公式ページから確認した値です。試算例は公式の単価と「音声 1 秒 = 25 トークン」の注記から計算したもので、実測値ではありません。仕様は変わることがあるため、実装前に必ず公式ページで最新の値を確認してください。