2026年11月13日時点で、Muse Ember は Meta が「いちばん小さく、いちばん効率のよいモデル」と呼ぶ Muse の推論モデルで、エージェントの中で何度も繰り返す区切られた仕事(サブエージェントの作業・道具の呼び出し・振り分け・大量の画像やファイルの処理)を受け持つ実行役です。モデル ID は muse-ember-1.0、料金は入力が 20 万トークンまでの要求で 100 万トークンあたり入力 0.10 ドル・出力 0.50 ドルで、Standard mode(送った内容を Meta の学習に使わない標準の方式)の推論モデル 3 つ(Muse Wonder・Muse Spark・Muse Ember)の中では単価が最も低いモデルです(Muse Ember(Meta Model API docs)・Pricing and rate limits)。
結論:Muse Ember は、量の多い反復作業を受け持つ、Muse で最も小さい実行モデルです。
この記事の要点(2026年11月13日時点)
- Meta が 2026年11月9日付の研究ブログで発表し、Meta Model API(Meta のモデルを API で呼ぶサービス)と Muse Code(Meta のコーディングエージェント)で使えるようになりました。モデル ID は
muse-ember-1.0で、Model API では Standard mode だけです。 - 料金は 100 万トークンあたり入力 0.10 ドル・出力 0.50 ドル(入力 20 万トークンまでの要求)。超える要求は、全体が入力 0.30 ドル・出力 1.50 ドルの単価になります。
- 文脈の長さ(1 回に読める量)は 1,048,576 トークン、出力の上限は 524,288 トークン、入力はテキスト・画像・動画・音声・PDF。エフォート(推論の深さ)の既定は最も深い max です。
対象読者:エージェントの下請けの作業を、単価の低いモデルに回したい開発者と PM。
今日やること:公式の最小例をテスト環境で動かし、実際の入力トークン数と費用を確認します。
この記事は 2026年11月13日時点で公式 docs を確認した範囲で、Muse の中での位置、料金、仕様、呼び出し方、大きいモデルとの組み方、Claude Haiku 5.5 との比べ方を順に整理します。コードは公式の例の形で、当社はこの記事の時点で Muse Ember を実行していません。ベンチマークの数字はすべて Meta の発表です。
この記事で比べる Muse の 4 つのモデル|Glimmer・Ember・Spark・Wonder
この記事で比べる Muse の 4 つのモデルは、Meta Model API(Meta が動かすサーバーを API で呼ぶ口)で使う Muse Wonder・Muse Spark・Muse Ember の 3 つと、重み(学習済みのモデルの中身)を公開して自分の機械で動かす Muse Glimmer です。docs は Ember を「Muse Spark と同じ要求を、より低いトークン単価で受け付ける」モデルと書いています(Models)。
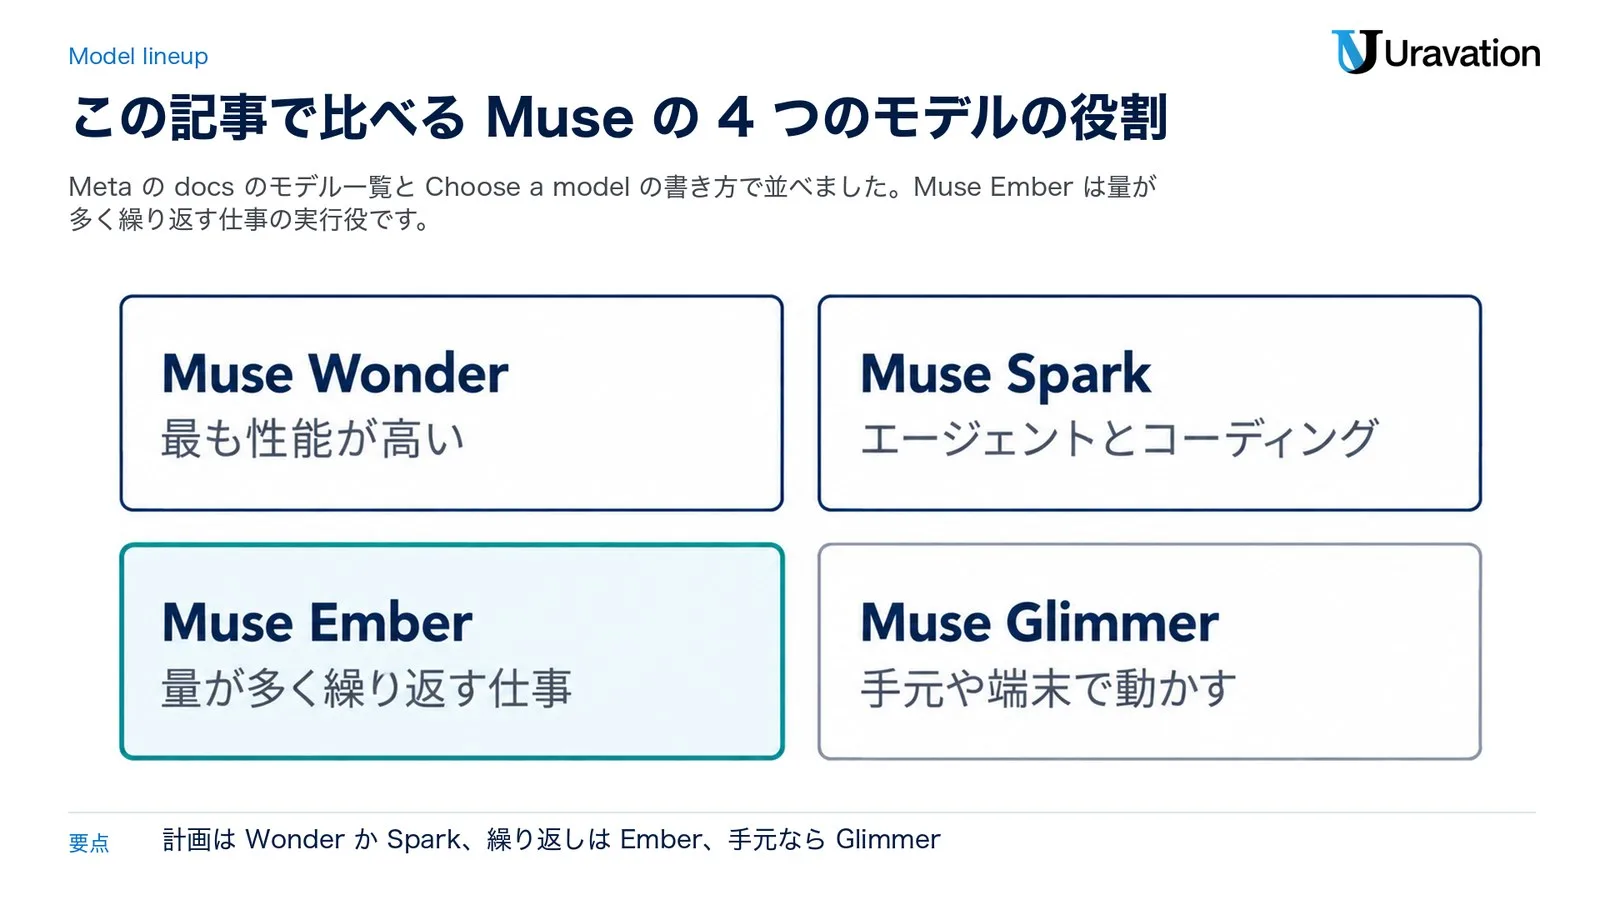
この記事で比べる 4 つのモデルの役割を docs の言い方で並べると次のとおりです(Models・Choose a model・Open-weight models)。
| モデル | docs の位置づけ | モデル ID・使う場所 | 重みの公開 |
|---|---|---|---|
| Muse Wonder | Meta で最も性能が高いモデル。複雑なソフトウェア開発と長いエージェントの仕事向け(プレビュー) | muse-wonder-1.0。Model API と Muse Code。上位版の Muse Wonder Full は Muse Code だけ |
なし(Model API で動く) |
| Muse Spark | 大規模なエージェントとコーディングの仕事向け。主ループを Wonder より安く回したい時に | muse-spark-1.3(推奨)・muse-spark-1.2・muse-spark-1.1。Model API には、送った内容を学習に使ってよいとする代わりに値引きされる Contributor mode の版もある |
Muse Spark 自体はなし。別の版の Muse Spark Open を公開 |
| Muse Ember | 量が多く繰り返す仕事を効率よくこなす実行役。大きいモデルが計画し、Ember が量をこなす | muse-ember-1.0。Model API(Standard mode だけ)と Muse Code |
なし(Model API で動く) |
| Muse Glimmer | 300 億パラメータのマルチモーダルのモデル。Muse Spark から蒸留(大きいモデルの振る舞いを小さいモデルに学ばせる作り方)し、手元や端末で動かす用途 | Model API では呼べない。重みを取ってきて vLLM などで自分で動かす | あり |
重みを公開しているのは Muse Spark Open(8,160 億パラメータの MoE=混合エキスパートで、1 回に使うのは 420 億)と Muse Glimmer の 2 つで、Ember は公開の一覧にありません(Open-weight models)。「いちばん小さい」は Meta の言い方で、今回読んだ docs とブログには Ember のパラメータ数が無く、Glimmer(300 億パラメータ)との大きさは比べられていません。研究ブログによると、Ember は Muse Wonder Full を使って訓練した最初のモデルです(Introducing Our Smallest, Most Efficient Model: Muse Ember)。
Glimmer を手元で動かす手順は Muse Glimmer の使い方(Ollama で手元で動かす)、Spark の全体像は Meta Muse Spark とは(エージェント開発者向けの解説) にまとめています。
Muse Ember の料金|入力 20 万トークンを境に 2 段
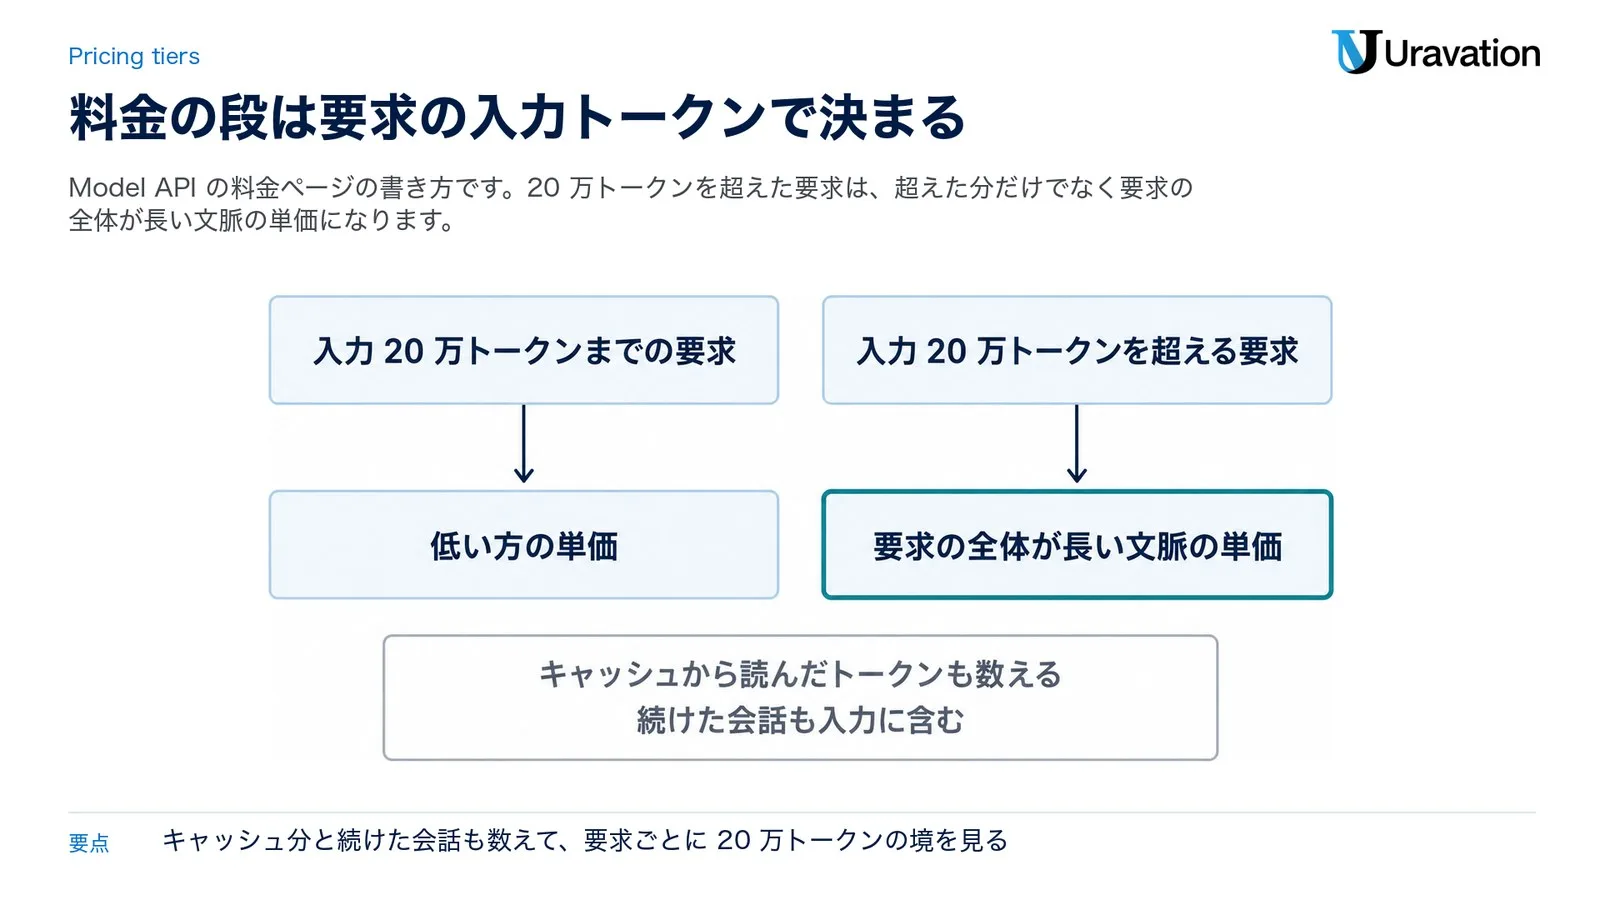
Model API の料金ページによると、Ember は使った分だけ払う従量制で、要求(API の 1 回の呼び出し)に含まれる入力トークンの数で単価が 2 段に分かれます。入力 20 万トークンまでの要求は低い方の単価、超える要求は長い文脈の単価です(Pricing and rate limits)。
| 項目(100 万トークンあたり) | 入力 20 万トークンまでの要求 | 入力 20 万トークンを超える要求 |
|---|---|---|
| キャッシュ入力 | 0.004 ドル | 0.012 ドル |
| 入力 | 0.10 ドル | 0.30 ドル |
| 出力 | 0.50 ドル | 1.50 ドル |
開発者ブログと研究ブログも同じ数字を書いています。キャッシュ入力は、前の要求と同じ前置きの部分を使い回した時の単価で、何トークンが使い回されたかは応答の cached_tokens で見られます。見落としやすいのは段の決まり方で、料金ページは次の 3 点を書いています。
- 段を決める入力トークンには、キャッシュから読んだトークンも数える。
previous_response_id(前の応答の ID を渡して会話を続ける指定)で保存済みの会話を続ける要求は、続けた会話も入力に含む。- 20 万トークンを超えた要求は、超えた分だけでなく要求の全体が長い文脈の単価になる。請求書と使用量の画面では 2 つの段が分けて出る。
Model API の推論モデルを Standard mode の単価で並べると次のとおりです。Muse Wonder と Muse Spark には長い文脈の割増が無く、文脈の長さに関係なく同じ単価です(Pricing and rate limits)。
| モデル(Standard mode・100 万トークンあたり) | キャッシュ入力 | 入力 | 出力 |
|---|---|---|---|
Muse Wonder(muse-wonder-1.0) |
0.20 ドル | 4.00 ドル | 20.00 ドル |
| Muse Spark(1.3・1.2・1.1) | 0.15 ドル | 1.25 ドル | 4.25 ドル |
| Muse Ember(入力 20 万トークンまで) | 0.004 ドル | 0.10 ドル | 0.50 ドル |
コーディングエージェント向けの docs も、Ember を「最も費用の低い推論モデル」と書いています(Use Model API with coding agents)。ただし Muse Spark 1.3 と 1.2 の Contributor mode(送った内容を Meta の今後のモデルの学習に使ってよいと許す代わりに値引きされる方式)の版は、入力 0.10 ドル・出力 0.20 ドル・キャッシュ入力 0.002 ドルで、出力は Ember より低い単価です。Model API の Ember と Wonder に Contributor mode はありません(料金ページ)。Ember の単価が最も低いのは、Standard mode で比べた時です。
トークン以外の費用と上限も料金ページにあります。Web 検索の接地(web_search の道具で検索し、答えに出典を付ける機能)は、トークンの料金とは別に検索 1,000 回あたり 2.50 ドルです。毎分の上限は muse-ember-1.0 で 3,000 回・400 万トークンで、API キーごとではなくチームごとに数えます。Muse Code の定額プランで使う場合は、入力が 20 万トークンを超える要求はプランの使用量を早く使います(Muse Ember の docs)。
仕様と使える場所|文脈の長さ・出力の上限・入力の種類・クラウド
Muse Ember の docs の「At a glance」の表は次のとおりです。研究ブログの「Availability」の節も、文脈の長さと出力の上限を丸めた数で同じ内容に書いています(Muse Ember の docs)。
| 項目 | docs の記載 |
|---|---|
| モデル ID(Standard mode) | muse-ember-1.0 |
| 入力/出力 | テキスト・画像・動画・音声・PDF/テキスト |
| 文脈の長さ(コンテキストウィンドウ) | 1,048,576 トークン |
| 出力の上限 | 524,288 トークン |
| エフォート | "minimal" から "max"。既定は "max" |
| 使える口(エンドポイント) | Responses・Chat Completions・Messages |
| モード | Model API では Standard mode だけ(Contributor mode の版は無い) |
docs は、Ember が computer use(画面を見てパソコンを操作する機能)・画像の理解・道具の呼び出し・構造化出力(決めた JSON の形で答えさせる機能)・検索の接地に対応するとしています。使い分けで気をつける点も docs にあります。
- 難しい 1 回勝負のコーディング、知識が要る質問、見た目を作るコーディングは、Ember ではなく Muse Spark か Muse Wonder を使う(Muse Ember の docs・Choose a model)。
- Choose a model の「用途で選ぶ」表は、音声の理解に Muse Spark 1.2、文字起こしに Muse Voice Transcribe を挙げている。
- 動画は Chat Completions の口では送れない。Responses API なら
input_videoで送れる(Use Model API with coding agents)。
使える場所は次の 4 つです。
| 場所 | 使い方・記載 | 出典 |
|---|---|---|
| Meta Model API | 従量制。muse-ember-1.0 を指定する |
Muse Ember の docs |
| Muse Code(Meta のターミナル向けコーディングエージェント) | 従量制と、すべての定額プラン | Muse Ember の docs・開発者ブログ |
| Google Cloud | Google Cloud の Model Garden(モデルの一覧から選んで使う場所)の Meta のページに「Muse Ember on Google Cloud」の欄がある | 研究ブログ・Google Cloud のページ |
| Oracle Cloud | 研究ブログに名前があるだけで、リンクは無い | 研究ブログ |
研究ブログは末尾で「Muse Ember・Muse Spark・Muse Wonder は Google Cloud と Oracle Cloud でも使える」と書き、Google Cloud の Meta のモデルのページにリンクしています(研究ブログ・Meta models on Google Cloud)。両方のクラウドでの料金と提供地域は今回は確認できませんでした。クラウドで使う場合は、各クラウドの案内で確かめてください。
データの扱いは使う場所で違います。Model API の Ember は Standard mode だけなので(Geographic Use Policy も Ember を Standard のモデルに分類)、送った内容は Meta のモデルの学習に使われません。一方、料金ページは、Muse Code の定額プランが既定で Contributor mode で、設定でオン・オフできると書いています。2026年11月9日更新の Geographic Use Policy も、コーディング用のハーネスの定額(Coding Harness Subscription)から使う時は、選んだモデルに関係なく既定で Contributor の扱いになり、Standard にするにはアカウントの設定を変えるとしています(Geographic Use Policy)。Muse Code の定額で Ember を使う前に、この設定を確かめます。Muse Code の機能とプランは Muse Code とは(機能・料金・使い方) にまとめています。
API での呼び出し方|docs の最小の例とモデル ID の書き方
docs の最初の呼び出しは、Responses API(OpenAI 互換の口)にモデル ID を muse-ember-1.0 として送る形です。Python や TypeScript では、quickstart の例のモデル ID を muse-ember-1.0 にするよう docs は案内しています(Muse Ember の docs・Quickstart)。始め方は次の順です。
- Model API のダッシュボードの「API keys」から「Create API key」で API キーを作る。
- キーをコードに書かず、環境変数
MODEL_API_KEYに入れる。 - Responses API(
https://api.meta.ai/v1/responses)に"model": "muse-ember-1.0"で送る(下の例 1)。 - OpenAI の SDK を使う時は、
base_urlをhttps://api.meta.ai/v1にし、api_keyを明示して渡す。SDK はMODEL_API_KEYを自動では読まない(下の例 2)。 - 答えは応答の
messageのoutput_textにある。推論のトークンはoutput_tokensに含まれるので、usageで入力と出力のトークン数を見て費用を確かめる。 - 401 の
invalid_api_keyはキーの未設定か誤り、404 のmodel_not_foundはモデル ID の誤り。ID を一字ずつ確かめる。
動作環境:Model API アカウントと API キー、curl、または Python 3.9 以上と OpenAI SDK(pip install openai)。本番環境で使用する前に、必ずテスト環境で動作確認してください。
例 1:Muse Ember の docs にある最初の呼び出しです(公式の例・当社は実行していません)。
curl -X POST "https://api.meta.ai/v1/responses" \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-ember-1.0",
  "input": "Classify this support ticket as billing, bug, or feature request, and give a one-sentence reason: \"I was charged twice for my October invoice.\""
}'
例 2:Quickstart の Python(OpenAI SDK)の例です。Python 3.9 以上を用意し、先に pip install openai を実行します。model は docs の案内どおり muse-ember-1.0 にしています(公式の例をもとにしたもの・当社は実行していません)。
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.responses.create(
    model="muse-ember-1.0",
    input="What is the capital of France?",
)

print(response.model_dump_json(indent=2))
モデル ID の書き方には注意が要ります。開発者ブログの写真の整理の例は、環境変数を EMBER_MODEL="muse-ember"、作業役の定義を "model": "muse-ember" と、版の数字なしで書いています。一方、同じブログの Rust への移植の例と結びの段落、docs、研究ブログは muse-ember-1.0 です(開発者ブログ)。docs の標準のモデル ID は muse-ember-1.0 なので、こちらを書きます。当社は版の数字なしの ID で呼べるかを試していません。
Anthropic の Messages 形式で書いたコードや道具は、ベース URL を https://api.meta.ai(末尾に /v1 を付けない)にして Messages API につなぎます(Quickstart・Use Model API with coding agents)。Model API の始め方の全体と Muse Spark 1.3 での使い方は Meta Model API とは(Muse Spark 1.3 の料金と使い方) にあります。
Muse Spark・Muse Wonder と組む使い方|計画は大きいモデル、量は Ember
docs の Choose a model は、たいていのエージェントは 1 つのモデルですべてをこなす必要はないとし、計画と何段もの推論が結果を決める主ループに Muse Wonder(安くしたいなら Muse Spark)を、短く絞った仕事を何度も回すサブエージェントと裏の作業に Ember を置く形を勧めています。3 つの推論モデルは同じ要求の形を受け付けるので、要求ごとに model の欄でモデルを選べます(Choose a model)。
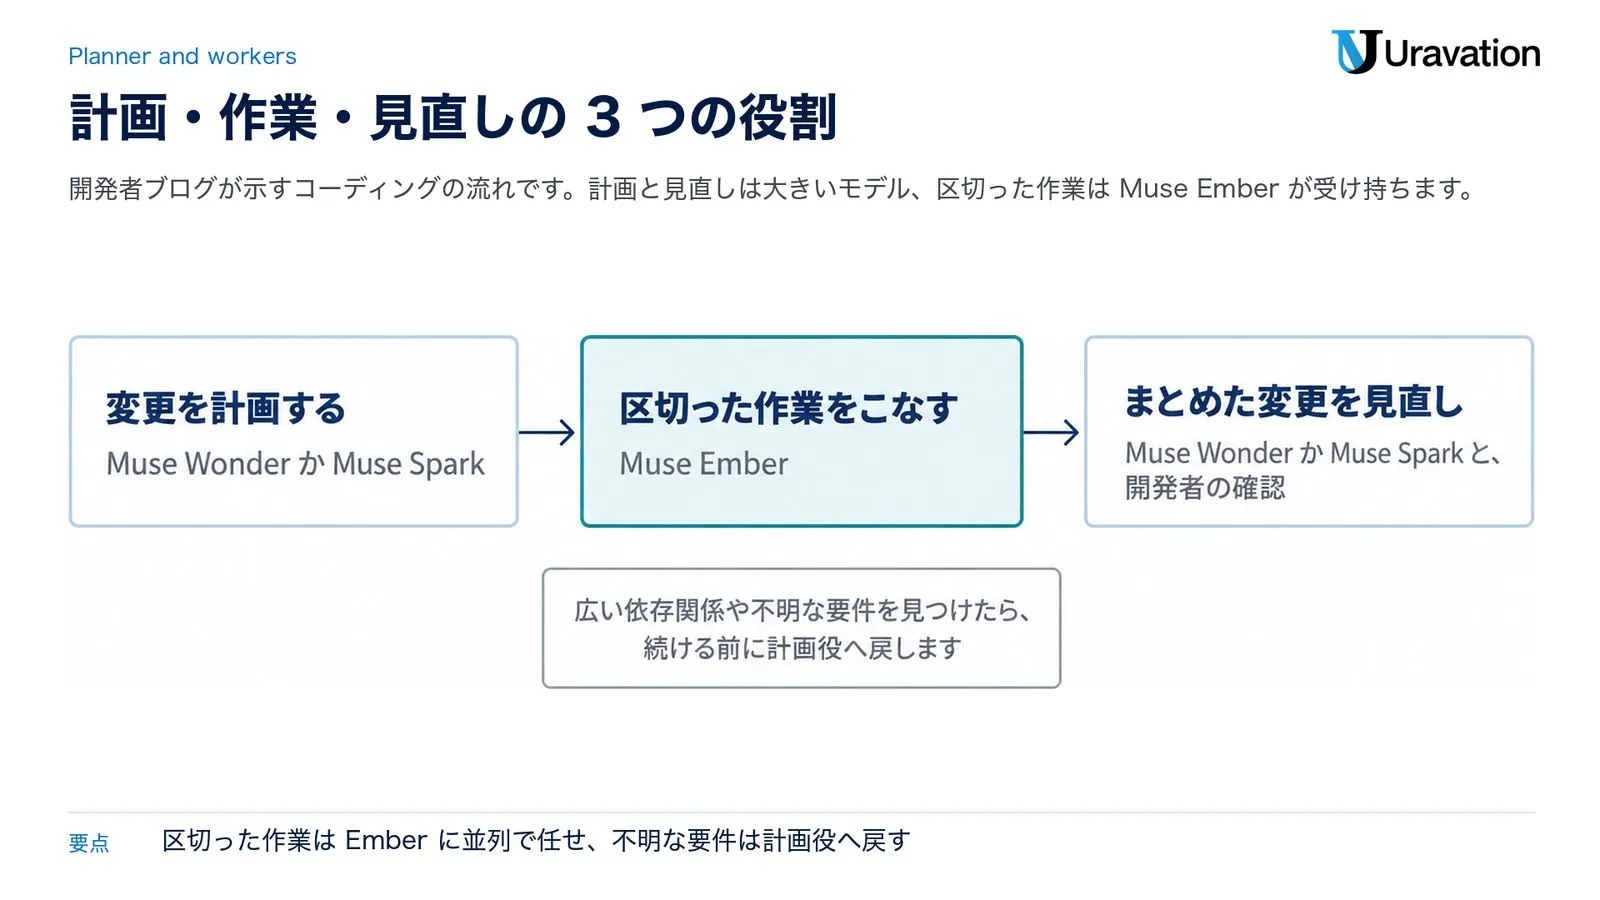
開発者ブログは、コーディングの流れを次の 3 つの役割に分けています(開発者ブログ)。
| 流れの段 | 勧めるモデル |
|---|---|
| リポジトリ全体の変更を計画する(依存関係と合格の条件を含む) | Muse Wonder か Muse Spark |
| 関係するファイル・制約・テストを使って、区切った作業をこなす | Muse Ember |
| まとめた変更を見直し、残った問題を考え抜く | Muse Wonder か Muse Spark と、開発者の確認 |
作業役に渡す内容として、ブログは「仕事・関係する文脈・作業役が変えてよいファイル・合格の確かめ・返す結果」を決めるよう書いています。作業役が広い依存関係や不明な要件を見つけたら、続ける前に計画役へ戻します。API を直接呼ぶ場合、モデルが返すのは答えと道具の呼び出しの依頼だけで、道具を実際に動かして結果を返すのはアプリ側です。
ブログには Meta が試した例が 2 つ載っています。数字はどちらも Meta の実行の結果です。
- Python から Rust への移植:Pygments(構文の色付けのライブラリ)の 16 言語分の字句解析器を、Muse Wonder が計画・監督し、Ember の作業役 16 体が並列で移植しました。16 個すべてが 383 の試験の入力と、コードを固めた後に渡した実ファイル 62 本で Python と同じ結果になりました。入力トークンは Ember が 1 億 5,800 万、Wonder が 440 万で、費用は従量の単価で約 3.96 ドル(Wonder 2.12 ドル・Ember 1.84 ドル)で、ブログは「結果は回ごとに違う」と添えています。
- 写真 10,000 枚の整理:Muse Wonder が見本から 8 つのアルバムを決めて処理の台本を書き、Ember の作業役 16 体が分担しました。台本は 1 回の要求に写真 8 枚(512 ピクセル・エフォートは minimal)を送ります。費用はブログの中で 2 通りに書かれていて、ある段落は合計 1.59 ドル(うち Ember 0.50 ドル)、別の段落は合計 1.33 ドル(Wonder 0.81 ドル・Ember 0.52 ドル)です。同じ要求を Wonder の単価で回すと約 20 ドルだったとしています。
写真の例で Muse Code に渡す作業役の定義は次のとおりです(開発者ブログの公式の例・当社は実行していません)。仕事の中身は計画役の Muse Wonder が書きます。"model": "muse-ember" は版の数字なしの書き方で、前の節のとおり docs の標準は muse-ember-1.0 です。
{
  "ember-worker": {
    "description": "A muse-ember worker for one bounded, fully specified task. Give it the complete task: the files it owns, the commands to run, and what to report.",
    "model": "muse-ember",
    "effort": "low",
    "maxTurns": 20,
    "prompt": "Do exactly the task in your input. Edit only the files it names, run the commands it gives, fix your own files if a command fails, and report the result in one short line. Never claim a result you did not run."
  }
}
Claude Code と Claude Agent SDK でもこの分け方を組めると docs は書いています(Choose a model)。Claude Code の設定は次の節で扱います。
エフォートの既定は max|費用の注意と見落としやすい 4 点
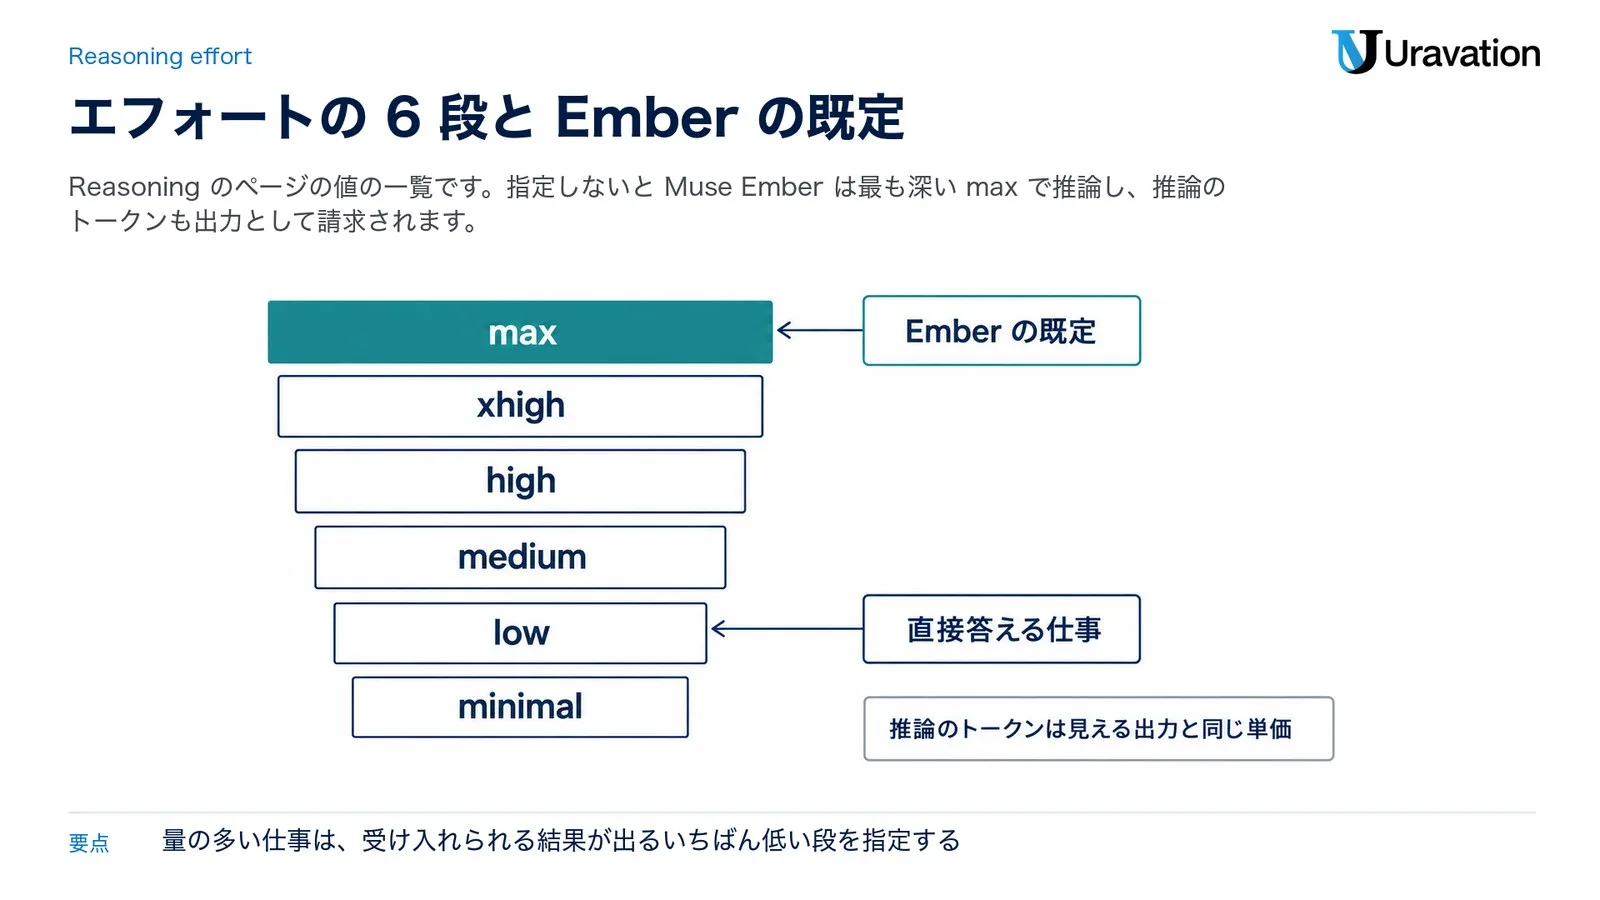
Ember は推論モデルで、見える答えの前に内部で推論のトークンを作ります。その量を決めるのがエフォート(reasoning_effort)で、要求で指定しない時の既定は Ember と Muse Wonder が最も深い "max"、Muse Spark が "high" です(Reasoning)。
| 値 | docs の説明 |
|---|---|
"minimal" |
いちばん短い推論 |
"low" |
軽い推論 |
"medium" |
中くらいの深さ |
"high" |
深い推論 |
"xhigh" |
さらに深い推論 |
"max" |
"xhigh" より長い推論(Ember の既定) |
推論を切る "none" は Ember では使えず、HTTP 400 が返ります。推論のトークンは見える出力と同じ単価で出力として請求され、出力の上限(Responses API の max_output_tokens)も推論と答えの合計で数えます。docs は「受け入れられる結果が出るいちばん低い段を使う」よう勧め、引き当て・整形・翻訳のような直接答える仕事には "low" を挙げています。指定する場所は、Responses API では reasoning.effort、Chat Completions では一番上の reasoning_effort です。
次は Muse Ember の docs の例に、Reasoning のページの reasoning.effort の書き方を足し、値を docs の一覧にある "low" にした形です(公式の例をもとにしたもの・当社は実行していません)。
curl -X POST "https://api.meta.ai/v1/responses" \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-ember-1.0",
  "reasoning": {
    "effort": "low"
  },
  "input": "Classify this support ticket as billing, bug, or feature request, and give a one-sentence reason: \"I was charged twice for my October invoice.\""
}'
エフォートを指定しないまま大量に回す
❌ 振り分けや抽出のような短い仕事を、エフォートの指定なしで何千回も呼ぶ。既定の "max" で推論のトークンが増え、出力の料金と待ち時間が増える。
⭕ 小さな見本で段を比べ、受け入れられる結果が出るいちばん低い段を要求に書く(Reasoning)。開発者ブログの写真の例も、Ember への要求は minimal、作業役の定義は "effort": "low" でした。
会話を続けるうちに入力が 20 万トークンを超える
❌ previous_response_id で長い会話をつなぎ続け、ある要求から入力が 20 万トークンを超える。その要求は全体が長い文脈の単価になる。
⭕ 応答の usage で入力のトークン数(キャッシュ分を含む)を見る。docs も、実際の入力の大きさで費用を比べるよう書いています(Pricing and rate limits・Choose a model)。
出力の上限を小さくして答えが切れる
❌ max_output_tokens を見える答えの長さだけで決め、推論で上限を使い切って答えが途中で切れる。
⭕ 上限は推論と答えの合計なので余裕を持たせる。docs は、"max" では推論が出力に占める割合が大きくなるので、上限を多めに取るよう書いています(Reasoning)。
Claude Code をつなぐ時に別名を一部だけ替える
❌ Claude Code を Model API につなぐ時に主のモデルだけを替え、haiku の別名やサブエージェントのモデルを残す。Model API は Claude のモデルを出していないので、その経路は届かないモデルを呼ぼうとする。
⭕ docs の設定は、Claude Code 全体を Model API に向け、すべての別名を Muse のモデルに固定するものです。主ループは muse-wonder-1.0、haiku の別名とサブエージェントは muse-ember-1.0 です(Use Model API with coding agents・公式の例・当社は実行していません)。キーは ANTHROPIC_API_KEY ではなく ANTHROPIC_AUTH_TOKEN で渡し、ENABLE_TOOL_SEARCH は MCP の道具の検索を有効のままにする設定です。
export ANTHROPIC_BASE_URL="https://api.meta.ai"
export ANTHROPIC_AUTH_TOKEN="$MODEL_API_KEY"
export ANTHROPIC_MODEL="muse-wonder-1.0"
export ANTHROPIC_DEFAULT_OPUS_MODEL="muse-wonder-1.0"
export ANTHROPIC_DEFAULT_SONNET_MODEL="muse-spark-1.3"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="muse-ember-1.0"
export CLAUDE_CODE_SUBAGENT_MODEL="muse-ember-1.0"
export ENABLE_TOOL_SEARCH="true"
Claude Haiku 5.5 との比べ方|単価は両社の公式、ベンチマークは Meta の発表
Claude Haiku 5.5 は Anthropic のモデルで、Anthropic は「最も速く最も安いモデルで、手早い調べ物や、要約・データの仕分けのような量の多い仕事向け」「短く範囲の狭い仕事に向く」と説明しています(Anthropic の記事)。Meta は Ember の比べる相手に、Haiku 5.5 と GPT-6 Luna(OpenAI のモデル)を選んでいます。
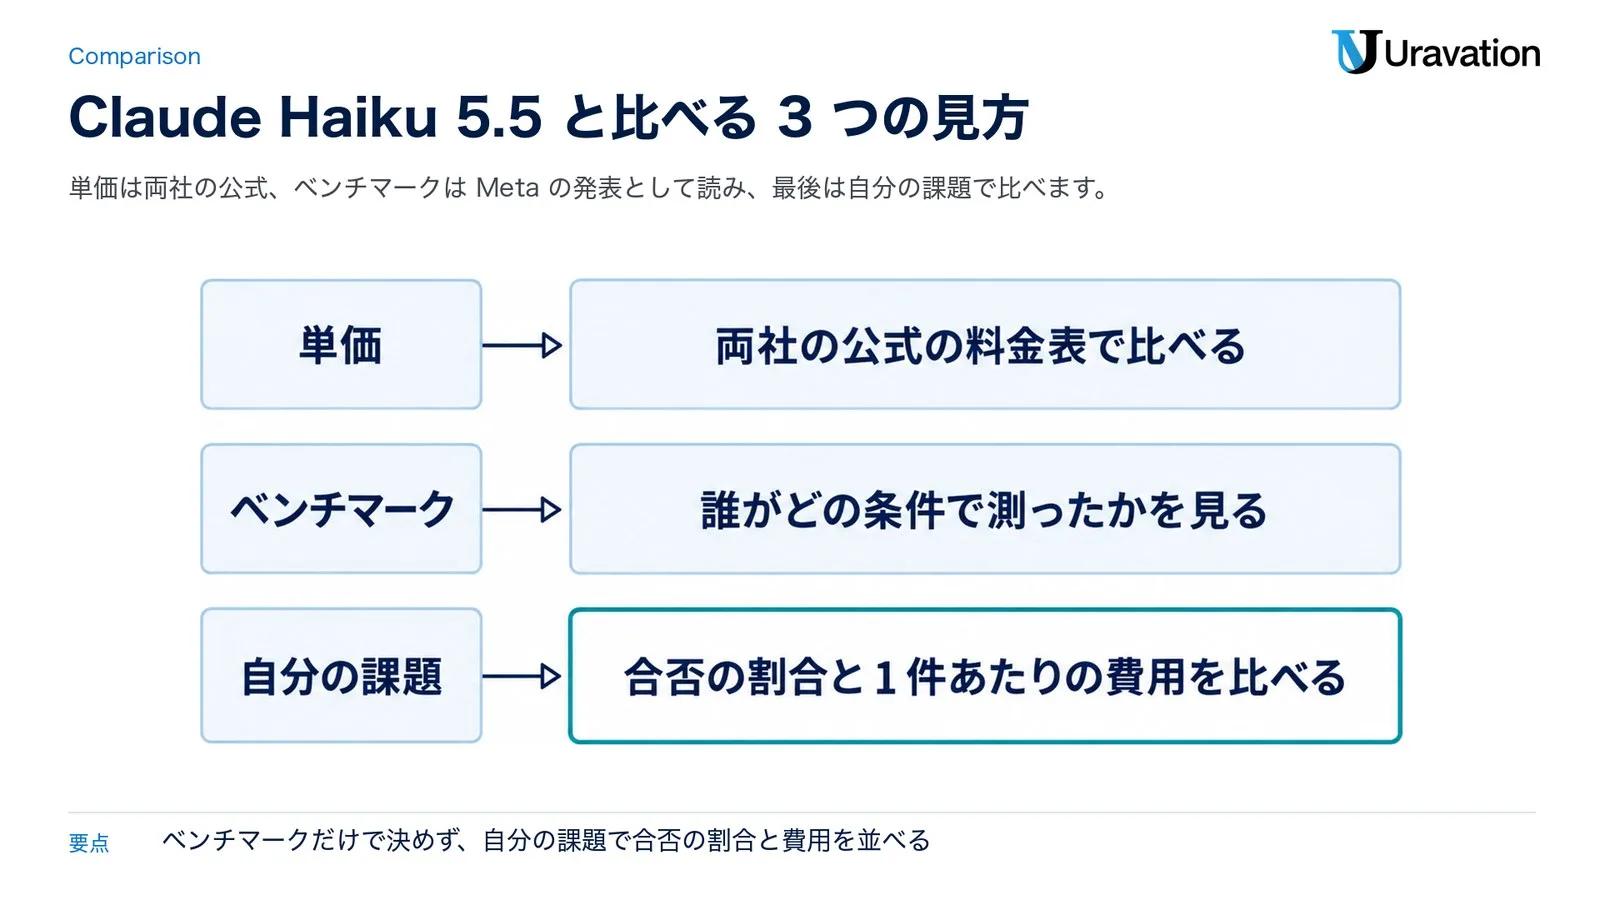
比べる時は、次の 3 つの見方を分けます。
- 単価:両社の公式の料金表で比べる。
- ベンチマーク:Meta の発表の数字として読み、誰がどの条件で測ったかを見る。
- 自分の課題:同じ課題を両方に流し、合否の割合と 1 件あたりの費用を比べる。
| モデル(100 万トークンあたり) | 入力 | 出力 | 単価が変わる境と、その先の単価 |
|---|---|---|---|
| Muse Ember(Meta の料金ページ) | 0.10 ドル | 0.50 ドル | 要求の入力トークン(キャッシュ分を含む)が 20 万トークンを超えると、要求の全体が入力 0.30 ドル・出力 1.50 ドル |
| Claude Haiku 5.5(Anthropic の記事) | 0.10 ドル | 0.50 ドル | この単価は 10 万トークンまでのプロンプトに当てはまり、それより長いプロンプトは入力 0.50 ドル・出力 2.50 ドル |
短い入力の単価は同じで、違うのは単価が変わる境(Ember は 20 万トークン、Haiku 5.5 は 10 万トークン)とその先の単価です。数え方は各社の書き方のまま写しました。Haiku 5.5 のキャッシュの単価は、この出典には書かれていません。
ベンチマークは、研究ブログの表(開発者ブログにも同じ表)を写し、Meta の評価の方法の資料をもとに「測った主体・条件」の列を足しました。Artificial Analysis はモデルの評価を公表している外部の団体、ハーネスはモデルを動かすエージェントの枠組みです。エフォートはどれも max です(研究ブログ・評価の方法(PDF))。
| 評価 | Muse Ember | Claude Haiku 5.5 | 測った主体・条件 |
|---|---|---|---|
| AutomationBench-AA(業務の流れ) | 37.8 | 13.9 | Artificial Analysis(Zapier の非公開の 657 タスク) |
| Agents’ Last Exam(エージェントの課題) | 61.6 | 57.0 | Meta の社内(ALE v1.0 の Linux 課題 105 件から 5 件を全モデル共通で除外した 100 件・共通のループ) |
| Personal Superintelligence Index | 46.8 | 36.1 | Meta の社内の 8 つの評価の合成 |
| Terminal-Bench 4.0(ターミナルでのコーディング) | 40.9 | 39.2 | 別々のハーネスの値を並べたもの。Ember は Artificial Analysis が mini-swe-agent で実行、Haiku 5.5 は Anthropic のシステムカードの Claude Code の結果 |
| Coding Agent Index-AA | 46 | 37 | Artificial Analysis。Ember は Muse Code、Haiku 5.5 は Claude Code の中で実行 |
| FrontierCode 2.0-AA(マージできる変更か) | 27.2 | 34.9 | Artificial Analysis(非公開の 132 タスク) |
| GDP.pdf-AA(長い文書での仕事) | 22.8 | 20.8 | Artificial Analysis |
| OSWorld 2.1(デスクトップの操作) | 部分点 69.5/満点の割合 33.8 | 部分点 68.9/満点の割合 27.8 | Meta の社内(108 タスク・公式の実行環境ではない) |
| PerceptionBench(細かい視覚) | 80.6 | 78.6 | Meta の社内(道具あり) |
| Artificial Analysis Index(総合) | 36 | 36 | Artificial Analysis(Intelligence Index v5) |
Meta の表で Haiku 5.5 が上なのは FrontierCode 2.0-AA(34.9 対 27.2)で、総合の Artificial Analysis Index は 36 で並んでいます。研究ブログは「どのエフォートでも Haiku 5.5 や GPT-6 Luna より 1 ドルあたりの知能が高く、Haiku の最高点に約 3 分の 1 の費用で並ぶ」と書き、根拠の図の注で Ember の費用を推定としています。課題 1 問あたりの Ember の費用(推定)は、研究ブログが約 0.14 ドル、開発者ブログが約 0.13 ドルと、2 つの記事で少し違います。
評価の方法の資料で、Meta は他社のモデルを社内で動かした結果を「最善の努力」とし、プロンプト・道具・実行環境が他社のモデル向けに最適に調整されていない場合があると書いています。Haiku 5.5 もエフォートを選べるモデル(Anthropic の説明)なので、段をそろえ、応答の usage のトークン数に各社の単価を掛けた 1 件あたりの費用と合否の割合を、自分の課題で並べて比べます。
よくある質問
Muse Ember のモデル ID は何ですか?
docs の標準のモデル ID は muse-ember-1.0 です。開発者ブログの写真の例は版の数字なしの muse-ember と書いていますが、docs・研究ブログ・同じブログの別の例は muse-ember-1.0 なので、こちらを使います(Muse Ember の docs)。
Muse Ember の料金はいくらですか?
100 万トークンあたり、入力が 20 万トークンまでの要求は入力 0.10 ドル・キャッシュ入力 0.004 ドル・出力 0.50 ドル、20 万トークンを超える要求は全体が入力 0.30 ドル・キャッシュ入力 0.012 ドル・出力 1.50 ドルです。推論のトークンは出力として請求され、Web 検索の接地は検索 1,000 回あたり 2.50 ドルが別にかかります(Pricing and rate limits)。
Muse Code の定額プランでも Muse Ember を使えますか?
使えます。docs は Ember を Muse Code の従量制とすべてのプランで使えるとしています。定額プランでは、入力が 20 万トークンを超える要求はプランの使用量を早く使います(Muse Ember の docs)。
Muse Ember に送った内容は Meta の学習に使われますか?
Model API の Ember は Standard mode だけなので、送った内容は Meta のモデルの学習に使われません。Muse Code の定額プランは、選んだモデルに関係なく既定で Contributor mode(学習に使ってよいとする方式)の扱いなので、Standard mode にしたい時はアカウントの設定を変えます(料金ページ・Geographic Use Policy)。
日本から Muse Ember を使えますか?
2026年11月9日更新の Geographic Use Policy で、使えない地域(Restricted Territories)の一覧と、モデルごとの制限(Muse Wonder と Muse Wonder Full は韓国で使えない)に、日本と Muse Ember は入っていません。ただし同じ方針は、Meta が使えるようにした地域だけで使えることと、Meta がいつでも地域の扱いを変えられることも書いています。この方針だけでは、日本から利用できるとは確認できません。当社は日本から Ember を呼んで確かめてはいません(Geographic Use Policy)。
Claude Code のサブエージェントを Muse Ember にできますか?
docs の Claude Code の設定では、haiku の別名とサブエージェントのモデル(CLAUDE_CODE_SUBAGENT_MODEL)を muse-ember-1.0 にしています。ただしこの設定は Claude Code 全体を Model API に向け、主ループも Muse Wonder にするもので、docs はすべての別名を Muse のモデルに固定するよう書いています(Use Model API with coding agents)。
まとめ
- Muse Ember は、Meta が 2026年11月9日付の研究ブログで発表した Muse の推論モデルで、量が多く繰り返す仕事に向きます。
- モデル ID は
muse-ember-1.0。入力 20 万トークンまでの要求は 100 万トークンあたり入力 0.10 ドル・出力 0.50 ドル、超えると要求の全体が入力 0.30 ドル・出力 1.50 ドルです。 - エフォートの既定は max です。量の多い仕事では、受け入れられる結果が出るいちばん低い段を要求に書きます。
- 計画は Muse Wonder か Muse Spark、区切った作業は Ember。Muse Spark と同じ要求の形なので、多くはモデル ID の差し替えで試せます。
- Claude Haiku 5.5 とは短い入力の単価が同じで、単価が変わる境が違います。ベンチマークは Meta の発表として読み、自分の課題で比べます。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Muse Ember — Meta Model API docs(参照日: 2026-11-13)
- Start building with Muse Ember, our smallest, most efficient model — Meta AI Developer blog(参照日: 2026-11-13)
- Introducing Our Smallest, Most Efficient Model: Muse Ember — Meta AI Research(2026年11月9日・参照日: 2026-11-13)
- Muse Ember Evaluation Methodology(PDF) — Meta(2026年11月・参照日: 2026-11-13)
- Pricing and rate limits — Meta Model API docs(参照日: 2026-11-13)
- Choose a model — Meta Model API docs(参照日: 2026-11-13)
- Quickstart — Meta Model API docs(参照日: 2026-11-13)
- Reasoning — Meta Model API docs(参照日: 2026-11-13)
- Models — Meta Model API docs(参照日: 2026-11-13)
- Open-weight models — Meta Model API docs(参照日: 2026-11-13)
- Use Model API with coding agents — Meta Model API docs(参照日: 2026-11-13)
- Meta Model API Model Designation and Geographic Use Policy — Meta(2026年11月9日更新・参照日: 2026-11-13)
- Try Meta’s latest models in the Google Cloud model garden — Google Cloud(参照日: 2026-11-13)
- Using Claude Opus 5.5 as your daily driver for knowledge work — Anthropic(2026年11月12日・参照日: 2026-11-13)