結論(2026年9月24日時点)
- Meta Model API は、Meta の Muse Spark 系モデルを従量課金で呼び出す開発者向け APIです。ベース URL は
https://api.meta.ai/v1で、OpenAI SDK(Responses / Chat Completions)と Anthropic の Messages API にドロップイン互換。既存コードのbase_urlを差し替えるだけで叩けます。 - 単価は100万トークンあたり、Standard ティアがキャッシュ入力 $0.15(約23円)/入力 $1.25(約188円)/出力 $4.25(約638円)、Contributor ティアがキャッシュ入力 $0.002(約0.3円)/入力 $0.10(約15円)/出力 $0.20(約30円)(1ドル150円換算)。Contributor は自分のプロンプトと出力を Meta のモデル学習に使うことを許諾する代わりに安く使える枠で、Standard では学習に使われません。
- モデル ID は
muse-spark-1.3(最新・ドキュメントの既定)、muse-spark-1.3-contributor、muse-spark-1.2、muse-spark-1.2-contributor、muse-spark-1.1。ほかにmuse-image-1.0(画像生成)、muse-voice-transcribe-1.0(音声のテキスト化)、sam-3.1(領域分割)があります。Muse Spark のコンテキストウィンドウはいずれも 1,048,576 トークンです。 - レート制限はStandard が 3,000 リクエスト/分・4,000,000 トークン/分、Contributor が 100 リクエスト/分・3,000,000 トークン/分。上限は API キー単位ではなくチーム単位で共有されます。
- 最小の呼び方は、curl なら
POST https://api.meta.ai/v1/responsesにAuthorization: Bearer $MODEL_API_KEYと{"model": "muse-spark-1.3", "input": "..."}。Python の OpenAI SDK ならbase_urlを差し替えたうえでapi_keyを明示的に渡します(OpenAI SDK は既定でOPENAI_API_KEYを探しにいくため)。
Meta Model API の Standard ティアは、2026年9月24日時点で入力100万トークンあたり $1.25(約188円)・出力 $4.25(約638円)・キャッシュ入力 $0.15(約23円)。同日に公式料金ページで確認できた OpenAI の gpt-6-sol(入力 $2.00/出力 $10.00)、Anthropic の Claude Sonnet 5(入力 $2/出力 $10)と比べると、入力で約6割、出力で4割強の水準になる。最新モデルは muse-spark-1.3 で、2026年9月2日の Meta AI Research の発表以降、9月24日時点で後継バージョンは公開されていない。
この記事では、Meta 公式の開発者ドキュメント(dev.meta.ai)・料金とレート制限のページ・地域利用ポリシーを2026年9月24日に取得し、そこに書かれている値だけで、APIキーの取り方から最初のリクエスト、料金の見積もり、日本から使うときの条件までをまとめる。公式に記載がない項目は「2026年9月24日時点で公式に記載なし」と明記し、推測では埋めない。
結論:Meta Model APIで何ができるのか
先に要点を並べる。
- ベースURL:
https://api.meta.ai/v1(OpenAI SDK系)/https://api.meta.ai(Anthropic Messages API系・SDKが/v1/messagesを付け足す) - モデルID:
muse-spark-1.3(2026年9月24日時点の既定。ほかに muse-spark-1.3-contributor/1.2/1.2-contributor/1.1、画像の muse-image-1.0、音声の muse-voice-transcribe-1.0、領域分割の sam-3.1) - コンテキストウィンドウ:1,048,576トークン(Muse Spark の3バージョンすべて共通)
- 最大出力:131,072トークン(公式Quickstartのエージェント設定例に記載の値)
- 料金:入力 $1.25 / 100万トークン、出力 $4.25 / 100万トークン、キャッシュ入力 $0.15 / 100万トークン(Standardティア)
- 対応プロトコル:OpenAI Responses API・Chat Completions API・Anthropic Messages API
- 対応エージェントCLI:Claude Code、OpenCode、Codex、Goose、Rooなど(公式ドキュメントに設定例あり)
Muse Spark の入力モダリティはテキスト・画像・動画・音声・PDF、出力はテキストのみ。ただし公式のモデル一覧には「Muse Spark 1.3 の音声理解は現在フルサポートではなく、音声を含むリクエストは応答品質が落ちる可能性がある。音声は 1.2 か Muse Voice Transcribe を使うこと」という注記がある。音声を扱うなら 1.3 を素直に選ばない、が公式の推奨だ。
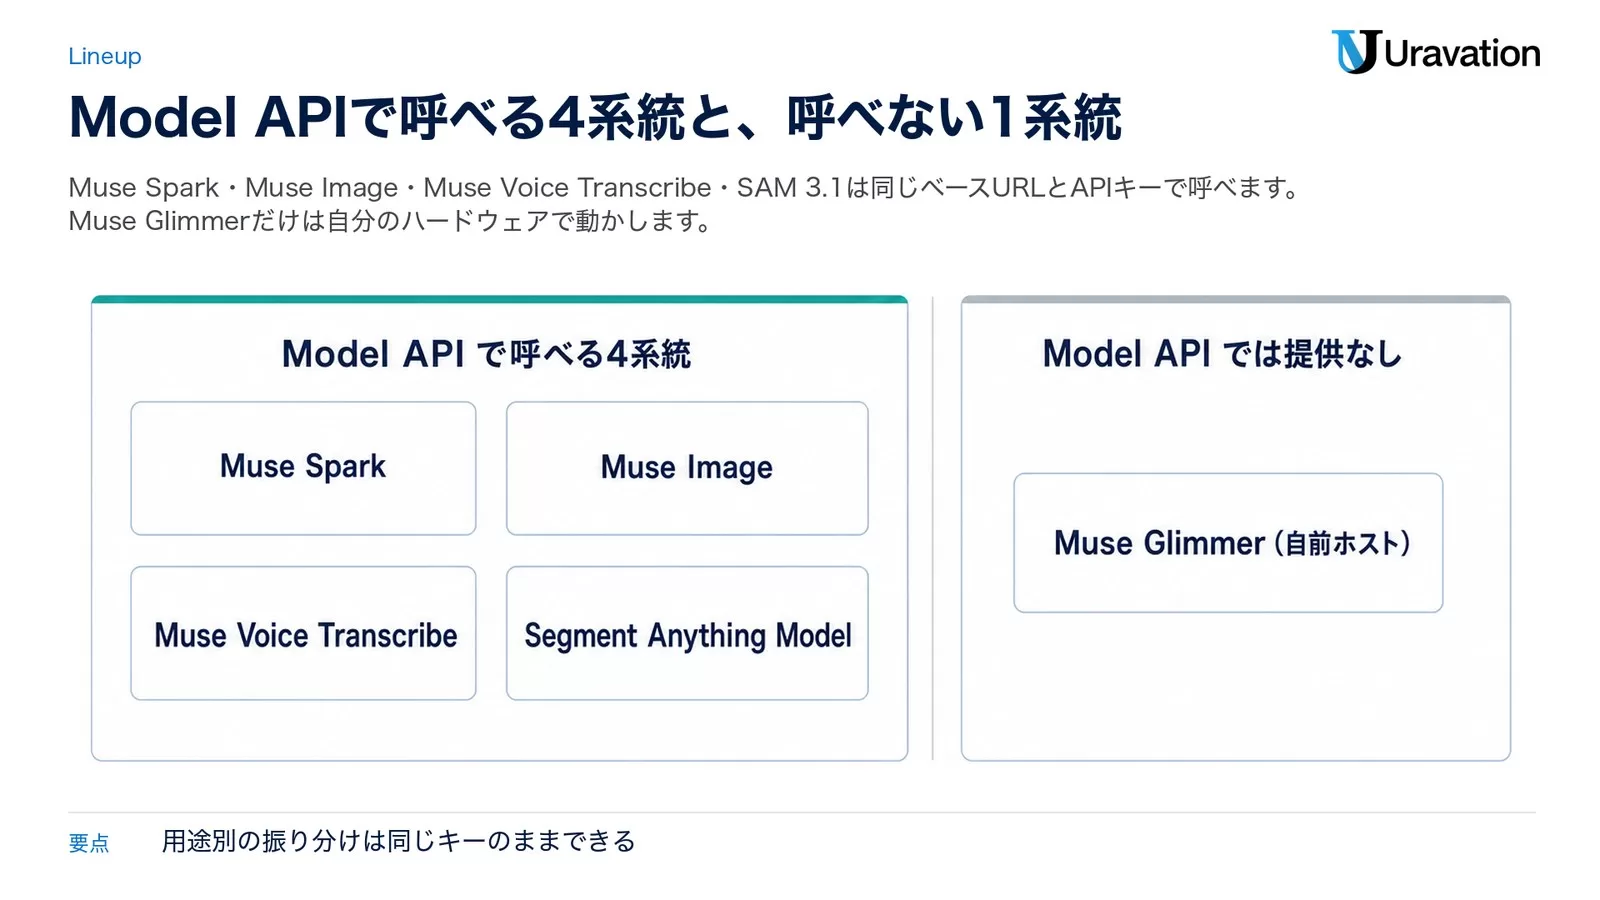
Model API で呼べる4系統と、呼べない1系統
2026年9月24日時点で Meta が公開しているモデルは5系統ある。このうち API で叩けるのは4系統で、Muse Glimmer だけは自分のハードウェアで動かす形になる。
| 系統 | モデルID | 入力 | 出力 | 呼び出し先 |
|---|---|---|---|---|
| Muse Spark | muse-spark-1.3 ほか4種 | テキスト・画像・動画・音声・PDF | テキスト | Responses/Chat Completions/Messages |
| Muse Image | muse-image-1.0 | テキスト・画像 | 画像 | Responses//v1/images/generations・/v1/images/edits |
| Muse Voice Transcribe | muse-voice-transcribe-1.0 | 音声 | 文字起こしテキスト | wss://api.meta.ai/v1/asr/realtime/POST /v1/asr/transcribe |
| Segment Anything Model | sam-3.1 | テキスト指示・画像・動画 | ボックスとマスク | POST /v1/responses |
| Muse Glimmer | (オープンウェイト) | マルチモーダル | テキスト | Model API では提供なし・自前ホスト |
初版(2026年7月)で「モデルは1種類のみ、用途ごとの使い分けはできない」と書いたが、これは 2026年9月24日時点では誤りになった。画像生成・音声認識・領域分割が同じベースURLと同じAPIキーでぶら下がっており、用途別の振り分けができる。Muse Glimmer をローカルで回す手順はMuse Glimmerの使い方|30BをOllamaでローカル実行にまとめている。
APIキーの取得と最初のリクエスト(公式の手順どおり)
手順は公式のAuthenticationページとヘルプセンターに書かれているとおり、アカウント作成 → 支払い方法の登録 → APIキー発行の3段だ。ヘルプセンターの「How do I sign up for Model API?」には、18歳以上であることとサポート対象の国・地域にいることが事前条件として明記されている。
- アカウントを作る:Model API のサイトで「Start building」を選び、メールアドレスか携帯番号、または Facebook・Google・GitHub のいずれかでアカウントを作成する。サインアップすると同時にチームが1つ作られる。
- 支払い方法を登録する:ダッシュボードの Billing でカード情報を登録し、続けてビジネス情報(税務書類に使う法人名と住所。法人でない場合は本名と郵送先住所)を入力する。この登録は管理者権限が要る。
- APIキーを発行する:ダッシュボードの「API keys」タブ →「Create API key」→ 名前を付けて作成。キーが表示されるのは1回だけなので、その場でコピーしてシークレットマネージャか環境変数に入れる。キーの形式は
LLM|(数字列)|(英数字)。
キーはチーム単位で発行され、同じチームのメンバーは同じキーを使える。取り消しはダッシュボードでキーの横の Delete を押すだけで、ほかのキーには影響しない。
export MODEL_API_KEY="LLM|607358788850350|nx9.....LJY"キーを入れたら、公式Quickstartに載っている最小のリクエストで疎通を確認する。必要なのは curl か Python 3.9以上、または Node.js 18以上。
curl -X POST "https://api.meta.ai/v1/responses" \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-spark-1.3",
  "input": "What is the capital of France?"
}'
Python(OpenAI SDK)から呼ぶ場合は、base_urlを差し替えるだけでいい。
from openai import OpenAI
import os

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.responses.create(
    model="muse-spark-1.3",
    input="この関数のテストコードを書いて: def add(a, b): return a + b",
)
print(response.output_text)
Anthropic SDK を使う場合は、ホストを https://api.meta.ai(/v1なし)に向け、auth_token に MODEL_API_KEY を渡したうえで client.messages.create() を呼ぶ。TypeScript版のOpenAI SDKでも baseURL を書き換えるだけで動く。
from anthropic import Anthropic
import os

client = Anthropic(
    base_url="https://api.meta.ai",
    auth_token=os.environ["MODEL_API_KEY"],
)

message = client.messages.create(
    model="muse-spark-1.3",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Explain mixture-of-experts in two sentences."}],
)
print(message.content[0].text)
最初に踏みやすい2つの落とし穴
公式ドキュメントが名指しで注意している詰まりどころが2つある。
- OpenAI SDK は
MODEL_API_KEYを自動で読まない。既定で探すのはOPENAI_API_KEYなので、クライアント生成時にapi_keyを明示的に渡すか、OPENAI_API_KEYに Model API のキーを入れる。Meta の公式SDKを使う場合はMODEL_API_KEYを自動で読むため、この差が混乱の元になる。 - エラーは401と404の切り分けから。
401 authentication_errorはキーが未設定か無効、404 model_not_foundはモデルIDの綴りミス。公式Quickstartのトラブルシューティングはこの2つだけを挙げている。
なお、Meta 自身のコーディングエージェント「Muse Code」を使うなら、APIキーを作らずブラウザ認証だけで始められる。インストールは macOS・Linux が curl -fsSL https://dev.meta.ai/install.sh | sh、Windows が irm https://dev.meta.ai/install.ps1 | iex。機能と料金体系はMuse Codeとは|機能・料金・使い方と設計者への影響にまとめている。
料金早見表(2026年9月24日時点・1ドル150円換算)
Meta Model API は前払いも最低利用料金もない従量課金で、テキストはトークン単位、画像は1枚単位、音声は処理した分数、領域分割は画像・フレーム単位で課金される。以下はすべて公式の料金ページを2026年9月24日に取得した値で、円は1ドル150円で換算した参考値だ。
Muse Spark(テキスト・100万トークンあたり)
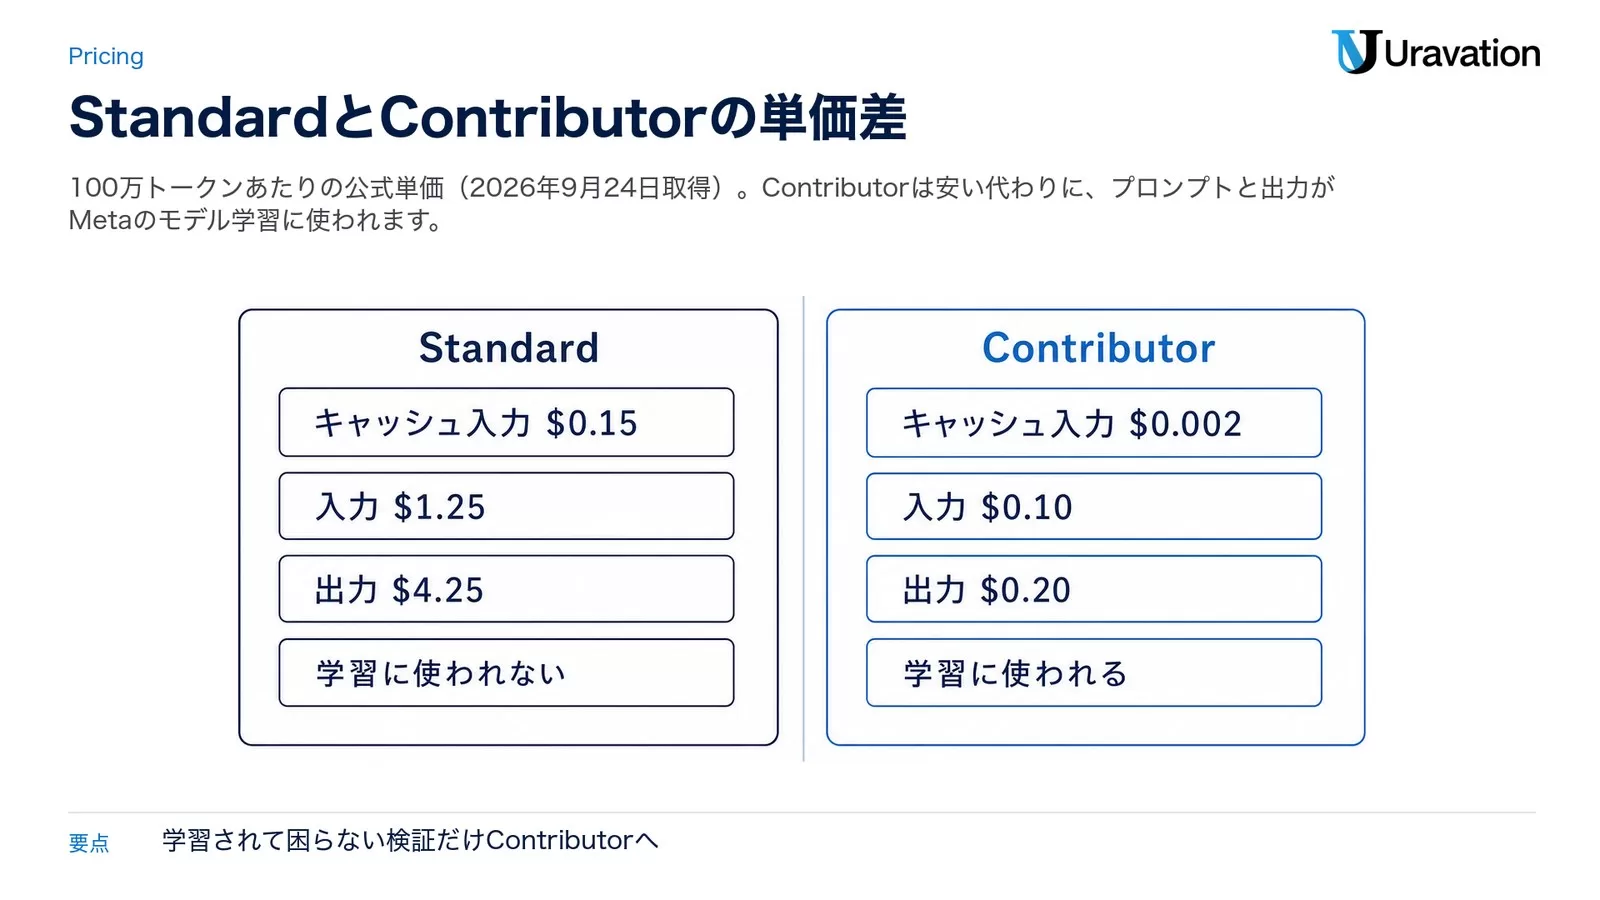
| 種別 | Standard(1.3/1.2/1.1) | Contributor(1.3/1.2) |
|---|---|---|
| キャッシュ入力 | $0.15(約23円) | $0.002(約0.3円) |
| 入力 | $1.25(約188円) | $0.10(約15円) |
| 出力 | $4.25(約638円) | $0.20(約30円) |
| 学習への利用 | されない | される(許諾が前提) |
Muse Spark 1.1・1.2・1.3 はどのバージョンでも Standard の単価が同じ。新しいから高い、という構造にはなっていない。
Muse Spark 以外
| 対象 | 単価 | 円換算(1ドル150円) |
|---|---|---|
| Muse Image(画像生成) | $0.01 / 1枚 | 約1.5円 |
| Muse Voice Transcribe(音声) | $0.18 / 1時間 | 約27円 |
| SAM 3.1(画像の領域分割) | $2.50 / 1,000枚 | 約375円 |
| SAM 3.1(動画の領域分割) | $0.20 / 1,000フレーム | 約30円 |
| Web検索グラウンディング | $2.50 / 1,000クエリ | 約375円(トークン課金に加算) |
Muse Image に内蔵されたWeb検索・画像検索は1枚あたりの価格に含まれ、別課金にならない。生成に失敗した画像と、安全フィルタで返却前に除かれた画像は課金対象外だ。Muse Voice Transcribe はストリーミングとファイル処理で同額で、音声の秒数はトークン課金とは別の明細行になる(秒未満は切り捨て)。
試算:入力2,000・出力500トークンを1,000回
公式単価から素直に計算すると、Standard ティアでのコストは次のようになる。
入力: 2,000 × 1,000 ÷ 1,000,000 × $1.25 = $2.50
出力:   500 × 1,000 ÷ 1,000,000 × $4.25 = $2.13
合計:   約 $4.63(1ドル150円換算で約695円)
同じ処理量を Contributor ティア(入力 $0.10/出力 $0.20)で回すと約 $0.30(約45円)。学習に使われてよい検証用トラフィックだけ Contributor に寄せる、という設計が価格差からも成り立つ。
もうひとつ、公式が明記している重要な性質が「長コンテキストの割増料金がない」点だ。コンテキストがほぼ空でも100万トークン近くまで埋まっていても、単価は変わらない。長い設計書やリポジトリ全体を毎回投げるエージェントでは、この一点が実効単価を大きく左右する。課金の考え方全体はAIエージェントのコスト管理|API従量とサブスク徹底比較で整理している。
レート制限とプロンプトキャッシュの実装
レート制限はティアとモデル系統で分かれ、APIキー単位ではなくチーム単位で適用される。同じチームで複数のキーを使っても、リクエスト・トークン・画像・音声分数はすべて共有クォータに積み上がる。
| 対象 | リクエスト/分(RPM) | トークン/分(TPM) |
|---|---|---|
| Standard(muse-spark-1.3/1.2/1.1) | 3,000 | 4,000,000 |
| Contributor(1.3-contributor/1.2-contributor) | 100 | 3,000,000 |
| Muse Image(muse-image-1.0) | 150 | 制限なし(枚数課金のため) |
| SAM 3.1 | チームのティア上限に合算 | 同左 |
Contributor は単価が安い代わりに RPM が 100 と厳しい。本番の並列処理を Contributor で回す設計は、料金より先に RPM で頭打ちになる。
実装上、公式が指示している点は4つある。
- 429 のリトライはジッター付き指数バックオフ。初期遅延は500ミリ秒程度から始め、連続して制限に当たるたびに2倍にし、同時接続のクライアントが一斉に再送しないようランダムな揺らぎを足す。
- ヘッダーを読んで制限の前に減速する。成功レスポンスには
x-ratelimit-limit-tokens/x-ratelimit-remaining-tokens/x-ratelimit-limit-requests/x-ratelimit-remaining-requestsが付く。制限に当たってから反応するのではなく、残量を見て先に落とす設計が推奨されている。 - バックグラウンド実行は別枠。
background: trueでの投入は RPM・TPM とは別にチームあたり毎分600件の投入上限があり、超えると429 Too Many RequestsとRetry-Afterが返る。走行中のジョブは影響を受けない。 - Muse Voice Transcribe はトークンではなくストリーム数で制限される。同時ストリーム128・1時間あたりの開始ストリーム16,000の2軸で、リアルタイム側は拒否時にクローズコード1013、ファイル側は 429 が返る。
なお、Meta がすべてのプロンプトに注入するシステムプロンプト等の「ステアリング用コンテキスト」は課金されず、利用状況に表示されるトークン数にも含まれない。429の捌き方そのものはLLM APIのレート制限・スロットリング対策ガイド|429を捌くで共通の設計パターンを解説している。
プロンプトキャッシュはフラグ不要のプレフィックス方式
Meta Model API のプロンプトキャッシュは接頭辞(プレフィックス)キャッシュの自動適用で、キャッシュキーもフラグもブレークポイントも指定しない。リクエストごとにトークン列の先頭を直近のキャッシュと突き合わせ、一致した範囲だけをキャッシュから返す。開発者が操作できるのは「並び順」だけだ。
- システムプロンプト・指示・Few-shot の例といった変わらない内容を前に置く
- ユーザーの入力など毎回変わる内容を後ろに置く
- ヒット量は Responses なら
usage.input_tokens_details.cached_tokens、Chat Completions ならusage.prompt_tokens_details.cached_tokensで確認する
cached_tokens は入力トークンの内訳であって追加課金ではない。キャッシュ書き込みに別料金が発生しないのは、後述するとおり他社との明確な差になっている。3社のキャッシュ設計の比較はプロンプトキャッシュ比較2026|3大LLMのコスト最適化戦略にまとめた。
推論の深さ(reasoning_effort)は6段階
Muse Spark は reasoning_effort で推論の深さを段階指定できる。公式ドキュメントに載っている値は minimal/low/medium/high/xhigh/max の6つで、none は非対応。max は Standard ティアの muse-spark-1.3 だけで、Contributor では使えない。推論トークンは出力トークンの予算(max_tokens/max_output_tokens)に含まれて課金されるため、max を使うときは出力上限を大きめに取らないと可視の回答が途中で切れる。
OpenAI・Anthropic APIとの差(公式値だけで比べる)
3社の公式料金ページを2026年9月24日に取得して並べた。円は1ドル150円換算の参考値で、いずれも標準ティア・100万トークンあたりの表示価格。
| モデル | 入力 | キャッシュヒット | 出力 |
|---|---|---|---|
| muse-spark-1.3(Meta・Standard) | $1.25(約188円) | $0.15(約23円) | $4.25(約638円) |
| gpt-6-sol(OpenAI・短コンテキスト) | $2.00(約300円) | $0.20(約30円) | $10.00(約1,500円) |
| gpt-6-astra(OpenAI・短コンテキスト) | $10.00(約1,500円) | $1.00(約150円) | $50.00(約7,500円) |
| Claude Sonnet 5(Anthropic) | $2(約300円) | $0.20(約30円) | $10(約1,500円) |
| Claude Opus 5.5(Anthropic) | $4(約600円) | $0.20(約30円) | $20(約3,000円) |
出典は OpenAI 公式の Pricing ページと Anthropic 公式の Pricing ドキュメント(いずれも2026年9月24日取得)。
Metaが有利な点
- 表示単価:入力・出力とも、比較した中では最も安い。先ほどの試算(入力2,000・出力500を1,000回)を同じ式で解くと、muse-spark-1.3 が約$4.63、gpt-6-sol と Claude Sonnet 5 が約$9.00、Claude Opus 5.5 が約$18.00になる。
- キャッシュ書き込みが無料:OpenAI の料金表には「Cache writes」の列があり、gpt-6-sol の短コンテキストで $2.50/100万トークン。Anthropic も5分キャッシュで入力単価の1.25倍、1時間キャッシュで2倍の書き込み料金がかかる。Meta の料金ページにはキャッシュ書き込みの項目自体がない。
- 学習利用を明示的に切り分けている:Standard を選ぶ限り、規約5.1で「Standard Services のコンテンツを Meta モデルの学習に使わない」と条文で書かれている。安く使いたいときだけ Contributor を選ぶ、という明示的なトレードオフになっている。
他社が有利な点
- モデルの選択肢:OpenAI は gpt-6-astra/sol/luna、Anthropic は Fable 5.1/Opus 5.5/Sonnet 5/Haiku 4.5 と、性能と価格の階段が細かい。Meta の Muse Spark は1.1〜1.3がすべて同じ単価で、「安く済ませたい軽量モデル」に相当する階層が Standard 側に存在しない。gpt-6-luna は入力 $0.10・出力 $0.50 で、Meta の Standard より1桁安い。
- バッチ処理の割引:Anthropic は Batch API で入出力とも50%引き、OpenAI も Batch の料金表を別に持つ。Meta の料金ページには2026年9月24日時点でバッチ割引の記載がない。
- データ所在地の選択:OpenAI は地域処理エンドポイント(10%増し)、Anthropic は
inference_geoによる米国内推論(1.1倍)を公式に提供している。Meta Model API には同等の地域指定オプションが2026年9月24日時点の公式ドキュメントに見当たらない。 - 長コンテキストの扱いは互角:OpenAI は「Short context/Long context」の2列に分かれ、gpt-6-sol では入力が $2.00 から $4.00、出力が $10.00 から $15.00 に上がる(区切りのトークン数は取得したページに明記なし)。一方 Anthropic は Claude 4.6 以降で100万トークンまで標準単価、Meta も長コンテキスト割増なしと明記しており、この点は Meta と Anthropic が同条件になる。
OpenAI 側の移行で見るべき論点はGPT-6 Astra移行の準備5点|開発者チェックリストに、複数モデルを使い分ける設計そのものはモデルルーティング設計ガイド2026|タスク複雑度×コスト判断フローにまとめている。
日本からの利用条件とデータの扱い
日本から使えるかどうかを判断する材料は、公式には次の3つしかない。
- ヘルプセンターの記載:「Meta Model API は、Meta AI が利用でき、かつ課金が対応している大半の国と地域で利用できます」。そのうえで「Meta Model API Model Designation and Geographic Use Policy が正式な根拠である」と書かれている。
- 地域ポリシーの制限地域リスト(最終更新2026年9月18日):アフガニスタン、ベラルーシ、カンボジア、中国(香港・マカオを含む)、キューバ、エリトリア、エチオピア、ハイチ、イラン、イラク、リビア、ミャンマー、ニカラグア、北朝鮮、パキスタン、ロシア、ソマリア、シリア、ウクライナのクリミア・ドネツク・ルハンスク地域、ベネズエラ、西サハラ。日本はこのリストに含まれていない。モデル別の制限は「Muse Image はインドで利用不可」の1件のみ。
- 同ポリシーの但し書き:「本サービスはすべての法域で利用できるわけではなく、Meta は技術的手段等により提供可否を管理し、いつでも自らの裁量で有効化・制限できる」「利用可能性を示す参考情報を公開することがあるが、それはポリシーや規約の一部ではなく、継続的なアクセスを保証せず、リアルタイムの状況を反映しない場合がある」。
つまり、日本が明示的に禁止されている事実はない一方、「日本で提供中」と名指しで宣言した公式の一覧表も存在しない(2026年9月24日時点)。実務上の確認手順は、サインアップして支払い方法を登録できるかどうかで判定するのが確実だ。出張・旅行でサポート外の地域に入るとログインできなくなる旨もヘルプセンターに明記されている。
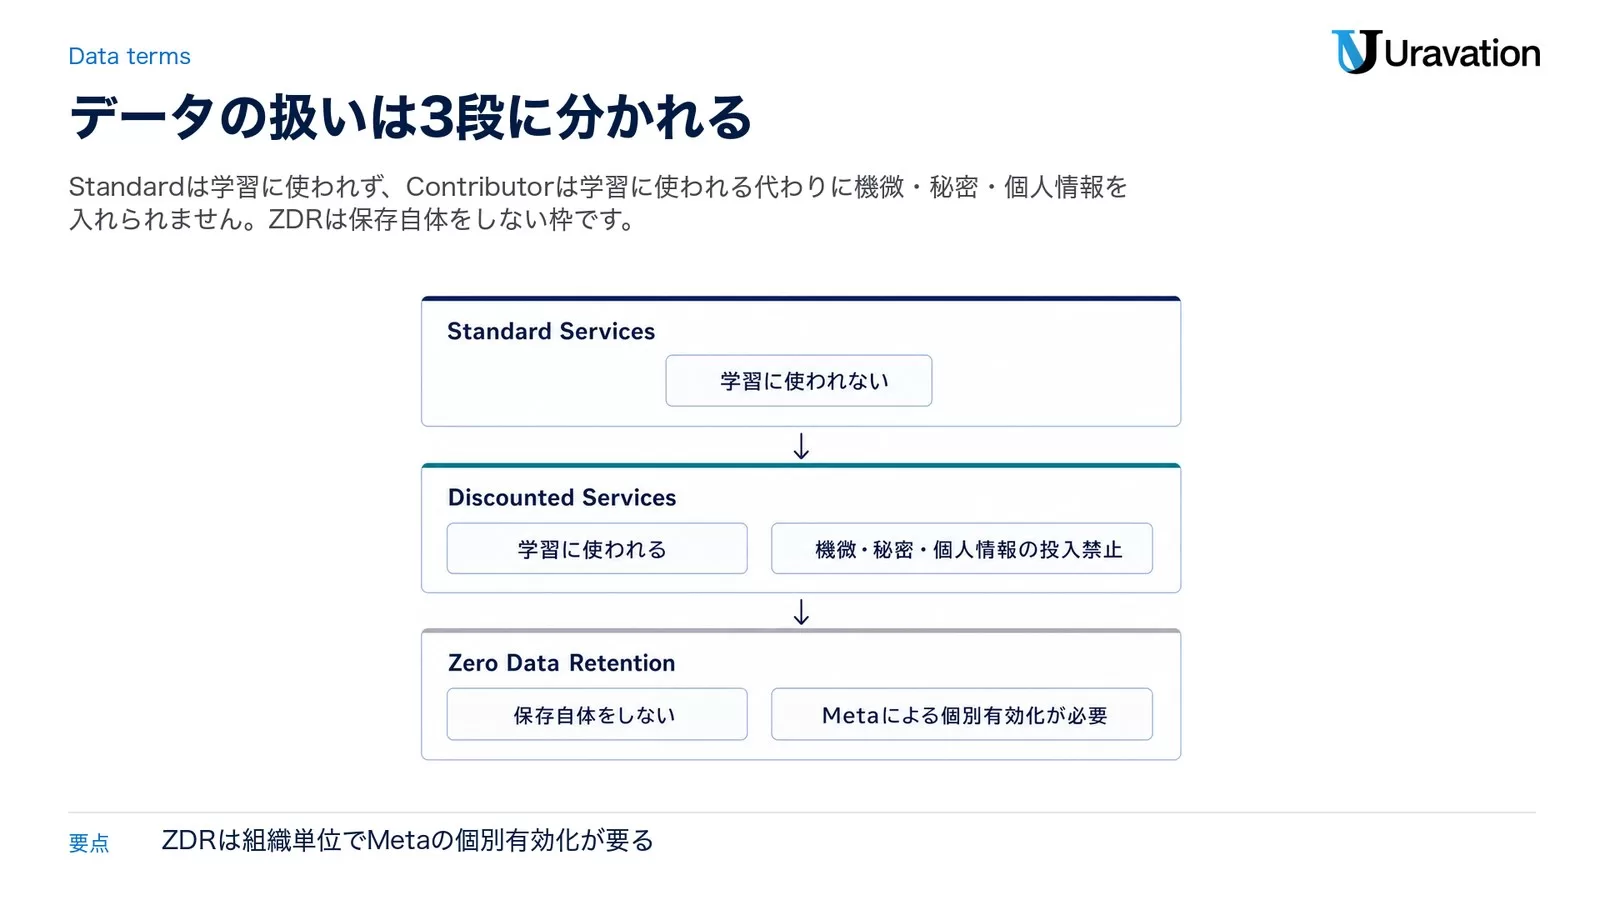
データの扱い:Standard/Contributor/ZDRの3段
| 区分 | 学習利用 | Metaの立場 | 主な条件 |
|---|---|---|---|
| Standard Services | されない | 委託先(Processor/Service Provider) | 規約5.1・MGPTに基づく処理 |
| Discounted Services(Contributor) | される | 自社利用 | 機微・秘密・個人情報の投入禁止 |
| Zero Data Retention(ZDR) | されない | 保存自体をしない | 組織単位・Metaによる個別有効化が必要 |
Contributor ティアは単に安いだけの枠ではない。利用規約6.2には「機微情報・秘密情報・個人情報を Discounted Services に投入してはならない」「契約等で秘密保持義務のあるソースコードを投入してはならない」と書かれており、さらに「特定のトラフィックだけ学習対象から除外する仕組みは提供されない」と明記されている。エンドユーザーの所在地によって学習利用が許されない場合は、そのトラフィックを Standard に回すのは利用者側の責任になる。
ZDR はヘルプセンターに専用の項目がある。有効化すると、プロンプトと応答はリアルタイムに処理され、応答を返した後に Meta 側へ保存されない(法令遵守と不正利用対応で必要な場合を除く)。ただしWeb UIからは有効にできず、組織単位で Meta の営業窓口経由の個別有効化が必要で、代わりに以下の機能が使えなくなる。
- サーバー側で過去の応答を参照するステートフルなリクエスト
- バックグラウンド(非同期)リクエスト
- ファイルアップロード
- Web検索
- Playground のチャット履歴
ZDR下でも保持されるものは、ポリシー違反として検知された入出力(最長2年)、トークン・リクエスト・ツール呼び出しの件数といった利用統計、アカウントとチームの管理情報、モデル名・レイテンシ・アプリIDなどの運用メタデータ、サポート窓口に送った内容。第三者プラットフォーム経由の呼び出しはZDRの対象外で、そのプラットフォームの保持ポリシーに従う。
出力の権利と知財補償
ヘルプセンターの「Will Meta claim copyright over what outputs I generate with Meta Model API?」に対する回答は「No」で、規約5.1の「you own all rights, title, and interests in and to your Inputs and Outputs」を根拠として挙げている。加えて規約17.2には、Standard Services(プロモーションクレジット経由を除く)の利用について、第三者からの知的財産権侵害の主張に対する Meta の補償条項が置かれている。補償の対象は利用そのもの・学習データ・未改変の出力で、通知や防御の主導権など通常の手続要件が付く。法務レビューで「学習データ由来のリスクを誰が持つか」を問われる法人導入では、ここが Standard を選ぶ実利的な理由になる。
逆に、規約9条(ix)は出力を使って Meta と競合するモデルを学習・蒸留することを書面許諾なしに禁じている。自社システムの評価・ベンチマーク・品質確認に使う分は禁止対象外と明記されているので、社内評価目的での利用は問題ない。
コーディングエージェントCLIから使う
Meta Model APIの特徴は、既存のOpenAI互換・Anthropic互換のエージェントCLIにほぼそのまま接続できる点にある。公式のコーディングエージェント設定ガイド(2026年9月24日取得)に掲載されている設定例を紹介する。接続に必要なのはベースURL・APIキー・モデルIDの3つだけだ。
Claude Code
ClaudeCodeはAnthropic Messages APIで接続する。x-api-keyではなくANTHROPIC_AUTH_TOKENでベアラー認証する点、モデルエイリアスを全てmuse-spark-1.3に固定する点がポイントだ(固定しないとPlan Modeやサブエージェント、コミットメッセージ生成などの軽量タスクがClaudeモデルへフォールバックし、Model APIが提供していないモデルを呼びにいってしまう)。
export ANTHROPIC_BASE_URL="https://api.meta.ai"
export ANTHROPIC_AUTH_TOKEN="$MODEL_API_KEY"
export ANTHROPIC_MODEL="muse-spark-1.3"
export ANTHROPIC_DEFAULT_OPUS_MODEL="muse-spark-1.3"
export ANTHROPIC_DEFAULT_SONNET_MODEL="muse-spark-1.3"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="muse-spark-1.3"
export CLAUDE_CODE_SUBAGENT_MODEL="muse-spark-1.3"
export ENABLE_TOOL_SEARCH="true"
古いバージョンのClaude Codeは非推奨のANTHROPIC_SMALL_FAST_MODELをバックグラウンドモデルとして読む、という注記も公式にある。ENABLE_TOOL_SEARCHは、Claude Codeが既定でサードパーティ製ホスト向けのMCPツール検索を無効にするため、明示的に有効化するためのもの。Claude Agent SDKでの自前実装を検討している場合はClaude Agent SDK実践ガイド|Python自律エージェント構築も合わせて参照するとよい。
OpenCode
OpenCodeはResponses APIアダプター(@ai-sdk/openai)経由でベースURLを差し替える。opencode.json(グローバルは ~/.config/opencode/opencode.json)にプロバイダーブロックを追加する。
{
  "provider": {
    "meta": {
      "name": "Meta Model API",
      "npm": "@ai-sdk/openai",
      "options": { "baseURL": "https://api.meta.ai/v1" },
      "models": {
        "muse-spark-1.3": {
          "reasoning": true,
          "limit": { "context": 1048576, "output": 131072 },
          "options": {
            "reasoningEffort": "high",
            "reasoningSummary": "auto",
            "include": ["reasoning.encrypted_content"]
          }
        }
      }
    }
  }
}
include: ["reasoning.encrypted_content"] は、ターンをまたいで推論の文脈を引き継ぐための指定。これがないと毎ターン推論をやり直すことになり、複数ステップのツールループで筋を見失いやすくなる、と公式が明記している。
Codex
CodexはResponses APIを使い、config.tomlにプロバイダーを登録する。Codexはtemperatureやtop_pを送らないため、Muse Sparkの既定値(いずれも1.0)がそのまま適用される。これが推奨設定だと公式は書いている。
model = "muse-spark-1.3"
model_provider = "meta"
model_reasoning_effort = "high"
model_context_window = 1048576

[model_providers.meta]
base_url = "https://api.meta.ai/v1"
env_key = "MODEL_API_KEY"
wire_api = "responses"
Computer Use(画面操作)を実装する
Muse SparkはComputer Use用にcomputer.computerとcomputer.stopという2つのfunction toolをResponses API上で提供している。computer.computerはアクション配列を受け取ってスクリーンショットを返し、computer.stopはタスク完了時に最終回答を返してセッションを終了する。
座標はピクセルではなく0〜1000に正規化されたグリッドで指定する(左上が(0,0)、右下が(1000,1000))。アクション種別はleft_click・type・scroll・key・waitなど17種類が用意されている(仕様は公式Computer Useドキュメントを参照)。呼び出し例は以下の形になる。
response = client.responses.create(
    model="muse-spark-1.3",
    instructions=system_prompt,
    parallel_tool_calls=False,
    tools=tools,  # computer.computer / computer.stop を含む
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": task},
            {"type": "input_image", "image_url": screenshot_data_url(png)},
        ],
    }],
)
公式ドキュメントが明記する実装上の注意点は3つ。
- バッチサイズ:1回のアクション配列は2〜5件程度を推奨。上限はガードレールであって「目標値」ではない。
- 並列ツール呼び出しは禁止:UI操作の順序が曖昧にならないよう
parallel_tool_calls=Falseを必ず指定する。 - スクリーンショットのサイズ固定:タスクの軌跡(trajectory)を通じて解像度を一定に保たないと座標がずれる。長いタスクでは古いスクリーンショットをトリミングしてコンテキストを節約する必要がある。
対応環境としてドキュメントが明示しているのは「ブラウザまたはデスクトップ環境」で、モバイル操作についての具体的なAPI記述は2026年9月24日に確認した公式ページにも見当たらなかった。ニュースメディアの一部は「デスクトップ/ブラウザ/モバイル対応」と報じているが、これはAPI仕様書ベースではなく製品発表全体の要約と見られるため、モバイルComputer UseのAPI仕様は現時点で「公式ドキュメント未公開」として扱う。
Computer Use自体を初めて扱う場合は、先にComputer Use本番運用ガイド|ループ設計とtask budgetで共通の設計パターン(アクションループの組み方・タイムアウト設計)を押さえておくと理解が早い。
マーケティングの謳い文句と、公式ドキュメントで確認できる範囲のズレ
2026年9月2日の Muse Spark 1.3 発表で Meta が強調しているのは、長時間のタスクを1本のスレッドで持続させること、曖昧な指示に対して聞き返すこと、重大な操作の前に確認を取ることだ。効率面では「Metaのエンジニアによる比較で、同等のコーディングタスクに対しツール呼び出しが約20%少なく、トークンが約25%少ない」と書かれている。これは Meta 自身による社内比較であり、第三者が再現した測定値ではない点は読み分けが要る。
一方、開発者向けドキュメント側で実装仕様として明記されているのは、1Mトークンコンテキスト、Computer Use、OpenAI/Anthropic互換、ツール呼び出し、構造化出力、検索グラウンディング、プロンプトキャッシュ、reasoning_effortの6段階まで。ブログが語る「並列サブエージェントへの委譲」については、2026年9月24日時点でも専用APIパラメータの仕様は公式ドキュメントに見当たらない。エージェントフレームワーク向けのページで触れられているのは、Claude Agent SDKのモデルエイリアス経由でサブエージェントを振り分ける設定にとどまる。
発表ブログの締めくくりには「今後のロードマップには、より大きなモデル、Muse Sparkのオープンウェイト公開などがある」と書かれている。すでにオープンウェイトで出ている Muse Glimmer は Muse Spark からの蒸留モデルで、Apache 2.0ライセンス。Metaが非オープンウェイト路線に舵を切った経緯はMeta Muse Sparkとは?エージェント開発者向け徹底解説に、Computer Use API単体でGPTと比較したい場合はGPT-5.4のネイティブComputer Use徹底解説も参考になる。
2026年7月の初版から訂正した4点
この記事は2026年7月9日の Meta Model API 公開時に書いたものを、2026年9月24日の公式ドキュメントで突き合わせ直している。旧版のまま残しておくと判断を誤る記述が4つあったので、訂正内容を明示しておく。
| 旧版の記述(2026年7月) | 2026年9月24日時点の公式 |
|---|---|
| モデルは1種類のみ。用途ごとの使い分けはできない | Muse Spark 3バージョン(Contributor変種2つを含め5ID)に加え、Muse Image・Muse Voice Transcribe・SAM 3.1が同じベースURLで提供 |
| 無料枠(Free)と有料枠(Paid)でレート制限が分かれる | 区分はStandardとContributor。Freeという枠は料金ページに存在しない |
| 公開プレビュー(Public Preview)段階 | 公式ドキュメント・利用規約・料金ページのいずれにも「Public Preview」の表記は確認できない |
| 地域制限の明記が見当たらない | 地域利用ポリシー(最終更新2026年9月18日)に制限地域21件とモデル別制限(Muse Imageのインド)が明記 |
導入前に確認すべき制約
- 出力はテキストのみ(Muse Spark):入力は画像・動画・音声・PDFまで対応するが、Muse Spark自体は画像を出力しない。画像生成が要るなら muse-image-1.0 を別に呼ぶ。
- 1.3の音声理解は公式が「フルサポートではない」と書いている:音声を含むリクエストは品質が落ちる可能性があるため、音声理解は muse-spark-1.2、文字起こしは muse-voice-transcribe-1.0 に寄せる。
- レート制限はチーム共有:アプリごとにキーを分けても上限は分かれない。負荷の高いバッチと対話型のサービスを同じチームに同居させると、片方が他方を止める。
- Contributorは本番向けではない:RPMが100と低いうえ、規約上「機微・秘密・個人情報の投入禁止」が課される。安さだけを見て本番トラフィックを流す設計にしない。
- ZDRは自動では付かない:組織単位でMetaに個別有効化してもらう必要があり、有効化するとファイルアップロードやWeb検索など一部機能が使えなくなる。要件があるなら設計段階で先に確認する。
- バッチ割引とデータ所在地の指定は2026年9月24日時点で公式に記載なし:この2点が要件に入る案件では、現時点では他社のほうが条件を満たしやすい。
- 仕様変更の速さ:規約と地域ポリシーはいずれも2026年9月18日更新、モデルは9月2日に1.3が追加されたばかり。料金とレート制限は本番投入前に公式ページで再確認する前提で組む。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
よくある質問
Meta Model APIとは何ですか?
Metaが提供する開発者向けの推論APIで、Muse Spark(テキスト・マルチモーダル)、Muse Image(画像生成)、Muse Voice Transcribe(音声認識)、SAM 3.1(領域分割)を従量課金で呼び出せます。ベースURLは https://api.meta.ai/v1、認証はAPIキーのベアラートークンです。OpenAI SDK・Anthropic SDKにドロップイン互換で、LangChain・LlamaIndex・Vercel AI SDKなどOpenAI互換のフレームワークからも使えます。
Meta Model APIの料金はいくらですか?
Standardティアは100万トークンあたり入力 $1.25(1ドル150円換算で約188円)、出力 $4.25(約638円)、キャッシュヒットした入力 $0.15(約23円)です。Contributorティアは入力 $0.10・出力 $0.20・キャッシュ入力 $0.002。最低利用料金や契約の縛りはなく、使った分だけの従量課金です。画像生成は1枚 $0.01、音声は1時間 $0.18、SAM 3.1は画像1,000枚 $2.50、Web検索グラウンディングは1,000クエリ $2.50が別に加算されます(いずれも2026年9月24日時点の公式料金ページの値)。
API key(APIキー)はどこで取得しますか?
Model APIのダッシュボードにログインし、「API keys」タブで「Create API key」を選び、名前を付けて作成します。キーが表示されるのは作成直後の1回だけなので、その場でコピーして環境変数(MODEL_API_KEY)かシークレットマネージャに保存してください。キーはチーム単位で、同じチームのメンバーが共用します。取得の前提として、18歳以上であること、サポート対象の国・地域にいること、支払い方法を登録済みであることが必要です。
Meta Model APIとMuse Sparkは同じものですか?
いいえ。「Muse Spark」はMeta Superintelligence Labsが開発したモデル自体の名称で、「Meta Model API」はそのモデル群を開発者が呼び出すためのAPIサービスの名称です。2026年9月24日時点でAPI経由で使えるMuse Sparkは muse-spark-1.3/1.3-contributor/1.2/1.2-contributor/1.1 の5つのIDです。
Muse Spark 1.3と1.2・1.1の違いは何ですか?
3バージョンともモダリティとコンテキストウィンドウ(1,048,576トークン)は同じで、Standardティアの単価も同額です。違いは能力で、1.3はエージェント的なワークフロー(複数ステップのツール利用、ブラウザ操作、長時間のタスク)向けに調整され、1.2よりコーディング性能が改善されています。reasoning_effort の max が使えるのはStandardティアの1.3だけです。ただし音声理解は1.3が「フルサポートではない」と公式に注記されており、音声は1.2が推奨されています。
Contributorティアを使うと何が起きますか?
単価が大幅に下がる代わりに、送ったプロンプトと出力がMetaの将来のモデルの学習・開発・評価・改善に使われることに同意したことになります。規約上、機微情報・秘密情報・個人情報、および秘密保持義務のあるソースコードの投入は禁止されています。特定のトラフィックだけ学習対象から外す仕組みは提供されていないため、学習されては困るトラフィックはStandardに分けて流す必要があります。
日本から使えますか?
2026年9月18日最終更新の地域利用ポリシーの制限地域リストに日本は含まれていません。一方で「日本で提供中」と名指しした公式の一覧表も2026年9月24日時点では公開されていません(ヘルプセンターは「Meta AIが利用でき課金が対応している大半の国と地域」と書くにとどまります)。実務上はサインアップと支払い方法の登録ができるかどうかで確認してください。なお、サポート外の地域へ渡航中はログインできません。
既存のOpenAI SDKのコードをそのまま移植できますか?
ベースURLとAPIキーの渡し方を変えるだけで、Responses APIのコードはほぼそのまま動く設計になっています。ただしOpenAI SDKは既定で環境変数OPENAI_API_KEYを探すため、Meta Model API用のキー(MODEL_API_KEY)はクライアント生成時に明示的に渡す必要があります。
Claude CodeやCodexといった既存のエージェントCLIから使えますか?
使えます。Claude CodeはAnthropic Messages API互換のエンドポイント(https://api.meta.ai)に環境変数で接続でき、OpenCodeやCodexはResponses API互換のプロバイダー設定を追加することで接続できます。いずれも公式ドキュメントに設定例が公開されています。Claude Codeではモデルエイリアス(opus/sonnet/haiku)とサブエージェント用モデルをすべて muse-spark-1.3 に固定するのを忘れないでください。
生成した出力の著作権はどうなりますか?
Metaは出力の著作権を主張しません。ヘルプセンターは利用規約5.1の「you own all rights, title, and interests in and to your Inputs and Outputs」を根拠として挙げています。加えて規約17.2には、Standard Services(プロモーションクレジット経由を除く)について第三者からの知的財産権侵害の主張に対するMetaの補償条項があります。ただし規約9条(ix)により、出力を使ってMetaと競合するモデルを学習・蒸留することは書面許諾なしに禁止されています(自社システムの評価・ベンチマーク目的は対象外)。
無料で試せる枠はありますか?
利用規約13.3に「プロモーションクレジット」の規定があり、料金ページのMuse Voice Transcribeの注記にも「プラットフォームの無料クレジットが適用される」という記述はあります。ただし金額・付与条件・有効期限は2026年9月24日時点の公式ドキュメントに記載がありません。なお規約17.2の知財補償はプロモーションクレジット経由の利用を対象外としている点に注意してください。
この記事を読んでAPI連携の実装イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
【2026年8月7日追記】 Muse Spark 1.1はAPIとして呼び出すモデル層でしたが、2026年8月5日にはコーディング特化版「Muse Spark 1.2」を基盤とするターミナル型エージェント本体「Muse Code」が新たに公開されました。モデル(Meta Model API)とツール(Muse Code)は別レイヤーの製品です。Muse Codeの機能・料金・使い方はMeta Muse Codeとは|機能・使い方・設計者への影響にまとめています。