2026年10月1日時点で、Cloudflare Auto Routerは、AI Gatewayに送るリクエストのモデル名をcloudflare/autoにするだけで、既定の7つのモデルからリクエストごとにその作業に十分な能力のモデルを選ぶ機能で、2026年9月30日(米国時間)に公開ベータになり、ベータの間は無料です。Cloudflareによると、社内のOpenCodeで使った初期の結果では、OpenAIのSolやAnthropicのClaude Opusのようなフロンティアモデルだけを使う場合と比べて、最大30%の節約になりました。この数字はCloudflare社内のOpenCodeでの実測で、測った期間やリクエストの件数はブログに書かれていません。
この記事の要点(2026年10月1日時点)
- 使い方は、AI Gatewayへのリクエストでモデル名を
cloudflare/autoにするだけです。選ばれたモデルは応答ヘッダーのcf-aig-routed-modelでわかります - 候補を絞り、会話を分類し、品質の見込みと費用で順位を付けて選びます。既定の候補は7つで、GPT-6 SolやClaude Opus 5.5はヘッダーで許可した時だけ候補に入ります
- 何度もやり取りする会話では
cf-aig-session-idを付けると、1つのターンの間は同じモデルを使い、プロンプトキャッシュを生かせます - 「最大30%」はCloudflare社内のOpenCodeでの初期の実測です。社内の知識業務ベンチマークでは、成功率はClaude Opus 5.5より低く、費用はSolの80%、Opusの35%でした
- ベータの間はAuto Router自体は無料で、選ばれたモデルの利用料は別にかかります。WebSockets APIには対応していません
対象読者:AI GatewayやOpenCodeを使う開発者と、社内のAI利用費を管理する担当者。読み終えたらできること:cloudflare/autoを試す設定を書き、候補のモデル・鍵の扱い・30%という数字の前提を社内で説明できます。
この記事は、Cloudflareの公式ブログ「Cut your AI spend with AI Gateway’s Auto Router」(2026年9月30日)と、開発者向けドキュメントのAuto Routerのページ(2026年9月30日更新)を中心に、料金・制限・認証・Unified Billingのページを2026年10月1日に読んで整理したものです。手順とコードは、ドキュメントに載っている形をそのまま引用しています(当サイトでの動作確認ではありません)。
Cloudflare Auto Routerとは|AI Gatewayの中での位置づけ
AI Gatewayは、アプリやエージェントとAIの提供元(プロバイダー)の間に入り、利用の分析・キャッシュ・回数の制限・失敗時のモデルの切り替えなどをまとめて扱うCloudflareのサービスです。Auto Routerはその中の機能で、アプリやエージェントがモデル名にcloudflare/autoを書いて送ると、AI Gatewayがリクエストごとにモデルを選び、選んだ提供元へ送ります。
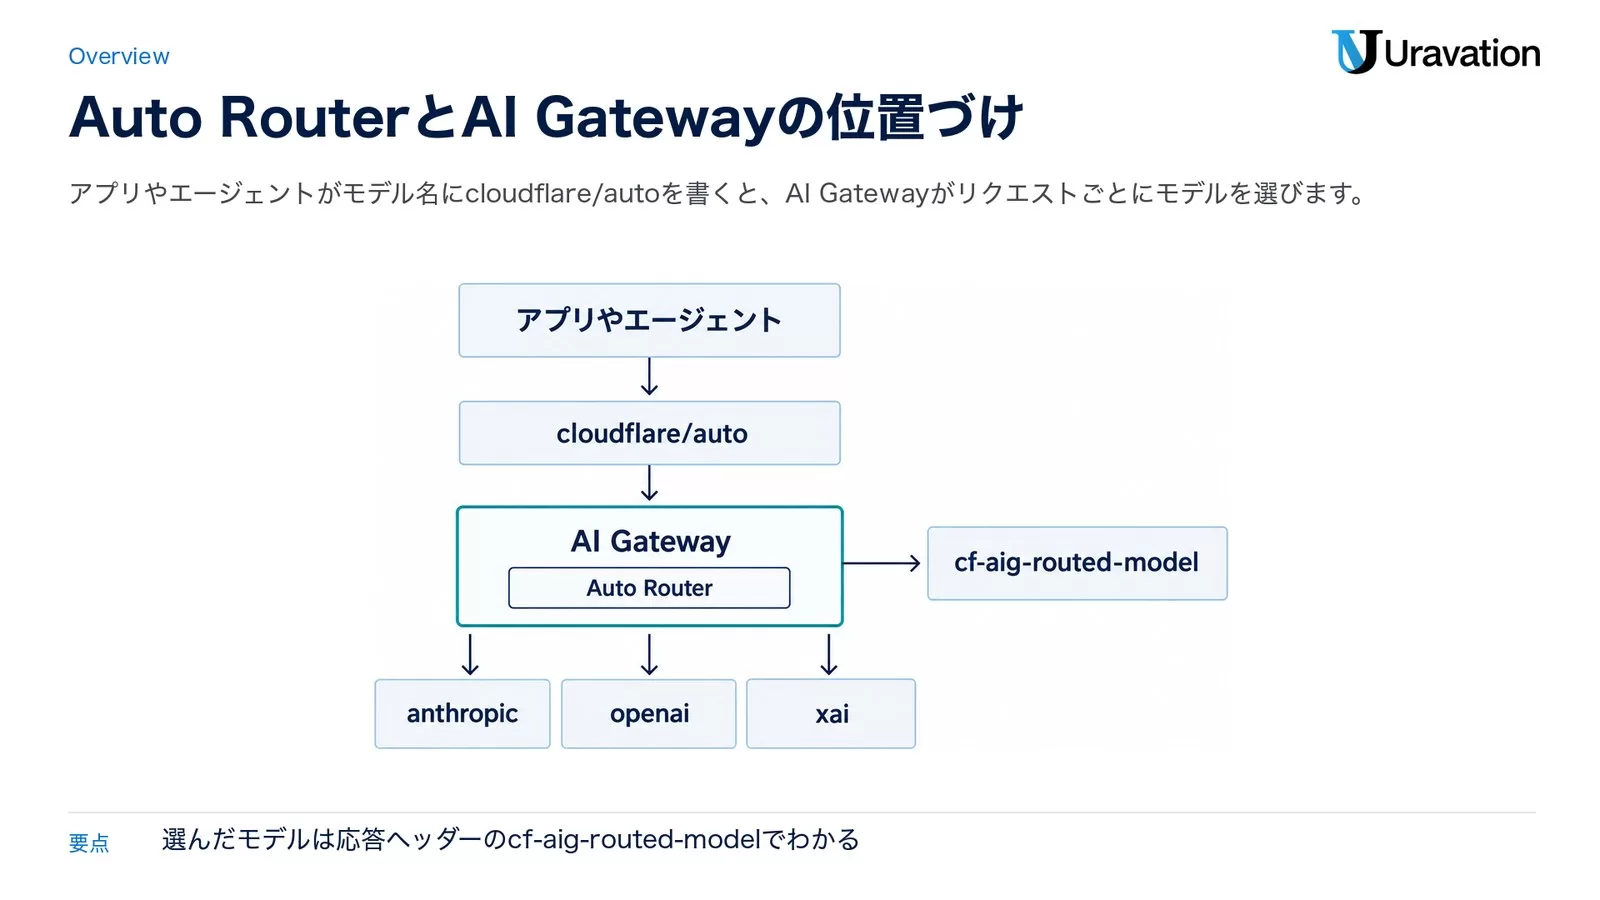
Cloudflareはブログで、OpenCode・Claude Code・Codexなど多くのハーネスでは、今も利用者が手でモデルを選んでいると書いています。メールやチャットのスレッドを要約するのにOpusほどの性能は要りませんが、セキュリティの技術チームからそのモデルを取り上げたくはありません。予算・支出の上限・利用者ごとの分析で見える化と歯止めはできても、1件ごとに費用を意識してモデルを選ぶのは利用者のままでした。そこで、利用者・エージェント・ツールのリクエストがすべて通るゲートウェイの側で、作業に足りるモデルを選ばせる、というのがAuto Routerの考え方です。
Cloudflare自身は、社内のOpenCodeと、独自のエージェント・ハーネスであるCloudflare OSでAuto Routerを使っています。AI Gatewayの費用に関わる機能を並べると、Auto Routerの位置がわかります。
| 機能 | 何をするか | 決め方 |
|---|---|---|
| キャッシュ | 同じプロンプトへの応答をキャッシュから返す | 管理者が設定する |
| 回数の制限(Rate limiting) | リクエストの数に上限を設ける | 管理者が設定する |
| 支出の上限(Spend limits) | モデル・提供元・利用者などの単位で金額の上限を決め、達したら429で止める | 管理者が設定する |
| Dynamic routing | 条件・割合・予算の分岐を組んだ流れで、送り先のモデルを決める | 管理者がルールを作る |
| Auto Router | 会話の中身を分類し、品質の見込みと費用のつり合いでモデルを選ぶ | ゲートウェイが自動で選ぶ |
| User Insights | 誰がいくら使ったかと、より速いか安いモデルで足りそうなリクエストを示す | 見るだけで、止めはしない |
使い始める設定|cloudflare/autoとヘッダー
使い方は、AI Gatewayに送るリクエストで、提供元ごとのモデル名の代わりにcloudflare/autoを指定するだけです。エンドポイントと認証は、ドキュメントのUnified API(OpenAI互換)のページに従います。Auto RouterはChat CompletionsとResponses APIの形式に対応していて、WebSockets APIには2026年10月1日時点で対応していません。ドキュメントにあるcurlの例は次のとおりです。
curl -i -X POST "https://gateway.ai.cloudflare.com/v1/$CLOUDFLARE_ACCOUNT_ID/$CLOUDFLARE_GATEWAY_ID/compat/chat/completions" \
  --header "cf-aig-authorization: Bearer $CLOUDFLARE_API_TOKEN" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "cloudflare/auto",
    "messages": [
      {
        "role": "user",
        "content": "hello"
      }
    ]
}'$CLOUDFLARE_ACCOUNT_IDはCloudflareのアカウントID、$CLOUDFLARE_GATEWAY_IDはゲートウェイのID、$CLOUDFLARE_API_TOKENはCloudflareのAPIトークンに置き換えます。応答のヘッダーに、Auto Routerが選んだモデルが出ます。ドキュメントの例は次のとおりです。
cf-aig-routed-model: openai/gpt-5.6-luna
cf-aig-routing-reason: cost_optimal_within_pool
cf-aig-routing-decision-id: 91e0b970-33f0-4921-b8dc-127412e7b103
応答のヘッダー
| ヘッダー | 内容 |
|---|---|
cf-aig-routed-model |
実際に処理したモデル(例:anthropic/claude-sonnet-5) |
cf-aig-routing-reason |
そのモデルを選んだ理由(後述の8種類) |
cf-aig-routing-decision-id |
振り分けの判断のID |
cf-aig-request-id |
リクエストのID |
ドキュメントは、これらのヘッダーで選ばれたモデルとその理由を確かめ、AI Gatewayのログと突き合わせて、問い合わせや原因の調査に使えると説明しています。
リクエストのヘッダー
| ヘッダー | 内容 |
|---|---|
cf-aig-session-id |
リクエストが属するセッションを示す。1つのターンの間、同じモデルを使い続ける動き(session affinity)が有効になる |
cf-aig-turn-id |
リクエストが属するターンを示す。会話の履歴からのターンの判定より優先される |
cf-aig-no-session-affinity |
trueにすると、ターンでモデルを固定せず、リクエストごとに選ぶ |
cf-aig-allowed-models |
選んでよいモデルをカンマ区切りで指定する。*が使える(例:anthropic/*) |
cf-aig-allowed-providers |
選んでよい提供元をカンマ区切りで指定する(例:openai,anthropic) |
cf-aig-allowed-modelsを送ると、既定の候補が指定したモデルに置き換わります。指定は後述の追加のモデルにも一致します。*は/に一致しないので、すべてを指すつもりで*とだけ書かず、anthropic/*のように書きます。どのモデルにも一致しない指定があると400エラーが返り、2つのヘッダーを両方送ると、両方に一致するモデルだけが候補になります。
鍵と請求の扱い|BYOKとUnified Billing
上のcurlの例では、cf-aig-authorizationヘッダーにCloudflareのAPIトークンを入れて、ゲートウェイに対して認証しています。モデルの提供元に対する認証と支払いは別の話で、Unified Billingのページは、AI Gatewayが提供元への認証情報を次の順で決めると書いています。
- リクエストに提供元のキー(例えば
Authorizationヘッダー)が付いていれば、そのまま提供元に渡す。BYOKとUnified Billingは使わない - 付いていなければ、ゲートウェイに
defaultの別名で保存したキー(BYOK)を使う - どちらもなければ、Cloudflareが管理する認証情報で処理し、Cloudflareのクレジットから差し引く(Unified Billing)
Auto Routerが候補のモデルを絞る時は、ゲートウェイに設定した認証情報・請求の設定・支出の上限も見ます。ブログはこれにアクセス制御のポリシーを加えています。同じcloudflare/autoでも、どのモデルが候補に残るかはゲートウェイの設定で変わるということです。
2026年9月14日の変更履歴では、第三者の提供元へのリクエストに自社の認証情報を必須にする設定「Require provider credentials」(APIではbyok_only)が加わりました。オンにすると、使える認証情報のないリクエストはUnified Billingに回らず、400で返ります。自社のキーと契約で使いたい会社は、Auto Routerを試す前にこの設定を確かめておくと、思っていない請求の経路に流れるのを防げます。
トークンの扱いにも注意が要ります。ドキュメントによると、AI GatewayのAPIトークンはアカウント単位で効き、AI Gateway Runの権限を持つトークンなら、BYOKのキーを保存したゲートウェイを含め、アカウント内のすべてのゲートウェイにリクエストを送れます。ゲートウェイや顧客ごとに分けたい場合、ドキュメントはアカウントを分けるか、Worker側のAI Gatewayのbindingを使うよう案内しています。トークンの使い方を見える化する方法は、当サイトのAIエージェントのコスト監視|トークン可視化と暴走対策で扱っています。
候補になるモデル|既定の7つと追加の20
Auto Routerが選ぶのは、Cloudflareが管理するモデルの集まりで、ドキュメントは中身が変わることがあると書いています。2026年9月30日更新のページで、既定の候補は次の7つです。
| モデル | 提供元 |
|---|---|
anthropic/claude-fable-5 |
anthropic |
anthropic/claude-opus-5 |
anthropic |
anthropic/claude-sonnet-5 |
anthropic |
openai/gpt-5.6-luna |
openai |
openai/gpt-5.6-sol |
openai |
openai/gpt-5.6-terra |
openai |
xai/grok-4.5 |
xai |
このほかに追加のモデルが20あり、cf-aig-allowed-modelsかcf-aig-allowed-providersの指定に一致した時だけ選ばれます。提供元の列の値は、cf-aig-allowed-providersにそのまま書ける値です。
| 提供元 | 追加のモデル |
|---|---|
workers-ai |
@cf/deepseek-ai/deepseek-v4-flash-0731、@cf/deepseek-ai/deepseek-v4-pro-0813、@cf/google/gemma-4-26b-a4b-it、@cf/moonshotai/kimi-k2.7-code、@cf/openai/gpt-oss-20b、@cf/qwen/qwen3.8-27b、@cf/zai-org/glm-5.2 |
alibaba |
alibaba/qwen3.8-max |
anthropic |
anthropic/claude-fable-5.1、anthropic/claude-opus-4.8、anthropic/claude-opus-5.5、anthropic/claude-sonnet-4.6 |
fireworks |
fireworks/glm-5.3、fireworks/glm-5.3-flash |
minimax |
minimax/m3 |
openai |
openai/gpt-5.5、openai/gpt-6-astra、openai/gpt-6-luna、openai/gpt-6-sol |
xai |
xai/grok-4.6 |
読むときの注意が2つあります。1つ目は、ブログのベンチマークで比べた相手のGPT-6 SolとClaude Opus 5.5が、既定の7つではなく追加のモデルの側にあることです。新しいモデルを候補に入れたい場合は、ヘッダーで指定する必要があります。2つ目は、提供元の列にGoogle AI StudioとVertex AIがなく、Geminiは既定と追加のどちらの一覧にもないことです。ブログは今後の予定の最初に、cloudflare/autoで選べるモデルを増やすことを挙げています。
振り分けの仕組み|候補を絞り、会話を分類し、点数で選ぶ
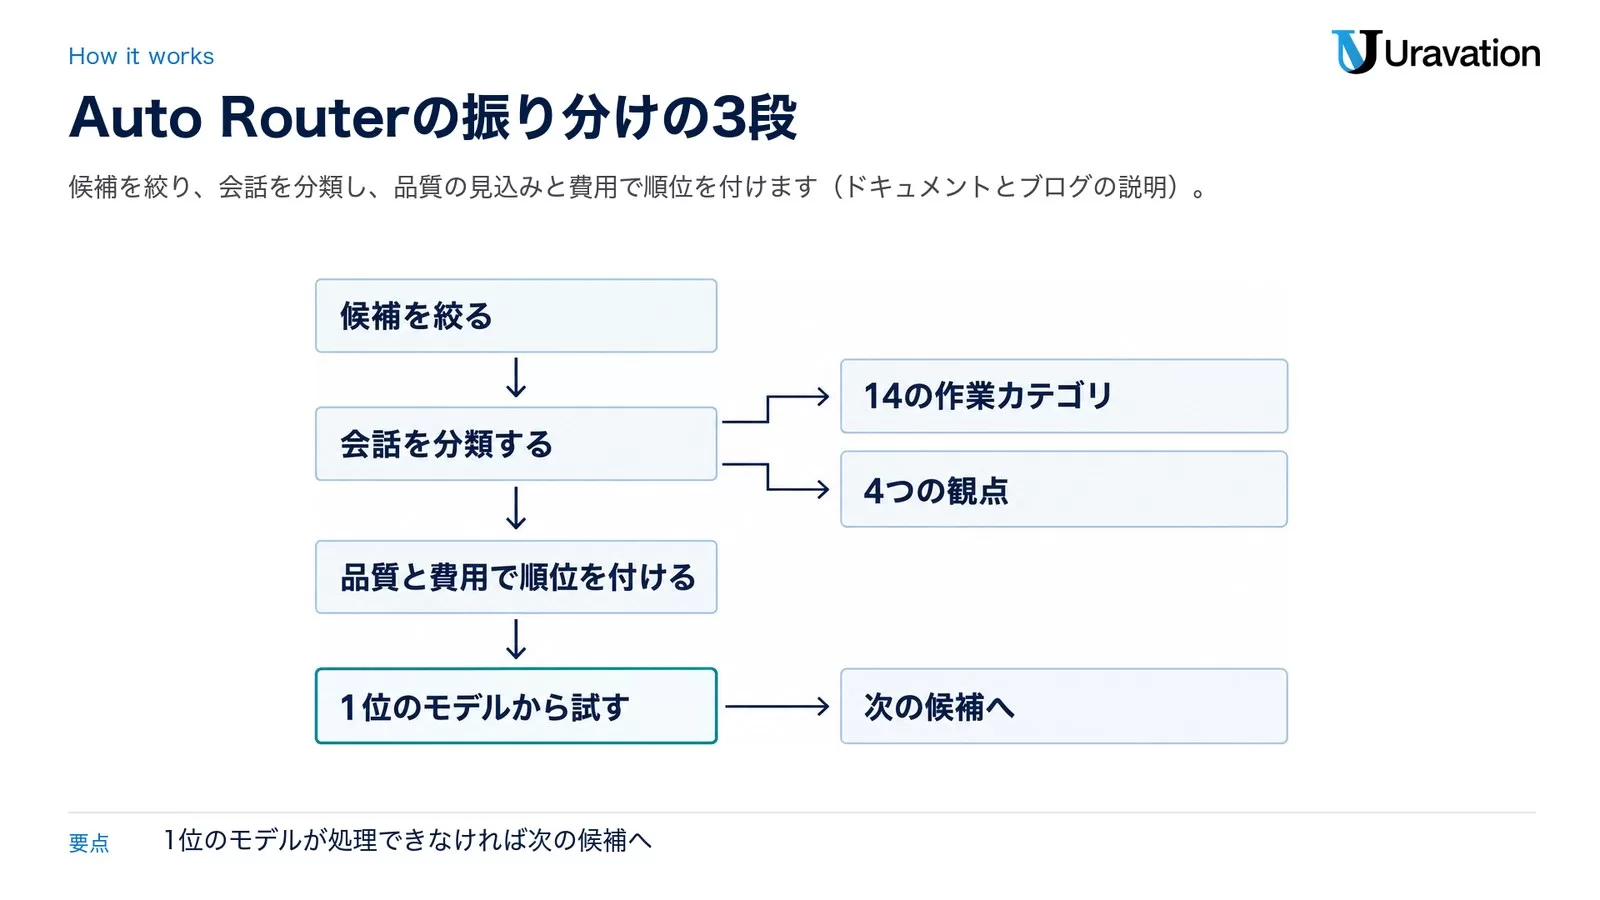
ドキュメントの説明は3段です。まず、そのリクエストを処理できるモデルの候補を作り、次に会話を分類して作業の種類と難しさを見積もり、最後に各候補の品質の見込みと費用を比べて順位を付けます。そのあとは1位のモデルから試す流れで、提供元が処理できなければ次の候補へ移ります。ブログは、それぞれの段をもう少し詳しく書いています。
1. 候補を絞る
リクエストの形式や実行のモードに対応しないモデルを外します。例えば画像を含むリクエストなら、画像を受け付けるモデルだけが候補になります。ゲートウェイの認証情報・請求の設定・支出の上限も考慮し、不調の提供元やモデルは障害の間だけ外して、回復すると自動で候補に戻します。
2. 会話を分類する
残った候補について、ルーターは会話を短くまとめた形で見ます。新しいやり取りほど重く見て、直近のメッセージを中心にします。会話は、CloudflareのネットワークのGPUで動くWorkers AI上の分類モデルに送られ、2種類の信号が返ります。1つはコーディング・計画・調査・データ分析など14の作業カテゴリそれぞれの確率、もう1つは複雑さ・あいまいさ・影響の大きさ・それまでの文脈への依存という4つの観点の、1から5の評価です。
3. 品質と費用で順位を付ける
別の採点表(scoring matrix)が、分類の信号と各モデルのベンチマークの結果を組み合わせて、モデルごとの合い具合を見積もります。採点表は、作業の種類と難しさの例ごとに望ましいモデルを決め、その選び方になるよう重みを調整して作ったとブログは説明しています。そのうえで、品質の見込みと各モデルの入力・出力のトークン単価を合わせます。簡単なリクエストでは価格の重みが大きく、能力が足りていれば小さなモデルが選ばれます。難しくなるほど費用の罰点が小さくなり、強いモデルが選ばれやすくなります。ブログが示す簡略な式は次のとおりです。
utility = expected quality - adaptive cost penaltyブログは、表の単価が安いモデルでも、問題を解くのに多くのトークンを使えば結果として高くつくことがあり、ルーターは100万トークンあたりの単価ではなく、作業全体で見込まれる費用を小さくするべきだとも書いています。新しいモデルが出た時は、学習し直さずに、ベンチマークから求めた重みを採点表に足すだけで対応できるとしています。
選んだ理由はcf-aig-routing-reasonに、次の8種類のどれかで出ます。
| 値 | 意味 |
|---|---|
cost_optimal_within_pool |
品質の見込みと費用のつり合いが最もよいモデルを選んだ |
forced_by_candidate_pool |
候補が1つしかなく、選ぶ必要がなかった |
pinned_by_turn |
同じターンで先に選んだモデルを使い続けた |
fallback_candidate_unavailable |
選んだモデルが処理できず、別の候補を使った |
fallback_key_not_in_candidates |
振り分けの判断が有効でなく、それを使わずにモデルを選んだ |
fallback_router_error |
ルーターが使えず、ルーターなしでモデルを選んだ |
fallback_router_timeout |
ルーターが時間内に応答せず、ルーターなしでモデルを選んだ |
fallback_unsupported_input |
分類できる文字がなく、ルーターなしでモデルを選んだ |
fallback_で始まる値は、ルーターの判断どおりのモデルで処理されなかったことを示します。試す段階では、この値の内訳をログで見ておくと、振り分けがどのくらい働いているかがわかります。作業の重さと費用からモデルを選ぶ設計を自分で組む場合は、当サイトのモデルルーティング設計ガイド2026|タスク複雑度×コスト判断フローも参考になります。
多ターンの会話|セッションIDとプロンプトキャッシュ
コーディングエージェントのように何度もやり取りする使い方では、cf-aig-session-idヘッダーを毎回付けます。こうすると、Auto Routerは1つのターンの間は同じモデルを使い続け、プロンプトキャッシュを生かせます。ターンとは、利用者のメッセージ1つと、それに続くツール呼び出しなどのリクエストのまとまりです。OpenCodeのように対応しているクライアントは、これを自動で行います。
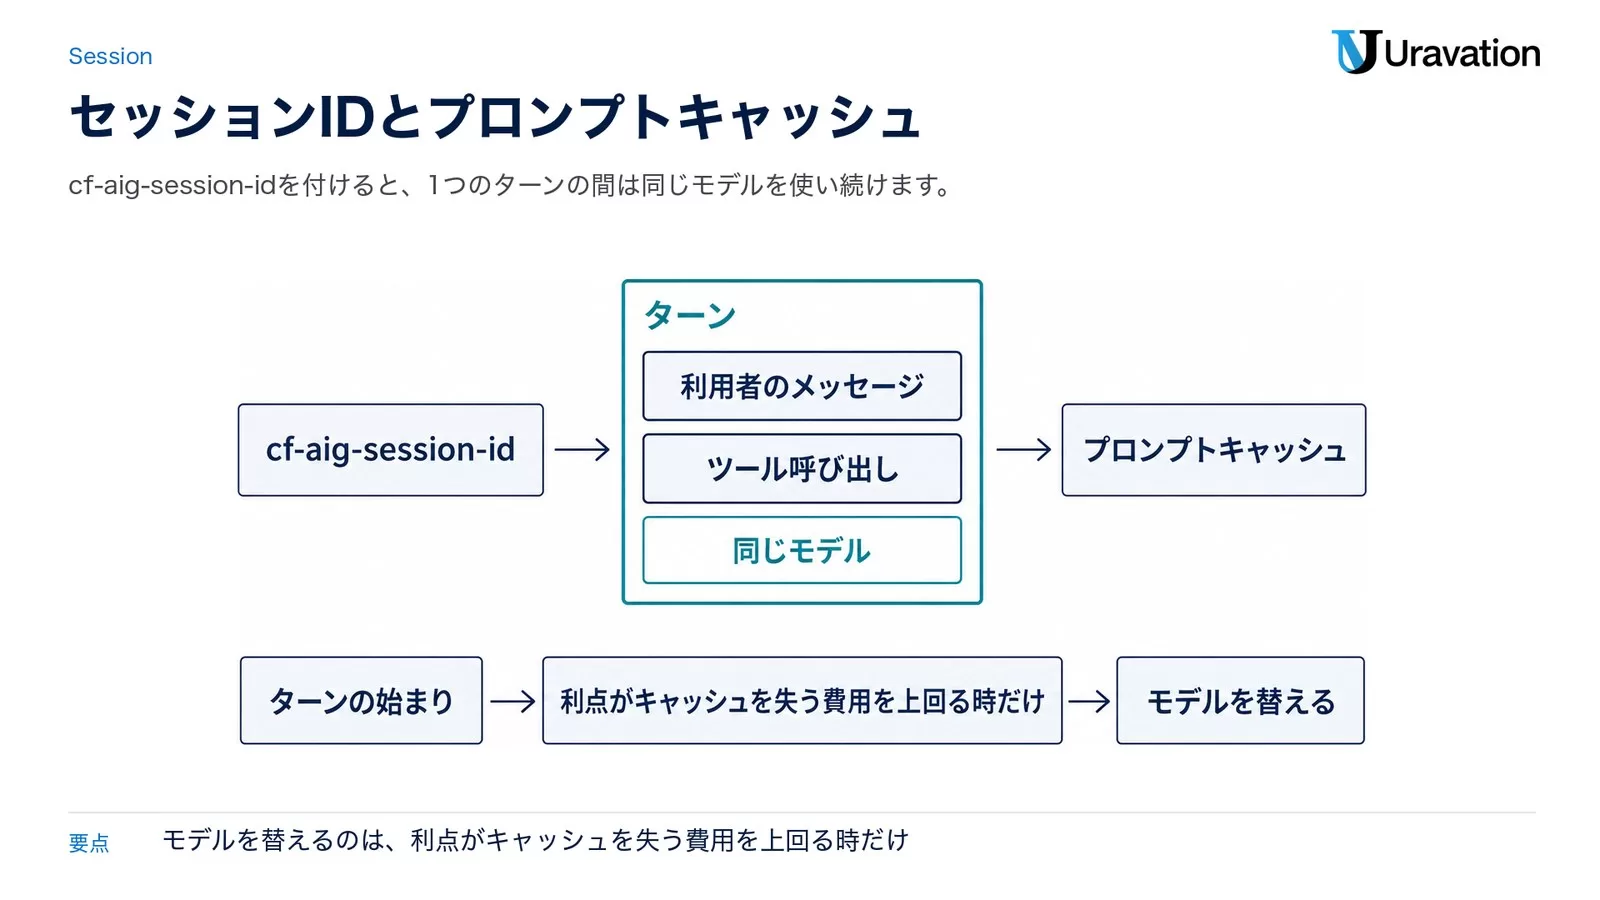
セッションIDがない場合、Auto Routerはリクエストごとにモデルを選びます。同じ会話の中でも別のモデルに回ることがあり、そのときはプロンプトキャッシュを再利用できません。ターンは会話の履歴から判定され、自分で区切りたい時はcf-aig-turn-idを送ります。対応クライアントを含めてこの固定を止めたい時は、cf-aig-no-session-affinity: trueを送ります。
ターンの始まりでモデルを替えるのは、見込まれる利点がキャッシュを失う費用を上回る時だけです。ドキュメントの例では、簡単な質問から複数のファイルにまたがるコーディングの作業に移った時に、より能力の高いモデルへ替えることがあります。
ブログによると、デバッグやコーディングのような長いセッションで費用を左右するのは、モデルの定価よりも、会話が長くなるほど増えるキャッシュの読み込みの代金です。モデルを替えるとキャッシュは捨てられ、新しいモデルが文脈を最初から書き直します。キャッシュの読み書きが安いモデルなら書き直しの費用をすぐ取り戻せるので、替える価値がある場合もあります。そこでAuto Routerは、同じターンの中ではモデルを替えず、ターンをまたぐ時は、すでに文脈にあるトークンが多いほど大きくなる切り替えの罰点をかけます。まだキャッシュを持っているモデルはキャッシュ読み込みの単価で、ほかの候補は文脈を書き直す全額で比べます。
もう1つの費用は推論のトークンです。多くのモデルは別のモデルの推論のトークンを読めないため、替えた先で推論をやり直すと、その分に出力の単価がかかります。Cloudflareは、替える時は同じ系統のモデルを優先する仕組みを今後入れたいとしています。キャッシュの単価の考え方は、当サイトのプロンプトキャッシュ比較2026|3大LLMのコスト最適化戦略で主要なLLMを比べています。
OpenCode・Claude Code・Codexで使う手順
Auto Routerのページに手順が載っているのはOpenCodeです。OpenCodeでは、Auto Routerを独自のモデルとして使えます。環境変数CLOUDFLARE_ACCOUNT_ID・CLOUDFLARE_GATEWAY_ID・CLOUDFLARE_API_TOKENを設定し、プロジェクトの直下に次のopencode.jsonを置きます。
{
	"$schema": "https://opencode.ai/config.json",
	"enabled_providers": ["cloudflare-auto-gateway"],
	"provider": {
		"cloudflare-auto-gateway": {
			"npm": "@ai-sdk/openai-compatible",
			"name": "Cloudflare AI Gateway",
			"options": {
				"baseURL": "https://gateway.ai.cloudflare.com/v1/{env:CLOUDFLARE_ACCOUNT_ID}/{env:CLOUDFLARE_GATEWAY_ID}/compat",
				"apiKey": "",
				"headers": {
					"cf-aig-authorization": "Bearer {env:CLOUDFLARE_API_TOKEN}"
				}
			},
			"models": {
				"cloudflare/auto": {
					"name": "Cloudflare Auto",
					"modalities": {
						"input": ["text", "image"],
						"output": ["text"]
					},
					"limit": {
						"context": 1000000,
						"output": 128000
					},
					"options": {
						"max_completion_tokens": 32000
					}
				}
			}
		}
	}
}トークンはファイルに直接書かず、{env:…}の形で環境変数から読む作りです。opencodeで起動し、モデルの一覧から「Cloudflare Auto」を選びます。
選ばれたモデルをOpenCodeの画面で見たい場合は、AI Gatewayのプラグイン@cloudflare/aig-opencode-pluginを入れます。OpenCode 1.18.29以降が必要で、コマンドはOpenCodeの版で分かれます。入れた後はOpenCodeを再起動します。
OpenCode 2の場合:
opencode plugin add @cloudflare/aig-opencode-pluginOpenCode 1の場合:
opencode plugin @cloudflare/aig-opencode-plugin --globalプラグインを入れると、サイドバーにAI Gatewayの欄が加わり、直近のリクエストについて、選ばれたモデル・セッションID・リクエストID・振り分けの判断のID・トレースIDが出ます。/aig-showは、モデルに何も送らずに、cf-aig-routing-reasonを含む直近のヘッダーを表示します。/aig-capture offと/aig-capture onで記録を止めたり再開したりでき、記録は既定でオン、メモリーに置かれてOpenCodeの再起動で消えます。
Claude CodeとCodexの場合
AI Gatewayのドキュメントには、Claude CodeとCodexをゲートウェイ経由にする手順もあります。Claude CodeはAI GatewayのAnthropicのエンドポイントへ送る構成で、このエンドポイントはClaude Codeが使う/v1/messagesのAPIを受けます。Codexはconfig.tomlに独自の提供元を作り、OpenAIのエンドポイントへwire_api = "responses"で送る構成で、ドキュメントはこの方法で使えるのはResponses APIに対応したOpenAIのモデルだけだと書いています。
ただし、どちらの手順にもcloudflare/autoは出てきません。Claude CodeとCodexからAuto Routerを使う手順は、2026年10月1日時点で公式に確認できていません。ゲートウェイを経由させるだけでも、リクエストの記録・キャッシュ・回数の制限・費用の記録・DLP(機密情報の検出)は使えるとドキュメントは説明しています。
「最大30%」の読み方|社内のOpenCodeでの実測
ブログの「最大30%の節約」は、Cloudflareが社内のOpenCodeでAuto Routerを使った初期の結果です。比べる相手は、OpenAIのSolやAnthropicのClaude Opusのようなフロンティアモデルだけを使う場合です。測った期間・リクエストの件数・作業の内訳は、2026年10月1日時点で公式に確認できていません。自社の削減の見込みとしてそのまま使える数字ではないので、自社の利用で確かめる手順が要ります。
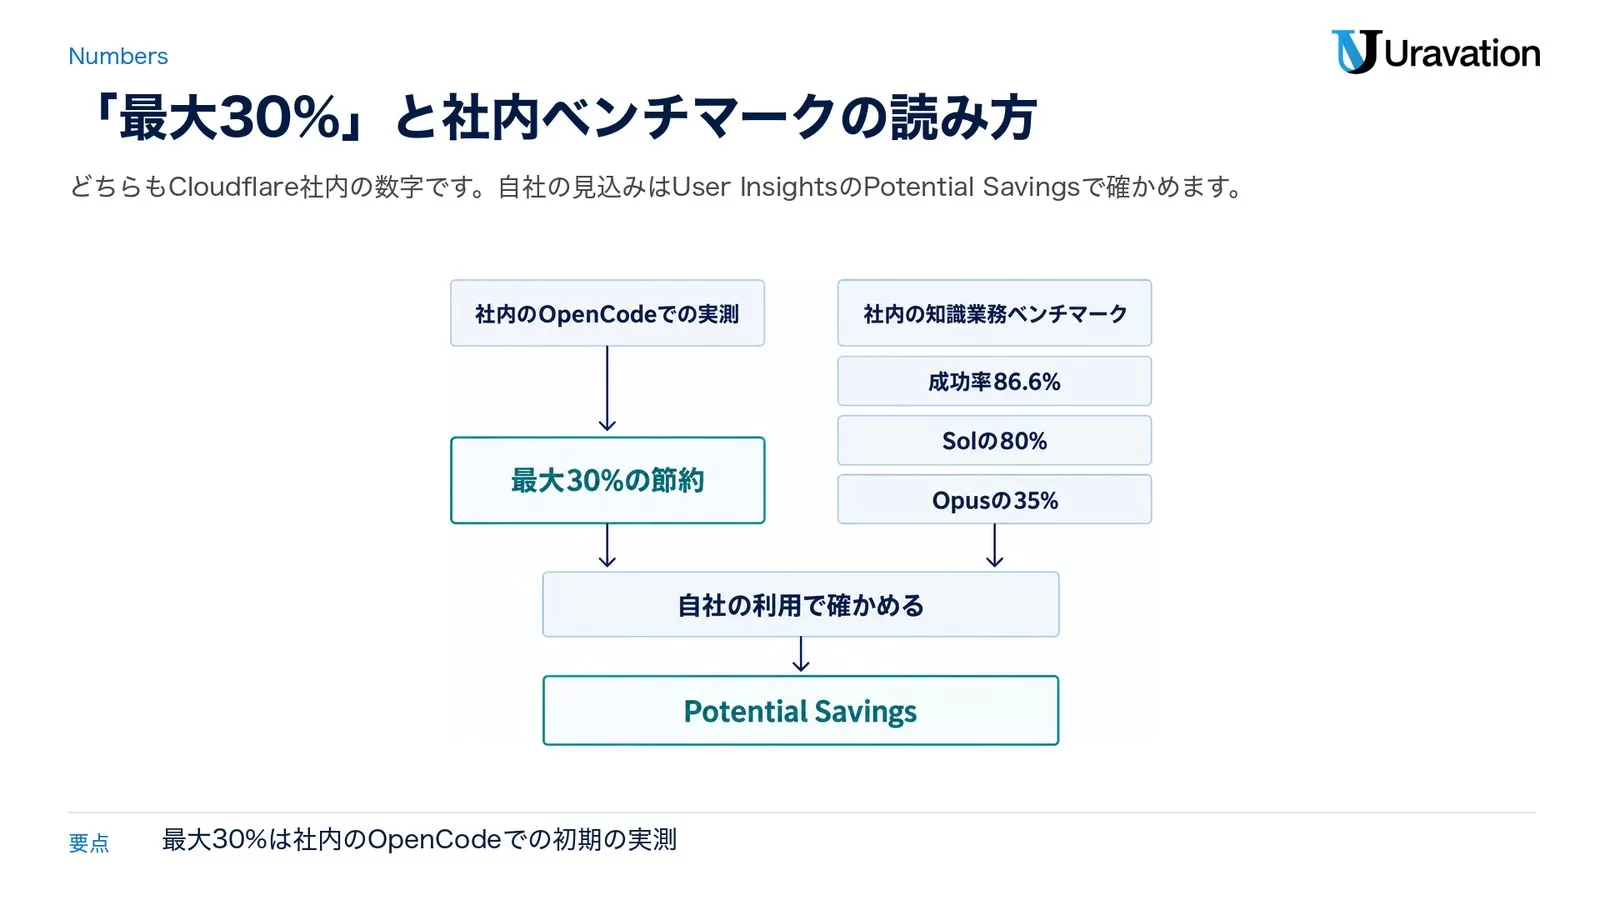
ブログはもう1つ、社内の知識業務ベンチマークの結果を出しています。職場の道具を模したツールを使い、メール・カレンダー・Slack・ファイル・旅行・財務にまたがる日常の作業97個について、確かめられる答えを出すか操作を終えるまでを求めるもので、各モデルで1つの作業を3回ずつ、計291回試しています。比べた相手はGPT-6 SolとClaude Opus 5.5です。
| モデル | 成功した回数 | 成功率 | 費用の合計 | 成功1回あたりの費用 |
|---|---|---|---|---|
cloudflare/auto |
252/291 | 86.6% | 2.10ドル(約315円) | 0.0084ドル(約1.26円) |
| Claude Opus 5.5 | 281/291 | 96.6% | 5.91ドル(約887円) | 0.0210ドル(約3.15円) |
| GPT-6 Sol | 245/291 | 84.2% | 2.64ドル(約396円) | 0.0108ドル(約1.62円) |
円は1ドル150円で換算しています。成功率の95%信頼区間(作業単位で1万回のブートストラップによる推定)は、cloudflare/autoが上側6.2ポイント・下側6.9ポイント、Claude Opus 5.5が上側2.7ポイント・下側3.8ポイント、GPT-6 Solが上側6.5ポイント・下側6.9ポイントです。
ブログは、Auto Routerがふだん使いの最先端のモデルと同程度の性能を出し、費用はSolの80%、Opusの35%だったと書いています。表で見ると、cloudflare/autoは成功率86.6%で、Claude Opus 5.5の96.6%より低く、GPT-6 Solの84.2%に近い値です。成功1回あたりの費用は3つの中で最も低くなっています。失敗した時のやり直しの手間や影響が大きい作業では、この成功率の差をどう見るかが判断の分かれ目になります。
ベンチマークでcloudflare/autoがどの候補から選んでいたか(既定の7つだけか、追加のモデルを含めたか)は、ブログに書かれていません。ブログは、Auto Routerが最もよく働くのは、技術と技術以外のチームの仕事が混ざる大きな組織のように、幅広い知識業務で使う場合だとしています。社内ではコーディングの作業でもフロンティアモデルと同程度の結果だったと書いていますが、その数字は出していません。
自社の見込みを立てるなら、2026年9月29日にAI GatewayのUser Insightsに加わったPotential Savingsの画面が使えます。より速いか安いモデルでも出力の品質を落とさずに済みそうなリクエストを示す画面で、変更履歴は、Auto Routerがモデルを選ぶのと同じ信号を使っていると書いています。AI Gatewayの利用者は追加の費用なしで使えます。
料金と制限|ベータ中は無料、モデルの利用料は別
ブログは「Auto Routerはベータの間は無料」と書いています。AI Gatewayの料金ページ(2026年9月24日更新)にはAuto Routerの項目がなく、ベータが終わった後の料金と、ベータがいつまで続くかは、2026年10月1日時点で公式に確認できていません。選ばれたモデルの利用料は、ルーターとは別にかかります。
| 項目 | 2026年10月1日時点の記載 | 出典 |
|---|---|---|
| Auto Router | ベータの間は無料 | 公式ブログ |
| AI Gatewayの基本機能 | すべてのプランで使え、分析・キャッシュ・回数の制限などの基本機能は無料 | 料金ページ |
| Unified Billingのクレジット | 購入額に5%の手数料。100ドル(15,000円)分を買うと105ドル(15,750円)の請求 | 料金ページ |
| モデルの利用料(Unified Billing) | 提供元の単価のまま上乗せなし。Cloudflareのクレジットから差し引く | 料金ページ・Unified Billingのページ |
| モデルの利用料(自社のAPIキー) | 提供元が請求する | Claude Codeの連携ページ(Anthropicの例) |
制限は、Auto Router自体の項目と、AI Gateway全体の項目に分かれます。
| 項目 | 内容 |
|---|---|
| 対応する形式 | Chat CompletionsとResponses API。WebSockets APIは未対応 |
| 文字のないリクエスト | 分類できないため、ルーターを使わずにモデルを選ぶ(fallback_unsupported_input) |
| Unified Billingのリクエストの速さ | 1つのゲートウェイで60秒あたり200リクエスト。超えると429。自社のキー(BYOK)のリクエストには適用されない |
| ゲートウェイの数 | 1つのアカウントで、無料プランは10、有料プランは20 |
| 支出の上限のルール | 1つのゲートウェイに20まで。上限に達すると429。費用は処理の後に記録されるため、同時に多く送ると一時的に上限を超えることがある |
ブログは今後の予定として、選べるモデルを増やす、データを残さない条件(ZDR)を候補の絞り込みに入れる、提供元の処理能力を考慮する、リクエストごとに推論の深さを選ぶ、Responses APIとWebSocketsに完全に対応する、構造化された判断モデルを最初の分類に使うことを試す、の6つを挙げています。ドキュメントはResponses APIの形式に対応と書いていますが、ブログが「完全な対応」を予定に挙げているため、Responses APIのどこまでが今使えるかは、2026年10月1日時点で公式に確認できていません。費用を気にせず品質の見込みが最も高いモデルを選ぶcloudflare/auto-bestも、今後出す予定だとしています。
自前のルーティングとの使い分け|当社の見方
モデルの振り分けは、当サイトでもCisco9万人AIエージェント導入に学ぶモデルルーティング設計やClaude Opus 5登場|エージェント設計のモデル振り分けが変わるで扱ってきました。AI Gatewayの中にも条件で振り分けるDynamic routingがあり、選び方は大きく3つになります。ここからは当社の見方です。
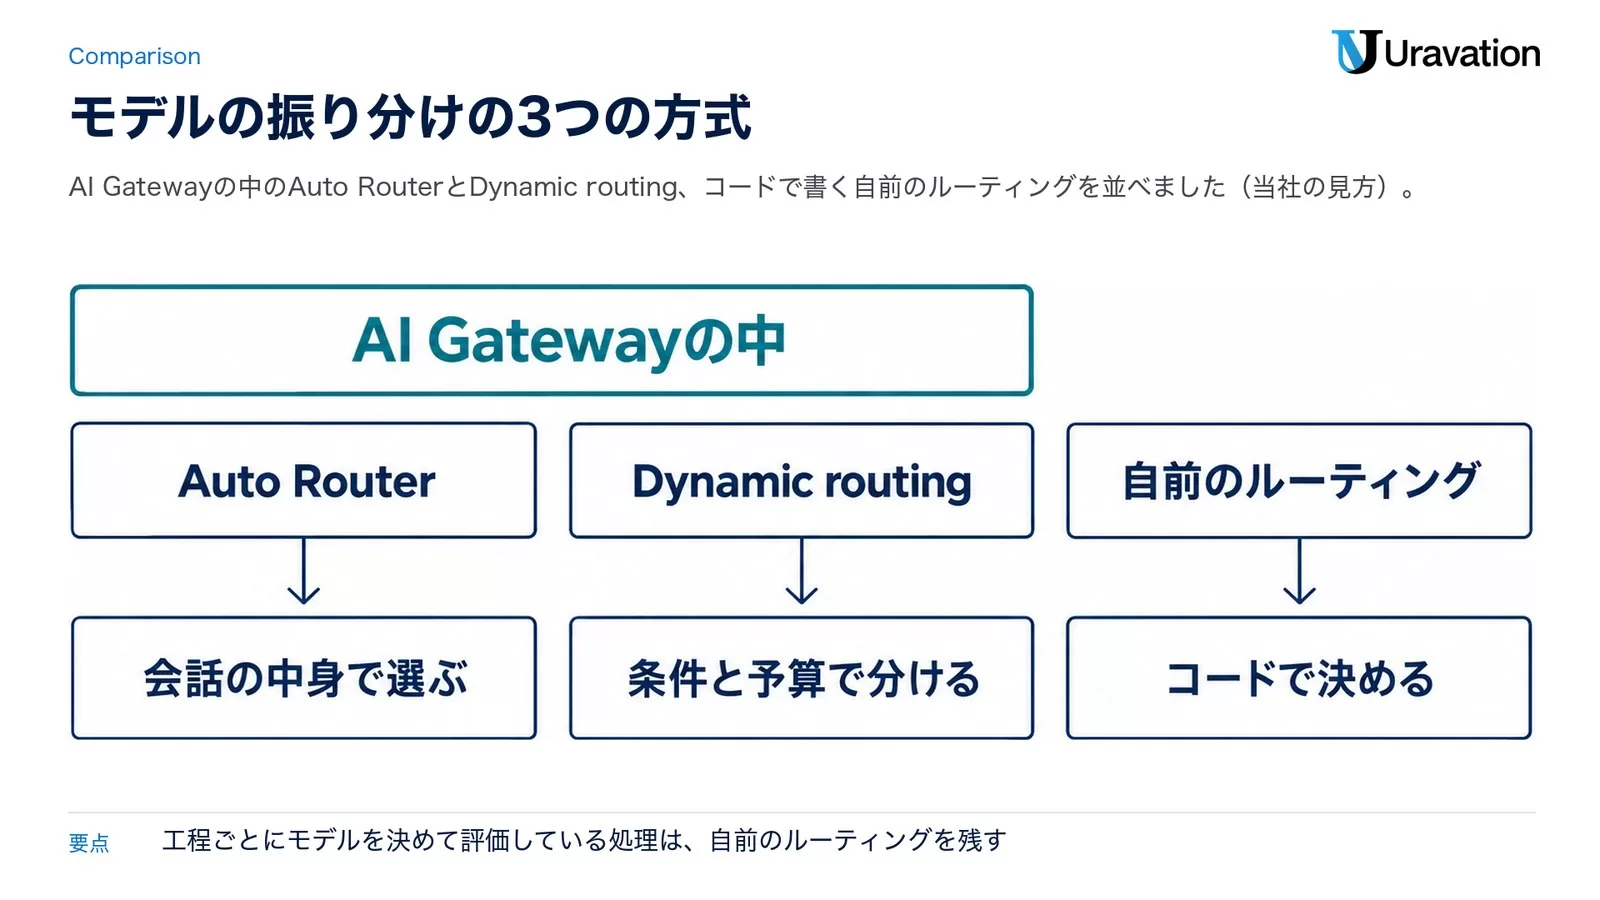
| 方式 | 選び方 | 向いている場面 | 気をつけること |
|---|---|---|---|
| Auto Router | 会話の中身で選ぶ | 社員が自分でモデルを選んでいて、作業の種類が混ざる社内のチャットやコーディングエージェント | 候補はCloudflareが管理し、変わることがある。公開ベータ |
| Dynamic routing | 条件と予算で分ける | 有料と無料の利用者でモデルを分ける、利用者やチームごとの予算、A/Bテストや段階的な切り替え | ゲートウェイの認証とBYOKのキーの保存が前提。/compat/chat/completionsで呼ぶ |
| 自前のルーティング | コードで決める | エージェントの工程ごとに使うモデルを決めて評価している、候補にないモデルを使う | 振り分けの規則と評価の仕組みを自分で持つ |
当社の見方では、Auto Routerがいちばん合うのは、社員がチャットやコーディングエージェントで自分でモデルを選び、作業の重さに比べて上位のモデルを使いがちな組織です。ブログの例のとおり、メールの要約と難しい設計の相談が同じ入口に混ざる使い方なら、ゲートウェイの側で選ばせる意味があります。
一方で、エージェントの工程ごとに使うモデルを決め、評価を回している場合は、自前のルーティングを残すのが無難です。cloudflare/autoの候補はCloudflareが管理して変わることがあり、工程ごとにモデルを固定して評価するやり方とは相性がよくありません。試すなら、工程の決まっていないチャットや調べものから始め、cf-aig-routed-modelとcf-aig-routing-reasonの記録を見てから広げる順番が安全です。データを残さない条件が要る処理や、Geminiを使う処理は、今の候補の一覧と予定から見て、当面はAuto Routerの外に置くことになります。
費用の全体像は、AIエージェントのコスト管理|API従量とサブスク徹底比較で、API従量とサブスクリプションの比べ方を整理しています。Cloudflareの上でエージェントを動かす基本は、Cloudflare Workers AIエージェント実装ガイド2026を参考にしてください。
【要注意】よくある失敗パターン
発表の直後に起こりやすい読み違いと、設定の失敗を5つ挙げます。
失敗1:「最大30%」をそのまま予算の削減額にする
❌ ブログの「最大30%の節約」を前提に、AIの利用費の予算を3割減らす
⭕ User InsightsのPotential Savingsと、cf-aig-routed-modelの記録で、自社のリクエストがどのモデルに回るかを見てから見積もる
なぜ重要か:30%はCloudflare社内のOpenCodeでの初期の実測で、期間や件数はブログに書かれていません。作業の内訳が違えば、下がり方も変わります。
失敗2:セッションIDを付けずにエージェントから呼ぶ
❌ 自作のエージェントからcloudflare/autoを呼ぶ時に、cf-aig-session-idを付けない
⭕ 何度もやり取りする会話ではcf-aig-session-idを毎回付ける(OpenCodeは自動で行う)
なぜ重要か:セッションIDがないとリクエストごとにモデルが選ばれ、同じ会話でも別のモデルに回ってプロンプトキャッシュを再利用できません。
失敗3:新しいモデルも自動で候補に入ると思い込む
❌ GPT-6 SolやClaude Opus 5.5も選ばれる前提で、モデル名をcloudflare/autoに切り替える
⭕ 既定の7つを確かめ、必要なモデルはcf-aig-allowed-modelsで指定する(指定すると既定の候補は置き換わる)
なぜ重要か:2026年9月30日更新の一覧では、どちらも追加のモデルで、ヘッダーの指定に一致した時だけ選ばれます。
失敗4:データを残さない条件が要る処理までまとめて切り替える
❌ 顧客の情報を含む処理も含めて、すべてのリクエストをcloudflare/autoに回す
⭕ ZDRが必要な処理は当面モデルを固定し、使うモデルがZDRに対応しているかをモデルのカタログで確かめる
なぜ重要か:ブログは、ZDRの条件を候補の絞り込みに入れることを今後の予定にしています。ドキュメントでは、ZDRはCloudflareが管理する認証情報を使うUnified Billingのリクエストにだけ適用されます。
失敗5:Run権限のトークンを1つのゲートウェイ専用だと思って渡す
❌ チームごとにゲートウェイを分け、それぞれにAI Gateway Runの権限のトークンを渡して、分けたつもりになる
⭕ トークンはアカウント全体に効く前提で管理し、分ける必要があればアカウントを分けるか、Worker側のbindingを使う
なぜ重要か:ドキュメントは、Run権限のトークンでアカウント内のすべてのゲートウェイ(BYOKのキーを保存したものを含む)にリクエストを送れ、その認証情報を使えてしまうと注意しています。
よくある質問
Cloudflare Auto Routerは無料ですか?
ブログによると、ベータの間は無料です。選ばれたモデルの利用料は別にかかり、Unified Billingならクレジットから差し引かれます(クレジットの購入時に5%の手数料)。自社のAPIキーを使う場合は提供元が請求します。ベータの後の料金は、2026年10月1日時点で公式に確認できていません。
どのモデルが選ばれますか?
既定ではanthropic/claude-fable-5・anthropic/claude-opus-5・anthropic/claude-sonnet-5・openai/gpt-5.6-luna・openai/gpt-5.6-sol・openai/gpt-5.6-terra・xai/grok-4.5の7つから選びます。openai/gpt-6-solなどの追加のモデル20は、cf-aig-allowed-modelsかcf-aig-allowed-providersの指定に一致した時だけ候補に入ります。候補はCloudflareが管理していて、変わることがあります。
Claude CodeやCodexでも使えますか?
Auto Routerのページに手順が載っているのはOpenCodeだけです。Claude CodeとCodexをAI Gateway経由にする手順はドキュメントにありますが、cloudflare/autoを使う手順は2026年10月1日時点で公式に確認できていません。Auto Routerが対応する形式は、Chat CompletionsとResponses APIです。
選ばれたモデルはどこで確かめられますか?
応答のヘッダーのcf-aig-routed-modelに処理したモデルが、cf-aig-routing-reasonに選んだ理由が出ます。AI Gatewayのログと突き合わせる時は、cf-aig-routing-decision-idとcf-aig-request-idを使います。OpenCodeでは、プラグインのサイドバーと/aig-showで見られます。
Cloudflare AI Gatewayとは何ですか?
アプリとAIの提供元の間に入り、利用の分析・キャッシュ・回数の制限・失敗時のモデルの切り替えなどで、AIを使うアプリの動きを見て管理するためのCloudflareのサービスです。料金ページによると、すべてのプランで使え、基本機能は無料です。Auto Routerは、このAI Gatewayの機能の1つとして提供されています。
まとめ
Cloudflare Auto Routerは、AI Gatewayでモデル名をcloudflare/autoにするだけで、リクエストごとに作業に足りるモデルを選ぶ機能で、2026年9月30日に公開ベータになりました。既定の候補は7つで、何度もやり取りする会話はセッションIDで1つのターンの間モデルを固定でき、ベータの間は無料です。「最大30%」はCloudflare社内のOpenCodeでの初期の実測で、社内のベンチマークでは成功率がClaude Opus 5.5より低いことも示されています。
今週やるなら、順番は3つです。User InsightsのPotential Savingsで自社の利用を見る、OpenCodeかチャットの一部でcloudflare/autoを試す、cf-aig-routed-modelとcf-aig-routing-reasonの記録を見てから対象を広げる。社内でモデルの使い分けや費用の決まりを設計する段階で相談先が必要な場合は、UravationでもAIエージェントの導入を支援しています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Cut your AI spend with AI Gateway’s Auto Router — Cloudflare公式ブログ(2026年9月30日・参照日: 2026-10-01)
- Auto Router — Cloudflare Docs(2026年9月30日更新・参照日: 2026-10-01)
- Unified API (OpenAI compat) — Cloudflare Docs(2026年8月7日更新・参照日: 2026-10-01)
- Pricing — Cloudflare Docs(2026年9月24日更新・参照日: 2026-10-01)
- Limits — Cloudflare Docs(2026年9月24日更新・参照日: 2026-10-01)
- Unified Billing — Cloudflare Docs(2026年9月23日更新・参照日: 2026-10-01)
- Authenticated Gateway — Cloudflare Docs(2026年6月17日更新・参照日: 2026-10-01)
- Spend limits — Cloudflare Docs(2026年9月9日更新・参照日: 2026-10-01)
- Dynamic routing — Cloudflare Docs(2026年8月7日更新・参照日: 2026-10-01)
- User Insights — Cloudflare Docs(2026年9月24日更新・参照日: 2026-10-01)
- Coding agents・Claude Code・OpenAI Codex — Cloudflare Docs(2026年9月10日・8月17日・8月5日更新・参照日: 2026-10-01)
- AI Gateway Changelog — Cloudflare Docs(2026年9月29日と9月14日の項・参照日: 2026-10-01)