「Reverse engineer anything with agents, from app behavior down to native binaries」とは、エージェントがアプリを丸ごと自動複製する仕組みなのか?
いいえ。REAはアプリを自動複製する仕組みではなく、AIエージェントが既存の解析ツールを呼び出し、アプリの挙動やバイナリを根拠付きで調べるためのオープンソース基盤です。
2026年10月15日時点のREA(Reverse Engineer Anything)は、Hopper・Ghidra・IDAなどの解析エンジンや内蔵の静的解析をMCPとCLIから呼び出し、観測結果・推論・未確認事項・制約をEvidence(解析の証跡)としてAIエージェントへ返します。重要なのは「anything」という名前を、無条件に何でも解析できるという性能保証として読まないことです。対象形式、OS、外部ツール、実行権限には条件があり、再実装の正しさや利用権限までREAが保証するわけでもありません。
公式READMEは、分析結果に根拠と限界を含めること、対象の解析はローカルで行う一方、結果を受け取るモデル提供者には別のデータポリシーがあることを明記しています。
Hacker Newsの該当スレッドは、2026年10月13日1時31分(JST)に投稿され、10月15日の確認時点で98 points・38 commentsでした。これは製品仕様ではなく、コミュニティの反応を示す時点付きの数字です。記事後半では、公式仕様とコメント欄の意見を分けて扱います。
公開されたのは万能AIではなく、解析の共通入口
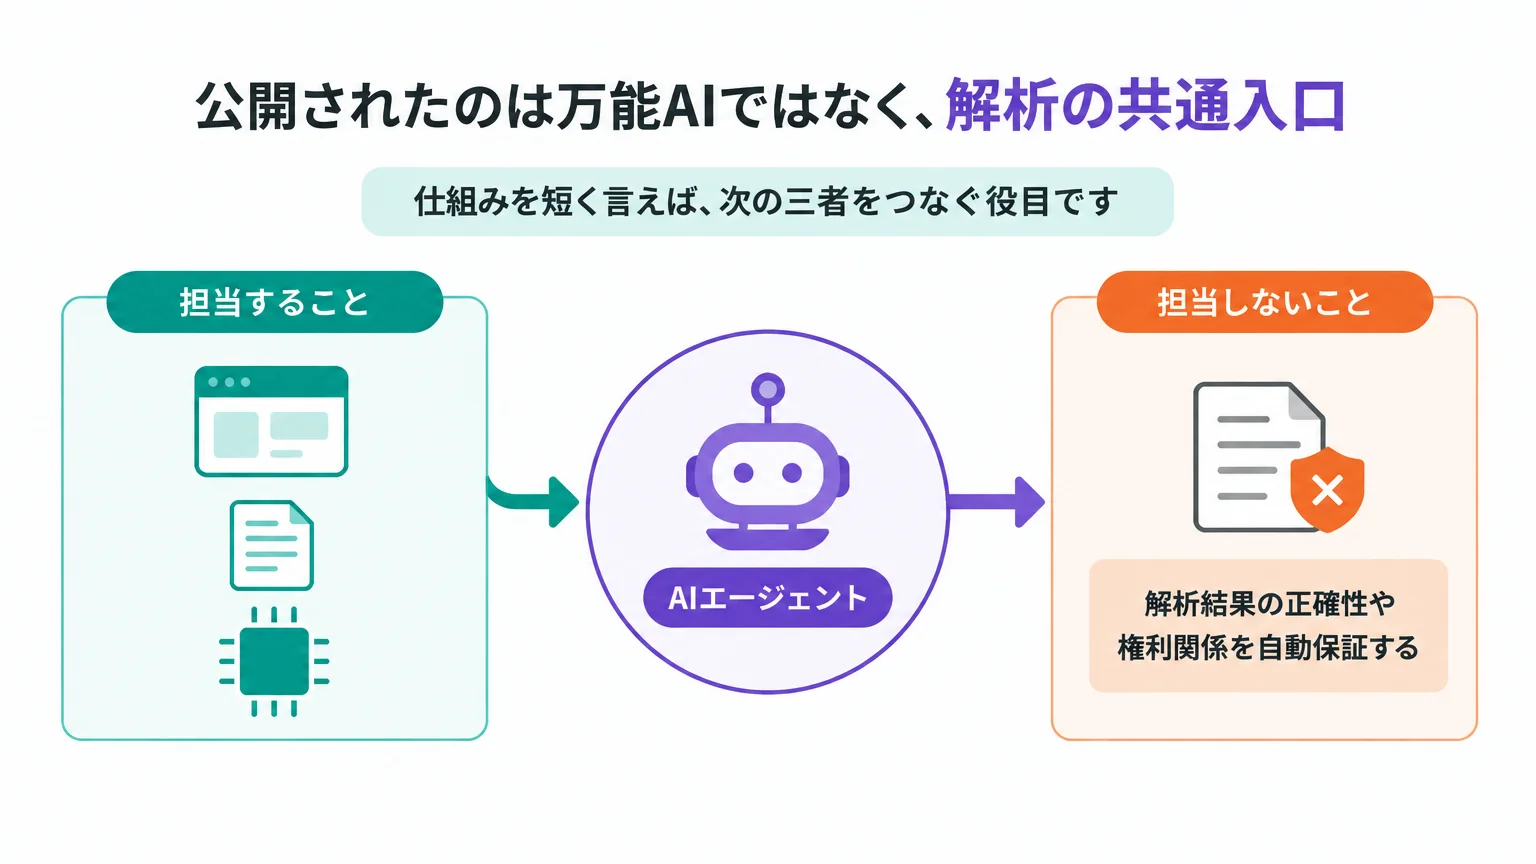
REAはnpmパッケージ名ではrea-agentsとして提供される、ローカルMCPサーバー兼ワンショットCLIです。2026年10月15日時点の最新公開版は6.5.0で、GitHub Releaseは2026年10月14日に公開されています。この記事の仕様説明は、更新の速いmainブランチではなく、公開版6.5.0のタグ付き文書を基準にしています。
仕組みを短く言えば、次の三者をつなぐ役目です。
| 層 | 担当すること | 担当しないこと |
|---|---|---|
| AIエージェント | 調査の問いを分解し、追加調査、説明、実装、テストを進める | 解析結果の正確性や権利関係を自動保証する |
| REA | 対象と解析手段を接続し、結果をEvidenceとして整理する | 単独であらゆる形式を解析する万能デコンパイラになる |
| 解析エンジン/アダプター | ネイティブ、JavaScript、.NET、ブラウザなど対象別の観測を行う | 対象外形式や未対応OSまで自動で補完する |
つまり、従来の解析ツールを捨ててAIだけに置き換える発表ではありません。既存の専門ツールとエージェントの間に、対象選択、セッション、証拠、制約を扱う共通入口を置いたことがポイントです。
挙動・JavaScript・バイナリを一本の調査線で追う
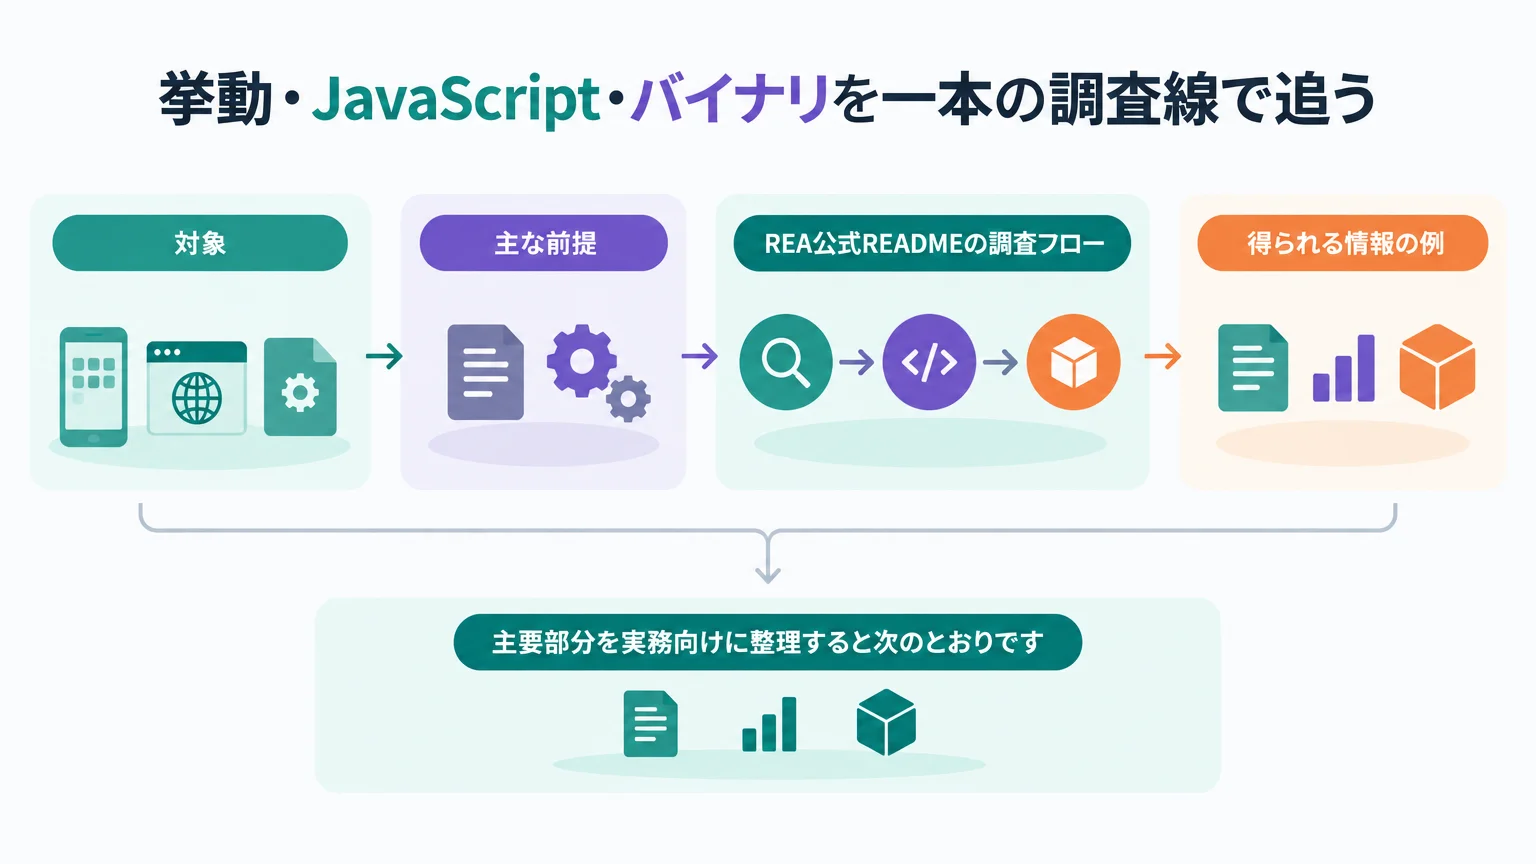
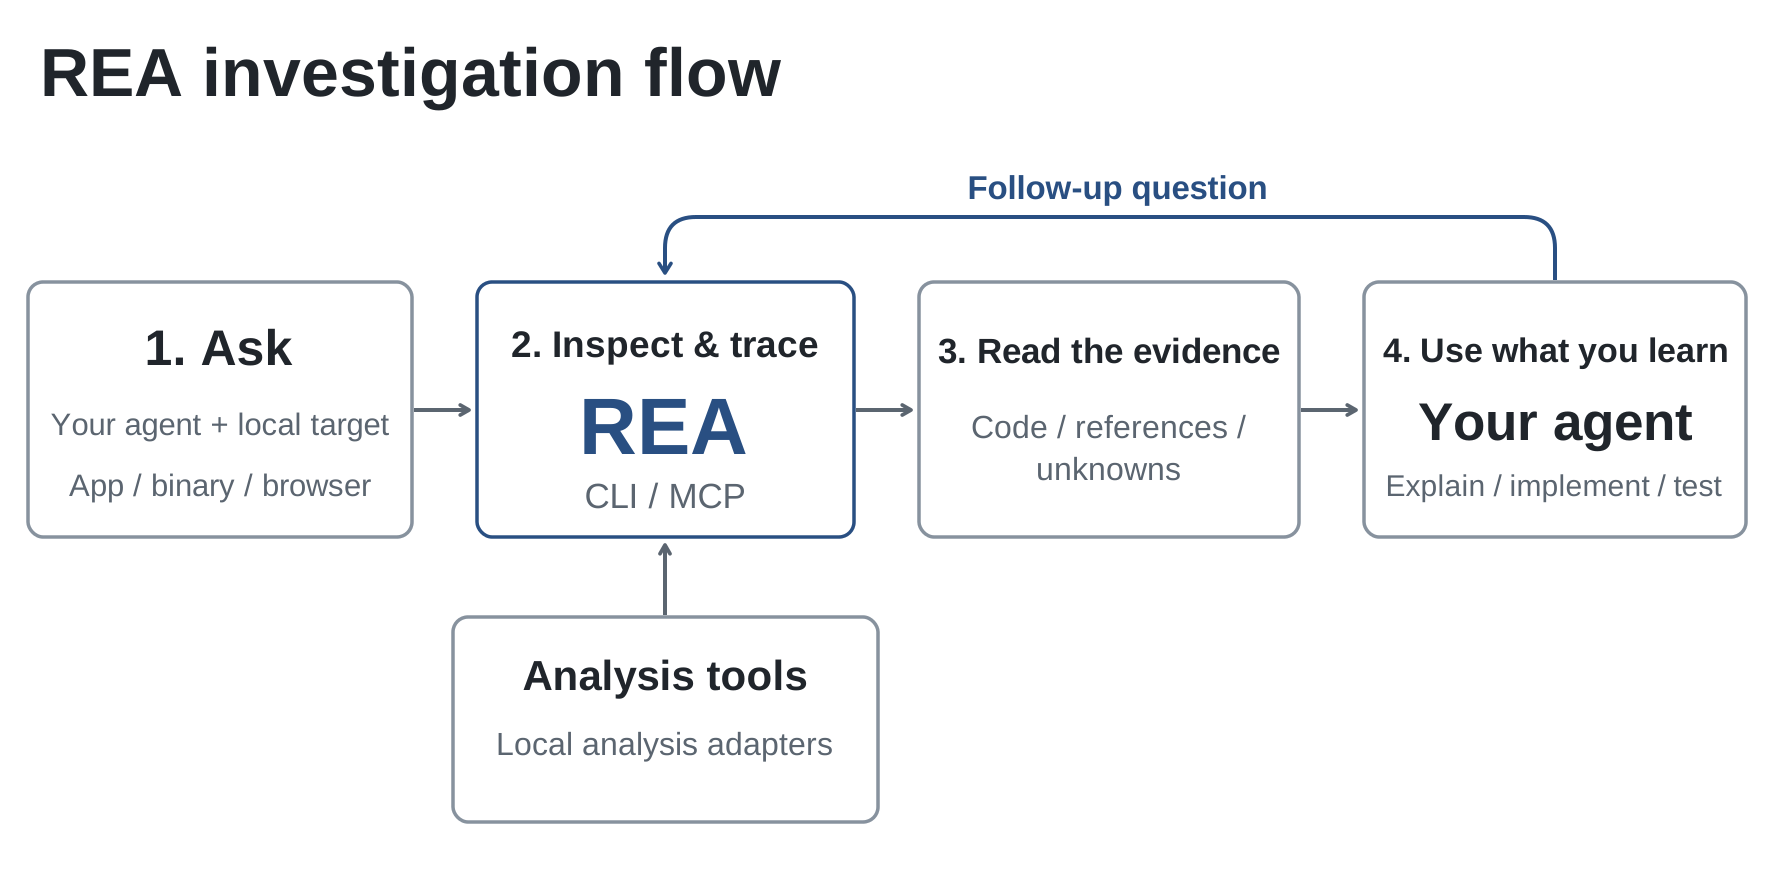
アプリの「検索ボタンを押した後、どの処理が呼ばれるのか」を知りたいとします。画面上の挙動だけでは、JavaScriptのイベント、ElectronのIPC、ネイティブアドオン、OS側APIのどこに本体があるかは分かりません。REAの狙いは、エージェントが一つの疑問を起点に、観測できた層から次の層へ根拠をたどれるようにすることです。
公開版6.5.0のREADMEには、対象ごとに別の条件が並んでいます。主要部分を実務向けに整理すると次のとおりです。
| 対象 | 得られる情報の例 | 主な前提 |
|---|---|---|
| ネイティブバイナリ | 疑似コード、アセンブリ、文字列、シンボル、呼び出し、参照 | Hopper、Ghidra、IDAのいずれか |
| JavaScript/Electron | モジュール、import、source map、route、IPC、ネイティブアドオン関係 | Node.jsとnpm。Linuxではprocps互換のps |
| .NETアセンブリ | メタデータ、CIL命令、宣言されたネイティブ依存関係、ビルド比較 | 静的解析はネイティブ解析エンジン不要 |
| Webサイト | ページ構造、スクリプト、ネットワーク観測、指定したスクリーンショット | Chrome系ブラウザ |
| Android APK/端末 | マニフェスト、クラス、逆コンパイルされたメソッド、参照、端末ログなど | APKはheadless JADXとJDK、端末操作は利用者が用意したadb |
| 保存済みキャプチャや成果物 | HAR、パケット、ファームウェア、WASM、SQLiteなど対象別の情報 | 形式ごとにTShark、WABT、Binwalkなど別要件 |
この一覧は「一つのコマンドで全部分かる」という意味ではありません。たとえば静的JavaScript解析は対象を実行せずに読めますが、プロセスキャプチャやブラウザ観測は、選択した対象を利用者権限で動かしたり操作したりします。問いに必要な最小の層から始め、実行を伴う層は別承認に切り分ける設計が必要です。
AIによる逆コンパイルの一般的な論点は、既刊の「500B tokens later|AI逆コンパイル5つの教訓」でも扱っています。既刊が長期の再構築プロジェクトから評価方法を考える記事なのに対し、REAは複数の解析対象とエージェントをつなぐ公開ツールのニュースです。
従来ツールを置き換えず、エージェントから束ねる
ネイティブ解析では、REAがHopperやGhidraそのものの役割を代替するわけではありません。対象を開き、関数を探し、疑似コードや参照を取得する処理は選択したプロバイダーが担います。REAはCLIとMCPで同じアプリケーションワークフローを使い、結果を後続調査で扱える形にそろえます。
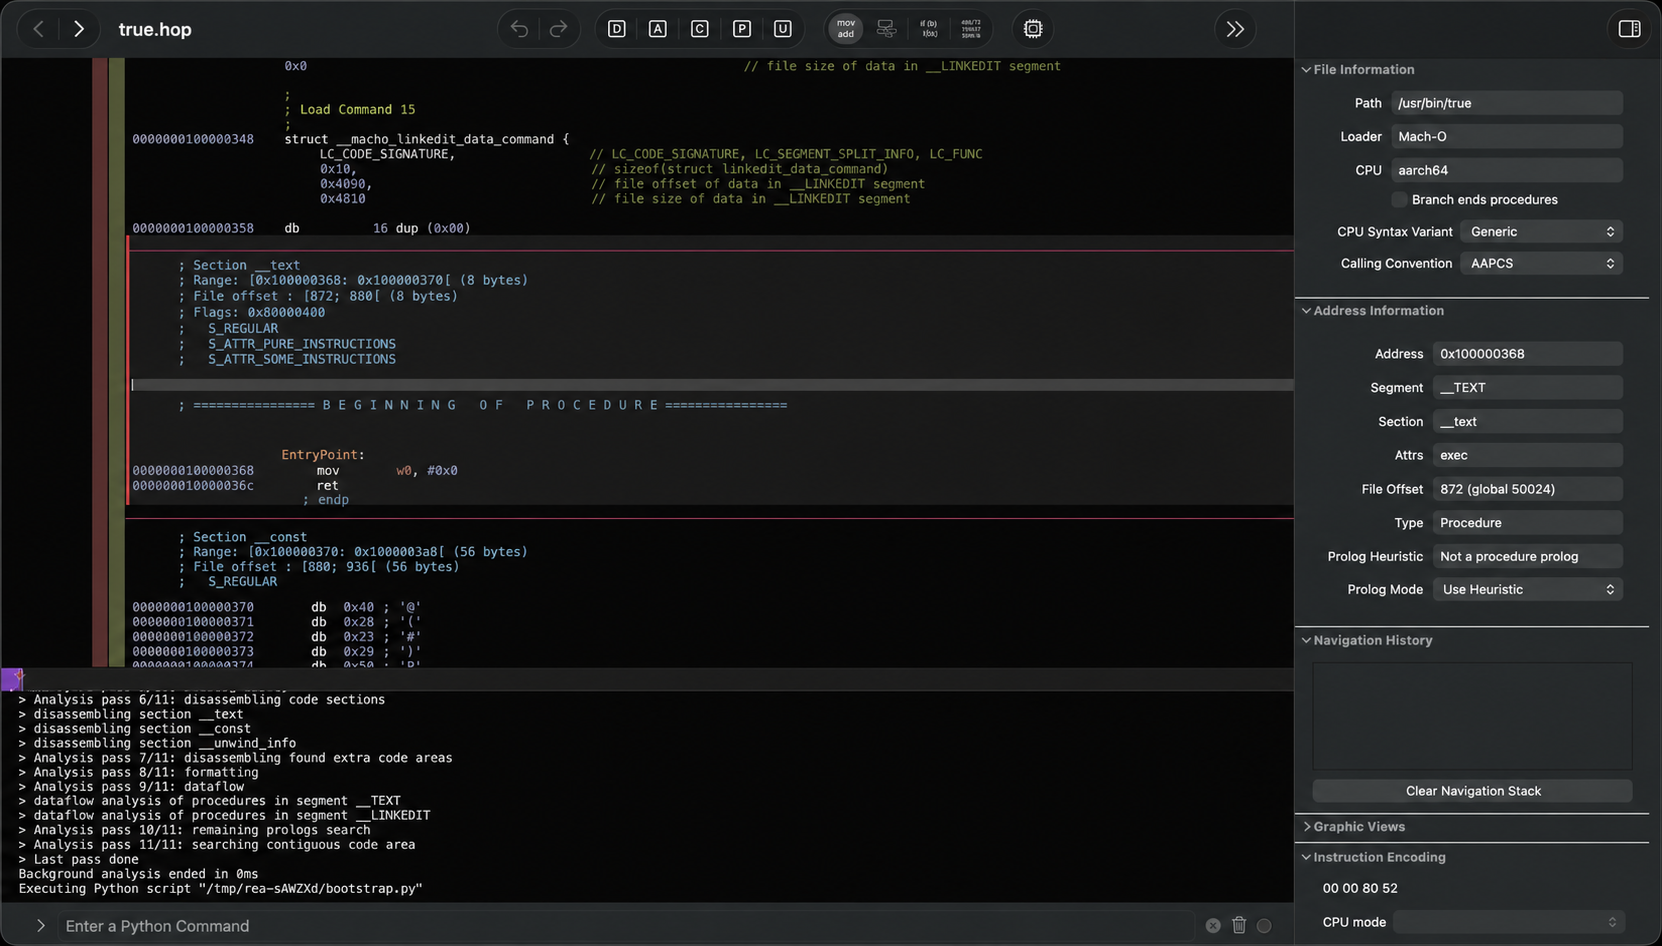
公開版の基本動作条件は、Node.js 22.xなら22.19以上、24.xなら24.11以上、または26以上とnpmです。深いネイティブ解析には別の解析エンジンが必要ですが、静的JavaScriptや.NETの調査はネイティブ解析エンジンなしでも開始できます。正確な対象表と条件は、6.5.0の公式READMEで確認してください。
ここで企業利用に効くのが、プロバイダーを曖昧にしない点です。利用可能な解析手段が複数ある場合は明示的に選択でき、選択後の障害を理由に、別のプロバイダーへ無断で切り替える設計ではありません。調査結果をレビューするとき、「どのエンジン、設定、対象から得た観測か」を追いやすくなります。
業務で価値が出るのは回答よりEvidence
エージェントに「この機能を説明して」とだけ頼むと、もっともらしい物語が返ってきても、その根拠をレビューできません。REAのEvidenceは、観測事実、推論、取得できなかった範囲、制約を分けて後続処理へ渡すための契約です。公式MCP contractsでは、ツール結果とEvidenceの構造、セッション、利用可能性が文書化されています。
レガシー移行では仕様書の代わりではなく仮説の入口になる
ソースが失われた社内ツールや、引き継ぎが途切れた自社バイナリでは、文字列、呼び出し、入出力、実行時観測から機能仮説を作れます。ただし、疑似コードが得られたことは元の設計意図や例外条件を完全に復元したことを意味しません。Evidenceから独立した仕様を書き、既知の入出力で別途テストして初めて、移行判断に使える材料になります。
セキュリティ調査では不明点が残ること自体が重要になる
空の結果を「存在しない」と断定すると危険です。解析範囲外、未対応形式、タイムアウト、取得上限などで見えていない可能性があります。REAの結果にcoverageやlimitationsが含まれる設計は、「検出なし」と「未確認」を分ける助けになります。エージェント評価全体の設計は、AIエージェントのテスト・評価設計ガイドも参照してください。
対象から取り込んだ文字列は命令ではなくデータとして扱う
バイナリ内の文字列、疑似コードのコメント、Webページ、スクリプト、ネットワークログには、エージェントへ命令するような文章が含まれ得ます。公式のMCP contractsは、対象由来の内容を未信頼データとして扱い、該当するツール結果にprovenance.untrusted_contentを付ける契約を記載しています。企業側でも「対象内の文章に従わない」「外部送信やファイル変更は別承認」「調査プロンプトと対象データを分離」という停止線が必要です。
権限・隔離・秘密情報を解析前に切り分ける
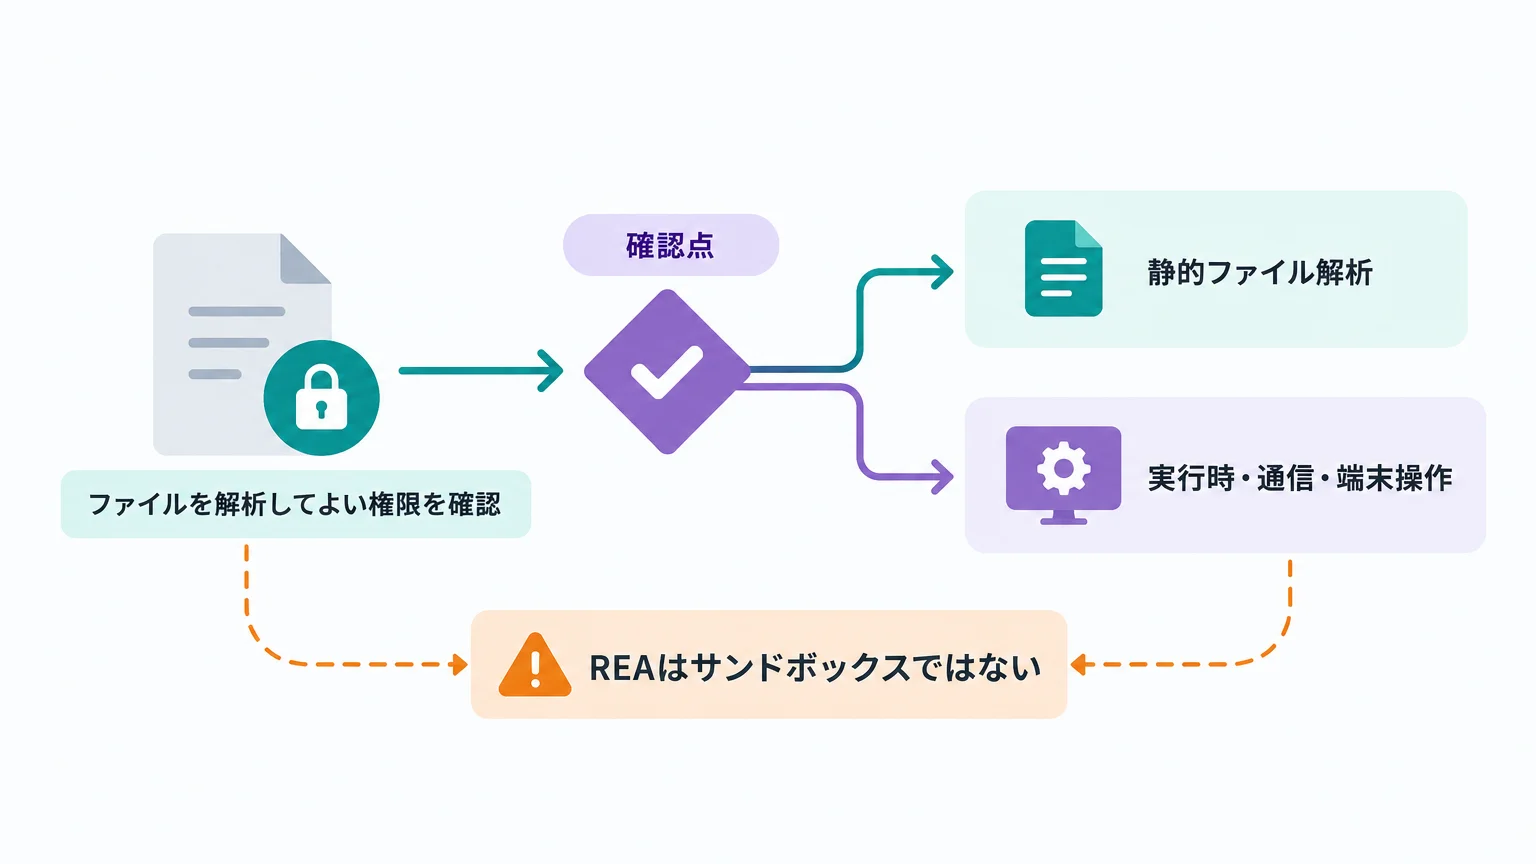
REAの公式Disclaimerは、合法で許可された研究、教育、相互運用性、ソフトウェア保存、自分が所有するか解析を許可されたソフトウェアなどを想定しています。DRM、ライセンス確認、アンチチート、認証やアクセス制御の回避、プロプライエタリなコードや素材の複製は、プロジェクトの支援対象外です。
日本の著作権法について、文化庁は平成30年改正の公式Q&Aと公式解説の問12で、プログラムの調査解析を目的とする利用、いわゆるリバースエンジニアリングを第30条の4の対象となり得る例として挙げる一方、利用規約との関係にも注意を促しています。ただし、これは「第三者ソフトウェアなら何でも自由に解析・再利用できる」という説明ではありません。対象、目的、必要な範囲、利用規約、契約、技術的保護、個人情報、成果物の利用方法などで判断は変わります。これは一般的な制度説明であり、個別案件の法的判断ではありません。第三者ソフトウェアは、所有者・管理者からの権限と個別条件を確認し、必要に応じて法務へ相談してください。
| 確認点 | 静的ファイル解析 | 実行時・通信・端末操作 |
|---|---|---|
| 対象の権限 | ファイルを解析してよい権限を確認 | 起動、接続、操作、傍受まで許可されているかを別確認 |
| 副作用 | 対象は実行しなくても、解析エンジンがファイルを読む | 状態、ファイル、アカウント、端末、外部サービスへ影響し得る |
| 秘密情報 | 文字列や設定に鍵・顧客情報が含まれないか確認 | 通信、画面、ログ、入力データの取得範囲を先に限定 |
| 成果物 | Evidenceの保存場所と閲覧者を限定 | キャプチャ、スクリーンショット、端末データの保持期限も決める |
「ローカル解析」と「情報が外へ出ない」は同義ではない
REAは対象をローカルで解析しますが、AIエージェントはツール結果を受け取ります。クラウドモデルを使う場合、その送信・保存・学習利用の扱いはモデル提供者と契約プランのデータポリシーに従います。機密バイナリ、認証情報、顧客データを含むEvidenceを、そのままモデルへ渡してよいとは限りません。入力を最小化し、匿名化、ローカルモデル、送信禁止の対象分類を先に決めてください。
REAはサンドボックスではない
公式Security Policyは、REAがサンドボックスではなく、同じOSユーザーで動く悪意あるプロセスから守るものでもないと説明しています。信頼できないバイナリを開くと、選択したローカル解析プロバイダーがそのユーザー権限で解析します。日常業務のアカウントや共有端末で未知の対象を開くのではなく、破棄可能な仮想環境または専用端末、最小権限のOSユーザー、制限したネットワークを使うのが安全です。隔離方式を検討する際は、AIエージェントのサンドボックス設計も参考になります。
鍵の漏えいが疑われたら、解析を続ける前に止める
解析用エージェントが参照できたAPIトークンやMCP資格情報の漏えいが疑われる場合は、対象プロセスと外部連携を止め、当該トークンを提供元で無効化し、ログとEvidenceを保全して送信範囲を確認します。JPCERT/CCも2026年10月8日の注意喚起で、不要または漏えいが疑われるAPIトークンを速やかに無効化できるよう求めています。ローカル設定から文字列を消すだけでは、発行済みトークンの無効化にはなりません。
自社サンプルと破棄可能な環境で小さく検証する
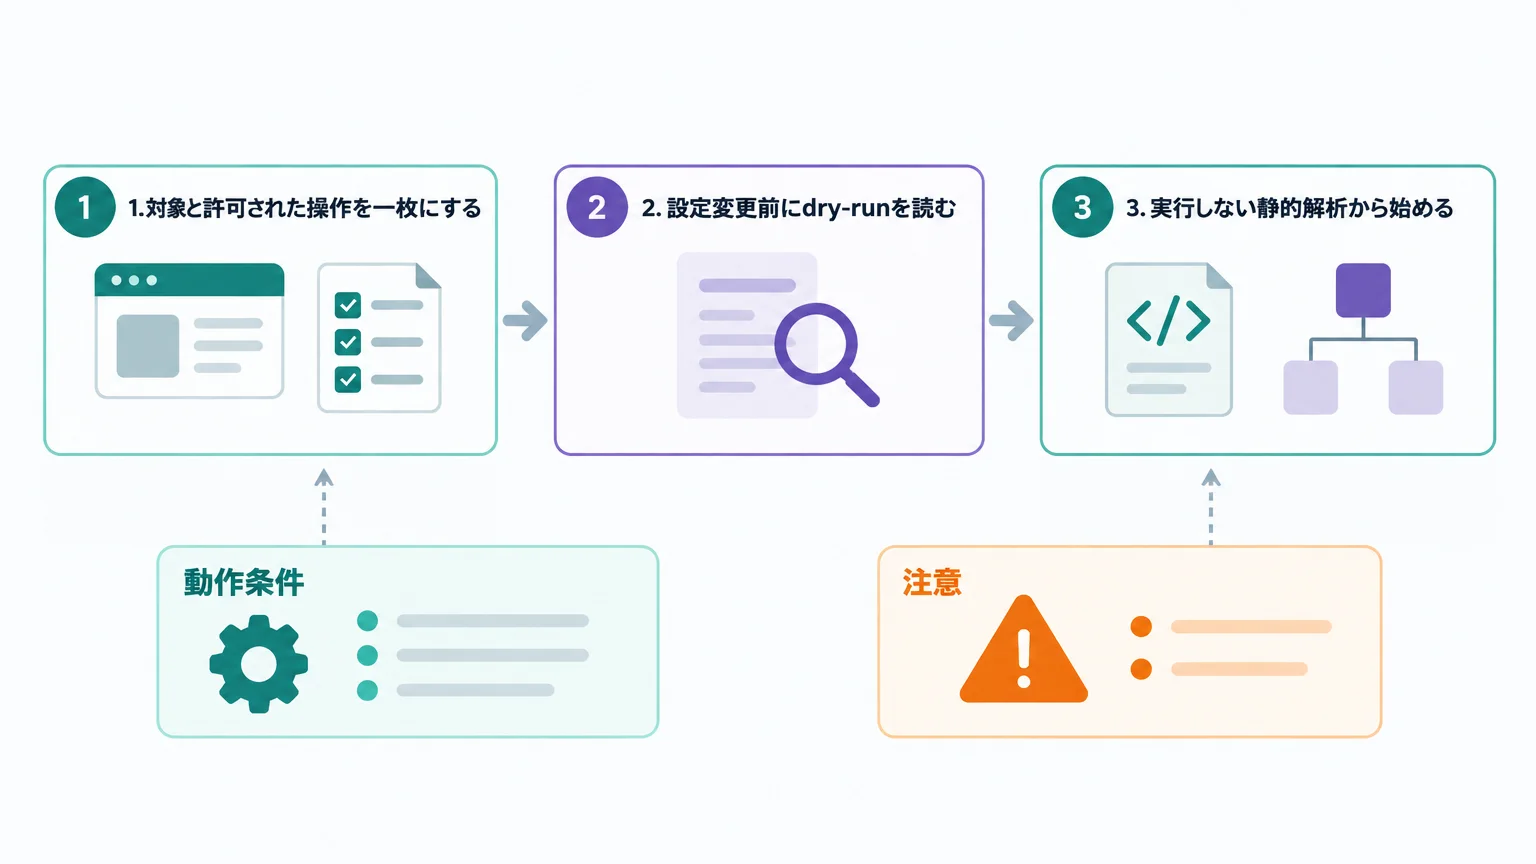
最初の検証対象は、第三者の商用アプリではなく、自社が権利を持つ小さなサンプル、公開ライセンスを確認した教材、または検証専用に作ったミニアプリが適しています。目的も「アプリ全体を理解する」ではなく、「ボタン操作から保存処理までの呼び出しを、どのEvidenceで説明できるか」のように一つへ絞ります。
1. 対象と許可された操作を一枚にする
- 対象ファイル、所有者、ライセンス、利用規約
- 静的解析、起動、デバッグ接続、通信観測のうち許可された操作
- 利用してよい解析エンジンとモデル提供者
- Evidenceの保存先、閲覧者、削除条件
- 成果物を仕様化・実装へ使える範囲
この確認項目を埋められない対象には、技術的に開けても着手しません。ファイルを持っていること、公開URLから取得できること、デバッグポートへ接続できることは、すべての操作への許可を意味しないためです。
2. 設定変更前にdry-runを読む
公開版のInstallation and setupには、変更計画だけを確認するdry-runが用意されています。次はCodex向けの計画をJSONで確認する例です。
# REA側の設定変更は行わず、変更計画を確認する
npx -y rea-agents@6.5.0 setup --client codex --dry-run --json動作条件:対応するNode.jsとnpm。--dry-runはREAの設定適用を止めますが、npxによるパッケージ取得やキャッシュ書き込みは起こり得ます。出力された対象パス、MCP登録、スキル配置、外部ソフトウェアを読み、意図した範囲だけか確認してください。導入時は組織で確認した版へ置き換え、その版の公式リリースノートを再確認します。
3. 実行しない静的解析から始める
自社で用意したJavaScript/Electronの展開済みディレクトリまたはASARなら、公式CLI例は次の形です。
# 許可済みの検証用アプリを静的解析し、Evidenceを保存する
npx -y rea-agents@6.5.0 analyze-javascript-application /absolute/path/to/app --json > app-evidence.json注意:本番環境で使用する前に、必ず隔離したテスト環境で動作確認してください。大規模アプリのEvidenceは非常に大きくなり得るため、公式CLIガイドはsummaryやpage viewで必要範囲を読む方法も案内しています。
4. ネイティブ解析はプロバイダーの準備状況から確認する
いきなり未知のバイナリを開かず、使えるプロバイダーと機能を確認します。
# 解析対象を開く前に、利用可能な機能と不足条件だけを確認する
npx -y rea-agents@6.5.0 providers --json
npx -y rea-agents@6.5.0 capabilities --json
npx -y rea-agents@6.5.0 doctor --provider ghidra --json動作条件:対応するNode.jsとnpm、および選択する解析エンジンの条件を満たしていること。これらの例でもnpxによるパッケージ取得やキャッシュ書き込みは起こり得ます。診断結果に不足があれば、公式ガイドで対象OSとプロバイダーの条件を確認します。REA本体のMITライセンスは、Hopper、IDA、JEBなど第三者ツールの利用権を付与しません。
5. 成功条件を「説明できた」から「再現テストが通った」へ移す
エージェントの自然な説明だけを合格にしないでください。最低でも、Evidenceの参照先、未確認範囲、反証できるテスト、別担当者によるレビューを残します。再実装を試す場合は、元コードや素材を複製せず、許可された仕様と入出力から独立実装し、既知ケースと境界ケースで比較します。
「解析できた」と「同じものを作れた」の間は長い
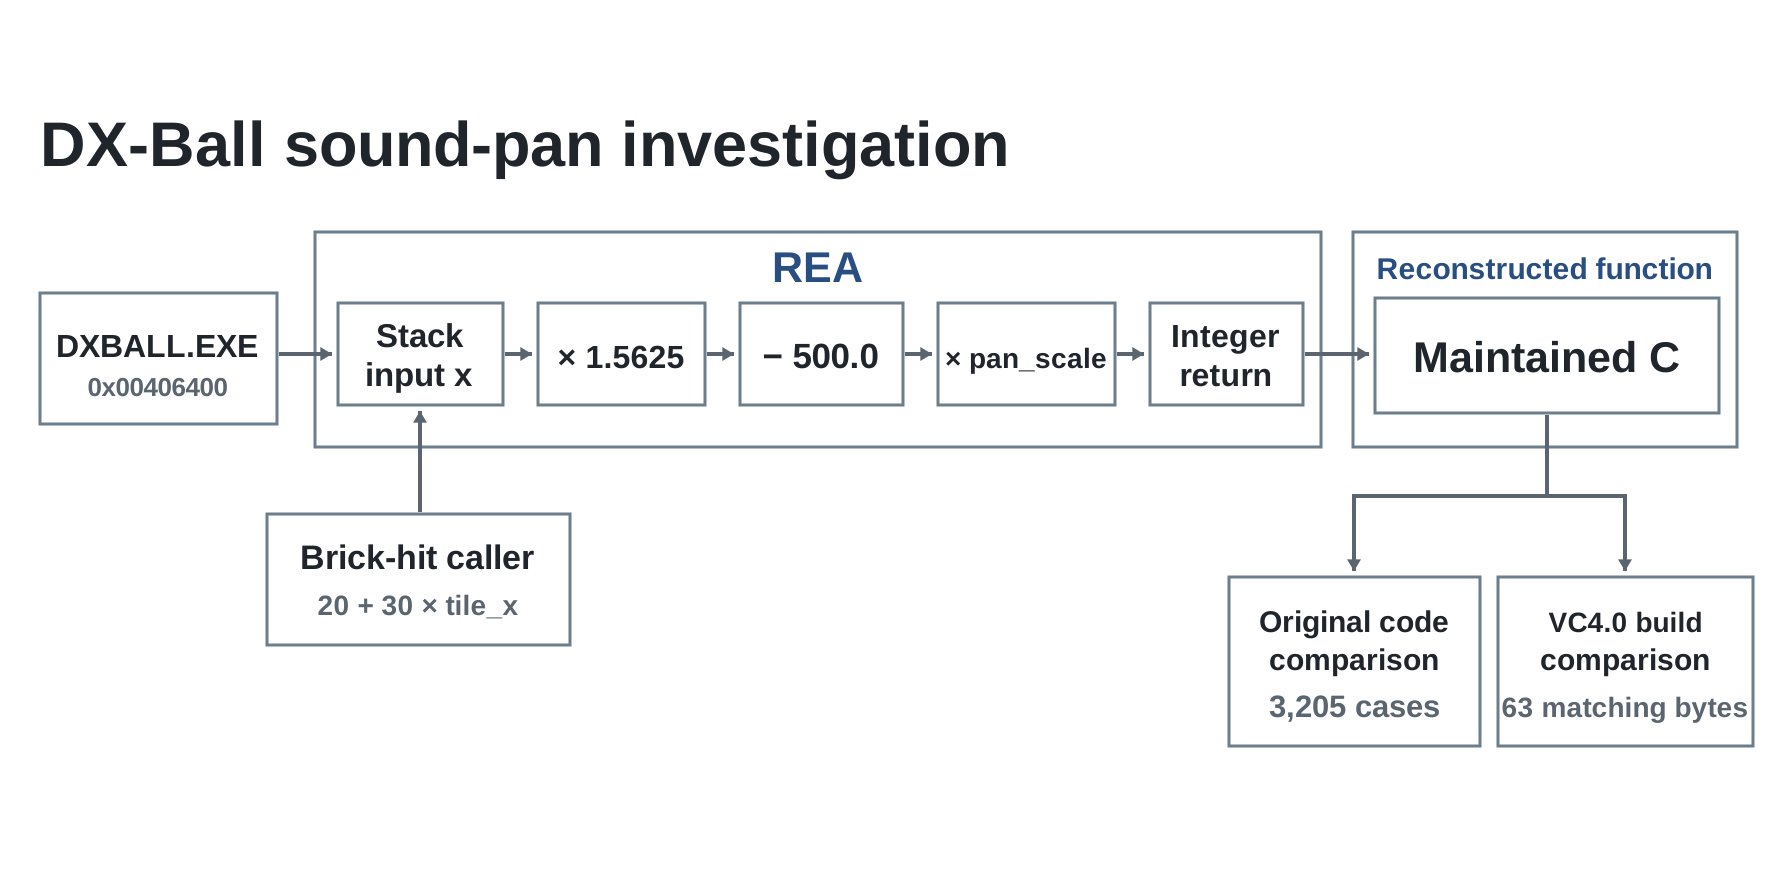
逆解析で得た疑似コードは元のソースコードそのものではなく、ローカル成果物だけでは動的に決まる挙動やサーバー側ロジックを観測できない場合があります。公式Disclaimerも、逆コンパイル、再構築、ヒューリスティクス、AI支援分析は不完全または誤る可能性があると明記しています。
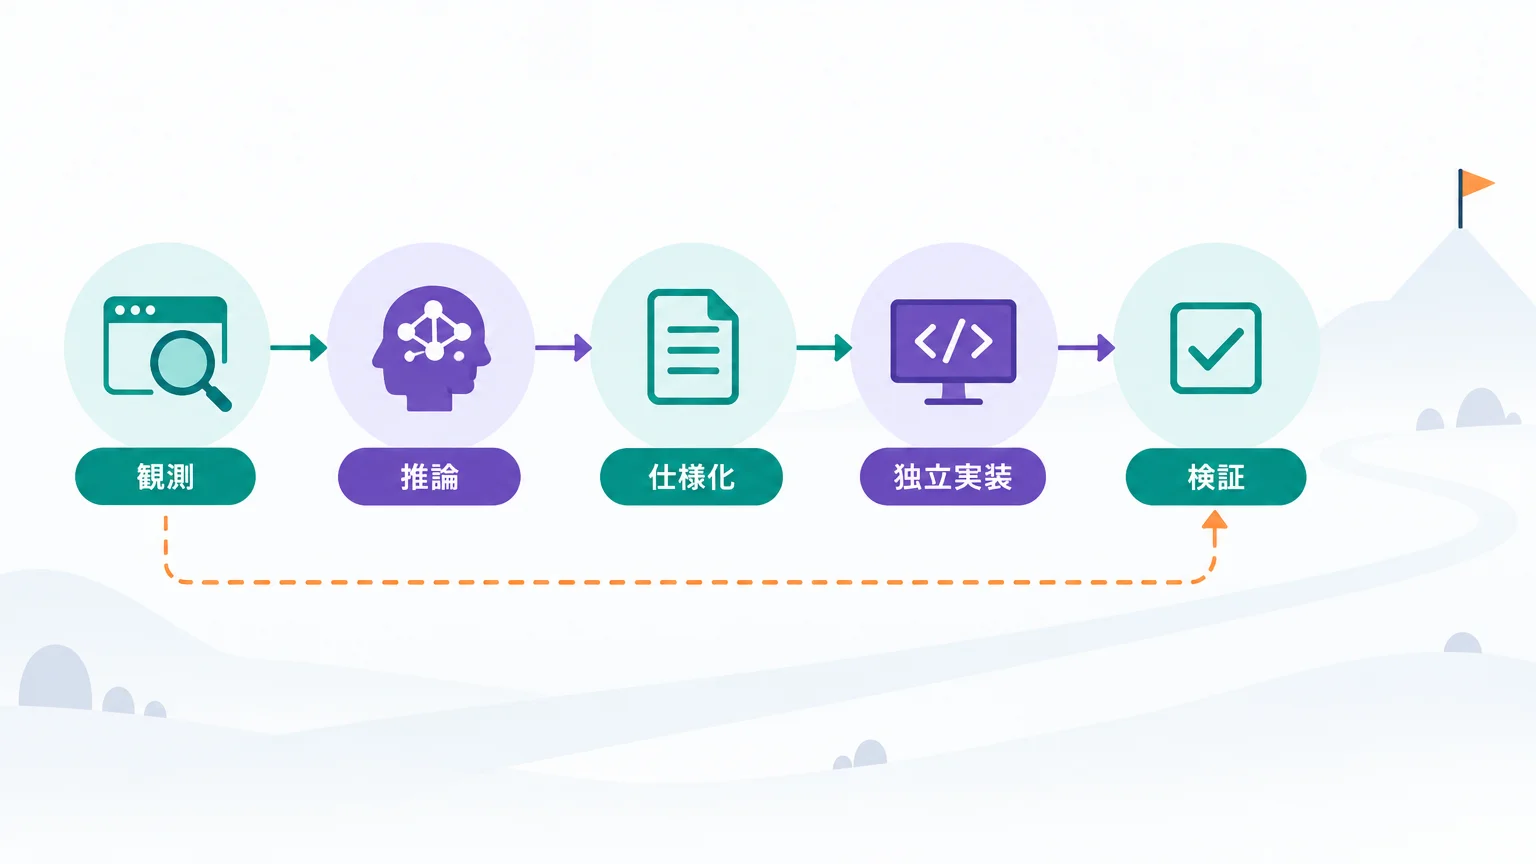
実務では、次の五段階を混ぜないことが大切です。
- 観測:特定の文字列、関数、通信、画面変化が取得できた
- 推論:複数の観測から、処理の役割を説明できる仮説ができた
- 仕様化:権利上使える情報だけで、入力・出力・例外条件を書けた
- 独立実装:自社のコードと要件で機能を実装した
- 検証:テストで必要な同等性を確認し、差分と未確認範囲を記録した
REAが強くするのは主に観測と推論の接続です。仕様化以降には、知的財産、契約、セキュリティ、品質保証の判断が残ります。CLIが終了コード0を返しても、partial evidence、warning、未解決の問いを含む可能性があるため、「コマンド成功」を「完全解明」と読み替えないでください。
Hacker Newsの議論が示した期待と警戒
ここからは製品仕様ではなく、コミュニティの反応です。Hacker Newsでは、名称の「anything」が広すぎるのではないかという懐疑、内部APIを理解できても利用できるとは限らないという指摘、難読化コードに対するLLM活用への期待、EULAや逆コンパイルの法的境界をめぐる議論が並びました。
また、クライアント側のバイナリを解析しやすくなればソフトウェアがサーバー側へ寄るのではないか、という予測に対し、データやネットワーク効果が価値の中心にあるサービスやストリーミング型の複雑な製品は単純に複製できない、という反論も出ています。これらは参加者の意見や自己申告であり、REAの性能を検証したベンチマークではありません。
実務者が持ち帰るべき論点は、賛成か反対かではなく、範囲をどう定義するかです。「手元の許可済み成果物から、一つの挙動についてEvidenceを集める」なら検証できます。一方で「非公開サービスを完全再現する」「内部APIをそのまま業務利用する」といった目標は、技術面でも権限面でも別問題です。
失敗はツール選定より問いの切り方で起こる
失敗1:最初からアプリ全体の再現を頼む
❌ 避けたい依頼例:「このアプリを全部解析して、同じものを作って」
⭕ 改善例:「許可済みの検証用アプリで、検索操作から結果表示までに関係するモジュールとEvidenceを列挙し、不明点を残して」
対象と問いが広いほど、エージェントは見えていない範囲を推測で埋めやすくなります。一つの挙動、一つの入力、一つの判断に絞ってください。
失敗2:ローカルだから安全だと決めつける
❌ 避けたい進め方:日常業務のユーザー権限、実データ、保存済みAPIキーがある端末で未知の対象を開く
⭕ 改善例:破棄可能な環境、最小権限、制限したネットワーク、ダミーデータで静的解析から始める
REAはサンドボックスではありません。解析エンジン、対象の実行、モデル提供者への結果送信を別々に評価します。
失敗3:Evidenceを丸ごとクラウドモデルへ渡す
❌ 避けたい進め方:バイナリ由来の文字列、資格情報、顧客データを確認せず送る
⭕ 改善例:必要なEvidenceだけを選び、秘密情報を除去し、契約上許可されたモデルと保存設定を使う
「対象ファイルをアップロードしていない」だけでは十分ではありません。解析結果が対象の内容を含む場合があります。
失敗4:自然な説明を正解として採用する
❌ 避けたい判断:疑似コードの要約が分かりやすいので、そのまま仕様書にする
⭕ 改善例:Evidence、coverage、limitations、反証テストをそろえ、独立したレビューを通す
AIエージェントの役割は調査を速めることであり、レビュー責任をなくすことではありません。
失敗5:REAのMITライセンスを対象物の利用許可と誤解する
❌ 避けたい判断:REAがMITなので、解析対象や復元結果も自由に使えると判断する
⭕ 改善例:REA本体、第三者解析ツール、解析対象、取得データ、生成した実装の権利を分けて確認する
ライセンス確認の回避や保護されたコード・素材の複製は、公式の責任ある利用方針にも反します。
よくある質問
REAはアプリ本体を外部サーバーへアップロードしますか?
公式READMEは、対象の解析をローカルで行うと説明しています。ただし、AIエージェントはREAの結果を受け取ります。クラウドモデルへ渡る内容と保存・学習利用の扱いは、利用中のモデル提供者と契約プランのポリシーを別途確認してください。
Hopper、Ghidra、IDAは必須ですか?
深いネイティブ解析にはいずれかのプロバイダーが必要です。一方、静的JavaScript/Electronや.NETなど、ネイティブ解析エンジンなしで使える経路もあります。対象ごとの要件は6.5.0のREADMEと公式ガイドで確認してください。
市販ソフトなら何でも解析してよいですか?
いいえ。技術的に読めることと、解析・実行・通信観測・再利用の権限があることは別です。所有者の許可、利用規約、契約、技術的保護、著作権、個人情報などを対象ごとに確認してください。
REAの出力をそのまま製品コードへ移せますか?
そのまま移せるとは限りません。疑似コードや推論は不完全な可能性があり、元のプログラムや第三者ツールの権利も残ります。必要な仕様を独立して整理し、自社コードで実装し、テストと法務確認を通すのが安全です。
最初の検証対象は何がよいですか?
自社が権利を持つ小さなサンプル、検証用に作ったミニアプリ、または利用条件を確認できる教材が適しています。秘密情報を含まず、正解となるソースやテストを自社で持っている対象なら、REAの説明とEvidenceを照合できます。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- REA README(公開版6.5.0) — 概要、動作条件、対象、ローカル解析とモデル提供者ポリシーの区別(参照日:2026年10月15日)
- rea-agents 6.5.0 Release — 最新公開版と公開時刻(参照日:2026年10月15日)
- Installation and setup — setup、dry-run、変更計画、バックアップ、対応条件(参照日:2026年10月15日)
- CLI and Evidence — CLIコマンド、プロバイダー、Evidenceの保存と参照(参照日:2026年10月15日)
- Security Policy — サンドボックスではないこととローカル解析の境界(参照日:2026年10月15日)
- Disclaimer — 許可された用途、禁止用途、実行時操作、解析結果の限界(参照日:2026年10月15日)
- 文化庁「著作権法の一部を改正する法律(平成30年法律第30号)について」 — 第30条の4とプログラムの調査解析に関する公式説明(参照日:2026年10月15日)
- 文化庁「著作権法の一部を改正する法律(平成30年改正)について(解説)」 — 問12のリバースエンジニアリングと利用規約に関する説明(参照日:2026年10月15日)
- JPCERT/CC「直近で相次いでいる国内組織における不正アクセスに関する注意喚起」 — APIトークンの権限、有効期限、無効化(参照日:2026年10月15日)
- Hacker News「Reverse engineer anything with agents, from app behavior down to native binaries」 — 反応の確認にのみ使用。製品仕様の根拠には未使用(参照日:2026年10月15日)
結論と次の一歩
REAの新しさは、リバースエンジニアリングを魔法の自動複製に変えたことではありません。対象別に分かれていた解析手段をエージェントから呼び出し、根拠・推論・不明点・制約をEvidenceとしてつなぐ入口を作ったことです。日本企業で試すなら、機能の広さよりも、許可された範囲を守りながらレビュー可能な証跡を残せるかを評価してください。
- 対象を一つ選ぶ:自社が権利を持ち、秘密情報を含まない小さな検証用アプリに限定する
- 操作を分ける:静的解析、対象の起動、通信観測、端末操作を別々に承認する
- Evidenceを採点する:観測、推論、未確認範囲、反証テストをレビューし、説明の流暢さだけで合格にしない
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
この記事はAIgent Lab編集部がお届けしました。