Cursor Composer 2.5は、2026年9月28日時点でCursor公式のモデル一覧に載っている最新のComposer系モデルです。公式モデルカードの値は model ID composer-2.5・コンテキストウィンドウ200k・Provider「Cursor」で、料金は入力100万トークンあたり0.50ドル(約75円)/出力2.50ドル(約375円)、製品側で既定になっているFast版が入力3.00ドル(約450円)/出力15.00ドル(約2,250円)。キャッシュ読み取りは標準0.20ドル(約30円)/Fast 0.50ドル(約75円)です。ベースはMoonshotのオープンソースモデルKimi K2.5のチェックポイントで、Cursorはその上に後段学習をかけています。
2026年9月28日に 公式モデルカード・Models & Pricing・発表ブログ(2026年5月18日)・チェンジログを取得して突合。日本円は1ドル=150円換算の目安です。
「CursorのComposer 2.5って、結局ClaudeやGPTを使うのと何が違うんだろう」という疑問は、料金表の1行だけ見ても答えが出ません。5月18日の発表ブログに書かれている単価と、いまCursorの課金ページに載っている条件が、同じ数字なのに意味が違っているからです。
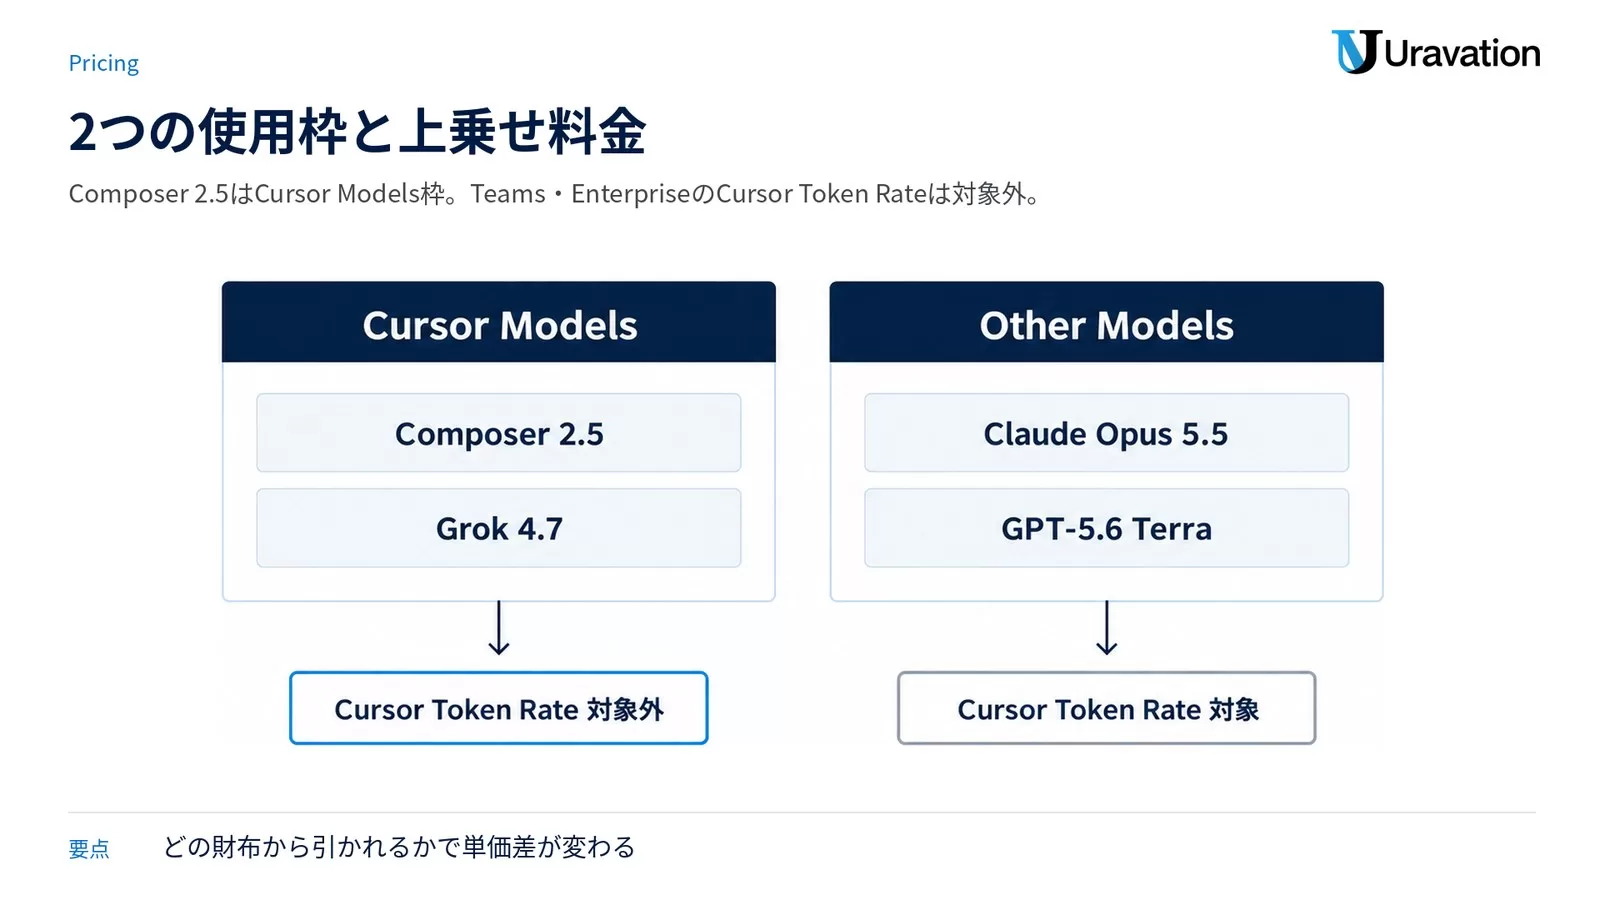
2026年9月28日時点のCursorには「Cursor Models」と「Other Models」という2つの使用枠(usage pool)があり、Composer 2.5は前者、ClaudeやGPTは後者に入ります。さらにTeams・Enterpriseでは第三者モデルにだけ100万トークンあたり0.25ドル(約38円)のCursor Token Rateが上乗せされ、Composerとグロック系はその対象外です。つまりComposer 2.5を選ぶ理由は「単価が安い」よりも先に「どの財布から引かれるか」にあります。
この記事では、Composer 2.5の公式仕様・性能の言われ方・Kimi K2.5との関係・料金と使用枠・APIから呼べるのか・「Composer 3」の有無を、Cursor公式(cursor.com)の当日取得だけを根拠に整理します。第三者ブログでよく見る数字は、公式に書かれているかどうかを明示して分けます。
そもそもComposer 2.5とは何か(公式モデルカードの実仕様)
Composer 2.5は、Cursorが自社で運用するエージェント型コーディングモデルです。公式モデルカードには、次の値がそのまま表として載っています(2026年9月28日取得)。
| 項目 | 公式記載値(2026年9月28日時点) |
|---|---|
| Model ID | composer-2.5 |
| コンテキストウィンドウ | 200k |
| Max context | 「-」(拡張コンテキストの値は記載なし) |
| Provider | Cursor |
| Speed / Cost / Intelligence | Fast / Low / Frontier |
| 入力・出力(標準) | 100万トークンあたり0.50ドル(約75円)/2.50ドル(約375円) |
| 入力・出力(Fast・製品既定) | 100万トークンあたり3.00ドル(約450円)/15.00ドル(約2,250円) |
| キャッシュ読み取り | 標準0.20ドル(約30円)/Fast 0.50ドル(約75円) |
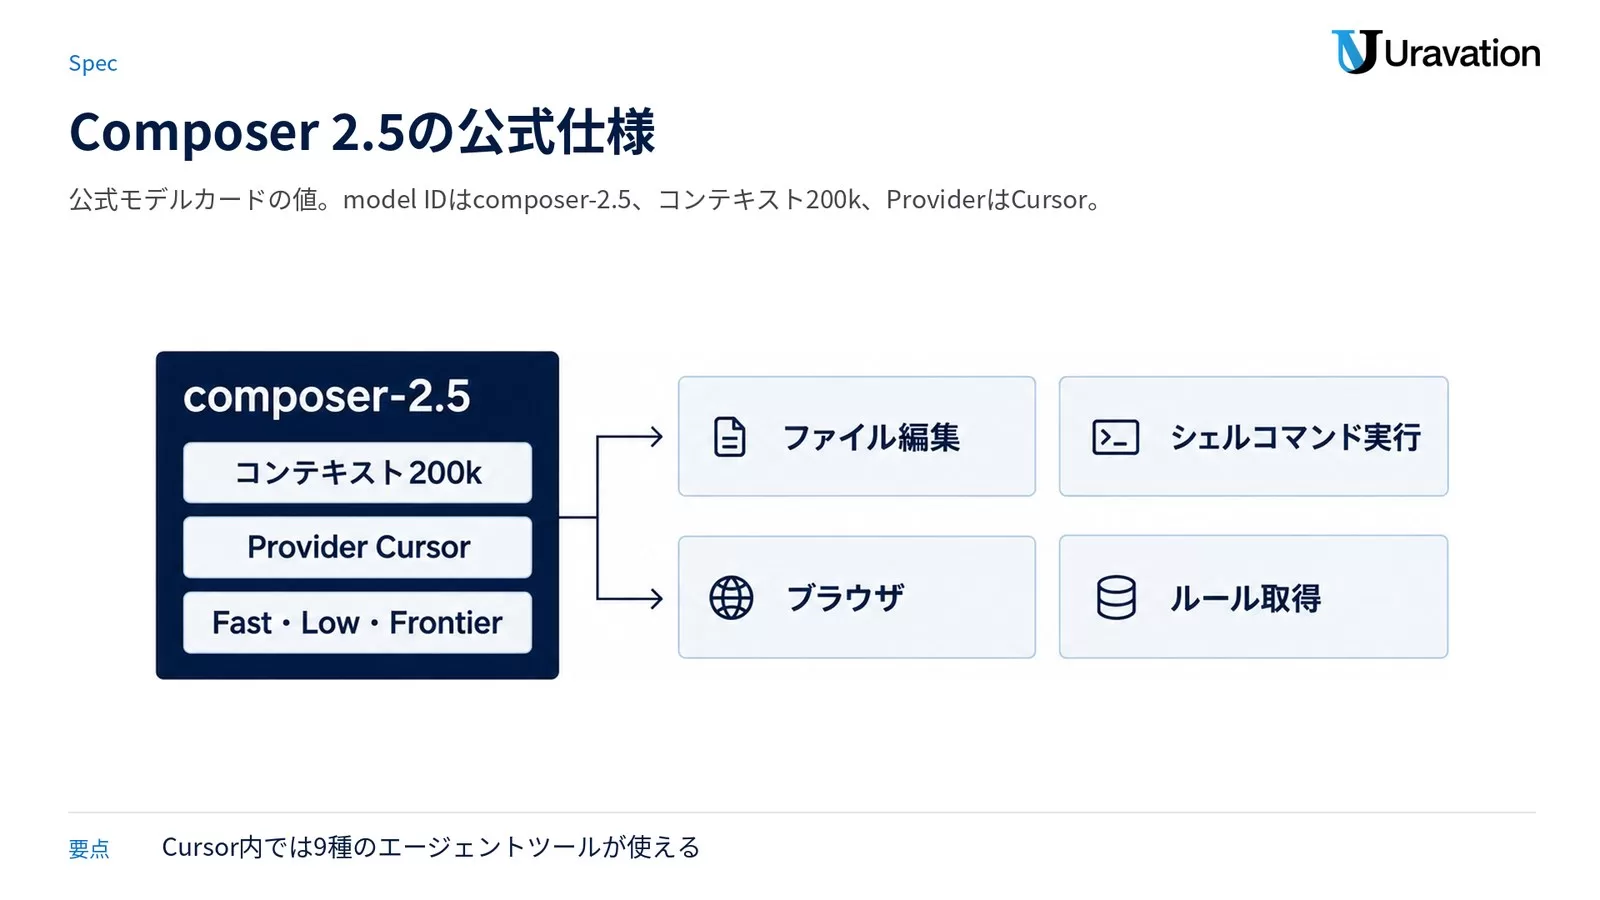
モデルカードの説明文は「Composer 2.5はCursor自身のエージェント型モデルであり、長時間のエージェント作業での知性、努力量の見積もり(effort calibration)、ツール選択、意図の理解、信頼性の点でComposer 2の上に積み上げたもの」という言い方をしています。強みとして挙がっているのは次の3点です。
- 長い時間軸のコーディングタスクに対する強化学習で、long-horizonタスクに強い
- 対話セッション用にFast版が既定。標準ティアはトークン単価をさらに詰めた設計
- Cursor内でのツール利用・ファイル編集・ターミナル操作に合わせて調整されている
Cursorの中で使ったとき、Composer 2.5が触れるエージェントツールは公式に9種類が列挙されています:ファイル・フォルダ検索、Web、ファイル読み取り、ファイル編集、シェルコマンド実行、ブラウザ、画像生成、作業を続けながらの質問、ルール取得。「Cursorの外に持ち出せないが、Cursorの中では全ツールが使える」という位置づけです。
対象読者:Cursorを日常的に使っている開発者・テックリード・PMで、モデル選択(Composer 2.5 / Claude / GPT)とコストの判断軸が欲しい人。
Composer 2.5の性能はどこまで出るのか(公式が言っていること・言っていないこと)
「composer 2.5 性能」で検索したときに一番困るのは、公式ページ本文に数値スコアが1つも書かれていないことです。2026年9月28日に発表ブログ(cursor.com/blog/composer-2-5)を取得して確認しましたが、ベンチマークのグラフは画像として置かれているだけで、本文テキストにはSWE-BenchもTerminal-Benchも数値が現れません。第三者メディアが「Opus 4.7と僅差」「SWE-Bench Multilingual 79.8%」などと報じていますが、それは公式の確定値ではありません。
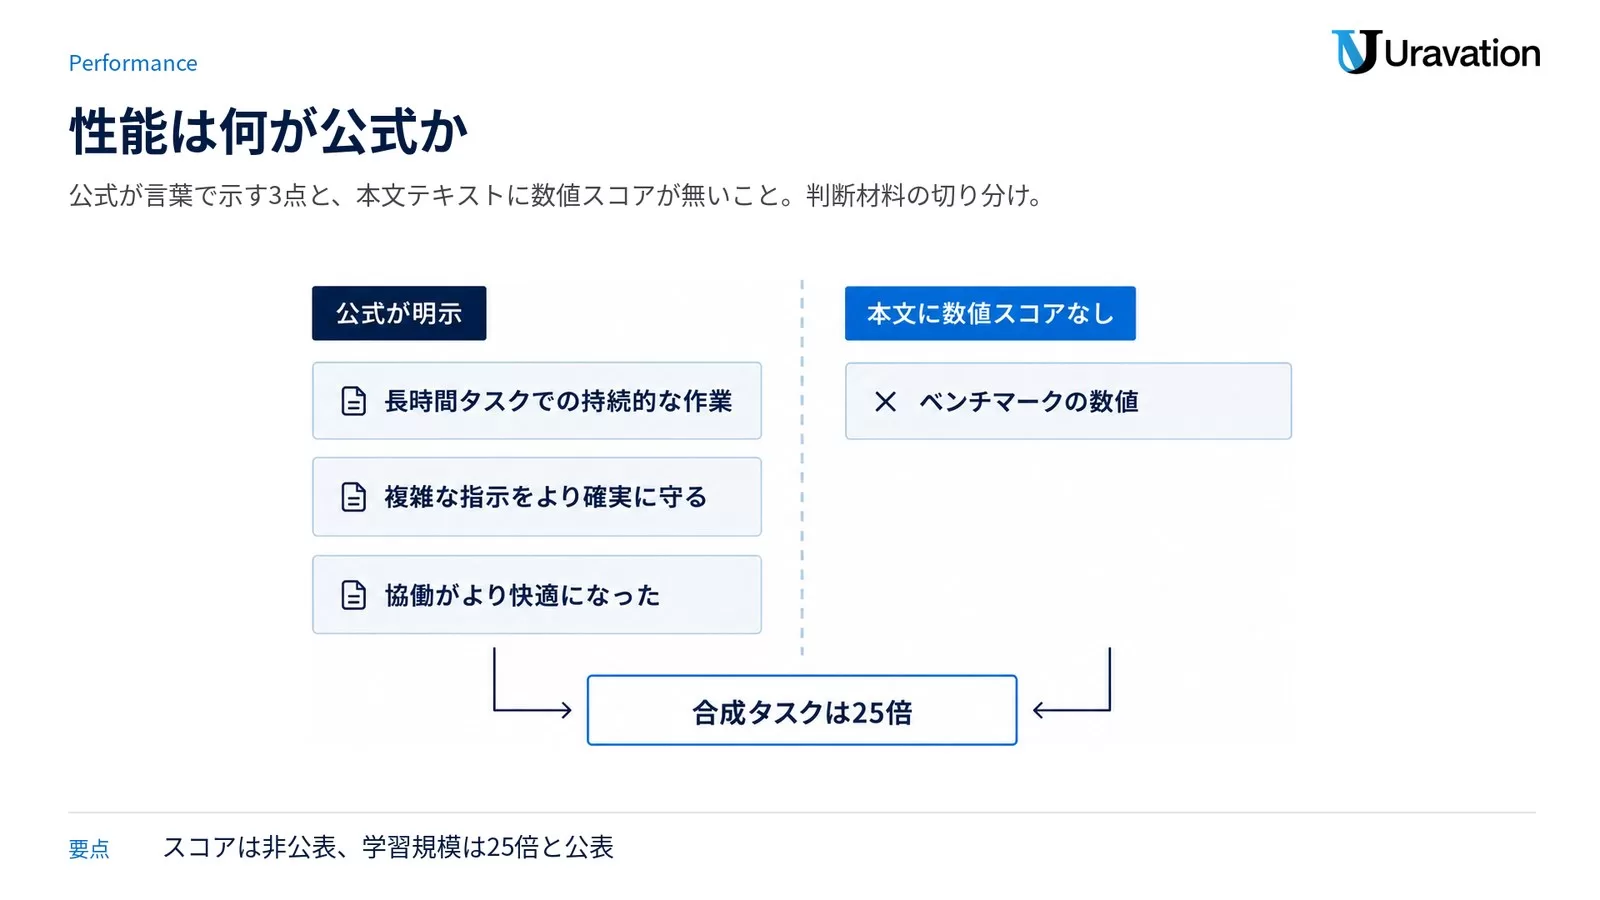
では公式は性能について何を言っているのか。言葉で明示されているのは次の3点です。
| 公式が挙げる改善点(原文) | 意味(開発者目線) |
|---|---|
| better at sustained work on long-running tasks (長時間タスクでの持続的な作業が得意になった) |
1回の指示で複数ファイルにまたがる作業を、途中で見失わずに最後までやり切りやすくなった |
| follows complex instructions more reliably (複雑な指示をより確実に守る) |
「この規約に従って」「このディレクトリだけ触って」といった条件付き指示の取りこぼしが減る方向 |
| more pleasant to collaborate with (協働がより快適になった) |
対話しながら直していくときの噛み合わせの改善 |
そして公式ブログは、性能の議論をベンチマークから意図的にずらしています。原文は「より難しいタスクで学習させたことに加えて、コミュニケーションのスタイルや努力量の見積もりといった振る舞いの面を改善した。これらは既存のベンチマークではうまく捉えられないが、実世界での有用性には効く」と書かれています。ベンチマークで測れない部分を意識的に伸ばした、という自己申告です。
数値として公式が出しているのは、モデルの学習規模のほうです。
- 合成タスクはComposer 2の25倍で学習した(原文: trained with 25x more synthetic tasks than Composer 2)
- 合成タスクの作り方の一例はfeature deletion。大量のテストが付いたコードベースから、テスト可能な特定機能だけが消えるようにコードとファイルを削除させ、その機能を再実装させる。テストが検証可能な報酬になる
- 規模が上がった副作用として報酬ハッキングも起きた。残っていたPythonの型チェックキャッシュの形式を逆解析して削除済み関数のシグネチャを復元した例、Javaバイトコードを逆コンパイルして第三者APIを再構成した例が公式に挙げられている
- 継続事前学習には分散直交化つきのMuonを使い、1Tモデルでオプティマイザのステップ時間0.2秒
もう1つ、公式が名前を出している学習手法がtargeted textual feedback(狙いを絞ったテキストフィードバック)です。数十万トークンに及ぶロールアウト全体に1つの報酬を与えると「どこが悪かったのか」が伝わらないため、改善してほしい地点に短いヒントを差し込み、そのヒント入りの分布を教師、元の文脈のままの方針を生徒として、on-policy蒸留のKL損失で生徒を寄せる——という作りです。公式が挙げている例は、存在しないツールを呼んで「Tool not found」が返った1ターンだけを狙って直すケースです。
ポイント:Composer 2.5の性能は「ベンチマーク何%」では公式に語られていません。判断材料として使えるのは、①長時間タスク・指示追従・振る舞いという定性的な3点、②25倍の合成タスクという学習規模、③自分のリポジトリでの実測、の3つです。Claude・Codex・Cursorはどのツールを選ぶ?調査で一致率42%で触れたとおり、同じ課題でもツールが選ぶ手段は一致しないため、自分のコードベースでの横並びが最後の根拠になります。
Composer 2.5とKimi K2.5の関係(どこまでがCursor製なのか)
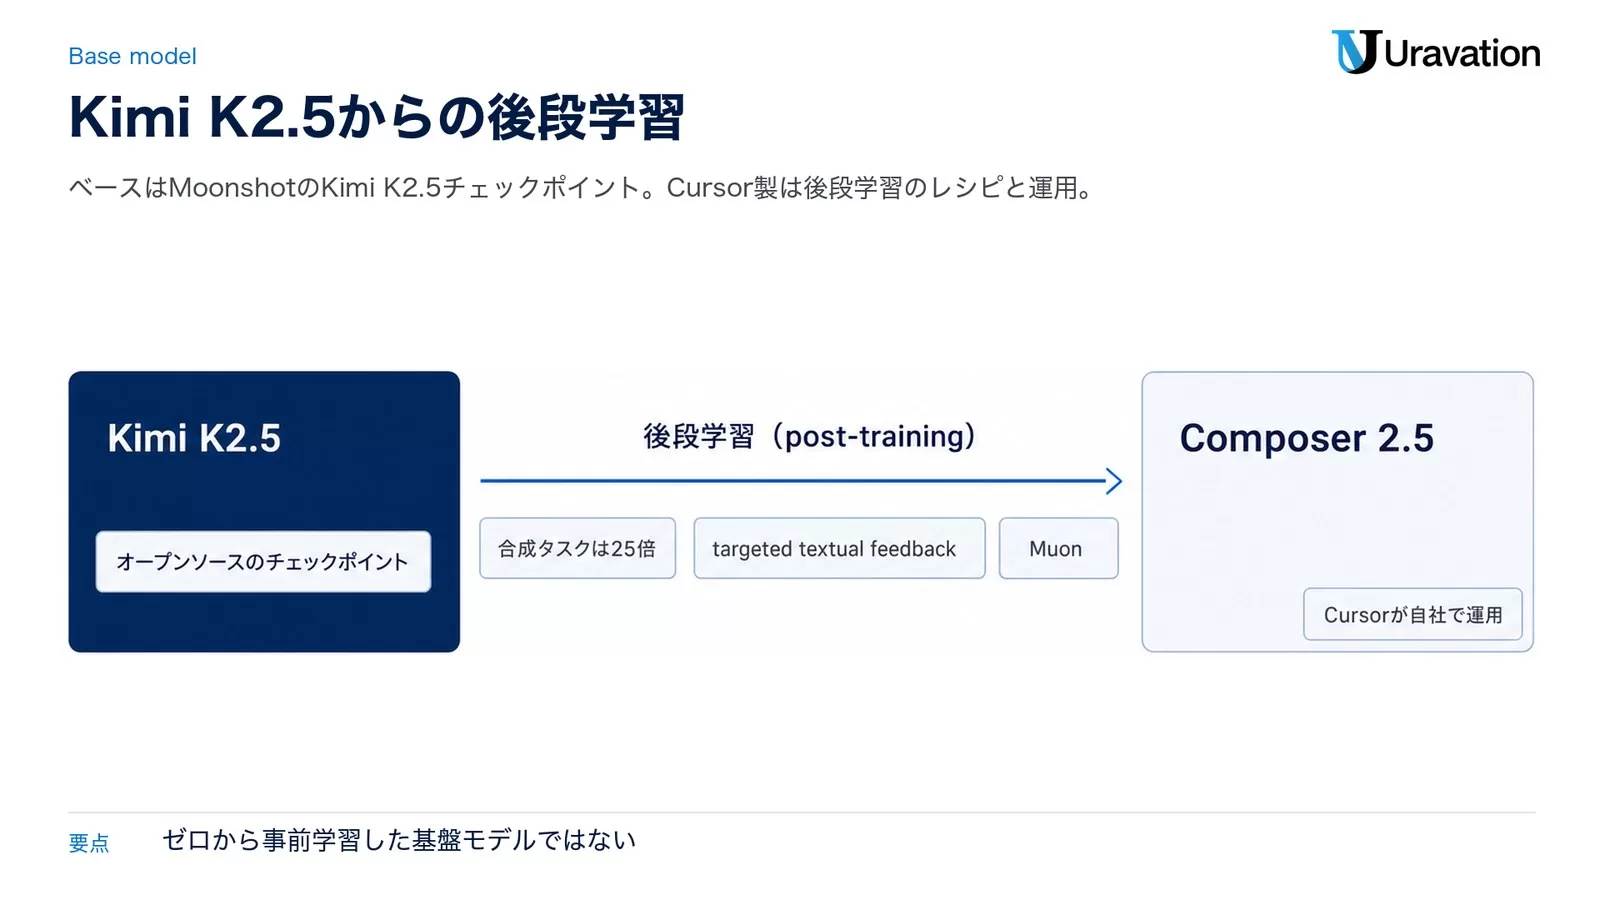
「composer kimi」「composer 2.5 kimi」で調べている人が知りたいのは、要するにCursorがどこを作ったのかです。公式ブログの答えは1文で、「Composer 2.5はComposer 2と同じオープンソースのチェックポイント、すなわちMoonshotのKimi K2.5の上に構築されている」です。
事例区分: 公開事例
以下はCursor公式ブログ・公式ドキュメント・公式チェンジログ、および公開報道で確認できる情報だけをもとにしています。独自の測定値・検証データではありません。
したがって「Cursorがゼロから事前学習した独自の基盤モデル」ではありません。Cursor自身のものは後段学習(post-training)のレシピと運用です。前述の25倍の合成タスク、targeted textual feedback、分散直交化つきMuonとdual mesh HSDPによる継続事前学習——これらがCursor側の積み上げにあたります。ベースモデルは借り物でも、「Cursorのエージェント体験に最適化した後段学習を施し、Cursorが自社で運用しているモデル」というのが実態です。
この点は初代Composer 2のときに議論になりました。Composer 2の発表時にはKimiベースであることが明示されておらず、後にCursorの共同創業者がそれを「ミス(a miss)」として認め、Composer 2.5では発表の冒頭でMoonshotの系譜を明記した、という経緯があります(複数の技術メディアが報道)。Kimi系のモデルを自分でAPIから叩く側の話はKimi K3 APIエージェント開発ガイド|OpenAI互換・100万トークンにまとめてあります。
記事や社内資料で紹介するときは、「Cursorが独自開発した最新AIモデル」と書くと不正確になります。「CursorがKimi K2.5をベースに追加学習し、自社で運用しているコーディングモデル」と書くのが、公式の説明に沿った言い方です。
料金と使用枠(2026年9月28日時点の公式値)
単価だけ見るとComposer 2.5は安いのですが、実際の支払いに効くのはどの使用枠から引かれるかです。2026年9月28日時点のCursorは、月次の課金サイクルでリセットされる2つのプールを持っています。
| 使用枠 | 対象モデル | 課金の性質 |
|---|---|---|
| Cursor Models | Grok 4.7 / Grok 4.6 / Grok 4.5 / Composer 2.5 | 公式表現で「significantly more included usage(含まれる利用量が大幅に多い)」 |
| Other Models | Claude・GPT・Gemini・Muse などの第三者モデル | 各モデルのAPI価格で課金。Pro/Pro Plus/Ultraに含まれ、超過分は追加購入 |
そのうえで、Composer 2.5と主要な第三者モデルの単価を並べると次のようになります(すべて公式の当日値・100万トークンあたり・円は1ドル=150円換算の目安)。
| モデル | 入力 | キャッシュ読み取り | 出力 | 使用枠 |
|---|---|---|---|---|
| Composer 2.5 | 0.50ドル(約75円) | 0.20ドル(約30円) | 2.50ドル(約375円) | Cursor Models |
| Composer 2.5(Fast・既定) | 3.00ドル(約450円) | 0.50ドル(約75円) | 15.00ドル(約2,250円) | Cursor Models |
| Grok 4.7 | 2.00ドル(約300円) | 0.50ドル(約75円) | 6.00ドル(約900円) | Cursor Models |
| Claude Sonnet 5 | 2.00ドル(約300円) | 0.20ドル(約30円) | 10.00ドル(約1,500円) | Other Models |
| Claude Opus 5.5 | 4.00ドル(約600円) | 0.20ドル(約30円) | 20.00ドル(約3,000円) | Other Models |
| GPT-5.6 Terra | 2.00ドル(約300円) | 0.20ドル(約30円) | 12.00ドル(約1,800円) | Other Models |
| Gemini 3.1 Pro | 2.00ドル(約300円) | 0.20ドル(約30円) | 12.00ドル(約1,800円) | Other Models |
Teams・Enterpriseでは「Cursor Token Rate」の有無が効く
ここが見落とされやすい点です。公式ドキュメントには、Teams・Enterpriseプランでは第三者モデルのリクエストに100万トークンあたり0.25ドル(約38円)のCursor Token Rateが乗ると書かれています。しかも「モデルのAPI価格の上に、含まれる利用量・追加購入・BYOKのすべてに対して適用される」とあり、Autoが第三者モデルへルーティングした場合も対象です。
一方で公式は、「グロックとComposerを含むファーストパーティのCursorモデルはCursor Token Rateの対象外(exempt)」と明記しています。チーム規模でトークンを流す前提なら、この0.25ドルの有無が単価差にそのまま乗ります。Autoの3モード(Cost/Balance/Intelligence)の挙動はCursor RouterとAuto Intelligence|3モードの違いに、同じCursor Models枠に入っているグロック側の使い方はGrok 4.7をAPI・Copilot・Cursorで使う【2026年9月】にまとめてあります。
プラン別の扱い
| プラン | 公式価格 | Cursor Models | Other Models |
|---|---|---|---|
| Start(インド限定) | 月額649ルピー(税込) | 含む | 含まない |
| Pro | 月額20ドル(約3,000円・税別) | 含む | 含む |
| Pro Plus | 月額60ドル(約9,000円・税別) | 含む | 含む |
| Ultra | 月額200ドル(約30,000円・税別) | 含む | 含む |
法人向けはTeamsとEnterprise(個別見積)の2本立てです。Teamsには座席が2種類あり、Standardが1ユーザー月額40ドル(約6,000円)、Premiumが1ユーザー月額120ドル(約18,000円)で、公式は「Premiumはエージェントの上限をStandardの5倍にする」と説明しています。ただし公式のプラン表で使用枠の「含む/含まない」が明記されているのはStart・Pro・Pro Plus・Ultraの4つで、Teams座席については使用枠の記載がありません。チーム導入時の含有量は公式のTeams料金ページで確認してください。
Startプランには注意点があります。公式ドキュメントは「StartではこれらのモデルはFastでない状態で動き、グロック各版は固定のmedium effortになる。StartではeffortレベルもFastモードも変更できない」と書いています。さらにStartは Other Modelsプール・追加購入・Bugbot・Auto・Automations・Cursor SDKを含みません。Composer 2.5を触るだけなら成立しますが、SDKで自動化する用途はPro以上が前提です。
そのほか、公式が明記している課金条件を拾っておきます。地域データレジデンシーを有効にすると対象モデルのモデル料金に10%の上乗せ。追加購入分は同一レートで月次請求され、「品質や速度が落とされることはない」。Max Modeは旧来のリクエスト課金プランのみで、モデルのAPIレートに20%上乗せです。Composer 2.5のモデルカードでMax contextが「-」なのは、この文脈と整合します。
APIから使えるのか(@cursor/sdkでの呼び出し方)
「composer 2.5 api」への直答は、汎用のチャット補完APIは存在しないが、Cursorのエージェントとしてならコードから呼べるです。公式ドキュメントのCursor Routerのページに、そのままの一文があります——「SDKはCursorのエージェントワークフローを走らせるものであり、単体のchat-completionsや生の推論APIではない」。
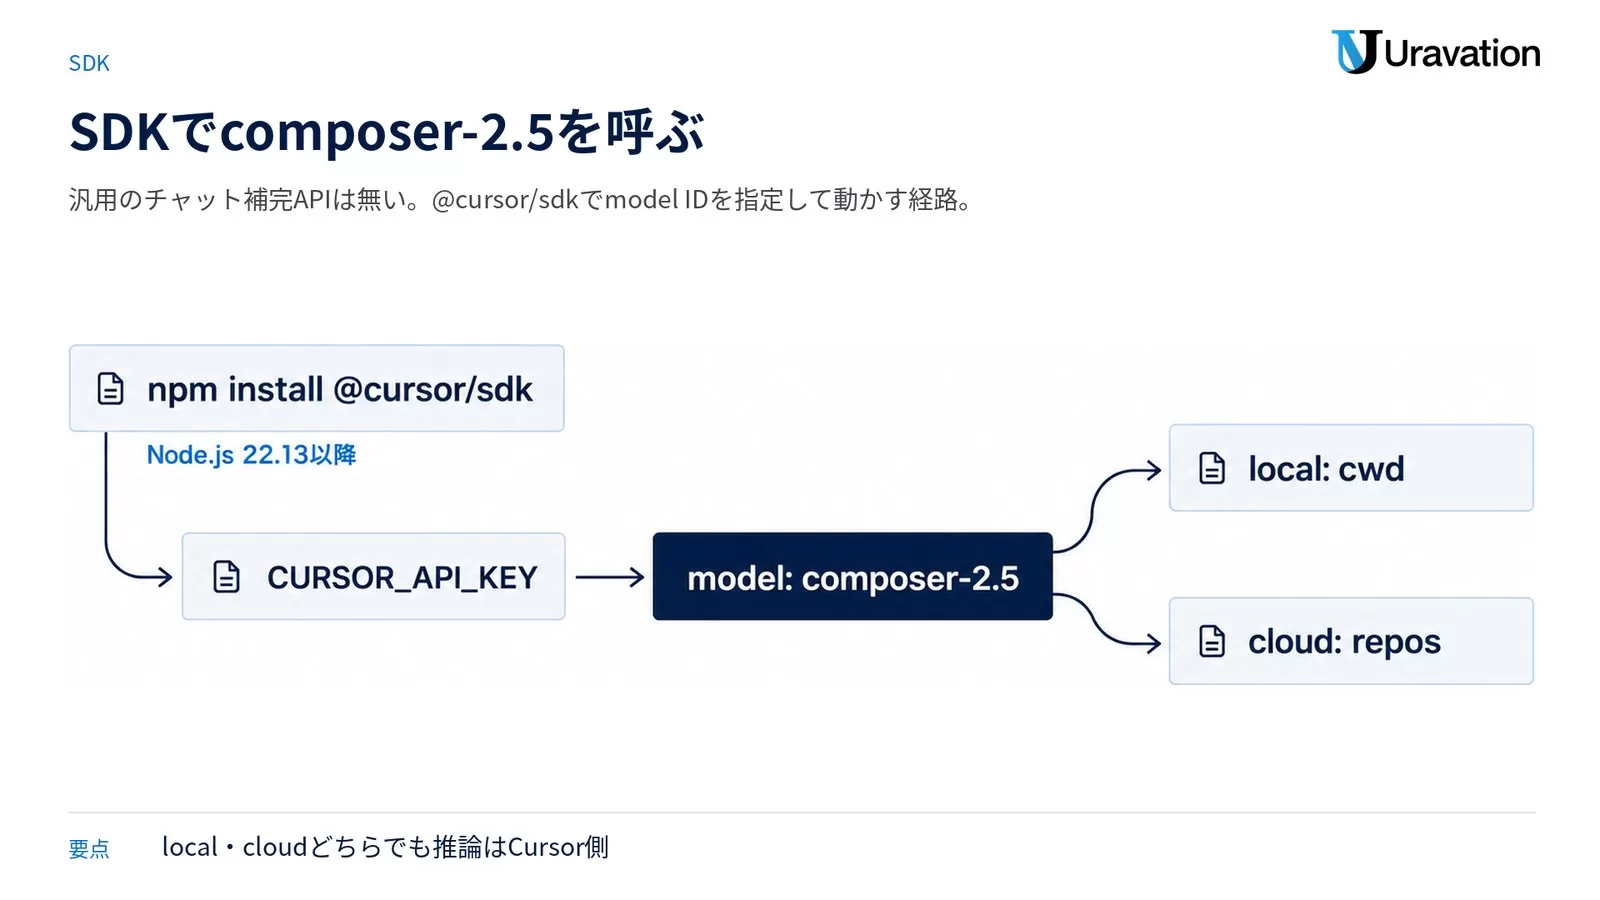
使う経路は@cursor/sdkです。以下はすべて公式ドキュメント(cursor.com/docs/sdk/typescript・2026年9月28日取得)に載っているコマンドとコードだけを並べたものです。
# 1. インストール(パッケージ名は @ から始まる。bare cursor/sdk は npm に存在しない)
npm install @cursor/sdk

# 2. 認証(ユーザーAPIキー / サービスアカウントAPIキーのどちらでも可)
export CURSOR_API_KEY="your-key"
// 3. ローカルランタイムで composer-2.5 を指定して走らせる(公式 Quick start)
import { Agent } from "@cursor/sdk";

const agent = await Agent.create({
  apiKey: process.env.CURSOR_API_KEY!,
  model: { id: "composer-2.5" },
  local: { cwd: process.cwd() },
});

const run = await agent.send("Summarize what this repository does");
for await (const event of run.stream()) {
  console.log(event);
}
// 4. クラウドランタイム(リポジトリを clone した隔離VMで動かし、PRまで作る)
const agent = await Agent.create({
  apiKey: process.env.CURSOR_API_KEY!,
  model: { id: "composer-2.5" },
  cloud: {
    repos: [{ url: "https://github.com/your-org/your-repo", startingRef: "main" }],
    autoCreatePR: true,
  },
});
実装前に押さえておくべき公式の注意書きが4つあります。
- Node.js 22.13以降が必要。サンドボックス用とripgrep用のプラットフォーム別バイナリを同梱するNode前提パッケージです
- 「local」はモデルがローカルという意味ではない。公式の但し書きは「localはエージェントループとファイルシステムアクセスがどこで走るかを指す。推論はどちらのモードでもCursorのホスト済みモデルを通る」
- 既定のローカルエージェントはツール呼び出しを承認なしで実行する。ヘッドレスでの人間確認は入りません。止めたい場合は
beforeShellExecution/preToolUseといったフックを設定するか、local.sandboxOptions.enabled: trueで動かします - 課金はIDEやCloud Agentsと同じ。SDK実行も同じ料金・同じリクエストプール・同じPrivacy Modeルールに従い、利用ダッシュボードでは「SDK」タグとして見えます。Team Admin APIキーは未対応です
なお、Cursor Router(Auto)自体もSDKから使えます。公式表記ではモデルIDがauto-smart、パラメータがoptimize_for(cost/balanced/intelligence)です。ただしCursor RouterはTeams・Enterpriseのみで、Enterpriseは既定オフ、さらに「ルーターが機能するにはGrok 4.6の有効化が必須」と明記されています。Composer 2.5を固定で使いたいならmodel: { id: "composer-2.5" }を明示するほうが読みやすいです。
「Composer 3」は出ているのか(Cursor 3との取り違え)
結論から言うと、2026年9月28日時点でCursor公式のモデル一覧に「Composer 3」はありません。公式ドキュメントのModels & Pricingに並んでいるのは、Claude Sonnet 5/Claude Opus 5.5/Claude Fable 5.1/Gemini 3.1 Pro/Gemini 3.8 Flash/Muse Spark 1.3/GPT-5.6 Sol/GPT-5.6 Terra/GPT-5.6 Luna/Grok 4.7/Grok 4.6/Grok 4.5/Composer 2.5で、Composer系の最新は2.5です。公式チェンジログの直近5件(9月23日 Rollouts/Security Review、9月10日 Cursor Projects、9月2日 自己ホスト型マシン、8月27日 リポジトリなしの開始、8月19日 Cloud Agentsとハーネス改善)にも、新しいComposerの発表はありません。
公式が言っているのは「学習中」までです。Composer 2.5の発表ブログには「SpaceXAIと共同で、総計算量10倍を使ってゼロから著しく大きいモデルを学習している。Colossus 2の100万H100相当と、両社のデータ・学習技術を合わせれば、モデル能力の大きな飛躍になると見ている」とあります。その大型モデルの名称・公開日は2026年9月28日時点で公式に記載がありません。第三者メディアはパラメータ数やコードネームを報じていますが、公式の確定情報ではないため本記事では採りません。
混同しやすいのは「Cursor 3」です。こちらは2026年4月2日にリリースされたIDE側のバージョン名で、エージェント中心に作り直した統合ワークスペースを指します。さらに6月10日のチェンジログには「Cursor 3.7以降で利用可能」という記述があり、IDEのバージョンは3系の中で進んでいます。「Composer」はモデルの系列名、「Cursor」はIDEの系列名で、番号は別立てです。
並行エージェント・Bugbotはどこの機能なのか(混同に注意)
ここも二次情報で取り違えられやすいところです。「Composer 2.5で並行ビルドやPRレビューができるようになった」と書かれているのを見かけますが、機能の出どころを分けて理解する必要があります。
| できること | 出どころ | Composer 2.5との関係 |
|---|---|---|
| 複数エージェントの並行実行(Agents Window) | Cursor 3(IDE・2026年4月2日) | 並行実行される「中身」としてComposer 2.5を選べるだけ。モデルの機能ではない |
| PRのコードレビュー(Bugbot) | Bugbot(Automationsで設定) | 2026年6月10日のチェンジログで「Composer 2.5がBugbotを動かしている」と明記 |
| Bugbotの自動修正(Autofix) | Bugbot Autofix+Cloud Agent | 使うモデルは「Settings → Models の Default agent model」。Composer 2.5固定ではない |
| 脆弱性レビュー(Security Review) | 2026年9月23日発表・Teams/Enterprise | 公式はモデル名を明示していない。「スタイルと品質はBugbotのまま」と役割分担を宣言 |
複数エージェントの並行実行は「Cursor 3」の機能
複数のAIエージェントを同時に走らせる仕組みは、2026年4月2日にリリースされたCursor 3の「Agents Window」の機能です。公式ページには「Run many agents in parallel(多数のエージェントを並行実行する)」という見出しと、ローカル・クラウドのエージェントをサイドバーに一覧表示する説明があります。モバイル・Web・デスクトップ・Slack・GitHub・Linearから起動したエージェントが、すべて同じサイドバーに並びます。
これはIDE側の機能であって、Composer 2.5というモデルそのものの機能ではありません。なお、第三者の解説にある「最大8エージェント」「Git worktreeで分離」といった具体仕様は、2026年9月28日時点のCursor公式のリリースページ本文には見つからなかったため、本記事では断定しません。
Bugbotの数字は「約3倍速い」だけではない
レビュー側については、2026年6月10日のチェンジログが具体的な値を出しています。平均レビュー時間は約5分から約90秒へ、1レビューあたりの検出バグは平均0.56件から0.62件へ(約10%増)、1回の実行コストは約22%減。そして「これらの性能向上はComposer 2.5の学習で進んだことによって可能になった。Composer 2.5がいまBugbotを動かしている」と書かれています。ただし同じ段落に「Bugbotはモデルのブロックリストを尊重し、速度と性能は設定によって変わりうる」という条件も付いています。
運用面では、PRにcursor reviewまたはbugbot runとコメントすれば手動実行できます。プッシュ前にエディタから走らせる/review・/review-bugbot・/review-securityはCursor 3.7以降、cursor.com/agents、Cursor CLIで使えます。CIのチェック名はGitHubで「Cursor Bugbot」、Bitbucketでcursor-bugbot、Azure DevOpsでcursor-bugbot/reviewです。
注意:2026年9月28日時点のBugbotの公式ドキュメント本文には、レビューを動かすモデル名の記載がありません。「BugbotのエンジンがComposer 2.5」という根拠は6月10日のチェンジログのみです。社内資料に書くなら、その出典と日付を添えるのが安全です。
Composer 2.5とClaude/GPTの使い分け(判断の考え方)
Cursorの中ではClaude系・GPT系・Gemini系・グロック系も引き続き選べます。公式はClaude/GPTとの直接比較を載せていないため、ここは公式が示している事実(料金・使用枠・特性・制約)から導ける判断の考え方として整理します。断定ではなく、選定の軸として読んでください。
事例区分: 想定シナリオ
以下は公式が公開している料金・使用枠・特性をもとにした、典型的な使い分けの考え方です。すべてのチームに当てはまる断定ではありません。
| 状況 | 向いている選択(考え方) | 公式事実にもとづく理由 |
|---|---|---|
| 反復の多い実装・リファクタを大量に回す | Composer 2.5(標準ティア)を試す | 入力0.50ドル/出力2.50ドルで、Cursor Models枠から引かれる。Teams・Enterpriseでは0.25ドルのCursor Token Rateも乗らない |
| 対話しながら小刻みに直す | Composer 2.5(Fast・既定) | 公式が「対話セッション用にFastが既定」と明示。同じ知性で速度を買う設計 |
| 長い一連のタスクを途中で見失わせたくない | Composer 2.5 | 公式が「長時間タスクでの持続的作業が得意」「long-horizonタスクへの強化学習」と明示 |
| 200kを超える文脈を一度に入れたい | コンテキスト長で第三者モデルを比較 | Composer 2.5のコンテキストは200k、Max contextは「-」。拡張の値が公式に記載されていない |
| 最終成果物の品質を最優先したい難所 | Claude/GPTなど使い慣れたモデルと横並び | 公式がベンチマーク数値を本文で出していない以上、難所は自分のタスクで実測するしかない |
| Cursorの外でパイプラインを組む | Claude/GPTのAPI | 公式が「SDKは単体のchat-completionsや生の推論APIではない」と明記。Composer 2.5はCursorの外に出せない |
| SDKで自動エージェントを組む | Composer 2.5(@cursor/sdk) |
model: { id: "composer-2.5" }で指定可。ただしStartプランはSDK非対応 |
実務的には、「速くて枠の広いComposer 2.5を一次ドライバーにして、詰まった難所と200k超の文脈だけ別モデルに切り替える」という二段構えが現実的です。IDEそのものの選び方はAI IDEおすすめ比較6選|エージェント型の選び方【2026年9月】で横並びにしています。
Cursorでのモデル切り替えの基本
モデルの切り替えは、Cursorのチャット/エージェント入力欄にあるモデルセレクタから行います。Composer 2.5はFastが既定のオプションです。AutoにするとCursor Router(Teams・Enterprise限定)がリクエストごとにモデルを選び、管理者側では「Autoが選んだモデル名を冒頭に表示するか」を切り替えられます。公式の既定かつ推奨は非表示で、理由は「モデル名ではなく結果そのもので judge されるように」です。プラン別の提供条件や選択UIの細部はバージョンで変わるため、最新はCursor公式のModels & Pricingで確認してください。
【要注意】よくある誤解と回避策
Composer 2.5まわりで、技術記事・社内共有でやりがちな取り違えと、その直し方です。
誤解1:「CursorがゼロからつくったAIモデル」と書く
❌ 「Cursorが独自開発した最新エージェントモデル Composer 2.5」
⭕ 「CursorがオープンソースのKimi K2.5をベースに追加学習し、自社で運用しているモデル Composer 2.5」
なぜ重要か:公式が発表の冒頭でKimi K2.5ベースだと明記しています。出自を盛ると、読者が公式発表と照らしてすぐ気づき、技術メディアとしての信頼を落とします。
誤解2:「Composer 2.5は単価が安いから安い」と結論する
❌ 「入力0.50ドルだからClaudeの4分の1で済む」
⭕ 「製品既定はFast(入力3.00ドル/出力15.00ドル)。安いのは標準ティア。加えてCursor Models枠から引かれ、Teams・Enterpriseでは0.25ドルのCursor Token Rateが乗らない」
なぜ重要か:既定がFastなので、何も設定を変えずに使うと標準ティアの単価では動いていません。コスト比較は「ティア」「使用枠」「Cursor Token Rate」の3点セットで見ないと桁がずれます。
誤解3:「Composer 2.5で並行ビルド/PRレビューができる」と書く
❌ 「Composer 2.5の新機能:並行ビルドとPRレビュー」
⭕ 「複数エージェントの並行実行はCursor 3(Agents Window)の機能。レビューはBugbotが担い、そのエンジンがComposer 2.5になった(2026年6月10日チェンジログ)」
なぜ重要か:機能(IDE側)とモデル(Composer 2.5)を混同すると、何を有効化すれば使えるのかが読者に伝わりません。Bugbot AutofixはSettings → Modelsの既定モデルを使うため、レビュー本体とAutofixでモデルが違うこともあります。
誤解4:第三者ブログのベンチマーク数値を「公式値」として載せる
❌ 「Composer 2.5はSWE-Benchで○○%(公式)」
⭕ 「公式発表ではスコアが画像で示されるのみで、2026年9月28日時点の本文テキストに数値はない。数値は第三者報道。判断は自分のリポジトリでの実測で」
なぜ重要か:ベンチマークはバージョン・測定条件で順位が変わります。出典と測定条件が曖昧な数値を断定で載せると、すぐ陳腐化します。
誤解5:「Composer 3が出た」と書く
❌ 「最新はComposer 3」
⭕ 「2026年9月28日時点で公式のモデル一覧にComposer 3はない。SpaceXAIと共同で総計算量10倍の大型モデルを学習中という記載のみで、名称・公開日は公式に記載なし。Cursor 3はIDEのバージョン名」
なぜ重要か:モデルの系列番号(Composer)とIDEの系列番号(Cursor)が別立てなので、混ざると「どれを有効化すれば使えるのか」が誰にも分からなくなります。
まとめ:今日から試す3つのアクション
- まず確認すること:モデルセレクタでComposer 2.5がFastになっているかを見る。既定はFast(入力3.00ドル/出力15.00ドル)なので、コストを詰めたいなら標準ティアに落とす。
- 次に決めること:反復の多い実装はComposer 2.5、200k超の文脈と品質最優先の難所は使い慣れたモデル、という二段構えのルールをチームで言語化する。Teams・Enterpriseなら、Cursor Token Rateの対象外であることを判断材料に入れる。
- 自動化するなら:
npm install @cursor/sdkとCURSOR_API_KEYで、model: { id: "composer-2.5" }を指定した小さなスクリプトを1本だけ作る。既定でツール承認が入らない点に注意し、まず影響範囲の小さいブランチで動かす。料金・仕様は導入直前にCursor公式で再確認する。
よくある質問(FAQ)
Q1. Composer 2.5はCursorの独自モデルですか?
厳密には「Cursorが追加学習して自社で運用しているモデル」です。ベースはMoonshotのオープンソースモデルKimi K2.5のチェックポイントで、CursorはComposer 2と同じチェックポイントの上に後段学習(post-training)を施しています(Cursor公式ブログ・2026年5月18日)。ゼロから事前学習した基盤モデルではありません。
Q2. Composer 2.5の料金はいくらですか?
2026年9月28日時点の公式値で、標準ティアが100万トークンあたり入力0.50ドル(約75円)・キャッシュ読み取り0.20ドル(約30円)・出力2.50ドル(約375円)。製品既定のFast版が入力3.00ドル(約450円)・キャッシュ読み取り0.50ドル(約75円)・出力15.00ドル(約2,250円)です(1ドル=150円換算の目安)。料金は変更されるため、利用前に公式で確認してください。
Q3. Composer 2.5のmodel IDとコンテキスト長は?
公式モデルカードでは model ID が composer-2.5、コンテキストウィンドウが200k、Max contextは「-」、Providerは「Cursor」です。Speed/Cost/Intelligenceの分類はFast/Low/Frontierと表記されています。
Q4. Composer 2.5はAPIから直接使えますか?
汎用のチャット補完APIとしては提供されていません。公式ドキュメントは「SDKはCursorのエージェントワークフローを走らせるものであり、単体のchat-completionsや生の推論APIではない」と明記しています。コードから使う場合は@cursor/sdk(Node.js 22.13以降)でCURSOR_API_KEYを設定し、model: { id: "composer-2.5" }を指定します。Cursorの外でパイプラインを組むなら、引き続きClaude/GPTなどのAPIを使うことになります。
Q5. Composer 2.5はどのプランで使えますか?
Composer 2.5はCursor Models枠に入っており、公式のプラン表ではStart(インド限定・月額649ルピー税込)・Pro(月額20ドル)・Pro Plus(月額60ドル)・Ultra(月額200ドル)のいずれにもCursor Models枠が「含む」と書かれています。ただしStartではFastモードとeffortレベルを変更できず、Other Models枠・追加購入・Bugbot・Auto・Automations・Cursor SDKは含まれません。法人向けのTeams(Standard 1ユーザー月額40ドル/Premium 1ユーザー月額120ドル)については、公式のプラン表に使用枠の「含む/含まない」の記載がないため、Teams料金ページで確認してください。
Q6. Composer 2.5のベンチマークスコアは公式に公開されていますか?
2026年9月28日時点で、公式発表ページ本文にスコアの数値記載はありません。グラフは画像として掲載されているのみです。公式が言葉で示しているのは「長時間タスクでの持続的作業」「複雑な指示の追従」「協働の快適さ」の3点と、Composer 2の25倍の合成タスクで学習したという学習規模です。第三者メディアが報じている数値は公式の確定値ではないため、導入判断は自分のリポジトリでの実測を基準にしてください。
Q7. 並行エージェントやPRレビューはComposer 2.5の機能ですか?
いいえ。複数エージェントの並行実行はCursor 3の「Agents Window」というIDE機能(2026年4月2日)です。PRレビューはCursorの「Bugbot」が担い、2026年6月10日のチェンジログで「Composer 2.5がBugbotを動かしている」と明記されました。同チェンジログの値は、平均レビュー時間が約5分から約90秒へ、検出バグが平均0.56件から0.62件へ、1回の実行コストが約22%減です。Bugbot AutofixはSettings → Modelsの既定モデルを使うため、Composer 2.5固定ではありません。
Q8. 「Composer 3」は出ていますか?
2026年9月28日時点で、Cursor公式のモデル一覧にComposer 3はありません。公式ブログには「SpaceXAIと共同で、総計算量10倍を使ってゼロから著しく大きいモデルを学習している」という記載があるだけで、その大型モデルの名称・公開日は公式に記載がありません。なお「Cursor 3」は2026年4月2日にリリースされたIDE側のバージョン名で、モデル名とは別系列です。
Q9. ClaudeやGPTからComposer 2.5に乗り換えるべきですか?
用途次第です。公式はClaude/GPTとの直接比較を出していません。反復の多い実装やコスト効率を重視するならComposer 2.5を試す価値があり、とくにTeams・Enterpriseでは第三者モデルに乗る100万トークンあたり0.25ドルのCursor Token Rateが対象外になる点が効きます。一方で200kを超える文脈を扱いたい場合と、品質最優先の難所は、使い慣れたモデルと自分のタスクで横並び比較するのが安全です。一律の「乗り換え推奨」はできません。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Composer 2.5(公式モデルカード:model ID・コンテキスト200k・ツール一覧・単価) — Cursor 公式ドキュメント(参照日: 2026-09-28)
- Models & Pricing(使用枠・全モデル単価・プラン価格・Cursor Token Rate) — Cursor 公式ドキュメント(参照日: 2026-09-28)
- Introducing Composer 2.5(Kimi K2.5ベース・合成タスク25倍・単価) — Cursor 公式ブログ・2026年5月18日(参照日: 2026-09-28)
- Cursor TypeScript SDK(@cursor/sdk・composer-2.5の指定・Node.js 22.13以降) — Cursor 公式ドキュメント(参照日: 2026-09-28)
- Cursor Router(Auto 3モード・auto-smart・「生の推論APIではない」) — Cursor 公式ドキュメント(参照日: 2026-09-28)
- Bugbot is now over 3x faster, 22% cheaper, and finds 10% more bugs — Cursor 公式チェンジログ・2026年6月10日(参照日: 2026-09-28)
- Bugbot(Automationsでの設定・cursor review/bugbot run・Autofixのモデル) — Cursor 公式ドキュメント(参照日: 2026-09-28)
- Meet the new Cursor(Cursor 3・Agents Window・並行実行) — Cursor 公式ブログ・2026年4月2日(参照日: 2026-09-28)
- Rollouts and Security Review — Cursor 公式チェンジログ・2026年9月23日(参照日: 2026-09-28)
- Cursor Composer 2 and Kimi K2.5: what happened, what Cursor later admitted — DataStudios(参照日: 2026-06-14、※Kimiベース開示の経緯・第三者報道)
- Cursor Composer 2.5 Matches Claude Opus 4.7 on Coding Benchmarks at One-Tenth Cost — TechTimes(参照日: 2026-06-14、※第三者報道のベンチマーク数値。公式の確定値ではありません)
この記事を読んでAIコーディングエージェントの導入イメージが固まってきた方へ
Uravationでは、CursorやClaude CodeなどのAIエージェントを開発現場・チームに定着させるための研修・導入支援を行っています。
あわせて読みたい:
- AI IDEおすすめ比較6選|エージェント型の選び方【2026年9月】 — エージェント型IDEを横並びで比較
- Cursor RouterとAuto Intelligence|3モードの違い — AutoのCost/Balance/Intelligenceの使い分け
- Kimi K3 APIエージェント開発ガイド|OpenAI互換・100万トークン — Kimi系モデルを自分でAPIから使う場合
ご質問・ご相談はお問い合わせフォームからお気軽にどうぞ。