「Engineer says Claude Code has made his job "soul-sucking"」は、Claude Codeがエンジニアの仕事を一律に空虚にするというニュースなのでしょうか。
いいえ。2026年10月7日時点で確認できるのは、匿名の開発者が「生成物を確認する時間がないまま出荷量を求められる職場運用」を問題視したという報道です。Claude Code単体が長時間労働や仕事の意味の喪失を引き起こすと証明した調査ではありません。
ただし、単なる個人の愚痴として片づけるべきでもありません。Anthropicの公式調査にも、AIで成果を増やせるという評価と、技能、仕事の楽しさ、同僚との協働が弱まる懸念が同時に記録されています。日本企業が読むべきポイントは、「AIを使うか、使わないか」ではなく、生成速度が上がったときに誰が考え、読み、止め、責任を負うのかです。
- 公開されたもの:一社・一個人の匿名証言を扱った2026年9月22日のTechSpot記事
- 実務上の警告:実装速度だけを上げると、レビュー能力、理解可能性、技能形成が新しい制約になる
- 企業が始めること:対象業務、合否証拠、権限境界、人への影響を先に決め、小さな検証単位で広げる
公開されたのは「製品評価」ではなく、ひとつの職場経験
TechSpotが報じた内容
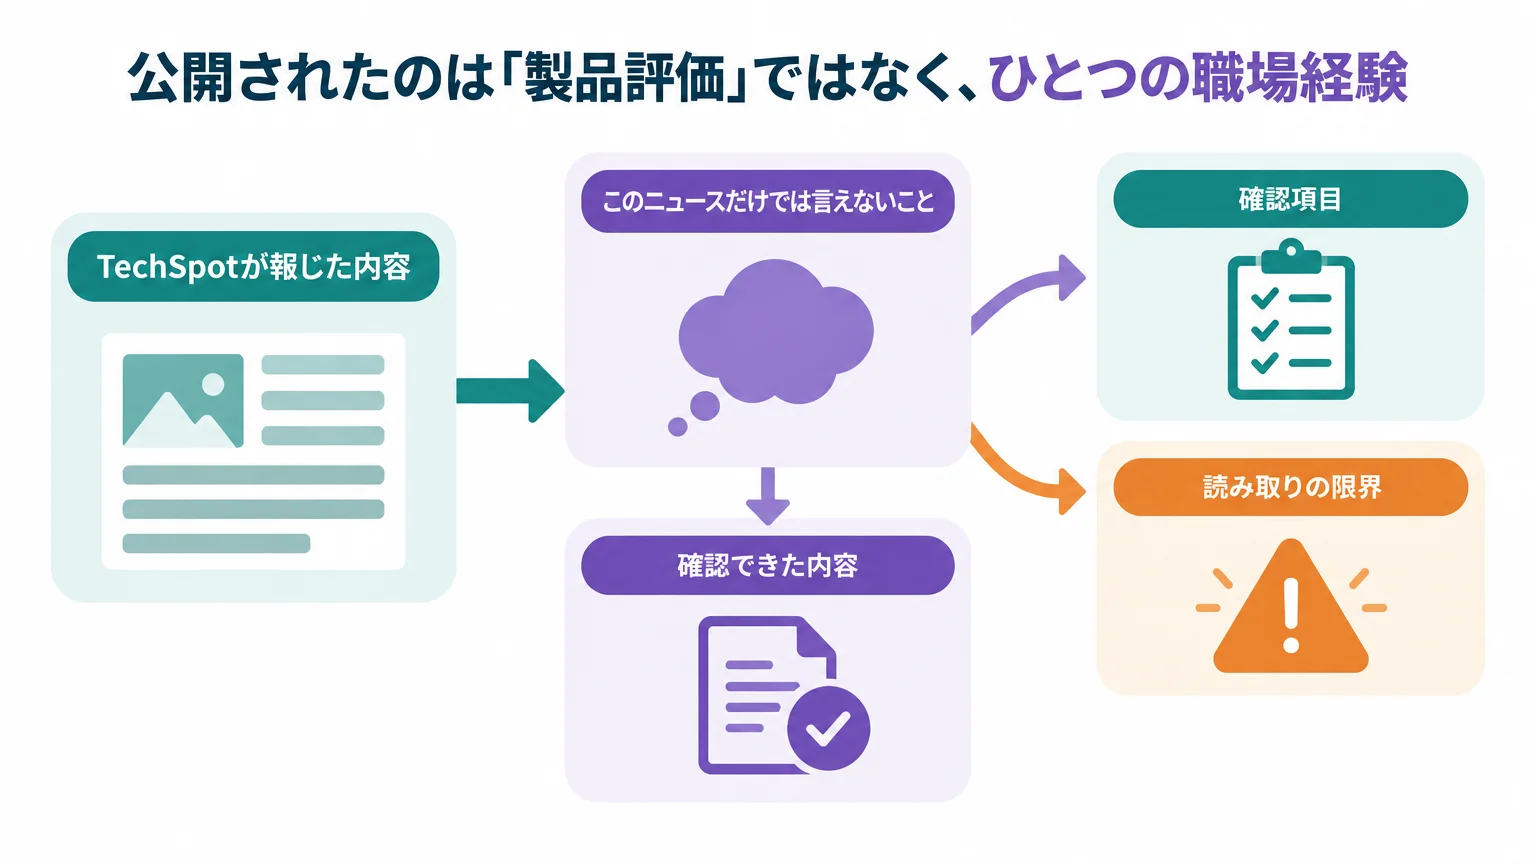
TechSpotの2026年9月22日付記事は、X上の匿名アカウント「v0xium」による投稿を紹介しました。投稿者は実名と勤務先を明かしていません。TechSpotによれば、投稿者は新しい職場で、仕様、コード、テスト、チケット、レポートまでClaude Codeが生成し、人は出荷を急かされていると訴えました。
見出しになった「soul-sucking」は、仕事から達成感や目的が失われたという本人の評価です。勤務状況については、1日に12〜13時間、Enterを押すような仕事になったという強い表現も使われています。しかし、勤怠記録、生成コードの品質、障害件数、会社の正式見解は公開されていません。ここは事実と証言を分ける必要があります。
重要なのは、投稿者がLLMによるコード生成そのものを全面否定していない点です。2026年9月20日の元投稿では、コードを確認し、どこへ入り、何をしているかを理解する時間があれば構わないという趣旨を明記しています。中心にある不満は、生成ツールの存在よりも、レビューと理解を省いて「とにかく出す」ことを求める運用です。

| 確認項目 | 確認できた内容 | 読み取りの限界 |
|---|---|---|
| 公開日 | 元投稿は2026年9月20日、TechSpot記事は2026年9月22日 | TechSpot表示時刻のタイムゾーンは明記されていない |
| 発言者 | v0xiumを名乗る匿名アカウント | 実名、企業名、雇用関係は公開されていない |
| 訴えの中核 | 生成量を優先し、レビューと理解の時間が足りない | 一社・一個人の自己申告であり、業界統計ではない |
| ツールへの立場 | LLM利用自体を拒否せず、確認時間を求めている | 利用設定、権限、対象リポジトリは不明 |
このニュースだけでは言えないこと
「Claude Codeを導入すると12〜13時間労働になる」「AI生成コードは一律に品質が下がる」「エンジニア全体が考えなくなった」とは言えません。投稿者の表現を、製品全体の因果関係や平均値へ広げる根拠がないからです。
逆方向の断定も危険です。「生成量が増えたのだから生産性は上がった」「コードを書かなくてよいのだから仕事は楽になった」とも限りません。出荷件数が増えても、利用者価値、保守性、障害、手戻り、レビュー負荷が悪化すれば、組織としての成果は上がっていない可能性があります。

| 書けること | 書けないこと |
|---|---|
| 匿名の開発者が、レビュー時間不足と出荷圧力を訴えた | Claude Codeが長時間労働を引き起こした |
| 仕事の意味や達成感を失ったと本人が述べた | 利用者全体の仕事満足度が低下した |
| 仕様から報告まで広く生成していると本人が主張した | 勤務先の全社員が同じ方法で働いている |
| 生成物を読む時間がほしいと本人が留保した | ツールを使わないことが解決策である |
「Claude Codeが悪い」で終えると、運用上の原因を見失う
ボトルネックが実装から検証へ移った
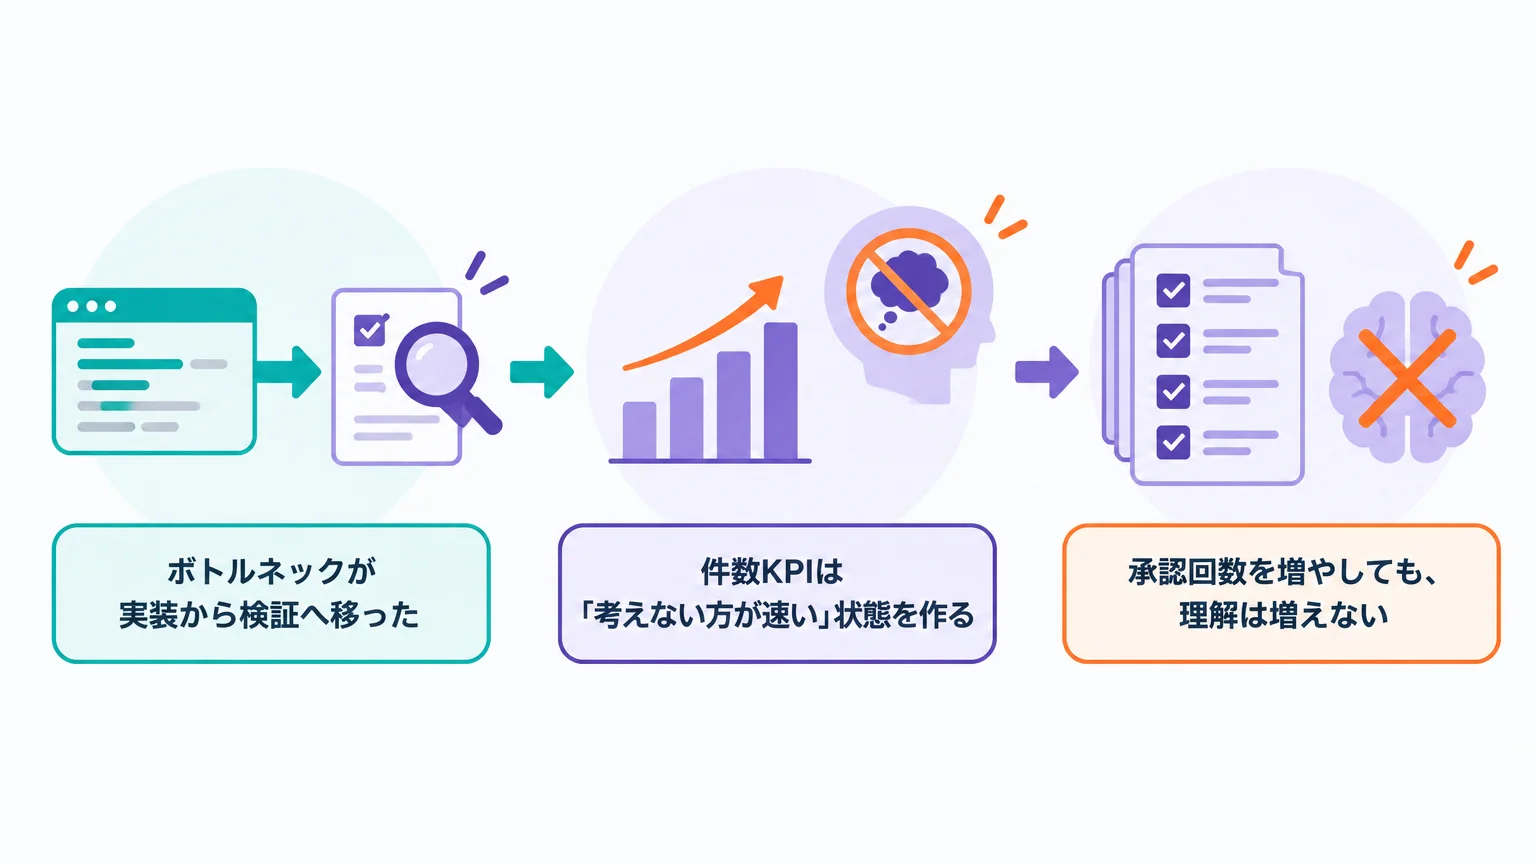
AIがコード、テスト、文書を速く生成すると、開発工程の制約は消えるのではなく移動します。次に詰まりやすいのは、要件の妥当性、差分の理解、テストの意味、設計整合性、リリース判断です。生成できる量だけを増やし、レビュー担当者と検証時間を据え置けば、未読の差分が積み上がります。
これは「人間がすべて手で書くべきだ」という話ではありません。人が読む必要のある情報量と、読める時間の差を管理する話です。AI支援の速度を評価する際は、AIコーディングツールの生産性研究を整理した記事でも扱っているように、実装時間だけでなく、レビューや手戻りまで含めて観察する必要があります。
件数KPIは「考えない方が速い」状態を作る
PR数、コミット数、生成行数、リリース機能数は数えやすい指標です。しかし、これらだけを目標にすると、問題を小さく解くより変更を増やす方が高く評価されます。投稿者が訴えたのも、顧客にとっての改善より、スプリントや出荷量が優先される状況でした。
AIエージェント導入後は、作る量の指標を捨てるのではなく、結果の指標と対にします。受け入れ条件を満たしたか、レビューで重大な見落としがなかったか、障害やロールバックを増やしていないか、不要な機能を作っていないかまで見て、はじめて「速くなった」と判断できます。
承認回数を増やしても、理解は増えない
「危険なら毎回人にEnterを押させればよい」という設計にも限界があります。AnthropicはClaude Codeのauto modeに関する2026年3月25日の公式記事で、利用者が許可プロンプトの93%を承認していたと報告し、反復的な承認が注意力を落とす「承認疲れ」を問題として扱っています。この数値はAnthropicの製品データであり、すべての企業に同じ比率が当てはまるという意味ではありません。
承認は、内容を理解して判断した場合にだけ統制として機能します。何百回も同じボタンを押す工程は、人を責任者に見せながら、実際には検証能力を発揮させない恐れがあります。高頻度で安全な操作は技術的な境界内で自動化し、不可逆な操作や外部影響のある操作に、人の注意を集中させる方が合理的です。
Anthropicの公式調査は、利益と懸念の両方を示している
社内調査でも「楽しさ」と「技能」の変化が出た
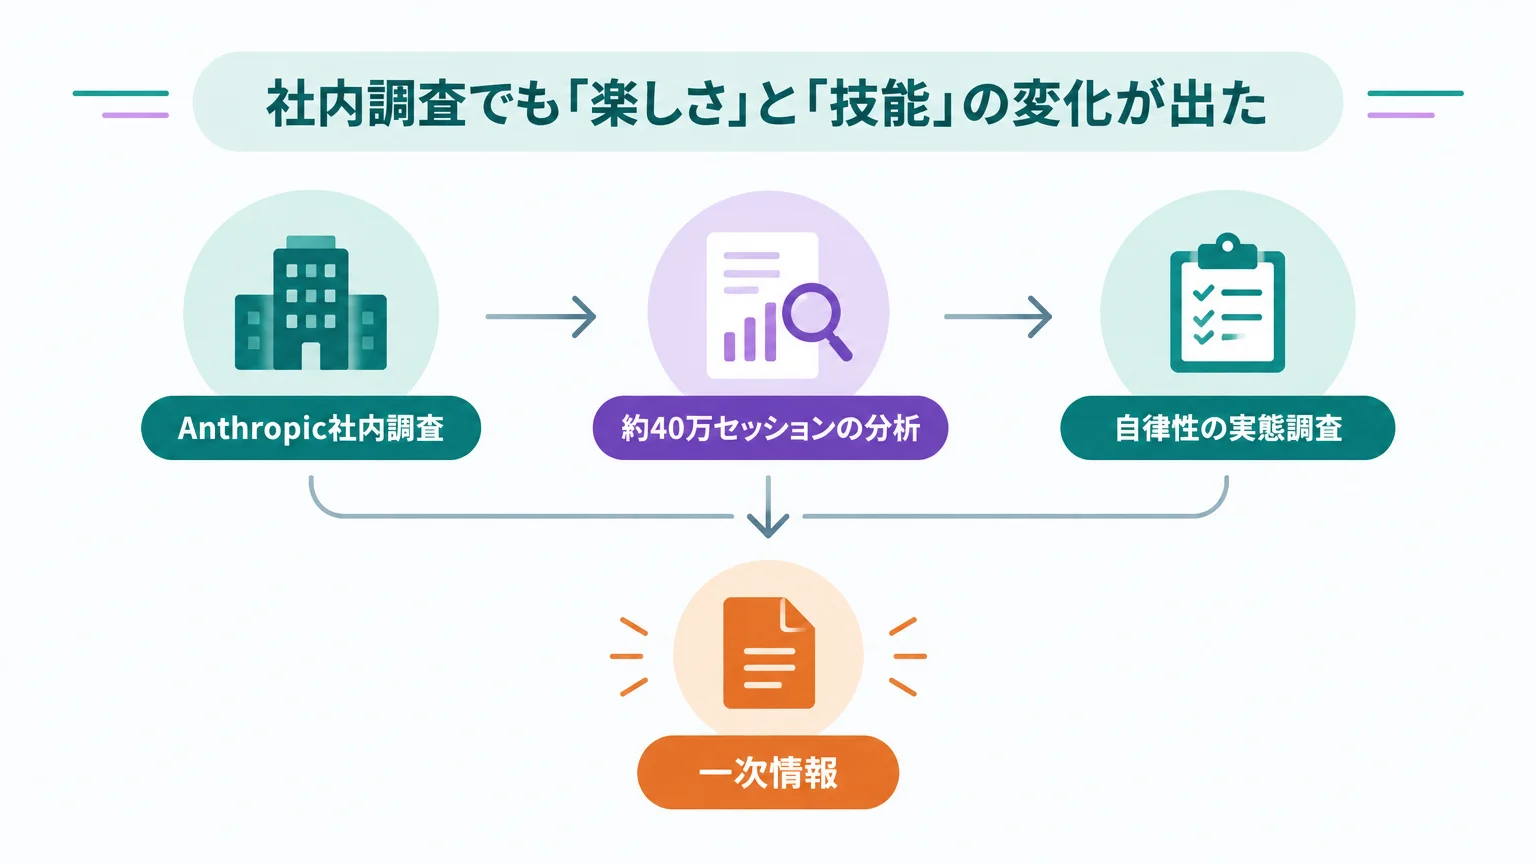
AnthropicはHow AI is transforming work at Anthropicを2025年12月2日に公開しました。2025年8月にエンジニアと研究者132人へ調査し、53人へ定性インタビューを行い、Claude Codeの社内利用データも分析したものです。
調査では、成果量や扱える仕事の幅が増えたという肯定的な声の一方で、手作業のデバッグで得ていた偶発的な学習、コードを書く没頭感、同僚へ相談する機会が減るのではないかという懸念も記録されています。つまり、「便利になった」と「仕事の意味が変わった」は両立します。片方だけを見ても実態を捉えられません。
ただし、この調査はAnthropic社員という特殊な集団を対象にし、回答は匿名ではなく、自己申告も含みます。公式ページ自身が選択バイアスや社会的望ましさの影響を限界として挙げています。TechSpotの匿名証言を証明する資料ではなく、似た論点が製品提供企業の内部調査にも現れた、と位置づけるのが適切です。
約40万セッションの分析では、専門性が成果と結びついた
2026年6月16日公開のAgentic coding and persistent returns to expertiseは、2025年10月から2026年4月までの約40万件の対話型Claude Codeセッション、約23万5,000人を分析しています。典型的なセッションでは、人が「何をするか」という計画判断を多く担い、Claudeが「どう実行するか」という実装判断を多く担う分業が観察されました。
同研究では、対象領域への専門性が高い利用者ほど、セッションを成功へ導き、エラーや誤解から回復しやすい傾向も示されています。実装をAIへ任せるほど人の知識が不要になる、という結論ではありません。むしろ、目的を定義し、出力の異常に気づき、修正方向を選ぶために専門性が効いています。
ここにも限界があります。成功はテスト通過、コミット、利用者の肯定など、セッション内で観察できる代理指標です。そのコードが本番で価値を生んだかまでは測っていません。企業側は公式研究の「成功」を、そのまま事業成果と読み替えないよう注意してください。
自律性が上がるほど、監督は「都度承認」から「観察と介入」へ変わる
AnthropicのMeasuring AI agent autonomy in practiceは2026年2月18日、Claude Codeと公開APIにおける数百万件の人間とエージェントのやり取りを分析したと発表しました。経験を積んだ利用者ほどfull auto-approveを使う割合が上がる一方、実行中に介入する割合も上がったとしています。
これは、ボタンを押す回数を監督の強さと見なせないことを示します。必要なのは、エージェントが何をしているかを追える可視性、異常時に止められる仕組み、実行後に結果を検証できる証拠です。Anthropicも、効果的な監督には新しいモニタリング基盤と、人とAIが自律性とリスクを共同管理する方法が必要だと結論づけています。

| 一次情報 | 示されたこと | 一般化するときの注意 |
|---|---|---|
| Anthropic社内調査 | 成果拡大と、技能・楽しさ・協働への懸念が併存 | 社員という特殊な標本で、自己申告を含む |
| 約40万セッションの分析 | 人が計画、Claudeが実行を多く担い、領域専門性が成果と関連 | 本番採用や事業価値までは測定していない |
| 自律性の実態調査 | 経験者は自動承認を増やしつつ、介入も増やす | Claude Codeと公開APIの観察で、他製品へ直接は広げられない |
Hacker News 61ptの反応は「総意」ではなく論点集として読む
指定のHacker Newsスレッドは、2026年10月7日JSTの確認時点で61 points、85 commentsでした。点数とコメント数は変動します。また、参加者は無作為抽出された開発者ではないため、業界の支持率としては使えません。
反応は一方向ではありません。手書きのコーディングから、アーキテクチャ、指示、品質判断へ仕事が移ったという見方があります。一方で、経験者は出力の良し悪しを判断できても、若手がその判断力をどこで身につけるのかという懸念も出ました。さらに、構文知識が薄れる代わりにシステム設計など別のリテラシーが重要になる、という反論もあります。
経営と職場文化を問題の中心に置くコメントもあれば、人が設計を担い、定型処理をClaudeへ任せることで仕事が楽しくなったという経験談もあります。したがってコミュニティの反応から取り出せるのは、「Claude Codeは善か悪か」という投票結果ではなく、設計責任、技能継承、品質判断、KPI設計という検証項目です。
日本企業のエージェント運用で先に詰まりやすい4領域
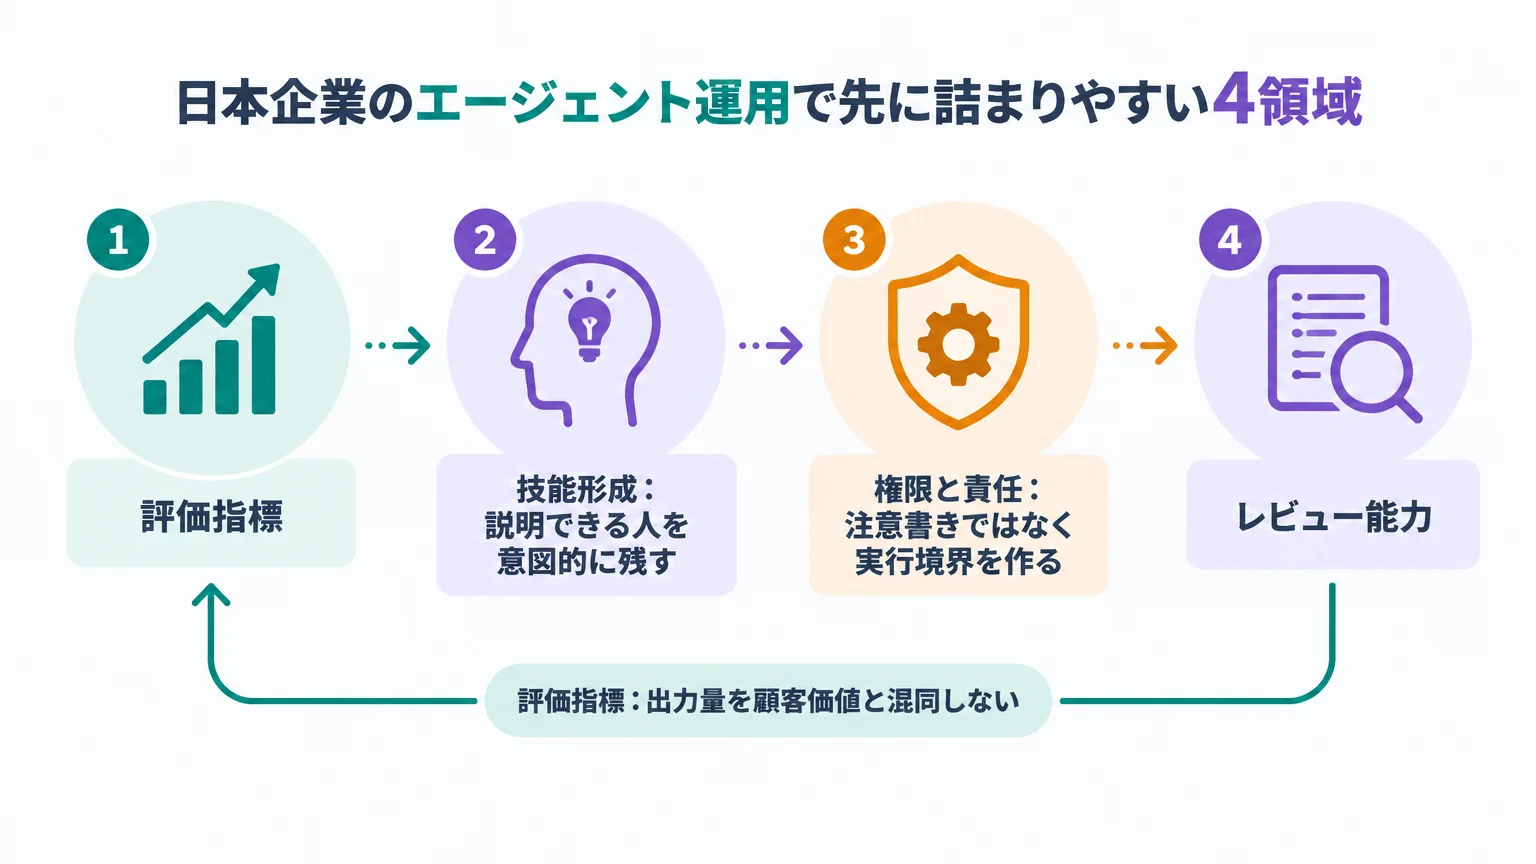
レビュー能力:生成量に合わせて検証可能性を設計する
レビュー担当者を増やすだけでは足りません。差分が大きい、受け入れ条件が曖昧、テストが何を保証するか不明という状態では、人数を増やしても読み切れません。タスクを小さく分け、変更理由、影響範囲、実行した検証、未確認事項を一つのレビュー単位に揃えます。
評価指標:出力量を顧客価値と混同しない
「PRが増えた」「実装が速い」は活動量です。顧客の課題が解けたか、障害が増えていないか、変更後も保守できるかは別の指標です。AI導入の責任者は、速度だけを経営へ報告せず、品質と手戻りを同じ画面に置く必要があります。
技能形成:説明できる人を意図的に残す
出力を採用する人が、なぜその設計なのか、失敗時にどこを見るのかを説明できなければ、組織はツールを監督できません。全員にすべてを手書きさせる必要はありませんが、設計レビュー、障害解析、コードリーディング、若手への説明を「余裕があれば行う作業」にしないことが重要です。
権限と責任:注意書きではなく実行境界を作る
Claude Codeの公式権限ドキュメントでは、Allow、Ask、Denyのルールや権限モードを使い、ツール操作を制御できると説明されています。プロンプトやCLAUDE.mdに「本番へ触らない」と書くことと、製品側で操作を拒否することは同じではありません。
本番変更、共有ブランチへの反映、秘密情報、外部送信のような高リスク操作は、自然言語のお願いだけに頼らず、denyルール、公式解説にあるサンドボックス、公式Hooks referenceの実行前フック、別アカウント、承認者の分離を組み合わせます。詳しい承認パターンは、実在確認済みのHuman-in-the-Loopの承認設計ガイドも参照してください。

| 領域 | 早期シグナル | 運用上の対策 | 残す証拠 |
|---|---|---|---|
| レビュー能力 | 未読差分、巨大PR、説明できない変更 | タスク分割、受け入れ条件、独立レビュー | 差分、テスト結果、レビュー指摘 |
| 評価指標 | PR数や生成行数だけが増える | 顧客価値、品質、手戻りを併記 | 採用結果、障害、ロールバック理由 |
| 技能形成 | 障害時にAIへ聞く以外の手段がない | 説明レビュー、障害演習、メンタリング | 判断理由、復旧手順、学習記録 |
| 権限と責任 | 誰でも本番・外部操作を実行できる | 最小権限、技術的拒否、責任者の明示 | 権限変更、実行ログ、承認記録 |
導入・検証は期間ではなく4つのゲートで進める
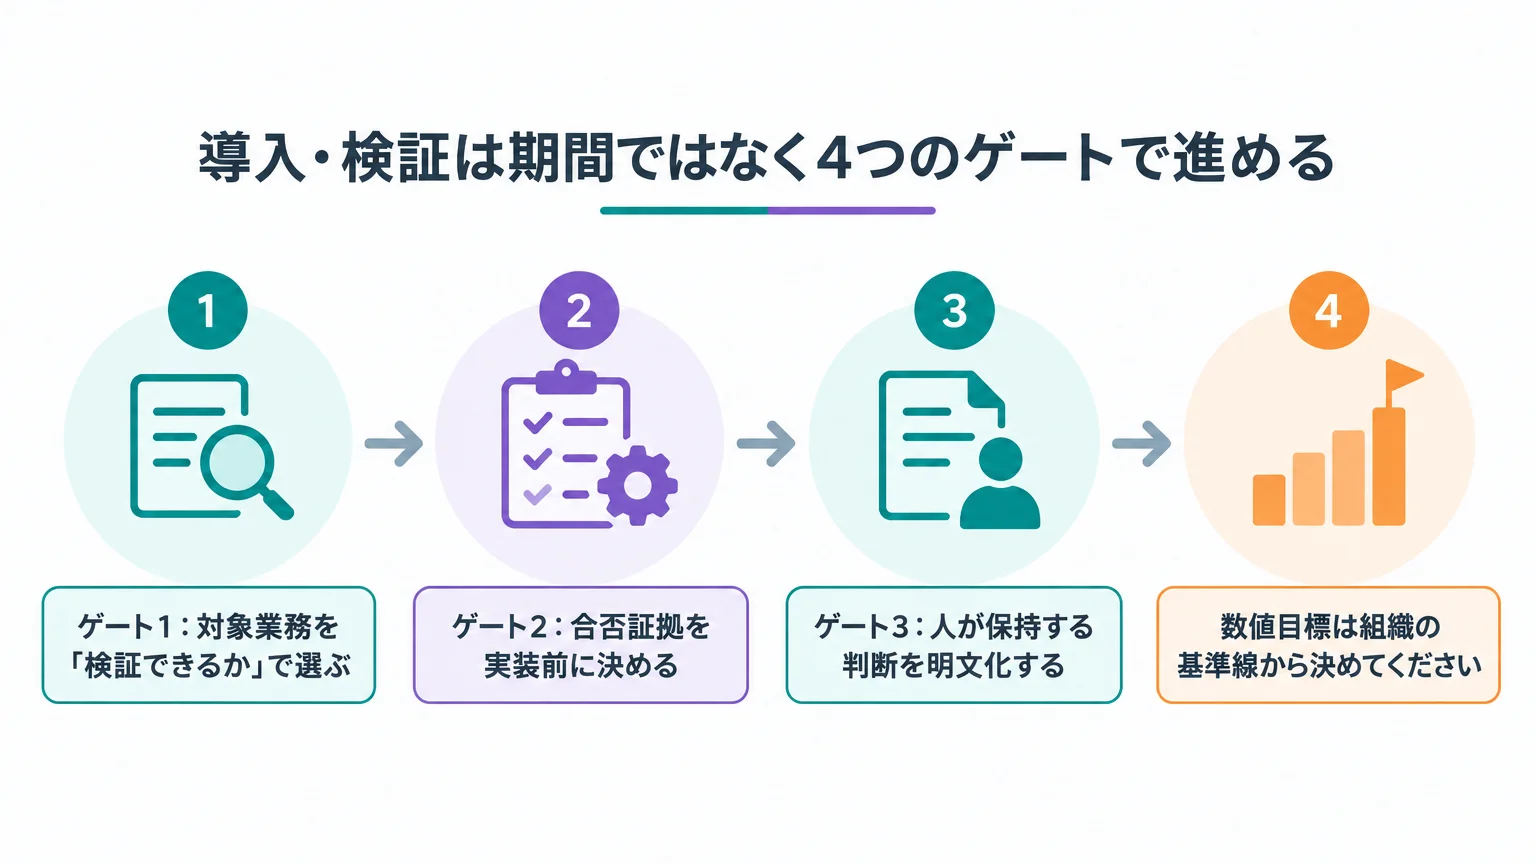
ゲート1:対象業務を「検証できるか」で選ぶ
最初の対象は、失敗しても戻せて、合否を証拠で示せる業務にします。既存テストがある小さな修正、lintや型エラーへの対応、文書と実装の差分調査などが候補です。要件が曖昧な新規事業の設計、本番データ変更、外部送信を同じ入口へ入れないでください。
業務名だけで選ぶのではなく、許可する入力、変更可能な場所、禁止操作、期待する成果物、失敗時の戻し方まで定義します。Claude Code公式ベストプラクティスも、テスト、ビルド、lint、画面確認など、エージェントが結果を検証できる手段を与えることを重視しています。
ゲート2:合否証拠を実装前に決める
「Claudeが完了と言った」は合格証拠ではありません。テストが通った、ビルドできた、意図した画面差分になった、禁止操作がブロックされた、レビュー担当者が要件との対応を説明できた、といった観察可能な証拠を決めます。
証拠は多ければよいのではなく、要求と対応していることが大切です。見た目の変更に単体テストだけを要求しても、意図した表示かは分かりません。データ移行なら件数だけでなく、失敗時の復旧が確認できる必要があります。タスクごとに「何を見れば合格か」を先に書きます。
ゲート3:人が保持する判断を明文化する
目的、優先順位、設計原則、例外の扱い、リスク許容、最終リリースは人の責任として残します。Claudeには探索、案の比較、実装、反復テストを担当させても、採用理由まで自動生成文のまま通さないようにします。
レビュー担当者には「問題がないか確認」ではなく、具体的な問いを渡します。たとえば、受け入れ条件のどこを満たしたか、壊れ得る境界は何か、既存設計と違う判断はどこか、戻すときに必要な操作は何かです。人が答えられない変更は、出荷を急がず調査へ戻します。
ゲート4:拡張前に品質と人への影響を同時に見る
処理時間だけが改善しても、レビュー残業、手戻り、障害、仕事満足度の低下が増えていれば、範囲を広げる根拠は弱いままです。技術指標と、利用者への短い匿名調査を同じ検証単位で見ます。質問は「便利だったか」だけでなく、「生成物を説明できるか」「集中して考える時間が減っていないか」「同僚へ相談する機会が変わったか」まで含めます。
数値目標は組織の基準線から決めてください。ここでは、裏取りできない改善率や目標値を置きません。まず導入前の実態を測り、同じ定義で比較できる状態を作ることが先です。
検証ダッシュボードに載せる指標
Claude CodeのMonitoring公式ドキュメントによると、OpenTelemetryで利用状況、コスト、ツール活動などを出力できます。ただし、テレメトリーだけでは「コードを理解しているか」「仕事に意味を感じるか」は測れません。機械ログと、人の評価を分けて収集します。

| 観点 | 測るもの | 避けたい代替指標 | 判断に使う問い |
|---|---|---|---|
| 顧客価値 | 受け入れ条件、利用状況、課題解決 | 生成機能数だけ | 使われる改善になったか |
| 品質 | レビュー指摘、手戻り、障害、復旧 | テスト本数だけ | 不具合を見つけ、戻せるか |
| レビュー負荷 | 待ち時間、読解時間、未読差分 | 承認回数だけ | 判断に必要な注意を払えたか |
| 制御可能性 | 禁止操作の遮断、例外、権限変更 | 警告文の設置だけ | 意図しない操作を技術的に止めたか |
| 技能 | 設計説明、障害解析、若手の学習 | ツール利用時間だけ | AIなしでも原因と影響を説明できるか |
| 仕事の質 | 集中、達成感、負荷、相談機会 | 満足度の単一設問だけ | 成果量と働き方の両方が改善したか |
記録の目的は個人を監視することではありません。どの種類のタスクで手戻りが増えるか、どの権限で確認が形骸化するか、どこで専門家の介入が効くかを特定するためです。プロンプトやコードの内容をログへ含める場合は、機密情報、個人情報、保存期間、閲覧権限を別途設計してください。
「押すだけ運用」を招く4つの失敗と修正
失敗1:承認ボタンを人間レビューだと見なす
❌ 同じ許可を何度も表示し、人が押した事実だけを監査証跡にする。
⭕ 反復的で低リスクな操作は限定されたサンドボックス内へ閉じ、高リスク操作にだけ具体的な差分、影響、戻し方を添えて承認を求める。
なぜ重要か:Anthropic自身が承認疲れを課題として扱っています。クリック数ではなく、注意を向けるべき判断へ人の時間を残す必要があります。
失敗2:PR数と生成行数を生産性と呼ぶ
❌ 出力件数の増加だけを導入成果として経営会議へ報告する。
⭕ 顧客価値、障害、手戻り、レビュー負荷と一緒に示し、不要な変更が増えていないか確認する。
なぜ重要か:生成速度が上がるほど、価値のない変更も速く増やせます。量と結果を切り離すと、今回の匿名投稿が訴えた出荷偏重を再現します。
失敗3:AIの説明を組織の理解だと見なす
❌ 変更理由をClaudeに再説明させ、その文章がもっともらしければ人は理解したことにする。
⭕ 採用責任者が自分の言葉で要件、設計判断、失敗条件、復旧方法を説明し、別のレビュー担当が差分と照合する。
なぜ重要か:同じエージェントが作成と自己評価を担うと、前提の誤りを引き継ぐ可能性があります。公式ベストプラクティスも、長く自律実行した仕事ほど、別の文脈から独立レビューする重要性を示しています。
失敗4:禁止事項をプロンプトだけに書く
❌ 「本番を変更しない」「秘密を送らない」と指示し、実行権限は残したままにする。
⭕ 権限ルール、ファイルとネットワークの分離、実行前フック、別資格情報で境界を強制し、禁止操作を試して本当に止まるか確認する。
なぜ重要か:公式ドキュメントでは、権限はモデルの指示とは別にClaude Code側で強制されます。守るべき規則を「覚えているはず」にしない設計が必要です。
よくある質問
このニュースは、Claude Codeが仕事の満足度を下げると証明したのですか?
証明していません。匿名の一個人による職場経験であり、勤務先、対象人数、比較条件は公開されていません。ただしAnthropicの社内調査にも、技能、仕事の楽しさ、協働への懸念が記録されており、企業が測るべき論点としては無視できません。
日本企業はClaude Codeの導入を止めるべきですか?
この報道だけを理由に一律停止する根拠はありません。検証可能で戻せる業務から始め、目的と最終判断を人が持ち、権限と証拠を設計してください。既に運用中なら、出力量だけでなくレビュー負荷と技能形成を追加で点検します。
最初の検証対象は何がよいですか?
既存の合否基準があり、失敗しても戻せる小さな変更が適しています。テスト、lint、型検査、画面差分などで確認でき、外部送信や本番変更を伴わない範囲を選びます。業務名ではなく、検証方法と権限境界で選ぶのがポイントです。
人が毎回承認すれば安全ですか?
承認だけでは十分ではありません。反復する確認は形骸化しやすく、内容を理解せず押すだけになる可能性があります。最小権限、サンドボックス、denyルール、実行前フック、独立レビューを重ね、高リスク判断へ注意を集中させます。
エンジニアが「ボタンを押す人」になっていないか、どう測れますか?
採用した変更の目的、設計判断、壊れ得る条件、復旧方法を本人が説明できるか確認します。加えて、未読差分、レビュー待ち、手戻り、障害解析、同僚との相談、若手の学習、仕事の達成感を継続して見ます。単一の満足度スコアだけで判断しません。
Hacker Newsの61 pointsは業界の総意ですか?
いいえ。2026年10月7日の取得時点を示す動的な評価で、参加者も無作為抽出ではありません。コメントは、経営問題、技能継承、上位設計への移行、肯定的な利用経験を知るための論点集として扱い、統計には使わないでください。
ここまでの要点
- TechSpotの「soul-sucking」報道は匿名の一事例であり、Claude Code利用企業全体の因果関係を示す調査ではありません。
- 投稿者が問題視した中心は、LLM利用そのものではなく、レビューと理解の時間を与えず出荷量を優先する運用でした。
- Anthropicの公式調査でも、成果拡大と、技能、仕事の楽しさ、協働への懸念は併存しています。
- 専門性は不要にならず、目的設定、異常検知、失敗からの回復に役立つことが公式研究で示されています。
- 導入は期間で区切るより、対象業務、合否証拠、人の判断、拡張条件というゲートで進める方が安全です。
- PR数や生成行数だけでなく、顧客価値、品質、レビュー負荷、制御可能性、技能、仕事の質を一緒に測ります。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Engineer says Claude Code has made his job "soul-sucking" as workers spend 12-hour days pressing enter — TechSpot、2026年9月22日公開(参照日:2026年10月7日)
- v0xiumによる元投稿 — X、2026年9月20日公開(参照日:2026年10月7日)
- Engineer says Claude Code has made his job "soul-sucking" — Hacker News、2026年10月6日JST投稿(コミュニティの反応、参照日:2026年10月7日)
- How AI is transforming work at Anthropic — Anthropic、2025年12月2日公開(参照日:2026年10月7日)
- Agentic coding and persistent returns to expertise — Anthropic、2026年6月16日公開(参照日:2026年10月7日)
- Measuring AI agent autonomy in practice — Anthropic、2026年2月18日公開(参照日:2026年10月7日)
- How we built Claude Code auto mode: a safer way to skip permissions — Anthropic、2026年3月25日公開(参照日:2026年10月7日)
- Best practices for Claude Code — Claude Code公式ドキュメント(参照日:2026年10月7日)
- Configure permissions — Claude Code公式ドキュメント(参照日:2026年10月7日)
- Beyond permission prompts: making Claude Code more secure and autonomous — Anthropic、2025年10月20日公開(参照日:2026年10月7日)
- Hooks reference — Claude Code公式ドキュメント(参照日:2026年10月7日)
- Monitoring — Claude Code公式ドキュメント(参照日:2026年10月7日)
この記事はAIgent Lab編集部がお届けしました。
この記事を読んで、AIエージェント導入時の役割分担や検証項目を具体化したい方へ
Uravationでは、AIエージェント導入の研修・コンサルティングを行っています。