結論:Vercel AI SDK(公式名は AI SDK)の現行メジャーは7で、npmのaiパッケージの最新は7.0.127(2026年10月1日公開・日付はUTC)です。7.0.0は2026年6月25日に公開され、Node.js 22以上・ESM専用が前提になりました。
関連: Vercel Eve完全ガイド|次世代AIエージェントフレームワーク【2026年7月】
- 要点1:構造は「
aiパッケージ(コア)+@ai-sdk/*プロバイダ(OpenAI/Anthropic/Google等)+@ai-sdk/react(useChat/useCompletion/useObject)」の3層です。プロバイダを差し替えるとモデルを変えられます。 - 要点2:
useChatはDefaultChatTransportとsendMessageで使い、サーバー側はstreamTextの結果をcreateUIMessageStreamResponseで返します。ツール呼び出しはinputSchema・stopWhen・toolApprovalで書きます。 - 要点3:Vercelの公式ドキュメントは Edge から Node.js ランタイムへの移行を推奨しており、Next.js 16.3 以降は
runtime = 'edge'の指定が使えません。この記事のコードは既定の Node.js ランタイムで動かす前提です。
対象読者:Next.js / React でAIチャットUIやAIエージェントを実装したいエンジニア、PoCから本番運用に移したいテックリード、OpenAI/Anthropic/Googleを切り替えながら使いたい開発チーム。
今日やること:npm i ai @ai-sdk/openai @ai-sdk/react zodを実行し、本記事の「即効テクニック1」のチャットルートを動かしてください。
AI SDKは、Vercelが公開しているTypeScript向けのオープンソースのツールキットです(Apache-2.0ライセンス)。npmのaiパッケージは、4.0.0が2024年11月18日、5.0.0が2025年7月31日、6.0.0が2025年12月22日、7.0.0が2026年6月25日に公開されました(日付はnpmレジストリの記録で、いずれもUTC)。約1年半でメジャーが3回上がっており、古い記事のコードはそのままでは動きません。
この記事では、AI SDK公式ドキュメント(ai-sdk.dev)と7.0のMigration Guide、npmレジストリ、Vercel・Next.jsの公式ドキュメントを2026年10月4日時点で確認し、useChat・構造化出力・tool calling・複数プロバイダ・本番デプロイを、現行の書き方のコードで整理します。コードは公式ドキュメントのAPIに沿って構成した例で、特定のプロジェクトの計測結果ではありません。
まず試したい「5分即効」セットアップ3選
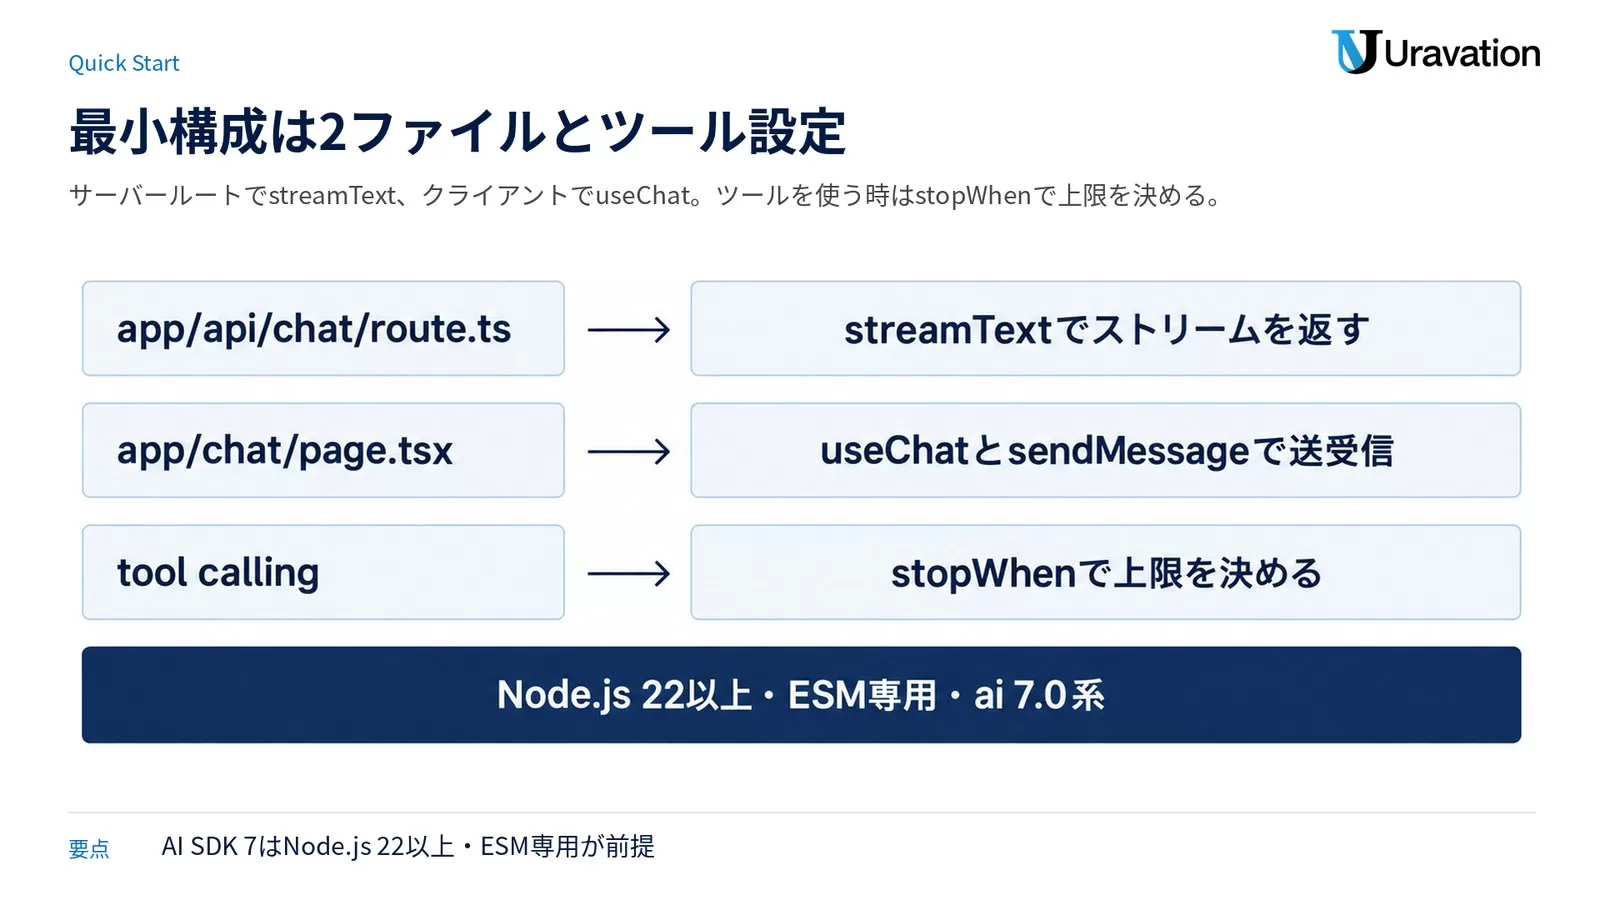
まずは動くコードを3本、手元で試してください。Next.js App Router / TypeScript / Node.js 22以降(AI SDK 7.0の要件)を前提にします。
即効テクニック1:useChatで30行のストリーミングチャット
useChatフックは、ストリームの受信・差分の結合・状態管理を引き受けます。公式ドキュメントのチャット構成に沿うと、サーバールートとクライアントコンポーネントの2ファイルでチャットUIが動きます。
// 動作環境: Next.js App Router / ai 7.0系 / @ai-sdk/openai / Node.js 22以上(AI SDK 7はESM専用)
// 必要パッケージ: npm i ai @ai-sdk/react @ai-sdk/openai zod
// app/api/chat/route.ts
import { openai } from '@ai-sdk/openai';
import {
  streamText,
  convertToModelMessages,
  createUIMessageStreamResponse,
  toUIMessageStream,
  type UIMessage,
} from 'ai';

// ストリーミング応答を最大30秒まで許可(公式のChatbotガイドと同じ設定)
export const maxDuration = 30;

export async function POST(req: Request) {
  const { messages }: { messages: UIMessage[] } = await req.json();

  const result = streamText({
    model: openai('gpt-6-luna'),
    instructions: 'You are a helpful assistant. Respond concisely in Japanese.',
    messages: await convertToModelMessages(messages),
  });

  // UIメッセージ形式のストリームをそのままレスポンスへ
  return createUIMessageStreamResponse({
    stream: toUIMessageStream({ stream: result.stream }),
  });
}
// app/chat/page.tsx
'use client';
import { useChat } from '@ai-sdk/react';
import { DefaultChatTransport } from 'ai';
import { useState } from 'react';

export default function ChatPage() {
  // v5以降、入力欄の状態はuseChatが持たない。useStateで自前管理する
  const { messages, sendMessage, status } = useChat({
    transport: new DefaultChatTransport({ api: '/api/chat' }),
  });
  const [input, setInput] = useState('');

  return (
    <div>
      {messages.map(m => (
        <div key={m.id}>
          <strong>{m.role}:</strong>{' '}
          {m.parts.map((part, i) =>
            part.type === 'text' ? <span key={i}>{part.text}</span> : null,
          )}
        </div>
      ))}
      <form
        onSubmit={e => {
          e.preventDefault();
          if (input.trim()) {
            sendMessage({ text: input });
            setInput('');
          }
        }}
      >
        <input value={input} onChange={e => setInput(e.target.value)} disabled={status !== 'ready'} />
        <button type="submit" disabled={status !== 'ready'}>送信</button>
      </form>
    </div>
  );
}
ポイント:
- 公式のChatbotガイドのルートは
export const maxDuration = 30;を指定しています。クイックスタートもChatbotガイドも、ランタイムの指定は書いていません(既定の Node.js で動きます)。 statusは'submitted' | 'streaming' | 'ready' | 'error'の4状態です。送信ボタンの無効化やスピナーの切り替えに使えます。- メッセージ本文は
parts配列で届きます。テキストのほか、ツール呼び出しの途中の状態もpartsから描画できます(後述)。
注意:本番環境で使う前に、テスト環境で動作を確認してください。APIキー(OPENAI_API_KEY)は.env.localに置き、Vercelでは環境変数として登録します。
即効テクニック2:Output.objectで型安全なJSON抽出
モデルが返すJSONを型つきで受け取るには、generateTextにoutput: Output.object({ schema })を渡します。旧来のgenerateObject / streamObjectは6.0で非推奨になりました(APIは残っています)。
// 動作環境: ai 7.0系 / @ai-sdk/openai / zod
// app/api/extract/route.ts
import { openai } from '@ai-sdk/openai';
import { generateText, Output } from 'ai';
import { z } from 'zod';

const InvoiceSchema = z.object({
  company: z.string().describe('請求元の会社名'),
  amount: z.number().describe('税込金額(円)'),
  due_date: z.string().describe('支払期日 YYYY-MM-DD'),
  items: z.array(z.object({
    name: z.string(),
    quantity: z.number(),
    unit_price: z.number(),
  })),
});

export async function POST(req: Request) {
  const { text } = await req.json();

  const { output } = await generateText({
    model: openai('gpt-6-astra'),
    output: Output.object({ schema: InvoiceSchema }),
    prompt: `次の請求書テキストから、請求書の構造化データを抽出してください:${text}`,
  });

  // output は z.infer<typeof InvoiceSchema> として完全に型がつく
  return Response.json(output);
}
ポイント:
- スキーマは生成結果の検証にも使われます。型に合わない出力はエラーになるため、リトライやフォールバックは自分で設計します。
.describe()でフィールドの意味を書いておくと、モデルに意図が伝わります。- OpenAIプロバイダは、AI SDK 6.0から
strictJsonSchemaが既定で有効です(6.0のMigration Guide)。スキーマの書き方が厳しくなるため、拒否された時はスキーマ側を直します。 - 途中経過を画面に出したい時は、
streamTextとOutput.objectを組み合わせ、クライアントはuseObjectで受けます(後述)。
即効テクニック3:tool callingでLLMに関数を呼ばせる
tool()でツールを定義し、streamTextやgenerateTextのtoolsに渡します。
// 動作環境: ai 7.0系 / @ai-sdk/openai / zod
import { openai } from '@ai-sdk/openai';
import {
  streamText,
  tool,
  isStepCount,
  convertToModelMessages,
  createUIMessageStreamResponse,
  toUIMessageStream,
  type UIMessage,
} from 'ai';
import { z } from 'zod';


export async function POST(req: Request) {
  const { messages }: { messages: UIMessage[] } = await req.json();

  const result = streamText({
    model: openai('gpt-6-astra'),
    messages: await convertToModelMessages(messages),
    stopWhen: isStepCount(5), // tool call → 結果 → 再度LLM呼び出し をマルチホップで許可
    tools: {
      getWeather: tool({
        description: '指定都市の現在の天気を取得する',
        inputSchema: z.object({
          city: z.string().describe('都市名(例: 東京、大阪)'),
        }),
        execute: async ({ city }) => {
          // 注意: 本番では実APIを叩く。ここではダミー
          return { city, temperature: 22, condition: '晴れ' };
        },
      }),
      searchKnowledge: tool({
        description: '社内ナレッジベースを検索する',
        inputSchema: z.object({
          query: z.string(),
          top_k: z.number().default(3),
        }),
        execute: async ({ query, top_k }) => {
          // 本番はベクトルDB呼び出し
          return { results: [{ title: 'ダミー結果', score: 0.92 }] };
        },
      }),
    },
  });

  return createUIMessageStreamResponse({
    stream: toUIMessageStream({ stream: result.stream }),
  });
}
ポイント:
stopWhenを指定しないと、生成は1回で終わります。ツールを呼んだ後に最終の回答まで進めたい時はisStepCount(5)のように上限を決めます。- 停止条件には
isStepCount(n)・hasToolCall(...)・isLoopFinished()があります。 executeは非同期関数なので、中でDB・外部API・ベクトル検索を呼べます。
Vercel AI SDKの全体像は「3層」で考える
AI SDKは、UI・Core・Providerの3層に分かれています。アプリのコードはCoreのAPIに対して書き、モデルはProviderで差し替えます。
| 層 | パッケージ | 役割 | 主なAPI |
|---|---|---|---|
| UI層 | @ai-sdk/react / @ai-sdk/vue / @ai-sdk/svelte |
フックでチャットの状態を管理 | useChat / useCompletion / useObject |
| Core層 | ai |
モデルの抽象化・ストリーミング・tool calling | streamText / generateText / Output.object / tool / embed |
| Provider層 | @ai-sdk/openai / @ai-sdk/anthropic / @ai-sdk/google など |
各社モデルとの接続 | openai(‘gpt-6-astra’) / anthropic(‘claude-sonnet-5-5’) / google(‘gemini-3.8-flash’) |
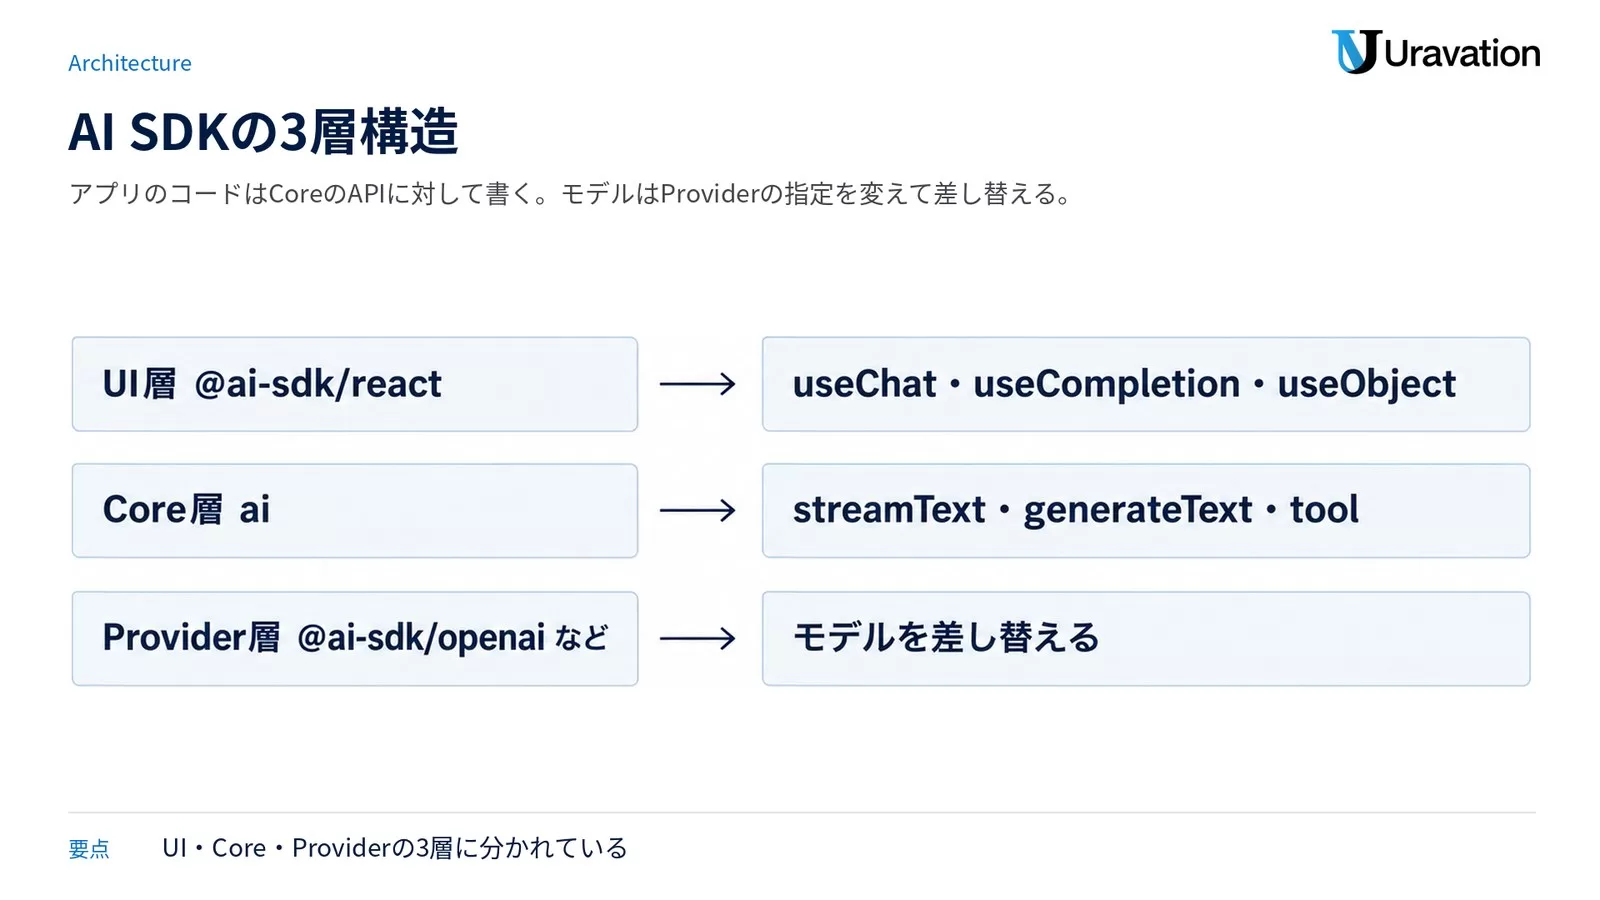
OpenAIで開発したものをAnthropicに切り替える時も、アプリ側で書き換えるのはmodel: openai(...)をmodel: anthropic(...)にするところです(プロバイダ固有の機能を使っている場合を除きます)。対応プロバイダの一覧は公式のProviders and Modelsにあります。
AI SDK 4.0から7.0までに変わったこと(移行チェックリスト)
2026年10月4日時点で、npmのaiパッケージの最新は7.0.127です(AI SDK by Vercel)。4.0系のコードは、5.0・6.0・7.0の3回のメジャー更新で、次の名前が変わっています。公式のMigration Guideで確認できた変更だけを挙げます。
| 旧(4.0系) | 現行(7.0系) | 導入されたメジャー |
|---|---|---|
parameters(tool定義) |
inputSchema |
5.0 |
maxSteps |
stopWhen: isStepCount(n) / hasToolCall(...) |
5.0(stepCountIsから7.0でisStepCountへ改名) |
CoreMessage / Message |
ModelMessage / UIMessage(本文はparts配列) |
5.0 |
convertToCoreMessages |
convertToModelMessages(awaitして使う) |
5.0 / 6.0 |
result.toDataStreamResponse() |
createUIMessageStreamResponse({ stream: toUIMessageStream({ stream: result.stream }) }) |
5.0 / 7.0 |
useChat({ api, input, handleSubmit }) |
useChat({ transport: new DefaultChatTransport({ api }) }) + sendMessage(入力欄は自前のuseState) |
5.0 |
ai/rsc |
@ai-sdk/rsc(別パッケージ) |
5.0 |
generateObject / streamObject |
generateText / streamText + output: Output.object({ schema }) |
6.0 |
Experimental_Agent |
ToolLoopAgent |
6.0 |
system |
instructions |
7.0 |
experimental_telemetry |
telemetry(OpenTelemetryは@ai-sdk/otelへ分離) |
7.0 |
onFinish / onStepFinish |
onEnd / onStepEnd |
7.0 |
result.fullStream |
result.stream |
7.0 |
ツール側のneedsApproval |
呼び出し側のtoolApproval |
7.0 |
7.0では実行環境の前提も上がりました。Migration Guideは「AI SDK 7.0 requires Node.js 22 or later」と書いており、検証対象は Node.js 22・24・26 です。Node.js 22 は2026年4月30日に保守が終わっているため、本番は Node.js 24(LTS)か 26 が推奨されています。全パッケージがESM専用になり、require()は使えません。CommonJSのプロジェクトは、package.jsonに"type": "module"を足すか.mjsへ切り替える作業が先に必要です。
改名の多くは codemod で自動適用できます。プロジェクト直下でnpx @ai-sdk/codemod v7を実行します。構造が変わった箇所は手で直す前提で見積もってください。詳細は5.0・6.0・7.0の各Migration Guideにあります。
ツール承認(Tool Execution Approval)の書き方が変わった
7.0では、承認の設定をツール定義ではなく呼び出し側に書きます。generateText / streamText / ToolLoopAgentのtoolApprovalで宣言し、UI側はaddToolApprovalResponseで応答します。ツール部品の状態としてapproval-requested / approval-respondedが届きます(Chatbot Tool Usage)。ツール側のneedsApprovalは非推奨になりました(既存のコードは動きます)。
useChat / useCompletion / useObject の使い分け
UI層の3つのフックは、想定する用途が分かれています。先にどれを使うかを決めてから書き始めると、後からの書き直しが減ります。
useChat(マルチターン会話)
ユーザーとAIが何往復もする対話を作る時の第一選択です。会話履歴・送信中の状態・エラー処理が含まれます。5.0以降、入力欄の状態はuseChatが持たなくなったため、useStateで管理します。
| 返り値 | 用途 |
|---|---|
messages |
会話履歴の配列。本文はpartsで届く |
sendMessage |
メッセージを送る(例: sendMessage({ text: input })) |
status |
'submitted' | 'streaming' | 'ready' | 'error' |
stop |
ストリーミングを中断する |
regenerate |
最後の応答を作り直す(エラー後の再試行にも使う) |
error |
リクエスト中に起きたエラー |
setMessages |
履歴を直接書き換える(クリア・編集) |
addToolOutput / addToolApprovalResponse |
クライアント実行ツールの結果と、承認の応答を返す |
useCompletion(単発の補完)
タイトル生成や要約など、会話履歴を持たない単発の生成で使います。こちらはinput・handleInputChange・handleSubmitを返します。
'use client';
import { useCompletion } from '@ai-sdk/react';

export default function SummaryForm() {
  const { completion, input, handleInputChange, handleSubmit, isLoading } = useCompletion({
    api: '/api/summarize',
  });

  return (
    <form onSubmit={handleSubmit}>
      <textarea value={input} onChange={handleInputChange} />
      <button disabled={isLoading}>要約する</button>
      <div>{completion}</div>
    </form>
  );
}
useObject(型安全な部分JSONストリーム)
useObjectは、Zodスキーマを渡すと、JSONが組み上がっていく途中の状態(partial object)を受け取れるフックです。フォームの自動補完やレポートの組み立てに向きます。
'use client';
import { useObject } from '@ai-sdk/react'; // 公式ドキュメントの現行のimport
import { z } from 'zod';

const ReportSchema = z.object({
  title: z.string(),
  summary: z.string(),
  sections: z.array(z.object({
    heading: z.string(),
    body: z.string(),
  })),
});

export default function ReportBuilder() {
  const { object, submit, isLoading } = useObject({
    api: '/api/report',
    schema: ReportSchema,
  });

  return (
    <>
      <button onClick={() => submit({ topic: 'AIエージェント設計' })}>生成</button>
      {object?.title && <h1>{object.title}</h1>}
      {object?.sections?.map((s, i) => (
        <section key={i}>
          <h2>{s?.heading}</h2>
          <p>{s?.body}</p>
        </section>
      ))}
    </>
  );
}
サーバー側はstreamTextとOutput.objectで実装し、テキストストリームとして返します。
// app/api/report/route.ts
import { openai } from '@ai-sdk/openai';
import { createTextStreamResponse, Output, streamText, toTextStream } from 'ai';
import { z } from 'zod';

const ReportSchema = z.object({
  title: z.string(),
  summary: z.string(),
  sections: z.array(z.object({
    heading: z.string(),
    body: z.string(),
  })),
});

export async function POST(req: Request) {
  const { topic } = await req.json();
  const result = streamText({
    model: openai('gpt-6-astra'),
    output: Output.object({ schema: ReportSchema }),
    prompt: `${topic}について、3セクションのレポートを生成してください`,
  });
  return createTextStreamResponse({
    stream: toTextStream({ stream: result.stream }),
  });
}
使いどころ:出力が大きい変換処理では、組み上がっていく構造をそのまま画面に出せます。処理時間そのものが縮むわけではなく、途中経過が見えるようになるという違いです。
tool calling実装パターン早見表
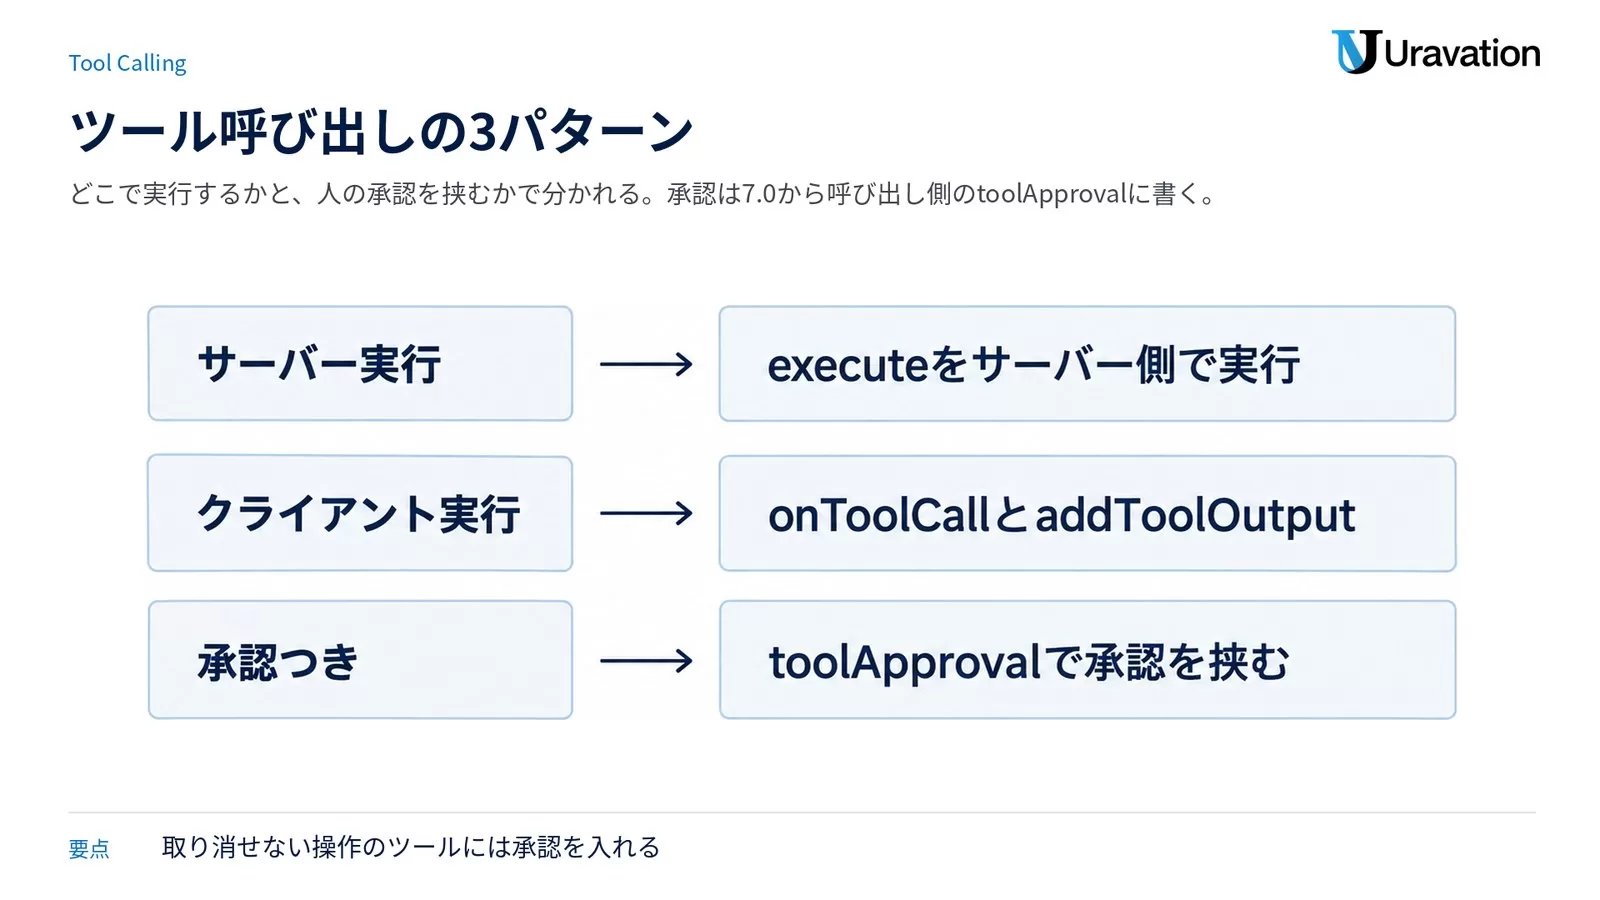
ツール呼び出しは、どこで実行するかと、人の承認を挟むかで3つに分かれます。
| パターン | 使い所 | 実装ポイント |
|---|---|---|
| サーバー実行 | DB問い合わせ、外部API、ベクトル検索 | tool({ ..., execute: async () => {} })でサーバー側で実行 |
| クライアント実行 | 位置情報の取得、ブラウザ側の操作 | executeを書かず、useChatのonToolCallで処理してaddToolOutputで結果を返す |
| Human-in-the-loop | 承認、確認、決済 | サーバー側のtoolApprovalで'user-approval'を指定し、UIはaddToolApprovalResponseで応答 |
クライアント実行ツールの例
// app/chat/page.tsx
'use client';
import { useChat } from '@ai-sdk/react';
import { DefaultChatTransport, lastAssistantMessageIsCompleteWithToolCalls } from 'ai';

export default function ChatPage() {
  const { messages, sendMessage, addToolOutput } = useChat({
    transport: new DefaultChatTransport({ api: '/api/chat' }),
    sendAutomaticallyWhen: lastAssistantMessageIsCompleteWithToolCalls,
    async onToolCall({ toolCall }) {
      // 型を絞り込むため、動的ツールかどうかを先に判定する
      if (toolCall.dynamic) return;
      if (toolCall.toolName === 'getCurrentLocation') {
        // ブラウザのGeolocation APIを呼ぶ
        const pos = await new Promise<GeolocationPosition>((resolve, reject) =>
          navigator.geolocation.getCurrentPosition(resolve, reject)
        );
        // awaitを付けずに呼ぶ(デッドロック回避)
        addToolOutput({
          tool: 'getCurrentLocation',
          toolCallId: toolCall.toolCallId,
          output: { lat: pos.coords.latitude, lng: pos.coords.longitude },
        });
      }
    },
  });
  // 以下省略
}
サーバー側のツール定義からexecuteを外すと、処理はクライアントのonToolCallに渡ります。ブラウザのAPIを使いたい場合のパターンです。sendAutomaticallyWhenにlastAssistantMessageIsCompleteWithToolCallsを渡すと、ツール結果がそろった時点で次のリクエストが自動で送られます。
Human-in-the-loopパターン(承認フロー)
決済や社内システムへの書き込みなど、エージェントに勝手に実行させたくない処理は、サーバー側でtoolApprovalを設定し、クライアント側でaddToolApprovalResponseを呼んで承認を挟みます。
// サーバー側: 承認を必要とするツールを宣言する
const result = streamText({
  model: openai('gpt-6-astra'),
  messages: await convertToModelMessages(messages),
  tools: { sendEmail },
  toolApproval: {
    sendEmail: 'user-approval',
  },
});
// クライアント側で承認UIをレンダリングし、ボタン押下で承認結果を戻す
const { messages, addToolApprovalResponse } = useChat();

{message.parts.map((part, i) => {
  if (part.type === 'tool-sendEmail' && part.state === 'approval-requested') {
    return (
      <div key={i}>
        <p>以下のメールを送信しますか?</p>
        <pre>{JSON.stringify(part.input, null, 2)}</pre>
        <button onClick={() => addToolApprovalResponse({
          id: part.approval.id,
          approved: true,
        })}>承認</button>
        <button onClick={() => addToolApprovalResponse({
          id: part.approval.id,
          approved: false,
        })}>却下</button>
      </div>
    );
  }
})}
ポイント:取り消しが効かない操作(決済・更新・外部への送信)を持つツールには、承認を入れておくのが安全側の設計です。toolApprovalは関数でも書けるため、入力の内容によって承認の要否を変えられます。
複数モデルプロバイダの統合(OpenAI / Anthropic / Google)
Provider層は、各社のモデルを同じインターフェースで扱えるようにしています。主要3社の使い方を整理します。
3社のプロバイダ初期化
// 動作環境: ai 7.0系 / @ai-sdk/openai / @ai-sdk/anthropic / @ai-sdk/google
import { openai } from '@ai-sdk/openai';
import { anthropic } from '@ai-sdk/anthropic';
import { google } from '@ai-sdk/google';

// それぞれデフォルトで環境変数を読む
// OPENAI_API_KEY / ANTHROPIC_API_KEY / GOOGLE_GENERATIVE_AI_API_KEY

// モデルIDは2026年10月4日時点のAI SDK公式ドキュメントのサンプルに合わせた
const models = {
  fast:    openai('gpt-6-luna'),
  smart:   openai('gpt-6-astra'),
  claude:  anthropic('claude-sonnet-5-5'),
  gemini:  google('gemini-3.8-flash'),
};
用途別のモデルと料金(2026年10月4日時点)
| 用途 | モデルの例 | 料金(100万トークンあたり・標準) | 確認した仕様 |
|---|---|---|---|
| 軽量チャット・分類 | openai('gpt-6-luna') |
入力 $0.10 / 出力 $0.50(約15円 / 約75円) | 短コンテキスト(入力272Kトークン以下)の料金 |
| tool calling中心のエージェント | openai('gpt-6-astra') |
入力 $10.00 / 出力 $50.00(約1,500円 / 約7,500円) | 同上 |
| 長文の要約・コード理解 | anthropic('claude-sonnet-5-5') |
入力 $2 / 出力 $10(約300円 / 約1,500円) | コンテキスト 1Mトークン・最大出力 128Kトークン |
| 画像・動画・PDFを混ぜる | google('gemini-3.8-flash') |
Google公式の料金ページを参照 | 対応する入力形式は公式のモデルページを参照 |
※円換算は1ドル150円で計算しています。OpenAIは公式のPricingのStandardの表、AnthropicはModels overviewの表を2026年10月4日に確認した値です。モデルIDは、AI SDK公式ドキュメントのサンプルで使われているものに合わせています。料金とモデルは変わるため、使う前に各社の公式ページで確認してください。
1コードで複数プロバイダを使い分けるパターン
モデルが共通のインターフェースなので、入力に応じてモデルを切り替える処理を1か所に書けます。
import type { ModelMessage } from 'ai'; // v5でCoreMessageから改名

async function routeToModel(messages: ModelMessage[]) {
  // 簡易ルーター:入力の長さで振り分け
  const totalLen = messages.reduce((acc, m) => acc + JSON.stringify(m.content).length, 0);

  const model = totalLen > 50_000
    ? anthropic('claude-sonnet-5-5')  // 長文はClaude(コンテキスト1Mトークン)
    : openai('gpt-6-luna');       // 短文は軽量モデル

  return streamText({ model, messages });
}
フォールバック(プロバイダ障害対策)
プロバイダ単体の障害に備えるなら、generateTextは例外を投げるのでtry/catchで別のモデルに切り替えられます。
async function generateWithFallback(prompt: string) {
  try {
    return await generateText({ model: openai('gpt-6-astra'), prompt });
  } catch (err) {
    console.warn('OpenAI failed, falling back to Anthropic', err);
    return await generateText({ model: anthropic('claude-sonnet-5-5'), prompt });
  }
}
注意:streamTextは同じ書き方では切り替えられません。公式ドキュメントは「streamText はすぐにストリーミングを始め、エラーはストリームの一部になり、例外としては投げられない」と説明しています。ストリーミングのエラーはonErrorコールバックで記録します。リトライやロギングをまとめたい時はcustomProvider(7.0でexperimental_の別名が削除)でプロバイダを包む方法があります。
ストリーミングUIの実装パターン
AI SDKのストリームは3種類あり、受け取る側のフックと対になっています。
| ストリーム形式 | サーバーAPI | クライアント受信 | 用途 |
|---|---|---|---|
| UI Message Stream | createUIMessageStreamResponse + toUIMessageStream |
useChat / useCompletion |
ツール呼び出しの途中の状態や承認状態を含む会話 |
| Text Stream | createTextStreamResponse + toTextStream |
useObject / 生のfetch |
文字列だけのストリーム・部分JSON |
| RSC(実験的) | streamUI(@ai-sdk/rsc) |
Server Componentsで描画 | ツールの結果をReactコンポーネントとして返す |
7.0では、result.toUIMessageStreamResponse()やresult.toTextStreamResponse()のような結果オブジェクトのメソッドが非推奨になり、'ai'からimportする関数(toUIMessageStream・createUIMessageStreamResponse・toTextStream・createTextStreamResponse)に置き換わりました。
RSC(React Server Components)対応のstreamUI
streamUIは、ツール呼び出しの結果に応じてReactコンポーネントをストリームできる機能です。
// 動作環境: ai 7.0系 / @ai-sdk/rsc / react 19以降 / Next.js App Router
// 注意: AI SDK RSC は公式ドキュメント上「experimental」。本番は AI SDK UI(useChat)が推奨されている。
// 必要パッケージ: npm i @ai-sdk/rsc
// app/actions.tsx
'use server';
import { streamUI } from '@ai-sdk/rsc';
import { openai } from '@ai-sdk/openai';
import { z } from 'zod';

export async function submitMessage(content: string) {
  const result = await streamUI({
    model: openai('gpt-6-astra'),
    messages: [{ role: 'user', content }],
    text: async function* ({ content }) {
      return <p>{content}</p>;
    },
    tools: {
      weather: {
        description: '都市の天気を表示',
        inputSchema: z.object({ city: z.string() }),
        generate: async function* ({ city }) {
          yield <p>天気を確認しています...</p>;
          const data = await fetchWeather(city);
          return <WeatherCard {...data} />;
        },
      },
    },
  });
  return result.value;
}

// fetchWeather と WeatherCard は自分のプロジェクトで用意する注意点:公式ドキュメントは「AI SDK RSC is currently experimental. We recommend using AI SDK UI for production.」と書いています。パッケージは5.0でai/rscから@ai-sdk/rscに分かれました(npm install @ai-sdk/rsc)。本番はuseChatを既定にし、RSCは検証用にとどめるのが公式の方針に沿った選び方です。
本番デプロイ構成:ランタイムは Node.js が推奨
以前は「軽いチャットは Edge Runtime」が定番でしたが、2026年10月時点の公式ドキュメントは方針を変えています。
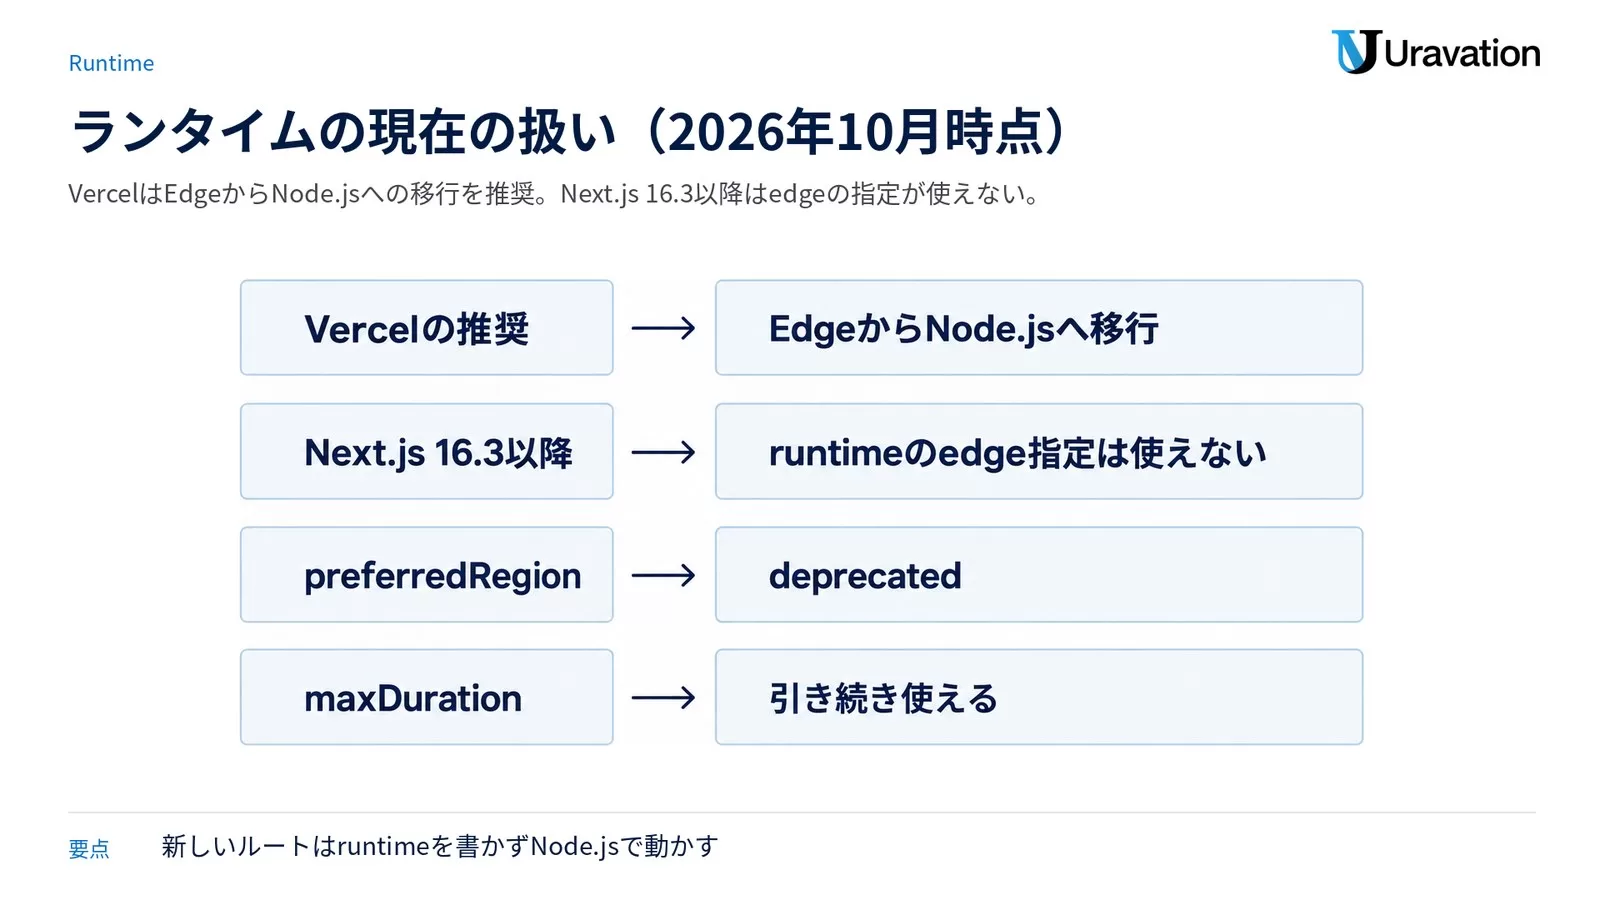
Edge Runtime と Node.js Runtime の現在の扱い
VercelのEdge Runtimeのドキュメントには、次の注記があります。
We recommend migrating from edge to Node.js for improved performance and reliability. Both runtimes run on Fluid compute with Active CPU pricing.
Starting in Next.js 16.3, setting
runtime = 'edge'is no longer supported. Routes and pages run on Node.js.
| 項目 | 公式ドキュメントの記載(2026年10月4日確認) |
|---|---|
| Vercelの推奨 | Edge から Node.js への移行を推奨。どちらも Fluid compute 上で動く |
| Next.js 16.3 以降 | runtime = 'edge'は使えない。ルートとページは Node.js で動く |
| Next.jsのルート設定 | runtimeの'edge'とpreferredRegionは deprecated。maxDurationは引き続き使える |
| Edge の応答時間 | 25秒以内に応答を始める必要があり、ストリーミングは最大300秒まで続けられる |
| AI SDK 7 の前提 | Node.js 22 以上・ESM専用 |
新しく作るルートではruntimeを書かず、既定の Node.js で動かすのが現行の公式に沿った構成です。既存の Edge ルートは、Next.js を 16.3 以降に上げる前に指定を外しておきます。
Vercel Functionsのstreaming設定
// app/api/chat/route.ts
// runtime は指定しない(既定の Node.js ランタイムで動く)
export const maxDuration = 30; // ストリーミング応答を最大30秒まで許可

export async function POST(req: Request) {
  // streamText の結果を createUIMessageStreamResponse で返す
}
AI SDKの公式のChatbotガイドも、ルートに書いている設定はmaxDuration = 30だけです。エージェントの処理が長い場合は、プランの上限の範囲でこの値を上げます。
環境変数とAPIキー管理
OPENAI_API_KEY/ANTHROPIC_API_KEY/GOOGLE_GENERATIVE_AI_API_KEYは、Vercelの環境変数で管理する- キーは「本番」「Preview」「開発」で分ける
- 各プロバイダの管理画面で支出の上限を設定する
- キーは定期的に入れ替える
監視・トレース
7.0でテレメトリの仕組みが変わりました。OpenTelemetryの出力はaiパッケージから@ai-sdk/otelに分かれ、アプリの起動時に1回登録します。連携を登録すると、各呼び出しのテレメトリは既定で有効になります(呼び出しごとにisEnabled: falseで止められます)。オプション名はexperimental_telemetryからtelemetryに変わりました。
// instrumentation.ts(アプリの起動時に1回だけ登録する)
import { registerTelemetry } from 'ai';
import { OpenTelemetry } from '@ai-sdk/otel';

registerTelemetry(new OpenTelemetry());

// app/api/chat/route.ts
import { streamText } from 'ai';

const result = streamText({
  model: openai('gpt-6-astra'),
  messages,
  telemetry: {
    functionId: 'chat-route', // トレースを見分けるための名前
  },
});
トレースを監視ツールに流すと、どの呼び出しが遅かったか、どのツールが失敗したかを追えます。
【要注意】よくある失敗パターンと回避策
公式ドキュメントの仕様から起きやすい失敗を4つ整理します。
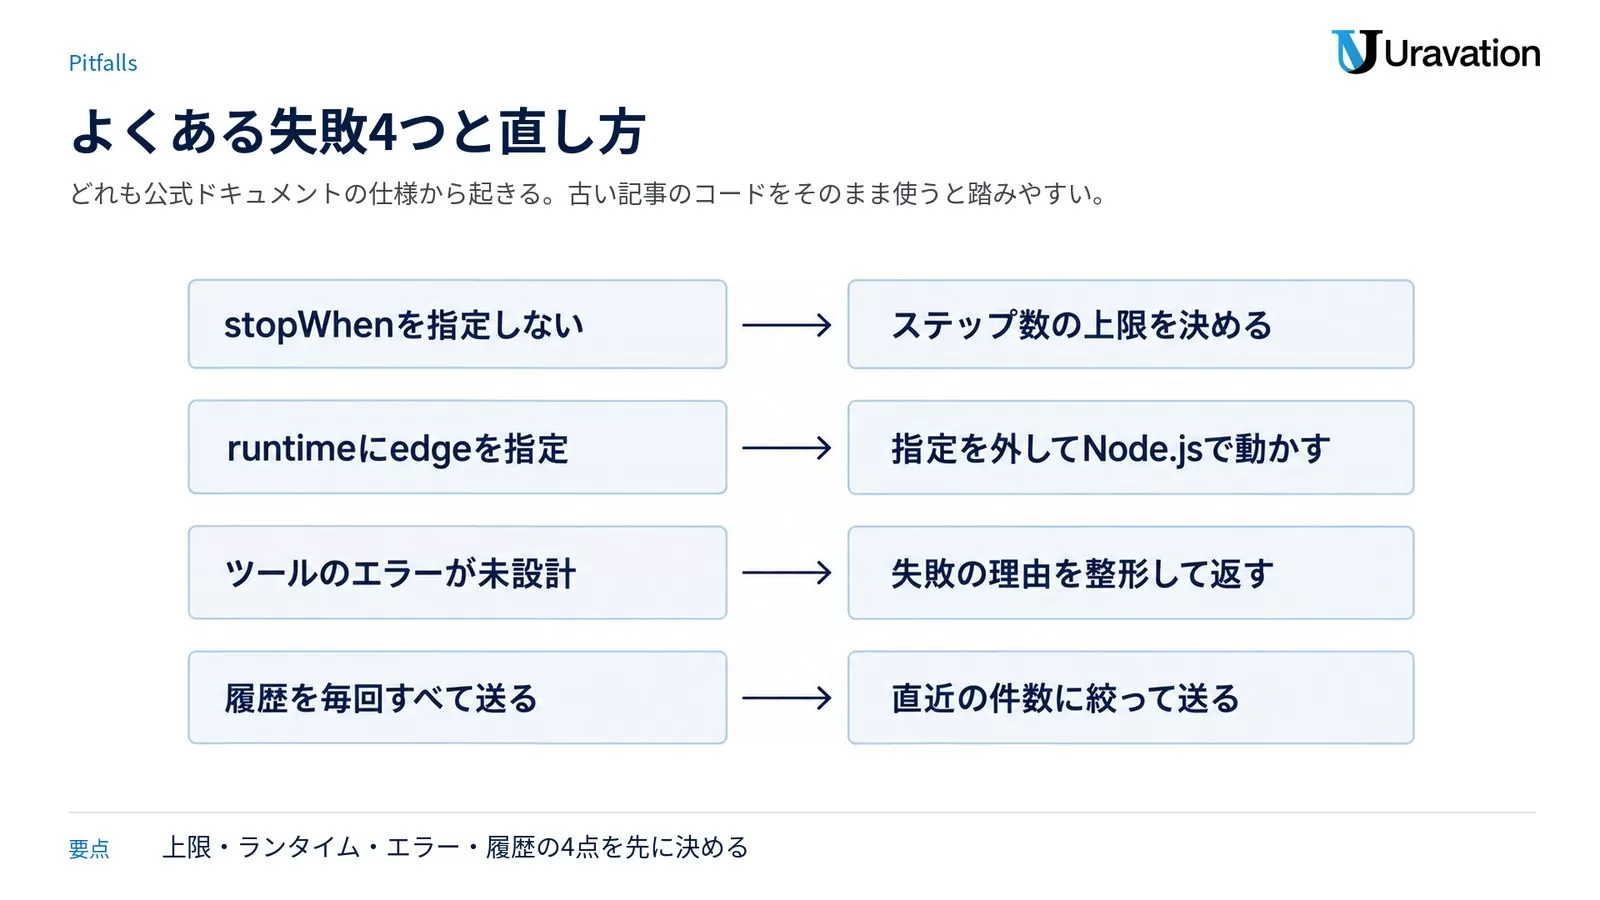
失敗1:stopWhenを指定せずtool callingが止まる
❌ よくある間違い
streamText({
  model: openai('gpt-6-astra'),
  tools: { searchDB: tool({ ... }) },
  messages,
}); // stopWhenを指定していない
⭕ 正しいアプローチ
import { isStepCount } from 'ai';

streamText({
  model: openai('gpt-6-astra'),
  tools: { searchDB: tool({ ... }) },
  messages,
  stopWhen: isStepCount(5), // ツール実行後に再度LLMを呼び出して最終応答を生成
});なぜ重要か:generateText / streamTextは、既定では1回の生成しか行いません。ツールを渡しただけでは、モデルがツール呼び出しを返した時点で終わり、最終の回答が返りません。
失敗2:古い記事のまま runtime = ‘edge’ を指定する
❌ よくある間違い:ルートにexport const runtime = 'edge'を書き、Node.js専用のパッケージ(fsを使うライブラリなど)をimportしてビルドが落ちる。
⭕ 正しいアプローチ:
- 新しいルートでは
runtimeを指定しない(既定の Node.js で動く) - 既存の Edge ルートは、Vercelの推奨に沿って Node.js へ移す
- Next.js 16.3 以降に上げる前に、
runtime = 'edge'の指定が残っていないか検索する
なぜ重要か:Edge RuntimeはNode.js APIの一部しか使えません。加えて、Next.js 16.3 以降では指定そのものが使えなくなっています。
失敗3:ツールのエラーを設計していない
公式ドキュメントによると、executeの中で投げた例外はtool-errorという部品として結果に追加され、複数ステップの処理ではモデルに渡されます。つまり、例外を投げてもループは続きます。ただし、モデルに届くのはエラーの内容だけです。
tool({
  inputSchema: z.object({ id: z.string() }),
  execute: async ({ id }) => {
    const data = await fetchFromDB(id); // 例外はtool-errorとしてモデルに渡る
    return data;
  },
})
次に取れる手をモデルに選ばせたい時は、失敗の理由を自分で整形して返す書き方があります。
tool({
  inputSchema: z.object({ id: z.string() }),
  execute: async ({ id }) => {
    try {
      const data = await fetchFromDB(id);
      return { success: true, data };
    } catch (err) {
      // 失敗の理由を整形して返す。内部情報は含めない
      return { success: false, error: err instanceof Error ? err.message : 'unknown' };
    }
  },
})なぜ重要か:どちらの書き方でも処理は続きますが、モデルが「別の方法を試す」「ユーザーに聞く」を選べるかどうかは、返ってくる情報の質で決まります。接続文字列や内部のスタックトレースをそのまま返さないことも、あわせて設計します。失敗の記録はonToolExecutionEndコールバックで取れます。
失敗4:messagesの肥大化でコストが増え続ける
❌ よくある間違い:useChatのmessagesを無制限にため、毎回すべて送る
⭕ 正しいアプローチ:
DefaultChatTransportのprepareSendMessagesRequestで、送る前に直近の件数だけに絞る- 古いメッセージは要約して
instructionsに入れる
const { messages, sendMessage } = useChat({
  transport: new DefaultChatTransport({
    api: '/api/chat',
    // v5以降、送信ボディの加工はtransport側のprepareSendMessagesRequestで行う
    prepareSendMessagesRequest: ({ messages }) => ({
      body: {
        // 直近20件のみ送信。それ以前は要約を別途渡す
        messages: messages.slice(-20),
        summary: getSummaryOfOlderMessages(messages.slice(0, -20)),
      },
    }),
  }),
});なぜ重要か:履歴を毎回すべて送る実装では、送信するトークン数が会話の長さに比例して増えます。会話が長くなるほど高く、遅くなります。
セキュリティと本番運用ルール
AI SDKを使うかどうかに関わらず、本番で守る点を整理します。
プロンプトインジェクション対策
- 外部の入力を
instructionsに直接つなげない。ユーザーのメッセージとして渡し、instructionsは固定の文に保つ - 外部のデータ(検索結果、URLの本文)には、信頼できないデータであることを明記する
- ツールの
executeでは入力を検証し直す。Zodで型を検証していても、SQLやコマンドへの埋め込みは別に防ぐ
シークレット管理
- APIキーをコードに書かない(環境変数で管理する)
- クライアントから直接モデルを呼ばない(サーバールートを経由する)
- 各プロバイダで支出の上限を設定する
レート制限・コスト管理
- ユーザー単位のレート制限を実装する
- セッション単位のトークン消費を記録する
- 異常な消費を検知して通知する
ロールバック戦略
- モデル名は環境変数で管理し(例:
MODEL_NAME=gpt-6-astra)、すぐに切り替えられるようにする - 非ストリーミングの処理には、前述の
generateWithFallbackのような切り替えを入れる - Vercelのデプロイのロールバック機能を使う
実戦レシピ:useChatでAIエージェントを作る完全構成
ここまでの要素をまとめた、チャットエージェントのサーバールートの構成例です。Next.js App Router / Node.js ランタイム / ツール2つ / 承認つきツール / エラーの記録 / トレースの識別子、という構成です。
// app/api/chat/route.ts  (AI SDK 7.0系での構成)
import { openai } from '@ai-sdk/openai';
import {
  streamText,
  tool,
  isStepCount,
  convertToModelMessages,
  createUIMessageStreamResponse,
  toUIMessageStream,
  type UIMessage,
} from 'ai';
import { z } from 'zod';

export const maxDuration = 30;

export async function POST(req: Request) {
  const { messages }: { messages: UIMessage[] } = await req.json();

  const result = streamText({
    model: openai('gpt-6-astra'),
    instructions: 'あなたは社内ナレッジアシスタント。簡潔・誠実・出典明記。',
    messages: await convertToModelMessages(messages),
    stopWhen: isStepCount(8),
    telemetry: { functionId: 'chat' },
    tools: {
      searchKnowledge: tool({
        description: '社内ナレッジを検索',
        inputSchema: z.object({ query: z.string(), top_k: z.number().default(3) }),
        execute: async ({ query, top_k }) => {
          try {
            const hits = await searchVectorDB(query, top_k);
            return { success: true, hits };
          } catch (err) {
            return { success: false, error: '検索に失敗しました' };
          }
        },
      }),
      scheduleEmail: tool({
        description: 'メール送信を予約(ユーザー承認が必要)',
        inputSchema: z.object({
          to: z.string().describe('宛先のメールアドレス'),
          subject: z.string(),
          body: z.string(),
        }),
        execute: async (input) => enqueueEmail(input),
      }),
    },
    // 承認が要るツールは呼び出し側で宣言する
    toolApproval: {
      scheduleEmail: 'user-approval',
    },
    // streamText は例外を投げない。ストリーム中のエラーは onError で記録する
    onError({ error }) {
      console.error('chat stream error', error);
    },
  });

  return createUIMessageStreamResponse({
    stream: toUIMessageStream({ stream: result.stream }),
  });
}

declare function searchVectorDB(q: string, k: number): Promise<any[]>;
declare function enqueueEmail(input: { to: string; subject: string; body: string }): Promise<{ queued: true }>;
この構成は、公式ドキュメントのAPIを組み合わせた例です。効果の数字は環境で変わるため、導入の前後で自分の環境の応答時間とコストを測って比べてください。
他フレームワークとの比較:Vercel AI SDKはどんな時に選ぶか
AIエージェント実装の選択肢は増えています。それぞれが向く場面を整理します。
| フレームワーク | 主言語 | 強み | 向く場面 |
|---|---|---|---|
| Vercel AI SDK | TypeScript | Next.js/Reactとの統合、ストリーミングUI、複数プロバイダ | UIを持つAIアプリ、Web中心の本番運用 |
| OpenAI Agents SDK | Python / TypeScript | マルチエージェント設計、Handoffs、Traces | 複雑なマルチエージェント、バックエンド中心 |
| Anthropic Claude Agent SDK | Python | Claude特化、長文・Computer Use | 自律的・長時間動作するエージェント |
| LangChain / LangGraph | Python / TypeScript | 豊富なツール群、複雑なグラフ実行 | RAG重視、研究プロトタイプ |
| Mastra | TypeScript | Workflow指向、エージェント定義のスキーマ化 | TypeScript製のエージェントパイプライン |
関連記事として、OpenAI Agents SDK TS比較|Python版との違いとClaude Agent SDK実践ガイド|Python自律エージェント構築もぜひ参照してください。マルチエージェント設計を学びたい方はOrchestrator-Workerパターンのマルチエージェント設計も合わせて読むと、Vercel AI SDKでの実装イメージが立体的になります。
選び方の基準
「Webアプリ・UIが必要・チームがTypeScript」なら、Vercel AI SDKが第一候補になります。逆に「Pythonバックエンド中心・マルチエージェント・コードプロセス制御が重い」場合はOpenAI Agents SDKやClaude Agent SDK Pythonを選びます。複雑なグラフ実行や研究系プロトタイプならLangGraphが強い。要は「フロントから本番運用までの距離を最短にしたい」ならVercel AI SDK、という選び方です。
Vercel AI SDKに置き換えると何が変わるか
前提:次の表は、「生のプロバイダSDKと自前のストリーム処理」から「AI SDK」へ置き換えた時に、何がどういう理由で変わるかを整理したものです。実プロジェクトの観測値ではなく、改善幅を保証するものでもありません。
| 観点 | 置き換え前 | 置き換え後 | 変わる理由 |
|---|---|---|---|
| ストリームの処理 | 受信・差分の結合・状態管理を自前で持つ | useChatが担当する |
差分の結合と状態遷移がSDK側に移る |
| モデルの切り替え | プロバイダごとにコードが分かれる | modelの指定を変える |
Provider層が共通のインターフェースを持つ |
| 構造化出力 | JSON文字列を自前でパースして検証 | Zodスキーマで定義し、SDKが検証する | スキーマに合わない出力がその場でエラーになる |
| 承認フロー | 自前で状態を管理 | toolApprovalとaddToolApprovalResponse |
承認の状態がメッセージの部品として届く |
ポイント:コストは、SDKを入れるだけでは下がりません。軽い処理を安いモデルに回す設計を自分で入れて、初めて効いてきます。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- AI SDK by Vercel 公式ドキュメント(参照日: 2026-10-04)
- AI SDK 7.0 Migration Guide(Node.js 22以上・ESM専用・改名一覧・codemod)
- AI SDK 6.0 Migration Guide(strictJsonSchemaの既定値)
- Next.js App Router Quickstart — AI SDK
- Chatbot — AI SDK UI(useChat / transport / sendMessage / status)
- Chatbot Tool Usage — AI SDK UI(addToolOutput / addToolApprovalResponse)
- Tools and Tool Calling — AI SDK Core(inputSchema / stopWhen / toolApproval / tool-error)
- AI SDK RSC Overview(実験的という位置づけ)
- Providers and Models — AI SDK
- npm: ai(7.0.127・Apache-2.0・各メジャーの公開日)
- Edge Runtime — Vercel Docs(Node.jsへの移行の推奨・Next.js 16.3)
- Route Segment Config — Next.js Docs(runtime ‘edge’・preferredRegion は deprecated)
- OpenAI API Pricing(gpt-6-astra / gpt-6-luna・2026年10月4日確認)
- Claude Models overview(claude-sonnet-5-5のID・料金・コンテキスト長)
- Gemini API Models
よくある質問(FAQ)
Q1. Vercel AI SDKの最新バージョンはいくつですか?
2026年10月4日時点で、npmのaiパッケージの最新は7.0.127(2026年10月1日公開・UTC。日本時間では10月2日)です。7.0.0は2026年6月25日に公開されました。6系はai-v6、5系はai-v5のタグで配信されています。
Q2. Vercel AI SDKはVercel以外でも使えますか?
使えます。オープンソースのライブラリで、Vercelへのデプロイは必須ではありません。7.0は Node.js 22 以上とESMが前提です。ストリーミングを使う場合は、ホスティング側がストリーミング応答に対応している必要があります。
Q3. 料金はいくらかかりますか?
AI SDK自体は無料です(Apache-2.0ライセンス)。費用は、モデルの従量課金とホスティングの料金です。2026年10月4日時点の標準料金は、gpt-6-lunaが入力 $0.10 / 出力 $0.50、gpt-6-astraが入力 $10.00 / 出力 $50.00、claude-sonnet-5-5が入力 $2 / 出力 $10 です(いずれも100万トークンあたり。1ドル150円換算で、gpt-6-lunaの入力は約15円)。
Q4. AI SDK 4系から7系へ移行する時は何を直しますか?
改名はnpx @ai-sdk/codemod v7でまとめて処理できます。手作業が要るのは、toDataStreamResponseからcreateUIMessageStreamResponseとtoUIMessageStreamへの書き換え、useChatのtransportとsendMessageへの切り替え、parametersからinputSchemaへの置き換えです。Node.js 22 以上とESMへの移行が先に必要です。
Q5. Edge RuntimeとNode.js Runtime、どちらを選べばよいですか?
Node.js です。Vercelは Edge から Node.js への移行を推奨しており、Next.js 16.3 以降ではruntime = 'edge'が使えません。AI SDKの公式クイックスタートもランタイムを指定していません。
Q6. useChatでinputやhandleSubmitが使えません。なぜですか?
5.0でuseChatの作りが変わったためです。入力欄はuseStateで管理し、送信はsendMessage({ text: input })で行います。APIの指定はtransport: new DefaultChatTransport({ api: '/api/chat' })に移りました。
Q7. OpenAI、Anthropic、Googleのどれを選ぶべきですか?
用途で決めます。記事中の表のとおり、軽い処理はgpt-6-luna、ツール呼び出し中心ならgpt-6-astraかclaude-sonnet-5-5、長い文書はコンテキストが1Mトークンのclaude-sonnet-5-5が目安です。AI SDKではmodelの指定を変えるだけで切り替えられるため、同じ入力で比べて決められます。
Q8. ストリーミングUIのテストはどう書きますか?
サーバー側は、ai/testのMockLanguageModelV4と、aiからimportするsimulateReadableStreamでモデルをモックできます(公式ドキュメントのTesting)。画面側は、ルートをモックしてuseChatの表示を確認する方法と、実際のルートを呼ぶE2Eテストを組み合わせます。
Q9. Vercel AI SDKだけでAIエージェントは作れますか?
単独のエージェントなら、stopWhenつきのstreamTextかToolLoopAgentで作れます。複数のエージェントが協調する設計は、マルチエージェント設計パターンを参考にしてください。
まとめ:今日から始める3つのアクション
- 今日:
npm i ai @ai-sdk/openai @ai-sdk/react zodを実行し、「即効テクニック1」のチャットルートを動かす。Node.jsのバージョンが22以上かを先に確認する。 - 今週中:
Output.objectとtoolを使い、自社の業務から「構造化したJSONを取りたい処理」を1つ選んで実装する。stopWhenと、ツールが失敗した時に返す内容を決める。 - 今月中:既存のコードに
runtime = 'edge'・ai/rsc・system:・experimental_telemetryが残っていないか検索し、7.0の書き方へ移す。telemetryにfunctionIdを付けてトレースを追えるようにする。
あわせて読みたい
- OpenAI Agents SDK TS比較|Python版との違い
- Claude Agent SDK実践ガイド|Python自律エージェント構築
- マルチエージェント設計パターン|Orchestrator-Worker型実装ガイド
この記事を読んでVercel AI SDKの導入イメージが固まってきた方へ。
UravationではAIエージェント導入の研修・コンサルティング・伴走開発を行っています。Next.js × AI SDKでの本番構築のレビュー、社内チームのキャッチアップ研修、PoCから本番への移行支援まで対応します。