「Why are coding agents so dumb?」は、LLMの知能が低いという記事ではありません。2026年10月10日時点で一次ソースを確認すると、著者Michael Lynch氏が問題にしているのは、タスク分割、委譲、計画表示、停止判断、権限制御、検証を担うコーディングエージェントの「ハーネス」です。
検索意図への短い答えはこうです。高性能なモデルを選んでも、それを動かす周辺システムが仕事を適切に分けず、必要な文脈を渡さず、完了を証明せず、安全な境界も作らなければ、利用者には「エージェントが賢くない」と見えます。企業が評価すべき対象はモデル単体ではなく、モデル、指示、ツール、実行環境、権限、評価、人間の承認を含む一式です。
よくある誤解は、この記事を「最新モデルでもコードを書けない」という性能批判として読むことです。実際には逆で、Lynch氏はAI支援開発そのものの進歩を認めたうえで、モデルの能力を実務へつなぐソフトウェア層がボトルネックになっていると論じています。
この区別は、日本企業の導入判断にも直結します。デモでコードが生成できたことと、社内リポジトリで安全かつ再現可能に作業を完了できることは同じではありません。以下では、2026年10月9日に公開された原文の論点を事実・体験・仮説に分け、各社の公式情報で補正しながら、検証の始め方まで落とし込みます。
公開されたのは新製品ではなく、開発者からの問題提起
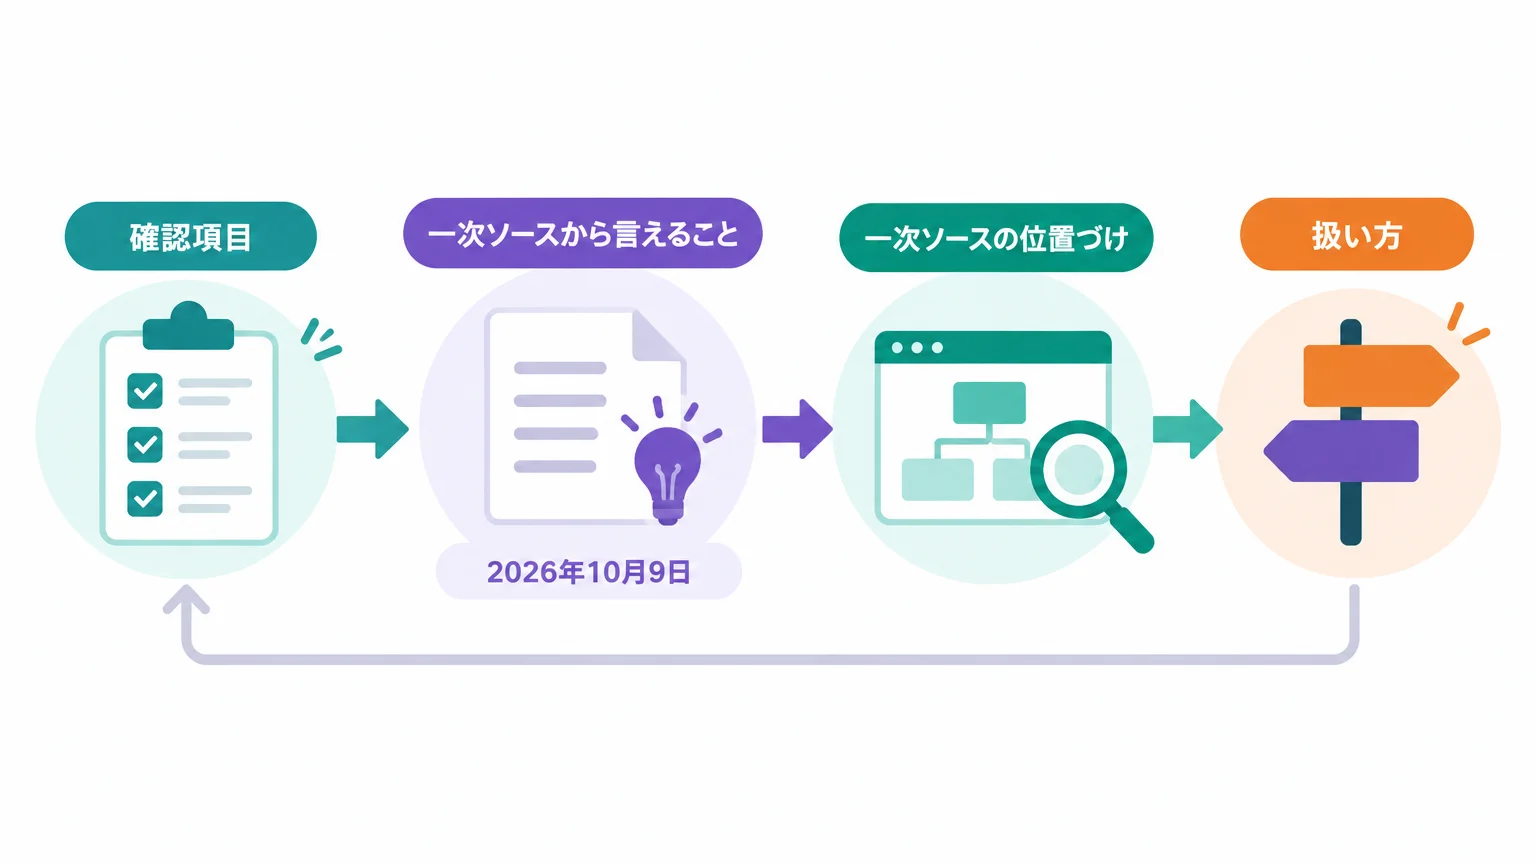
Why Are Coding Agents So Dumb?は、2026年10月9日にMichael Lynch氏が公開した個人ブログの論評です。新しいエージェント製品、ベンチマーク、研究成果の発表ではありません。Claude、Codex、OpenCode、Cline、Piを試し、OpenCodeとClaude Codeを日常的に使っている著者が、自身の継続利用で感じた摩擦を整理した記事です。
| 確認項目 | 一次ソースから言えること | 扱い方 |
|---|---|---|
| 公開日 | 2026年10月9日 | 出来事の日付として記載できる |
| 記事の種類 | 開発者の経験に基づく論評 | 全製品を横断した実証研究とは区別する |
| 中心論点 | モデルより、モデルを動かすエージェント/ハーネスが実務上の制約になっているという指摘 | 著者の観察として帰属させる |
| 改善が遅い理由 | 経営側と利用開発者の関心のずれではないか、という仮説 | 確認済みの企業内部事情として断定しない |
原文はHacker Newsでも議論を集めました。ただし、コミュニティの賛否は製品性能の検証結果ではありません。また、記事内の一部の数字は著者の体験的な表現やジョークです。この記事では、一次ソースで確認できても一般化できない数字は、企業判断の根拠に使いません。
AIエージェント全体の選択肢を先に把握したい場合は、サイト内のAIエージェントツール比較12選も参照してください。今回の論点は「どのモデルが最強か」ではなく、選んだモデルをどの実行系で動かすかです。
「頭脳」と「仕事の進め方」を分けると、失敗箇所が見える
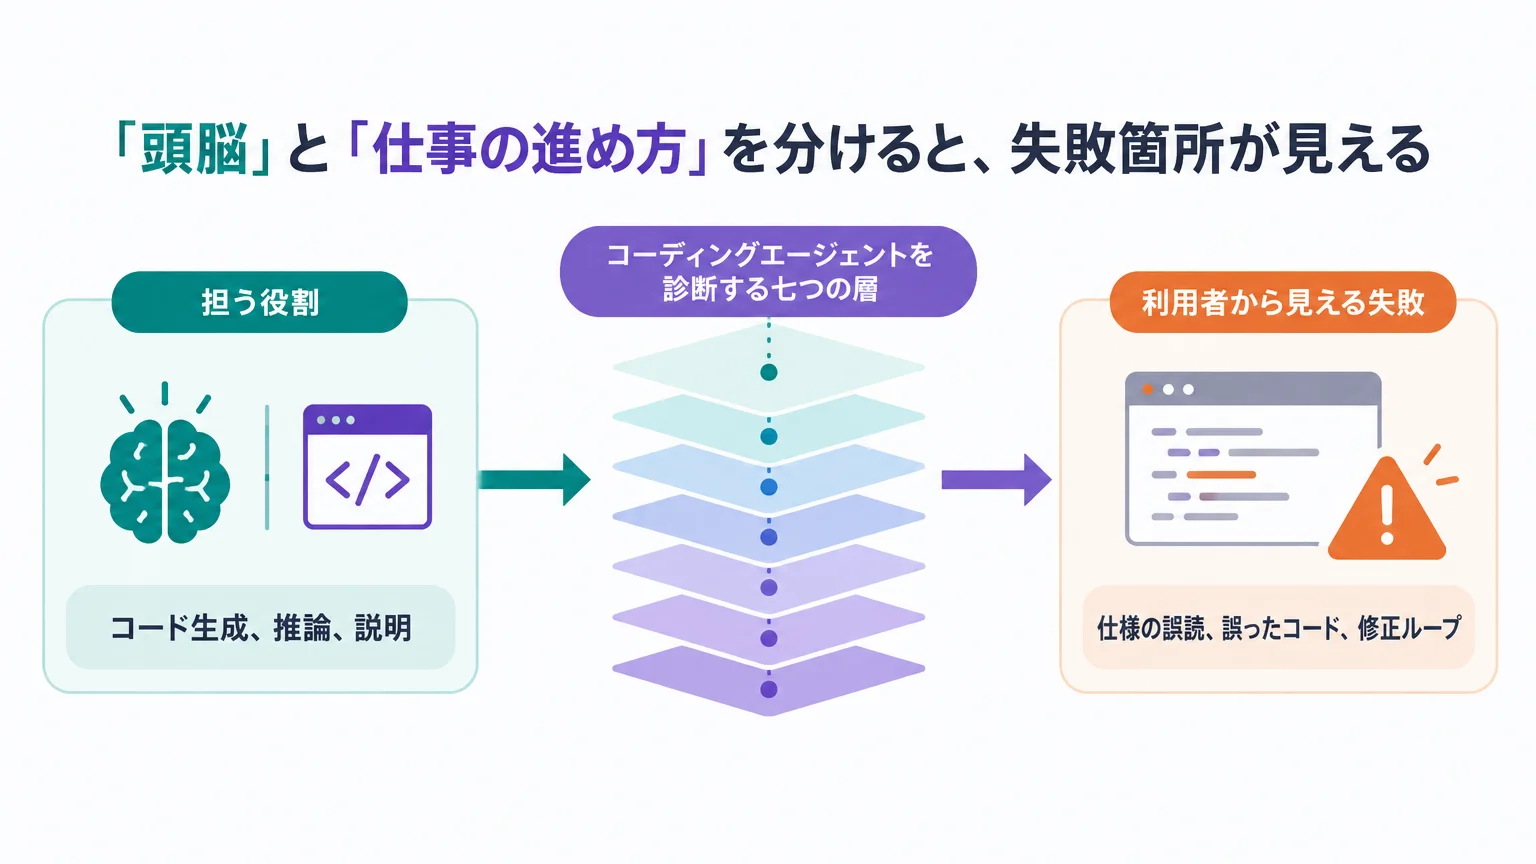
Lynch氏は、モデルを「頭脳」、エージェントをモデルとファイルやコマンドをつなぐ「身体」にたとえています。実務では、さらに細かく分けたほうが診断しやすくなります。コーディングエージェントの出力が悪いとき、原因が常にモデルにあるとは限りません。
| 層 | 担う役割 | 利用者から見える失敗 |
|---|---|---|
| モデル | コード生成、推論、説明 | 仕様の誤読、誤ったコード、修正ループ |
| コンテキスト | 設計判断、規約、関連ファイル、過去の決定を渡す | 既存の設計を無視する、同じ確認を繰り返す |
| ツール接続 | 検索、編集、コマンド、ブラウザ、テストを実行する | 必要な証拠を取得できない、誤ったツールを使う |
| オーケストレーション | タスク分解、順序、並列化、モデルの割り当て | 独立作業を直列に進める、難度に合わないモデルを使う |
| 実行状態 | 中断、再開、質問待ち、タイムアウトを管理する | 軽微な確認で止まり、再開条件も残らない |
| 権限境界 | 読める場所、書ける場所、通信先、秘密情報を制限する | 過剰な許可要求、または不要な場所へのアクセス |
| 検証と表示 | 差分、テスト、ログ、計画、完了証拠を人に示す | 未完了なのに完了と表示する、計画が読みにくい |
この分解が重要なのは、対策が層ごとに違うからです。仕様の理解不足ならモデルや文脈を見直します。テスト待ちの間に別作業を始めないならオーケストレーションの問題です。リポジトリ外を読めるなら、プロンプトではなくOSや実行環境の権限を見直します。
コンテキストの渡し方と圧縮を詳しく見たい方は、コンテキストエンジニアリング完全ガイドで、指示を増やすだけでは解決しない理由を確認できます。
原文が挙げた不満は、六つの運用課題に整理できる
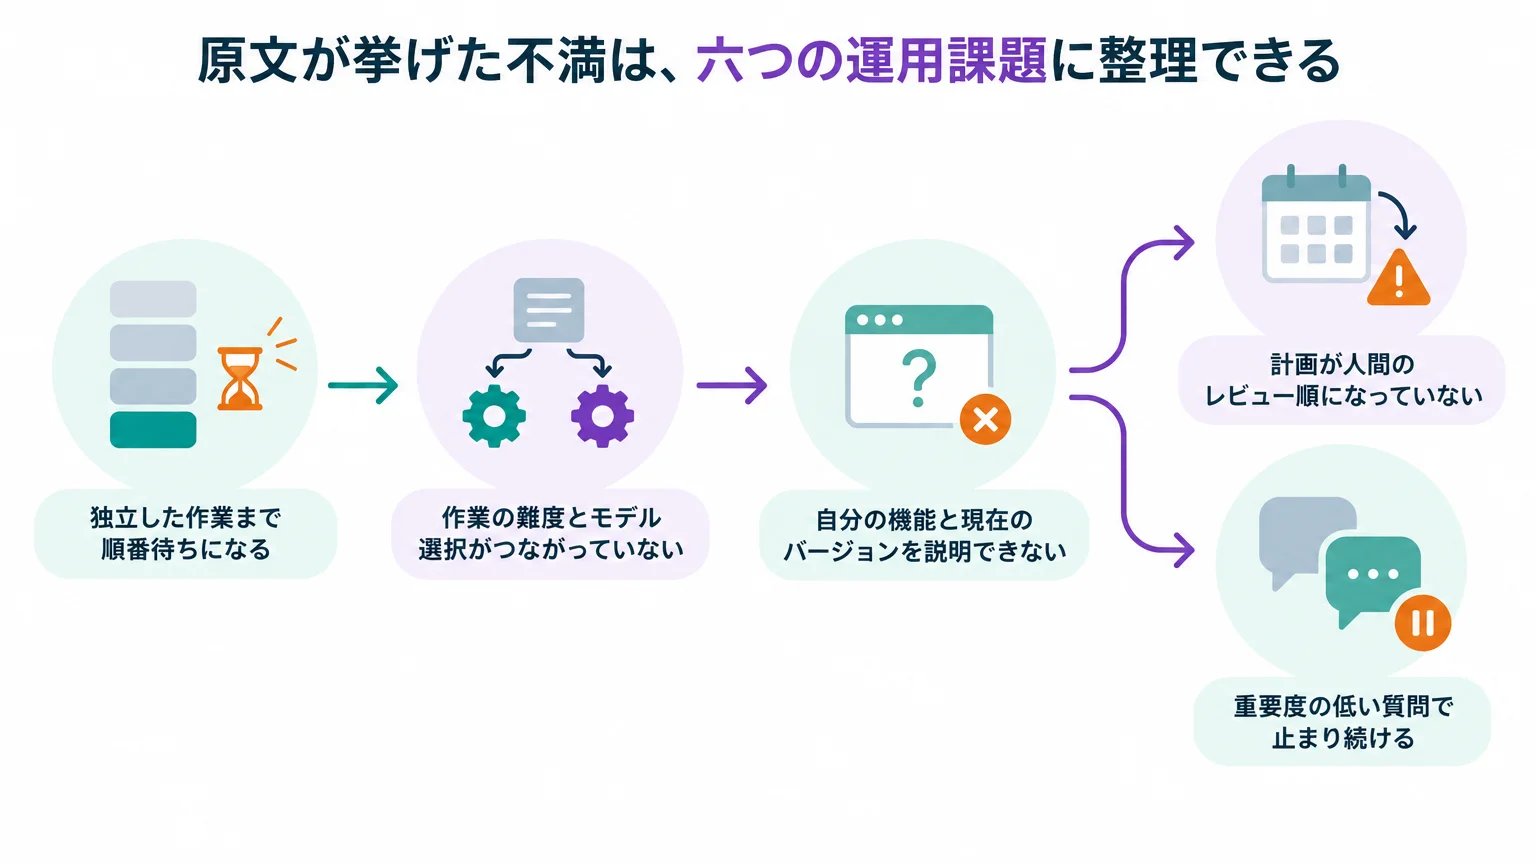
独立した作業まで順番待ちになる
著者は、自身のオープンソースアプリに機能を追加した際、OpenCodeが仕事を複数のサブタスクへ分けたのに、一つずつ処理した例を示しています。また、Claude Codeがテスト終了を待ってからコミットメッセージの規約を調べ始めた経験も紹介しました。ここでの批判は「並列機能が一切ない」ではなく、依存しない仕事と待ち時間を標準状態で十分に重ねられない、という利用体験への評価です。
すべてを並列にすればよいわけではありません。複数の作業が同じファイルを編集すれば競合し、各ワーカーへ文脈を渡すコストも増えます。AnthropicのBuilding effective agentsも、独立したサブタスクには並列化、入力ごとに必要な作業が変わる複雑な変更にはオーケストレーターとワーカーの構成を例示しています。先に必要なのは、並列化の有無ではなく、依存関係を判定する仕組みです。
作業の難度とモデル選択がつながっていない
単純な検索にも高性能で高コストなモデルを使い、反対に難しい判断でも上位モデルへ切り替えない。著者は、このモデル割り当てを人間が細かく管理する負担を問題視しています。企業利用では「自動ルーティングがあるか」だけでなく、選択理由、上限、失敗時の昇格条件、利用量を後から確認できるかまで見る必要があります。
タスク分解と委譲の設計は、マルチエージェント設計パターン完全ガイドで詳しく扱っています。重要なのは、安価なモデルへ回すこと自体ではなく、誤判定したときに戻せることです。
自分の機能と現在のバージョンを説明できない
著者は、エージェント自身の使い方を尋ねても、その場でWeb検索し、インストール済みの版に合うか分からない情報を参照する体験を挙げています。原文から原因までは確認できませんが、モデルの一般知識だけでは製品の現行仕様と一致しない可能性があります。企業側では、製品名を知っているかではなく、利用中のバージョン、管理者設定、社内ルールを含む文書へ到達できるかを確認すべきです。
計画が人間のレビュー順になっていない
原文では、Codexが作った機能追加計画について、抽象度の異なるUI、データ、保存頻度、アクセス制御の判断が並び、人間が全体像を追いにくいと批判しています。各項目が誤りという話ではありません。人間が判断する順番に整理されていないことが問題です。
企業のレビューでは、目的と利用者影響、変更する境界、データの流れ、権限、失敗時の戻し方、個別ファイルの順に降りると確認しやすくなります。計画の長さより、意思決定の順序と未確定事項の明示を評価してください。
重要度の低い質問で止まり続ける
著者は、長い作業を任せた直後、ブランチ名の確認で停止し、翌朝まで進まなかった体験を紹介しています。これは一つの個人体験であり、全製品に同じ挙動があるとは言えません。ただし、長時間実行を導入する組織には、質問の重要度、無回答時の既定動作、保留可能な決定、必ず人に戻す境界を決める必要があると分かります。
便利さと最小権限の間で利用者が疲れる
原文で最も重い論点が権限です。著者は、広いアクセスを与えるか、頻繁な許可操作を続けるかという二択になりやすいと批判し、自然言語の禁止命令ではなく、OSレベルのファイルとネットワーク境界を求めています。ただし、著者個人の秘密情報流出体験を、すべての製品で一般的に起きる事実として扱うことはできません。
日本企業では、リポジトリ単位の隔離、読み取りと書き込みの分離、通信先の許可、秘密情報の注入方式を製品評価に含める必要があります。実装方式の比較は、AIエージェントのサンドボックス設計も参考になります。
公式情報で補正すると、「機能がない」より「既定値と統合」が論点になる
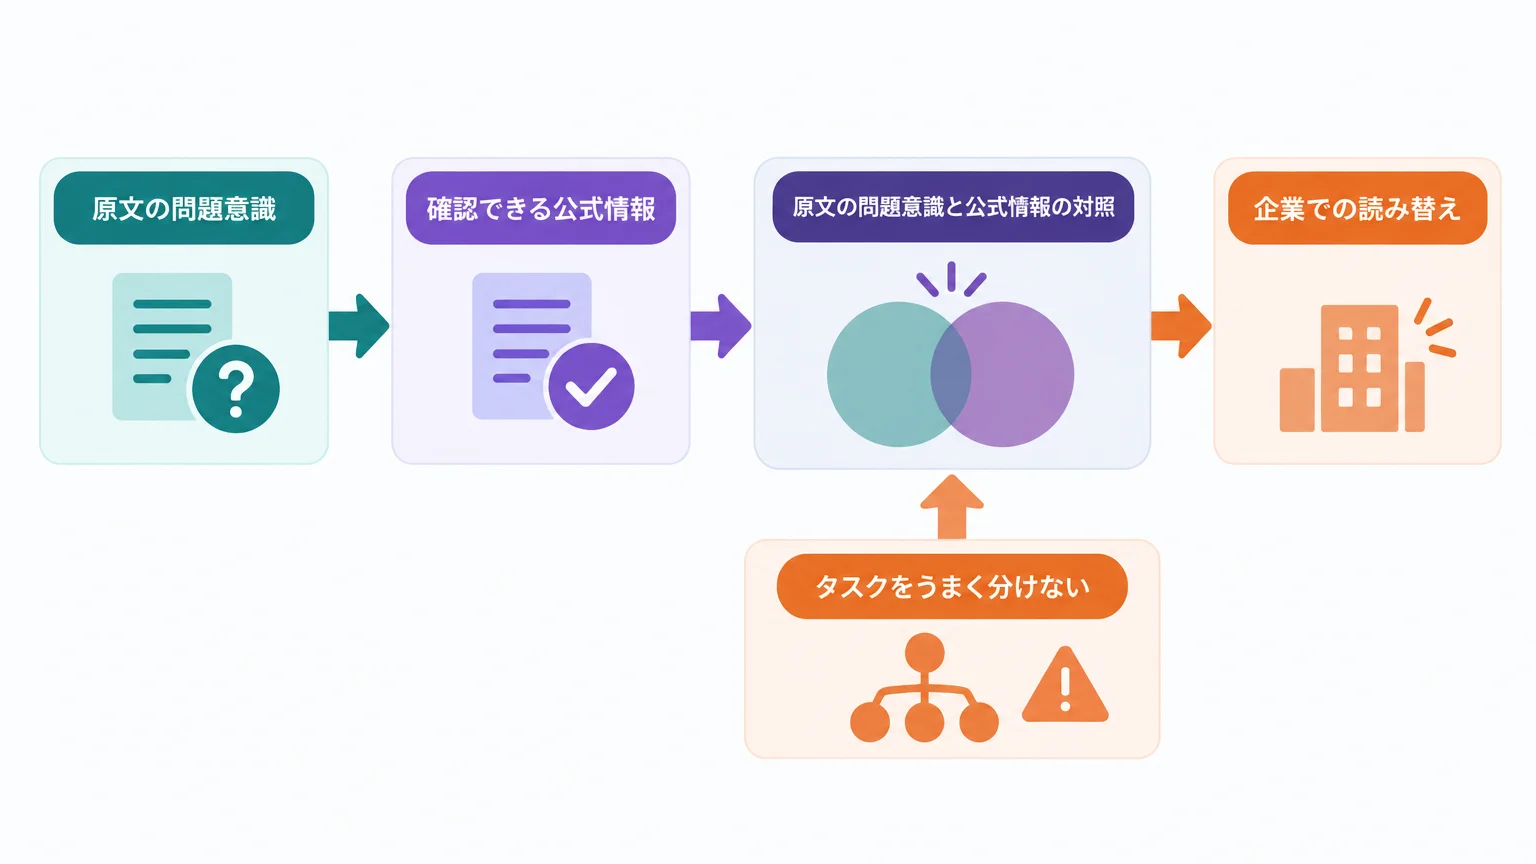
原文の不満をそのまま「現在のツールには機能が存在しない」と読むのは正確ではありません。2026年10月10日時点の公式情報には、並列ワーカーのような実装可能な設計パターンと、文脈管理、実行中の方向修正、サンドボックス、独立レビュー、評価基盤といった製品機能・運用手法の双方が示されています。一方で、設計パターンや機能が示されていることと、初期状態で安全かつ自然に使えることは別です。
| 原文の問題意識 | 確認できる公式情報 | 企業での読み替え |
|---|---|---|
| タスクをうまく分けない | Anthropicは並列化、ルーティング、オーケストレーター・ワーカーを用途別パターンとして説明 | 機能名ではなく、自社課題で分解と合流が正しく働くかを見る |
| 長いセッションで文脈が崩れる | VS Codeは2026年3月5日、共有メモリ、手動コンパクション、セッションの分岐、実行中の方向修正を紹介 | 保持する情報と捨てる情報を運用側で指定できるかを見る |
| 安全境界が弱い | Claude Code公式文書ではサンドボックスは既定で無効。オンにするとOSレベルで書き込み先や通信を制限でき、作業ディレクトリ外の読み取りを止める設定もある | 「サンドボックスあり」だけでなく、既定値、読取範囲、例外設定、管理者ロックを確認する |
| 許可確認が多い | OpenAIは2026年4月30日、境界を越える操作を別エージェントが審査するAuto-reviewの設計を公開 | 実行役と承認役を分け、拒否後に安全な代替経路へ戻れるかを見る |
| 完了の証拠が弱い | Anthropicは2026年1月9日、コード判定、モデル判定、人間判定を組み合わせるエージェント評価を説明 | エージェント自身の完了宣言を、独立した証拠で照合する |
Claude Codeの公式サンドボックス文書は、原文のセキュリティ批判を読むうえで特に重要です。現行文書では、サンドボックスが既定で無効であり、有効化しても既定の読み取り範囲は広いと説明されています。一方で、ホームディレクトリを拒否し、現在のプロジェクトだけを再許可する設定や、作業ディレクトリ外の読み取りをまとめて止める設定もあります。したがって「サンドボックスが存在しない」ではなく、「企業が必要とする最小権限が初期状態と運用設定で成立しているか」が正しい確認点です。
OpenAIのAuto-review解説も、別エージェントによる審査を決定論的な安全保証とは位置づけていません。記事は、モデルベースの審査が誤る可能性と、補完的な監視・評価が必要なことを明記しています。レビュー役を追加しただけで安全になったと判断しないことが大切です。
日本企業では、モデル性能より待ち時間と事故半径が経営課題になる
企業が高性能モデルを比較するとき、回答品質や生成速度に目が向きます。しかしコーディングエージェントは、ファイルを読み、コマンドを実行し、状態を変えるシステムです。導入後の成否は、開発者がどれだけ待たされるか、どの範囲まで変更できるか、誤動作がどこで止まるか、証拠を残せるかで変わります。
開発部門には「人間の介入理由」が見えることが重要
質問回数だけを減らすと、危険な判断まで自動化しかねません。記録すべきなのは、どの判断で止まったか、その判断は保留できたか、再開時に文脈が残ったかです。ブランチ名のように後から変えられる判断と、本番データ削除のように戻しにくい判断を同じ承認フローへ入れるべきではありません。
セキュリティ部門には「プロンプトの禁止事項」より強制境界が必要
「秘密情報を読まないでください」は運用方針として必要でも、アクセス制御そのものではありません。読めないファイル、書けない場所、接続できない宛先を実行環境で定義し、エージェントの判断と切り離します。追加権限はセッション単位にし、読み取り専用と読み書きを分けます。
品質保証には「テストに通った」以外の証拠もいる
テストは重要ですが、エージェントが変更したテストだけで自分の実装を判定すると、仕様の取り違えを見逃すことがあります。既存テスト、型検査、静的解析、差分レビュー、受け入れ条件、人間の確認を別々に記録すると、どこで不合格になったかを追えます。Anthropicのエージェント評価ガイドも、単一の評価方法ではなく複数の判定方法を組み合わせる考え方を示しています。
調達部門には「モデル名」ではなく構成の変更履歴が必要
同じ製品名でも、モデル、システム指示、権限、ツール、拡張機能、管理者設定が変われば結果は変わります。評価時には構成と日付を残し、製品のベンチマークを自社リポジトリでの結果へ読み替えないでください。AIコーディング支援の効果を研究と現場で分けて考えるには、AIコーディングツールは本当に速い?最新研究の意外な結論も参考になります。
導入判断を一回のデモから切り離す評価表
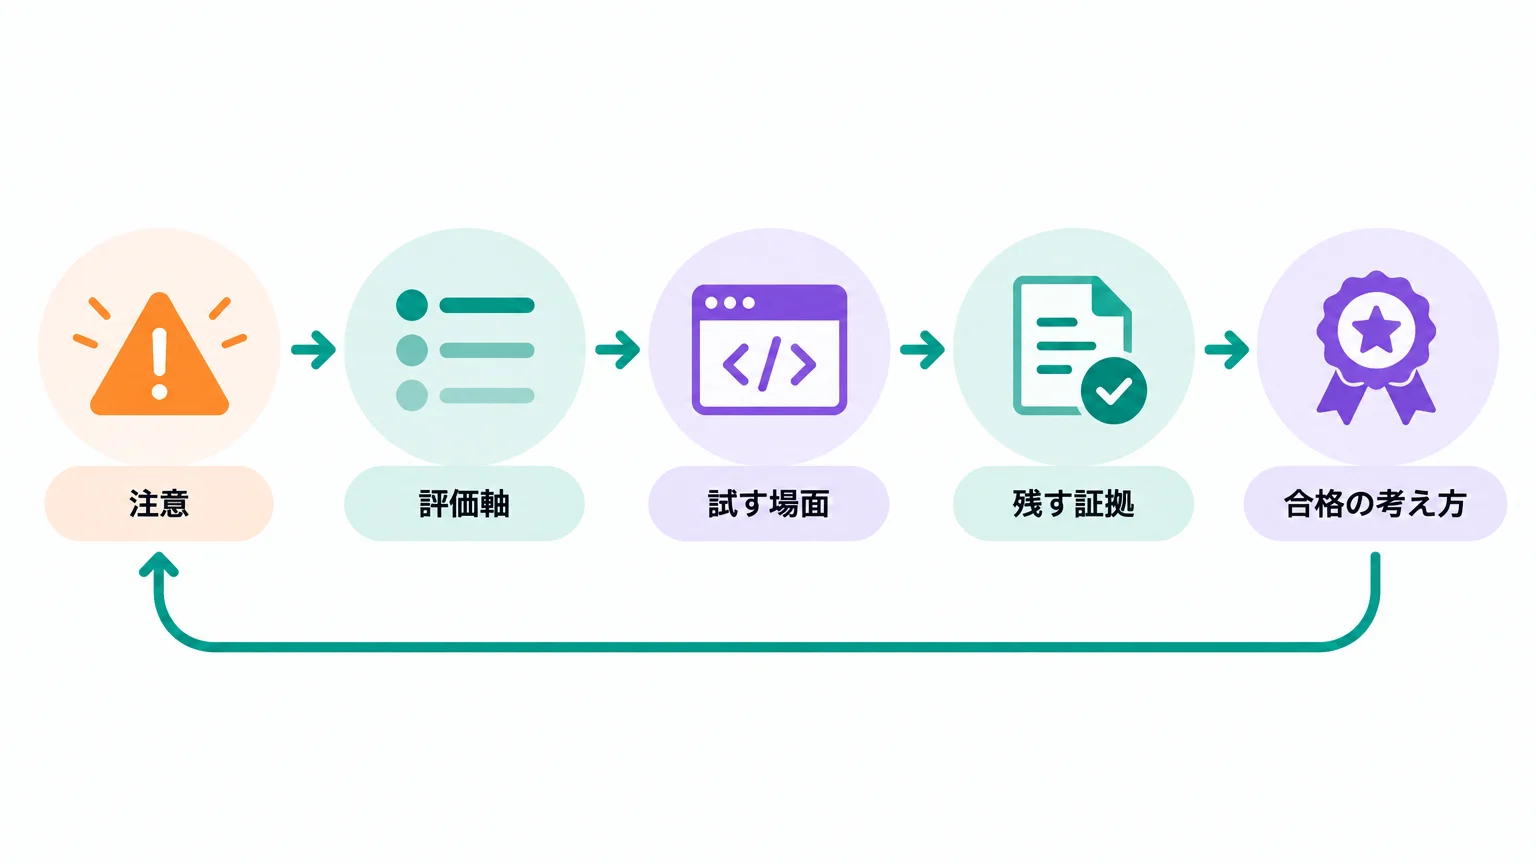
評価の単位は「このモデルは賢いか」ではなく、「この構成で、この仕事を、証拠付きで完了できるか」にします。Microsoftは2026年6月2日、組織の方針を具体的な評価ケースへ変換するASSERTと、入力・モデル・状態・ツール実行・出力の各地点へ制御を置くAgent Control Specificationを発表しました。製品を問わず、自社の要件をテスト可能な形へ変えるという考え方が参考になります。
| 評価軸 | 試す場面 | 残す証拠 | 合格の考え方 |
|---|---|---|---|
| タスク理解 | 曖昧さのある実際の修正依頼 | 質問、前提、変更対象 | 重要な不明点だけを質問し、勝手な範囲拡大をしない |
| 文脈利用 | 社内規約と例外があるリポジトリ | 参照した指示・設計文書 | 適用した規約と例外の根拠を説明できる |
| 分解と委譲 | 独立作業と依存作業が混ざる変更 | 依存関係、担当、合流ログ | 競合を避けつつ、待ち時間を別作業へ使える |
| 完了判定 | テスト追加を含む機能修正 | 差分、既存テスト、新規テスト、失敗ログ | 実装者の自己申告だけで完了にしない |
| 権限 | 作業範囲外のファイルと未許可通信を置く | 拒否ログ、承認履歴、通信先 | 方針違反を自然言語ではなく実行環境が止める |
| 回復 | コマンド失敗、テスト失敗、質問待ち | 再試行、代替手段、中断理由 | 同じ失敗を無限に繰り返さず、安全に人へ戻せる |
| 説明可能性 | 設計変更を含む作業 | 高水準の計画、データ流れ、最終差分 | 担当者が実装詳細へ入る前に影響を判断できる |
評価条件は、会話の中だけでなくファイルとして固定します。次は特定製品の設定仕様ではなく、チーム内で条件をそろえるための記入例です。
task:
  objective: "対象機能の不具合を修正し、根拠を残す"
  allowed_paths:
    - "src/"
    - "tests/"
  required_evidence:
    - "変更差分"
    - "既存テストの結果"
    - "追加した検証の結果"
  prohibited_actions:
    - "外部送信"
    - "本番反映"
    - "指定外ディレクトリの変更"
  escalation:
    - "仕様が競合したら停止して質問"
- "戻しにくい操作は実行前に承認を得る"注意:これはベンダー固有の設定ファイルではありません。実際に使う際は、対象ツールの公式文書に合わせて実装し、本番環境で使用する前に必ずテスト環境で動作を確認してください。
小さな検証は「同じ課題・違う制御」で始める
- 代表的で低リスクな課題を選ぶ:自動テストがあり、本番反映を伴わず、正否を人が確認できる変更を使います。簡単すぎる一発生成だけでは、停止・回復・文脈維持を評価できません。
- 課題と成功条件を固定する:対象ファイル、変更してよい範囲、禁止操作、必要な証拠を先に記録します。モデルへ渡す条件を毎回変えると、改善要因を判断できません。
- 構成を一つずつ変える:モデル、指示、ツール、サンドボックス、レビュー方式を同時に変えず、同じ課題で差を確認します。単発の成功ではなく、複数回の軌跡を見ます。
- 結果ではなく軌跡も保存する:成功・失敗だけでなく、読んだファイル、実行したコマンド、質問、拒否、再試行、テスト、最終差分を残します。失敗がモデル、ハーネス、評価器のどこで起きたかを分けます。
- 境界を先に狭くする:読み取り専用から始め、必要な書き込み先だけを許可します。外部通信、秘密情報、本番操作は別の権限として扱います。
- 独立した検証者を置く:実装を行ったエージェントとは別のテスト、ルール、レビュー担当が完了を判定します。自動判定で曖昧な箇所は人へ戻します。
評価項目の作り方をさらに具体化するなら、AIエージェントのテスト・評価設計ガイドを併用してください。元記事の不満を、自社で再現可能なテストケースへ変えることができます。
コミュニティの反応は、賛成一色ではない
Hacker Newsの議論では、複雑な実務で同じ摩擦を感じるという共感がある一方、現在の製品機能や拡張で一部は解消できるという反論も出ています。これは「記事が正しい/間違い」の投票結果ではなく、標準状態に何を求めるか、利用者側の設定をどこまで前提にするかの違いとして読むのが妥当です。
共感側は、長期の整合性とレビュー負担を問題にした
単純な一回の作業では便利でも、長く続く設計、保守しやすさ、複数工程の追跡では苦労するという声がありました。生成速度が上がるほど、人間が内部構造を理解できず、レビューの負担が後から増えるという懸念も示されています。
反論側は、機能とカスタマイズを挙げた
サブエージェント、スキル、ローカルツール、サンドボックス、拡張可能なエージェントを使えば、原文の不満の一部は軽減できるという体験談があります。これに対して著者は、「利用者が自分で作れば解決できるか」ではなく、「標準状態で一般的な開発フローを備えるべきではないか」が論点だと補足しています。
並列化には、速度以外のコストがあるという指摘も出た
サブエージェントを増やすと、文脈の再取得、連絡、競合、テスト干渉、利用上限の消費が増えるという指摘です。作業の難度を事前に正確に予測できないため、常に自動ルーティングすれば解決するわけではないという反論もありました。
これらはコミュニティ参加者の意見であり、製品仕様や性能を裏付ける資料ではありません。ただし、評価表に「標準状態」と「カスタマイズ後」を分ける必要があることは分かります。導入担当者が多くの拡張を保守しなければ期待性能が出ないなら、その保守も総コストに含めるべきです。
運用で繰り返しやすい判断ミスと直し方
失敗:出力が悪いと、すぐ上位モデルへ替える
❌ モデルの能力不足と決めつけ、モデルだけを変更する。
⭕ まず、必要なファイルが渡っていたか、ツールが正しく動いたか、完了条件が機械判定できたか、権限で処理が止まっていないかを確認する。
なぜ重要か:原因がハーネスにある場合、モデルを替えても欠損した文脈と権限設計は残り、同じ失敗が再発する可能性があります。
失敗:禁止事項をプロンプトだけに書く
❌ 「秘密情報を読まない」「外部へ送らない」と指示して安全境界にする。
⭕ ファイル、ネットワーク、秘密情報、外部操作を実行環境で制限し、例外だけを明示承認する。
なぜ重要か:自然言語の指示は挙動を導くものですが、アクセス自体を不可能にする制御とは役割が違います。
失敗:一度成功したデモを再現性とみなす
❌ きれいな一回の実行や公開ベンチマークだけで採用を決める。
⭕ 同じ課題を複数回実行し、失敗軌跡、介入理由、差分、検証結果、構成変更も保存する。
なぜ重要か:エージェントは多段の処理を行うため、途中の小さな違いが最終結果へ積み重なります。成功率だけでは修理箇所が分かりません。
失敗:「完了しました」を完了証明にする
❌ エージェントの報告文だけでチケットを閉じる。
⭕ 変更差分、既存テスト、追加検証、未解決事項、実際の成果物を独立して確認する。
なぜ重要か:原文が指摘した「作業がほとんど進んでいないのに完了を宣言する」という摩擦は、完了条件を外部化すれば検知しやすくなります。
失敗:許可を全部なくすか、全部人に聞くかの二択にする
❌ 調査から本番操作まで同じ承認ルールを使う。
⭕ 読み取り、ローカル変更、外部送信、本番反映、削除、秘密情報利用を分け、影響が大きい境界だけで止める。
なぜ重要か:承認が多すぎると形骸化し、少なすぎると事故半径が広がります。操作の可逆性と外部影響で境界を決めます。
よくある質問
Why are coding agents so dumb? の答えは何ですか?
元記事の答えは、モデル自体より、モデルをタスク、文脈、ツール、権限、検証へ接続するハーネスが利用体験のボトルネックになっている、という指摘です。ただし、これは著者の経験に基づく論評であり、すべての製品に共通する実証結果ではありません。
ハーネスとは何ですか?
モデルへ入力を渡し、ファイルやコマンドなどのツールを使わせ、状態を保持し、権限を適用し、結果を人へ返す周辺システムです。同じモデルでも、ハーネスの設計と設定が違えば、作業の進み方と安全性は変わります。
高性能なモデルへ替えれば解決しますか?
モデルの理解力が原因なら改善する可能性があります。しかし、必要な文脈がない、作業を誤って直列化する、権限で止まる、完了条件がないといった問題はモデル変更だけでは解決しません。失敗軌跡から層を特定してください。
サブエージェントは常に並列実行すべきですか?
いいえ。依存しない調査やファイル群には有効ですが、同じファイルや状態を変更する作業は競合します。依存関係、合流方法、共有する文脈、利用量を設計してから使います。
サンドボックスがあれば安全ですか?
保証にはなりません。何を読めるか、どこへ書けるか、どの通信先へ接続できるか、秘密情報をどう扱うか、例外を誰が設定できるかを確認してください。公式文書も、広い例外設定やネットワーク制御には限界があることを説明しています。
企業は最初に何を検証すべきですか?
自動テストがあり、本番へ影響しない代表課題を選びます。成功条件と禁止操作を固定し、同じ構成で複数回実行して、差分、テスト、質問、拒否、再試行を保存してください。その後、一つの制御だけを変えて比較します。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Why Are Coding Agents So Dumb? — Michael Lynch、2026年10月9日公開(参照日:2026年10月10日)
- Why are coding agents so dumb? | Hacker News — コミュニティの反応。製品事実とは分けて参照(参照日:2026年10月10日)
- Building effective agents — Anthropic、2024年12月19日公開(参照日:2026年10月10日)
- Demystifying evals for AI agents — Anthropic、2026年1月9日公開(参照日:2026年10月10日)
- Configure the sandboxed Bash tool — Claude Code公式ドキュメント(参照日:2026年10月10日)
- Making agents practical for real-world development — Visual Studio Code、2026年3月5日公開(参照日:2026年10月10日)
- Auto-review of agent actions without synchronous human oversight — OpenAI、2026年4月30日公開(参照日:2026年10月10日)
- Build agents you can trust across any framework with open evals and a control standard — Microsoft、2026年6月2日公開(参照日:2026年10月10日)
最後に確認すべきこと
「Why are coding agents so dumb?」が投げかけた本質は、より賢いモデルを待つだけでよいのか、という問いです。日本企業が持ち帰るべき答えは、モデルを低く評価することでも、エージェントへ仕事を丸投げすることでもありません。
- モデル、ハーネス、コンテキスト、権限、評価を別々に診断する
- 標準状態とカスタマイズ後の性能・保守負担を分ける
- プロンプトではなく実行環境で事故半径を制限する
- 完了宣言ではなく差分・テスト・成果物を確認する
- 公開ベンチマークではなく自社の代表課題で再現性を見る
ツール選定から始める場合はAIエージェントツール比較12選、評価設計から始める場合はAIエージェントのテスト・評価設計ガイド、権限制御から始める場合はAIエージェントのサンドボックス設計へ進むと、次の作業を具体化できます。
自社の開発業務で、モデル比較だけでは見えない停止条件・権限・完了判定まで整理したい方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
この記事はAIgent Lab編集部がお届けしました。