2026年11月19日時点で、Gemini 4 Neon を Gemini API から呼ぶモデル ID は gemini-4-neon、単価は有料枠の Standard で入力 $3.00・出力 $15.00(100 万トークンあたり。出力には思考のトークンを含む)で、無料枠では使えません(Gemini API の料金のページ・What’s new in Gemini 4 Neon)。Google は 2026年11月18日(米国の日付)に Gemini API で一般提供(GA)を始め(Gemini API のリリースノート)、同じ日に GitHub Copilot でも一般提供になりました。
この記事の要点(2026年11月19日時点)
- モデル ID:
gemini-4-neon(Stable)。generateContent と Interactions API(会話の状態をサーバー側で持てる API)の両方、Google Cloud(Gemini Enterprise Agent Platform)で同じ ID です(Google Cloud は認証済みの企業の顧客に一部のリージョンで提供)。 - 単価: Standard は入力 $3.00・出力 $15.00・キャッシュの入力(前と同じ先頭部分を再利用した入力)$0.15(100 万トークンあたり)。応答を急がない Batch と Flex は $1.50・$7.50、Priority(標準と Flex より先に処理される区分)は $5.40・$27.00 です。
- 無料枠: なし。課金のアカウントをつないだ有料枠のプロジェクトから呼びます。Google AI Studio の画面は Google AI Pro・Ultra のプランで使えます。
- 窓と思考: 入力・思考・出力で 1,048,576 トークンの窓(コンテキストウィンドウ)を共有し、1 回の同期の出力は 65,536 まで、それ以上は long decode(64K ずつの生成をつないで長く出す仕組み。サーバー側の background か、手元で続きを呼ぶ client-side continuation で動かす)で出します。thinking_level(思考の段階)は low・medium・high(既定)・xhigh の 4 段です。
- Carbon・Hydrogen との違い(Google の説明): Hydrogen と Carbon の間に置かれ、Hydrogen より深く推論し、Carbon より速く作業を終えます。既定の思考は Carbon の medium に対して high です。
- GitHub Copilot: Pro+・Max・Business・Enterprise で選べます(Pro と、年払いのまま従来の課金に残った Pro+ は対象外)。Business と Enterprise は管理者の model policy(使えるモデルを決める設定)次第です。
対象読者:Gemini API か GitHub Copilot で、Carbon・Hydrogen から Neon に替えるか、単価はいくらか、無料枠で試せるか、思考の段階をどう選ぶかを決めたい開発者と開発の責任者。
読み終えたらできること:モデル ID・thinking_level・max_output_tokens・有料枠の準備のうち直す所を、公式の移行のチェックリストに沿って確かめられます。
この記事は、呼び出し方・thinking_level・料金の区分・有料枠の上限・移行で直す引数を、2026年11月19日時点で取得して確認した Google と GitHub の公式ページの範囲で整理します。当社は Neon を実行しておらず、性能の数字は Google の発表の物だけを載せ、コードは公式の例をそのまま写しています。
Gemini 4 Neon の位置づけ|Hydrogen と Carbon の間・API で呼び出せる場所
Google の開発者向けの文書は、Neon を「Gemini 4 Hydrogen と Gemini 4 Carbon の間」に置き、頻度の高い複雑な作業(high-frequency complex tasks)向けのモデルと説明しています(What’s new in Gemini 4 Neon)。発表では、Carbon が最も難しく長期にわたるプロジェクトを、Hydrogen が速い日常の実行を受け持ち、Neon は推論の深さと効率の釣り合いを取る役だと書かれています(Introducing Gemini 4 Neon)。モデルカードによると Neon は Gemini 4 Carbon を元に作られ、知識の締め切りは 2026年3月です(Gemini 4 Neon のモデルカード)。
発表は、Google Antigravity(Google のエージェント型の開発環境)で Neon が単独でも、並列に動く Hydrogen のサブエージェントを指揮する Orchestrator(指揮役)としても動くと書き、長い作業で不要なファイルの読み直しを減らすと説明しています。API では、Gemini Managed Agents(Google がエージェントの実行を受け持つ API)の Antigravity agent が Neon に対応し(単独でも Hydrogen と組んでも使える)、既定の Hydrogen から agent_config の model で替えられます(What’s new・Choosing a model)。
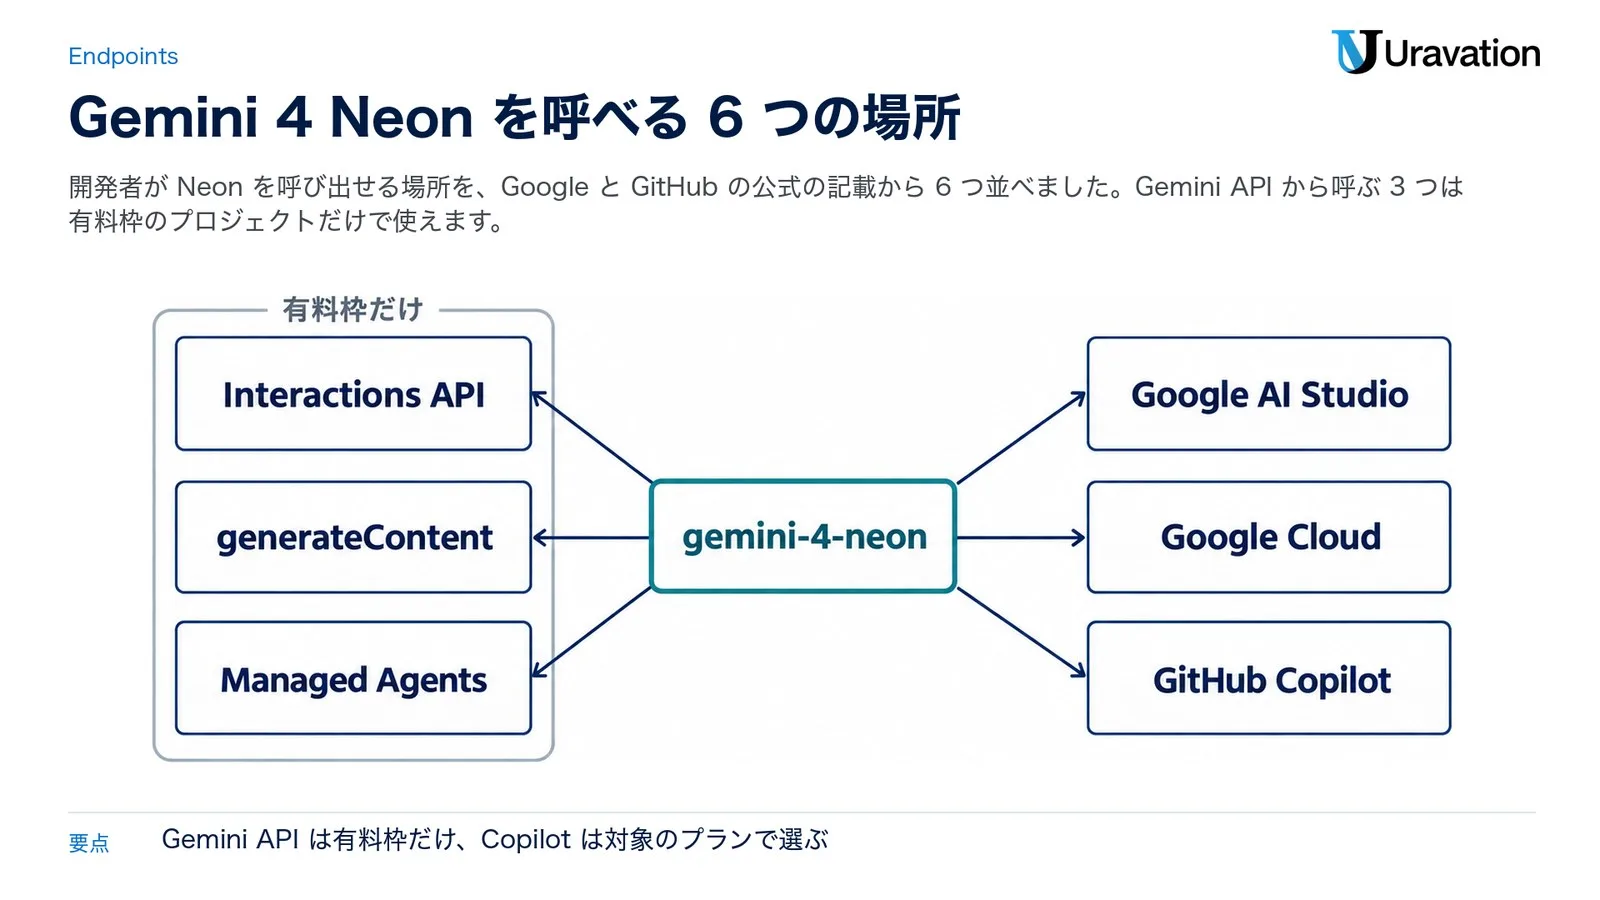
開発者が Neon を呼び出せる場所は次のとおりです(2026年11月19日時点の公式の記載)。
| 場所 | 呼び方 | 条件(公式の記載) |
|---|---|---|
| Gemini API の Interactions API | client.interactions.create(model="gemini-4-neon", …) |
有料枠のプロジェクトだけ。会話の状態をサーバー側に持てる(previous_interaction_id) |
| Gemini API の generateContent | client.models.generate_content(model="gemini-4-neon", …) |
有料枠だけ。Batch API はこちらの API だけで使える |
| Google AI Studio の画面 | モデルの一覧から選ぶ | Google AI Pro・Ultra のプラン |
| Google Cloud(Gemini Enterprise Agent Platform) | 同じモデル ID。リージョンは global と us・eu(マルチリージョン) | GA。「信頼性・容量・安全のため、認証済みの企業の顧客に一部のリージョンで提供」 |
| Gemini Managed Agents(Antigravity agent) | agent_config の model を指定 |
Antigravity agent はプレビュー(antigravity-preview-09-2026)。既定は Hydrogen。Neon は単独か Hydrogen と組む(Neon は Gemini API の有料枠だけ) |
| GitHub Copilot | モデルピッカーで選ぶ | Pro+・Max・Business・Enterprise(年払いのまま従来の課金に残った Pro+ を除く) |
出典: What’s new・Batch API・Antigravity agent・Google Cloud のモデルのページ・GitHub の changelog・GitHub Docs の年払いのプランのページ。このほか発表は、Gemini API の有料枠を Android Studio からも使えるとし、Gemini for business(企業向けの Gemini。API とモデルの選択欄から)、Antigravity の製品(有料の Google AI Pro・Ultra)、Gemini アプリ(Pro・Ultra)にも順次出ると書いています。
発表は Artificial Analysis(AI モデルを比べる第三者の評価機関)の Coding Agent Index で 58.6 の 1 位、Terminal-Bench 4.1 で 65.2% などの数字を挙げています。ただ SWE-sweep(発表が本番向けのコードの項で挙げる評価)は、mini-SWE のハーネス(モデルを動かす評価用の仕組み)で 12.8%(発表はこの条件でも首位と記載)、Antigravity のハーネスで 39.0% と、ハーネスによって大きく変わるので、自社の環境で同じ値が出るとは限りません(当社は測っていません)。
発表にある Gemini 4 Neon for cyber は、Fairwind Program(防御側の専門家向けの Google のプログラム)の対象者に向けて順次提供が始まる別の枠(発表は「今後数日で」と記載)で、一般の Gemini API の機能ではありません。Fairwind Program への参加は、Google Cloud のアカウントチームに問い合わせると書かれています。
モデル ID と呼び出し方|gemini-4-neon と thinking_level
モデルのページでは、モデル ID は Stable 版の gemini-4-neon 1 つ(最終更新は 2026年11月)で、入力はテキスト・画像・動画・音声・PDF、出力はテキストです。function calling(関数の呼び出し)・structured outputs(スキーマに沿った JSON の出力)・コードの実行・computer use(画面の操作)・Google 検索の grounding(検索結果に基づく回答)などに対応し、画像と音声の生成、Live API、明示的なキャッシュには対応していません(Gemini 4 Neon のモデルのページ)。
最小のコード(公式の Quickstart の形)
API キーは Google AI Studio の API keys のページで作ります。環境変数と SDK の準備は、Getting started に載っている次の 2 行です。
export GEMINI_API_KEY="YOUR_API_KEY"
pip install -U google-genai
What’s new のページの Quickstart は Interactions API の形で、何も指定しなければ thinking_level は high、同期の出力の上限は 64K(65,536 トークン)です。当社はこのコードを実行していないので、本番環境で使う前にテスト環境で動作を確かめてください。
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
)

print(interaction.output_text)
generateContent のコードでは、model を gemini-4-neon にし、思考の段階は thinking_config(types.ThinkingConfig の thinking_level)で指定します(Gemini thinking の generateContent 版の例)。SDK の基本は Gemini API完全ガイド|PythonとFunction Calling でも扱っています。
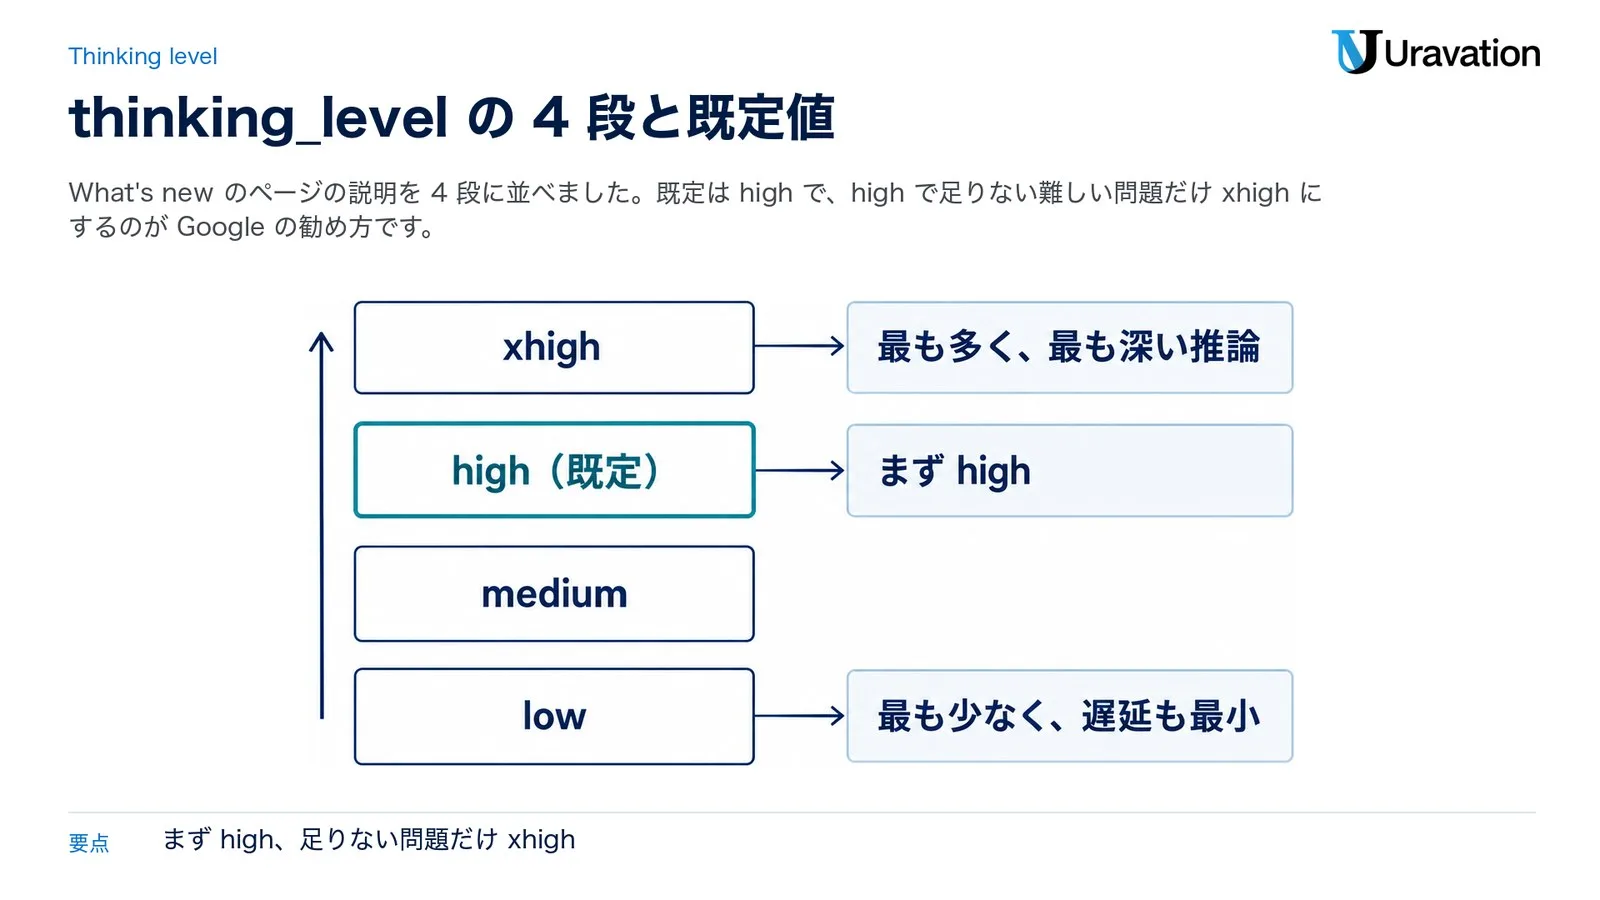
thinking_level の 4 段
What’s new のページは thinking_level を品質・遅延・トークンの量を決める主な設定とし、4 段を次のように説明しています(訳は当社)。
| 段階 | トークンの使い方 | 公式が挙げる使いどころ |
|---|---|---|
| low | 最も少なく、遅延も最小 | 速いチャットや大量の処理。エージェントの作業もこなせる |
| medium | 少なめで、応答が速い | 対話しながらのコーディング、UI の試作、速さが要るツールの呼び出し |
| high(既定) | 知能と速さの釣り合い | 多くの作業の既定として推奨。複雑なコーディング、エージェントの実行 |
| xhigh | 最も多く、最も深い推論 | high で足りない難しい多段の問題。遅延とトークンの増加を受け入れられる時だけ |
Google の勧め方は「まず high、足りない問題だけ xhigh」で、4 段すべてを max_output_tokens を高くして評価し、品質を満たす最も低い段を選ぶ手順です。xhigh はテキストや JSON の抽出のような簡単な指示で考えすぎたり、max_output_tokens を使い切ったりすることがあります(thinking のガイド)。Gemini 3 の一部にあった minimal は Gemini 4 では使えません。Interactions API では段階を generation_config に入れます。次は What’s new のページの REST の例です。
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions and rewrite the lock acquisition logic.",
    "generation_config": {
      "thinking_level": "xhigh"
    }
  }'
出力の上限と long decode
max_output_tokens は思考と出力を合わせた上限です。1 回の同期の応答は 65,536 トークンまでで、それより長く出す時は max_output_tokens を 65,536 より大きく(1,048,576 から入力を引いた値まで)して background を true にするか、最新の SDK の client-side continuation(手元で続きを呼ぶ方法)を使います。background だけで max_output_tokens を指定しないと 65,536 で止まります。公式の目安は、ふつうの作業で 65,536、長い出力や多段の作業で 131,072 か 262,144 です。難しい指示は数分かかるので、background を使うか HTTP のタイムアウトを 15 分以上にします(What’s new)。background の組み方は Gemini APIのbackground実行入門|長時間タスク実装ガイド にまとめています。
料金|無料枠なし・4 つの区分と課金の数え方
料金のページの Neon の表は、無料枠(Free Tier)の欄がすべて「Not available」です。有料枠には Standard・Batch・Flex・Priority の 4 つの区分があり、どれも 100 万トークンあたりのドル建てで、入力した内容が Google の製品の改善に使われることはありません(料金のページ)。
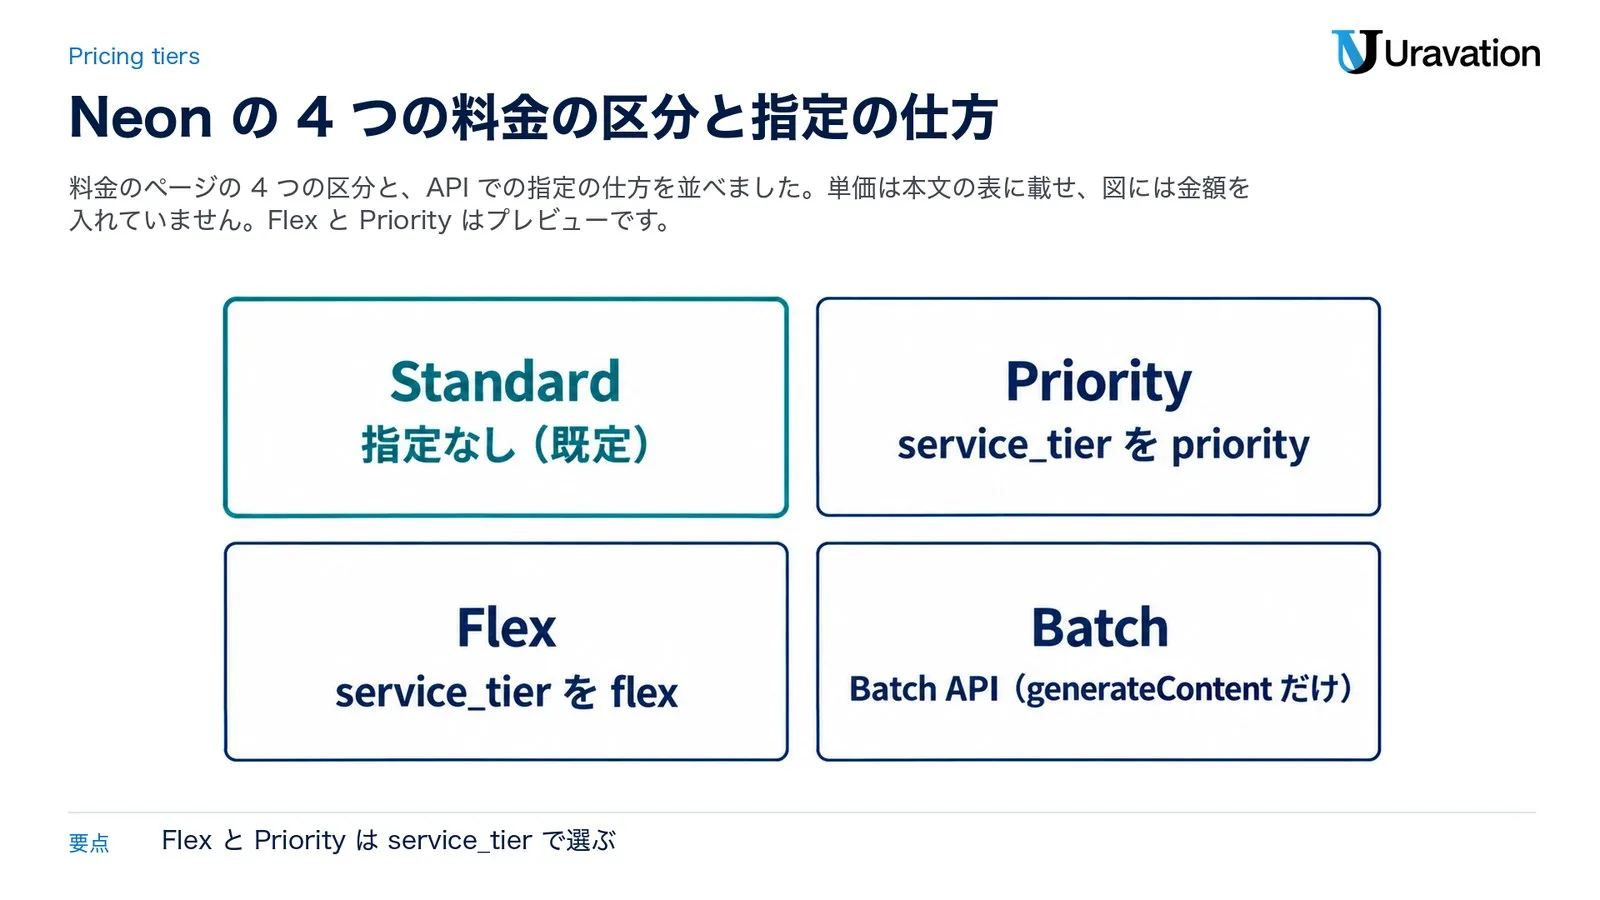
| 区分 | API での指定 | 入力 | 出力(思考を含む) | キャッシュの入力 | docs の待ち時間の目安 |
|---|---|---|---|---|---|
| Standard | 指定なし(既定) | $3.00 | $15.00 | $0.15 | 秒〜分 |
| Priority(プレビュー) | service_tier を priority |
$5.40 | $27.00 | $0.27 | 秒 |
| Flex(プレビュー) | service_tier を flex |
$1.50 | $7.50 | $0.075 | 分(1〜15 分が目標) |
| Batch | Batch API(generateContent だけ) | $1.50 | $7.50 | $0.075 | 24 時間が目標 |
指定の仕方と待ち時間は Flex inference・Priority inference・Batch API の各ページによります。Flex は混んでいない時間の計算資源を使う best-effort(処理の保証がない)の区分で、標準の処理が急に増えると後回しや打ち切りになることがあり、待ち行列で待つこともあるので手元のタイムアウトは 10 分以上が勧められています。Priority は動的な上限を超えた分が Standard の処理に回る区分です。
見積もりで押さえる数え方は次の 4 つです。
- 思考のトークンは出力の単価で数えます。Google 検索などの grounding を使う時は、道具の内部の指示と関数の宣言のトークンも課金されます(料金のページ)。
- 単価は 1M の窓のどこまで使っても同じで、長い入力で単価が上がる段はありません(What’s new)。
- キャッシュは暗黙のキャッシュだけで、Neon では 4,096 トークン以上の入力で自動で働き、当たった分は入力の単価の 95% 引きの $0.15 です。多ターンの会話やエージェントのループでは、新しい依頼が 2,050 トークン以上を足した時だけ前の依頼全体がキャッシュされます。当たった量は
usage.total_cached_tokensで確かめられます(Context caching)。 - Google 検索の grounding は月 5,000 回まで無料(Gemini 3 以降のモデルで共有)、その後は 1,000 回あたり $14 で、Gemini API ではプロジェクトごとに 1 日 1,500 回が既定の上限です(太平洋時間の午前 0 時に戻ります)。1 回の依頼が複数の検索になると、その数だけ課金されます(料金のページ)。
発表は「既定の high で、Artificial Analysis の Intelligence Index で高い得点を取りながら、1 回の作業あたりの費用が Carbon より 32% 低い」と書いていますが、比べた Carbon の思考の段階や、どの時期の単価で計算したかは確認できませんでした。Carbon の Standard の単価は 2026年11月30日まで入力 $2.00・出力 $10.00 の導入価格で、12月1日から $4.00・$20.00 です。Neon に導入価格はありません(Choosing a model)。作業あたりの費用は単価と 1 回の作業で使うトークンの量で決まるので、自社の評価のセットで段階ごとの使用量を測ってから比べてください。
Carbon・Hydrogen との使い分け|API の挙動の違い
Google の Choosing a model のページは、新しいプロジェクトの出発点を Hydrogen とし、Neon は「Hydrogen では足りず、Carbon の追加の検証までは要らない」複雑なソフトウェア開発・密な知識労働・科学のワークフローに選ぶよう書いています。Carbon は 1 ターンに多くの思考トークンを使って仮説を試し、修正をテストで確かめるモデルで、システムの設計・複数ファイルのデバッグ・セキュリティの監査や、速いモデルが行き詰まった時に向くとされています(Choosing a model)。大量の翻訳・要約・JSON の抽出なら Gemini 3.5 Flash-Lite が挙げられています。
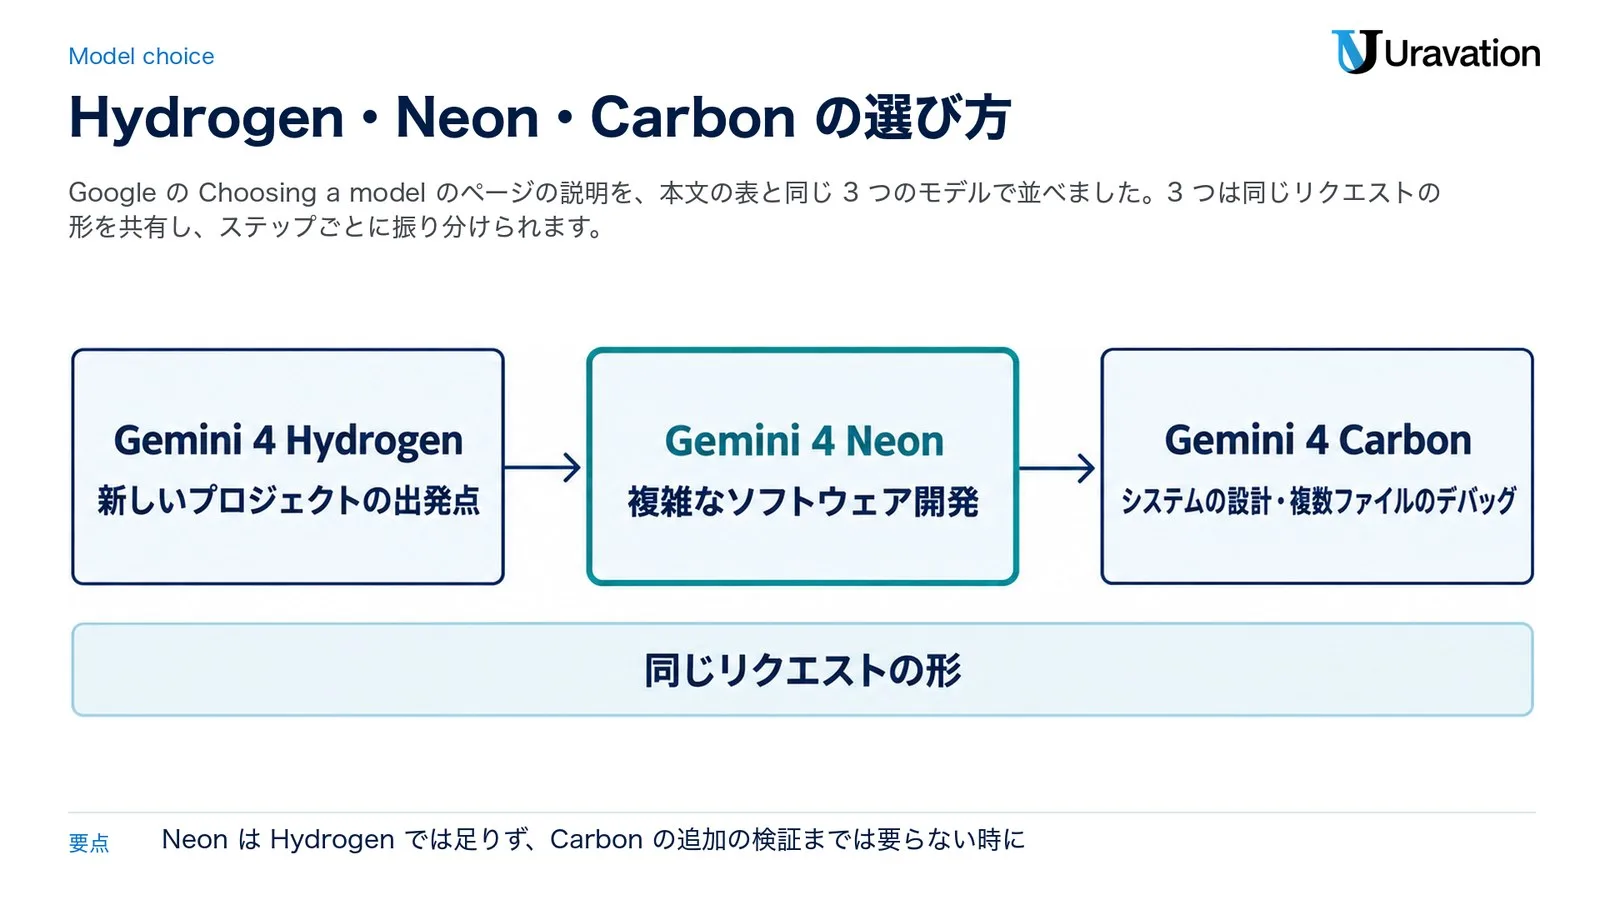
コードを書く側に効く違いを、公式の文書から表にしました。
| 項目 | Hydrogen | Neon | Carbon |
|---|---|---|---|
| モデル ID | gemini-4-hydrogen |
gemini-4-neon |
gemini-4-carbon |
| 既定の thinking_level | high | high | medium |
| xhigh | 使える | 使える | 使えない(上限は high) |
| 非ストリーミングの 1 回の出力 | 65,536 まで | 65,536 まで | 32,768 まで |
| Gemini API の無料枠 | あり | なし | なし |
| docs の速さの表記 | Fast | Moderate | Deliberate |
| Copilot の料金表の分類 | Versatile | Versatile | Powerful |
出典: Gemini thinking・Choosing a model・GitHub の Models and pricing。3 つは同じリクエストの形・1M の窓・組み込みの道具を共有するので、1 つのアプリの中でステップごとにモデルを振り分けられます。Google Cloud の開発者ガイドは、Neon で多段の作業を計画・検証し、previous_interaction_id を渡して Hydrogen のサブエージェントに実行を任せる組み方を挙げています(Developer’s guide to Gemini 4 Neon)。組み合わせは、自社の評価のセットで品質と使ったトークンを比べて決めます。
GitHub Copilot で使う|対象のプランと管理者の model policy
GitHub は 2026年11月18日の changelog で Neon を Copilot の一般提供にし、用途をエージェント型のコーディング・多段の道具の利用・知識労働としています。同じ changelog は「Google によると」として、Carbon に近い質を作業あたり低いトークンの費用で出せる、コーディングの作業では Carbon より応答の始まりが速く頼んでいない変更が少ない、コード・道具・テストの結果について根拠のない主張をしにくい、と紹介しています。これは Google の説明を GitHub が伝えた物で、GitHub 自身の評価ではありません(Gemini 4 Neon in GitHub Copilot)。
選べるのは Copilot Pro+・Max・Business・Enterprise の利用者で、GitHub Docs のプラン別の表では Copilot Pro が対象外です(Supported AI models in Copilot)。年払いのまま従来のリクエスト単位の課金(legacy)に残った Copilot Pro・Pro+ の利用者は、新しいモデルと機能を使えません(Model multipliers for annual plans)。モデルピッカーで選べるのは VS Code・Copilot CLI・Copilot coding agent・github.com・JetBrains IDEs など 10 か所です(一覧は changelog)。提供は順次で、IDE ごとの必要な版は Docs の表で「TBD(未定)」のままです。
料金は usage-based billing(使ったトークンに応じた課金)で提供元の定価のとおり、100 万トークンあたり入力 $3.00・キャッシュの入力 $0.15・出力 $15.00 です。使った分は GitHub AI Credits(1 クレジット=$0.01)に換算され、プランに含まれる分を超えるとこの単価で課金されます。超過を止めるには、Bundled AI credits の予算を $0 にして「Stop usage when budget limit is reached」を有効にします(Models and pricing for GitHub Copilot)。
Business と Enterprise では、管理者が Copilot の設定の model policy で Neon を使わせるかを決めます。既定のモデルの有効化(default model enablement)のままだと、全体の既定を切るかこのモデルを個別に無効にしない限り新しいモデルは自動で有効になります。Neon は 2026年11月18日の一般提供から順次出ているので、既定のままの組織ではもう有効になっていることがあります。評価が済むまで止めたい組織は、model policy で状態を確かめて無効にします。モデルの選び方は Copilotのモデル選択|Haiku 5.5・GPT-6.1 Sol、ポリシーをまとめて管理する方法は CopilotモデルポリシーAPIで一括管理 を参考にしてください。
移行の時に確かめること|Gemini 4 から・Gemini 3 から
What’s new の移行のチェックリストは、Gemini 4(Carbon・Argon・Hydrogen)から移る場合の 3 項目と、Gemini 3 以前から移る場合の 10 項目に分かれ、Gemini 4 どうしならリクエストの形は変えずに済むと書かれています。Choosing a model の移行先の表は、gemini-3.1-pro-preview からの移行先に Neon(いちばん難しい問題は Carbon)を挙げています。次の手順は、What’s new の両方の項目と課金の準備を作業の順に並べ直したものです。
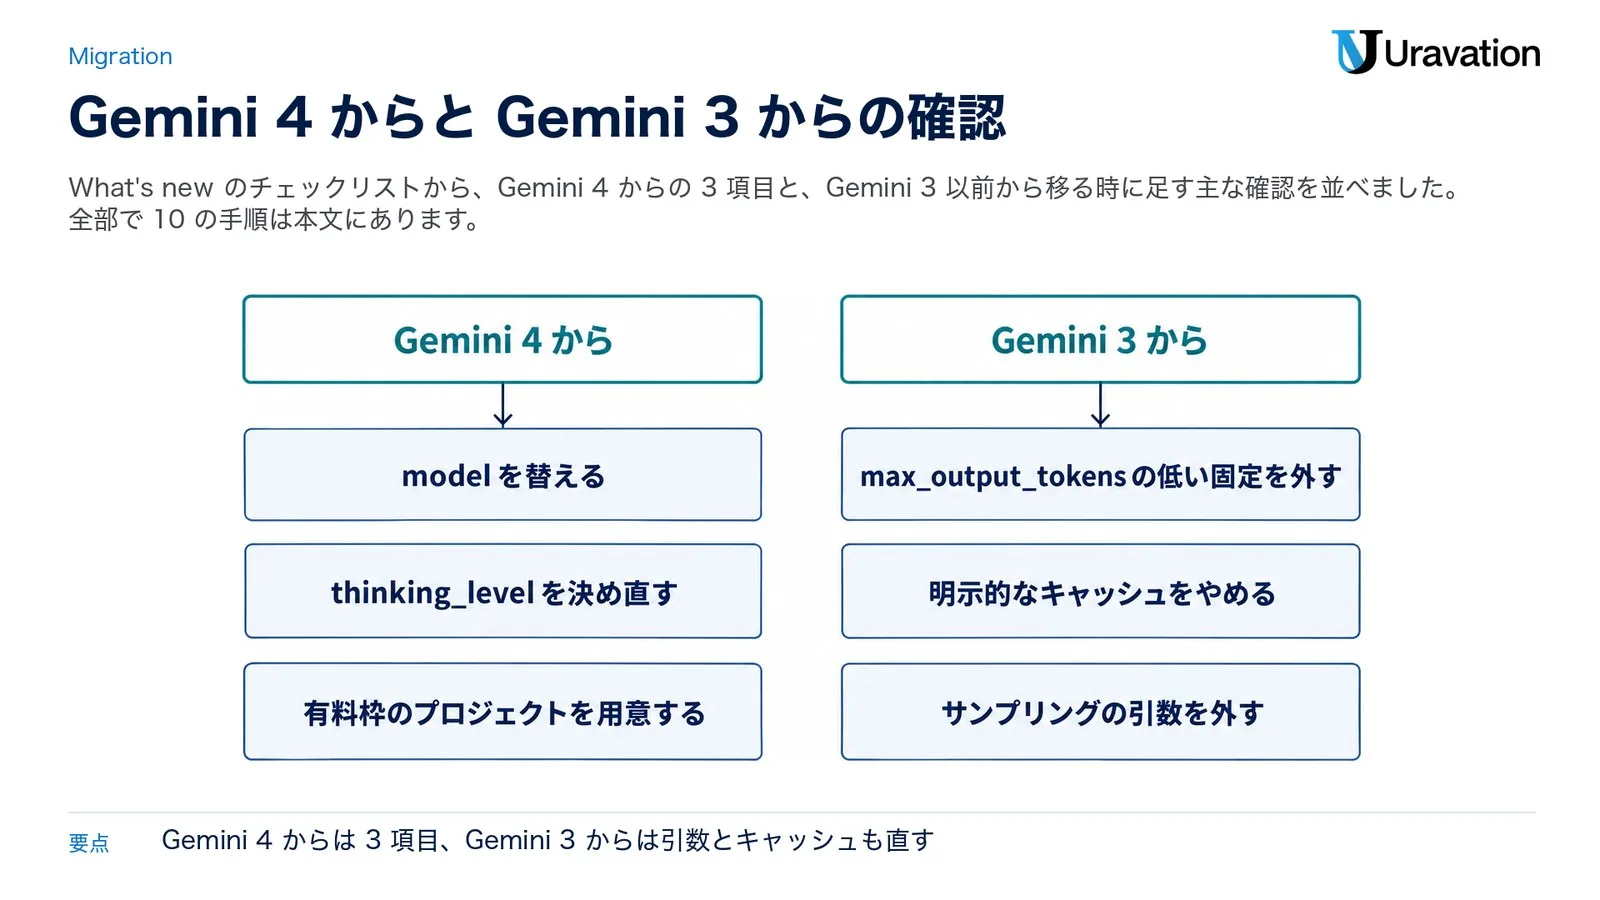
- 有料枠のプロジェクトを用意する: Google AI Studio で課金のアカウントをつなぎ、最低 $5(ほかの通貨では相当額)を前払い(Prepay)すると有料枠に移ります(新しいアカウントの既定。後払いの Postpay を選べる・割り当てられるアカウントもあります)。最初の利用の段階(Tier 1)には月の支出の上限があり、請求の履歴などによっては 10 分ごとの支出のレート制限もかかります(数字は下の「つまずき 4」・Billing・Rate limits)。
- model を替える:
modelをgemini-4-neonにします。 - thinking_level を決め直す: Carbon と Argon は既定が medium で上限が high、Neon は既定が high で xhigh も使えます。指定しないまま Carbon から移ると、既定の段階が一段上がります。Gemini 3 の minimal はエラーになるので外します。
- max_output_tokens の低い固定を外す: 8,192 のような固定は外すか 65,536 に上げ、トークンを減らしたい時は thinking_level を下げます。Gemini 3.8 Flash は入力 1M と出力 64K が別枠でしたが、Neon は入力・思考・出力で 1 つの窓を分け合います。
- 64K を超える出力は background で:
backgroundを true にし、max_output_tokens を 131,072 や 262,144 のように 65,536 より大きくします。HTTP のタイムアウトは 15 分以上にします。 - 明示的なキャッシュをやめる(Gemini 3 から):
cachedContentsとcaches.createは使えないので、リクエストのcached_contentを外します。暗黙のキャッシュは 4,096 トークン以上で自動で働きます。 - サンプリングの引数を外す(Gemini 3 から):
temperature・top_p・top_kは、範囲内の値なら無視され、範囲外なら 400 のエラーになります。 - 道具を宣言する(Gemini 3 から): 道具を宣言せずにシステム指示で生の JSON の呼び出しを出させると
MALFORMED_FUNCTION_CALLが返ることがあります。function calling か structured outputs で宣言します。 - 会話の状態と thought signature を保つ: Interactions API では
previous_interaction_idを使います。generateContent で履歴を手元で持つ場合は、前のモデルのターンと thought signature(推論の続きを保つための暗号化された署名)を毎回そのまま返し、並列のfunctionCallの間で署名を写しません。 - 費用の見積もりを直す: 思考のトークンと、grounding の時の内部の指示・関数の宣言も課金に入れて見積もります。
Antigravity のような skills に対応したコーディングエージェントでは、gemini-api-dev の skill を入れると、次の 1 行でこの移行を任せられると What’s new に書かれています。
/gemini-api-dev migrate my app to Gemini 4 NeonGemini 3 から Gemini 4 へ移す時の考え方は、Gemini 4 Argon API|移行手順と料金の試算 でも扱っています。
【要注意】Gemini 4 Neon の API でつまずきやすい 4 つ
公式の文書の注意書きから、Neon に替える時に起きやすい失敗を 4 つ選びました。
つまずき 1:無料枠のプロジェクトのキーで呼ぶ
❌ Hydrogen を無料枠で試していたプロジェクトのキーのまま、model だけ gemini-4-neon に替える。
⭕ Neon は有料枠だけなので、課金のアカウントをつないだ有料枠のプロジェクトのキーで呼びます。新しいアカウントは最低 $5 を前払い(Prepay)すると有料枠に移り、後払いの Postpay を選べる・割り当てられるアカウントもあります(料金のページ・Billing)。
つまずき 2:max_output_tokens を小さく固定して費用を抑えようとする
❌ 費用を抑えるつもりで max_output_tokens を 8,192 に固定する。思考と出力の合計の上限なので、答えが途中で切れることがあります。
⭕ 65,536 にするか指定を外し、費用は thinking_level を下げて抑えます(What’s new)。xhigh は簡単な抽出でも上限を使い切ることがあるので、段階と上限を一緒に評価します。
つまずき 3:前の世代の書き方を残す
❌ thinking_level の minimal、thinking_budget、temperature、cached_content をリクエストに残したまま移す。
⭕ minimal は Gemini 4 では使えません。thinking_budget は Gemini API では非推奨で、単独なら近い thinking_level に置き換えて警告を返し、thinking_level と一緒に送ると 400 になります。Google Cloud では thinking_budget か MINIMAL を送ると HTTP 400 です。temperature・top_p・top_k は、Gemini API では範囲外の値が 400 になり、Google Cloud のページは独自の値を無視する(固定)と書いています。明示的なキャッシュはどちらも非対応です(What’s new・Gemini thinking の generateContent 版・Google Cloud のモデルのページ)。
つまずき 4:有料枠にした直後に大きな評価を一度に流す
❌ Tier 1 のまま、xhigh や long decode の評価を一度に大量に流す。
⭕ 10 分あたり $10 の支出のレート制限(かかる場合があり、超えると 429 RESOURCE_EXHAUSTED)、請求のアカウント全体で月 $250 の上限(達すると翌月 1 日まで、つないだ全プロジェクトが停止・引き上げの申請は可)、Batch の待ち行列の上限(Tier 1 の Neon は 5,000,000 トークン)の 3 つを先に確かめます。急がない評価は Batch か Flex に回します(Flex は空きがないと 503 で失敗し、Standard には自動で切り替わらないので、再試行を手元で組みます)。プロジェクトごとの月の上限も AI Studio の Spend のページで設定できます(実験的な機能)が、請求の反映が 10 分ほど遅れるので上限を超えて課金されることがあり、Batch やエージェントの長い処理も上限を超えることがあります。前払い(Prepay)の残高が $0 になると、その請求のアカウントにつないだ全プロジェクトのキーが一斉に止まり、クレジットを足すまで HTTP 402 が返ります(Billing・Rate limits・Flex inference)。
よくある質問
Gemini 4 Neon API は無料枠で試せますか?
試せません。料金のページの Neon の表は無料枠の欄がすべて「Not available」で、API で使うには課金のアカウントをつないだ有料枠のプロジェクトが要ります。新しいアカウントは最低 $5(ほかの通貨では相当額)の前払いが既定で、後払いの Postpay を選べる・割り当てられるアカウントもあります(Billing)。Google AI Studio の画面で試す場合は Google AI Pro・Ultra のプランが条件です。Gemini 4 で無料枠があるのは Hydrogen です(Choosing a model)。
Carbon から Neon に替える時、コードはどこを直しますか?
リクエストの形はそのままで、model を gemini-4-neon にするのが基本です。そのうえで、指定がなければ thinking_level の既定が medium から high に上がること(xhigh も使える)、非ストリーミングの 1 回の出力の上限が 32,768 から 65,536 に広がること、呼び出し元が有料枠のプロジェクトであることを確かめます(What’s new・Gemini thinking)。
64K トークンを超える出力はどう受け取りますか?
Interactions API で max_output_tokens を 65,536 より大きく(1,048,576 から入力を引いた値まで)して background を true にすると、サーバーが 64K ずつ続けて生成します。What’s new の例は、終わるまで interactions.get で取り直し、各ステップのテキストをつなぎます。最新の SDK の client-side continuation でも出せます。max_output_tokens を指定しないと 65,536 で止まります。
GitHub Copilot Pro で Gemini 4 Neon は選べますか?
2026年11月19日時点の GitHub Docs のプラン別の表では、Copilot Pro は対象外です。選べるのは Pro+・Max・Business・Enterprise で、Business と Enterprise では管理者が model policy で無効にしていないことも条件です。年払いのまま従来のリクエスト単位の課金(legacy)に残っている Copilot Pro・Pro+ の利用者は、新しいモデルと機能を使えないと GitHub Docs に書かれています。提供は順次なので、対象のプランでもモデルピッカーにまだ出ないことがあります。
Google Cloud の Gemini Enterprise Agent Platform でも使えますか?
Google Cloud のモデルのページでは gemini-4-neon は GA(2026年11月18日公開)で、リージョンは global と us・eu のマルチリージョンです。ただし「認証済みの企業の顧客に一部のリージョンで提供」とあるので、自社のプロジェクトで選べるかを先に確かめてください。日本のリージョンはページに挙がっていません。Gemini API と Google AI Studio の提供の国と地域の一覧には日本が入っていますが、Neon に限った記載ではありません。
まとめ
Gemini 4 Neon は Hydrogen と Carbon の間に置かれた有料枠だけのモデルで、モデル ID は gemini-4-neon、単価は Standard で入力 $3.00・出力 $15.00(100 万トークンあたり・思考を含む)です。発表の「Carbon より作業あたり 32% 低い」は既定の high での値で単価の比較ではないので、自社の作業で使ったトークンを測ってから判断してください。
- 今日: 有料枠のプロジェクトで What’s new の Quickstart を動かし、プロジェクトの Tier と月の上限を確かめる
- 今週: 自社の評価のセットを 4 段の thinking_level で回し、品質と使ったトークンを Carbon・Hydrogen と並べる
- 今月: 移る元に合わせて移行の項目(Gemini 4 からは 3 項目、Gemini 3 以前からは 10 項目)を直し、急がない処理を Batch か Flex に回す。Copilot は管理者が model policy で使わせるかを決める
あわせて読みたい: Gemini 4 Argon API|移行手順と料金の試算(Gemini 3 からの移行の考え方)/Gemini APIのbackground実行入門(long decode の前提になる background の実行)
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Introducing Gemini 4 Neon — Google(2026年11月18日・参照日: 2026-11-19)
- What’s new in Gemini 4 Neon — Gemini API の文書(参照日: 2026-11-19)
- Gemini 4 Neon(モデルのページ) — Gemini API の文書(参照日: 2026-11-19)
- Gemini Developer API pricing(Gemini 4 Neon の節) — Gemini API の文書(参照日: 2026-11-19)
- Choosing a model — Gemini API の文書(参照日: 2026-11-19)
- Gemini thinking — Gemini API の文書(参照日: 2026-11-19)
- Context caching — Gemini API の文書(参照日: 2026-11-19)
- Flex inference・Priority inference・Batch API・Antigravity agent — Gemini API の文書(参照日: 2026-11-19)
- Rate limits・Billing — Gemini API の文書(参照日: 2026-11-19)
- Release notes(November 18, 2026 の項) — Gemini API の文書(参照日: 2026-11-19)
- Getting started・Available regions for Google AI Studio and Gemini API — Gemini API の文書(参照日: 2026-11-19)
- Gemini 4 Neon model card — Google DeepMind(2026年11月公開・参照日: 2026-11-19)
- Gemini 4 Neon(Gemini Enterprise Agent Platform)・Developer’s guide to Gemini 4 Neon — Google Cloud の文書(参照日: 2026-11-19)
- Gemini 4 Neon in GitHub Copilot — GitHub Changelog(2026年11月18日・参照日: 2026-11-19)
- Supported AI models in Copilot・Models and pricing for GitHub Copilot・Model multipliers for annual plans on request-based billing (legacy) — GitHub Docs(参照日: 2026-11-19)