2026年11月21日時点で、Gemini API の Tool Retrieval(ツールの取得)は、エージェントにつないだ多くのツールのうち、その時の作業に要るツールの引数の定義(parameter schema)だけを会話の途中で読み込む機能で、Interactions API(会話の状態をサーバー側で持てる Gemini の API)でプレビューとして使えます(Google の発表・Tool retrieval の docs)。有効にするには、API の版を v1beta(ベータ版)にして、ツールの配列に {"type": "tool_search"} を 1 つ足し、後回しにしたいツールに defer_loading: true を付けます。Tool Retrieval 自体に別料金はなく、docs が対応モデルとして挙げるのは gemini-4-carbon・gemini-4-neon・gemini-4-hydrogen・gemini-4-argon・gemini-3.8-flash・gemini-3.6-flash の 6 つです。
この記事の要点(2026年11月21日時点)
- 何をするか: 既定のサーバー側の検索では、モデルには後回しにしたツールの名前と説明だけを見せ、引数の定義はモデルが名前で求めた時に API が読み込みます。検索から、モデルが関数の呼び出しを返すところまでが、1 回の API の呼び出しの中で進みます(発表)。自分のアプリで探すクライアント側の検索では、検索ごとに往復が 1 回増えます(発表・docs)。
- 何を抑えるか: Google は、すべてのツールの定義を毎回送ると、入力のトークンが膨らみ、遅くなり、候補が増えるほどツールを選ぶ精度が下がると説明しています。発表は冒頭で、Tool Retrieval を、入力のトークンを減らし、エージェントが大きくなってもツールを選ぶ精度を保つための機能だと書いています。どれだけ減るかの割合や、遅さがどれだけ変わるかは、発表にも docs にも書かれていません。
- 有効にする方法:
tool_searchを 1 つ足し、後回しにするツールにdefer_loading: trueを付けます。v1beta が必要で、generateContent(Gemini API に前からある生成の呼び出し方)では使えません(docs)。 - 対応モデル: 発表は「Gemini 3.6 以降のモデル(Gemini 4 の全モデルを含む)」、docs の一覧は上の 6 つです。選ぶ時は docs の一覧から選びます。
- 料金: 別料金はなく、トークンは呼んだモデルの通常の単価で数えます。後回しのツールの一覧・検索の指示・読み込んだ定義は入力のトークンとして数え、サーバー側の検索ごとに走る追加のモデル呼び出しのプロンプトは、ツールを使うためのトークン(tool-use tokens)として示され、入力の単価で数えます(docs・料金のページ)。
- 状態: プレビューです。docs は、一般提供(GA)までに API の形が変わることがあると書いています。
社内のシステムや SaaS、MCP サーバー(MCP=Model Context Protocol。AI のアプリと外部のツールをつなぐ共通の取り決め)をつなぐほど、エージェントに渡すツールの定義は長くなります。Gemini API の docs は、数十の関数の宣言(function declarations)が毎回のリクエストで数万トークンを使うことがあり、候補が増えるほどツールを選ぶ精度が下がると書いています(Tool retrieval の docs)。
この記事では、Google が 2026年11月19日に発表した Tool Retrieval を、2026年11月21日時点で公式の docs を確認した範囲で整理します。載せるコードは docs の公式の例を写したもので、当社では実行していません。
Tool Retrieval とは|ツールが増えた時の困りごとと後回しにする仕組み
Tool Retrieval は、エージェントのツール一式を控えに置いたまま、今の作業に要るツールの引数の定義だけを読み込む機能です。Google の発表は、エージェントが数十から数百のツールにつながる時、すべての引数の定義を毎回送ると、入力のトークンが膨らみ、遅くなり、候補が増えるほどツールを選ぶ精度が下がると書いています(発表)。
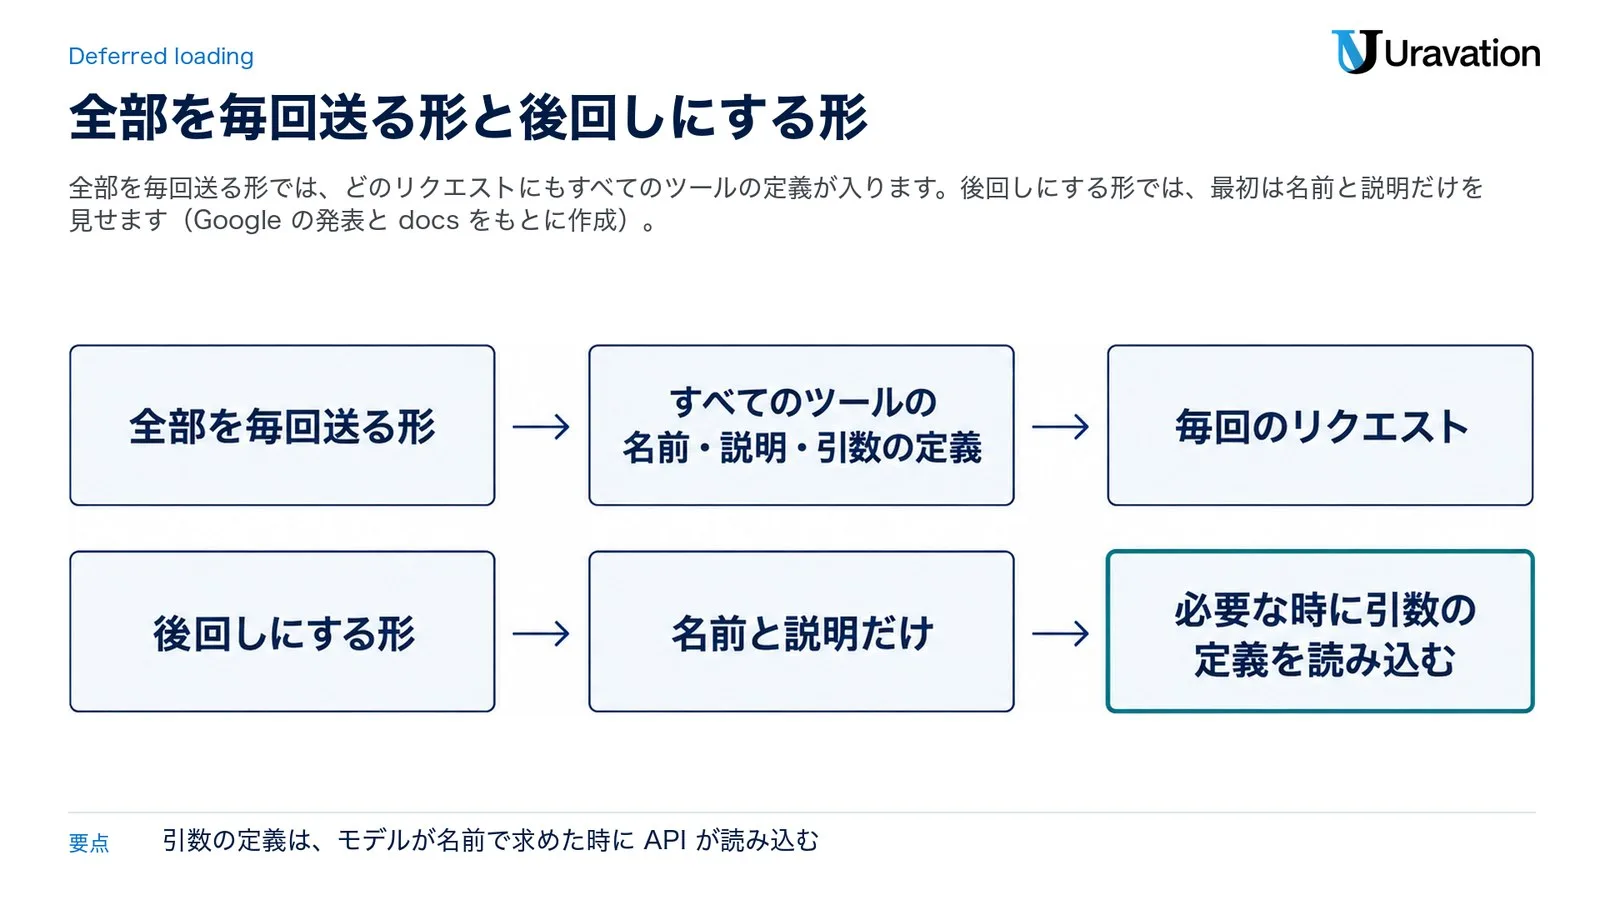
ここで言う引数の定義は、関数呼び出し(function calling=モデルが呼ぶ関数を選び、引数を組み立てて返す仕組み)で、関数が受け取る引数の名前と型を JSON Schema で書いた部分です。全部を毎回送る形では、どのリクエストにもすべてのツールの名前・説明・引数の定義が入ります。後回しにする形では、最初は名前と説明だけを見せ、必要な時に引数の定義を読み込む、という順になります。
| ツールの扱い | 最初にモデルに見えるもの | 引数の定義が入る時 |
|---|---|---|
| 最初から読み込むツール(defer_loading なし) | 名前・説明・引数の定義 | 毎回のリクエスト |
| 後回しのツール(defer_loading: true) | 名前と説明。docs の料金の節では、入力に入るのは名前と short_description(無ければ description の最初の 1 文)だけ | モデルが名前で求め、API が読み込んだ後 |
既定のサーバー側の検索では、流れは次のとおりです。モデルは後回しのツールの名前と説明を見て、どんなツールがあるかを知っています。ツールが要る時は名前で求め、API が引数の定義を読み込み、モデルが関数を呼びます。発表と docs は、この検索、定義の読み込み、モデルが関数の呼び出し(function_call)を返すところまでが、1 回の API の呼び出しの中で進むと説明しています(発表・docs)。
似た仕組みは Anthropic の Claude API にもあり、tool search tool という名前で、後回しにするツールに同じく defer_loading: true を付けます。ただ、検索の方式(正規表現と、自然文で探す BM25 の 2 種類)や、最初にモデルの文脈に入るのが検索のツールと後回しにしないツールだけである点など、細部は Gemini API と同じではありません(Anthropic の docs)。両方を使う場合は、各社の docs で挙動を確かめてください。
発表の要点|2026年11月19日・Interactions API でプレビュー
Google は 2026年11月19日(日本時間 11月20日)、公式ブログで Tool Retrieval を発表しました。書き手は Gemini API のプロダクトマネージャーの Lucia Loher 氏と、Google DeepMind の研究者の Nora Kassner 氏です。発表と docs の要点を表にまとめます。
| 項目 | 内容 | 出典 |
|---|---|---|
| 発表 | 2026年11月19日(日本時間 11月20日)・Google の公式ブログ | 発表 |
| 提供の形 | プレビュー。v1beta が必要で、一般提供までに API の形が変わることがある | docs |
| 使える API | Interactions API だけ。generateContent は非対応 | docs |
| 対応モデル | 発表: Gemini 3.6 以降のモデル(Gemini 4 の全モデルを含む)。docs の一覧: gemini-4-carbon・gemini-4-neon・gemini-4-hydrogen・gemini-4-argon・gemini-3.8-flash・gemini-3.6-flash(6 つとも Models のページに載るモデルコード) | 発表・docs・Models |
| 探し方 | サーバー側の検索(既定)と、クライアント側の検索の 2 つ | docs |
| MCP | リモートの MCP サーバーのツールも後回しにできる | 発表・docs |
| 料金 | 別料金なし。トークンは呼んだモデルの通常の単価 | 発表・docs・料金のページ |
Interactions API は、会話の状態をサーバー側で持てる Gemini の API です。docs は、2026年6月の時点で一般提供(GA)になっており、新しいプロジェクトに勧める API だと書いています。従来の generateContent は legacy(旧来の API)の扱いですが、引き続きサポートされます。docs は、新しいエージェントの機能やツールは今後 Interactions API で出すと書いています(Interactions API の docs)。Interactions API 自体は一般提供ですが、Tool Retrieval はその上のプレビューの機能という位置づけです。
Interactions API の基本と、長い作業をサーバー側で走らせる background 実行は、Gemini APIのbackground実行入門|長時間タスク実装ガイドで書いています。
使い方|tool_search を足して defer_loading を付ける
サーバー側の検索(Gemini がツールを探す既定の形)なら、発表が挙げるコードの変更は 2 つです。ツールの配列に {"type": "tool_search"} を足すことと、後回しにしたいツールに defer_loading の印を付けることです。索引を作ったり置いたりする必要はなく、検索は Gemini がサーバー側で行います(発表)。docs の例は、これに加えてクライアントを v1beta で作っています。
docs に沿った手順は次のとおりです。
- 最新の Google GenAI SDK(Gemini API を呼ぶための Google の公式のライブラリ。Python は google-genai、JavaScript は @google/genai)を入れ、クライアントを v1beta で作る(docs の Python の例は
genai.Client(http_options={"api_version": "v1beta"}))。 - ツールの配列に
{"type": "tool_search"}を 1 つ足す(1 回のリクエストに入れられるのは 1 つ)。 - 後回しにするツールに
"defer_loading": Trueを付ける。引数の定義は省かずに全部書く。 - ほとんどのやり取りで使うツールには
defer_loadingを付けず、最初から読み込む。 client.interactions.createで呼び、interaction.stepsの中の function_call を自分のコードで実行する。- 結果を function_result で返す次のリクエストにも、ツールの配列を全部付ける。
次のコードは docs の「Server-side tool retrieval」の例です(公式の例・当社では実行していません)。為替の換算と為替の推移の 2 つの関数を、どちらも後回しにしています。動作環境は Python と Google GenAI SDK(google-genai)です。
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "convert_currency",
        "description": "Convert an amount from one currency to another.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "amount": {"type": "number"},
                "from_currency": {"type": "string"},
                "to_currency": {"type": "string"},
            },
            "required": ["amount", "from_currency", "to_currency"],
        },
    },
    {
        "type": "function",
        "name": "get_exchange_rate_history",
        "description": "Return historical exchange rates for a currency pair.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "pair": {"type": "string"},
                "days": {"type": "integer"},
            },
            "required": ["pair", "days"],
        },
    },
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Convert 100 USD to EUR.",
    tools=tools,
)

for step in interaction.steps:
    print(step.type, getattr(step, "name", ""))
docs には同じ内容の JavaScript と REST(curl)の例もあり、REST の例は API キーを環境変数 GEMINI_API_KEY から渡しています。キーはコードに直接書かず、環境変数などから読み込みます。本番で使う前に、必ずテスト用の環境で動作を確かめてください。
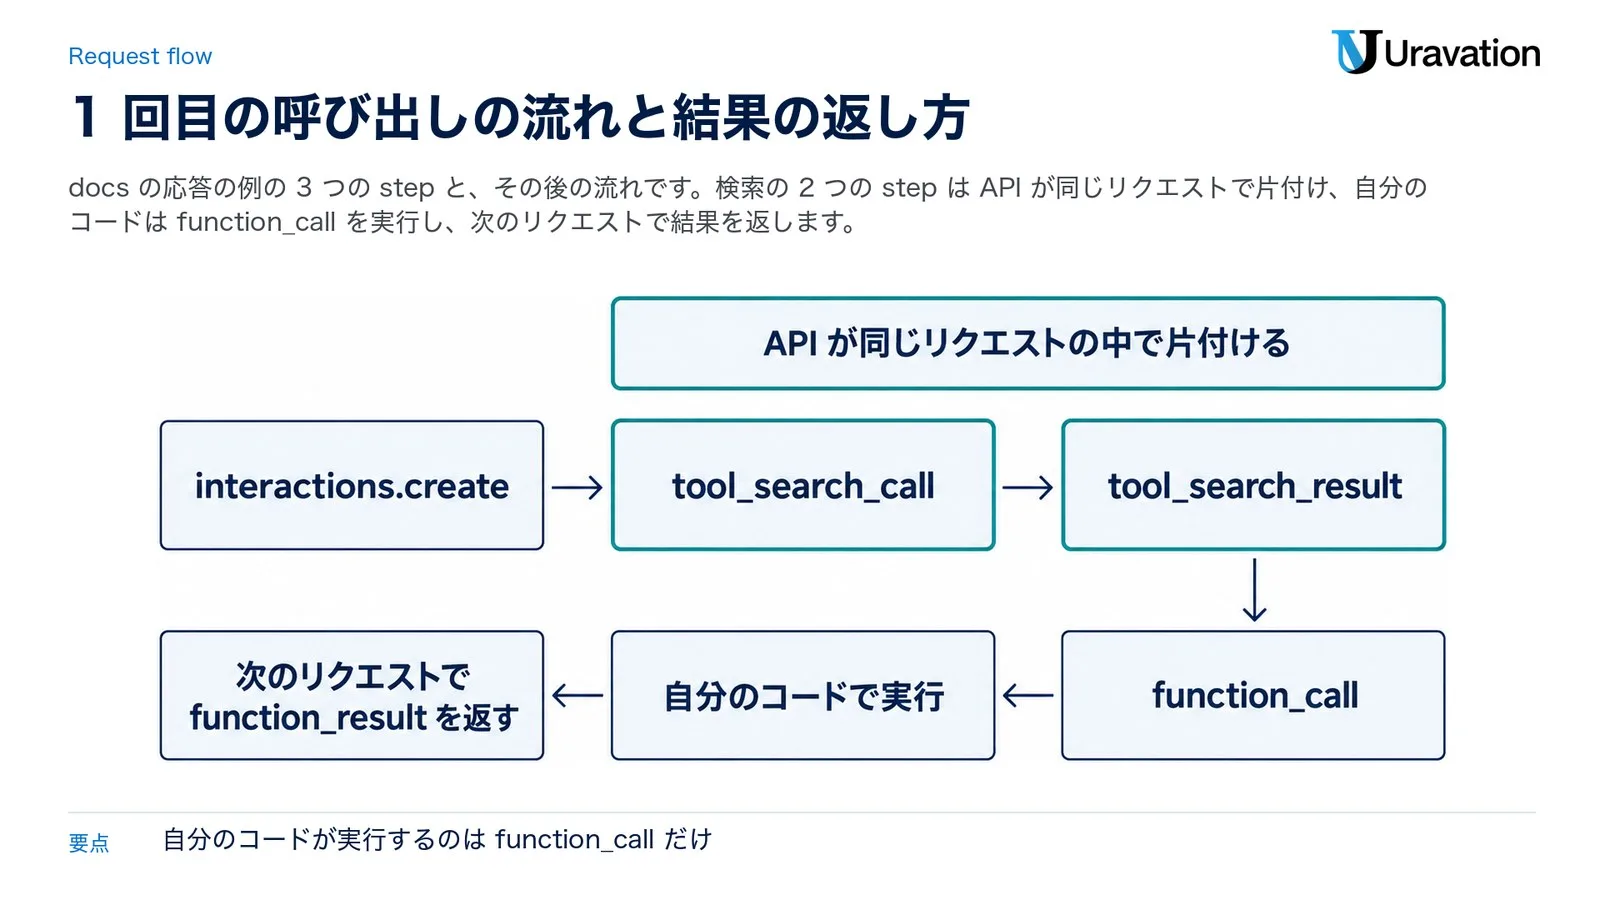
この例の応答には、3 種類の step が順に入ります(docs の応答の例)。tool_search_call と tool_search_result は API が同じリクエストの中で片付けるので、自分のコードが実行するのは function_call だけです。
| step の type | 入っているもの | 自分のコードがすること |
|---|---|---|
| tool_search_call | モデルが求めたツールの名前(例: "function_names": ["convert_currency"])と、暗号化された signature(署名の値) |
何もしない。会話を自分で持つ時は、そのまま残す |
| tool_search_result | API が読み込んだ引数の定義と signature | 同上 |
| function_call | 呼ぶツールの名前と引数(例: amount 100・from_currency USD・to_currency EUR) | 関数を実行し、次のリクエストで function_result を返す |
発表は、この 3 つの step を見れば、モデルがどのツールを候補にしたかが分かり、ツールの名前や説明文を直す手がかりになると書いています(発表)。docs の例の status は requires_action(自分の側の処理を待つ状態)ですが、function_call が返っても status がそうなるとは限らないので、docs は毎回 steps を見るよう勧めています。
関数の結果を返す 2 回目のリクエストにも、ツールの配列を全部付けます。API はツールの宣言を次のやり取りに持ち越さないためです。docs の例では、previous_interaction_id に前の interaction.id を、input に function_result(name・call_id・result)を入れ、tools=tools をもう一度渡しています(docs)。同じ形は、後で載せるクライアント側の検索の例の 2 回目でも使われています。
どのツールを最初から読み込むか
docs は、ほとんどのやり取りで使う中心のツールは最初から読み込み、たまにしか使わないツールを後回しにするよう勧めています。docs と発表の書き方から、分け方をまとめると次のとおりです。
| ツール | 扱い | docs・発表の書き方 |
|---|---|---|
| ほとんどのやり取りで使う中心のツール | 最初から読み込む | defer_loading を付けない(docs)・最初から読み込んだままにできる(発表) |
| システムの指示やツールの出力で名前を出すツール | 最初から読み込む | 後回しにすると、モデルが検索せずに呼ぶことがある(docs) |
| たまにしか使わないツール | 後回しにする | long tail(たまにしか使わない多くのツール)を後回しにする(発表・docs) |
| 20 未満の、あまり変わらないツール一式 | 全部を最初から読み込む形が合う | 比べの表の「Fewer than 20 stable tools」(docs) |
並列のツール呼び出しや tool_choice(どのツールを呼ばせるかの指定)の設計は、AIエージェントのParallel Tool Use & tool_choice設計パターン2026で整理しています。
MCP サーバーとつなぐ時|mcp_server に defer_loading を付ける
Tool Retrieval は、Gemini API のリモートの MCP サーバーにも使えます。docs の書き方では、サーバー側の tool_search と一緒に、ツールの配列の mcp_server の項目に defer_loading: true を付けると、そのサーバーが出すツールがすべて後回しになります(docs)。発表は、大きなサーバーでも、ツールを 1 つずつ書き並べずにつなげると説明しています(発表)。次は docs の例です(公式の例)。
{
  "type": "mcp_server",
  "name": "weather_service",
  "url": "https://gemini-api-demos.uc.r.appspot.com/mcp",
  "defer_loading": true
}
モデルが後回しの MCP のツールを読み込んで呼ぶと、API がそのツールをリモートのサーバーで実行し、mcp_server_tool_call と mcp_server_tool_result の step を同じ応答に入れて返します(docs)。自分で宣言した関数(function)は自分のコードが実行して function_result で返すのに対し、MCP のツールは API がサーバーに呼びに行く点が違います。
Gemini API のリモートの MCP には、Function calling の docs に次の決まりがあります(Function calling の docs)。
- つなげるのは Streamable HTTP(MCP の通信方式の 1 つ)のサーバーだけで、SSE(Server-Sent Events)の方式のサーバーには対応していません。
- サーバーの名前に「-」を使わず、snake_case(語を「_」でつなぐ書き方)にします。
- mcp_server の項目は、type(”mcp_server” が必須)・name・url・headers(認証のトークンなど、毎回サーバーに送る HTTP ヘッダー)・allowed_tools(呼んでよいツールを絞る)です。Tool Retrieval で後回しにする時は、これに defer_loading を足します(Tool retrieval の docs)。
Tool Retrieval の 2 つの探し方のうち、MCP サーバーに使えるのはサーバー側の検索です。次の節のクライアント側の検索は、docs の比べの表で MCP サーバーに「該当なし(Not applicable)」となっています。認証の値を headers に入れる時は、コードに直接書かず、環境変数などから読み込みます。Streamable HTTP のサーバーの作り方は、MCP Streamable HTTP完全実装ガイド|Python/TypeScript【2026】で書いています。
自前の登録簿で探す形|クライアント側の検索(execution: client)
ツールを自前の登録簿(レジストリ)や埋め込みの索引(文の意味を数値の並びにして、近い物を探す仕組み)で管理している場合や、利用者ごとの権限で出すツールを絞りたい場合は、検索を自分のアプリで行うクライアント側の検索を使います。tool_search に "execution": "client" と名前・説明・検索の引数を付けて宣言し、モデルがそれを呼んだら、自分のアプリが探して返す形です(発表・docs)。
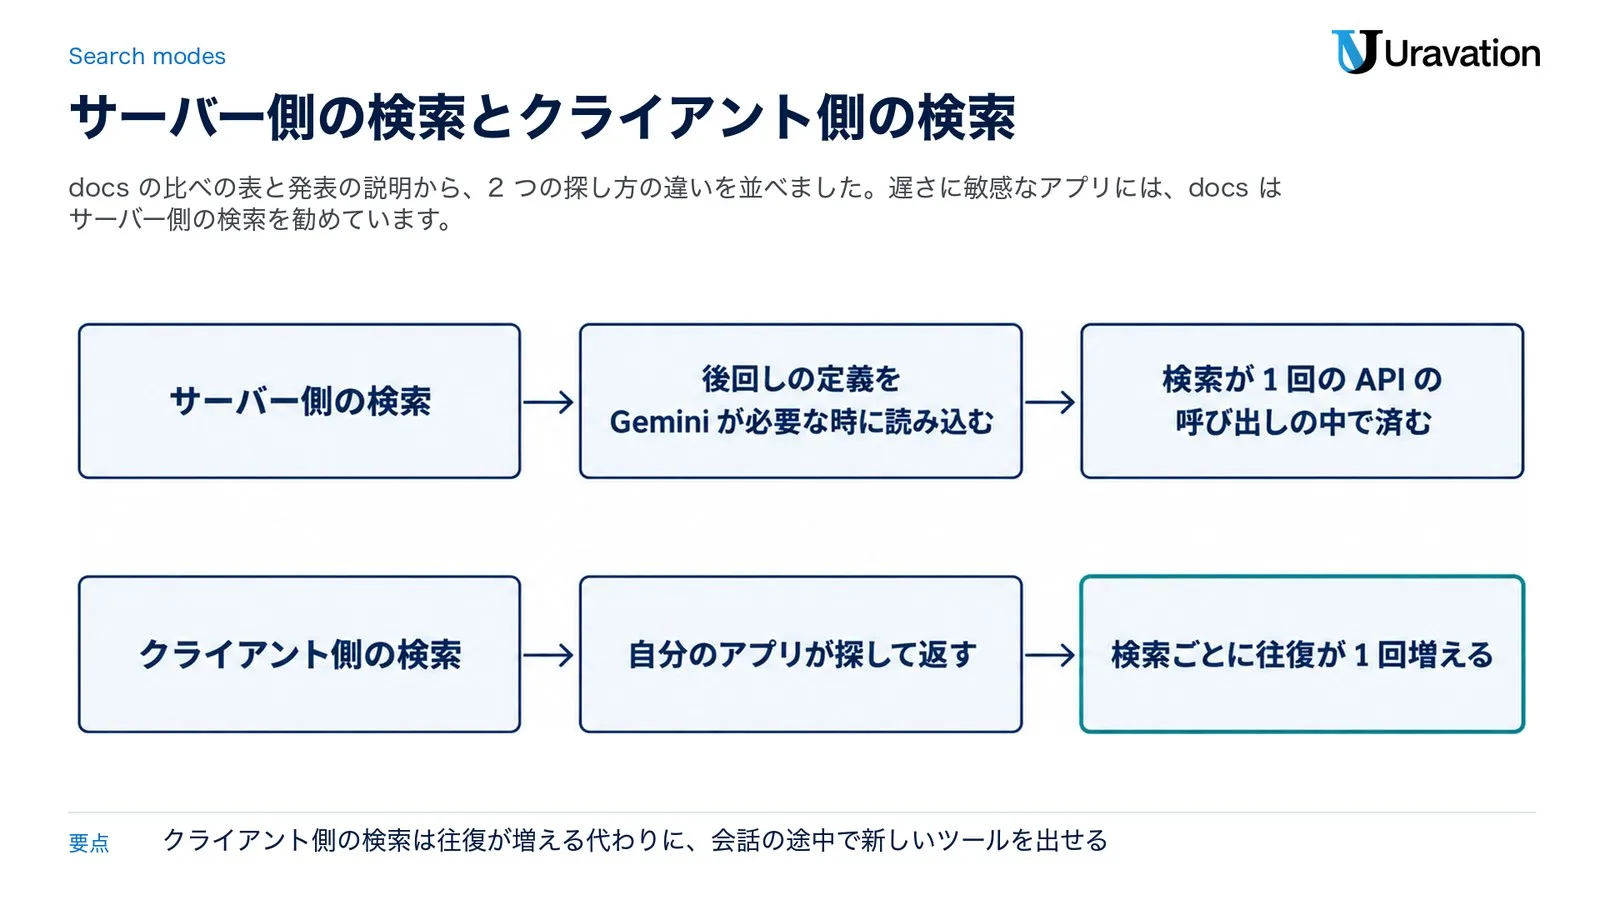
発表は、自分のアプリが探すので、検索ごとに往復が 1 回増えると書いています。その代わり、返すツールは最初のツールの配列に書いておく必要がなく、利用者が新しい連携をつないだ時など、会話の途中で新しいツールを出せます(発表・docs)。docs の比べの表を訳すと次のとおりです。
| 項目 | 最初から読み込む形 | サーバー側の検索 | クライアント側の検索 |
|---|---|---|---|
| 定義がモデルに届く方法 | すべての定義を毎回送る | 後回しの定義を Gemini が必要な時に読み込む | 自分のアプリが必要な時に定義を返す |
| 自分で書く検索のコード | なし | なし | 検索・順位付け・絞り込みの処理 |
| 最初にツールを宣言するか | する | する | しない |
| リモートの MCP サーバー | 使える | 使える | 該当なし |
| 検索ごとに増える往復 | なし | なし | 検索ごとに 1 回 |
| 向いている場面 | 20 未満の、あまり変わらないツール | 大きく、中身の決まったツール一式と MCP サーバー | 中身の変わる登録簿・名前空間・利用者ごとのツール |
docs は、遅さに敏感なアプリには、検索が 1 回の API の呼び出しの中で済むサーバー側の検索を勧めています。次のコードは docs の「Client-side tool retrieval」の例です(公式の例・当社では実行していません)。1 回目でモデルが検索のツールを呼び、2 回目で自分のアプリが見つけた宣言を返し、その応答でモデルが見つかったツールを呼びます。
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {
        "type": "tool_search",
        "execution": "client",
        "name": "search_tool_registry",
        "description": "Search the internal tool registry for functions.",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {
                    "type": "string",
                    "description": "The tool name or capability to look for.",
                },
                "namespace": {
                    "type": "string",
                    "description": "Namespace filter, such as 'billing'.",
                },
            },
            "required": ["query"],
        },
    }
]

# Turn 1: the model calls your search tool.
interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Look up the billing history for user 123.",
    tools=tools,
)

for step in interaction.steps:
    if step.type == "function_call" and step.name == "search_tool_registry":
        # Run your own retrieval and return complete function declarations.
        matches = [
            {
                "type": "function",
                "name": "get_billing_history",
                "description": "Retrieve billing history for a user.",
                "parameters": {
                    "type": "object",
                    "properties": {"user_id": {"type": "integer"}},
                    "required": ["user_id"],
                },
            }
        ]

        # Turn 2: return the matching schemas.
        followup = client.interactions.create(
            model="gemini-4-hydrogen",
            previous_interaction_id=interaction.id,
            tools=tools,
            input=[
                {
                    "type": "function_result",
                    "name": step.name,
                    "call_id": step.id,
                    "result": matches,
                }
            ],
        )

        # Turn 3: the model calls the discovered tool.
        for followup_step in followup.steps:
            if followup_step.type == "function_call":
                print(followup_step.name, followup_step.arguments)
クライアント側の検索で気をつける点は、docs に次のように書かれています。
- サーバー側とクライアント側の検索は、同じリクエストの中で組み合わせられません。
- defer_loading はサーバー側の検索で使う印です。tool_search を execution: client だけにしたまま defer_loading を付けると、「tool_search tool must be specified when using defer_loading.」のエラーになります(docs の Common errors)。
- 検索できる名前空間を description に並べ、見つけた宣言は JSON の文字列ではなくオブジェクトで返し、何も見つからない時は使えるカテゴリを短く返すよう勧めています(docs の Best practices)。
料金とトークンの考え方|別料金なし・増える分と減る分
Tool Retrieval に別料金はありません。入力と出力のトークンは、呼んだモデルの通常の単価で数えます(発表・docs)。料金のページの表でも、Tool retrieval の行は無料枠の列が「Free of charge」、有料枠の列が「No separate charge」です(料金のページ)。
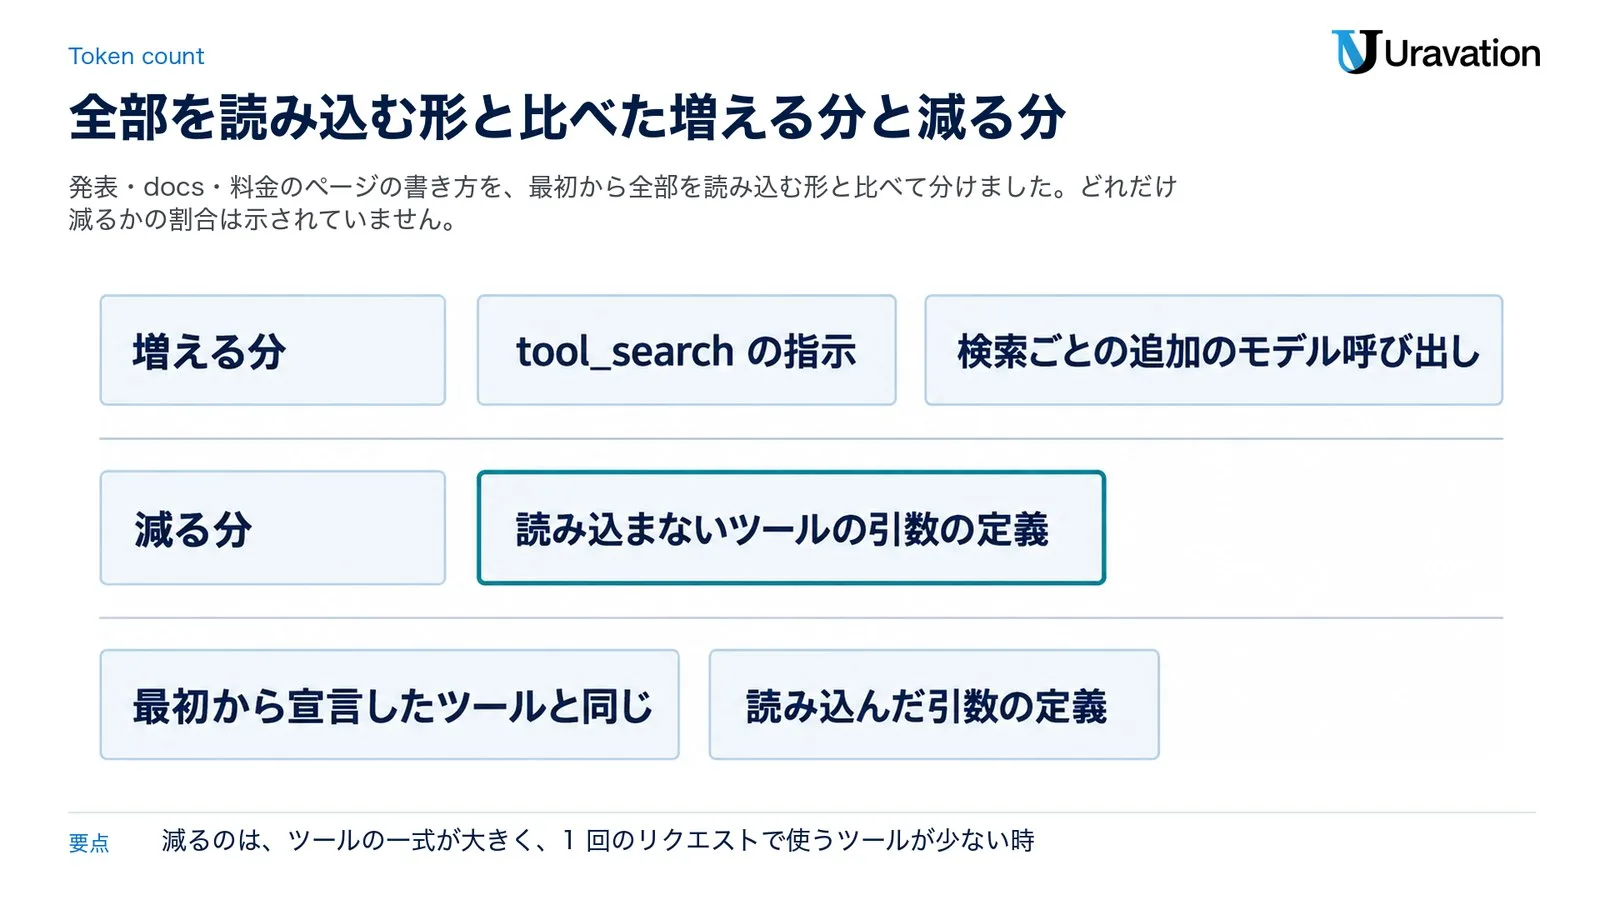
ただし、何も増えないわけではありません。最初から全部を読み込む形と比べた時の増える分と減る分を、発表・docs・料金のページの書き方で整理すると次のとおりです。
| 中身 | 数え方 | 全部を読み込む形と比べて | 出典 |
|---|---|---|---|
| tool_search の指示(有効にすると足される) | 決まった量の入力のトークンが少し増える。量の数字は示されていない | 増える分 | 発表・料金のページ |
| 検索ごとの追加のモデル呼び出し(サーバー側の検索) | 検索 1 回ごとに、リクエストの中で追加のモデル呼び出しが走る。文脈の全体と読み込んだ定義を含むそのプロンプトは、応答の usage の total_tool_use_tokens(ツールを使うためのプロンプトのトークン数)に出て、入力の単価で数える | 増える分 | docs・料金のページ・API リファレンス |
| 後回しのツールの一覧 | 名前と short_description(無ければ description の最初の 1 文)だけが total_input_tokens(usage にある入力のトークン数)に入る | 名前と短い説明だけが残る | docs |
| 読み込まないツールの引数の定義 | 読み込むまで課金されない | 減る分 | docs |
| 読み込んだ引数の定義 | その後の会話で、入力として数える | 最初から宣言したツールと同じ | 発表・docs |
得になるかどうかについて、docs は、ツールの一式が大きく、1 回のリクエストで使うツールが少ない時にトークンが減ると書いています。逆に、ツールが少ない時や、とても長い文脈で毎回検索する時は、最初から読み込む方が安くなることがあります。発表も、読み込まない定義の分が読み込む分を上回れば減り、大きなツール一式ではそれが普通だとしたうえで、自分の通信で測るよう勧めています(発表・docs)。どれだけ減るかの割合は、発表にも docs にも示されていません。
増える分は入力の単価で数えるので、使うモデルの入力の単価も合わせて確かめておきます。2026年11月21日時点の料金のページでは、対応 6 モデルは次のとおりです(Standard の区分・100 万トークンあたり・米ドル)。
| モデル ID | 無料枠 | 有料枠の入力の単価 |
|---|---|---|
| gemini-4-carbon | 対象外 | $2.00(2026年11月30日まで)、$4.00(2026年12月1日から) |
| gemini-4-argon | 対象外 | $2.00(2026年11月30日まで)、$4.00(2026年12月1日から) |
| gemini-4-neon | 対象外 | $3.00 |
| gemini-4-hydrogen | 無料 | $1.50 |
| gemini-3.8-flash | 無料 | $0.75(2026年12月31日まで)、$1.50(2027年1月1日から) |
| gemini-3.6-flash | 無料 | $0.75(2026年12月31日まで)、$1.50(2027年1月1日から) |
出典は料金のページで、出力とキャッシュの単価、Batch・Flex・Priority の区分も同じページにあります。
prefix caching(先頭のキャッシュ)との関係
prefix caching は、前のリクエストと同じ先頭部分を再利用して、処理を安く速くする仕組みです。発表は、後回しの定義はプロンプトの先頭に入らず、読み込んだ定義は会話の後ろに足されるので、キャッシュした先頭部分がやり取りごとに変わらないと説明しています。docs も、先頭部分がモデルごとの最小の大きさに達していれば、暗黙のキャッシュ(implicit caching=自動で効くキャッシュ)が効き続けると書いています(発表・docs)。
一方で docs は、ツールを後回しにするとプロンプトが短くなり、中くらいのプロンプトがその最小の大きさを下回ることがあるとも書いています。Interactions API の docs は、previous_interaction_id で会話を続ける方が、会話の履歴に暗黙のキャッシュを使いやすいと説明しています(Interactions API の docs)。各社のプロンプトキャッシュの違いは、プロンプトキャッシュ比較2026|3大LLMのコスト最適化戦略で整理しています。
使う前に確かめること|v1beta・説明文・会話の続け方
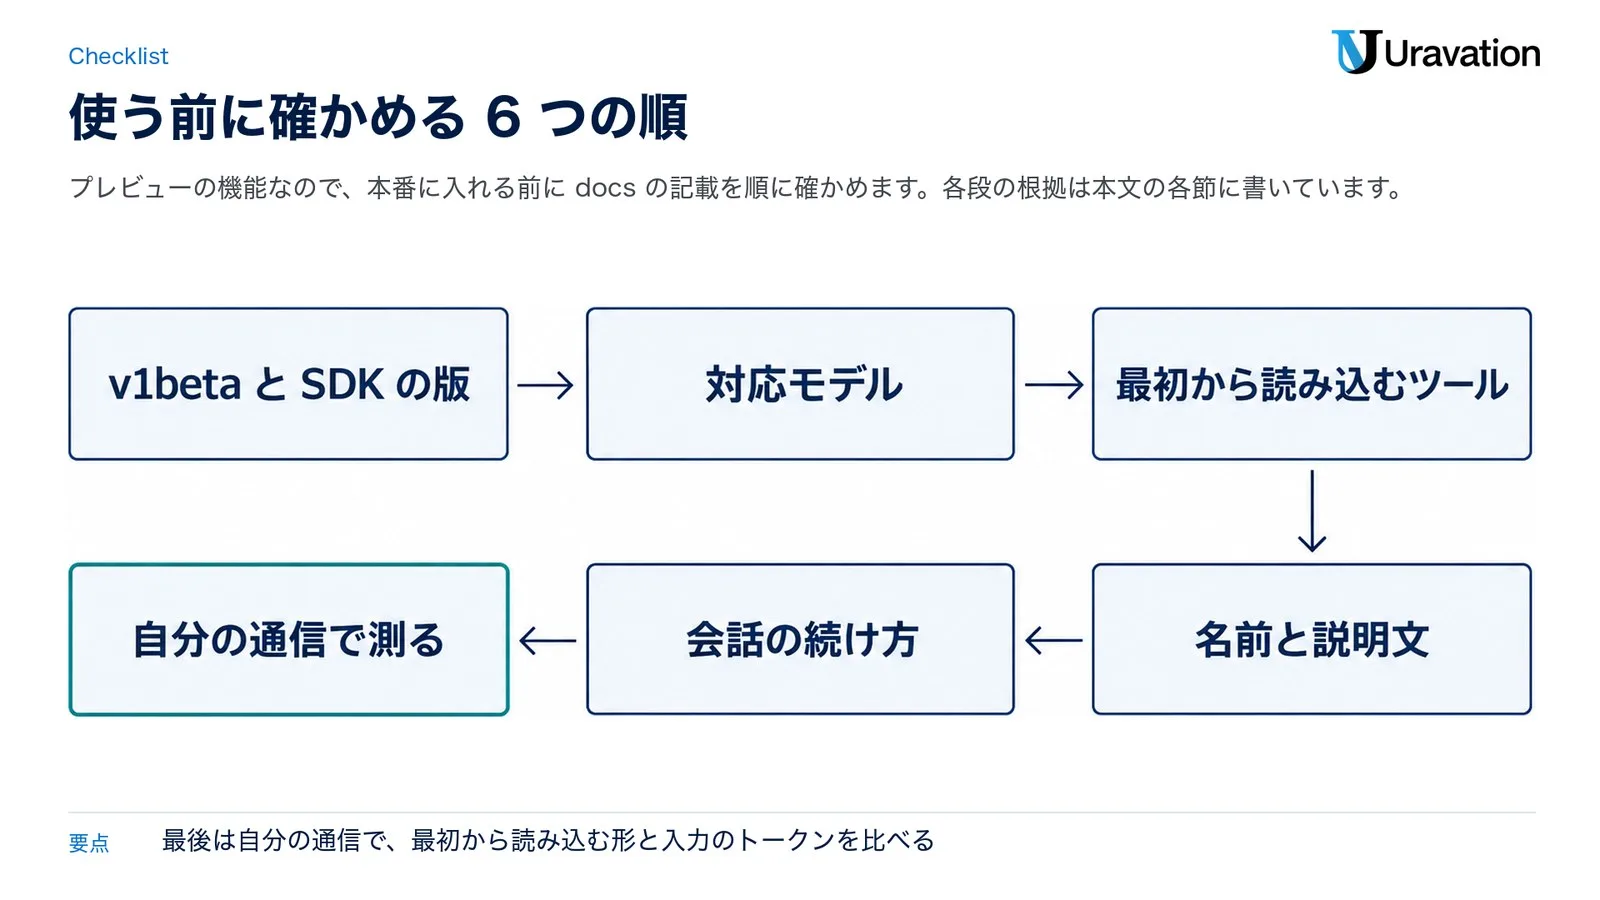
Tool Retrieval はプレビューで、docs は v1beta が必要なこと、一般提供までに API の形が変わることがあることを書いています(docs)。本番に入れる前に、v1beta と SDK の版、対応モデル、最初から読み込むツール、名前と説明文、会話の続け方を確かめ、最後に自分の通信で測る、という順で進めます。この節で詳しく書くのは版・名前と説明文・会話の続け方とつまずきやすい点で、対応モデルは発表の要点の節、最初から読み込むツールは使い方の節、自分の通信で測ることは料金の節に書いています。
プレビューと API の版
発表の記事のコードは genai.Client() のままですが、docs でクライアントを作るコードは、Python の例がどれも http_options={"api_version": "v1beta"}、JavaScript の例がどれも httpOptions: { apiVersion: "v1beta" } を指定しています。書く時は docs に合わせます。SDK について docs は、会話を自分で持つ時に tool_search_call と tool_search_result を落とさない版を使うよう書いていますが、版の番号は示していません。Python の google-genai の変更履歴では、3.4.0(2026年11月16日)で Interactions の SDK に tool search の型が、3.6.0(11月18日)で tool retrieval の schema が入っています(GitHub の変更履歴)。Interactions API の docs は、最新の Google GenAI SDK を使うよう案内しています。
ツールの名前と説明文の書き方
後回しのツールは、名前と説明を手がかりにモデルに選ばれます。docs の Configuration options と Best practices には、次の書き方が並んでいます。
- 説明が長いツールには short_description(検索の時に、長い description の代わりにモデルに見せる短い要約。defer_loading: true の時だけ使える)を付ける。
- 似た名前のツールはサービス名を頭に付けて分け(例: billing_get_customer と crm_get_customer)、short_description の最初でサービス名を書く。
- 後回しのツールでも、引数の定義は全部送る。読み込む前の定義は課金されず、省くと読み込んだ後に呼べなくなる。
使うツールを絞り、文脈を小さく保つ考え方は、コンテキストエンジニアリング完全ガイド|圧縮と予算設計【2026】で書いています。
会話の続け方
previous_interaction_id で会話を続ける場合、API は tool_search_call と tool_search_result を含む前の step を保存しますが、ツールの宣言は保存しません。そのため、毎回のリクエストにツールの配列を全部付けます。store=false で会話を自分で持つ場合は、応答の step をすべて順番どおり、そのまま履歴に足し、tool_search_call・tool_search_result・thought・function_call の signature も消しません(docs)。docs の Limitations には、ほかに次の 3 つがあります。
- 1 回のやり取りで、モデルが何度か検索することがある。
- 読み込んだツールは会話の残りで文脈に残り、外せない。
- どの後回しのツールにも一致しない検索は、構造化されたエラーではなく、文の応答になる。
【要注意】Tool Retrieval でつまずきやすい 4 つ
つまずき 1:2 回目のリクエストで tool_search を外す
❌ 関数の結果を返す 2 回目のリクエストで、defer_loading を付けたツールを残したまま tool_search を外す。「tool_search tool must be specified when using defer_loading.」のエラーになります(docs の Common errors)。ツールの配列を丸ごと省くと、モデルはすでに呼んだツールしか分からなくなります(Function calling の docs)。
⭕ previous_interaction_id で続ける時も、tool_search を含むツールの配列を毎回全部送ります(docs)。
つまずき 2:名前を出しているツールを後回しにする
❌ システムの指示(system instructions)やツールの出力の中で名前を出しているツールに defer_loading を付ける。モデルが検索せずに呼ぶことがあり、会話を自分で持つ形では「Server side tool call context must be circulated when using deferred loading functions.」のエラーの原因になります。
⭕ 名前で触れるツールは最初から読み込みます(docs)。
つまずき 3:自分で持つ履歴から tool_search の step を落とす
❌ store=false で会話を自分で持つ時に、function_call だけを残して tool_search_call を捨てる、または signature を消す。function_result を返した時に 400 のエラーになります。tool_search_result だけを落とした場合はエラーにならず、読み込んだ定義が文脈から消えます。
⭕ 応答の step を順番どおり、signature も含めてそのまま履歴に足します。SDK は tool_search_call と tool_search_result を落とさない版を使います(docs)。
つまずき 4:対応していないモデルで後回しの印を付ける
❌ docs の一覧にないモデルのまま defer_loading を付ける。対応していないモデルでは「deferred loading is not supported for this model」のエラーになります(docs の Common errors)。
⭕ docs の対応モデルの 6 つから選びます(docs)。
よくある質問
Tool Retrieval に料金はかかりますか?
別料金はかかりません。トークンは、呼んだモデルの通常の単価で数えます。ただし、tool_search の指示(発表は「決まった量で少し」と説明)、後回しのツールの名前と短い説明、読み込んだ引数の定義は、入力のトークンとして数えます。サーバー側の検索ごとの追加のモデル呼び出しのプロンプトも、応答の usage の total_tool_use_tokens に出て、入力の単価で数えます(docs・料金のページ)。
Gemini API の無料枠でも Tool Retrieval は使えますか?
料金のページの表では、Tool retrieval の行の無料枠の列は「Free of charge」で、無料枠でも Tool Retrieval 自体の料金はかかりません。ただし、呼ぶモデル自体が無料枠の対象である必要があります。2026年11月21日時点の料金のページでは、対応 6 モデルのうち gemini-4-hydrogen・gemini-3.8-flash・gemini-3.6-flash は無料枠の列が「Free of charge」、gemini-4-carbon・gemini-4-argon・gemini-4-neon は「Not available」です。また、無料枠の対象のこの 3 つのモデルは、「Used to improve our products」(Google の製品の改善に使われるか)の行が無料枠の列で Yes、有料枠の列で No です(料金のページ)。
どのモデルで使えますか?
docs の一覧は gemini-4-carbon・gemini-4-neon・gemini-4-hydrogen・gemini-4-argon・gemini-3.8-flash・gemini-3.6-flash の 6 つで、発表は「Gemini 3.6 以降のモデル(Gemini 4 の全モデルを含む)」と書いています。Models のページにある gemini-3.8-live や gemini-3.8-flash-tts のように、3.6 以降の番号でも docs の一覧にないモデルは、対応と書かれていません。docs の Common errors は、対応していないモデルでは「deferred loading is not supported for this model」のエラーになるとし、対応モデルを使うよう書いているので、選ぶ時は docs の 6 つから選びます。使える API は Interactions API(v1beta)だけで、generateContent では使えません。2026年11月21日時点ではプレビューで、一般提供までに API の形が変わることがあります(docs)。
MCP サーバーのツールでも使えますか?
使えます。サーバー側の tool_search と一緒に、mcp_server の項目に defer_loading: true を付けると、そのサーバーが出すツールがすべて後回しになります(docs)。つなげるのは Streamable HTTP のリモートの MCP サーバーで、SSE の方式のサーバーには対応していません(Function calling の docs)。docs の比べの表では、クライアント側の検索は MCP サーバーに「該当なし」です。
後回しにできるツールは何個までですか?
2026年11月21日時点で、Tool retrieval と Function calling の docs に後回しにできるツールの数の上限は見つけられず、確かめられませんでした。docs に書かれているのは、tool_search は 1 回のリクエストに 1 つまでであること、最初から読み込む形は 20 未満のあまり変わらないツールに向くこと(比べの表)、ツールがおよそ 20〜30 個を超えたら Tool Retrieval を検討すること(Function calling の docs の Scaling to large tool libraries)です。Function calling の docs の Best practices は、有効にしておくツール(active set)を最大 10〜20 個に保つよう勧めており、Tool retrieval の docs は、Tool Retrieval が有効なツールの集まりを小さく保つと説明しています。どれも後回しにできる数の上限ではありません。なお Function calling の docs は、関数呼び出しのモードを any(必ずどれかの関数を呼ばせる指定)にした時や引数の定義が複雑な時、宣言したツール全体の複雑さが上限を超えると 400 INVALID_ARGUMENT のエラーで断ると書いています。後回しにしたツールがこの数え方に入るかは、docs に書かれていません。
今のコードはどこを変えればいいですか?
Interactions API を使っているなら、モデルを docs の対応 6 モデル(gemini-4-carbon・gemini-4-neon・gemini-4-hydrogen・gemini-4-argon・gemini-3.8-flash・gemini-3.6-flash)のどれかにし、クライアントを v1beta で作り、ツールの配列に {“type”: “tool_search”} を足し、後回しにするツールに defer_loading: true を付けます。2 回目以降のリクエストにもツールの配列を全部付け、store=false で会話を自分で持つ時は、tool_search_call と tool_search_result を落とさない版の SDK を使い、その step を signature ごと残します。generateContent を使っている場合、Tool Retrieval は使えません。docs の移行ガイド(Migration Guide)で、Interactions API に移るところからになります(Interactions API の docs)。
まとめ
Tool Retrieval は、後回しにしたツールの名前と説明だけをモデルに見せ、引数の定義は要る時に読み込む機能で、2026年11月21日時点では Interactions API(v1beta)のプレビューです。サーバー側の検索なら、変更の中心はツールの配列に tool_search を足し、後回しにするツールに defer_loading を付けること(docs の例ではクライアントを v1beta で作る)で、別料金もありません。一方で、サーバー側の検索ごとに追加のモデル呼び出しが走り、読み込んだ定義は会話の残りで入力として数えるので、得になるかどうかはツールの数と使い方で変わります。
- 今日: つないでいるツールの数と、1 回のリクエストで実際に使うツールの数を書き出し、最初から読み込むツールの候補を決める。
- 今週: テスト用の環境で、対応モデルと v1beta のクライアントを使い、tool_search と defer_loading を入れて、interaction.steps と、応答の usage にある total_input_tokens・total_tool_use_tokens を見る。
- 今月: 自分の通信で、最初から読み込む形と入力のトークンを比べ、後回しにするツールを決める。
あわせて読みたい: Gemini APIのbackground実行入門|長時間タスク実装ガイド(Interactions API の基本と background 実行)/AIエージェントのParallel Tool Use & tool_choice設計パターン2026(ツール呼び出しの設計)
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Introducing Tool Retrieval in the Gemini API — Google 公式ブログ(2026年11月19日・参照日: 2026-11-21)
- Tool retrieval — Gemini API の docs(参照日: 2026-11-21)
- Interactions API — Gemini API の docs(参照日: 2026-11-21)
- Function calling with the Gemini API(Step 4・Scaling to large tool libraries・Function calling modes・Remote MCP・Best practices・Simplifying complex function schemas の節) — Gemini API の docs(参照日: 2026-11-21)
- Creating an interaction(usage の項) — Interactions API の API リファレンス(参照日: 2026-11-21)
- Gemini Developer API pricing — Gemini API の docs(参照日: 2026-11-21)
- Models — Gemini API の docs(参照日: 2026-11-21)
- python-genai CHANGELOG(3.4.0・3.6.0 の項) — GitHub(googleapis/python-genai)(参照日: 2026-11-21)
- Tool search tool — Claude API の docs(Anthropic)(参照日: 2026-11-21)