OpenAI は 2026年9月22日(米国時間)に「Better prompt caching for GPT-6」を公開し、GPT-6 系(Astra・Sol・Luna)のプロンプトキャッシュを強化しました。2026年9月23日時点で公式ドキュメントに書かれている変更は次の 4 点です。①既定のままでキャッシュ命中率が上がる、②prompt_cache_options.comparison_response_id を付けると「なぜ命中しなかったか」の理由(tools_changed など 9 種)が prompt_cache_diagnostics で返る、③prompt_cache_breakpoint でキャッシュする接頭辞の終点を自分で決められる、④推論の強さ(reasoning effort)とツールの有効・無効を変えてもキャッシュが切れない。単価は据え置きで、キャッシュ読み取りは通常入力の 0.1 倍、書き込みは 1.25 倍。GPT-6 Sol なら 100万トークンあたり入力 $2.00 に対して読み取り $0.20 です。
この記事では、OpenAI の公式ガイド・API リファレンス・料金表・GPT-6 Sol/Luna の発表文だけを根拠に、仕組み → 変わった点 → 設定手順 → エージェントでの並べ方 → 費用の試算例 → Anthropic との違い → 失敗パターンの順で整理します。筆者が API を動かして測った数値は載せていません。コード例はすべて公式ドキュメントに載っているものです。
結論|GPT-6のプロンプトキャッシュで変わった点と費用の下がり方
先に要点を表にまとめます。参照日はすべて 2026年9月23日です。
| 項目 | 2026年9月23日時点の公式記載 |
|---|---|
| 対象モデル | GPT-5.6 以降(GPT-6 Astra・Sol・Luna を含む)。Responses API で利用 |
| 読み取り単価 | 通常入力の 0.1 倍(Sol: $0.20/Luna: $0.01/Astra: $1.00、いずれも 100万トークンあたり) |
| 書き込み単価 | 通常入力の 1.25 倍(Sol: $2.50/Luna: $0.125/Astra: $12.50) |
| 最小キャッシュ長 | 1,024 トークン(OpenAI 側の隠しシステム文は数えない) |
| 保持時間 | prompt_cache_options.ttl は "30m" のみ。最後の書き込みか再利用から 30 分は再利用できる(それより長く残ることもある) |
| 断点の指定 | prompt_cache_options.mode(implicit/explicit)と prompt_cache_breakpoint。1 リクエストの書き込みは最大 4 か所 |
| 診断 | prompt_cache_options.comparison_response_id を付けると prompt_cache_diagnostics が返る。追加費用なし |
| 設定変更への耐性 | 推論の強さは configuration_update 入力アイテムで、ツールは tool_choice: "none"/allowed_tools で変えると接頭辞を壊さない |
| 計測 | usage.input_tokens_details.cached_tokens と cache_write_tokens |
費用面の効き方は公式ガイドに倍率で示されています。ある接頭辞を「1 回書いて 1 回再利用」すると通常入力の 1.35 倍(書き込み 1.25 + 読み取り 0.1)で、キャッシュなしで 2 回処理する 2 倍より安くなります。10 リクエストで「1 回書いて 9 回読む」なら 2.15 倍対 10 倍です。つまり同じ接頭辞を 2 回以上使う時点で元が取れ、回数が増えるほど差が開きます。後半では GPT-6 Sol の公式単価で 100 リクエストの試算を置きました。
GPT-6 Sol/Luna の発表文には、GitHub がこの改善によって「新規に処理が必要なプロンプトトークンの割合を、数十億リクエスト規模で 50% 以上減らした」と報告していると書かれています(OpenAI の発表文に引用された GitHub の報告で、筆者の測定ではありません)。
なお、キャッシュの一般論と 3 社比較は既刊のプロンプトキャッシュ比較2026|3大LLMのコスト最適化戦略で扱っています。本記事は GPT-6 で新しく入った仕様に絞ります。
プロンプトキャッシュとは|接頭辞が一致した分だけ再利用する仕組み
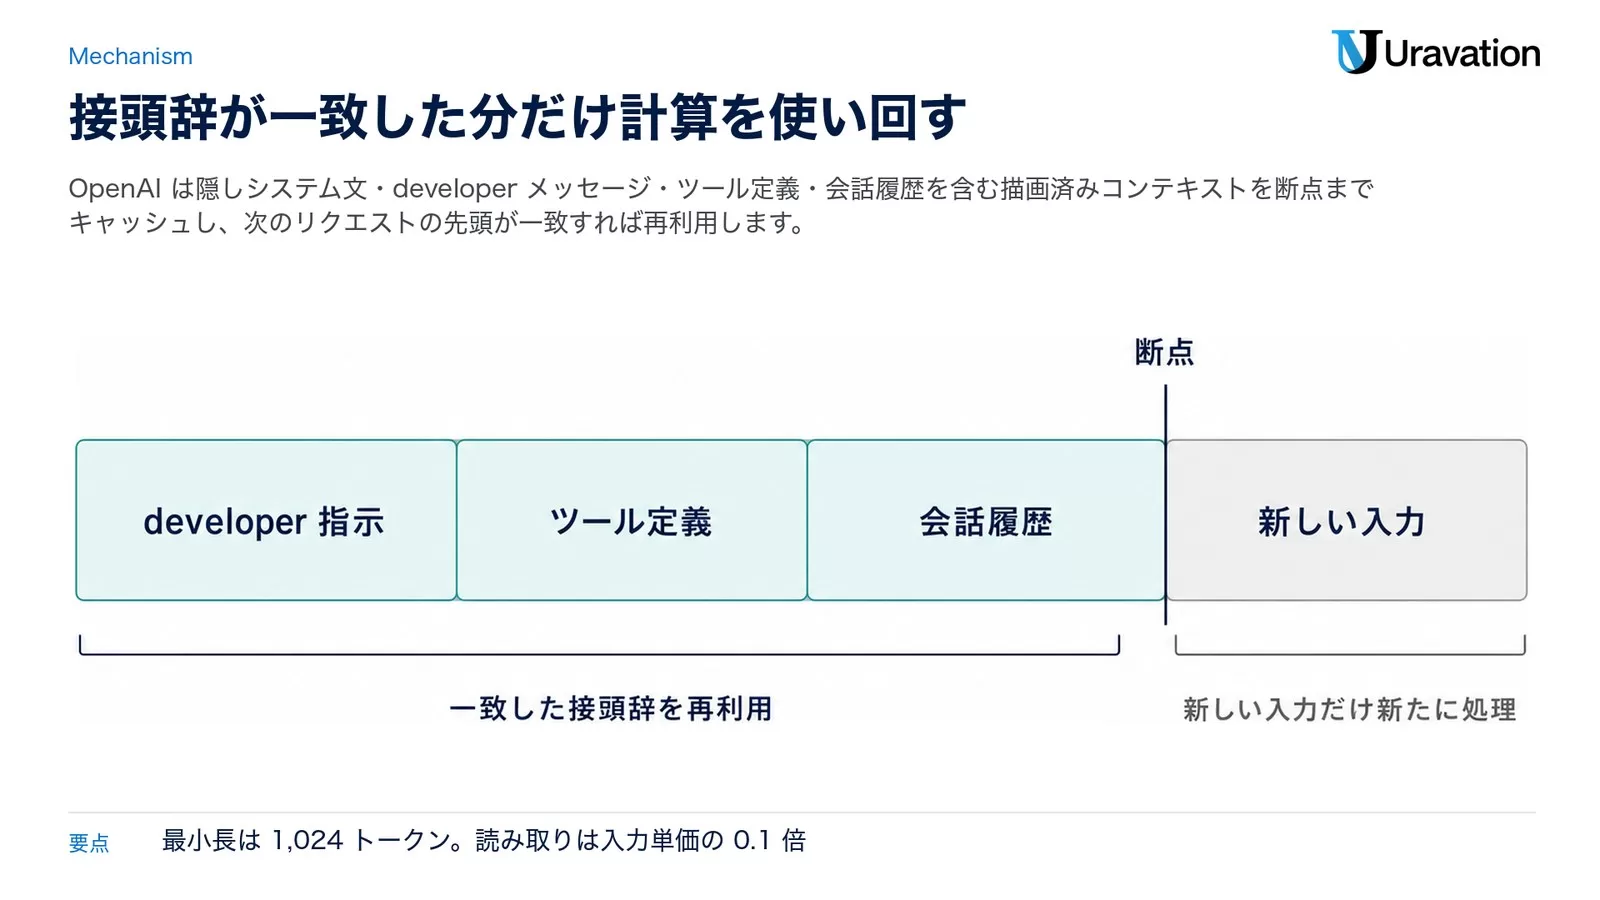
プロンプトキャッシュは、リクエスト同士が同じ「接頭辞(プレフィックス)」を持つときに、前回の計算結果を使い回す仕組みです。モデルは入力トークンを処理するときに中間状態(KV 状態)を計算しますが、この状態を接頭辞ぶんだけ保存しておき、次のリクエストの先頭が一致すれば計算をやり直さずに済みます。一致した接頭辞を再利用し、断点より後ろの新しい入力だけを新たに処理する、という動きです。公式ガイドが挙げる利点は 3 つで、計算の節約、入力トークン単価の割引(最大 90%)、応答開始までの時間短縮です。
何がキャッシュの対象になるか
OpenAI は「描画済みのコンテキスト全体」をキャッシュします。具体的には、OpenAI 側の隠しシステム文、developer メッセージ、ツール定義、会話履歴(テキスト・画像・ドキュメント・対応する音声)です。逆にいうと、これらのどれか 1 つでも断点より前で変わると、その位置から後ろは前回のキャッシュと一致しなくなります。
接頭辞を変えてしまう設定
公式ガイドは、リクエストの設定を変えたときに接頭辞へ影響するものを次のように挙げています。「設定を変えたら必ずキャッシュが消える」のではなく、「次のリクエストが同じ接頭辞を持ち、一致する断点を見つけられるか」が判定基準です。
| 設定 | 影響 |
|---|---|
model |
モデルが違えば重みもキャッシュの挙動も違う |
tools |
ツールの名前・説明・スキーマ・順序・ツール固有の指示が変わる |
parallel_tool_calls |
複数ツール呼び出しに関する指示が変わりうる |
text.format |
出力形式の指示と要求スキーマが加わる |
reasoning.effort |
モデル側の推論指示が変わりうる。対応モデルでは configuration_update で変えると接頭辞を保てる |
text.verbosity |
応答の詳しさに関する指示が変わりうる |
context_management(compaction) |
過去の会話を圧縮して置き換えるため、最初に変わったトークン以降の再利用ができなくなる |
断点(cache breakpoint)と最小長
「断点」は、キャッシュに保存して後で再利用できる接頭辞の終わりを示す印です。最初のリクエストが条件を満たす接頭辞をキャッシュに書き、以降のリクエストは「一番長く一致する接頭辞」を、候補になる断点を後ろから順にさかのぼって探します。接頭辞は最小長を超えていないとキャッシュされず、GPT-5.6 以降の最小長は 1,024 トークンです(隠しシステム文のトークンは数えません)。
GPT-5.6 以降では、断点を OpenAI に任せる implicit モードと、自分で置く explicit モードの 2 つがあります。
- implicit(既定): 「最新の対象メッセージ」の終わりに断点が置かれる。対象は user メッセージ、連続するツール応答のうち最後のもの、最初に連続する developer メッセージ群の最後のもの。
- explicit:
prompt_cache_options.modeを"explicit"にし、入力メッセージ内の対応する content ブロックにprompt_cache_breakpoint: {"mode": "explicit"}を付ける。断点を 1 つも置かないとキャッシュは使われず、書き込みも起きない。最後の断点より後ろは通常単価で処理され、書き込み料金がかからない。
1 リクエストで書き込める断点は最大 4 つで、implicit モードでは implicit の断点が 1 枠を使うため、explicit 断点は 3 つまでになります。最上位の instructions には explicit 断点を置けないので、再利用したい開発者指示は developer メッセージ内の input_text ブロックに入れます。
保持時間とキャッシュの置き場所
GPT-5.6 以降の保持時間は prompt_cache_options.ttl で指定し、対応する値は既定でもある "30m" だけです。キャッシュされた接頭辞は、最後に書かれたか再利用された時点から 30 分は再利用でき、再利用するたびに追加の書き込み料金なしで寿命が延びます。それより前のモデルで使っていた prompt_cache_retention(in_memory/24h)は、API リファレンスで「非推奨。prompt_cache_options.ttl を使う」と明記されました。
キャッシュは個々のマシン上に置かれ、1 分あたり 15 リクエストを超えるトラフィックはあふれた分が別のマシンへ回されることがあります。組織をまたいで共有されることはなく、リージョン処理の境界もまたぎません。GPT-5.6 以降ではルーティングを OpenAI が自動で行うため、prompt_cache_key は命中率のためには不要で、顧客やユーザーごとにキャッシュの会計を分けたい場合にだけ使います。
GPT-6で変わった4点|命中率・診断・断点・設定変更
GPT-6 Sol/Luna の発表文の「Improving caching for agents and long conversations」節と、公式ガイドの「GPT-5.6 and later」の記述を突き合わせると、以前のモデル(GPT-5.5 以前)との違いは次の表になります。
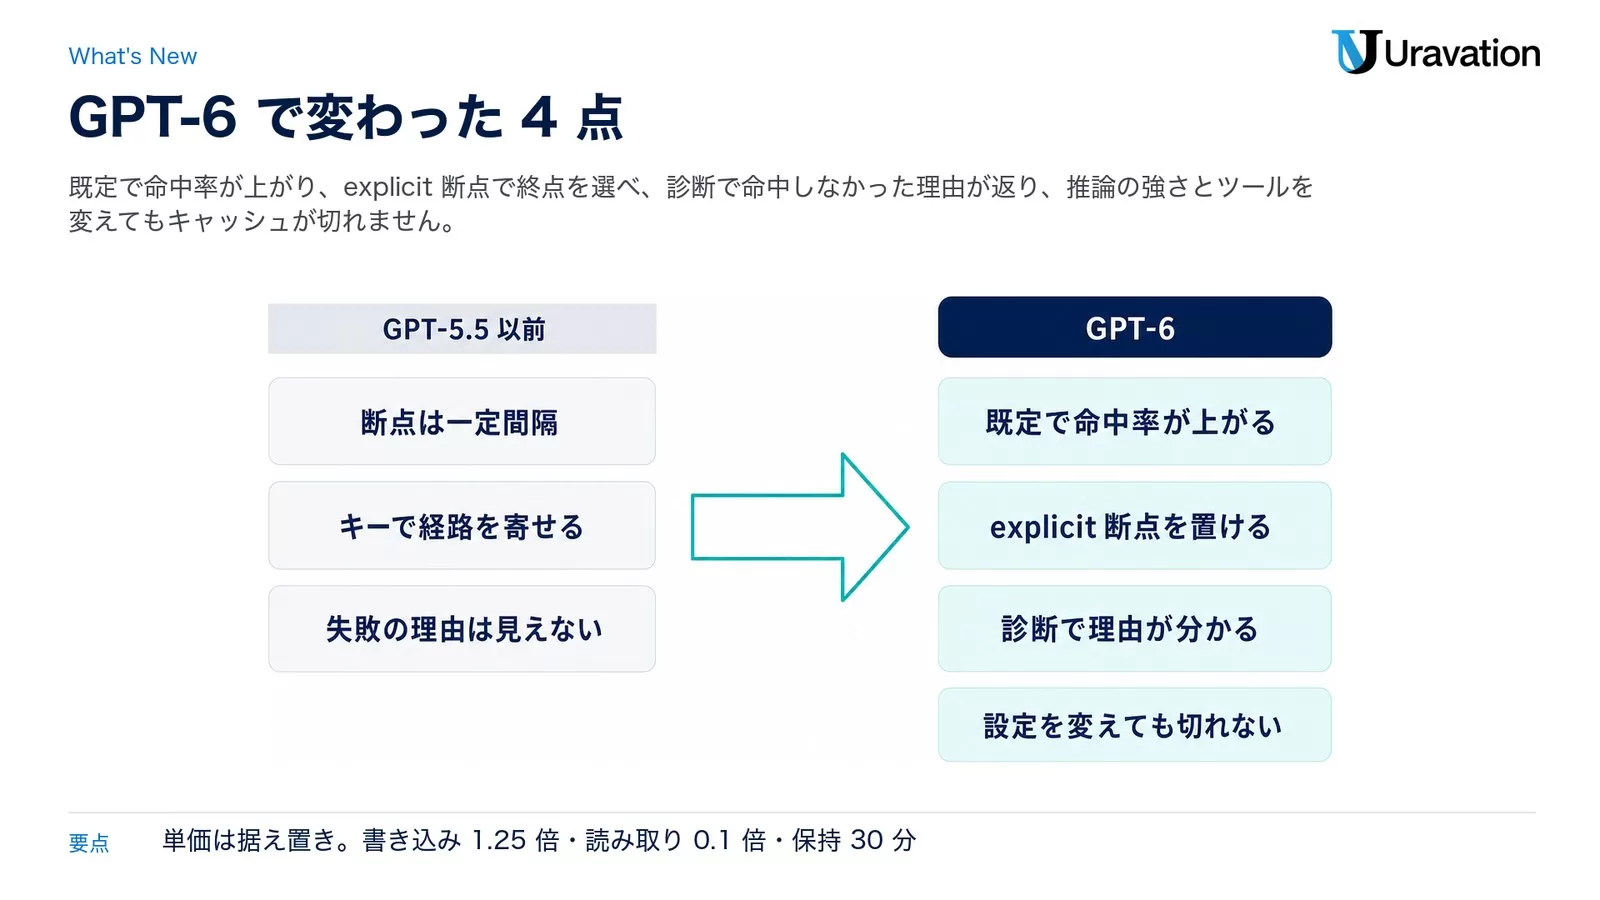
| 挙動 | GPT-5.5 以前 | GPT-5.6 以降(GPT-6 を含む) |
|---|---|---|
| implicit 断点 | 一定間隔(GPT-5.5 は 2,048 トークンごと) | 最新の対象メッセージの終わり |
| explicit 断点 | 非対応 | 対応(1 リクエスト最大 4 書き込み) |
prompt_cache_key |
安定したキーでルーティングを寄せる | 任意。会計を分ける用途だけ |
| 最小キャッシュ長 | リクエスト設定で変わる | 可視入力 1,024 トークン |
cached_tokens の報告 |
隠しトークンを除き 128 の倍数へ切り捨て | 対象境界ちょうどの値 |
| 読み取り料金 | モデルごとのキャッシュ入力単価 | 通常入力の 0.1 倍 |
| 書き込み料金 | 追加なし | 通常入力の 1.25 倍 |
| 保持時間の制御 | prompt_cache_retention(24h など) |
prompt_cache_options.ttl("30m") |
1. 既定のまま命中率が上がる
発表文は「GPT-6 のプロンプトキャッシュを改善し、既定でより高いキャッシュ命中率を出す」と述べています。仕組みの側から見ると、implicit 断点が「最新の対象メッセージの終わり」に置かれるようになったこと、照合の候補が広がったことが該当します。公式ガイドによると、implicit モードでの照合候補は「最初の 2 つと最新 50 個の explicit 断点、implicit 断点、それより前の最大 20 個の対象メッセージの終わり、最初の developer メッセージ群の終点」です。explicit 断点を置いていなくても、途中のメッセージの終わりで一致した接頭辞を再利用できます。
2. 命中しなかった理由が返る(診断)
新設の診断機能は、比較したいレスポンスの id を prompt_cache_options.comparison_response_id に渡すと、現在のレスポンスの prompt_cache_diagnostics に結果が入るものです。追加費用はなく、レート制限にも別枠で数えられず、Zero Data Retention と併用できます。返ってくる type は 4 つです。
type |
意味 |
|---|---|
cache_hit |
比較対象と同じ接頭辞が再利用された。実際の再利用量は usage.input_tokens_details.cached_tokens で見る |
cache_miss |
差分があって再利用できなかった。reason・cache_missed_tokens(推定)・comparison_reusable_tokens が付く |
comparison_response_not_found |
比較対象の診断記録が無いか期限切れ |
unavailable |
結論が出せない、またはモデルが診断に非対応 |
reason は model_changed・prompt_cache_key_changed・service_tier_changed・tools_changed・text_format_changed・reasoning_effort_changed・verbosity_changed・context_compacted・input_changed の 9 種です。診断は最初に分類できた理由を 1 つだけ返すので、直したらもう一度比較して次の原因を探します。
3. キャッシュする接頭辞の終点を自分で決められる
explicit 断点によって「固定の指示と参照資料までをキャッシュし、その後ろの可変部分は書き込まない」という制御ができます。公式ガイドの「Gotchas」に、implicit だけで運用すると「長い共通接頭辞+毎回違う末尾」の構成で短い共通部分が再利用されない例が載っており、explicit 断点はその解決策として示されています。
4. 推論の強さとツールを変えてもキャッシュが切れない
GPT-6 系では、リクエスト上位の reasoning.effort はそのままにして、input 配列に configuration_update アイテムを追加すると、以後のレスポンスの推論の強さだけを変えられます。上位の reasoning.effort を変えると隠しシステム指示が書き換わって接頭辞が崩れるため、公式ガイドは「元の値のまま置いておく」よう指示しています。ツール側は、ツール定義を消さずに tool_choice: "none" で止める、allowed_tools で呼べるツールを絞る、Tool search の defer_loading: true で必要になるまで定義を読み込まない、の 3 つが推奨です。
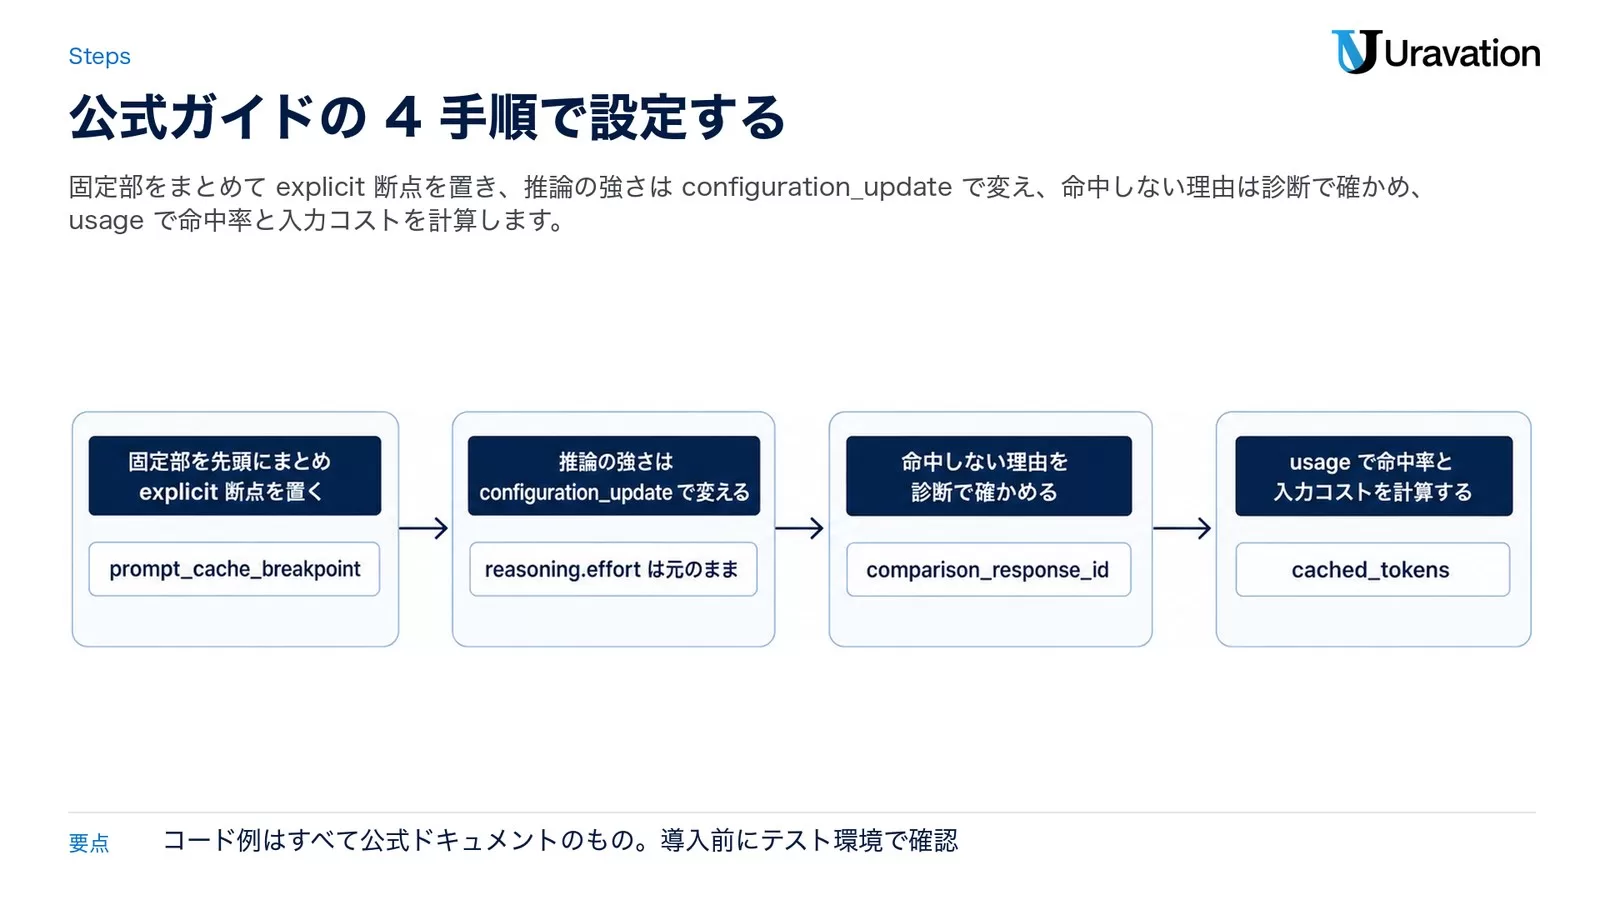
設定の手順|公式ガイドの例で explicit 断点・診断・計測を入れる
ここからは公式ドキュメントに載っているリクエスト例をそのまま使います。筆者は本番で動かして検証していないので、導入時はテスト環境で動作確認してください。既存コードからの移行手順は既刊のプロンプトキャッシュ実装ガイド|Claude/OpenAI対応【2026】も参照してください。
手順1: 固定部を先頭にまとめ、explicit 断点を置く
公式ガイドの「Keep changing content after the breakpoint」の例です(モデル名を gpt-6-sol に置き換えています。元の例は gpt-5.6 で、仕様は GPT-5.6 以降で共通です)。固定の指示と参照資料を最初の developer メッセージの input_text ブロックに入れ、そのブロックに断点を付けます。日時やユーザー固有の内容は 2 つ目の developer メッセージに分けて後ろへ置きます。
{
  "model": "gpt-6-sol",
  "reasoning": { "effort": "low", "context": "all_turns" },
  "text": { "verbosity": "medium" },
  "prompt_cache_options": { "mode": "explicit" },
  "input": [
    {
      "role": "developer",
      "content": [
        {
          "type": "input_text",
          "text": "Stable instructions and shared reference material...",
          "prompt_cache_breakpoint": { "mode": "explicit" }
        }
      ]
    },
    {
      "role": "developer",
      "content": "Dynamic developer instructions, such as user-specific content and timestamps..."
    },
    {
      "role": "user",
      "content": "The user's current question..."
    }
  ]
}
ポイントは 3 つです。①prompt_cache_options.mode を "explicit" にすると implicit 断点は作られず、置いた断点だけが書き込み対象になる。②断点の後ろ(動的な developer 文と user 文)は通常単価で処理され、書き込み料金がかからない。③固定部は 1,024 トークン以上にする。
手順2: 推論の強さは configuration_update で変える
公式の Reasoning ガイド「Change reasoning mid-conversation」の Python 例です。1 回目は effort: "low" で始め、2 回目は上位の reasoning.effort を low のまま、input の先頭に configuration_update を足して high に上げています。
from openai import OpenAI

client = OpenAI()
model = "gpt-6-astra"

response = client.responses.create(
    model=model,
    reasoning={"effort": "low"},
    input="Draft a database migration plan.",
    store=True,
)
print(response.output_text)

response = client.responses.create(
    model=model,
    previous_response_id=response.id,
    reasoning={"effort": "low"},
    input=[
        {
            "type": "configuration_update",
            "reasoning": {"effort": "high"},
        },
        {
            "role": "user",
            "content": "Analyze the failure modes and propose rollback steps.",
        },
    ],
    store=True,
)
print(response.output_text)
公式ガイドの注記では、configuration update は GPT-6 モデルファミリーの標準・単一エージェントモードで対応し、変えられるのは推論の強さだけです。最新の update が以後のレスポンスに効き、別の update で上書きするまで続きます。
手順3: 命中しない理由を診断で確かめる
Prompt cache diagnostics ガイドの Python 例です。2 つのリクエストで関数ツールの名前だけを get_time から get_date に変え、2 回目で 1 回目との比較を要求しています。support-policy.txt は 1,024 トークン以上の自分のポリシー文書に置き換えます。
from pathlib import Path

from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()  # At least 1,024 tokens.

first = client.responses.create(
    model="gpt-6-astra",
    instructions=policy,
    input="Reply with exactly OK.",
    tools=[{"type": "function", "name": "get_time"}],
)

second = client.responses.create(
    model="gpt-6-astra",
    instructions=policy,
    input="Reply with exactly OK.",
    tools=[{"type": "function", "name": "get_date"}],
    prompt_cache_options={"comparison_response_id": first.id},
)

diagnostics = second.prompt_cache_diagnostics
if diagnostics is not None and diagnostics.type == "cache_miss":
    print(diagnostics.reason)
    print(diagnostics.comparison_reusable_tokens)
    print(diagnostics.cache_missed_tokens)
公式ガイドにある期待出力は reason が tools_changed で、comparison_reusable_tokens と cache_missed_tokens にトークン数が入る形です(数は入力で変わります)。複数ターンで使うときは、各レスポンスの id を保存して次のリクエストの comparison_response_id に渡し、最初のターンでは省略します。ストリーミング時は response.completed イベントの event.response から読みます。
手順4: usage で命中率と入力コストを計算する
公式ガイドの「Calculate input cost」の Python 例です。通常入力・キャッシュ読み取り・キャッシュ書き込みの 3 種類を倍率で重み付けし、100万トークンあたりの入力単価を掛けます。
from openai.types.responses import ResponseUsage


def calculate_input_cost(
    usage: ResponseUsage,
    input_price_per_million: float,
    cache_input_multiplier: float = 0.1,
    cache_write_multiplier: float = 1.25,
) -> float:
    input_tokens = usage.input_tokens
    cached_tokens = usage.input_tokens_details.cached_tokens
    cache_write_tokens = usage.input_tokens_details.cache_write_tokens
    ordinary_input_tokens = input_tokens - cached_tokens - cache_write_tokens

    weighted_input_tokens = (
        ordinary_input_tokens
        + cached_tokens * cache_input_multiplier
        + cache_write_tokens * cache_write_multiplier
    )
    input_cost = weighted_input_tokens * input_price_per_million / 1_000_000
    return input_cost
命中率は「キャッシュされたトークンの合計 ÷ 入力トークンの合計」で、ユーザー・ワークスペース・日などの単位で集計するよう公式ガイドは勧めています。組織全体の推移は Prompt Caching Dashboard で見られます。
補足: 起動時に事前ウォームする
対話アプリで初回応答を速くしたいときは、prompt_cache_options.prewarm を true にしたリクエストを先に送ると、出力を生成せずにキャッシュだけ準備できます。公式の例は次のとおりです(モデル名は元の例のまま gpt-5.6)。事前ウォームで書き込んだトークンには通常の書き込み単価がかかります。
{
  "model": "gpt-5.6",
  "input": [
    {
      "role": "developer",
      "content": "Your app's shared instructions and reference material..."
    }
  ],
  "prompt_cache_options": {
    "prewarm": true
  }
}
エージェントと長い会話での並べ方|固定部を先頭に、可変部を最後に
公式ガイド「How to optimize prompt caching」は、会話履歴の保持・ツール定義の安定・断点の位置決めの 3 つに集中するよう述べています。エージェント開発の観点で並べ直すと次の 3 層です。
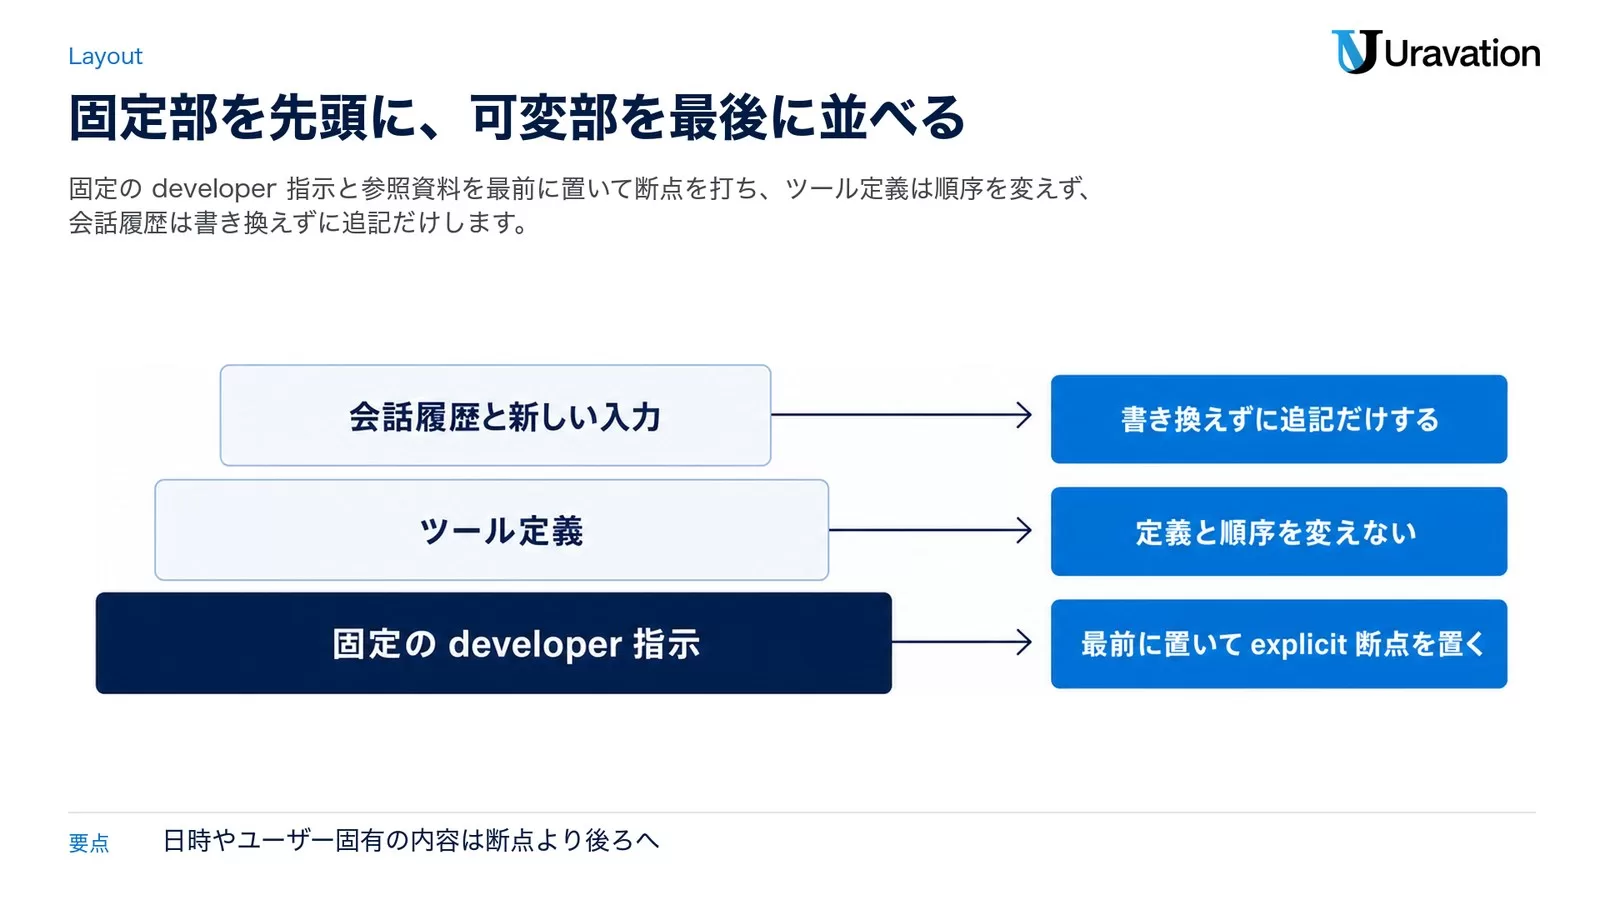
| 層 | 置くもの | 公式ガイドの推奨 |
|---|---|---|
| 第1層(最前) | 固定の developer 指示・共有の参照資料 | タイムスタンプやユーザー固有の内容は先頭に置かず、末尾か後続メッセージへ移す。ここに explicit 断点を置く |
| 第2層 | ツール定義 | 定義・順序・スキーマを変えない。使わせないときは tool_choice: "none" か allowed_tools。途中で足すときは developer ロールの additional_tools 入力アイテム |
| 第3層(末尾) | 会話履歴と新しい入力 | 過去ターンを書き換えず追記だけする。要約・compaction・切り詰めは接頭辞を変える |
複数ターンのエージェントの公式例
公式ガイドの「Multi-turn agent」の例です(モデル名を gpt-6-sol に置き換え。元の例は gpt-5.6-sol)。implicit モードのまま、各ツール結果の input_text に explicit 断点を足して、途中の接頭辞も再利用できるようにしています。prompt_cache_key はユーザー 456 のキャッシュ会計を分けるためのもので、分ける必要がなければ省略できます。
{
  "model": "gpt-6-sol",
  "reasoning": { "effort": "medium", "context": "all_turns" },
  "text": { "verbosity": "medium" },
  "prompt_cache_key": "agent_123_v1:user_456",
  "prompt_cache_options": { "mode": "implicit" },
  "tools": [
    {
      "type": "function",
      "name": "function_name",
      "description": "Function description",
      "parameters": { "...": "..." }
    }
  ],
  "input": [
    {
      "role": "developer",
      "content": "Stable developer instructions and reference material..."
    },
    { "role": "user", "content": "Can you do...?" },
    {
      "type": "function_call",
      "call_id": "call_123",
      "name": "function_name",
      "arguments": "..."
    },
    {
      "type": "function_call_output",
      "call_id": "call_123",
      "output": [
        {
          "type": "input_text",
          "text": "Tool result...",
          "prompt_cache_breakpoint": { "mode": "explicit" }
        }
      ]
    },
    { "role": "assistant", "content": "Assistant response..." },
    { "role": "user", "content": "Can you also do...?" }
  ]
}
公式ガイドは、この構成のデプロイ例で「トークンのキャッシュ命中率が 90% を超えた」と紹介しつつ、「あくまで一例で、実際の上限はコンテキストと使い方で変わる」と注記しています。単発の LLM-as-a-Judge(採点ルーブリックと few-shot 例を固定部にし、評価対象の会話を断点の後ろに置く構成)では「約 70%」が例示されています。どちらも公式の例示値で、筆者の測定ではありません。
ツールを途中で増やすときの順序
Tool search を使う場合は、関数定義に defer_loading: true を付けると、必要になるまで定義がコンテキストに載らず、見つかったツールはコンテキストの末尾に追加されます。前の再利用可能な内容が保たれるので、多ターンのスレッドで序盤の入力トークンを減らせます。ツール検索の外で自分のロジックによってツールを足すときは additional_tools 入力アイテムを使い、会話アイテムを手で往復させるときはそのアイテムの位置を保ちます。なお additional_tools アイテムには現時点で prompt_cache_breakpoint を付けられません。
compaction との付き合い方
compaction(context_management)は過去の会話を短い表現に置き換えるため、その直後のリクエストは前回のキャッシュをあまり再利用できません。公式ガイドは「固定の指示と参照資料は安定させ、圧縮後のコンテキストに以後のターンを積む」「命中率が下がっても入力トークン自体が減れば総額は下がることがあるので、圧縮前後の入力コスト総額で比べる」よう勧めています。
費用の計算例|GPT-6 Solで100リクエストを回した場合
ここは試算例(実測値ではありません・前提と計算式を明示)です。単価は OpenAI の料金表(2026年9月23日参照)の Standard・短コンテキストの値を使います。
| モデル | 入力 | キャッシュ読み取り | キャッシュ書き込み | 出力 |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $12.50 | $50.00 |
| gpt-6-sol | $2.00 | $0.20 | $2.50 | $10.00 |
| gpt-6-luna | $0.10 | $0.01 | $0.125 | $0.50 |
| gpt-5.6-sol(参考) | $4.00 | $0.40 | $5.00 | $20.00 |
いずれも 100万トークンあたりの USD。入力が 272,000 トークンを超えるリクエストは入力とキャッシュが 2 倍、出力が 1.5 倍になります。Batch と Flex は Standard の 50%、Fast mode は 2 倍です。GPT-6 Astra の料金と移行の注意はGPT-6 Astra API|料金・1.05M・移行手順【2026年9月】にまとめています。
前提
- モデル: gpt-6-sol(Standard)
- 固定部(開発者指示+ツール定義+参照資料): 20,000 トークン。explicit 断点をここに置く
- 各リクエストの新規入力: 2,000 トークン、出力: 1,000 トークン
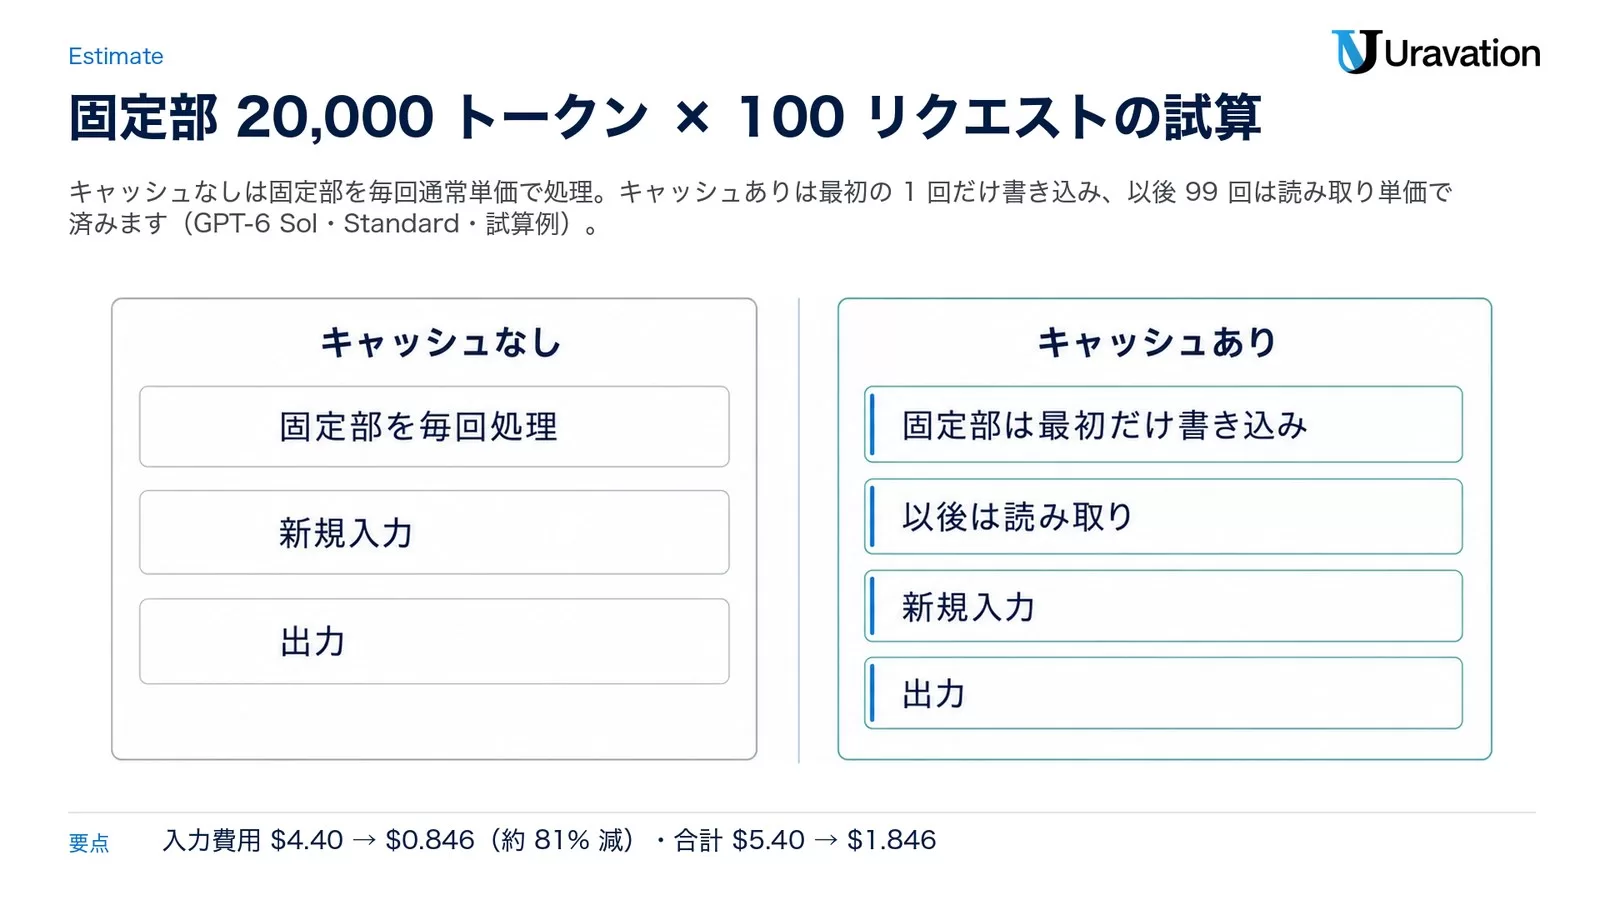
- リクエスト数: 100 回。すべて 30 分の保持時間内に送られ、固定部は最初だけ書き込み、以後は読み取り(2 回目以降は固定部が毎回キャッシュに当たる)と仮定
計算
| 項目 | キャッシュなし | キャッシュあり |
|---|---|---|
| 固定部の処理 | 20,000 × 100 = 2,000,000 トークン × $2.00 = $4.00 | 書き込み 20,000 × $2.50 = $0.05、読み取り 20,000 × 99 = 1,980,000 トークン × $0.20 = $0.396 |
| 新規入力 | 2,000 × 100 = 200,000 トークン × $2.00 = $0.40 | 同じ $0.40 |
| 入力の小計 | $4.40 | $0.846 |
| 出力 | 1,000 × 100 = 100,000 トークン × $10.00 = $1.00 | 同じ $1.00 |
| 合計 | $5.40 | $1.846 |
この前提では入力費用が $4.40 から $0.846 へ(約 81% 減)、出力を含む合計は $5.40 から $1.846 へ(約 66% 減)です。出力の単価は入力の 5 倍なので、出力が長い用途ではキャッシュの効きが合計に占める割合は小さくなります。逆に、参照資料が大きく出力が短い用途(分類・抽出・判定)ほど効果が大きくなります。
固定部が 1,024 トークンに届かないとき
公式ガイドには「最小キャッシュ長のコストの罠」という節があり、共通の接頭辞が 1,024 トークンに届かない場合に、有用で安定した指示や例を足して 1,024 トークンまで伸ばすほうが安くなる条件が式で示されています。最小長 1,024・読み取り 0.1 倍・書き込み 1.25 倍のとき、損益分岐となる元の接頭辞長は「102.4 + 1,177.6 ÷ リクエスト数」トークンで、10 リクエストなら 221 トークン以上の接頭辞は 1,024 トークンへ伸ばしたほうが安く、再利用回数が増えるほど分岐点は 102.4 トークンに近づきます。102 トークン以下の接頭辞はこの前提では伸ばしても得になりません。
Anthropicのプロンプトキャッシュとの違い
Claude 側の仕様は Anthropic の公式ドキュメント(2026年9月23日参照)に基づきます。実装の詳細は既刊のAnthropic Prompt Caching完全実装ガイドを参照してください。
| 項目 | OpenAI GPT-6(GPT-5.6 以降) | Anthropic Claude |
|---|---|---|
| 断点の指定 | prompt_cache_breakpoint を content ブロックへ。モードは prompt_cache_options.mode |
cache_control: {"type": "ephemeral"}。リクエスト最上位に置く自動キャッシュか、ブロック単位の明示断点 |
| 断点の数 | 1 リクエスト最大 4 書き込み | 最大 4 |
| 最小キャッシュ長 | 1,024 トークン | モデル別。Fable 5.1・Opus 5.5・Opus 5・Fable 5 は 512、Sonnet 5・4.6・4.5 は 1,024、Haiku 4.5 は 4,096 |
| 保持時間 | ttl: "30m" のみ。最後の書き込みか再利用から 30 分以上 |
既定 5 分。ttl: "1h" で 1 時間(書き込み単価が上がる) |
| 書き込み単価 | 入力の 1.25 倍 | 5 分は 1.25 倍、1 時間は 2 倍 |
| 読み取り単価 | 入力の 0.1 倍 | 原則 0.1 倍。Fable 5.1・Mythos 5.1 は 0.025 倍、Opus 5.5 は 0.05 倍 |
| usage のフィールド | input_tokens_details.cached_tokens/cache_write_tokens |
cache_read_input_tokens/cache_creation_input_tokens(input_tokens は断点より後ろの分だけ) |
| 照合のさかのぼり | explicit 断点は最初の 2 つと最新 50 個、implicit ではさらに最大 20 個の対象メッセージの終わり | 断点ごとに最大 20 ブロック |
| 診断 | prompt_cache_diagnostics(理由つき) |
usage の 2 フィールドで判定(公式ドキュメントの記載範囲) |
| 事前ウォーム | prompt_cache_options.prewarm |
公式ドキュメントに「Pre-warming the cache」の節あり |
単価の並びも見ておきます。Claude Sonnet 5 は入力 $2/5 分書き込み $2.50/読み取り $0.20/出力 $10 で、GPT-6 Sol の Standard 単価と同じ数字です。Claude Opus 5.5 は入力 $4/5 分書き込み $5/1 時間書き込み $8/読み取り $0.20/出力 $20、Claude Fable 5.1 は入力 $10/5 分書き込み $12.50/1 時間書き込み $20/読み取り $0.25/出力 $50 です(いずれも 100万トークンあたり・Anthropic 公式の料金表)。読み取り倍率は Anthropic の上位モデルのほうが低く、保持時間は OpenAI のほうが長い、という違いが 2026年9月23日時点の公式記載です。
よくある失敗パターンと回避策
公式ガイドの「Gotchas」と診断ガイドの「Fix a cache miss」から、GPT-6 への移行で起こりやすいものを 4 つ選びました。
失敗1: 共通の接頭辞があるのにキャッシュに当たらない
❌ implicit モードのまま「固定の developer 文+毎回違う user 文」を送る。1 回目は user 文まで含めて書き込まれ、2 回目は user 文が違うので長い接頭辞に一致せず、固定部だけの断点も無い。
⭕ 固定の developer 文を input_text ブロックにして prompt_cache_breakpoint を付け、prompt_cache_options.mode を "explicit" にする。1 回目が固定部を書き、2 回目以降は user 文が変わっても固定部を再利用できる。
なぜ重要か: GPT-5.5 以前は一定間隔の implicit 断点で救われていた構成が、GPT-5.6 以降では「最新の対象メッセージの終わり」だけになるため、移行直後にこの形で命中率が落ちやすいと公式ガイドが指摘しています。
失敗2: implicit から explicit-only に切り替えて前回の書き込みを取りこぼす
❌ リクエスト 1 を implicit で送り、リクエスト 2 で mode: "explicit" に切り替える。リクエスト 2 は自分の explicit 断点しか照合しないので、リクエスト 1 が書いた implicit の接頭辞を再利用しない。
⭕ リクエスト 2 でも implicit のままにするか、リクエスト 1 の終点と同じ content ブロック境界に explicit 断点を置く。
失敗3: 同じメッセージを伸ばして送る
❌ リクエスト 1 の最後の user メッセージが「内容 A」で、リクエスト 2 で同じメッセージを「内容 A + 内容 B」に伸ばす。前回の終点がメッセージの途中になり、implicit 同士でも再利用されない。
⭕ 元のメッセージを保ったまま新しいメッセージを追記する。構造上それができないなら、再利用したい文を別の content ブロックにして、両方のリクエストでその後ろに explicit 断点を置く。
失敗4: ツールや設定を毎回いじる
❌ ターンごとにツール定義を出し入れする、reasoning.effort をリクエスト上位で切り替える、指示文の先頭にタイムスタンプを入れる。診断では tools_changed・reasoning_effort_changed・input_changed として返る。
⭕ ツールは定義を残して tool_choice: "none" か allowed_tools で制御し、推論の強さは configuration_update で変え、変わる内容は断点より後ろへ移す。
そのほか、モデルの自動フォールバックや A/B テストで model_changed が出る、要求した service_tier と実際の処理階層が違って service_tier_changed が出る、といったケースも診断の一覧に載っています。
よくある質問
プロンプトキャッシュとは何ですか?
複数のリクエストで先頭部分(接頭辞)が同じとき、その部分のモデル内部の計算結果(KV 状態)を保存して使い回す仕組みです。OpenAI では対応モデルで既定で有効になっており、再利用されたトークンは通常入力の 0.1 倍の単価になります。保存されるのは KV テンソルで、トークンそのものではありません。
GPT-6 で何か設定を変えないとキャッシュは効きませんか?
何もしなくても implicit モードで有効です。ただし「長い固定部+毎回違う末尾」の構成では固定部だけが再利用されないことがあるので、固定部の終わりに prompt_cache_breakpoint を置き、必要なら prompt_cache_options.mode を "explicit" にすると狙った範囲だけをキャッシュできます。
キャッシュは何分残りますか?延ばせますか?
GPT-5.6 以降は prompt_cache_options.ttl が "30m" のみで、最後の書き込みか再利用から 30 分は再利用できます(それより長く残ることもあります)。再利用するたびに寿命が延び、追加の書き込み料金はかかりません。以前の prompt_cache_retention: "24h" は GPT-5.6 以降では使わず、API リファレンスで非推奨と明記されています。
キャッシュが効いているかはどこで確認できますか?
レスポンスの usage.input_tokens_details.cached_tokens(読み取り)と cache_write_tokens(書き込み)で確認できます。組織全体の推移は Prompt Caching Dashboard、個々のリクエストで命中しなかった理由は prompt_cache_options.comparison_response_id を付けて返る prompt_cache_diagnostics で分かります。
キャッシュされた入力はレート制限や出力に影響しますか?
キャッシュ読み取り分も 1 分あたりトークン数(TPM)の制限には数えられます。出力の生成には影響せず、同じリクエストでも同じ出力が返るとは限りません。また、キャッシュを手動で消す操作は用意されておらず、保持時間の経過で失効します。
まとめ
GPT-6 のプロンプトキャッシュ強化は、単価の値下げではなく「命中率を上げ、命中しない理由を見え、狙った範囲だけ書き込める」ようにした変更です。2026年9月23日時点の公式記載を前提に、やることは 4 つに絞れます。
- 固定部を先頭に、可変部を末尾に並べ直し、固定部は 1,024 トークン以上にする
- 固定部の終わりに
prompt_cache_breakpointを置き、可変部を書き込みたくなければmode: "explicit"にする - 推論の強さは
configuration_update、ツールはtool_choice: "none"/allowed_tools/defer_loadingで変え、定義そのものを動かさない cached_tokens・cache_write_tokensで命中率と入力コストを集計し、落ちたらcomparison_response_idで理由を取る
GPT-6 Astra への移行全体のチェックリストはGPT-6 Astra移行の準備5点|開発者チェックリスト【2026年9月】にあります。本記事の数値と仕様は公式ドキュメントの参照日時点のもので、単価・保持時間・対応モデルは変わることがあります。実装前に下の出典を再確認してください。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
著者: 佐藤傑(さとう・すぐる)。株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。著書『AIエージェント仕事術』。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Better prompt caching for GPT-6 — OpenAI(公開 2026-09-22・参照日 2026-09-23。本文は Cloudflare の認証画面で取得できなかったため、要点は下記の発表文と公式ガイドから確認)
- Introducing GPT-6 Sol and Luna — OpenAI(公開 2026-09-22・参照日 2026-09-23。「Improving caching for agents and long conversations」節と API 価格)
- Prompt caching — OpenAI 公式ガイド(参照日 2026-09-23。仕組み・断点・保持時間・最適化・Gotchas・コード例)
- Prompt cache diagnostics — OpenAI 公式ガイド(参照日 2026-09-23。
comparison_response_id・prompt_cache_diagnostics・理由の一覧) - Reasoning models — OpenAI 公式ガイド(参照日 2026-09-23。「Change reasoning mid-conversation」の
configuration_update) - Create a model response — OpenAI API リファレンス(参照日 2026-09-23。
prompt_cache_options・prompt_cache_retentionの非推奨・usageのフィールド) - Pricing — OpenAI(参照日 2026-09-23。GPT-6 Astra・Sol・Luna の Standard/Batch/Flex/Fast 単価)
- GPT-6 Sol — OpenAI モデルページ(参照日 2026-09-23。コンテキスト 1,050,000・単価・対応機能)
- Prompt caching — Anthropic 公式ドキュメント(参照日 2026-09-23。
cache_control・保持時間・最小長・単価・usage フィールド)