Kevは、TypeSafe の判断モデル Jev とまったく同じ要求の形(POST /v1/systemone)を受け取り、自分のマシンの中で答えを返すオープンウェイトのモデル群です。2026年9月22日時点で公開されているのは Kev-0.8B・Kev-4B・Kev-9B の3つ、ライセンスは Apache-2.0、重みは Hugging Face にあります。
読み違えやすいのは「Jev の代わりが無料で手に入った」という受け取り方です。公式の README が載せている数字を素直に読むと、学習していないデータでの正答率は Kev-9B が 0.822、Jev が 0.857 で、Jev のほうが上です。Kev の価値は精度で勝つことではなく、重みが手元にあることと自分のデータで学習し直せることに寄っています。
この記事は、GitHub の README、3つのモデルカード、Hugging Face のモデルページ、TypeSafe の公式ドキュメントを2026年9月22日に自分で開いて読み、そこに書いてある値だけで構成しています。筆者はこのモデルを手元で動かしていないため、コマンドと応答例はすべて公式の例としてそのまま引用します。
- 公開は速い。リポジトリ作成が2026年9月17日、Kev-0.8B・4B・9B のリリースが9月20日、README が Qwen3.5 版へ書き換わったのが9月21日
- 作者は Jared Palmer 氏。GitHub プロフィールの所属欄は Cognition、README の謝辞には「Built with Devin」とある
- 2026年9月22日時点の GitHub スター数は 2,412、フォーク数は 124
- 公開直後に X で告知された 0.6B・4B・8B は Qwen3 ベースの旧世代。現行は Qwen3.5 ベースの 0.8B・4B・9B
Kevとは|Jevと同じAPIで動くオープンウェイトの判断モデル
判断モデル(decision model)は、文章を生成しません。評価したい本文(state)と、型のついた質問(questions)をまとめて渡すと、質問ごとの確率分布を1回の前向き計算で返します。「90%の確信度です」という文字列を書かせて、それを確率として扱う従来のやり方をやめる、という発想です。
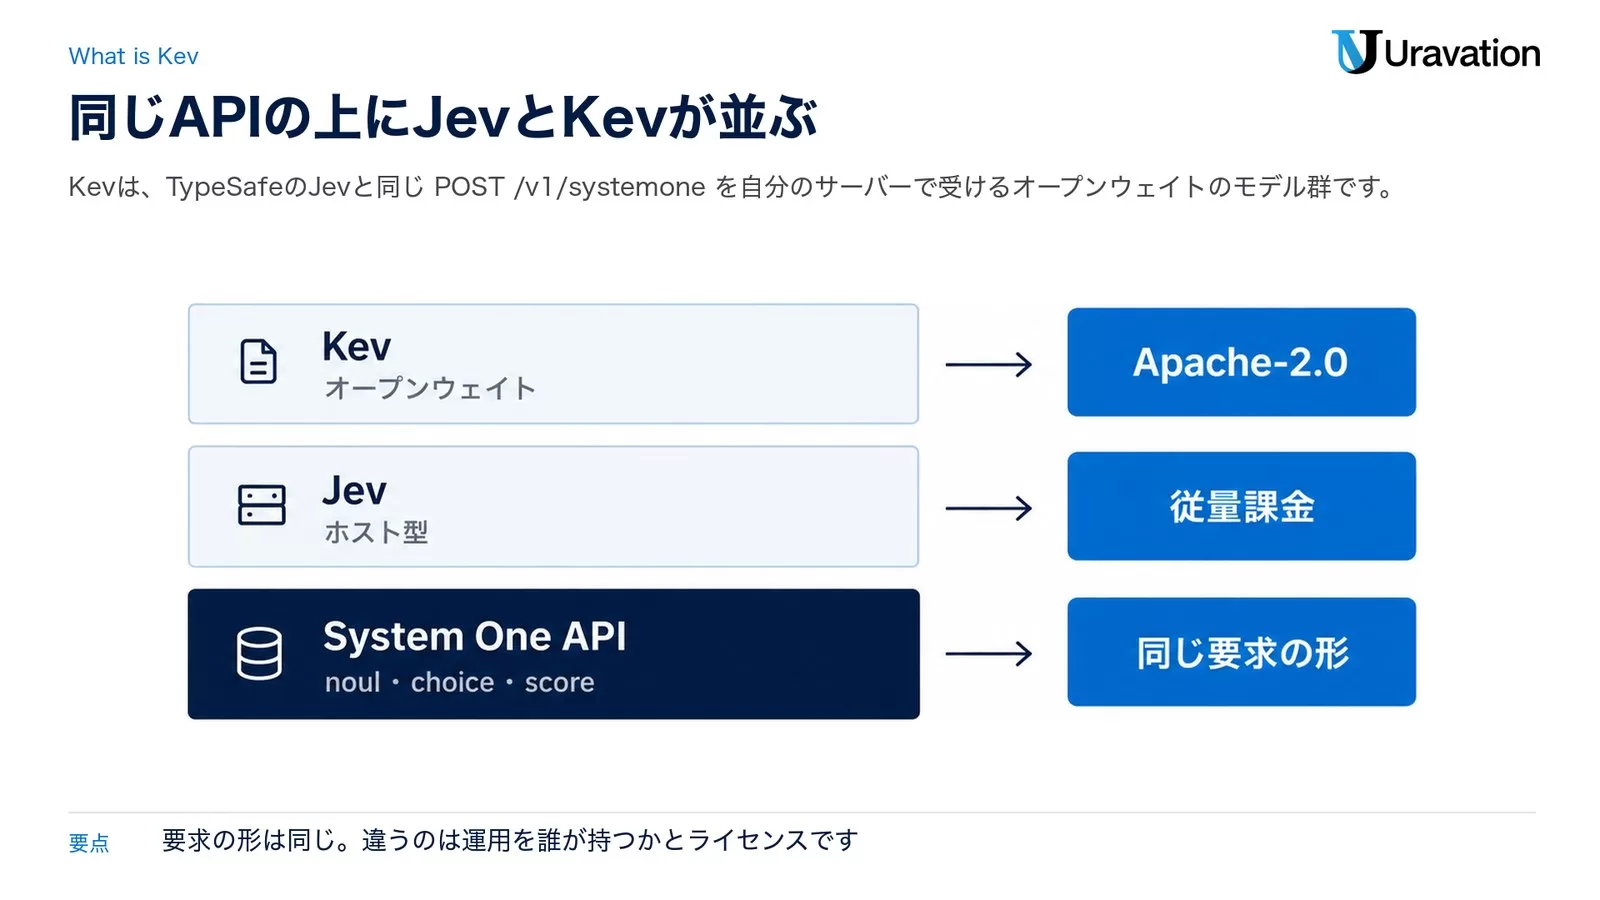
Kev はその発想を、誰でも落としてこられる重みで再現したものです。README の一行目は「Small Jev-like decision models you can train and run yourself」。TypeSafe の System One API に合わせてあるので、TypeSafe の Python SDK の接続先をローカルサーバーへ向けるだけで動きます。
質問の型は3つだけ
| 型 | 渡すもの | 返ってくるもの |
|---|---|---|
noul |
はい/いいえの説明(省略可) | noul=「はい」の確率 |
choice |
選択肢の名前と説明(1〜255個) | 最有力の選択肢、probabilities、confidence |
score |
低い順に並べた水準の説明 | 水準の期待値(0始まり)、legend、probabilities、confidence |
3つの型は1回の要求の中に混ぜられます。README が明示しているのは「質問は state を共有するが、質問どうしは互いを読めない」という性質です。ルーティングの質問の答えが、隣のエスカレーション判定に漏れない、ということになります。
公開されている3つのモデル
| モデル | ベース | 学習済み出所の正答率 (開発/テスト) |
新規出所の正答率 (開発/テスト) |
新規出所の Brier (開発/テスト) |
|---|---|---|---|---|
| Kev-0.8B | Qwen3.5-0.8B-Base | 0.825 / 0.834 | 0.652 / 0.684 | 0.499 / 0.460 |
| Kev-4B | Qwen3.5-4B-Base | 0.872 / 0.871 | 0.797 / 0.837 | 0.299 / 0.255 |
| Kev-9B | Qwen3.5-9B-Base | 0.872 / 0.874 | 0.822 / 0.852 | 0.286 / 0.237 |
| Jev | ホスト型 | 0.845 / - | 0.857 / - | 0.211 / - |
README は「まず Kev-4B から。メモリより精度と較正が大事なら Kev-9B。最小が必要なときだけ Kev-0.8B」と勧めています。3つとも同じ学習データ(decision-v7)と同じ手順で作られていて、README は「違うのはベースだけ」と説明しています。設定で違うのは学習率で、Kev-0.8B が 1e-4、Kev-4B と Kev-9B が 5e-5 です。
Jev と Kev は何を共有し、どこで分かれるか
- System One API:
POST /v1/systemoneという同じ要求の形を両方が受け取る。型は noul・choice・score の3つ - Jev:TypeSafe が運用するホスト型。使った入力トークンぶんの従量課金
- Kev:重みが配られるオープンウェイト。アダプターとヘッドは Apache-2.0
判定そのものを外部 API に任せる設計の勘所は、姉妹記事のJev API入門|if判定を任せる判定モデルにまとめてあります。Kev はその記事で扱った要求と応答を、そっくりそのまま自前のサーバーで受ける選択肢だと考えると分かりやすいはずです。
仕組み|Qwen3.5のベースにLoRAとポインターヘッドを重ねる
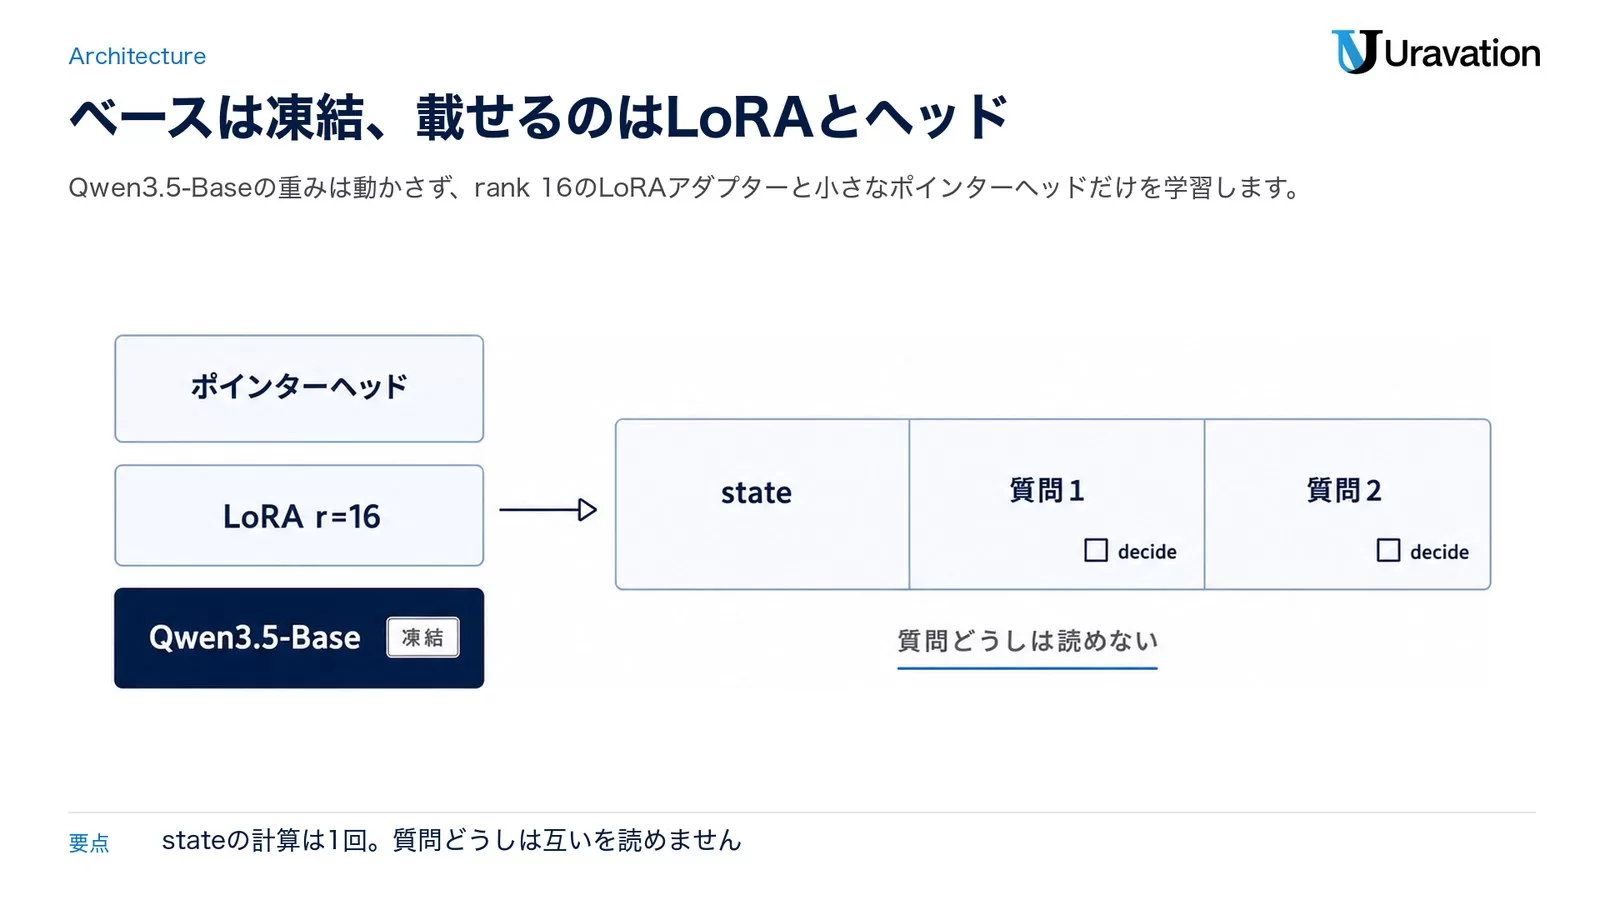
チェックポイントの中身は、ベースモデル本体ではありません。README の記述では、各チェックポイントは Qwen3.5-Base の上に載せた LoRA r=16 のアダプターと、小さなポインターヘッドです。Kev-4B のモデルカードによれば、学習されるパラメータは 33.8M(3,380万)で、ベースの重みは凍結されたまま動きません。
ひとつの列に state と質問を並べる
注意機構だけで作られたベース(Qwen3 世代)では、state と質問がひとつのトークン列に並びます。README が載せている形はこうです。
<state> …state…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
注意マスクは「そのトークンが state と自分の質問1・質問2のうち自分自身だけを読める」ように組まれ、各質問の位置IDは state の直後から振り直されます。だから state の計算は1回で済み、質問はそれぞれ独立に答えられます。
ところが Qwen3.5 は、注意層と Gated DeltaNet 層(再帰型の線形注意)を混ぜた構造です。再帰層は注意マスクを無視するため、Kev は Qwen3.5 系では質問ごとに別の行として走らせています。行が独立している以上、質問どうしは読めないという性質は構造から保証され、サーバーは state を1回計算してそのキャッシュを全部の行で使い回します。
ポインターヘッドが確率を作る
ポインターヘッドは、各選択肢の </opt> の隠れ状態を、その質問の <decide> の隠れ状態と突き合わせて点数を出し、softmax で確率に変えます。<decide> が列の最後に来るので、選択肢の一覧を全部見たうえで点数がつく、という順序になります。
学習は正解に対するクロスエントロピーだけ。アダプターとヘッドを一緒に学習し、ベースは触りません。README は「Jev の出力は学習に使っていない」とはっきり書いています。蒸留モデルではない、ということです。
LoRA でドメインを足す考え方そのものは、QLoRA/LoRAでAIエージェントをドメイン適応させる実装ガイドで扱った枠組みと同じです。Kev が特殊なのは、そこにポインターヘッドという「答えを指す部品」を足している点です。
Jevとの位置関係|提供形態・精度・料金・学習データ
比較は README と TypeSafe 公式ドキュメントの両方を開いて突き合わせます。数字はどちらも2026年9月22日に参照した公式値です。
| 観点 | Jev(TypeSafe) | Kev |
|---|---|---|
| 提供形態 | ホスト型 API。現行は jev-1.13.0 |
重みを配布。自分のサーバーで kev.serve |
| 料金 | 入力100万トークンあたり 0.042 ドル。出力トークンは無料 | モデル利用料は無し。GPU または Mac の費用だけ |
| 新規出所の正答率 | 0.857(開発セット) | 0.822(Kev-9B・開発セット)/0.852(テスト) |
| 新規出所の Brier | 0.211 | 0.286(Kev-9B・生の確率) |
| Choice の選択肢数 | 最大 255 | 最大 255 |
| Score の水準数 | 最低2、API は 10 まで受け付ける | 2〜255 |
| コンテキスト | 1回 64,000 トークン。state と最長の質問で 32,000 | state と質問1つで 8,192 トークンまで |
| レート制限 | 1秒あたり25万トークン、1分あたり1,200リクエスト | サーバーは1リクエストずつ処理 |
| 学習データの出所 | 非公開 | 公開10データセットと生成データ。モデルカードに一覧 |
| ライセンス | 利用規約に従う商用サービス | Apache-2.0(アダプターとヘッド・ベースも Apache-2.0) |
精度の差をどう読むか
README は Kev-9B について「新規出所の開発セットで Jev に 3.5 ポイント差をつけられている(0.822 対 0.857)」と書いたうえで、続けて「Jev がどのデータセットで学習されたか分からないので、これは2つのアーキテクチャの統制された比較ではない」と断っています。公式が自分で比較の限界を書いているので、この記事でも「Kev が Jev に迫った」とは書きません。
一方で、外部の第三者が作った評価セットでは順位が入れ替わる場面もあります。README の evals/external/ に載っているのは次の2件です。
| 外部評価セット | Kev-9B | Jev |
|---|---|---|
| SemIf の手書き判断 144件 | 0.917 | 0.965 |
| scienthoon のサポートチケット 900件(ルーティング) | 0.952 | 0.897 |
| 同上(トーン判定) | 0.911 | 0.914 |
サポートチケットのルーティングのように「型が決まっていて、判断材料が本文に書いてある」仕事では、Kev-9B が Jev を上回っています。逆に知識を問う設問では差がはっきりしていて、MMLU は Kev-9B 0.74 に対して Jev 0.90、MMLU-Pro は 0.52 対 0.84 です。README はこの差をベースモデルで決まる部分だと説明しています。
触ってみる最短手順|公式のQuick Startとコード例
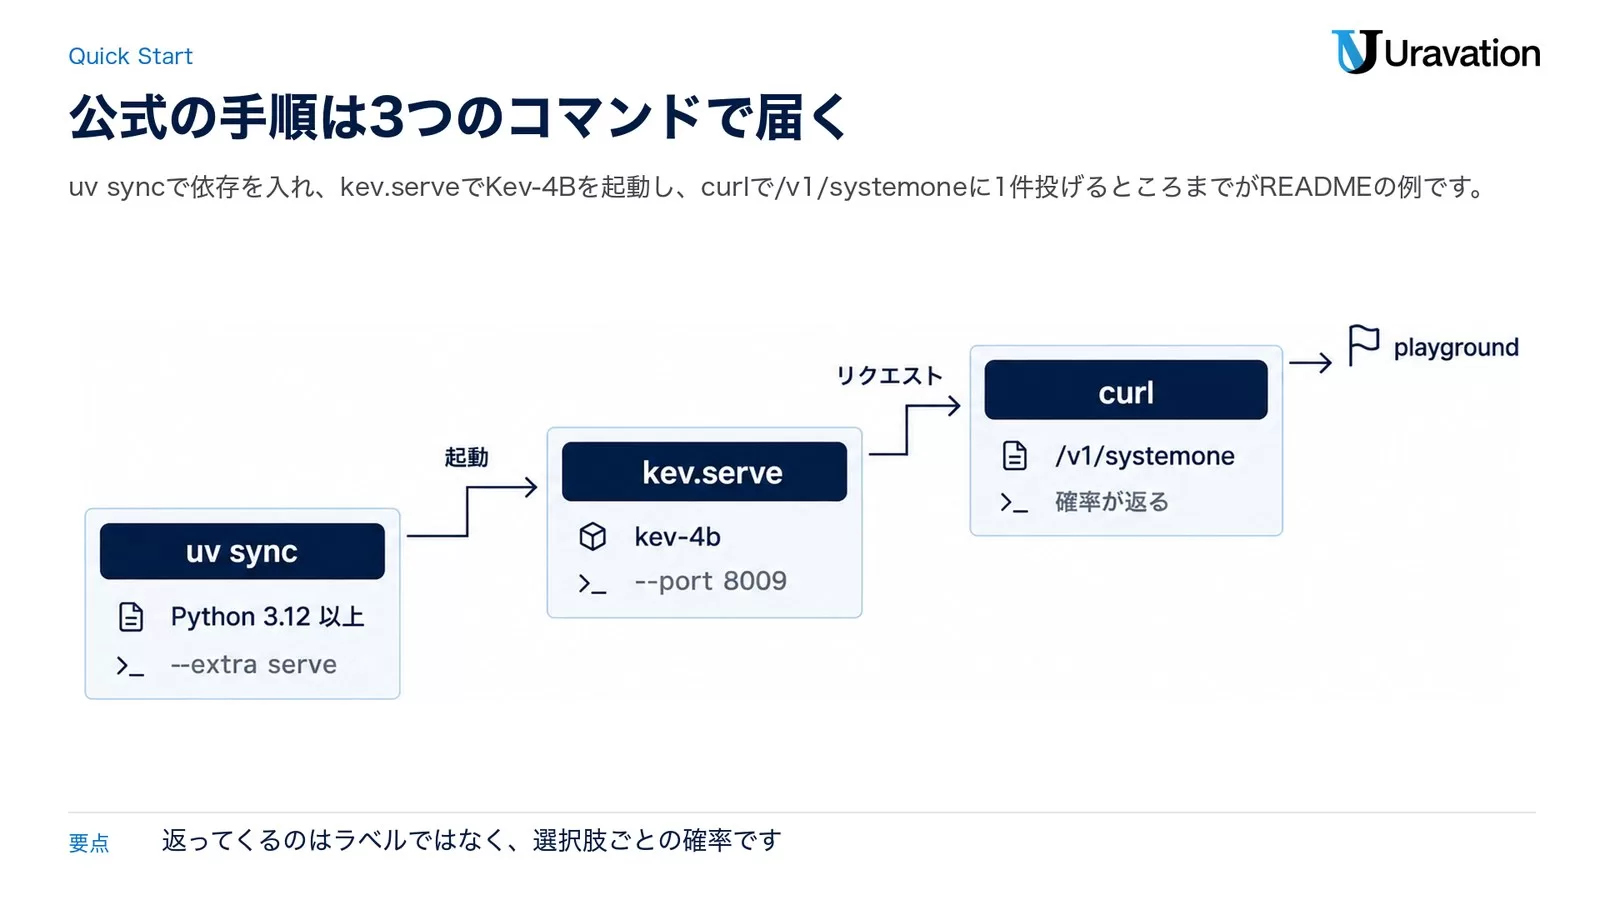
ここから先のコマンドは、すべて README に載っている公式の例です。筆者は実行していないので、所要時間や体感についての記述はしません。必要なのは Python 3.12 以上と uv です。
1. サーバーを起動する(uv sync と kev.serve)
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
README によれば、初回の実行でアダプターとベースモデルがダウンロードされます。--run にはローカルのチェックポイントのディレクトリや、jaredpalmer/kev-4b@qwen3 のような Hub のリビジョンも渡せます。サーバーは 127.0.0.1 にだけ接続を受け、認証はありません。
2. リクエストを1件投げる(curl で /v1/systemone)
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
README が載せている応答例(Kev-4B を Apple M5 上の bf16 で動かしたもの)では、department の確率が returns 0.47・shipping 0.28・billing 0.25 に割れます。このチケットは返品・配送遅延・二重請求の3つを同時に含んでいるので、1つのラベルではなく確率が返ることに意味がある、というのが README の説明です。
3. Python SDK から呼ぶ
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)
response = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(
            instructions="What is the customer's tone?",
            criteria={"calm": None, "frustrated": None, "angry": None},
        ),
        "urgency": Score(
            instructions="How urgent is this ticket?",
            criteria=["can wait", "this week", "today"],
        ),
    },
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)
TypeSafe の SDK は uv sync --extra serve に同梱されています。本番で Jev を使っているコードがあるなら、base_url と model を差し替えるだけで宛先が変わる、という作りです。呼び出し側の組み方そのものは Jev API実装パターン7つ|Pythonコード例 で整理したものがそのまま使えます。
4. 入れずに試す
Hugging Face の Kev の Space では、Kev-4B と Kev-0.8B をブラウザから試せます。モデルカードによれば、Space は kev.serve と同じエンコーダと API コードを ZeroGPU 上で動かしています。ローカルに playground を立てたい場合は Node 20.9 以上を用意して cd playground && npm install && npm run dev -- -p 3001 です。選択肢の並び順を6通りに入れ替えて答えの揺れを見る「Permute」や、質問をまとめて聞く場合と1つずつ聞く場合を比べる「Packed vs separate」がプリセットとして用意されています。
精度表の読み方|Trained SourcesとNew Sources、Brier、較正
README の表には Trained Sources と New Sources という2つの列があり、それぞれが「開発/テスト」の2つの値を持ちます。ここを読み違えると、数字の意味が反対になります。
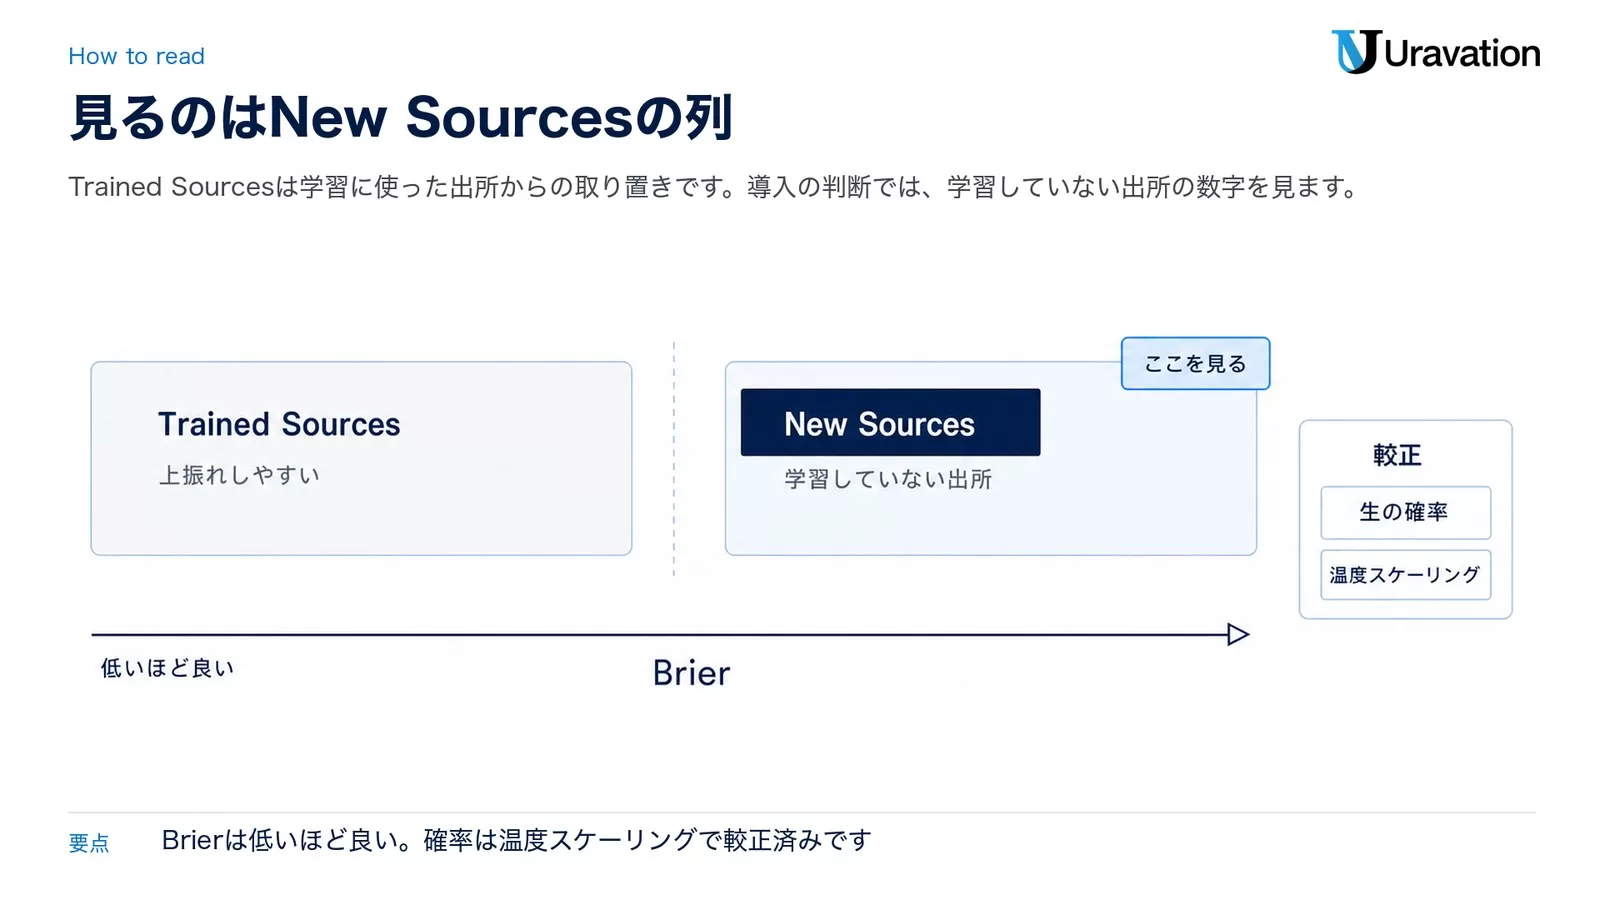
2つの列と2つの数字
- Trained Sources:Kev の学習に使ったデータセットから取り置いた例。上振れしやすい
- New Sources:学習していない出所のデータセットと、学習していない方針ルールの型。導入判断ではここを見る
- 開発セットはモデルを選ぶために何度でも読む。テストセットは候補を決めたあと1回だけ読む(README が「read once per released checkpoint, after model selection」と明記)
Brier は確率の当て方まで含めて測る指標で、低いほど良い数字です。正答率が同じでも、外したときに高い確率を出していれば Brier は悪化します。Kev-9B のテストセットでの Brier は 0.237 で、これが Kev 3種の中では最も良い値です。
較正(温度スケーリング)は既定で入っている
Kev は確率を出したあとに温度スケーリングをかけています。各チェックポイントが自分の温度(およそ 2.1〜2.4)を head.pt に持っていて、読み込み時にポインターヘッドが適用します。Kev-4B は 2.14、Kev-9B は 2.30、Kev-0.8B は 2.41 です。
README によれば、Kev-9B では較正によって較正誤差が 0.106 から 0.042 へ下がり、確率 0.9 以上で間違える「自信のある誤答」が 8.7% から 4.0% へ下がります(Jev は 3.7%)。答え自体は変わらないので正答率は同じです。生の確率を見たいときは KEV_TEMPERATURE=1.0 を指定します。表に載っている Brier は生の確率のほうの値です。
「何割を自動化できるか」は別の数字
実務で効くのは正答率よりも、README が coverage と呼んでいる指標です。誤りを5%以内に抑える閾値を引いたとき、人を通さずに流せる判断の割合を指します。Kev はこれが 0.45〜0.57、Jev は 0.70 と書かれています。同じ正答率でも、確率の並び方が良くないと自動化できる割合は伸びません。
日付の引き算は Kev の弱点として README に明記されています。KEV_DATE_FACTS=1 を立てると、state に出てくる2つの絶対日付の差を文として追記してくれます(「June 26, 2026 is 8 days before July 4, 2026」)。これを使うと Kev-9B の締切系の設問が 0.80 から 0.90 へ上がります(Jev は 0.93)。README は「これは前処理であり、モデル自身の数字には混ぜない」として別扱いにしています。
エージェント開発での使いどころ
ここまでの数字を前提にすると、置きどころは3つに分かれます。
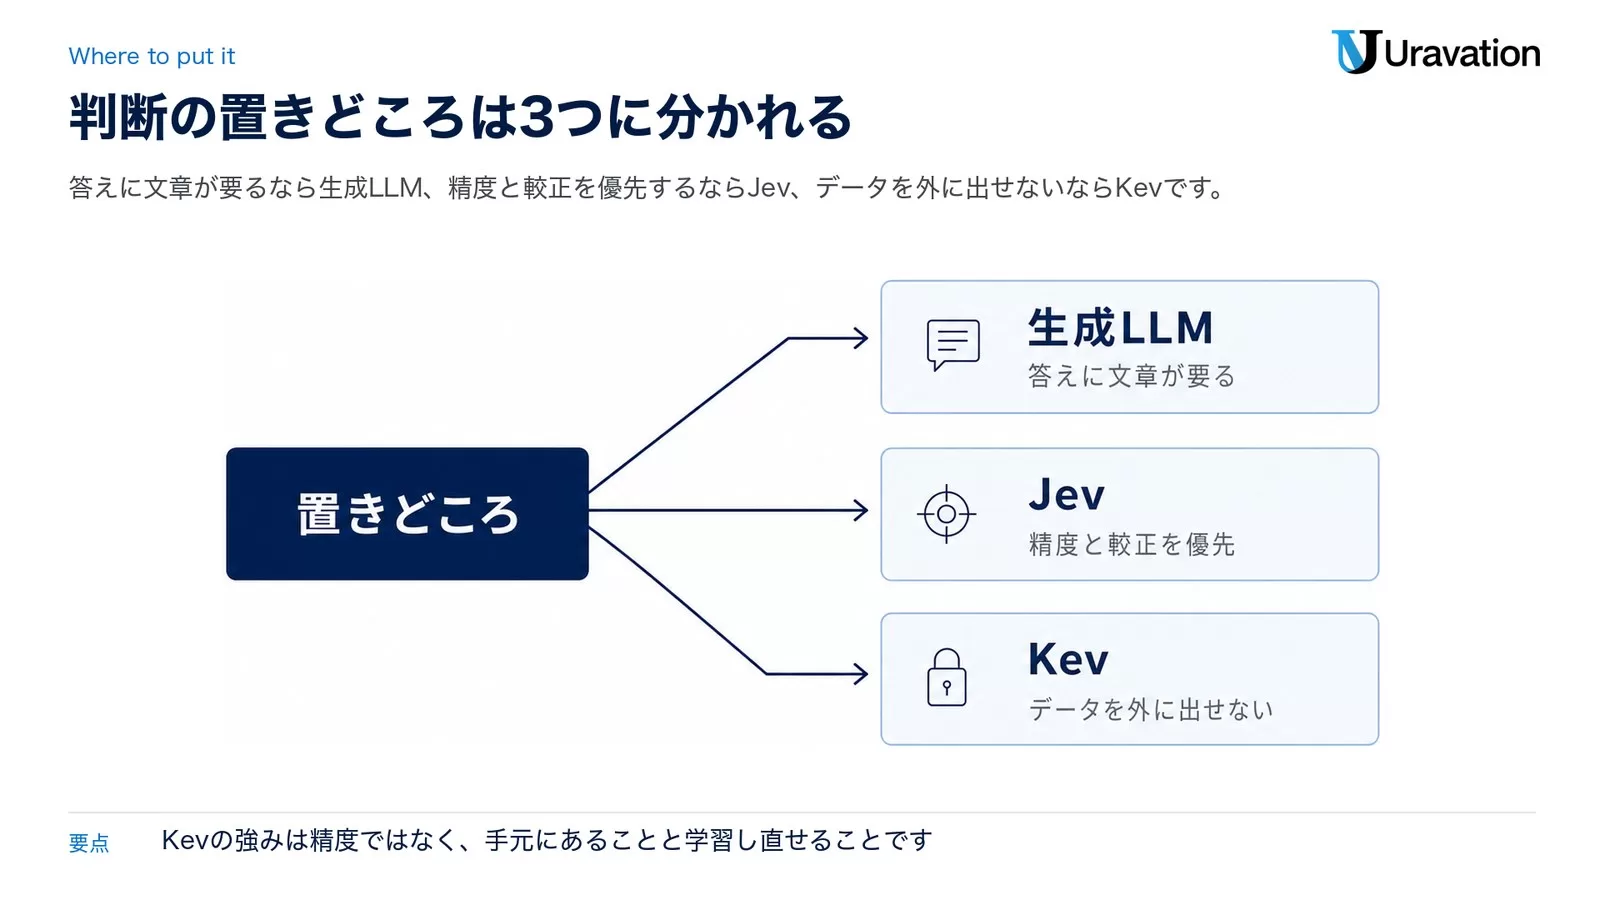
| 置きどころ | 向いている場面 | 判断の理由 |
|---|---|---|
| 生成LLM | 要約・下書き・説明文のように、答えに文章が要る仕事 | そもそも判断モデルは文章を返さない |
| Jev | 精度と較正を優先し、運用も任せたい仕事 | coverage 0.70・Brier 0.211 と、運用不要という利点 |
| Kev | データを外に出せない、または自分のデータで再学習したい仕事 | 重みが手元にあり、Apache-2.0 で改変できる |
自分のデータで学習し直せることが最大の差
README が強く勧めているのは、公開チェックポイントから始める --init_from です。学習データは1行1リクエストの JSONL で、API の要求とまったく同じ形に各質問の label を足すだけです。
{"state": {"subject": "Charged twice", "body": "I see two charges for order #4411. Please refund one."},
 "questions": {
   "team":     {"type": "choice", "instructions": "Which team should handle this ticket?",
                "criteria": {"billing": "Payments and refunds", "shipping": "Delivery problems", "access": "Login and account access"}, "label": "billing"},
   "angry":    {"type": "noul",   "instructions": "Is the customer angry?", "label": false},
   "priority": {"type": "score",  "instructions": "How urgent is this ticket?", "criteria": ["low", "normal", "high"], "label": 1}}}
uv run python -m kev.train --data train.jsonl --base Qwen/Qwen3.5-4B-Base --init_from jaredpalmer/kev-4b \
--epochs 2 --lr 2e-5 --batch 1 --accum 8 --dtype bf16 --checkpointing 1 --device cuda --out runs/mine
uv run python -m kev.benchmark --run runs/mine --data heldout.jsonl --out runs/mine-eval
KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run runs/mine --port 8009README は、あるユーザーがサポートツールの判断 836 件で試した結果を紹介しています。ベースモデルから学習し直した場合は Kev 自身の評価セットで 0.33 まで落ちたのに対し、公開モデルは 0.84。同じデータを --init_from 付きで学習すると評価セットで 0.83 を保ったまま、新しいドメインでは 0.88 に届いた、という内容です。学習率は最初から学習するときより小さく、2e-5 が出発点として挙げられています。
--batch 1 --accum 8 の bf16 なら、Kev-0.8B は 4GB の GPU に収まります。コーディングエージェントと一緒に進めたい場合は、README が案内している kev-finetune スキル(npx skills add jaredpalmer/kev@kev-finetune)が、Modal 上での学習から評価・エンドポイント展開・後片付けまでを手順化しています。
どのマシンで動かすか
README の Serving Performance には、Apple M5 の bf16 で「3選択肢の質問5つ・約230トークンの state」を投げたときのモデル処理時間の中央値が載っています。
| モデル | M5・bf16 での時間 | 同じ要求での旧世代 |
|---|---|---|
| Kev-0.8B | 329ミリ秒 | Kev-0.6B(Qwen3)123ミリ秒 |
| Kev-4B | 779ミリ秒 | Kev-4B(Qwen3)174ミリ秒 |
| Kev-9B | 約2秒 | Kev-8B(Qwen3)約300ミリ秒 |
Apple Silicon で遅いのは、DeltaNet 層に対応した高速カーネルが無く PyTorch の参照実装が走るためだと README は説明しています。CUDA と ROCm では flash-linear-attention を入れれば、質問5つの要求が H100 と MI300X で数十ミリ秒とされています。Mac で低遅延が要るなら当面は Qwen3 世代を使い、MLX バックエンドが次の予定だ、というのが公式の案内です。メモリはモデルカードの値で Kev-4B が bf16 でおよそ 9GB、Kev-9B がおよそ 19GB です。
ローカルで推論基盤を組む前提知識は、Ollamaの使い方 2026|ローカルLLMでAIエージェントとローカルAIエージェントとは|プライバシーと自律性が近い話題です。Kev は Ollama のような汎用サーバーではなく、専用の kev.serve を使う点が違います。
注意点|ライセンス・学習データ・未検証の範囲
ライセンスと商用利用
README の License 節は「Apache-2.0。Qwen3 と Qwen3.5 のベースモデルも Apache-2.0。学習データセットはそれぞれのライセンスに従う(モデルカード参照)」と書いています。アダプターとポインターヘッドが Apache-2.0、ベースも Apache-2.0 なので、モデルそのものの商用利用は妨げられません。
ただし Hugging Face のモデルページが列挙している学習データセット(banking77、BoolQ、AG News、MultiNLI、SST-5、Yelp Review Full、TREC、DBpedia-14、Amazon Reviews Multi、IMDB)は、それぞれ別のライセンスです。学習済みの重みを使う分には問題になりにくい一方、データを再配布したり学習を再現したりする場合は各データセットの条件を自分で確認する必要があります。
公式が挙げている限界
- 較正は in-distribution で合わせた単一の温度。閾値を決める前に自分のデータで確かめること、と README が明記している
- ファインチューニングでベースの個別能力が落ちることがある。日付計算がその例で、未学習の Qwen3.5-9B が 0.82 のところ、最初の Kev-9B は 0.72 だった
- 知識問題の差(MMLU 0.74 対 0.90、MMLU-Pro 0.52 対 0.84)はベースモデルで決まる。35B-A3B の混合エキスパート版で学習しても動かなかったと書かれている
- 選択肢の順番を変えると答えが変わりうる。質問の独立性はこれを防がない
- 学習は state 最大384トークン、state と質問1つで1,024トークンまで。サーバーは 8,192 トークンまで受けるが、それは学習範囲の外
- サーバーは同時に1件しか処理しない。state のキャッシュはするが、別の呼び出し元の要求をまとめて処理はしない
transformersは 5.17 以上、peftは 0.21 以上が必要
まだ確かめられていないこと
この記事は公式資料の読解であって、実行結果の報告ではありません。日本語の state での挙動、日本語のカテゴリ名を使った Choice の精度、国内の業務データでの coverage は、README にもモデルカードにも書かれていません。README 自身が「あなたの質問が学習データと違う形なら、数百件の教師データでの短い追加学習が、どんなプロンプト調整よりも効くことが多い」と書いているので、日本語で使うつもりなら自分のデータでの追加学習と測定が前提と考えるのが妥当です。2026年9月22日時点で、日本語向けの公式チェックポイントは公開されていません。
失敗パターン4つ|取り違えやすいところ
❌ X で見た「0.6B・4B・8B」で判断する
⭕ 公開直後の告知にあった 0.6B・4B・8B は Qwen3 ベースの旧世代です。現行は Qwen3.5 ベースの 0.8B・4B・9B。旧世代は README の折りたたみ節に残っていて、Mac では今も速い選択肢として案内されていますが、開発は終了しています。サイズの数字が合わない資料を見たら、まず世代を確認してください。
❌ Trained Sources の数字を導入判断に使う
⭕ Kev-4B の Trained Sources は 0.872 ですが、これは学習に使った出所からの取り置きです。自分の業務データは学習に入っていないので、見るべきは New Sources の 0.797(開発)/0.837(テスト)のほうです。さらに言えば、正答率より coverage(0.45〜0.57)のほうが自動化の判断には直結します。
❌ confidence を正答率として扱う
⭕ README は Choice の confidence を (p_max − 1/K) / (1 − 1/K) という式で定義し、「TypeSafe の式は公開されていないので、これはその近似」「どちらのフィールドも測定された正答率ではない」と明記しています。0.8 という confidence が「8割当たる」を意味しないので、閾値は必ず自分のデータで引き直します。
❌ ローカルだから安全、と考える
⭕ kev.serve は 127.0.0.1 にバインドされ、認証機構がありません。README も「自分で認証を足さない限りローカルから出すな」と書いています。社内ネットワークに公開したり、コンテナのポートを外に開いたりする構成にするなら、前段にリバースプロキシと認証を置く設計が要ります。
よくある質問
Kev は無料で商用利用できますか?
アダプターとポインターヘッドは Apache-2.0、ベースの Qwen3.5 も Apache-2.0 なので、モデル利用の料金はかかりません。ただし学習データセットは個別のライセンスを持つため、学習の再現やデータの再配布を行う場合は各データセットの条件を確認してください。運用費として GPU または Mac の費用はかかります。
GPU が無くても動きますか?
README は CUDA・ROCm・Apple Silicon で動くと書いており、Kev-4B と Kev-9B は bf16 なら 32GB の Mac に収まるとしています。ただし Apple Silicon では DeltaNet 層の高速カーネルが無いため遅く、M5・bf16 で質問5つの要求が Kev-4B で 779ミリ秒、Kev-9B で約2秒という中央値が公式に載っています。低遅延が要るなら CUDA か、旧世代の Qwen3 版を選ぶことになります。
Jev との違いは結局どこですか?
要求の形は同じで、違うのは提供形態・精度・改変の自由度です。Jev はホスト型で新規出所 0.857、Brier 0.211、coverage 0.70。Kev-9B は重みが配られて新規出所 0.822、Brier 0.286、coverage 0.45〜0.57。精度と較正は Jev が上、データを外に出さないことと再学習できることは Kev が上、という整理になります。
ローカルLLM で同じことをさせるのとは何が違いますか?
汎用のローカルLLM に判定させる場合、答えはテキストとして生成され、確信度も文章です。Kev は文章を生成せず、質問ごとの確率分布を1回の前向き計算で返し、その確率は温度スケーリングで較正されています。選択肢の確率が 0.47・0.28・0.25 のように割れて返ること自体が判断材料になる、という点が根本的に違います。
日本語のチケットにそのまま使えますか?
2026年9月22日時点で、公式に日本語での評価結果は公開されていません。Hugging Face のモデルページの言語タグは英語(en)です。README は「自分の分類カテゴリ、自分のエスカレーション規則、別の言語なら、数百件の教師データでの短い追加学習のほうが効く」と書いているので、日本語で使うなら --init_from を起点にした追加学習と、自前の評価セットでの測定を前提にしてください。
まとめ
Kev は、Jev と同じ POST /v1/systemone を自分のサーバーで受けられるオープンウェイトの判断モデルです。2026年9月22日時点の構成は Kev-0.8B・Kev-4B・Kev-9B の3つ、ベースは Qwen3.5、中身は rank 16 の LoRA アダプターとポインターヘッド、ライセンスは Apache-2.0。新規出所の正答率は Kev-9B が 0.822(Jev 0.857)で、精度と較正では Jev に届いていません。
それでも試す価値があるのは、重みが手元にあること、判断の確率が較正済みで返ること、そして --init_from で自分のデータに寄せられることの3点です。まずは Hugging Face の Space で Kev-4B に自分のチケットを1件投げてみて、確率の割れ方が業務の判断に使えそうかを見る。使えそうなら数百件の教師データを用意して追加学習と測定に進む。その順番が、公式資料から読み取れる素直な進め方です。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
以下はすべて2026年9月22日に参照しました。
- jaredpalmer/kev(GitHub・README とライセンス)
- Kev-0.8B, Kev-4B, Kev-9B のリリース(2026年9月20日)
- Kev-4B モデルカード(Hugging Face)
- Kev-9B モデルカード(Hugging Face)
- Kev-0.8B モデルカード(Hugging Face)
- Kev コレクション(Hugging Face)
- Kev の Space(ブラウザで試す)
- TypeSafe API リファレンス(System One の仕様)
- TypeSafe Models(Jev の料金・レート制限・コンテキスト)
- Archer Hume「Jev’s Architecture Unmasked」(2026年9月17日・README が土台にした解析)
- SemIf(外部評価セット)/scienthoon/jev-ood-calibration(外部評価セット)
判断をどこまでモデルに任せ、どこから人が持つか。この線引きは、モデルの精度よりも運用設計で決まります。
Uravation では、AIエージェントの導入設計と社内定着に向けた研修・伴走支援を行っています。判断の自動化をどの範囲から始めるかの整理からご相談いただけます。