Grok 4.7は2026年9月21日に公開され、2026年9月22日時点で xAI API(モデルID grok-4.7)・Grok Build・GitHub Copilot・Cursor の4つの入口から使えます。API単価は入力100万トークンあたり2.00ドル、キャッシュ入力0.50ドル、出力6.00ドル。文脈は50万トークンで、xAIの公式リリースノートによればこれはGrok 4.6と同じ価格帯です。
ただし「同じ単価」で通せる範囲は思ったより狭く、プロンプトが20万トークンを超えた瞬間にそのリクエスト全体が2倍の単価で課金されます。さらに出力速度を2倍にするFast版は公開APIには存在せず、CursorとGrok Buildだけの選択肢です。この記事は、開発者が今日から手を動かすために必要な「入口ごとの設定手順」と「単価が跳ねる条件」を、x.aiの発表・docs.x.ai・GitHub Changelog・Cursorのドキュメントから拾った値だけで整理します。
【総論】Grok 4.7 の料金・仕様・法人での使いどころ
Grok 4.6 からの変化、法人の業務での使いどころ、管理者が先に決めるデータの保持・処理場所、請求と品質でつまずく失敗パターンは、法人向けの総論として uravation.com 側にまとめています。 → Grok 4.7とは|料金・仕様・使い方と4.6からの変化【2026年9月】
結論|Grok 4.7が使える4つの入口と、それぞれの課金元
先に全体像です。同じ grok-4.7 でも、どこから呼ぶかで課金される財布と使える機能が変わります。下の表は2026年9月22日時点の公式ドキュメントの記載をそのまま整理したものです。
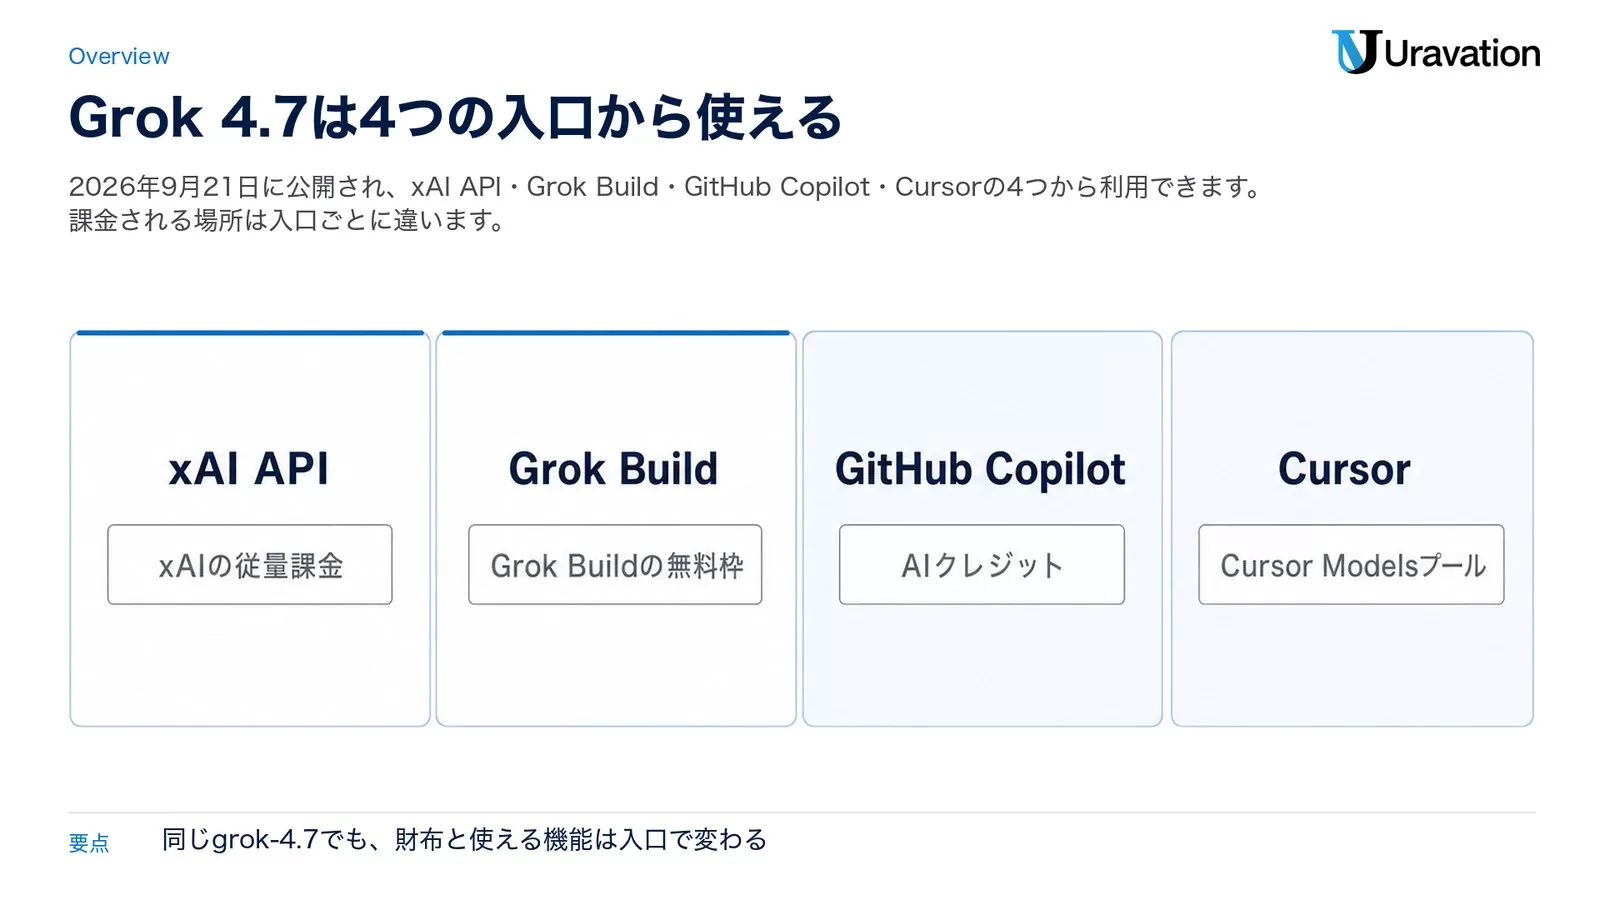
| 入口 | 何で動かすか | 課金される場所 | Grok 4.7 Fast |
|---|---|---|---|
| xAI API | grok-4.7 をHTTPまたはSDKから呼ぶ |
xAIの従量課金(トークン単価) | 使えない(公開APIには無い) |
| Grok Build | grok コマンド(TUI・ヘッドレス・ACP) |
xAIの従量課金/Grok Buildの無料枠 | 使える(無料枠には含まれない) |
| GitHub Copilot | 各IDEのモデルピッカーで選択 | Copilotプランに含まれるAIクレジット | Changelogに記載なし |
| Cursor | モデル選択(Cursor Modelsプール) | Cursorプランの利用枠 | 使える(Startプランは不可) |
判断の軸はシンプルです。すでにCopilotかCursorを契約しているなら、まずモデルピッカーを切り替えるだけで試せます。自前のエージェントループに載せたい、あるいはツール呼び出しやキャッシュを自分で制御したいならxAI APIです。ターミナルで手早く触りたいならGrok Buildが最短で、公式のインストーラ1行から始まります。
Grok 4.7とは|公式が出した確定値と、公表されたベンチマーク
xAIの発表「Introducing Grok 4.7」(2026年9月21日)は、Grok 4.7を「コーディングとナレッジワークのための、これまでで最も高性能なモデル」と説明しています。Grok 4.6と比べてより大きな新しいベースモデルを使い、数時間かかる難しいタスクへ重みを置いた強化学習を長く回したこと、自分の出力を検証する能力と長い文脈の扱いが改善したこと、そしてGrok Botのハーネスをネイティブに理解するよう訓練したことが挙げられています。
docs.x.aiに載っている仕様の確定値
| 項目 | 値(2026年9月22日時点) |
|---|---|
| モデル名 | grok-4.7 |
| コンテキストウィンドウ | 50万トークン |
| 知識のカットオフ | 2026年5月 |
| 入出力の種類 | 入力はテキストと画像、出力はテキストのみ |
| 出力上限 | テキスト出力の上限なし |
| 入力単価 | 100万トークンあたり2.00ドル |
| 出力単価 | 100万トークンあたり6.00ドル |
| 推論の深さ | low / medium / high(既定)/ xhigh |
| 対応API | Responses API、Chat Completions |
| 使えるツール | 関数呼び出し、Web検索、X検索、コード実行 |
見落としやすいのが知識のカットオフが2026年5月である点です。docs.x.aiのモデルページには「検索ツールを有効にしない限りリアルタイムの出来事へのアクセスは無い」と明記されています。最新の仕様やニュースを前提にした回答が欲しいなら、サーバー側のWeb検索・X検索ツールを明示的に有効にする必要があります。
公式が公開したベンチマークの表
以下はxAIの発表ページに掲載された比較表の数値です。筆者が測ったものではなく、公式が自社で公表した値である点を前提に読んでください。カッコ内は公式表に記載された推論設定です。
| 項目 | Grok 4.7(xHigh) | Grok 4.6(High) | GPT-5.6 Sol(Max) | Fable 5.1(Max) |
|---|---|---|---|---|
| 入力単価(100万トークン) | 2ドル | 2ドル | 4ドル | 10ドル |
| 出力単価(100万トークン) | 6ドル | 6ドル | 20ドル | 50ドル |
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%(high effort) | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
読み方のポイントは2つあります。ひとつは、Grok 4.7は絶対値でトップを取る表ではないということ。CursorBench 4.0もTerminal-Bench 4.0もFable 5.1が上です。もうひとつは、その単価差です。出力単価はFable 5.1の50ドルに対してGrok 4.7は6ドルで、公式が「価格と性能のフロンティアにいる」と表現しているのはこの軸です。発表ページの散布図も横軸が「タスクあたりの平均コスト」になっており、絶対性能ではなくコスト対効果を主張する図になっています。
同じ発表では安全面の数値も公開されています。バイオセーフティのベンチマークであるLatchBioで62.4%、サイバー領域の危険なプロンプトを扱うHackerBench v0.3では、リスクのあるデュアルユースのプロンプトのうち通してしまったのは3.3%だったと記載されています。
入口①②|xAI APIとGrok Buildの最短手順
ここからは実際の設定です。掲載するコマンドとコードはすべて公式ドキュメントに載っている例で、筆者の環境で動かした結果ではありません。
xAI API|キー発行から最初のリクエストまで
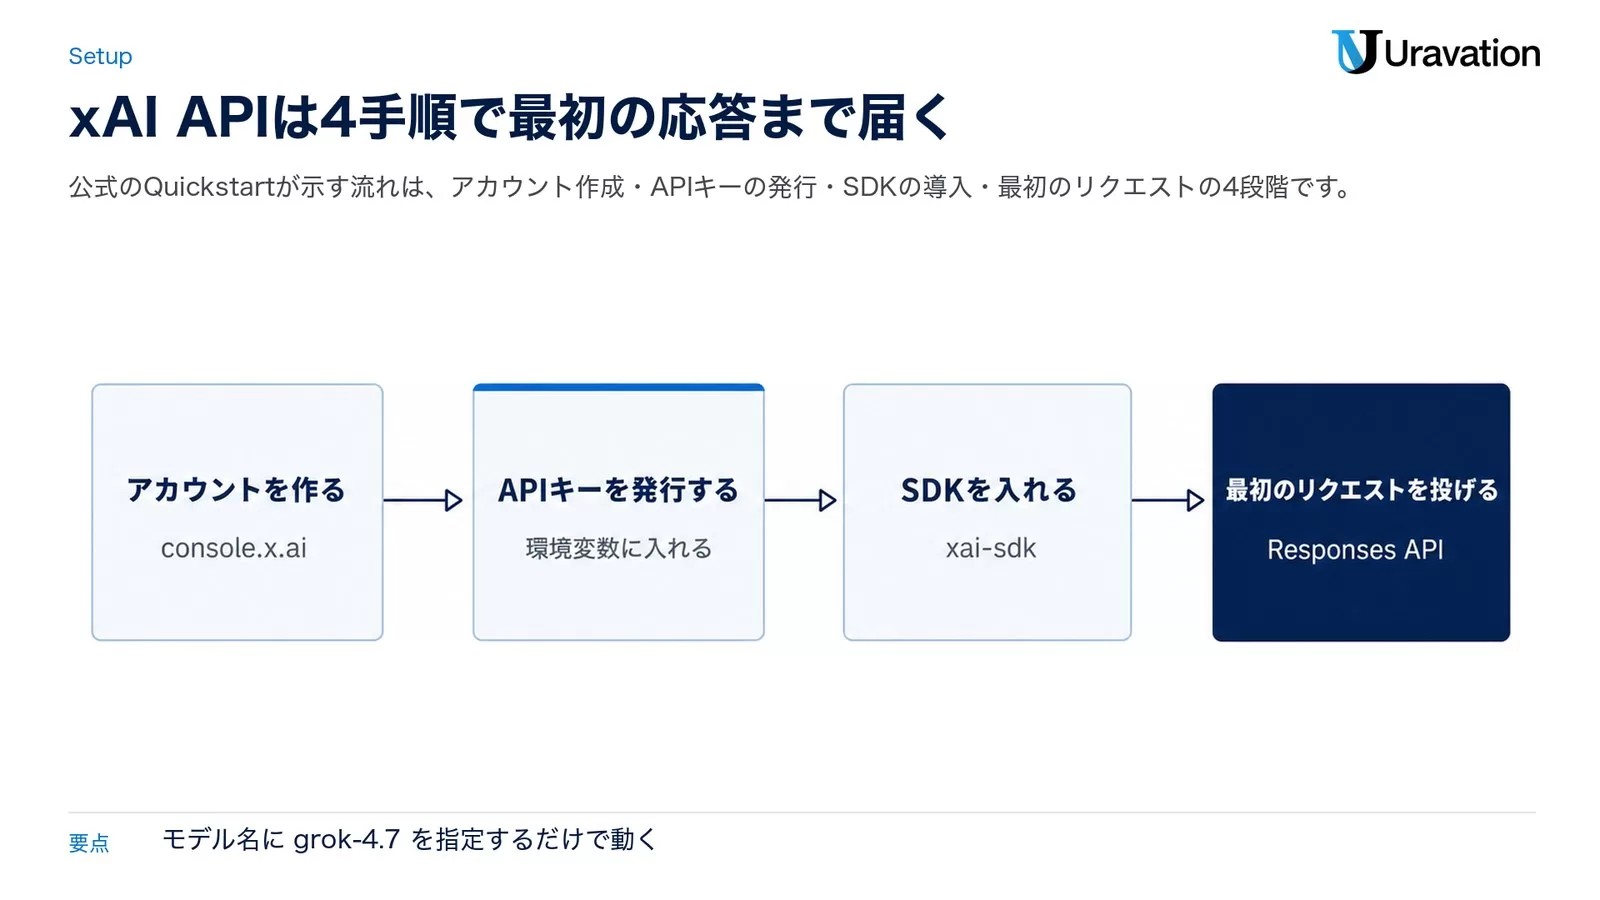
docs.x.aiのQuickstartが示す手順は4段階です。
- アカウントを作る:
console.x.aiでサインアップし、クレジットを入れる - APIキーを発行する:コンソールのAPI Keysページで作成し、環境変数に入れる
- SDKを入れる:Pythonなら
pip install xai-sdk、JavaScriptならnpm install ai @ai-sdk/xai zod - 最初のリクエストを投げる:モデル名に
grok-4.7を指定する
環境変数の設定は公式の例ではこうなっています。
export XAI_API_KEY="your_api_key"最小のリクエストは、公式ドキュメントのcurlの例がそのまま使えます。エンドポイントはResponses APIです。
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -d '{
    "model": "grok-4.7",
    "input": "Find and fix the bug, then explain it: function median(a){a.sort();return a[a.length/2]}"
  }'
Python SDKの公式例は次のとおりです。xai_sdk のクライアントにモデル名を渡すだけで、追加のパラメータは要りません。
import os
from xai_sdk import Client
from xai_sdk.chat import user

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(model="grok-4.7")
chat.append(user("Find and fix the bug, then explain it: function median(a){a.sort();return a[a.length/2]}"))

response = chat.sample()
print(response.content)
既存のOpenAI SDKを使っている場合は、base_url を差し替えるだけで移せます。これも公式に掲載されている例です。
import OpenAI from 'openai';

const client = new OpenAI({
  apiKey: process.env.XAI_API_KEY,
  baseURL: 'https://api.x.ai/v1',
});

const response = await client.responses.create({
  model: 'grok-4.7',
  input: [
    {
      role: 'user',
      content:
        'Find and fix the bug, then explain it: function median(a){a.sort();return a[a.length/2]}',
    },
  ],
});

console.log(response.output_text);
推論の深さを変えたいときは、Responses APIなら reasoning オブジェクトに effort を渡します。公式ドキュメントのcurl例はこうです。
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -m 3600 \
  -d '{
    "model": "grok-4.7",
    "reasoning": {"effort": "high"},
    "input": [
        {"role": "system", "content": "You are a highly intelligent AI assistant."},
        {"role": "user", "content": "Find all prime numbers p such that p^2 + 2 is also prime. Prove your answer."}
    ]
}'
公式例で -m 3600 のようにタイムアウトを長く取っているのは、推論モデルの応答が長くかかりうるためです。Python SDKの例でも timeout=3600 が明示されています。
Grok Build|インストーラ1行から
Grok BuildはxAIのコーディングエージェントで、対話型のTUI・スクリプト向けのヘッドレス・他アプリからのACP接続の3通りで動きます。ドキュメントによればGrok Buildの既定モデルがGrok 4.7です。インストールは公式の1行で済みます。
curl -fsSL https://x.ai/cli/install.sh | bashWindowsの場合は次のコマンドが案内されています。
irm https://x.ai/cli/install.ps1 | iex起動はプロジェクトのディレクトリで grok と打つだけです。初回起動時はブラウザが開いて認証に進み、ブラウザが使えない環境では XAI_API_KEY を渡します。
cd your-project
grok
export XAI_API_KEY="xai-..."
grokスクリプトやCIに組み込むときはヘッドレスモードです。--output-format streaming-json を付ければ構造化した出力を受け取れます。
grok -p "Explain this codebase"
grok -p "Explain the architecture" --output-format streaming-json
モデルを切り替えたいときはTUI内で /model <name>、ヘッドレスなら -m を使います。いま何が読み込まれているか(設定ファイル・指示・スキル・プラグイン・フック・MCPサーバー)を確認するコマンドも用意されています。
grok inspect
grok -p "Hello" -m my-model設定ファイルの書き方やMCPサーバー・権限まわりの指定は、Grok Build設定ガイド|config.tomlとMCP・権限の書き方で個別に整理しています。並列実行の扱いや料金プランについてはGrok Build使い方|料金・8並列エージェント・設定手順も合わせて確認してください。
入口③④|GitHub CopilotとCursorでの選び方
GitHub Copilot|対象プランと管理者の有効化
GitHubのChangelog(2026年9月21日)によれば、Grok 4.7はGitHub Copilotで段階的に提供が始まっています。記載されている内容は次のとおりです。
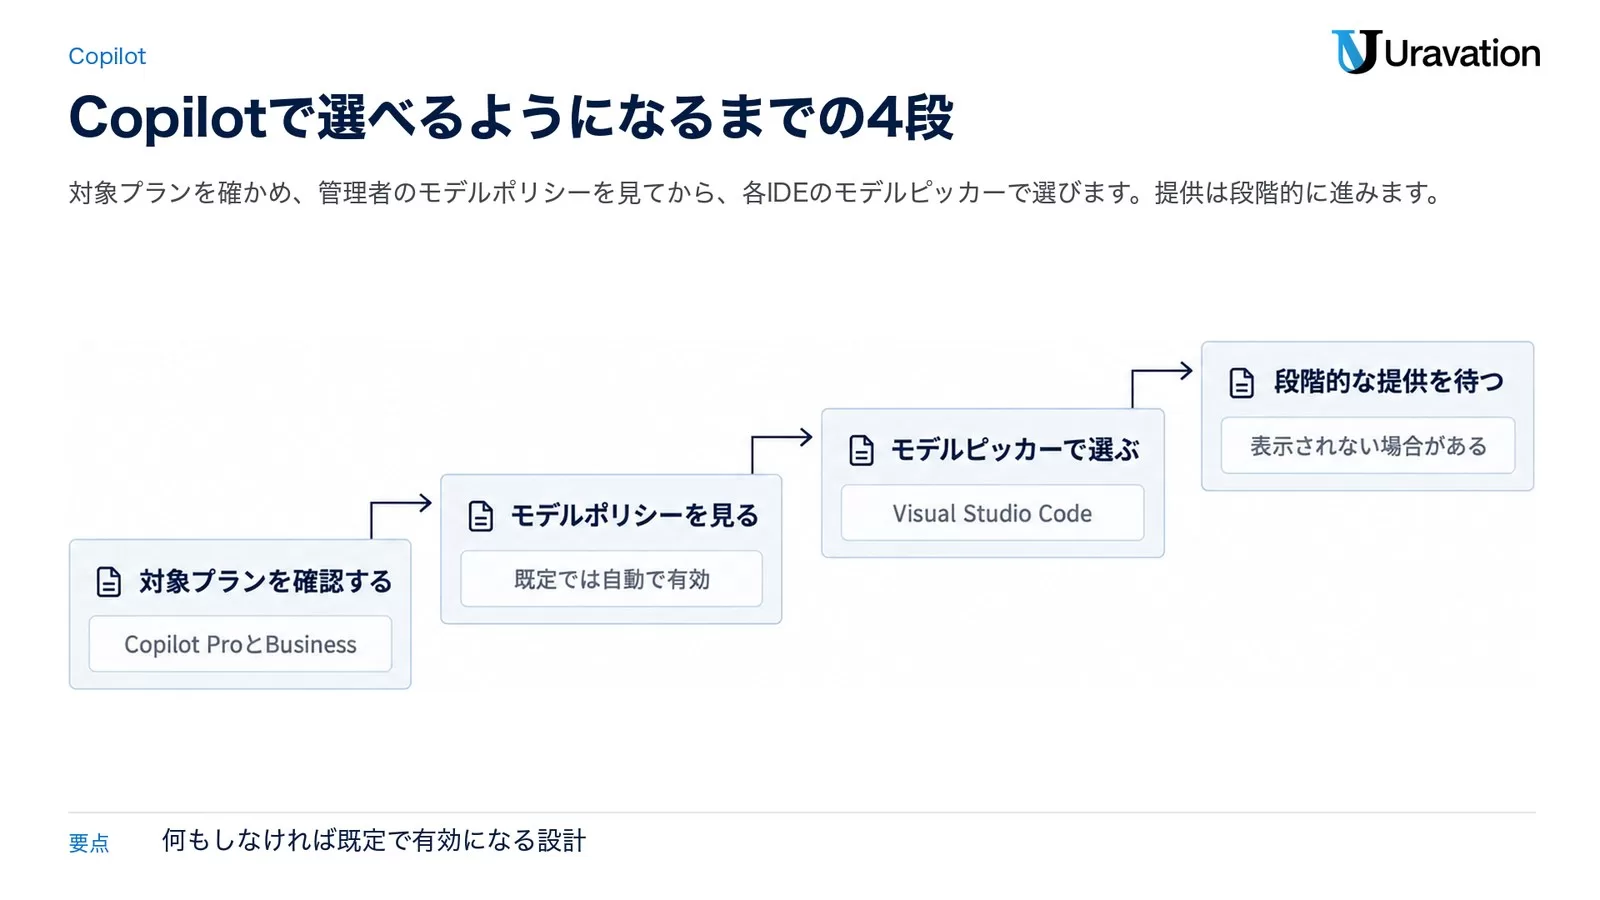
- 対象プラン:Copilot Pro、Pro+、Max、Business、Enterprise
- モデルピッカーで選べる場所:Visual Studio Code、Visual Studio、Copilot CLI、GitHub Copilot cloud agent、GitHub Copilot app、JetBrains、Xcode、Eclipse
- 課金:従量課金のもとで、プロバイダーのリスト価格で請求される
- ロールアウト:段階的に進むため、すぐに表示されない場合がある
組織で使う場合の要は管理者側のモデルポリシーです。Changelogには「Copilot EnterpriseとCopilot Businessの管理者は、Copilot設定のモデルポリシーからGrok 4.7へのアクセスを管理できる」と書かれています。加えて「既定のモデル有効化のもとでは、管理者がグローバルの既定をオフにしているか、このモデルを明示的に無効化していない限り、新しいモデルは自動的に有効になる」とあります。何もしなければ社内で使えるようになる設計なので、利用モデルを統制している組織は先に設定を見ておく必要があります。
GitHubのドキュメント「Models and pricing for GitHub Copilot」では、Copilotの課金はトークン数をAIクレジットへ換算する方式で、1 AIクレジットが0.01ドルと定義されています。プランごとに含まれるクレジットがあり、それを超えた分が従量で請求されます。Grok 4.7の単価は次のように掲載されています。
| ティア | 入力トークンのしきい値 | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|---|
| Default | 20万トークン以下 | 2.00ドル | 0.50ドル | 6.00ドル |
| Long context | 20万トークン超 | 4.00ドル | 1.00ドル | 12.00ドル |
単価はすべて100万トークンあたりです。GitHubのサポート対象モデル一覧では、Grok 4.7の区分はVersatile、リリース状態はGA、最小IDEバージョンとしてVisual Studio 17.14.19が挙げられています。他のIDEはTBD(未記載)です。
Cursor|Cursor Modelsプールに入っている
xAIの発表は「Grok 4.7は本日からCursorとGrok Buildで利用できる」と書いており、モデルのドキュメントには「Cursor: すべてのプランで利用可能」と記載されています。Cursorのドキュメント「Models & Pricing」では、Grok 4.7はCursorが持つ2つの利用枠のうちCursor Modelsプールに含まれます。このプールにはGrok 4.7・Grok 4.6・Grok 4.5・Composer 2.5が入っており、サードパーティモデル用のOther Modelsプールとは別枠です。
| Cursorでの表記 | 入力 | キャッシュ読み出し | 出力 |
|---|---|---|---|
| Grok 4.7 | 2ドル | 0.5ドル | 6ドル |
| Grok 4.7 (Fast) | 4ドル | 1ドル | 12ドル |
| Grok 4.7 500k | 4ドル | 1ドル | 12ドル |
| Grok 4.7 500k (Fast) | 6ドル | 1.5ドル | 18ドル |
単価は100万トークンあたりです。Cursor側で押さえておく実務上の違いが2つあります。ひとつはCursor Token Rateの対象外であること。TeamsとEnterpriseではサードパーティモデルに100万トークンあたり0.25ドルが上乗せされますが、ドキュメントは「GrokとComposerを含むファーストパーティのCursorモデルはCursor Token Rateの対象外」と明記しています。もうひとつはStartプラン(インド向け)の制限で、Startではこれらのモデルは非Fastで動き、Grok 4.7・4.6・4.5は推論の深さがmedium固定になります。深さの変更とFastモードはPro以上が必要です。
CursorのAuto機能がどのモデルへ振り分けるかは3つのモードで変わります。挙動の詳細はCursor RouterとAuto Intelligence|3モードの違いで整理しています。
コスト設計|同じgrok-4.7でも単価が変わる5つの条件
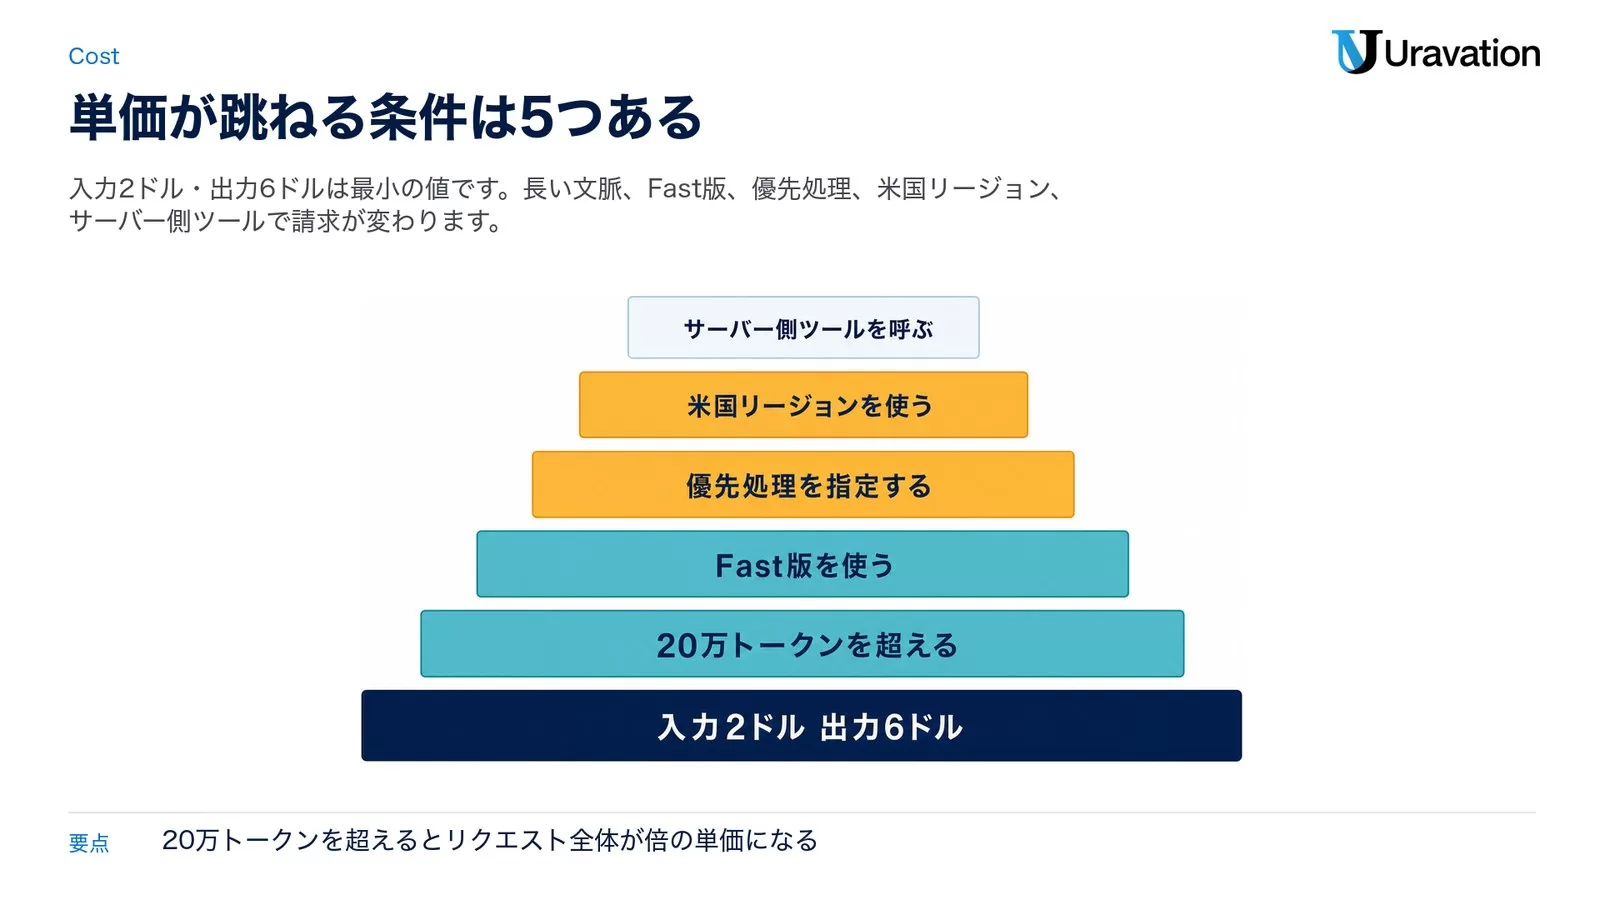
「入力2ドル・出力6ドル」は最小の値であって、条件が揃うと実際の請求は2倍や1.1倍になります。docs.x.aiのPricingページに書かれている条件を整理します。
条件1:プロンプトが20万トークンを超える
Grok 4.7は50万トークンの文脈を持ちますが、価格表は2段になっています。プロンプトが20万トークン未満なら入力2.00ドル・キャッシュ入力0.50ドル・出力6.00ドル。20万トークン以上になると入力4.00ドル・キャッシュ入力1.00ドル・出力12.00ドルです。この高いレートはリクエスト内のすべてのトークンに適用されます(公式の注記に「しきい値に達したリクエストは、そのリクエスト内の全トークンが高いレートで課金される」とあります)。20万1トークン目を入れた瞬間に、そのリクエストの請求が倍になるという挙動です。
条件2:Fast版を使う
Grok 4.7 Fastは同じモデルをより速いインフラで提供するもので、標準の2倍のトークン単価です。重要なのは提供範囲で、docs.x.aiは「CursorとGrok Buildでのみ利用可能で、Grok Buildの無料枠には含まれない。公開のxAI APIでは利用できない」と明記しています。API側で速度を買う選択肢はありません。
条件3:優先処理(Priority Processing)を指定する
低レイテンシのためにスケジューリング優先度を上げると、標準の2倍で課金されます。入力・出力・キャッシュ・推論のすべてのトークン種別に倍率がかかり、プロンプトキャッシュの割引は倍率をかける前に適用されます。実際に優先レートで請求されるのはレスポンスが "service_tier": "priority" を返したときだけで、既定ティアで処理された場合は標準レートです。
条件4:米国リージョンのエンドポイントを使う
処理を米国内に閉じたい場合は https://us.api.x.ai/v1 を使います。トークン単価はグローバルの1.1倍で、公式は具体的に「20万トークン未満で2.20ドル/0.55ドル/6.60ドル、超えると4.40ドル/1.10ドル/13.20ドル」と記載しています。この地域エンドポイントが現在扱うのは grok-4.7 と grok-4.6 のみです。
条件5:サーバー側ツールを呼ぶ
Web検索やコード実行などのサーバー側ツールは、トークンとは別にツール呼び出し分が課金されます。Pricingページの記載は次のとおりです。
| ツール | ツール名 | 1,000回あたり |
|---|---|---|
| Web検索 | web_search |
5ドル |
| コード実行 | code_execution |
5ドル |
| 添付ファイル検索 | attachment_search |
10ドル |
| コレクション検索(RAG) | collections_search |
2.50ドル |
X検索は課金方式が変わった点に注意が必要です。公式の警告欄には「2026年9月21日の米国太平洋時間12時から、X検索は取得した投稿1,000件あたり5ドル、取得したユーザープロフィール1,000件あたり10ドルで課金され、これまでの呼び出し1,000回あたり5ドルを置き換える」と書かれています。検索やスレッド取得で返ってきた投稿は、親投稿や引用投稿も含めてすべて数えられます。
なおBatch APIの割引はGrok 4.7には適用されません。公式の割引一覧に挙がっているのは grok-4.3 と grok-4.20 系で、それ以外は「割引なし」と明記されています。バッチで安くする設計は立てられません。
前提を置いた試算例を1つ挙げます(実測値ではなく、公式単価に基づく計算です)。入力15万トークン・出力2万トークンのリクエストを1日100回投げる場合、入力は15万×100=1,500万トークンで、100万トークンあたり2.00ドルなので30.00ドル。出力は2万×100=200万トークンで6.00ドルなので12.00ドル。合計42.00ドルです。ここでプロンプトが20万トークンを超える設計に変えると、同じ回数でも単価が倍になるため、トークン数の増分以上に費用が跳ねます。Grok Buildの無料枠と有料の境目についてはGrok Buildは無料で使える?無料枠の上限と料金プラン比較で整理しています。
エージェント開発での使いどころ|effortとキャッシュの設計
エージェントに組み込む場合、docs.x.aiがGrok 4.7について「重要な点」として挙げているのは3つです。順に見ていきます。
reasoning_effortは4段階、無効化はできない
grok-4.7・grok-4.6・grok-4.5 は reasoning_effort に対応します。指定しない場合の既定は "high" で、推論そのものを止めることはできません。公式が示す使い分けは次のとおりです。
| 設定 | 公式の説明 | 向いている用途 |
|---|---|---|
low |
推論トークンをいくらか使うが、それでも速い | レイテンシに敏感なエージェント用途、単純なツール呼び出し |
medium |
レイテンシの要求が緩い用途向けに、より多く考える | 複雑なデータ分析、長い文脈の推論 |
high(既定) |
より多くの推論トークンで深く考える | 非常に難しい問題、複雑な数学、多段の論理 |
xhigh |
推論の深さは最大、相応にレイテンシも上がる | 応答時間より答えの質が重要な最難問 |
実装で引っかかりやすいのが、presencePenalty・frequencyPenalty・stop が推論モデルでは使えない点です。これらを含むリクエストはエラーを返します。既存のチャット実装を移植するときは、この3つのパラメータを外す必要があります。xhigh はGrok 4.6以降で使え、非対応のモデルに渡した場合は high として扱われます。
prompt_cache_keyを付けないとキャッシュが効かない
docs.x.aiは prompt_cache_key の設定を「強く推奨」しています。理由は明快で、このキーが会話のリクエストを同じサーバーへ振り分けるからです。公式の表現では「これが無いと、キャッシュが冷えたサーバーで入力の全額を払うことがよくある」となっています。Chat Completions側では x-grok-conv-id ヘッダーが同じ役割を担います。キャッシュ入力は0.50ドルで通常入力の4分の1なので、長い会話を回すエージェントでは効き方が大きい設定です。
長いループはコンテキスト圧縮で畳む
会話が伸びると毎回すべての履歴を送り直すことになり、入力トークンをその都度支払います。xAIはこれに対してコンテキスト圧縮(Context Compaction)を用意しており、/v1/responses/compact に会話を送ると、システムプロンプト・添付ファイル・過去の推論・やり取りの要約を保った1つの不透明なアイテムが返ります。次のリクエストではそれをそのまま先頭に置いて続けます。公式が挙げる効果は、入力コストの低減・レイテンシの低減・古いツール出力に引きずられない応答・長時間のループを文脈上限の内側に保つことの4点です。
ドキュメントは、圧縮すべきなのは「毎回の input_tokens がコストやレイテンシを圧迫している」「それでも過去のやり取りを覚えていてほしい」「現在の窓がまだ文脈上限に収まっている」の3条件がすべて成り立つときだと書いています。圧縮は会話を縮める仕組みであり、すでに上限を超えたリクエストを救うものではありません。
Responses APIでは推論の暗号化データが常に返る
grok-4.7 はResponses APIで reasoning.encrypted_content を常に返します。include に列挙していなくても返る挙動で、出力内の推論アイテムが encrypted_content フィールドを持ちます。自分で会話履歴を管理している場合は、この推論アイテムを次のリクエストの input へそのまま戻すことで、モデルがターンをまたいで推論を保てます。中身を解析したり書き換えたりせず、不透明なデータとして扱うのが公式の指示です。
レート制限については、docs.x.aiのRate Limitsページが grok-4.7 の上限を掲載しています。ティア0(累計利用額0ドル)で毎秒150リクエスト・毎分5,000万トークン、ティア4(累計5,000ドル)で毎秒500リクエスト・毎分1億トークンです。ティアは2026年1月1日以降の累計支出で自動的に上がり、一度上がると下がりません。エージェントの設計全般についてはGrokエージェント完全ガイド|設定から活用までにまとめています。
法人で使う前に確認する点|データの扱いと提供範囲
導入判断で聞かれる項目を、公式ドキュメントの記載だけで整理します。
学習利用と保存期間
docs.x.aiのSecurity FAQには「xAIは明示的な許可なくAPIの入力・出力で学習することはない」と書かれています。一方で既定では、不正利用が疑われた場合の監査のために、APIのリクエストとレスポンスがサーバー上に保存されます(保存期間は30日・保管時は暗号化、期間経過後は自動削除)。
ゼロデータ保持(ZDR)は安易に入れない
より厳しいデータ取り扱いが必要な場合はZDRがありますが、公式は「ほとんどの顧客にはZDRの有効化を推奨しない」と警告欄で明言しています。ZDRを有効にすると、保存されたデータに依存する機能が使えなくなるためです。具体的には、APIキーごとのリクエストログ、ステートフルなResponses API(previous_response_id による継続)、Files API、Collections API、Batch API、遅延補完、画像・動画の保存出力、音声エージェントの会話履歴が対象です。ZDRはチーム単位で、APIキー個別には設定できません。有効かどうかはレスポンスの x-zero-data-retention ヘッダーで確認できます。
Grok Build CLIについては、ZDRが有効ならトレースもコードのデータも保持されないと記載されています。ZDR無しでも、/privacy や /settings のスラッシュコマンドからコードデータの保持を切ることができます。
処理地域とコンプライアンス
既定のエンドポイント https://api.x.ai は処理地域を保証しません。米国内に閉じたい場合は https://us.api.x.ai/v1 を使いますが、保証の対象はAPIリクエストの処理・推論・モデレーション・保存されたリクエストデータまでで、Files・Collections・サーバー側ツール・自社システムからエンドポイントまでの経路は対象外です。ドキュメントには、SOC 2 Type 2に準拠していること、HIPAAのBAAについては専用の質問票からの問い合わせになることも書かれています。
2026年9月22日時点で、Grok 4.7の次期版の時期やモデル構成について公式発表はありません。ここで扱った数値はすべて当日時点の公式ページの記載であり、料金表やモデル一覧は更新されるため、実装前に必ず最新のPricingページとModelsページを確認してください。
よくやる失敗4つ|❌と⭕で直す
❌ APIで「Fast版」を指定して速くしようとする
⭕ Grok 4.7 FastはCursorとGrok Buildだけの提供です。公開のxAI APIには存在しないため、モデル名にFastを意図した文字列を足しても速くなりません。APIで応答時間を詰めたいなら、reasoning_effort を low に下げる、優先処理を使う(単価2倍)、ストリーミングで体感の待ちを減らす、のいずれかです。Grok Buildの無料枠でもFastは使えません。
❌ 文脈が50万トークンあるから単価は据え置きだと思い込む
⭕ 単価が切り替わるのは20万トークンで、50万ではありません。しかも高いレートはそのリクエストの全トークンに適用されます。長い履歴を丸ごと投げる設計は、しきい値をまたいだ瞬間に請求が倍になります。履歴を畳むコンテキスト圧縮を組み込むか、プロンプトを20万トークン未満に収める設計にしてください。
❌ 会話を毎回そのまま投げ直して入力を全額払う
⭕ prompt_cache_key(Chat Completionsでは x-grok-conv-id ヘッダー)を付けると、同じ会話のリクエストが同じサーバーへ振り分けられ、キャッシュが当たりやすくなります。キャッシュ入力は100万トークンあたり0.50ドルで、通常の入力2.00ドルの4分の1です。公式が「強く推奨」と書いている設定を外したまま本番へ出さないでください。
❌ 安全側に倒すつもりでZDRをとりあえず有効にする
⭕ 公式は「ほとんどの顧客には推奨しない」と明記しています。ステートフルなResponses API、Files、Collections、Batch APIといった主要機能が止まり、ZDR下で削除されたデータは復元もできません。コンプライアンス要件が本当にそれを求めている場合だけ有効にし、そうでなければ既定の保存30日の方が扱いやすい、というのが公式の推奨です。
よくある質問
Grok APIの料金はいくらですか?
2026年9月22日時点のdocs.x.aiのPricingページでは、grok-4.7 はプロンプトが20万トークン未満のとき100万トークンあたり入力2.00ドル・キャッシュ入力0.50ドル・出力6.00ドル、20万トークン以上のとき入力4.00ドル・キャッシュ入力1.00ドル・出力12.00ドルです。サーバー側ツールを使う場合は、これに呼び出し分(Web検索なら1,000回あたり5ドルなど)が加わります。
GrokのAPIキーの取得方法は?
公式のQuickstartでは、console.x.ai でアカウントを作ってクレジットを入れ、コンソールのAPI Keysページでキーを発行し、XAI_API_KEY として環境変数か .env に置く、という手順が案内されています。キーはチームに紐づくため、コンソールで正しいチームを選んでから発行・無効化・削除を行います。
Grok APIのモデルは何を選べばいいですか?
docs.x.aiのモデルページには用途別の推奨が表で載っており、コードとチャットはいずれも grok-4.7、画像は Grok Imagine Image 2.0、動画は Grok Imagine Video 1.5、音声はVoice APIとされています。「音声・画像・動画には専用のモデルとAPIがあり、それ以外はコードを含めてGrok 4.7を使う」というのが公式の説明です。
Grok APIは無料で使えますか?
docs.x.aiのPricingページに記載されているのは従量課金の単価で、2026年9月22日時点でAPI自体の無料枠についての記載は確認できませんでした。一方でGrok Buildには無料枠があることがドキュメントに書かれており、その無料枠にGrok 4.7 Fastは含まれないと明記されています。Copilotの場合は各プランに含まれるAIクレジットの範囲内で使い、超えた分が従量課金になります。
Grok 4.7とGrok 4.6は何が違いますか?
公式発表によれば、Grok 4.7はGrok 4.6より大きい新しいベースモデルを使い、数時間かかるタスクへ重みを置いた強化学習をより長く回しています。自分の出力の検証と長い文脈の管理が改善し、Grok Botのハーネスをネイティブに理解するよう訓練された点も挙げられています。価格と速度はGrok 4.6と同じで、公式のベンチマーク表ではCursorBench 4.0が40.4%から46.3%、Terminal-Bench 4.0が20.3%から38.0%へ変化しています。
まとめ|どの入口から始めるか
2026年9月22日時点の整理をもう一度まとめます。
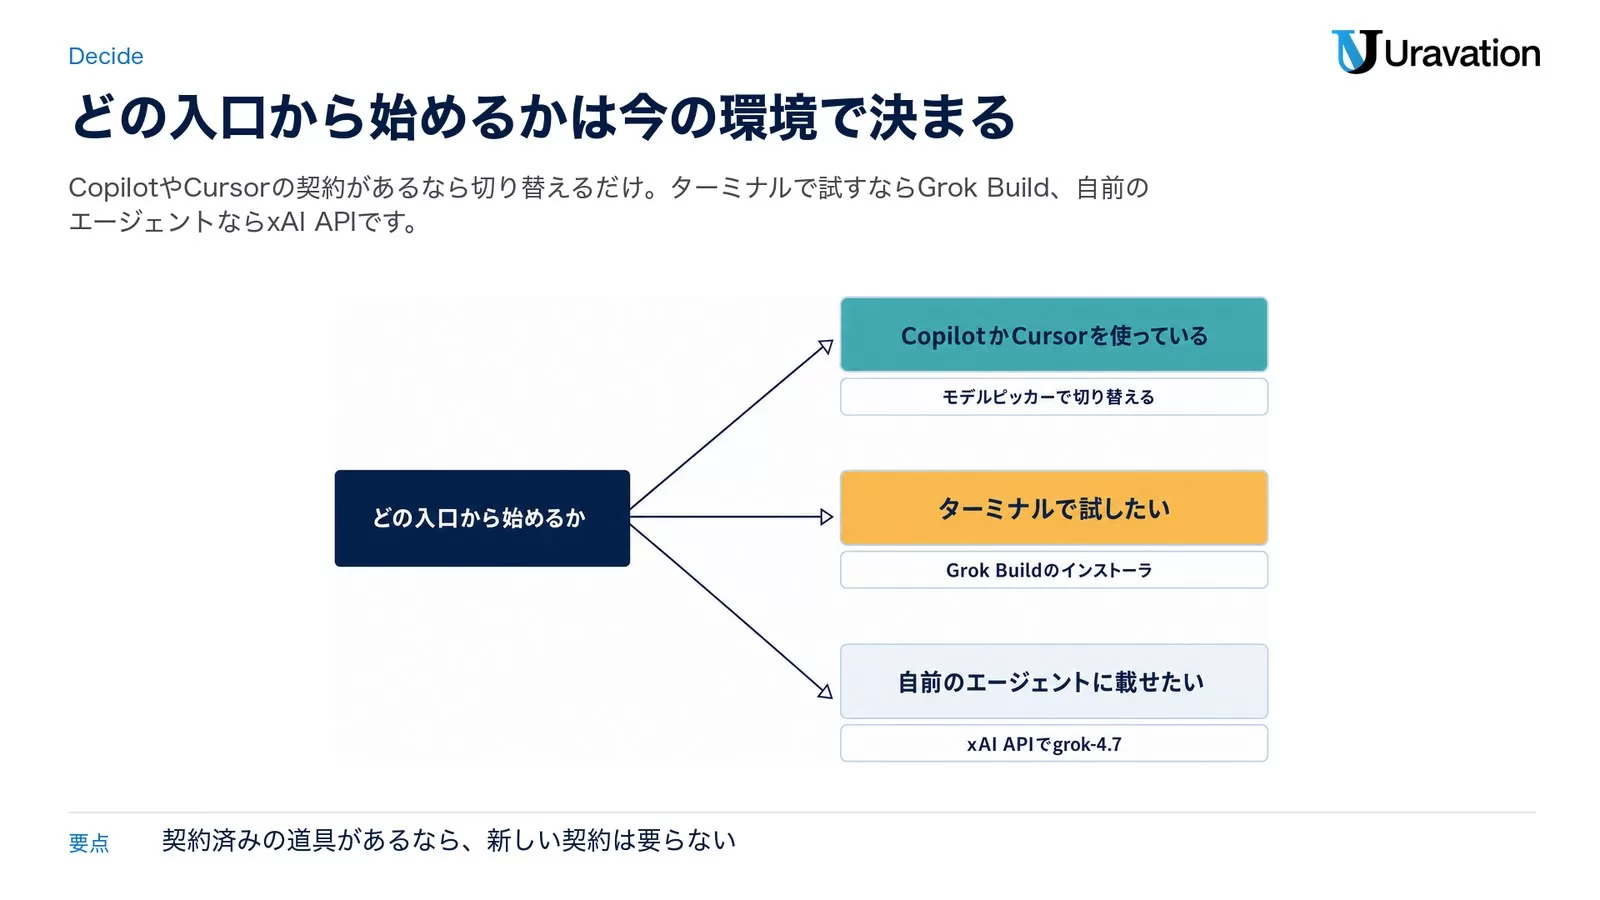
- すでにCopilotかCursorを使っている:モデルピッカーで切り替えるのが最短。Copilotは管理者のモデルポリシーが先、Cursorは
Cursor Modelsプールに入っているので追加契約は要らない - ターミナルで手早く試したい:Grok Buildのインストーラ1行。既定モデルがGrok 4.7なので設定は最小で済む
- 自前のエージェントに載せたい:xAI APIで
grok-4.7を指定。同時にprompt_cache_keyとコンテキスト圧縮を最初から設計へ入れる - コストを読み違えない:20万トークンのしきい値、Fast版の2倍、優先処理の2倍、米国リージョンの1.1倍、サーバー側ツールの呼び出し課金。Batch割引はGrok 4.7には無い
Grok 4.7の売りは絶対性能の1位ではなく、出力100万トークンあたり6ドルという単価で何段階か上のクラスに近づいた点です。裏を返せば、単価が倍になる条件を踏み抜くと魅力の半分が消えます。入口を選ぶ前に、自分のワークロードのプロンプト長と1日あたりの回数を紙に書き出しておくと判断が早くなります。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
いずれも2026年9月22日に参照しました。
- Introducing Grok 4.7(xAI・2026年9月21日) — 発表本文、ベンチマーク表、価格と提供範囲
- Grok 4.7(docs.x.ai) — モデルID、仕様表、Fast版の提供範囲、公式コード例
- Pricing(docs.x.ai) — 長文脈の単価、ツール呼び出し、優先処理、米国リージョン、Batch割引
- Models & Pricing(docs.x.ai) — 用途別の推奨モデル、検索ツールの前提、モデルエイリアス
- Reasoning(docs.x.ai) —
reasoning_effortの4段階、使えないパラメータ、暗号化された推論 - Rate Limits(docs.x.ai) — ティアごとのRPSとTPM
- Security FAQ(docs.x.ai) — 学習利用、保存、ZDRの制約、SOC 2
- Grok Build(docs.x.ai) — インストール、TUIとヘッドレス、カスタムモデル設定
- Grok 4.7 is now available in GitHub Copilot(GitHub Changelog・2026年9月21日) — 対象プラン、対応サーフェス、管理者の有効化
- Models and pricing for GitHub Copilot(GitHub Docs) — AIクレジットの定義とGrok 4.7の単価表
- Models & Pricing(Cursor Docs) — Cursor Modelsプール、Fastと500kの単価、Startプランの制限