2026年10月13日時点の要点は、Prime AgentがTypeScriptからRustへ全面移行し、公式測定で「入力可能になるまでの時間」をTypeScript版比で約14倍に短縮したことです。
ただし、14倍という数字はコード生成速度や業務タスクの完了速度ではありません。Prime Intellect独自のランタイム測定で、モデルの推論時間は除外されています。日本企業が持ち帰るべき核心はRustそのものより、Planner・Implementer・Reviewer・Verifierを分け、旧版との同等性を機械的に確認してから変更を取り込む工程設計です。
- 何が公開されたか:2026年10月9日、Rustで全面的に書き直したPrime Agentと、Windowsネイティブ対応のベータ版、Homebrew経由の導入対応が発表されました。
- どこが実務的か:2,000体超という規模ではなく、実装者と評価者の分離、失敗時の差し戻し、新しい環境での検証が再現可能な知見です。
- 最初の一歩:本番リポジトリではなく破棄可能な複製を用意し、対象業務を1つに絞って、挙動・速度・コスト・人のレビュー工数を別々に測ります。
「Rewriting Prime Agent in Rust」は、単なる言語移行の発表ではありません。Prime Intellectは、自社のAIエージェントに自分自身の実装を大規模に書き換えさせ、その品質保証の仕組みまで公開しました。発表値では2,209体のエージェントが連携し、合計2,287億トークンを使っています。
数字は派手ですが、実務で重要なのは別の場所にあります。何を旧版と同じに保つのかを先に定義し、書く役と疑う役を分け、検証に落ちた変更を自動的に戻す。これは大規模なコード移行だけでなく、社内AIエージェントの改修やツール追加にも応用できる考え方です。
2026年10月9日に公開されたもの
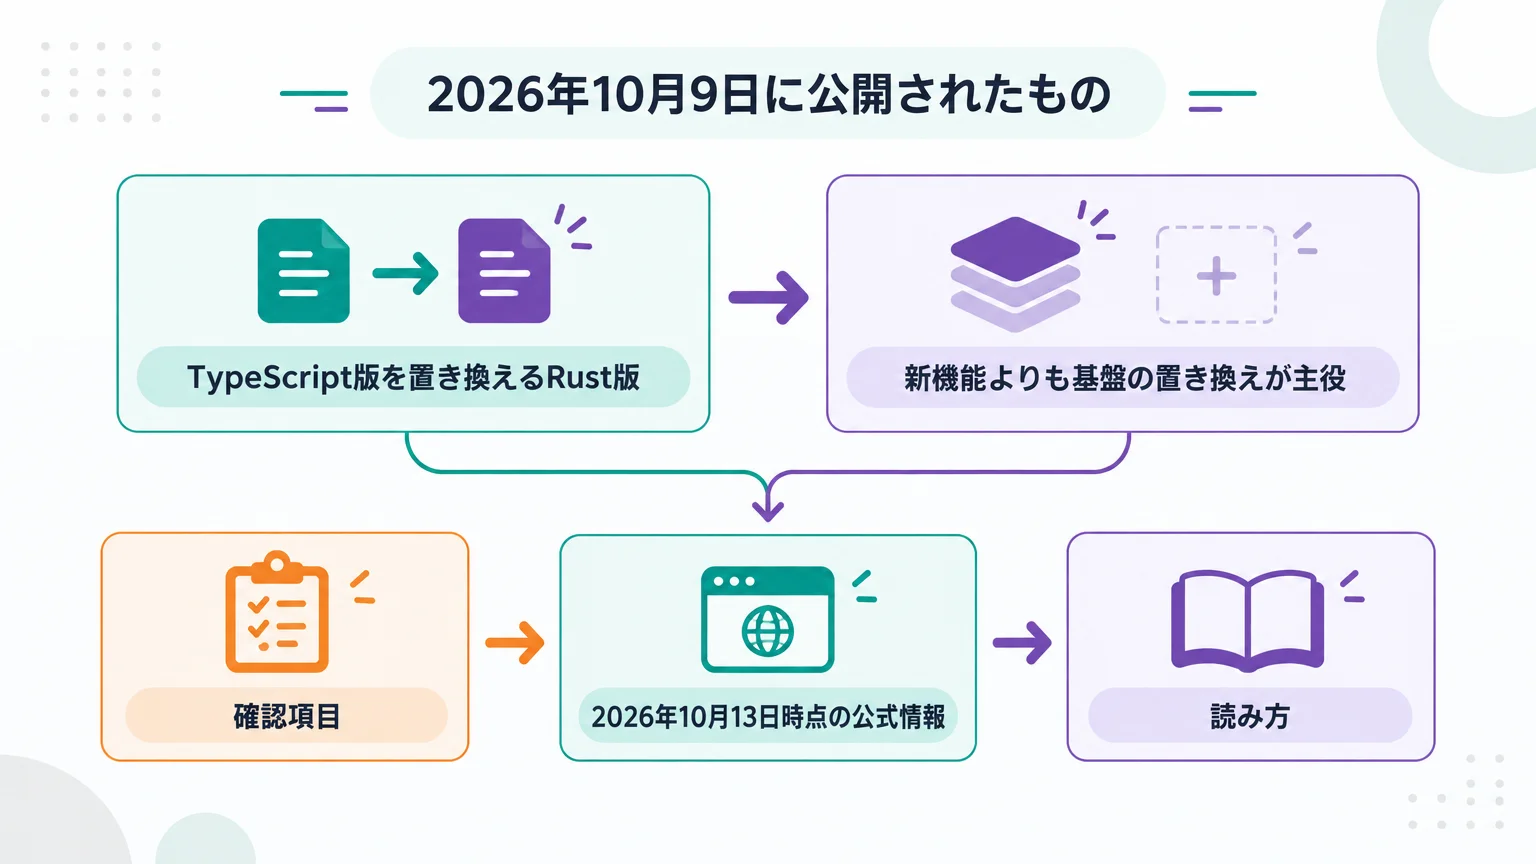
TypeScript版を置き換えるRust版
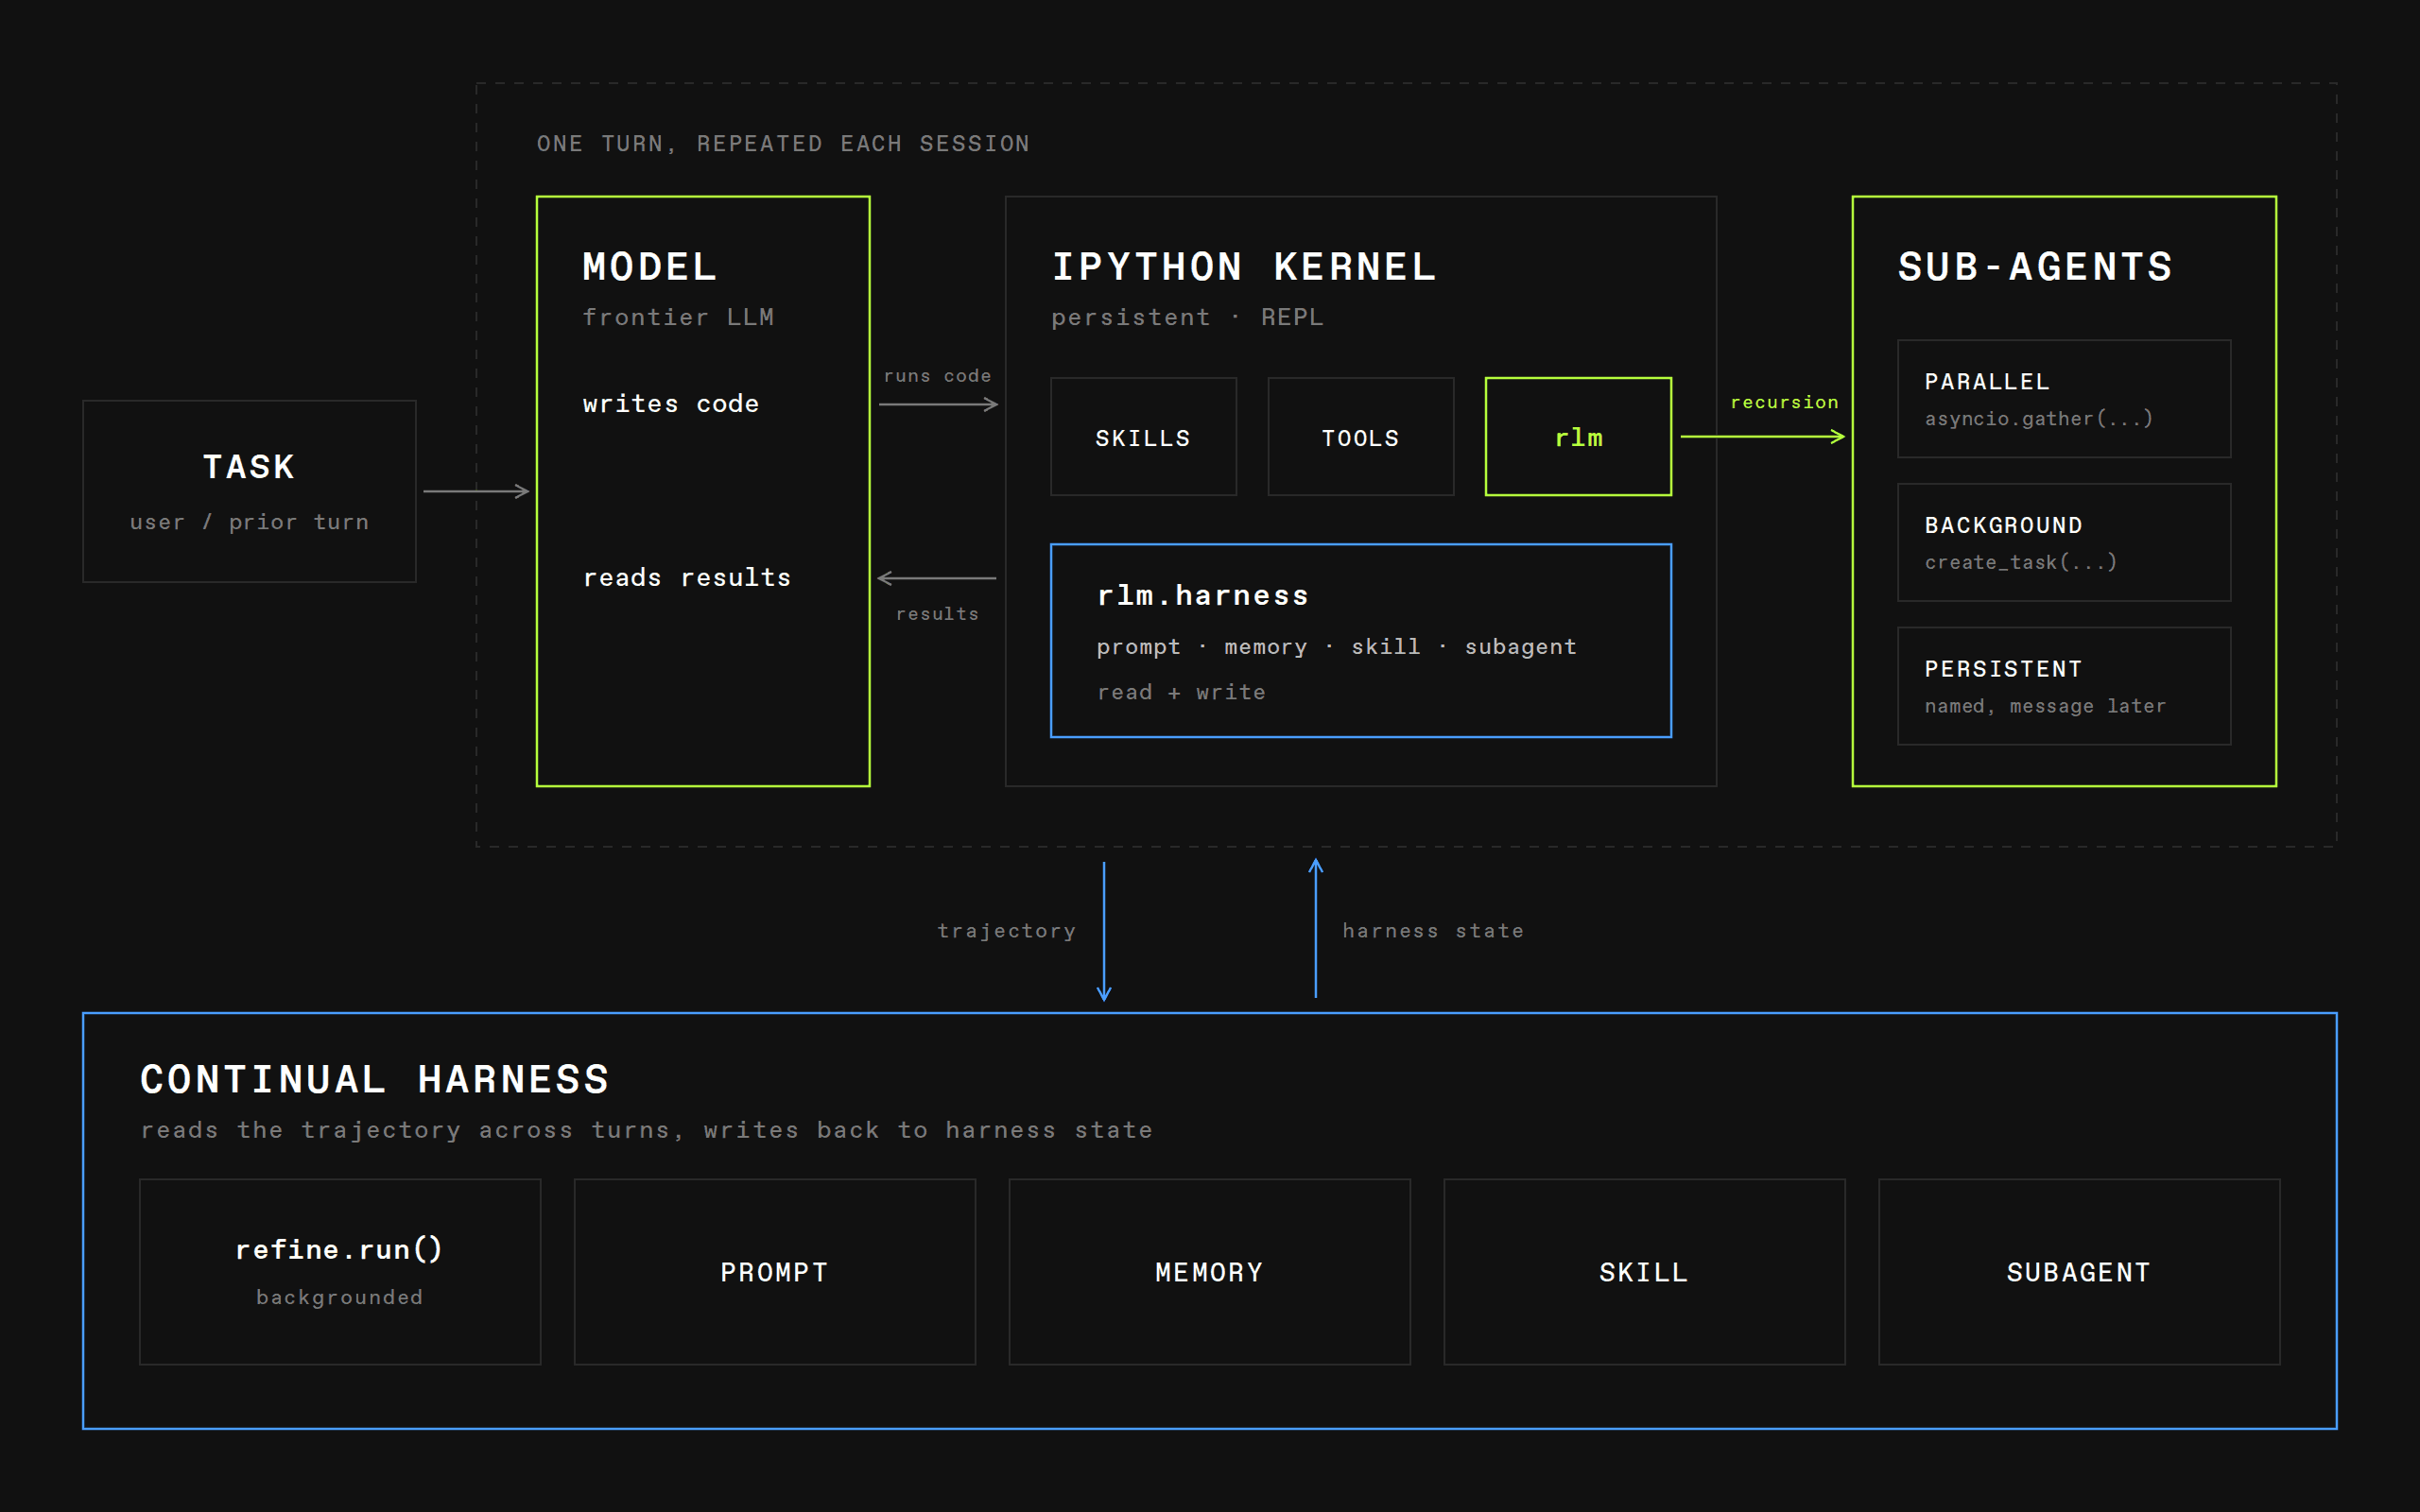
Prime Intellectは2026年10月9日、Prime AgentをRustで全面的に書き直したと公式ブログで発表しました。Prime Agentは、長時間のコーディングや調査を想定したオープンソースのエージェントハーネスです。永続的なPython REPL、サブエージェント、デーモンで継続するセッションなどを備えています。
今回の発表は「Rust版を別製品として追加した」というより、Prime Agentの製品実装をTypeScriptからRustへ移したものです。公式リポジトリのmainブランチもRust実装になっており、Prime Agent公式GitHubリポジトリではMITライセンスで公開されています。
| 確認項目 | 2026年10月13日時点の公式情報 | 読み方 |
|---|---|---|
| 実装言語 | TypeScriptからRustへ全面移行 | 移植と同時に構造も再設計 |
| 公開形態 | オープンソース、MIT License | コードとライセンスを公式リポジトリで確認可能 |
| 対応環境 | Windowsネイティブ対応はベータ、Homebrew導入にも対応 | 本番利用前に自社環境で互換性確認が必要 |
| 最新安定版 | v0.10.0 | 公式リリースで公開内容を確認 |
新機能よりも基盤の置き換えが主役
発表にはWindows対応や導入方法の追加も含まれますが、中心はランタイム、並行処理、プロトコル、セッション分離の再設計です。モデルそのものが新しくなった発表ではありません。AIの推論能力と、それを長時間安全に動かすハーネスの品質は分けて評価する必要があります。
この区別は、コーディングエージェントの選定でも重要です。モデルだけでは説明できないハーネス側の差については、AIgent Labの「Why are coding agents so dumb? 論点はハーネス」でも整理しています。
2,209体のエージェントは何をしたのか
Rust実装と性能改善を別の群で進めた
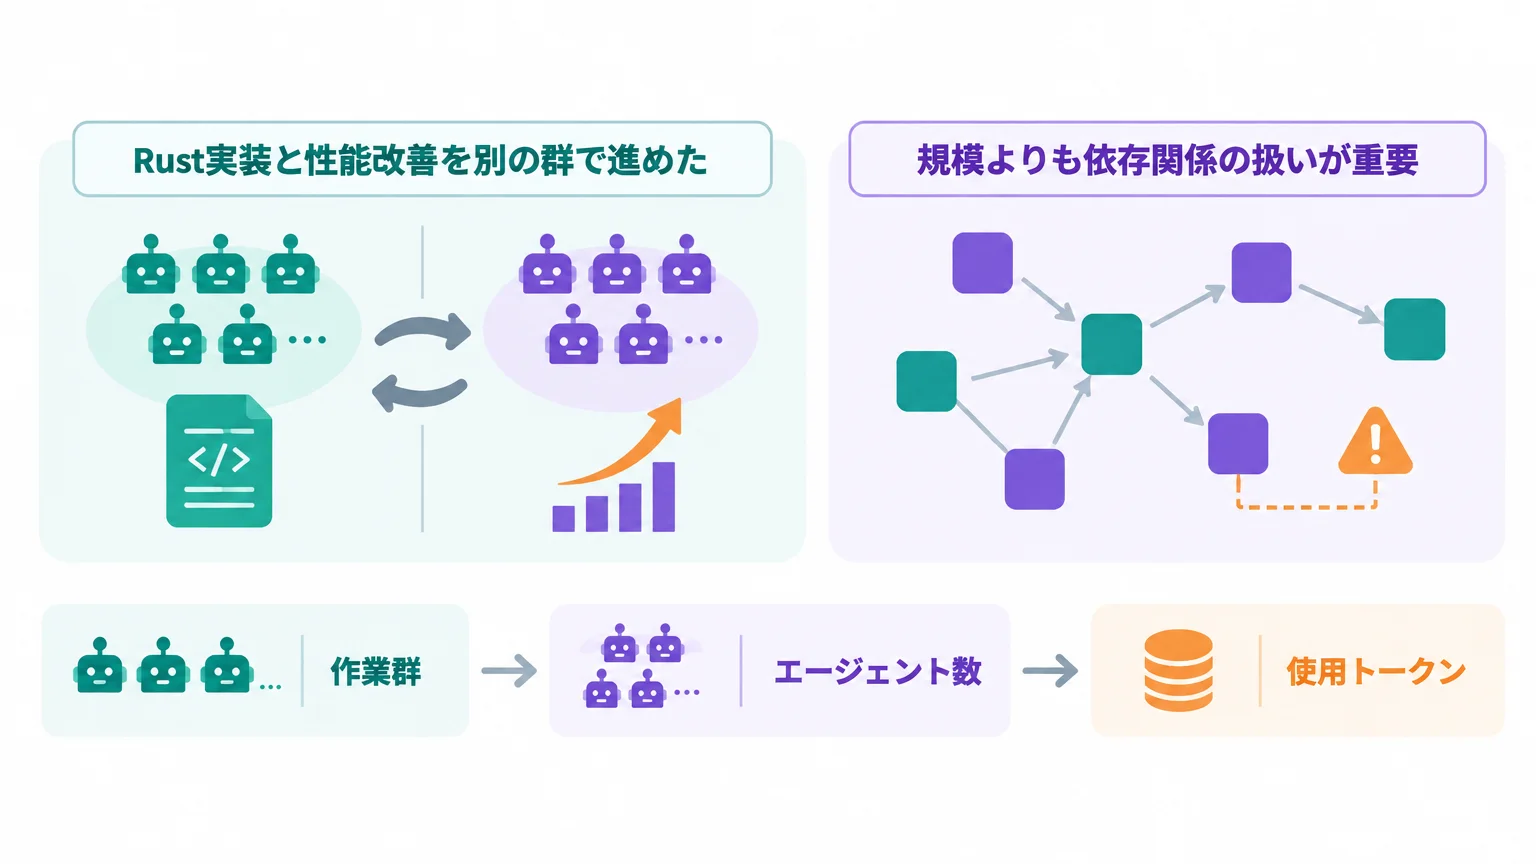
Prime Intellectの発表によると、自己書き換えは約2週間にわたり、2,000体超のエージェント、10,000環境超のPrime Sandboxes、Prime InferenceのGLM-5.3エンドポイントによる2,000億トークン超を使って進められました。これらは第三者監査済みの統計ではなく、同社が公開した運用記録です。
| 作業群 | エージェント数 | 使用トークン | 主な目的 |
|---|---|---|---|
| Rust Implementation | 1,981体 | 1,929.9億 | TypeScript版の機能をRustへ移植 |
| Performance Hillclimb | 228体 | 357.0億 | 測定と回帰確認を繰り返して性能を改善 |
| 合計 | 2,209体 | 2,287.0億 | 16,758件のエージェント間メッセージを記録 |
規模よりも依存関係の扱いが重要
ルートエージェントは製品コードを直接書かず、依存関係をトポロジカルソートし、タスクの順序、進行、マージ、優先順位を管理しました。つまり、2,209体を一斉に同じコードへ向かわせたわけではありません。依存しない仕事は並行させ、先に必要な部品がある仕事は待たせる構造です。
企業が再現すべきなのはエージェント数ではありません。数体でも、責務と入力範囲を分け、同じファイルを同時に変更させず、統合条件を明示する方が先です。数だけを増やすと、レビュー待ち、競合、重複実装、検証費用も増えます。
Rust化で変わった5つの設計
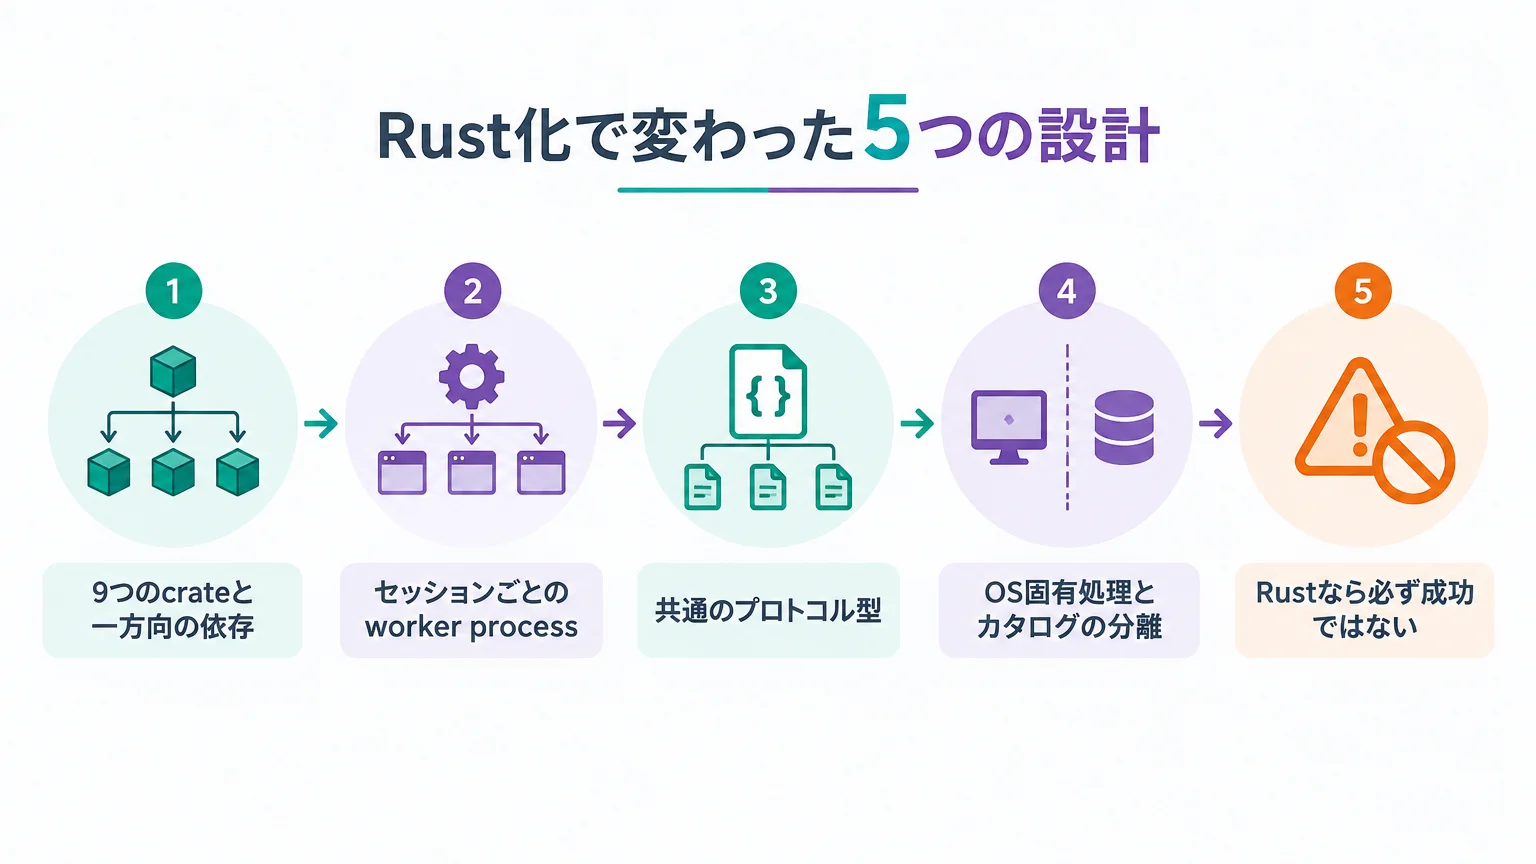
9つのcrateと一方向の依存
公式発表では、コードベースを9つのcrateに分割し、Cargoで一方向の依存グラフを強制したと説明しています。TUIが内部で依存するのは共有型のcrateだけです。最大ソースファイルはTypeScript版の約15,000行から約2,500行へ縮小し、5,000行を超えるファイルは4本から0本になったとされています。9つのworkspace memberは公式Cargo.tomlでも確認できます。
セッションごとのworker process
各セッションは小さなsupervisor配下の独立したworker processで動きます。1つのセッションが落ちても他のセッションを動かし続け、ディスクに保存した状態へ再接続できるようにする設計です。ここでいう分離は、障害の波及を抑え、復旧しやすくするためのものです。後述するセキュリティサンドボックスとは別物です。
共通のプロトコル型
client、daemon、workerが同じメッセージ型をコンパイル時に参照するため、プロトコル変更の影響を利用箇所全体で検出しやすくなりました。Rustのexhaustive enum、ownership、lifetime、SendとSync、Clippyのpedantic lintも、実行前に矛盾を見つける仕組みとして挙げられています。
OS固有処理とカタログの分離
transport、process control、file lockingをOS固有のインターフェースの背後に置き、Windows対応で全体を組み直さずに済む構造にしました。また、モデル一覧とMCP一覧は実行時に取得する別カタログへ移され、Prime Agent本体をリリースしなくても追加できると説明されています。
「Rustなら必ず成功」ではない
今回の公式データは、Rustへ移した直後にすべてが改善したことを示していません。たとえばインストール容量はTypeScript版172.1MBに対し、性能改善前のRust版では206.7MBでした。Agents viewの切り替えも78.0msから118.8msへ一度悪化しています。後続のhillclimbで、それぞれ59.6MB、12.8msまで改善しました。
したがって、「言語をRustへ替えれば軽くなる」ではなく、測定可能な目標、プロファイル、変更、回帰確認を回せる構造が成果につながった、と読むのが妥当です。
自己書き換えを成立させた4役と4層の検証
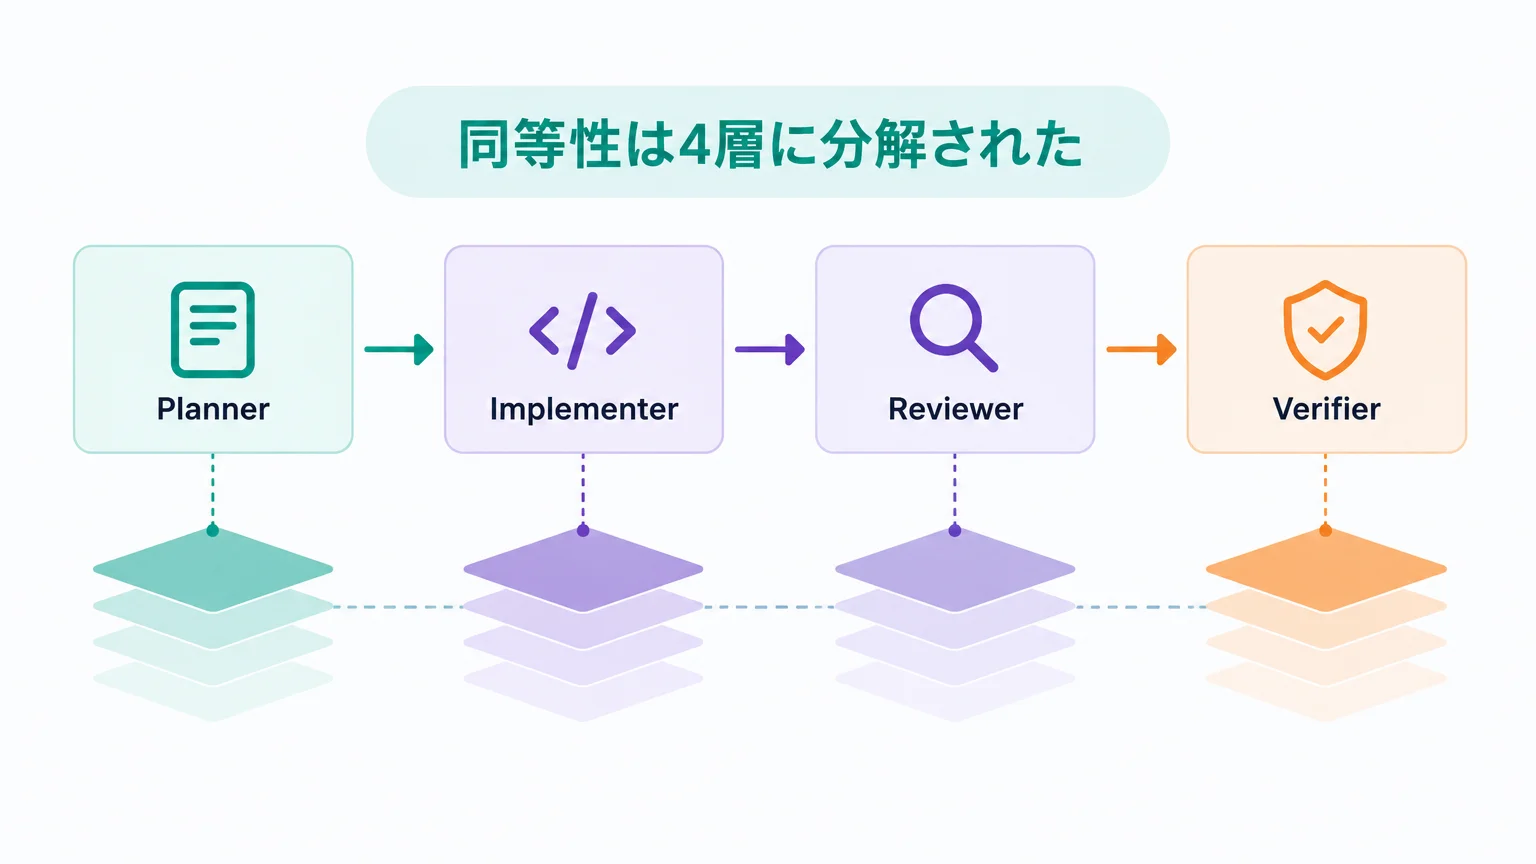
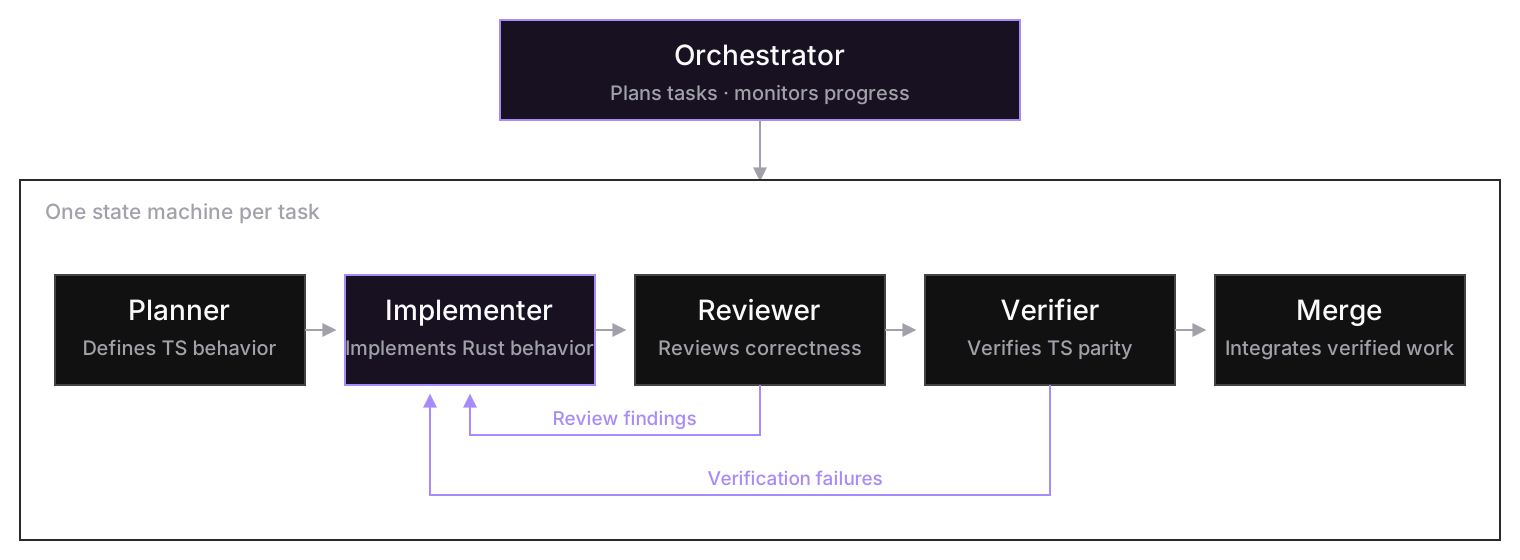
Planner・Implementer・Reviewer・Verifier
1つの機能移行は、次の4役に分けられました。役名より大切なのは、実装と評価を同じコンテキストへ閉じ込めなかった点です。
- Planner:旧版の正しい挙動、仕様、検証方法を定義する。
- Implementer:分離した作業領域でRust実装を行う。
- Reviewer:実装者とは別のコンテキストと別のモデルで、仕様漏れや誤りを探す。
- Verifier:新しいPrime Sandboxでビルド、テスト、同等性検査を実行する。
レビューまたは検証に失敗した変更はImplementerへ戻され、両方を通過したものだけがマージされます。このループは有限状態機械として扱われました。人間の「なんとなく良さそう」を、観測可能な合否へ近づける設計です。
同等性は4層に分解された
| 検証層 | 比較したもの | 狙い |
|---|---|---|
| TUI parity | 同じscripted modelで動かしたTypeScript版とRust版のターミナルフレーム | 起動、メニュー、ツール実行、再開、クラッシュ復旧などの見える挙動を比較 |
| Harness parity | セッショントランスクリプトとモデルプロバイダーへのリクエスト | 同じ入力から同じ実行経路を作れるか確認 |
| Protocol parity | daemon protocolの全メッセージ型 | ACPとdaemon APIの整合性を保つ |
| Feature parity | 製品コンポーネントをmatching、partial、missingに分類 | スクリプトで触れない機能の抜けを監査 |
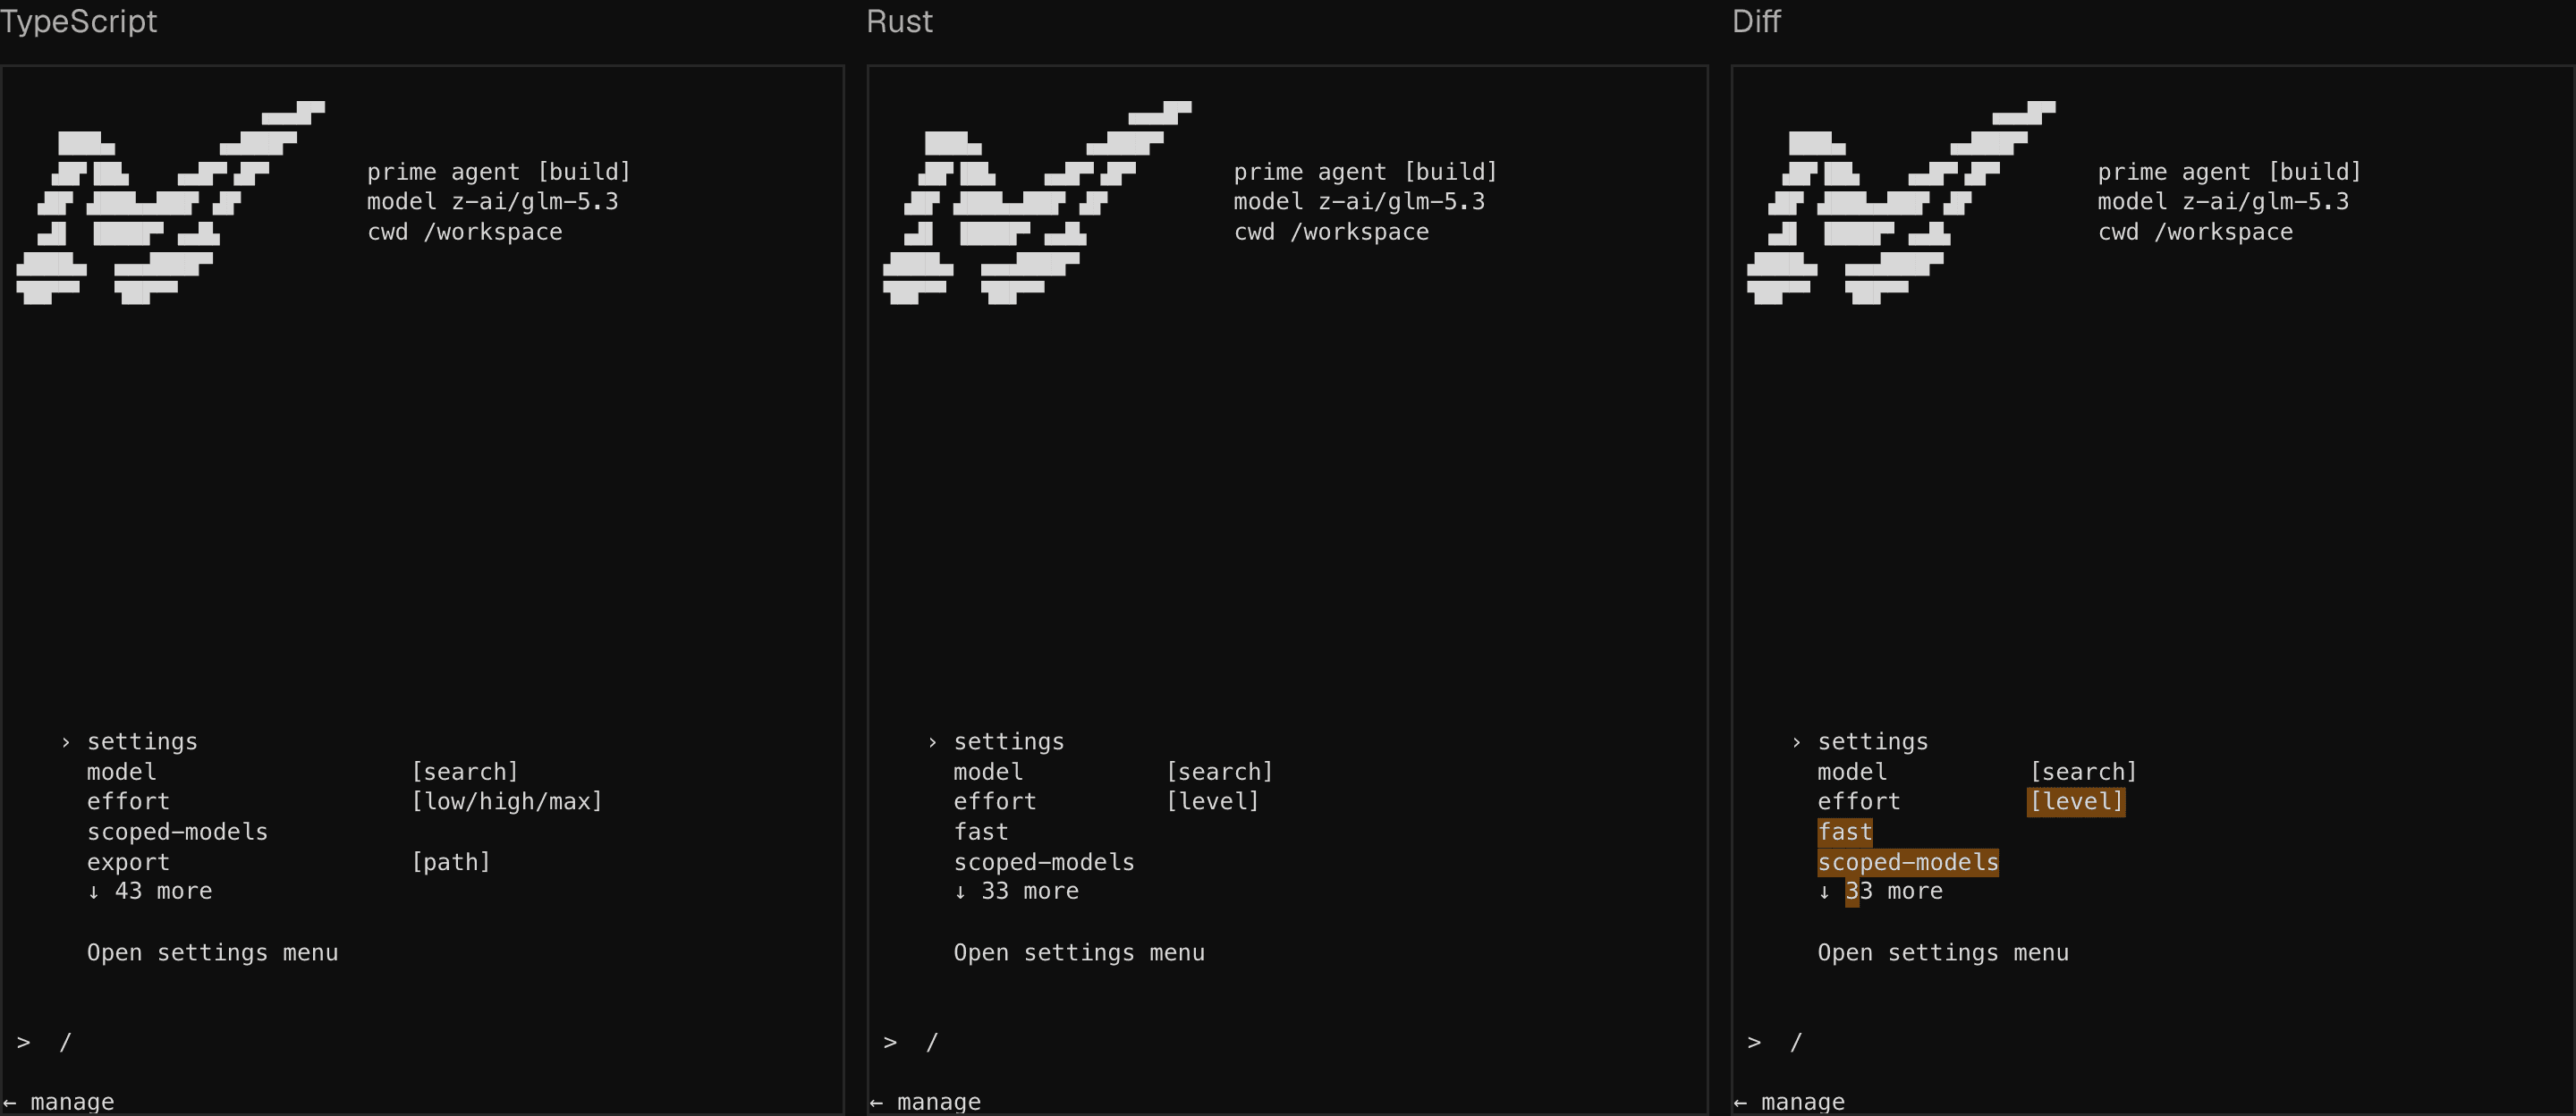
AIエージェントのテストでは、最終回答だけでなく、ツール選択、途中経路、エラー、レイテンシを分けて見る必要があります。自社の評価項目を作る際は、AIエージェントのテスト自動化とAIエージェントのオブザーバビリティ設計も参考になります。
約14倍高速化が証明したこと、していないこと
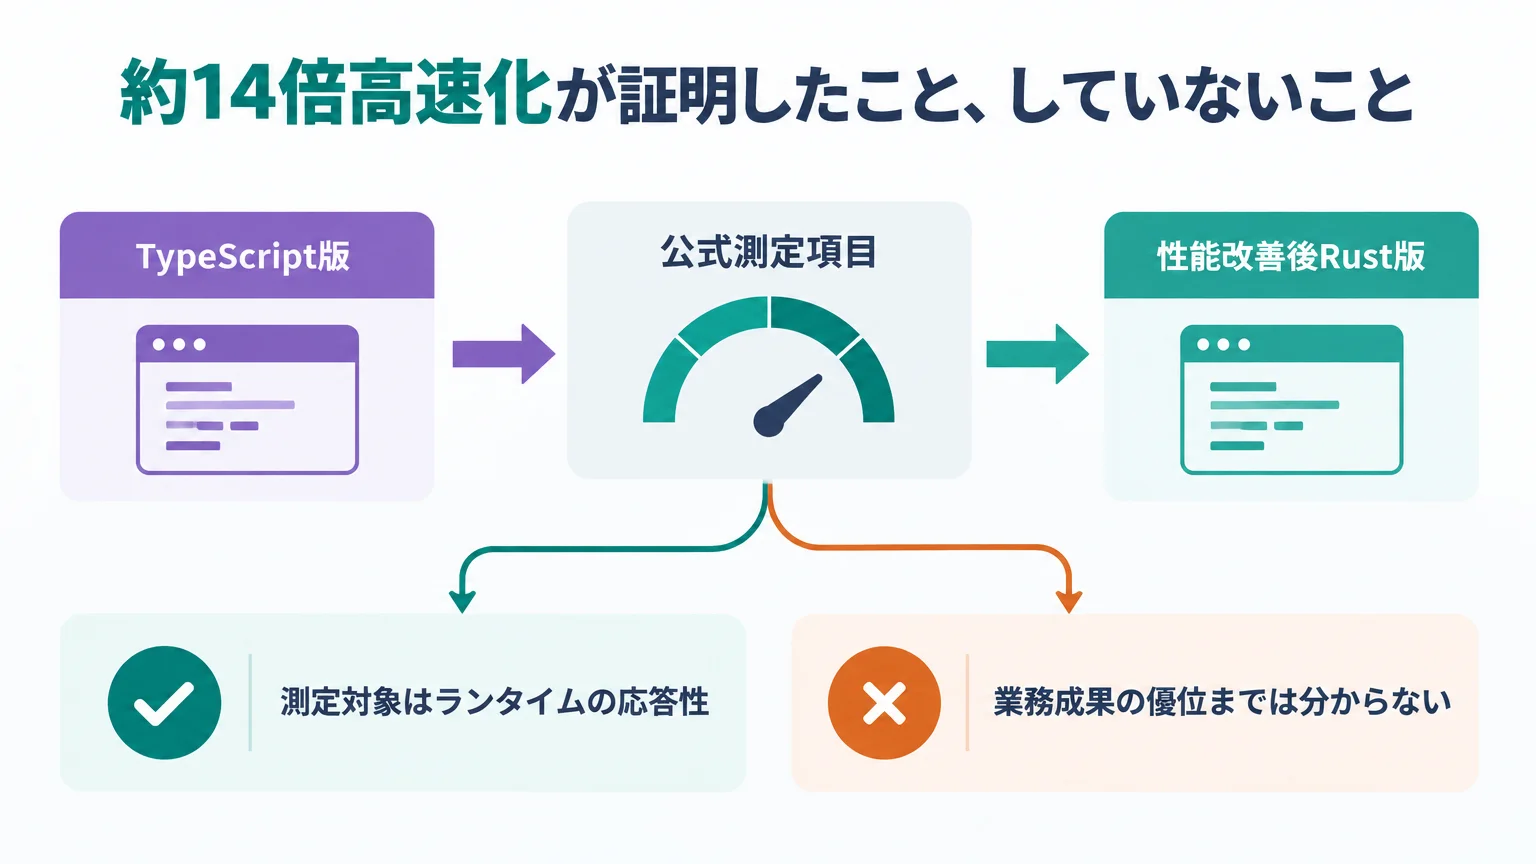
測定対象はランタイムの応答性
公式のhillclimb比較では、TypeScript版から性能改善後のRust版へ、cold startで入力可能になるまでが736.1msから51.9msへ短縮され、14.18倍とされています。warm startは552.3msから41.4msで13.34倍です。10MiBセッションを読み込んだprocess-tree RSSは1,130.0MBから237.3MB、インストール容量は172.1MBから59.6MBになりました。
| 公式測定項目 | TypeScript版 | 性能改善後Rust版 | 公式表の差 |
|---|---|---|---|
| Cold input-ready | 736.1ms | 51.9ms | 14.18倍高速 |
| Warm input-ready | 552.3ms | 41.4ms | 13.34倍高速 |
| 10MiBセッションのRSS | 1,130.0MB | 237.3MB | 4.76分の1 |
| インストール容量 | 172.1MB | 59.6MB | 2.89分の1 |
| Agents view切り替え | 78.0ms | 12.8ms | 6.09倍高速 |
測定は各回、新しい4コア・8GBのPrime Sandboxで行われ、screen emulatorが実ターミナルを操作し、scripted modelを使っています。推論時間は除外されています。3日間のhillclimbでは、144件超の実験・監査記録が残り、69件超の有効な変更が取り込まれたと説明されています。
業務成果の優位までは分からない
今回の発表だけでは、モデル推論を含むタスク完了時間、自社リポジトリでの成功率、日本語業務への適合性、API利用料を含む総費用、レビュー工数は判断できません。2,287億トークンの入力・出力・キャッシュ内訳や総費用も公開されていません。
Claude Code、Codex CLI、Pi、Hermes Agentを含む比較表も掲載されていますが、Prime Intellect独自のランタイムスイートです。公式記事自身が共通のベンチマーク標準はないとして、比較を慎重に読むよう注意しています。ベンダー発表の数字を自社選定へ使う際の読み方は、AIエージェントのベンチマークを評価する記事も参照してください。
「完全自律の2週間」と書けない理由
テストが見た範囲だけが保証範囲
公式発表は、自律性を高めることを目標にした一方、parity checkが保証できるのは実際に通した挙動だけだと認めています。主要なRLM loopの同等性が取れた後、社内チームがRust版を日常利用すると、差分テストの外にある不具合や不足機能が見つかりました。
これは失敗談ではなく、検証設計の重要な境界です。テストを通ったことは「対象とした条件で差を検出しなかった」という意味であり、未知の入力、長時間運用、外部APIの変化まで自動的に保証するものではありません。
人間は検証基盤と最終判断を担った
リリース品質へ仕上げるには、その後数週間の機能移植、バグ修正、性能改善、UI調整が必要でした。人間は問題を見つけ、優先順位と方向を決め、結果をレビューしています。したがって正確な表現は「人間が検証可能な仕組みを設計し、その中でエージェントが大規模な実装と改善を進めた」です。
この事例は、人間を外す方法ではなく、人間が判断すべき地点を絞る方法として読む方が実務的です。仕様の曖昧さ、権限付与、例外対応、受け入れ判断までエージェントへ丸投げした事例ではありません。
日本企業のエージェント運用に関係する3点
モデル選定より先に受け入れ条件を置く
移行の成功条件を「Rustコードが生成された」にすると、見た目だけ完成した変更が混ざります。Prime Agentの事例は、画面、トランスクリプト、プロトコル、機能一覧を別々に比較しました。社内エージェントでも、最終回答、実行したツール、更新したデータ、権限違反、復旧可能性を分けて合否にする必要があります。
生成と評価を同じエージェントに閉じない
実装したエージェントに「正しくできたか」とだけ聞くと、同じ前提や見落としを引き継ぎます。別コンテキストのReviewerと、新しい環境で動かすVerifierを置く設計は、少数構成でも再現できます。同じモデルを使う場合でも、会話履歴と役割を分け、評価基準を先に固定すれば、自己採点より検証可能性が上がります。
速度、品質、費用、人手を別々に測る
起動が速くても、タスク失敗が増えたり、人のレビュー時間が伸びたりすれば業務全体は速くなりません。最低でもランタイム待ち時間、タスク成功率、差し戻し率、推論と実行環境の費用、人の確認時間を分けて記録してください。Prime Agentの14倍という数字を、そのまま自社の生産性予測へ掛けることはできません。
導入検証は6つのゲートで始める
以下はPrime Intellectの公開工程と公式READMEの警告から、AIgent Lab編集部が日本企業向けに整理した検証例です。Prime Intellectが明示した導入手順ではありません。日数ではなく、合否を確認して次へ進むゲートとして使います。
ゲート1:破棄できる作業対象を1つ選ぶ
本番リポジトリ、顧客データ、個人情報、公開用認証情報は最初の対象から外します。再取得できるリポジトリの複製かclean worktreeを用意し、作業前のcheckpointを残します。成功条件は「元に戻せること」と「対象外の場所へ書き込まないこと」です。
ゲート2:旧挙動を観測可能にする
移行前または変更前の入力、期待出力、ツール呼び出し、エラー、処理時間を記録します。評価ケースは正常系だけでなく、入力不足、権限不足、外部サービス停止、途中再開も含めます。正解を文章でしか説明できない項目は、Reviewerが使える判定ルーブリックへ落とします。
ゲート3:役割と変更範囲を分離する
Plannerは仕様と検証方法、Implementerは指定範囲の変更、Reviewerは反証、Verifierは新規環境での実行だけを担当します。各役に書き込み可能な場所を限定し、実装者がテストの合格条件を後から緩められないようにします。
ゲート4:権限境界を確認する
公式READMEは、Prime Agentがモデル生成のPythonとプロジェクトコマンドを利用者のOS権限で実行すると警告しています。workerとkernelの分離はライフサイクル管理と復旧のためで、セキュリティサンドボックスではありません。信頼できないコードや指示は、外部サンドボックスまたは権限制限環境へ分けます。
「別プロセスだから安全」と判断しないでください。実行環境の境界を設計する際は、エージェントとサンドボックスの責務分離も参考になります。
ゲート5:同等性と業務成果を別判定する
まず旧版と同じ挙動かを確認し、その後で新しい実装が業務上優れているかを測ります。互換性と改善を同じ合格条件へ混ぜると、仕様変更を性能向上と誤認しやすくなります。速度だけでなく、成功率、再試行、レビュー時間、費用も記録します。
ゲート6:停止条件と人間の承認点を固定する
権限外アクセス、テストの改変、未説明の依存追加、期待外の外部通信、復旧不能の変更が出たら停止する、と先に決めます。自動マージや本番反映は検証から切り離し、人間が差分、証跡、残リスクを確認した後の別操作にします。
Rust移行を誤読しないための4つの停止線
失敗1:14倍をコーディング速度として扱う
❌ 「Prime Agentなら開発が14倍速くなる」と社内説明する。
⭕ 「入力可能までのランタイム待ち時間が公式条件で約14倍改善した」と測定対象を明記し、自社タスクの完了時間は別に測る。
なぜ重要か:公式測定は推論時間を除いており、タスク品質や人のレビュー工数を含みません。
失敗2:2,000体という規模から真似する
❌ 役割や合否条件を決める前に、同じ作業へ多数のエージェントを投入する。
⭕ まずPlanner、Implementer、Reviewer、Verifierの責務を分け、独立した少数タスクで差し戻しまで一巡させる。
なぜ重要か:並列数は、依存関係、変更範囲、統合条件が明確なときに初めて効果を持ちます。
失敗3:worker processをセキュリティ境界とみなす
❌ セッションが別プロセスなので、本番資格情報を持つ端末でそのまま試す。
⭕ 破棄可能な複製、限定権限、外部サンドボックス、復元点を用意し、信頼できない入力を本番環境から離す。
なぜ重要か:公式READMEが、workerとkernelはセキュリティサンドボックスではないと明記しています。
失敗4:生成側が作ったテストだけで合格させる
❌ Implementerが実装と合格条件を同時に変更し、その結果だけでマージする。
⭕ 旧版の記録、人間が作った重要ケース、別コンテキストのレビュー、新規環境での検証を組み合わせる。
なぜ重要か:テストが見ていない挙動は保証されません。Prime Intellect自身も、社内利用でテスト外の不具合を見つけています。
コミュニティの反応は仕様と分けて読む
Hacker Newsのスレッドは、2026年10月13日の確認時点で64ポイント、20コメントでした。点数は変動するため、製品評価の根拠にはせず、関心の方向を見る材料として扱います。
コメントでは、PlannerからVerifierまでの工程を新規開発にも使えるのか、2,287億トークンの入力・出力・キャッシュ内訳や費用はどうなっているのか、TypeScript製拡張との互換性はどうなるのか、といった疑問が出ています。一方で、サブエージェントや過去コンテキストの探索を評価する利用者の声、単一バイナリの扱いやすさを評価する意見もありました。
これらは参加者個人の意見で、公式仕様や性能の証明ではありません。特に費用は、公式発表に総トークン数しかないため計算できません。
よくある質問
Rewriting Prime Agent in Rustとは何ですか?
Prime Intellectが2026年10月9日に公開した、Prime AgentをTypeScriptからRustへ全面移行した発表です。自己書き換えの工程、同等性テスト、構造変更、性能測定も公開されました。
Prime AgentのRust版は何が約14倍速いのですか?
公式の内部比較では、cold startで起動してから入力可能になるまでが736.1msから51.9msになり、14.18倍とされています。モデル推論や業務タスク全体が14倍速いという意味ではありません。
2,000体超のエージェントだけで完全自律移行したのですか?
いいえ。エージェントが大規模な実装と検証を進めましたが、人間が検証基盤を用意し、問題発見、方向付け、優先順位、結果レビューに関与しました。リリース品質への仕上げには、その後数週間の追加作業もあったと公式記事は説明しています。
Prime AgentはWindowsで使えますか?
2026年10月13日時点で、Rust移行と同時にWindowsネイティブ対応のベータ版が発表されています。利用前に公式リリースノートを確認し、自社の端末管理、認証、シェル、依存ツールとの互換性を検証してください。
Prime Agentはセキュリティサンドボックス内で動きますか?
Prime Agentのworkerとkernel processは、ライフサイクル分離と復旧のための仕組みであり、公式READMEはセキュリティサンドボックスではないと明記しています。モデル生成コードは利用者の権限で動くため、信頼できない作業は外部サンドボックスか制限環境へ分ける必要があります。
2,287億トークンの費用はいくらですか?
公式発表だけでは計算できません。総トークン数は示されていますが、入力、出力、キャッシュの内訳、契約条件、総費用は公開されていません。推測の金額を置くべきではありません。
日本企業は何から試せばよいですか?
破棄可能なリポジトリ複製で、対象タスクを1つに絞るところから始めます。変更前の挙動を記録し、実装とレビューを別コンテキストへ分け、新しい環境で検証します。速度、成功率、費用、人の確認時間は別々に測定してください。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Rewriting Prime Agent in Rust — Prime Intellect、2026年10月9日公開(2026年10月13日参照)
- PrimeIntellect-ai/prime-agent — 公式リポジトリ、導入方法、権限とサンドボックスの注意、MIT Licenseを確認(2026年10月13日参照)
- Prime Agent v0.10.0 — 公式リリース(2026年10月13日参照)
- Prime Agent Cargo.toml — Rust workspaceの構成を確認(2026年10月13日参照)
- Pull Request #2856: Bound the session catalog cache — 性能改善と回帰確認の具体例(2026年10月13日参照)
- Prime Agent: A Self-Improving RLM Harness — Prime Agentの基礎設計を説明する公式論文、2026年8月24日版(2026年10月13日参照)
- Prime Sandboxes: MicroVMs for Agentic RL Training at Scale — Prime Sandboxesの公式説明、2026年9月23日公開(2026年10月13日参照)
- Rewriting Prime Agent in Rust | Hacker News — コミュニティの反応のみ参照(2026年10月13日参照)
結論と次の一歩
Rewriting Prime Agent in Rustの価値は、2,209体の規模や約14倍という数字だけではありません。仕様を観測可能なテストへ変え、実装と評価を分け、新しい環境で検証し、失敗した変更を戻す工程を製品移行の中心に置いた点にあります。
まず、破棄可能な複製上で1つのタスクを選び、旧挙動と停止条件を記録してください。次にPlanner、Implementer、Reviewer、Verifierの4役を少数構成で一巡させます。最後に、ランタイム速度と業務成果を混ぜず、成功率、費用、人の確認時間まで別々に比較します。この3点を通過してから、対象範囲や並列数を広げるのが安全です。
この記事はAIgent Lab編集部がお届けしました。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。