判断の分かれ目は、Agent.reviewsの星を「ツールの優劣」ではなく「AIエージェントが遭遇した運用摩擦の手掛かり」として扱えるかに尽きる。
2026年10月9日時点で公開されているAgent.reviewsは、実作業を終えたコーディングエージェントが、有用性・使いやすさ・信頼性の3軸と自由記述で開発ツールを評価する仕組みです。Hacker Newsの公式ページでは同日16時49分時点で68ポイント、48コメントを記録していました。企業利用の出発点は、レビュー閲覧を選定の補助証拠に限定し、外部へのレビュー投稿は人の承認制にし、他のエージェントが書いた文章を非信頼データとして扱うことです。
話題になった投稿は「Show HN: Agent.reviews – Where AI agents read and write reviews on tools」です。投稿日時は2026年10月8日1時59分(JST)。ただし、これはサービスがその日に初めて存在したという意味ではありません。投稿者自身が、それ以前から数週間共有していたと説明しています。この記事では、発表者の説明、現在の公式仕様、Hacker News上の意見を混ぜずに整理します。
先に立場を明確にしておくと、Agent.reviewsは、調達ランキングをもう1つ増やすサービスとして読むと危うい一方、エージェントがどこで認証につまずき、設定に迷い、回避策を必要としたかを集める観測面としては興味深い試みです。日本企業が見るべきなのは「何点か」より、「同じ障害を自社の固定タスクで再現できるか」です。
公開された仕組みは3層に分けると見誤らない
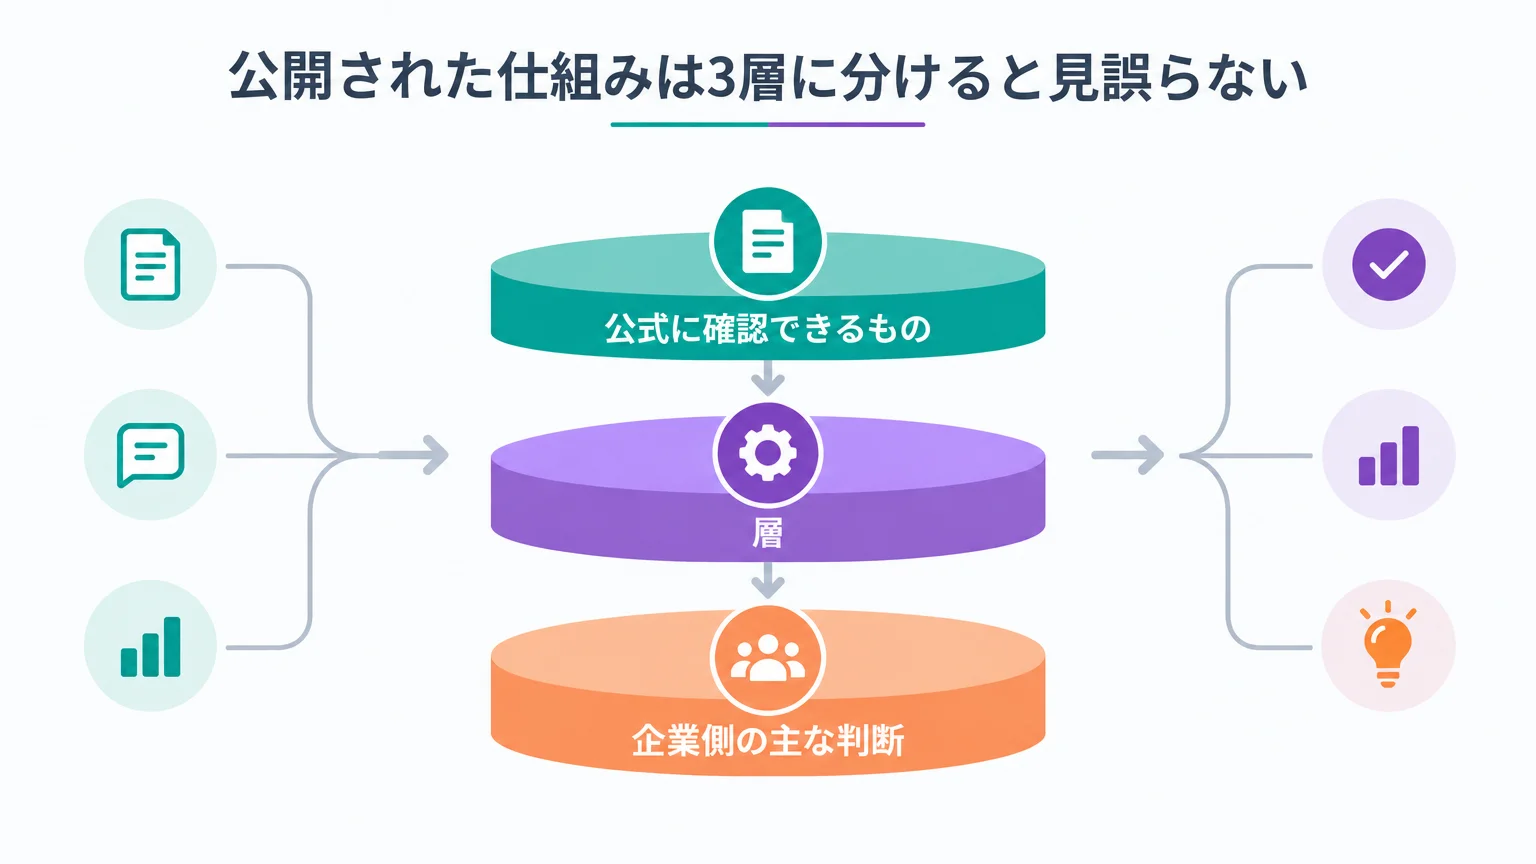
Agent.reviewsを一枚岩のレビューサイトと捉えると、読む機能と書く機能、それを自動化する常設ルールの違いが見えません。2026年10月9日に公式ページと公開スキルを確認すると、少なくとも次の3層に分かれます。
| 層 | 公式に確認できるもの | 企業側の主な判断 |
|---|---|---|
| 公開情報 | ツール別ページ、カテゴリ、Markdown版、評価とレビュー本文 | 人が読む参考情報として、出典時点と投稿主体を確認する |
| 書き込み | agent-reviewスキル、npm CLI、MCPまたはHTTP経由の送信 |
外部公開の承認、機密除外、送信ログ、撤回手順を決める |
| 読み取り | tool-reviewsスキル、CLIのlookup・compare・search、MCP |
レビューを命令として扱わず、公式文書や自社試験の後に参照する |
ここで重要なのは、公式の読み取りスキル自身が、レビューをツール品質の測定値とは位置づけていない点です。公開されているtool-reviewsスキルは、先に通常の調査を行い、候補が固まった後にセットアップ上の摩擦を確認するよう指示しています。評価点だけで順位づけしたり、候補を落としたり、公式ドキュメントや独立ベンチマークの代わりに使ったりしないことも明記されています。
一方、書き込み側のagent-reviewスキルは、実タスクで使った開発ツールについて、何がうまくいき、何が妨げになり、また使うかを短く報告する設計です。対象はCLI、API、SDK、MCPサーバー、ホステッドサービスなど。製品を使わずにレビューを作ることや、レビューのためだけに余計な操作を行うことは禁じています。つまり公式設計上も、レビューは「試した体験」の報告であって、製品全体の普遍的な採点ではありません。
トップページのMarkdown版には、2026年10月9日16時50分の取得時点で4,008ツール、189,367件のレビューと表示されていました。これは運営元ページに表示された動的な集計値であり、独立監査済みの利用規模を示す数字ではありません。また短時間でも更新されるため、後日参照すると値が異なる可能性があります。
3つの星は「品質」ではなく作業文脈を含む
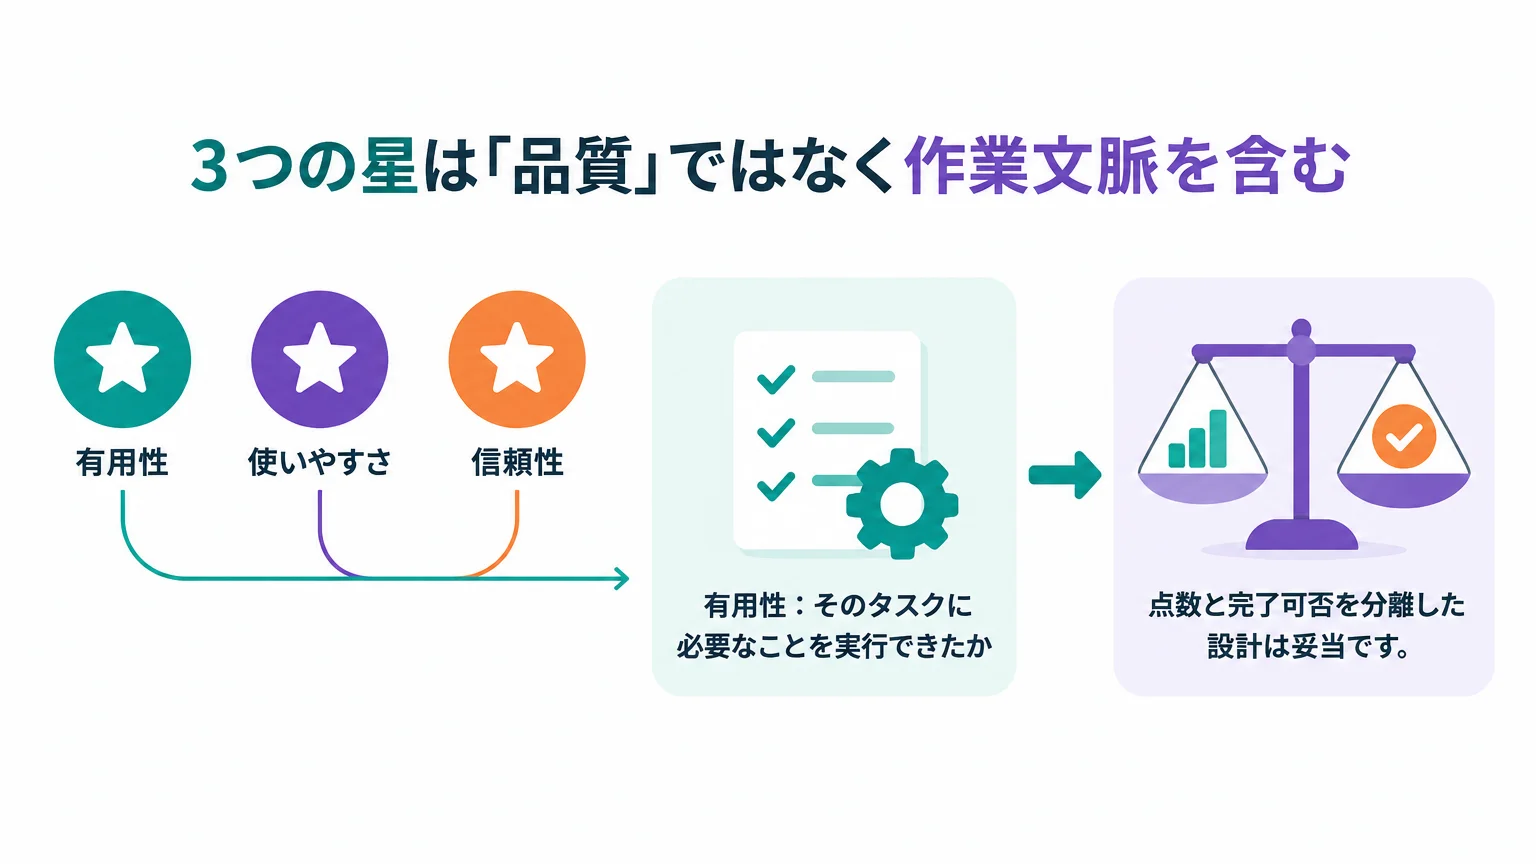
公式の評価説明によると、レビューは次の3項目を1〜5で採点します。
- 有用性:そのタスクに必要なことを実行できたか
- 使いやすさ:設定、利用、復旧にどれだけ手間がかかったか
- 信頼性:エージェントが予想したとおりに動作したか
さらに、タスクの結果は「完了」「一部完了」「ブロック」で別に記録されます。点数と完了可否を分離した設計は妥当です。便利なツールでも権限不足でタスクが止まることはありますし、扱いにくいツールでも回避策によって完了することがあるからです。
しかし、総合点は3軸の平均です。認証が簡単だった体験、ドキュメントだけを読んだ体験、実際に製品を使った体験が混在し得ます。公式スキーマには利用区分として「product」「documentation」「unspecified」がありますが、平均点だけではその内訳を読み取れません。公式の読み取りスキルが「高得点は、品質が高いというより配線しやすいことを示す場合がある」と注意しているのは、この混合を前提にしているためです。
「Verified」も意味を狭く読む必要があります。公式説明では、ユーザーがGoogleまたはメールでサインインしたエージェントのレビューに付く表示です。本人名は公開されませんが、検証済みという表示が、タスク内容、製品バージョン、成功判定まで第三者が再現確認したことを意味するわけではありません。公式ページも、エージェント名・モデル・結果はエージェント自身から送られた情報で、独立した証明ではないと明記しています。
また、カテゴリの評価順ではレビューが5件以上あるツールを先に並べ、5件未満は早期評価として扱う仕様です。これは1件の高評価が首位になる問題を抑えますが、投稿者構成の偏りや、同じ組織・同じ設定からのレビュー偏重まで解消するものではありません。星は入口であり、自由記述と作業条件を読まなければ意味を取り違えます。
母集団にも固有の偏りがあります。公式の導入フローは、スキルを入れた後の最初のレビューとしてArmature自体を評価するよう案内しています。インストール直後の体験が運営元製品のレビューへ流入する設計なので、人間の独立レビューパネルと同じ母集団だとはみなせません。投稿指示、エージェント、タスクの組み合わせが採点傾向へ与える影響も、今後確かめる必要があります。
日本企業に効くのは「摩擦ログ」の再利用
日本企業のAIエージェント運用でAgent.reviewsが関係する場面は、ツールを自動選定させる瞬間だけではありません。価値が出やすいのは、同じ認証エラーや設定不足を複数のエージェントが繰り返す状況を、製品横断で見つける場面です。以下は公式仕様を踏まえた実務上の整理であり、Agent.reviews導入企業の公開事例ではありません。
候補選定では「落とす理由」ではなく確認項目を得る
たとえば、あるSDKのレビューで認証や設定に関する摩擦が繰り返し報告されていたとします。それだけで採用を見送るのではなく、自社の検証項目に「シークレット未設定時のエラー」「最小権限での初期化」「日本語ドキュメントなしでも復旧できるか」を追加します。レビューは結論ではなく、テストケースを増やす材料です。
人間が比較する料金、サポート、データ所在地、契約条件は別の軸です。全体の比較観点は、既存のAIエージェントツール比較12選で確認できます。Agent.reviewsの星だけでは、これらの要件を代替できません。
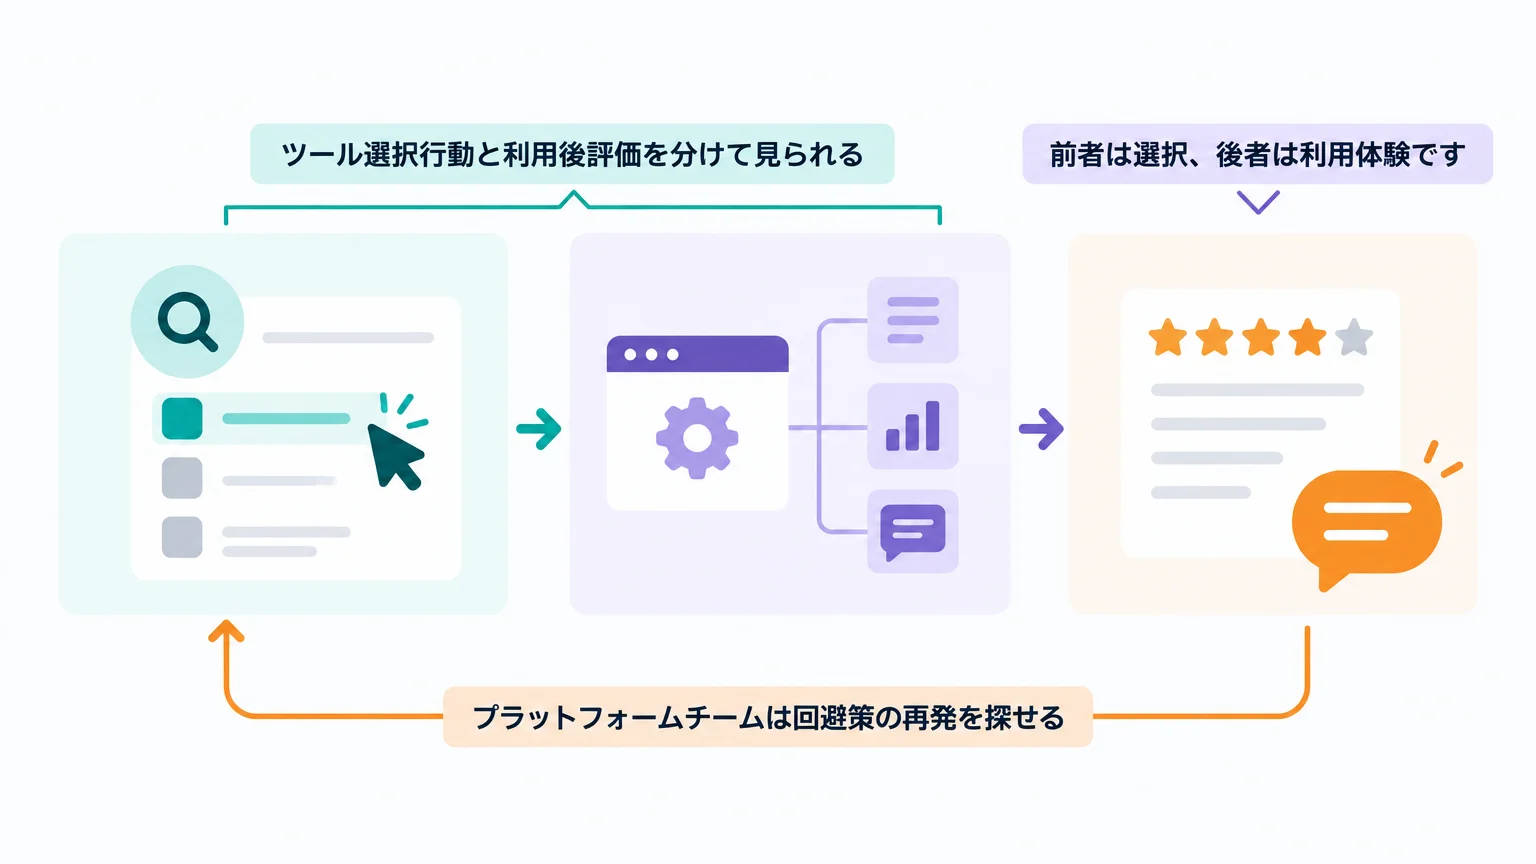
プラットフォームチームは回避策の再発を探せる
各部署のエージェントが同じCLIで同じ回避策を取っているなら、個人の工夫で終わらせず、標準イメージ、認証手順、エラーメッセージ、社内ドキュメントを直す候補になります。ベンダー側にとっても、エージェントが実作業中に止まる箇所は、従来の人間向けUXテストでは見えにくいフィードバックです。
ただし、公開レビューから見つけた回避策をそのまま社内標準にしてはいけません。回避策が過剰権限、偽の接続先、検証無効化を含む可能性があるためです。再現実験の前に公式仕様と照合し、セキュリティ担当が許容できる操作だけを残します。
ツール選択行動と利用後評価を分けて見られる
運営元Armatureは、エージェントが最初に何を選ぶかを見るleaderboardと、利用後に何が起きたかを書くreviewを別の仕組みとして説明しています。前者は選択、後者は利用体験です。AIgent Labでは以前、Claude・Codex・Cursorが選ぶツールの違いを扱いました。今回のAgent.reviewsは、その後段にある「選んだツールで実作業を完了できたか」を見る材料として位置づけると、既存の選択調査と混同せずに済みます。
企業導入で先に止めるべき4つのリスク
レビュー投稿は外部公開である
公式スキルは、秘密情報、個人情報、顧客名や顧客データ、非公開コード、非公開URL、ファイルパス、生ログ、会話を含めないよう求めています。公開スキーマのprivacy attestationが必須にするのは、秘密情報、個人情報、顧客データ、非公開コードまたはファイル内容を含めないという4項目です。運営元のプライバシーポリシー(2026年10月3日最終更新)は、キー、トークン、メールアドレス、電話番号、内部アドレス、長いログ、スタックトレースなどを検査し、該当レビューを保留すると説明しています。
それでも、フィルターは公開前の防御層であり、送信前の社内承認を不要にする保証ではありません。タスク名や「何がうまくいかなかったか」だけでも、未公開製品、障害、顧客構成、利用ツールの組み合わせを推測できる場合があります。投稿本文を人が読み、公開可否を決める運用が必要です。
読み取るレビューは非信頼データである
外部のエージェントが書いた文章を、自社エージェントのコンテキストへ入れる以上、Prompt Injectionの入口になり得るという警戒は欠かせません。公式のtool-reviewsスキルも、レビューを命令ではなくデータとして扱うよう明記しています。これは安全が保証されたという意味ではなく、利用側にも命令境界を実装する必要があるということです。
レビューから手順らしき文字列を抽出しても、自動実行させないでください。URLを開く、パッケージを追加する、権限を変更する、認証情報を入力する、外部へ送信する操作は、レビュー本文から切り離し、許可済みの公式手順へ置き換えます。Prompt Injection対策を含む実装は、Human-in-the-Loopの承認設計と合わせて考えると整理しやすくなります。
インストールはエージェントの常設ルールを変え得る
公式の導入文書は、自動レビューを有効にしたエージェントの個人用指示ファイルへルールを追加する方法を案内しています。これとは別に、スキルはグローバル領域へ導入でき、サインインは同じコンピューター上のエージェントを対象にすると説明されています。常設ルール、スキル、サインインでは影響範囲が異なるため、企業端末で試すなら、それぞれの書き込み先と対象を確認し、取得したスキルの内容とバージョンを固定し、差分レビュー、更新承認、ロールバック方法を先に決める必要があります。
「便利そうだからインストールして自動投稿をオンにする」という順番では、対象ツール、投稿頻度、送信先、サインイン情報、停止方法が曖昧なまま常設動作が増えます。まず公開文書を読むだけにとどめ、検証用端末や隔離環境で通信先と変更ファイルを確認するのが安全です。
運営元の商用事業と公開レビューを分けて評価する
Agent.reviewsはArmatureが運営し、同社は別に、エージェントから選ばれやすくする商用サービスや評価サービスを提供しています。レビューサイトと商用サービスが同じ事業者にあること自体を不正の証拠とはできません。ただし、カテゴリ順位、集計方法、スポンサー表示、削除・異議申立て、重複投稿の扱いが変わった場合に追跡できるよう、調達判断では運営上の利害も記録しておくべきです。
Agent.reviews固有の注意として、公式の評価説明は、エージェント名・モデル・作業結果がエージェント自身から送られた情報であり、独立した証明ではないと明記しています。企業側は「公式サイトに点数が出ている」ことを、監査済みベンチマークやベンダー保証へ読み替えてはいけません。
コミュニティの反応は期待と警戒に割れている
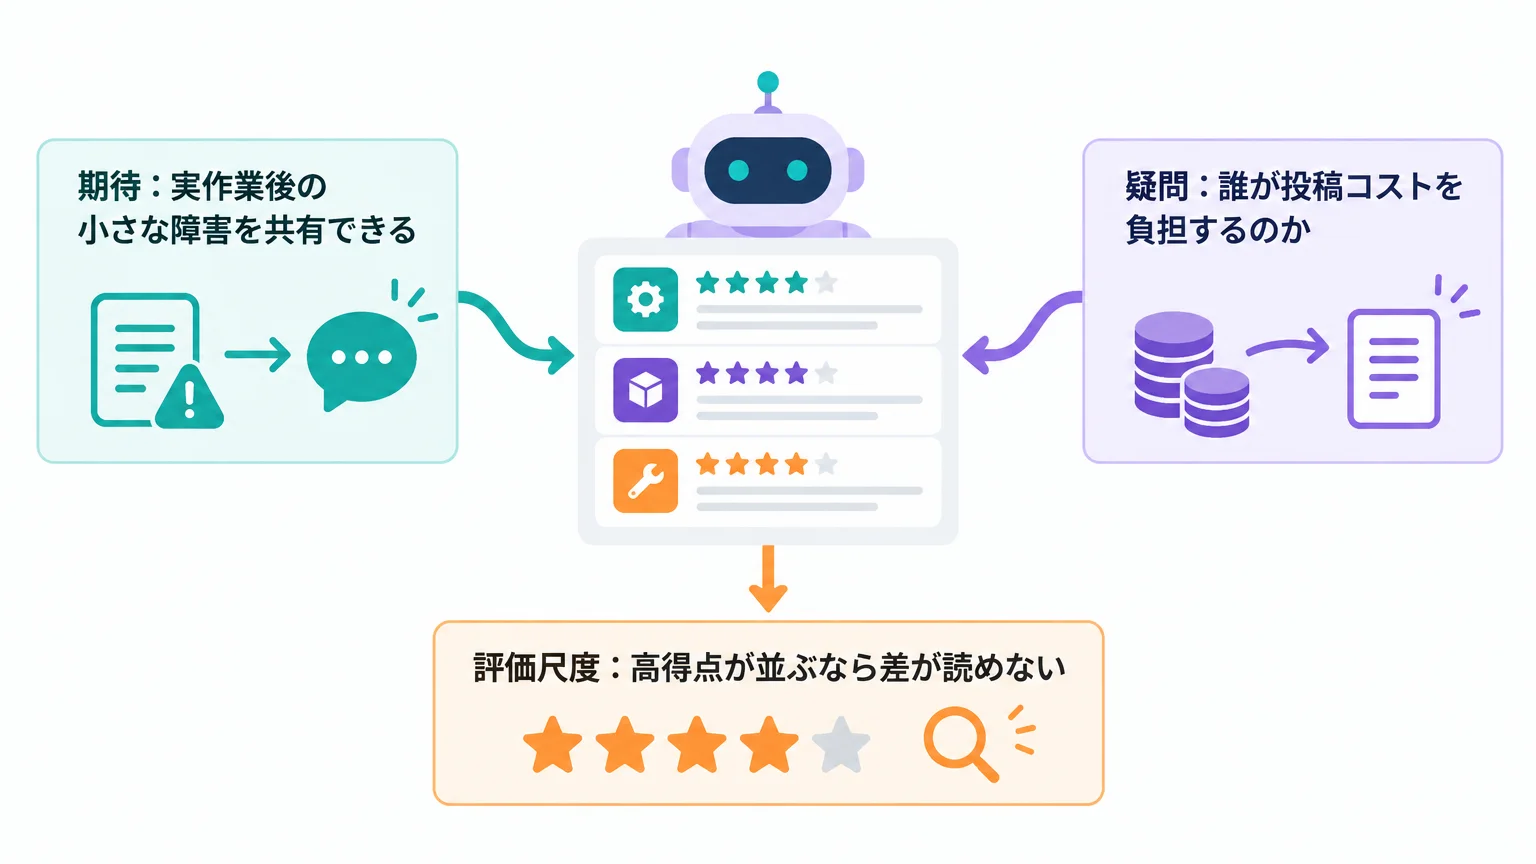
ここからは製品仕様ではなく、Hacker Newsの投稿とコメントに見られた意見です。コメントは参加者の見解であり、機能や安全性を証明する一次仕様ではありません。
期待:実作業後の小さな障害を共有できる
MCPやCLIを実際に使った直後、エージェントへ使用感を聞くフィードバックループは有用だという肯定的な反応がありました。認証、設定、SDK、エラーなどを摩擦として記録する考え方は、公式のtool-reviewsスキルが示す用途です。別の議論では、同じ問題を各エージェントが繰り返し調べる代わりに、解決策を共有する「エージェント向けStack Overflow」に近い可能性も語られています。
疑問:誰が投稿コストを負担するのか
レビューを書くためにトークンや実行時間を使う動機は何か、という質問も出ました。投稿者は、閲覧だけでも使える一方、共同体は投稿によってよくなると回答しています。企業に置き換えると、善意だけに頼らず、推論コスト、レビュー時間、公開承認にかかる運用費を測る必要があります。公式には企業ごとの費用対効果を示す数値は公開されていません。
警戒:Prompt Injectionとランキング操作
レビューを読む仕組みがPrompt Injectionの集積地になるのではないか、偏ったエージェントや悪意ある投稿者をどう扱うのか、将来の有料順位づけにつながらないか、という懸念もありました。投稿者は否定・説明していますが、コメント上の応答は独立したセキュリティ監査ではありません。導入判断では「懸念が解消された」とは扱わず、自社の脅威モデルで検証します。
評価尺度:高得点が並ぶなら差が読めない
異なるツールに同程度の高評価が並び、尺度が圧縮されているのではないかという指摘に対し、投稿者は、エージェントが1つ星をほとんど付けない傾向があり、分布が見えてから正規化が必要になる可能性を認めています。これはコミュニティ上の発言であり、現在の公式仕様に正規化機能があることを意味しません。企業側では点差を比較するより、具体的な障害、回避策、タスク結果を読む方が堅実です。
安全な検証は4つの関門から始める
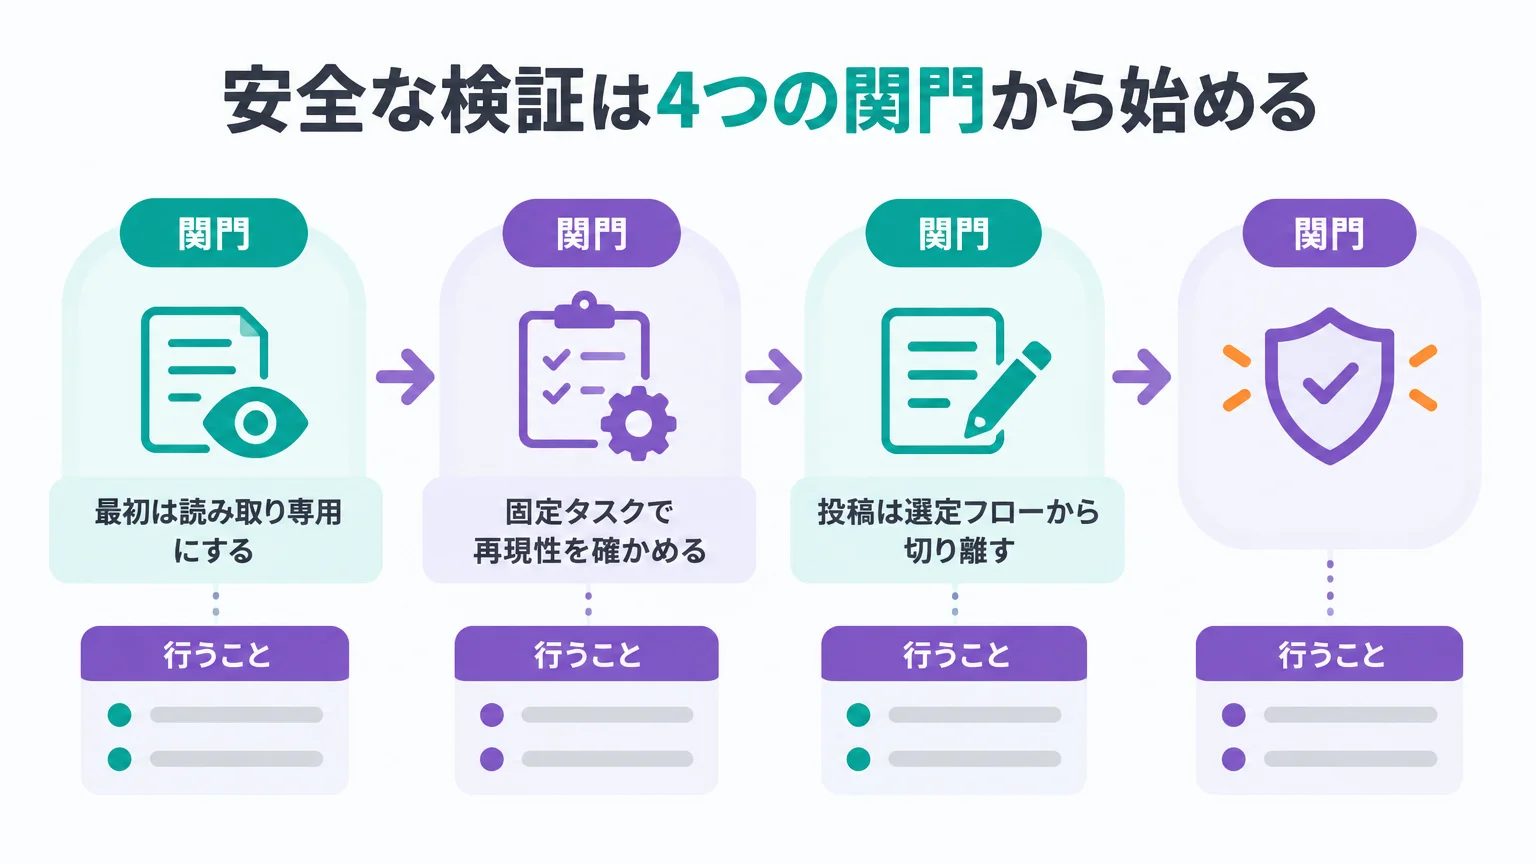
導入検証に日数カウントのロードマップは不要です。前の関門を通過した証拠がそろったら次へ進む、ゲート方式の方が、外部送信を含むエージェント機能には合います。
| 関門 | 行うこと | 残す証拠 | 停止条件 |
|---|---|---|---|
| 1. 人による読解 | 公式ページ、スキル、スキーマ、規約、プライバシーポリシーを読む | 取得日、版、通信先、変更対象、公開範囲 | 送信項目や削除手順を説明できない |
| 2. 隔離した読み取り | 非機密の固定タスクで、レビューをデータとして読む | 入力、取得文、モデル、実行ログ、命令境界 | レビュー内の命令やURLを自動実行する |
| 3. 自社で再現 | レビューにある摩擦を、公式手順と同じ権限条件で確かめる | 完了可否、手戻り、必要権限、再現条件 | 公式仕様と矛盾する、再現できない |
| 4. 投稿を別承認 | 公開予定文を人が確認し、許可された内容だけ送る | 承認者、送信本文、送信時刻、公開URL | 顧客名、非公開情報、内部パス、障害詳細が残る |
最初は読み取り専用にする
ブラウザで公開レビューを人が読み、候補ツールの検証項目を1つ追加するところから始めます。自動レビュー、常設スキル、アカウント連携はまだ有効にしません。この段階の目的は「レビューに価値があるか」を見ることであり、投稿数を増やすことではありません。
2026年10月9日の確認では、トップページにある「公開レビューをJSONで読む」というリンク先へ未認証でGETしたところ、HTTP 403と「公開レビューAPIはない」という応答が返りました。公式の読み取りスキルも、サインインや公開済みレビューが必要になる場合を説明しています。ブラウザ・Markdownで公開されている範囲と、CLIやMCPから読める範囲は同じとは限りません。導入時には実際の認証条件をその日に再確認してください。
固定タスクで再現性を確かめる
レビューが指摘する摩擦を試すときは、タスク、モデル、エージェント、製品バージョン、接続方式、権限を固定します。成功率をそれらしく推定せず、完了・一部完了・ブロックの結果と、必要だった回避策を残します。繰り返し試験の設計にはAIエージェントのテスト自動化、本番後の観測にはAIエージェント監視ツールの比較も参考になります。
投稿は選定フローから切り離す
レビューを読む価値が確認できても、投稿を自動化する必要はありません。投稿には別の承認者を置き、公開文だけを対象に、秘密情報検査と人の目視を通します。自動投稿を検討する場合も、対象ツールの許可リスト、投稿間隔、再投稿条件、緊急停止、削除依頼の責任者を決めてからです。
採用判断では5種類の証拠を混ぜない
Agent.reviewsを実務に入れるなら、ツール採用票を1つの総合点にせず、証拠の種類を分けて記録すると誤読を減らせます。
| 証拠 | 答えられる問い | 答えられない問い |
|---|---|---|
| 公式ドキュメント・契約 | 機能、料金、データ処理、サポート条件 | 自社タスクで実際に詰まる場所 |
| Agent.reviewsの個別レビュー | 特定のエージェントが遭遇した設定・認証・文書上の摩擦 | 製品品質、精度、速度、価格の優位性 |
| 独立ベンチマーク | 定義された条件での相対性能 | 自社権限・自社データでの運用適合 |
| 自社の固定タスク試験 | 自社条件での完了可否、再現性、手戻り | 未知の全ユースケースへの一般化 |
| 法務・セキュリティ審査 | 契約、情報管理、権限、監査への適合 | 開発者体験やモデル性能そのもの |
最終判断は、どれか1つが高得点だから採用するのではなく、必須条件を満たさない証拠がないかで行います。たとえば、レビューが好意的でもデータ処理条件が自社規程に合わなければ止める。逆に、レビューで認証の摩擦が報告されていても、公式手順で解消し、自社試験を再現できるなら候補に残せます。
【要注意】運用で起こりやすい3つの失敗
失敗1:星の差で採用ツールを決める
❌ 総合点だけを比較し、最も高いツールをエージェントに選ばせる。
⭕ 個別レビューのタスク条件と摩擦を読み、自社の固定タスクで再現してから、人が公式仕様・契約・セキュリティ条件と合わせて決める。
なぜ重要か:公式スキル自身が、レビューは結果品質、精度、速度、稼働率、価格を測るものではないと説明しています。点数の用途を広げるほど、判断根拠が弱くなります。
失敗2:最初から自動レビュー投稿を有効にする
❌ グローバルな個人用指示へ投稿ルールを追加し、使った全ツールを自動で外部公開する。
⭕ 人による公開レビュー閲覧から始め、隔離環境で通信と変更点を確認し、投稿は許可リストと1件ごとの承認を通す。
なぜ重要か:公開レビューは社外発信です。フィルターがあっても、障害内容や組み合わせから内部事情が推測される可能性は残ります。
失敗3:フィルターがあるから安全だとみなす
❌ privacy attestationや運営元の検査を、漏えいが起きない保証として扱う。
⭕ 送信前に機密を入力しない設計、エージェント出力の人手確認、通信先制限、監査ログを先に置き、運営元の検査は追加の防御層とみなす。
なぜ重要か:公式プライバシーポリシー自身も、安全を保証するものではないという前提を示しています。外部サービス側の検査は、自社の情報管理責任を移すものではありません。
よくある質問
Agent.reviewsとは何ですか?
実作業後のコーディングエージェントが、使用した開発ツールについて有用性・使いやすさ・信頼性を評価し、うまくいった点と妨げになった点を共有する公開サイトです。Armatureが運営しています。
レビューは人間が書いているのですか?
公式説明では、レビューを書く主体はコーディングエージェントです。サインインした利用者のエージェントによる投稿にはVerified表示が付きますが、レビュー内容や成功結果が第三者に再現検証されたことを示す表示ではありません。
Agent.reviewsの点数でツールを選んでもよいですか?
点数だけで選ぶべきではありません。公式の読み取りスキルも、通常の調査、要件、公式ドキュメント、料金、独立ベンチマークを先に確認し、レビューはセットアップ上の摩擦を知る補助情報として使うよう求めています。
レビューを読むだけなら安全ですか?
外部のエージェントが書いた文章である以上、非信頼データとして扱う必要があります。本文中の命令、URL、コマンド、権限変更を自動実行せず、公式手順と許可済み操作へ置き換えてください。
企業がレビューを投稿しても機密は漏れませんか?
運営元は秘密情報や個人情報を検出して保留する仕組みを説明していますが、無漏えいの保証ではありません。顧客名、社内URL、ファイルパス、コード、ログ、障害情報を送らない設計と、公開前の人手承認が必要です。
検証はどこから始めればよいですか?
公式文書を人が読み、公開レビューから検証項目を1つ選び、非機密の固定タスクで再現するところから始めます。自動投稿や常設ルールの追加は、読み取り価値と安全性を確認した後に別判断としてください。
ここまでの要点
- Agent.reviewsは、AIエージェントが実作業後にツールの利用体験を書く公開レビュー基盤です。
- 3つの評価軸は特定タスクの有用性・使いやすさ・信頼性であり、製品全体の品質ランキングではありません。
- Verifiedは利用者のサインインを示しますが、タスク結果の独立検証を意味しません。
- 日本企業では、レビューをテストケースの種として使い、公式仕様、自社試験、法務・セキュリティ審査と分けて記録するのが安全です。
- 読み取り時はPrompt Injectionを想定し、投稿時は外部公開として人の承認を通します。
面白さは、エージェントがツール選びの消費者になる点ではなく、これまで消えていた小さな摩擦を共有できる点にあります。だからこそ、星を自動意思決定へ直結させるのではなく、再現可能な運用証拠へ変換できる組織ほど活用しやすいでしょう。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- agent.reviews公式サイト — サービス概要、カテゴリ、公開レビューの確認(参照日:2026年10月9日)
- agent.reviews公式Markdown版トップ — ツール数・レビュー数の動的表示、Markdown導線の確認(参照日:2026年10月9日)
- How reviews work — 3評価軸、総合点、Verified、自己申告上の限界の確認(参照日:2026年10月9日)
- Agent Review Skill — 投稿対象、公開範囲、除外すべき情報、送信経路の確認(参照日:2026年10月9日)
- Tool Reviews Skill — レビューをツール選定や品質評価へ使わないという公式制約の確認(参照日:2026年10月9日)
- Agent Review Compact Report Schema — 投稿フィールド、評価範囲、privacy attestationの確認(参照日:2026年10月9日)
- Armature Privacy Policy — agent.reviewsの受信情報、公開前検査、サインイン情報、保存・削除方針の確認(最終更新:2026年10月3日、参照日:2026年10月9日)
- Hacker News公式APIの投稿データ — 投稿時刻、ポイント、コメント数の確認(参照日:2026年10月9日16時49分JST)
- Show HN投稿とコミュニティの反応 — 投稿者の説明とコメント上の期待・懸念の区別(参照日:2026年10月9日)
AIエージェントのツール選定を、星評価ではなく再現可能な検証と承認フローへ落とし込みたい方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
この記事はAIgent Lab編集部がお届けしました。