判断の分かれ目は、これを「AIによる惑星発見」と読むか、「AIを使った未確認候補の検証設計」と読むかに尽きます。
2026年10月9日時点で確認できるのは、独立研究者Pavel Rabtsevich氏がClaude Codeを使った解析からTIC 4206066の惑星候補を報告し、プレプリント、解析を裏づけるデータとコード、検証ルールを公開したこと、そしてTESSの追加観測枠が有効になっていることです。惑星そのものは未確認で、NASAによる発見認定や査読済み論文の成立を意味しません。
- 公開済み:3.18日周期の主信号、より弱い11.13日周期の信号、解析資料、Sector 110向け事前登録
- 公式に確認可能:TESS DDT Program 100がactiveで、TIC 4206066を2分間隔で観測する予定
- 未確定:信号の原因が惑星か、どの天体を周回するか、追加観測で予測どおり再現するか
- 企業が学ぶ点:エージェントの出力を「回答」ではなく、反証条件、独立監査、再実行可能な証拠を伴う「候補」として扱うこと
ニュースの元になったのは、2026年10月7日にRedditへ投稿された「I think I found a planet nobody knew existed. I used Claude Code to find it」です。刺激的な題名ですが、投稿者自身が本文で「planet candidateであり、confirmed planetではない」と線を引いています。ここを外すと、ニュースの意味を正反対に読んでしまいます。
TIC 4206066をめぐり、確認できた事実は三つ
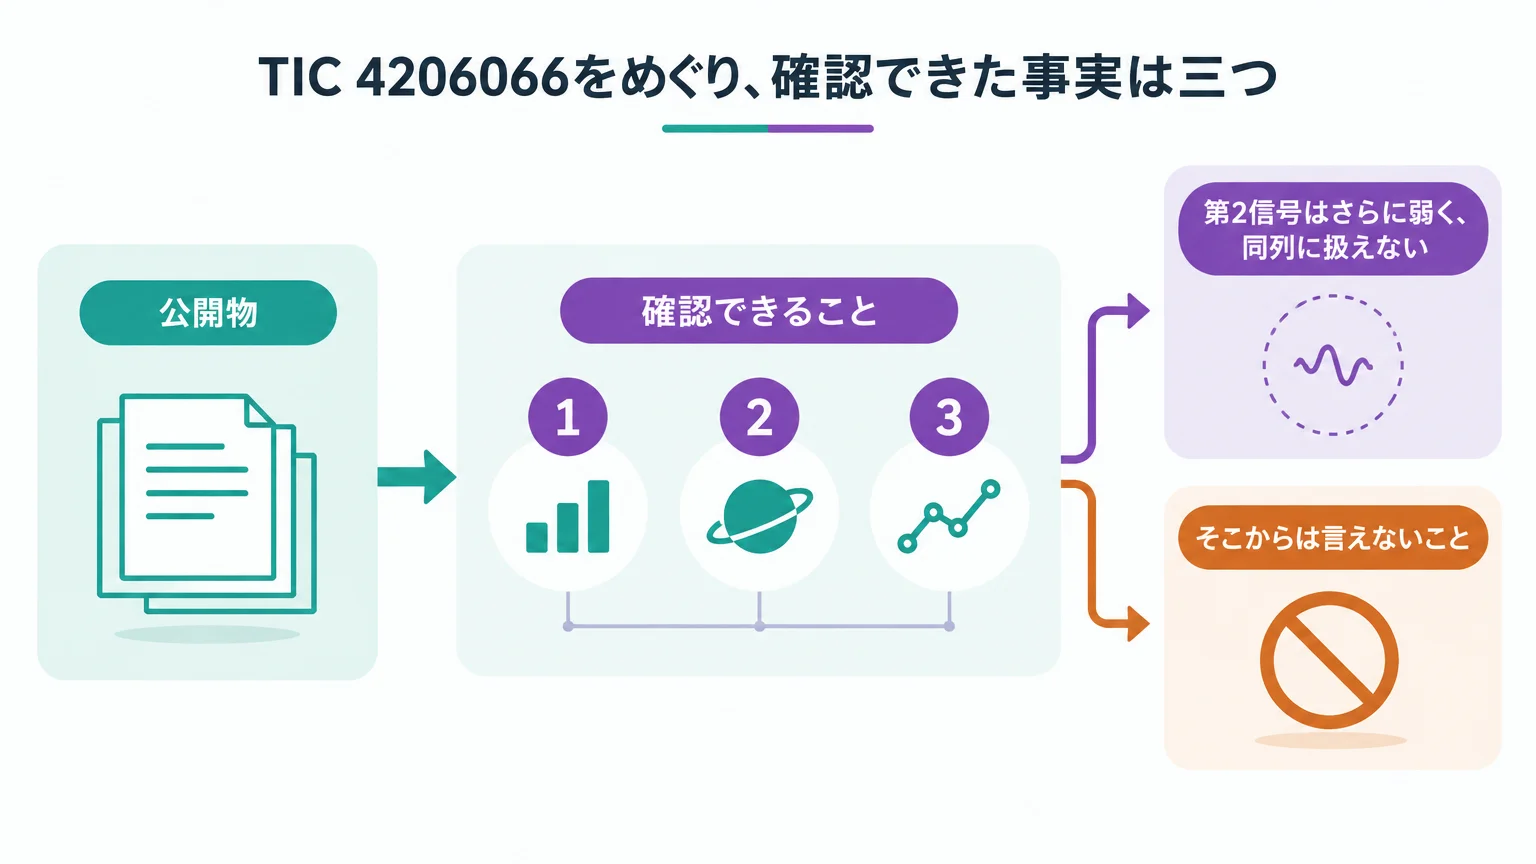
今回公開されたものは、SNS上の成功談だけではありません。候補を記述したプレプリント、分析を支えるデータとコード、まだ取得されていない将来データに対する判定ルールが別々の記録として残されています。一方、それらが公開されていることと、第三者が全計算を再現し、惑星を確認したことは別です。
| 公開物 | 確認できること | そこからは言えないこと |
|---|---|---|
| Reddit投稿 | 投稿者が説明する発見経緯、Claude Codeの担当、監査手順 | モデル利用ログの第三者確認、科学的妥当性の確定 |
| Zenodoプレプリント | 候補の数値、解析方法、残る偽陽性、AI利用開示 | 査読済み掲載、統計的な妥当性確認、正式な惑星確認 |
| 解析を裏づけるデータとコード | 再確認に使える資料が公開されていること | 本稿執筆時点で全工程が独立再現されたこと |
| Sector 110事前登録 | 未来データを見る前に予測と判定条件を固定したこと | 追加観測で信号が再現すること、原因が惑星であること |
| TESS DDT一覧 | Program 100、対象1件、2分間隔、activeという登録 | NASAやMITが候補を惑星と認定したこと |
主信号は3.18日周期、ただし著者も妥当性確認を主張していない
2026年9月25日公開のプレプリントは、TESSのSector 98で見つけ、Sector 6とSector 32へ遡って確認した主信号を報告しています。著者の解析では周期は約3.18日、23回のトランジット、深さは約500 ppmで、信号が対象星を回る惑星によるものなら半径は地球の1.4±0.1倍に相当します。
しかし同プレプリントは、偽陽性確率(FPP)を0.03〜0.04とし、TRICERATOPSの基準(FPP < 0.015かつ近傍偽陽性確率のNFPP < 10-3)のうちFPP条件を満たさないため、統計的な妥当性確認(validation)を主張しないと明記しています。未解像の伴星を惑星が横切る場合など、まだ排除し切れていない説明が残るからです。「地球より少し大きい岩石惑星」とまで言い切ることもできません。推定されているのは条件付きの半径であり、組成を決める質量や密度が確認されたわけではないためです。
第2信号はさらに弱く、同列に扱えない
同じ対象には11.13日周期の第2信号も報告されています。対象星上の信号なら地球半径の約2.2倍に相当するとされますが、プレプリントは約3σの事後検定で得た暫定的な信号と位置づけています。主信号と第2信号をまとめて「2惑星を発見」と書くのは、一次ソースの留保を落とす表現です。
投稿者が説明した、人間とClaude Codeの分業
事例区分:公開事例
以下はReddit投稿と著者プレプリントに記載された役割分担です。AIの実行ログを本稿で独立監査したものではありません。
投稿者によると、Claude CodeはTESSデータのダウンロードと解析、探索コードの作成、トランジットのフィッティング、近傍星や二次食などの偽陽性チェック、図の生成、失敗したテストの再実行を担当しました。投稿ではOpus 5.5とFable 5.1を使ったと説明し、Codexと新しい読み取り専用セッションをレビュー役に置いたとしています。
一方、何を問うか、どの検査が重要か、何を合格・不合格とみなすかは人間が決めたと書かれています。プレプリントのAI利用開示も、著者が研究を設計・指揮し、結果と図を確認して結論を出し、Claude Codeはコード、計算、図、参考文献、草稿を支援したという整理です。つまり「AIが自律的に天文学上の発見を確定した」のではありません。
この分業はAnthropic自身の調査とも整合します。Anthropicが2026年6月16日に公表した約40万件のClaude Codeセッション分析では、典型的なセッションで人が計画上の判断を多く担い、Claudeが実行上の判断を多く担う傾向が報告されました。今回の事例で価値があるのは、専門判断までモデルへ移したことではなく、専門判断を検査可能な作業へ落とし、反復部分をエージェントへ渡した点です。
隠した年を当てても、独立した確認観測にはならない
投稿者が特に重視したのは、ある年の観測を隠し、残る年から周期を計算して、隠した年のトランジット時刻を予測する検査です。投稿では2018年、2020年、2025年の各データについて予測位置に信号が出たと説明しています。時系列データの再現性を見る方法としては分かりやすく、単一期間だけに現れたノイズではないかを疑う助けになります。
ただし、Sector 110の事前登録は、過去のデータがすでに探索・選択に使われたため、それらは完全に独立したテストではないと明記しています。過去データを分け直す擬似ホールドアウトと、まだ存在しない未来データで行う前向き検証は、証拠の強さが違います。この違いは企業のエージェント評価でも重要です。
- 既存ログを分割して評価する場合、設計者が全体の傾向を知っている可能性を記録する
- 最終判定用データは、プロンプトや閾値を固定した後まで触らない
- 同じモデルに「作成」と「自己採点」をさせただけの結果を独立評価と呼ばない
- 陽性が再現しても、別原因が同じ結果を生む可能性を残す
2026年10月6日に公開されたSector 110向け事前登録は、主信号について9回、第2信号について3回の予測時刻、期待する深さ、処理方法、位置の検査、判定ルールを新規データ取得前に固定しました。結果は「回復(recovered)」「予測と不整合(inconsistent)」「除外(excluded)」「データ不足(insufficient data)」の4区分です。曖昧な結果を無理に成功か失敗へ押し込まず、「データ不足」を正規の状態にした点も実務的です。
追加観測枠と「発見認定」は別物
TESSのDirector’s Discretionary Targets公式一覧には、Program 100としてPavel Rabtsevich氏、TIC 4206066、2分間隔、対象数1、activeと掲載されています。これは投稿者の申請が追加観測枠に入り、対象星を細かい時間間隔で観測する予定であることを公式に確かめられる証拠です。
一方、Sector 110公式ページが示す観測期間は2026年10月31日から11月26日です。2026年10月9日時点では新しい観測データ自体がまだ存在しません。「NASAが11月に惑星を確認する」と未来の結果を先取りすることはできません。
NASAは系外惑星のcandidateとconfirmedの違いを説明し、候補は望遠鏡で見つかった有望な信号であって、まだ存在が証明されていない段階だとしています。周期的な減光は、伴星、塵、褐色矮星、望遠鏡やデータ処理由来のアーティファクトでも起こり得ます。今回の公式DDT登録が意味するのは「追試する価値がある対象として観測枠が設定されたこと」であり、「惑星であると判定されたこと」ではありません。
ExoFOP-TESSのTIC 4206066対象ページも、2026年10月9日の確認時点ではConfirmed Planet(s)をN/A、TOIとCommunity TESS Object of Interestを各0件と表示していました。これは当日のカタログ状態であり、将来の登録や別名での記録を否定するものではありませんが、少なくとも「すでに公式カタログで確認済み」という説明とは一致しません。
AIによる科学候補と確認済み成果の区別は、AIgent LabのOpus 5.5の常温磁性半導体2候補を扱った記事でも共通する論点です。候補生成の速度と、専門家コミュニティが行う確認の強度は、別のKPIとして管理する必要があります。
Hacker Newsの論点は科学利用、偽陽性、文章表現に分かれた
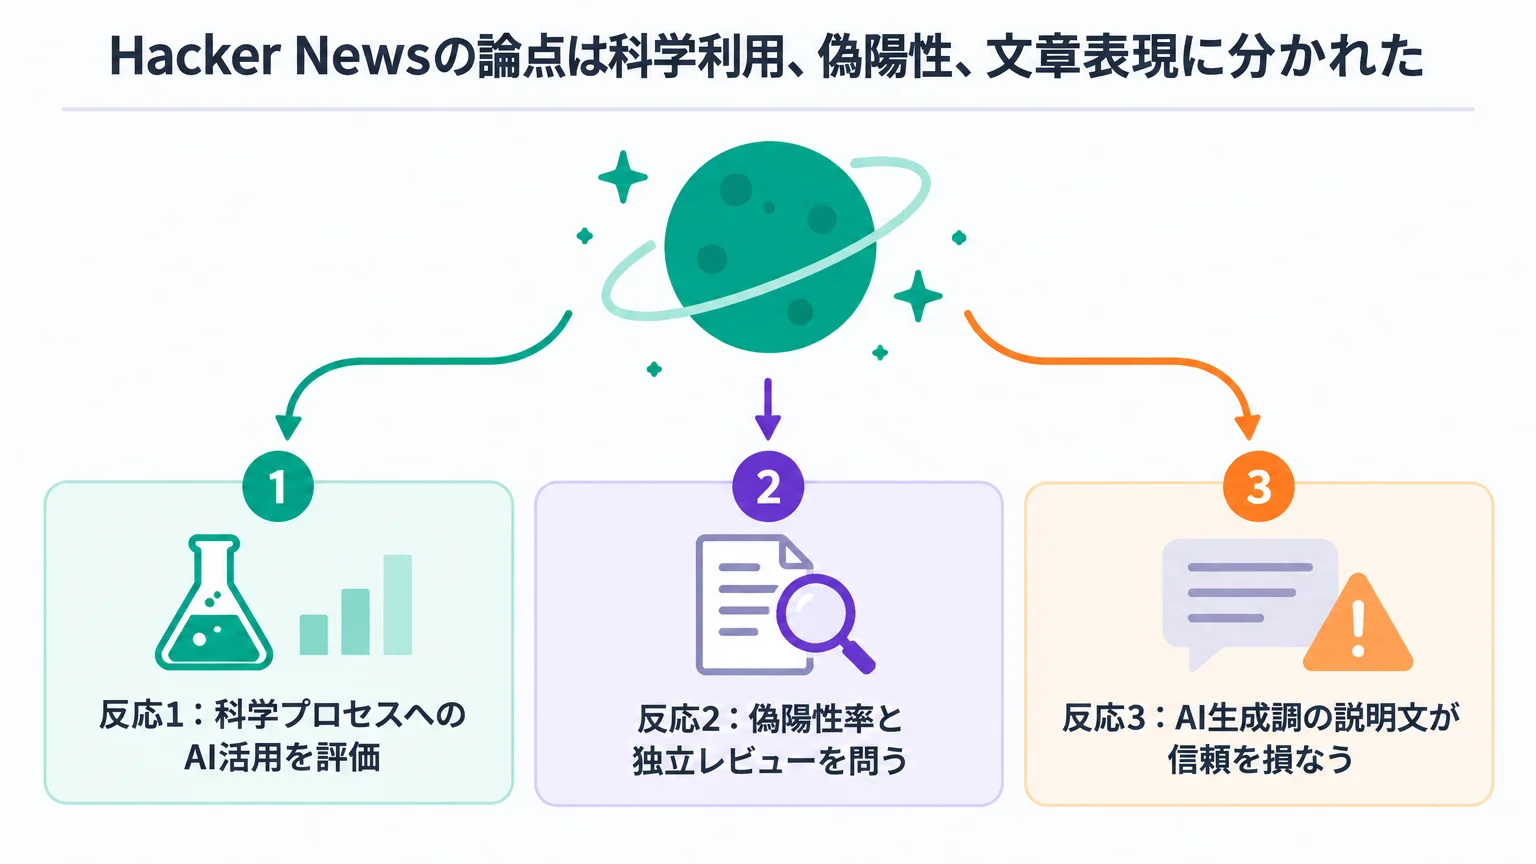
この話題を扱ったHacker Newsのスレッドでは、科学分野での具体的なAI活用を評価する声、偽陽性率や査読を重視する慎重論、AI生成調の文章への反発が混在していました。以下はあくまでコミュニティの反応であり、候補の科学的妥当性を裏づける証拠ではありません。
反応1:科学プロセスへのAI活用を評価
科学分野での応用を評価したコメントでは、科学プロセスに合わせて訓練されたモデルと、適切なエージェント運用への期待が示されました。これはコミュニティの評価であり、候補の科学的妥当性を裏づける証拠ではありません。
反応2:偽陽性率と独立レビューを問う
偽陽性率とデータ処理上の幻覚を懸念するコメントがあり、別の検証方法を提案したコメントでは、既知の正解を持つデータ、人工的に埋め込んだ信号、シャッフルしたデータ、新規セッションによる破壊的レビューが挙げられました。これは企業のPoCでも、そのまま使える論点です。
反応3:AI生成調の説明文が信頼を損なう
研究内容とは別に、投稿文のAIらしい書き味を理由に読む意欲を失うという批判もありました。これは文章表現への反応であり、候補の科学的妥当性を判断する証拠ではありません。ただし、技術的な成果が良くても、説明文が誇張気味だったり、AI利用範囲が曖昧だったりすると、証拠を見る前に信頼を失う可能性があります。
このニュースを業務へ翻訳すると「候補の状態管理」になる
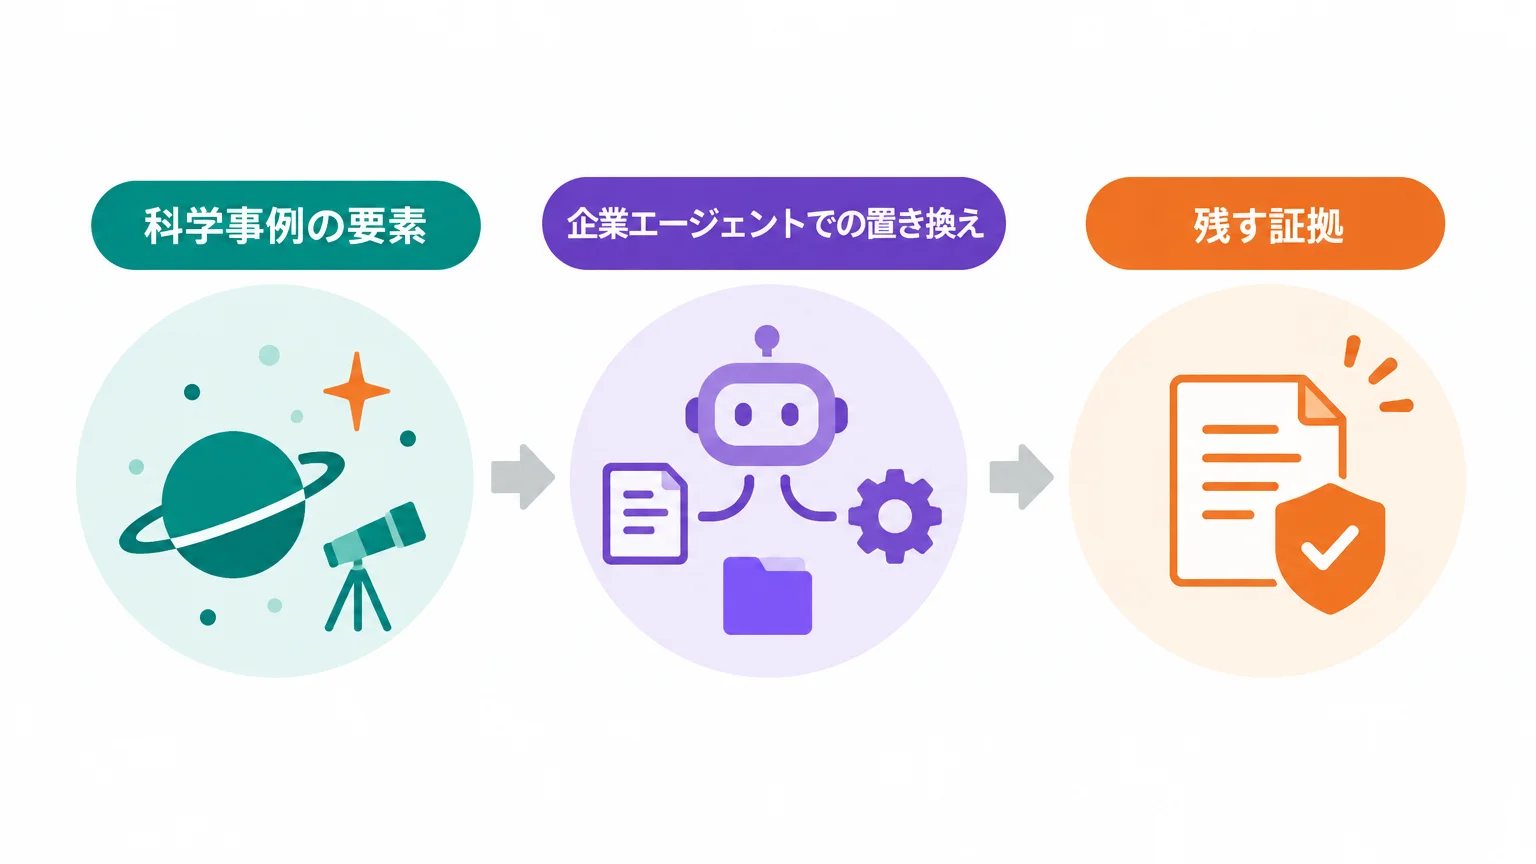
企業のAIエージェント運用では、出力を「正しい/誤り」の2値で扱いがちです。今回の事例は、候補、再現、反証、追加確認という中間状態を明示する重要性を示しています。営業予測、問い合わせ分類、契約条項抽出、障害原因の推定など、答えがその場で一意に確定しない業務ほど、この状態設計が効きます。
| 科学事例の要素 | 企業エージェントでの置き換え | 残す証拠 |
|---|---|---|
| トランジット様信号 | モデルが出した候補、異常、分類、推奨 | 入力ID、出力、根拠箇所、実行時刻 |
| 過去データでの回復 | 既知正解データでの再現テスト | テスト集合、期待値、実結果、失敗例 |
| 別原因の排除 | 競合仮説や業務例外の検査 | 反証リスト、未解決項目、担当者 |
| 未来データへの事前登録 | 本番前に評価条件と停止条件を固定 | 承認済み仕様、ハッシュ、変更履歴 |
| 追加観測 | 新規データでの前向き評価 | 未見データ、評価ログ、人間の判定 |
| confirmedへの移行 | 業務責任者が証拠を確認して限定導入 | 承認者、適用範囲、残るリスク |
特に大切なのは、エージェントが自信満々に書いた最終文ではなく、どの入力から、どのコードで、どの判定規則を通り、何が未解決なのかを成果物にすることです。自然言語の説明は読みやすくても、再実行性や追跡可能性の代わりにはなりません。
企業で再現するなら、先に固定する五つの条件
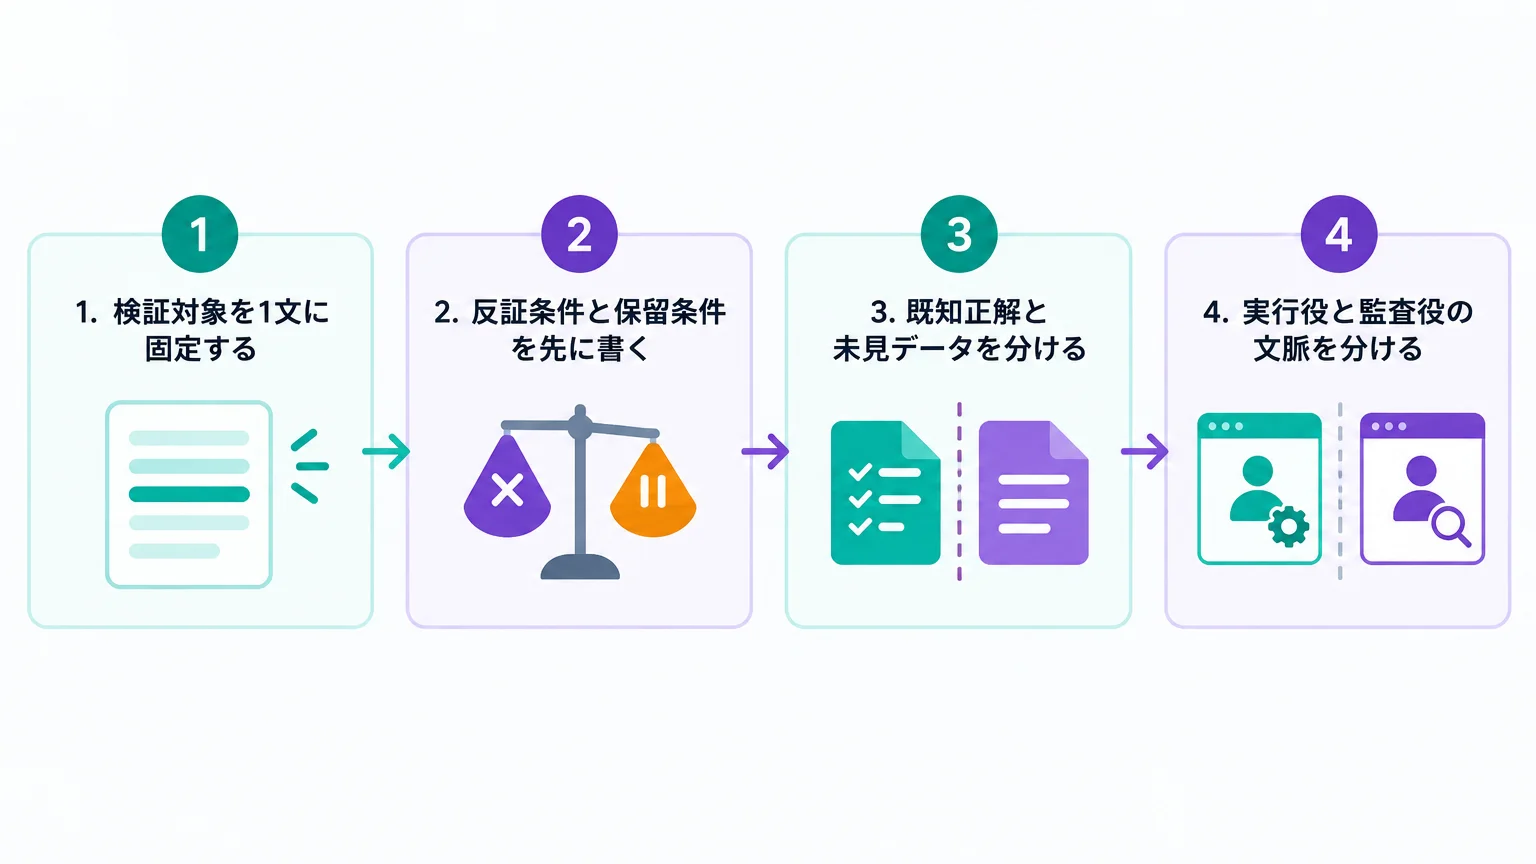
最初から複数部門をまたぐ自動化へ進む必要はありません。狭い問いを1つ選び、その候補をどう棄却するかを先に決めます。次の順番なら、エージェントの速度を使いながら、判断責任を曖昧にしにくくなります。
1. 検証対象を1文に固定する
「問い合わせ対応を自動化する」のような広い目標ではなく、「既存の製品FAQだけを根拠に、問い合わせを所定の分類へ振り分けられるか」のように、入力、出力、根拠範囲を特定します。個人情報や機密情報は、利用規約、保存先、権限設計を確認するまで投入しません。
2. 反証条件と保留条件を先に書く
正解率だけでなく、どの種類の誤りで停止するかを定義します。たとえば、根拠にない固有名詞を生成した、参照箇所を示せない、対象外カテゴリを無理に分類した、という条件です。同時に「情報不足」「対象外」「人間確認待ち」を正式な出力状態にします。無理に答えさせない設計が、もっともらしい誤答を減らします。
3. 既知正解と未見データを分ける
既知正解データは、プロンプトや処理の不具合を見つけるために使います。最終評価に使う未見データは、その調整が終わるまで隔離します。既知正解で調整した結果を、そのまま「本番でも再現した」と表現してはいけません。
4. 実行役と監査役の文脈を分ける
実装したセッションに「問題ないか」と聞くだけでは、同じ前提を引き継いだ自己評価になります。監査役には、入力、出力、評価基準だけを渡し、作成過程の説明や自己弁護を渡しすぎない方がよいでしょう。AnthropicのClaude Code公式ベストプラクティスも、作成者とは新しい文脈のレビュー役を置き、主張ではなくテスト結果などの証拠を示す方法を案内しています。
5. 人間の承認対象を結果ではなく状態遷移に置く
人間が毎件ゼロから分析すると自動化の価値が薄れます。そこで、人間は「候補から限定利用へ移す」「保留を解除する」「例外を新しい規則へ追加する」といった状態遷移を承認します。誰が何を確認すれば次へ進めるかを先に決めておけば、速度と統制を両立しやすくなります。
文脈の分離は、権限まで分けて初めて機能する
投稿者は、新しい読み取り専用セッションをレビューに使ったと説明しています。この実行履歴を本稿で独立確認したわけではありません。企業で同様の方法を採る場合は、文脈に加えて権限も分けます。実行役は指定ディレクトリへ分析結果を書けても、元データの上書きや外部送信はできない。監査役は入力と成果物を読めても変更できない。承認者だけが限定導入や外部反映を決める、という構成です。
Claude Codeの現行公式セキュリティ文書は、権限モード、ファイルシステムとネットワークのsandbox、許可・拒否ルールを説明する一方、提案されたコードやコマンドをレビューする責任は利用者側にあるとしています。ツールの安全機能は、業務上の承認設計を代替しません。
権限分離の考え方は、AIgent LabのClaude Codeサブエージェントの権限と隔離を扱った記事でも詳しく整理しています。分析案件では、少なくとも元データ、作業領域、レビュー用成果物、外部反映先を分け、書き込み可能な範囲を役割ごとに限定してください。
入力だけ固定しても、検証条件は再現できない
評価前後で入力ファイルが変わると、同じコードを再実行しても同じ検証になりません。次のPython例は、検証に使うファイル群のSHA-256を計算し、マニフェストへ保存します。モデルの出力を正しくするコードではなく、「何を入力として評価したか」を後から照合するための土台です。今回の事例に対応させるなら、入力に加えて評価規則、モデル識別子、実行コードの版、一次判定、人間の承認状態も固定します。
動作環境:Python 3.11以上、外部パッケージ不要
from pathlib import Path
import hashlib
import json

SOURCE_DIR = Path("frozen_inputs")
MANIFEST_PATH = Path("input_manifest.sha256.json")


def sha256_file(path: Path) -> str:
    digest = hashlib.sha256()
    with path.open("rb") as stream:
        for chunk in iter(lambda: stream.read(1024 * 1024), b""):
            digest.update(chunk)
    return digest.hexdigest()


if not SOURCE_DIR.is_dir():
    raise SystemExit("frozen_inputs directory was not found")

files = []
for path in sorted(SOURCE_DIR.rglob("*")):
    if path.is_symlink():
        raise SystemExit(f"symlink is not allowed: {path}")
    if path.is_file():
        files.append(path)

manifest = {
    str(path.relative_to(SOURCE_DIR)): sha256_file(path)
    for path in files
}

MANIFEST_PATH.write_text(
    json.dumps(manifest, ensure_ascii=False, indent=2) + "\n",
    encoding="utf-8",
)
print(f"recorded {len(manifest)} files in {MANIFEST_PATH}")ポイント:マニフェスト自体、実行コード、評価規則、モデル識別子、実行時刻も同じ案件フォルダに残します。入力に機密情報がある場合、ハッシュ値だけを公開してよいとは限りません。ファイル名やフォルダ構造が機密を示すことがあるため、保存先と閲覧権限を先に決めてください。
注意:本番環境で使用する前に、必ずテスト環境で動作確認してください。SHA-256は入力が同一かを確かめる手段であり、入力の正しさ、分析方法の妥当性、エージェント出力の安全性を保証するものではありません。
この事例から逆算できる三つの失敗
失敗1:観測枠の採択を、結果の承認と言い換える
❌ 「外部機関が確認作業を受け付けたので、AIの結論は正しい」
⭕ 「追加検証へ進む条件を満たした。最終結果は未確定」と状態を分ける
社内PoCの予算承認、法務レビューの開始、顧客ヒアリングの実施も、成果の正しさを保証するイベントではありません。プロセスが前へ進んだことと、仮説が確定したことを同じステータスにしないでください。
失敗2:作成したエージェントに同じ文脈で合格判定させる
❌ 実行セッションへ「この結果は正しいですか」と尋ね、その返答を監査記録にする
⭕ 未見データ、決定的なテスト、新しい文脈、読み取り専用権限を持つ監査役で崩しにいく
独立監査とは、エージェントの数を増やすことではありません。入力情報、利害、権限、評価基準の少なくとも一部を分離し、同じ思い込みがそのまま複製されないようにすることです。
失敗3:成功例だけを残し、保留と失敗を消す
❌ うまくいった出力だけを資料へ貼り、失敗した試行、閾値変更、対象外データを記録しない
⭕ 除外、矛盾、データ不足を正式な結果として残し、変更前後の条件を追跡する
もっともらしい出力を減らす設計は、AIエージェントのハルシネーション対策ともつながります。モデルへ注意を促すだけでなく、根拠制約、検証器、人間へのエスカレーションを組み合わせる必要があります。
確認に使った一次情報
- I think I found a planet nobody knew existed. I used Claude Code to find it — Reddit元投稿、2026年10月7日公開(参照日:2026年10月9日)
- Two Transit-like Signals in TESS Photometry of the Nearby K Dwarf TIC 4206066 — Pavel Rabtsevich、プレプリント、2026年9月25日公開(参照日:2026年10月9日)
- Supporting data and code for Two Transit-like Signals in TESS Photometry of the Nearby K Dwarf TIC 4206066 — 解析を裏づけるデータとコード、2026年9月25日公開(参照日:2026年10月9日)
- A Pre-registered TESS Sector 110 Test of Two Transit-like Signals in TIC 4206066 — 事前登録、2026年10月6日公開(参照日:2026年10月9日)
- Director’s Discretionary Targets — TESS Science Office、Program 100の登録(参照日:2026年10月9日)
- Observation Sector 110 — TESS Science Office、観測予定(参照日:2026年10月9日)
- Exoplanets: Confirmed vs. Candidate — NASA Science、候補と確認済み惑星の区別(参照日:2026年10月9日)
- 10 Steps to Confirm a Planet Around Another Star — NASA Science、確認までの検査(参照日:2026年10月9日)
- ExoFOP-TESS: TIC 4206066 — ExoFOPの対象別カタログ状態(参照日:2026年10月9日)
- Best practices for Claude Code — Anthropic、検証条件と新しい文脈でのレビュー(参照日:2026年10月9日)
- Claude Code Security — Anthropic、権限とsandboxの公式文書(参照日:2026年10月9日)
- Hacker News discussion — コミュニティの反応としてのみ参照(参照日:2026年10月9日)
惑星候補と業務適用でよくある質問
本当に新しい惑星が発見されたのですか?
2026年10月9日時点では、確認済み惑星ではありません。著者がTESSデータから未報告とみられるトランジット様信号を報告した段階で、プレプリント自身も統計的な妥当性確認を主張していません。安全な表現は「未確認の惑星候補が報告された」です。
NASAはこの候補を認めたのですか?
TESS公式DDT一覧でProgram 100がactiveであることは確認できます。ただし、これは追加観測の対象になったことを示すもので、NASAが惑星の存在を確認した、発見者を認定した、査読した、という意味ではありません。
Sector 110で予測どおり信号が出れば確定ですか?
確定ではありません。事前登録自身が、信号の回復は周期的な減光の独立再現を強める一方、未解像の伴星など別の説明も同じ予測を満たし得ると明記しています。高解像度撮像や視線速度観測など、追加の確認が必要です。
Claude Codeだけで同じ研究を再現できますか?
公開されたコードと資料は再確認の入口になりますが、「Claude Codeへ同じ質問をすれば再現できる」という種類の作業ではありません。TESSデータ、天文学の前提、環境固定、解析コード、偽陽性検査、独立レビューが必要です。本稿では公開物の存在と記載内容を確認しましたが、全計算の独立再実行までは行っていません。
企業で最初に試すなら何を選ぶべきですか?
正解データを用意でき、誤りを検出しやすく、誤作動しても顧客や本番データへ直接影響しない1タスクが適しています。狭い分類、抽出、照合などから始め、合格条件より先に停止条件と保留条件を書いてください。
複数エージェントを置けば独立監査になりますか?
同じ入力、同じ説明、同じ権限、同じ評価観点を与えただけでは、独立性は限定的です。作成役の推論を渡さない、元データを読み取り専用にする、既知正解や未見データを使う、決定的な判定は人間が確認する、といった分離が必要です。
結論
「I think I found a planet nobody knew existed. I used Claude Code to find it」の価値は、Claude Codeが惑星の存在を宣言したことではありません。投稿者は、人間が問いと合否を決め、エージェントに反復分析を担わせ、別セッションで監査したと説明しています。外部から確認できる重要な成果は、未来データを見る前に予測と判定条件をZenodoへ公開し、結果が外れる可能性を残したことです。
日本企業が再現すべきなのも、この検証の形です。エージェントの出力は候補として受け取り、既知正解で誤りを探し、未見データで確かめ、実行役・監査役・承認者の権限を分けます。そして、成功だけでなく矛盾、除外、情報不足を正式な結果として残します。AIが答えを速く作れるほど、「何なら間違いと判定するか」を人間が先に定義する価値は高まります。
この記事はAIgent Lab編集部がお届けしました。
AIエージェントの候補出力を、監査可能な業務フローへ落とし込みたい方へ
Uravationでは、権限分離、評価設計、人間承認を含むAIエージェント導入の研修・コンサルティングを行っています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)