2026年10月15日時点の直答:よくある誤解は、「Linus TorvaldsがClaude CodeにLinuxカーネルを丸ごと書かせ、性能を3倍にして採用を決めた」という理解です。確認できた事実は異なります。Torvalds氏は、ページキャッシュの特定の競合を減らす実験的な変更を別ブランチで公開し、そのコード、テストプログラム、既知問題の洗い出し、説明文の初稿をClaude Codeが本人の指揮下で支援したと記しました。限定条件では大幅な改善が出た一方、悪化した条件と未解決点も明記されており、メインライン採用済みではありません。
2026年10月11日、Phoronixは「Linus Torvalds Working On A Hefty Linux Kernel Improvement With Claude Code」と報じました。見出しだけを見ると、AIが熟練エンジニアを置き換え、Linuxの中核機能を完成させたようにも読めます。しかし、公開されたコミット説明を読むと、むしろ重要なのは逆の部分です。人間が問題を定義し、AIの担当範囲を開示し、実機で測り、都合の悪い結果と未解決点を並べ、採否をレビューに委ねています。
日本企業のAIエージェント運用者が持ち帰るべきものは、著名開発者の名前でも「3倍」という数字でもありません。成果物を信用する前に、変更の状態、測定条件、反証テスト、権限境界、既知の問題、人間の責任者を一つずつ確認できる形にすることです。ここから、公開物の中身と企業で再現できる検証手順を分けて見ていきます。
まず誤解を解く:公開は「完成」でも「採用」でもない
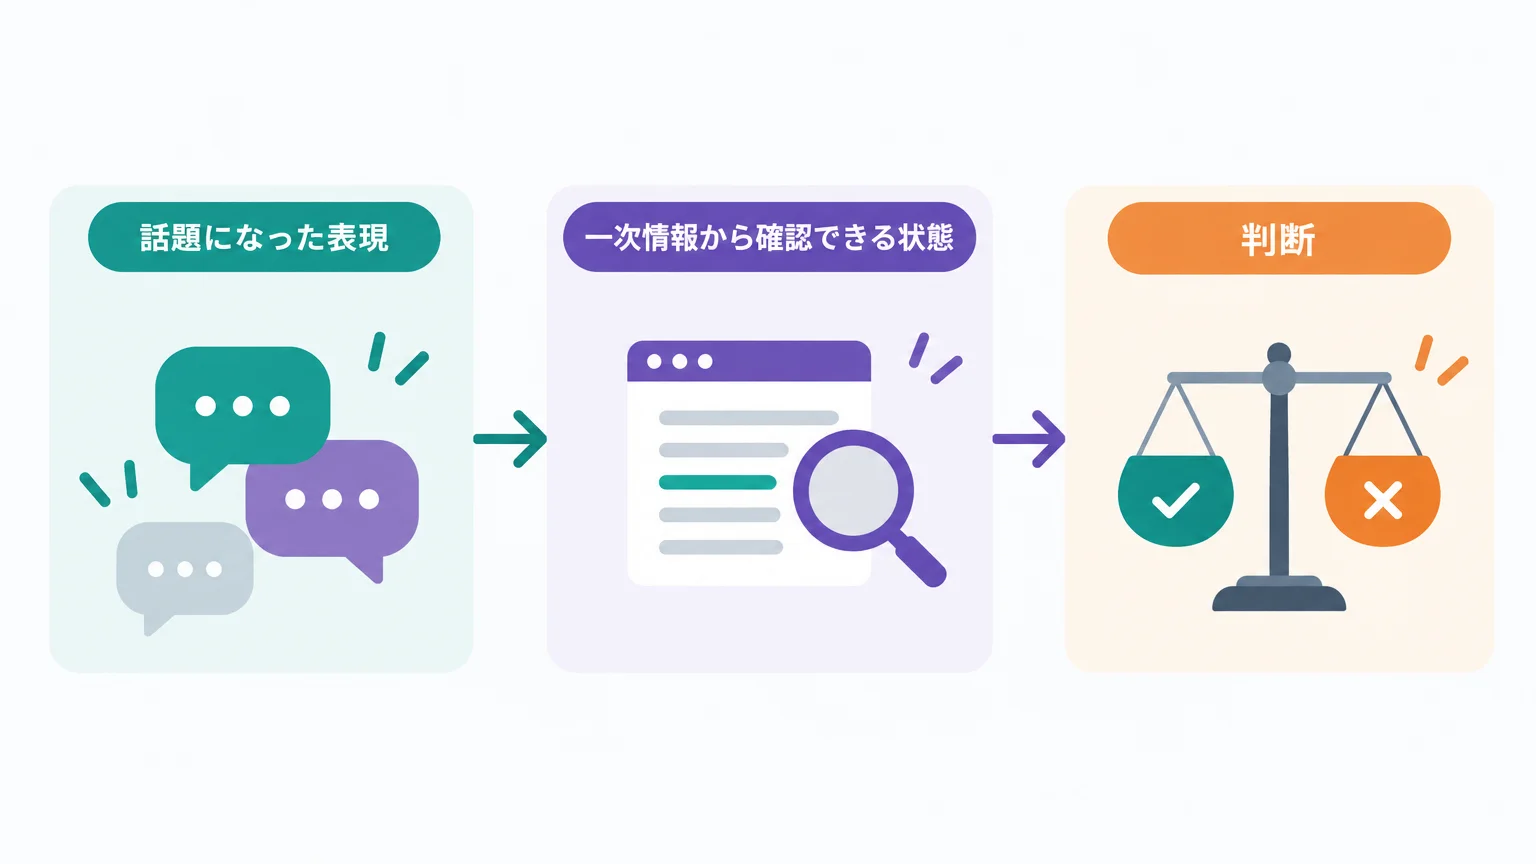
今回公開されたのは、Torvalds氏のLinuxリポジトリにあるnoref-filemap-read-with-llmという別ブランチです。2026年10月15日に公開参照を確認すると、通常の開発本線であるmasterと当該ブランチは異なるコミットを指し、当該変更は本線との差分として残っていました。したがって、「Linuxに搭載された」「Linux 7.4への採用が決まった」とは言えません。
| 話題になった表現 | 一次情報から確認できる状態 | 判断 |
|---|---|---|
| Claude CodeがLinuxを書いた | 特定の実験ブランチで、本人の指揮下においてコードなど複数工程を支援 | 自律開発と表現しない |
| Linuxが3倍高速化した | 1台のノートPC上の限定した読み出し条件で、毎秒読み出し回数が大きく増加 | 一般性能へ拡張しない |
| 高品質なので採用された | 既知の問題を10項目挙げた別ブランチで、2026年10月15日時点では本線との差分 | 未マージとして扱う |
| AIだけで検証した | テスト作成はAI支援を含むが、測定はTorvalds氏のマシンで本人が実施したと説明 | 人間の測定責任を分ける |
この区別は、企業の開発現場でもそのまま使えます。「エージェントが変更案を作った」「隔離環境でテストを通した」「独立レビューを通過した」「本番へ反映した」は別の状態です。状態名を一つにまとめて「完了」と呼ぶと、実験結果がそのまま本番品質の証明に化けます。
公開物は8本のコード変更と1本の説明用コミット
カバーレター用コミットの題名は「ページキャッシュをfolio参照なしで読む」という内容です。対象ブランチにはコードを変更する8本のパッチがあり、その先頭に説明を集約したコード差分のないコミットがあります。土台はLinux 7.3-rc6に修正を加えた状態です。
問題は同じファイルを多くのスレッドが小さく読むときの競合
Linuxのページキャッシュから読み出す既存経路では、読み出し側がfolioの参照を取得し、処理後に解放します。同じファイルへ多数のスレッドが小さな読み出しを繰り返すと、参照カウントが置かれた共有キャッシュラインへの書き込みが競合します。今回の案は、この限定されたボトルネックを狙ったものです。
案の中心はRCU猶予期間が終わるまで再利用を遅らせること
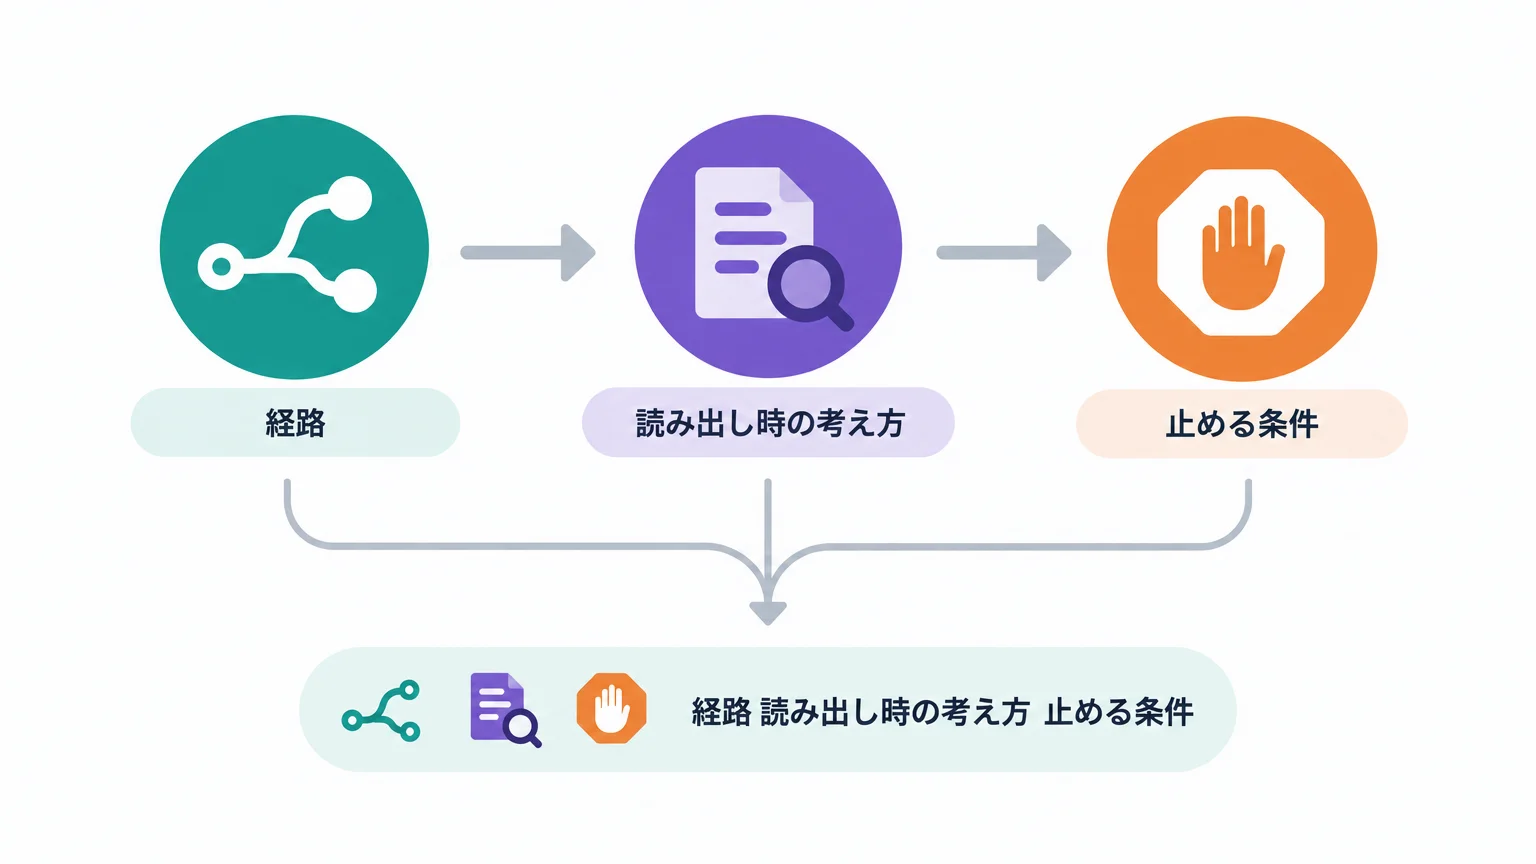
提案では、ページキャッシュからfolioを外しても、すぐページアロケータへ返しません。RCUの猶予期間が終わるまでメモリの再利用を遅らせ、その保護区間では参照を取得せずにデータを読みます。ページが見つからない、最新状態ではない、ユーザーページでフォルトが起きる、EOFへ達する、といった条件では既存経路へ戻ります。
| 経路 | 読み出し時の考え方 | 止める条件 |
|---|---|---|
| 従来経路 | folio参照を取得し、読み出し後に解放する | 既存のカーネル処理に従う |
| 提案する高速経路 | RCU保護中はメモリを再利用させず、folio参照なしで読む | フォルト、欠落、非uptodate、EOF、致命的シグナルなど |
| フォールバック | 高速経路を続けられない位置から既存経路へ戻る | 正しさを優先して高速化を諦める |
ここで大切なのは、Claude Codeが「正解を知っていた」と短絡しないことです。カバーレターは、過去の議論や以前の試み、設計上の反論、測定結果、未解決点を一つの検討材料としてまとめています。AIエージェントに向くのは、こうした広い作業面を横断して候補を作り、テストと説明を同時に更新する役割です。採否を決める役割とは分けて考える必要があります。
性能表が示すのは特定の競合解消である
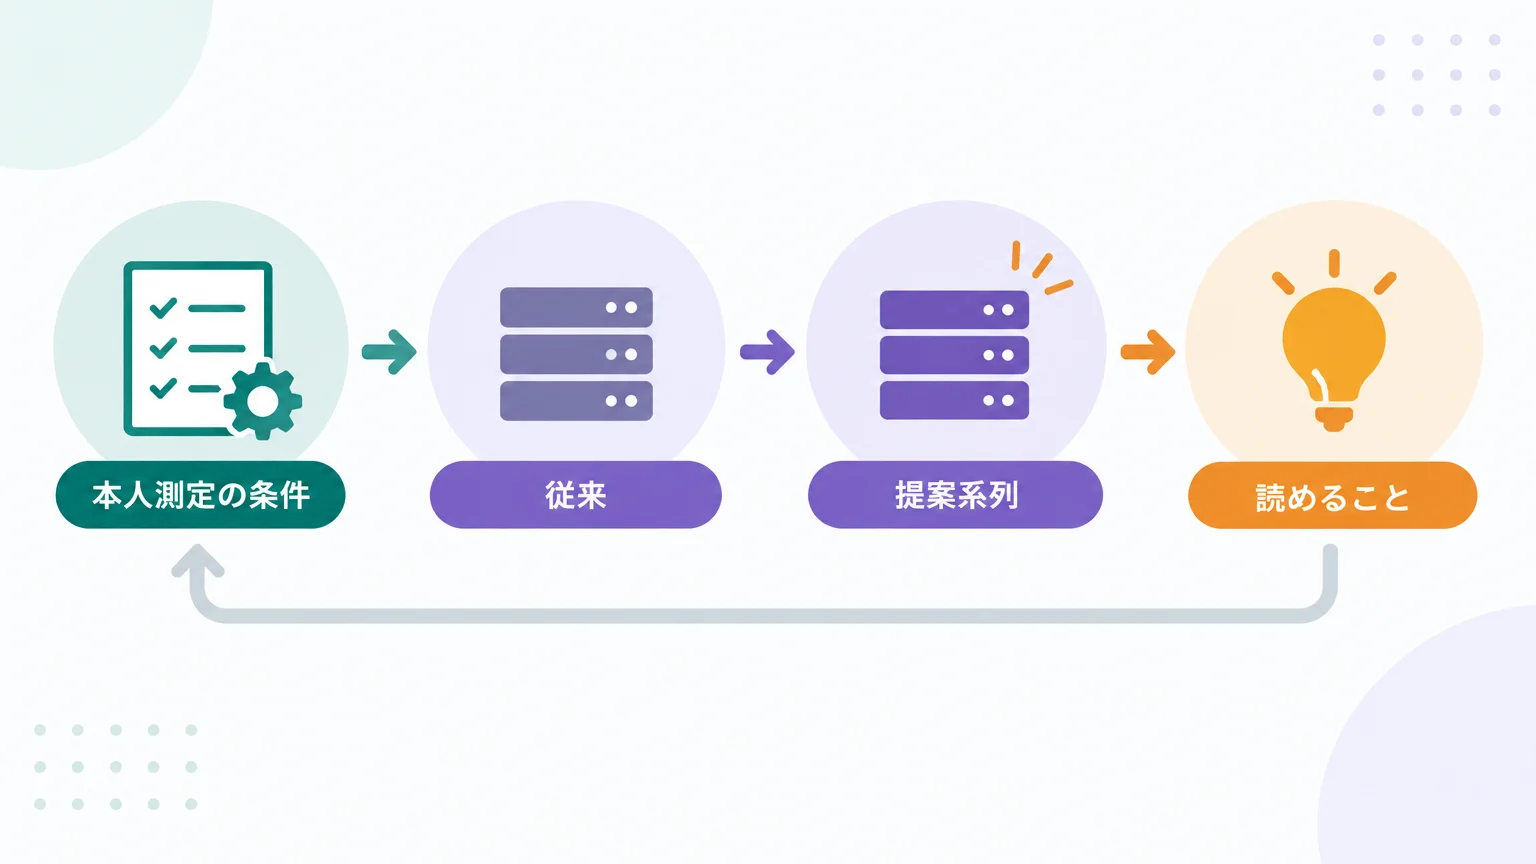
数字は魅力的ですが、まず測定条件を固定しましょう。カバーレターに書かれた環境は、Intel Core i7-8565U、4コア・8スレッドのノートPC、ext4、CPU脆弱性緩和策を無効化、CONFIG_HARDENED_USERCOPYを無効化した構成です。1ページの同一ファイルを、各スレッドが別のファイルディスクリプタから16バイトずつ読む条件でした。Torvalds氏自身、温度でスロットリングするため、毎秒回数より1回あたりのコストを比較すべきだと注意しています。
| 本人測定の条件 | 従来 | 提案系列 | 読めること |
|---|---|---|---|
| 8スレッド、同一ファイル、16バイト | 毎秒990万〜1,040万回 | 毎秒3,000万〜3,300万回 | 共有folio参照カウントの競合が強い条件で改善 |
| 1スレッド、同一ファイル、16バイト | 毎秒790万〜810万回 | 毎秒880万〜890万回 | 単一スレッドでは増加幅が小さい |
| 1スレッド、16バイト、ユーザーページ不在 | 1回あたり4,117〜4,188サイクル | 1回あたり6,543〜6,593サイクル | ページフォルトを伴う条件では悪化 |
したがって、「Linuxのファイル読み出しが3倍になった」とは書けません。より正確には、「同じ小さなファイルを8スレッドで繰り返し読む本人の限定試験で、毎秒読み出し回数が約1,000万回から3,000万〜3,300万回へ増えた」です。しかも、ユーザーページが存在せずフォルトする条件ではサイクル数が増えています。成果だけでなく反例も同じ表に載せる姿勢が、企業の検証報告に必要です。
Claude Codeと人間の担当範囲は明確に分かれていた
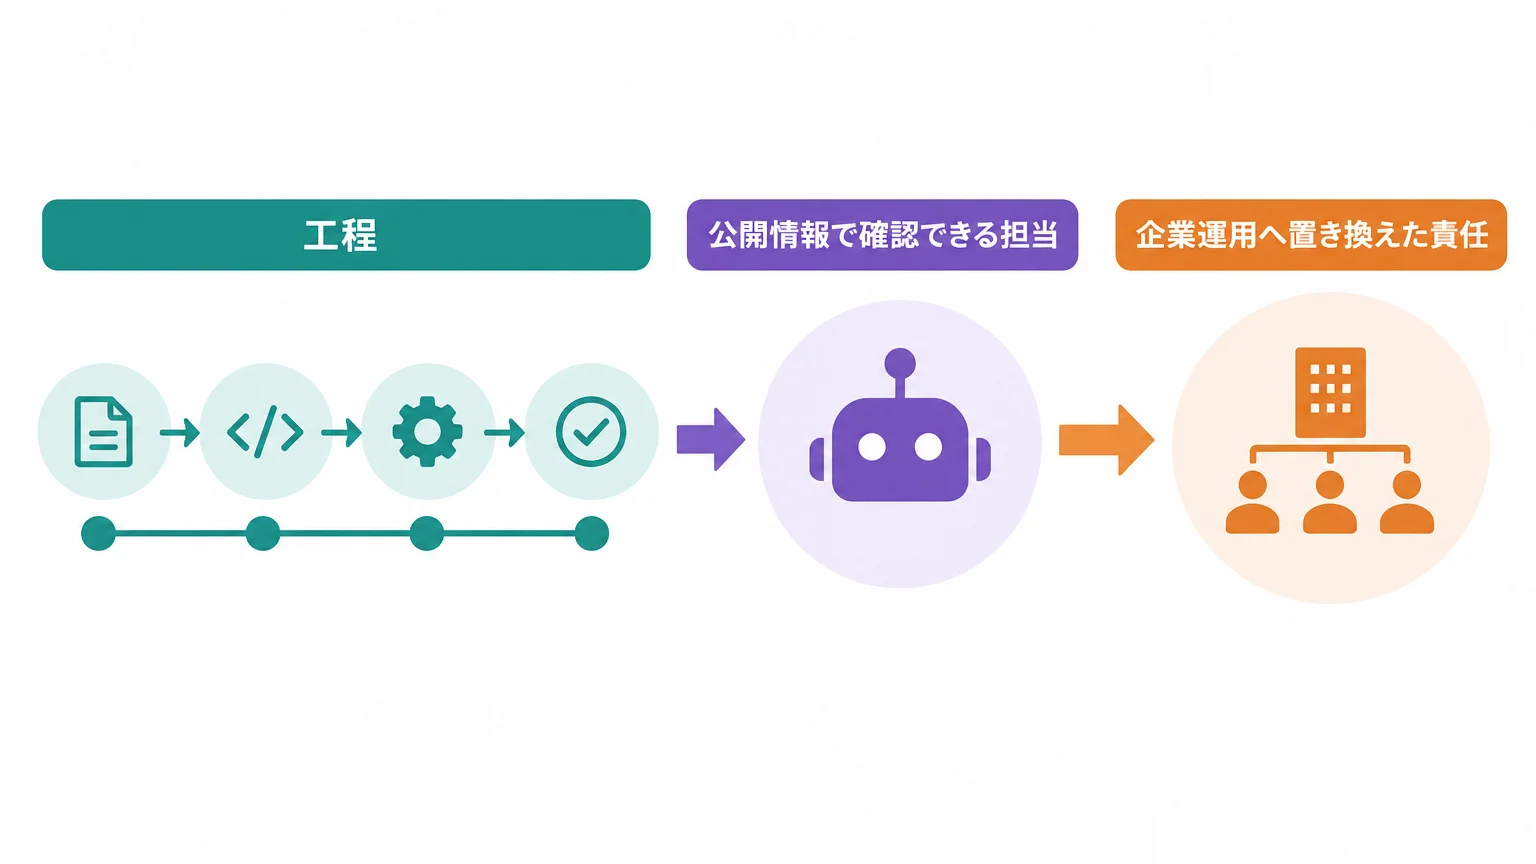
Torvalds氏は、コード、テストプログラム、既知問題リストにつながるレビュー、カバーレター初稿を、Claude Codeが本人の指揮下で支援したと説明しています。一方、測定は本人のマシンで行ったと明記しました。使用モデル、プロンプト、セッション数、作業時間、生成コードの比率、手修正の量は公開情報から確認できません。
| 工程 | 公開情報で確認できる担当 | 企業運用へ置き換えた責任 |
|---|---|---|
| 問題設定と方向づけ | Torvalds氏の指揮 | 技術責任者が目的、対象外、受け入れ基準を決める |
| コードとテストの作成 | Claude Codeの支援を明示 | エージェントの作業ログと差分を残す |
| 問題点レビューと説明初稿 | Claude Codeの支援を明示 | 生成者とは別のレビュー経路で反証する |
| 測定 | Torvalds氏のマシンで本人が実施 | 環境、入力、比較対象、失敗条件を固定する |
| 採用判断 | 別ブランチで公開し、未解決点を提示 | 承認者が証拠を読み、状態を変更する |
Linux KernelのAI Coding Assistantsガイドも、AIエージェントはSigned-off-byを付けてはならず、人間の投稿者が生成コードをレビューし、ライセンスを確認し、責任を負うと定めています。また、非自明なバグは再現方法を作り、修正をビルドして検証し、できなかったことを明示する流れを求めています。
ツール生成コンテンツのガイドは、利用ツール、入力、影響を受けた部分、テスト方法を透明にし、提出内容を自分で理解して説明できなければ提出しないよう求めています。今回のニュースを「AIの能力証明」だけで読むより、「責任を人間に残した公開方法」として読む方が、企業実務に近いのです。
未解決点を10項目書いたことが最大の実務ヒント
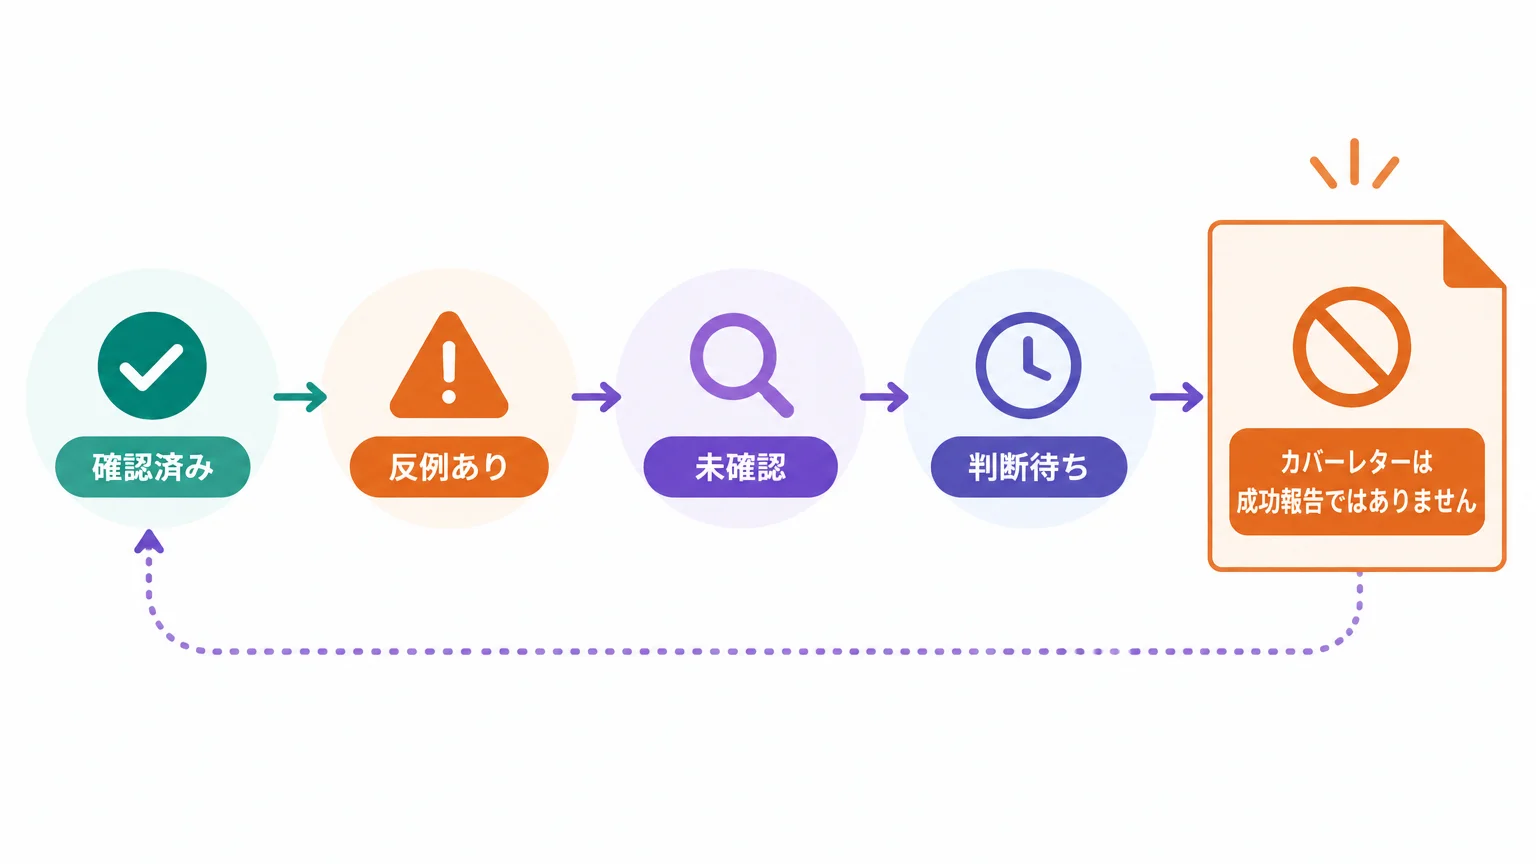
カバーレターは成功報告ではありません。メモリアロケータからRCU待ちのページが見えないこと、連続メモリ確保に回帰があること、待機メモリに上限がないこと、ページフラグの制約、s390との相互作用、読み出し経路以外の未測定コスト、メモリ順序の議論にlitmus testがないこと、監視ツールの見え方が変わること、RCUの緊急処理コスト、スケジューラ変更の方向性などを列挙しています。
試していない条件も具体的です。現行系列に対するxfstests、lockdep、KASAN、clangでリンクしたカーネル、32ビット、CONFIG_HARDENED_USERCOPY、本人のノートPC以外、別のプリエンプション構成などです。限定試験で良い数字が出ても、未試験の領域を空欄にしない。この書き方自体が、AIエージェントの成果物をレビュー可能にします。
日本企業の報告書でも、「確認済み」だけを並べるより、次の4区分を固定した方が安全です。
- 確認済み:再現手順と証拠があり、誰が実行したか分かる
- 反例あり:改善しなかった条件や悪化した条件を記録する
- 未確認:試していない環境、データ、例外系を列挙する
- 判断待ち:証拠はあるが、責任者の採用判断を終えていない
日本企業に関係するのはモデル名より検証可能性
成果物の量ではなく、受け入れ条件に対する証拠を見る
変更行数、生成ファイル数、エージェントの稼働時間は、仕事の量を示しても成果を証明しません。今回も価値の中心は8本という本数ではなく、狙った競合条件で差が出たこと、悪化条件を示したこと、未解決点が追跡できることです。AIコーディングの評価指標を考える際は、関連記事「AI coding agentsでコード量30%増、成果は?」で整理したように、コード量と利用者価値を分けてください。
モデル単体でなく、指示・実行環境・テストを一つの系として見る
熟練者が明確な問題を渡し、リポジトリの履歴と議論を参照させ、試験を作らせ、結果を本人が読む。この全体が成果を生みます。エージェントが賢いかどうかだけで説明すると、再現に必要なハーネスが抜け落ちます。「Why are coding agents so dumb? 論点はハーネス」も、モデル以外の設計を見るための補助線になります。
公開・提案・採用・本番を別の状態として管理する
ニュース記事で最も混同されやすいのが状態です。実験ブランチにあるものを「実装済み」、テストが通ったものを「本番可能」、レビュー依頼を「採用決定」と呼ばないでください。最低でも「案」「隔離環境で検証済み」「独立レビュー済み」「承認待ち」「本番反映済み」を分け、状態を変えた人と根拠を残します。
権限はプロンプトではなく実行基盤で狭める
Claude Codeの公式権限ドキュメントでは、allow・ask・denyのルールやPlan、Manualなどのモードが説明され、権限ルールはモデルではなくClaude Code側で強制されると明記されています。重要なリポジトリでは、読み取り調査、編集、コマンド実行、ネットワーク、本番変更を同じ権限にしないことが基本です。隔離の考え方は「AIエージェント サンドボックス設計」も参考になります。
導入は日数計画ではなく5つの検証ゲートで始める
今回の事例を企業でまねるなら、最初から大規模な自律開発へ進む必要はありません。期間で区切るより、証拠がそろうまで次へ進まないゲート式が向いています。対象は、再現可能な不具合修正、遅い処理の改善、既存テストがあるリファクタリングなど、良否を機械判定しやすい一件に絞ります。
| ゲート | 必要な証拠 | 通過できない例 |
|---|---|---|
| 1. 問題固定 | 再現入力、現状値、変更対象、対象外 | 「性能を上げる」だけで測定方法がない |
| 2. 権限制限 | 隔離ブランチ、許可ツール、禁止操作、秘密情報の除外 | 本番資格情報へ到達できる |
| 3. 生成と自己検証 | 差分、テスト、実行ログ、既知の問題 | 成功要約だけで生ログがない |
| 4. 独立反証 | 別担当レビュー、負荷・例外・回帰試験、悪化条件 | 生成したエージェントだけが採点する |
| 5. 人間の承認 | 採否、承認者、ロールバック条件、状態変更記録 | テスト成功だけで自動反映する |
最初の依頼は一枚の検証仕様にする
エージェントへ渡す依頼は、長い理想像より、合否が分かる一枚の仕様が有効です。次の形なら、成功条件と停止条件を同時に渡せます。
対象: 再現できる問題を1件だけ扱う
現状: 再現手順、比較値、対象コミットを示す
変更範囲: 編集してよいファイルと禁止領域を列挙する
受け入れ条件: 通すテストと改善を判断する指標を示す
反証条件: 例外系、負荷条件、悪化を疑う条件を示す
出力: 差分、実行ログ、未確認事項、既知の問題を分ける
停止: 権限不足、再現不能、根拠不足なら変更せず報告する
不足している情報があれば、最初に質問してから作業を開始してください。
数字と固有名詞は、根拠(出典または計算式)を添えてください。

注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。Anthropicの「Claude Code Best Practices」も、テスト、ビルド、差分、スクリーンショットなど、エージェント自身が読める合否判定を与えることを推奨しています。また、探索・計画・実装を分け、証拠を示させる考え方を紹介しています。Claude Codeの実務的な指示方法は「Opus 5.5使いこなし|Claude Code公式7策」も併せて確認してください。
見落とすと危ない4つの運用ミス
失敗1:最も良い数字だけを一般性能として発表する
❌「AIでLinuxが3倍高速化した」と、条件を外して説明する。
⭕「1台の特定構成で、同一ファイルへの8スレッド・16バイト読み出しに改善があり、ページフォルト条件では悪化した」と、改善と反例を同じ場所に書く。
なぜ重要か:最良ケースだけでは、業務負荷に適合するか判断できません。比較対象、入力、環境、除外条件がそろって初めて数字を再利用できます。
失敗2:テストを作ったエージェントに最終判定まで任せる
❌ 生成したテストが通ったため、そのまま「検証済み」にする。
⭕ 独立した担当者が、テストが仕様の弱点を見逃していないか、変更前に失敗して変更後に成功するか、例外系と回帰を含むかを確認する。
なぜ重要か:実装と採点基準を同じ主体が作ると、都合の良いテストだけで閉じる可能性があります。新しいレビュー文脈から反証する工程が必要です。
失敗3:未確認事項を空欄のまま本番へ進める
❌ テストしていない構成を「問題なし」とみなし、既知の問題を書かない。
⭕ 未確認のOS、アーキテクチャ、権限、負荷、監視への影響を一覧化し、対象外として承認するか追加検証する。
なぜ重要か:今回のカバーレターは、未実施の試験や未測定コストまで列挙しました。空欄は合格ではなく、判断材料がない状態です。
失敗4:便利さを理由にエージェントへ広すぎる権限を渡す
❌ 開発、外部通信、本番反映、秘密情報へのアクセスを一つのセッションにまとめる。
⭕ 調査は読み取り専用、変更は隔離環境、外部送信と本番反映は別承認にし、denyルールとサンドボックスで止める。
なぜ重要か:指示文は行動の希望であり、強制力のある境界ではありません。権限設定、ネットワーク制限、資格情報の分離を実行基盤で担保してください。
コミュニティの反応はモデルより「誰が指揮するか」に向いた
Hacker Newsの対象スレッドは、2026年10月15日の確認時点でトップレベルコメントが2件と少数でした。一つは、Claude CodeがGit設定などから相手をTorvalds氏だと認識したのかという好奇心、もう一つは、人間の協働者を率いてきた経験がAIエージェントの指揮にも生きるのではないかという個人の見立てです。
これは性能評価でも、コミュニティ全体の総意でもありません。ただ、反応が「どのモデルが勝ったか」ではなく、「誰がどの文脈を与え、どう指揮したか」に向いた点は興味深いものです。企業が再現できるのも、著名開発者の勘そのものではなく、問題設定、権限、検証、レビュー、状態管理という観察可能な部分です。
よくある質問
Linus TorvaldsのClaude Code支援パッチはLinux本体へマージ済みですか?
2026年10月15日時点で、対象コミットはnoref-filemap-read-with-llmという別ブランチにあり、masterとの差分として確認できます。Linux本体へ採用済み、またはLinux 7.4への採用決定とは確認できません。
Claude CodeがLinuxカーネルの改善を単独で作ったのですか?
いいえ。公開説明は、コード、テストプログラム、既知問題につながるレビュー、説明初稿をClaude Codeが「Torvalds氏の指揮下」で支援したとしています。問題設定、方向づけ、本人マシンでの測定、最終責任をAI単独の仕事として扱う根拠はありません。
「3倍高速化」は正しいですか?
限定付きなら近い表現ですが、一般化は不正確です。本人の1台のノートPCで、同一ファイルを8スレッドが16バイトずつ読む条件では、毎秒約1,000万回から3,000万〜3,300万回へ増えました。一方、ページフォルトを伴う条件では悪化例があります。Linux全体の速度を示す数字ではありません。
日本企業も同じようにAIエージェントへ大きな改修を任せるべきですか?
最初から大きな改修を任せる必要はありません。再現可能な一つの問題を選び、隔離環境、限定権限、合否テスト、独立レビュー、承認者を用意してください。証拠がそろったときだけ状態を進める方法が安全です。
検証記録には何を残せばよいですか?
対象コミット、依頼範囲、許可したツール、生成差分、実行したテスト、計測条件、生ログ、改善しなかった条件、既知の問題、未確認範囲、レビュー担当、承認者、ロールバック条件を残します。「エージェントが成功と報告した」という文章だけでは証拠になりません。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Linus Torvalds Working On A Hefty Linux Kernel Improvement With Claude Code — Phoronix、2026年10月11日公開(参照日:2026年10月15日)
- mm: read from the page cache without folio references — Linux kernel Git、2026年10月10日(参照日:2026年10月15日)
- noref-filemap-read-with-llm branch log — Linux kernel Git(参照日:2026年10月15日)
- masterと対象ブランチの差分コミット一覧 — Linux kernel Git mirror(参照日:2026年10月15日)
- AI Coding Assistants — The Linux Kernel documentation(参照日:2026年10月15日)
- Kernel Guidelines for Tool-Generated Content — The Linux Kernel documentation(参照日:2026年10月15日)
- Best practices for Claude Code — Anthropic公式ドキュメント(参照日:2026年10月15日)
- Configure permissions — Anthropic公式ドキュメント(参照日:2026年10月15日)
- Hacker News discussion — コミュニティの反応としてのみ参照(参照日:2026年10月15日)
結論
Linus Torvalds氏とClaude Codeの事例が示したのは、AIが人間を不要にしたことではありません。難しい変更でも、問題を狭く定義し、AIにコード・テスト・レビュー材料・説明を横断させ、人間が実機で測り、悪化条件と未解決点を公開し、採用前の状態に留められるということです。
企業で始めるなら、まず再現可能な問題を一件選び、読み取りと変更の権限を分け、合否テストと反証条件を先に決めてください。差分、ログ、既知の問題、未確認範囲がそろった後に、別担当がレビューし、人間の責任者が状態を変えます。この順序なら、モデルの話題性に依存せず、AIエージェントを検証可能な開発工程へ組み込めます。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
この記事はAIgent Lab編集部がお届けしました。