AIエージェント運用で先に整えるべきものは3つです。短い入口文書、現在有効な仕様、そして文書どおりに動いたかを確かめるテストです。
「Agents don’t need memory, they need documentation」への実務上の答えは、メモリをすべて捨てることではありません。会話履歴から自動抽出した断片を、組織の正式な仕様や判断の代わりにしないことです。2026年10月5日時点では、レビュー済みの知識は版管理できる文書へ、個人の好みや作業中の気づきはメモリへ、実行履歴はログへ分けるのが安全です。
2026年10月3日、Kevin Liao氏はAgents Don’t Need Memory. They Need Documentation.を公開しました。翌10月4日未明(JST)にHacker Newsへ投稿され、2026年10月5日16時49分の確認時点で362ポイント、256コメントに達しています。スコアは時点によって変動するため、以下では確認時刻を固定して扱います。
見出しは強烈ですが、論点は「記憶か、文書か」という二者択一ではありません。現在のプロジェクト状態を伝える情報を、類似検索で偶然見つかる断片の集合に任せるのか、それとも人が読めて更新履歴も追える文書にするのか。日本企業の現場で重要なのは、この管理責任の違いです。
なお、元記事には文書方式と既存メモリ方式を比べたA/Bテスト結果は掲載されていません。提案としての鋭さと、実証済みの効果は分けて読む必要があります。
10月3日の記事で公開された考え方
Liao氏が問題視したのは、セッション記録から短い「記憶」を作り、埋め込み検索で似た断片を毎回のプロンプトへ差し込む運用です。同氏はこれを典型的なメモリープラグインの構成として例示し、過去の会話をうまく思い出すことと、現在のプロジェクトを正しく理解することは別だと主張しました。
| 確認項目 | 一次ソースで確認できた内容 | 読み手が留保すべき点 |
|---|---|---|
| 公開日 | 2026年10月3日 | 記事の公開日であり、製品カテゴリ全体の評価日ではない |
| 中心命題 | 想起中心のメモリより、読み書きできる文書ワークスペースを重視する | 「すべてのメモリが不要」は筆者の強い意見 |
| 運用ループ | 作業前に確認し、構築し、作業後に文書を更新する | 更新を忘れない保証は別途必要 |
| 実装例 | Operator Memoryというオープンソース実装 | リポジトリは開発中と明記されている |
| 比較実験 | 記事内に他方式との定量比較はない | 自社環境での評価が必要 |
会話の保存ではなく、プロジェクトの現在地を残す
提案されているループは「prompt → consult → build → update」です。作業前に索引や仕様を確認し、作業を終えたら古くなった説明を直す。ここで保存する対象は、会話の全文ではなく、指示、仕様、意思決定、調査結果、索引など、次の担当者や次のセッションでも使う情報です。
この違いは小さくありません。会議で「認証方式はA案からB案へ変えた」と決まったとき、古いA案の発言も新しいB案の発言も履歴には残ります。一方、現行仕様の文書はB案へ更新し、A案は変更理由をたどる証跡として別に残せます。エージェントが今従うべき情報と、調査のために参照する過去を分離できるわけです。
Operator MemoryはMarkdownの「頭脳」を置く
Operator Memory公式リポジトリは、仕様、意思決定、標準、調査、教訓をMarkdown文書として保存すると説明しています。プロジェクト内の非共有領域、リポジトリと共有する領域、個人の横断知識を分け、Consult、Build、Updateの順に回す設計です。
ただし「Markdownなら自動的に正しくなる」わけではありません。公式READMEは開発中であることを明記し、長い会話の途中でも確実に文書を更新する機能をロードマップに置いています。公式アーキテクチャ文書も、上流の大きな変更や更新忘れによって文書が古くなり得ると認めています。強みは腐敗しないことではなく、腐敗を人が見つけ、差分として直せることです。
筆者が挙げた5つの問題を実務に訳す
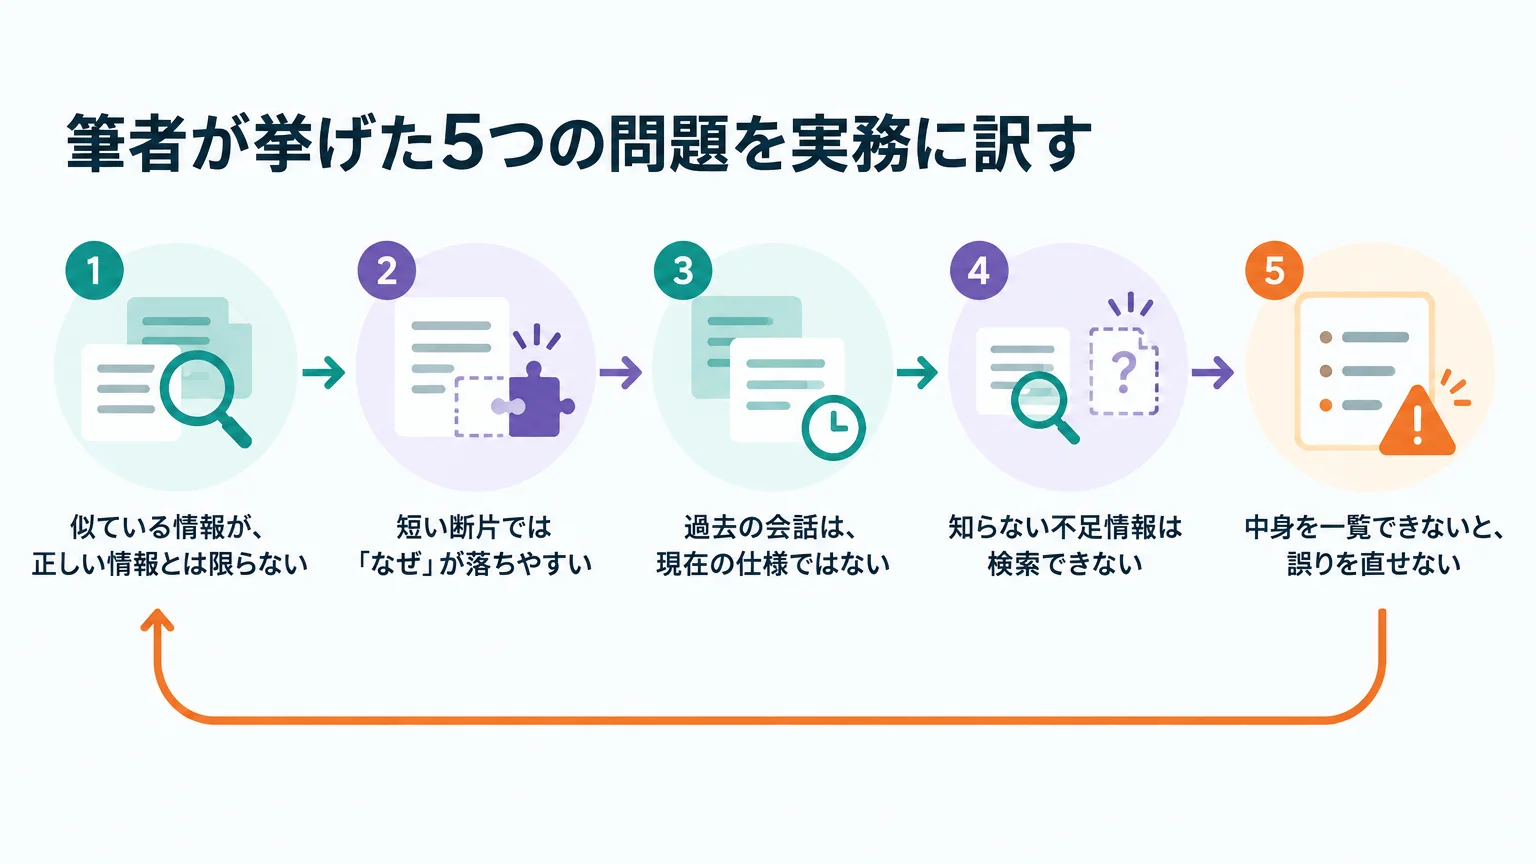
元記事が列挙する問題は、メモリー製品への一律な判定ではなく、類似検索した断片を無批判に「現在の知識」として扱う設計への警告として読むと有用です。
似ている情報が、正しい情報とは限らない
埋め込み検索は、質問に意味的に近い候補を探すための仕組みです。候補が承認済みか、最新版か、必要な情報が欠けていないかまでは自動的に保証しません。旧料金表と新料金表が両方残っていれば、どちらも検索対象になります。検索精度の問題に見えて、実際には状態管理の問題です。
短い断片では「なぜ」が落ちやすい
「外部送信には承認が必要」という一文だけでは、対象、例外、承認者、監査方法が分かりません。背景を切り落とした断片は扱いやすい半面、意思決定の条件を失いやすくなります。文書なら、ルール本体、適用範囲、理由、確認手順を同じ単位で管理できます。
過去の会話は、現在の仕様ではない
会話履歴には、検討中の案、撤回された案、誤解、途中の数字が混在します。履歴は「当時何が話されたか」を調べる証跡として価値がありますが、「いま何を実行すべきか」を決める元ファイルには向きません。現在有効な判断だけを集めた文書へ昇格させる工程が必要です。
知らない不足情報は検索できない
エージェントが検索ツールを持っていても、必要な文書や制約の存在を知らなければ検索語を作れません。そこで短い入口文書が効きます。どの種類の作業で、どの仕様、運用手順、テストを読むかを案内すれば、探索の起点を固定できます。
中身を一覧できないと、誤りを直せない
保存件数が増えても、古い記憶、矛盾する記憶、一度も使われない記憶が見えなければ手入れできません。普通のファイルは、検索、差分確認、レビュー、所有者設定、アーカイブがしやすい。ここが文書方式の実務的な利点です。
もっとも、RAG自体が悪いわけではありません。大量の規程、マニュアル、議事録から関連候補を探す用途では検索が必要です。詳しい仕組みはRAGとは|仕組み・作り方・精度を上げる順番【2026年9月】で確認できます。今回の論点は、検索結果を現行仕様と同一視しないことにあります。
「文書かメモリか」ではなく用途を分ける
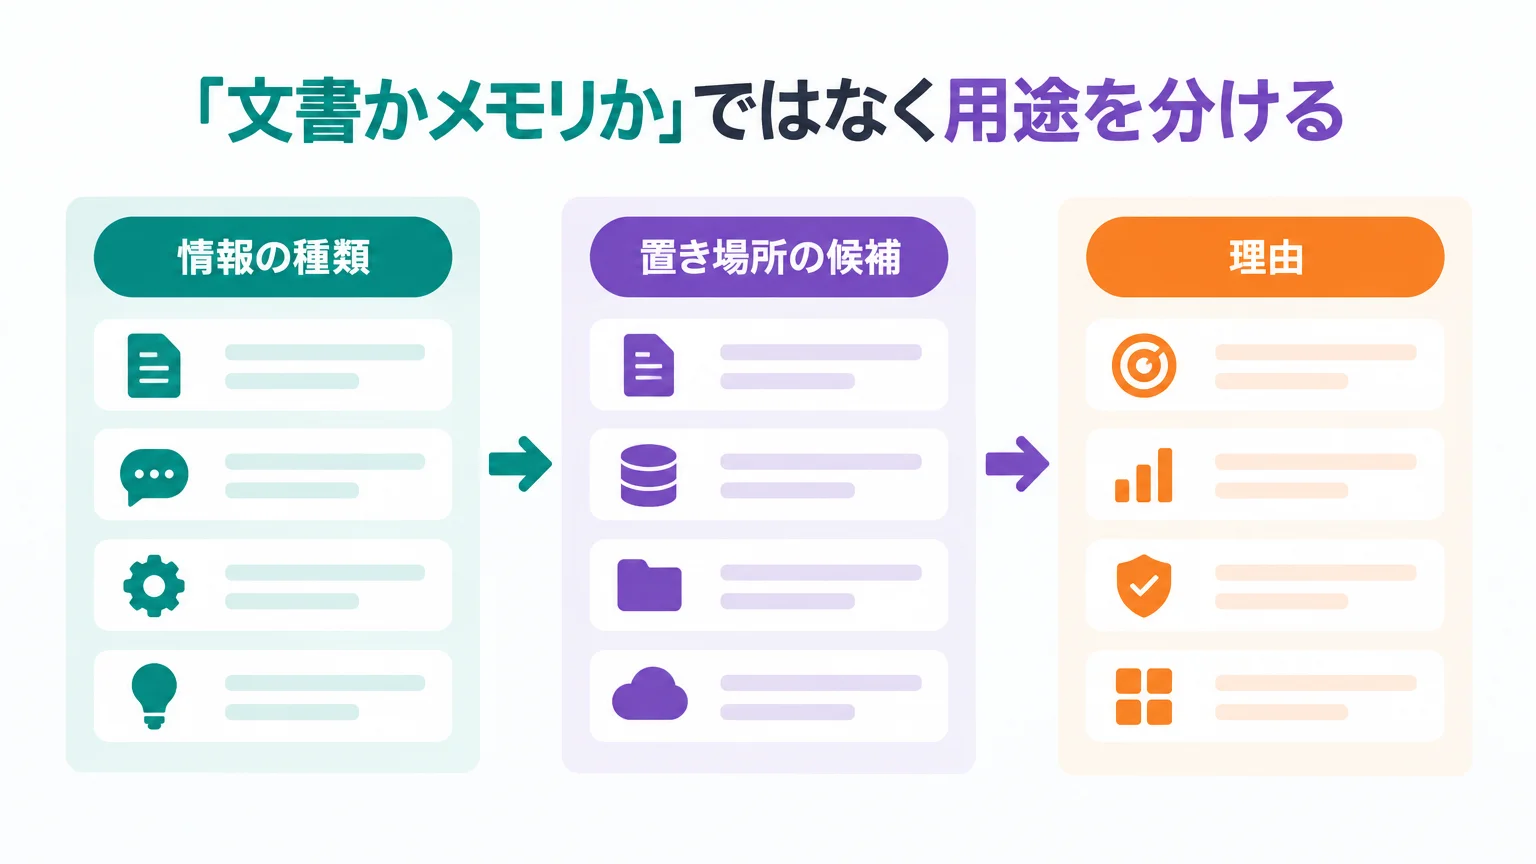
公式情報を見ると、主要な開発ツールも二者択一を採っていません。2026年9月30日付のVS Code公式のエージェントメモリ文書は、個人の好み、作業中の文脈、まだチームレビューされていない知識をローカルメモリへ置く一方、レビュー済みのアーキテクチャ判断、コマンド、規約、ワークフローは版管理された文書へ移すよう案内しています。
AnthropicのClaude Code公式文書も、利用者が書くCLAUDE.mdまたはAGENTS.mdと、Claudeが書くauto memoryを補完関係として説明しています。つまり、安定した組織ルールと、セッションから得た学びは同じ棚に置かない設計です。
| 情報の種類 | 置き場所の候補 | 理由 |
|---|---|---|
| 現在有効な仕様・禁止事項 | 版管理された文書と強制ルール | 承認、差分、適用範囲を確認できる |
| 個人の表示・説明の好み | ユーザーメモリ | 他の担当者へ強制する必要がない |
| 作業中の仮説・未完了メモ | セッションメモリ | 確定前の情報を正式仕様へ混ぜない |
| 大量の参考資料 | 検索基盤またはRAG | 必要な候補を絞って読む |
| 実行結果・失敗の証跡 | ログ、トレース、チケット | 事後検証と原因調査に使う |
| 繰り返し使う作業手順 | スキルまたは運用手順書 | 必要な場面だけ読み込み、検証手順も含められる |
エージェントの短期・長期・エピソード記憶そのものを設計したい場合は、既刊のAIエージェントのメモリ設計|Short/Long/Episodic実装ガイドが補助線になります。そこにある「何を保持するか」という設計と、今回の「何を組織の正式な知識にするか」という設計は両立します。
日本企業では「現在の判断」と「履歴」を分ける
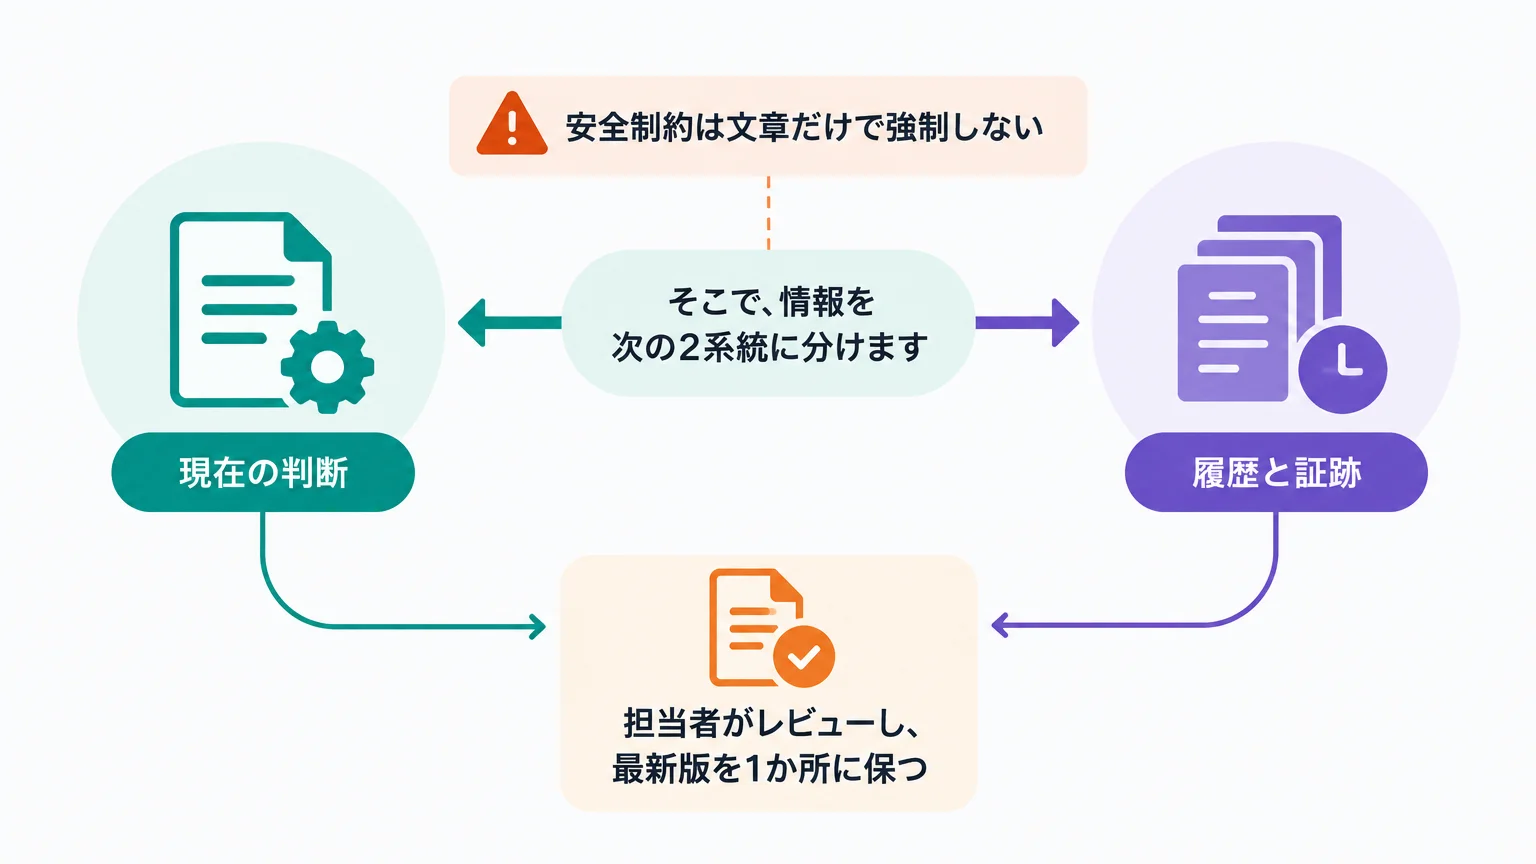
国内企業でこの議論が重要なのは、AIエージェントの知識がコードだけに閉じないからです。顧客との合意、法務確認、運用当番、障害時の連絡順、使用禁止データ、承認が必要な操作は、会議、メール、チャット、チケットに散らばりやすい情報です。
散らばった履歴を全部検索対象にすると、発見はできても「どれが正式版か」が残ります。そこで、情報を次の2系統に分けます。
- 現在の判断:エージェントが作業時に従う仕様、手順、制約。担当者がレビューし、最新版を1か所に保つ。
- 履歴と証跡:会議、チャット、旧版、ログ、トレース。判断の背景や事故原因を調べるときに検索する。
「記憶を文書へ変える」とは、履歴を消すことではありません。再利用する価値がある内容を、現在の判断へ昇格させることです。昇格時に、出典、確認者、適用範囲、最終確認日、失効条件を付ければ、後から正しさを点検できます。
安全制約は文章だけで強制しない
ここは特に重要です。Anthropic公式文書は、CLAUDE.mdなどの指示を強制設定ではなくコンテキストとして位置づけています。OpenAIのHarness engineeringも、文書だけでは一貫性を保てないため、リンターや構造テストで制約を機械的に適用したと説明しています。
外部送信の承認、個人情報の持ち出し禁止、本番変更の権限制御などは、文書に書くだけでなく、権限設定、フック、承認ゲート、テストで止める必要があります。文書は判断を伝え、仕組みは逸脱を止める。この役割分担があって初めて、監査可能な運用になります。
実行履歴の残し方はAIエージェントの監査ログ設計|記録すべき7要素【2026】も参考になります。文書の変更履歴と、エージェントの実行ログは別々に残し、必要なときに突合できるようにしてください。
最小構成は入口・現行文書・検証ルール
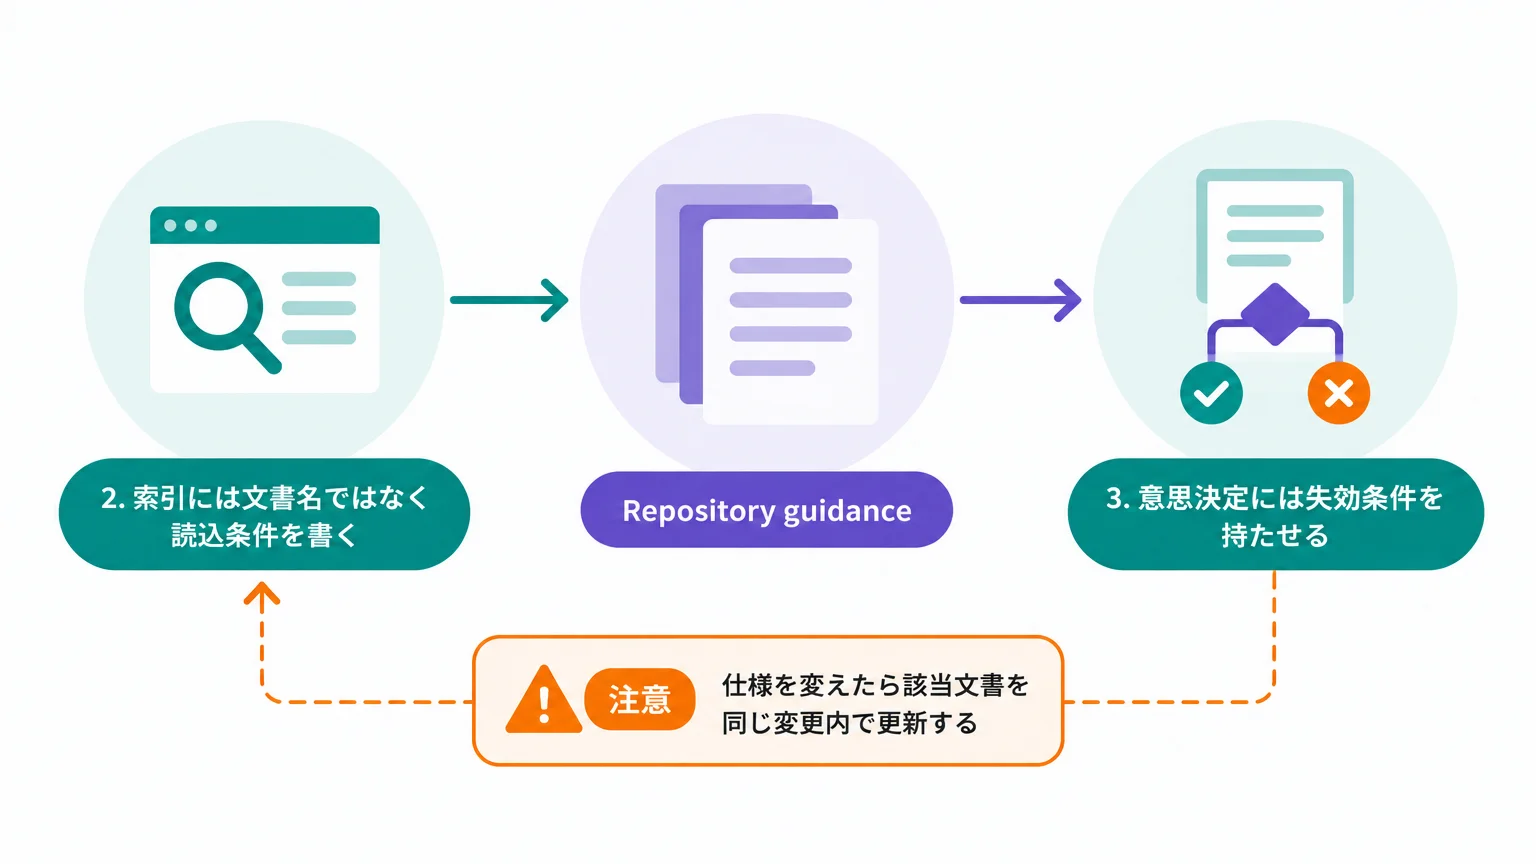
文書を増やすこと自体を目的にすると、すぐに別の問題が生まれます。OpenAIの指示設計に関する公式記事は、すべての編集前に文書一式を読ませる指示はコンテキストを消費し、作業を遅くすると注意しています。必要なのは百科事典ではなく、必要な情報へ迷わず着ける案内図です。
1. 入口文書は「何を、いつ読むか」だけに絞る
AGENTS.mdやCLAUDE.mdには、全仕様を貼り付けず、作業種別と参照先を置きます。以下は構成例であり、特定製品の必須形式ではありません。
# Repository guidance

- サービス境界を変更するときは docs/architecture.md を読む
- 顧客向け出力を変更するときは docs/policies/customer-output.md を読む
- 本番操作の前は docs/runbooks/release.md と承認条件を確認する
- 仕様を変えたら該当文書を同じ変更内で更新するCodexでのAGENTS.mdの探索順や階層化は、OpenAI公式のAGENTS.mdガイドで確認できます。Claude CodeでAGENTS.mdを使う場合の優先関係は、Claude CodeがAGENTS.md対応|優先順位と設定【2026年9月】も参照してください。
2. 索引には文書名ではなく読込条件を書く
ファイル一覧だけでは、エージェントはどれを開くべきか判断できません。目的、担当、適用範囲、確認日を索引に含めます。
# Documentation index

## architecture.md
- 読む条件: サービス境界、データフロー、依存関係を変えるとき
- 担当: Platform Team
- 適用範囲: src/services/
- 最終確認: 2026-10-05

## release.md
- 読む条件: 本番反映、ロールバック、権限変更を扱うとき
- 担当: SRE Team
- 適用範囲: deployment/
- 最終確認: 2026-10-05
3. 意思決定には失効条件を持たせる
「いつ決めたか」だけでは足りません。何が変わったら再確認するかを書きます。これにより、関連コードや制度が変わったとき、文書が現行かを判断しやすくなります。
# Decision: 認証方式の選択

- 状態: 有効
- 所有者: Identity Team
- 確認日: 2026-10-05
- 適用範囲: 顧客向けWebアプリ
- 失効条件: IdP、契約要件、認証ポリシーのいずれかが変更されたとき
- 根拠: セキュリティレビュー記録と承認済み設計書を参照
- 置換先: 新しい判断が承認されたら、この文書を更新して旧版を履歴へ移す注意:本番環境で使用する前に、必ずテスト環境で動作確認してください。文書へAPIキー、パスワード、個人情報を貼り付けず、参照先と安全な取得手順だけを記載します。
導入前に同じタスクで比較する
元記事に比較実験がない以上、「文書方式の方が必ず優れる」とは言えません。まず対象業務を限定し、現在の運用と文書を加えた運用で同じ代表タスクを実行します。製品導入より先に、情報の置き分けが効くかを確かめるのが順序です。
比較条件をそろえる
- 同じモデル、同じツール権限、同じ開始プロンプトを使う
- ベースライン側は現行のメモリや検索だけを使う
- 比較側は短い入口文書と、レビュー済みの仕様を追加する
- 正解条件は実行前に人間が決め、結果を見てから変更しない
- 古い文書を意図的に混ぜるのではなく、現実に起きた更新を追跡する
見るべき5つの指標
| 指標 | 確認すること | 記録方法 |
|---|---|---|
| 現行仕様への一致 | 古い判断ではなく、承認済みの現行仕様に従ったか | 合否と根拠文書を記録 |
| 再調査の量 | 同じファイルや履歴を何度も探し直したか | 検索・読込の重複を数える |
| 人間の修正 | 担当者がどこを直し、なぜ直したか | レビュー指摘を分類 |
| 古い情報の参照 | 失効済みの仕様や撤回案を採用したか | 誤参照の有無を記録 |
| コンテキスト負荷 | 必要のない文書まで毎回読み込んでいないか | 入力とツール履歴を比較 |
数値の基準値は組織やタスクで異なります。架空の改善率を置くのではなく、現行運用の実測を基準にしてください。新しい方式で品質が変わらないのに読込量と保守作業だけが増えるなら、対象範囲を縮める判断も正解です。
中止条件も先に決める
文書が増え続けて所有者不明になる、同じ事実が複数ファイルで競合する、秘密情報が混入する、レビュー待ちが業務を止める。このいずれかが起きたら、文書追加を止めて索引、責任者、アーカイブ規則を見直します。導入の成否は保存量ではなく、正しい情報へたどり着き、変更を安全に検証できるかで判断します。
文書型運用で起きやすい4つの失敗
失敗1:エージェントが書いた内容をそのまま正式版にする
❌ 会話終了時に自動生成された説明を、確認なしで共有文書へ追記する。
⭕ エージェント生成は提案扱いにし、所有者が根拠と差分を確認してから現行文書を更新する。
文書が読める形式でも、中身の正しさは保証されません。「生成された」と「承認された」を区別してください。
失敗2:1枚の巨大な指示書へ全部入れる
❌ 設計、運用、セキュリティ、調査メモを1ファイルへ追加し続け、毎回全文を読み込ませる。
⭕ 入口は案内図にし、仕様、意思決定、運用手順を分け、作業に関係する文書だけ読む。
OpenAIの実運用報告でも、大きなAGENTS.mdは重要度の希薄化、陳腐化、検証の難しさを招いたと説明されています。文書方式の価値は量ではなく、段階的に必要情報へ到達できることです。
失敗3:古い記述へ新しい説明を継ぎ足す
❌ 「以前はA、現在はB、例外ではA」と追記だけを重ね、現行ルールが分からなくなる。
⭕ 現行文書はBへ更新し、Aの経緯は履歴や意思決定記録へ移す。索引から失効済み文書を外す。
「過去を残す」と「毎回の作業で過去を読ませる」は別です。古い情報は証跡として保管し、通常の読込対象から外します。
失敗4:文書をセキュリティ制御の代わりにする
❌ 「外部送信禁止」と書けば必ず止まると考え、権限や承認ゲートを設けない。
⭕ 指示文書に加えて、最小権限、送信前承認、入力検証、フック、監査ログで停止線を作る。
共有文書そのものが改ざんされれば、エージェントへの指示経路にもなります。変更権限とレビュー履歴を管理し、外部由来の文書を無条件に信頼済みコンテキストへ入れないでください。
コミュニティの反応は「小さく保つ」で交差した
Hacker Newsの議論では、文書の監査しやすさを支持する声と、文書も古くなりコンテキストを汚すという批判が並びました。ここから先は一次記事の事実ではなく、コメント投稿者によるコミュニティの反応です。
- 支持:コードだけでは外部制約や設計理由を読み取れないため、短い入口文書と焦点を絞った仕様が役立つ。
- 批判:エージェント生成文書は追記で肥大化しやすく、誤った過去を残すとメモリと同じ問題を起こす。
- 折衷:すべてを文書化せず、繰り返し再発見する摩擦だけを入口やスキルへ移す。作業中の情報はメモリに残す。
- 評価要求:効果を主張するなら、文書あり・なしで同じタスクを比べる必要がある。
対立しているようで、実務的な接点はあります。巨大な知識庫を常時注入しないこと、古い情報を放置しないこと、正しさを測ることです。文書派でもメモリ派でも、この3点を欠けば運用は不安定になります。
よくある質問
AIエージェントのメモリの役割は何ですか?
セッションをまたいで、利用者の好み、過去の作業から得た学び、プロジェクト固有の文脈を再利用することです。ただし、未レビューの学びと、組織が承認した現行仕様は分けて管理します。
ベクトルDBやRAGは不要になりますか?
不要にはなりません。大量資料から関連候補を探す用途ではRAGが有効です。一方、承認済みの制約や最新版の仕様は、検索順位だけに依存せず、版管理された文書と明示的な入口から参照する方が監査しやすくなります。
AGENTS.mdには何を書けばよいですか?
プロジェクト概要を長く書くより、どの作業でどの文書を読むか、どのテストを通すか、どこで人の承認が必要かを簡潔に示します。詳細な手順は別文書やスキルへ分けます。
文書が古くなる問題はどう防ぎますか?
所有者、適用範囲、最終確認日、失効条件を持たせ、仕様変更と文書更新を同じレビュー単位にします。索引から未確認文書を見つけ、古い文書は通常の読込対象から外します。それでも完全には防げないため、実際のコード、設定、公式情報を優先して再確認します。
Operator Memoryをすぐ全社導入すべきですか?
現時点で一律に推奨できません。公式リポジトリは開発中と明記しており、元記事にも他方式との定量比較はありません。まず限定した検証環境で、現行仕様への一致、修正回数、古い情報の参照、保守負担を比較してください。
メモリと文書は併用できますか?
併用できます。作業中の仮説や個人の好みはメモリ、レビュー済みの仕様は文書、過去の実行はログ、広い資料群は検索基盤に置くと、用途と責任が明確になります。
要点の整理
- 今回の主張は「記憶機能をすべて捨てる」ではなく、「会話の断片を現在の仕様の代わりにしない」と読むのが実務的です。
- 文書方式の利点は、人が読めること、差分をレビューできること、最新版を明示できることです。文書も古くなるため、所有者と失効条件が欠かせません。
- 入口文書は短い案内図にし、必要な文書だけ段階的に読みます。安全制約は権限、フック、テスト、承認ゲートでも強制します。
- 効果は自社の代表タスクで比較し、現行仕様への一致、再調査、人の修正、古い情報の参照、コンテキスト負荷を記録します。
関連する設計をさらに掘り下げるなら、ファイル型メモリの別アプローチを扱ったAgent memory as a file format|設計判断4つも参考になります。今回のOperator MemoryがベクトルDBを使わない文書ワークスペースを提案するのに対し、こちらはMarkdownと検索用キャッシュを組み合わせた可搬フォーマットを扱っています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Agents Don’t Need Memory. They Need Documentation. — Kevin Liao、公開日: 2026年10月3日、参照日: 2026年10月5日
- Operator Memory公式リポジトリ — Aerovato、参照日: 2026年10月5日
- Operator Memory Architecture — Aerovato、参照日: 2026年10月5日
- Agents don’t need memory, they need documentation|Hacker News — コミュニティの反応、参照日: 2026年10月5日
- Hacker News公式Item API 49945933 — 得点・コメント数・投稿時刻の確認、参照日: 2026年10月5日
- Use memory with agents in VS Code — Microsoft、更新日: 2026年9月30日、参照日: 2026年10月5日
- How Claude remembers your project — Anthropic、参照日: 2026年10月5日
- Custom instructions with AGENTS.md — OpenAI、参照日: 2026年10月5日
- Harness engineering: leveraging Codex in an agent-first world — OpenAI、公開日: 2026年2月11日、参照日: 2026年10月5日
- Rethinking skills and prompts for GPT-6 Astra — OpenAI、公開日: 2026年9月11日、参照日: 2026年10月5日
- AGENTS.md公式サイト — 参照日: 2026年10月5日
自社のAIエージェントで、メモリ、文書、監査ログの境界を整理したい方へ
Uravationでは、AIエージェント導入の研修・コンサルティングを行っています。まずは現在の情報源と承認フローを棚卸しし、限定した検証から設計できます。