2026年11月20日時点で、Groq は AI の推論(学習済みのモデルを動かして答えを出すこと)のための処理装置 LPU を生み出し、推論のクラウド「GroqCloud」を運営する米国の会社です(Groq の発表・2026年6月22日)。GroqCloud の API は、OpenAI の SDK の base_url を https://api.groq.com/openai/v1 に替えて呼べる作りで(OpenAI Compatibility)、単価は例えば openai/gpt-oss-120b が入力 $0.15・出力 $0.60(100 万トークンあたり)、上限つきの Free プランもあります(Supported Models・Rate Limits)。名前が似た「Grok」は x.ai で提供されている AI で、Groq とは別の会社の製品です。
この記事の要点(2026年11月20日時点)
- 会社: Groq は 2016年創業の米国の会社で、トップページでは自らを「速い推論のための neocloud(AI の計算に絞った新しい形のクラウド事業者)」と呼んでいます。Groq の発表では、データセンターは 13 か所です。
- NVIDIA との関係: 2025年12月24日に推論の技術の「非独占のライセンスの契約」を結び、2026年8月12日に NVIDIA Cloud Partner になりました。契約の発表は、Groq が独立した会社として続くと書いています。
- モデル: 11月19日の docs では、本番用に
openai/gpt-oss-120b・openai/gpt-oss-20b・Whisper など、プレビュー(評価用)にqwen/qwen3.8-27bや Meta の Muse Spark Open などが並びます。Muse Spark Open は申し込み制の限定プレビューです。Llama 3.3 70B と Llama 3.1 8B は 2026年8月16日に Free と Developer での提供を終えました。この 3 つは一覧では Enterprise の印付きで、単価は「営業に相談」です。 - 料金: 100 万トークンあたりのドル建てで、
openai/gpt-oss-20bは入力 $0.075・出力 $0.30 です。支払い方法を登録して Developer プランに上げると、使った分を後から払います。 - 無料の範囲: Free プランは上限つきで、
openai/gpt-oss-120bなら毎分 30 リクエスト・1 日 1,000 リクエスト・毎分 8,000 トークン・1 日 200,000 トークンです。上限は利用者ごとではなく組織ごとにかかります。 - Grok との違い: Grok は x.ai の AI アシスタントとモデルの名前です。11月19日の GroqCloud のモデルの一覧に Grok は入っていません。
対象読者:エージェントや音声・チャットの応答を速くしたい開発者と開発の責任者で、Groq が何の会社か、GroqCloud の API で何がいくらで使えるか、OpenAI の SDK のまま呼べるか、無料でどこまで試せるかを確かめたい人。
読み終えたらできること:使うモデル ID とプラン(Free・Developer・Enterprise)を決め、OpenAI の SDK の client の base_url を公式の例どおりに替え、curl の公式の例で最初の呼び出しを送れます。
この記事は、Groq の発表とブログの一覧、GroqCloud の開発者向けの docs、課金の FAQ を 2026年11月19日時点で確認し、書かれている範囲でまとめたものです。速さや費用は当編集部では測っておらず、記事の中の速さの数字は Groq が公表している値です。コードは docs に載っている公式の例をそのまま写しています。
Groqとは|LPUを生んだ、推論のクラウドGroqCloudを運営する米国の会社
Groq(8月17日の発表での社名は Groq LLC)は 2016年に創業した米国の会社です。2026年6月22日の発表の会社紹介は、Groq が LPU を先駆けて作り、AI のモデルをより速く、より安く動かすために GroqCloud を始めたと説明し、自社を「独立した、米国を拠点とする会社」と書いています(Groq の発表・2026年6月22日)。トップページの題名(ブラウザのタブに出る title)は「Groq is the premier neocloud for fast inference」で、本文には数百メガワットの計算の能力を作っている所だと書かれています(Groq のトップページ)。
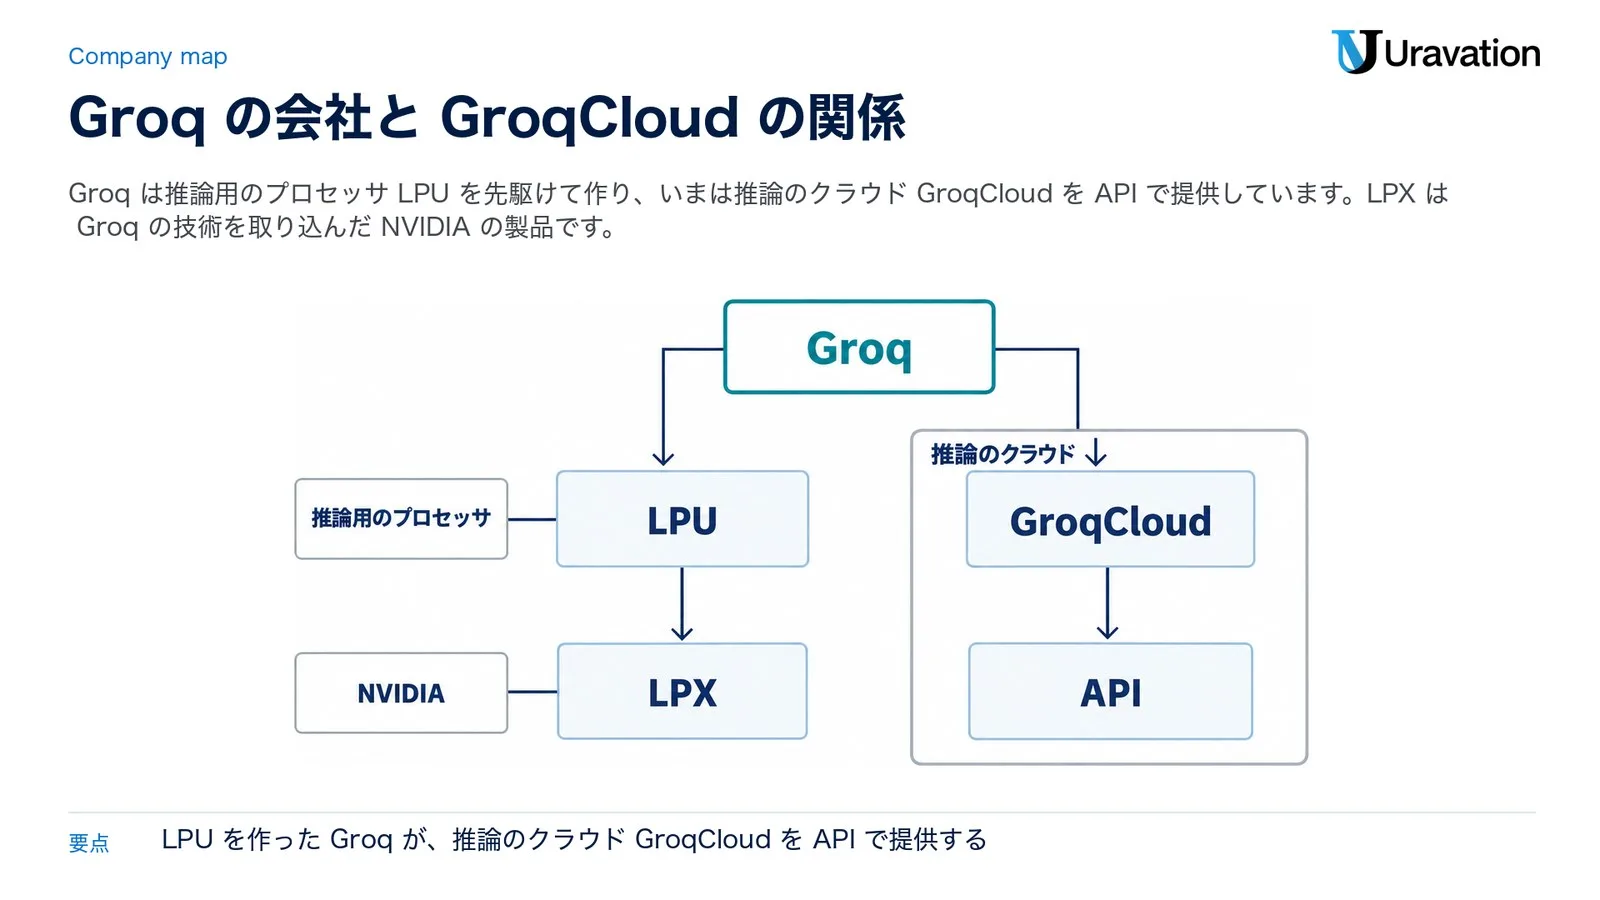
LPU は Groq が一から作った推論用のプロセッサ
LPU(Language Processing Unit)は、Groq が AI のために一から作った新しい種類のプロセッサです。Groq の説明(2025年3月7日のブログ)は、設計の考え方として「ソフトウェアを先に考える」「組み立てラインのように流す作り」「計算とネットワークが決まった順に動く(deterministic)」「チップの上のメモリ」の 4 つを挙げ、GroqCloud はこの LPU で動くと書いています(What is a Language Processing Unit?)。
LPX は NVIDIA の製品で、Groq の技術を取り込んでいる
11月19日に見たトップページは、Groq が LPU を先駆けて作り、いまはその LPU が LPX で NVIDIA の次の世代の GPU と一緒に推論を担うと書いています。6月22日の発表によると、LPX は NVIDIA が 2026年の GTC(NVIDIA の技術の会議)で発表した次の世代の基盤で、Groq の推論の技術を取り込んでいます。Platform のページは、NVIDIA Groq 3 LPX の 1 つのラックが次の世代の LPU のアクセラレータを 256 基つなぎ、NVIDIA の Vera Rubin(NVIDIA の次の世代の GPU の基盤)と組み合わせて遅延の小さい推論を出すと説明しています。書き出しは「When released(出た時には)」で、提供の開始日は書かれていません(Groq Platform)。
企業向けの 3 つの層と、この記事で扱う API
同じ Platform のページは、企業向けの提供の形を 3 つの層で説明しています。GroqMetal は専用のベアメタル(仮想化しない物理のサーバ)の基盤、GroqCore はその上で動く検証済みの推論の仕組み、GroqAssured は企業向けの統制と監査の層で、上の層は下の層を含みます。データセンターは「4 つの大陸で 13 か所」と書かれています。この記事で扱うのは、コンソールでキーを作って呼ぶ GroqCloud の API です。
2026年のGroqの動き|NVIDIAとの契約からMuse Spark Openまで
Groq の発表とブログの一覧に並ぶ題名と日付を、2025年12月の NVIDIA との契約から順に並べました(Groq Blog)。6月22日の発表は、12月の契約と GTC での LPX の発表の後、取締役会と主な投資家が経営陣と一緒に、会社の焦点を「世界を率いる AI の推論のクラウドを作ること」1 つに絞ったと書いています。2026年は、その推論のクラウドのために資金を調達し、データセンターを広げ、NVIDIA との関係を深めた年です。
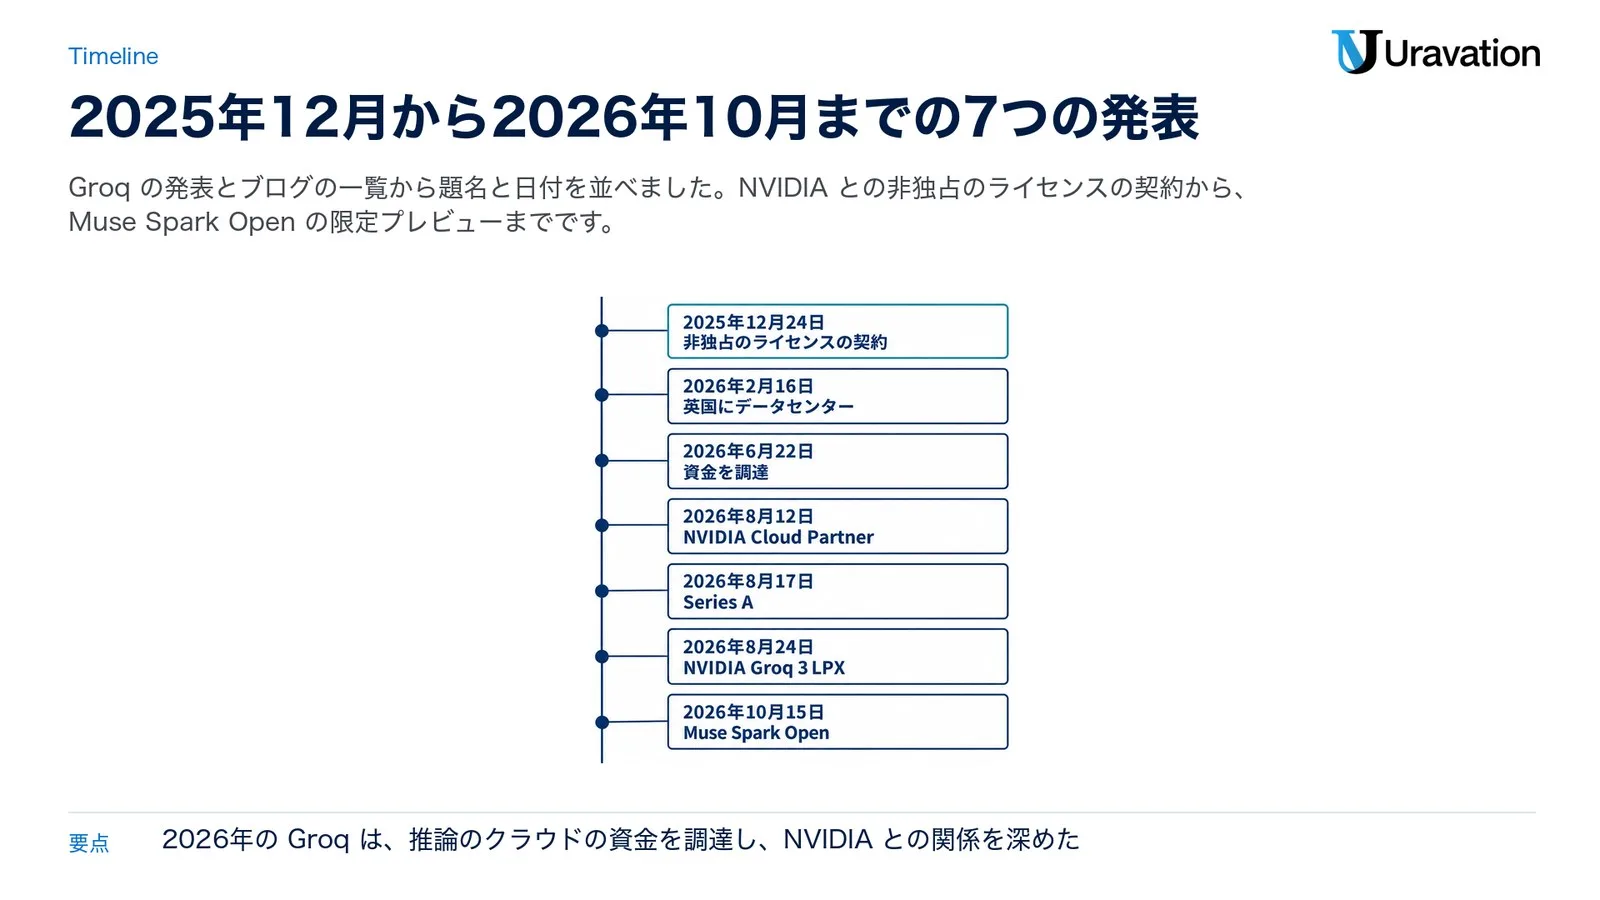
| 日付 | 発表の要点 | 本文に書かれていること |
|---|---|---|
| 2025年12月24日 | NVIDIA と推論の技術の非独占のライセンスの契約 | 創業者の Jonathan Ross 氏、社長の Sunny Madra 氏ほかが NVIDIA に加わる。Groq は独立した会社として続き、Simon Edwards 氏が CEO に就く。GroqCloud は中断なく動き続ける(発表) |
| 2026年2月16日 | GroqCloud の拡大(ブログ) | 開発者が 350 万人を超えた。Equinix と組んで英国にデータセンターを開いた。設計・ロードマップ・顧客への約束は「Groq が主導する」と明記(ブログ) |
| 2026年6月22日 | 推論のクラウドの事業のために 6億5,000万ドルを調達 | 投資会社の Disruptive と Infinitum が主導。13 のデータセンター、開発者 500 万人超。2027年末までに 200 メガワットの規模を目指す。この発表での CEO は Adam Winter 氏で、12月の発表で CEO に就くとされた Simon Edwards 氏からいつ替わったかは書かれていない(発表) |
| 2026年8月12日 | NVIDIA Cloud Partner に | NVIDIA の参照設計と運用の基準で、NVIDIA の計算の基盤を設計・構築・運用する認定(NCP)を受けた。開発者は 600 万人超(発表) |
| 2026年8月17日 | 3億5,000万ドルの Series A | Disruptive が主導し、NVIDIA が参加する予定。発表では会社の評価は 35 億ドルで、6月分と合わせた最近の調達は 10 億ドル。題は「Closes(完了)」だが、本文は通例の完了の条件(customary closing conditions)が付くと書く。54 メガワットから 2027年に 200 メガワット超へ広げる見込み(発表) |
| 2026年8月24日 | NVIDIA Groq 3 LPX を最初に採用する社の 1 つに(ブログ) | Vera Rubin NVL72 を自社の推論のクラウドに入れる予定で、Dell Technologies と組んで NVIDIA Groq 3 LPX を入れる(ブログ) |
| 2026年10月15日 | Meta の Muse Spark Open を GroqCloud で限定プレビュー(ブログ) | Meta の公開の重み(重みのデータが公開されている形)のモデルを、Meta が出したその日から限定プレビューで提供。使いたい組織はフォームで用途を伝え、Groq から連絡が来る形(ブログ・申し込みのページ) |
NVIDIA との関係は「非独占のライセンス」と「パートナー」
2025年12月24日の発表は、Groq が自社の推論の技術について NVIDIA と非独占のライセンスの契約を結んだという内容で、同じ発表の中で Groq は独立した会社として続くと書いています。2月16日のブログも、設計・ロードマップ・顧客への約束は Groq が主導すると書いています。その後の主な関係は、8月12日の NVIDIA Cloud Partner の認定、8月17日の Series A への NVIDIA の参加の予定、8月24日の NVIDIA Groq 3 LPX の採用の発表です。11月19日に発表とブログの一覧を確かめた範囲で、NVIDIA による買収の発表はありません。
Muse Spark Open は限定プレビューで、一般提供ではない
10月15日のブログ(Muse Spark Open のブログ)によると、Muse Spark Open は Meta がエージェントのコーディング向けに出した公開の重み(モデルの重みのデータが公開されている形)のモデルです。全体で 8,160 億のパラメータのうち 1 トークンごとに 420 億を使う Mixture of Experts(256 個の専門家から一部だけを選んで使う作り)で、GroqCloud では 131,072 トークンの文脈、テキストと画像の入力、テキストの出力に対応します。速さは、Groq の発表では利用者 1 人あたり毎秒 350 トークン以上です。docs のモデルの一覧でもプレビューの欄に Enterprise の印付きで載り、単価は「営業に相談」です。Meta 自身の API で使う Muse Spark の料金と使い方は、Meta Model API と Muse Spark の記事にまとめています。
GroqCloudで使えるモデル|本番用・プレビュー・提供を終えたモデル
GroqCloud で呼べるモデルは、docs のモデルの一覧に「Production(本番用)」と「Preview(プレビュー)」に分けて載っています。docs は本番用を「本番の環境で使う前提で、速さ・品質・信頼性の基準を満たすもの」、プレビューを「評価のためだけのもので、本番の環境では使わない。短い予告で終わることがある」と説明しています(Supported Models)。11月19日に確かめた一覧は次のとおりです。速さは docs の表に Groq が載せている値です。
| 区分 | モデル ID | 文脈の長さ/最大の出力(トークン) | 速さ(docs の値・毎秒のトークン) |
|---|---|---|---|
| 本番用 | openai/gpt-oss-120b |
131,072/65,536 | 500 |
| 本番用 | openai/gpt-oss-20b |
131,072/65,536 | 1,000 |
| 本番用 | whisper-large-v3・whisper-large-v3-turbo(音声の文字起こし) |
ファイルは 100 MB まで | — |
| 本番用(Enterprise) | llama-3.3-70b-versatile |
131,072/32,768 | 280 |
| 本番用(Enterprise) | llama-3.1-8b-instant |
131,072/131,072 | 560 |
| プレビュー | qwen/qwen3.8-27b |
131,072/16,384(ファイルは 20 MB まで) | 450 |
| プレビュー | openai/gpt-oss-safeguard-20b |
131,072/65,536 | 1,000 |
| プレビュー(Enterprise) | meta-models/muse-spark-open |
131,072/131,072 | 350 |
| プレビュー(Enterprise) | minimaxai/minimax-m2.7 |
196,608/131,072 | 260 |
| プレビュー | meta-llama/llama-prompt-guard-2-22m・meta-llama/llama-prompt-guard-2-86m |
512/512 | — |
| プレビュー | canopylabs/orpheus-v1-english・canopylabs/orpheus-arabic-saudi(音声の読み上げ) |
4,000/50,000 | — |
Enterprise の印が付いた 4 つのモデルは、単価と上限の欄が「Contact Sales(営業に相談)」です。一覧に並ぶのは OpenAI・Meta・Qwen・MiniMax・Canopy Labs のモデルで、11月19日の一覧に Groq の名前の付いたモデルはありません。
Llama 3.x は 8月16日に Free と Developer での提供を終えた
docs の廃止のページによると、Groq は 2026年6月17日に利用者へメールで知らせたうえで、llama-3.1-8b-instant と llama-3.3-70b-versatile の Free と Developer での提供を、2026年8月16日に終えました。一定額の利用を約束する契約(committed-spend)を結んだ Enterprise の顧客は対象外と書かれています。代わりに勧めているのは、llama-3.1-8b-instant には openai/gpt-oss-20b、llama-3.3-70b-versatile には openai/gpt-oss-120b か qwen/qwen3.6-27b です。廃止の日の後に廃止したモデル ID を呼ぶと、エラーが返ります(Model Deprecation)。
同じページには、7月17日に qwen/qwen3-32b と meta-llama/llama-4-scout-17b-16e-instruct、9月14日に qwen/qwen3.6-27b(後継は qwen/qwen3.8-27b)の Free と Developer での提供を終えた記録(どちらも一定額の利用を約束した Enterprise の顧客は対象外)と、9月21日に groq/compound と groq/compound-mini を終えた記録も並びます。Llama 3.3 70B の勧め先だった qwen/qwen3.6-27b も Free と Developer では終わっているので、移す先は今の一覧で確かめます。
今使えるモデルは、API の https://api.groq.com/openai/v1/models からも JSON の一覧で取れます。docs に載っている公式の例です(Supported Models)。
import requests
import os

api_key = os.environ.get("GROQ_API_KEY")
url = "https://api.groq.com/openai/v1/models"

headers = {
    "Authorization": f"Bearer {api_key}",
    "Content-Type": "application/json"
}

response = requests.get(url, headers=headers)

print(response.json())
GroqCloudの料金|100万トークンあたりの単価と払い方
GroqCloud の単価は、docs のモデルの一覧の「PRICE PER 1M TOKENS」の列と各モデルのページに、ドル建てで載っています(Supported Models)。groq.com/pricing の URL は、11月19日に開くとトップページへ転送されました。11月19日の単価は次のとおりで、円への換算はしていません。表のうち本番用は openai/gpt-oss-120b・openai/gpt-oss-20b・whisper-large-v3・whisper-large-v3-turbo と、Enterprise の行の Llama の 2 つで、ほかはプレビュー(評価用)です。
| モデル ID | 入力 | 出力 | 単位 |
|---|---|---|---|
openai/gpt-oss-120b |
$0.15 | $0.60 | 100 万トークンあたり |
openai/gpt-oss-20b |
$0.075 | $0.30 | 100 万トークンあたり |
openai/gpt-oss-safeguard-20b |
$0.075 | $0.30 | 100 万トークンあたり |
qwen/qwen3.8-27b |
$0.80 | $4.00 | 100 万トークンあたり |
meta-llama/llama-prompt-guard-2-22m |
$0.03 | $0.03 | 100 万トークンあたり |
meta-llama/llama-prompt-guard-2-86m |
$0.04 | $0.04 | 100 万トークンあたり |
whisper-large-v3 |
$0.111 | 音声 1 時間あたり | |
whisper-large-v3-turbo |
$0.04 | 音声 1 時間あたり | |
canopylabs/orpheus-v1-english |
$22.00 | 100 万文字あたり | |
canopylabs/orpheus-arabic-saudi |
$40.00 | 100 万文字あたり | |
| Enterprise の 4 つ(Llama 3.3 70B・Llama 3.1 8B・Muse Spark Open・MiniMax M2.7) | 営業に相談(Contact Sales) | — | |
キャッシュされた入力(前と同じ先頭部分を再利用した入力)は、モデルのページに別の単価があります。たとえば openai/gpt-oss-20b は 100 万トークンあたり $0.037 です(GPT OSS 20B のページ)。
払い方は、使った分の後払い
課金の FAQ によると、Free から Developer に上げる時は支払い方法を登録します。登録できるのは、クレジットカード、米国の銀行口座、SEPA(欧州のユーロ建ての口座振替)のデビット口座です。上げた時点の請求はなく、使った分を月末か、累計の利用額が $1・$10・$100・$500・$1,000 に届いた時に請求します(請求先がインドの顧客は区切りが違います)。利用額が $0.50 に届くまでは請求しません。Developer では Spend Limits(使う額の上限と予算の通知)を設定でき、Free にはいつでも戻せます。戻す時は、まだ請求していない分の最後の請求書を払い終えると切り替わります(Billing FAQs)。
GroqCloudの使い方|APIキーとOpenAIのSDKのbase_url
GroqCloud の API は、OpenAI のクライアントのライブラリと「ほぼ互換」になるよう作られていて、キーと base_url(API の送り先のアドレス)を替えれば、OpenAI 向けに書いたアプリを Groq に向けやすくしてあります。Groq 自身の Python と TypeScript のライブラリもあり、docs はそちらも勧めています(OpenAI Compatibility)。使い始めの手順は次のとおりです。手順 6 と 7 は、呼び出した後に上限に届いた時と、上限を上げたい時の動き方です。
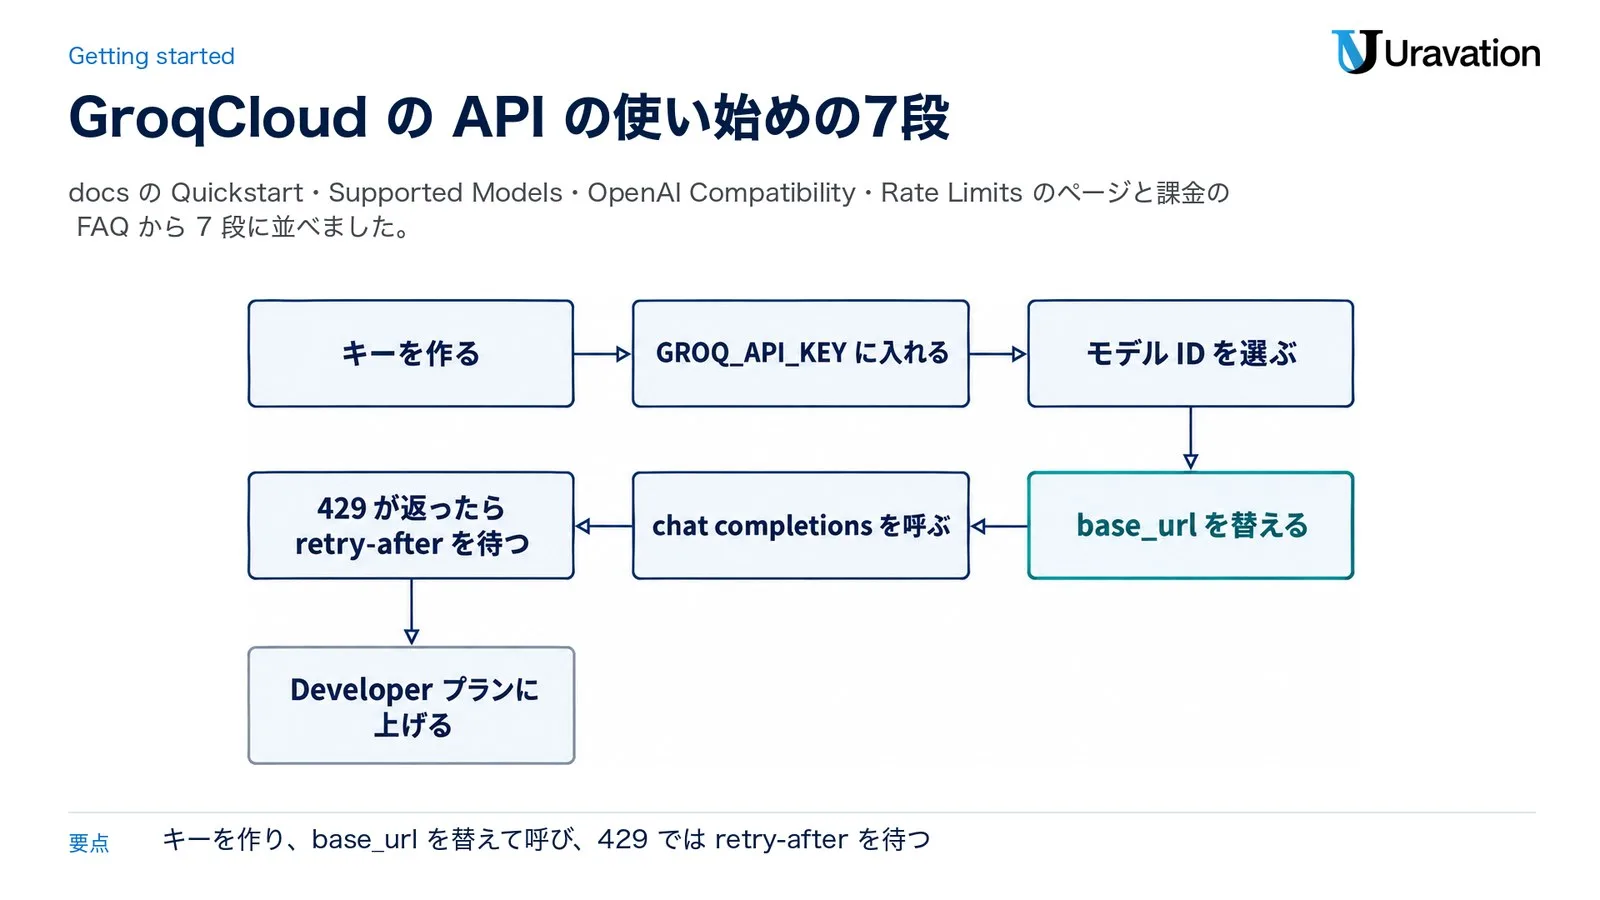
- GroqCloud のコンソールの API キーのページ(console.groq.com/keys)でキーを作ります(Quickstart)。
- キーを環境変数
GROQ_API_KEYに入れます。docs は、リクエストのたびにキーを書かずに済み、コードにキーが紛れ込む危険も減らせるとして、この形を勧めています。 - docs のモデルの一覧から、自分のプランで使うモデル ID を選びます。Free の上限の表に載っているモデルは、次の節の表のとおりです。
- OpenAI の SDK を使う時は、base_url を
https://api.groq.com/openai/v1に替え、api_key に Groq のキーを渡します。 - model と messages を渡して、chat completions(会話の形の生成)を呼びます。
- 応答のヘッダーで残りの回数とトークンを見て、429 が返ったら retry-after のヘッダーの秒数を待ってから送り直します。
- 上限を上げたい時は、支払い方法を登録して Developer プランに上げます。
手順 2 の公式の例です(docs の Quickstart)。
export GROQ_API_KEY=<your-api-key-here>手順 4 の公式の例です。OpenAI の Python のライブラリで client を作る所を示しています(docs の OpenAI Compatibility)。当編集部ではこの記事のコードを動かしていないので、本番の環境で使う前に、テストの環境で動くことを確かめてください。
import os
import openai

client = openai.OpenAI(
    base_url="https://api.groq.com/openai/v1",
    api_key=os.environ.get("GROQ_API_KEY")
)
手順 5 を curl で書いた公式の例です。openai/gpt-oss-20b のモデルのページに載っています(GPT OSS 20B)。
curl https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-oss-20b",
    "messages": [
      {
        "role": "user",
        "content": "Explain why fast inference is critical for reasoning models"
      }
    ]
  }'
Quickstart のページの例は、11月19日の時点でも model に llama-3.3-70b-versatile を書いています(Quickstart)。このモデルはモデルの節のとおり Free と Developer での提供を終えているので、写す時はモデル ID を今の一覧の物に替えます。
OpenAI の SDK で使えない項目
docs は「ほぼ互換」としたうえで、まだ対応していない項目を挙げています(OpenAI Compatibility)。
logprobs・logit_bias・top_logprobs・messages[].nameを渡すと 400 エラーになるnを渡すなら 1 だけtemperatureに 0 を入れると 1e-8 に置き換わる(うまく動かない時は、0 より大きく 2 以下の値にするよう docs は書いている)- 音声の文字起こしと翻訳で、出力の形式 vtt・srt は使えない
一方で、Responses API(前の応答を文脈に使って会話を続けられる、より高度な呼び出しの形)には対応していると書かれています。
無料プランとレート制限|FreeとDeveloperの上限
GroqCloud には上限つきの Free プランがあり、上限を上げたい時は Developer プランに上げます。レート制限(一定の時間に呼べる量の上限)は、次の単位で数えます(Rate Limits)。
- RPM・RPD: 1 分・1 日あたりのリクエストの数
- TPM・TPD: 1 分・1 日あたりのトークンの数
- ASH・ASD: 1 時間・1 日あたりの音声の秒数
- ITPM・OTPM: 1 分あたりの入力・出力のトークンの数(一部の組織にだけ、合計の TPM とは別にかかる)
上限は利用者 1 人ずつではなく組織(organization)の単位でかかり、どれか 1 つの上限に先に届いた所で止まります。キャッシュされたトークンは上限に数えません。11月19日の Free プランの表は次のとおりで、Developer の基本の上限は docs のモデルの一覧の「RATE LIMITS (DEVELOPER PLAN)」の列から写しています(Supported Models)。
| モデル ID | Free のリクエスト(毎分/1 日) | Free のトークン(毎分/1 日) | Developer の基本(毎分のトークン/毎分のリクエスト) |
|---|---|---|---|
openai/gpt-oss-120b |
30/1,000 | 8,000/200,000 | 250,000/1,000 |
openai/gpt-oss-20b |
30/1,000 | 8,000/200,000 | 250,000/1,000 |
qwen/qwen3.8-27b |
30/1,000 | 8,000/200,000 | 250,000/1,000 |
openai/gpt-oss-safeguard-20b |
3/1,000 | 2,000/200,000 | 150,000/1,000 |
meta-llama/llama-prompt-guard-2-22m・meta-llama/llama-prompt-guard-2-86m |
30/14,400 | 15,000/500,000 | 30,000/100 |
canopylabs/orpheus-v1-english・canopylabs/orpheus-arabic-saudi |
10/100 | 1,200/3,600 | 50,000/250 |
whisper-large-v3 |
20/2,000 | 音声 7,200 秒(1 時間)/28,800 秒(1 日) | 音声 200,000 秒(1 時間)/300 |
whisper-large-v3-turbo |
20/2,000 | 音声 7,200 秒(1 時間)/28,800 秒(1 日) | 音声 400,000 秒(1 時間)/400 |
docs はこの表を「大まかなまとめで、例外がある」とし、自分の組織の正確な上限はコンソールの設定の Limits のページで見るよう案内しています。Developer の値も基本の上限で、一部の用途や Enterprise ではもっと高い上限があると書かれています。Free の表に Llama 3.x・Muse Spark Open・MiniMax M2.7 は載っていません。
上限に届いた時の 429 とヘッダー
上限を超えると API は 429(Too Many Requests)を返し、その時だけ retry-after のヘッダーに待つ秒数が入ります。ほかのヘッダーは毎回付き、x-ratelimit-remaining-requests は 1 日のリクエストの残り、x-ratelimit-remaining-tokens は 1 分のトークンの残りを指します(Rate Limits)。429 を受けた時の待ち方と送り直し方は、LLM API のレート制限の対策の記事で詳しく扱っています。
Developer に上げると、上限が上がるほか、チャットでの問い合わせ、Flex(単価は通常と同じで上限が高い代わりに、空きが無い時はエラーが返ることがある処理の区分・Flex Processing)、Batch(大量のリクエストをまとめて処理する仕組み)、Spend Limits が使えるようになります。課金の FAQ には、ハッカソンや催しで販促のクレジットを出すことがあるとも書かれています(Billing FAQs)。
GroqとGrokの違い|名前が似た別の会社と製品
Groq(最後の字が q)と Grok(最後の字が k)は、名前が似ていますが別の会社の別の製品です。Groq は推論のクラウドの GroqCloud を運営し、OpenAI・Meta・Qwen などのモデルを API で動かしています。Grok は x.ai で提供されている AI アシスタントとモデルの名前で、x.ai のトップページは新しいモデルとして Grok 4.7 を案内しています(x.ai・Grok)。
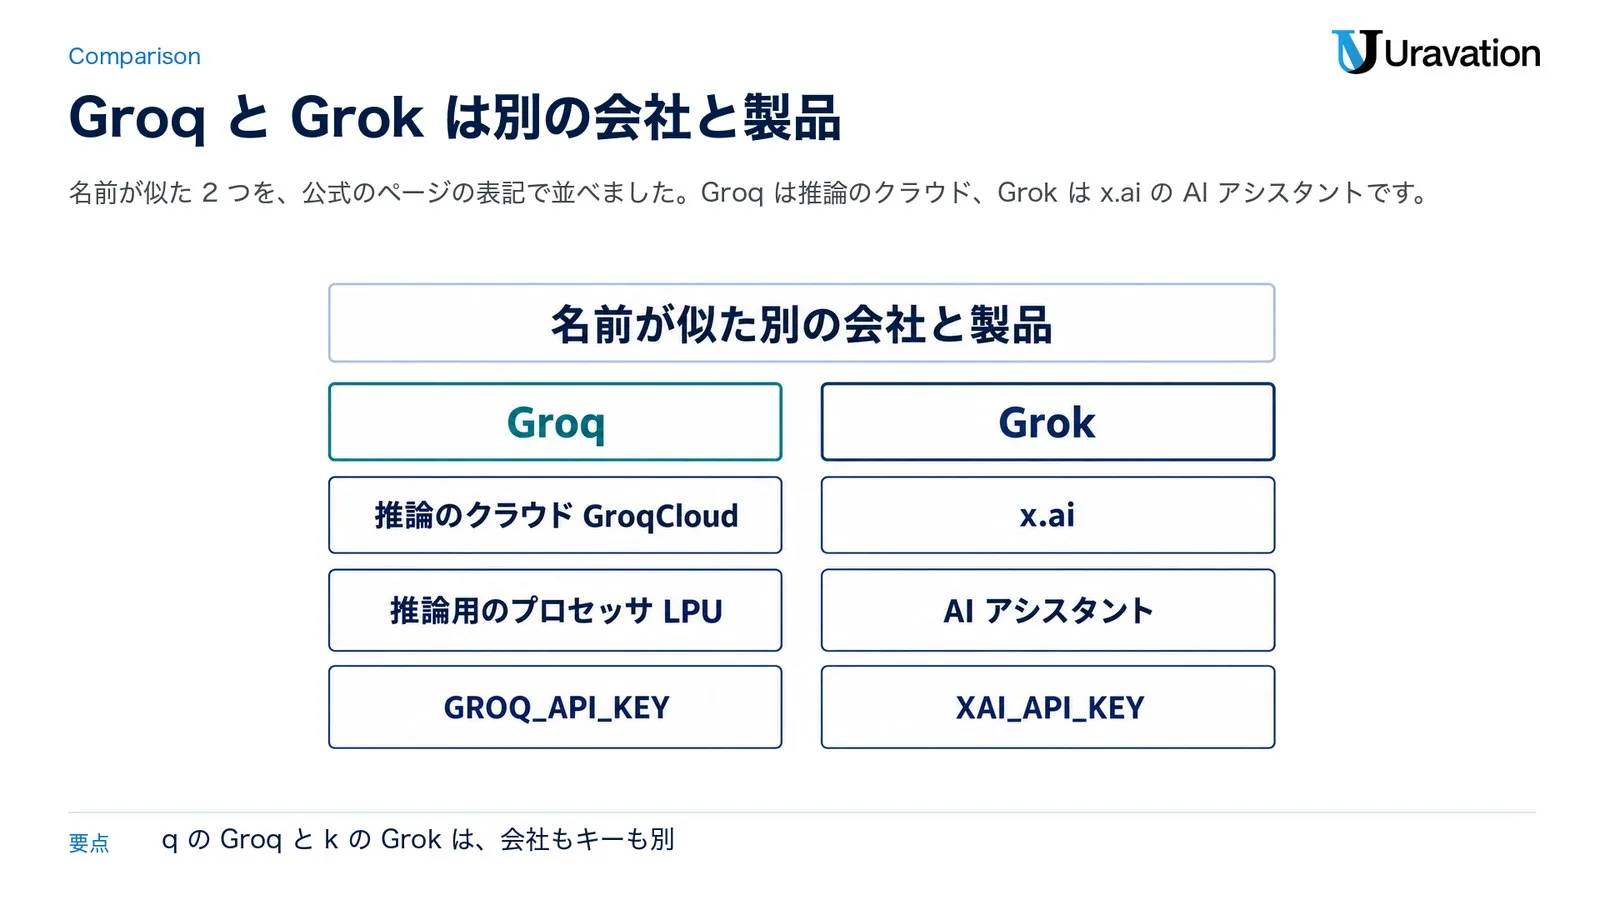
| 見る所 | Groq | Grok |
|---|---|---|
| 何か | 推論のクラウド GroqCloud と、推論用のプロセッサ LPU | AI アシスタント(Web・iOS・Android)と、Grok の名前のモデル |
| 会社(公式のページの表記) | Groq LLC(2016年創業・米国) | x.ai のサイトの著作権表示は SpaceX Super Intelligence LLC(11月19日) |
| API のキー(公式の例の環境変数) | GROQ_API_KEY |
XAI_API_KEY |
| API の呼び方(公式の例) | base_url は https://api.groq.com/openai/v1(OpenAI 互換) |
x.ai のトップページの Python の例は xai_sdk のライブラリを使う。同じ所に、OpenAI の SDK で baseURL を https://api.x.ai/v1 にする TypeScript の例も並ぶ |
| 11月19日に並ぶモデル | gpt-oss・Qwen・Muse Spark Open など(Grok は無い) | Grok 4.7 など |
キーはそれぞれのコンソールで作る別の物で、呼び先のアドレスも違います。記事や設定の例を写す時は、q と k の綴りと、環境変数の名前を確かめます。Grok の API の使い方は、Grok 4.7 を API・Copilot・Cursor で使う記事にまとめています。
Groqの使い分けの考え方|向く場面と、つまずきやすい4つ
Groq が向くとする場面は、Groq 自身が次のように説明しています。10月15日のブログは、エージェントのコーディングの作業を「モデルの呼び出しの鎖」と呼び、各段が前の段の答えを待つので、推論の速さが開発者の待ち時間を決めると書いています(Muse Spark Open のブログ)。2月16日のブログは、各業界のチームがリアルタイムのアプリに GroqCloud を使っていると書き、英国のデータセンターで欧州の組織がリアルタイムや対話のアプリの遅延を小さくできると挙げています(ブログ)。この記事では速さや費用を測っていないので、Groq の説明の範囲で場面を並べます。
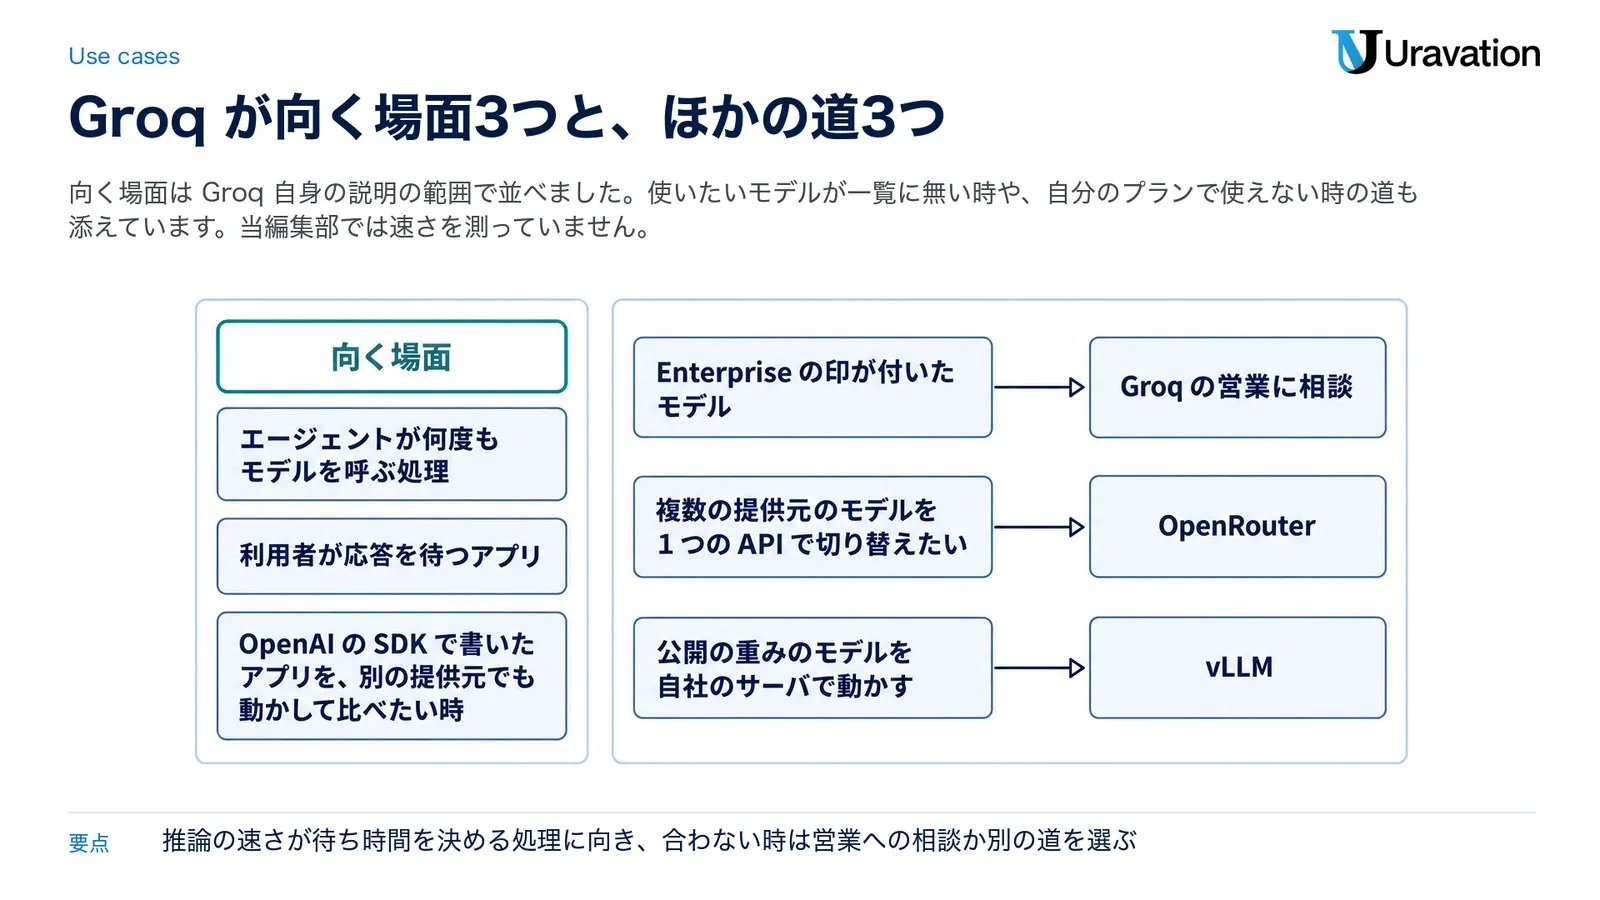
- エージェントが何度もモデルを呼ぶ処理。
openai/gpt-oss-20bのページは、ツールの呼び出しを使う低い遅延のエージェントを用途の 1 つに挙げています(GPT OSS 20B) - チャットや音声など、利用者が応答を待つアプリ。一覧には音声の文字起こしの Whisper と、読み上げの Orpheus もあります(Orpheus は英語用の
canopylabs/orpheus-v1-englishとサウジアラビアのアラビア語用のcanopylabs/orpheus-arabic-saudiの 2 つで、日本語用は一覧に無く、どちらもプレビューです・Text to Speech) - OpenAI の SDK で書いたアプリを、別の提供元でも動かして比べたい時。docs は、既存のアプリを Groq に向けて推論の速さを試しやすくするために互換にしたと書いています(OpenAI Compatibility)
反対に、使いたいモデルが自分のプランで使えない時や、GroqCloud の一覧に無い時は、ほかの道もあります。Enterprise の印が付いたモデルは、docs の表のとおり Groq の営業に相談します。複数の提供元のモデルを 1 つの API で切り替えたいなら OpenRouter のガイド、公開の重みのモデルを自社のサーバで動かすなら vLLM のセルフホストのガイドが参考になります。
つまずき 1:古い例のまま Llama 3.x を指定する
❌ 以前の記事や Quickstart の例を写して、llama-3.3-70b-versatile や llama-3.1-8b-instant を Free や Developer のキーで呼ぶ。
⭕ この 2 つは 2026年8月16日に Free と Developer での提供を終え、廃止の日の後に呼ぶとエラーが返ります。docs が勧める移り先のうち 11月19日の一覧に残っているのは、openai/gpt-oss-20b(8B の代わり)と openai/gpt-oss-120b(70B の代わり)です。Enterprise で一定額の利用を約束する契約を結んでいる場合は対象外です(Model Deprecation)。
つまずき 2:プレビューのモデルを本番の機能に入れる
❌ 一覧で新しいモデルを見つけ、そのまま本番の機能の既定のモデルにする。
⭕ docs はプレビューを評価のためだけの物とし、短い予告で終わることがあると書いています。本番は本番用の欄から選び、プレビューは評価に使います。モデルの入れ替わりは速く、6月に Llama 3.3 70B の移り先として挙がった qwen/qwen3.6-27b も、9月14日に Free と Developer での提供を終え、後継は qwen/qwen3.8-27b です。
つまずき 3:OpenAI の引数がそのまま通ると考える
❌ base_url だけ替えて、logprobs や logit_bias、n に 2 以上を渡すコードを残す。
⭕ logprobs と logit_bias は 400 エラーになり、n は 1 しか使えません。temperature の 0 は 1e-8 に置き換わります。移す前に、OpenAI Compatibility のページの対応していない項目とコードを突き合わせます。
つまずき 4:上限を利用者 1 人ずつの値と考える
❌ Free の上限を 1 人分と考え、チームの全員と自動のジョブが同じ組織のキーから呼ぶ。
⭕ 上限は組織の単位でかかり、どれか 1 つの上限に先に届くと 429 が返ります。正確な値はコンソールの Limits のページで見て、足りなければ Developer に上げるか、Enterprise の上限を営業に相談します(Rate Limits)。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
よくある質問
Groq は無料で使えますか?
上限つきの Free プランで使えます。11月19日の表では、openai/gpt-oss-120b なら毎分 30 リクエスト・1 日 1,000 リクエスト・毎分 8,000 トークン・1 日 200,000 トークンまでです。Free の表に載っているのは gpt-oss・Qwen・Whisper など 10 のモデルで、Llama 3.x・Muse Spark Open・MiniMax M2.7 は載っていません。上限は組織の単位でかかり、正確な値はコンソールの Limits のページで確かめます。上限を上げるには、支払い方法を登録して Developer プランに上げ、使った分を払います(Rate Limits・Billing FAQs)。
Groq と Grok は同じ会社ですか?
別の会社です。Groq は Groq LLC(社名は8月17日の発表の表記)で、2016年創業の米国の会社です(6月22日の発表)。推論のクラウド GroqCloud を運営しています。Grok は x.ai で提供されている AI アシスタントとモデルの名前で、x.ai のサイトの著作権表示は SpaceX Super Intelligence LLC です(11月19日に確認・x.ai)。11月19日の GroqCloud のモデルの一覧に、Grok のモデルはありません。
Groq は NVIDIA に買収されたのですか?
Groq の発表の言葉では、2025年12月24日に結んだのは推論の技術の「非独占のライセンスの契約」です(契約の発表)。創業者の Jonathan Ross 氏らは NVIDIA に加わると発表されましたが、同じ発表は Groq が独立した会社として続き、GroqCloud は中断なく動き続けると書いています。その後、2026年8月12日に NVIDIA Cloud Partner になり(NCP の発表)、8月17日の Series A には NVIDIA が参加する予定と発表しました(Series A の発表)。11月19日に発表とブログの一覧を確かめた範囲で、買収の発表はありません。
日本から使えますか?
確かめられませんでした。11月19日に読んだ Groq の docs(Quickstart・レート制限・モデル)、課金の FAQ、Platform のページには、日本からの利用の可否、日本の法人との契約、円の価格を書いた文が見つかりませんでした。課金の FAQ が挙げる支払い方法は、Visa・Mastercard・American Express・Discover のクレジットカード、米国の銀行口座、SEPA のデビット口座です(Billing FAQs)。Platform のページに名前が出ているデータセンターは米国・カナダ・フィンランド・英国・オーストラリア・サウジアラビアの 11 か所で、その中に日本はありません。使う前に、コンソールで登録できるかと、Groq の利用規約を確かめてください。
OpenAI の SDK のまま使えますか?
使えます。docs は Groq の API を OpenAI のクライアントのライブラリと「ほぼ互換」と説明し、api_key に Groq のキー、base_url に https://api.groq.com/openai/v1 を渡す例を載せています。ただし logprobs・logit_bias・top_logprobs・messages[].name は 400 エラーになり、n は 1 だけ、temperature の 0 は 1e-8 に置き換わります。モデル ID も Groq の一覧の物に替えます(OpenAI Compatibility)。
Groq の LPU は GPU と何が違いますか?
Groq の説明(2025年3月7日のブログ)では、GPU はグラフィックスのような独立した並列の処理のために作られ、実行を整えるためのキャッシュやバッファなどの部品を多く持つため、実行のたびにばらつきが出るとしています。LPU は、ソフトウェアを先に考える・組み立てラインのように流す・計算とネットワークが決まった順に動く・チップの上のメモリ、の 4 つの考え方で一から作ったプロセッサです(What is a Language Processing Unit?)。11月19日に見たトップページは、いまは LPU が LPX で NVIDIA の次の世代の GPU と一緒に推論を担うと書いています。
まとめ
Groq は LPU を先駆けて作り、いまは推論のクラウド GroqCloud を運営する米国の会社です。NVIDIA とは、2025年12月の非独占のライセンスの契約、2026年8月の NVIDIA Cloud Partner の認定、Series A への参加の予定などの関係で、Groq は自らを独立した会社と書いています。GroqCloud の API は OpenAI の SDK の base_url を替えて呼べ、単価は 100 万トークンあたりのドル建て、上限つきの Free プランもあります。Grok は x.ai の別の製品です。
- 今日: コンソールでキーを作り、
/openai/v1/modelsで今使えるモデルを確かめてから、openai/gpt-oss-20bの公式の例で最初の呼び出しを送る - 今週: 既存のコードから、Free・Developer で終わった
llama-3.3-70b-versatileなどのモデル ID と、対応していない引数(logprobsなど)を探して直す - 本番の前: 本番用のモデルを選び、組織の上限を Limits のページで確かめ、Developer に上げるなら Spend Limits を決める
あわせて読みたい: OpenRouterガイド|LLMルーティングとLiteLLM比較(複数の提供元の切り替え)/LLM APIのレート制限・スロットリング対策ガイド(429 の扱い方)
参考・出典
- Groq Blog — Groq(発表とブログの一覧。groq.com/newsroom を開くとこのページに転送される・参照日: 2026-11-19)
- Groq and Nvidia Enter Non-Exclusive Inference Technology Licensing Agreement to Accelerate AI Inference at Global Scale — Groq(2025年12月24日・参照日: 2026-11-19)
- GroqCloud: Expanding to Meet Demand — Groq ブログ(2026年2月16日・参照日: 2026-11-19)
- Groq Raises $650M to Scale Its AI Inference Cloud Business — Groq(2026年6月22日・参照日: 2026-11-19)
- Groq Becomes an NVIDIA Cloud Partner — Groq(2026年8月12日・参照日: 2026-11-19)
- Groq Closes $350 million Series A, Building the World’s Leading AI Inference Cloud — Groq(2026年8月17日・参照日: 2026-11-19)
- Groq Among the First to Bring NVIDIA Groq 3 LPX and Vera Rubin NVL72 to Market — Groq(2026年8月24日・参照日: 2026-11-19)
- Meta’s Muse Spark open-weight release Is Now in Limited Preview on GroqCloud — Groq(2026年10月15日・参照日: 2026-11-19)
- Muse Spark Open on Groq(限定プレビューの申し込み) — Groq(参照日: 2026-11-19)
- What is a Language Processing Unit? — Groq ブログ(2025年3月7日・参照日: 2026-11-19)
- Groq(トップページ)・Groq Platform — Groq(参照日: 2026-11-19)
- Supported Models — GroqCloud Docs(モデルの一覧・単価・Developer の上限・参照日: 2026-11-19)
- GPT OSS 20B — GroqCloud Docs(モデルのページ・参照日: 2026-11-19)
- Quickstart — GroqCloud Docs(参照日: 2026-11-19)
- OpenAI Compatibility — GroqCloud Docs(参照日: 2026-11-19)
- Rate Limits — GroqCloud Docs(Free プランの表・参照日: 2026-11-19)
- Billing FAQs — GroqCloud Docs(参照日: 2026-11-19)
- Flex Processing — GroqCloud Docs(処理の区分 Flex・参照日: 2026-11-19)
- Text to Speech — GroqCloud Docs(読み上げのモデルと言語・参照日: 2026-11-19)
- Model Deprecation — GroqCloud Docs(廃止の履歴・参照日: 2026-11-19)
- x.ai・Grok — x.ai(著作権表示 SpaceX Super Intelligence LLC・参照日: 2026-11-19)