よくある誤解は、「オンデバイス向けの大規模モデルを入れれば、それだけで速く安全な業務エージェントが完成する」という見方です。正しくは、2026年10月13日にLiquid AIが公開したLFM2.5-24B-A2Bは、総パラメータ24Bのうちトークンごとに約2Bを動かすMoE型の推論モデルで、端末上のツール実行エージェントを狙った有力な選択肢です。ただし、実務での価値はモデル単体の速度ではなく、ツール成功率、権限、データ経路、日本語業務での品質まで含めて判断する必要があります。
2026年10月16日時点の直答:今回の発表で公開されたのは、エージェント用途向けに後学習されたモデルとベースモデルのオープンウェイトです。公式資料では131,072トークンのコンテキスト、ツール呼び出し、日本語を含む16言語、複数のローカル実行形式が案内されています。日本企業が最初に行うべきことは、全面導入ではなく、読み取り専用の業務を一つ選び、既存モデルと同じ評価データで完了品質を比較することです。
LFM2.5-24B-A2B: Built for fast on-device agentsという発表が注目された理由は、単に「新しい24Bモデルが出た」からではありません。クラウドAPIへ毎回問い合わせる構成とは別に、社内端末や自社管理ハードウェアの中で、推論とツール選択のループを回す現実的な選択肢が増えたからです。
一方で、名称の「24B」と「A2B」だけを見て、小型モデルと同じメモリで動く、データが一切外へ出ない、どの業務でもクラウド最上位モデルを置き換えられる、と解釈するのは危険です。公式発表が示した強みと、まだ利用企業が自分で確かめるべき領域を分けて見ていきます。
LFM2.5-24B-A2Bの発表を一枚に整理
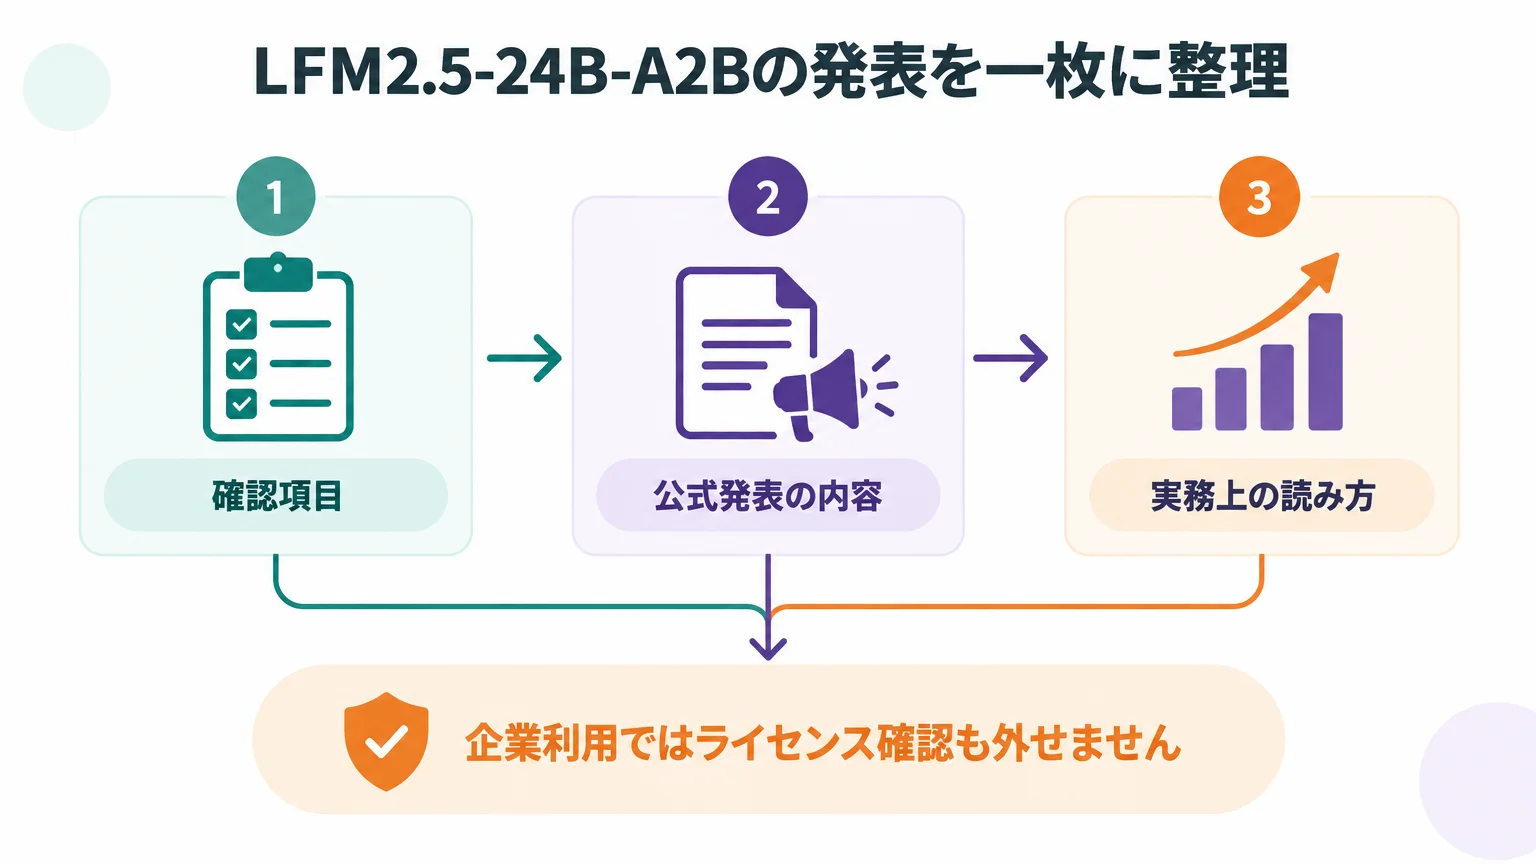
Liquid AIは2026年10月13日、LFM2.5ファミリー最大かつ最後のモデルとしてLFM2.5-24B-A2Bを発表しました。公式ブログとモデルカードによれば、ベースモデルと、エージェント用途向けに後学習されたモデルの両方がHugging Faceで公開されています。ここで重要なのは「オープンソース」と一括りにせず、オープンウェイトであり、利用条件はLFM Open License v1.0に従うと理解することです。
| 確認項目 | 公式発表の内容 | 実務上の読み方 |
|---|---|---|
| 公開日 | 2026年10月13日 | 仕様が動きやすい時期のため、導入時はモデルカードを再確認する |
| モデル規模 | 総パラメータ24.0B、活性パラメータ2.45B | 計算量を抑える設計だが、重み全体の保管や読込は別問題 |
| 用途 | テキスト推論、ツール呼び出し、複数手順のエージェント処理 | 画像理解モデルではなく、業務手順を進める「頭脳」候補として見る |
| コンテキスト | 131,072トークン | 上限まで使うことを前提にせず、速度・メモリ・品質との関係を測る |
| 対応言語 | 日本語を含む16言語 | 日本語対応の記載は、日本固有業務での品質保証を意味しない |
| 主な実行経路 | Transformers、llama.cpp、MLX、vLLM、SGLang、ONNXなど | 端末、量子化、同時実行数に合わせてランタイムを選ぶ |

企業利用ではライセンス確認も外せません。公式ライセンス本文は、年間売上が1,000万米ドル以上の法人による商用利用を同ライセンスの許諾対象外と定めています。これは「重みをダウンロードできるから、どの企業でも同じ条件で自由に商用利用できる」という意味ではありません。グループ会社の範囲、利用主体、再配布の有無を含め、LFM Open License v1.0の公式ページを法務担当と確認してください。
24Bの器を約2Bで動かすMoE設計
LFM2.5-24B-A2BはMixture of Experts、略してMoEのモデルです。すべてのパラメータを毎回均等に使うのではなく、入力された各トークンに応じて一部の専門家を選びます。公式モデルカードでは、各MoEブロックに64の専門家があり、そのうち上位4つをルーティングすると説明されています。この疎な活性化が、24Bという総容量を持ちながら、1トークン当たりの計算を2.45B相当に抑える土台です。
ただし、活性パラメータが少ないことと、モデル全体が2Bモデルと同じ容量で収まることは同義ではありません。ローカル導入では、重みの形式、量子化、KVキャッシュ、コンテキスト長、同時実行数がメモリ使用量を左右します。「A2Bだから手元のPCで必ず軽い」と決めつけず、候補端末ごとにロード可否と長時間実行時の余裕を測るべきです。
前世代のLFM2-24B-A2Bからは、コンテキスト長が32,768から131,072トークンへ、語彙が65Kから128Kへ拡張されました。Liquid AIは語彙拡張の狙いとして、非ラテン文字のトークン化改善を挙げています。日本語が対応言語に含まれる点と合わせ、国内利用者には重要な更新です。ただし、トークン化効率と、敬語・社内用語・帳票・規程を正しく扱う能力は別なので、日本語評価を省略する理由にはなりません。
構造は40層で、30の二重ゲート付き短畳み込みブロックと10のGQAブロックを組み合わせます。事前学習は約33兆トークンへ拡大され、続く中間学習では推論、数学、コード、指示追従、多言語、長文脈を重視したデータが使われたと説明されています。後学習には教師特化、非エージェントとエージェントのオンポリシー蒸留、エージェント強化学習が含まれます。

後学習ではOpenClaw、Hermes Agent、Pi、OpenCodeといったエージェントハーネス内で学習したとされています。これはツール選択と複数手順の実行を狙った設計であることを示します。一方、特定のハーネスで学習したからといって、自社のツール定義、認証方式、エラー形式にもそのまま適合するとは限りません。関数名の揺れ、必須引数の欠落、実行結果を受けた再計画までを、自社の定義で確かめる必要があります。
公式ベンチマークは強みと弱みを同時に読む
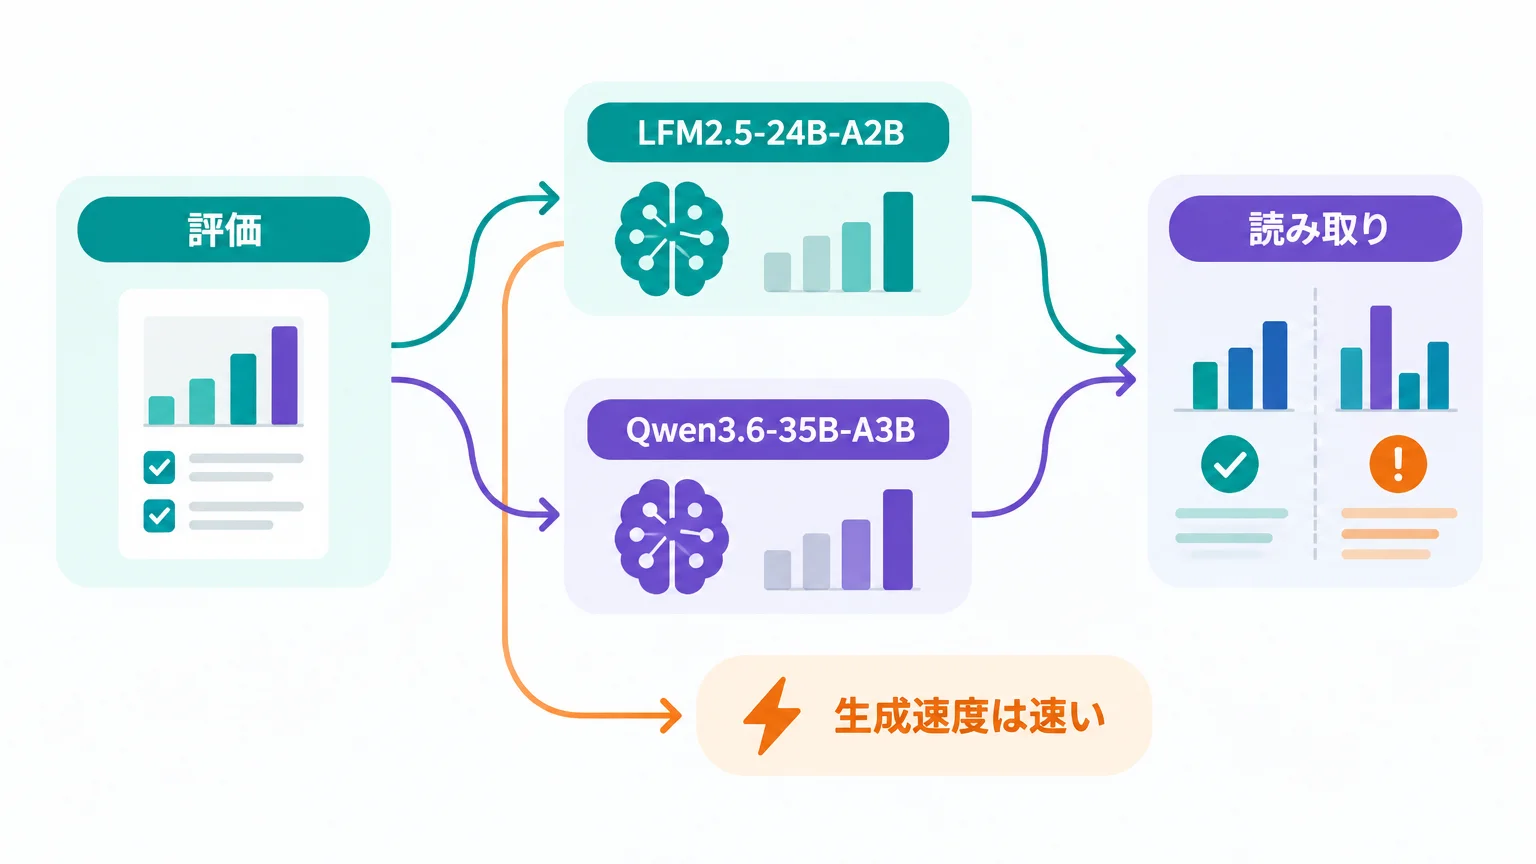
Liquid AIは16のベンチマークを公開し、LFM2.5-24B-A2Bが8つのエージェント・ツール利用系評価のうち5つで比較対象を上回るか同等だったと説明しています。目を引くのはAutomationBenchやLiveClawですが、すべての評価で首位というわけではありません。WebArena Verified、PinchBench、知識、コーディングの一部では比較モデルが上回っています。
| 評価 | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | 読み取り |
|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 自動化タスクでは公式比較上の強み |
| LiveClaw | 48.09 | 38.19 | エージェント系評価で優位 |
| ToolSandbox | 80.71 | 75.02 | ツール利用評価で優位 |
| PinchBench | 83.18 | 89.93 | 比較モデルが上回る |
| WebArena Verified | 26.75 | 37.62 | Web操作系では比較モデルが上回る |
| SWE-Bench Verified(OpenCode) | 51.00 | 66.20 | コード修正では比較モデルが上回る |

この表から言えるのは、「ローカルで動くのに万能」ということではなく、ツール利用と指示追従を主戦場にしたモデルであるということです。Liquid AI自身も、知識集約型の業務では検索やRAGと組み合わせるよう勧めています。社内規程の照会や製品仕様回答では、モデルの内部知識を試すより、承認済み文書を検索して根拠付きで返す構成の方が製品の狙いに合います。
さらに、これらはLiquid AIが公開したベンダーベンチマークです。評価条件は公式ブログ脚注に記載されていますが、独立した第三者評価でも、日本企業の業務データを使った結果でもありません。「公式数値だから採用を決める」のではなく、「どのタスクなら候補になるかを絞る材料」として使うのが妥当です。
生成速度は速い。それでもtok/sだけで決めない
端末側の公式測定では、llama.cpp、Q4_K_M量子化、4Kトークンの入力という条件で、Apple M5 Maxが毎秒184トークン、AMD Ryzen AI Max+ 395が毎秒114トークンのデコードを記録し、比較対象のMoEより最大1.7倍速いと発表されています。サーバー側では、NVIDIA B300を1基使い、SGLang 0.5.22、BF16、入力1,024トークン、最大出力256トークンの持続負荷条件で、出力スループットが毎秒21,000トークンを超えたとしています。後者は高並列時の合計スループットであり、1人の応答待ち時間を表す数値ではありません。


エージェント運用で知りたいのは、文章を吐き出す速さだけではありません。コンテキストの読込、最初のツール選択、引数生成、ツールの待ち時間、失敗後の再試行、最終回答までを含む「タスク完了時間」が本当の体感です。推論専用モデルは回答前に思考過程を生成する設計でもあるため、出力速度が高くても、必要な総トークンが増えれば完了までの時間は延びます。
日本の現場で効くのは「通信しないこと」だけではない
社内文書を外部モデルAPIへ送らない構成を選べる
モデルサーバーを自社管理端末に置けば、プロンプトや検索結果を外部の生成AI APIへ送らずに推論できます。Liquid AIはM5 Max MacBook Pro上のHermes Agentで、クラウドAPIを使わずに計画とツール呼び出しを行うデモを公開しました。機密文書、設計資料、顧客対応履歴を扱うチームにとって、これは検討価値のある構成です。
ただし、エージェントがWeb検索、SaaS、メール、社内APIへ接続すれば、そのツール通信は発生します。モデルがローカルであることと、ワークフロー全体が閉域であることは別です。データフロー図には、モデルサーバーだけでなく、検索基盤、ログ、監視、クラッシュレポート、更新確認、ツール接続先まで入れてください。ローカルAIエージェントのプライバシーと自律性も、構成を切り分ける際の前提整理に使えます。
短いツールループを対話的に回せる可能性がある
端末内での高速デコードは、「候補を出す、確認する、実行する、結果を見て次へ進む」という短い往復に向きます。たとえば、社内ファイルの検索、候補文の作成、読み取り専用データベースの照会、ローカル開発環境の診断などです。ネットワーク遅延が減ることは利点ですが、ツール側の処理時間までは消えません。モデル応答と外部処理を別々に計測すると、改善点を見誤りにくくなります。
日本語対応は出発点であって合格証ではない
公式モデルカードは日本語を対応言語に含め、語彙拡張が非ラテン文字のトークン化改善を狙うと説明しています。これは日本語業務にとって前向きな材料です。しかし、稟議、契約、敬語、部署略称、製品コード、表形式の帳票といった日本固有の要件で十分かは別途確認が必要です。日本語の長文を一度読ませて印象を比べるだけではなく、表記ゆれを含む検索、根拠箇所の特定、ツール引数への転記、断るべき依頼の拒否まで評価してください。
Hacker Newsの283 pointsは期待と慎重論の両方を示した
Hacker Newsの議論は、2026年10月16日9時49分JSTの確認時点で283 points、76 commentsでした。以下は公式仕様ではなく、利用者や開発者によるコミュニティの反応です。個別環境の速度や失敗談は条件が統一されていないため、性能の根拠には使えません。
| 反応のテーマ | コメント欄で見られた論点 | 実務者が持ち帰ること |
|---|---|---|
| 速度と品質 | 生成速度を評価する一方、実タスク品質やベンチマークの意味を問う声 | tok/sとタスク成功率を別指標にする |
| 安全性 | 高速に動くほど、最小権限、サンドボックス、本番環境との分離が重要という議論 | モデル評価と権限設計を同時に進める |
| 用途 | コーディングだけでなく、検索や予定管理など短いツール連鎖への期待 | 自社で頻度が高く、戻せる作業を選ぶ |
| 測定方法 | 再試行やツール時間を含む完了時間で見るべきという意見 | 一回の生成速度を採用判断にしない |
| ライセンス | 社内利用や商用条件をどう読むかという質問 | コメントではなく公式ライセンスを確認する |
この議論で特に重要なのは、旧LFM2-24B-A2Bの第三者スコアをLFM2.5-24B-A2Bの評価と取り違え、投稿者が訂正したやり取りがあったことです。モデル名が似ていても、世代、後学習、量子化、ランタイムが違えば結果は移せません。社内資料でも「LFM2」「LFM2.5」「Base」「post-trained」「量子化版」を別々に記録してください。
採用判断は業務タスクの完了品質で行う
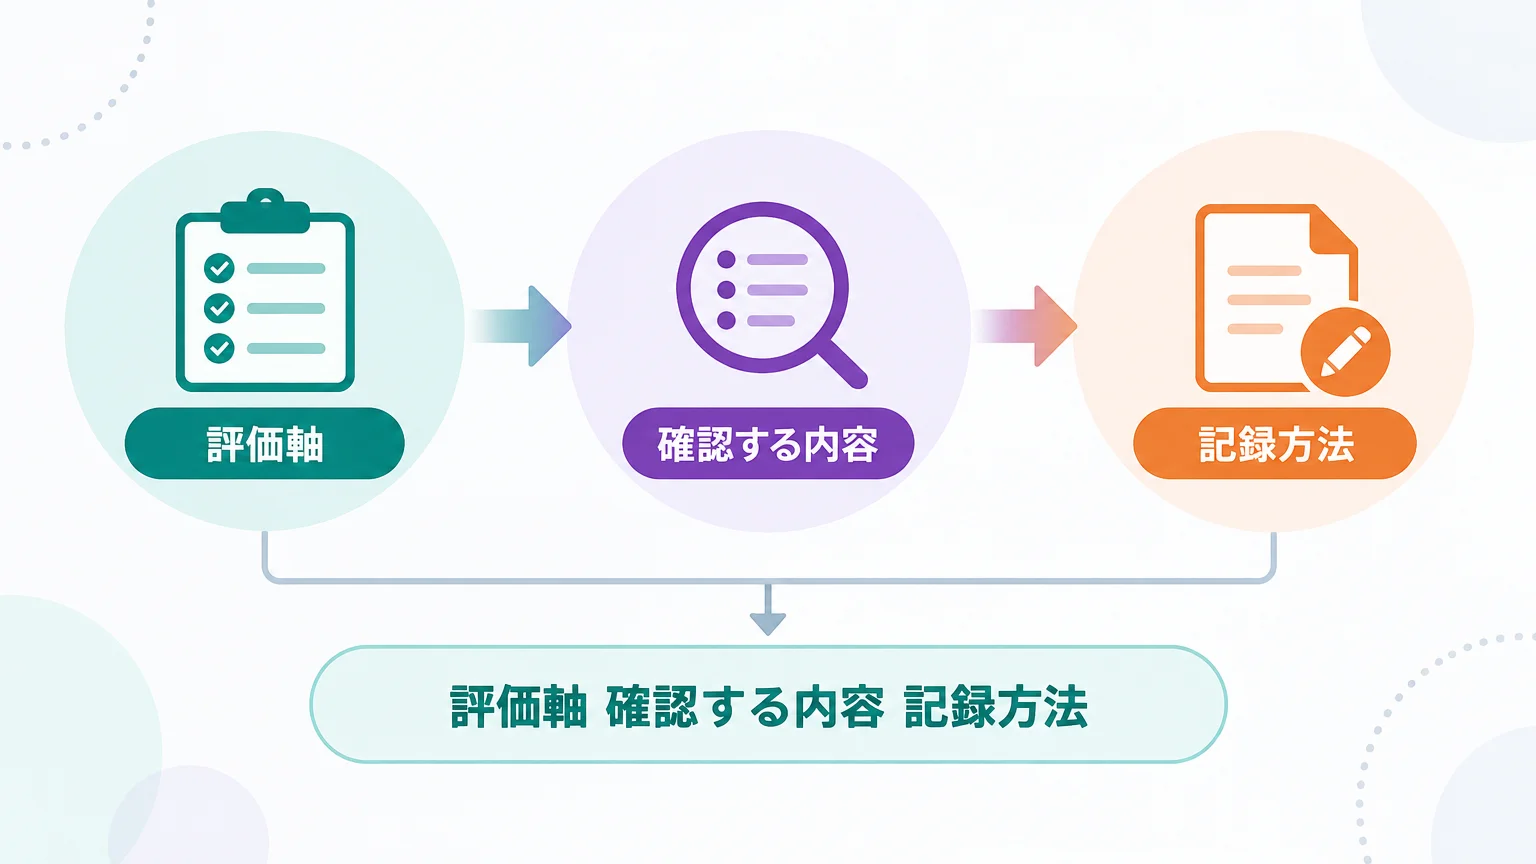
評価表はモデルの一般知識テストではなく、実際に任せたい業務から作ります。同じ入力、同じツール、同じ成功条件を既存構成とLFM2.5-24B-A2Bへ与え、どこで差が出たかを記録します。速度だけが良くても、誤ったツールを呼び、再試行が増えれば、総時間と人の確認負荷は悪化します。
| 評価軸 | 確認する内容 | 記録方法 |
|---|---|---|
| タスク完了 | 最終状態が業務の成功条件を満たしたか | 成功、部分成功、失敗を理由付きで残す |
| ツール選択 | 必要なツールを選び、不要なツールを避けたか | 呼び出し順序と不要呼び出しをログ化する |
| 引数の正しさ | ID、日付、範囲、列名などを正確に渡したか | スキーマ違反と意味上の誤りを分ける |
| 復旧 | タイムアウトや空結果から安全にやり直せたか | 再試行回数と人の介入点を残す |
| 完了時間 | 読込から最終回答まで、どこに時間を使ったか | prefill、生成、ツール、再試行を分解する |
| 日本語品質 | 社内用語、敬語、表記ゆれ、根拠提示を扱えるか | 業務担当者が共通ルーブリックで判定する |
| データ経路 | どの情報が端末外へ出たか | 通信先、送信項目、保存期間を棚卸しする |
| 資源 | メモリ、発熱、電力、同時実行時の低下 | 候補端末と量子化ごとに測定する |
評価項目を作る際は、端末横断OSSエージェントNanoMuseの検証法のような隣接事例も参考になります。ただし、別製品の結果をLFM2.5-24B-A2Bへ転用せず、観点だけを借りてください。ローカルLLMのサーバーとエージェントの役割分担は、OllamaでローカルLLMエージェントを組む基本でも整理しています。この記事のリンクは一般的な構成理解のためであり、LFM2.5-24B-A2BのOllama対応を保証するものではありません。
小さく安全に始める検証フロー
フェーズA:戻せる業務を一つ選ぶ
最初の対象は、失敗しても元データを壊さず、人が結果をすぐ確認できる作業にします。社内文書の候補検索、読み取り専用の問い合わせ、下書き生成、開発ログの分類などが考えられます。送信、削除、決済、本番変更のような不可逆操作は外します。ここで成功条件と、実行してはいけない条件を文章にします。
フェーズB:推論サーバーとデータ経路を固定する
Liquid AIのモデル別公式ドキュメントから、候補ハードウェアに合う実行経路を選びます。Apple SiliconならMLX、CPUオフロードを含む汎用構成ならllama.cpp、GPUサーバーで同時処理するならvLLMやSGLangが候補です。これは優劣ではなく、運用形態の違いです。使用するチェックポイント、量子化、ランタイム版、コンテキスト上限、生成設定を固定し、変更履歴を残します。
フェーズC:読み取り専用ツールを一つ接続する
最初から多数のSaaSや社内システムをつながず、引数が明確な読み取り専用ツールを一つだけ渡します。存在しないID、権限不足、空結果、タイムアウト、同名候補などを意図的に発生させ、モデルが勝手に成功扱いしないかを確認します。Liquid AIはローカルモデルをエージェントハーネスへ接続する公式ガイドを公開していますが、権限設計と業務の成功条件は利用企業側で決める必要があります。
フェーズD:同じ課題で現行構成と比較する
クラウドモデル、既存ローカルモデル、人手の現行手順と、同じ入力セットで比較します。平均値だけでなく、失敗の種類を見ます。引数を一つ間違えるモデルと、慎重すぎて毎回確認を求めるモデルでは、改善方法が違うからです。比較後は「採用」「限定採用」「継続検証」「見送り」を、用途ごとに分けて判断します。
フェーズE:書き込み権限は最後に分離して試す
読み取りで基準を満たした後も、書き込みは別の検証として扱います。確認画面、対象件数の上限、許可リスト、ロールバック、操作ログを用意し、モデルの判断だけで実行させません。高速なローカル推論は、誤操作も高速化し得ます。速度の利点を活かすためにも、実行前確認と権限境界が必要です。
つまずきやすい設計と切り返し
失敗1:オンデバイスならデータは絶対に外へ出ない
❌ モデルを端末に置いた時点で、プライバシー対応は完了したと考える。
⭕ モデル、検索、ツール、ログ、監視、更新確認を含むデータ経路を図示し、外向き通信を実測する。
なぜ重要か:ローカル推論でも、Web検索やSaaS連携があれば入力の一部が外部へ送られる可能性があります。
失敗2:ベンチマーク首位の行だけで採用する
❌ AutomationBenchやLiveClawの差だけを見て、すべてのエージェント業務で優位と判断する。
⭕ Web操作、コード修正、知識系で比較モデルが上回る行も読み、自社タスクと評価の距離を確認する。
なぜ重要か:公式表そのものが、強みがタスク依存であることを示しています。
失敗3:最初からメール送信や本番変更を許可する
❌ デモの成功後すぐに、書き込み・送信・削除ツールを同じ権限で渡す。
⭕ 読み取り専用、隔離環境、明示確認、限定的な書き込みの順に権限を分ける。
なぜ重要か:モデル性能が高くても、誤った引数や再試行ループは起こり得ます。被害範囲は権限側で制御できます。
失敗4:131Kコンテキストへ資料を全部入れる
❌ 長い文脈に入る限り、規程、議事録、メール履歴を無選別に投入する。
⭕ 必要な情報を検索で絞り、根拠箇所と版を付け、不要な個人情報を除いて渡す。
なぜ重要か:コンテキスト上限は、必要な情報を選ぶ設計を不要にするものではありません。長い入力は読込時間とメモリにも影響します。
よくある質問
LFM2.5-24B-A2Bとは何ですか?
Liquid AIが2026年10月13日に公開した、総パラメータ24B、活性パラメータ2.45BのMoE型テキスト推論モデルです。ツール呼び出しと複数手順のエージェント用途を重視して後学習されています。
完全にオフラインで動きますか?
モデル推論をローカルで動かす構成は可能です。ただし、エージェントがWeb検索、SaaS、外部APIを使えば通信は発生します。オフライン可否はモデルだけでなく、接続するツールとログ基盤を含めて判断してください。
どのハードウェアが最低条件ですか?
2026年10月16日時点の公式資料は複数端末での測定値と実行形式を示していますが、すべての量子化・コンテキスト・同時実行条件を覆う単一の最低要件は示していません。候補端末で実際にロードし、業務に必要な文脈長でメモリと速度を測るのが確実です。
日本語の業務に使えますか?
公式モデルカードの対応言語には日本語が含まれます。ただし、これは日本語業務の品質保証ではありません。社内略称、敬語、帳票、規程、ツール引数を含む評価セットで確認してください。
オープンソースで商用利用も自由ですか?
公式表現はオープンウェイトで、LFM Open License v1.0が適用されます。ライセンス本文には年間売上1,000万米ドル以上の法人に関する商用利用制限があります。自社への適用は公式本文を読み、必要に応じて法務担当やLiquid AIへ確認してください。
どの業務から試すのがよいですか?
社内検索、分類、読み取り専用照会、下書き作成など、結果を人が確認できて元データを変えない業務が向いています。公式評価の強みを踏まえ、知識を暗記で答えさせるより、承認済み情報を検索してツールで処理する課題から始めると評価しやすくなります。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- LFM2.5-24B-A2B: Built for Fast On-Device Agents — Liquid AI、2026年10月13日公開(参照日:2026年10月16日)
- LiquidAI/LFM2.5-24B-A2B Model Card — Liquid AI公式Hugging Face(参照日:2026年10月16日)
- LFM2.5-24B-A2B — Liquid Docs公式モデル仕様(参照日:2026年10月16日)
- Run local agents with LFMs — Liquid Docs公式ローカルエージェントガイド(参照日:2026年10月16日)
- LFM License — Liquid AI公式ライセンス(参照日:2026年10月16日)
- Hacker News discussion: LFM2.5-24B-A2B — コミュニティの反応。製品仕様の根拠には使用していません(参照日:2026年10月16日)
ここまでの要点
- LFM2.5-24B-A2Bは、24Bの総容量と約2Bの活性化を組み合わせ、端末上のツール実行エージェントを狙ったオープンウェイトモデルです。
- 公式評価はツール利用と指示追従で強みを示す一方、Web操作、知識、コード修正では比較モデルが上回る項目もあります。
- 日本企業にとっての価値は、外部モデルAPIへ送らない構成、短いツールループ、日本語対応の可能性にあります。ただし、データ経路、権限、ライセンスを別々に確認する必要があります。
- 検証ではtok/sだけでなく、ツール成功率、再試行、人の介入、最終完了時間を現行構成と同じ課題で比較します。
- 最初は読み取り専用の一業務に限定し、書き込み・送信・削除は評価と権限を分けて後段に置きます。
ローカルAIエージェントの候補が増えた今、重要なのは「動いたか」ではなく「どの条件なら安全に任せられるか」を記録することです。モデル名を先に決めるより、業務の成功条件と停止条件を先に決めると、LFM2.5-24B-A2Bを採用する場合も見送る場合も、判断の根拠が残ります。
自社業務に合う評価項目や、ローカル推論とクラウドAPIの切り分けを整理したい方へ
Uravationでは、AIエージェント導入の研修・検証設計・運用支援を行っています。製品ありきではなく、対象業務、権限、評価方法からご相談いただけます。
この記事はAIgent Lab編集部がお届けしました。