2026年10月16日時点で、RustとAIエージェントの関係は「設計・構築・最適化」の3本柱で判断すべきです。
2026年10月14日に公開された「What agents mean for Rust (and vice versa)」は、Rustの型システムがコーディングエージェントのガードレールになり得る一方、性能調整の余地をプロファイラと組み合わせれば最適化ループを作れると論じています。ただし、型やテストだけでは業務上の正しさを保証できず、設計はなお未解決です。これはRust Projectの新機能発表ではなく、言語設計とエージェント開発の次の論点を示した個人ブログの論考です。
- 公開されたもの:REBASEでの招待講演を補う論考。Rustの仕様変更や採択済みの正式計画ではありません。
- 日本企業への意味:コード生成量より、仕様・機械検査・人間レビューを接続する運用設計が重要になります。
- 最初の一手:リポジトリを1つ、変更種類を1つに限定し、
cargo check、cargo test、cargo clippyと人間の差分確認を受け入れ条件にします。
対象読者:AIコーディングエージェントを評価する開発責任者、Rustチーム、品質保証・セキュリティ担当者。原文の主張、Rust公式情報、コミュニティの意見を分けて読みたい方に向けた整理です。
「RustでAIエージェントを作る」と「AIエージェントにRustを書かせる」は、似ているようで別の話です。前者は実装言語の選定、後者はエージェントが生成した変更をコンパイラ、テスト、レビューでどう拘束するかという開発工程の設計です。今回の論考が主に扱うのは後者であり、題名の「vice versa」は、Rustがエージェントを助けるだけでなく、エージェントの登場がRustの言語設計にも新しい要求を返す、という双方向性を表しています。
ここを取り違えると、「RustならAIが安全なコードを書ける」「コンパイルが通れば完成」といった飛躍が起きます。原文はむしろ、テストにも型にも限界があり、最上流の設計をどう表現するかが難題として残る、と明記しています。日本企業が持ち帰るべきなのは、特定言語への全面移行ではなく、エージェントの確率的な出力を検証可能な工程へ変換する考え方です。
3本柱で読む原文の核心
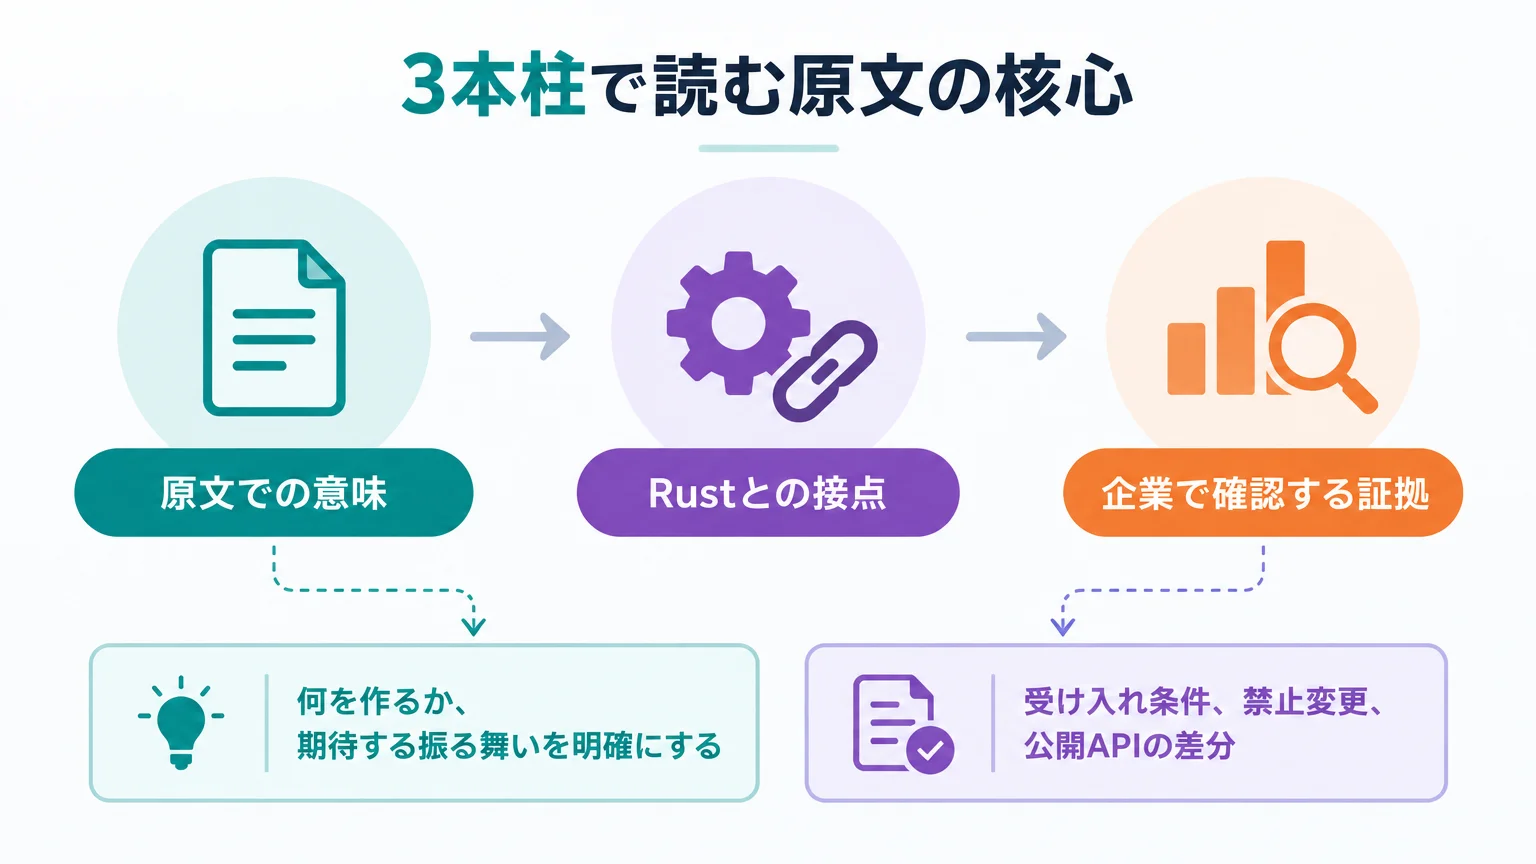
What agents mean for Rust (and vice versa)は2026年10月14日に公開されました。筆者は、この文章をREBASEで行った講演を補うブログ版と位置づけています。REBASEの公式プログラムでは、同講演は2026年10月7日の招待講演として掲載されています。
公開されたのは製品、ベンチマーク、Rustの新バージョンではありません。人間のプログラミング技能と言語設計はエージェント時代にも意味を持つのか、Rustはどこで有利になり、どこを変える必要があるのかを整理した論考です。筆者が置いた土台は、ソフトウェア構築を次の3本柱に分けることでした。
| 柱 | 原文での意味 | Rustとの接点 | 企業で確認する証拠 |
|---|---|---|---|
| 設計 | 何を作るか、期待する振る舞いを明確にする | インターフェース、型、lint、将来の設計言語へ意図を落とす | 受け入れ条件、禁止変更、公開APIの差分 |
| 構築 | 意図した振る舞いをするコードを書く | 所有権、型、コンパイラ診断、テストで誤りの一部を早く拒否する | コンパイル結果、テスト結果、レビュー可能な差分 |
| 最適化 | 必要な実行効率へ調整する | プロファイル結果を基にエージェントが変更案を作り、再計測する | 同一条件の計測、回帰テスト、変更理由 |
重要なのは、原文が「3本とも解決済みではない」としている点です。構築と最適化では機械的なフィードバックを増やしやすい一方、設計では、Markdownの指示を渡してエージェントが従うことを期待するだけの運用が残りがちです。人間の役割が消えるというより、コードを一行ずつ入力する比重が下がり、意図の定義、結果の理解、例外判断の比重が上がる、というのが中心的な見立てです。
「Rustが選ばれる」は実測ランキングではなく仮説
原文はRustをエージェント開発と相性のよい言語だと評価します。ただし、Rustだけが適しているとは述べていません。脚注ではGoにも異なる適合点があると認めています。また、本文中にはRustの伸びを示す第三者の分析が引用されていますが、独立した公式統計ではありません。そのため、ここでは成長率やコード量を一般事実として転記しません。採用判断に使えるのは人気の印象ではなく、自社の変更で検証ループが成立するかどうかです。
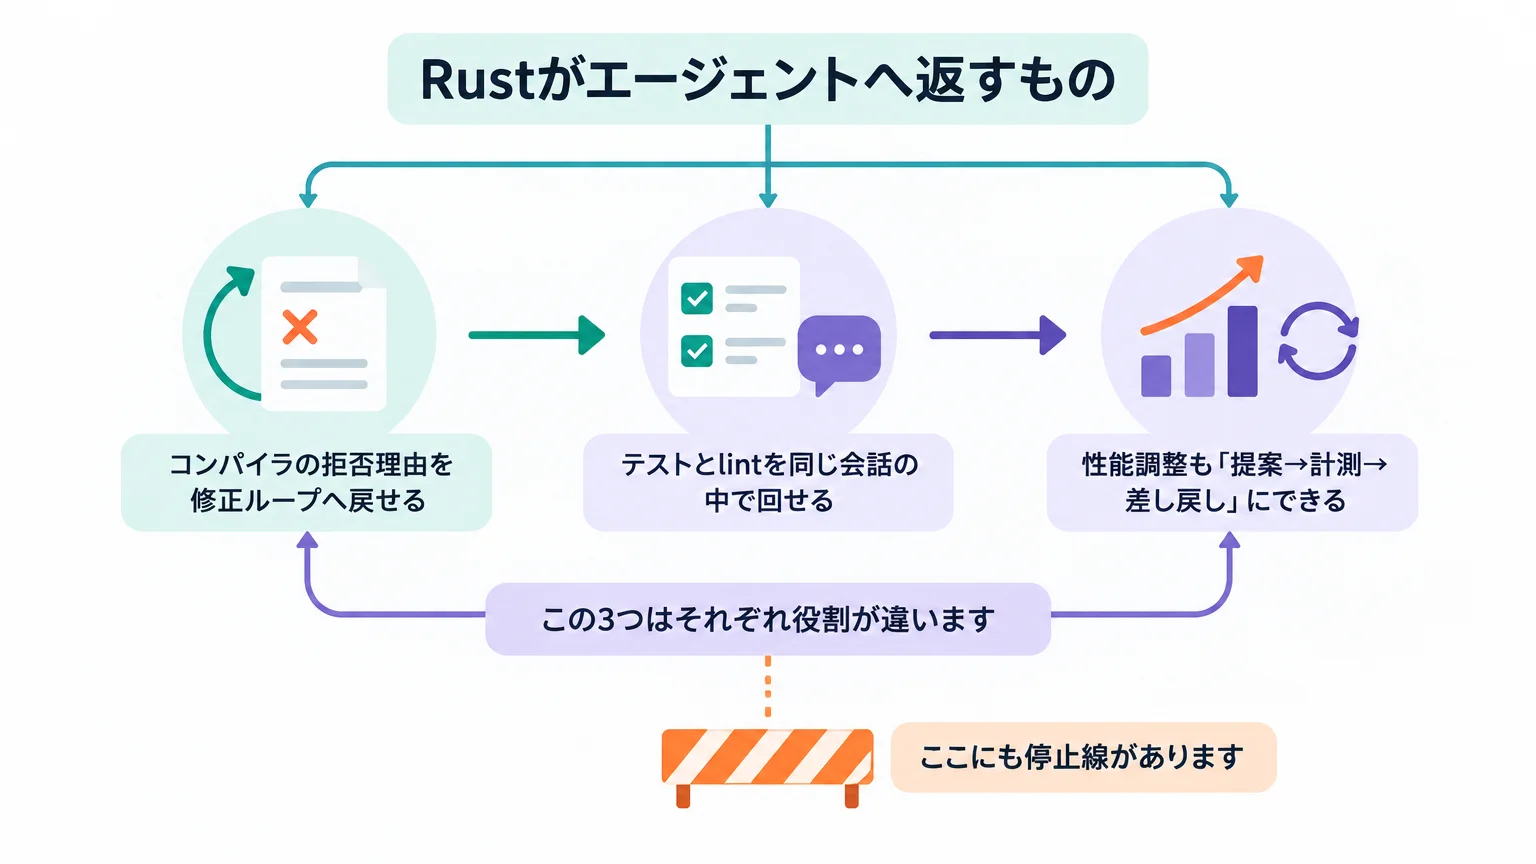
Rustがエージェントへ返すもの
コンパイラの拒否理由を修正ループへ戻せる
Rustの強みとして最も分かりやすいのは、所有権や借用の規則をコンパイル時に検査することです。公式のThe Rust Programming Language「What Is Ownership?」は、所有権規則に違反したプログラムはコンパイルされないと説明しています。可変参照については、References and Borrowingが、特定の値に対する可変参照を同時に1つへ制約する仕組みを説明しています。
コーディングエージェントにとって、これは失敗を具体的な診断として受け取れることを意味します。存在しないフィールド、所有権の移動後の利用、競合する借用など、言語が表現できる範囲の誤りは、実行後の曖昧な不具合ではなく、修正可能なフィードバックになります。人間にとって厳しいコンパイラが、反復を苦にしにくいエージェントには有益な制約として働く、というのが原文の見方です。
ただし「コンパイルできた」と「要求を満たした」は同義ではありません。請求額の計算規則を取り違えたコード、誤った認可条件を忠実に実装したコード、必要なログを欠いたコードでも、型が整っていればコンパイルは通り得ます。Rustが提供するのは、誤りの全消去ではなく、一定の誤りを機械的に拒否できる境界です。
テストとlintを同じ会話の中で回せる
Rustの標準的なツールチェーンには、生成された変更へ短い周期で結果を返せるコマンドがあります。公式のcargo checkは最終コード生成を省いてチェックするため通常のビルドより速い一方、コード生成時だけ見つかる問題は報告されない場合があります。cargo testはユニットテスト、統合テスト、ドキュメントテストを構築・実行します。Clippyの公式利用ガイドは、cargo clippyでlintを実行し、警告レベルを構成する方法を示しています。
この3つはそれぞれ役割が違います。cargo checkは型とコンパイル可能性、cargo testは書かれたテストケース内の振る舞い、cargo clippyは既知のコードパターンを見ます。どれか1つを万能な合格印にせず、証拠を積み重ねることが大切です。
性能調整も「提案→計測→差し戻し」にできる
原文は、Rustが既定で良好な性能を狙いながら、配置、間接参照、ボックス化、低レベル処理まで調整の余地を持つ点を挙げています。エージェントに自由な最適化を頼むのではなく、ベンチマーク、プロファイル、変更案、再計測という閉じたループに入れれば、変更理由を比較できます。
ここにも停止線があります。原文が紹介するのは方向性であり、すべてのRustコードをエージェントが高速化できるというベンチマークではありません。企業の検証では、測定対象、入力、ビルド設定、比較基準を固定できない限り、「速くなった」を採用理由にしない方が安全です。Rustでエージェント基盤を書き換えた個別事例は、AIgent LabのRewriting Prime Agent in Rustの検証記事で、測定対象と一般化できない範囲を分けて確認できます。
エージェントがRustへ要求するもの
題名の「vice versa」はここにあります。エージェントがRustを使いやすくするだけでなく、エージェントが主なコード作成者になると、言語側で重視すべき設計の配分も変わる、という主張です。筆者は、短く書けることより、人間が意図を読み取りやすいこと、機械が検査できる制約を増やすこと、外部ツールを統合しやすくすることへ比重を移すべきだと論じます。
型で防げない正しさは、証明可能な性質へ寄せる
型システムは「してはいけないこと」の一部を除外できますが、「期待した計算結果である」「個人情報をログへ出さない」といった業務・運用上の性質を自動的に証明するものではありません。原文は次の段階として、Verus、Creusot、Aeneas、KaniなどRust向けの検証ツールを挙げます。たとえばKaniの公式リポジトリはRust向けモデルチェッカーとして公開されています。
これらはRust Projectの標準機能でも、任意のコードを全自動で安全にする機能でもありません。対象にできるRustの範囲、記述すべき契約、利用するソルバー、ツールチェーンの固定など、それぞれ前提があります。一般の業務アプリケーションで最初から全面導入するのではなく、境界条件を明文化できる重要処理で適用可能性を調べる、という扱いが妥当です。
「unsafeをなくす」はキーワード廃止ではない
原文は「no more unsafe code」を北極星として提案しますが、同時にunsafeキーワードを一切使わないという意味ではないと説明しています。目指すのは、unsafe部分が未定義動作を起こさないことを証明できる状態です。Rust公式のunsafe keywordリファレンスも、unsafe関数やunsafeブロックを「安全性を証明する義務」として説明しています。
したがって、この記事から「Rustがunsafe廃止を決定した」と読むのは誤りです。現時点で確認できるのは、筆者が証明ツールとの連携を強化する方向を提案したこと、unsafe境界には呼び出し側・実装側が満たすべき条件があることです。企業内では、エージェントがunsafe境界を新設・拡張した場合に自動マージを止め、担当者へ上げるルールへ翻訳できます。
コンパイラ拡張と設計言語は将来構想
筆者は、証明ツールを統合しやすい拡張可能なコンパイラ、インターフェースと実装を分離してレビューしやすくする仕組み、高水準の設計や不変条件を表すモデリング言語に期待を寄せています。人間が高水準の設計を指定し、それを型、lint、証明義務へ変換し、エージェントが実装へ落とす構図です。
魅力的な方向ですが、2026年10月16日時点で、この論考を受けたRust Projectの仕様決定やリリース計画は確認できません。拡張可能なコンパイラや設計言語は著者の提案として扱い、採用予定の公式機能として予算や工程へ織り込まないでください。
公式の動きと個人の提案を混ぜない
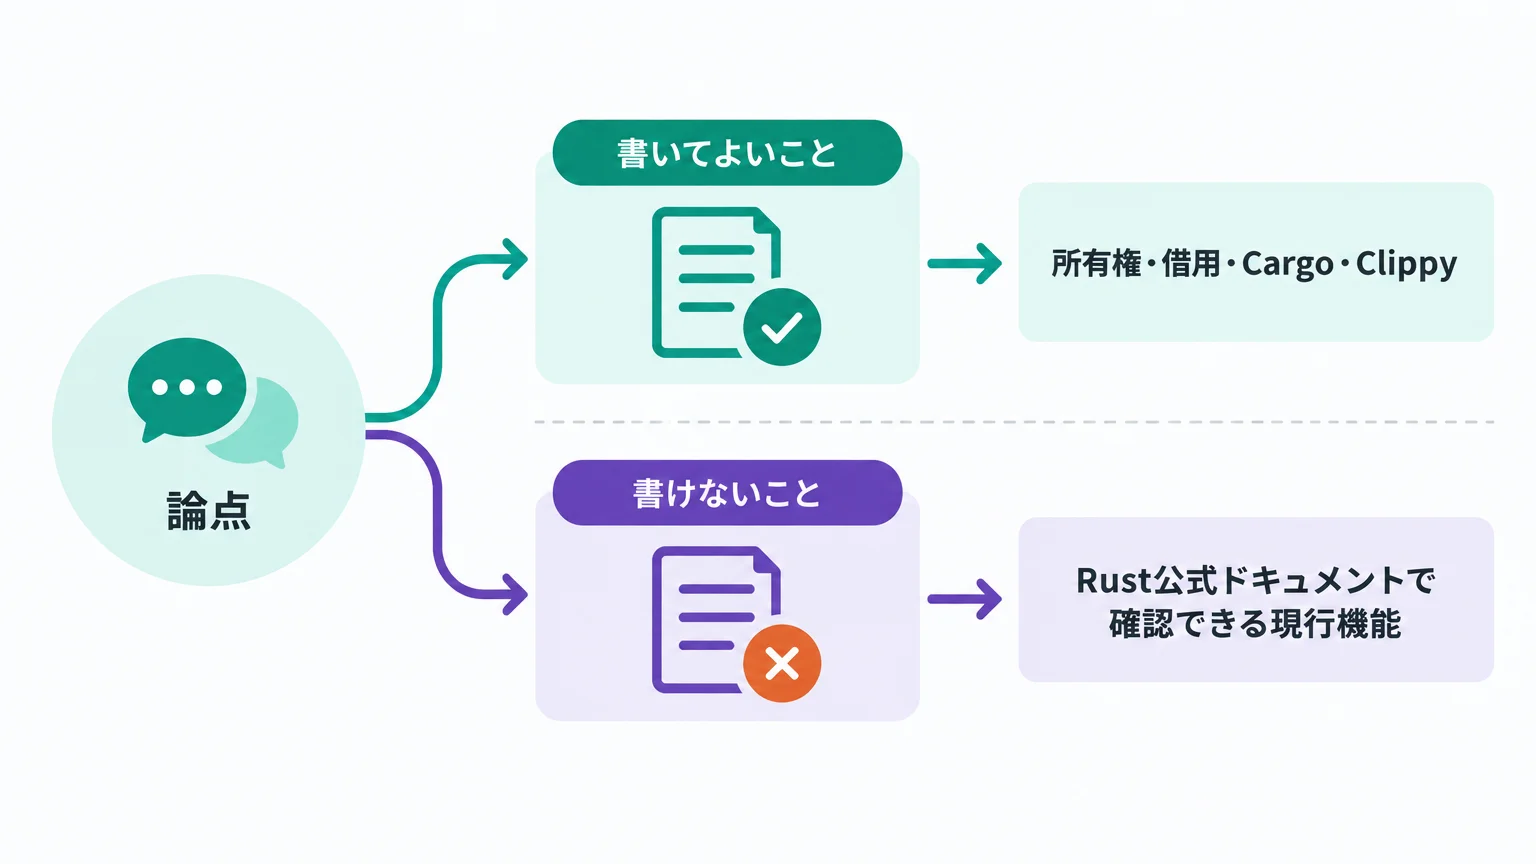
| 論点 | 2026年10月16日時点で確認できる位置づけ | 書いてよいこと | 書けないこと |
|---|---|---|---|
| 所有権・借用・Cargo・Clippy | Rust公式ドキュメントで確認できる現行機能 | 機械検査の入力として利用できる | 業務要件の正しさまで保証する |
| Rust向け証明ツール | 各プロジェクトが公開しているツール群 | 明示した性質の検証を補助できる | Rust標準で自動適用される |
| unsafe without unsafety | 原著者が示した北極星 | 証明可能なunsafe境界を目指す提案 | unsafe廃止が正式決定した |
| 拡張可能なコンパイラ・設計言語 | 原著者の将来構想 | 言語設計上の研究・検討テーマ | 実装時期が決まったRustの正式計画 |
Rust ProjectのLLMポリシーが示す別の現実
言語機能とは別に、Rust ProjectではLLM生成物が生むレビュー負荷への対応がすでに始まっています。2026年8月5日のInside Rust Blogは、5つのチームがrust-lang/rustモノレポ向けのLLM利用ポリシーを採用したと説明しました。公式のLLM Usage Policyでは、LLMレビューは助言にとどまり、人間のレビューや自己レビューを代替できないとしています。LLMが作成したコード変更は条件付きで扱われ、開示やテストなどの要件があります。
このポリシーはRustを利用する全企業へ適用される一般規則ではなく、採用したRust Project内のリポジトリ向けです。それでも、コード生成コストが下がるほど、理解、判断、レビュー帯域が希少になるという運用課題を示す一次情報として参考になります。社内規程へ取り込むなら、文面をコピーするのではなく、誰が生成物を理解し、誰がマージ判断を持ち、どの利用を開示するかを自社の責任分界へ置き換える必要があります。
Rust Foundationが紹介したSymposiumは「文脈を渡す」試み
Rust Foundationは2026年9月25日、Symposiumを扱う公式記事を公開しました。記事は、モデル学習後に追加された言語機能、モデルが知らない社内ライブラリ、チーム固有の慣例が、正しく実用的で慣用的なコード生成を難しくすると説明しています。Symposiumは、依存ライブラリに応じて作者が用意したツールやガイダンスを読み込ませる仕組みとして紹介されています。
これは10月14日の論考への公式回答ではなく、それ以前から進む別プロジェクトです。ただし、モデルを替える前に、必要な文脈と検査手段をエージェントへ渡すという実務上の補助線になります。AIgent Labのコーディングエージェントのハーネス解説も、モデル性能と仕事環境を分けて評価する観点を整理しています。
日本企業の判断軸はコード量より検証可能性
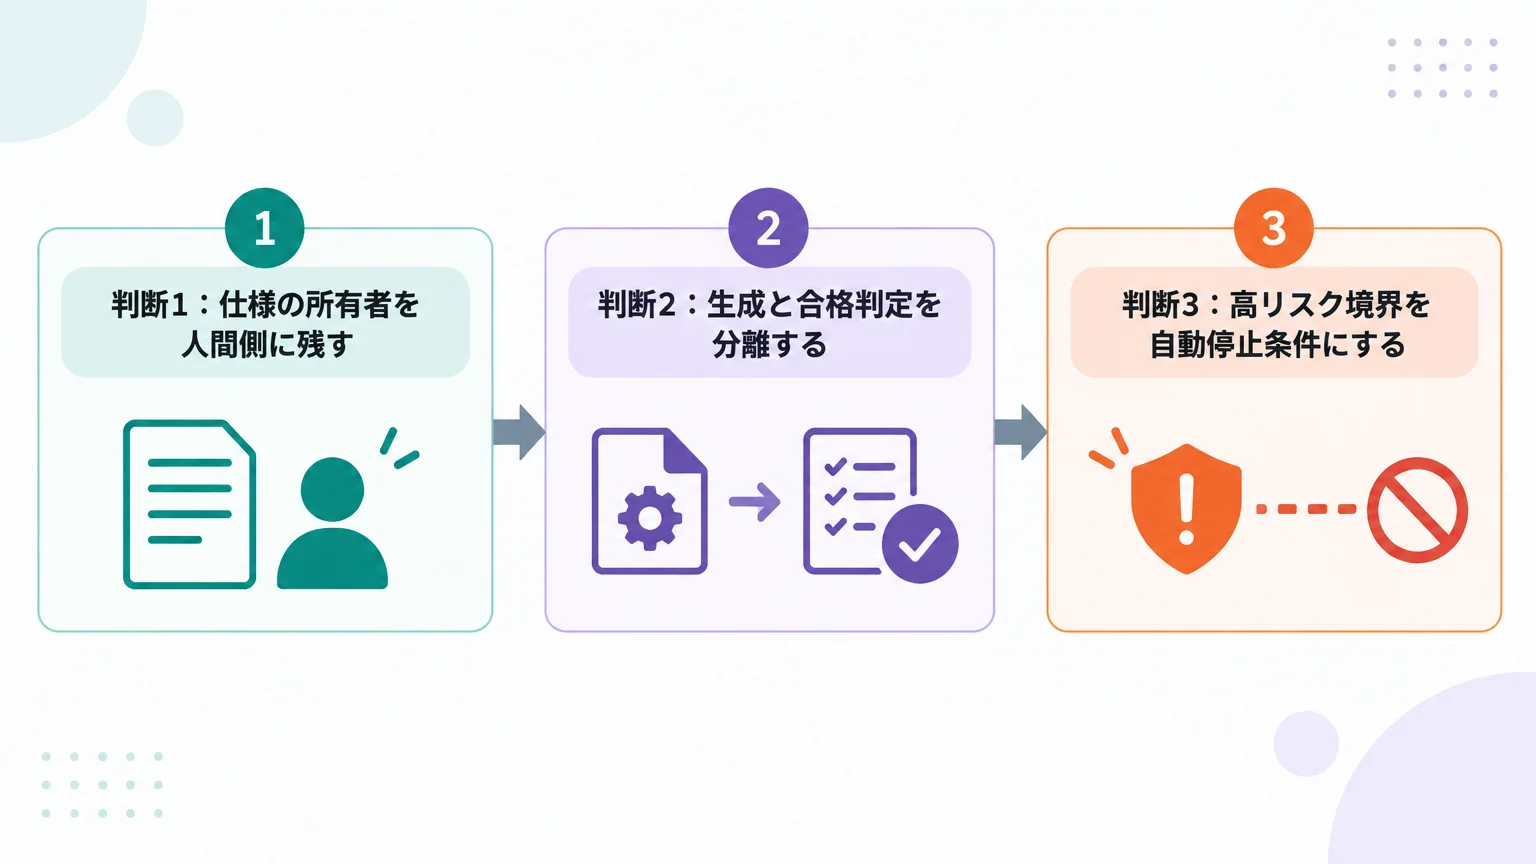
原文を企業運用へ翻訳すると、Rustを採用するかどうかより先に決めるべきことが見えます。エージェントが何行書いたか、何件のPRを出したかは活動量です。業務上必要なのは、意図した変更が完成し、既存契約を壊さず、担当者が根拠を確認して受け入れられることです。コード量と完成成果を分ける考え方は、AI coding agentsでコード量が増えた研究の解説でも確認できます。
判断1:仕様の所有者を人間側に残す
エージェントへ渡す依頼には、変更対象だけでなく、変えてはいけないインターフェース、保持すべき不変条件、失敗時の扱い、確認に使うコマンドを含めます。曖昧な依頼を大量のコードへ変換すると、後から仕様を逆算する負担が増えます。原文が「設計」を未解決の柱として残した理由は、コード生成が速くなっても、正解の定義そのものは自動的に生まれないからです。
判断2:生成と合格判定を分離する
同じエージェントに「実装して、自分で問題ないと判断して」と任せると、見落とした前提が実装と評価の両方へ残ります。コンパイラ、テスト、lintは独立した機械ゲートとして実行し、その結果と差分を人間が見ます。別のレビューエージェントを追加する場合も、最終責任を移すのではなく、指摘候補を増やす用途に限定します。
判断3:高リスク境界を自動停止条件にする
認証・認可、課金、秘密情報、外部公開、データ削除、unsafe、公開API、依存関係の大幅変更は、通常のリファクタリングと同じ自動承認ルールで扱わない方が安全です。Rustの型が強くても、権限設計や業務判断の誤りは残ります。変更ファイル名だけでなく、公開インターフェース、権限、データの流れが変わったかを停止条件にします。
リポジトリ1つで試す判定順
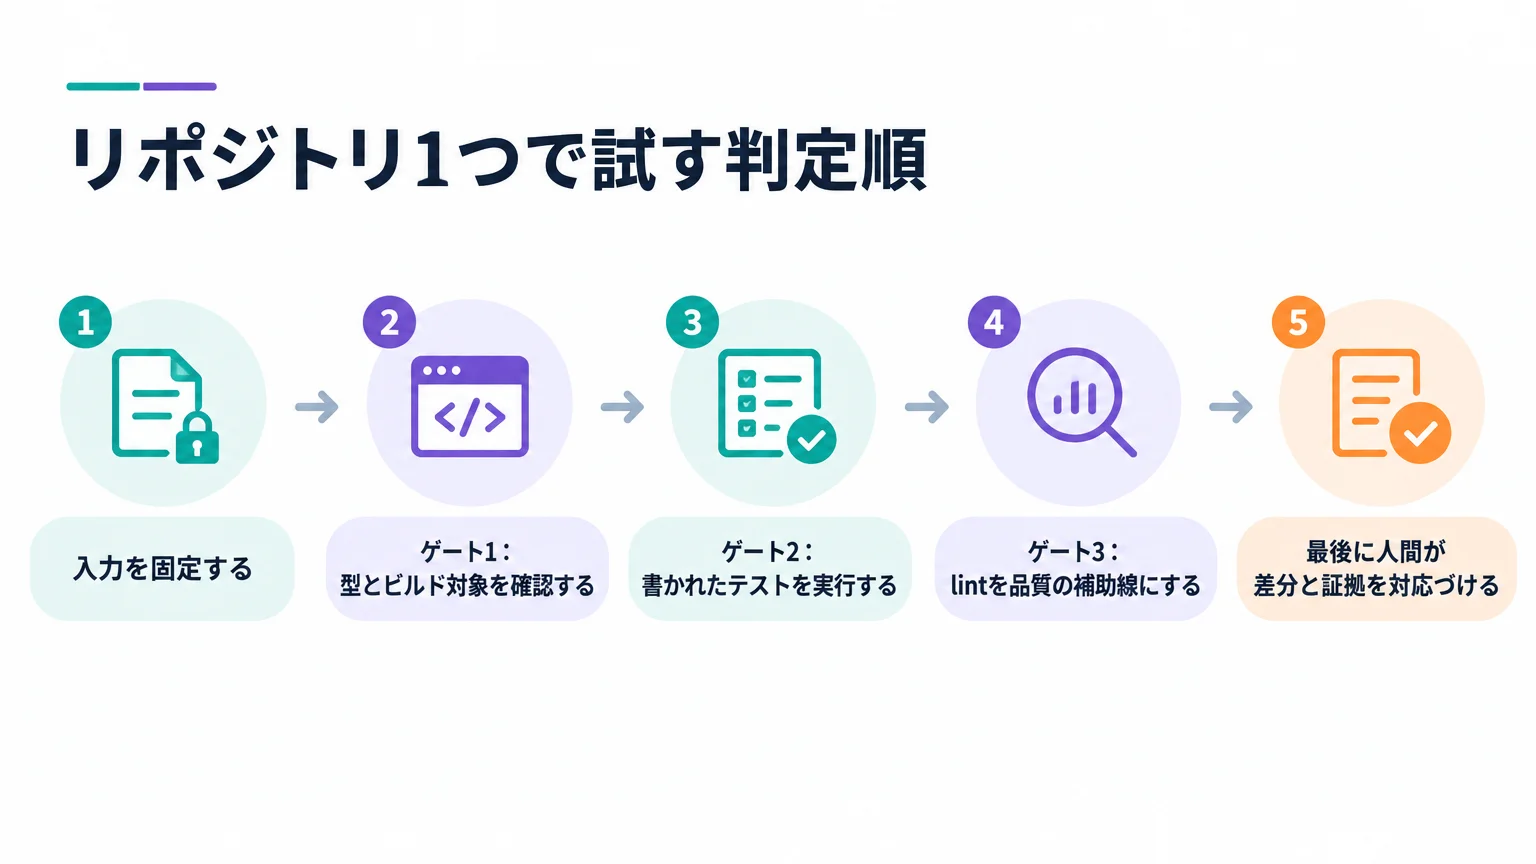
導入検証は、全社の開発標準を変えることから始める必要はありません。破棄可能なブランチ上で、対象リポジトリを1つ、変更種類を1つに限定します。候補は、既存テストの追加、内部リファクタリング、診断メッセージの改善など、受け入れ条件を説明しやすい作業です。認証、決済、削除処理、unsafe境界は最初の対象から外します。
入力を固定する
- 変更したい振る舞いと、変更しない振る舞いを別々に書く
- 触れてよいディレクトリと、触れてはいけないファイルを指定する
- 公開API、エラー形式、性能条件など、レビュー対象を先に列挙する
- 完了報告には実行したコマンド、終了状態、未確認範囲を含める
ゲート1:型とビルド対象を確認する
最初に、テスト用プロファイルを含む全ターゲットをチェックします。公式ドキュメントが示す通り、cargo checkは最終コード生成を省くため、この結果だけで最終的なビルド成功とは判断しません。
動作環境:Rust stable toolchain、Cargo。対象リポジトリの依存関係を取得済みであること。
cargo check --all-targets --profile=test注意:本番環境で使用する前に、必ず隔離したテスト環境で動作確認してください。失敗時はエージェントへログ全文を渡す前に、秘密値や社内パスが含まれていないか確認します。
ゲート2:書かれたテストを実行する
次に、ユニットテスト、統合テストなど、リポジトリが持つテストを実行します。テストが存在しない要求は、先に期待結果をテストまたはレビュー可能な受け入れ条件へ変換します。
動作環境:Rust stable toolchain、Cargo。外部サービスを呼ぶテストはモックまたは検証用環境へ切り替えること。
cargo test --all-targets注意:この--all-targetsの例はドキュメントテストを含まないため、ドキュメント内のコード例も対象にする場合はcargo test --docを別に実行します。通過は「用意されたテストケースで失敗しなかった」ことを示します。存在しないケースや誤った期待値までは保証しません。エージェントが追加したテストは、実装と同じ誤解を共有していないか人間が確認します。
ゲート3:lintを品質の補助線にする
Clippyで警告を確認し、CIで警告をエラーとして扱う例です。既存リポジトリに警告が残っている場合は、いきなり全体を失敗させず、今回の差分で新しい警告を増やさない運用から始めます。
動作環境:Rust stable toolchain、Cargo 1.97以降、Clippyコンポーネント。
CARGO_BUILD_WARNINGS=deny cargo clippy --all-targets --all-features注意:lintは業務仕様のレビューを代替しません。誤検知やプロジェクト固有の許容もあるため、抑制する場合は理由を差分に残します。本番環境で使用する前に、必ずテスト環境で動作確認してください。
最後に人間が差分と証拠を対応づける
| 確認対象 | 主な証拠 | 人間が判断すること |
|---|---|---|
| 型・所有権 | cargo checkの終了状態 |
対象範囲が十分か、コード生成を伴うビルドも必要か |
| 振る舞い | cargo testの結果と追加ケース |
要求の重要な例外がテストへ入っているか |
| 既知のコードパターン | cargo clippyの結果 |
抑制理由が妥当か、差分外の警告を混同していないか |
| 設計・権限・公開面 | 差分、API変更、設定変更 | 意図、責任境界、ロールバック方法が明確か |
継続判断では、生成行数ではなく、受け入れまでの経過、再作業の理由、レビュー待ち、検査失敗の種類を残します。数回成功しただけで全社標準へ広げず、同じ変更種類で再現できること、担当者が証拠を読めることを確認してから対象を増やします。
エージェント運用を壊す3つの思い込み
思い込み1:コンパイルが通れば正しい
❌ 誤り:Rustは型が強いので、コンパイル成功をそのままマージ条件にする。
⭕ 修正:コンパイラは所有権や型など、言語が表現した規則を検査します。業務ロジック、期待した入出力、権限、運用上の禁止事項は、テスト、仕様、レビューで別に確認します。
なぜ重要か:原文自身が、型システムは「正しいことをしている」とまでは示さないと留保しています。強いガードレールと最終目的の達成を分けることが、過信を防ぎます。
思い込み2:生成が速ければ開発全体も速い
❌ 誤り:エージェントが多数のPRを作れば、そのままチームの成果が増える。
⭕ 修正:変更種類、同時進行数、レビュー担当、却下条件を先に決めます。レビュー待ちや再作業を含む受け入れまでの流れで評価します。
なぜ重要か:Rust Projectの公式LLMポリシーを説明する記事も、コードを書きやすくなることで既存のレビュー帯域問題が悪化すると指摘しています。生成側だけを高速化すると、判断側へ負荷が移ります。
思い込み3:証明ツールを入れれば自動で安全になる
❌ 誤り:VerusやKaniなどを導入すれば、エージェント生成コード全体の安全性が証明される。
⭕ 修正:何を証明するのか、対象コードがツールの範囲に入るか、前提条件が正しいかを専門担当者が決めます。重要な境界へ限定し、通常のテストとレビューも残します。
なぜ重要か:証明は、定義した性質と前提に対して力を発揮します。誤った仕様を正しく証明しても、業務上の正解にはなりません。
コミュニティが挙げた反論と補助線
Hacker Newsの議論では、Rustの制約をエージェント向けの利点とみる意見だけでなく、コンパイル時間、学習データ、慣用的なAPI利用、人間の理解を問題にする意見も出ています。以下は公式見解やベンチマークではなく、参加者個人の経験・意見です。ポイント数とコメント数は取得時刻で変動するため、評価根拠には使いません。
- コンパイル時間を弱点とするコメントは、エージェントが高速に反復するほど待ち時間が目立つと指摘しました。型の強さだけでなく、フィードバックが返るまでの時間も測る必要があります。
- 言語特性を分解したコメントは、診断の有用性、コンパイル速度、実行効率、学習データとの親和性、標準的な書き方、明示的な型などを評価軸として挙げ、Rustがすべてを満たすわけではないと整理しました。
- Rust固有の優位性に懐疑的なコメントは、研究を探したものの、言語特性とエージェント性能の強い相関を示す証拠を見つけられなかったと述べました。これは個人の探索結果であり、証拠不足を確定する研究レビューではありません。原文の主張を普遍的な性能事実ではなく、検証すべき仮説として扱う補助線になります。
日本企業の検証では、この反論を「Rustを使わない理由」ではなく測定項目へ変換できます。型エラーの修正回数、チェック待ち、CPU・メモリの競合、レビュー待ち、APIの誤用、テストで初めて見つかった問題を分けて記録すれば、自社環境でRustのガードレールが反復コストを上回るか判断できます。比較対象を置く場合も、同じ課題、同じ受け入れ条件、同じレビュー基準を使います。
よくある質問
Q1. What agents mean for Rust (and vice versa)は何を意味しますか?
AIエージェントがRustコードを書く時に、型・所有権がガードレールとなり、プロファイラと性能調整の余地が最適化ループを支えるという一方向と、エージェントが主なコード作成者になることで、Rust側にも証明、コンパイラ拡張、人間が理解しやすい設計表現が求められるという逆方向を指します。
Q2. RustでAIエージェントを作る話ですか?
主題は「エージェントにRustを書かせること」と、その変化がRustの言語設計へ与える影響です。Rustを使ってエージェント本体を実装する話と接点はありますが、同じ検索意図ではありません。
Q3. RustはAIコーディングに最適な言語だと証明されましたか?
証明されていません。原文は著者の論考で、Rustの利点を説明しつつ、Rustだけが適合するとはしていません。企業では、自社のリポジトリと作業種類を固定し、反復時間、検査結果、レビュー負荷で比較する必要があります。
Q4. コンパイルが通ればエージェントのコードをマージできますか?
できません。コンパイル成功は重要な証拠ですが、業務仕様、権限、例外処理、性能、運用条件を満たした証拠にはなりません。テスト、lint、差分レビュー、必要に応じた計測を組み合わせます。
Q5. 「no more unsafe code」はunsafeの禁止ですか?
違います。原文は、unsafeキーワードを使わないという意味ではなく、unsafeコードが未定義動作を起こさないことを証明可能にする北極星だと説明しています。現行Rustの正式な廃止方針ではありません。
Q6. 証明ツールは最初の検証から必須ですか?
必須ではありません。まずは要求、cargo check、cargo test、cargo clippy、人間レビューの対応を安定させます。証明したい性質を明確に定義でき、通常のテストだけでは不足する重要境界がある場合に、各ツールの対応範囲を確認します。
Q7. 日本企業はどこから始めればよいですか?
対象リポジトリを1つ、変更種類を1つに絞り、触れてよい範囲、禁止変更、検査コマンド、人間の承認者を先に決めます。生成行数ではなく、受け入れまでの証拠と再作業理由を残してください。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- What agents mean for Rust (and vice versa) — baby steps、2026年10月14日公開(参照日:2026年10月16日)
- REBASE Industry Track — SPLASH/ISSTA 2026公式プログラム(参照日:2026年10月16日)
- What Is Ownership? — The Rust Programming Language公式ドキュメント(参照日:2026年10月16日)
- References and Borrowing — The Rust Programming Language公式ドキュメント(参照日:2026年10月16日)
- cargo check — Cargo公式リファレンス(参照日:2026年10月16日)
- cargo test — Cargo公式リファレンス(参照日:2026年10月16日)
- Clippy Usage — Rust公式ドキュメント(参照日:2026年10月16日)
- The unsafe keyword — The Rust Reference(参照日:2026年10月16日)
- rust-lang/rust is adopting an LLM policy — Inside Rust Blog、2026年8月5日公開(参照日:2026年10月16日)
- LLM Usage Policy — Rust Forge公式ポリシー(参照日:2026年10月16日)
- Your AI Agent is Writing Rust… But Is It Good? — Rust Foundation、2026年9月25日公開(参照日:2026年10月16日)
- Kani Rust Verifier — Kani公式リポジトリ(参照日:2026年10月16日)
- Hacker News discussion — コミュニティの反応として参照。事実根拠には不使用(参照日:2026年10月16日)
最後に確認すべきこと
「What agents mean for Rust (and vice versa)」の価値は、Rustを無条件に推すことではありません。エージェントがコードを書く時代に、設計・構築・最適化を分け、型、テスト、lint、計測、証明、人間レビューをどう接続するかという判断枠を示した点にあります。
- これはRust Projectの機能発表ではなく、2026年10月14日公開の個人論考である
- 型は誤りの一部を拒否するが、業務上の正しさ全体を保証しない
- unsafeの廃止ではなく、unsafe境界を証明可能にする構想である
- 導入判断は生成量ではなく、検査結果、レビュー負荷、再作業で行う
- 検証は対象と変更種類を限定し、人間の承認責任を残す
関連する具体例として、Rustへ書き換えたエージェント実装の事例、コーディングエージェントのハーネス設計、コード量と完成成果を分ける評価もあわせて確認できます。
この記事はAIgent Lab編集部がお届けしました。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。