2026年10月16日時点で、Neckbeardは3クラウド×2つのCI基盤×2つの実行方式、計12経路を対象に、AIエージェントがレビュー可能なインフラ構成、CI/CD、費用見積もりを作るためのプレアルファ版プラグインです。ただし、12経路すべてで本番デプロイが実証済みという意味ではありません。公式のv0.3.0 READMEは、全12経路で静的検証を行う一方、実クラウドでデプロイ・更新・ロールバックまで確認できたのはAWS/GitHub/サーバーレスとAzure/GitHub/サーバーレスの2経路だと説明しています。
- 何が公開されたか:アプリを分析し、人が管理するOpenTofuモジュール群へ要件を割り当て、計画・費用・生成物・検証結果を出すエージェント用プラグインとGo製CLIです。
- 日本企業との関係:AIにIaCを自由生成させず、承認済みの部品、根拠付きの入力、差分レビューへ寄せる設計は、プラットフォーム標準をAIエージェントへ渡す考え方として参考になります。
- 最初の判断:本番導入候補ではなく、隔離した検証用リポジトリで「対応するワークロードか」「未検証項目が何か」を確かめる段階です。
Hacker Newsで話題になった「Neckbeard – A DevOps/platform/SRE plugin for your agent」は、AIがSRE担当者の代わりに本番障害を自律復旧する製品ではありません。現時点の中心は、アプリケーションの構成を読み取り、定められたモジュールカタログからインフラの設計図とファイルを作り、費用と検証範囲を人がレビューできる状態にすることです。
この違いは重要です。「AIにクラウドを任せる」という言葉だけを見ると、エージェントがAWSやGCPへ自由にリソースを作る印象を持ちやすいからです。Neckbeardが狙っているのは逆で、モデルが判断する範囲を分析・質問・説明へ絞り、計画・レンダリング・検証は決定論的なCLIへ渡すことです。
以下では、2026年10月16日に公式リポジトリ、v0.3.0のリリース、設計文書、検証計画を照合したうえで、何が使えるのか、何がまだ証明されていないのか、日本企業がどこから検証すべきかを整理します。
Neckbeardで公開されたのは「自由生成しない」インフラ作成フロー
Neckbeardは、コーディングエージェントにDevOps、プラットフォーム、SREの知識を追加するプラグインと、その指示を受けて処理するGo製CLIで構成されています。公式のNeckbeard operating manualは、役割分担を明確にしています。エージェントはリポジトリを観察し、事実と推測を区別し、不明点を人へ質問します。何を構築するかの確定、ファイル生成、検証、費用見積もりはCLIが担います。
| 処理 | 生成・確認するもの | 人が見るべき点 |
|---|---|---|
analyze |
根拠付きのapp-profile.yamlと未解決の質問 |
事実のファイル・行番号、推測の確度、未回答の前提 |
plan |
カタログの版と入力を固定したblueprint.yaml |
クラウド、リージョン、実行方式、データストア、構成差分 |
estimate |
月額見積もり、前提、価格を付けられない項目 | 利用量の仮定、未価格項目、想定した構成が予算に合うか |
scaffold |
OpenTofu、CI/CD、Kubernetes用ファイル、運用手順 | 所有範囲、既存編集との競合、Pull Requestの差分 |
validate |
PASSED/FAILED/NOT EXERCISEDの検証結果 | 何を証明できたかと、実行していない検証 |
ここでのポイントは、Neckbeardが「モデルに上手なTerraformを書かせるプロンプト集」ではないことです。対応するインフラは、リポジトリ内のバージョン管理されたOpenTofuモジュールカタログに限定されます。必要なRedisなどがカタログ外なら、似たモジュールをAIが作るのではなく、未対応項目として止める設計です。
対象は3クラウド、2つのCI、2つの実行方式
公式READMEが示す対象は、AWS・Google Cloud・Microsoft Azure、GitHub Actions・GitLab CI、サーバーレスコンテナ・Kubernetesの組み合わせです。掛け合わせると12経路になります。サーバーレス側はECS on Fargate、Cloud Run、Azure Container Apps、Kubernetes側はEKS、GKE、AKSです。
最初のワークロード契約も狭く定義されています。基本形は1つのコンテナイメージ、HTTP・worker・cronを合計最大10プロセス、PostgreSQL、オブジェクトストレージ、シークレットです。これは弱点を隠した制限ではなく、生成可能な範囲を明示するための境界です。既存の複雑な基盤へそのまま当てはまるとは限りません。
v0.3.0は2026年10月16日(JST)に公開
v0.3.0の公式リリースが記録する公開時刻は2026年10月15日15時26分(UTC)、日本時間では10月16日0時26分です。変更点として、環境ごとの予算通知、見積もりが上限を超えた場合に処理を拒否する仕組み、Docker Composeのイメージからデータストア機能を対応付ける分析、Ponytailとの併用についての文書化が挙げられています。ライセンスはApache-2.0です。
一方、版番号が付いたことと本番利用の成熟度は別です。READMEは現在地を「Pre-alpha」とし、プラグインの主な価値を分析、費用見積もり、スキャフォールド、静的検証、ブートストラップ手順までと位置付けています。
AIと決定論的CLIを分ける仕組み
事実・推測・前提・人の回答を混ぜない
neckbeard analyzeはDockerfile、公開ポート、環境変数、ヘルスチェック、Procfileなどを読み、アプリのプロフィール案を作ります。公式スキルでは、事実にはファイルと行番号、推測には確度と理由、未確認の既定値には前提、人が答えた内容には確認済みの回答を持たせるよう求めています。データベースクライアントが見つかっただけで、PostgreSQLを新規作成してよいとは判断しません。
これは日本企業のエージェント運用でも重要な考え方です。「コードから観測できたこと」と「可用性、停止許容時間、既存DBを使うか、といった事業判断」を同じ入力にしないことで、AIの推測がそのままクラウド契約へ変わるのを防ぎやすくなります。
blueprint.yamlが再現可能な設計図になる
公式の設計文書では、プロフィール、設定、環境情報、固定したカタログ版からblueprint.yamlを作り、同じ入力なら同じバイト列を生成する構成が説明されています。設計図には利用するモジュールの版と具体的な入力が入り、生成ファイルはその設計図の純粋な出力として扱われます。
この分離により、Pull Requestで見るべき対象が整理されます。人は、AIの文章を信じるのではなく、前提が確定しているか、カタログ版が何か、設計図の差分は何か、生成されたIaCが組織の基準に合うかを確認できます。
人が触ったファイルを黙って上書きしない
Neckbeardは生成ファイルのパス、設計図のハッシュ、内容のハッシュを所有情報として記録します。再生成時に利用者が編集したファイルを見つけると、元ファイルを上書きせず、別名の新しい生成物を出して処理を止める契約です。これにより「エージェントをもう一度動かしたら手修正が消えた」という事故を防ぐ方向へ寄せています。
ただし、これはコンフリクトを自動解決する仕組みではありません。変更の意図を、利用者が管理するファイルや許可されたオーバーライドへ移す判断は人に残ります。
費用を先に見る設計はFinOpsの判断材料になる
Neckbeardはスキャフォールド前にInfracostで見積もりを作り、利用量の前提、アイドル時の基準、低・想定・高のシナリオ、価格を付けられないリソースを示す方針です。公式のインストール文書によると、計画とスキャフォールド自体には追加ツールやクラウド認証情報は不要です。費用見積もりにはInfracost 0.10.xとログインが必要で、足りないツールはdoctorが報告します。
v0.3.0では、費用に関する2つの制御が分けられています。
| 設定 | 役割 | 誤解しやすい点 |
|---|---|---|
monthly_budget_alert |
環境ごとのクラウド予算通知を生成する | 通知であり、支出そのものを停止する上限ではない |
monthly_ceiling |
想定総額が指定上限を超える場合に見積もりやスキャフォールドを拒否する | 実請求額を保証するものではなく、見積もり前提の上限判定 |
日本企業で見るべきなのは、表示された合計だけではありません。対象リージョン、稼働量、環境数、ログ保持、データ転送、価格未取得リソースが見積もりにどう入っているかを確認してください。見積もりはアーキテクチャ判断の入力であり、請求額の保証ではありません。
12経路対応と本番での実証は分けて読む
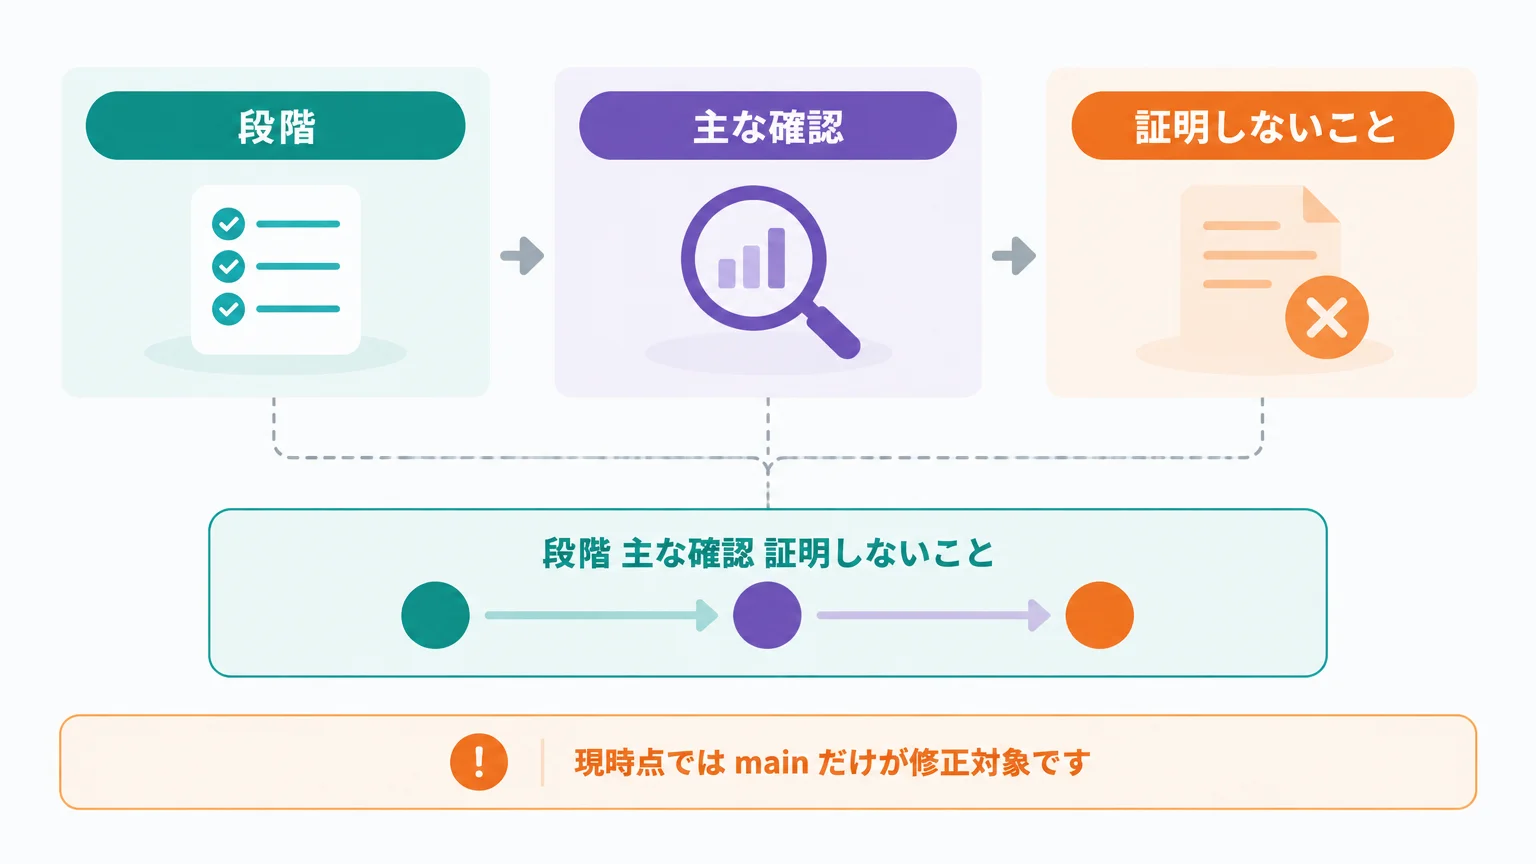
Neckbeardの評価で最も間違えやすいのが、「12経路の静的マトリクスがCIで通る」と「12経路が実クラウドで運用できる」を同じ意味にすることです。公式設計は検証をV0、V1、V2に分けています。
| 段階 | 主な確認 | 証明しないこと |
|---|---|---|
| V0 static | OpenTofuの形式・構文、ポリシー、Kubernetesマニフェスト、CI定義 | 実アカウントでの解決、クォータ、実際のデプロイ、稼働後の挙動 |
| V1 authenticated plan | 実クラウド認証を使ったplan、参照先、権限エラーの一部 | applyの成功、アプリの正常性、本番条件 |
| V2 deployment verification | 隔離環境への適用、ヘルス確認、更新、ロールバック、後片付け | 個別企業の本番環境での適合性 |
公式Launch planは、完全なライフサイクル受入れを0/12と記録しています。AWS/GitHub/サーバーレスとAzure/GitHub/サーバーレスには実クラウドでのデプロイ、更新、ロールバックに関する相当の証跡がありますが、どちらも全受入れ項目を完了したとはしていません。GCP、GitLab側のアプリ配備、Kubernetes、昇格、復旧訓練などには未完了項目があります。
詳細なデプロイ検証記録も、直接実行したcronの確認とスケジュール起動の証明を分けるなど、確認できた範囲を限定しています。この姿勢は信頼できますが、同時に「未実施の検証が多い」ことを意味します。
セキュリティサポートにもプレアルファの条件がある
公式Security policyは、プロジェクトが1.0未満で、保守はベストエフォート、担当者を常設した応答時間保証はないと明記しています。現時点ではmainだけが修正対象です。企業の本番基盤へ取り込むなら、社内で保守する範囲、更新監視、脆弱性対応、撤退手順を別に決める必要があります。
日本企業で効くのはツールより「標準をカタログに閉じ込める」発想
Neckbeardをそのまま採用するかどうか以上に、日本企業にとって参考になるのは、AIエージェントへ自由なクラウド権限を渡すのではなく、プラットフォームチームが検証した構成だけを選ばせる設計です。社内標準のネットワーク、ID、ログ、暗号化、バックアップ、予算通知をモジュール化できれば、AIの役割を「新しい基盤を考案する人」から「アプリ要件を標準へ割り当て、根拠と差分を説明する人」へ変えられます。
合いやすい検証対象
- コンテナ化済みで、HTTP、worker、cron、PostgreSQL、オブジェクトストレージという対応範囲に収まる新規アプリ
- クラウド構成を新しく作る前に、候補アーキテクチャと費用前提をPull Requestで比較したいチーム
- プラットフォーム担当が、AIエージェントに許す構成をカタログとして管理する方式を試したい組織
- 本番権限を与えず、分析・計画・生成・V0検証までの品質を確認したいチーム
慎重に判断すべき環境
- 既存の複数アカウント、Transit Gateway、複雑なIAM境界、独自の監査基盤を前提とする大規模環境
- Redis、キュー、MySQL、MongoDB、GPUなど、現行カタログ外の依存が中核にあるアプリ
- 組織やランディングゾーンの新設まで一括で任せたいケース。公式READMEでは、この領域は設計済み・未実装です
- V0の静的検証だけで、本番デプロイ可能だと承認してしまう運用
また、エージェントが行った分析、入力、生成、検証結果を後から追えるようにする必要があります。記録項目はAIエージェントの監査ログ設計、クラウドやCIへの権限設計はAIエージェントのシークレット・認証情報管理もあわせて確認してください。
コミュニティの反応は「抽象化」と「費用」に集中
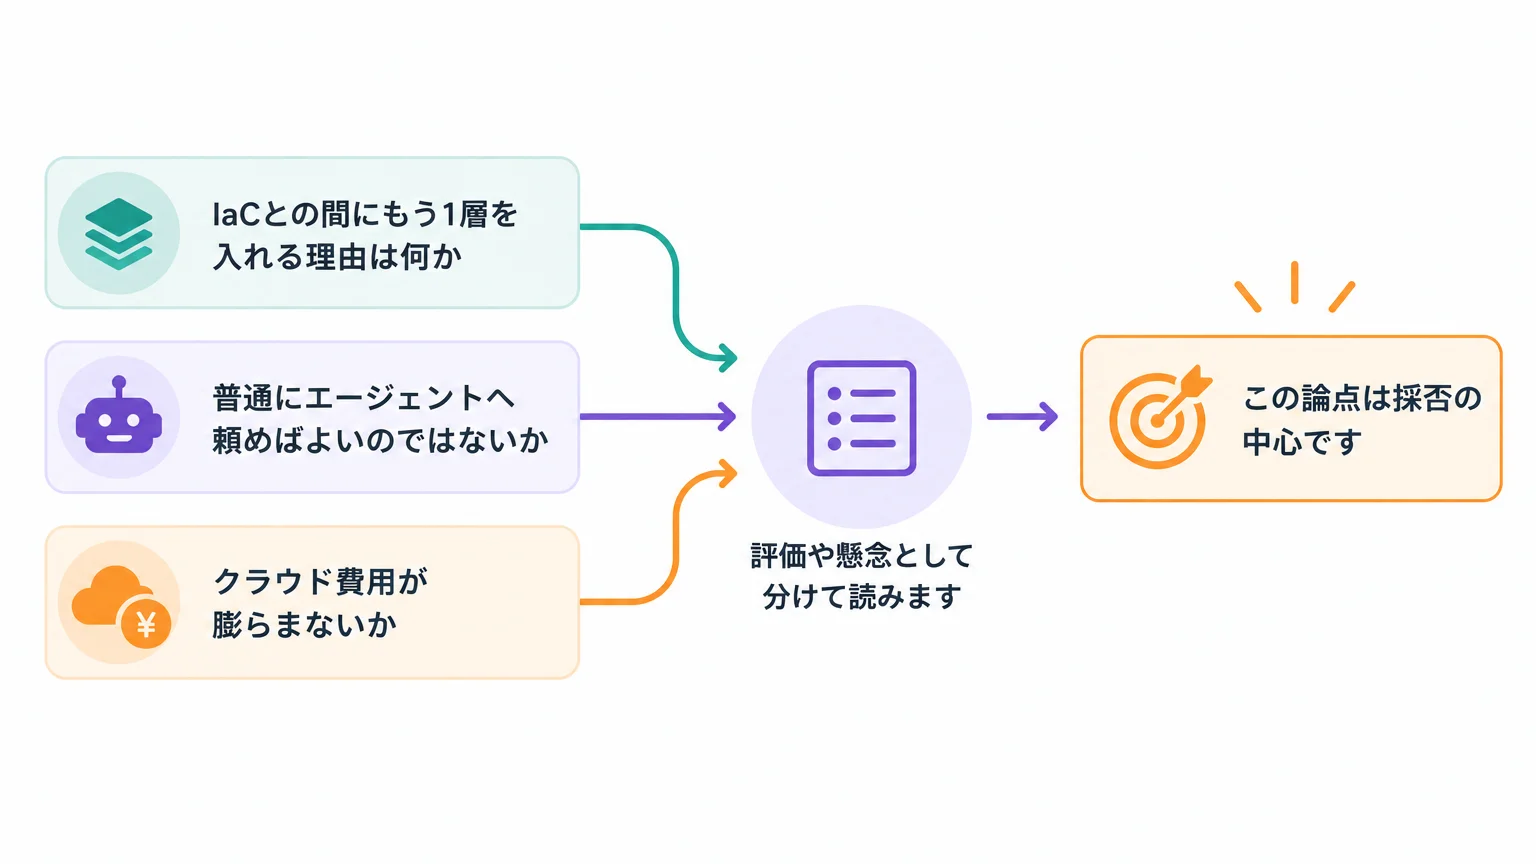
以下は公式仕様ではなく、Hacker Newsの投稿に寄せられたコミュニティの反応です。評価や懸念として分けて読みます。
「IaCとの間にもう1層を入れる理由は何か」
あるコメントは、Terraform/HCL、plan、実環境の間に新しい抽象化層を入れる必要性を問いかけました。作者は返信で、Neckbeardは参照アーキテクチャを持つ意見の強い仕組みであり、LLMに不足するアーキテクチャとFinOpsの判断を注入する狙いだと説明しています。
この論点は採否の中心です。すでに成熟した社内モジュール、レビュー手順、費用管理がある企業では、Neckbeardを追加する価値より、既存標準との二重管理が重くなる可能性があります。逆に、標準構成をこれから用意する小規模チームでは、制約が初期値として役立つことがあります。
「普通にエージェントへ頼めばよいのではないか」
別のコメントは、プラグインを入れずにエージェントへ直接依頼できると指摘しました。作者は回答で、目的はOpenTofuの意見の強いライブラリを使い、エージェント単体にはない設計上の制約を与えることだとしています。
つまり比較対象は「AIを使うか使わないか」ではありません。「モデルが毎回IaCを自由生成するか」「承認済みカタログから決定論的に生成するか」の違いです。
「クラウド費用が膨らまないか」
費用急増を心配するコメントもありました。作者は返信で、LLMに直接構築させる仕組みではないと指摘しています。事前見積もりとカタログ制約を置く設計は、公式READMEで確認できます。ただし、仕組みがあることと費用超過が起きないことは同義ではありません。見積もりの対象外、実利用量、ログ・転送、残存リソースを人が確認する必要があります。
また作者は、OpenTofuとAnsibleを自分で管理できる利用者には不要な場合があり、現在はコンテナ/サーバーレス寄りだと説明しています。大規模な既存基盤の万能な置き換えとして評価しないほうが、プロジェクト自身の説明に合っています。
導入検証は本番権限を与えずに始める
最初の検証では、成果を「デプロイできたか」だけにしないでください。アプリ分析の根拠が正しいか、未回答の前提で停止するか、カタログ外の依存を無理に置き換えないか、同じ入力で同じ生成物になるか、V0の未実施項目を正直に表示するかを確認します。
Claude Codeでは2つのプロンプトで追加する
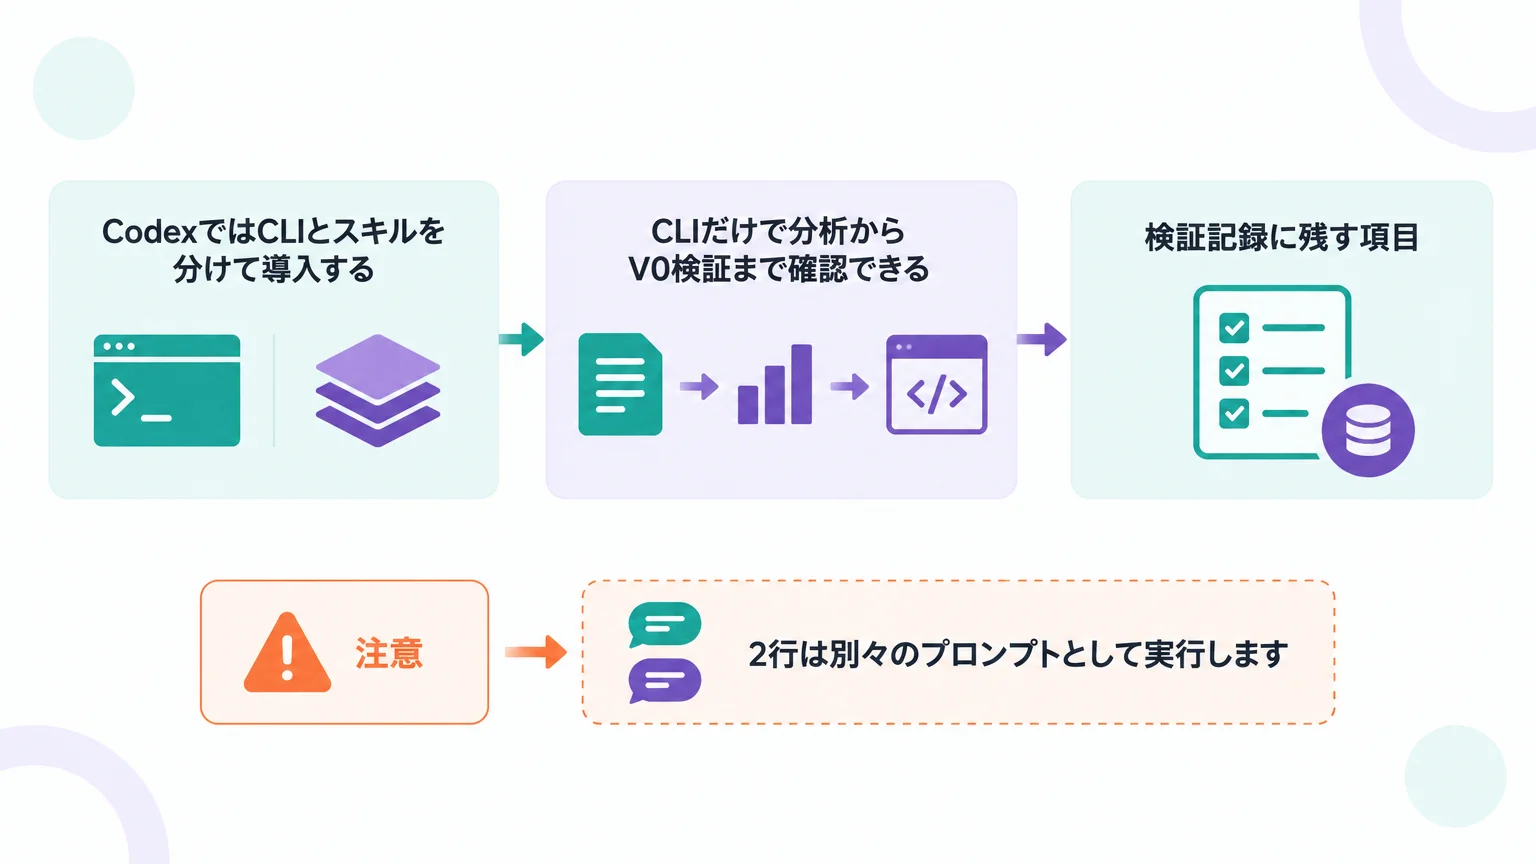
公式INSTALL.mdに記載されたClaude Code向けの導入コマンドは次のとおりです。2行は別々のプロンプトとして実行します。組織で許可された検証端末とテスト用リポジトリに限定し、導入前にリリースとチェックサムを確認してください。
/plugin marketplace add bealesh/neckbeard
/plugin install neckbeard@neckbeard追加後は、対象リポジトリで/neckbeard:doctorを先に実行し、ツール不足と検証可能な範囲を確認してから/neckbeard:analyzeへ進みます。
CodexではCLIとスキルを分けて導入する
Codex CLI向けに公式文書が示す手順は次の2行です。@latestは将来別の版を取得する可能性があるため、企業検証では取得した版、リリースノート、チェックサムを証跡に残してください。
go install github.com/bealesh/neckbeard/cmd/neckbeard@latest
neckbeard skill install -target codexインストールされたスキルは/skillsまたは$neckbeardから呼び出せます。エージェントの指示ファイルと、決定論的な処理をするCLIを分けて確認するのがポイントです。
CLIだけで分析からV0検証まで確認できる
エージェントを介さず、CLIの各段階を個別に確認する公式フローも用意されています。最初は使い捨て可能なサンプルアプリで実行し、各コマンドの出力をレビューしてから次へ進んでください。
neckbeard doctor -for plan
neckbeard analyze
$EDITOR app-profile.yaml
$EDITOR neckbeard.yaml
neckbeard plan
neckbeard doctor -for estimate
neckbeard estimate
neckbeard scaffold
neckbeard validate注意:本番環境で使用する前に、必ずテスト環境で動作確認してください。validateのPASSEDはV0の構文・ポリシー検証であり、本番デプロイの成功を示しません。
検証記録に残す項目
- Neckbeard、カタログ、OpenTofu、Infracost、Checkovなどの版
- 対象アプリのコミット、検出した事実、推測、未回答の前提、人が確定した回答
- 生成された
blueprint.yamlのハッシュとPull Request差分 - 費用見積もりの前提、価格取得日、価格を付けられなかった項目
- V0/V1/V2ごとのPASSED、FAILED、NOT EXERCISED
- 生成物の削除・ロールバック方法と、検証用クラウドに残ったリソース
AIエージェント自体の変更をCI/CDに組み込み、回帰を追う考え方はAIエージェントの継続的評価とCI/CD回帰検知で詳しく整理しています。
検証で避けたい5つの判断ミス
1.V0のPASSEDを本番稼働の証明にする
❌ tofu validateやCheckovが通ったので、その構成はクラウドへ安全に配備できると判断する。
⭕ V0は構文・スキーマ・ポリシーの確認と扱い、実アカウントのplanはV1、隔離環境への適用とヘルス確認はV2として別々に承認する。
2.AIの推測を確認済み要件へ昇格する
❌ コードにDBクライアントがあるため、エージェントの判断だけで新しいPostgreSQLを作る。
⭕ 既存DBを参照するのか、新規作成するのかを人が回答し、同じ識別子の確認済み項目として記録する。未回答ならplanを止める。
3.費用見積もりを請求上限だと考える
❌ 予算通知や事前見積もりがあるため、実請求額も自動的に上限内へ収まると考える。
⭕ 通知と生成前の上限判定を分け、未価格項目、利用量、残存リソース、データ転送、ログ量をクラウド側でも監視する。
4.生成ファイルを直接直して再実行する
❌ 生成されたHCLだけを編集し、次のスキャフォールドで意図が維持されると期待する。
⭕ 利用者所有のファイルか許可されたオーバーライドへ変更意図を移し、カタログの対象外なら機能追加として扱う。別名生成された競合ファイルを差分レビューする。
5.最初から本番のクラウド権限を渡す
❌ プラグイン導入と同時に、本番アカウントのapply権限や既存シークレットをエージェントへ渡す。
⭕ まずクラウド認証なしで分析・計画・スキャフォールドを確認し、V1とV2は隔離した環境、限定したID、承認ゲート付きCIへ段階を分ける。シークレット値ではなく名前と参照先だけを設定へ残す。
鍵や外部連携の異常を疑ったとき
エージェントやCIに渡したAPIトークン、クラウド認証情報の漏えいを疑った場合は、関連ジョブと外部連携を止め、疑わしい鍵を無効化し、監査ログと生成差分を保全します。JPCERT/CCも、不要または漏えいが疑われるAPIトークンを速やかに無効化できるよう求めています(JPCERT/CC 注意喚起 JPCERT-AT-2026-0030、2026年10月8日公開・10月9日更新)。その後、OIDCの信頼条件、CI変数、クラウド監査ログ、残存リソースを確認し、原因が分かるまで新しいapplyを再開しないでください。
障害時の役割分担や復旧判断は、AIエージェント障害対応・オンコール運用ガイドも参考になります。
よくある質問
Neckbeardとは何ですか?
アプリケーションのリポジトリを分析し、管理されたOpenTofuモジュールカタログから、インフラの設計図、費用見積もり、IaC、CI/CD、検証結果を作るためのAIエージェント向けプラグインとCLIです。エージェントが自由にインフラコードを発明する方式ではありません。
Neckbeardは本番で使える完成版ですか?
2026年10月16日時点で公式READMEはプレアルファとしています。分析、見積もり、スキャフォールド、静的検証が現在の中心で、デプロイライフサイクルは実験的です。本番採用の前に、組織の要件に合わせたV1・V2検証と保守体制が必要です。
AWS、GCP、Azureのすべてへ自動デプロイできますか?
3クラウド、2つのCI、2つの実行方式を組み合わせた12経路の生成と静的検証を対象にしていますが、全経路の実デプロイが受入れ済みではありません。公式Launch planでは完全なライフサイクル受入れは0/12です。
CodexやCursorでも利用できますか?
公式INSTALL.mdには、Codex、Cursor、その他のSKILL.md対応エージェント向け手順があります。エージェントごとにスキルの配置先と呼び出し方が異なるため、現在の公式手順を確認してください。
クラウド認証情報なしでも試せますか?
公式文書では、計画とスキャフォールドはクラウド認証情報なしで実行できます。費用見積もりにはInfracost 0.10.xとログインが必要です。実クラウドを参照するV1と、デプロイするV2には別途認証と限定権限が必要です。
既存の大規模な企業基盤にもそのまま合いますか?
一律には言えません。現行の対応範囲はコンテナ化した比較的定型のワークロードです。複雑なネットワーク、既存の組織ガードレール、独自IAM、カタログ外のデータストアがある場合は、既存標準との適合と二重管理を先に評価してください。
要点の整理
Neckbeardの新しさは、AIエージェントにインフラを「賢く自由生成」させるのではなく、人が管理するカタログ、根拠付きのアプリ分析、ハッシュで固定した設計図、上書きしない生成契約、費用の事前確認へ処理を閉じ込めた点です。
一方で、2026年10月16日時点ではプレアルファです。12経路は静的マトリクスの対象であって、完全な実クラウド受入れは0/12です。日本企業が今すぐ行うなら、採用決定ではなく、対象ワークロードを1つ選び、クラウド認証なしの分析・計画・生成・V0検証で「AIの推測を止められるか」「社内標準をカタログ化できるか」を見るのが現実的です。
本番へ進む判断は、V1の認証付きplan、V2の隔離環境デプロイ、費用の未価格項目、復旧と後片付け、脆弱性対応まで確認した後に行ってください。エージェント運用の可観測性を整える場合は、AIエージェント監視ツール比較もあわせて読むと、ツールの実行結果をどう追うか整理しやすくなります。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- bealesh/neckbeard v0.3.0 README — 機能、対応範囲、コマンド、現在地(参照日:2026年10月16日)
- Neckbeard v0.3.0 — 公開日と変更点(参照日:2026年10月16日)
- Neckbeard INSTALL.md — Claude Code、Codex、Cursor、CLIの公式導入手順(参照日:2026年10月16日)
- Neckbeard Design — 決定論的処理、所有契約、V0/V1/V2、FinOps設計(参照日:2026年10月16日)
- Neckbeard operating manual — エージェントとCLIの役割、対応外項目、検証フロー(参照日:2026年10月16日)
- Neckbeard Launch plan — 12経路の受入れ状況と残作業(参照日:2026年10月16日)
- Neckbeard deployment lifecycle evidence — 実クラウドで確認済みの範囲と未実施項目(参照日:2026年10月16日)
- Neckbeard Security policy — 脆弱性報告、保守範囲、SLAの扱い(参照日:2026年10月16日)
- JPCERT/CC 注意喚起 JPCERT-AT-2026-0030 — APIトークンの無効化に関する公式注意喚起(参照日:2026年10月16日)
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。