2026年9月現在の結論:DeepSeek-V4-Flash-0731は、反復的なAIエージェント処理を低コスト・高同時実行で回したい用途に向くモデルです。精度優先なら、8月13日に正式提供されたV4-Pro-0813を比較し、Flashはコスト重視、Proは複雑な判断重視で使い分けるのが実務的です。
2026年7月31日、DeepSeekが「DeepSeek-V4-Flash-0731」をHugging Faceで公開し、公式API側もV4-Flashのパブリックベータを開始した。開発者コミュニティの反応は速く、Hacker Newsには公式アナウンスのスレッド「DeepSeek-V4-Flash Update」と、性能・価格を分析したスレッド「DeepSeek V4 Flash 0731 Intelligence, Performance and Price Analysis」が同時に立ち、合わせて1,000pt超を集めている。
🎓 AIツールを「触ってみた」から「業務で使える」へ
生成AI・AIエージェントの法人向け導入研修と、Claude Codeの1on1個別指導(マンツーマン)を提供しています。
今回のアップデートで注目すべきは、モデルの大きさや構造を変えずに「再学習だけ」でエージェント系ベンチマークを大幅に押し上げてきた点だ。DeepSeekが公式モデルカードで公開した比較表では、V4-Flash-0731がTerminal Bench 2.1やDeepSWEなど複数の指標で、上位モデルであるはずのV4-Pro(Preview)を上回っている。本記事では、公式モデルカードとAPI changelogの一次情報をもとに、ベンチマーク・料金・実装コードの3方向から、V4無印(Pro)とV4-Flash 0731をエージェント開発でどう使い分けるかを整理する。
📌 続報(2026年8月13日追記):DeepSeek-V4-Pro-0813が正式リリース
DeepSeek公式API Change Log(api-docs.deepseek.com/updates)によると、2026年8月13日、DeepSeek-V4-Proの正式版(GA)「DeepSeek-V4-Pro-0813」がAPP・Web・APIの全チャネルにロールアウトされた。呼び出し方法は変更なく、モデル名は引き続きdeepseek-v4-proのまま新版に切り替わる。本記事内の「V4-Pro(Preview)」は、今回のエージェント特化再学習を受ける前の旧世代を指す。
| ベンチマーク | V4-Pro-0813 | V4-Flash-0731 | V4-Pro(Preview) |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 |
| DeepSWE | 62.7 | 54.4 | 12.8 |
| Cybergym | 83.3 | 76.7 | 52.7 |
| DSBench-FullStack | 71.1 | 68.7 | 41.8 |
| AutomationBench Public | 31.8 | 25.1 | 12.8 |
| NL2Repo | 61.5 | 54.2 | 38.5 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 |
出典: DeepSeek-V4-Pro-0813 公式モデルカード(Hugging Face / deepseek-ai、参照日: 2026-08-15)。V4-Pro-0813は上表の全項目でV4-Flash-0731も上回っており、再学習によりV4-ProがFlashより高性能という序列に戻った形になる。
その他、公式で確認できた変更点: ①推論努力レベルがlow/high/maxの3段階に対応 ②ライセンスはMIT ③チェックポイントの重みがHugging Faceで公開済み。
現行料金(2026年8月現在): DeepSeek公式料金ページ(api-docs.deepseek.com/quick_start/pricing)では、V4-Proの出力単価は100万トークンあたりオフピーク$1.98、ピーク時$3.96です。V4-Flashは同$0.66/$1.32で、平日のピーク帯はUTC 01:00-04:00・06:00-10:00です。
2026年8月15日時点で、上記ベンチマーク値はDeepSeek公式発表(自社の非公開ハーネス)によるもので、独立した第三者による再現検証は確認できていない。「AutomationBench」「DSBench-FullStack」はいずれもDeepSeek公式が独自定義したベンチマーク名で、第三者機関による標準ベンチマークではない点にも留意したい。
0731アップデートで何が変わったのか
DeepSeek公式API changelog(api-docs.deepseek.com/updates)は、今回の変更点を次のように説明している。
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年7月31日 |
| ステータス | V4-Flash公式APIがパブリックベータへ移行(呼び出し方法・モデル名は変更なし) |
| アーキテクチャ | V4-Flash-Previewと同一構造・同一サイズ。「再ポストトレーニングのみ」実施 |
| API対応 | Responses API形式をネイティブサポート。特にOpenAI Codex向けに最適化と明記 |
| V4-Proの扱い | V4-Pro、アプリ/Web版モデルは今回変更なし。V4-Proの正式リリースは近日予定と案内 |
つまり0731は「新モデル」ではなく、既存のV4-Flashを土台にした再学習版という位置づけだ。それでもベンチマークが大きく動いた理由は、次の章で見る通り学習データ・学習方法をエージェントタスクに寄せたためとみられる。その後、2026年8月13日にV4-Pro-0813が正式リリースされ、公式ベンチマークではFlashを上回る結果が公表されたため、現在はコスト・同時実行数を重視するならFlash、精度を重視するならProという使い分けが前提になる。
ベンチマークで見る実力|V4-Proを上回った項目
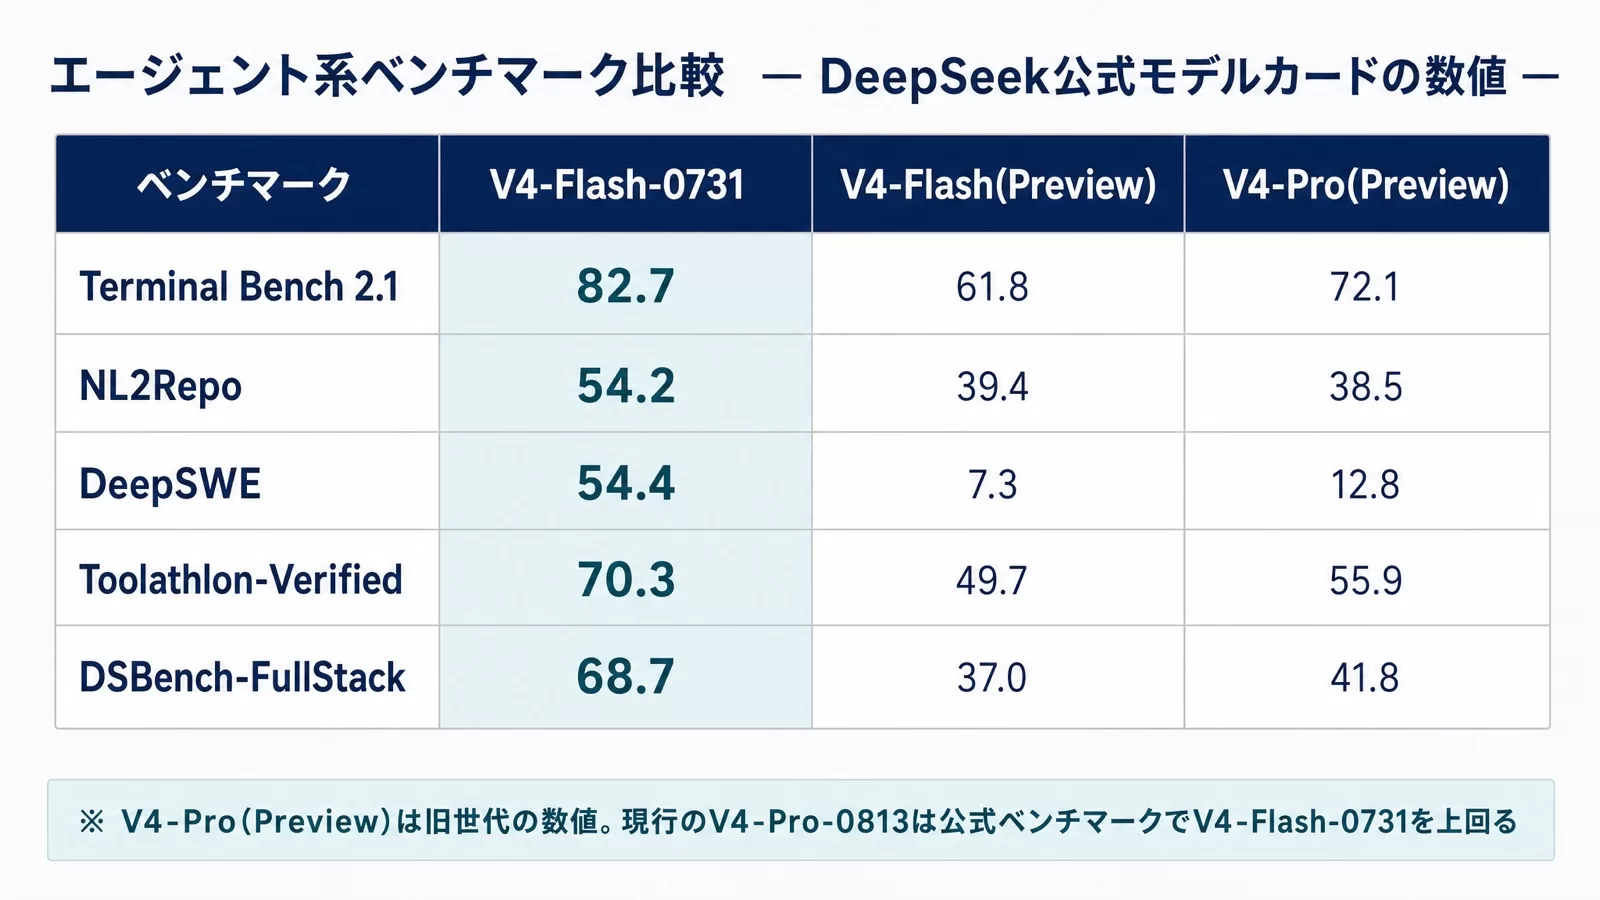
DeepSeekが公式モデルカード(huggingface.co/deepseek-ai/DeepSeek-V4-Flash-0731)で公開している比較表は以下の通り。DeepSeek-V4-Flash-0731、その前身のV4-Flash(Preview)、V4-Pro(Preview)、他社モデルのGLM-5.2・Opus-4.8を横並びにした自社発表の数値だ。
| ベンチマーク | V4-Flash-0731 | V4-Flash(Preview) | V4-Pro(Preview) | GLM-5.2 | Opus-4.8 |
|---|---|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 | 81.0 | 85.0 |
| NL2Repo | 54.2 | 39.4 | 38.5 | 48.9 | 69.7 |
| Cybergym | 76.7 | 38.7 | 52.7 | — | 83.1 |
| DeepSWE | 54.4 | 7.3 | 12.8 | 46.2 | 58.0 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 | 59.9 | 76.2 |
| Agents’ Last Exam | 25.2 | 15.8 | 16.5 | 23.8 | 25.7 |
| AutomationBench Public | 25.1 | 10.8 | 12.8 | 12.9 | 27.2 |
| DSBench-FullStack | 68.7 | 37.0 | 41.8 | 61.8 | 71.6 |
| DSBench-Hard | 59.6 | 25.8 | 31.1 | 54.5 | 71.7 |
9項目すべてで、V4-Flash-0731は前身のV4-Flash(Preview)を大きく上回っただけでなく、アクティブパラメータが約4倍近く多いV4-Pro(Preview)も全項目で上回っている。ターミナル操作を伴うコーディングタスク(Terminal Bench 2.1、DeepSWE)や、複数ツールを連携させるエージェントタスク(Toolathlon-Verified、AutomationBench)で特に伸び幅が大きい。DSBench-FullStack/Hardのようなフルスタック開発を模したベンチマークでも同様の傾向が見える。
ここで注意したいのは、この結果が「現行V4-Proより優れた」という意味ではない点だ。比較対象は旧世代のV4-Pro(Preview)であり、2026年8月13日に正式リリースされたV4-Pro-0813は、DeepSeek公式の主要エージェント系ベンチマークでV4-Flash-0731を上回っている。なお、これらのスコアはいずれもDeepSeek自身の評価環境による自社発表値で、独立した第三者検証ではない。実運用では、自社タスクに近い条件で比較してから採用するのが基本だ。
料金で見る実務比較|出力コストは約3分の1
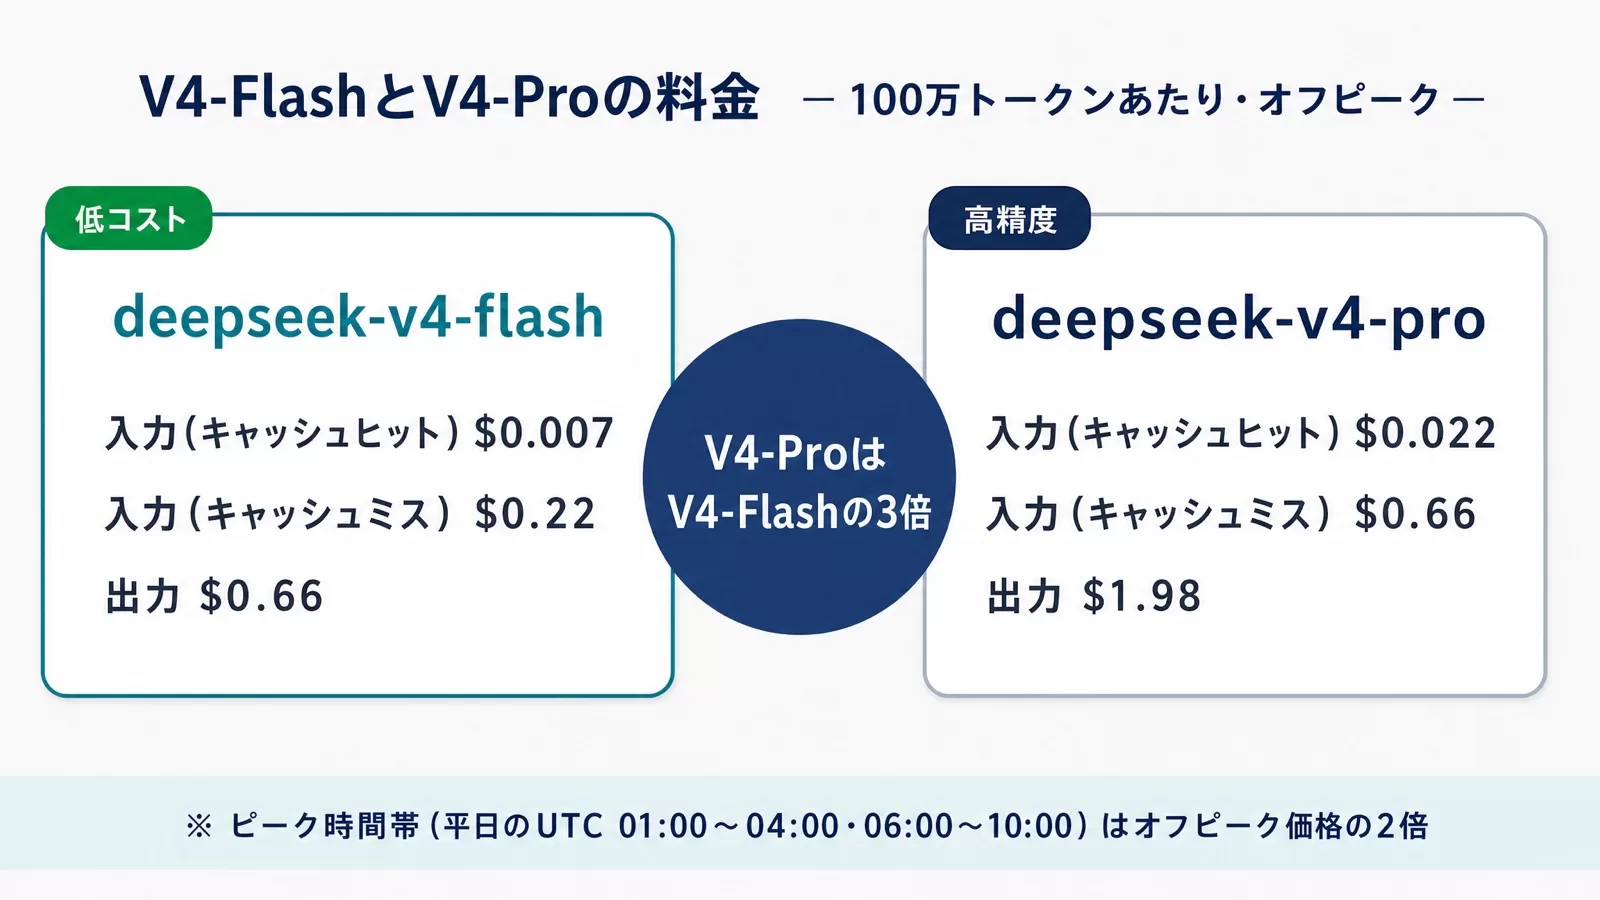
DeepSeek公式の料金ページ(api-docs.deepseek.com/quick_start/pricing)によると、V4-Flashのオフピーク基本料金は次の通り(100万トークンあたり、米ドル)。
| モデル | 入力(キャッシュヒット) | 入力(キャッシュミス) | 出力 |
|---|---|---|---|
| deepseek-v4-flash | $0.007 | $0.22 | $0.66 |
| deepseek-v4-pro | $0.022 | $0.66 | $1.98 |
オフピークの出力トークン単価は1.98ドル対0.66ドル、キャッシュミス時の入力単価も0.66ドル対0.22ドルで、V4-ProはV4-Flashの3倍です。エージェント用途はツール呼び出しのたびにAPIコールが発生し出力トークン量も増えやすいため、この価格差は月間の運用コストに直結します。
ピーク時間帯課金は平日のUTC 01:00〜04:00・06:00〜10:00に適用され、オフピーク価格の2倍になります。V4-Pro/V4-Flash共通のルールで、日本の営業時間帯とも重なるため、大量バッチ処理は夜間・早朝や週末にずらすとコストを抑えやすくなります。
使い分けの実装コード|タスク複雑度でモデルを切り替える
V4-Flash-0731はResponses API形式をネイティブサポートしており、特にOpenAI Codex向けの利用を想定して調整されている。まずは基本的な呼び出し例から確認する。
# 動作環境: Python 3.11以上, openai>=1.30.0
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。

from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4-flash",  # 0731版はモデル名を変えずにそのまま呼び出し可能
    messages=[{"role": "user", "content": "リポジトリのCIログからエラー原因を要約して"}],
    max_tokens=1024,
)
print(response.choices[0].message.content)
次に、エージェントのワークフロー内でタスクの複雑度に応じてV4-FlashとV4-Proを自動的に切り替えるルーティング例を示す。ツール呼び出し中心の反復処理はFlash、最終的な計画立案や高精度な検証が必要な工程はProに振り分ける発想だ。
# 動作環境: Python 3.11以上
# 注意: 閾値やルールは自社タスクの実測値に合わせて調整してください。

def choose_model(task: dict) -> str:
    """タスクの性質に応じてV4-Flash / V4-Proを振り分ける簡易ルーター"""
    # ツール呼び出し数が多い反復系タスクはFlashで十分なケースが多い
    if task.get("type") in ("tool_call_loop", "code_edit", "ci_check"):
        return "deepseek-v4-flash"
    # 複数ステップの計画立案や最終レビューは精度優先でProへ
    if task.get("type") in ("final_review", "complex_planning"):
        return "deepseek-v4-pro"
    # 迷った場合はコストの低いFlashを既定にし、失敗率を監視して切り替える
    return "deepseek-v4-flash"

model = choose_model({"type": "tool_call_loop"})
print(f"Selected model: {model}")
最後に、月間コストを概算するための簡易計算例。実測のトークン量を当てはめれば、FlashとProの費用差を事前に見積もれる。
# 動作環境: Python 3.11以上
# 注意: 単価は2026年8月現在の公式オフピーク料金。最新値は公式ページで確認してください。

PRICING = {
    "deepseek-v4-flash": {"input_miss": 0.22, "output": 0.66},
    "deepseek-v4-pro":   {"input_miss": 0.66, "output": 1.98},
}

def estimate_cost(model: str, input_tokens_m: float, output_tokens_m: float) -> float:
    p = PRICING[model]
    return input_tokens_m * p["input_miss"] + output_tokens_m * p["output"]

flash_cost = estimate_cost("deepseek-v4-flash", input_tokens_m=10, output_tokens_m=3)
pro_cost = estimate_cost("deepseek-v4-pro", input_tokens_m=10, output_tokens_m=3)
print(f"Flash: ${flash_cost:.2f} / Pro: ${pro_cost:.2f} / 差: {pro_cost/flash_cost:.1f}倍")
セルフホストする場合の要件
V4-Flash-0731の重みはMITライセンスでHugging Faceに公開されており、商用利用を含めライセンス上の制約は比較的緩やかだ。オンプレミス運用を検討する場合の要件について、MarkTechPostの解説記事は「3ビット量子化で約103GB、110GBのRAM+VRAMが必要」「フル精度ではGB300ノード4台相当が必要」と紹介している。中堅〜大規模企業でのセルフホストを想定した規模感であり、個人開発や小規模チームでは公式APIかクラウドの推論エンドポイントを使うほうが現実的だろう。Hugging Face上には有志によるGGUF・MLX形式の量子化版(unsloth、bartowski、bullerwins等が公開)も存在するが、これらはDeepSeek公式ではないコミュニティ提供版である点に注意したい。
ライセンス全般の考え方や、蒸留・再配布に関する注意点はオープンウェイトモデル導入の落とし穴、ライセンス・蒸留・更新運用で詳しく整理しているので、自社導入前の確認事項として合わせて読んでほしい。ローカル実行の設計思想全体を知りたい場合は2026年、AIエージェントがローカルへも参考になる。
【要注意】よくある失敗パターンと回避策
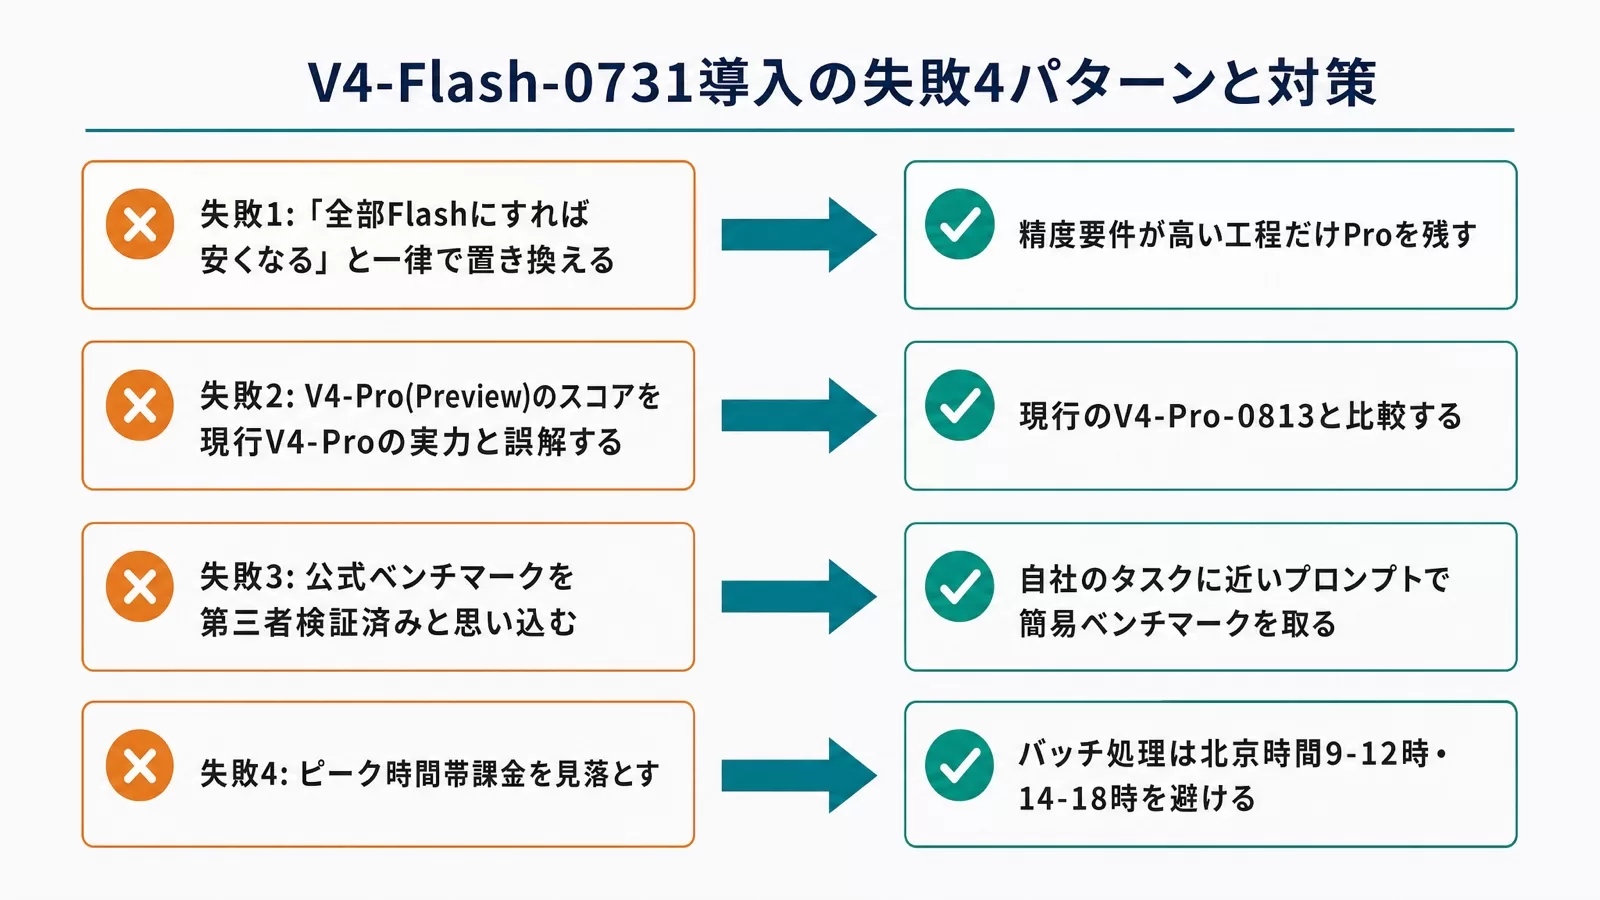
V4-Flash-0731への移行・導入でつまずきやすいポイントを整理する。
❌ 失敗1: 「全部Flashにすれば安くなる」と全タスクを一律で置き換える
⭕ 対策: 上記のルーティング例のように、ツール呼び出しの反復と最終判断を切り分け、精度要件が高い工程だけProを残す。ベンチマークの伸びはあくまでエージェント系タスク中心で、全ての用途で同じ差が出るとは限らない。
❌ 失敗2: V4-Pro(Preview)のスコアをそのまま「現行V4-Proの実力」と誤解する
⭕ 対策: 表のV4-Pro(Preview)は旧世代の数値です。現行のV4-Pro-0813は2026年8月13日に正式リリースされ、公式ベンチマークではV4-Flash-0731を上回っているため、現行モデル同士で比較してください。
❌ 失敗3: DeepSeek公式発表のベンチマークを第三者検証済みと思い込む
⭕ 対策: 本記事で紹介した数値はすべて自社発表かつ非公開ハーネスによるもの。採用判断の前に、自社のタスクに近いプロンプトで簡易ベンチマークを取ってから本番投入する。
❌ 失敗4: ピーク時間帯課金を見落として想定外のコストが発生する
⭕ 対策: バッチ処理は北京時間9-12時・14-18時を避けてスケジューリングする。キャッシュヒット率を上げるシステムプロンプト設計も有効。
V4安定版移行との関係、中国系オープンウェイトの中での位置づけ
DeepSeek V4は2026年7月24日に旧モデル名(deepseek-chat / deepseek-reasoner)が完全廃止され、deepseek-v4-pro / deepseek-v4-flashへの呼び出し名一本化が完了したばかりだった。その1週間後に今回のV4-Flash-0731が公開された形になる。旧モデル名からの移行がまだ済んでいない場合は、先にDeepSeek V4が正式版に|7/24旧モデル名廃止と移行ガイドで移行手順と料金体系の全体像を確認したうえで、今回のV4-Flash-0731への切り替えを検討するとスムーズだ。
同じ週にMoonshot AIの「Kimi K3」やAlibabaの「Qwen3.8-Max」など、中国発のオープンウェイトモデルが立て続けに動いている。各モデルの選定軸や勢力図の全体像はKimi K3・Qwen3.8-Max連発|中国オープンウェイト勢力図と選び方でまとめているので、DeepSeek以外の選択肢も含めて比較したい場合はあわせて参照してほしい。エージェント用のツール選定全般についてはAIエージェントツール比較完全ガイドも判断材料になる。
よくある質問
Q. DeepSeek-V4-Flash-0731は無料で使えますか?
いいえ、公式APIは従量課金制です。2026年8月現在、V4-Flashは100万トークンあたり入力(キャッシュミス時)$0.22、出力$0.66がオフピーク料金で、平日の指定ピーク時間帯は2倍です。重み自体はMITライセンスでHugging Faceに公開されており、セルフホストする場合はAPI料金は発生しませんが、相応のGPU/RAM環境が必要です。
Q. V4-ProとV4-Flash、どちらを使うべきですか?
2026年8月現在、コストと同時実行数を優先する反復処理にはV4-Flash-0731、公式ベンチマーク上の精度を優先する複雑な計画立案や最終判断にはV4-Pro-0813が候補です。価格差はオフピーク料金でおおむね3倍あるため、自社タスクで精度と費用を比較して選んでください。
Q. ベンチマークの数値はどこまで信頼できますか?
本記事で紹介した数値はDeepSeek公式モデルカードによる自社発表値で、非公開の評価ハーネスによるものです。第三者による独立検証ではないため、採用判断の前に自社タスクに近い条件で簡易検証することを推奨します。
Q. Responses API対応とは何ですか?
DeepSeek公式のchangelogによると、V4-Flash-0731はResponses API形式をネイティブサポートしており、特にOpenAI Codexでの利用に合わせて調整されています。既存のChatCompletions API・Anthropic互換APIも引き続き利用できます。
Q. 旧モデル名(deepseek-chat等)を使っているコードはどうなりますか?
2026年7月24日をもって旧モデル名は完全廃止済みで、現在はdeepseek-v4-flash / deepseek-v4-proの指定が必須です。まだ移行していない場合は、先に移行ガイド記事で手順を確認してください。
Q. DeepSeek-V4-Pro-0813とは何ですか?
2026年8月13日にDeepSeek公式が正式リリースした、V4-Proの一般提供版(GA)です。呼び出し名は従来通りdeepseek-v4-proのままで、コード変更なしに新版へ切り替わります。公式モデルカードのベンチマークでは、Terminal Bench 2.1が72.1→87.9、DeepSWEが12.8→62.7など、V4-Pro(Preview)から大きく向上しており、本記事のV4-Flash-0731も全項目で上回っています。詳細は本記事冒頭の続報ボックスを参照してください。
Q. DeepSeek V4-Flash 0721 というモデルはありますか?
ありません。2026年9月6日時点で Hugging Face の deepseek-ai 配下に公開されているのは DeepSeek-V4-Flash-0731 で、「0721」は日付の記憶違いか誤記です。検索で「0721」と出てきた場合も、公式のモデル名は 0731 です。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- DeepSeek-V4-Flash-0731 公式モデルカード — Hugging Face / deepseek-ai(参照日: 2026-08-01)
- DeepSeek-V4-Pro-0813 公式モデルカード — Hugging Face / deepseek-ai(参照日: 2026-08-15)
- DeepSeek API Change Log — DeepSeek公式(参照日: 2026-08-31)
- DeepSeek API Pricing — DeepSeek公式(参照日: 2026-08-31)
- DeepSeek Upgrades DeepSeek-V4-Flash-0731 with Major Agentic and Coding Gains — MarkTechPost(参照日: 2026-08-01)
- DeepSeek-V4-Flash Update — Hacker News(参照日: 2026-08-01)
- DeepSeek V4 Flash 0731 Intelligence, Performance and Price Analysis — Hacker News(参照日: 2026-08-01)
まとめ:今日から始める3つのアクション
- 今日やること: 既存のdeepseek-v4-flash呼び出しコードはそのままで0731の恩恵を受けられるので、まずは自社のツール呼び出し系タスクで応答品質を再確認する。
- 今週中: 上記のルーティング例を参考に、タスクの複雑度でFlash/Proを振り分けるロジックを設計し、コスト試算を出す。
- 今月中: V4-Pro-0813とV4-Flash-0731を自社タスクで比較し、旧モデル名からの移行漏れとピーク時間帯のコストをCI・運用設定でチェックする仕組みを整える。
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
続報(2026年8月10日追記):DeepSeekが自社製のAIエージェント実行基盤「DeepSeek Harness」のクローズドβを開始し、712プロジェクトが応募しました。詳細はDeepSeek Harnessとは?クローズドβに712件殺到の中身で解説しています。