「Mem0とは何で、料金はいくらからで、どう使い始めればいいのか?」——答えを先に言うと、Mem0はAIエージェントやチャットアプリに長期記憶(ユーザーの好み・過去のやり取り)を持たせるメモリレイヤーで、自前ホストするOSS版はApache 2.0ライセンスで無料、マネージドのクラウド版(Mem0 Platform)は無料のHobbyプランから月額249ドルのProプランまでがあり、最短ならpip install mem0aiと数行のPythonで動き始められます。
2026年9月26日時点で公式情報を確認すると、GitHubスターは6万を超え、公式サイトには15万人以上の開発者が利用していると記載されています。2025年10月28日にはSeedとSeries Aを合わせて2,400万ドルの資金調達を発表しており、その発表文によればプラットフォームのAPI呼び出しは2025年の第1四半期3,500万回から第3四半期には1億8,600万回まで伸びています。「エージェントを作ったのに、会話が終わるたびに全部忘れる」という悩みへの、現時点で最も採用例の多い答えの1つです。
以下では、Mem0が何をするライブラリかという基本、OSS版とクラウド版の違い、公式Pricingページの現在値、公式quickstartどおりの最短導入手順、LangChain・LlamaIndex・Claudeとの組み合わせ方を順に確認していきます。ZepやLettaなど他のメモリ基盤との横並び比較は、既刊のAIエージェントメモリ比較2026|Mem0・Letta・Zep選び方ガイドとMem0・Zep・LangMem比較2026に任せ、この記事はMem0単独の入門に絞ります。
Mem0は何をするライブラリか
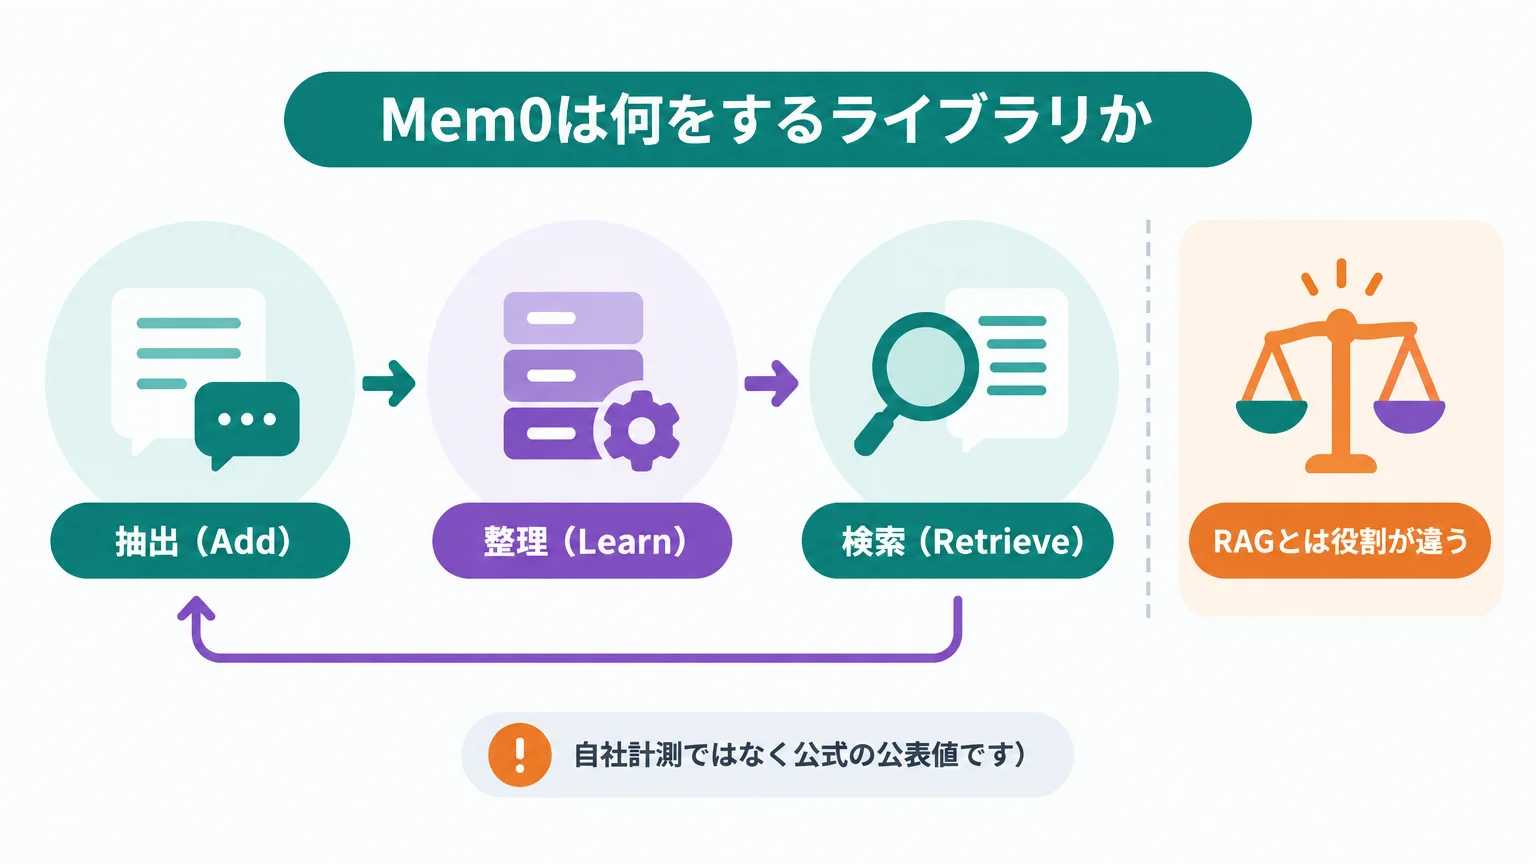
Mem0(メムゼロ)は、GitHubで「The Memory Layer for AI Agents」と説明されているオープンソースのメモリ基盤です。LLMアプリの会話ログをそのまま溜め込むのではなく、会話から「事実」を抽出して保存し、次の会話で関連する記憶だけを検索して文脈に注入する、という3段階で動きます。
- 抽出(Add):会話メッセージをLLMに通し、「ベジタリアンである」「ナッツアレルギーがある」のような個別のファクトに分解して保存する
- 整理(Learn):既存の記憶と矛盾・重複があれば更新や統合を行い、記憶を最新の状態に保つ
- 検索(Retrieve):次のリクエスト時に自然言語クエリで関連記憶を検索し、関連度スコア順に返す
記憶のスコープはUser(ユーザー単位)・Session(セッション単位)・Agent(エージェント単位)の多層で管理でき、user_idやagent_idを付けて書き込む設計になっています。SDKはPython(pip install mem0ai)とJavaScript/Node.js(npm install mem0ai)の両方が公式提供されています。
2026年4月のアルゴリズム刷新で何が変わったか
GitHubのREADMEによると、2026年4月に抽出アルゴリズムが刷新され、シングルパス抽出・エンティティリンキング・時制推論(temporal reasoning)が入りました。公表値では、長期記憶ベンチマークのLoCoMoで92.5(旧アルゴリズム比+21ポイント)、LongMemEvalで94.4(同+27ポイント)、検索レイテンシはp50で0.88〜1.09秒とされています(Mem0公式GitHub、2026年9月26日参照。自社計測ではなく公式の公表値です)。
RAGとは役割が違う
混同されやすいのですが、RAGが「社内文書やマニュアルなどの知識」をLLMに参照させる仕組みなのに対し、Mem0のようなメモリレイヤーは「そのユーザーとの過去のやり取りから得た文脈」を保持する仕組みです。両者は排他ではなく併用が普通で、知識はRAG、ユーザー文脈はメモリと役割を分けるのが基本形です。RAG側の設計はLlamaIndex完全ガイドが参考になります。
OSS版とクラウド版(Mem0 Platform)はどう違うか
Mem0には自前でホストするOSS版と、Mem0社がホストするクラウド版(Mem0 Platform)の2系統があります。コードの書き味はよく似ていて、OSS版はMemoryクラス、クラウド版はMemoryClientクラスを使います。違いを整理すると次のとおりです。
| 観点 | OSS版 | クラウド版(Mem0 Platform) |
|---|---|---|
| ライセンス/料金 | Apache 2.0・無料(LLM API代と自前インフラ代は別途) | Hobby無料〜Pro月額249ドル+Enterprise個別見積もり |
| セットアップ | pip install mem0ai+LLM・ベクトルDBの構成 |
サインアップしてAPIキー(m0-で始まる)を発行するだけ |
| データの置き場所 | 自分のインフラ内(デフォルトはローカルのQdrant+SQLite) | Mem0側のマネージド環境(Enterpriseはオンプレ展開に対応) |
| 構成の自由度 | LLM・埋め込みモデル・ベクトルDBを差し替え可能(Ollama・Anthropic等) | マネージドのため構成はサービス側におまかせ |
| 付加機能 | コアのadd/search/update/delete | ダッシュボード・分析、Proでグラフメモリ(エンティティリンキング)やDream(記憶の統合整理) |
| コンプライアンス | 自社の運用次第 | SOC 2(Type 1)・HIPAA・GDPR対応、BYOKサポートを公式サイトに明記 |
選び方の目安はシンプルです。まず試したい・データを自社インフラから出せない・LLMをローカルモデルにしたい場合はOSS版。記憶基盤の運用(ベクトルDBの面倒見やスケール対応)を持ちたくない場合や、ダッシュボードで記憶の中身をチームで確認したい場合はクラウド版が向きます。OSS版で概念検証してからクラウド版に載せ替える、という順番も、SDKのインターフェースが近いため無理がありません。
料金——公式Pricingの現在値(2026年9月26日確認)
クラウド版の料金は次の4プランです。公式Pricingページを2026年9月26日に確認した時点の値で、書き込み(add requests)と検索(retrieval requests)が別枠でカウントされる点が特徴です。
| プラン | 月額 | add requests/月 | retrieval requests/月 | プロジェクト数 | 主な内容 |
|---|---|---|---|---|---|
| Hobby | 無料 | 10,000 | 1,000 | 1 | エンドユーザー数無制限・コミュニティサポート |
| Starter | 19ドル | 50,000 | 5,000 | 1 | 個人〜小規模アプリ向け・コミュニティサポート |
| Pro | 249ドル | 500,000 | 50,000 | 無制限 | グラフメモリ・Dream(記憶統合)・高度な分析・専用Slackサポート |
| Enterprise | 個別見積もり | 無制限 | 無制限 | 無制限 | オンプレ展開・監査ログ・SSO・SLA付きサポート |
固定プランに収まらないトラフィックのチーム向けに、従量課金(usage-based pricing)の相談窓口があることもPricingページに記載されています。なお、この種のSaaS料金は改定が珍しくないため、契約前には必ず公式Pricingページで最新値を確認してください。
OSS版の「無料」にも注釈が要ります。ライセンス料はかかりませんが、デフォルト構成では記憶の抽出にOpenAIのAPI(既定モデルはgpt-5-mini)を呼ぶため、LLMのAPI利用料と、ベクトルDBを動かすインフラ代は自分持ちです。「Mem0自体のコストはゼロ、ただし周辺コストは発生する」と理解しておくのが正確です。
最短の導入手順——OSS版quickstart
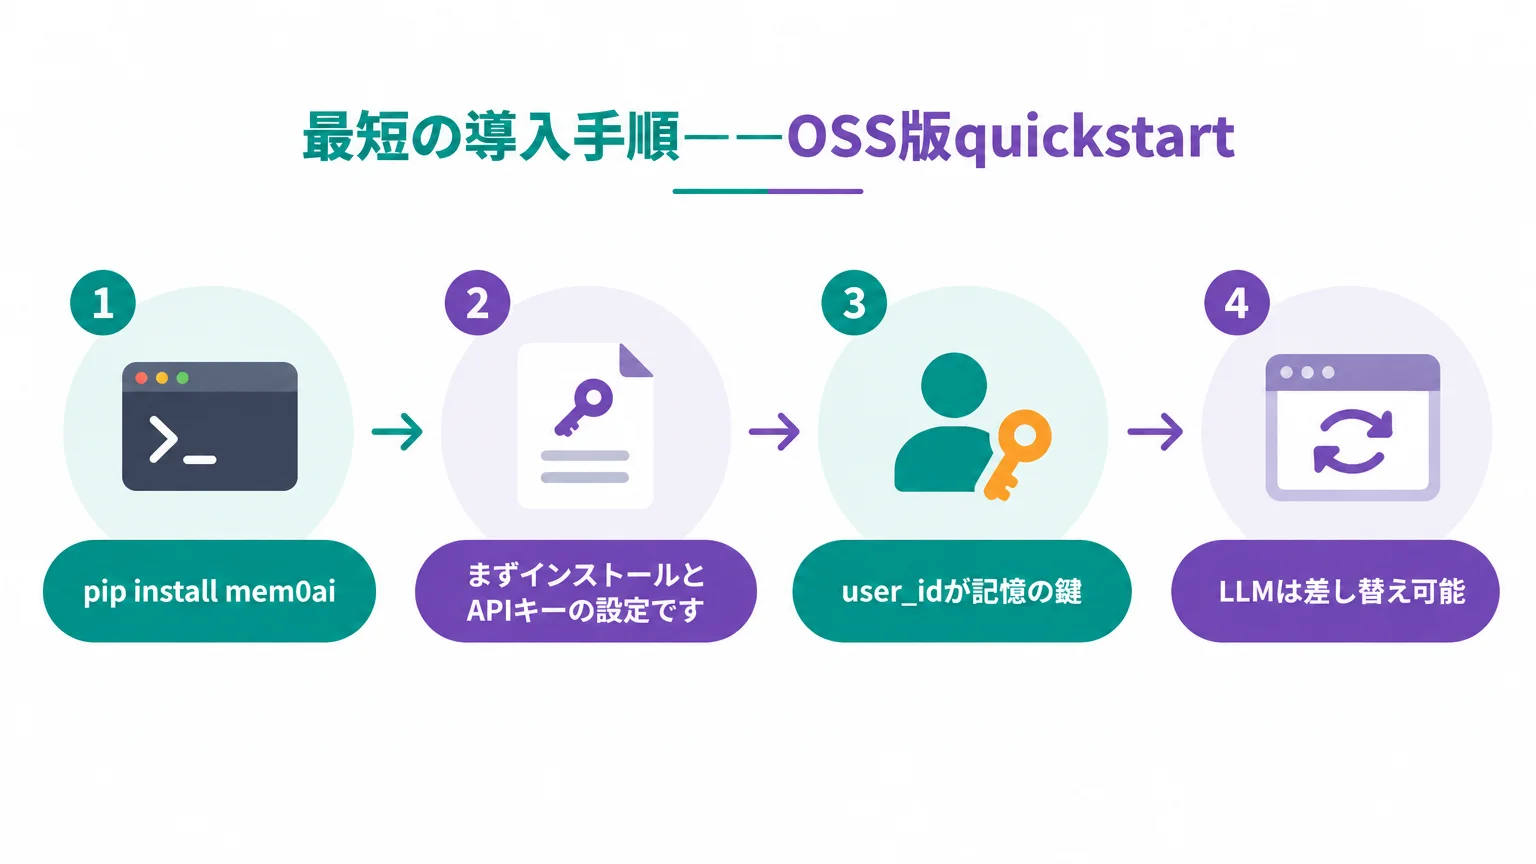
公式ドキュメントのPython Quickstartどおりに進めます。前提はPython 3.10以上とOpenAI APIキーです。
まずインストールとAPIキーの設定です。APIキーはコードに直書きせず、環境変数で渡します。
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
pip install mem0ai
export OPENAI_API_KEY="your-openai-api-key"
次に、記憶の追加と検索です。以下は公式quickstartのコードそのままで、会話メッセージを渡すと事実が抽出・保存され、自然言語で検索できます。
# 動作環境: Python 3.10+, mem0ai(2026年9月26日時点の公式quickstart準拠)
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
from mem0 import Memory

m = Memory()

# 記憶の追加
messages = [
    {"role": "user", "content": "Hi, I'm Alex. I love basketball and gaming."},
    {"role": "assistant", "content": "Hey Alex! I'll remember your interests."}
]
m.add(messages, user_id="alex")

# 記憶の検索
results = m.search("What do you know about me?", filters={"user_id": "alex"})
print(results)
ポイントは次の3つです。
- 追加構成なしで動く:既定ではLLMにgpt-5-mini、埋め込みにtext-embedding-3-small、ベクトルストアにQdrant、履歴管理にSQLiteが自動構成されます
user_idが記憶の鍵:誰の記憶かを識別するIDで、検索時もfiltersで同じIDを指定します- LLMは差し替え可能:OllamaのローカルモデルやAnthropicのモデルを使う構成は、公式のConfigurationドキュメントに設定例があります(設定キーはバージョンで変わり得るため、公式の該当ページを直接参照してください)
クラウド版はMemoryClientで始める
クラウド版はapp.mem0.aiでサインアップし、ダッシュボードからAPIキー(m0-で始まる文字列)を発行して使います。コードはOSS版とほぼ同じ形で、クラスがMemoryClientに変わるだけです。
# 動作環境: Python 3.10+, mem0ai(2026年9月26日時点の公式Platform quickstart準拠)
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
from mem0 import MemoryClient

client = MemoryClient(api_key="your-api-key")  # 実運用では環境変数から読み込む

messages = [
    {"role": "user", "content": "I'm a vegetarian and allergic to nuts."},
    {"role": "assistant", "content": "Got it! I'll remember your dietary preferences."}
]
client.add(messages, user_id="user123")

results = client.search("What are my dietary restrictions?", filters={"user_id": "user123"})
この例では「Is a vegetarian」「Allergic to nuts」という2つの記憶が別々に保存される、と公式ドキュメントに明記されています。検索結果は関連度スコア順で、作成日時やカテゴリのメタデータ付きで返ります。Hobbyプランの枠(add 10,000回・retrieval 1,000回/月)は個人の検証には十分な量なので、まず無料で試して挙動を確かめるのが現実的です。
LangChain・LlamaIndex・Claudeと組み合わせる
Mem0は単体で使うより、既存のエージェントフレームワークの「記憶担当」として組み込む場面が多いはずです。公式ドキュメントに手順がある3つの組み合わせを紹介します。
LangChain:会話フローの前後にsearchとaddを挟む
LangChainとの統合は、公式ドキュメントでは次のパッケージ構成で始めます。
pip install langchain langchain_openai mem0ai python-dotenv
構造は素直で、(1)ユーザー入力を受けたらmem0.search()で関連記憶を取得、(2)記憶をプロンプトに入れてLangChainのチェーンで応答生成、(3)やり取りをmem0.add()で保存、という3ステップをチェーンの前後に挟みます。LangChainが会話フロー、Mem0が記憶の永続化という分担です。LangChain自体の組み方はLangChainでAIエージェントを構築する完全ガイドで詳しく扱っています。
LlamaIndex:Mem0Memoryをmemory引数に渡すだけ
LlamaIndexには専用パッケージllama-index-memory-mem0があり、Mem0Memoryクラスをエージェントのmemoryにそのまま渡せます。
# 動作環境: Python 3.10+, llama-index-core, llama-index-memory-mem0
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
# pip install llama-index-core llama-index-memory-mem0 python-dotenv
from llama_index.memory.mem0 import Mem0Memory

context = {"user_id": "alice"}
memory = Mem0Memory.from_client(context=context, search_msg_limit=4)
クラウド版に繋ぐfrom_client()と、OSS版の自前構成に繋ぐfrom_config()の2つの初期化方法があり、SimpleChatEngine・FunctionCallingAgent・ReActAgentで使えると公式ドキュメントに記載されています。contextにはuser_id・agent_id・run_idの少なくとも1つを渡す必要があります。
Claude Code:公式プラグインで記憶を自動キャプチャ
コーディングエージェント向けには、Mem0がOpenMemoryという名前でMCP対応のメモリレイヤーを提供しており、Cursor・VS Code・ClaudeなどMCP互換クライアントで使えます。Claude Codeの場合は公式プラグインが用意されていて、セットアップは次の4行です(Mem0 PlatformのAPIキーが必要です)。
# 注意: 本番環境で使用する前に、必ずテスト環境で動作確認してください。
export MEM0_API_KEY='your-mem0-api-key'
claude plugin marketplace add mem0ai/mem0
claude plugin install mem0@mem0-plugins --scope user --config api_key="$MEM0_API_KEY"
unset MEM0_API_KEY
インストール後にClaude Codeを再起動(または/reload-plugins)してGitリポジトリを開けば、あとは普段どおり作業するだけで記憶が自動的に蓄積されます。コーディングの好み(テストの書き方、命名規則など)がセッションをまたいで引き継がれる、という使い方です。MCPサーバーとして直接組み込む手順は公式のMem0 MCPドキュメントにあります。
なお、エコシステム面では2026年9月16日にVercel Marketplaceへの参加が公式ブログで発表されており、Vercel上のプロジェクトからの導入経路も増えています。
つまずきやすいポイント4つ
その1:OSS版をAPIキーなしで動かそうとする
❌ pip install mem0aiしてすぐMemory()を実行し、認証エラーで止まる
⭕ 先にOPENAI_API_KEYを設定する。OpenAIを使いたくない場合は、Ollama等のローカルLLM構成に切り替えてから実行する
なぜ重要か:OSS版は「無料」ですが、既定構成では記憶の抽出にOpenAIのLLMを呼びます。「オープンソース=完全オフラインで動く」と思い込むと最初の1行で詰まります。オフラインで完結させたいならLLM・埋め込み・ベクトルDBをすべてローカル構成にする必要があります。
その2:addとretrievalのクォータを同じ感覚で見積もる
❌ 「Hobbyは月1万回まで無料だから余裕」とだけ見積もる
⭕ 書き込み(add)と検索(retrieval)は別枠と理解し、自分のアプリの読み書き比率から先に尽きる側を見積もる
なぜ重要か:Hobbyプランはadd 10,000回に対してretrievalは1,000回と、枠が10倍違います。チャットのたびに記憶検索を走らせる設計だと、検索側が先に上限へ到達します。リクエストごとに検索を1回に抑える、検索結果をリクエスト内で使い回すといった設計がプラン選定にも効いてきます。
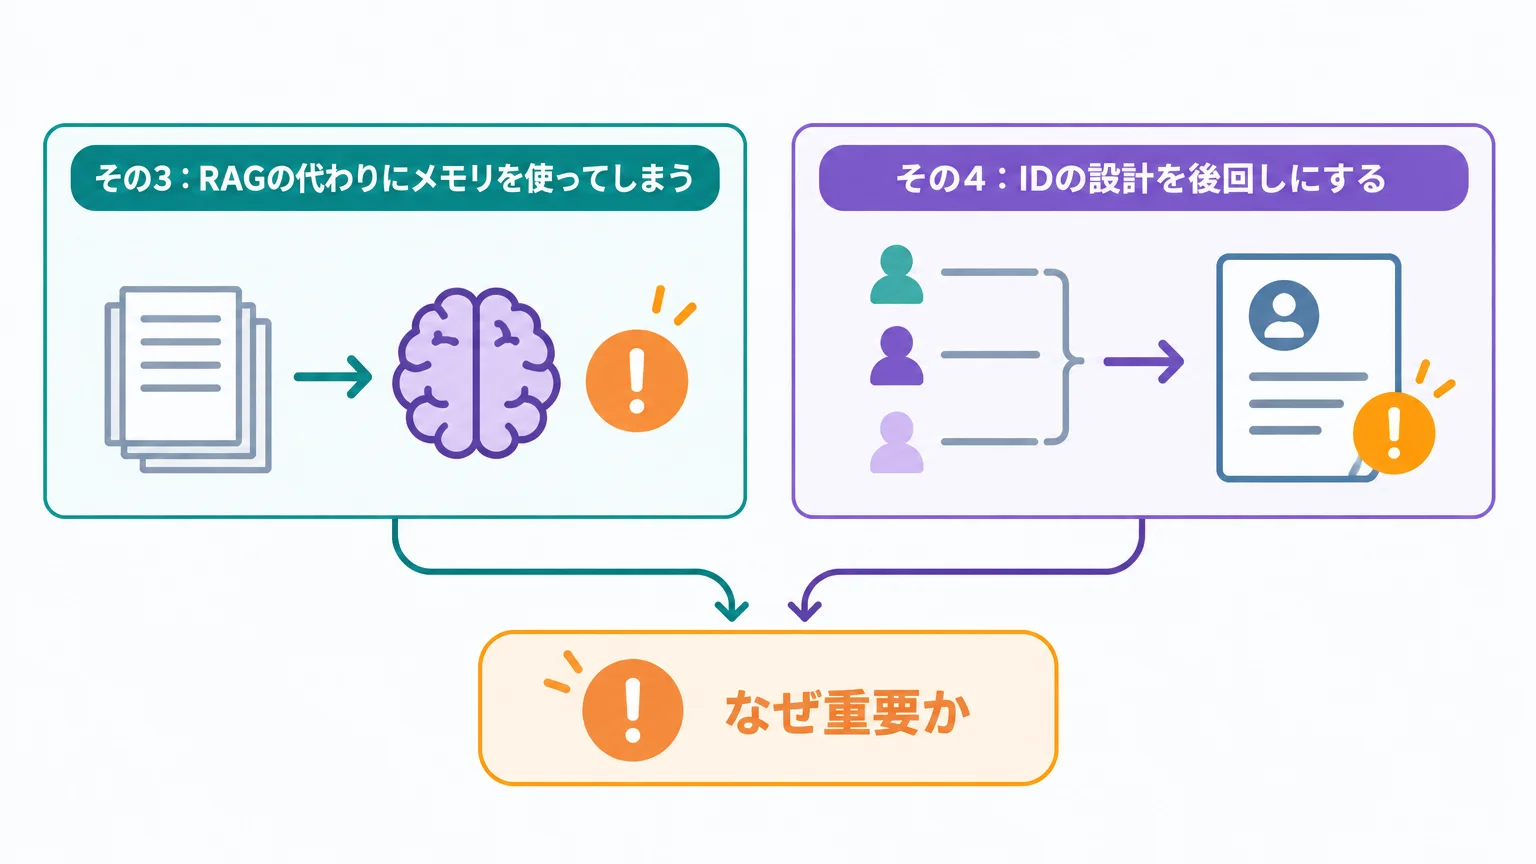
その3:RAGの代わりにメモリを使ってしまう
❌ 社内マニュアルやFAQ文書を丸ごとadd()に流し込んで「社内検索」を作ろうとする
⭕ 文書知識はRAG(LlamaIndex等)に、ユーザーごとの文脈・好みはMem0に、と役割を分ける
なぜ重要か:Mem0のaddは会話から「個人に紐づく事実」を抽出する前提で設計されています。文書検索の土俵ではチャンキングやリランクを備えたRAGパイプラインの方が適しています。実装パターンの整理はAIエージェントのメモリ実装入門も参考にしてください。
その4:IDの設計を後回しにする
❌ とりあえず全部同じuser_idで書き込み、後から誰の記憶か分離できなくなる
⭕ User・Session・Agentのどのスコープに何を記憶させるかを書き込み前に決め、user_id/agent_id等のID体系を先に設計する
なぜ重要か:Mem0の記憶は多層スコープで管理される設計で、検索もIDでのフィルタが前提です。ID設計が曖昧なまま本番データを書き込むと、ユーザー間で記憶が混ざる(=プライバシー事故につながる)リスクがあります。
よくある質問
Mem0とは何ですか?
AIエージェントやLLMアプリに長期記憶を持たせるオープンソースのメモリレイヤーです。会話から事実を抽出して保存し、次回以降の会話で関連する記憶を検索して文脈に注入します。GitHubスターは6万超(2026年9月26日時点)、ライセンスはApache 2.0です。
無料でどこまで使えますか?
OSS版はライセンス無料で全機能を自前ホストできます(LLM API代・インフラ代は別途)。クラウド版もHobbyプランなら無料で、月あたりadd 10,000回・retrieval 1,000回・1プロジェクトまで使えます(2026年9月26日時点の公式Pricing)。
OSS版とクラウド版はどちらを選ぶべきですか?
データを外部に出せない要件がある、ローカルLLMで動かしたい、まず仕組みを理解したい場合はOSS版。ベクトルDB等の運用を持ちたくない、ダッシュボードやグラフメモリなどの付加機能を使いたい場合はクラウド版が向きます。SDKの書き味が近いため、OSS版で検証してからクラウド版へ移す進め方も現実的です。
ZepやLettaなど他のメモリ基盤と何が違いますか?
それぞれ記憶の持ち方(抽出型・グラフ型・エージェント状態型)と運用形態が異なります。選定基準を含めた横並び比較はAIエージェントメモリ比較2026で詳しく扱っています。
CursorやClaude CodeからMCP経由で使えますか?
使えます。Mem0はOpenMemoryという名称でMCP対応のメモリレイヤーを提供しており、Cursor・VS Code・ClaudeなどMCP互換のコーディングエージェントに対応しています。Claude Codeには専用プラグイン(claude plugin install mem0@mem0-plugins)もあります。
ここまでの要点
- Mem0はAIエージェントに長期記憶を持たせるメモリレイヤー。会話から事実を抽出・保存し、検索して文脈に注入する
- OSS版はApache 2.0で無料(LLM API代・インフラ代は自分持ち)。クラウド版はHobby無料/Starter月額19ドル/Pro月額249ドル/Enterprise個別(2026年9月26日確認)
- 最短導入は
pip install mem0ai+Memory()のadd/search。クラウド版はMemoryClientにAPIキーを渡すだけ - LangChainとはsearch→生成→addの3ステップ、LlamaIndexとは
Mem0Memoryクラス、Claude Codeとは公式プラグインで組み合わせられる - 知識はRAG・ユーザー文脈はメモリという役割分担と、add/retrieval別枠のクォータ設計を最初に押さえるとつまずかない
次の一歩としては、まずOSS版quickstartを手元で動かして記憶の抽出結果(どんな事実が保存されるか)を実際に見てみるのがおすすめです。抽出のされ方を体感してから、クラウド版のHobbyプランで自分のアプリに組み込むか判断すると、プラン選定も含めて判断材料が揃います。
あわせて読みたい:
- AIエージェントメモリ比較2026|Mem0・Letta・Zep選び方ガイド — メモリ基盤を横並びで選定したい方向け
- Mem0・Zep・LangMem比較2026|AIエージェント長期記憶の選び方 — LangChain純正のLangMemとの違いはこちら
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Mem0 Pricing — Mem0公式(参照日: 2026-09-26)
- mem0ai/mem0 – GitHub — Mem0公式リポジトリ(参照日: 2026-09-26)
- Mem0 Open Source Python Quickstart — Mem0公式ドキュメント(参照日: 2026-09-26)
- Mem0 Platform Quickstart — Mem0公式ドキュメント(参照日: 2026-09-26)
- Mem0 raises $24M to build the memory layer for AI — Mem0公式・2025年10月28日発表(参照日: 2026-09-26)
- Mem0 × LangChain Integration — Mem0公式ドキュメント(参照日: 2026-09-26)
- Mem0 × LlamaIndex Integration — Mem0公式ドキュメント(参照日: 2026-09-26)
- Mem0 × Claude Code Integration — Mem0公式ドキュメント(参照日: 2026-09-26)
- OpenMemory – AI Memory MCP Server for Coding Agents — Mem0公式(参照日: 2026-09-26)
- Mem0 joins Vercel Marketplace — Mem0公式ブログ・2026年9月16日(参照日: 2026-09-26)