Doc-to-LoRA(D2L)は、文書を1回のフォワードパスで rank-8 の LoRA アダプタに変換し、以後その文書をコンテキストに入れずに質問へ答えられるようにする Sakana AI のハイパーネットワークです。公式ブログの実測では SQuAD でフルコンテキストの83.5%の精度を1秒未満の更新時間で出し、128Kトークンの文書で12GB超必要だった追加メモリを50MB未満に抑えます(Sakana AI 公式技術解説)。
2026年9月27日時点のスナップショット:論文は arXiv:2602.15902(v1・2026年2月13日投稿)のまま改訂なし。公式リポジトリ SakanaAI/doc-to-lora は MIT ライセンス・スター827・main への最新コミットは2026年5月25日。Hugging Face には4つのチェックポイント(Gemma 2 2B×2種/Mistral 7B Instruct v0.2/Qwen3 4B Instruct)が置かれており、合計約6.5GB。コードもモデル重みも無償で、費用としてかかるのは GPU 代だけです。ただし論文の主実験を再現する学習データは1モデルあたり約100GB・3モデル分で328GB、ハイパーネットワークのメタ学習自体は公式が「複数GPUで数日〜数週間」と明記しています。
Doc to LoRAとは|文書をLoRAアダプタに変換して「読み直し」をなくす技術
Doc to LoRA(正式表記 Doc-to-LoRA、略称 D2L)は、東京の Sakana AI が2026年2月に公開した「文書 → LoRA アダプタ」の変換器です。やっていることは1行で言えます。長い文書をハイパーネットワークに1回通して LoRA アダプタを作り、そのアダプタをベースモデルに当てて、以降は文書をプロンプトに入れずに質問へ答えさせる。これだけです。
なぜこれが要るのかは、論文の Abstract が直球で書いています。「Transformer の注意機構のコストは系列長の二乗で増えるため、推論はメモリを食い、遅くなる。コンテキスト蒸留(context distillation, CD)で情報をパラメータへ移すことはできるが、プロンプトごとに蒸留するのは学習コストとレイテンシの面で実用的でない」(arXiv:2602.15902・2026年2月13日投稿)。D2L はその蒸留を1回のフォワードパスで近似することをメタ学習で覚えさせた軽量なハイパーネットワークです。
読み間違えやすいので先に線を引いておきます。Doc-to-LoRA はLoRA を「学習」するのではなく「生成」する側の技術です。通常の LoRA / QLoRA は文書やデータセットごとに勾配計算を回してアダプタを作りますが、D2L は事前に訓練済みのハイパーネットワークに文書を通すだけで、勾配計算を1回も回さずにアダプタが出てきます。LoRA そのものの仕組みから確認したい場合はQLoRA/LoRAでAIエージェントをドメイン適応させる実装ガイドを先に読むと差がはっきりします。
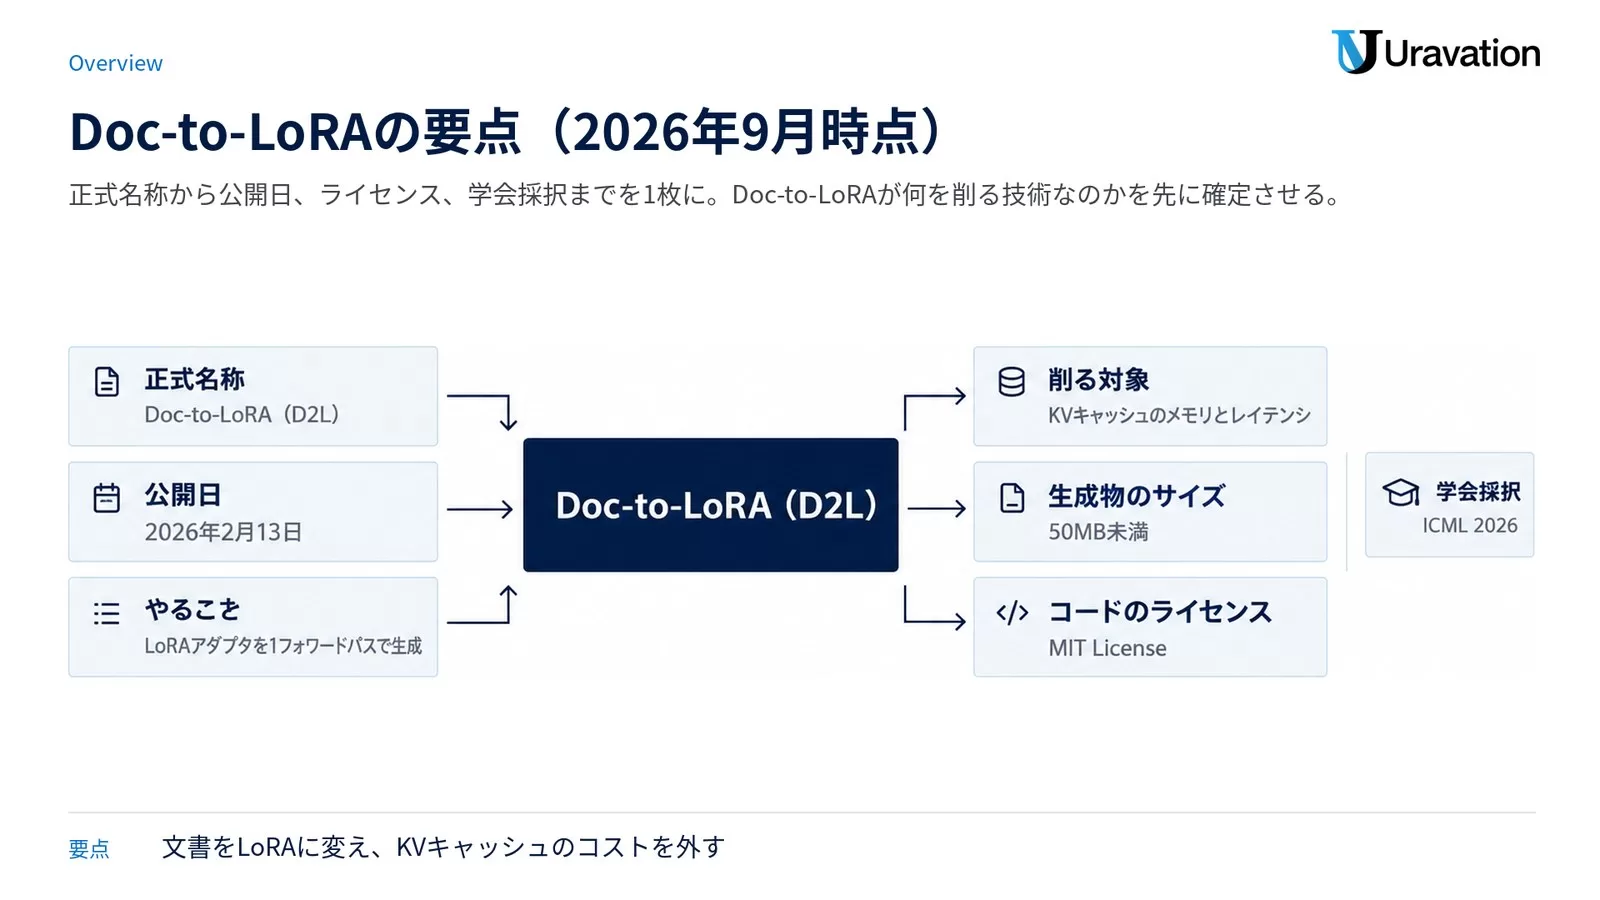
| 項目 | 2026年9月27日時点の公式値 | 出典 |
|---|---|---|
| 正式名称・略称 | Doc-to-LoRA(D2L)/副題「Learning to Instantly Internalize Contexts」 | arXiv:2602.15902 |
| 公開日 | arXiv 投稿 2026年2月13日/リポジトリ公開コミット 2026年2月27日 | arXiv・GitHub |
| やること | 未知の文書から対象 LLM 用の LoRA アダプタを1フォワードパスで生成 | arXiv Abstract |
| 削る対象 | 推論時の KV キャッシュのメモリとレイテンシ | arXiv Abstract |
| 生成物のサイズ | 50MB 未満(文書長に関係なく一定) | 公式ブログ NIAH 節 |
| コードのライセンス | MIT License(2026年3月2日のコミットで追加) | GitHub API |
| 学会採択 | 公式 README の引用情報は ICML 2026(第43回)の @inproceedings(詳細は後述) |
GitHub README |
この記事の対象:長文文書を扱う LLM アプリの設計者、RAG からの乗り換えを検討している開発者、オンプレ/エッジ環境で LLM を回す担当者。難易度:中級〜上級(LoRA と Transformer の基礎知識が前提)。
Doc-to-LoRAの仕組み|文書→凍結LLM→Perceiverハイパーネットワーク→rank-8 LoRA
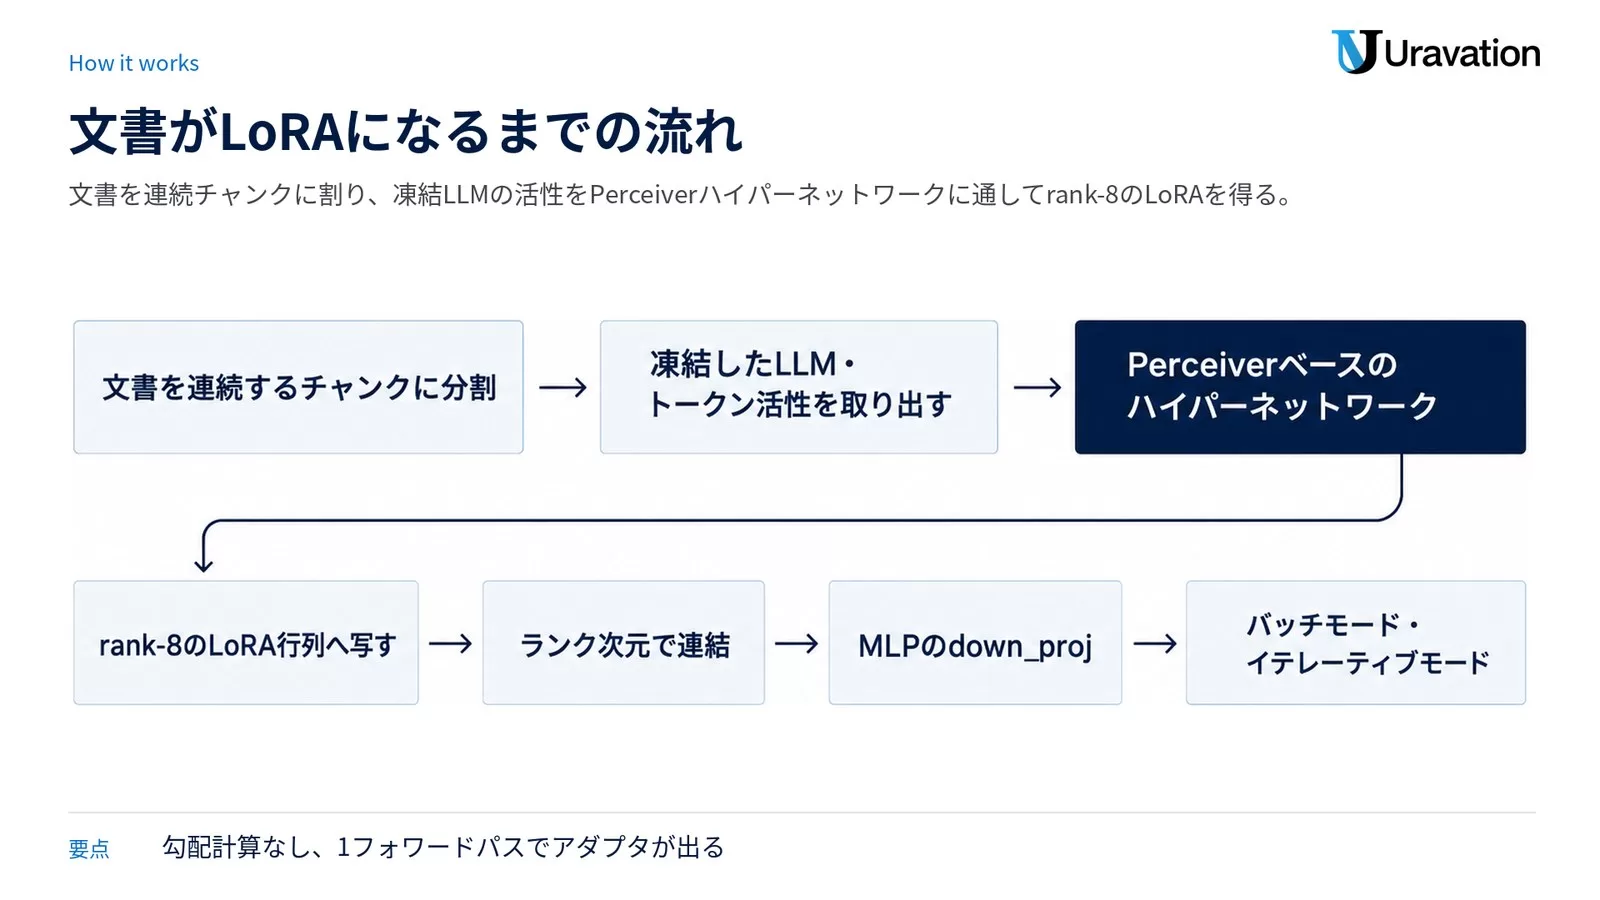
Doc-to-LoRA の処理は、公式ブログの表現をそのまま辿ると3段です。①文書を凍結した LLM に通してレイヤーごとのトークン活性を取り出す、②その活性を Perceiver ベースのハイパーネットワークが rank-8 の LoRA 行列へ写す、③その LoRA をベースモデルに当てる。学習時の目的関数は、文書を全部見せた教師(full document context)と、文書を見せずに LoRA だけ当てた生徒(LoRA-adapted, no context)の応答の差を最小化するコンテキスト蒸留の教師-生徒目的です。
アーキテクチャの公式値
公式ブログは実装をこう書いています。「8 cross-attention blocks, ~309M parameters, targeting MLP layers in Gemma-2-2b-it」。推論はバッチモード(全レイヤーを一度に・速い)とイテレーティブモード(1レイヤーずつ・省メモリ)を選べて、どちらも1秒未満で終わります。
一方、Hugging Face に置かれている配布チェックポイントの args.yaml(実ファイル・2026年9月27日取得)を開くと、より細かい実値が読めます。ブロック数の数え方はブログ記述と1つずれるので、どちらかへ丸めずに両方を併記します。
| 項目 | 公式ブログの記述 | 配布 args.yaml の実値 |
|---|---|---|
| 集約器 | Perceiver ベース | aggregator_type: perceiver |
| ブロック数 | クロスアテンション8ブロック | num_blocks: 9/num_self_attn_per_block: 0 |
| パラメータ数 | 約309M(3億900万) | args.yaml に記載なし(重みファイルは約1.17GiB) |
| 文書エンコーダ | 凍結 LLM のレイヤーごと活性 | ctx_encoder_type: per_layer_activations |
| LoRA ランク | rank-8 | lora_r: 8/lora_dropout: 0.0 |
| 当てる層 | MLP レイヤー | target_modules: [down_proj](MLP の down_proj のみ) |
| 損失 | 教師(全文)と生徒(LoRA のみ)の差を最小化 | use_kl_loss: true/gen_lora_l1_reg_coef: 0.1 |
| ベース系列長 | Gemma-2-2b-it のネイティブ窓は8K | max_base_len: 8192 |
長文を扱うのはチャンキングで、ランクを横に伸ばす
固定ランクのアダプタ1枚では長い文書が入りきらないため、D2L は文書を連続するチャンクに分割し、同じハイパーネットワークで独立に処理します。各チャンクが rank-r の LoRA を出し、それをランク次元で連結することで実効ランク r × K のアダプタになります。ハイパーネットワークの構造を変えずに文書長へスケールできるのはこの設計のおかげです。
訓練と評価でチャンクの粒度が違うのも押さえておく価値があります。メタ学習時の入力コンテキストは32〜256トークン、チャンク数は1〜8のランダム、最小チャンクは25トークン。一方 NIAH 評価では干し草の山を1,024トークン単位のチャンクに切って1枚のアダプタに合成しています。つまり「訓練時より桁違いに長い入力へ外挿できている」ことがチャンキングの成果です。RAG のチャンク設計と考え方が近いので、RAGチャンキング戦略 完全ガイドの分割設計と読み比べると設計判断が立てやすくなります。
「1秒未満」が成り立つのは、高いコストを前払いしているから
D2L の速さはコスト償却(amortization)の結果です。高いのはメタ学習(1回だけ)で、運用時は1フォワードパスで済む。公式ブログはここを美化せずこう書いています。「it is not a free lunch. Meta-training can be very expensive (days to weeks on multiple GPUs)」。複数GPUで数日から数週間という数字が公式に明記されているので、「1秒未満で微調整できる技術」という要約だけを持って社内提案に出すと前提を外します。公開済みのチェックポイントを使う限りこの費用は発生しませんが、独自ドメイン用にハイパーネットワークを訓練するなら、この桁が初期コストになります。
Doc-to-LoRAの一次情報はどこにあるか|論文・GitHub・Hugging Face・ICMLの4か所
「doc-to-lora」を完全一致で検索して来た場合、欲しいのはたぶん解説ではなく出どころです。2026年9月27日時点で公式が出している一次情報は次の4系統に整理できます。いずれも当日アクセスして状態を確認しました。
| 種類 | 場所 | 2026年9月27日時点の状態 |
|---|---|---|
| 論文 | arXiv:2602.15902 | v1 のみ(2026年2月13日 06:54 UTC・566KB)。改訂版なし。分類は cs.CL / cs.AI。Comments 欄に学会名の記載はない |
| 解説ページ | pub.sakana.ai/doc-to-lora/ | Doc-to-LoRA と Text-to-LoRA の合同ページ。表記は「Feb 2026」。ベンチマーク図・対話デモの実録が載る。JavaScript 必須 |
| 実装 | GitHub SakanaAI/doc-to-lora | MIT License。スター827・フォーク105・オープン Issue 0。main の最新コミットは2026年5月25日。リリース・タグは0件 |
| 重み | Hugging Face SakanaAI/doc-to-lora | ゲートなし・非公開なし。いいね15。最終更新2026年2月12日。4構成・合計約6.5GB |
ICML 2026採択の扱い(ここは慎重に)
公開当初、Doc-to-LoRA は「テクニカルレポート」でした。公式ブログ末尾の引用ブロックは今も @techreport{...note = {Technical Report}} のままです。ところがGitHub の README は違います。2026年5月25日の「Change citation format for Doc-to-LoRA」コミット以降、README の引用は次の形になっています。
@inproceedings{charakorn2026doctolora,
  title       ={Doc-to-Lo{RA}: Learning to Instantly Internalize Contexts},
  author      ={Rujikorn Charakorn and Edoardo Cetin and Shinnosuke Uesaka and Robert Tjarko Lange},
  booktitle   ={Forty-third International Conference on Machine Learning},
  year        ={2026},
  url         ={https://openreview.net/forum?id=iW1oBBO72S}
}
Forty-third International Conference on Machine Learning は第43回 ICML、つまりICML 2026 です。テクニカルレポートから @inproceedings へ書き換わったこと自体が、採択を反映した更新と読めます。ただし本記事では断定を1段落としておきます。理由は、引用に書かれた OpenReview のフォーラム(iW1oBBO72S)を当日確認しようとしたところ、api.openreview.net も api2.openreview.net も「Challenge verification required」で HTTP 403 を返し、掲載状態を独立に検証できなかったためです。2026年9月27日時点で言えるのは「公式リポジトリの README の引用情報が ICML 2026 の @inproceedings になっている」までで、それ以上の公式アナウンスは確認できていません。
なお、同時発表された Text-to-LoRA 側は公式ブログの引用が booktitle = {Forty-second International Conference on Machine Learning}, year = {2025} で、こちらはICML 2025(第42回)採択です。2本の関係は後半の専用セクションで整理します。
配布済みの対応モデルは4チェックポイント|Gemma 2 2B・Mistral 7B・Qwen3 4Bまで揃っている
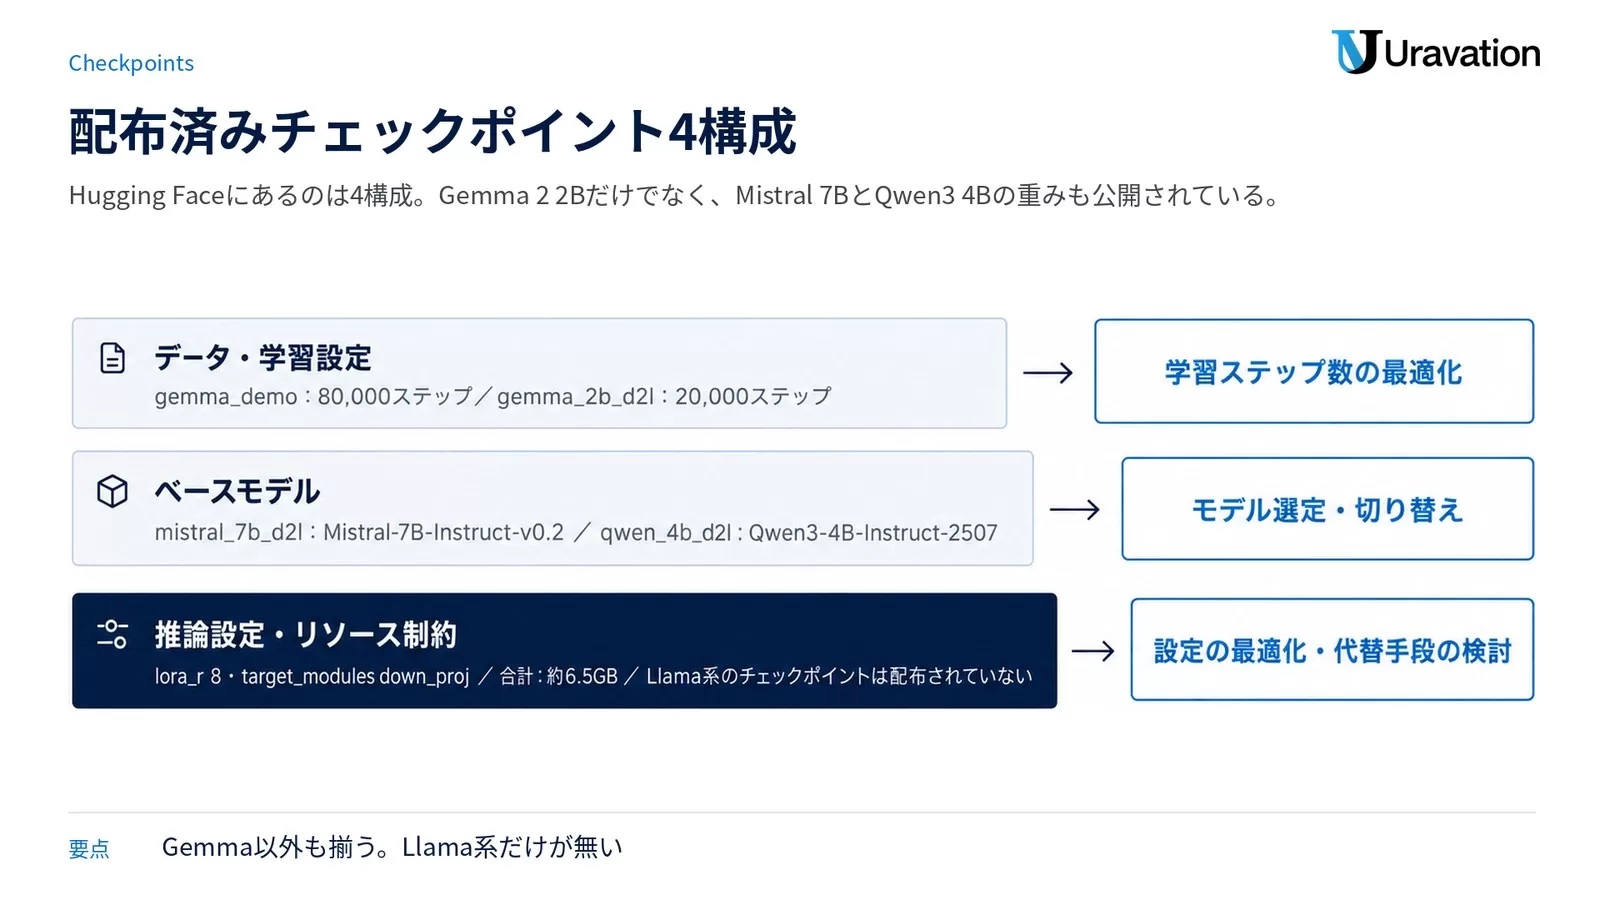
日本語の解説記事はほぼ例外なく「ベースモデルは Gemma-2-2b-it」で止まっています。実際に Hugging Face のリポジトリを開くと、2026年9月27日時点で4つのチェックポイントが配布済みです。しかも args.yaml が各構成に同梱されているので、ベースモデルも学習設定も外から読めます。
| 構成ディレクトリ | ベースモデル(args.yaml の model_name_or_path) |
学習ステップ | 重みファイルの実サイズ |
|---|---|---|---|
gemma_demo/checkpoint-80000 |
google/gemma-2-2b-it |
80,000 | 1,261,017,534 バイト(約1.17GiB) |
gemma_2b_d2l/checkpoint-20000 |
google/gemma-2-2b-it |
20,000 | 1,261,017,534 バイト(約1.17GiB) |
mistral_7b_d2l/checkpoint-20000 |
mistralai/Mistral-7B-Instruct-v0.2 |
20,000 | 2,296,925,054 バイト(約2.14GiB) |
qwen_4b_d2l/checkpoint-20000 |
Qwen/Qwen3-4B-Instruct-2507 |
20,000 | 1,684,073,598 バイト(約1.57GiB) |
| 合計 | 3系統のベースモデル | — | 6,503,033,720 バイト(約6.5GB) |
読み方の要点は3つです。
- Mistral と Qwen は「今後の対応予定」ではなく、すでに重みがある。リポジトリ側にも
scripts/niah/train_mistral_7b.shとscripts/niah/train_qwen3_4b.sh、configs/main_exp/mistral/・configs/main_exp/qwen/が実在します。GitHub のscripts/main_exp/README.mdも「download training data for all three models」と3モデル前提で書かれています。 - README の Python サンプルが読むのは
gemma_demo/checkpoint-80000の1つだけ。ほかの3つは自分でパスを差し替える必要があります。gemma_demoは80,000ステップで、max_packed_ctx_lenが4096、max_qas_lenが2048と、ほかの20,000ステップ構成より長い文脈に寄せた設定です(learning_rateも 4.0e-05 対 2.0e-05 で異なる)。デモ用に別建てされた重み、と理解するのが近いです。 - Llama 系のチェックポイントは配布されていない。2026年9月27日時点で Hugging Face 上に Llama ベースの構成はなく、公式リポジトリにも Llama 用の設定ファイルはありません。Llama で使いたい場合は自前でハイパーネットワークを訓練する側に回ります。
各チェックポイントに共通する設定も args.yaml から読めます。lora_r: 8、target_modules: [down_proj]、aggregator_type: perceiver、ctx_encoder_type: per_layer_activations、max_base_len: 8192、num_train_epochs: 3.0、per_device_train_batch_size: 1、bf16: true/tf32: true、optim: adamw_torch_fused、lr_scheduler_type: cosine_with_min_lr。Mistral 7B と Qwen3 4B の構成は max_ctx_chunk_len: 512・min_ctx_chunk_len: 25 でそろっています。
公式ベンチマークの数字|SQuAD 83.5%・長文QA 85%・NIAHは約40Kトークン
ここは旧版の本記事で数字の取り違えがあった箇所なので、公式ブログの記述と1対1で合わせ直します。SQuAD の節と長文コンテキスト QA の節では、比較相手のベースラインの数字が別物です。混ぜると「Oracle CD は40GB 食う」といった逆の結論になります(実際は Oracle CD が約1GB、generated-query CD が40GB超)。
SQuAD(短文コンテキストQA)
| 手法 | 精度(フルコンテキスト比) | 更新時間 | メモリ |
|---|---|---|---|
| フルコンテキスト(上限) | 100%(基準) | 毎クエリで全文を再入力 | 文書長に比例 |
| Oracle CD(テストクエリを直接使う蒸留) | 公式ブログ本文に数値記載なし(図のみ) | 40秒 | 約1GB |
| Generated-query CD(従来のCD) | 公式ブログ本文に数値記載なし(図のみ) | 100秒超 | 40GB超 |
| Doc-to-LoRA | 83.5% | 1秒未満 | 約1GB |
Oracle CD は「テストクエリをそのまま蒸留に使う」条件付きの上振れベースラインで、実運用では使えません。generated-query CD がクエリ生成と逆伝播を要するため100秒超・40GB超になります。D2L は Oracle CD と同じ約1GB のまま、更新を40分の1以下の時間に押し込んでいる、という読み方が正確です。
長文コンテキストQA
| 手法 | 相対精度 | 更新時間 | VRAM |
|---|---|---|---|
| Oracle CD | 90% | 40秒 | 7GB超 |
| Doc-to-LoRA | 85% | 1秒未満 | 公式ブログに数値記載なし |
テストサンプルは最大32Kトークンまで伸び、これはD2L の学習時最長サンプル(2,344トークン)を大きく超えています。それでも85%が出るのがチャンキングによる外挿の効果です。
Needle-in-a-Haystack(NIAH・長文検索)
- 約40Kトークンまでほぼ完璧:ベースモデル(Gemma-2-2b-it)の8Kコンテキスト窓は8Kを超えると破綻するのに対し、D2L は約40Kトークンまで精度を維持。論文 Abstract 側の言い方は「対象 LLM のネイティブ文脈長を4倍超える系列長でほぼ完璧なゼロショット精度」です(ブログの約40K/8K と論文の4倍超は、どちらも公式表現なので併記します)。
- 追加メモリは50MB未満で一定:128Kトークンの干し草の山ではベースモデルが12GB超の追加メモリを要するのに対し、D2L の内在化済み知識は50MB未満・文書長に関係なく一定。
- 訓練は極端に短い入力だけ:メタ学習は32〜256トークン、チャンク1〜8、最小チャンク25トークン。評価では1,024トークン単位でチャンクして合成。
KV キャッシュ側を圧縮して同じ問題を解く手法との比較軸としては、TurboQuant|KVキャッシュ6倍圧縮の仕組みが対になります。D2L は KV キャッシュを圧縮するのではなく要らなくする側、という違いです。
画像を LoRA に入れるゼロショット実験
公式ブログは副次実験も出しています。VLM(Gemma-3-4b-it)を文書エンコーダとして別のハイパーネットワークを訓練し、訓練中に画像を1枚も見せずに、テキスト専用モデル(Gemma-2-2b-it)へ画像情報を LoRA として転送する構成です。ImageNet の10クラス部分集合 Imagenette で75.03%の精度に達しています。ブログはこれを「Doc-to-LoRA を汎用の Context-to-LoRA 写像として使える可能性」と位置づけており、ハイパーネットワークがモダリティ間の橋になりうるという示唆です。
Doc-to-LoRAの料金とライセンス|コードも重みも無償、かかるのはGPU代だけ
2026年9月27日時点で、Sakana AI は Doc-to-LoRA の有償プラン・商用 API・SaaS 提供を公開していません。公式 Corporate Info に記載されているプロダクトは Sakana Chat/Sakana Marlin/Sakana Fugu で、Doc-to-LoRA はその一覧に入っていません。研究成果としてコードと重みが公開されている状態です。
| 対象 | 2026年9月27日時点の条件 |
|---|---|
| 実装コード(GitHub) | MIT License・無償。2026年3月2日のコミットで追加 |
| 重み(Hugging Face) | ダウンロード無償・ゲートなし。モデルカードにライセンスタグの記載はない(タグは region:us のみ) |
| ベースモデル | Gemma 2 / Mistral 7B Instruct v0.2 / Qwen3 4B Instruct の各配布元ライセンスが別途かかる。Gemma はゲート付きのため huggingface-cli login が必要 |
| API 利用料 | 該当なし(公式 API が存在しない) |
| 実際に発生する費用 | GPU インスタンス代とストレージ代のみ。金額は利用するクラウド事業者の料金表に依存し、Sakana AI 側の課金はない |
商用利用を検討する場合の確認順は、①リポジトリの MIT ライセンス(コードは明確)→②Hugging Face の重みのライセンス(2026年9月27日時点でモデルカードに明示がないため、利用前に配布元へ確認が必要)→③ベースモデル側のライセンス、の3段です。②を「MIT だから重みも自由」と読み替えないでください。リポジトリの LICENSE はコードに対するもので、重みのライセンスは別に示される必要があります。
動かすのに本当に必要な環境|install.shが要求する構成と、学習データ328GB
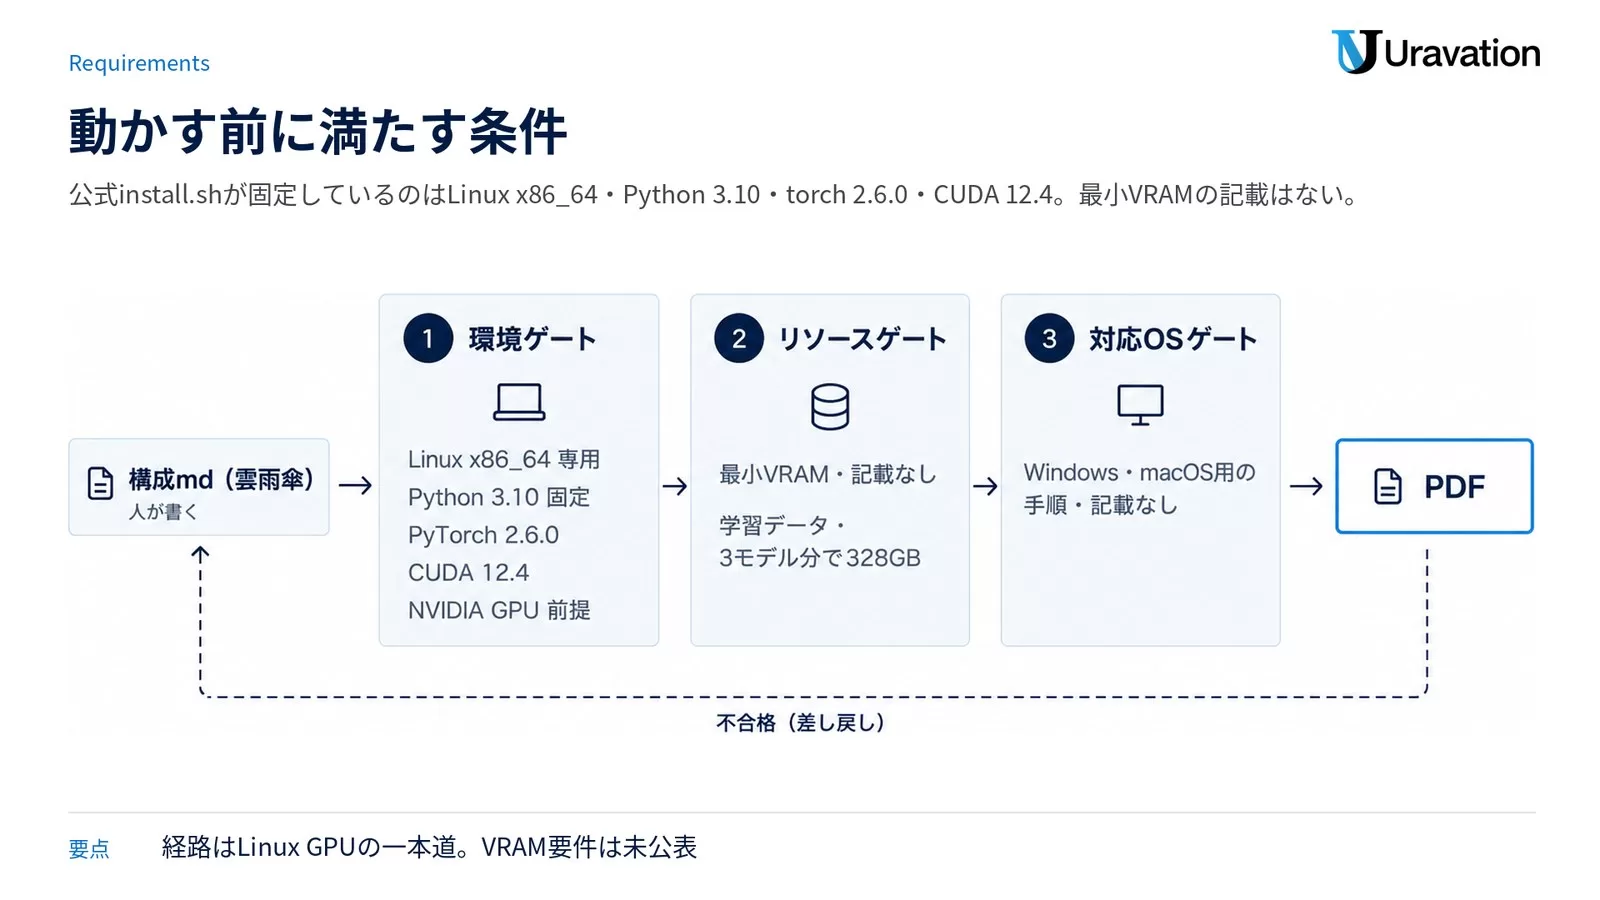
「単一GPUで動く」「4GBのVRAMで足りる」といった要約が流通していますが、公式は最小VRAM要件を一度も明示していません。2026年9月27日時点で README にも install.sh にも GPU 世代・VRAM 容量の要件は書かれていません。書かれているのは、もっと具体的な依存関係です。install.sh の実物を読むとこうなります。
uv venv --python 3.10 --seed
uv pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 --torch-backend=cu124
uv sync
uv pip install tokenizers==0.21.0
uv pip install https://github.com/Dao-AILab/flash-attention/releases/download/v2.7.4.post1/flash_attn-2.7.4.post1+cu12torch2.6cxx11abiFALSE-cp310-cp310-linux_x86_64.whl
uv pip install flashinfer-python==0.2.2 -i https://flashinfer.ai/whl/cu124/torch2.6| 要件 | install.sh が指定している値 | 実務上の意味 |
|---|---|---|
| Python | 3.10 固定(uv venv --python 3.10) |
3.11・3.12 は flash-attn の wheel が合わない |
| PyTorch | 2.6.0(torchvision 0.21.0 / torchaudio 2.6.0) | バージョン固定。上げると flashinfer のインデックスも合わなくなる |
| CUDA | 12.4(--torch-backend=cu124) |
NVIDIA GPU 前提。CPU 実行・Apple Silicon 実行の手順は公式にない |
| OS・アーキテクチャ | wheel 名が cp310-cp310-linux_x86_64 |
Linux x86_64 専用。Windows・macOS 用の手順は2026年9月27日時点で公式に記載なし |
| その他 | flash-attn 2.7.4.post1 / flashinfer-python 0.2.2 / tokenizers 0.21.0 | いずれもバージョン固定で直接 wheel を指定 |
| 最小 VRAM | 記載なし | 2026年9月27日時点で公式に記載なし。自環境で実測して判断する |
install.sh は依存関係を入れたあと、続けて SQuAD データセット(rajpurkar/squad)を取得し、data/build_drop_compact.py・build_pwc_compact.py・build_ropes_compact.py・build_squad_compact.py の4本を回します。つまりセットアップの時点で DROP・PwC・ROPES・SQuAD の前処理まで走る設計です。huggingface-cli login は「optional: needed for gated models」とコメントアウトされていますが、Gemma 2 はゲート付きなので実際には必要になります。
「50MB」の読み違いを避ける
50MB 未満というのは生成された LoRA アダプタのサイズです。動かすために手元へ置くものは別で、少なくとも次の3つが積み上がります。
- ハイパーネットワークのチェックポイント:約1.17GiB〜2.14GiB(構成ごと。4構成すべてなら約6.5GB)
- ベースモデルの重み:Gemma 2 2B/Mistral 7B/Qwen3 4B のいずれか
- 論文の主実験を再現する場合の学習データ:1モデルあたり約100GB、3モデル分で328GB(
scripts/main_exp/README.mdの原文「~100 GB for each model」「download training data for all three models (328GB)」)
推論だけならデータ328GBは要りませんが、「論文の数字を自分で再現する」までやるなら桁が変わります。加えてメタ学習は公式が「複数GPUで数日〜数週間」と書いている作業です。ローカル推論基盤側の設計判断はvLLMでオープンLLMをセルフホスト|本番運用ガイド、手軽に試す側はOllamaの使い方 2026|ローカルLLMでAIエージェントが参考になります(どちらも D2L 専用の手順ではなく、周辺基盤の話です)。
触ってみる最短手順|公式READMEのコマンドだけで内在化を確認する
以下はすべて公式 README・install.sh・examples/python_api.py に実在する記述だけです。公式に書かれていない引数やフラグは足していません。
1. セットアップ
git clone https://github.com/SakanaAI/doc-to-lora.git
cd doc-to-lora

# README の Installation 節そのまま
curl -LsSf https://astral.sh/uv/install.sh | sh
./install.sh
2. 学習済みハイパーネットワークの取得
uv run huggingface-cli login
uv run huggingface-cli download SakanaAI/doc-to-lora --local-dir trained_d2l --include "*/"
--include "*/" は README に明記されている引数です。落ちてくるのは前掲の4構成(合計約6.5GB)。
3. Python API で内在化を確認する
公式リポジトリの examples/python_api.py の内容です。モジュール名が doc_to_lora ではなく ctx_to_lora であること、チェックポイントは from_pretrained ではなく from_state_dict で読むことに注意してください。
# caveat: this interface only supports non-batched inputs
# for batched inference please see `src/ctx_to_lora/modeling/hypernet.py`
import torch

from ctx_to_lora.model_loading import get_tokenizer
from ctx_to_lora.modeling.hypernet import ModulatedPretrainedModel

checkpoint_path = "trained_d2l/gemma_demo/checkpoint-80000/pytorch_model.bin"
state_dict = torch.load(checkpoint_path, weights_only=False)
model = ModulatedPretrainedModel.from_state_dict(
    state_dict, train=False, use_sequence_packing=False
)
model.reset()
tokenizer = get_tokenizer(model.base_model.name_or_path)

doc = open("data/sakana_wiki.txt", "r").read()
chat = [{"role": "user", "content": "Tell me about Sakana AI."}]
chat_ids = tokenizer.apply_chat_template(
    chat,
    add_special_tokens=False,
    return_attention_mask=False,
    add_generation_prompt=True,
    return_tensors="pt",
).to(model.device)

# 内在化。これ以降の生成は取り込んだ情報の影響を受ける
model.internalize(doc)

outputs = model.generate(input_ids=chat_ids, max_new_tokens=512)
print(tokenizer.decode(outputs[0]))

# 内在化を解除したいときは model.reset()
効果の確認手順まで README がお膳立てしています。model.reset() で内在化を外して同じ質問を投げると、README のコメントどおりモデルはハルシネーションを起こす。この前後比較が最短の動作確認です。サンプル文書として data/sakana_wiki.txt と data/gutenburg_sample.txt がリポジトリに同梱されています。
4. 対話デモ(Gradio)
uv run demo/app.py公式ブログには、この UI で文書を1回内在化したあと、生のコンテキストをプロンプトに入れずに複数の質問へ答えさせる動画デモが置かれています。ブログの表現では「持続的なメモリのトグルを触っている感覚」に近い体験になる、とのことです。
Sakana AIという会社とDoc-to-LoRAの位置づけ
Sakana AI は2023年に東京で設立されたフロンティア AI の研究開発企業です。公式 Corporate Info(2026年9月27日取得)の表記では、創業者は David Ha(Co-Founder & CEO)、Ren Ito(Co-Founder & Chairman)、Llion Jones(Co-Founder & CTO)の3名。Llion Jones 氏は Transformer を提示した論文「Attention Is All You Need」の共著者です。David Ha 氏は Google Brain 東京のリサーチチームを率いた経歴で、その前は Goldman Sachs Japan で金利トレーディングの責任者を務めています。さらに Jürgen Schmidhuber 氏が Chief Scientific Advisor として RSI Lab を統括し、CFO は2025年7月入社の Ai Fujiki 氏です。
公式が自社の研究として並べているのは The AI Scientist、Darwin Gödel Machine、ShinkaEvolve、AB-MCTS、Multi-Agent Orchestration Foundation Models、日本語向けの Namazu LLMs。プロダクトは Sakana Chat、Sakana Marlin、Sakana Fugu。応用領域として金融・防衛・インテリジェンスを挙げています。Doc-to-LoRA はプロダクト一覧には入っておらず、研究成果としてコードと重みが公開されている段階です。
会社そのもの(資金調達、企業価値、上場、株主構成、プロダクトの料金)については、公式 Corporate Info に数値の記載がないため本記事では扱いません。サカナAI(Sakana AI)とは|何がすごい・上場・料金に会社側の情報をまとめてあります。
技術としての位置
Doc-to-LoRA は、現行の Transformer ベース LLM を置き換える技術ではなく、その運用コストを下げる橋渡しの技術です。長文文書を毎回読み直す前提を外す、という一点に効きます。専門文書を大量に抱える組織(設備マニュアル、規格書、診療ガイドライン、規制文書など)にとっては、「文書を増やしても推論時の追加メモリが50MB未満で一定」という性質が設計の自由度に直結します。ただし後述のとおり精度は上限に届かないため、置き換えではなく併用の設計が現実的です。
注意点・落とし穴 — 導入前に知っておくべき制限事項
Doc-to-LoRA は画期的な技術ですが、万能ではありません。導入を検討する際に認識しておくべき制限事項があります。
1. 精度のトレードオフ:ミッションクリティカルな用途には不向き
SQuAD でフルコンテキスト比83.5%、長文コンテキスト QA で85%という数字は、上限に対して15ポイント前後の差が残ることを意味します。医療診断、法律判断、金融取引など、1つの誤りが重大な結果を招く領域では、この差は許容できない場合があります。このようなユースケースでは、Doc-to-LoRA を唯一の知識ソースとするのではなく、RAG との併用や人間によるレビューのパイプラインに組み込むことを推奨します。
2. 構造化ドキュメントに最適化:非構造的コンテンツには弱い
公式が評価に使っているのは SQuAD・DROP・ROPES・PwC といった読解ベンチマークと、合成 NIAH タスクです。事実情報の抽出と保持に寄った設計であり、以下のようなコンテンツでは性能が保証されていません。
- 文脈に強く依存する比喩的・暗示的な表現
- 高度に創造的な文章(詩、小説など)
- 図表やグラフに依存する情報
- ドキュメント間の相互参照が多い資料体系
3. ベースモデル依存:モデル切り替え時は別のチェックポイントが必要
ハイパーネットワークは特定のベースモデルに紐づいています。gemma_2b_d2l のチェックポイントで生成した LoRA を Mistral 7B に当てることはできません。2026年9月27日時点で配布されているのは Gemma 2 2B・Mistral 7B Instruct v0.2・Qwen3 4B Instruct の3系統で、それ以外のモデル(Llama 系など)に載せるにはハイパーネットワークを自分で訓練する必要があります。ベースモデルを固定して運用する前提なら、この制約は表に出ません。
4. ハイパーネットワークの事前訓練コスト
「1秒未満の内在化」は、事前訓練済みのハイパーネットワーク(約309Mパラメータ)があって初めて成立します。公式ブログは訓練コストを「複数GPUで数日〜数週間」と明記し、学習データは1モデルあたり約100GB。公開済みのチェックポイントを使う限りこの費用は発生しませんが、カスタムドメイン用に訓練するなら初期投資の桁が変わります。
5. リポジトリの更新が2026年5月25日以降止まっている
main ブランチの最新コミットは2026年5月25日の「Change citation format for Doc-to-LoRA」で、リリース・タグはいずれも0件(2026年9月27日確認)。オープン Issue は0件です。活発に機能追加が続いているプロダクトではなく、論文の参照実装として置かれているリポジトリとして扱うのが妥当です。本番投入を前提にするなら、依存バージョンの固定(Python 3.10・torch 2.6.0・CUDA 12.4)を自分の側で維持する覚悟が必要になります。
Doc-to-LoRAが最も効果を発揮する条件
- 静的な知識(頻繁に更新されないドキュメント)の高速参照
- 速度とメモリが精度より重要なユースケース(大量文書を横断する初期スクリーニングなど)
- リソース制約のあるオンプレ・エッジ環境でのAI運用
- 複数の専門ドメインのLoRAアダプタを切り替えながら使うマルチドメイン対応
- ベースモデルが Gemma 2 2B / Mistral 7B Instruct v0.2 / Qwen3 4B Instruct のいずれかに固定できる
Doc-to-LoRAが「効く場面」と「効かない場面」— 用途×適性の早見表
Doc-to-LoRAはあらゆるドキュメント適応タスクに万能ではない。公式の性能評価(SQuAD・長文QA・NIAH)からわかる傾向と、一般的なLLMアダプテーション設計の知見を組み合わせると、「この場面に投入すれば費用対効果が高い」「この場面では別手法を使うべき」という使い分けの軸が見えてくる。
| ユースケース | 適合度 | 理由 |
|---|---|---|
| 社内ナレッジベース・FAQへの即時適応(文書更新頻度:週次〜月次) | ◎ 高適合 | 文書が構造化されており、新しいLoRAを高速に生成できる。更新のたびにファインチューニングジョブを走らせるコストが不要 |
| 長文技術仕様書・マニュアル(長大なコンテキスト)を根拠としたQ&A | ◎ 高適合 | KVキャッシュをLoRAに置き換えることで、長文コンテキストを50MB未満の追加メモリで保持できる。RAGのチャンク分断による文脈欠落を回避 |
| エッジデバイス・オンプレ環境でのドキュメント検索 | ◎ 高適合 | 推論時の追加メモリが文書長に関係なく一定のため、GPUメモリの限られた端末でも見積もりが立てやすい |
| ミッションクリティカルな医療・法律判断支援 | △ 要検討 | フルコンテキスト比83.5〜85%で上限に届かない(公式ベンチマーク参照)。誤回答の許容範囲が厳しい用途では追加検証フローが必要 |
| 非構造化コンテンツ(会話ログ・SNS・雑多なメモ集)への適応 | × 低適合 | ハイパーネットワークは読解系ベンチマークのデータで訓練されているため、非構造データへの汎化は保証されていない |
| モデル挙動を根本的に変えたい(スタイル転換・新タスク獲得) | × 低適合 | Doc-to-LoRAはドキュメント知識の「注入」に特化。rank-8・down_projのみという出力空間の制約上、大幅な挙動変更には表現力が足りない。挙動を変えたいならText-to-LoRAか通常のLoRA訓練を検討 |
| マルチドメイン並列対応(ドキュメントを頻繁に切り替えるマルチテナント) | ○ 中適合 | LoRAを動的切り替えできる設計と組み合わせれば有効。ただし切り替えごとのロードオーバーヘッドを計測し許容値内に収まるか確認が必要 |
判断の要点: 「ドキュメントが構造化されている」「更新頻度が高い」「VRAMが制約」という3条件が揃うほど、Doc-to-LoRAの優位性は大きくなる。逆に、精度の絶対値が最優先されるケースや、文書の質が不均一なケースでは、RAGまたは通常のLoRAファインチューニングとの組み合わせを検討するべきだ。RAG・ファインチューニング・プロンプトの3択で迷っている段階なら、RAG・ファインチューニング・プロンプトの使い分けの判断フローを先に通すと選択肢が絞れる。
他のVRAM削減・省メモリ手法との使い分け — 量子化・QLoRA・オフロードとのトレードオフ比較
Doc-to-LoRAはLLM省メモリ戦略のひとつにすぎない。現場では量子化(GPTQ/AWQ)、QLoRA、CPU/NVMe オフロードなど複数の手法を目的に応じて使い分けることが多い。以下に各手法の特性と、Doc-to-LoRAとの関係を整理する(削減率・精度の具体数値は環境・モデルに依存するため、必ず公式ドキュメントと自環境の実測で確認すること)。
| 手法 | 主な削減対象 | 特徴・トレードオフ | Doc-to-LoRAとの関係 |
|---|---|---|---|
| 量子化(GPTQ/AWQ・INT4) | モデルウェイト | ウェイトを低ビット化してVRAMを削減。精度損失の程度は設定・モデルに依存する | 目的が別。量子化ベースモデル上でDoc-to-LoRAを動かせるかは公式に記載がないため、自分で検証が必要 |
| QLoRA | ファインチューニング時のメモリ | 量子化+LoRAで大規模モデルを少ないGPUメモリで訓練できる手法 | 役割が異なる。QLoRAは「訓練時」の省メモリ手法。Doc-to-LoRAは「推論時」のコンテキスト圧縮。目的・フェーズが別 |
| 通常LoRA(標準的なPEFT) | ファインチューニング時パラメータ数 | フルfinetuningと比較して訓練コストを大幅削減。タスク・ランク設定で精度は変化 | Doc-to-LoRAは「LoRAを勾配計算なしで生成する」点が最大の違い。通常LoRAは文書更新のたびに再訓練が必要 |
| RAG(検索拡張生成) | コンテキスト長(KVキャッシュ) | 長文を丸ごと入力しない分、推論時メモリを節約。チャンク分断による文脈欠落リスクがあり検索精度に依存 | 直接の代替候補。RAGはインフラが軽く知識更新が即時。Doc-to-LoRAは検索器なしで一定メモリだが、公式ベンチマークでは上限精度に届かない |
| KVキャッシュ量子化 | KVキャッシュそのもの | キャッシュを低ビット化して長文時のメモリを削る。キャッシュ自体は保持し続ける | 同じ痛点を別方向から解く。Doc-to-LoRAはKVキャッシュを圧縮するのではなく不要にする |
| CPU/NVMeオフロード(DeepSpeed ZeRO等) | GPU→CPU/ストレージへのパラメータ退避 | GPUメモリを大幅削減できるが、PCIe帯域がボトルネックでレイテンシが増加するためリアルタイム応答用途には不向き | Doc-to-LoRAの応答速度の優位性を殺さないよう、オフロードとの組み合わせは慎重に評価する |
| FlashAttention | アテンション計算時のメモリ効率 | 等価な計算で省メモリ・高速化(長文ほど効果大)。精度への影響はほぼなし | 競合しない。Doc-to-LoRA自身が flash-attn 2.7.4.post1 を依存に持ち、args.yaml も use_flash_attn: true |
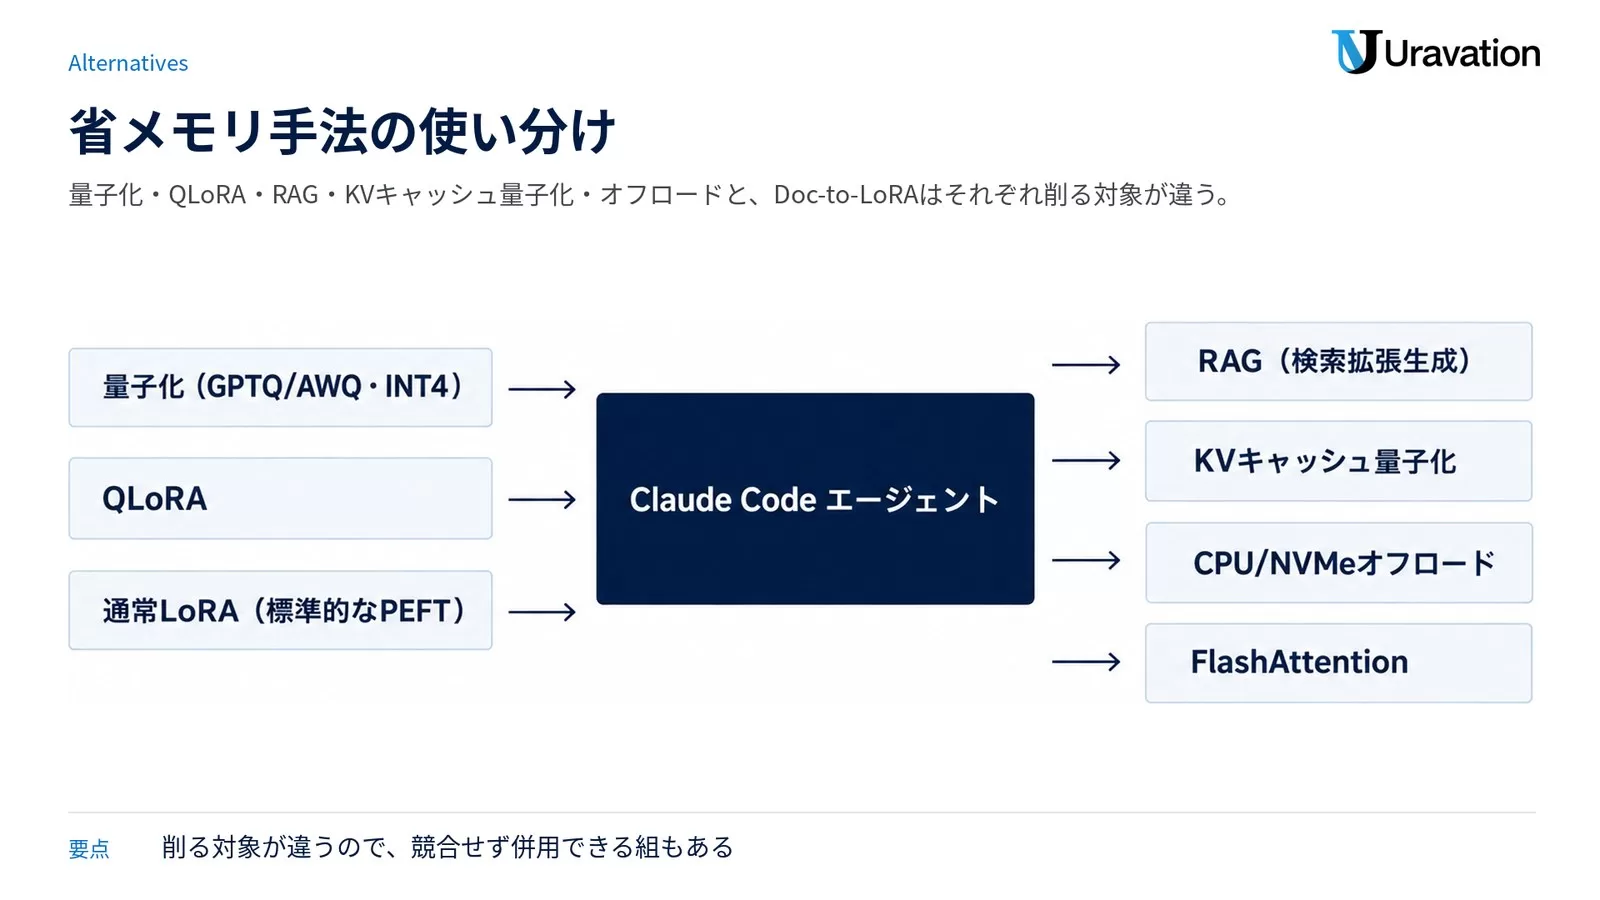
使い分けの原則:
- 「文書知識を素早く注入したい・推論時の追加メモリを一定にしたい」 → Doc-to-LoRAが第一候補
- 「モデル自体を軽量化したい・推論コストを下げたい」 → 量子化(AWQ/GPTQ)
- 「限られたGPUで大規模モデルをファインチューニングしたい」 → QLoRA
- 「既存ドキュメントストアを活かしたい・知識を即時に差し替えたい」 → RAG
- 「長文の文脈を保持したまま、キャッシュだけ縮めたい」 → KVキャッシュ量子化系(TurboQuantの仕組みなど)
各手法の削減率・精度の具体数値は環境・モデルによって大きく異なる。Doc-to-LoRA 側についても、公式が出しているのは Gemma-2-2b-it を中心としたベンチマーク値であり、自分の構成での数字は自分で測る前提で計画を立てるべきだ。長期記憶の設計として比較したい場合はAIエージェントのメモリ実装入門|コード付き5パターンとAIエージェントのメモリ設計|Short/Long/Episodic実装ガイドが、外部ストア型との対比の材料になる。
Text-to-LoRAとの関係 — 同チームが2本を並行して発表した理由
Doc-to-LoRAと同じ公式ページで発表されたText-to-LoRA(T2L)は、ICML 2025に採択されています(公式ブログ末尾の引用が booktitle = {Forty-second International Conference on Machine Learning}, year = {2025})。この2本は同一チームによる並行研究であり、同じハイパーネットワークのアプローチを「ドキュメント→LoRA」と「自然言語タスク記述→LoRA」という異なる入力形式に適用したものです。
2論文の著者・arXiv番号・採択状況(2026年9月27日時点)
| 論文 | arXiv | 著者(公開情報) | 引用情報の学会表記 |
|---|---|---|---|
| Doc-to-LoRA Learning to Instantly Internalize Contexts |
2602.15902(v1・2026年2月13日) | Rujikorn Charakorn, Edoardo Cetin, Shinnosuke Uesaka, Robert Tjarko Lange | GitHub README は ICML 2026(第43回)の @inproceedings/公式ブログは @techreport のまま |
| Text-to-LoRA Instant Transformer Adaption |
2506.06105 | Rujikorn Charakorn, Edoardo Cetin, Yujin Tang, Robert Tjarko Lange | ICML 2025(第42回) |
Rujikorn Charakorn・Edoardo Cetin・Robert Tjarko Lange の3名は両論文に共通しており、同一チームが「ドキュメント知識の即時注入(D2L)」と「テキスト指示によるゼロショット適応(T2L)」という2つの問題設定を同時に解いたことがわかります。
公式が示している対比表
| 観点 | Doc-to-LoRA | Text-to-LoRA |
|---|---|---|
| 解く問題 | 知識更新のためのコンテキスト蒸留が高コスト | モデル適応のためのファインチューニングが高コスト |
| ハイパーネットワークが学ぶこと | 新しい事実知識をLLMへ即座に追加する | 下流タスク向けにLLMを即座に適応させる |
| 入力 | ドキュメント(テキスト、またはVLM経由の視覚トークン) | 自然言語のタスク記述 |
| LoRAが保持するもの | ドキュメント由来の事実知識 | タスク固有のふるまい・スキル |
| 学習目的 | コンテキスト蒸留(教師=全文コンテキストのモデル) | 再構成損失、またはエンドツーエンドのSFT損失 |
| LoRAの当て先(公式値) | MLPの down_proj・rank-8 |
全レイヤーの q_proj/v_proj・rank-8(アダプタ約340万パラメータ) |
Text-to-LoRA 側の学習データは、SNI 由来の Lots-of-LoRAs コレクションからフィルタ後479タスク、ベースモデルは Mistral-7B-Instruct。訓練は2通りで、既存の LoRA を復元する再構成訓練と、生成アダプタを凍結モデルに当てて下流損失で直接ハイパーネットワークを更新するSFT訓練です。公式ブログは「再構成訓練は本質的にアダプタライブラリの圧縮」と位置づけ、汎化を測るには SFT 訓練が必要だと整理しています。また、ハイパーネットワークを大きくし訓練データセット数を増やすほど性能が上がる明確なスケーリング傾向も報告されています。
使い分けは単純です。ふるまいを変えたいなら T2L、知識を入れたいなら D2L。競合ではなく、同じ「コスト償却」の枠組みを別のシナリオに当てた補完関係です。実装は SakanaAI/text-to-lora に別途あり、Mistral-7B-Instruct をベースにした対話デモが含まれます。
Doc-to-LoRA GitHub実践ガイド — 評価スクリプトとリポジトリ構成
公式リポジトリ SakanaAI/doc-to-lora(スター827・フォーク105・2026年9月27日確認)には、論文で報告された SQuAD・NIAH の結果を自分で再現するためのスクリプトが含まれています。2026年9月27日にリポジトリのファイル一覧を取得して実在を確認した構成だけを載せます。
ルート直下の主要スクリプト
| パス | 用途 |
|---|---|
install.sh |
依存インストールとデータ前処理(Python 3.10 / torch 2.6.0 / CUDA 12.4 を固定) |
train.py |
ハイパーネットワークの学習エントリポイント |
run_eval.py |
評価実行のエントリポイント |
examples/python_api.py |
README に載っている最小構成の内在化サンプル |
demo/app.py |
Gradio UIのインタラクティブデモ |
webui/self_gen_viewer.py |
自己生成データのビューア(説明は webui/SELF_GEN_VIEWER.md) |
src/ctx_to_lora/ |
本体パッケージ(model_loading.py/configs.py/trainer.py/metrics.py/eval_utils.py/pooling.py ほか) |
実験の再現フロー(README の表どおり)
| 実験 | データ準備 | 学習 | 評価 |
|---|---|---|---|
| Main experiment(論文主結果) | scripts/main_exp/0-download_data(約100GB/モデル、3モデルで328GB) |
scripts/main_exp/1-train.sh(チャンク版は 2-train-chunk.sh) |
scripts/main_exp/eval/ 配下の各 .sh |
| NIAH(長文検索) | scripts/niah/0-gen_data.sh(1回だけ) |
scripts/niah/1-train.sh(Mistral / Qwen 用は train_mistral_7b.sh/train_qwen3_4b.sh) |
scripts/niah/2-eval.sh(テスト分割は 2-eval-test.sh) |
順番は README に明記されています(NIAH の README 原文:「run the scripts in this order」「data generation is only needed to be run once」)。実行はいずれも uv run bash <スクリプト> の形です。
ここで1つ罠があります。README の表はデータ準備を scripts/main_exp/0-download_data.sh と書いていますが、2026年9月27日時点のリポジトリに実在するのは scripts/main_exp/0-download_data.py(拡張子が .py)です。README の表記をそのままコピーして叩くとファイルが見つかりません。パスは自分の手元のツリーで確認してください。
再現できるベースラインが揃っている
scripts/main_exp/eval/ 配下には、比較対象のベースラインまで個別スクリプトで用意されています。ベンチマーク表の数字を「言われたまま」受け取らずに自分で確かめられるのは、この構成のおかげです。
d2l.sh:Doc-to-LoRA 本体の評価base_model.sh:ベースモデル素のままcd_oracle.sh:Oracle コンテキスト蒸留(テストクエリを直接使う上振れ条件)cd.sh/cd_minibatch.sh:通常のコンテキスト蒸留llmlingua.sh:プロンプト圧縮系のベースラインt2l.sh:Text-to-LoRA 側の評価imagenette_eval.py:VLM→LLM 内在化(Imagenette 75.03%)の評価
設定ファイルは configs/main_exp/self_gen_lv1_closed_qa_1_l2l.yaml(Gemma 用)、configs/main_exp/mistral/、configs/main_exp/qwen/、NIAH は configs/niah_exp/ctx_magic_number_32_256.yaml。最後のファイル名の「32_256」が、公式ブログの「メタ学習の入力コンテキストは32〜256トークン」に対応しています。
つまずきやすい4点|流通している要約と公式記述のズレ
この技術は要約されて伝わる過程で情報が落ちやすく、実際に手を動かす段で止まります。よくある4つを公式記述で潰しておきます。
❌ from doc_to_lora import ModulatedPretrainedModel と書く
⭕ 正しいパッケージ名は ctx_to_lora。公式サンプルは from ctx_to_lora.modeling.hypernet import ModulatedPretrainedModel と from ctx_to_lora.model_loading import get_tokenizer の2行。リポジトリのディレクトリも src/ctx_to_lora/ です。
❌ ModulatedPretrainedModel.from_pretrained("trained_d2l") で読み込もうとする
⭕ 公式は torch.load(checkpoint_path, weights_only=False) で state_dict を取り出し、ModulatedPretrainedModel.from_state_dict(state_dict, train=False, use_sequence_packing=False) で組み立てます。パスは構成ディレクトリまで指定が必要(例:trained_d2l/gemma_demo/checkpoint-80000/pytorch_model.bin)。読み込み後の model.reset() も公式サンプルに入っています。
❌ model.generate("ドキュメントについての質問") と文字列を渡す
⭕ generate() に渡すのは input_ids(トークナイズ済みテンソル)です。公式サンプルは tokenizer.apply_chat_template(...) でチャット形式の chat_ids を作ってから model.generate(input_ids=chat_ids, max_new_tokens=512) を呼びます。内在化は model.internalize(doc) で別に行い、質問文には文書を含めません。
❌ 「必要なのは50MB」と読んで GPU とストレージを小さく見積もる
⭕ 50MB 未満は生成された LoRA アダプタのサイズです。手元に置くハイパーネットワークのチェックポイント自体が約1.17GiB〜2.14GiB(4構成すべてで約6.5GB)あり、これにベースモデルの重みが加わります。論文の主実験を再現するなら学習データが1モデル約100GB。最小 VRAM 要件は2026年9月27日時点で公式に記載がないため、自環境で実測して見積もるしかありません。
よくある質問
Doc-to-LoRAとD2Lは同じものですか?
同じものです。D2L は Doc-to-LoRA の略称で、論文・公式ブログ・リポジトリのスクリプト名(scripts/main_exp/eval/d2l.sh、trained_d2l)でも一貫して使われています。arXiv の Abstract も「we propose Doc-to-LoRA (D2L)」と併記しています。
Doc-to-LoRAの論文はどれですか。ICMLに採択されていますか?
論文は arXiv:2602.15902「Doc-to-LoRA: Learning to Instantly Internalize Contexts」で、2026年2月13日投稿の v1 のみ(2026年9月27日時点で改訂版なし)。採択については、公式リポジトリ README の引用情報が2026年5月25日のコミット以降 booktitle={Forty-third International Conference on Machine Learning}, year={2026}=ICML 2026 の @inproceedings になっています。ただし引用に併記された OpenReview のページは当日アクセス時に HTTP 403(Challenge verification required)で確認できず、arXiv の Comments 欄にも学会名の記載はありません。「README の引用情報が ICML 2026 になっている」までが2026年9月27日時点で確認できる事実です。なお Text-to-LoRA は ICML 2025 採択です。
GitHubリポジトリはどこですか。ライセンスは何ですか?
github.com/SakanaAI/doc-to-lora です。ライセンスは MIT License(2026年3月2日のコミットで追加)。2026年9月27日時点でスター827・フォーク105・オープン Issue 0・リリースとタグは0件、main の最新コミットは2026年5月25日です。
Hugging Faceにはどのモデルが置かれていますか?
SakanaAI/doc-to-lora に4つの構成があります。gemma_demo/checkpoint-80000 と gemma_2b_d2l/checkpoint-20000(どちらもベースは google/gemma-2-2b-it)、mistral_7b_d2l/checkpoint-20000(mistralai/Mistral-7B-Instruct-v0.2)、qwen_4b_d2l/checkpoint-20000(Qwen/Qwen3-4B-Instruct-2507)。合計約6.5GB、ゲートなしでダウンロードできます。README の Python サンプルが読むのは gemma_demo です。
Doc-to-LoRAは無料で使えますか。料金はいくらですか?
コードは MIT ライセンスで無償、重みのダウンロードも無償です。2026年9月27日時点で Sakana AI が Doc-to-LoRA の有償プラン・商用 API を公開している記載はなく、公式に定められた利用料金は存在しません。実際にかかるのは自分で用意する GPU インスタンス代とストレージ代だけで、これは利用するクラウド事業者の料金表に依存します。ベースモデル側のライセンスは別途確認が必要です。
自分の手元のドキュメントで使うのに、学習は必要ですか?
不要です。それが D2L の要点で、公開済みのハイパーネットワークに文書を通すだけで LoRA が生成されます(model.internalize(doc))。勾配計算は1回も走りません。学習が必要になるのは、配布されていないベースモデル(Llama 系など)に載せたい場合や、独自ドメイン向けにハイパーネットワーク自体を訓練したい場合です。その場合のコストは公式が「複数GPUで数日〜数週間」と明記しています。
Doc-to-LoRAとText-to-LoRA(T2L)はどう違いますか?
入力と目的が違います。D2L の入力はドキュメントで、LoRA に入るのは文書由来の事実知識。T2L の入力は自然言語のタスク記述で、LoRA に入るのはタスク固有のふるまいです。当てる場所も違い、D2L は MLP の down_proj、T2L は全レイヤーの q_proj/v_proj(rank-8・アダプタ約340万パラメータ)。競合ではなく補完関係です。
WindowsやmacOSでも動きますか?
公式の install.sh が指定している flash-attn の wheel は cp310-cp310-linux_x86_64、PyTorch は --torch-backend=cu124(CUDA 12.4)です。つまり公式に用意されているのは Linux x86_64 + NVIDIA GPU + Python 3.10 の経路だけで、Windows・macOS 向けの手順は2026年9月27日時点で公式に記載がありません。試すなら Linux の GPU インスタンスを用意するのが素直です。
日本語のドキュメントでも使えますか?
2026年9月27日時点で、公式は日本語文書での評価結果を公開していません。論文・公式ブログのベンチマークは SQuAD・DROP・ROPES・PwC・合成 NIAH・Imagenette で、いずれも英語または画像です。配布チェックポイントのベースモデル(Gemma 2 2B / Mistral 7B Instruct v0.2 / Qwen3 4B Instruct)はいずれも多言語をある程度扱えますが、ハイパーネットワークが日本語文書でどの程度内在化できるかは公式値がないため、自分で測るしかありません。なお公式ブログは、VLM の視覚トークンを扱える理由の仮説として「英語が他言語のアンカーになっている前提で、視覚トークンを読むことは非英語のテキストトークンを読むことに似ている」と述べており、多言語での挙動には言及があります。
まとめ
Doc-to-LoRA は、「長い文書を毎回読み直す」という前提を外す技術です。文書を1回のフォワードパスで rank-8 の LoRA に変え、以後は追加メモリ50MB未満・文書長に関係なく一定のまま質問に答えさせる。SQuAD でフルコンテキスト比83.5%、長文 QA で85%という精度は上限に届きませんが、更新は1秒未満で、Oracle コンテキスト蒸留の40秒に対して桁が違います。
そのうえで、2026年9月27日時点の現実的な立ち位置は次のとおりです。配布済みチェックポイントは Gemma 2 2B・Mistral 7B Instruct v0.2・Qwen3 4B Instruct の3系統4構成で、Llama 系は含まれません。コードは MIT・重みも無償で、Sakana AI 側の課金は一切ありません。一方で動かす経路は Linux x86_64・Python 3.10・torch 2.6.0・CUDA 12.4 に固定されており、最小 VRAM 要件は公式に示されていません。論文の主実験まで再現するなら学習データが1モデル約100GB、メタ学習は複数GPUで数日〜数週間。「1秒未満で微調整」という要約の裏側はこの構成です。
導入判断の順番としては、①ベースモデルを配布済みの3系統に固定できるか、②精度が上限比85%前後で足りる用途か、③Linux GPU 環境を用意できるか、の3点を先に通すのが早いです。そのうえで RAG の代替なのか併用なのかを決める。リポジトリの更新が2026年5月25日で止まっている点も踏まえ、参照実装として扱い、依存バージョンは自分の側で固定する前提で計画を立てるのが現実的です。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Sakana AI — Instant LLM Updates with Doc-to-LoRA and Text-to-LoRA(公式技術解説・2026年9月27日取得)
- arXiv:2602.15902 — Doc-to-LoRA: Learning to Instantly Internalize Contexts(v1・2026年2月13日投稿)
- GitHub — SakanaAI/doc-to-lora(README・install.sh・リポジトリ構成・MIT License/2026年9月27日取得)
- Hugging Face — SakanaAI/doc-to-lora(4構成のチェックポイントと args.yaml/2026年9月27日取得)
- GitHub — SakanaAI/text-to-lora(Text-to-LoRA 参照実装)
- Sakana AI — Text-to-LoRA: Instant Transformer Adaption(ICML 2025)
- arXiv:2506.06105 — Text-to-LoRA: Instant Transformer Adaption
- Sakana AI — Corporate Info(創業者・リーダーシップ・研究とプロダクト一覧/2026年9月27日取得)
- MarkTechPost — Sakana AI Introduces Doc-to-LoRA and Text-to-LoRA(2026年2月27日)
佐藤 傑(さとう すぐる)
株式会社Uravation 代表取締役|Agent Lab 編集長
SoftBank IT連載執筆(全7回)。AIエージェントの実践導入支援を手がけ、技術と経営の橋渡しをミッションに活動中。
あわせて読みたい
- ChatGPT API ビジネス自動化ガイド
- n8n AIエージェントワークフロー自動化ガイド
- AIエージェントとは?仕組み・種類・活用事例を徹底解説
AIエージェントの導入・活用についてのご相談は、Uravationのサービス一覧をご覧ください。
関連する実装ガイド
あわせて読みたい
→ AIエージェントとは?仕組み・種類・活用事例をわかりやすく解説【2026年版】
→ 【2026年版】法人向け生成AI導入 完全バイヤーズガイド|ChatGPT・Claude・Gemini・Copilot 料金比較
→ Luma Agents登場――全モダリティ統合のクリエイティブAIエージェント
関連記事
- サカナAI(Sakana AI)とは|何がすごい・上場・料金
- RAG・ファインチューニング・プロンプトの使い分け
- Claude Code × Qwen 3.5 ローカルLLMハイブリッド開発
- TurboQuant|KVキャッシュ6倍圧縮の仕組み
- Gemma 3nとは?エッジで動くマルチモーダルLLM実装
関連記事:サカナAIという会社そのものについて(創業者・資金調達・Fugu/Namazuの位置づけ・企業が使えるのか)は、サカナAI(Sakana AI)とは|何がすごい・上場・料金で総合的に解説しています。